Extraktionsgenauigkeit von Felddatenformularen:
Wetter, Handschrift und Formulardesign
Die Extraktionsgenauigkeit von Felddatenformularen wird lange bevor die Datei ein Extraktionstool erreicht, entschieden – sie wird auf dem Klemmbrett, im Regen, von der Person mit dem Stift entschieden. Ein Umwelttechniker in einem r/Environmental_Careers-Thread brachte es in Worte, die jeder kennt, der schon einmal ein Feuchtgebiet durchquert hat: „Wenn kein Schlamm auf Ihren Datenformularen ist, haben Sie das Feuchtgebiet wirklich abgegrenzt?“ Dieser Schlamm ist nicht nur Authentizität – er ist der größte einzelne Prädiktor dafür, ob eine Schädlingszählung, ein pH-Wert oder ein Sicherheitsbefund am anderen Ende korrekt herauskommt. Dieser Artikel kartiert jeden Faktor, der zwischen einem Formular im Feld und einer zuverlässigen Zeile in Ihrer Datenbank liegt, und kennzeichnet, welche davon Sie tatsächlich kontrollieren können.
Wichtige Erkenntnisse
- Genauigkeitsprobleme bei Feldformularen sind fast nie die Schuld des Extraktionstools – sie werden auf dem Klemmbrett, im Regen, von der Person mit dem Stift entschieden, lange bevor die Datei irgendeine Software erreicht.
- Dieselben Bedingungen, die ein Formular für KI schwer lesbar machen, machen es auch für Menschen schwer: dokumentierte manuelle Transkriptionsfehlerraten (manuelles Abtippen von Formularinhalten in eine Datenbank) liegen bei 1–10 %, und allein die Erfassungsqualität verändert die Extraktionsergebnisse um 10–20 Prozentpunkte.
- Hören Sie auf, nach einem besseren Extraktionstool zu suchen – Ihr eigentlicher Hebel ist die Kette: Gestalten Sie Formulare mit Codes statt Freitext, fotografieren Sie sie am Tag der Erfassung und verifizieren Sie nur die 10 % der Zellen, die die KI als unsicher markiert, statt alles neu einzutippen.
Selbst perfekte Transkription startet im Rückstand
Bevor überhaupt Software im Spiel ist, geht beim manuellen Übertragen von Felddaten bereits ein messbarer Prozentsatz verloren – und Felddaten, die mit Handschuhen und bei Wind erfasst werden, verlieren mehr als Bürodaten.
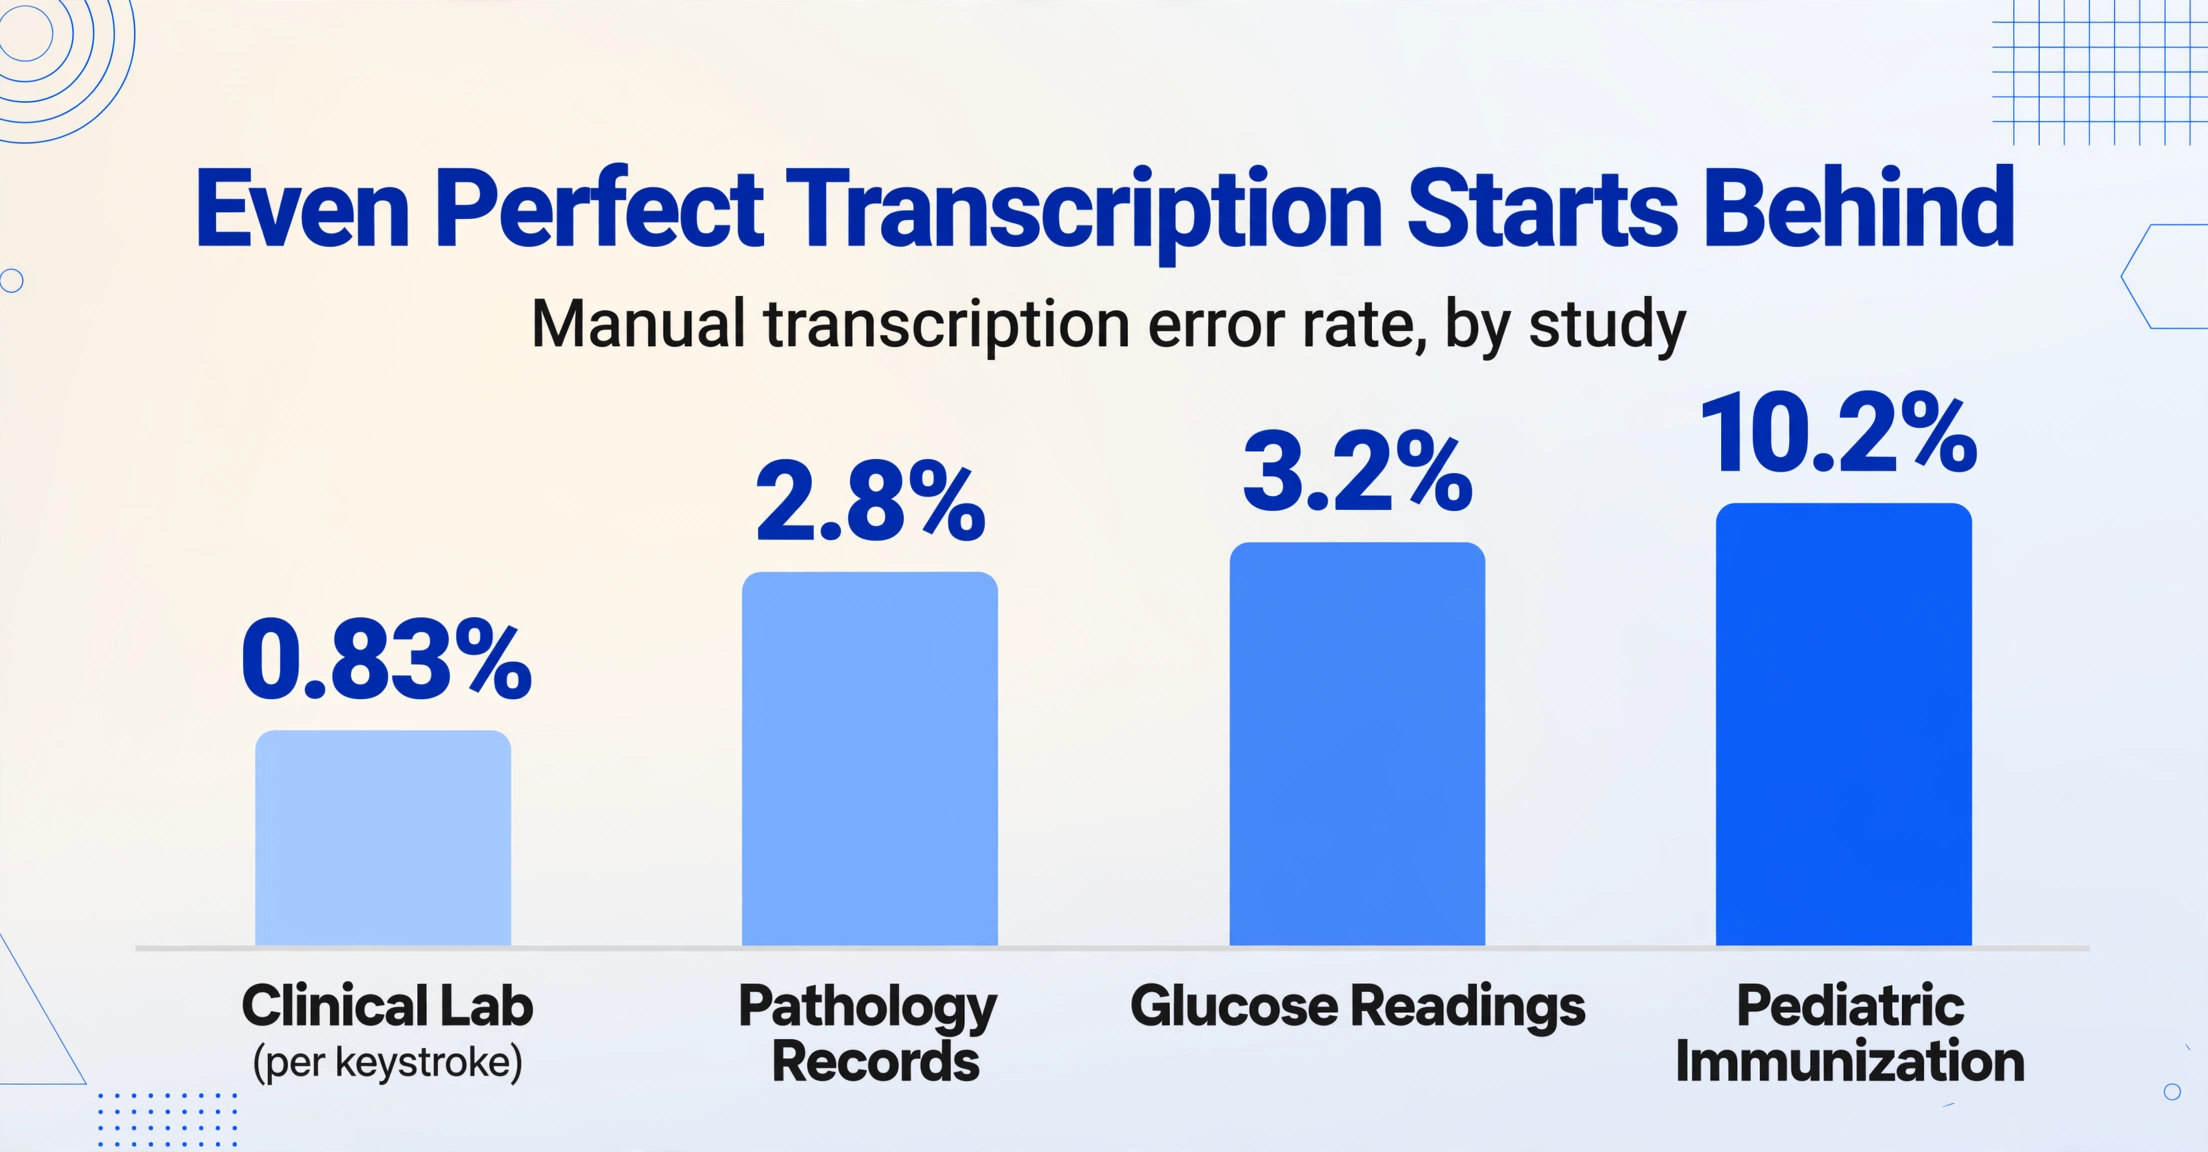
Studien zu manuellen Transkriptionsfehlern im medizinischen Umfeld und bei Aufzeichnungen, zusammengefasst in einem Peer-Review-Review, das im PMC-Archiv der NCBI veröffentlicht wurde, ergaben Fehlerraten über eine Größenordnung hinweg: 0,83 % pro Tastendruck in einem klinischen Labor, 2,8 % insgesamt in einer Studie zu Pathologieaufzeichnungen (je nach Feld zwischen 0,5 und 6,4 %), 3,2 % bei Glukosemesswerten am Point-of-Care und 10,2 % bei einem pädiatrischen Impfdatensatz. Der gemeinsame Nenner ist, dass selbst motivierte, geschulte Personen beim Übertragen von Werten zwischen Medien Fehler im niedrigen einstelligen Prozentbereich machen – und die Fehler konzentrieren sich genau auf die numerischen Felder, von denen die Feldarbeit abhängt: vertauschte Ziffern beim pH-Wert, die falsche Proben-ID bei einer Sammelprobe, ein Wasserstand, der in der Nachbarspalte landet.
Das ist die Ausgangsbasis. Extraktionssoftware konkurriert nicht gegen perfekte Transkription, sondern gegen diese fehlerbehaftete, menschlich schnelle Ausgangsbasis – weshalb „Ist die KI genau?“ die falsche Frage ist. Die richtige Frage lautet: „Genau im Vergleich zu was, bei welchen Eingaben?“ Das Genauigkeitsspektrum nach Feldtyp, das wir separat kartiert haben, zeigt dasselbe Phänomen aus Sicht des Tools: gedruckter Text bei fast 99 %, Schreibschrift bei etwa 70 %, Kontrollkästchen irgendwo dazwischen – eine Spannweite von 25 Punkten auf einem einzigen Formular. In dieser Spannweite leben Feldformulare, denn alles, was ein Formular schwer lesbar macht, macht es auch schwer zu transkribieren – egal, ob die lesenden Hände menschlich oder maschinell sind.
Regen, Schlamm und Sonnenlicht: Das Feld schreibt das Formular um
Physische Schäden am Papier sind der erste Genauigkeitsfaktor – und gleichzeitig der, den Feldteams am wenigsten erwarten, weil sie ihn irgendwann nicht mehr wahrnehmen. Ein Techniker, der ein Logbuch die ganze Saison getragen hat, bemerkt den Wasserfleck über der Leitfähigkeitsspalte, den Knick, wo das Blatt in eine Hosentasche gefaltet war, oder die Tinte, die durch Sonne zu einem blassen Grau ausgeblichen ist, nicht mehr. Jedes dieser Elemente verschlechtert das visuelle Signal, das das Extraktionsmodell liest – genauso, wie es das Signal für einen Vorgesetzten verschlechtern würde, der das Formular im Büro liest.
Feldteams haben ihre eigenen Workarounds, die zeigen, wie real das Problem ist. Im selben r/Environmental_Careers-Thread teilte ein Kommentator den klassischen Fix: "Feld-Hack: Kauft das lose Blatt Papier zum Schreiben im Regen und druckt die Formulare darauf. Es ist die Kosten wert!" Wetterfestes Papier, Stifte mit wasserfester Tinte und Klemmbretter mit Deckel existieren, weil Wasser, Schlamm und Sonne Feldaufzeichnungen zuverlässig zerstören. Wenn diese Aufzeichnungen überleben, kommen sie mit dem Wetter, das ihnen zugesetzt hat, im Büro an – und genau das ist die Eingabe, die eine Extraktions-Pipeline erhält.
Was Sie hier kontrollieren: Fotografieren oder scannen Sie das Formular, solange es noch lesbar ist – am Tag der Aufnahme, nicht am Tag, an dem es im Büro ankommt. Formulare, die zum Zeitpunkt der Erfassung fotografiert werden, halten die Schrift fest, bevor eine Woche im LKW-Führerhaus sie verblassen lässt. Wenn das nicht möglich ist, behandeln Sie sichtbar beschädigte Formulare als separates, kleineres Batch und erwarten Sie, sie intensiver zu verifizieren (mehr zur Verifizierung unten).
Durchschläge und Duplikat-Formulare fügen eine zweite Schicht von Schäden hinzu: Die Durchschlagsqualität auf dem zweiten und dritten Exemplar nimmt stark ab, und wenn Teammitglieder beide Exemplare gleichzeitig ausfüllen, kann der Druck die Schrift auf dem obersten Blatt flacher machen. Die Extraktion behandelt einen blassen Durchschlag so, wie es ein Mensch tut – sie liest ihn, zögert und kann ihn falsch lesen. Die gleiche Logik gilt für Bleistift: radierbar und für den Schreiber lesbar, blass und verschmieranfällig für jeden, der später liest.
Handschrift einer müden Person mit Handschuhen
Die Qualität der Handschrift variiert im Laufe eines Nachmittags stärker als zwischen zwei beliebigen Extraktionstools – das elfte Formular eines Außendienstmitarbeiters am Tag ist messbar weniger leserlich als das erste. Die Forschung zur Handschrifterkennung behandelt Leserlichkeit als eine Eigenschaft des Schreibers, aber bei der Feldarbeit ist sie eine Eigenschaft der Bedingungen: kalte Finger, nasse Handschuhe, ein Klemmbrett auf der Motorhaube eines Trucks, der Druck, zur nächsten Station zu eilen. Reddit-Feldtechniker beschreiben den Kompromiss präzise – „Im Feld ist es einfach viel schneller, eine Zahl auf ein Papierformular zu schreiben, als das iPad zu entsperren, die App zu öffnen und die Zahl einzutippen“ – weshalb Papier im digitalen Zeitalter überlebt und weshalb genau dieses Papier das ist, was die Extraktion verarbeiten muss.
Die gute Nachricht ist, dass die meisten Feldaufzeichnungen in Druckschrift oder Blockschrift erfolgen, die die Extraktion mit hoher Genauigkeit verarbeitet; die Genauigkeitsgrenze liegt bei hastiger Schreibschrift und bei Ziffern, die so schnell geschrieben werden, dass 3 und 8 oder 1 und 7 ineinander übergehen. Ein gemischtes Formular – gedruckte Beschriftungen, handschriftliche Blockwerte, eine eingekreiste Option, eine Unterschrift – ist ein normaler Fall, und moderne Vision-Modelle lesen die Mischung ganzheitlich, statt eine einheitliche Schriftart pro Seite zu verlangen.
Es gibt eine institutionelle Antwort darauf, die älter ist als KI, und es lohnt sich, sie zu übernehmen. Das Field Book for Describing and Sampling Soils (Version 4.0, 2024) des USDA NRCS weist Bodenwissenschaftler an, Pflanzenarten als standardisierte Symbolcodes zu erfassen – Großes Blaues Mastgras wird zu „ANGE“, einem vierstelligen Code aus der offiziellen Pflanzenliste – statt Namen auszuschreiben, die in Schreibweise und Länge variieren. Der Design-Gedanke lässt sich direkt übertragen: Je weniger Freitext-Handschrift das Formular verlangt, desto weniger Raum bleibt für die Schrift selbst als Fehlerquelle. Codes, Kontrollkästchen und Zahlen sind für Maschinen aus demselben Grund lesbarer wie für müde Menschen. Unser Leitfaden zur Verbesserung der Handschriftgenauigkeit geht näher darauf ein, was die Handschrift des einen Formulars extrahierbar macht und die eines anderen nicht.
Formulardesign ist der unterschätzte Hebel für die Extraktionsgenauigkeit
Das Formulardesign bestimmt die Extraktionsgenauigkeit stärker als jeder Erfassungstrick, denn es entscheidet, was das Extraktionsmodell überhaupt interpretieren muss. Die vom Interstate Technology & Regulatory Council (ITRC) veröffentlichte Anleitung zur Umweltdatenverwaltung macht diesen Punkt aus Sicht der Dokumentation deutlich: „Entwerfen Sie ein Feldformularfeld im Wissen um den erwarteten Datentyp und die Länge des Datenbankfelds, in dem es gespeichert wird." Ein Formular, das mit Blick auf seine Zieldatenbank gestaltet ist – ein Wert pro Feld, Einheiten direkt neben dem Feld, kein mehrzeiliger Freitext, wenn ein Code genügt – erzeugt Zeilen, die mit minimaler Interpretation in den richtigen Spalten landen. Ein auf Bequemlichkeit ausgelegtes Formular erzeugt Mehrdeutigkeiten, die kein Extraktionsmodell vollständig auflösen kann.
Vier Designentscheidungen tauchen in Feldformularen immer wieder auf, und jede lässt sich einem bekannten Genauigkeitsverhalten zuordnen:
| Designentscheidung | Warum sie problematisch ist | Die genauigkeitsfreundliche Variante |
|---|---|---|
| Überall offene Leerfelder | Freitextfelder laden zu Abkürzungen, Kurzschrift und Einheitenverwechslungen ein – der Schreibende setzt Kontext voraus, den der Leser nicht hat | Checkboxen für bekannte Optionen; Einheiten im Label angegeben („pH (Einheiten)"), Codes für wiederkehrende Werte |
| Linienraster durch die Wertbereiche | Gitterlinien, die den Text kreuzen, erzeugen visuelles Rauschen, das mit den Zeichen konkurriert | Abgesetzte Leerfelder oder dezente Linien, die vor der Schreibzone enden |
| Hohe Dichte – alles auf einer Seite | Enge Felder drücken die Schrift an Beschriftungen und Ränder; Werte verschwimmen ineinander | Ein Wert pro Feld mit klarer Trennung; eine zweite Seite schlägt eine überladene erste |
| Gemischte Ausrichtung innerhalb eines Stapels | Quer- und Hochformatseiten im selben Stapel benötigen jeweils einen eigenen Lesepfad | Nach Möglichkeit eine Ausrichtung pro Stapel; bei Mischung sollte das Tool Felder weiterhin nach Bedeutung statt nach Position finden |
Die letzte Zeile ist entscheidend, denn hier trennen sich die Extraktionsansätze. Vorlagen-OCR fixiert jedes Feld auf eine Koordinate in einem Referenzformular – drehen Sie das Formular, ändern Sie das Layout, fügen Sie eine andere Logbuchvorlage einer Station hinzu, und die Felder passen nicht mehr. Der semantische Ansatz, den ImageToTable.ai mit Custom Column Extraction verwendet, kehrt das um: Sie geben die gewünschten Spaltennamen ein („pH", „Schädlingsanzahl", „Stations-ID"), und die KI lokalisiert den Wert, der jedem Namen entspricht, überall auf der Seite – nach Bedeutung statt nach Position. Ein Stapel Feldformulare mit unterschiedlichen Layouts, unterschiedlicher Handschrift und unterschiedlichem Abnutzungsgrad liefert weiterhin dieselben benannten Spalten, weil das Modell das Dokument so liest, wie es ein Mensch tun würde – es verlangt nicht, dass das Feld an einer gespeicherten Koordinate sitzt.
Erfassung: Ein Foto ist die halbe Genauigkeit
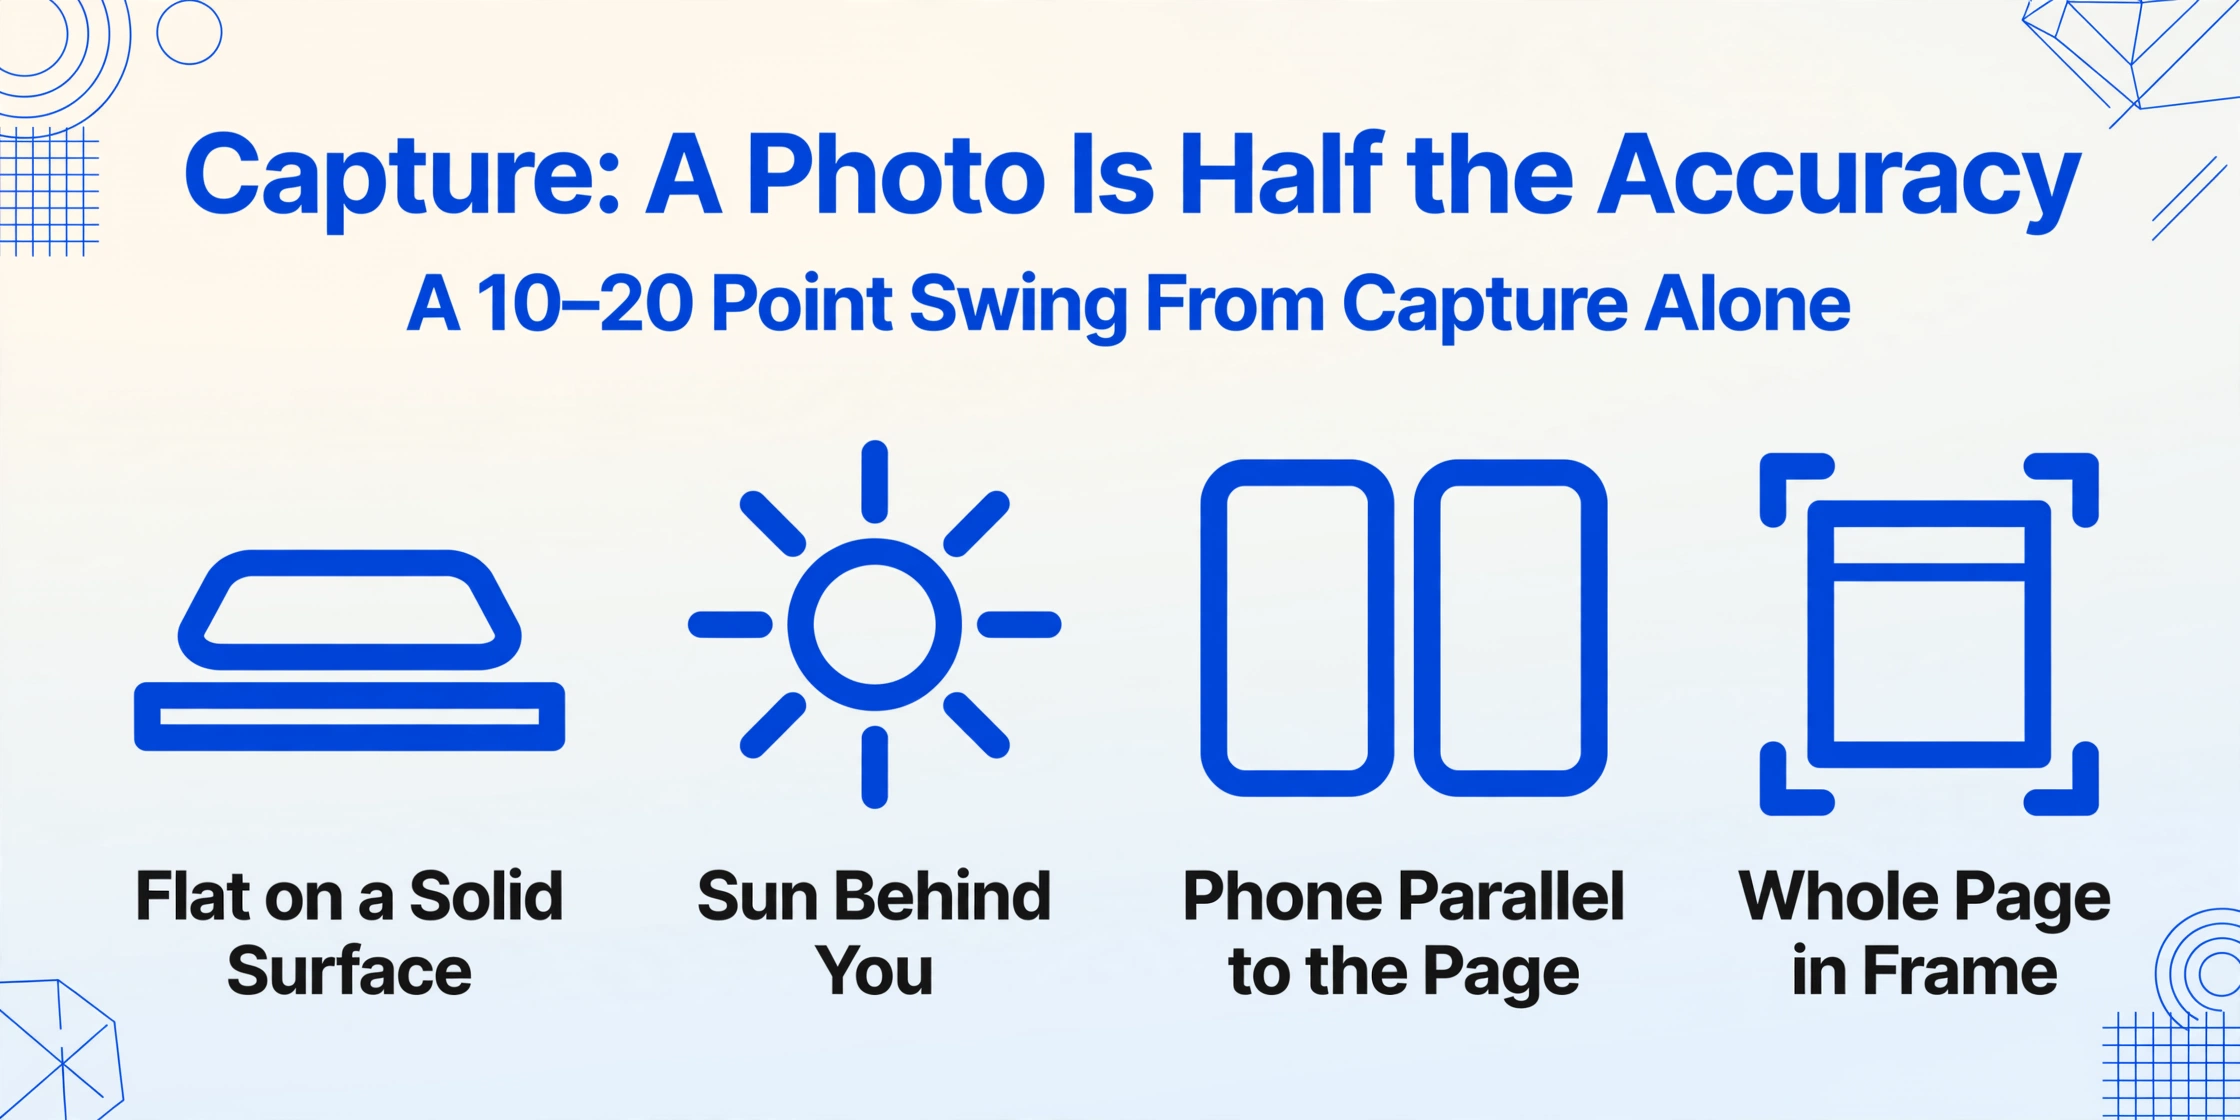
Zwischen zwei Fotos desselben Formulars macht die Erfassungsqualität allein einen Genauigkeitsunterschied von 10–20 Prozentpunkten aus – eine Zahl, die unsere eigenen Tests zur Formulargenauigkeit immer wieder bestätigen. Der Großteil dieser Schwankung lässt sich auf vier einfache Gewohnheiten zurückführen: das Formular flach auf eine feste Unterlage legen, Blendung und Gegenlicht vermeiden, das Telefon parallel zur Seite halten und die gesamte Seite einschließlich der Kopfzeilen-Identifikatoren im Bild haben. Die Dokumentenscan-Modi der Telefonkameras automatisieren den Großteil davon – Perspektivkorrektur, Abflachung und Schattenentfernung sind in jedem modernen Telefon integriert – aber sie helfen nur, wenn der Außendienstmitarbeiter sie auch öffnet.
Die Erfassung im Freien hat ihre eigenen Fehlerquellen. Direktes Sonnenlicht, das die Seite auswäscht, und der eigene Schatten des Fotografen, der über die Schrift fällt, sind die beiden häufigsten – und beide werden mit derselben Maßnahme behoben: sich so drehen, dass die Sonne hinter dem Fotografen steht, oder den eigenen Schatten nutzen, um die Seite zu beschatten. Der Techniker im Reddit-Thread, der digitale Formulare als „bei hellem Sonnenlicht schwer lesbar“ beschrieb, beschrieb dieselbe Physik, die ein Papierformular gegen einen hellen Himmel unterbelichtet – nur dass ein Papierformular beschattet, geneigt oder bewegt werden kann, während ein Foto nur das festhält, was die Kamera gesehen hat.
Die Auflösung ist weniger wichtig, als die meisten annehmen, sobald eine bescheidene Schwelle überschritten ist – ein Telefonfoto eines Briefbogen-Formulars ist typischerweise 2.000–3.000 Pixel breit, mehr als genug – aber die Art der Erfassung ist entscheidend: Ein flacher, gut beleuchteter Scan eines sauberen Formulars ist der beste Fall; ein Foto desselben Formulars, abends im LKW aufgenommen, ist der schlechteste Fall, und beide können in derselben Charge landen. Wenn die Fotos Ihrer Crew eine Woche im LKW liegen, verkürzt das Sammellink-Muster, das wir in unserem Leitfaden zur Feldformular-zu-Excel-Workflow beschrieben haben – ein teilbarer Link, über den die Crew Fotos direkt in Ihre Verarbeitungswarteschlange hochladen kann – diese Lücke und begrenzt, wie stark die Formulare vor der Erfassung verfallen.
Warum semantische Extraktion hält, wo Vorlagen-OCR versagt
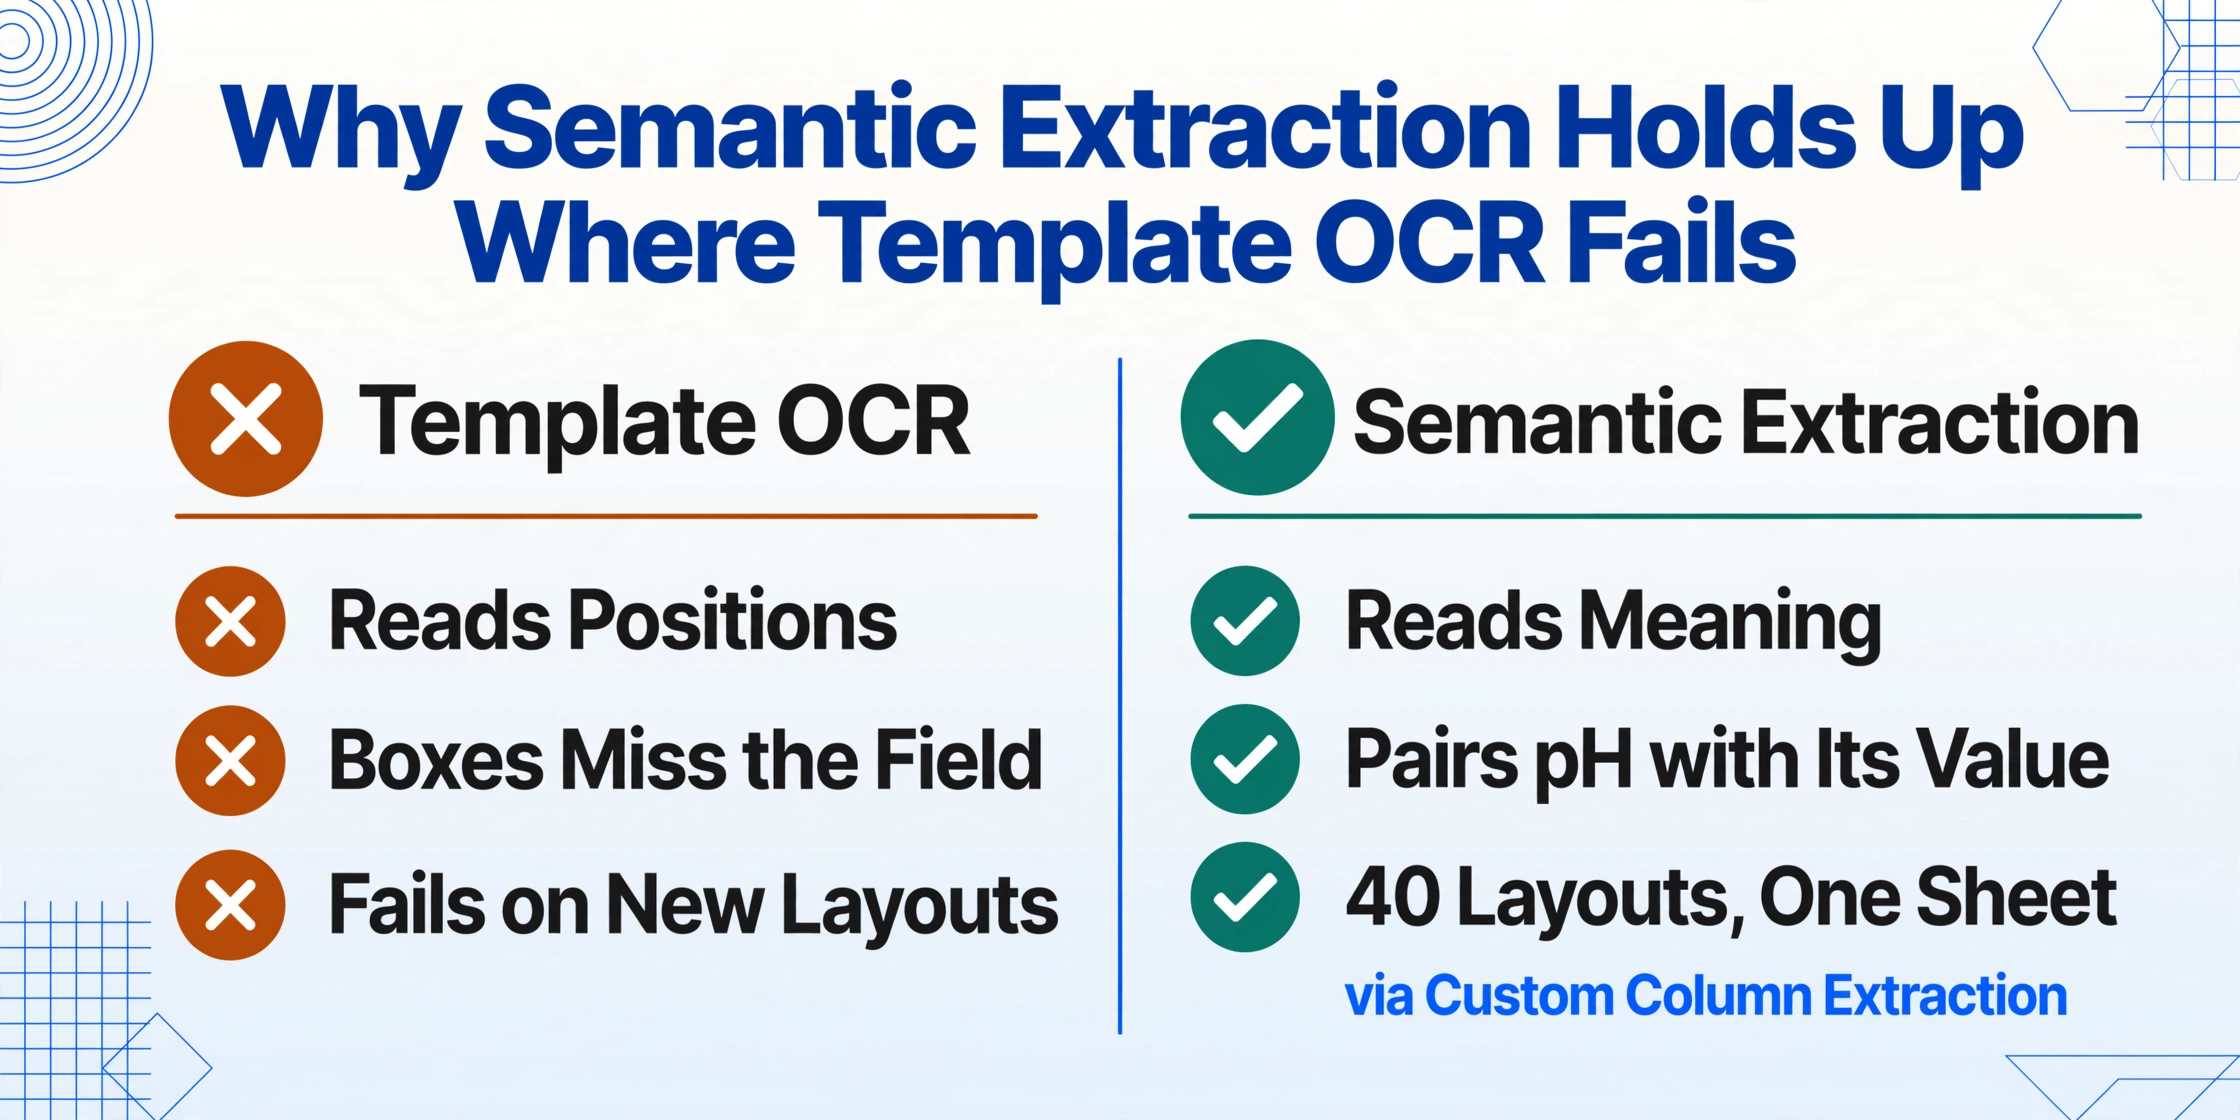
Vorlagen-OCR liest Positionen; semantische Extraktion liest Bedeutung – und bei Feldformularen lügen Positionen.
Vorlagen-OCR hat sich seinen Ruf mit Rechnungen und Formularen verdient, die von derselben Quelle immer im selben Layout kommen: Zeichnen Sie ein Feld auf einem Referenzdokument, extrahieren Sie, was in das Feld fällt, und wiederholen Sie das. Felddatenformulare verletzen diese Annahme bei jeder Gelegenheit – verschiedene Teams verwenden verschiedene Layouts, Stationen haben unterschiedliche Logbuchvorlagen, ein Formular wird einmal im Querformat gescannt und beim nächsten Mal im Hochformat fotografiert. Wenn sich das Layout ändert, stimmen die Felder nicht mehr mit den Feldern überein, und die Genauigkeit bricht zusammen, obwohl die Schrift einwandfrei lesbar ist.
Die Extraktion mit Vision-Modellen umgeht das Positionsproblem vollständig. Das Modell liest die gesamte Seite, versteht, dass „pH“ eine Messgröße ist und der Wert daneben die Antwort darauf ist, und liefert die Zuordnung unabhängig davon, wo das Paar steht. Das ist der Mechanismus hinter der oben beschriebenen Custom Column Extraction, und es ist auch der Grund, warum eine Charge von 40 Formularen mit 40 verschiedenen Layouts trotzdem eine saubere Tabelle ergibt. Die ITRC-Leitlinie erkennt dasselbe Prinzip von der Datenseite an – Felddaten „verdienen oft besondere Prüfung, da die Wahrscheinlichkeit von Fehlern erhöht ist, etwa Transkriptionsfehler oder In-situ-Instrumentendrift“ – weil die Fehler in Felddaten häufiger semantisch (falscher Wert für falschen Kontext) als positionell sind. Ein Werkzeug, das Kontext versteht, beantwortet die richtige Frage.
Hier ist der ehrliche Punkt, um zu sagen, was semantische Extraktion nicht beheben kann: unleserliche Handschrift, ein Wert, der mit einem Stiftstrich durchgestrichen ist und vom Modell als Teil der Zahl fehlgelesen wird, oder eine Seite, auf der Regen die Tinte in ein Aquarell verwandelt hat. Kein Werkzeug – weder Mensch noch Maschine – kann Daten wiederherstellen, die das Quelldokument nicht mehr enthält. Was die Extraktion ändert, ist das Fehlerprofil: Sie verschiebt das Versagen von Tausenden von Tastatureingaben, bei denen Fehler unsichtbar bleiben, zu einer Handvoll markierter Zellen, die ein Mensch prüfen kann. Für einen tieferen Einblick in die verbleibenden Fehlermodi bei Handschrift finden Sie in unserer Analyse der Fehlermodi bei der Handschriftextraktion eine detaillierte Auflistung.
Prüfen Sie, was zählt – nicht alles
Da keine Extraktion zu 100 % genau ist, entscheidet die Frage, worauf Sie Ihre Verifizierung ausrichten – und die Antwort sind dieselben Felder, die Ihr Compliance-Rahmenwerk bereits berücksichtigt. Das Quality Assurance Handbook for Air Pollution Measurement Systems (EPA-600/R-94/038a) der EPA und die darauf basierenden Umweltprogramme definieren Datenverifizierung als Prüfung, dass „Daten korrekt transkribiert und aufgezeichnet wurden" und dass elektronische und Papieraufzeichnungen eine Eins-zu-eins-Entsprechung aufweisen. Die Aufzeichnungspflicht nach 29 CFR 1904 der OSHA verlangt den OSHA-Formular-301-Unfallbericht innerhalb von sieben Tagen nach einem meldepflichtigen Unfall – eine Frist, die die Geschwindigkeit der Extraktion zu einem Compliance-Merkmal und die Genauigkeit der transkribierten Details zu einer Compliance-Anforderung macht. Der NRCS Nutrient Management Standard 590 des USDA macht die Förderfähigkeit von Kostenbeteiligungen von Bodenprobenahme- und Testverfahren abhängig, die dem Standard entsprechen – einschließlich der Aufzeichnungen, die belegen, dass die Proben korrekt behandelt wurden.
Alle drei Rahmenwerke laufen auf denselben operativen Bedarf hinaus: eine Möglichkeit, zu bestätigen, dass die Werte in der Datenbank mit den Werten auf den Quellformularen übereinstimmen, ohne jede Zeile manuell erneut zu lesen. Diese Lücke füllt Bounding-Box-gestützte Verifizierung. Im Prüfbereich von ImageToTable.ai hebt das Überfahren einer extrahierten Zelle den genauen Bereich des Originalbilds hervor, aus dem dieser Wert stammt – und ein Klick auf einen Bildbereich springt zurück zur passenden Zelle. Statt zur Kontrolle neu zu tippen, bestätigt ein Prüfer die wenigen Zellen, die die KI als unsicher markiert hat, und der Rest wird als vertrauenswürdig eingestuft. So wird aus „alles prüfen" (der Grund, warum manuelle Transkription langsam ist) „die riskanten 10 % prüfen" (das dauert Sekunden pro Formular).
Der realistische Arbeitsablauf ist: Stapelverarbeitung der Runde, Scannen der extrahierten Zeilen gegen die Originale mit Bounding-Box-Hervorhebung, Korrigieren der markierten Zellen und Export. Dasselbe Muster gilt für die Wartungsprotokolle und Inspektionsaufzeichnungen anderer Feldoperationen – der Workflow zur Wartungsprotokoll-zu-Excel-Konvertierung zeigt dieselbe Erfassungs-Prüf-Export-Schleife in einem industriellen Kontext, und unsere Analyse, wo Felddaten-Pipelines scheitern erklärt, warum der Verifizierungsschritt die Stelle ist, an der die meisten manuellen Systeme still versagen.
FAQ
Kann die Extraktion regenbeschädigte oder wasserfleckige Formulare lesen?
Das hängt davon ab, wie viel der Schrift den Regen überstanden hat. Leichte Flecken um gut lesbaren Text werden in der Regel problemlos verarbeitet; verlaufene oder bis zur Unleserlichkeit verblasste Tinte kann kein Werkzeug wiederherstellen, weder menschlich noch maschinell. Die praktische Lösung ist der Zeitpunkt der Erfassung: Fotografieren Sie Formulare am Tag des Ausfüllens, solange die Schrift noch intakt ist, statt erst nach einer Woche im Feld. Für Formulare, die im Feld aufbewahrt werden müssen, erhalten wetterfestes Papier und wasserfeste Tinte (der Trick, den Feldteams teilen) die Aufzeichnung.
Was, wenn die Handschrift meines Teams hastig oder unleserlich ist?
Die meisten Feldaufzeichnungen sind in Blockschrift und lassen sich gut extrahieren. Die Genauigkeitsgrenze liegt bei hastiger Schreibschrift und mehrdeutigen Ziffern (3 vs. 8, 1 vs. 7). Zwei Dinge helfen: Gestalten Sie Formulare so, dass freie Handschrift minimiert wird (Codes, Kontrollkästchen, ein Wert pro Feld – der NRCS-Pflanzensymbol-Ansatz), und nutzen Sie den Verifizierungsschritt, um genau die Zellen zu prüfen, die die KI als unsicher markiert, mit Bounding-Box-Hervorhebung am Originalbild.
Verarbeitet die Extraktion Kontrollkästchen, eingekreiste Optionen und Unterschriften?
Ja. Vision-Modelle lesen angekreuzte Kästchen, eingekreiste Optionen und handschriftliche Unterschriften als visuelle Elemente, nicht nur als Text. Für Felder, in denen Teammitglieder eine Option einkreisen oder ankreuzen statt einen Wert einzutragen, definieren Sie die Spalte mit den ausgeschriebenen Optionen – Schädlingsdruck (Optionen: Niedrig / Mittel / Hoch) – damit das Modell die Markierung dem richtigen Label zuordnet.
Reicht ein Handyfoto oder brauche ich einen Scanner?
Ein flaches, gut beleuchtetes Handyfoto reicht für die meisten Feldformulare – der Dokumentenmodus moderner Handys korrigiert Perspektive und Schatten automatisch. Die Aufnahmequalität beeinflusst die Genauigkeit um 10–20 Prozentpunkte, daher zählen die Gewohnheiten mehr als die Hardware: flache Oberfläche, parallele Kamera, ganze Seite im Bild, keine Spiegelungen. Ein Scanner gewinnt nur, wenn das Formular bereits sauber ist und Sie einen in der Nähe haben.
Unsere Stationen verwenden unterschiedliche Formularlayouts. Funktioniert die Extraktion trotzdem?
Ja — genau das ist der Fall, an dem Vorlagen-OCR scheitert. Da ImageToTable.ai Werte anhand der Bedeutung statt anhand der Position auf der Seite lokalisiert, liefert ein Batch mit gemischten Layouts, Ausrichtungen und Handschriftstilen weiterhin dieselben benannten Spalten. Sie pflegen keine Vorlage pro Layout; Sie benennen die Spalten einmal und das Modell findet die Werte.
Welche Genauigkeit kann ich tatsächlich erwarten?
Gedruckter Formulartext wird zu fast 99 % extrahiert; gut lesbare Blockschrift wird zuverlässig erkannt; hastige Schreibschrift fällt in den 70er-Bereich — dieselbe Spanne, die Menschen beim manuellen Übertragen zeigen, wo dokumentierte Fehlerraten in Studien bei 1–10 % liegen. Erwarten Sie das beste Ergebnis bei sauberen, gut erfassten und gut gestalteten Formularen, und planen Sie, die schlechtesten 10 % der Zellen bei beschädigten oder unordentlichen Formularen zu prüfen. Jedes Tool, das 100 % bei Felddaten verspricht, ist nicht ehrlich zu Ihren Eingaben.
Die Genauigkeit bei Feldformularen ist keine Eigenschaft des KI-Modells — sie ist eine Eigenschaft der gesamten Kette: das Papier, der Stift, das Design, das Foto und der Verifizierungsschritt. Jedes Glied können Sie kontrollieren.
Arbeiten Sie die Kette der Reihe nach ab, und das Ergebnis wird vorhersehbar: Gestalten Sie Formulare, die weniger Handschrift erfordern, erfassen Sie sie, solange sie lesbar sind, verarbeiten Sie sie im Batch mit einem Tool, das Bedeutung statt Position liest, und prüfen Sie die riskanten Zellen, statt alles neu zu tippen. So wird ein Wasserqualitäts-Logbuch, das im Regen geschrieben wurde, zu einem compliance-fähigen Datensatz — und so behält ein Bodenprobenformular, das am Ende eines langen Tages ausgefüllt wurde, seine Zahlen auf dem Weg zur Datenbank. Der Schlamm gehörte schon immer zum Job. Dass er Ihnen keine Daten mehr kostet, übernimmt die Extraktion — testen Sie sie an einem Formular, das tatsächlich im Feld war.