Felddaten sind bereits erfasst –
sie in Excel zu bringen ist die Arbeit
Ein Feldbegeher füllt am Feldrand einen handschriftlichen Schädlingszählungsbogen auf einem Klemmbrett aus, dann fährt der Bogen in einem Pickup, einem Ordner oder einem Stapel auf dem Büroschreibtisch mit, bis jemand Zeit findet, ihn in eine Tabellenkalkulation abzutippen. Ein Wasserqualitätstechniker fotografiert am Ende einer Probenahmerunde das Logbuch eines Überwachungsbrunnens, und die pH-Wert- und Leitfähigkeitsmesswerte bleiben tagelang auf dem Kameraspeicher. Die Felddaten – der mühsam erarbeitete Teil des gesamten Betriebs – sind bereits erfasst. Was die ganze Woche dauert, ist der Schritt, in dem jemand diese Formulare in Zeilen verwandelt. Genau diesen Schritt entfernt dieser Artikel: fünf Schritte, vom Formular, wie es im Feld existiert, bis zur Tabellenkalkulation, die Ihr Workflow tatsächlich nutzen kann.
Wichtigste Erkenntnisse
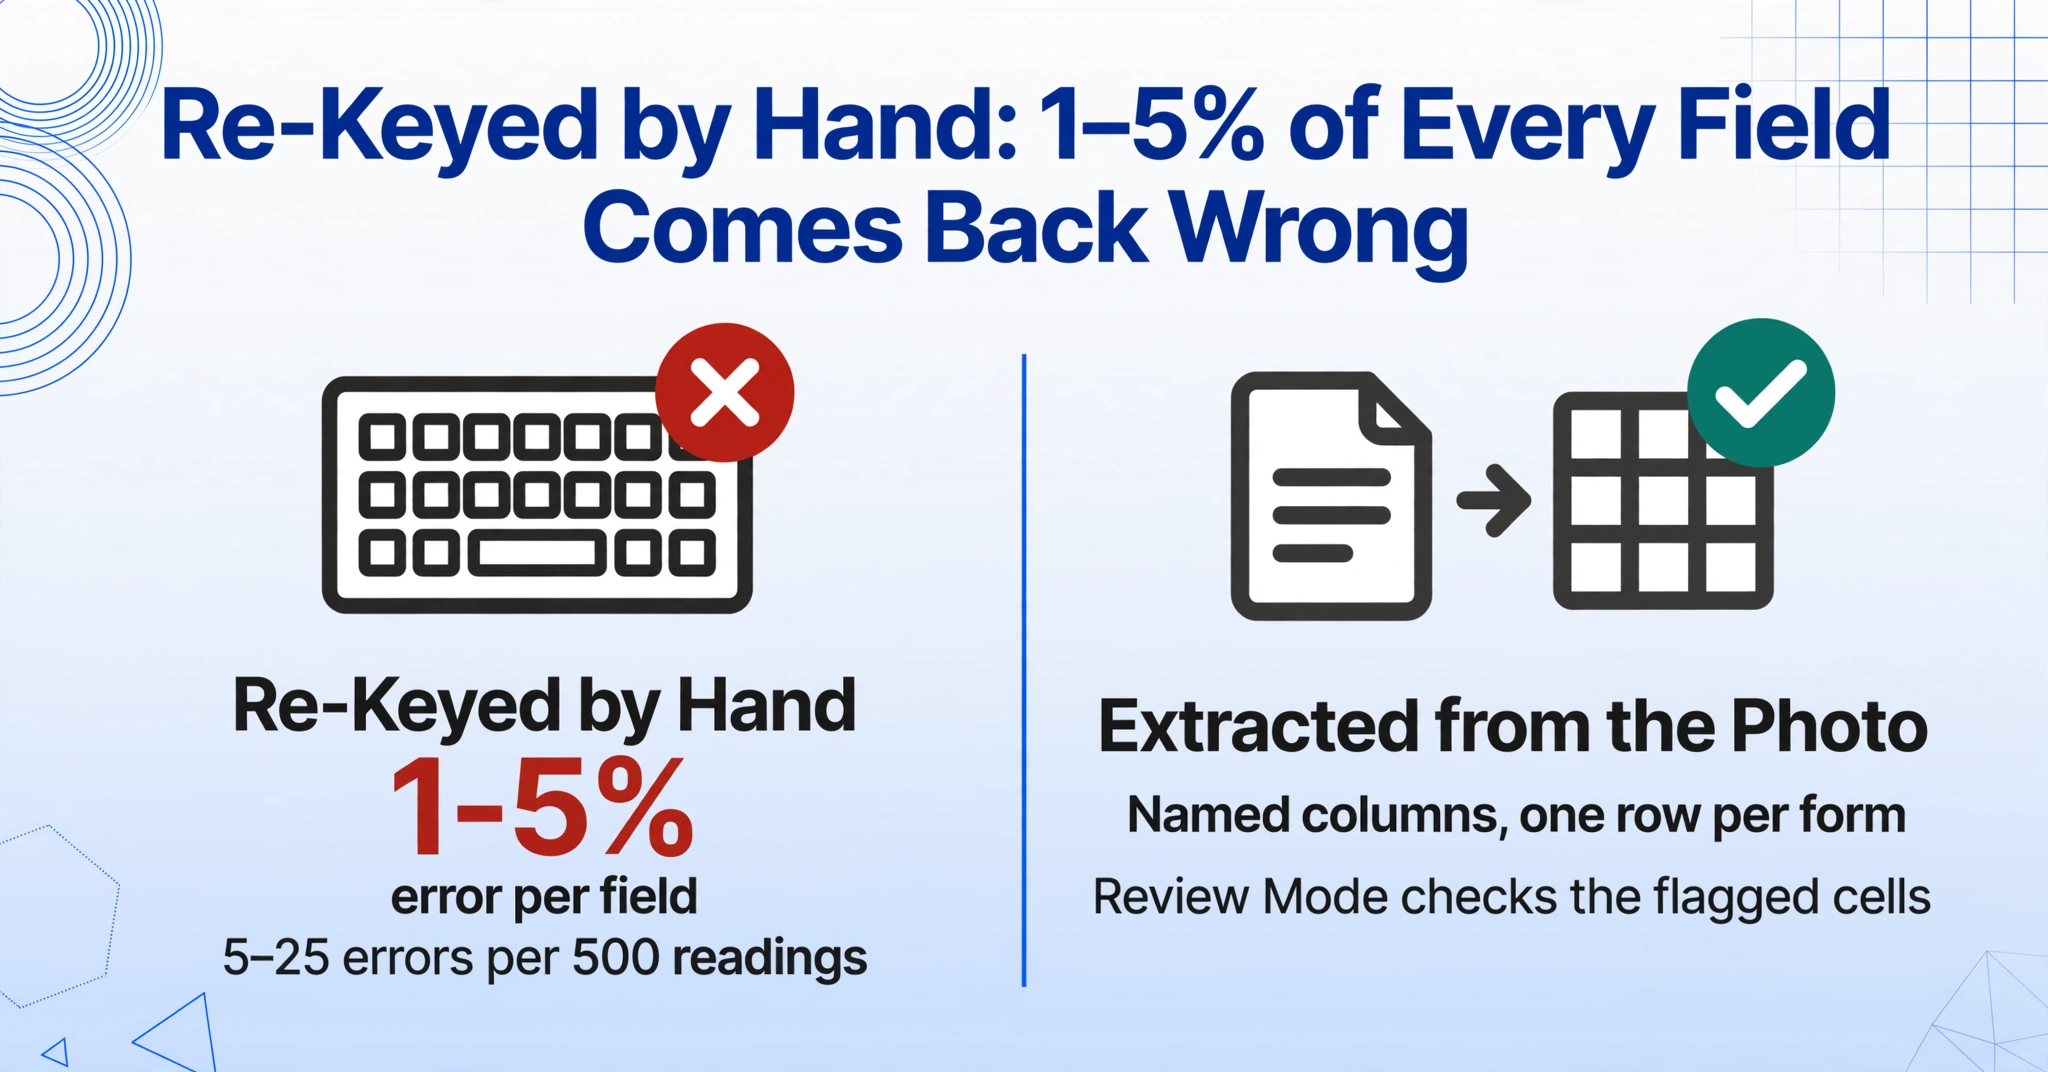
- Das manuelle Abtippen von Felddaten in Tabellenkalkulationen weist eine dokumentierte Fehlerquote von 1–5 % pro Feld auf und kostet ein staatliches Labor 10.000 manuelle Eingaben pro Monat.
- Schnelleres Tippen behebt das nicht – der Abtippschritt selbst ist der strukturelle Defekt, denn jede kopierte Zahl schafft einen Fehlerpunkt, den das ursprüngliche Feldformular nie hatte.
- Fotografieren Sie das Formular einmal und benennen Sie Ihre Spalten – die KI findet jeden Wert anhand seiner Bedeutung und füllt die Zeile, ohne dass jemand eine Tastatur berührt.
Das Formular ist bereits der Datensatz – die Tabelle ist das Problem
Das Feldformular ist kein Zwischenschritt. Es ist der primäre Datensatz dessen, was vor Ort passiert ist – und die Tabelle ist der Ort, an dem dieser Datensatz nutzbar wird. Die Lücke dazwischen ist reine, vermeidbare Arbeit.
Forscher, die für eine Studie von 2024 über landwirtschaftliche Datenerfassungspraktiken kleine und mittlere Betriebsleiter interviewten und die Ergebnisse am MIT veröffentlichten, haben festgehalten, wie leicht Feldaufzeichnungen außer Reichweite geraten: „Ob wir es aufgeschrieben haben oder ob man sich einfach daran erinnert, dass es in dieser Ecke des Feldes ein Weizenproblem gibt, dem man im Frühjahr Aufmerksamkeit schenken muss – und hoffentlich erinnert man sich, manchmal eben nicht.“ Das sind die Kosten von Papier: nicht das Papier selbst, sondern die Tatsache, dass die Information erst zu Daten wird, wenn jemand darauf reagiert – und das bedeutet, dass sie an einem durchsuchbaren Ort gespeichert werden muss.
Landwirte auf r/farming, die Aufzeichnungen führen, beschreiben genau diese Trennung zwischen Feld und Büro. Ein Thread über das Führen von Aufzeichnungen listet den typischen Stapel auf: „Tracking-Bögen für alle Geräte, Wartung, Aussaat-/Ernteergebnisse, Bodentests, Anbaupläne, Lieferscheine, Behälterinhalte“ – jeder davon ursprünglich handschriftlich. Das gleiche Muster zeigt sich im Umweltmonitoring, wo Feldtechniker Logbücher an Brunnen, Pegelstationen und Luftmessstationen ausfüllen, die niemand strukturiert neu erfasst.
Das ist keine isolierte Arbeitsablauf-Eigenheit. Das Virginia Tech Soil Testing Lab berichtet, dass in einem typischen März die Kundendaten für rund 10.000 Bodenproben von Hand eingegeben werden müssen – 10.000 Papierformulare, für ein einziges Landeslabor, in einem Monat. Das ist manuelle Transkription in institutionellem Maßstab, und genau dieser Schritt wird durch Extraktionssoftware ersetzt. Wir haben separat darüber geschrieben, wo die Felddaten-Pipeline tatsächlich bricht – dieser Leitfaden ist die Lösung dafür.
Warum der Abtipp-Schritt der Teil ist, den es zu entfernen gilt
Handschriftlich erfasste Felddaten weisen beim manuellen Abtippen eine dokumentierte Fehlerrate von etwa 1–5 % pro Feld auf – eine Zahl, die aus jahrzehntelanger Forschung zur menschlichen Faktoren zusammengestellt und in einem 2024 veröffentlichten Überblick über die betriebliche Dokumentation in Precision Agriculture zitiert wurde. Bei einer Probenahmerunde mit 500 Datenpunkten bedeutet das 5 bis 25 Fehler. Einige sind harmlos. Diejenigen, die zählen, sind die vertauschten Ziffern bei einem pH-Wert, die falsche Feld-ID bei einer Schädlingszählung oder ein Wasserstand, der in der Spalte des Nachbarn landet.
Drei regulatorische Rahmenwerke in den Vereinigten Staaten machen daraus nicht nur eine Frage der Effizienz, sondern eine Anforderung an die Dokumentation – und alle drei teilen eine Annahme: dass Feldaufzeichnungen genau, lesbar und abrufbar sind.
Alle drei Regeln führen zu derselben betrieblichen Schlussfolgerung: Der Datensatz muss in einer Form vorliegen, die durchsuchbar, prüfbar und übergebbar ist. Das ist eine Eigenschaft von Tabellenkalkulationen, nicht von Zwischenablagen.
Was aus einem Felddatenformular werden muss
Bevor Sie einen Extraktionsworkflow entwerfen, sollten Sie festlegen, welche Felder eines Feldformulars tatsächlich nachgelagerte Entscheidungen speisen. Ein Feldbegehungsbogen und ein Wasserqualitäts-Logbuch haben jeweils ihre eigenen hochwertigen Felder, und die Spalten, die Sie extrahieren, sollten zu den nachgelagerten Verwendungen passen – nicht zu jeder Zeile auf der Seite.
| Workflow | Hochwertige Felder | Wofür sie verwendet werden |
|---|---|---|
| Feldbegehung | Feld-ID, Kultur, Wachstumsstadium, Schädlingszählung, Unkrautdruck, Bodenfeuchte | Spritzempfehlungen, Schädlingsdrucktrends, Ernteplanung, Produktionsaufzeichnungen für die USDA-Ernteversicherung |
| Bodenprobenahme | Proben-ID, Feld-ID, Tiefe, Datum, Texturnotizen | Laboreinsendeformulare (wie der 10.000-pro-Monat-Rückstand des VT-Labors), Düngeplanung, Nährstoffmanagementpläne |
| Gewässerüberwachung | Stations-ID, Datum, Uhrzeit, Wasserstand, pH-Wert, Leitfähigkeit, Gelöster Sauerstoff | Compliance-Berichte, Qualitätssicherung/Qualitätskontrolle-Abgleich mit Feldprotokollen, Trendanalysen |
| Sicherheitsinspektionen (Feldbetrieb) | Inspektionsdatum, Standort, Inspektor, Befund, Korrekturmaßnahme | Prüfpfade, Nachverfolgung, Aufzeichnungen für behördliche Inspektionen |
Zwei Muster wiederholen sich in allen vier Fällen. Erstens sind die Identitätsfelder – Feld-ID, Stations-ID, Proben-ID, Standort – die Verknüpfungsschlüssel, mit denen Sie Datensätze sortieren, filtern und vergleichen können. Zweitens tragen die Messfelder Einheiten, die nachgelagert wichtig sind (pH-Wert hat keine Einheiten; Leitfähigkeit wird in µS/cm gemessen; der Wasserstand wird in Fuß oder Metern angegeben). Beide Muster leiten die Benennung Ihrer Extraktionsspalten.
Schritt 1: Erfassen Sie das Formular so, wie die KI es sehen muss
Machen Sie ein flaches, gut beleuchtetes Foto des gesamten Formulars – oder scannen Sie es, wenn ein Scanner in der Nähe ist. Die Qualität der Extraktion handschriftlicher Felddaten beginnt bei der Erfassung, und drei einfache Gewohnheiten machen den größten Unterschied zwischen einem sauberen ersten Versuch und einem frustrierenden aus.
Warum ist die Erfassungsqualität für die Extraktion so wichtig? Weil das Vision-Modell die Seite auf dieselbe Weise liest wie ein Mensch – wenn der Text auf dem Foto lesbar ist, kann er gelesen werden; wenn er ein weißer Fleck ist, kann kein Extraktionstool, egal wie gut, ihn wiederherstellen. Das richtige Foto zu machen, ist der einzige kostengünstigste Hebel für Genauigkeit im gesamten Arbeitsablauf.
Schritt 2: Benennen Sie die gewünschten Spalten
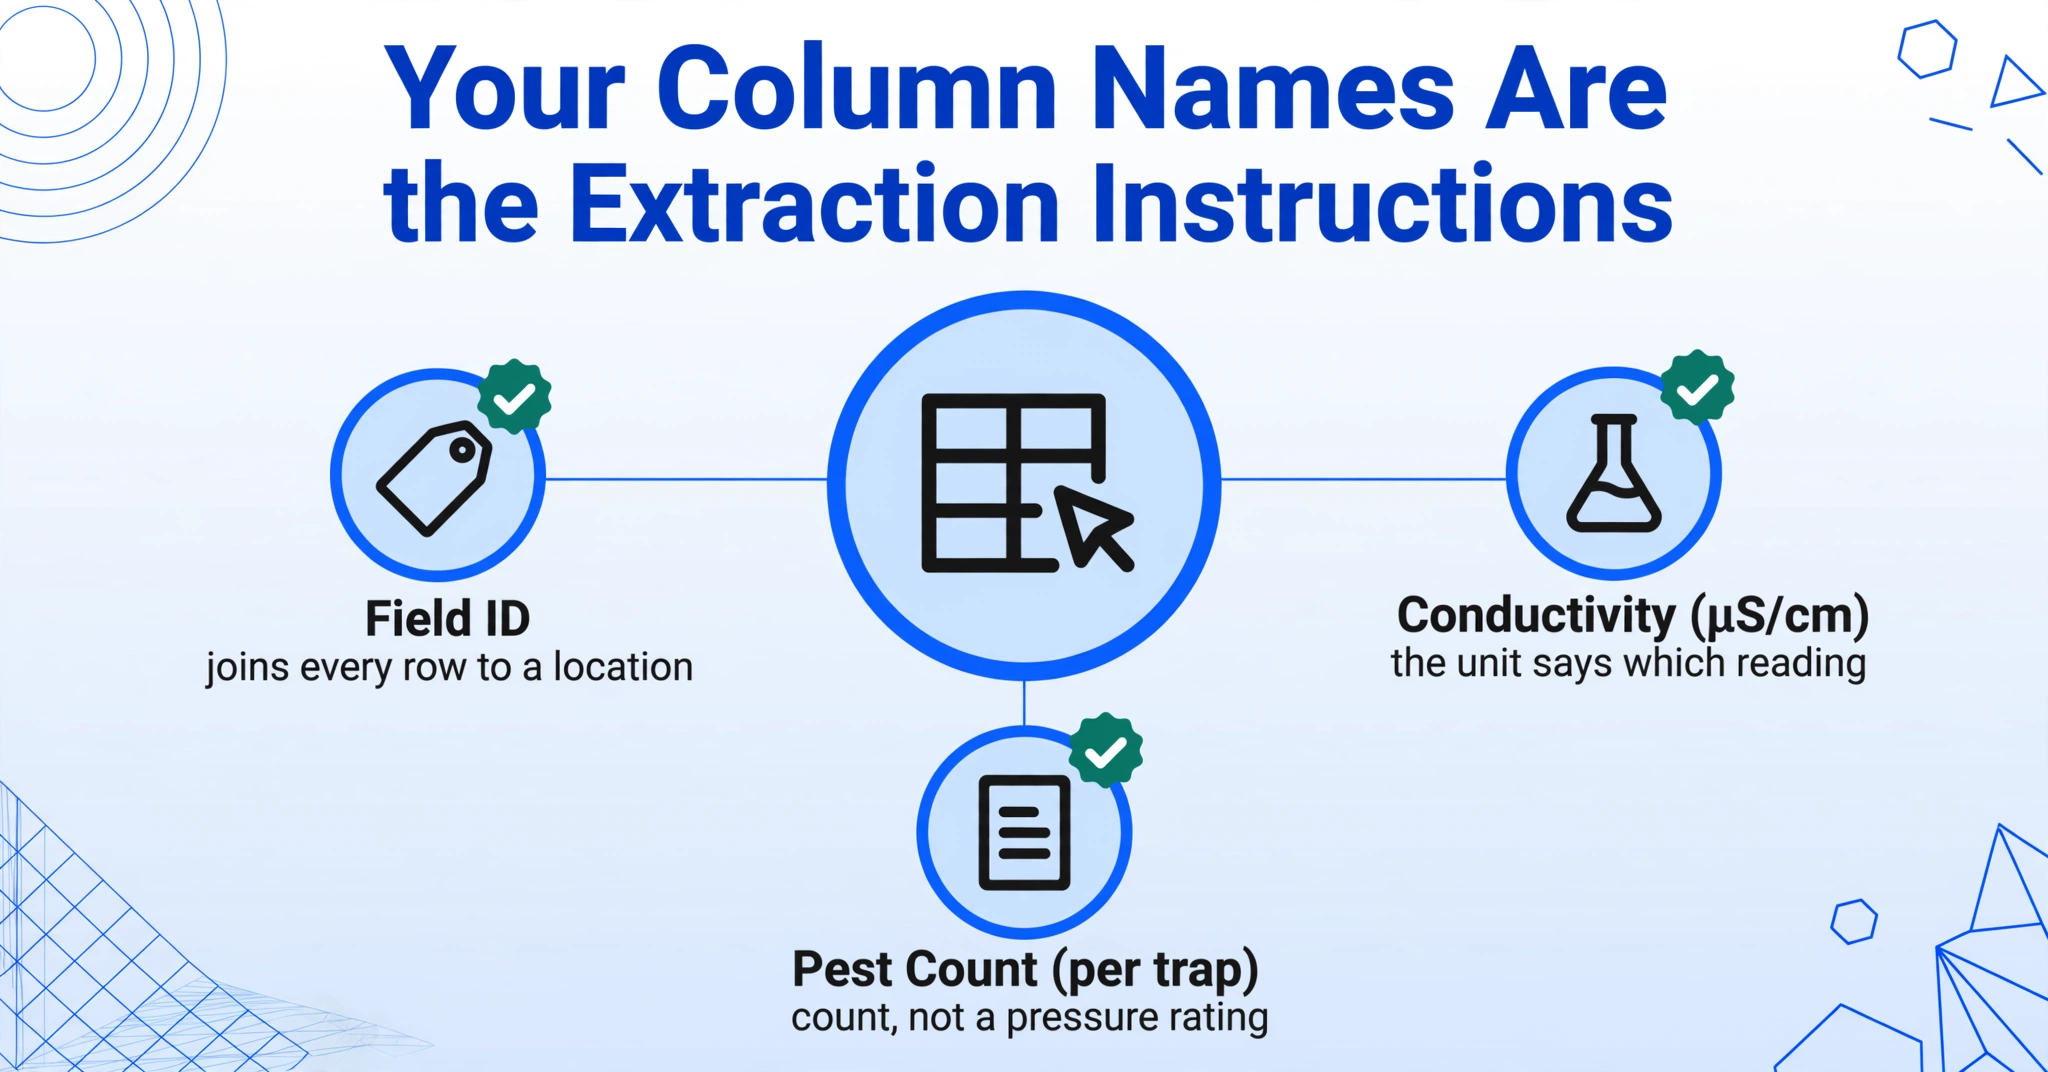
Geben Sie die Feldnamen ein, die Sie als Excel-Spalten wünschen – die KI findet jeden Wert anhand seiner Bedeutung, nicht anhand seiner Position auf der Seite. Dies ist der Mechanismus, den ImageToTable.ai als Benutzerdefinierte Spaltenextraktion bezeichnet: Sie definieren die Ausgabe („Schädlingszählung“, „pH-Wert“, „Stations-ID“), und die KI liest das Formular, findet den Wert, der zu jedem Spaltennamen passt, und füllt die Zeile. Dies unterscheidet sich grundlegend von der Template-OCR, bei der Sie ein Feld auf einem Referenzformular mit einem Rahmen umranden müssen und die dann fehlschlägt, wenn die Handschrift des nächsten Formulars außerhalb des Rahmens liegt.
Die Spaltenbenennung ist die Entscheidung mit der größten Hebelwirkung in diesem Arbeitsablauf – die von Ihnen eingegebenen Namen werden zu den Kopfzeilen der endgültigen Tabelle und zu den semantischen Anweisungen zum Auffinden jedes Werts. Gute Namen entsprechen der Beschriftung der Daten im Formular. Schwache Namen sind so mehrdeutig, dass die KI nicht erkennen kann, welchen von mehreren ähnlichen Werten Sie meinen:
| Formulartyp | Gute Spaltennamen | Warum sie funktionieren | Schwache Namen | Warum sie scheitern |
|---|---|---|---|---|
| Feldbegehung | Feld-ID, Kultur, Wachstumsstadium, Schädlingszählung (pro Falle), Unkrautdruck (Niedrig/Mittel/Hoch) | Entspricht den Beschriftungen des Formulars; Einheiten und Optionen im Namen lösen die Mehrdeutigkeit zwischen der Zählung und der Druckbewertung auf | Standort, Anzahl, Stadium | „Anzahl“ könnte Schädlingszählung, Pflanzenanzahl oder Fallenzählung bedeuten; „Stadium“ könnte Wachstumsstadium oder Probenahmestadium bedeuten |
| Wasserqualität | Stations-ID, Wasserstand (ft), pH-Wert, Leitfähigkeit (µS/cm), Gelöster Sauerstoff (mg/L) | Einheiten im Namen sagen der KI, zu welcher Spalte jeder Messwert gehört, und unterscheiden DO von BSB oder anderen Sauerstoffkennzahlen | Brunnen, Pegel, DO | „Pegel“ könnte Wasserstand oder Messlattenablesung bedeuten; „DO“ könnte Gelöster Sauerstoff oder Ausgabedatum bedeuten |
| Sicherheitsinspektion | Inspektionsdatum, Standort, Befund, Korrekturmaßnahme, Name des Inspektors | Feldbeschriftungen stimmen wörtlich mit dem Formular überein; jedes Feld ist einer nachgelagerten Verwendung zugeordnet | Datum, Problem, Name | „Problem“ könnte der Befund, das Datum oder eine Gerätenummer sein; „Name“ könnte der Inspektor oder ein Teammitglied sein |
Sie können die KI auch Werte ableiten lassen, die gar nicht auf dem Formular stehen. Eine abgeleitete Spalte wie Kategorie (Optionen: Chemisch / Biologisch / Physikalisch) weist die KI an, den Überwachungskontext zu lesen und jede Messung einer der aufgeführten Optionen zuzuordnen – ein einziger Durchgang, der sowohl extrahiert als auch kategorisiert, was nützlich ist, wenn Feldformulare Freitextnotizen statt Kontrollkästchen verwenden. Eine ausführlichere Erläuterung, wie die semantische Extraktion handschriftliche Formulare Feld für Feld verarbeitet, finden Sie in unserem Leitfaden zur Extraktion bestimmter Felder aus handschriftlichen Formularen. Wenn Sie zuerst das Muster Spaltenname → Tabellenblatt auf einen ähnlichen Dokumenttyp angewendet sehen möchten, zeigt der Workflow „Handschriftliches Formular zu Excel“ dieselbe Mechanik an einem einfacheren Beispiel.
Schritt 3: Stapelweises Hochladen – ein Formular, eine Zeile
Laden Sie die gesamte Runde an Formularen auf einmal hoch; jedes Formular wird zu einer Zeile in einer einzigen zusammengeführten Tabelle. Hier zahlt sich die Extraktion für die Feldarbeit aus, denn Felddaten kommen naturgemäß in Stapeln an – eine Begehungsrunde umfasst sechs Felder, ein Probenahmeereignis zwanzig Stationen, ein Inspektionstag ein ganzes Gelände. Sie einzeln zu verarbeiten würde den manuellen Engpass wiederherstellen, nur mit weniger Tastendrücken.
ImageToTable.ai ist Batch-First konzipiert: Sie laden mehrere Fotos oder Scans hoch, und die KI verarbeitet sie gemeinsam und führt die Ergebnisse in einer Excel-Datei zusammen – eine Zeile pro Formular, mit Ihren Spaltennamen als Kopfzeile. Eine Runde mit 40 Fotos von Wasserqualitäts-Logbüchern wird in einem einzigen Durchlauf zu 40 Zeilen in einem Blatt. Die Formulare müssen auch nicht gleich aussehen. Wenn Ihr Begehungsteam für jede Kultur ein anderes Blattlayout verwendet oder Ihre Probenahmestationen unterschiedliche Logbuchvorlagen haben, findet die KI dieselben benannten Felder dennoch in allen – genau das Szenario, an dem vorlagenbasierte Tools scheitern.
Für Teams, die die Formulare im Büro nie zu Gesicht bekommen, gibt es einen einfacheren Weg in die Pipeline: den Sammlungs-Link. Sie erstellen einen teilbaren Link, senden ihn an das Team, und jeder Feldarbeiter öffnet ihn, gibt einen kurzen Verifizierungscode ein und lädt seine Fotos direkt in Ihre Verarbeitungswarteschlange hoch – ohne Konto, ohne Anmeldung. Die Fotos landen in derselben Stapelwarteschlange wie alles andere. Wenn Ihr Team bereits Fotos oder Scans per E-Mail sendet, bietet die Funktion E-Mail-Posteingang Ihrem Konto eine dedizierte Adresse; das Weiterleiten von Anhängen an diese Adresse fügt sie automatisch zur Warteschlange hinzu. Beides sind Möglichkeiten, den Schritt „Formulare im Büro sammeln“ vollständig zu eliminieren.
Dateien werden sicher verarbeitet und nicht gespeichert.
Schritt 4: Prüfen, was die KI extrahiert hat (und wann Sie ihr vertrauen können)
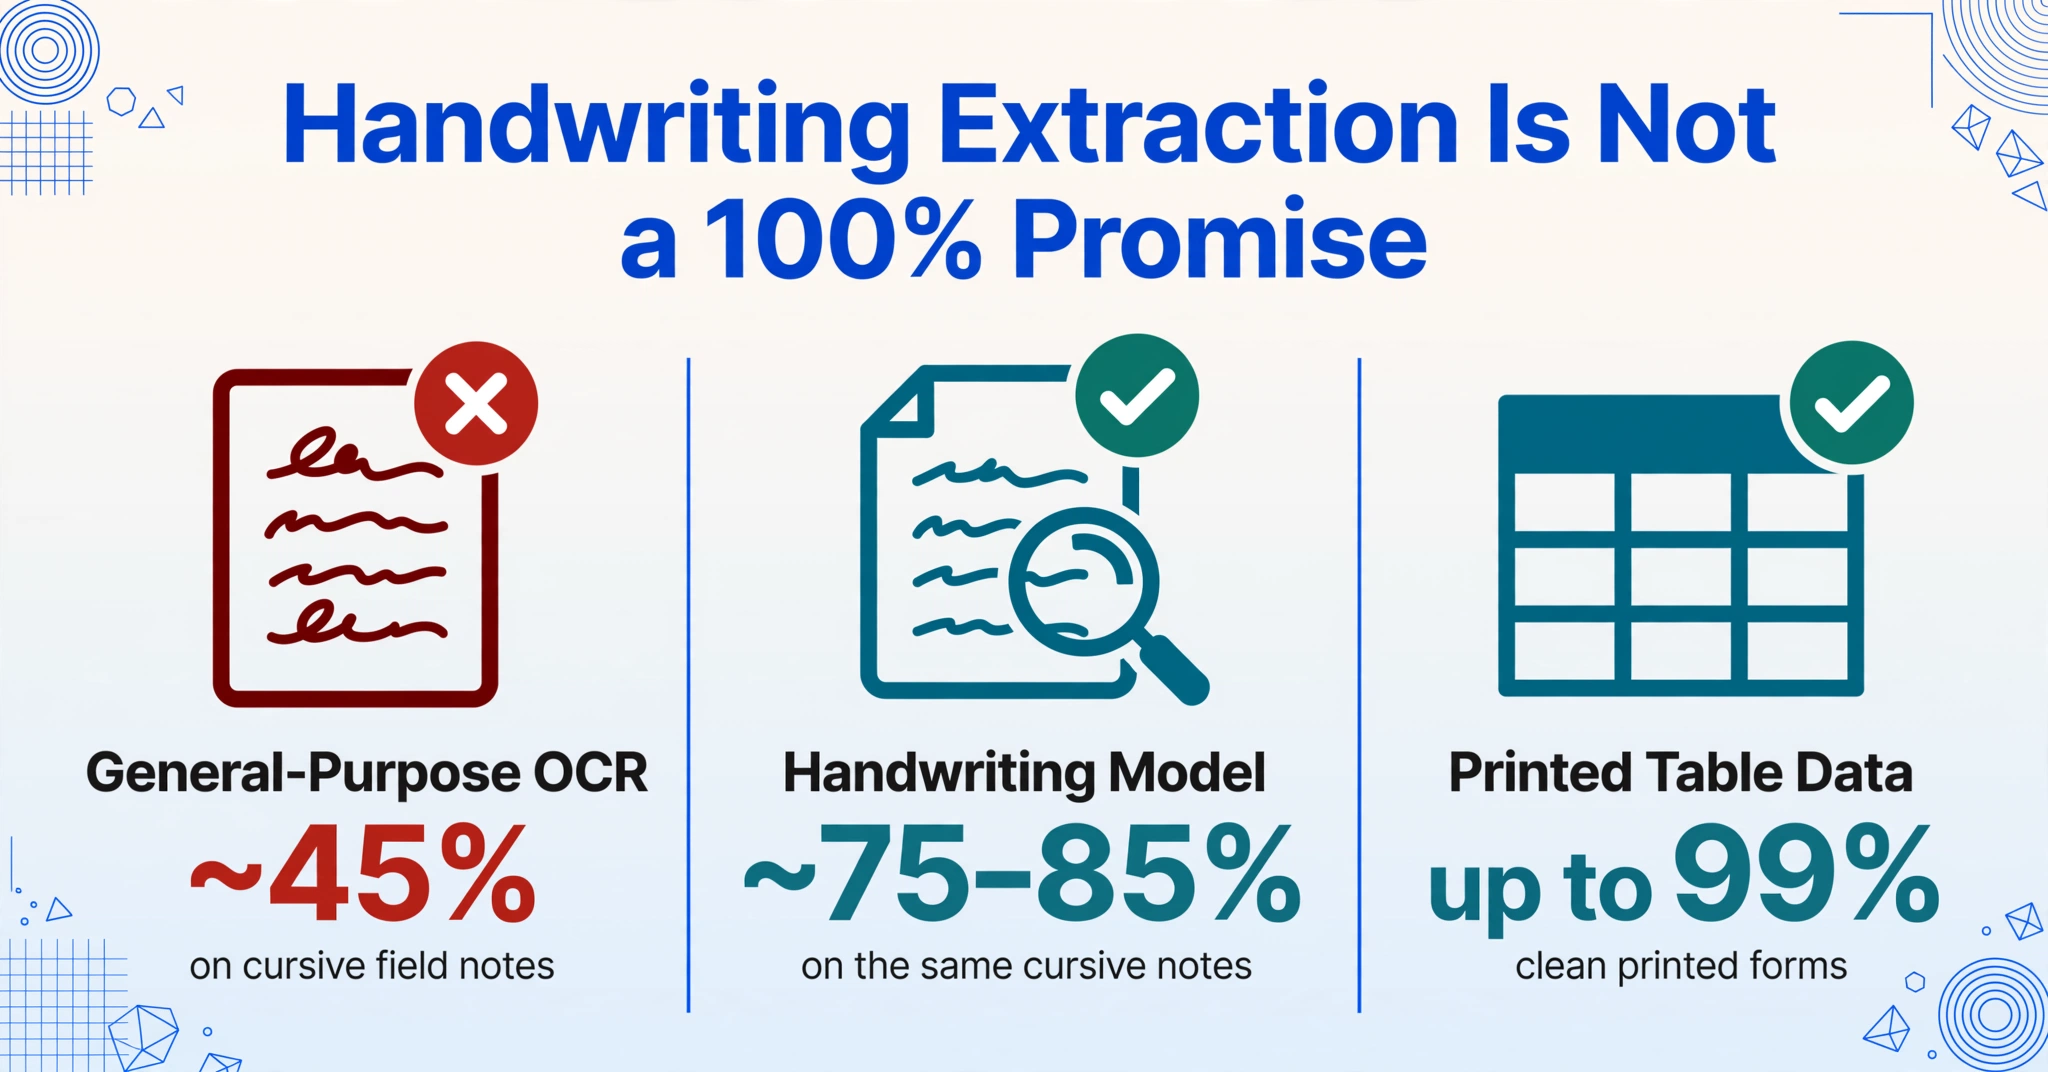
Vergleichen Sie die extrahierten Zeilen mit den Originalen – und wenn die KI eine Ablesung als unsicher markiert, prüfen Sie genau diese eine Zelle, nicht die ganze Seite. Handschriftenerkennung ist kein Versprechen von 100 % Genauigkeit, und jedes Tool, das das behauptet, ist nicht ehrlich. Unabhängige Tests mit unordentlicher Feldtechniker-Handschrift – dokumentiert von einem Team, das OCR an echten Inspektionsformularen testet – ergaben, dass die allgemeine OCR bei handschriftlichen Notizen in Schreibschrift auf etwa 45 % Genauigkeit abfällt, während spezialisierte Handschriftmodelle bei denselben Inhalten ca. 75–85 % erreichten. Lesbare Blockschrift wird deutlich besser extrahiert als hastige Schreibschrift; das ist eine Eigenschaft der Eingabe, nicht des Tools.
Was die Extraktion trotz dieser Grenze praktikabel macht, ist ein Verifizierungsablauf, der die menschliche Aufmerksamkeit genau dort bündelt, wo sie nötig ist. Der Prüfmodus von ImageToTable.ai mit Bounding-Box-gestützter Verifizierung macht genau das: Wenn Sie über eine extrahierte Zelle fahren, wird im Originalbild die genaue Stelle hervorgehoben, aus der der Wert stammt; klicken Sie auf eine Region im Bild, springt die Ansicht zur passenden Zelle. Sie lesen nicht mehr jede Zeile erneut – Sie prüfen die wenigen Ablesungen, bei denen die KI unsicher war, was Sekunden pro Formular dauert statt Minuten des Neuabtippens. Einen Wert bearbeitet? Ein Klick zeigt die ursprüngliche KI-Lesung und ermöglicht das Rückgängigmachen. Dieser Verifizierungsschritt ist auch genau der Punkt, an dem die Compliance-Geschichte von vorhin erfüllt wird: Die Bestätigung des Prüfers ist die menschliche Kontrolle, dass „genaue, lesbare und dauerhafte“ Aufzeichnungen tatsächlich genau sind.
Mehr darüber, was die Extraktionsqualität bei unordentlichen Außenformularen tatsächlich bestimmt – Stiftart, Fotobedingungen, Spaltenbenennung – finden Sie in unserem Genauigkeitsleitfaden für Feldinspektionsformulare, der dieselben Prinzipien ausführlich behandelt.
Schritt 5: Die Zeilen dort einsetzen, wo Ihr Workflow sie benötigt
Die extrahierte Tabelle ist nicht die Ziellinie — sie ist die Importdatei für das, was die Felddaten als Nächstes speisen. Der Sinn der früheren Schritte ist, dass die Ausgabe in einer Form ankommt, die Ihre bestehenden Systeme verarbeiten können: ein sauberes Blatt mit Kopfzeilen, eine Zeile pro Formular, keine überflüssigen Spalten. Das gleiche Fünf-Schritte-Muster — Erfassen, Spalten definieren, Batch, Prüfen, Weiterleiten — gilt auch für andere Feldaufzeichnungen, wie die Wartungsprotokolle, von denen wir gezeigt haben, wie man sie in einen funktionierenden PM-Plan verwandelt.
In der Landwirtschaft wird diese Tabelle in die Farmmanagementsysteme importiert, die die Teams bereits nutzen — Climate FieldView, John Deere Operations Center, Granular oder Trimble Ag Software — oder in ein einfaches Feldaktivitäts-Arbeitsbuch, wenn der Betrieb mit Excel arbeitet. Schädlingszählungen nach Feld und Datum werden zur Sprühentscheidungstabelle; Pflanztermine und Hektar nach Feld werden zum Rohmaterial für den Flächenbericht und die Produktionsaufzeichnungen der Ernteversicherung. Im Umweltbereich speisen dieselben Zeilen ein Umweltdatenmanagementsystem wie EQuIS oder einen GIS-basierten Erfassungsablauf wie Survey123 oder Fulcrum, wo Stations-IDs und Zeitstempel Messwerte ihren Überwachungspunkten zuordnen — und der Prüfpfad erfüllt die Anforderung der Eins-zu-eins-Entsprechung für die Qualitätssicherung/Qualitätskontrolle.
Zwei Spaltentypen machen die Tabelle nützlicher als rohe Werte. Eine berechnete Spalte lässt die KI während der Extraktion rechnen: Definieren Sie Überschreitung (pH-Wert > 8,5 ? "Ja" : "Nein") oder Gesamtschädlingszählung (Summe aller Fallen) als Spalte, und die Ausgabe enthält das Flag oder die Summe, nicht nur die einzelnen Messwerte. Das verlagert einen Nachbearbeitungsschritt in Excel in den Extraktionsdurchlauf selbst — nützlich, wenn auf eine Überschreitung noch am selben Tag reagiert werden muss, an dem das Wasser beprobt wird. Wenn Sie stattdessen das ursprüngliche Layout des Formulars erhalten möchten — ein ausgefülltes Formular, bereit zur Ablage — gibt der Modus „Nach Word“ die Seite als bearbeitbares Dokument mit intaktem Layout aus, was sich für Aufzeichnungen eignet, die in originalgetreuer Form eingereicht werden müssen.
FAQ
Wie genau ist die Extraktion bei handschriftlichen Feldformularen?
Lesbare Druckbuchstaben werden mit hoher Genauigkeit extrahiert – Daten aus gedruckten Tabellen erreichen bis zu 99 %. Schnelle Schreibschrift senkt das deutlich; unabhängige Tests mit unordentlichen Feldnotizen zeigen bei allgemeiner OCR etwa 45 % und bei spezialisierten Handschriftmodellen etwa 75–85 %. Die praktische Antwort ist der Verifizierungsschritt: Nur die Zellen markieren und prüfen, bei denen die KI unsicher ist, mit Bounding-Box-Hervorhebung gegen das Originalbild. Bei Feldformularen lohnt sich die Investition in die Aufnahmequalität (flach, gut beleuchtet, ganze Seite) – das ist der größte Hebel für die Genauigkeit.
Kann das Kontrollkästchen, eingekreiste Optionen und gemischten Text lesen?
Ja. Das Vision-Modell erkennt angehakte Kästchen, eingekreiste Optionen, Unterschriften und handschriftliche Werte, die mit gedrucktem Text gemischt sind. Für Felder, in denen Mitarbeiter eine Option einkreisen oder abhaken statt eine Zahl zu schreiben, definieren Sie die Spalte mit den ausgeschriebenen Optionen – Schädlingsdruck (Optionen: Niedrig / Mittel / Hoch) – damit die KI die Markierung dem richtigen Label zuordnet, statt sie als Text zu lesen.
Was passiert, wenn meine Feldbilder bei schlechtem Licht oder schräg aufgenommen werden?
Die Extraktion wird es trotzdem versuchen, aber die Qualität zählt: Schatten und Blendung verdecken Schrift, die ein Modell nicht erfinden kann. Der Dokument-Scanmodus des Telefons korrigiert die Perspektive und glättet die Seite, und das Beschatten der Seite mit dem eigenen Schatten behebt den häufigsten Outdoor-Fehler. Fotos, die für einen Menschen lesbar sind, sind in der Regel auch für das Modell lesbar; Fotos, die für einen Menschen ein weißer Fleck sind, sind auch für die KI ein weißer Fleck.
Mein Team verwendet unterschiedliche Formularlayouts pro Feld oder Station. Bricht das die Extraktion?
Nein – und genau das ist der Fall, der vorlagenbasierte Tools speziell scheitern lässt. Da die Benutzerdefinierte Spaltenextraktion Werte nach Bedeutung statt nach Koordinaten lokalisiert, kann ein Batch verschiedene Layouts mischen und trotzdem dieselben benannten Spalten zurückgeben. Eine Station mit einer anderen Logbuchvorlage in derselben Runde erzeugt einfach dieselbe Zeilenstruktur mit ihren ausgefüllten Werten.
Wie viele Formulare kann ich gleichzeitig verarbeiten?
Die Batch-Verarbeitung bewältigt mehrere Formulare in einem Durchlauf und führt sie in einer einzigen Excel-Datei zusammen – eine Zeile pro Formular. Die praktische Grenze hängt von der Batch-Kapazität Ihres Tarifs ab, aber das Designziel ist, dass eine gesamte Probenahmerunde oder ein Begehungstag in einem Durchgang verarbeitet wird, statt Formular für Formular.
Können Feldmitarbeiter Formulare senden, ohne den Büro-Workflow zu nutzen?
Ja, auf zwei Wegen. Ein Sammlungs-Link ermöglicht Teammitgliedern, eine URL zu öffnen, einen Verifizierungscode einzugeben und Fotos direkt in Ihre Warteschlange hochzuladen – ohne Anmeldung oder Konto. Alternativ bietet die E-Mail-Posteingang-Funktion eine dedizierte Adresse, an die Sie Scans oder Fotos weiterleiten können; mit aktivierter Auto-Verarbeitung beginnen eingehende Anhänge sofort mit der Extraktion, sobald sie eintreffen.
Das Formular war nie der Engpass – der Schritt des Abtippens war es. Behalten Sie die Klemmbretter und Logbücher, und lassen Sie die Extraktion dort stattfinden, wo die Daten bereits sind.
Wenn die Schädlingszählungen eines Feldbegehers noch am selben Nachmittag in der Tabelle landen, wartet die Sprühentscheidung nicht auf einen Ordner. Wenn ein Wasserqualitätswert vor dem Verlassen der Station als Überschreitung markiert wird, wird der Überwachungsplan proaktiv statt retrospektiv. Das ist die Veränderung, die die fünf Schritte oben bewirken: Die Felddaten sind nicht länger eine Aufzeichnung dessen, was passiert ist, sondern die Grundlage für das, was als Nächstes passiert. Testen Sie es mit Ihren eigenen Formularen – eine Runde, fünf Schritte, und sehen Sie, wie der Nachmittag aussieht, wenn das Tippen wegfällt.