So extrahieren Sie 1099-NEC- und 1099-MISC-Daten
für die Steuersaison in Excel
Die praktischen Kosten der manuellen 1099-Dateneingabe liegen nicht in den Stunden des Tippens – sondern in den Fehlern, die unentdeckt bleiben, bis Monate später eine CP2100-Mitteilung eintrifft, mit einem vorgeschlagenen Bußgeld von 340 $ pro nicht übereinstimmendem Formular. Eine einzelne vertauschte Ziffer in einer neunstelligen TIN oder ein falsch gelesener Dollar-Betrag auf einem handschriftlichen 1099-NEC fällt nicht während der Dateneingabe auf. Er fällt auf, wenn das IRS-Abgleichsystem ihn markiert, was eine B Notice und Hinterlegungseinbehalte von 24 % der Zahlungen auslöst.
Zu diesem Zeitpunkt vervielfacht der Zeitaufwand für die Fehlerbehebung – das Einholen eines korrigierten W-9, das Einreichen einer geänderten Steuererklärung und die Beantwortung der IRS-Korrespondenz – die ursprünglichen Eingabekosten um eine Größenordnung. Der Engpass bei der 1099-Verarbeitung ist nicht die Tippgeschwindigkeit. Es ist die Lücke zwischen der Eingabe von Daten und dem Wissen, ob diese Daten korrekt sind.
Wichtigste Erkenntnisse
- Das Eintippen von 200 1099-Formularen kostet 25 Stunden während der Steuersaison – und diese Stunden sind der günstigste Teil der manuellen Eingabe.
- Die Strafuhr für eine falsch getippte TIN startet in dem Moment, in dem Sie die Eingabetaste drücken – nicht wenn die IRS-Mitteilung eintrifft – und bis dahin trägt jedes unkorrigierte Formular Kosten von 340 $ plus obligatorische Hinterlegungseinbehalte von 24 %.
- Semantische KI, die Formularfelder anhand ihrer Bedeutung liest – nicht anhand ihrer Pixelposition – verarbeitet QuickBooks, Drake Tax und handschriftlich ausgefüllte 1099-Formulare in einem einzigen Batch und markiert nur die drei Zellen mit geringer Konfidenz, die es wert sind, aus Hunderten geprüft zu werden.
1099-NEC vs. 1099-MISC: Zwei Formulare, ein Datenproblem
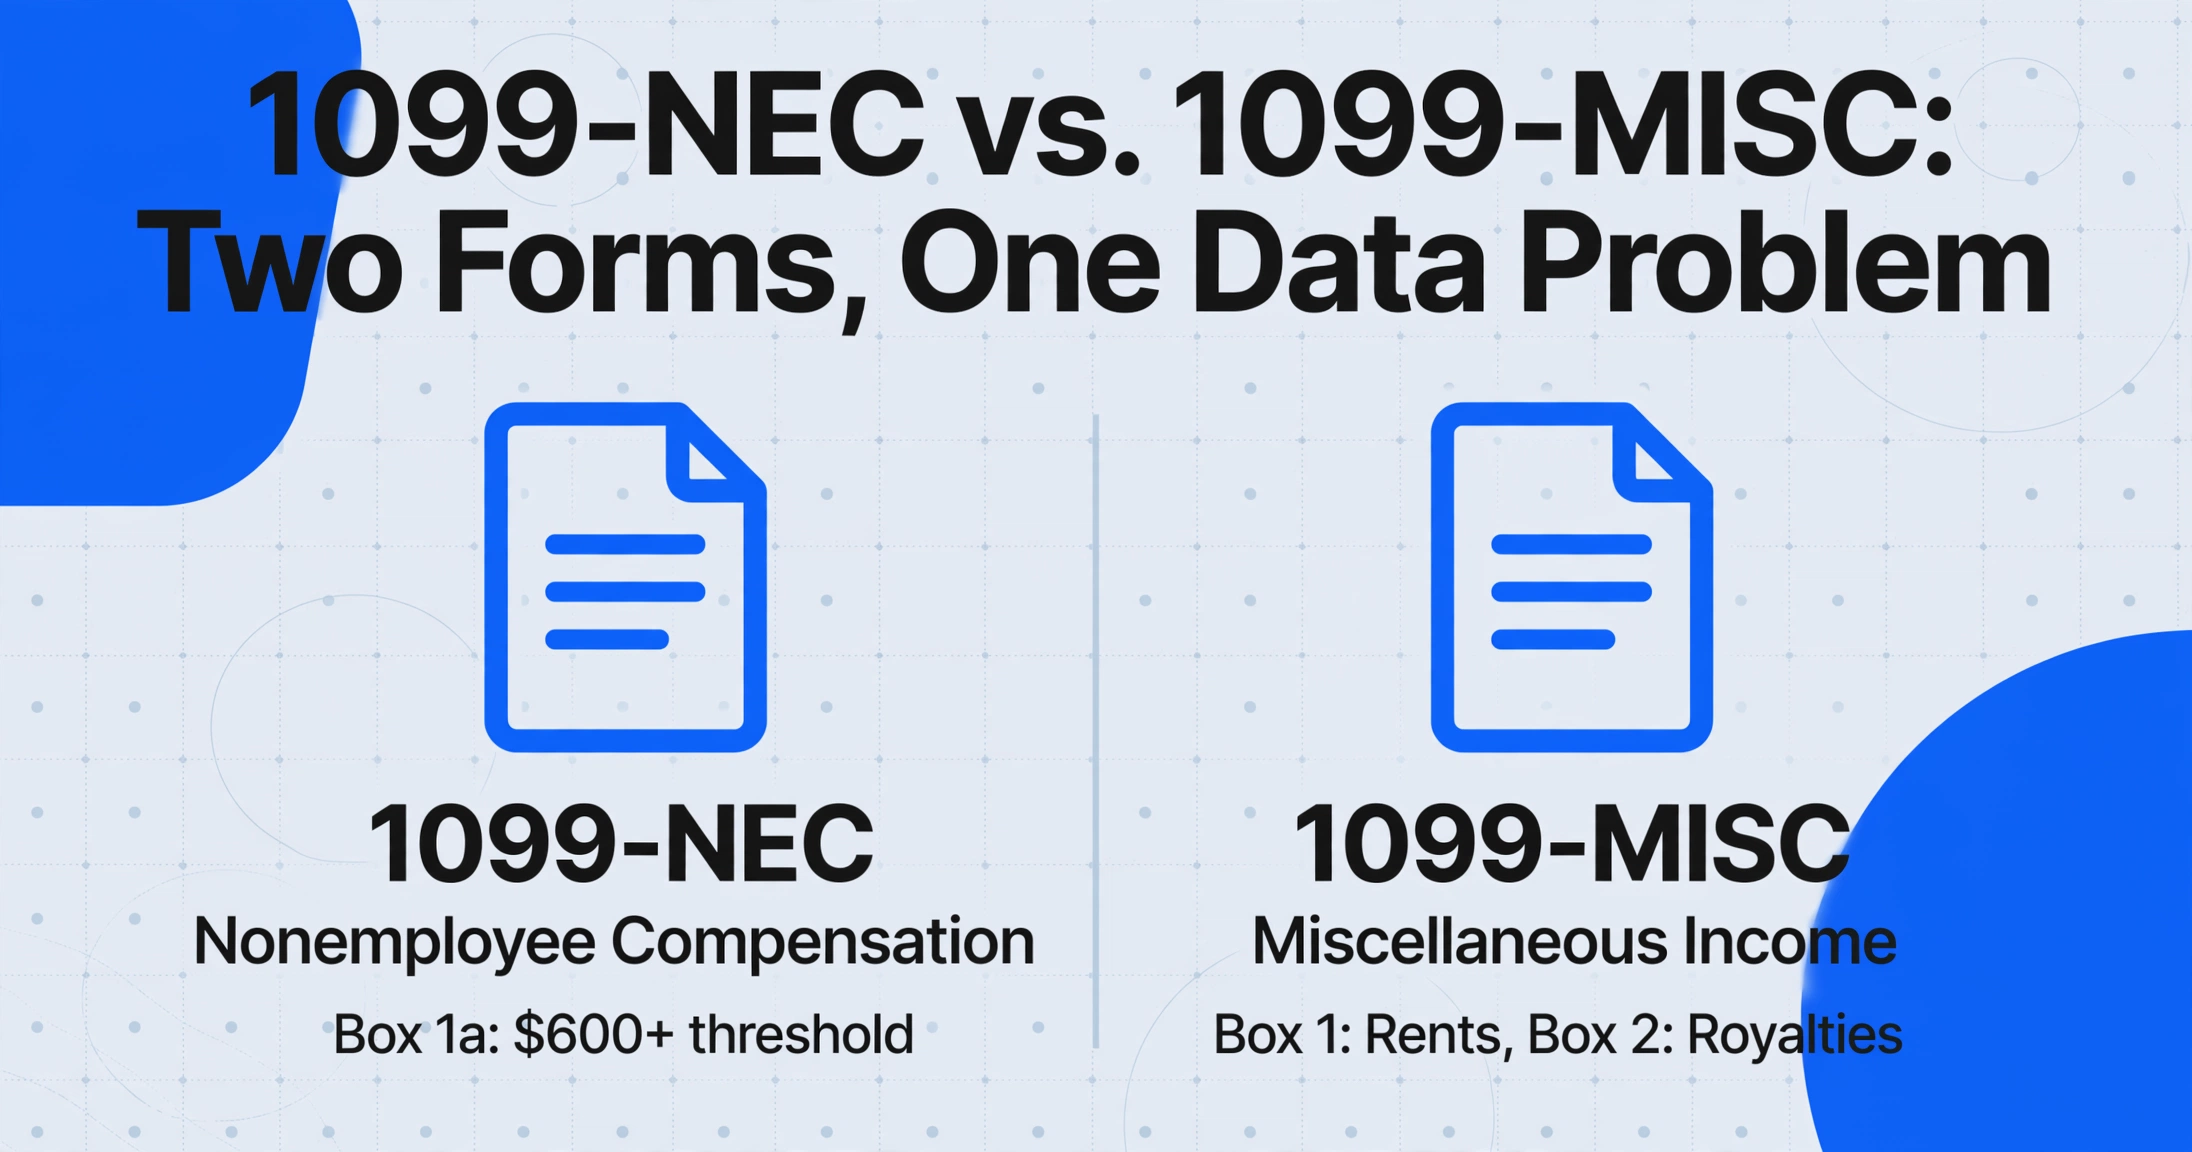
Vor dem Steuerjahr 2020 wurden sowohl nichtangestellte Vergütungen als auch sonstige Einkünfte auf einem einzigen Formular gemeldet – dem 1099-MISC. Der IRS führte Formular 1099-NEC (Nonemployee Compensation) ab dem Steuerjahr 2020 wieder ein, um die Verwirrung um die beiden Einreichungsfristen zu beseitigen, die Zahler jahrelang gestolpert hatte. Heute dienen die beiden Formulare unterschiedlichen Meldezwecken und haben unterschiedliche Feldanordnungen, doch ein typisches kleines Unternehmen oder eine Buchhaltungskanzlei erhält beide in derselben Steuersaison-Batch – oft für denselben Lieferanten.
Formular 1099-NEC meldet Zahlungen von 600 $ oder mehr an Nichtangestellte – unabhängige Auftragnehmer, Freiberufler, Berater, Gig-Worker – für Dienstleistungen, die im Rahmen eines Gewerbes oder Geschäfts erbracht wurden. Es ist das Formular, das kleinen Unternehmen und Einzelunternehmern am häufigsten begegnet. Sein Layout ist relativ kompakt: sieben nummerierte Felder (die Revision 2026 erweiterte es um Feld 1b für Trinkgelder in bar, Feld 1c für den Treasury Tipped Occupation Code und Feld 1d für Überstundenvergütung), wobei das Hauptfeld Feld 1a – Nonemployee Compensation – ist. Die Meldeschwelle stieg von 600 $ auf 2.000 $ für Zahlungen ab 2026, aber das Formular behält dieselbe Struktur mit den neuen Feldern bei.
Formular 1099-MISC (Miscellaneous Information) deckt alles ab, was das NEC nicht abdeckt: Mieten (Feld 1), Lizenzgebühren (Feld 2), sonstige Einkünfte (Feld 3), medizinische und Gesundheitszahlungen (Feld 6), Ernteversicherungserträge (Feld 9), Bruttoerlöse an Anwälte (Feld 10) und mehr – über achtzehn nummerierte Felder mit stark unterschiedlichen Meldeschwellen und Einreichungsregeln. Die offiziellen IRS-Anweisungen umfassen über 30 Seiten und legen fest, welche Zahlungsarten in welches Feld gehören.
Beide Formulare teilen dasselbe physische Format: Kopie A wird in OCR-lesbarer roter Tinte für IRS-Verarbeitungszentren gedruckt, während Kopie B (die Empfängerkopie) standardmäßige schwarze Tinte verwendet und das ist, was Praktiker am häufigsten scannen, fotografieren oder als PDF erhalten. Die rote Kopie A ist für Hochgeschwindigkeits-Produktionsscanner in IRS-Servicezentren konzipiert – nicht für einen Desktop-Scanner oder eine Handykamera. Dieser Unterschied ist wichtig, weil generische OCR-Tools, die versuchen, eine gescannte Kopie A zu lesen, oft Geistertext aus den gedruckten Feldbeschriftungen des Formulars gemischt mit den eingegebenen Daten zurückgeben, was eine verrauschtere Ausgabe erzeugt, als wenn sie von vornherein Kopie B verarbeitet hätten.
Was die manuelle 1099-Dateneingabe in der Steuersaison kostet
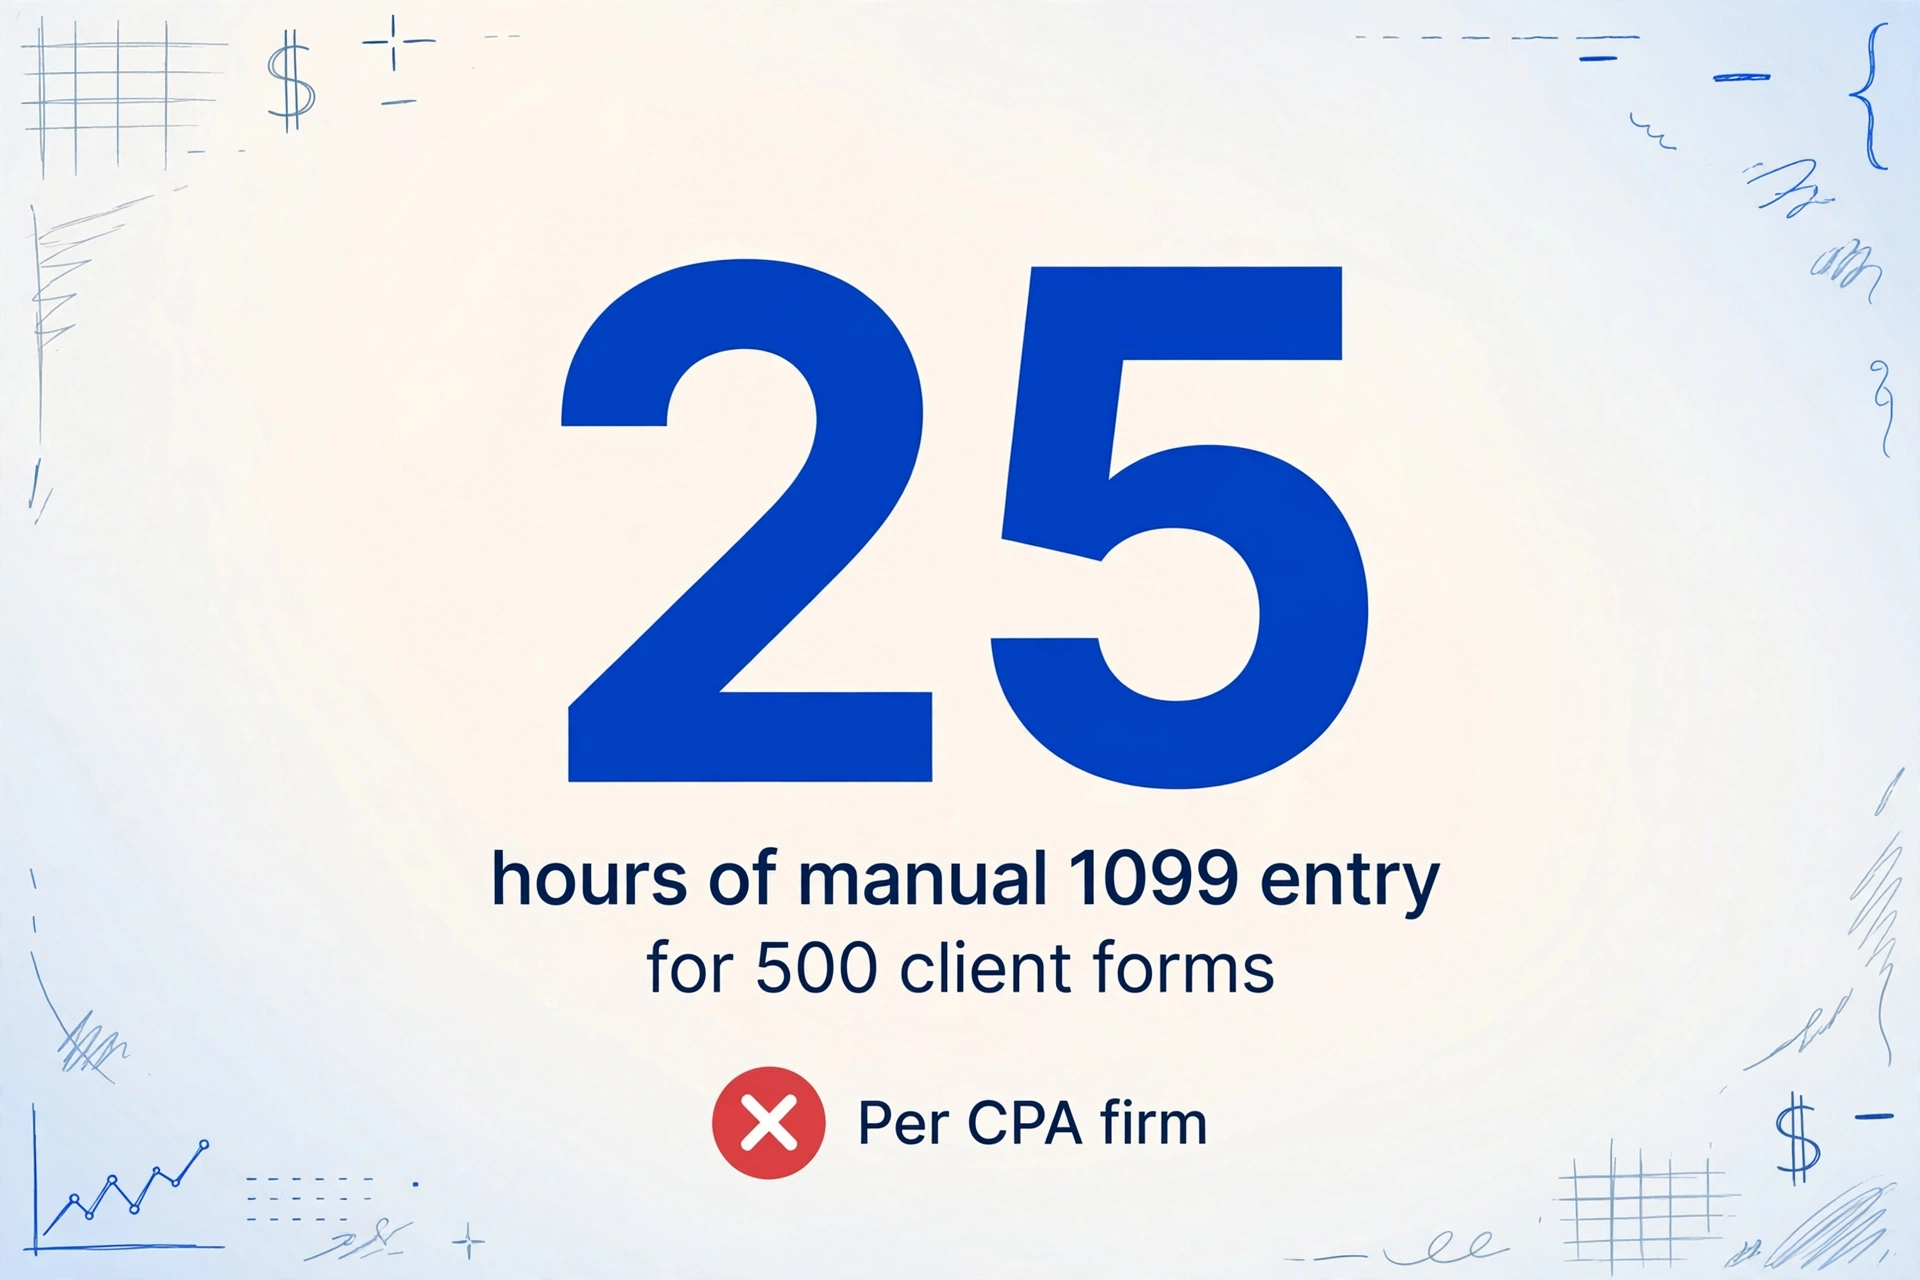
Ein einzelnes 1099-Formular enthält je nach Variante zwischen 12 und 25 Datenpunkte: Name und Adresse des Zahlers, TIN des Zahlers, Name und Adresse des Empfängers, TIN des Empfängers, Einkommensbeträge pro Feld, einbehaltene Bundessteuer und Details zur Einbehaltung auf Staatsebene. Bei durchschnittlich drei Minuten pro Formular für eine kompetente Datenerfassungskraft bedeutet ein Stapel von 200 1099-Formularen zehn Stunden ununterbrochenes Tippen. Für eine CPA-Kanzlei, die während der Steuersaison 500 Kunden-1099-Formulare verarbeitet, sind das 25 Stunden – mehr als drei volle Arbeitstage –, die ausschließlich für die Übertragung aufgewendet werden.
Aber die Zeit ist nicht der dominierende Kostenfaktor. Laut Xeros Accounting Report 2025 sind 80% der routinemäßigen Buchhaltungsaufgaben mit aktuellen KI-Tools automatisierbar, doch 46% der Buchhalter geben weiterhin an, KI-Tools täglich zu nutzen – das bedeutet, die anderen 54% verbringen den Großteil ihrer Zeit mit manueller Compliance-Arbeit. Eine Umfrage von Thomson Reuters ergab, dass die Standard-Steuererstellungszeit durch Automatisierung um 50–70% reduziert werden kann, aber die Branche sieht sich auch einem Talentmangel von 340.000 CPAs bis 2030 gegenüber, so die AICPA. Jede Stunde, die ein CPA damit verbringt, 1099-Feldwerte in eine Tabellenkalkulation zu tippen, ist eine Stunde, die nicht für Beratungsarbeit, Kundenbeziehungen oder komplexe Steuerstrategie aufgewendet wird – die Dienstleistungen, die eine Kanzlei differenzieren und Premium-Honorare rechtfertigen.
Das Strafrisiko fügt eine weitere Kostenschicht hinzu. Gemäß IRC Section 6721 löst die Einreichung einer 1099 mit einer falschen TIN Strafen aus, die von $60 pro Formular (innerhalb von 30 Tagen korrigiert) bis zu $340 pro Formular (nach dem 1. August unkorrigiert) eskalieren, wobei Strafen bei vorsätzlicher Missachtung bis zu $680 pro Formular erreichen. Eine CP2100-Mitteilung – die B Notice – kommt, wenn das IRS-Abgleichssystem eine Namens-/TIN-Diskrepanz kennzeichnet. In diesem Fall muss der Zahlungsverpflichtete mit dem Backup-Einbehalt von 24% auf alle zukünftigen Zahlungen an diesen Lieferanten beginnen, eine formelle Aufforderung zur korrigierten W-9 einleiten und eine geänderte Erklärung einreichen. Für eine Kanzlei, die Tausende von 1099-Formularen verarbeitet, bedeutet eine Fehlerquote von 2% beim TIN-Abgleich ein potenzielles Strafrisiko von Tausenden von Dollar, ganz zu schweigen von den administrativen Kosten für die Bearbeitung jeder Korrektur.
Wie ein Steuerfachmann in einem Praktikerforum postete: „Ich wurde CPA, um Unternehmen beim Wachstum und bei strategischen Entscheidungen zu helfen. Stattdessen verbringe ich 80% meiner Zeit mit Dateneingabe und grundlegender Compliance-Arbeit." Der Schmerzpunkt ist nicht, dass die Dateneingabe schwierig ist – es ist, dass sie Kapazitäten verbraucht, die für Arbeiten eingesetzt werden könnten, die tatsächlich das Fachwissen eines CPA erfordern.
Drei Gründe, warum die Extraktion von 1099-Daten knifflig ist
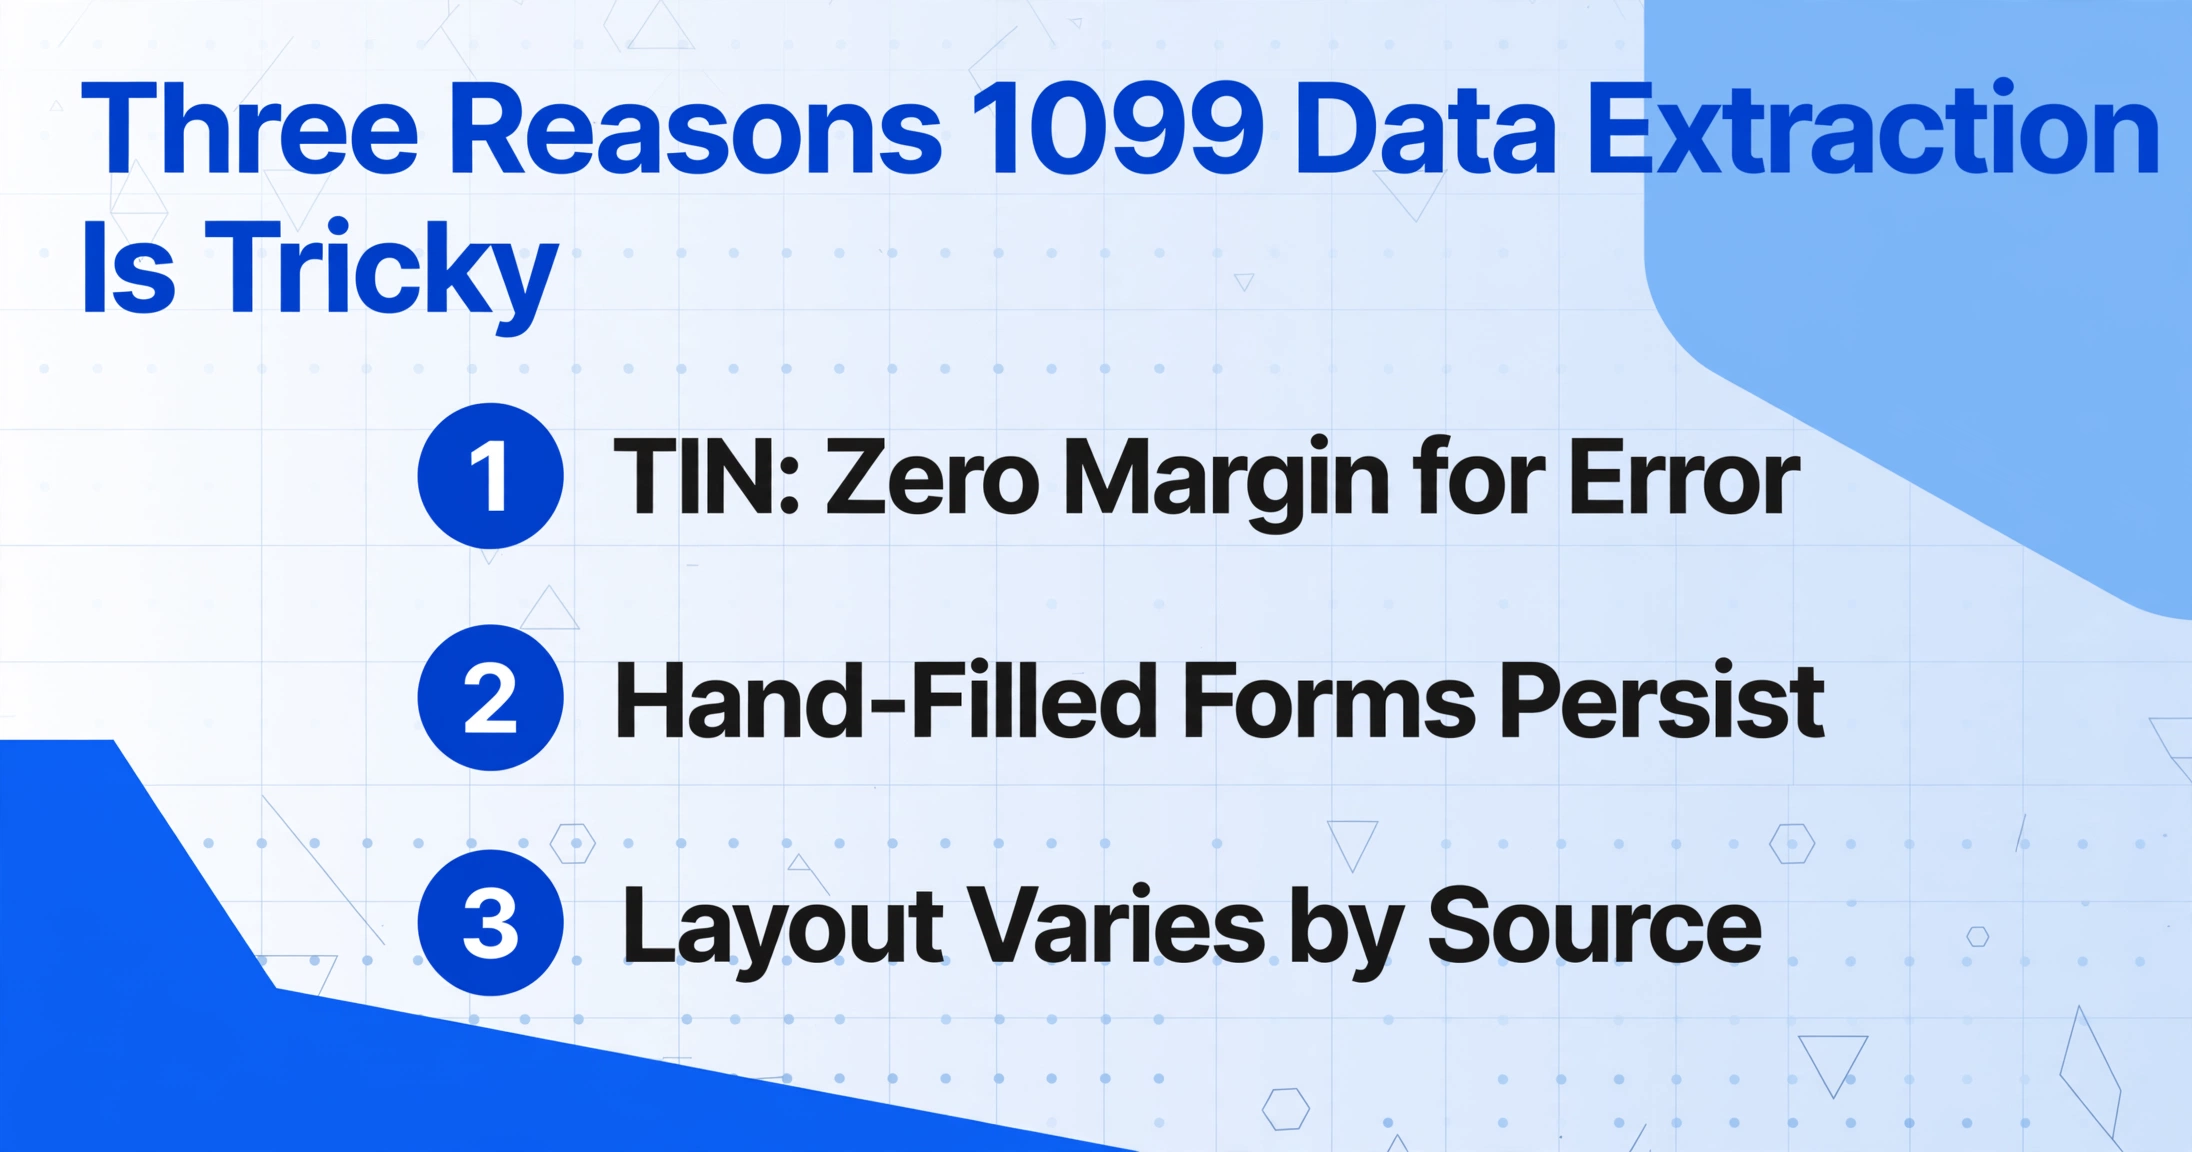
Die 1099-Extraktion stellt Herausforderungen dar, die generische OCR-Tools – und sogar einige formspezifische Extraktoren – nur schlecht bewältigen. Diese Problemstellen zu verstehen, ist wichtig, denn das richtige Tool muss sie gezielt adressieren, nicht nur mit „KI-gestützter Extraktion" werben.
1. Die 9-stellige TIN hat keine Fehlertoleranz. Anders als bei einem Dollarbetrag, bei dem eine Abweichung von ein paar Cent selten eine Rolle spielt, ist eine TIN entweder exakt korrekt oder funktional nutzlos. Eine vertauschte Ziffer in Feld 4 einer 1099-NEC (einbehaltene Bundessteuer) ist ein Datenfehler. Eine vertauschte Ziffer im TIN-Feld des Empfängers wird zu einer Namens-/TIN-Diskrepanz, die das IRS kennzeichnet. Menschliche Datenerfasser, die unter dem Druck der Steuersaison arbeiten, lesen handschriftliche 5er routinemäßig als S, 0er als O und 2er als Z – das klassische Zeichenverwechslungsmuster, das neunstellige Zahlenfelder verstärken. Selbst softwaregenerierte 1099-Formulare (von QuickBooks, Drake Tax, UltraTax oder ProSeries) erzeugen leicht unterschiedliche Schriftdarstellungen und Abstände für das TIN-Feld, was positionsbasierte OCR-Vorlagen über verschiedene Quellen hinweg unzuverlässig macht.
2. Handschriftliche 1099-Formulare sind bei kleinen Zahlern weiterhin üblich. Das IRS akzeptiert handschriftliche 1099-Formulare, sofern sie „vollständig lesbar und genau sind, um Verarbeitungsfehler zu vermeiden", und viele kleine Unternehmen – insbesondere solche, die nur eine Handvoll Auftragnehmerzahlungen pro Jahr abwickeln – füllen Formulare weiterhin von Hand oder mit der Schreibmaschine aus. Ein handschriftliches 1099-NEC bringt Erkennungsprobleme mit sich, für die herkömmliche OCR nicht ausgelegt war: variable Zeichenabstände, inkonsistenter Druck (helle vs. dunkle Tinte), durchgestrichene Einträge und Einträge, die leicht in angrenzende Felder hineinragen. Das IRS selbst warnt, dass „handschriftliche Formulare oft zu Namens-/TIN-Diskrepanzen führen". Für Extraktionstools liegt das Kernproblem nicht im Versagen der Zeichenerkennung auf einzelner Buchstabenebene – sondern darin, dass handschriftliche Zeichen an unvorhersehbaren Positionen innerhalb jedes Feldes sitzen und damit die räumlichen Annahmen zonenbasierter OCR brechen.
3. Formularvarianten und Layoutunterschiede zwischen Softwarequellen. Eine von QuickBooks erzeugte 1099-NEC layoutet die Zahler- und Empfängerblöcke anders als eine von Drake Tax oder Lacerte erzeugte. Die Breite des TIN-Feldes, der Abstand zwischen Zahler- und Zahlungsempfängerabschnitten und die Ausrichtung der Felder für einbehaltene Steuern auf Bundesstaatsebene variieren alle subtil zwischen den Softwarepaketen. Vorlagenbasierte Extraktionstools erfordern separate Zonendefinitionen für jede Softwarevariante – oder zumindest ein vorkonfiguriertes Modell pro Formulartyp. Wenn Sie eine gemischte Charge von 1099-NEC- und 1099-MISC-Formularen verarbeiten, die mit fünf verschiedenen Softwarepaketen erstellt wurden, wird ein Tool, das auf festen Zonenvorlagen basiert, Felder auf den Formularen übersehen, für die es nicht trainiert wurde.
Zur Einordnung: Ein Praktiker im r/taxpros-Subreddit merkte an, dass selbst eine einfache Steuererklärung mit einer einzigen 1099 1,5 bis 2 Stunden dauert, „aufgrund der Arbeitspapiere" – das heißt, die Extraktion selbst dauert Minuten, aber der umgebende Verifizierungs-, Querverweis- und Dokumentationsworkflow vervielfacht den Gesamtaufwand. Die Extraktionsgenauigkeit der Daten bestimmt direkt, wie viel dieser Verifizierungsarbeit automatisiert werden kann und wie viel von Hand erledigt werden muss.
Wie KI-gestützte Extraktion ohne Vorlage mit 1099-Formularen umgeht
Die oben beschriebenen Ansätze – TIN-Präzision, Handschrift-Toleranz, variantenübergreifende Layout-Anpassungsfähigkeit – laufen auf eine einzige Anforderung hinaus: Das Extraktionstool muss verstehen, was es liest, nicht nur, wo Text auf der Seite erscheint. Dies ist der Unterschied zwischen vorlagenbasierter OCR (auch Zonen-OCR genannt) und semantischer KI-Extraktion.
Vorlagenbasierte Tools gehen bei einem 1099-NEC wie folgt vor: „Suche Text bei etwa X Pixeln vom linken Rand und Y Pixeln vom oberen Rand – was dort steht, ist die TIN des Zahlers." Wurde das Formular von einer anderen Software erstellt, auf einer leicht verschobenen Seite gedruckt oder stammt es von einem gescannten, schiefen Exemplar, zeigt diese X/Y-Koordinate nicht mehr auf das richtige Feld. Die Ausgabe verschiebt sich still – oder das Tool liefert für dieses Feld gar nichts.
Benutzerdefinierte Spaltenextraktion – das zentrale Extraktionsparadigma von Tools wie ImageToTable.ai – kehrt diese Logik um. Statt zu definieren, wo Daten auf der Seite sind, definieren Sie, welche Daten Sie möchten, indem Sie die Felder benennen: „Name des Zahlers", „TIN des Empfängers", „Feld 1a – Nichtarbeitnehmervergütung", „Feld 4 – Einbehaltene Bundessteuer", „Feld 6 – Medizinische Zahlungen". Die KI liest das Dokument visuell – versteht die Struktur des Formulars, die Beziehung zwischen Beschriftungen und Werten, die Kastenlayouts – und lokalisiert jeden gewünschten Wert anhand seiner Bedeutung, nicht seiner Position. Eine „TIN des Empfängers" wird identifiziert, weil die KI die TIN-Beschriftung in der Nähe eines neunstelligen Zahlenfelds erkennt, unabhängig davon, ob diese Beschriftung oben links im Formular (wie bei einem 1099-NEC) oder im mittleren Bereich (wie bei einigen 1099-MISC-Varianten) sitzt.
Dieser Ansatz bewältigt die drei oben genannten Herausforderungen von Natur aus:
- TIN-Präzision: Die KI liest Zeichen im Kontext – wenn das Feld mit „TIN DES EMPFÄNGERS" beschriftet ist und der Wert eine neunstellige Zahl ist, validiert das Modell, dass die Ausgabe genau neun Zeichen umfasst, wodurch die Wahrscheinlichkeit einer verlorenen führenden Ziffer sinkt.
- Handschriftliche Formulare: Auf Handschrift trainierte Vision-Language-Modelle erkennen Zeichen anhand von Form und Kontext, nicht anhand der Position innerhalb eines festen Kastens – so wird eine handschriftliche 5, die eine Kastengrenze überschreitet, dennoch als 5 interpretiert und nicht auf zwei Felder aufgeteilt.
- Mehrere Variantenlayouts: Da die Extraktion semantisch ist (Beschriftung lesen, Wert finden), können ein 1099-NEC von QuickBooks und ein 1099-MISC von Drake Tax im selben Durchlauf mit denselben Spaltendefinitionen verarbeitet werden, ohne dass eine Konfiguration pro Vorlage erforderlich ist.
Im Gegensatz zur herkömmlichen OCR – die Bilder in Text umwandelt, diesen Text aber nicht in sinnvolle Felder organisiert – liefert die semantische KI-Extraktion strukturierte Ausgaben. Jeder Wert landet in der Spalte, unter der Sie ihn benannt haben, bereit für den Excel-Export, den Abgleich oder den Import in Steuervorbereitungssoftware.
Von 500 Papier-1099s zu einer Tabelle: Ein Workflow für die Steuersaison
Die 1099-Verarbeitung in der Steuersaison folgt einem vorhersehbaren Muster: Formulare treffen in Stapeln ein – per Post, per E-Mail als PDF- oder Bildanhänge, über Kundenportale oder als per Telefon aufgenommene Fotos. Das Volumen steigt Ende Januar stark an (wenn 1099-NEC-Formulare an die Empfänger ausgehändigt werden müssen) und hält bis März an, wenn 1099-MISC-Formulare eintreffen und Kunden ihre erhaltenen Formulare an ihren Steuerberater weiterleiten. Die Herausforderung besteht nicht darin, ein einzelnes Formular genau zu erfassen – sondern darin, diese Genauigkeit über Hunderte von Formularen hinweg beizubehalten, die in verschiedenen Formaten, zu verschiedenen Zeiten und aus verschiedenen Softwarequellen eintreffen.
Ein für diesen Workflow entwickeltes Tool verarbeitet Formulare Batch-First: Laden Sie 20, 50 oder 200 Formulare auf einmal hoch – gescannte PDFs, per E-Mail gesendete JPEGs, Handyfotos in einem ZIP-Ordner – und extrahieren Sie alle in einem einzigen Durchgang anhand derselben Spaltendefinition. Die Ausgabe ist eine konsolidierte Excel-Tabelle, in der jede Zeile ein 1099-Formular darstellt, mit Spalten für Name des Zahlers, TIN des Zahlers, TIN des Empfängers, Einkommensbeträge auf Box-Ebene, einbehaltene Bundessteuer und staatliche Einbehalte. Statt jedes Formular einzeln zu öffnen und Werte in eine Tabellenvorlage einzutippen, prüfen Sie eine einzige strukturierte Ausgabedatei – stichprobenartig kontrollieren Sie vom Tool markierte Werte mit geringer Konfidenz, anstatt jedes Feld erneut einzugeben.
Der praktische Unterschied für eine kleine Buchhaltungskanzlei: Ein Stapel von 150 1099-NEC- und 1099-MISC-Formularen, der etwa 7,5 Stunden manuelle Dateneingabe erfordern würde (bei 3 Minuten pro Formular), kann in etwa 10–15 Minuten Bearbeitungszeit hochgeladen, extrahiert und nach Excel exportiert werden – die restliche Zeit entfällt auf die KI-Verarbeitung, während der der Praktiker an anderen Aufgaben arbeiten kann.
ImageToTable.ai bietet bereits eine 1099-zu-Excel-Konvertierungsseite, die alle 1099-Varianten verarbeitet – NEC, MISC, INT, DIV und andere – und mehrere Varianten in einer einzigen strukturierten Tabelle konsolidiert. Die zugrunde liegende Extraktion ist identisch mit der oben beschriebenen: Sie benennen die benötigten Spalten, laden Ihren Stapel hoch, und die KI liefert eine strukturierte Tabelle mit einer Zeile pro Formular zurück.
Dateien werden sicher verarbeitet und nicht gespeichert.
Für Unternehmen, die auch Rechnungen, Belege oder andere Finanzdokumente verarbeiten, funktioniert derselbe Stapelverarbeitungs-Workflow ohne Code oder Integrationsaufwand – einfach hochladen, Spalten benennen und exportieren. Der vorlagenfreie Ansatz bedeutet, dass die KI sich an neue 1099-Varianten oder Layoutänderungen (wie bei den 2026er-Revisionen) anpasst, ohne dass Sie Vorlagen aktualisieren müssen.
Häufig gestellte Fragen
Kann KI Daten aus handschriftlichen 1099-Formularen extrahieren?
Ja, aber mit Einschränkungen. Vision-Language-Modelle lesen handschriftliche Einträge, einschließlich typischer Zeichenverwechslungen bei TINs (5 vs. S, 0 vs. O, 2 vs. Z). Allerdings ist die Genauigkeit bei handschriftlichen 1099-Formularen geringer als bei softwaregenerierten, insbesondere bei Empfänger-TINs, wo ein einziger falscher Ziffer das gesamte Feld ungültig macht. Die meisten Extraktionstools liefern Konfidenzwerte pro Feld, sodass Sie nur unsichere Zellen prüfen müssen, statt alle Werte neu einzugeben. Bei vielen handschriftlichen 1099-Formularen sollten Sie zusätzliche Prüfzeit für TIN-Felder einplanen.
Funktioniert die 1099-Extraktion mit allen Varianten?
Ja. Die semantische KI-Extraktion verarbeitet alle gängigen 1099-Varianten – NEC, MISC, INT, DIV, B, R, K, G, S und andere – ohne Konfiguration pro Formulartyp. Da die KI Formularfelder durch Lesen von Bezeichnungen und Kontextverständnis identifiziert, werden „Box 1" auf einem 1099-NEC (Nonemployee Compensation) und „Box 1" auf einem 1099-MISC (Mieten) automatisch den richtigen Spalten zugeordnet. Gemischte Stapel mit mehreren 1099-Varianten werden ohne Vorsortierung gemeinsam verarbeitet.
Wie genau ist die KI-1099-Extraktion im Vergleich zur manuellen Eingabe?
Branchendaten zeigen, dass die automatisierte Extraktion bei gedruckten, softwaregenerierten Formularen eine Zeichengenauigkeit von über 99,9 % erreicht, gegenüber 96–99 % bei manueller Eingabe (wobei sich die Fehlerrate über Dutzende Felder pro Formular summiert). Aussagekräftiger ist der Vergleich auf Feldebene: Ein einziger TIN-Fehler, der die menschliche Prüfung passiert, verursacht Strafkosten von 60–340 $. Extraktionstools mit Konfidenzbewertung ermöglichen es Ihnen, nur die unsicheren Werte zu prüfen, statt jedes Feld neu einzugeben – das fängt potenzielle TIN-Fehler ab, bevor sie eine Strafe auslösen.
Kann ich 1099-Formulare aus verschiedenen Softwarequellen in einem Batch verarbeiten?
Ja – und hier liegt der klare Vorteil der vorlagenfreien Extraktion gegenüber vorlagenbasierten Tools. Ein Batch mit 1099-NEC-Formularen aus QuickBooks, Drake Tax, UltraTax und handschriftlich ausgefüllten Formularen kann gemeinsam hochgeladen und mit denselben Spaltendefinitionen verarbeitet werden. Die KI erkennt jede Formularvariante eigenständig und leitet jedes Feld in die richtige Spalte – das Sortieren der Formulare nach Quelle vor der Verarbeitung entfällt.
Erfüllt die KI-Extraktion die IRS-Anforderungen an die digitale Aufbewahrung?
Die KI-Extraktion erzeugt strukturierte digitale Aufzeichnungen (Excel, CSV oder JSON), die den elektronischen Aufbewahrungsstandards des IRS gemäß Revenue Procedure 97-22 und den aktuellen IRS-Anforderungen an digitale Aufzeichnungen entsprechen. Die wesentliche Anforderung ist, dass die digitalen Aufzeichnungen korrekt, vollständig und auf Anfrage reproduzierbar sind – all dies wird durch einen gut strukturierten Export aus einem Extraktionstool erfüllt. Bewahren Sie die ursprünglichen gescannten 1099-Bilder zusammen mit den extrahierten Daten als Quelldokumentation auf, gemäß den üblichen US-amerikanischen Richtlinien zur Aufbewahrung von Steuerunterlagen (in der Regel 3–7 Jahre, je nach Art der Steuererklärung).