Comment extraire les données 1099-NEC et 1099-MISC
dans Excel pour la saison des impôts
Le coût réel de la saisie manuelle des données 1099 ne réside pas dans les heures passées à taper — mais dans les erreurs qui passent inaperçues jusqu'à l'arrivée d'un avis CP2100, des mois plus tard, avec une pénalité proposée de 340 $ par formulaire non conforme. Un seul chiffre inversé dans un TIN à neuf chiffres ou un montant mal lu sur un 1099-NEC manuscrit ne se révèle pas lors de la saisie. Il se révèle lorsque le système de correspondance de l'IRS le signale, déclenchant un avis B et des obligations de retenue à la source de 24 % des paiements.
À ce stade, le temps consacré à corriger l'erreur — collecter un W-9 corrigé, déposer une déclaration modifiée et répondre à la correspondance de l'IRS — multiplie le coût initial de la saisie par un ordre de grandeur. Le goulot d'étranglement dans le traitement des 1099 n'est pas la vitesse de frappe. C'est l'écart entre la saisie des données et la certitude que ces données sont correctes.
Points clés à retenir
- Saisir 200 formulaires 1099 consomme 25 heures pendant la saison des impôts — et ces heures sont la partie la moins coûteuse de la saisie manuelle.
- Le compte à rebours des pénalités pour un TIN mal saisi commence au moment où vous appuyez sur Entrée — pas à la réception de l'avis de l'IRS — et à ce moment-là, chaque formulaire non corrigé entraîne un coût de 340 $ plus une retenue à la source obligatoire de 24 %.
- L'IA sémantique qui lit les champs des formulaires selon leur signification — et non selon leur position en pixels — traite les formulaires QuickBooks, Drake Tax et les 1099 remplis à la main en un seul lot et ne signale que les trois cellules à faible confiance à vérifier sur des centaines.
1099-NEC vs. 1099-MISC : deux formulaires, un même problème de données
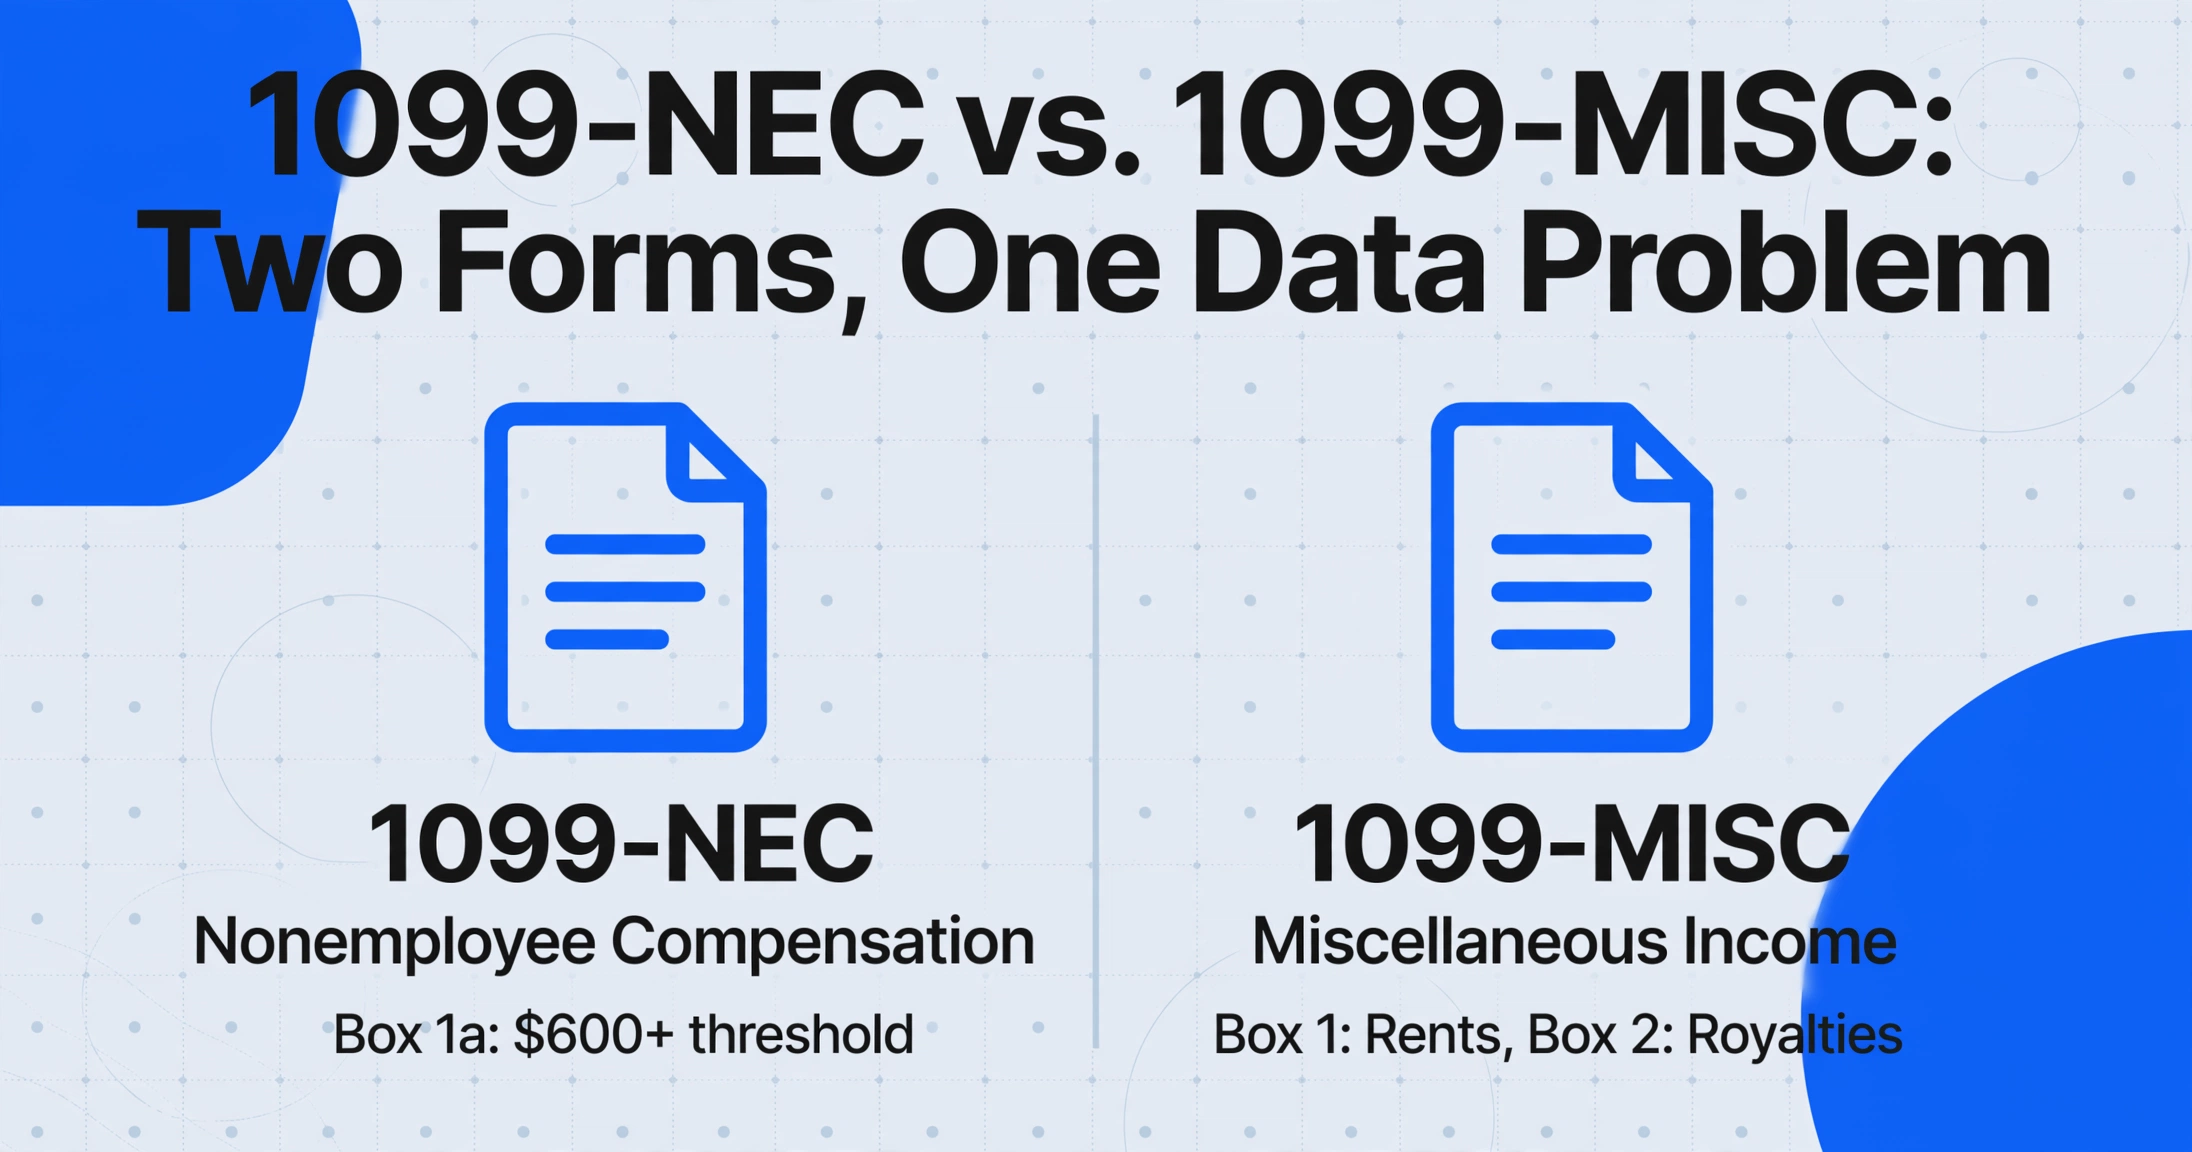
Avant l'année d'imposition 2020, la rémunération des non-employés et les revenus divers étaient déclarés sur un seul formulaire — le 1099-MISC. L'IRS a réintroduit le formulaire 1099-NEC (rémunération des non-employés) à compter de l'année d'imposition 2020 afin d'éliminer la confusion entre les deux dates limites de dépôt, qui avait piégé les déclarants pendant des années. Aujourd'hui, les deux formulaires servent des objectifs de déclaration distincts et comportent des dispositions de cases différentes, mais une petite entreprise ou un cabinet comptable typique reçoit les deux dans le même lot de la saison fiscale — souvent pour le même fournisseur.
Le formulaire 1099-NEC déclare les paiements de 600 $ ou plus versés à des non-employés — entrepreneurs indépendants, freelances, consultants, travailleurs à la demande — pour des services rendus dans le cadre d'une activité commerciale ou professionnelle. C'est le formulaire le plus couramment rencontré par les petites entreprises et les entreprises individuelles. Sa structure est relativement compacte : sept cases numérotées (la révision 2026 l'a élargi pour inclure la case 1b pour les pourboires en espèces, la case 1c pour le code de profession à pourboires du Trésor, et la case 1d pour la rémunération des heures supplémentaires), le champ principal étant la case 1a — Rémunération des non-employés. Le seuil de déclaration est passé de 600 $ à 2 000 $ pour les paiements effectués à compter de 2026, mais le formulaire conserve la même structure avec les nouvelles cases ajoutées.
Le formulaire 1099-MISC (Informations diverses) couvre tout ce que le NEC ne couvre pas : loyers (case 1), redevances (case 2), autres paiements de revenus (case 3), paiements médicaux et de soins de santé (case 6), produits d'assurance-récolte (case 9), produit brut versé aux avocats (case 10), et plus encore — couvrant dix-huit cases numérotées avec des seuils de déclaration et des règles de dépôt très variables. Ses instructions officielles de l'IRS s'étendent sur plus de 30 pages détaillant quels types de paiements vont dans quelle case.
Les deux formulaires partagent le même format physique : la copie A est imprimée en encre rouge lisible par OCR pour les centres de traitement de l'IRS, tandis que la copie B (la copie du destinataire) utilise une encre noire standard et est ce que les praticiens scannent, photographient ou reçoivent le plus souvent en PDF. La copie A en encre rouge est conçue pour les scanners de production à grande vitesse des centres de service de l'IRS — pas pour un scanner de bureau ou un appareil photo de téléphone. Cette distinction est importante car les outils OCR génériques qui tentent de lire une copie A scannée renvoient souvent du texte fantôme provenant des étiquettes de champs imprimées du formulaire mélangé aux données saisies, produisant une sortie plus bruitée que s'ils avaient traité la copie B en premier lieu.
Ce que coûte la saisie manuelle des données 1099 pendant la saison des impôts
Un seul formulaire 1099 contient entre 12 et 25 points de données selon la variante : nom et adresse du payeur, TIN du payeur, nom et adresse du bénéficiaire, TIN du bénéficiaire, montants de revenus par case, impôt fédéral retenu et détails de retenue au niveau de l'État. À raison de trois minutes en moyenne par formulaire pour un opérateur de saisie compétent, un lot de 200 formulaires 1099 représente dix heures de frappe continue. Pour un cabinet CPA traitant 500 formulaires 1099 clients pendant la saison des impôts, cela représente 25 heures — plus de trois journées complètes de travail — consacrées exclusivement à la transcription.
Mais le temps n'est pas le coût dominant. Selon le rapport comptable 2025 de Xero, 80 % des tâches comptables courantes sont automatisables avec les outils d'IA actuels, mais seulement 46 % des comptables déclarent utiliser des outils d'IA quotidiennement — ce qui signifie que les 54 % restants consacrent la majorité de leur temps à des travaux de conformité manuels. Une enquête de Thomson Reuters a révélé que le temps de préparation fiscale standard peut être réduit de 50 à 70 % grâce à l'automatisation, mais le secteur est également confronté à une pénurie de talents de 340 000 CPA d'ici 2030, selon l'AICPA. Chaque heure qu'un CPA passe à saisir les valeurs des cases 1099 dans une feuille de calcul est une heure non consacrée au travail de conseil, aux relations clients ou à la stratégie fiscale complexe — les services qui différencient un cabinet et justifient des honoraires premium.
L'exposition aux pénalités ajoute une autre couche de coût. En vertu de l'IRC Section 6721, le dépôt d'un formulaire 1099 avec un TIN incorrect déclenche des pénalités allant de 60 $ par formulaire (corrigé dans les 30 jours) à 340 $ par formulaire (non corrigé après le 1er août), avec des pénalités pour négligence délibérée atteignant 680 $ par formulaire. Un avis CP2100 — le B Notice — arrive lorsque le système de correspondance de l'IRS signale une discordance nom/TIN. À ce stade, le payeur doit commencer la retenue à la source de secours à 24 % sur tous les paiements futurs à ce fournisseur, lancer une demande formelle de W-9 corrigé et déposer une déclaration modifiée. Pour un cabinet traitant des milliers de formulaires 1099, un taux d'erreur de 2 % sur la correspondance TIN se traduit par des milliers de dollars d'exposition potentielle aux pénalités, sans compter le coût administratif de la gestion de chaque correction.
Comme l'a posté un professionnel de la fiscalité sur un forum de praticiens : « Je suis devenu CPA pour aider les entreprises à croître et à prendre des décisions stratégiques. Au lieu de cela, je passe 80 % de mon temps à la saisie de données et à des travaux de conformité de base. » Le problème n'est pas que la saisie de données soit difficile — c'est qu'elle consomme une capacité qui pourrait être déployée sur un travail qui requiert réellement l'expertise d'un CPA.
Trois raisons pour lesquelles l'extraction de données 1099 est délicate
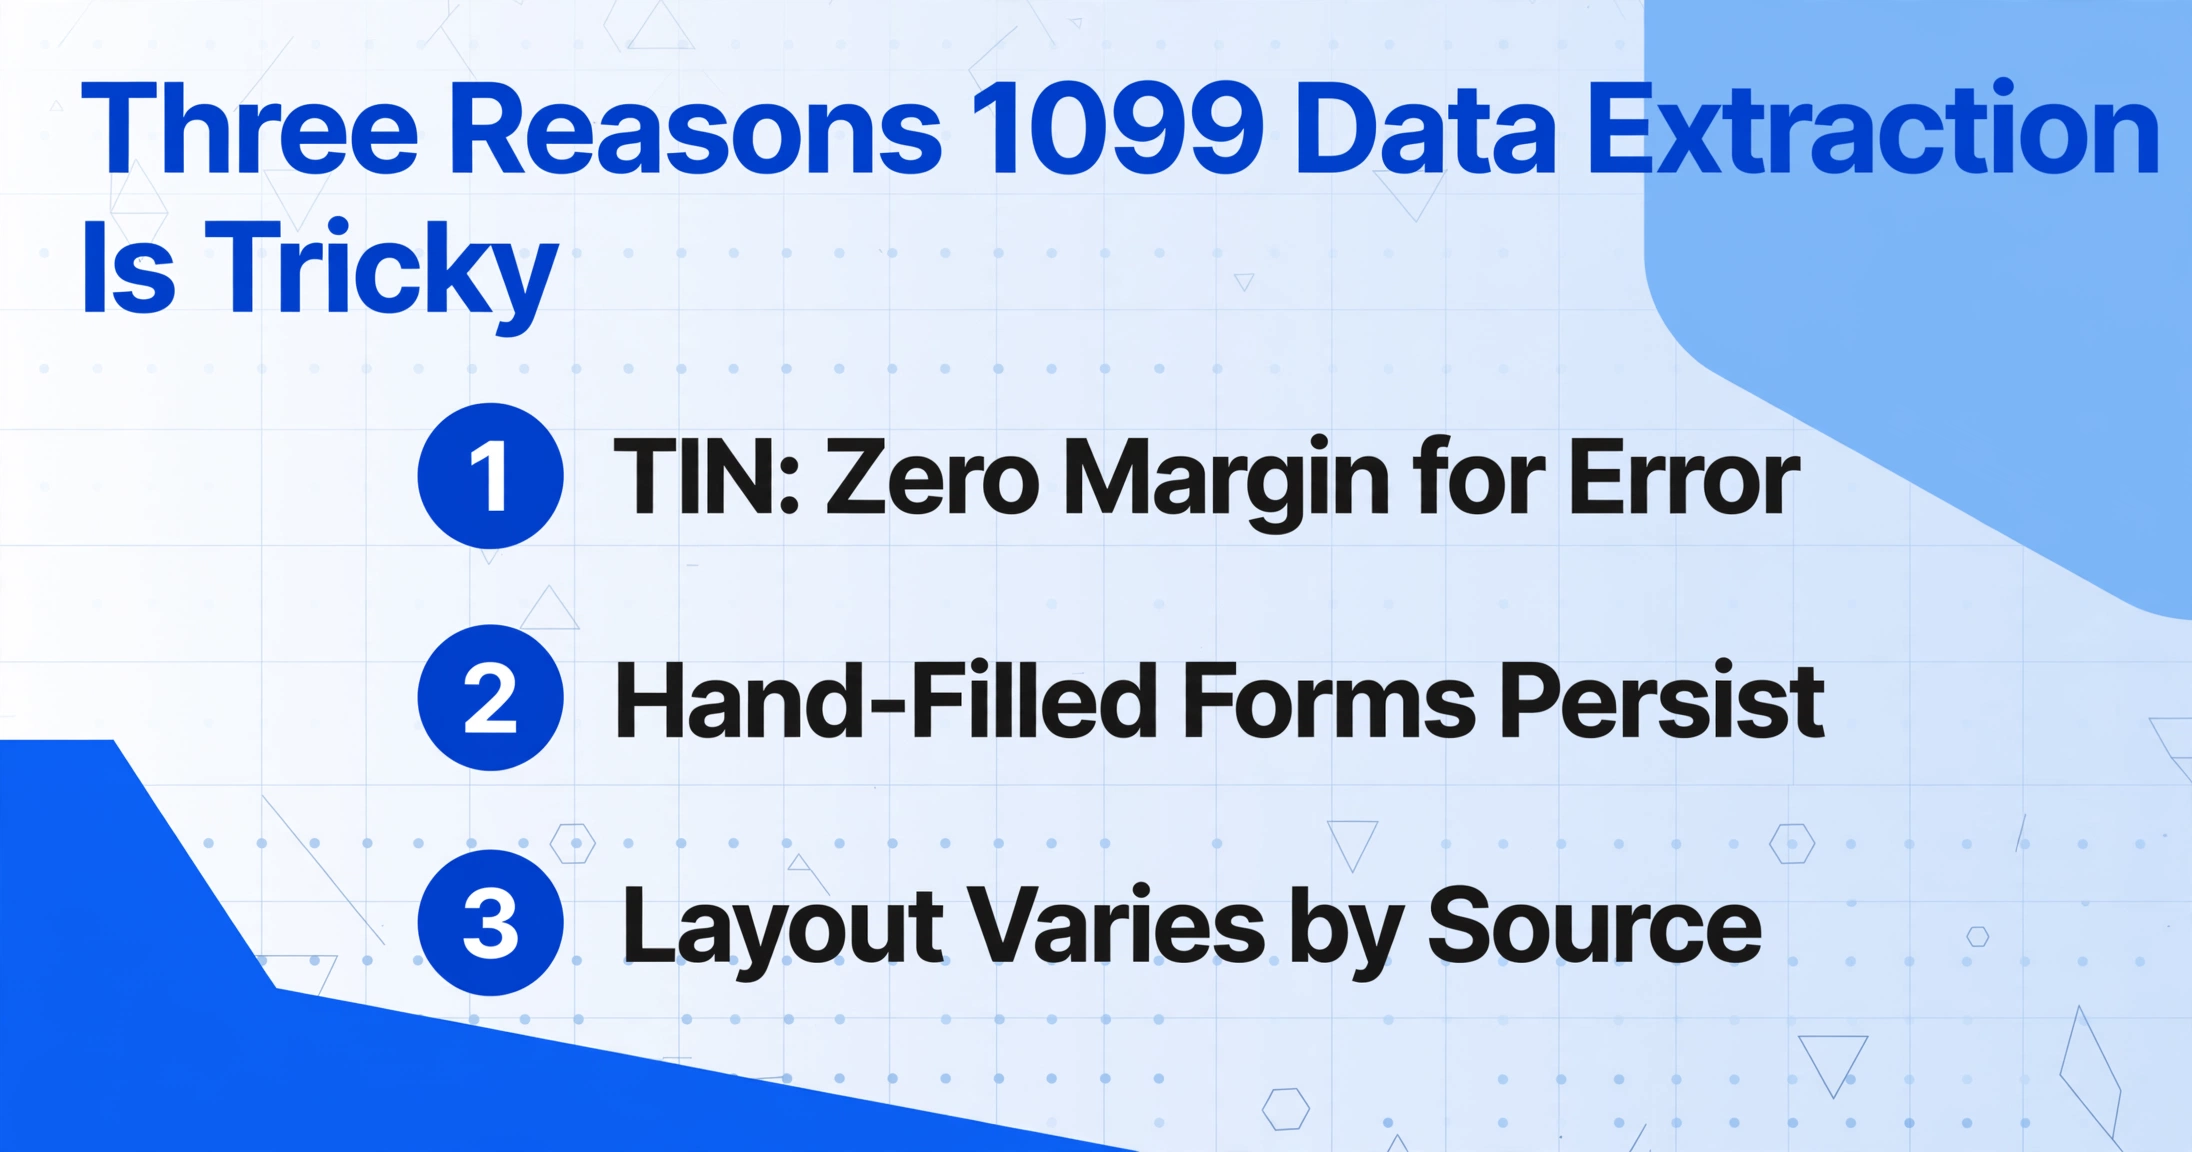
L'extraction de formulaires 1099 présente des défis que les outils OCR génériques — et même certains extracteurs spécifiques aux formulaires — gèrent mal. Comprendre ces points de friction est important, car le bon outil doit y répondre spécifiquement, et non pas simplement revendiquer une « extraction propulsée par l'IA ».
1. Le TIN à 9 chiffres n'a aucune marge d'erreur. Contrairement à un montant en dollars où une différence de quelques centimes importe rarement, un TIN est soit exactement correct, soit fonctionnellement inutile. Un chiffre inversé dans la case 4 d'un 1099-NEC (impôt fédéral sur le revenu retenu) est une erreur de données. Un chiffre inversé dans le champ TIN du bénéficiaire devient une non-concordance nom/TIN que l'IRS signalera. Les opérateurs de saisie de données travaillant sous la pression de la saison fiscale confondent régulièrement les 5 manuscrits avec des S, les 0 avec des O, et les 2 avec des Z — le schéma classique de confusion de caractères que les champs numériques à neuf chiffres amplifient. Même les 1099 générés par logiciel (à partir de QuickBooks, Drake Tax, UltraTax ou ProSeries) produisent un rendu de police et un espacement légèrement différents pour le champ TIN, rendant les modèles OCR basés sur la position peu fiables d'une source à l'autre.
2. Les 1099 remplis à la main restent courants chez les petits payeurs. L'IRS accepte les formulaires 1099 manuscrits à condition qu'ils soient « complètement lisibles et exacts pour éviter les erreurs de traitement », et de nombreuses petites entreprises — en particulier celles qui ne gèrent que quelques paiements à des entrepreneurs par an — remplissent encore les formulaires à la main ou à la machine à écrire. Un 1099-NEC manuscrit introduit des défis de reconnaissance que l'OCR traditionnel n'a pas été conçu pour gérer : espacement variable des caractères, pression incohérente (encre claire ou foncée), entrées barrées et entrées qui débordent légèrement dans les cases adjacentes. L'IRS lui-même avertit que « les formulaires manuscrits entraînent souvent des non-concordances nom/TIN ». Pour les outils d'extraction, le problème central n'est pas l'échec de reconnaissance des caractères au niveau de la lettre individuelle — c'est que les caractères manuscrits se trouvent à des positions imprévisibles dans chaque case, brisant les hypothèses spatiales sur lesquelles l'OCR basé sur les zones repose.
3. Variantes de formulaires et différences de mise en page selon les sources logicielles. Un 1099-NEC généré par QuickBooks dispose les blocs payeur et bénéficiaire différemment de celui généré par Drake Tax ou Lacerte. La largeur de la case TIN, l'espacement entre les sections payeur et bénéficiaire, et l'alignement des champs de retenue d'État varient tous subtilement entre les logiciels. Les outils d'extraction basés sur des modèles nécessitent des définitions de zones distinctes pour chaque variante logicielle — ou au minimum, un modèle préconfiguré par type de formulaire. Lorsque vous traitez un lot mixte de formulaires 1099-NEC et 1099-MISC générés par cinq logiciels différents, un outil qui s'appuie sur des modèles à zones fixes manquera des champs sur les formulaires sur lesquels il n'a pas été entraîné.
Pour contexte, un praticien sur le subreddit r/taxpros a noté que même une déclaration simple avec un seul 1099 prend 1,5 à 2 heures « en raison des feuilles de travail » — ce qui signifie que l'extraction elle-même prend quelques minutes, mais que le flux de travail environnant de vérification, de recoupement et de documentation multiplie l'effort total. La précision de l'extraction du flux de données détermine directement la part de ce travail de vérification qui peut être automatisée par rapport à celle effectuée manuellement.
Comment l'extraction IA sans modèle traite les formulaires 1099
Les approches décrites ci-dessus — précision du TIN, tolérance à l'écriture manuscrite, adaptabilité multi-variantes — convergent vers une exigence unique : l'outil d'extraction doit comprendre ce qu'il lit, et pas seulement où le texte apparaît sur la page. C'est la différence entre l'OCR basée sur des modèles (également appelée OCR zonale) et l'extraction sémantique par IA.
Les outils basés sur des modèles abordent un 1099-NEC en disant : « Cherchez le texte à environ X pixels de la marge gauche et Y pixels du haut — quoi qu'il s'y trouve, c'est le TIN du payeur. » Si le formulaire a été généré par un autre logiciel, imprimé sur une page légèrement décalée, ou provient d'une copie numérisée inclinée, ces coordonnées X/Y ne pointent plus vers le champ correct. La sortie se décale silencieusement — ou l'outil ne renvoie rien pour ce champ.
L'extraction par colonnes personnalisées — le paradigme central d'outils comme ImageToTable.ai — inverse cette logique. Au lieu de définir où se trouvent les données sur la page, vous définissez les données que vous souhaitez en nommant les champs : « Nom du payeur », « TIN du bénéficiaire », « Case 1a — Rémunération non salariale », « Case 4 — Retenue d'impôt fédéral sur le revenu », « Case 6 — Paiements médicaux ». L'IA lit visuellement le document — comprenant la structure du formulaire, la relation entre les étiquettes et les valeurs, la disposition des cases — et localise chaque valeur demandée par sa signification, et non par sa position. Un « TIN du bénéficiaire » est identifié parce que l'IA reconnaît l'étiquette TIN près d'un champ numérique à neuf chiffres, que cette étiquette se trouve en haut à gauche du formulaire (comme sur un 1099-NEC) ou dans la section centrale (comme sur certaines variantes du 1099-MISC).
Cette approche gère intrinsèquement les trois défis listés ci-dessus :
- Précision du TIN : L'IA lit les caractères en contexte — si le champ est étiqueté « TIN DU BÉNÉFICIAIRE » et que la valeur est un nombre à neuf chiffres, le modèle valide que la sortie fait exactement neuf caractères, réduisant le risque d'un premier chiffre manquant.
- Formulaires remplis à la main : Les modèles de vision-langage entraînés sur l'écriture manuscrite reconnaissent les caractères par leur forme et leur contexte, et non par leur position dans une case fixe — ainsi, un 5 manuscrit qui dépasse une bordure de case est toujours interprété comme un 5 plutôt que divisé entre deux champs.
- Dispositions multi-variantes : Parce que l'extraction est sémantique (lire l'étiquette, trouver la valeur), un 1099-NEC de QuickBooks et un 1099-MISC de Drake Tax peuvent être traités dans le même lot avec les mêmes définitions de colonnes, sans configuration par modèle.
Contrairement à l'OCR traditionnelle — qui convertit les images en texte mais n'organise pas ce texte en champs significatifs — l'extraction sémantique par IA produit une sortie structurée. Chaque valeur atterrit dans la colonne sous laquelle vous l'avez nommée, prête pour l'exportation Excel, le rapprochement ou l'importation dans un logiciel de préparation fiscale.
De 500 formulaires 1099 papier à une seule feuille de calcul : un flux de travail pour la saison des impôts
Le traitement des formulaires 1099 pendant la saison des impôts suit un schéma prévisible : les formulaires arrivent par lots — par courrier, par e-mail en pièces jointes PDF ou image, via les portails clients, ou sous forme de photos prises au téléphone. Le volume atteint son pic fin janvier (lorsque les formulaires 1099-NEC doivent être fournis aux bénéficiaires) et se poursuit jusqu'en mars, à mesure que les formulaires 1099-MISC arrivent et que les clients transmettent leurs formulaires reçus à leur préparateur fiscal. Le défi ne consiste pas à extraire un seul formulaire avec précision — il s'agit de maintenir cette précision sur des centaines de formulaires arrivant dans des formats différents, à des moments différents, provenant de différentes sources logicielles.
Un outil conçu pour ce flux de travail traite les formulaires par lots en priorité : téléversez 20, 50 ou 200 formulaires à la fois — PDF numérisés, JPEG envoyés par e-mail, photos prises au téléphone dans un dossier zip — et extrayez-les tous selon la même définition de colonnes en une seule passe. Le résultat est une feuille de calcul Excel consolidée où chaque ligne représente un formulaire 1099, avec des colonnes pour le nom du payeur, le TIN du payeur, le TIN du bénéficiaire, les montants de revenus par case, l'impôt fédéral retenu et la retenue d'État. Au lieu d'ouvrir chaque formulaire individuellement et de saisir les valeurs dans un modèle de feuille de calcul, vous vérifiez un seul fichier de sortie structuré — en contrôlant par sondage les valeurs à faible confiance signalées par l'outil plutôt qu'en ressaisissant chaque champ.
La différence pratique pour un petit cabinet comptable : un lot de 150 formulaires 1099-NEC et 1099-MISC qui prendrait environ 7,5 heures de saisie manuelle (à 3 minutes par formulaire) peut être téléversé, extrait et exporté vers Excel en environ 10 à 15 minutes de temps actif — le temps restant étant le traitement IA, pendant lequel le praticien peut travailler sur d'autres tâches.
ImageToTable.ai fournit déjà une page de conversion 1099 vers Excel qui gère toutes les variantes de 1099 — NEC, MISC, INT, DIV et autres — en consolidant plusieurs variantes dans une seule feuille de calcul structurée. L'extraction sous-jacente est identique à celle décrite ci-dessus : vous nommez les colonnes dont vous avez besoin, téléversez votre lot, et l'IA renvoie un tableau structuré avec une ligne par formulaire.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Pour les entreprises qui traitent également des factures, reçus ou autres documents financiers, le même flux de traitement par lots fonctionne sans code ni configuration d'intégration — il suffit d'importer, de nommer vos colonnes et d'exporter. L'approche sans modèle signifie que lorsque de nouvelles variantes du 1099 apparaissent ou que des formulaires existants changent de mise en page (comme avec les révisions de 2026), l'IA s'adapte sans que vous ayez à mettre à jour des modèles.
Questions fréquentes
L'IA peut-elle extraire des données de formulaires 1099 manuscrits ?
Oui, mais avec des réserves. Les modèles de langage visuel peuvent lire les écritures manuscrites, y compris les confusions de caractères courantes dans les TIN manuscrits (5 vs S, 0 vs O, 2 vs Z). Cependant, la précision sur les formulaires 1099 manuscrits est inférieure à celle des formulaires générés par logiciel, en particulier pour les TIN des bénéficiaires où un seul chiffre mal lu rend tout le champ invalide. La plupart des outils d'extraction renvoient des scores de confiance par champ, vous permettant de prioriser la vérification des cellules à faible confiance plutôt que de ressaisir chaque valeur. Si une grande partie de vos 1099 entrants sont remplis à la main, prévoyez un temps de vérification supplémentaire pour les champs TIN.
L'extraction 1099 fonctionne-t-elle avec toutes les variantes ?
Oui. L'extraction par IA sémantique gère toutes les variantes majeures du 1099 — NEC, MISC, INT, DIV, B, R, K, G, S et autres — sans configuration par type de formulaire. Comme l'IA identifie les champs du formulaire en lisant les étiquettes et en comprenant le contexte, une « Case 1 » sur un 1099-NEC (Rémunération des non-employés) et une « Case 1 » sur un 1099-MISC (Loyers) sont automatiquement mappées aux bonnes colonnes en fonction du type de formulaire. Les lots mixtes contenant plusieurs variantes de 1099 sont traités ensemble sans nécessiter de tri préalable.
Quelle est la précision de l'extraction IA des 1099 par rapport à la saisie manuelle ?
Les données du secteur montrent que l'extraction automatisée atteint une précision de 99,9 %+ au niveau des caractères sur les formulaires imprimés générés par logiciel, contre 96–99 % pour la saisie manuelle (où le taux d'erreur se cumule sur des dizaines de champs par formulaire). La comparaison la plus pertinente est la précision au niveau du champ : une seule erreur de TIN qui échappe à la vérification humaine entraîne une pénalité de 60 à 340 $. Les outils d'extraction avec notation de confiance vous permettent de vérifier uniquement les valeurs incertaines plutôt que de ressaisir chaque champ, ce qui détecte les erreurs potentielles de TIN avant qu'elles ne déclenchent une pénalité.
Puis-je traiter des 1099 provenant de différents logiciels en un seul lot ?
Oui — et c'est là que l'extraction sans modèle a un net avantage sur les outils basés sur des modèles. Un lot contenant des formulaires 1099-NEC provenant de QuickBooks, Drake Tax, UltraTax et des formulaires remplis à la main peut être téléchargé ensemble et traité avec les mêmes définitions de colonnes. L'IA reconnaît chaque variante de formulaire de manière indépendante et achemine chaque champ vers la bonne colonne, éliminant ainsi le besoin de trier les formulaires par source avant le traitement.
L'extraction par IA est-elle conforme aux exigences de tenue de registres numériques de l'IRS ?
L'extraction par IA produit des registres numériques structurés (Excel, CSV ou JSON) qui satisfont aux normes de conservation des registres électroniques de l'IRS en vertu de la Revenue Procedure 97-22 et des exigences actuelles en matière de registres numériques de l'IRS. L'exigence clé est que les registres numériques soient exacts, complets et reproductibles sur demande — conditions toutes remplies par une exportation bien structurée d'un outil d'extraction. Conservez les images originales scannées des 1099 avec les données extraites comme documentation source, conformément aux directives standard de conservation de documents aux États-Unis applicables aux registres fiscaux (généralement 3 à 7 ans selon le type de déclaration).