1099-NECおよび1099-MISCデータを
税務シーズンに向けてExcelに抽出する方法
手作業による1099データ入力の実質的なコストは、入力に費やす時間ではありません。数か月後にCP2100通知が届き、不一致フォーム1件につき$340の罰金が提案されるまで検出されないエラーこそが問題です。9桁のTINの数字が1つずれる、手書きの1099-NECの金額を読み間違える——こうしたミスは入力時には表面化しません。IRSの照合システムがフラグを立て、B Noticeと24%の支払いに対するバックアップ源泉徴収義務が発生して初めて表面化します。
その時点で、エラー修正にかかる時間——修正済みW-9の収集、修正申告書の提出、IRSへの対応——は、当初の入力コストを桁違いに膨らませます。1099処理におけるボトルネックは、キー入力の速さではありません。データを入力した時点と、そのデータが正しいと確認できる時点との間にあるギャップこそが問題なのです。
重要ポイント
- 1099を200件手入力すると、税務シーズン中に25時間を消費します——そして、その時間は手入力のコストの中では安い部分にすぎません。
- TINの入力ミスに対する罰金の時計は、エンターキーを押した瞬間から動き始めます——IRSの通知が届いた時ではありません——そして、その時点で修正されていない各フォームには$340のコストに加え、24%の強制バックアップ源泉徴収が発生します。
- ピクセル位置ではなく意味によってフォームのフィールドを読み取るセマンティックAIは、QuickBooks、Drake Tax、手書きの1099を一括処理し、数百件のうち監査に値する低信頼度セルを3件だけフラグ付けします。
1099-NECと1099-MISC:2つのフォーム、1つのデータ問題
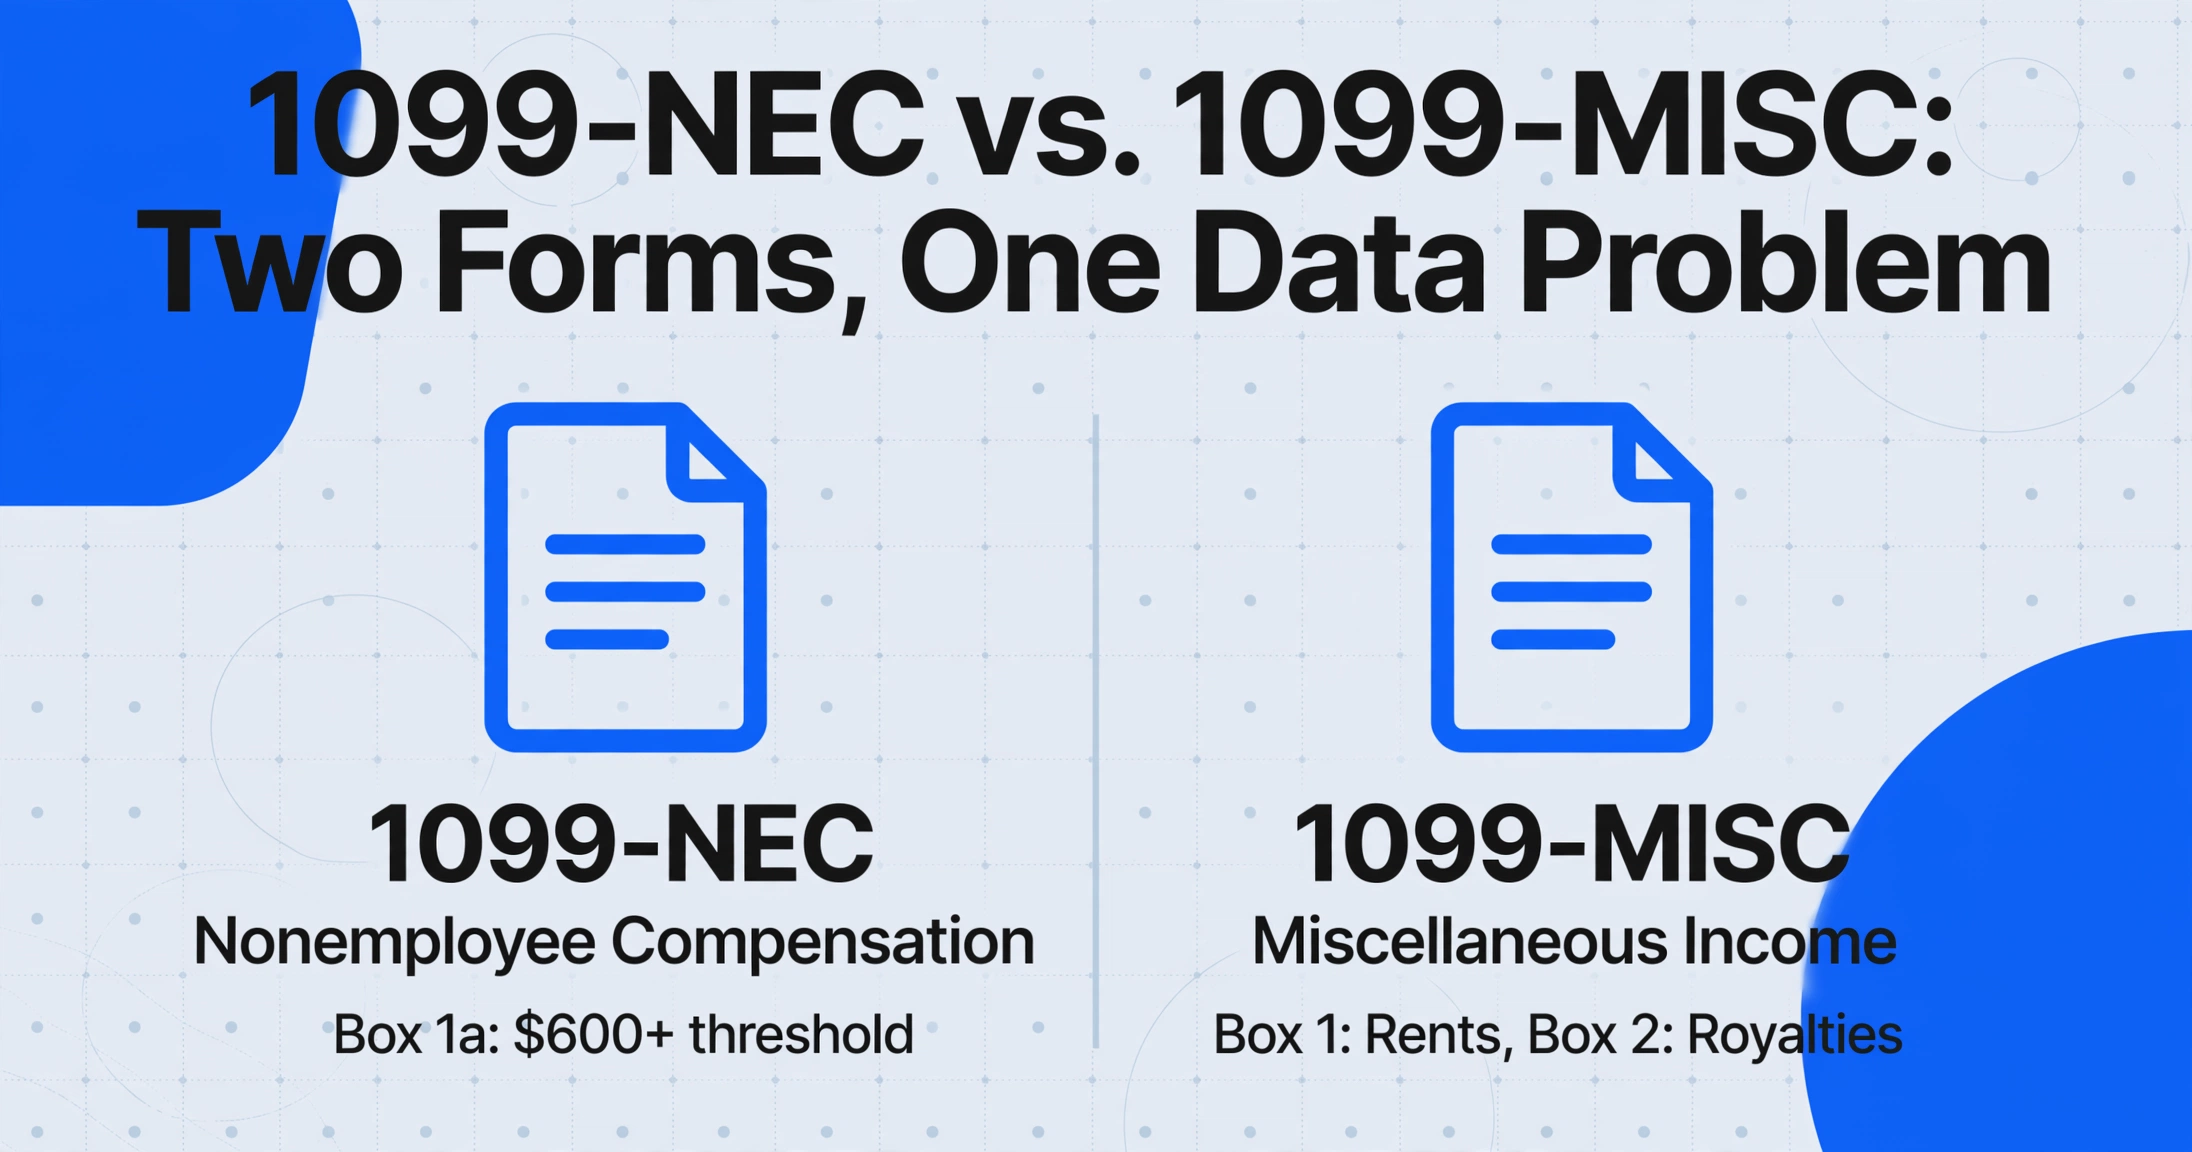
2020年度税制改正前は、非従業員報酬と雑所得の両方が単一のフォーム(1099-MISC)で報告されていました。IRSは2020年度からフォーム1099-NEC(非従業員報酬)を再導入し、長年支払者を悩ませてきた2つの申告期限の混乱を解消しました。現在、この2つのフォームは異なる報告目的を持ち、それぞれ別のボックス構成を備えていますが、一般的な中小企業や会計事務所では、同じ税務シーズンに両方を受け取ることになります——多くの場合、同じ取引先からのものです。
フォーム1099-NECは、事業の過程でサービスを提供した非従業員(独立契約者、フリーランサー、コンサルタント、ギグワーカー)に対して支払われた600ドル以上の報酬を報告します。中小企業や個人事業主が最も頻繁に受け取るフォームです。その構成は比較的コンパクトで、7つの番号付きボックスがあります(2026年改訂版では、現金チップ用のBox 1b、Treasury Tipped Occupation Code用のBox 1c、時間外報酬用のBox 1dが追加されました)。主要フィールドはBox 1a(非従業員報酬)です。報告基準額は2026年支払分から600ドルから2,000ドルに引き上げられましたが、フォームの基本構造は同じで、新しいボックスが追加された形になっています。
フォーム1099-MISC(雑所得)は、NECが対象としないすべてをカバーします:賃貸料(Box 1)、ロイヤルティ(Box 2)、その他の所得支払い(Box 3)、医療・ヘルスケア支払い(Box 6)、作物保険金(Box 9)、弁護士への総支払額(Box 10)など——18の番号付きボックスにわたり、報告基準額や申告ルールは多岐にわたります。その公式IRS説明書は30ページ以上に及び、どの支払いタイプがどのボックスに入るかを詳述しています。
両フォームは同じ物理形式を共有しています:Copy AはIRS処理センター向けにOCR読み取り可能な赤インクで印刷され、Copy B(受取人用コピー)は標準的な黒インクで、実務者が最も頻繁にスキャン、撮影、またはPDFとして受け取るものです。赤インクのCopy AはIRSサービスセンターの高速生産スキャナー用に設計されており、デスクトップスキャナーやスマートフォンのカメラ用ではありません。この違いは重要です。なぜなら、スキャンしたCopy Aを読み取ろうとする一般的なOCRツールは、フォームに印刷されたフィールドラベルのゴーストテキストと入力データが混ざった出力を返すことが多く、最初からCopy Bを処理した場合よりもノイズの多い結果になるからです。
繁忙期における手動1099データ入力のコスト
1099フォームは種類にもよりますが、1枚あたり12〜25個のデータ項目を含みます。支払者名・住所、支払者TIN、受取人名・住所、受取人TIN、ボックス別の所得金額、連邦税の源泉徴収額、州レベルの源泉徴収詳細などです。熟練したデータ入力オペレーターが1枚あたり平均3分かかるとして、200枚の1099を処理するには10時間の連続入力が必要です。繁忙期に500枚のクライアント1099を処理するCPA事務所の場合、それは25時間——丸3営業日以上——を単純な転記作業だけに費やすことになります。
しかし、時間だけが主なコストではありません。Xeroの2025年会計レポートによると、日常的な簿記業務の80%は現在のAIツールで自動化可能ですが、会計士の46%しか毎日AIツールを使用していないと報告されています。つまり、残りの54%は手作業のコンプライアンス業務にほとんどの時間を費やしていることになります。Thomson Reutersの調査では、標準的な税務申告準備時間は自動化により50〜70%削減できるとされていますが、業界はAICPAによると2030年までに34万人のCPA不足という人材難にも直面しています。CPAが1099のボックス値をスプレッドシートに入力する1時間は、アドバイザリー業務、クライアント関係、複雑な税務戦略——事務所を差別化し、プレミアム料金を正当化するサービス——に使えない1時間です。
罰則リスクもコストの層をさらに追加します。IRC Section 6721に基づき、誤ったTINで1099を提出すると、1枚あたり60ドル(30日以内に修正)から340ドル(8月1日以降も未修正)へと罰金が段階的に増加し、意図的な無視の場合は1枚あたり680ドルに達します。IRSのマッチングシステムが名前/TINの不一致を検出すると、CP2100通知——B Notice——が届きます。その時点で、支払者はそのベンダーへの将来の支払いすべてに対して24%のバックアップ源泉徴収を開始し、修正済みW-9の正式な提出要請を行い、修正申告書を提出する必要があります。数千枚の1099を処理する事務所では、TINマッチングの2%のエラー率は、各修正の管理コストを除いても、数千ドルもの潜在的な罰則リスクに相当します。
ある税務専門家が実務者フォーラムに投稿したように:「私は企業の成長と戦略的意思決定を支援するためにCPAになりました。しかし実際には、時間の80%をデータ入力と基本的なコンプライアンス業務に費やしています。」問題はデータ入力が難しいことではなく、CPAの専門知識を本当に必要とする業務に投入できるはずのキャパシティを消費してしまうことです。
1099データ抽出が難しい3つの理由
1099の抽出は、一般的なOCRツールや一部のフォーム専用抽出ツールでもうまく処理できない課題を伴います。これらの問題点を理解することは重要です。適切なツールは、単に「AI搭載の抽出」と謳うだけでなく、これらの課題に特化して対応する必要があるからです。
1. 9桁のTINには誤差の余地が一切ありません。数セントのずれが問題になることはほとんどない金額とは異なり、TINは完全に正確であるか、実質的に役に立たないかのどちらかです。1099-NEC(連邦所得税源泉徴収額)のBox 4で数字を入れ違えると、それはデータエラーです。受取人のTIN欄で数字を入れ違えると、IRSがフラグを立てる名前/TIN不一致になります。税務シーズンのプレッシャーの中で働く手作業のデータ入力担当者は、手書きの5をS、0をO、2をZと読み間違えることが日常的にあります。これは、9桁の数字フィールドで増幅される典型的な文字混同パターンです。ソフトウェアで生成された1099(QuickBooks、Drake Tax、UltraTax、ProSeriesなど)でも、TINフィールドのフォントレンダリングや間隔がわずかに異なるため、位置ベースのOCRテンプレートはソース間で信頼性が低くなります。
2. 手書きの1099は小規模な支払者の間で依然として一般的です。IRSは、「処理エラーを避けるために完全に読みやすく正確である」ことを条件に手書きの1099フォームを受け入れており、多くの小規模企業(特に年間に数件の請負業者への支払いしか処理しない企業)は、今でもフォームを手書きまたはタイプライターで記入しています。手書きの1099-NECは、従来のOCRが対応するように設計されていなかった認識上の課題を生み出します。文字間隔が一定でない、筆圧が一貫しない(薄いインクと濃いインク)、取り消し線のある記入、隣接するボックスにわずかににじみ出る記入などです。IRS自身も「手書きのフォームはしばしば名前/TIN不一致を引き起こす」と警告しています。抽出ツールにとって、核心的な問題は個々の文字レベルの認識失敗ではなく、手書き文字が各ボックス内の予測不可能な位置にあるため、ゾーンベースのOCRが依存する空間的な前提が崩れることです。
3. ソフトウェアソースによるフォームのバリエーションとレイアウトの違い。QuickBooksで生成された1099-NECは、Drake TaxやLacerteで生成されたものとは支払者と受取人のブロックのレイアウトが異なります。TINボックスの幅、支払者と受取人のセクション間の間隔、州の源泉徴収フィールドの配置は、ソフトウェアパッケージごとに微妙に異なります。テンプレートベースの抽出ツールは、ソフトウェアのバリエーションごとに個別のゾーン定義が必要です。少なくとも、フォームタイプごとに事前設定されたモデルが必要です。5つの異なるソフトウェアパッケージで生成された1099-NECと1099-MISCフォームの混合バッチを処理する場合、固定ゾーンテンプレートに依存するツールは、トレーニングされていないフォームのフィールドを見逃します。
参考までに、r/taxprosサブレディットのある実務者は、1099が1枚だけの単純な申告でも「ワークペーパーのため」に1.5〜2時間かかると指摘しています。つまり、抽出自体は数分で完了しますが、その後の検証、相互参照、文書化のワークフローが総作業量を何倍にも増幅します。データフィードの抽出精度が、その検証作業のうちどれだけを自動化できるか、どれだけを手作業で行う必要があるかを直接決定します。
テンプレート不要のAI抽出が1099フォームを処理する仕組み
上記で説明したアプローチ(TIN精度、手書き耐性、複数バリエーションのレイアウト適応性)は、1つの要件に集約されます。それは、抽出ツールがテキストの位置だけでなく、その内容を理解できなければならないということです。これが、テンプレートベースのOCR(ゾーンOCRとも呼ばれる)と、意味論的なAI抽出の違いです。
テンプレートベースのツールは1099-NECを処理する際、「左端から約Xピクセル、上端から約Yピクセルの位置にあるテキストを探せ。そこにあるものが支払者TINだ」と指示します。もしフォームが別のソフトウェアで生成されたり、ページ位置がずれて印刷されたり、傾いたスキャンコピーから取得された場合、そのX/Y座標は正しいフィールドを指さなくなります。出力は気付かれないうちにずれるか、ツールはそのフィールドに何も返さなくなります。
カスタム列抽出 — ImageToTable.aiのようなツールの中核となる抽出パラダイム — は、このロジックを逆転させます。データがページ上のどこにあるかを定義する代わりに、フィールドに名前を付けて必要なデータを定義します。「支払者名」「受取人TIN」「ボックス1a — 非従業員報酬」「ボックス4 — 連邦所得税源泉徴収額」「ボックス6 — 医療費支払額」。AIは文書を視覚的に読み取り、フォームの構造、ラベルと値の関係、ボックスレイアウトを理解し、各要求値をその意味に基づいて特定します。位置ではありません。「受取人TIN」は、AIが9桁の数値フィールドの近くにあるTINラベルを認識することで識別されます。そのラベルがフォームの左上(1099-NECの場合)にあるか、中央セクション(一部の1099-MISCバリアントの場合)にあるかは関係ありません。
このアプローチは、上記の3つの課題に本質的に対処します。
- TIN精度: AIは文脈の中で文字を読み取ります。フィールドに「受取人TIN」とラベル付けされ、値が9桁の数字である場合、モデルは出力が正確に9文字であることを検証し、先頭の数字が欠落する可能性を減らします。
- 手書きフォーム: 手書き文字で訓練された視覚言語モデルは、固定されたボックス内の位置ではなく、形状と文脈によって文字を認識します。そのため、ボックス境界をまたぐ手書きの「5」も、2つのフィールドに分割されることなく「5」として解釈されます。
- 複数バリエーションのレイアウト: 抽出が意味論的(ラベルを読み、値を見つける)であるため、QuickBooksからの1099-NECとDrake Taxからの1099-MISCを、同じ列定義で、テンプレートごとの設定なしに同じバッチで処理できます。
画像をテキストに変換するが、そのテキストを意味のあるフィールドに整理しない従来のOCRとは異なり、意味論的なAI抽出は構造化された出力を生成します。すべての値は、あなたが指定した名前の列に配置され、Excelへのエクスポート、照合、税務申告ソフトウェアへのインポートの準備が整います。
紙の1099を500枚から1つのスプレッドシートへ:税務シーズンのワークフロー
税務シーズンの1099処理は予測可能なパターンに従います。フォームは郵便、メールのPDFや画像添付、クライアントポータル、電話で撮影した写真など、バッチ単位で届きます。量は1月下旬(1099-NECフォームを受取人に送付する必要がある時期)にピークを迎え、1099-MISCフォームが届きクライアントが受領したフォームを税理士に転送する3月まで続きます。課題は単一のフォームを正確に抽出することではなく、異なる形式・異なるタイミング・異なるソフトウェアソースから届く何百ものフォームにわたってその正確性を維持することです。
このワークフロー向けに設計されたツールはフォームをバッチファーストで処理します。スキャンしたPDF、メールで送られたJPEG、zipフォルダ内の電話写真など、20枚・50枚・200枚のフォームを一度にアップロードし、同じ列定義に対して一括で抽出します。出力は統合されたExcelスプレッドシートで、各行が1つの1099フォームを表し、支払者名、支払者TIN、受取人TIN、ボックス別所得金額、連邦税源泉徴収額、州税源泉徴収額の列があります。各フォームを個別に開いてスプレッドシートテンプレートに値を入力する代わりに、単一の構造化出力ファイルを検証します。ツールがフラグを立てた低信頼度の値をスポットチェックするだけで、すべてのフィールドを再入力する必要はありません。
小規模な会計事務所にとっての実際的な違い:150枚の1099-NECおよび1099-MISCフォームのバッチは、手動データ入力で約7.5時間(1フォームあたり3分)かかるところ、アップロード・抽出・Excelへのエクスポートを約10〜15分の実作業時間で完了できます。残りの時間はAI処理中であり、その間に実務者は他のタスクに取り組めます。
ImageToTable.aiはすでに1099からExcelへの変換ページを提供しており、NEC、MISC、INT、DIVなどすべての1099バリアントを処理し、複数のバリアントを単一の構造化スプレッドシートに統合します。基礎となる抽出プロセスは上記と同一です。必要な列を指定し、バッチをアップロードすると、AIがフォームごとに1行の構造化テーブルを返します。
ファイルは安全に処理され、保存されません。
請求書や領収書など他の財務書類も処理する企業の場合、同じバッチ処理ワークフローはコードや統合設定不要で動作します — アップロードして、列名を指定し、エクスポートするだけです。テンプレート不要のアプローチにより、新しい1099バリアントが登場したり、既存のものがレイアウトを変更した場合(2026年改訂で発生したように)、テンプレートを更新することなくAIが適応します。
よくある質問
AIは手書きの1099フォームからデータを抽出できますか?
はい、ただし注意点があります。視覚言語モデルは手書きの記入内容を読み取ることができ、手書きのTINによく見られる文字の混同パターン(5とS、0とO、2とZなど)も処理できます。ただし、手書きの1099フォームの精度はソフトウェア生成フォームよりも低く、特に受取人TINでは1桁の読み間違いでフィールド全体が無効になります。ほとんどの抽出ツールはフィールドごとに信頼度スコアを返すため、すべての値を再入力するのではなく、低信頼度のセルのレビューを優先できます。受領する1099の多くが手書きの場合は、TINフィールドの確認に余分な時間を確保してください。
1099抽出はすべてのバリアントで機能しますか?
はい。セマンティックAI抽出は、NEC、MISC、INT、DIV、B、R、K、G、Sなど、主要な1099バリアントすべてをフォームタイプごとの設定なしで処理します。AIはラベルを読み取り、コンテキストを理解してフォームフィールドを識別するため、1099-NEC(非従業員報酬)の「Box 1」と1099-MISC(賃貸料)の「Box 1」は、フォームタイプに基づいて自動的に正しい列にマッピングされます。複数の1099バリアントを含む混合バッチも、事前の仕分けなしでまとめて処理されます。
AIによる1099抽出の精度は手動入力と比べてどうですか?
業界データによると、自動抽出は印刷されたソフトウェア生成フォームで99.9%以上の文字レベル精度を達成します。一方、手動入力では96~99%です(エラー率はフォームあたり数十のフィールドにわたって累積します)。より重要な比較はフィールドレベル精度です。人間のレビューを通過した単一のTINエラーには60~340ドルのペナルティコストが発生します。信頼度スコアリング機能を持つ抽出ツールを使用すると、すべてのフィールドを再入力するのではなく、不確かな値のみを監査でき、ペナルティが発生する前に潜在的なTINエラーを捕捉できます。
異なるソフトウェアから出力された1099を一括処理できますか?
はい — これこそ、テンプレート不要の抽出がテンプレートベースのツールに対して持つ明確な利点です。QuickBooks、Drake Tax、UltraTax、手書きの1099-NECフォームが混在するバッチでも、同じ列定義でまとめてアップロード・処理できます。AIが各フォームのバリエーションを個別に認識し、各フィールドを正しい列に振り分けるため、処理前にフォームをソース別に分類する必要はありません。
AI抽出はIRSのデジタル記録保存要件に準拠していますか?
AI抽出により生成される構造化デジタル記録(Excel、CSV、JSON)は、Revenue Procedure 97-22および現行のIRSデジタル記録要件に基づく電子記録保存基準を満たします。重要な要件は、デジタル記録が正確かつ完全で、要求に応じて再現可能であることです。これらはすべて、適切に構造化された抽出ツールのエクスポートにより達成されます。抽出データとともに元のスキャン済み1099画像をソース文書として保管し、税務記録に適用される標準的な米国文書保存ガイドライン(申告種類に応じて通常3~7年)に従ってください。