Os dados de campo já estão coletados —
o trabalho é levá-los para o Excel
Um inspetor de lavoura preenche uma planilha manuscrita de contagem de pragas em uma prancheta na borda do campo; depois, a planilha vai para uma caminhonete, uma pasta ou uma pilha na mesa do escritório até alguém encontrar tempo para digitá-la em uma planilha eletrônica. Um técnico de qualidade da água fotografa o livro de registro de um poço de monitoramento ao final de uma rodada de amostragem, e as leituras de pH e condutividade ficam na galeria da câmera por dias. Os dados de campo — a parte mais difícil de toda a operação — já estão registrados. O que leva a semana inteira é a etapa em que alguém transforma esses formulários em linhas. É exatamente essa etapa que este artigo elimina: cinco passos, do formulário como ele existe no campo até a planilha que seu fluxo de trabalho pode realmente usar.
Principais Conclusões
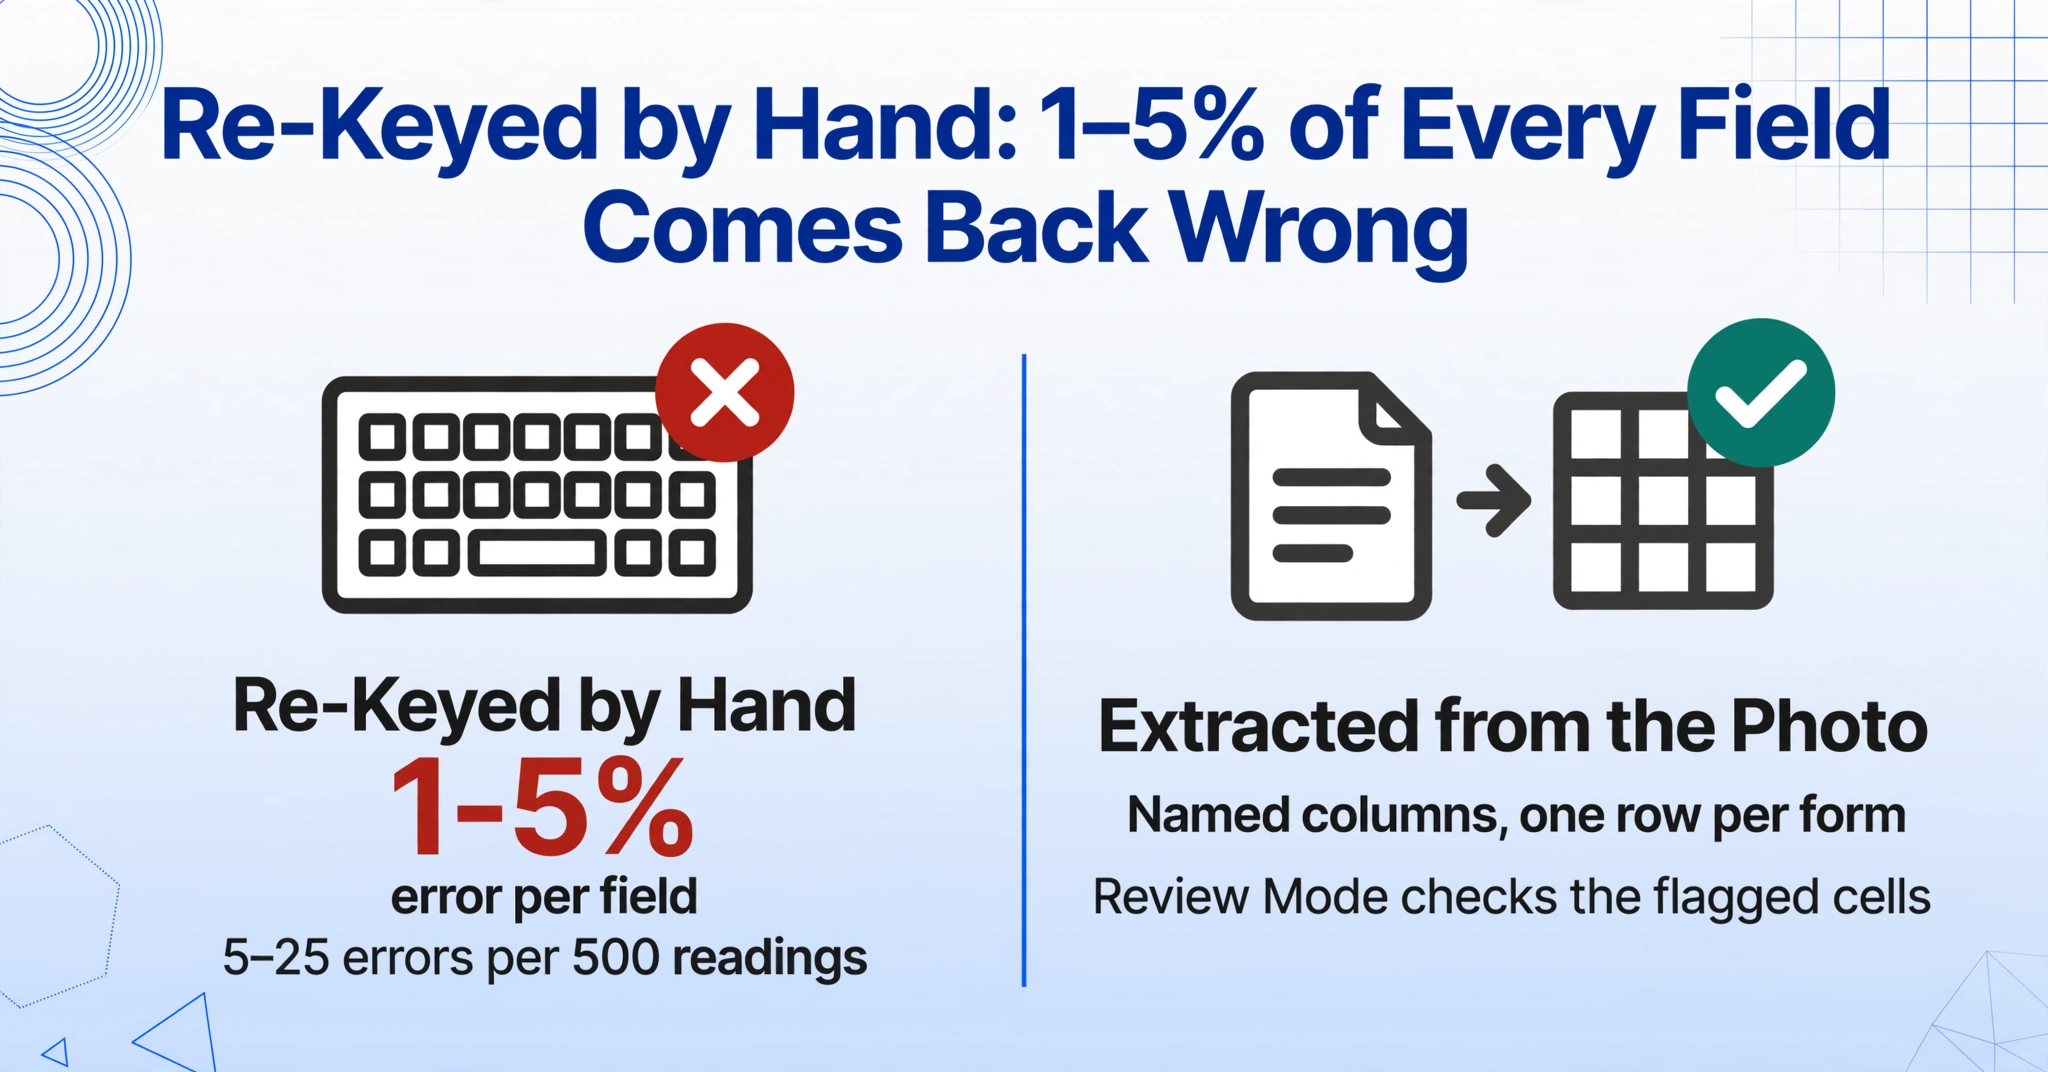
- Redigitar dados de campo manualmente em planilhas eletrônicas tem uma taxa de erro documentada de 1–5% por campo e custa a um laboratório estadual 10.000 entradas manuais todos os meses.
- Digitar mais rápido não resolve isso — a etapa de redigitação em si é o defeito estrutural, porque cada número copiado cria um ponto de falha que o formulário de campo original nunca teve.
- Fotografe o formulário uma vez e nomeie suas colunas — a IA encontra cada valor pelo que ele significa e preenche a linha sem que ninguém toque no teclado.
O Formulário Já É o Registro — a Planilha É o Problema
O formulário de campo não é uma etapa intermediária. Ele é o registro principal do que aconteceu no campo — e é na planilha que esse registro se torna utilizável. A lacuna entre eles é trabalho puro e evitável.
Pesquisadores que entrevistaram operadores de pequenas e médias fazendas para um estudo de 2024 sobre práticas de coleta de dados agrícolas publicado no MIT capturaram como os registros de campo escapam facilmente do alcance: "Se anotamos ou se você apenas lembra que, ei, há um problema de trigo neste canto do campo, você precisa prestar atenção nisso na primavera e, esperançosamente, lembrar — às vezes você não lembra." Esse é o custo do papel: não o papel em si, mas o fato de que a informação só se torna dado quando alguém age sobre ela, e agir sobre ela significa que ela precisa estar em algum lugar pesquisável.
Agricultores no r/farming que mantêm registros descrevem exatamente essa divisão entre o campo e o escritório. Um tópico sobre manutenção de registros lista a pilha típica: "planilhas de acompanhamento para todos os equipamentos, manutenção, resultados de plantio/colheita, testes de solo, planos de cultivo, tickets de carga, conteúdos de silos" — cada um deles originalmente escrito à mão. O mesmo padrão aparece no monitoramento ambiental, onde técnicos de campo preenchem diários de bordo em poços, medidores de riachos e estações de monitoramento de ar que ninguém redigita de forma estruturada.
Isso não é uma peculiaridade isolada do fluxo de trabalho. O Laboratório de Testes de Solo da Virginia Tech relata que em um março típico, as informações de amostras de clientes para cerca de 10.000 amostras de solo precisam ser digitadas manualmente — 10.000 formulários de envio em papel, para um laboratório estadual, em um mês. Isso é o que a transcrição manual parece em escala institucional, e é exatamente a etapa que o software de extração substitui. Escrevemos separadamente sobre onde o pipeline de dados de campo realmente quebra — este guia é a solução para isso.
Por que a etapa de redigitação é a parte a ser removida
Dados de campo manuscritos apresentam uma taxa de erro documentada de aproximadamente 1–5% por campo quando redigitados manualmente — um número compilado ao longo de décadas de pesquisa em fatores humanos e citado em uma revisão de 2024 sobre registros agrícolas publicada em Precision Agriculture. Em uma rodada de amostragem de 500 pontos de dados, isso significa de 5 a 25 erros. Alguns são inofensivos. Os que importam são os dígitos transpostos em uma leitura de pH, o ID do campo errado em uma contagem de pragas ou um nível de água que cai na coluna do vizinho.
Três estruturas regulatórias nos Estados Unidos transformam isso de uma preocupação de eficiência em um requisito de manutenção de registros, e todas as três compartilham uma suposição: que os registros de campo são precisos, legíveis e recuperáveis.
Todas as três regras convergem para a mesma conclusão operacional: o registro deve existir em uma forma que possa ser pesquisada, auditada e entregue. Isso é uma propriedade de planilhas, não de pranchetas.
O Que um Formulário de Dados de Campo Precisa se Tornar
Antes de projetar um fluxo de extração, vale decidir quais campos de um formulário de campo realmente alimentam decisões a jusante. Uma ficha de inspeção de lavoura e um diário de qualidade da água têm seus próprios campos de alto valor, e as colunas que você extrai devem corresponder aos usos a jusante — não a cada linha da página.
| Fluxo de trabalho | Campos de alto valor | O que eles alimentam |
|---|---|---|
| Inspeção de lavoura | ID do campo, Cultura, Estágio de crescimento, Contagem de pragas, Pressão de plantas daninhas, Umidade do solo | Recomendações de pulverização, tendências de pressão de pragas, planejamento de colheita, registros de produção do seguro agrícola |
| Amostragem de solo | ID da amostra, ID do campo, Profundidade, Data, Notas de textura | Formulários de envio ao laboratório (como o acúmulo de 10.000 por mês no laboratório de VT), planejamento de fertilidade, planos de manejo de nutrientes |
| Monitoramento da qualidade da água | ID da estação, Data, Hora, Nível da água, pH, Condutividade, Oxigênio dissolvido | Relatórios de conformidade, verificação de GQ/CQ em relação aos registros de campo, análise de tendências |
| Inspeções de segurança (operações de campo) | Data da inspeção, Local, Inspetor, Constatação, Ação corretiva | Trilhas de auditoria, acompanhamento de pendências, registros de inspeção regulatória |
Dois padrões se repetem nos quatro casos. Primeiro, os campos de identidade — ID do campo, ID da estação, ID da amostra, local — são as chaves de junção que permitem classificar, filtrar e comparar rodadas de dados. Segundo, os campos de medição carregam unidades que importam a jusante (pH não tem unidades; condutividade é µS/cm; nível da água é em pés ou metros). Ambos os padrões orientam como você nomeia suas colunas de extração.
Etapa 1: Capture o Formulário do Jeito que a IA Precisa Ver
Tire uma foto plana e bem iluminada do formulário inteiro — ou digitalize-o se houver um scanner por perto. A qualidade da extração de dados de campo manuscritos começa na captura, e três hábitos baratos são responsáveis pela maior parte da diferença entre uma primeira tentativa limpa e uma frustrante.
Por que a qualidade da captura importa tanto para a extração? Porque o modelo de visão lê a página da mesma forma que uma pessoa leria — se o texto estiver legível na foto, ele pode ser lido; se for um borrão branco, nenhuma ferramenta de extração, por melhor que seja, pode recuperá-lo. Acertar a foto é a alavanca de precisão mais barata em todo o fluxo de trabalho.
Etapa 2: Dê Nome às Colunas Que Você Quiere Extraer
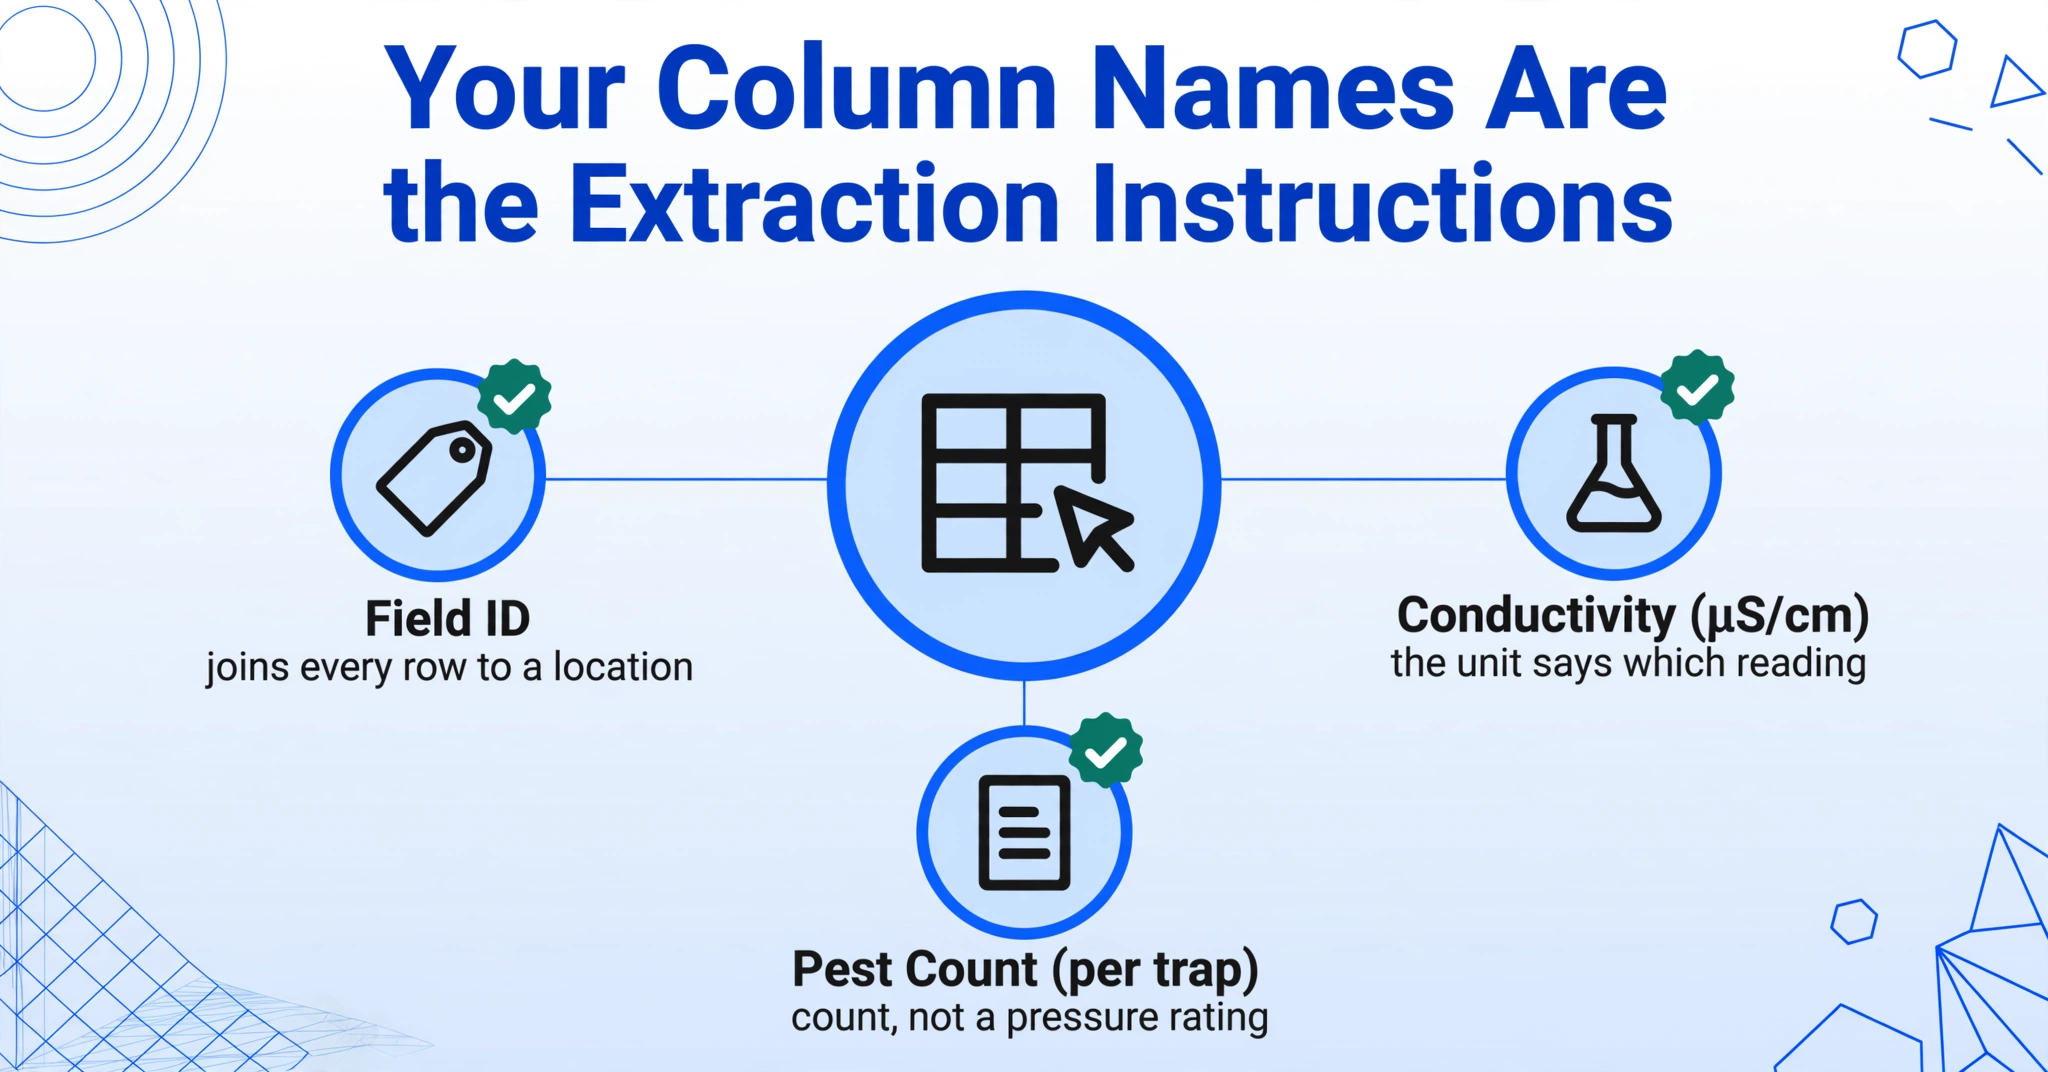
Digite os nomes dos campos que você quer como colunas do Excel — a IA localiza cada valor pelo que ele significa, não por onde está na página. Este é o mecanismo que ImageToTable.ai chama de Extraction de Colunas Personalizadas: você define a saída ("Contagem de Pragas", "pH", "ID da Estação"), e a IA lê o formulário, encontra o valor que responde a cada nome de coluna e preenche a linha. É fundamentalmente diferente do OCR baseado em modelo, que exige que você desenhe uma caixa ao redor de cada campo em um formulário de referência e depois falha quando a caligrafia do próximo formulário cae fora da caixa.
Nomear as colunas é a decisión de maior impacto neste fluxo de trabalho — os nomes que você digita se tornan os cabeçalhos da planilha final e as instruções semánticas para encontrar cada valor. Nomes bons se alinean com como o próprio formulário rotula os dados. Nomes fracos são ambíguos o suficiente para que a IA não consiga distinguir entre vários valores similares que você quer dizer:
| Tipo de Formulário | Nomes de Columna Adecuados | Por Qué Funcionan | Nomes Débiles | Por Qué Fallan |
|---|---|---|---|---|
| Inspección de cultivos | ID do Campo, Cultivo, Estágio de Crescimento, Contagem de Pragas (por armadilha), Pressão de Plantas Daninhas (Baixa/Media/Alta) | Coincide com os rótulos do formulário; unidades e opções no nome resolvem a ambigüidade entre a contagem e a classificação de pressão | Localização, Contagem, Estágio | "Contagem" poderia ser contagem de pragas, contagem de plantas ou contagem de armadillas; "Estágio" poderia ser estágio de crescimento ou estágio de muestreo |
| Qualidade da água | ID da Estação, Nível de Água (ft), pH, Condutividade (µS/cm), Oxígeno Dissolvido (mg/L) | Unidades no nome indicam à IA a que columna pertence cada leitura e desambiguam DO de BOD ou outras métricas de oxígeno | Pozo, Nível, DO | "Nível" poderia ser nível de água ou leitura do medidor de nível; "DO" poderia ser oxígeno dissolvido ou data de emissão |
| Inspección de segurança | Data da Inspección, Localização, Hallazgo, Acción Correctiva, Nome do Inspector | Os rótulos dos campos coinciden com o formulário textualmente; cada um se mapea a um uso posterior | Data, Problema, Nome | "Problema" poderia ser o hallazgo, a data ou um número de equipo; "Nome" poderia ser inspector ou membro da tripulación |
Você também pode deixar a IA inferir valores que não estão escritos no formulário. Uma coluna inferida como Categoria (opções: Químico / Biológico / Físico) instrui a IA a ler o contexto do monitoramento e classificar cada leitura em uma das opções listadas — uma única passada que extrai e categoriza ao mesmo tempo, o que é útil quando os formulários de campo usam anotações de texto livre em vez de caixas de seleção. Para um passo a passo mais detalhado de como a extração semântica lida com formulários manuscritos campo por campo, veja nosso guia para extrair campos específicos de formulários manuscritos. Se você quiser ver o padrão nome-da-coluna → planilha aplicado a um tipo de documento semelhante primeiro, o fluxo de trabalho de formulário manuscrito para Excel mostra a mesma mecânica em um exemplo mais simples.
Etapa 3: Envio em Lotes — Um Formulário, Uma Linha
Envie todas as rodadas de formulários de uma vez; cada formulário vira uma linha em uma única planilha mesclada. É aqui que a extração compensa no trabalho de campo, porque os dados de campo chegam em lotes por natureza — uma rodada de inspeção cobre seis campos, um evento de amostragem cobre vinte estações, um dia de inspeção cobre um local inteiro. Processá-los um a um recriaria o gargalo manual, só que com menos digitação.
O ImageToTable.ai é Processamento Prioritário em Lote: você envia várias fotos ou digitalizações, e a IA as processa juntas e mescla os resultados em um único arquivo Excel — uma linha por formulário, com seus nomes de colunas como cabeçalho. Uma rodada de 40 fotos de diário de qualidade da água vira 40 linhas em uma única planilha em uma única execução. Os formulários não precisam ser parecidos. Se sua equipe de inspeção usa um layout de planilha diferente por cultura, ou suas estações de amostragem têm modelos de diário diferentes, a IA ainda localiza os mesmos campos nomeados em todos eles — que é exatamente o cenário que quebra as ferramentas baseadas em modelo.
Para equipes que nunca veem os formulários no escritório, há um caminho mais simples para o pipeline: o link de coleta. Você gera um link compartilhável, envia para a equipe, e cada trabalhador de campo abre, insere um código de verificação curto e envia suas fotos diretamente para sua fila de processamento — sem conta, sem login. As fotos caem na mesma fila de lote que todo o resto. Se sua equipe já envia fotos ou digitalizações por e-mail, o recurso de caixa de entrada de e-mail dá à sua conta um endereço dedicado; encaminhar anexos para ele adiciona-os à fila automaticamente. Ambas são formas de eliminar completamente a etapa de "reunir os formulários no escritório".
Os arquivos são processados com segurança e não são armazenados.
Etapa 4: Revise o que a IA Extraiu (e Quando Confiar Nisso)
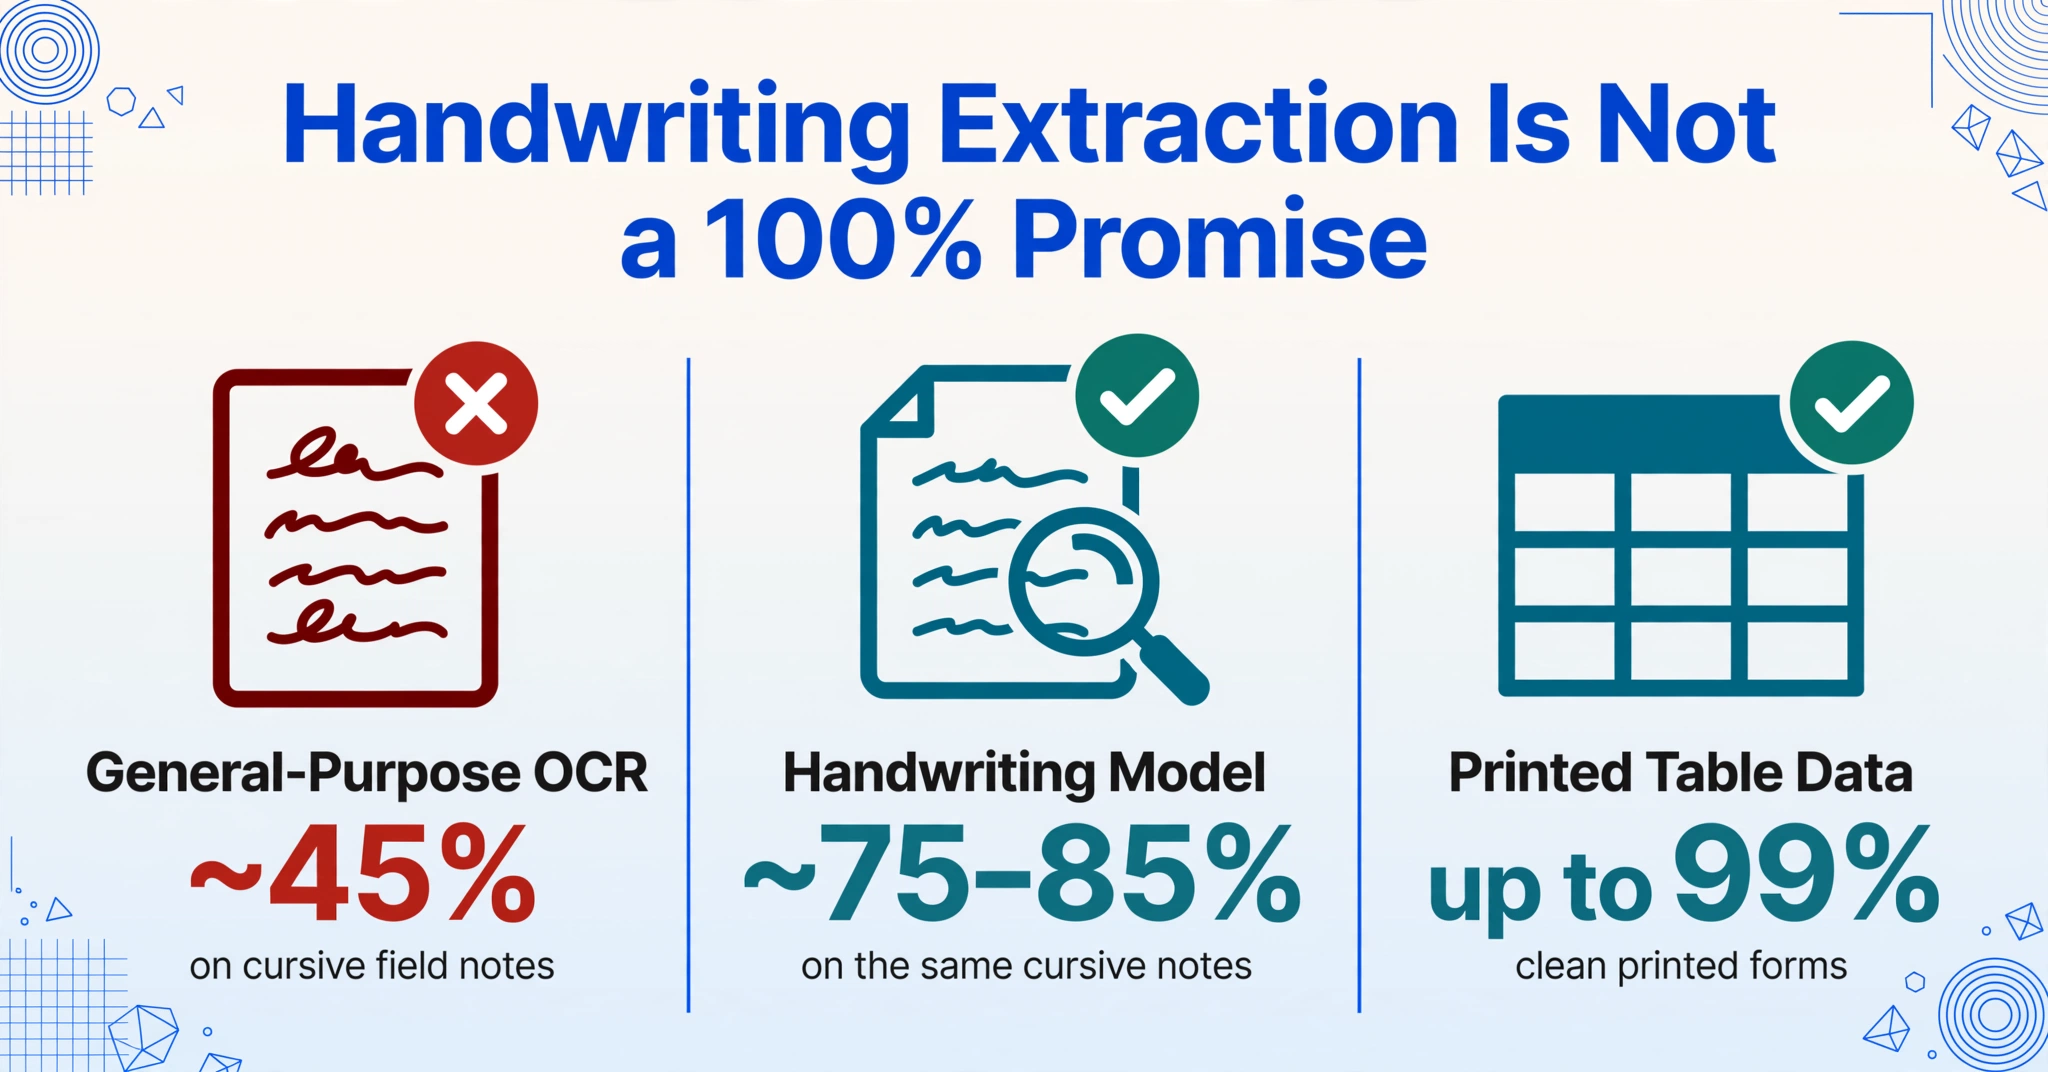
Compare as linhas extraídas com os originais — e quando a IA sinalizar uma leitura sobre a qual não tem certeza, verifique aquela célula, não a página inteira. A extração de caligrafia não é uma promessa de 100% de precisão, e qualquer ferramenta que afirme isso não está sendo honesta. Testes independentes com caligrafia bagunçada de técnicos de campo — documentados por uma equipe testando OCR em formulários de inspeção reais — descobriram que o OCR de uso geral cai para aproximadamente 45% de precisão em anotações de campo cursivas, enquanto modelos especializados em caligrafia alcançaram ~75–85% no mesmo conteúdo. Caligrafia legível em letras de forma extrai dramaticamente melhor do que cursiva apressada; isso é uma propriedade da entrada, não da ferramenta.
O que torna a extração prática apesar desse limite é um fluxo de trabalho de verificação que concentra a atenção humana onde é necessário. O modo de revisão do ImageToTable.ai com verificação assistida por caixa delimitadora faz isso: passe o mouse sobre qualquer célula extraída e a imagem original destaca o ponto exato de onde o valor veio; clique em uma região da imagem e ela salta para a célula correspondente. Você não está mais relendo cada linha — está verificando as poucas leituras sobre as quais a IA não tinha certeza, o que leva segundos por formulário em vez de minutos de redigitação. Editou um valor? Um clique mostra a leitura original da IA e permite reverter. Esta etapa de verificação também é exatamente onde a história de conformidade de antes é satisfeita: a confirmação do revisor é a verificação humana de que os registros "precisos, legíveis e indeléveis" são genuinamente precisos.
Para saber mais sobre o que realmente impulsiona a qualidade da extração em formulários externos bagunçados — tipo de caneta, condições de foto, nomenclatura de colunas — nosso guia de precisão para formulários de inspeção de campo cobre os mesmos princípios em profundidade.
Etapa 5: Coloque as Linhas Onde Seu Fluxo de Trabalho as Usa
A planilha extraída não é a linha de chegada — é o arquivo de importação para o que os dados de campo alimentam em seguida. O objetivo de todas as etapas anteriores é que a saída chegue em uma forma que seus sistemas existentes possam consumir: uma planilha limpa com cabeçalhos, uma linha por formulário, sem colunas soltas. O mesmo padrão de cinco etapas — capturar, definir colunas, processar em lote, revisar, alimentar o fluxo seguinte — se aplica a outros registros de campo, como os registros de manutenção que mostramos como transformar em um cronograma de manutenção preventiva funcional.
Na agricultura, essa planilha é importada para os sistemas de gestão agrícola que as equipes já usam — Climate FieldView, John Deere Operations Center, Granular ou Trimble Ag Software — ou para uma simples pasta de trabalho de atividades de campo se a operação roda em Excel. As contagens de pragas por campo e data viram a tabela de decisão de pulverização; as datas de plantio e hectares por campo viram a matéria-prima para o relatório de área plantada e os registros de produção do seguro agrícola. No trabalho ambiental, as mesmas linhas alimentam um sistema de gestão de dados ambientais como o EQuIS, ou um fluxo de coleta baseado em GIS como Survey123 ou Fulcrum, onde os IDs da estação e os carimbos de data/hora mapeiam as leituras para seus pontos de monitoramento — e a trilha de auditoria satisfaz o requisito de correspondência um a um do GQ/CQ.
Dois tipos de coluna tornam a planilha mais útil do que valores brutos. Uma coluna calculada permite que a IA faça aritmética durante a extração: defina Exceedance (pH > 8.5 ? "Yes" : "No") ou Total Pest Count (sum all traps) como uma coluna, e a saída contém o sinalizador ou o total, não apenas as leituras individuais. Isso elimina uma etapa de pós-processamento no Excel, incorporando-a à própria passagem de extração — útil quando uma excedência precisa ser tratada no mesmo dia em que a água é amostrada. Se, em vez disso, você precisar preservar o layout do formulário original — um formulário preenchido, pronto para arquivar — o modo Para Word gera a página como um documento editável com o layout intacto, o que atende a registros que devem ser enviados em formato de aparência original.
Perguntas Frequentes
Qual é a precisão da extração em formulários de campo manuscritos?
Escrita legível em letras de forma é extraída com alta precisão — dados em tabelas impressas chegam a até 99%. Caligrafia corrida e apressada reduz isso significativamente, com testes independentes em anotações de campo confusas mostrando OCR de uso geral em ~45% e modelos especializados em manuscritos em ~75–85%. A resposta prática está na etapa de verificação: sinalize e confira apenas as células sobre as quais a IA não tem certeza, usando o destaque por caixa delimitadora sobre a imagem original. Para formulários de campo, invista na qualidade da captura (superfície plana, bem iluminada, página inteira) — é a maior alavanca de precisão.
Ele consegue ler caixas de seleção, opções circuladas e texto misto?
Sim. O modelo de visão reconhece caixas marcadas, opções circuladas, assinaturas e valores manuscritos misturados com texto impresso. Para campos em que a equipe circula ou marca uma opção em vez de escrever um número, defina a coluna com as opções por extenso — Pressão de Pragas (opções: Baixa / Média / Alta) — para que a IA associe a marca ao rótulo correto em vez de tentar lê-la como texto.
E se minhas fotos de campo forem tiradas com pouca luz ou em ângulo?
A extração ainda tentará processá-las, mas a qualidade importa: sombras e reflexos obscurecem a escrita que um modelo não pode inventar. O modo de digitalização de documentos do celular corrige a perspectiva e achata a página, e sombrear a página com a própria sombra resolve a falha mais comum ao ar livre. Fotos legíveis para uma pessoa geralmente são legíveis para o modelo; fotos que são um borrão branco para uma pessoa serão um borrão branco para a IA também.
Minha equipe usa layouts de formulário diferentes por campo ou por estação. Isso atrapalha a extração?
Não — e este é exatamente o caso que quebra ferramentas baseadas em modelos. Como a Extração de Colunas Personalizadas localiza valores pelo significado e não por coordenadas, um lote pode misturar layouts diferentes e ainda retornar as mesmas colunas nomeadas. Uma estação com um modelo de diário de bordo diferente na mesma rodada simplesmente produz a mesma estrutura de linhas com seus valores preenchidos.
Quantos formulários posso processar de uma vez?
O processamento em lote lida com vários formulários em uma única execução e os mescla em um único arquivo Excel — uma linha por formulário. O limite prático depende da capacidade de lote do seu plano, mas o objetivo do design é que uma rodada inteira de amostragem ou um dia de inspeção passe de uma só vez, em vez de formulário por formulário.
Os trabalhadores de campo podem enviar formulários sem usar o fluxo de trabalho do escritório?
Sim, de duas maneiras. Um link de coleta permite que os membros da equipe abram uma URL, insiram um código de verificação e enviem fotos diretamente para a sua fila — sem necessidade de login ou conta. Alternativamente, o recurso de caixa de entrada de e-mail fornece um endereço dedicado para encaminhar digitalizações ou fotos, e com o processamento automático ativado, os anexos recebidos começam a ser extraídos assim que chegam.
O formulário nunca foi o gargalo — a etapa de redigitação era. Mantenha as pranchetas, mantenha os diários de campo e deixe a extração acontecer onde os dados já estão.
Quando as contagens de pragas de um inspetor de lavoura entram na planilha na mesma tarde em que são coletadas, a decisão de pulverização não fica esperando um fichário. Quando uma leitura de qualidade da água é sinalizada por excedência antes de a equipe sair da estação, o plano de monitoramento se torna proativo em vez de post-mortem. Essa é a mudança que as cinco etapas acima produzem: os dados de campo deixam de ser um registro do que aconteceu e passam a ser a entrada para o que acontece em seguida. Teste com seus próprios formulários — uma rodada, cinco etapas, e veja como fica a tarde quando a digitação desaparece.