Los datos de campo ya están recopilados —
el trabajo es llevarlos a Excel
Un explorador de cultivos llena una hoja de conteo de plagas en papel sobre una tabla sujetapapeles al borde de un campo, y luego la hoja viaja en una camioneta, una carpeta o una pila sobre el escritorio de la oficina hasta que alguien encuentra tiempo para escribirla en una hoja de cálculo. Un técnico de calidad del agua fotografía el libro de registro de un pozo de monitoreo al final de una ronda de muestreo, y las lecturas de pH y conductividad quedan en la galería de la cámara durante días. Los datos de campo —la parte más difícil de toda la operación— ya están registrados. Lo que toma toda la semana es el paso en el que alguien convierte esos formularios en filas. Ese paso es exactamente lo que este artículo elimina: cinco pasos, desde el formulario tal como existe en el campo hasta la hoja de cálculo que su flujo de trabajo realmente puede usar.
Conclusiones clave
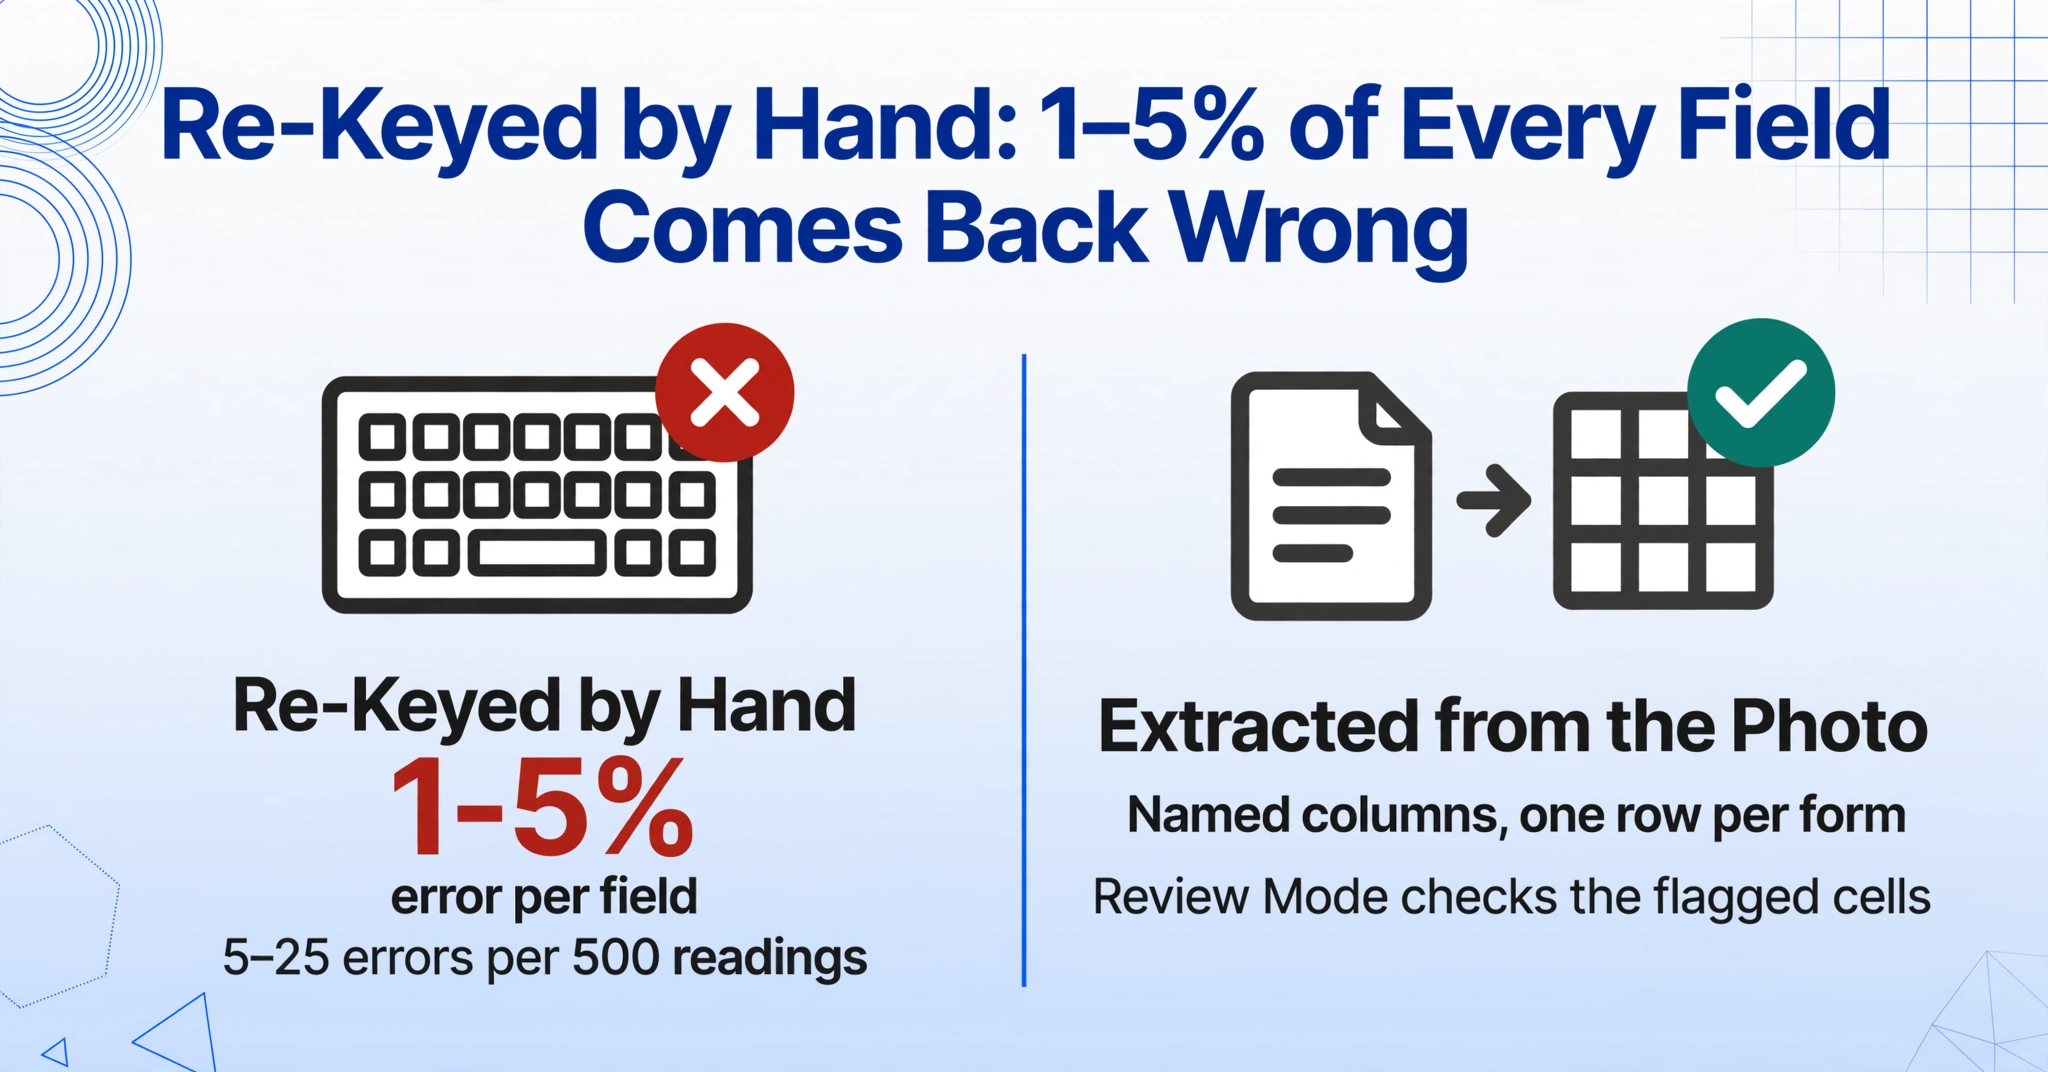
- Volver a escribir manualmente los datos de campo en hojas de cálculo conlleva una tasa de error documentada del 1–5% por campo y le cuesta a un laboratorio estatal 10,000 entradas manuales cada mes.
- Escribir más rápido no soluciona esto: el paso de volver a escribir en sí es el defecto estructural, porque cada número copiado crea un punto de falla que el formulario de campo original nunca tuvo.
- Fotografíe el formulario una vez y nombre sus columnas: la IA encuentra cada valor por lo que significa y llena la fila sin que nadie toque un teclado.
El formulario ya es el registro — la hoja de cálculo es el problema
El formulario de campo no es un paso intermedio. Es el registro principal de lo que ocurrió en el terreno — y la hoja de cálculo es donde ese registro se vuelve utilizable. La brecha entre ambos es trabajo puro y evitable.
Investigadores que entrevistaron a operadores de granjas pequeñas y medianas para un estudio de 2024 sobre prácticas de recopilación de datos agrícolas publicado en MIT capturaron con qué facilidad los registros de campo se escapan del alcance: "Ya sea que lo anotáramos o que simplemente lo recuerdes, oye, hay un problema de trigo en esta esquina del campo, tienes que prestarle atención en primavera y, con suerte, lo recuerdas — a veces no lo haces." Ese es el costo del papel: no el papel en sí, sino el hecho de que la información solo se convierte en datos cuando alguien actúa sobre ella, y actuar sobre ella significa que tiene que vivir en algún lugar buscable.
Los agricultores en r/farming que sí llevan registros describen exactamente esta división entre el campo y la oficina. Un hilo sobre cómo llevar registros enumera la pila típica: "hojas de seguimiento para todo el equipo, mantenimiento, resultados de siembra/cosecha, pruebas de suelo, planes de cultivo, boletas de carga, contenido de contenedores" — cada uno de ellos originalmente escrito a mano. El mismo patrón aparece en el monitoreo ambiental, donde los técnicos de campo llenan bitácoras en pozos, medidores de caudal y estaciones de monitoreo de aire que nadie vuelve a capturar de manera estructurada.
Esto no es una peculiaridad aislada del flujo de trabajo. El Laboratorio de Análisis de Suelos de Virginia Tech informa que en un marzo típico, la información de muestras de clientes para alrededor de 10,000 muestras de suelo debe escribirse a mano — 10,000 formularios de envío en papel, para un laboratorio estatal, en un solo mes. Eso es lo que parece la transcripción manual a escala institucional, y es exactamente el paso que el software de extracción reemplaza. Hemos escrito por separado sobre dónde se rompe realmente el flujo de datos de campo — esta guía es la solución.
Por qué el paso de reescritura es la parte que debe eliminarse
Los datos de campo escritos a mano presentan una tasa de error documentada de aproximadamente 1–5 % por campo cuando se vuelven a teclear manualmente, una cifra recopilada a lo largo de décadas de investigación sobre factores humanos y citada en una revisión de 2024 sobre el registro de datos en explotaciones agrícolas publicada en Precision Agriculture. En una ronda de muestreo de 500 puntos de datos, eso significa de 5 a 25 errores. Algunos son inofensivos. Los que importan son los dígitos transpuestos en una lectura de pH, el ID de campo incorrecto en un conteo de plagas o un nivel de agua que termina en la columna del vecino.
Tres marcos regulatorios en los Estados Unidos convierten esto de una preocupación de eficiencia en un requisito de mantenimiento de registros, y los tres comparten una suposición: que los registros de campo sean precisos, legibles y recuperables.
Las tres reglas convergen en la misma conclusión operativa: el registro debe existir en una forma que pueda buscarse, auditarse y entregarse. Esa es una propiedad de las hojas de cálculo, no de los portapapeles.
En qué debe convertirse un formulario de datos de campo
Antes de diseñar un flujo de extracción, vale la pena decidir qué campos de un formulario de campo alimentan realmente las decisiones posteriores. Una hoja de exploración de cultivos y un registro de calidad del agua tienen cada uno sus propios campos de alto valor, y las columnas que extraiga deben coincidir con los usos posteriores, no con cada línea de la página.
| Flujo de trabajo | Campos de alto valor | A qué alimentan |
|---|---|---|
| Exploración de cultivos | ID de campo, cultivo, etapa de crecimiento, conteo de plagas, presión de malezas, humedad del suelo | Recomendaciones de pulverización, tendencias de presión de plagas, planificación de cosecha, registros de producción del seguro de cosechas |
| Muestreo de suelo | ID de muestra, ID de campo, profundidad, fecha, notas de textura | Formularios de envío a laboratorio (como el acumulado de 10,000 al mes del laboratorio de VT), planificación de fertilidad, planes de manejo de nutrientes |
| Monitoreo de calidad del agua | ID de estación, fecha, hora, nivel del agua, pH, conductividad, oxígeno disuelto | Informes de cumplimiento, verificación de Garantía de Calidad/Control de Calidad frente a registros de campo, análisis de tendencias |
| Inspecciones de seguridad (operaciones de campo) | Fecha de inspección, ubicación, inspector, hallazgo, acción correctiva | Rastros de auditoría, seguimiento de acciones, registros de inspección regulatoria |
Dos patrones se repiten en los cuatro. Primero, los campos de identidad — ID de campo, ID de estación, ID de muestra, ubicación — son las claves de unión que le permiten ordenar, filtrar y comparar rondas de datos. Segundo, los campos de medición llevan unidades que importan más adelante (el pH no tiene unidades; la conductividad es µS/cm; el nivel del agua es en pies o metros). Ambos patrones guían cómo nombra sus columnas de extracción.
Paso 1: Capture el Formulario de la Manera que la IA Necesita Verlo
Tome una foto plana y bien iluminada de todo el formulario — o escanéelo si tiene un escáner cerca. La calidad de la extracción de los datos de campo escritos a mano comienza en la captura, y tres hábitos sencillos explican la mayor parte de la diferencia entre un primer intento limpio y uno frustrante.
¿Por qué la calidad de la captura importa tanto para la extracción? Porque el modelo de visión lee la página de la misma manera que lo haría una persona — si el texto es legible en la foto, se puede leer; si es un borrón blanco, ninguna herramienta de extracción, por buena que sea, puede recuperarlo. Lograr una buena foto es la palanca de precisión más económica en todo el flujo de trabajo.
Paso 2: Asigne nombres a las columnas que desea obtener
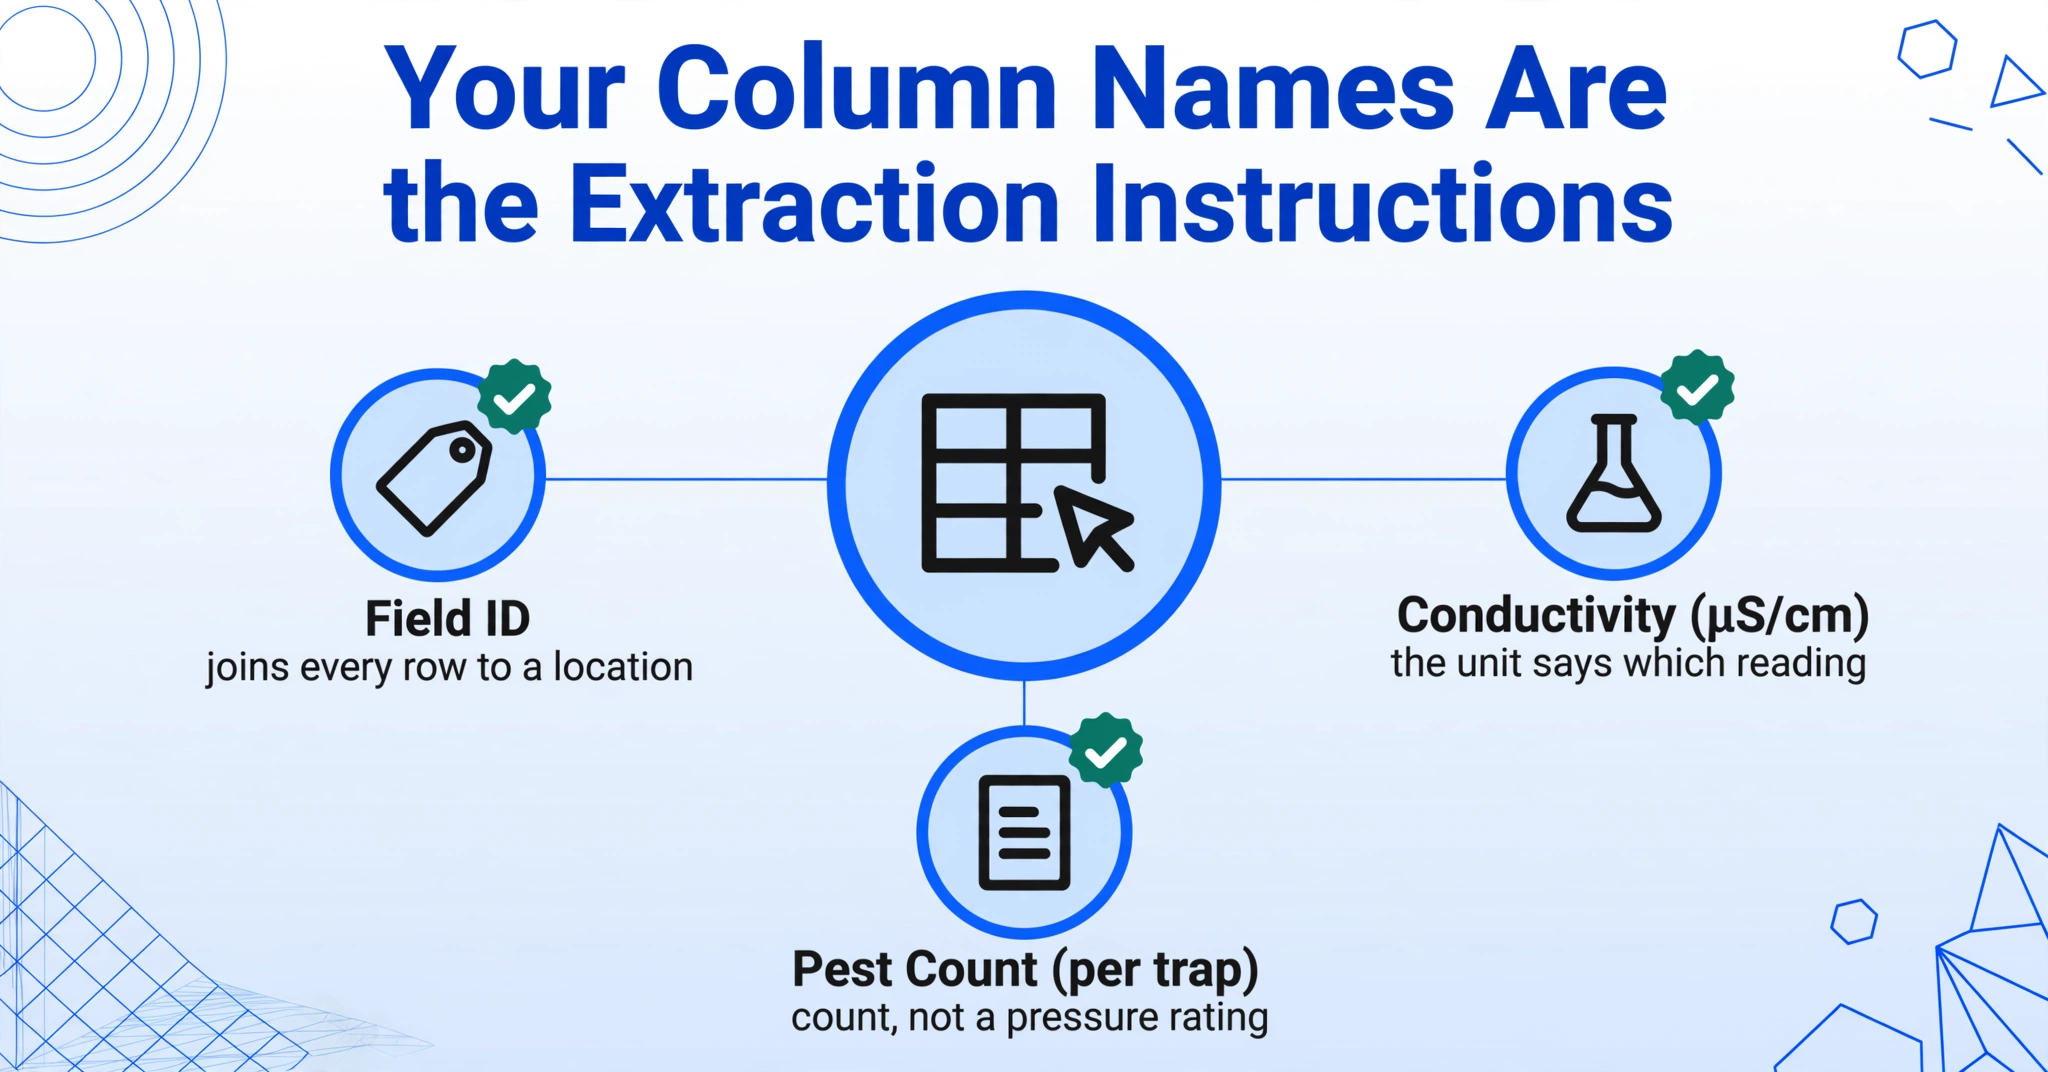
Escriba los nombres de los campos que desea como columnas de Excel: la IA localiza cada valor por lo que significa, no por dónde se encuentra en la página. Este es el mecanismo que ImageToTable.ai llama Extracción de Columnas Personalizadas: usted define la salida ("Conteo de plagas", "pH", "ID de estación"), y la IA lee el formulario, encuentra el valor que responde a cada nombre de columna y completa la fila. Es fundamentalmente diferente del OCR con plantilla, que requiere dibujar un cuadro alrededor de cada campo en un formulario de referencia y luego falla cuando la escritura del siguiente formulario queda fuera del cuadro.
Asignar nombres a las columnas es la decisión de mayor impacto en este flujo de trabajo: los nombres que escribe se convierten en los encabezados de la hoja de cálculo final y en las instrucciones semánticas para encontrar cada valor. Los buenos nombres se corresponden con la forma en que el propio formulario etiqueta los datos. Los nombres débiles son lo suficientemente ambiguos como para que la IA no pueda distinguir cuál de varios valores similares quiere decir:
| Tipo de formulario | Buenos nombres de columna | Por qué funcionan | Nombres débiles | Por qué fallan |
|---|---|---|---|---|
| Exploración de cultivos | ID de campo, Cultivo, Etapa de crecimiento, Conteo de plagas (por trampa), Presión de malezas (Baja/Media/Alta) | Coincide con las etiquetas del formulario; las unidades y opciones en el nombre resuelven la ambigüedad entre el conteo y la calificación de presión | Ubicación, Conteo, Etapa | "Conteo" podría ser conteo de plagas, conteo de plantas o conteo de trampas; "Etapa" podría ser etapa de crecimiento o etapa de muestreo |
| Calidad del agua | ID de estación, Nivel de agua (ft), pH, Conductividad (µS/cm), Oxígeno disuelto (mg/L) | Las unidades en el nombre le indican a la IA a qué columna pertenece cada lectura y desambiguan el OD del DBO u otras métricas de oxígeno | Pozo, Nivel, OD | "Nivel" podría ser nivel de agua o lectura del medidor; "OD" podría ser oxígeno disuelto o fecha de emisión |
| Inspección de seguridad | Fecha de inspección, Ubicación, Hallazgo, Acción correctiva, Nombre del inspector | Las etiquetas de campo coinciden con el formulario textualmente; cada una se asigna a un uso posterior | Fecha, Problema, Nombre | "Problema" podría ser el hallazgo, la fecha o un número de equipo; "Nombre" podría ser el inspector o un miembro del equipo |
También puede dejar que la IA infiera valores que no están escritos en el formulario. Una columna inferida como Categoría (opciones: Químico / Biológico / Físico) le indica a la IA que lea el contexto de monitoreo y clasifique cada lectura en una de las opciones listadas: una sola pasada que extrae y categoriza a la vez, lo cual es útil cuando los formularios de campo usan notas de texto libre en lugar de casillas de verificación. Para un recorrido más detallado sobre cómo la extracción semántica maneja formularios manuscritos campo por campo, consulte nuestra guía para extraer campos específicos de formularios manuscritos. Si primero desea ver el patrón de nombre de columna → hoja de cálculo aplicado a un tipo de documento similar, el flujo de trabajo de formulario manuscrito a Excel muestra la misma mecánica en un ejemplo más simple.
Paso 3: Cargue por lotes: un formulario, una fila
Cargue toda la ronda de formularios de una vez; cada formulario se convierte en una fila en una única hoja de cálculo combinada. Aquí es donde la extracción da resultados en el trabajo de campo, porque los datos de campo llegan por lotes de forma natural: una ronda de exploración cubre seis campos, un evento de muestreo cubre veinte estaciones, un día de inspección cubre todo un sitio. Procesarlos uno a la vez recrearía el cuello de botella manual, solo que con menos pulsaciones de teclas.
ImageToTable.ai está diseñado para procesamiento por lotes prioritario: usted carga varias fotos o escaneos, y la IA los procesa juntos y combina los resultados en un solo archivo de Excel: una fila por formulario, con los nombres de sus columnas como encabezado. Una ronda de 40 fotos de bitácoras de calidad del agua se convierte en 40 filas en una sola hoja en una sola ejecución. Los formularios tampoco necesitan verse iguales. Si su equipo de exploradores usa un diseño de hoja diferente por cultivo, o sus estaciones de muestreo tienen diferentes plantillas de bitácora, la IA igualmente localiza los mismos campos nombrados en todos ellos, que es precisamente el escenario que rompe las herramientas basadas en plantillas.
Para los equipos que nunca ven los formularios en la oficina, existe una ruta más simple hacia el flujo de trabajo: el enlace de recopilación. Usted genera un enlace compartible, lo envía al equipo, y cada trabajador de campo lo abre, ingresa un código de verificación corto y carga sus fotos directamente en su cola de procesamiento: sin cuenta, sin inicio de sesión. Las fotos llegan a la misma cola de lotes que todo lo demás. Si su equipo ya envía fotos o escaneos por correo electrónico, la función de bandeja de entrada de correo electrónico le da a su cuenta una dirección dedicada; reenviar archivos adjuntos a esa dirección los agrega a la cola automáticamente. Ambas son formas de eliminar por completo el paso de "reunir los formularios en la oficina".
Los archivos se procesan de forma segura y no se almacenan.
Paso 4: Revise lo que extrajo la IA (y cuándo confiar en ello)
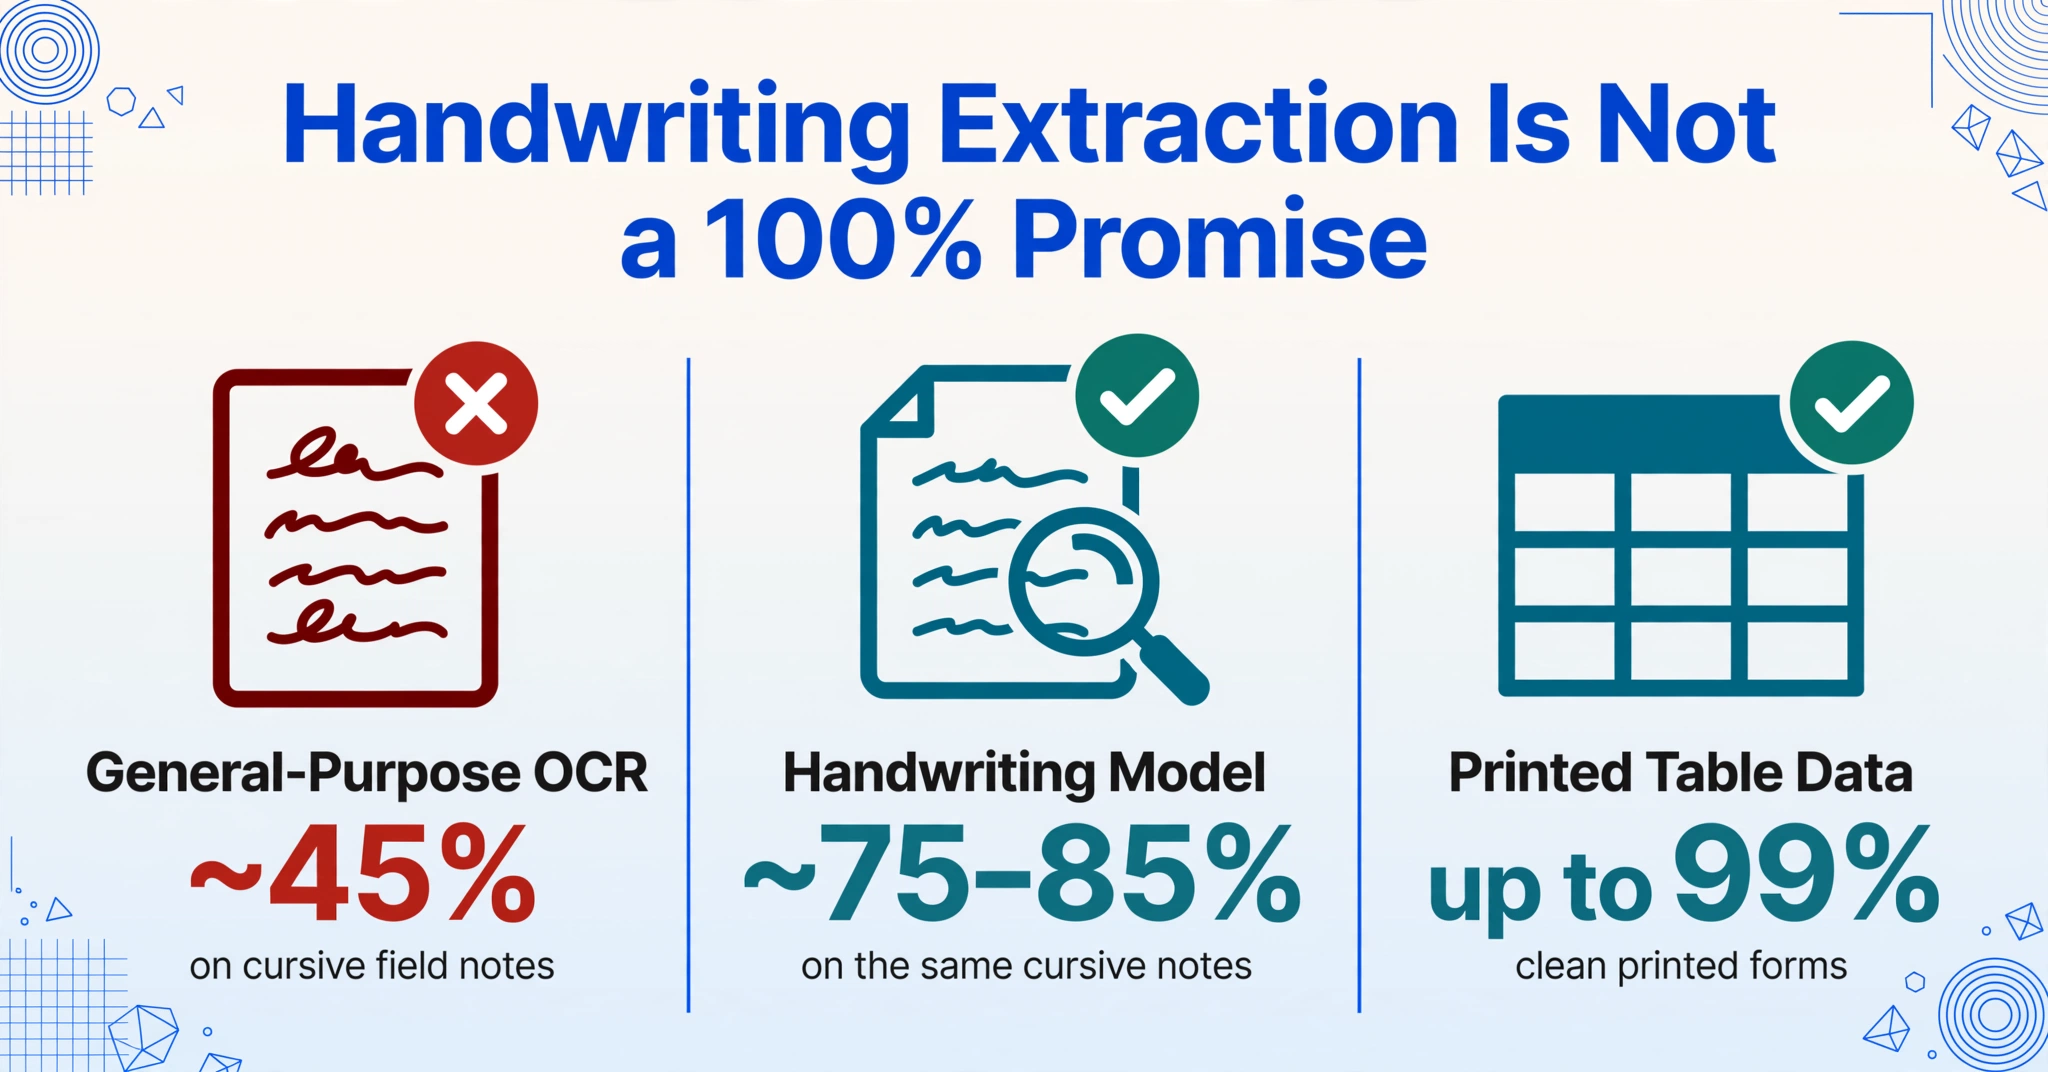
Compare las filas extraídas con los originales — y cuando la IA marque una lectura de la que no está segura, revise esa celda, no toda la página. La extracción de escritura manual no es una promesa de precisión del 100%, y cualquier herramienta que lo afirme no está siendo honesta. Las pruebas independientes con escritura desordenada de técnicos de campo — documentadas por un equipo que probó OCR en formularios de inspección reales — encontraron que el OCR de uso general caía a aproximadamente 45% de precisión en notas de campo en cursiva, mientras que los modelos especializados en escritura manual alcanzaban ~75–85% en el mismo contenido. La escritura legible en letra de molde se extrae dramáticamente mejor que la cursiva apresurada; eso es una propiedad de la entrada, no de la herramienta.
Lo que hace práctica la extracción a pesar de ese límite es un flujo de verificación que concentra la atención humana donde se necesita. El modo de revisión de ImageToTable.ai con verificación asistida por cuadro delimitador hace esto: pase el cursor sobre cualquier celda extraída y la imagen original resalta el punto exacto del que proviene el valor; haga clic en una región de la imagen y saltará a la celda correspondiente. Ya no tendrá que releer cada fila — solo revisará las pocas lecturas de las que la IA no estaba segura, lo que toma segundos por formulario en lugar de minutos de reescritura. ¿Editó un valor? Un clic muestra la lectura original de la IA y le permite revertirla. Este paso de verificación es también exactamente donde se satisface la historia de cumplimiento de antes: la confirmación del revisor es el control humano que garantiza que los registros "precisos, legibles e indelebles" sean genuinamente precisos.
Para más información sobre lo que realmente impulsa la calidad de extracción en formularios de campo desordenados — tipo de bolígrafo, condiciones de la foto, nombres de columnas — nuestra guía de precisión para formularios de inspección de campo cubre los mismos principios en profundidad.
Paso 5: Coloque las filas donde su flujo de trabajo las utiliza
La hoja de cálculo extraída no es la meta final: es el archivo de importación para lo que alimente los datos de campo a continuación. Todo el propósito de los pasos anteriores es que el resultado llegue en una forma que sus sistemas existentes puedan consumir: una hoja limpia con encabezados, una fila por formulario, sin columnas sobrantes. El mismo patrón de cinco pasos — capturar, definir columnas, procesar por lotes, revisar, alimentar los sistemas posteriores — se aplica a otros registros de campo, como los registros de mantenimiento que hemos mostrado cómo convertir en un cronograma de mantenimiento preventivo funcional.
En agricultura, esa hoja de cálculo se importa a los sistemas de gestión agrícola que los equipos ya utilizan — Climate FieldView, John Deere Operations Center, Granular o Trimble Ag Software — o a un libro de actividades de campo simple si la operación funciona con Excel. Los conteos de plagas por campo y fecha se convierten en la tabla de decisiones de pulverización; las fechas de siembra y acres por campo se convierten en la materia prima para el informe de superficie y los registros de producción del seguro de cosechas. En el trabajo ambiental, las mismas filas alimentan un sistema de gestión de datos ambientales como EQuIS, o un flujo de recopilación basado en GIS como Survey123 o Fulcrum, donde los ID de estación y las marcas de tiempo asignan las lecturas a sus puntos de monitoreo — y el rastro de auditoría satisface el requisito de correspondencia uno a uno de Garantía de Calidad/Control de Calidad.
Dos tipos de columnas hacen que la hoja de cálculo sea más útil que los valores brutos. Una columna calculada permite que la IA haga la aritmética durante la extracción: defina Exceedance (pH > 8.5 ? "Yes" : "No") o Total Pest Count (sum all traps) como una columna, y el resultado contiene el indicador o el total, no solo las lecturas individuales. Esto elimina un paso de posprocesamiento en Excel al integrarlo en la propia extracción — útil cuando se debe actuar sobre una excedencia el mismo día en que se muestrea el agua. Si en cambio necesita conservar el diseño del formulario original — un formulario completo, listo para archivar — el modo A Word genera la página como un documento editable con el diseño intacto, lo que es adecuado para registros que deben presentarse con su apariencia original.
Preguntas frecuentes
¿Qué tan precisa es la extracción en formularios de campo escritos a mano?
La escritura en letra de molde legible se extrae con alta precisión: los datos en tablas impresas alcanzan hasta un 99%. La escritura cursiva apresurada reduce esa cifra significativamente, con pruebas independientes en notas de campo desordenadas que muestran un OCR de propósito general en ~45% y modelos especializados en escritura a mano en ~75–85%. La respuesta práctica es el paso de verificación: marque y revise solo las celdas sobre las que la IA no está segura, usando el resaltado de cuadro delimitador contra la imagen original. Para formularios de campo, invierta en la calidad de captura (plano, bien iluminado, página completa): es la mayor palanca de precisión.
¿Puede leer casillas de verificación, opciones circuladas y texto mixto?
Sí. El modelo de visión reconoce casillas marcadas, opciones circuladas, firmas y valores escritos a mano mezclados con texto impreso. Para los campos donde el personal circula o marca una opción en lugar de escribir un número, defina la columna con las opciones escritas — Presión de Plagas (opciones: Baja / Media / Alta) — para que la IA asigne la marca a la etiqueta correcta en lugar de intentar leerla como texto.
¿Qué pasa si mis fotos de campo se toman con poca luz o en ángulo?
La extracción aún lo intentará, pero la calidad importa: las sombras y los reflejos ocultan la escritura que un modelo no puede inventar. El modo de escaneo de documentos del teléfono corrige la perspectiva y aplana la página, y sombrear la página con su propia sombra corrige la falla más común al aire libre. Las fotos que son legibles para una persona generalmente son legibles para el modelo; las fotos que son un borrón blanco para una persona también serán un borrón blanco para la IA.
Mi equipo usa diferentes diseños de formularios por campo o por estación. ¿Eso rompe la extracción?
No — y este es el caso que rompe específicamente las herramientas basadas en plantillas. Debido a que la Extracción de Columnas Personalizadas localiza los valores por significado en lugar de por coordenadas, un lote puede mezclar diferentes diseños y aún así devolver las mismas columnas nombradas. Una estación con una plantilla de libro de registro diferente en la misma ronda simplemente produce la misma estructura de filas con sus valores completados.
¿Cuántos formularios puedo procesar a la vez?
El procesamiento por lotes maneja múltiples formularios en una sola ejecución y los combina en un único archivo de Excel — una fila por formulario. El límite práctico depende de la capacidad de lote de su plan, pero el objetivo de diseño es que una ronda completa de muestreo o un día de exploración se procese de una sola pasada en lugar de formulario por formulario.
¿Pueden los trabajadores de campo enviar formularios sin usar el flujo de trabajo de la oficina?
Sí, de dos maneras. Un enlace de recopilación permite a los miembros del equipo abrir una URL, ingresar un código de verificación y subir fotos directamente a su cola — sin necesidad de inicio de sesión ni cuenta. Alternativamente, la función de bandeja de entrada de correo electrónico le brinda una dirección dedicada para reenviar escaneos o fotos, y con el procesamiento automático habilitado, los archivos adjuntos entrantes comienzan a extraerse tan pronto como llegan.
El formulario nunca fue el cuello de botella — el paso de volver a escribir lo era. Mantenga las tablillas y los cuadernos de registro, y deje que la extracción ocurra donde los datos ya están.
Cuando los conteos de plagas de un explorador de cultivos llegan a la hoja de cálculo la misma tarde en que se recopilan, la decisión de fumigación no espera a un archivador. Cuando una lectura de calidad del agua se marca por excedencia antes de que el equipo salga de la estación, el plan de monitoreo se vuelve proactivo en lugar de retrospectivo. Ese es el cambio que producen los cinco pasos anteriores: los datos de campo dejan de ser un registro de lo que sucedió y comienzan a ser el insumo para lo que sucede después. Pruébelo con sus propios formularios — una ronda, cinco pasos, y vea cómo se ve la tarde cuando la transcripción ya no existe.