Les données de terrain sont déjà collectées —
les mettre dans Excel, c'est là tout le travail
Un prospecteur de cultures remplit une fiche de comptage des nuisibles sur un bloc-notes au bord d'un champ, puis la fiche voyage dans un pick-up, un classeur ou une pile sur le bureau jusqu'à ce que quelqu'un trouve le temps de la saisir dans un tableur. Un technicien de la qualité de l'eau photographie le journal d'un puits de surveillance à la fin d'une tournée d'échantillonnage, et les relevés de pH et de conductivité restent sur l'appareil photo pendant des jours. Les données de terrain — la partie la plus difficilement gagnée de toute l'opération — sont déjà enregistrées. Ce qui prend toute la semaine, c'est l'étape où quelqu'un transforme ces formulaires en lignes. C'est exactement ce que cet article élimine : cinq étapes, du formulaire tel qu'il existe sur le terrain jusqu'au tableur que votre flux de travail peut réellement utiliser.
Points clés à retenir
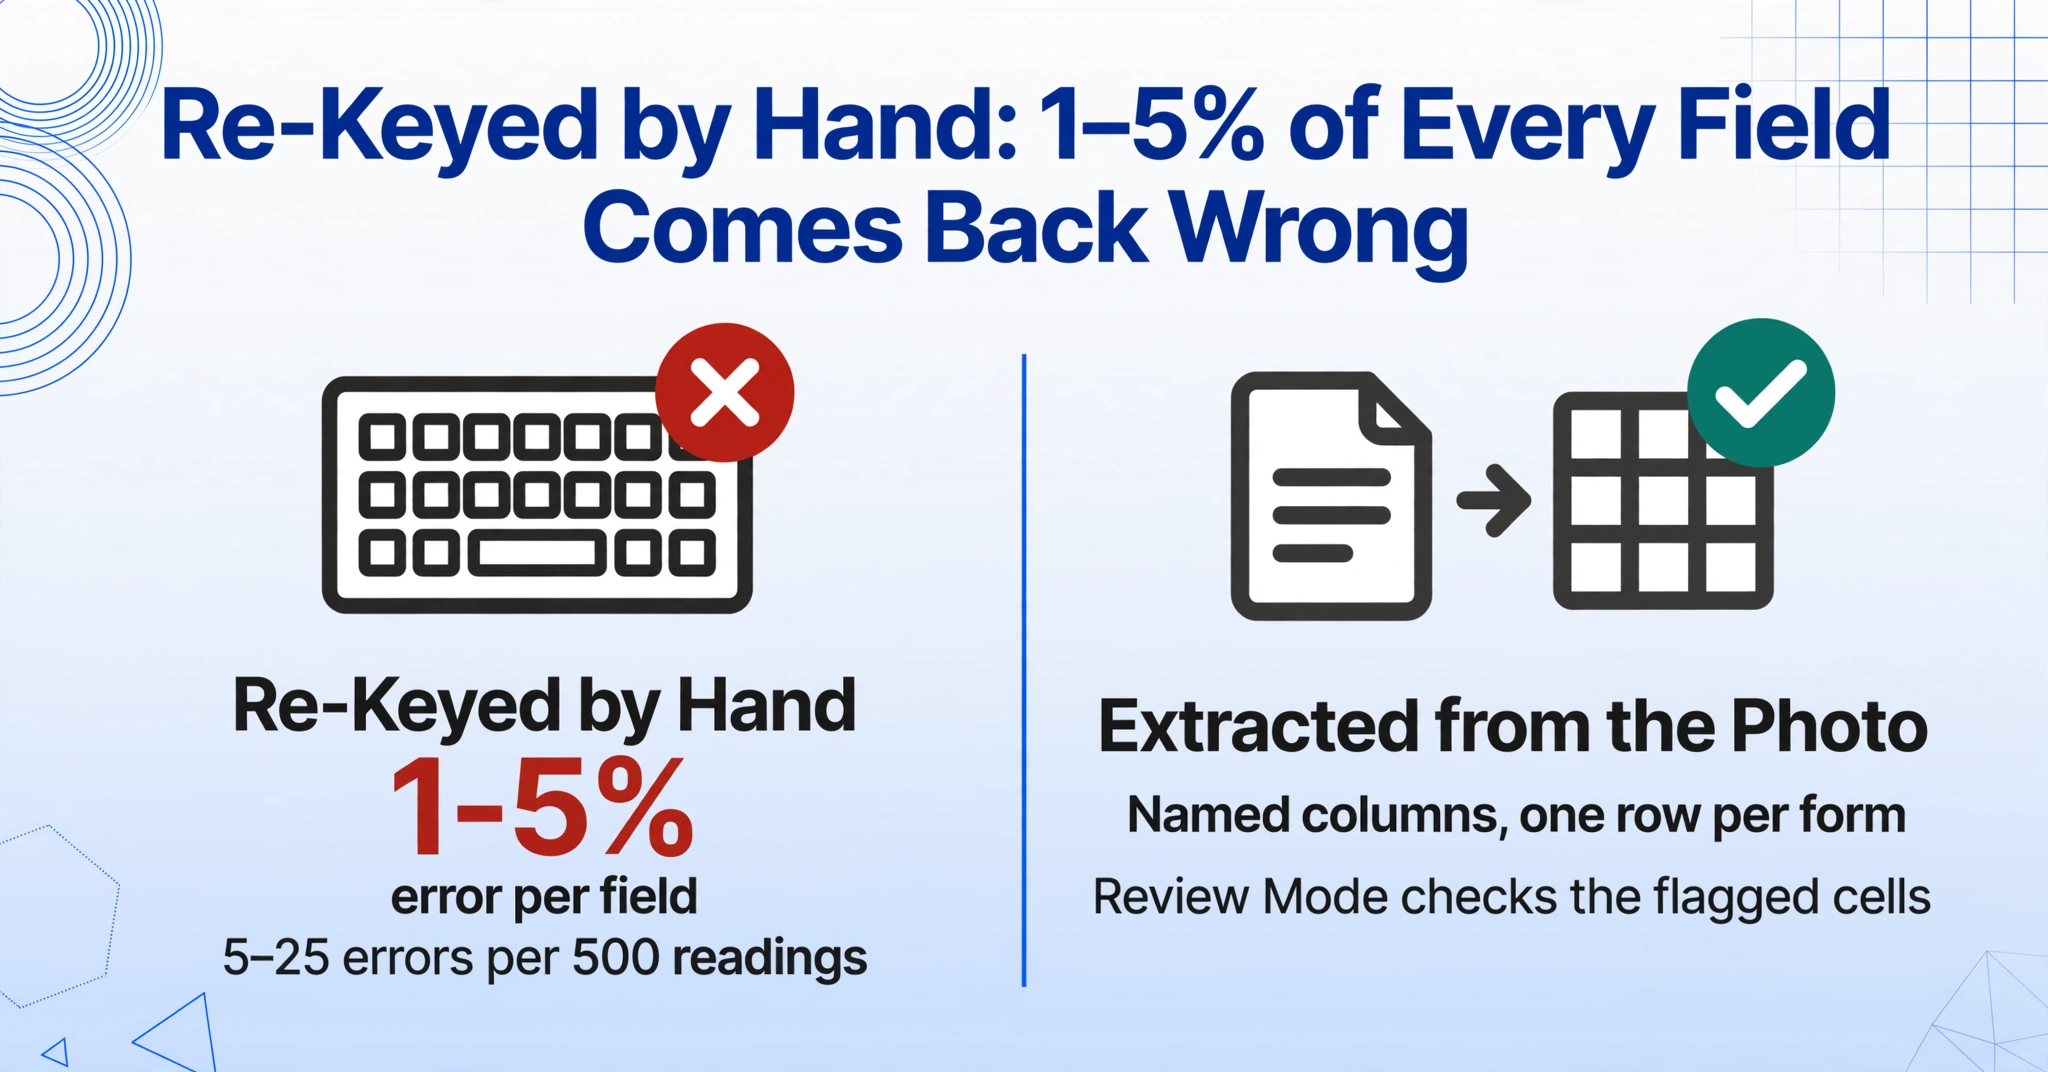
- La ressaisie manuelle des données de terrain dans des tableurs présente un taux d'erreur documenté de 1 à 5 % par champ et coûte à un laboratoire d'État 10 000 saisies manuelles chaque mois.
- Une saisie plus rapide ne résout pas ce problème — l'étape de ressaisie elle-même est le défaut structurel, car chaque chiffre copié crée un point de défaillance que le formulaire de terrain d'origine n'avait jamais.
- Photographiez le formulaire une fois et nommez vos colonnes — l'IA trouve chaque valeur selon sa signification et remplit la ligne sans que personne ne touche un clavier.
Le formulaire est déjà l'enregistrement — la feuille de calcul est le problème
Le formulaire de terrain n'est pas une étape intermédiaire. C'est l'enregistrement principal de ce qui s'est passé sur le terrain — et la feuille de calcul est l'endroit où cet enregistrement devient utilisable. L'écart entre les deux est un travail pur et évitable.
Les chercheurs qui ont interrogé des exploitants de petites et moyennes fermes pour une étude de 2024 sur les pratiques de collecte de données agricoles publiée au MIT ont capturé à quel point les enregistrements de terrain peuvent facilement échapper à la portée : « Que nous l'ayons écrit ou que vous vous en souveniez simplement, hé, il y a un problème de blé dans ce coin du champ, vous devez y prêter attention au printemps et, espérons-le, vous vous en souvenez — parfois non. » C'est le coût du papier : pas le papier lui-même, mais le fait que l'information ne devient des données que lorsque quelqu'un agit dessus, et agir dessus signifie qu'elle doit vivre quelque part de consultable.
Les agriculteurs sur r/farming qui tiennent des registres décrivent exactement cette scission entre le terrain et le bureau. Un fil sur la tenue de registres énumère la pile typique : « feuilles de suivi pour tout l'équipement, maintenance, résultats de semis/récolte, tests de sol, plans de culture, bons de chargement, contenus des silos » — chacun d'eux initialement écrit à la main. Le même schéma apparaît dans la surveillance environnementale, où les techniciens de terrain remplissent des journaux aux puits, aux jauges de cours d'eau et aux stations de surveillance de l'air que personne ne ressaisit de manière structurée.
Ce n'est pas une particularité de flux de travail isolée. Le Laboratoire d'analyse des sols de Virginia Tech rapporte qu'en mars typique, les informations d'échantillons clients pour environ 10 000 échantillons de sol doivent être saisies à la main — 10 000 formulaires de soumission papier, pour un laboratoire d'État, en un mois. C'est ce à quoi ressemble la transcription manuelle à l'échelle institutionnelle, et c'est exactement l'étape que le logiciel d'extraction remplace. Nous avons écrit séparément sur où le pipeline de données de terrain se brise réellement — ce guide est la solution.
Pourquoi l'étape de ressaisie est celle à supprimer
Les données de terrain manuscrites présentent un taux d'erreur documenté d'environ 1 à 5 % par champ lorsqu'elles sont ressaisies à la main — un chiffre établi à partir de décennies de recherche sur les facteurs humains et cité dans une revue de 2024 sur la tenue de registres agricoles publiée dans Precision Agriculture. Lors d'une campagne d'échantillonnage de 500 points de données, cela signifie 5 à 25 erreurs. Certaines sont sans gravité. Celles qui comptent sont les chiffres inversés dans une lecture de pH, le mauvais ID de parcelle sur un comptage des nuisibles, ou un niveau d'eau qui atterrit dans la colonne du voisin.
Trois cadres réglementaires aux États-Unis transforment cela d'une préoccupation d'efficacité en une exigence de tenue de registres, et tous trois partagent une hypothèse : que les registres de terrain sont exacts, lisibles et récupérables.
Les trois règles convergent vers la même conclusion opérationnelle : l'enregistrement doit exister sous une forme qui peut être recherchée, auditée et transmise. C'est une propriété des feuilles de calcul, pas des presse-papiers.
Ce que doit devenir un formulaire de données de terrain
Avant de concevoir un flux d'extraction, il convient de déterminer quels champs d'un formulaire de terrain alimentent réellement les décisions en aval. Une feuille de prospection des cultures et un journal de bord de la qualité de l'eau ont chacun leurs champs à forte valeur ajoutée, et les colonnes que vous extrayez doivent correspondre aux usages en aval — pas à chaque ligne de la page.
| Flux de travail | Champs à forte valeur ajoutée | Ce qu'ils alimentent |
|---|---|---|
| Prospection des cultures | ID de parcelle, Culture, Stade de croissance, Comptage des nuisibles, Pression des adventices, Humidité du sol | Recommandations de pulvérisation, tendances de pression des nuisibles, planification des récoltes, registres de production pour l'assurance récolte |
| Échantillonnage de sol | ID d'échantillon, ID de parcelle, Profondeur, Date, Notes sur la texture | Formulaires de soumission en laboratoire (comme l'arriéré de 10 000 par mois du laboratoire VT), planification de la fertilité, plans de gestion des nutriments |
| Surveillance de la qualité de l'eau | ID de station, Date, Heure, Niveau d'eau, pH, Conductivité, Oxygène dissous | Rapports de conformité, vérification AQ/CQ par rapport aux journaux de terrain, analyse des tendances |
| Inspections de sécurité (opérations terrain) | Date d'inspection, Lieu, Inspecteur, Constat, Mesure corrective | Pistes d'audit, suivi des actions, registres d'inspection réglementaire |
Deux schémas se répètent dans les quatre cas. Premièrement, les champs d'identité — ID de parcelle, ID de station, ID d'échantillon, lieu — sont les clés de jointure qui vous permettent de trier, filtrer et comparer les séries de données. Deuxièmement, les champs de mesure portent des unités qui comptent en aval (le pH n'a pas d'unités ; la conductivité est en µS/cm ; le niveau d'eau est en pieds ou en mètres). Ces deux schémas guident la façon dont vous nommez vos colonnes d'extraction.
Étape 1 : Capturez le formulaire comme l'IA doit le voir
Prenez une photo plane et bien éclairée de l'ensemble du formulaire — ou scannez-le si un scanner est à proximité. La qualité d'extraction des données de terrain manuscrites commence à la capture, et trois habitudes simples expliquent la plupart des différences entre une première tentative réussie et une expérience frustrante.
Pourquoi la qualité de capture est-elle si importante pour l'extraction ? Parce que le modèle de vision lit la page de la même manière qu'une personne — si le texte est lisible sur la photo, il peut être lu ; s'il s'agit d'un flou blanc, aucun outil d'extraction, aussi bon soit-il, ne peut le récupérer. Bien réussir la photo est le levier de précision le plus économique de tout le flux de travail.
Étape 2 : Nommez les colonnes que vous souhaitez obtenir
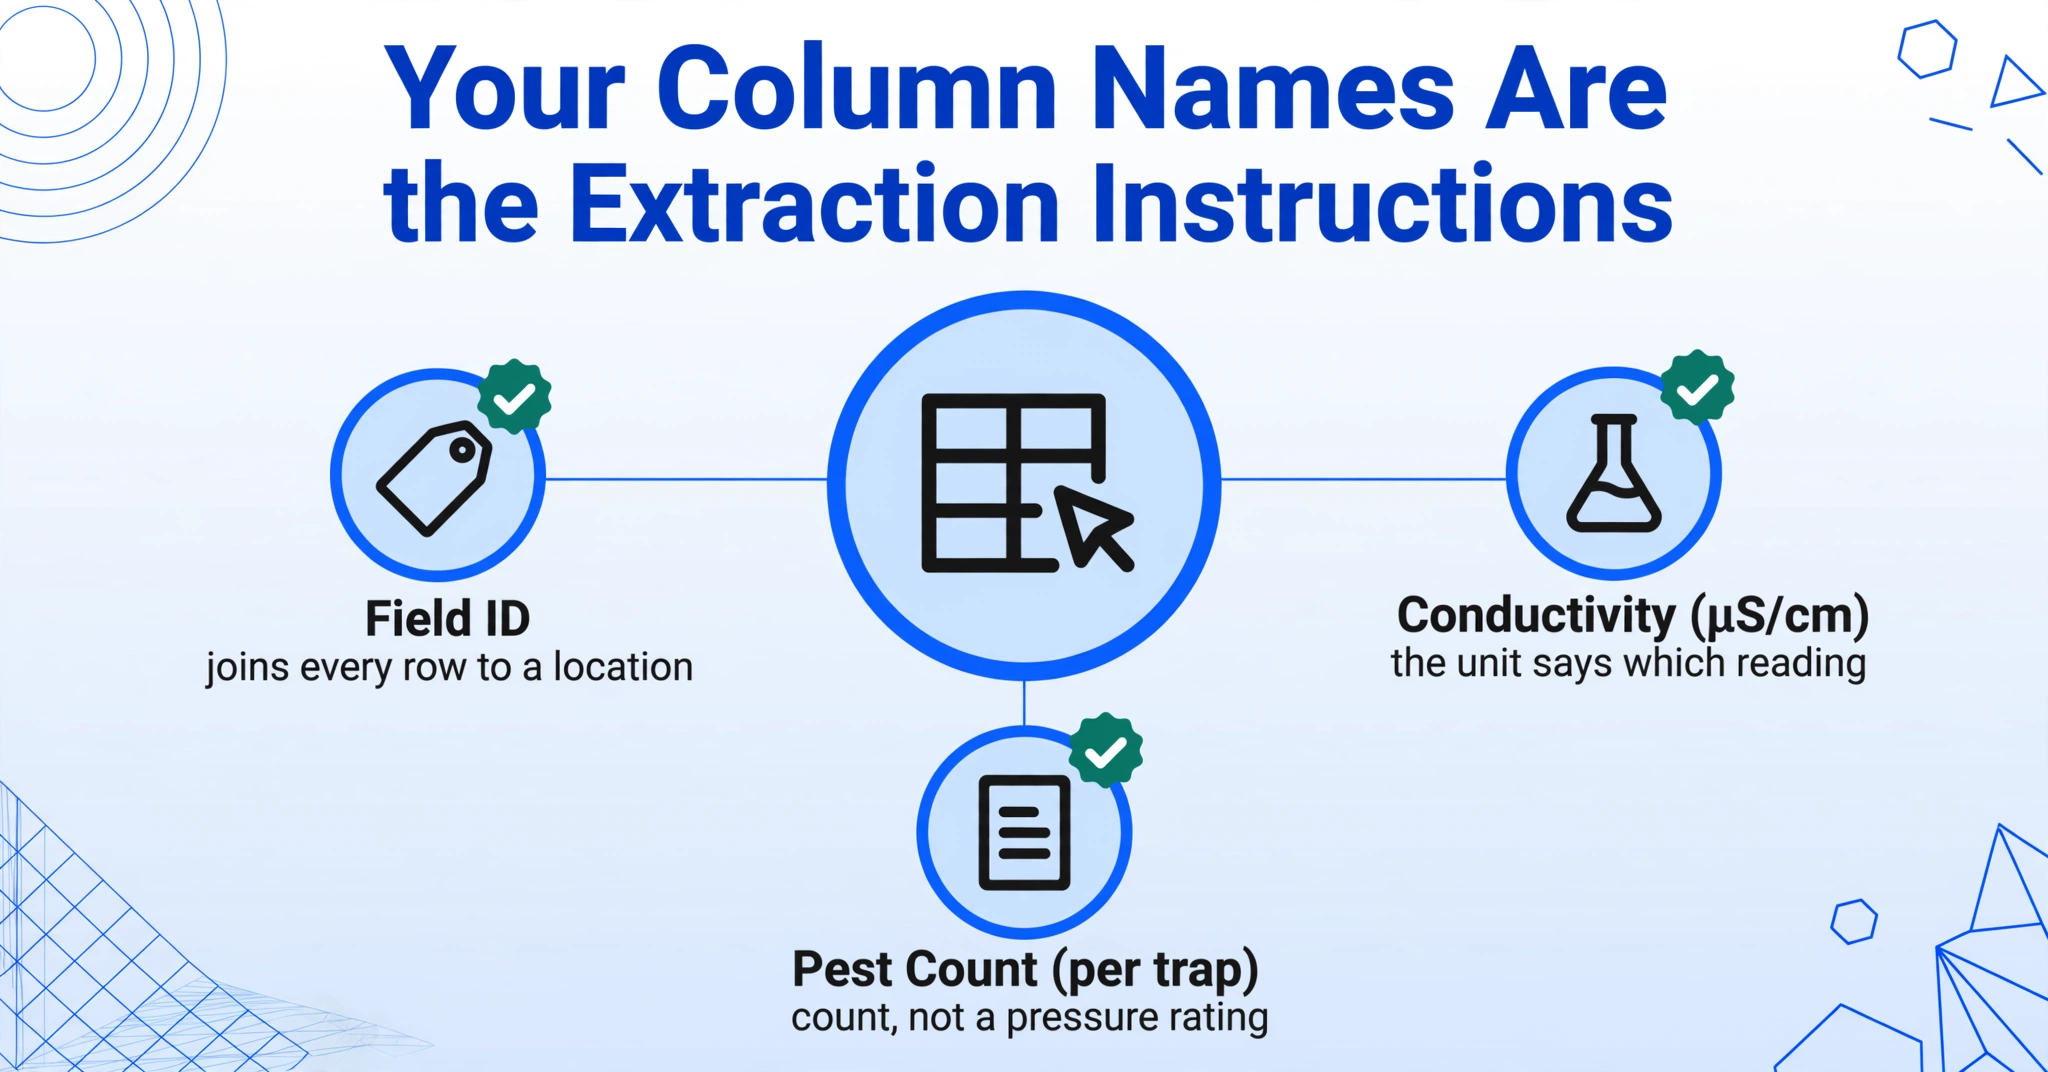
Saisissez les noms de champs que vous voulez comme colonnes Excel — l'IA localise chaque valeur par ce qu'elle signifie, et non par son emplacement sur la page. C'est le mécanisme qu'ImageToTable.ai appelle Extraction de colonnes personnalisées : vous définissez la sortie (« Comptage des nuisibles », « pH », « ID de station »), et l'IA lit le formulaire, trouve la valeur qui répond à chaque nom de colonne et remplit la ligne. C'est fondamentalement différent de l'OCR basé sur un modèle, qui exige de dessiner une boîte autour de chaque champ sur un formulaire de référence, puis échoue lorsque l'écriture manuscrite du formulaire suivant tombe en dehors de la boîte.
Le nommage des colonnes est la décision la plus stratégique de ce flux de travail — les noms que vous saisissez deviennent les en-têtes de la feuille de calcul finale et les instructions sémantiques pour trouver chaque valeur. De bons noms correspondent à la façon dont le formulaire lui-même étiquette les données. Des noms faibles sont suffisamment ambigus pour que l'IA ne puisse pas distinguer laquelle de plusieurs valeurs similaires vous voulez :
| Type de formulaire | Bons noms de colonnes | Pourquoi ils fonctionnent | Noms faibles | Pourquoi ils échouent |
|---|---|---|---|---|
| Prospection de cultures | ID de parcelle, Culture, Stade de croissance, Comptage des nuisibles (par piège), Pression des adventices (Faible/Moyenne/Forte) | Correspond aux étiquettes du formulaire ; les unités et options dans le nom lèvent l'ambiguïté entre le comptage et la note de pression | Emplacement, Comptage, Stade | « Comptage » pourrait être le comptage des nuisibles, des plantes ou des pièges ; « Stade » pourrait être le stade de croissance ou le stade d'échantillonnage |
| Qualité de l'eau | ID de station, Niveau d'eau (pi), pH, Conductivité (µS/cm), Oxygène dissous (mg/L) | Les unités dans le nom indiquent à l'IA à quelle colonne chaque lecture appartient et distinguent l'OD de la DBO ou d'autres mesures d'oxygène | Puits, Niveau, OD | « Niveau » pourrait être le niveau d'eau ou la lecture de la jauge ; « OD » pourrait être l'oxygène dissous ou la date d'émission |
| Inspection de sécurité | Date d'inspection, Emplacement, Constat, Mesure corrective, Nom de l'inspecteur | Les étiquettes de champs correspondent au formulaire mot pour mot ; chacune correspond à un usage en aval | Date, Problème, Nom | « Problème » pourrait être le constat, la date ou un numéro d'équipement ; « Nom » pourrait être l'inspecteur ou un membre de l'équipe |
Vous pouvez aussi laisser l'IA inférer des valeurs qui ne sont pas écrites sur le formulaire. Une colonne inférée comme Catégorie (options : Chimique / Biologique / Physique) demande à l'IA de lire le contexte de surveillance et de classer chaque relevé dans l'une des options listées — un seul passage qui extrait et catégorise à la fois, utile lorsque les formulaires de terrain utilisent des notes en texte libre plutôt que des cases à cocher. Pour une présentation plus détaillée de la façon dont l'extraction sémantique traite les formulaires manuscrits champ par champ, consultez notre guide d'extraction de champs spécifiques à partir de formulaires manuscrits. Si vous voulez d'abord voir le modèle nom-de-colonne → feuille de calcul appliqué à un type de document similaire, le flux de travail formulaire manuscrit vers Excel montre les mêmes mécanismes sur un exemple plus simple.
Étape 3 : Téléversement par lots — un formulaire, une ligne
Téléversez toute la série de formulaires d'un coup ; chaque formulaire devient une ligne dans une seule feuille de calcul fusionnée. C'est là que l'extraction porte ses fruits pour le travail de terrain, car les données de terrain arrivent naturellement par lots — une tournée de prospection couvre six parcelles, un événement d'échantillonnage couvre vingt stations, une journée d'inspection couvre tout un site. Les traiter un par un recréerait le goulot d'étranglement manuel, juste avec moins de frappes.
ImageToTable.ai est conçu pour le traitement par lots en priorité : vous téléversez plusieurs photos ou scans, et l'IA les traite ensemble et fusionne les résultats dans un seul fichier Excel — une ligne par formulaire, avec vos noms de colonnes comme en-tête. Une série de 40 photos de cahiers de bord sur la qualité de l'eau devient 40 lignes dans une seule feuille en une seule exécution. Les formulaires n'ont pas besoin de se ressembler non plus. Si votre équipe de prospection utilise une mise en page différente par culture, ou si vos stations d'échantillonnage ont des modèles de cahiers de bord différents, l'IA localise toujours les mêmes champs nommés sur tous — c'est précisément le scénario qui casse les outils basés sur des modèles.
Pour les équipes qui ne voient jamais les formulaires au bureau, il existe un chemin plus simple vers le pipeline : le lien de collecte. Vous générez un lien partageable, vous l'envoyez à l'équipe, et chaque travailleur de terrain l'ouvre, saisit un court code de vérification et téléverse ses photos directement dans votre file de traitement — sans compte, sans connexion. Les photos arrivent dans la même file de traitement que tout le reste. Si votre équipe envoie déjà des photos ou des scans par e-mail, la fonctionnalité de boîte de réception e-mail donne à votre compte une adresse dédiée ; le transfert des pièces jointes vers cette adresse les ajoute automatiquement à la file. Ces deux options éliminent l'étape « rassembler les formulaires au bureau ».
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Étape 4 : Vérifiez ce que l'IA a extrait (et quand lui faire confiance)
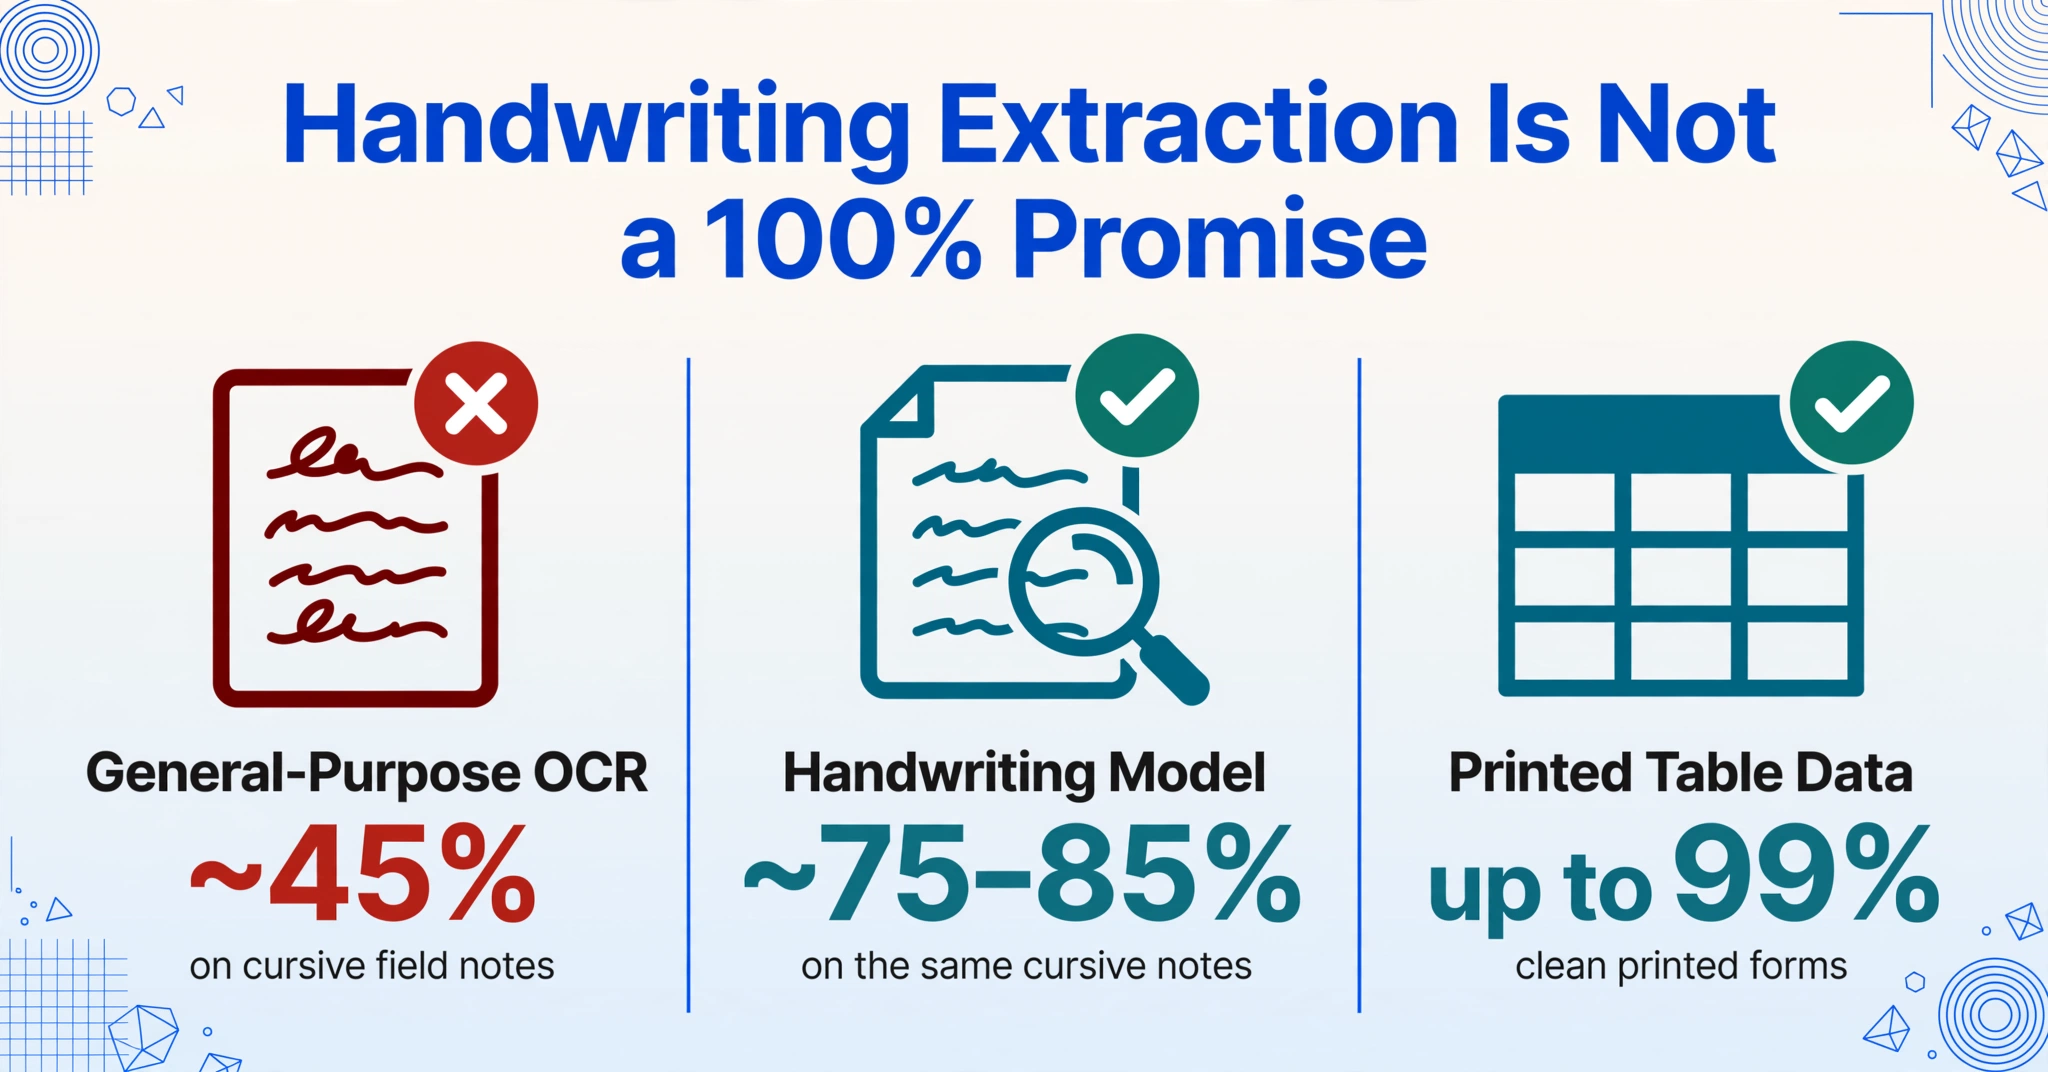
Comparez les lignes extraites aux originaux — et lorsque l'IA signale une lecture dont elle n'est pas sûre, vérifiez cette cellule-là, pas toute la page. L'extraction d'écriture manuscrite n'est pas une promesse de précision à 100 %, et tout outil qui le prétend n'est pas honnête. Des tests indépendants sur l'écriture manuscrite brouillonne de techniciens de terrain — documentés par une équipe testant l'OCR sur de vrais formulaires d'inspection — ont montré que l'OCR à usage général chutait à environ 45 % de précision sur les notes de terrain cursives, tandis que les modèles spécialisés en écriture manuscrite atteignaient ~75–85 % sur le même contenu. Une écriture en lettres majuscules lisibles s'extrait nettement mieux qu'une cursive rapide ; c'est une propriété de la saisie, pas de l'outil.
Ce qui rend l'extraction pratique malgré cette limite, c'est un flux de vérification qui concentre l'attention humaine là où elle est nécessaire. Le mode de révision d'ImageToTable.ai avec vérification assistée par boîte englobante fait exactement cela : survolez n'importe quelle cellule extraite et l'image d'origine met en évidence l'endroit exact d'où provient la valeur ; cliquez sur une région de l'image et elle saute à la cellule correspondante. Vous ne relisez plus chaque ligne — vous vérifiez la poignée de lectures dont l'IA n'était pas sûre, ce qui prend quelques secondes par formulaire au lieu de minutes de ressaisie. Vous avez modifié une valeur ? Un clic affiche la lecture originale de l'IA et vous permet de revenir en arrière. Cette étape de vérification est aussi précisément là où l'histoire de conformité évoquée plus tôt trouve sa satisfaction : la confirmation du réviseur est le contrôle humain qui garantit que les enregistrements « précis, lisibles et indélébiles » sont réellement précis.
Pour en savoir plus sur ce qui détermine réellement la qualité de l'extraction sur des formulaires extérieurs désordonnés — type de stylo, conditions de photo, nommage des colonnes — notre guide de précision pour les formulaires d'inspection de terrain couvre les mêmes principes en profondeur.
Étape 5 : Placez les lignes là où votre flux de travail les utilise
La feuille de calcul extraite n'est pas la ligne d'arrivée — c'est le fichier d'importation pour ce que les données de terrain alimentent ensuite. Tout l'intérêt des étapes précédentes est que la sortie arrive sous une forme que vos systèmes existants peuvent consommer : une feuille propre avec des en-têtes, une ligne par formulaire, aucune colonne parasite. Le même schéma en cinq étapes — capture, définition des colonnes, traitement par lots, révision, alimentation en aval — s'applique à d'autres enregistrements de terrain, comme les journaux de maintenance dont nous avons montré comment les transformer en calendrier de maintenance préventive fonctionnel.
En agriculture, cette feuille de calcul s'importe dans les systèmes de gestion agricole que les équipes utilisent déjà — Climate FieldView, John Deere Operations Center, Granular ou Trimble Ag Software — ou dans un simple classeur d'activités de terrain si l'exploitation fonctionne sous Excel. Les comptages des nuisibles par parcelle et par date deviennent le tableau de décision de pulvérisation ; les dates de plantation et les superficies par parcelle deviennent la matière première du rapport de superficie et des registres de production pour l'assurance récolte. Dans le travail environnemental, les mêmes lignes alimentent un système de gestion des données environnementales comme EQuIS, ou un flux de collecte basé sur SIG comme Survey123 ou Fulcrum, où les ID de station et les horodatages associent les lectures à leurs points de surveillance — et la piste d'audit satisfait à l'exigence de correspondance un-à-un de l'AQ/CQ.
Deux types de colonnes rendent la feuille de calcul plus utile que les valeurs brutes. Une colonne calculée permet à l'IA de faire l'arithmétique pendant l'extraction : définissez Dépassement (pH > 8,5 ? "Oui" : "Non") ou Comptage total des nuisibles (somme de tous les pièges) comme colonne, et la sortie contient le drapeau ou le total, pas seulement les lectures individuelles. Cela élimine une étape de post-traitement dans Excel en la fusionnant dans la passe d'extraction elle-même — utile lorsqu'un dépassement doit être traité le jour même de l'échantillonnage de l'eau. Si vous avez plutôt besoin de préserver la mise en page du formulaire d'origine — un formulaire rempli, prêt à être classé — le mode Vers Word génère la page sous forme de document modifiable avec la mise en page intacte, ce qui convient aux enregistrements qui doivent être soumis sous leur forme d'origine.
FAQ
Quelle est la précision de l'extraction sur les formulaires de terrain manuscrits ?
L'écriture en lettres capitales lisibles est extraite avec une grande précision — les données de tableaux imprimés atteignent jusqu'à 99 %. L'écriture cursive rapide fait chuter ce taux de manière significative, des tests indépendants sur des notes de terrain brouillonnes montrant une OCR généraliste à ~45 % et des modèles spécialisés en écriture manuscrite à ~75–85 %. La réponse pratique réside dans l'étape de vérification : signaler et contrôler uniquement les cellules dont l'IA n'est pas sûre, à l'aide d'une vérification assistée par boîte englobante sur l'image d'origine. Pour les formulaires de terrain, investissez dans la qualité de capture (à plat, bien éclairé, page entière) — c'est le levier de précision le plus important.
Peut-il lire les cases à cocher, les options encerclées et le texte mixte ?
Oui. Le modèle de vision reconnaît les cases cochées, les options encerclées, les signatures et les valeurs manuscrites mélangées au texte imprimé. Pour les champs où les membres de l'équipe encerclent ou cochent une option plutôt que d'écrire un nombre, définissez la colonne avec les options écrites en toutes lettres — Pression des adventices (options : Faible / Moyenne / Élevée) — afin que l'IA associe la marque à la bonne étiquette au lieu d'essayer de la lire comme du texte.
Que se passe-t-il si mes photos de terrain sont prises dans une mauvaise lumière ou en angle ?
L'extraction tentera quand même de les traiter, mais la qualité compte : les ombres et les reflets masquent une écriture qu'un modèle ne peut pas inventer. Le mode de numérisation de documents du téléphone corrige la perspective et aplatit la page, et ombrager la page avec votre propre ombre corrige la panne extérieure la plus courante. Les photos qui sont lisibles pour une personne sont généralement lisibles pour le modèle ; les photos qui sont un flou blanc pour une personne seront un flou blanc pour l'IA aussi.
Mon équipe utilise différentes mises en page de formulaires selon la parcelle ou la station. Cela casse-t-il l'extraction ?
Non — et c'est précisément le cas qui casse les outils basés sur des modèles. Parce que l'Extraction de colonnes personnalisées localise les valeurs par leur sens plutôt que par leurs coordonnées, un lot peut mélanger différentes mises en page et renvoyer toujours les mêmes colonnes nommées. Une station avec un modèle de journal différent dans le même cycle produit simplement la même structure de lignes avec ses valeurs remplies.
Combien de formulaires puis-je traiter à la fois ?
Le traitement par lots gère plusieurs formulaires en une seule exécution et les fusionne dans un seul fichier Excel — une ligne par formulaire. La limite pratique dépend de la capacité de lots de votre forfait, mais l'objectif de conception est qu'une session complète d'échantillonnage ou une journée de prospection passe en une seule fois plutôt que formulaire par formulaire.
Les travailleurs de terrain peuvent-ils envoyer des formulaires sans utiliser le flux de travail du bureau ?
Oui, de deux façons. Un lien de collecte permet aux membres de l'équipe d'ouvrir une URL, de saisir un code de vérification et de téléverser des photos directement dans votre file d'attente — sans connexion ni compte. Alternativement, la fonctionnalité de boîte de réception e-mail vous fournit une adresse dédiée pour transférer des scans ou des photos, et avec le traitement automatique activé, les pièces jointes entrantes commencent à être extraites dès leur arrivée.
Le formulaire n'a jamais été le goulot d'étranglement — c'était la ressaisie. Gardez les blocs-notes et les journaux, et laissez l'extraction se faire là où les données se trouvent déjà.
Lorsque les comptages de nuisibles d'un prospecteur de cultures arrivent dans le tableur le même après-midi qu'ils sont collectés, la décision de pulvérisation n'attend pas un classeur. Lorsqu'une lecture de qualité de l'eau est signalée comme dépassement avant que l'équipe ne quitte la station, le plan de surveillance devient proactif au lieu d'être rétrospectif. C'est le changement que produisent les cinq étapes ci-dessus : les données de terrain cessent d'être un enregistrement de ce qui s'est passé et deviennent l'entrée pour ce qui se passe ensuite. Testez-le sur vos propres formulaires — une session, cinq étapes, et voyez à quoi ressemble l'après-midi quand la saisie a disparu.