フィールドデータはすでに収集済み —
Excelに移すのが作業だ
作物調査員が圃場の端でクリップボードに手書きの害虫数シートを記入し、そのシートはピックアップトラック、バインダー、またはオフィスの机の山の中を移動し、誰かがスプレッドシートに入力する時間を見つけるまで待ちます。水質調査員はサンプリングラウンドの終わりにモニタリング井戸の記録簿を写真に撮り、pHと導電率の測定値は数日間カメラロールに残ります。フィールドデータ — 作業全体の中で最も苦労して得た部分 — はすでに記録されています。一週間かかるのは、それらのフォームを行に変換するステップです。この記事がまさにそのステップを省きます:現場に存在するフォームから、ワークフローが実際に使えるスプレッドシートまでの5つのステップです。
重要なポイント
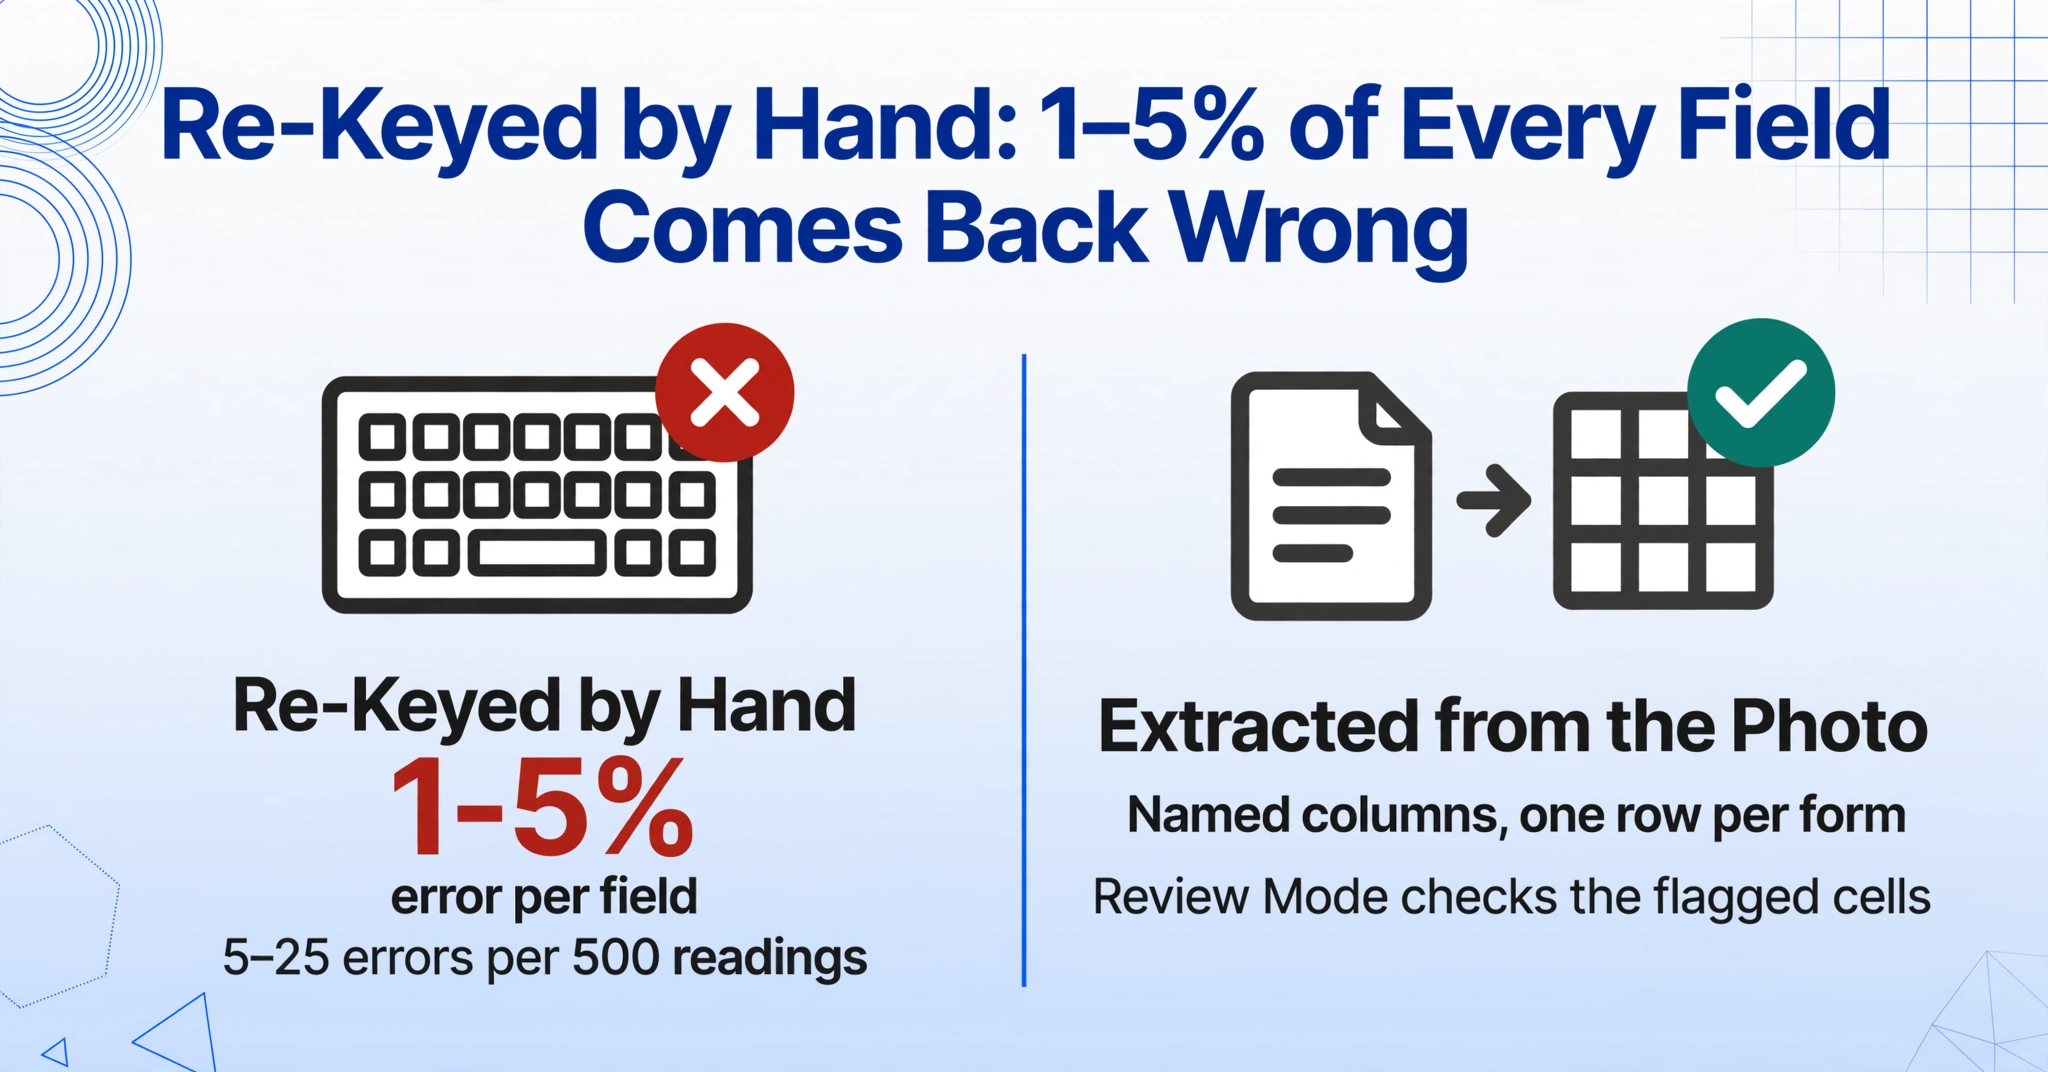
- フィールドデータをスプレッドシートに手入力すると、フィールドごとに文書化された1〜5%のエラー率が発生し、ある州のラボでは毎月10,000件の手動入力を要しています。
- 入力を速くしてもこの問題は解決しません — 再入力ステップ自体が構造的な欠陥です。コピーされた数字はすべて、元のフィールドフォームにはなかった障害ポイントを生み出すからです。
- フォームを一度写真に撮り、列に名前を付けるだけで — AIが各値を意味に基づいて見つけ出し、誰もキーボードに触れることなく行を埋めます。
フォームはすでに記録そのもの — 問題はスプレッドシートにある
現場フォームは中間ステップではありません。現場で起きたことの第一級の記録であり、スプレッドシートこそがその記録を活用可能にする場所です。両者の間にあるギャップは、純粋に避けられるはずの労力です。
2024年に実施された農場データ収集慣行に関する調査で中小規模の農場経営者にインタビューした研究者たちは、MITで公開された研究の中で、現場記録がいかに簡単に手の届かないところへ滑り落ちるかを次のように捉えています。「書き留めたか、あるいはただ覚えているだけか——『この圃場のこの隅に小麦の問題がある』と春に注意を払わなければならず、うまくいけば覚えているが、時には忘れてしまう」。それが紙のコストです。紙そのものではなく、情報が誰かが行動を起こしたときに初めてデータになるという事実、そして行動を起こすということは、その情報が検索可能な場所に存在しなければならないということです。
r/farmingで記録を実際に付けている農家たちは、現場と事務所の間にあるこの分裂をまさにこう表現しています。記録管理に関するあるスレッドでは、典型的な一式が挙げられています。「全設備の追跡シート、メンテナンス、播種・収穫結果、土壌検査、作付け計画、積荷伝票、サイロ内容」——そのすべてがもともとは手書きです。同じパターンは環境モニタリングにも見られ、現場技術者が井戸、流量観測所、大気モニタリング局で記入したログブックが、構造化された形で誰にも再入力されないままになっています。
これは孤立したワークフローの癖ではありません。バージニア工科大学土壌検査ラボは、典型的な3月には、約10,000件の土壌サンプルのクライアント情報を手入力しなければならないと報告しています。1つの州のラボで、1か月に10,000枚の紙の提出フォームです。それが組織規模での手動転記の実態であり、抽出ソフトウェアが置き換えるまさにそのステップです。私たちは別途、フィールドデータパイプラインが実際にどこで壊れるかについて書きました——このガイドはその修正策です。
再入力ステップをなくすべき理由
手書きのフィールドデータを手作業で再入力する場合、フィールドごとに約1〜5%のエラー率が発生することが、数十年にわたる人間工学の研究で明らかになっています。この数値は、2024年にPrecision Agricultureに掲載された農場記録管理に関するレビューでも引用されています。500データポイントのサンプリングラウンドでは、5〜25件のエラーが発生することになります。中には無害なものもありますが、問題となるのは、pH測定値の桁の入れ替え、害虫数に記録された誤った圃場ID、隣の列に入ってしまった水位などです。
米国の3つの規制枠組みにより、これは効率性の問題から記録保持の要件へと変わります。そして、その3つすべてに共通する前提があります。それは、圃場記録が正確で、読みやすく、取得可能であることです。
3つの規則はすべて同じ運用上の結論に収束します。記録は検索・監査・引き継ぎが可能な形で存在しなければならないということです。それはクリップボードではなく、スプレッドシートの特性です。
フィールドデータフォームが目指すべき姿
抽出ワークフローを設計する前に、フィールドフォームのどの項目が下流の意思決定に実際に使われるのかを決めておく価値があります。作物調査シートと水質記録簿にはそれぞれ重要度の高い項目があり、抽出する列は下流の用途に合わせるべきです。ページのすべての行に合わせる必要はありません。
| ワークフロー | 重要度の高い項目 | 活用先 |
|---|---|---|
| 作物調査 | 圃場ID、作物、生育段階、害虫数、雑草圧、土壌水分 | 散布推奨、害虫圧の傾向、収穫計画、USDA 作物保険の生産記録 |
| 土壌サンプリング | サンプルID、圃場ID、深さ、日付、土性メモ | ラボ提出フォーム(月1万件のVTラボのバックログなど)、施肥計画、栄養管理計画 |
| 水質モニタリング | 観測所ID、日付、時刻、水位、pH、導電率、溶存酸素 | コンプライアンス報告、現場記録とのQA/QC検証、傾向分析 |
| 安全点検(現場業務) | 点検日、場所、点検者、指摘事項、是正措置 | 監査証跡、フォローアップ追跡、規制検査記録 |
4つのワークフローすべてに共通する2つのパターンがあります。1つ目は識別項目です。圃場ID、観測所ID、サンプルID、場所などは、データの並べ替え、フィルタリング、比較を可能にする結合キーです。2つ目は測定項目で、下流で重要となる単位が含まれます(pHは単位なし、導電率はµS/cm、水位はフィートまたはメートル)。どちらのパターンも、抽出列の命名方法の指針となります。
ステップ1:AIが必要とする形でフォームを撮影する
フォーム全体を平らに置き、明るく撮影するか、近くにスキャナーがあればスキャンしてください。手書きのフィールドデータの抽出品質は撮影から始まります。3つの簡単な習慣が、最初からうまくいくか、イライラするかの違いを生みます。
抽出において撮影品質がそれほど重要なのはなぜでしょうか。それは、視覚モデルが人間と同じように用紙を読むからです。写真内の文字が判読できれば読み取れますが、白くぼやけていれば、どんなに優れた抽出ツールでも復元できません。写真を正しく撮ることは、ワークフロー全体の中で最もコストパフォーマンスの高い精度向上策です。
ステップ2:出力したい列の名前を指定する
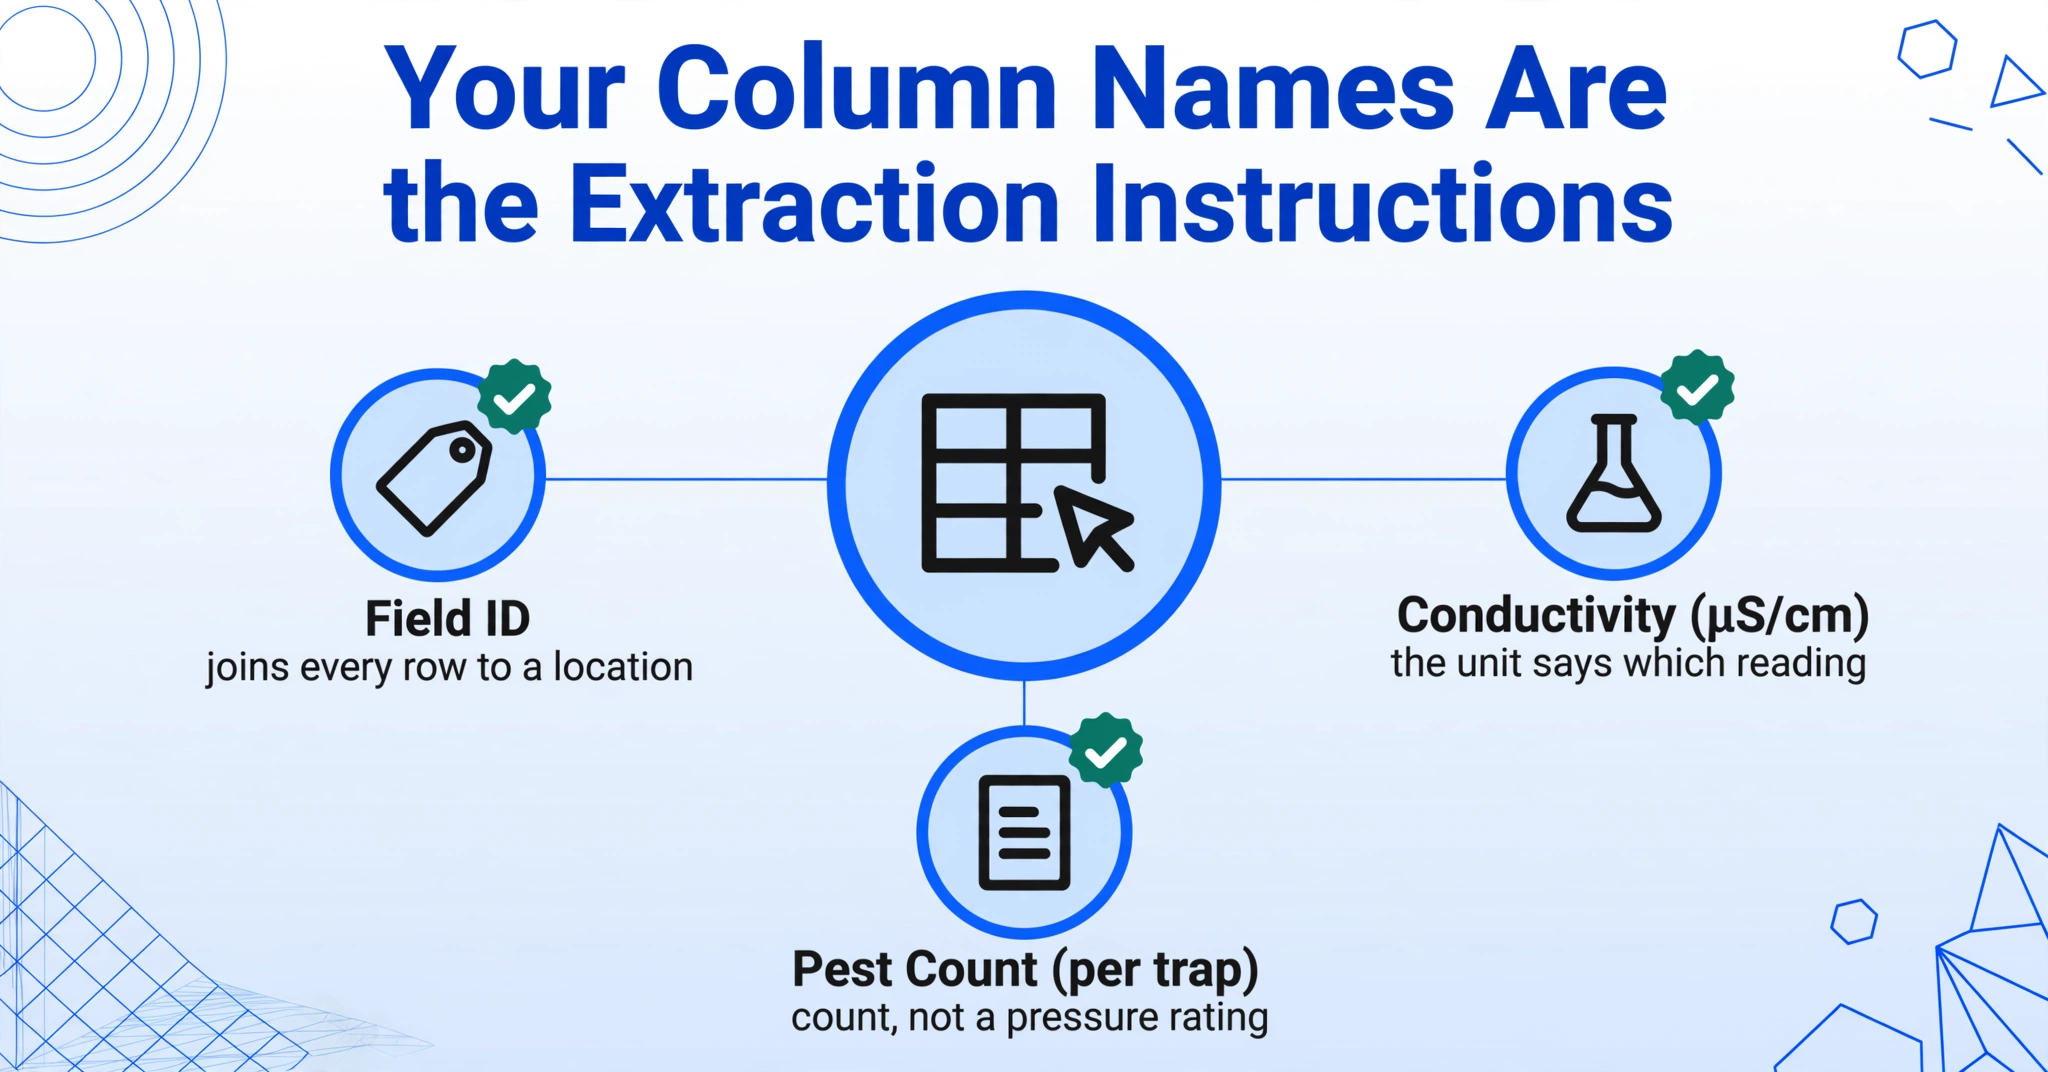
Excelの列にしたいフィールド名を入力してください。AIは、ページ上の位置ではなく、意味に基づいて各値を特定します。 これがImageToTable.aiが カスタム列抽出 と呼ぶ仕組みです。出力を定義すると(「害虫数」「pH」「観測所ID」など)、AIがフォームを読み取り、各列名に対応する値を見つけて行を埋めます。これは、参照フォームの各フィールドに枠を描く必要があり、次のフォームの手書き文字が枠の外にはみ出すと失敗するテンプレートOCRとは根本的に異なります。
列名の指定は、このワークフローで最も効果の高い判断です。入力した名前は、最終的なスプレッドシートのヘッダーになると同時に、各値を見つけるための意味的な指示にもなります。良い名前は、フォーム自体がデータをラベル付けする方法に対応しています。弱い名前は曖昧で、AIが複数の類似した値のどれを指しているのか判断できません。
| フォームの種類 | 良い列名 | 機能する理由 | 弱い列名 | 失敗する理由 |
|---|---|---|---|---|
| 作物調査 | 圃場ID、作物、生育段階、害虫数(トラップあたり)、雑草圧(低/中/高) | フォームのラベルと一致。名前内の単位と選択肢が、数値と圧力評価の曖昧さを解消する | 場所、数、段階 | 「数」は害虫数、植物数、トラップ数のいずれにもなり得る。「段階」は生育段階かサンプリング段階か不明 |
| 水質調査 | 観測所ID、水位(ft)、pH、導電率(µS/cm)、溶存酸素(mg/L) | 名前内の単位が、各測定値がどの列に属するかをAIに伝え、DOとBODや他の酸素指標を区別する | 井戸、水位、DO | 「水位」は水面の高さかスタッフゲージの読み取り値か不明。「DO」は溶存酸素か発行日か不明 |
| 安全点検 | 点検日、場所、指摘事項、是正措置、点検者名 | フィールドラベルがフォームと完全に一致。それぞれが下流の1つの用途に対応する | 日付、問題、名前 | 「問題」は指摘事項、日付、機器番号のいずれにもなり得る。「名前」は点検者か作業員か不明 |
フォームに記載されていない値も、AIに推論させることができます。推論列(例:カテゴリ(選択肢:化学 / 生物 / 物理))を指定すると、AIがモニタリングの文脈を読み取り、各記録をリストされた選択肢のいずれかに分類します。抽出と分類を1回の処理で行えるため、現場のフォームがチェックボックスではなく自由記述欄を使っている場合に便利です。手書きフォームを項目ごとに処理するセマンティック抽出の詳しい解説は、手書きフォームから特定の項目を抽出するガイドをご覧ください。まず、似た文書タイプで列名→スプレッドシートのパターンを確認したい場合は、手書きフォームからExcelへのワークフローで、よりシンプルな例を使って同じ仕組みを紹介しています。
ステップ3:バッチでアップロード — フォーム1枚につき1行
1ラウンド分のフォームをまとめてアップロードすると、各フォームが1つの結合スプレッドシートの1行になります。ここが現場作業で抽出の効果が最も発揮されるポイントです。フィールドデータは本質的にバッチで届くものだからです。調査ラウンドは6つの圃場をカバーし、サンプリングイベントは20の観測所をカバーし、点検日はサイト全体をカバーします。これらを1枚ずつ処理していたら、手作業のボトルネックをキー入力が減っただけで再現することになります。
ImageToTable.aiはバッチファースト処理を前提に設計されています。複数の写真やスキャンをアップロードすると、AIがまとめて処理し、結果を1つのExcelファイルに結合します。フォーム1枚につき1行、列名はヘッダーになります。水質ログブックの写真40枚は、1回の実行で1つのシートの40行になります。フォームが同じ見た目である必要もありません。調査チームが作物ごとに異なるシートレイアウトを使っていたり、サンプリング観測所ごとに異なるログブックテンプレートを使っていたりしても、AIはすべてのフォームから同じ名前のフィールドを特定します。これはまさに、テンプレートベースのツールが対応できないシナリオです。
オフィスでフォームを一切見ないチームには、パイプラインへのより簡単な入り口があります。それがコレクションリンクです。共有可能なリンクを生成してチームに送信すると、各現場作業員がリンクを開き、短い確認コードを入力して、写真を直接あなたの処理キューにアップロードできます。アカウントもログインも不要です。写真は他のすべてのファイルと同じバッチキューに登録されます。チームがすでに写真やスキャンをメールで送っている場合は、メール受信ボックス機能でアカウントに専用アドレスを設定できます。添付ファイルを転送すると、自動的にキューに追加されます。どちらも「オフィスでフォームを集める」というステップを完全に排除する方法です。
ファイルは安全に処理され、保存されることはありません。
ステップ4: AIが抽出した内容を確認する(どこまで信頼できるか)
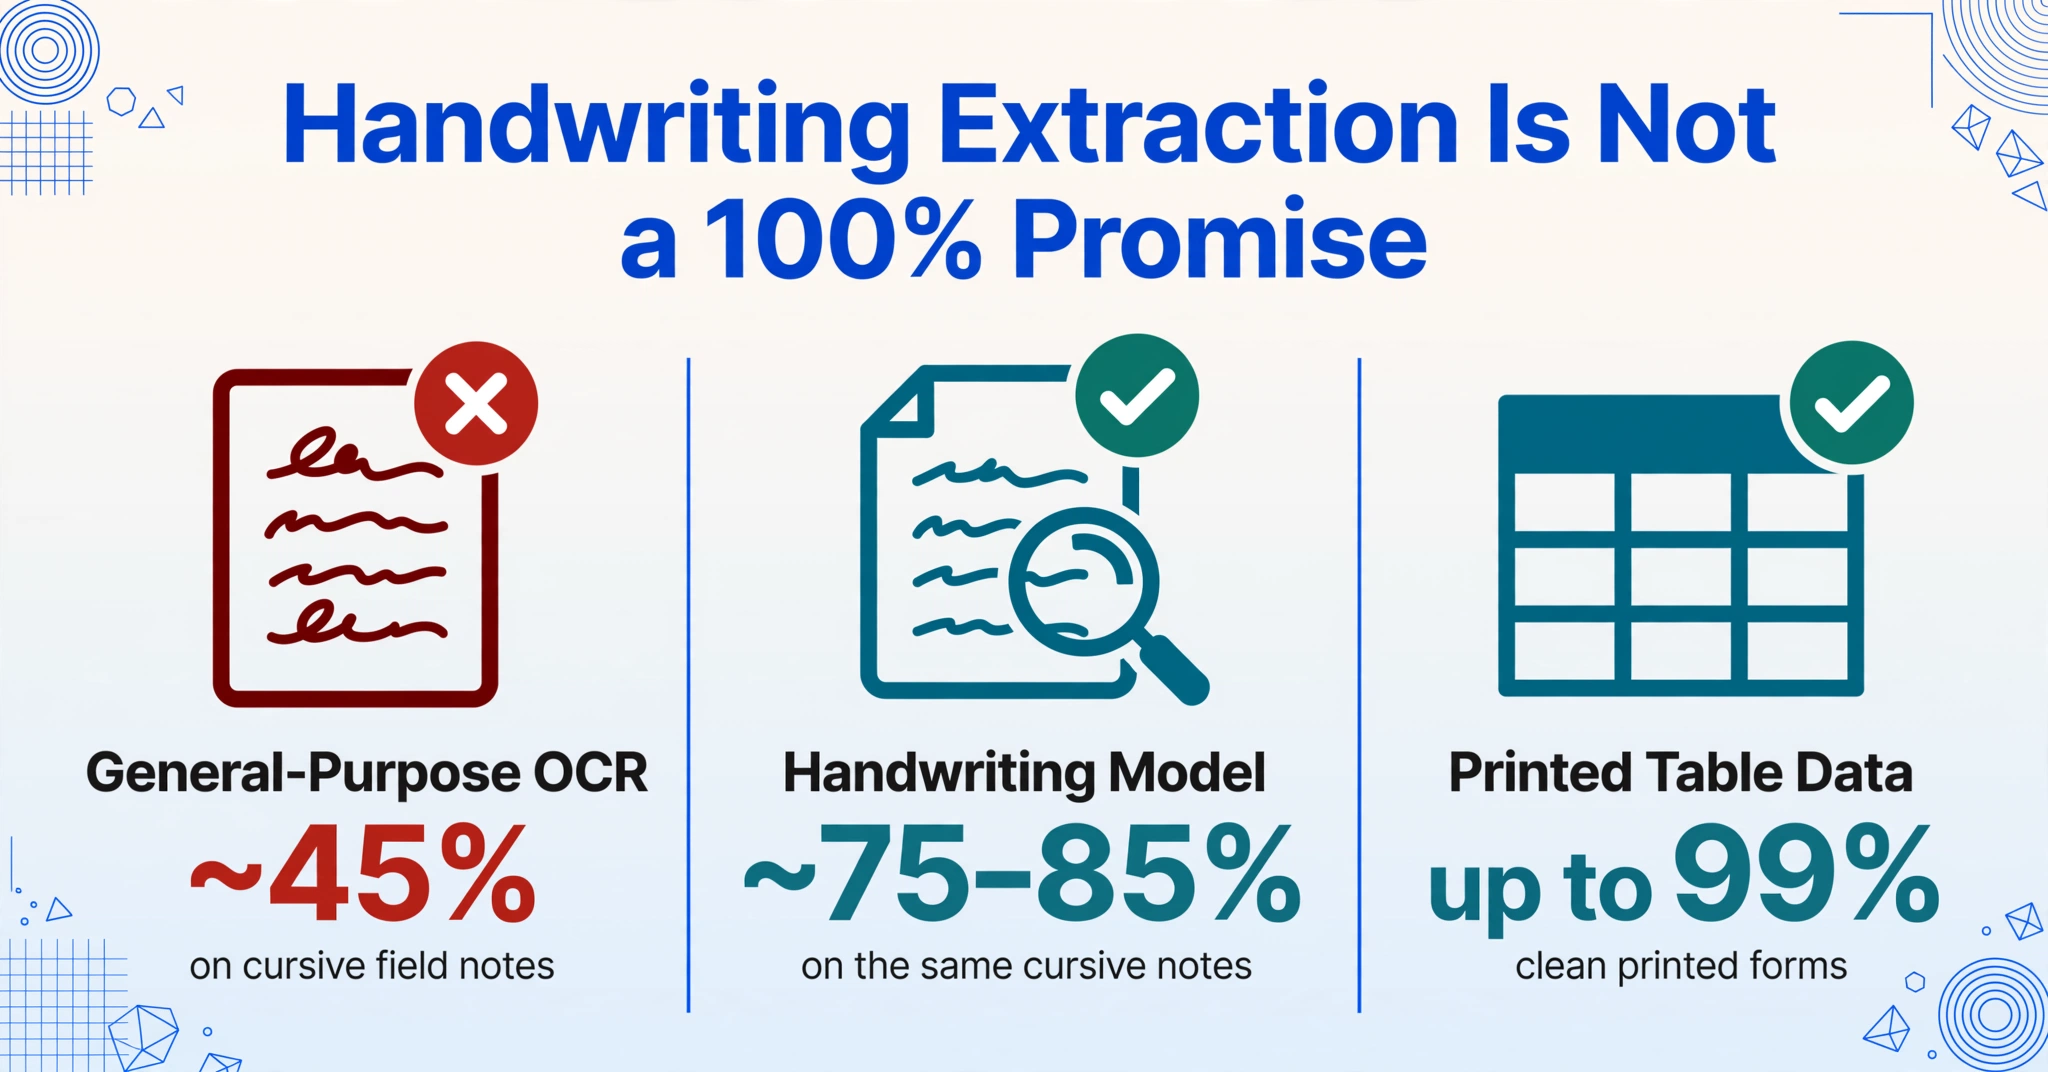
抽出された行を原本と照合しましょう。AIが確信を持てないとフラグを立てた場合は、ページ全体ではなく、そのセルだけを確認してください。手書き文字の抽出は100%の精度を約束するものではありません。それを約束するツールは、正直ではありません。現場の技術者の読みにくい手書き文字に関する独立したテスト — 実際の点検フォームでOCRをテストしたチームによる記録 — では、汎用OCRは筆記体の現場メモで約45%の精度にまで低下する一方、専用の手書き文字モデルは同じ内容で約75〜85%に達しました。読みやすいブロック体の手書き文字は、走り書きの筆記体よりもはるかに高い精度で抽出できます。これはツールではなく、入力データの性質によるものです。
その限界を踏まえても抽出を実用的にしているのは、人間の注意を必要な箇所に集中させる検証ワークフローです。ImageToTable.aiのレビューモードにはバウンディングボックス支援検証機能があります。抽出されたセルにカーソルを合わせると、元の画像上でその値の取得元の正確な位置がハイライトされます。画像上の領域をクリックすると、対応するセルにジャンプします。すべての行を読み返す必要はもうありません。AIが確信を持てなかった数件の読み取り値を確認するだけで、フォーム1枚あたり数秒で完了します。再入力に数分かかっていた作業が不要になります。値を編集しましたか?ワンクリックでAIの元の読み取り値を表示し、元に戻すこともできます。この検証ステップこそ、先ほど説明したコンプライアンスの要件を満たす場面です。レビュー担当者の確認が、「正確で、読みやすく、改ざんできない」記録が本当に正確であることを保証する人間によるチェックとなるのです。
屋外の乱雑なフォームで抽出品質を左右する要素(ペンの種類、写真の撮影条件、列の命名など)について詳しくは、現場点検フォームの精度ガイドで同じ原則を詳しく解説しています。
ステップ5:抽出した行を作業フローで使う場所に配置する
抽出したスプレッドシートはゴールではなく、フィールドデータが次に送られる先のインポートファイルです。 これまでのステップの目的は、既存のシステムがそのまま取り込める形で出力されることです。ヘッダー付きの1枚のクリーンなシート、フォームごとに1行、余分な列なし。同じ5ステップのパターン(取り込み、列定義、バッチ処理、確認、下流への受け渡し)は、稼働中のPMスケジュールに変換する方法をご紹介した保守ログなど、他のフィールド記録にも適用できます。
農業では、そのスプレッドシートは作業者がすでに使っている農場管理システム(Climate FieldView、John Deere Operations Center、Granular、Trimble Ag Software)や、Excelで運用している場合はシンプルな圃場作業台帳にインポートされます。圃場別・日付別の害虫数は散布判断テーブルになり、圃場別の作付日と面積は面積報告書や作物保険の生産記録の基礎データになります。環境調査では、同じ行がEQuISのような環境データ管理システム、またはSurvey123やFulcrumのようなGISベースの収集フローに取り込まれ、観測所IDとタイムスタンプが測定値をモニタリングポイントにマッピングし、監査証跡がQA/QCの1対1対応要件を満たします。
2種類の列タイプにより、スプレッドシートは生の値よりも使いやすくなります。計算列は、抽出中にAIが計算を実行できます。超過(pH > 8.5 ? "Yes" : "No")や総害虫数(全トラップ合計)を列として定義すると、出力には個々の測定値だけでなく、フラグや合計が含まれます。これにより、Excelでの後処理ステップが抽出パス自体に組み込まれ、水を採取した当日に超過値を処理する必要がある場合に役立ちます。元のフォームのレイアウトを保持する必要がある場合(提出用に完成したフォーム)は、Wordに変換モードでレイアウトを維持した編集可能なドキュメントとしてページを出力します。これは、元の形式で提出する必要がある記録に適しています。
よくある質問
手書きの現場フォームの抽出精度はどのくらいですか?
読みやすいブロック体の手書き文字は高い精度で抽出できます。印刷された表のデータは最大99%の精度に達します。急いで書かれた筆記体では精度が大幅に低下し、乱雑な現場メモを使った独立したテストでは、一般的なOCRが約45%、専用の手書き文字モデルが約75〜85%でした。実際的な答えは検証ステップにあります。AIが確信を持てないセルのみを、元画像に対するバウンディングボックス表示で強調して確認します。現場フォームでは、撮影品質(平らで、明るく、用紙全体が写っていること)に投資することが、最大の精度向上策です。
チェックボックス、丸で囲んだ選択肢、混在するテキストは読み取れますか?
はい。視覚モデルは、チェックされたボックス、丸で囲まれた選択肢、署名、印刷テキストに混在する手書きの値を認識します。作業員が数字を書く代わりに選択肢を丸で囲んだりチェックしたりする項目では、列を選択肢を明記して定義してください — 病害虫圧(選択肢:低 / 中 / 高) — これにより、AIはマークをテキストとして読もうとするのではなく、正しいラベルに対応付けます。
現場の写真が悪い照明や斜めの角度で撮影された場合はどうなりますか?
抽出はそれでも試みますが、品質が重要です。影や反射は、モデルが作り出すことのできない文字を覆い隠します。スマートフォンの書類スキャンモードは、遠近感を補正して用紙を平らにし、自分の影で用紙を日陰にすることで、最も一般的な屋外での失敗を修正できます。人が読める写真は一般的にモデルも読めます。人にとって白くぼやけた写真は、AIにとっても白くぼやけたものになります。
作業員が圃場や観測所ごとに異なるフォームレイアウトを使用しています。抽出に支障はありますか?
ありません。これはまさに、テンプレートベースのツールが対応できないケースです。カスタム列抽出は座標ではなく意味によって値を特定するため、1つのバッチで異なるレイアウトが混在しても、同じ名前の列を返すことができます。同じ巡回で異なるログブックテンプレートを使用する観測所でも、値が入力された同じ行構造が生成されるだけです。
一度に何枚のフォームを処理できますか?
バッチ処理では、複数のフォームを一度に処理し、1つのExcelファイルに統合します(フォームごとに1行)。実際の上限はプランのバッチ容量によって異なりますが、設計目標は、サンプリングの一巡や調査の1日分全体を、フォームごとではなく一度の処理で完了させることです。
現場の作業員がオフィスのワークフローを使わずにフォームを送信できますか?
はい、2つの方法があります。コレクションリンクを使用すると、作業員はURLを開き、確認コードを入力して、写真を直接キューにアップロードできます。ログインやアカウントは不要です。または、メール受信ボックス機能を使用すると、専用のアドレスにスキャンや写真を転送でき、自動処理を有効にすると、添付ファイルが届き次第、抽出が開始されます。
ボトルネックだったのはフォームではなく、再入力の作業でした。クリップボードもログブックもそのままで、データがすでにある場所で抽出を行いましょう。
作物調査員の害虫数が収集された当日の午後にスプレッドシートに入力されれば、散布の判断がバインダーを待つことはありません。水質測定値が超過としてフラグされ、作業員が観測所を離れる前に通知されれば、モニタリング計画は事後対応ではなく事前対応になります。これこそが、上記の5つのステップが生み出す変化です。フィールドデータは、何が起こったかの記録ではなく、次に何が起こるかの入力値になります。ご自身のフォームでお試しください。1ラウンド、5つのステップで、タイピングがなくなった午後がどう変わるかをお確かめください。