フィールドデータフォームの抽出精度:
天候、手書き、フォーム設計
フィールドデータフォームの抽出精度は、ファイルが抽出ツールに届くずっと前に決まります。クリップボードの上で、雨の中で、ペンを握る人によって決まるのです。r/Environmental_Careersのスレッドで、環境技術者が湿地を歩いたことのある人なら誰でもわかる言葉でこう言っています:「データフォームに泥がついていなければ、本当に湿地を区画したと言えるのか?」 その泥は単なる本物らしさではありません。害虫の数、pH値、安全上の発見が最終的に正しく出るかどうかを左右する最大の予測因子なのです。この記事では、現場のフォームとデータベースの信頼できる行の間に存在するすべての要因を整理し、そのうちどれを実際にコントロールできるかを示します。
重要なポイント
- フィールドフォームの精度問題は、ほとんど抽出ツールのせいではありません。ファイルがソフトウェアに届くずっと前に、クリップボードの上で、雨の中で、ペンを握る人によって決まるのです。
- AIが読みにくいフォームは人間にも読みにくいものです。手作業による転記(フォームの内容を手でデータベースに入力すること)のエラー率は1〜10%と報告されており、撮影品質だけで抽出結果が10〜20ポイントも変わります。
- より良い抽出ツールを探すのはやめましょう。本当のレバーはプロセス全体にあります。自由記述ではなくコードでフォームを設計し、収集当日に写真を撮り、AIが不確実とフラグを立てた10%のセルのみを検証すれば、すべてを打ち直す必要はありません。
完璧な転写でさえ、後れを取る出発点
ソフトウェアが関与する前の時点で、フィールドデータを手作業でコピーする行為はすでに測定可能な割合のデータを失っています。そして、手袋をはめた手と風の中で収集されるフィールドデータは、オフィスデータよりも多くの損失を被ります。
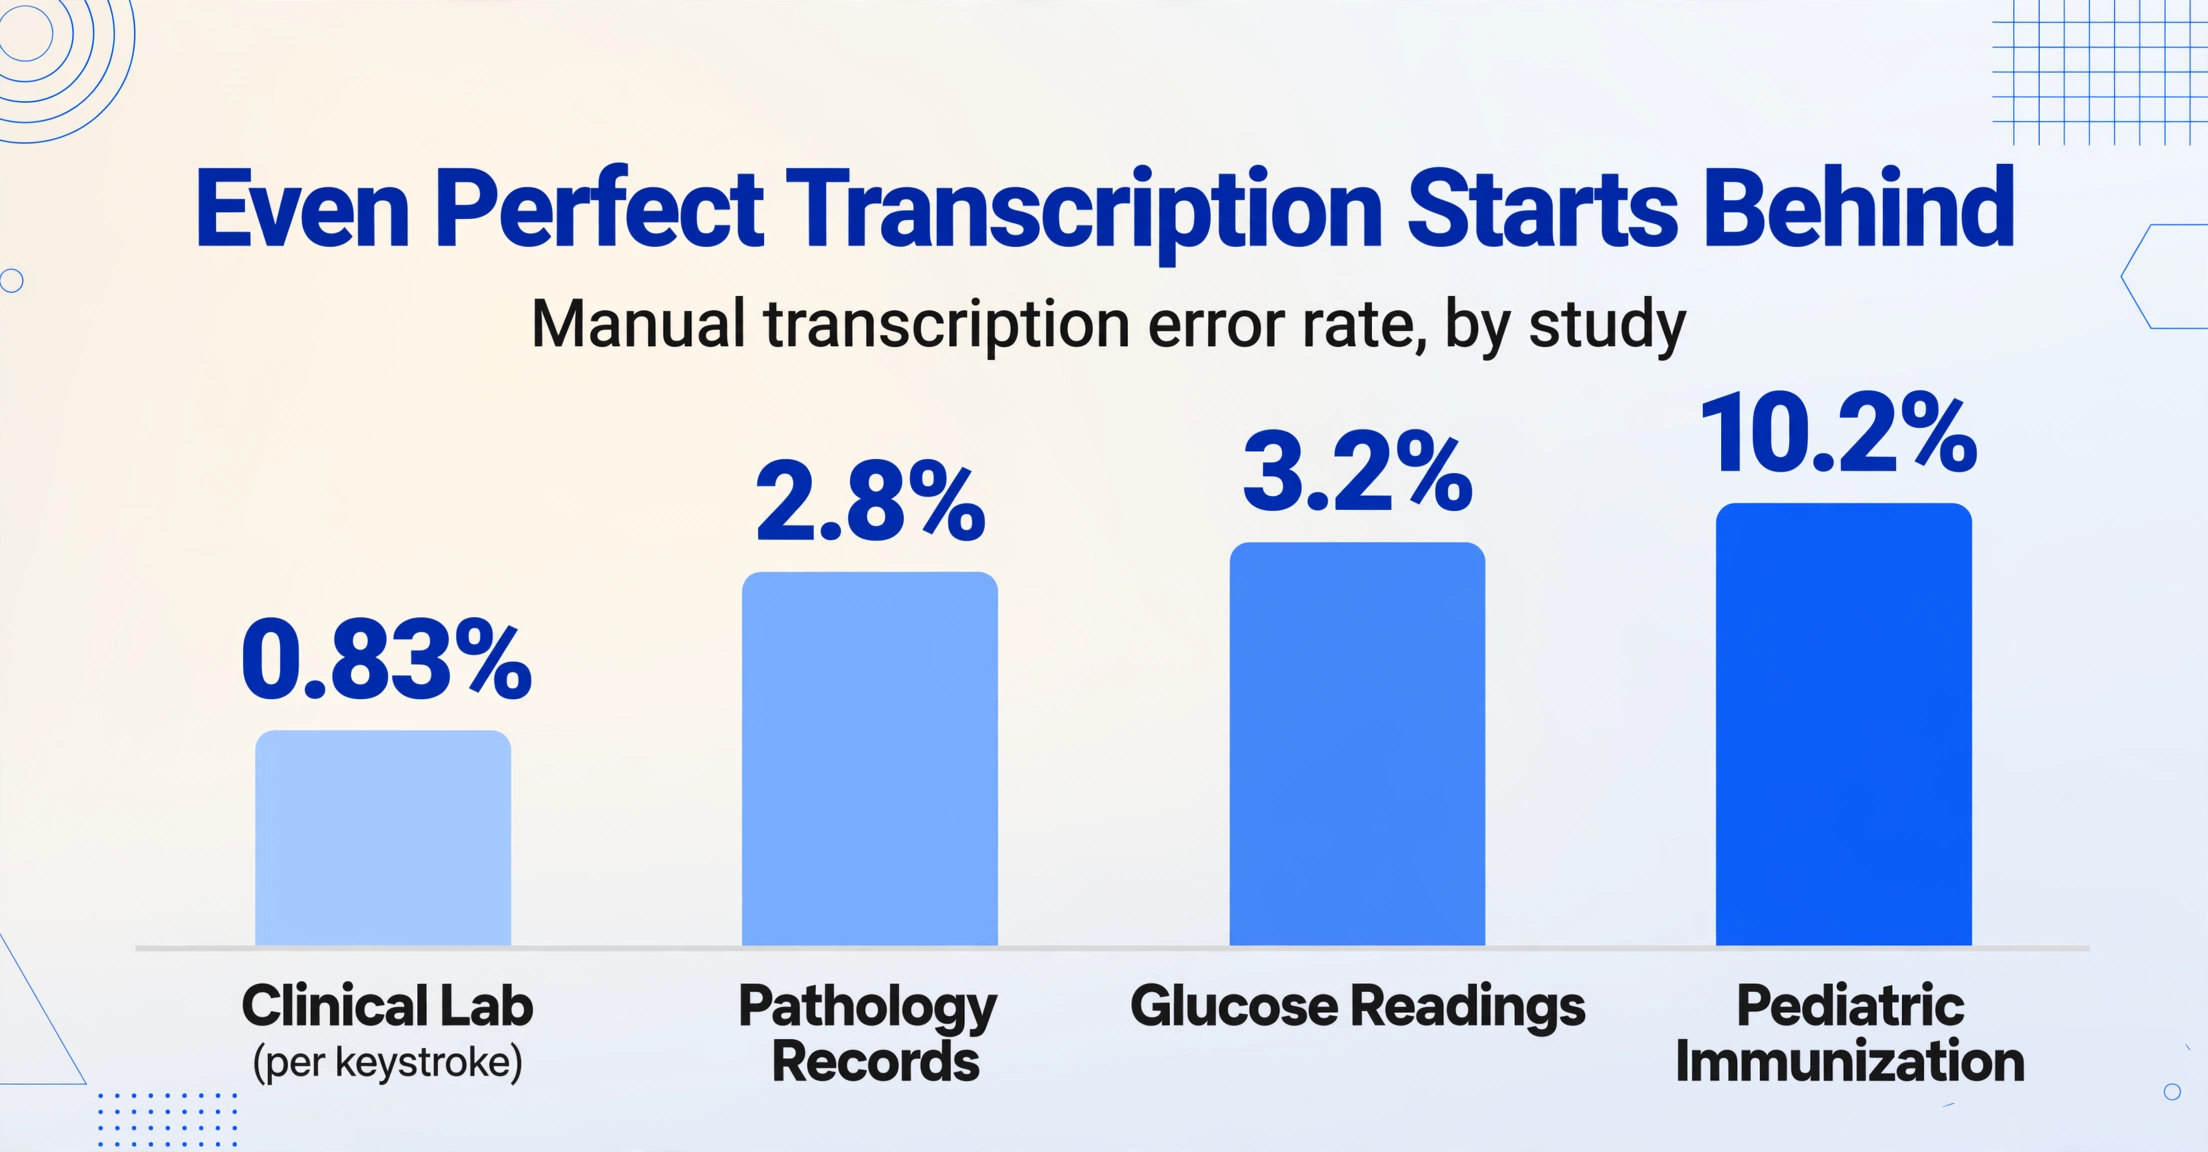
医療および記録管理の現場における手動転写エラーの研究は、NCBIのPMCアーカイブに掲載された査読付きレビューにまとめられていますが、エラー率は桁違いの幅を示しました:ある臨床検査室ではキーストロークあたり0.83%、病理記録の研究では全体で2.8%(フィールドによって0.5〜6.4%の範囲)、ポイントオブケア血糖値測定では3.2%、ある小児予防接種データセットでは10.2%でした。共通する点は、やる気があり訓練された人々でも、媒体間で値を移動する際に一桁台前半のエラーを犯すということです。そしてエラーは、フィールドワークが依存する数値フィールドに集中します——pHの桁の入れ替え、合成サンプルへの誤ったサンプルIDの付与、隣の列に入ってしまう水位などです。
それが基準です。抽出ソフトウェアが競う相手は完璧な転写ではなく、この欠陥のある人間速度の基準です。だからこそ「AIは正確か?」という問いは間違いです。正しい問いは「何と比較して、どの入力に対して正確なのか?」です。フィールドタイプ別の精度スペクトラムは、ツール側から同じ現象を示しています:印刷テキストは99%近く、筆記体は70%近く、チェックボックスはその中間——1つのフォームで25ポイントの差があります。この差こそがフィールドフォームの存在領域です。なぜなら、フォームを読みにくくするすべての要素は、読み取る手が人間であれ機械であれ、転写も難しくするからです。
雨、泥、そして日光:現場がフォームを書き換える
紙への物理的な損傷は、抽出精度に影響する最初の要因であり、現場チームが最も軽視しがちな要因でもあります。なぜなら、彼らはそれを見慣れてしまっているからです。 シーズン中ずっとログブックを持ち歩いてきた技術者は、導電率の欄に広がった水染み、ヒップポケットに折りたたんだ際にできた折り目、日光で薄いグレーに褪せたインクに、もはや気づきません。これらのそれぞれが、抽出モデルが読み取る視覚的な信号を劣化させます。これは、オフィスでフォームを読む監督者が読む信号を劣化させるのと同じことです。
現場チームには、この問題がどれほど現実的であるかを示す独自の回避策があります。同じr/Environmental_Careersのスレッドで、あるコメンターが古典的な解決策を共有していました:「現場の裏技:耐水紙のルーズリーフを買って、フォームをそれに印刷するんだ。コストに見合う価値がある!」 耐水紙、消えないインクのペン、蓋付きクリップボードが存在するのは、水、泥、日光が現場の記録を確実に破壊するからです。それらの記録が生き残った場合、天候の痕跡を残したままオフィスに届きます。そして、それが抽出パイプラインが受け取る入力なのです。
ここで制御できること: フォームがまだ判読可能なうちに写真を撮るかスキャンしてください。記入した当日に、オフィスに届く日ではなく。記録時に撮影されたフォームは、トラックのキャビンで一週間過ごす前に文字を捉えます。それが不可能な場合は、明らかに損傷したフォームを別の小さなバッチとして扱い、より重点的に検証することを想定してください(検証については後述します)。
カーボンコピーや複写フォームは、損傷の第二の層を追加します:2枚目、3枚目のコピーの印字品質は急激に低下し、クルーが両方のコピーを同時に記入する場合、その圧力で最上部のシートの筆跡が浅くなることがあります。抽出は、人がするのと同じように薄いカーボンコピーを扱います。読み取り、ためらい、そして誤読する可能性があります。同じ論理が鉛筆にも当てはまります:書いた本人には消せて判読可能でも、後で読む人にとっては薄く、にじみやすいのです。
疲れた人が手袋を着けて書いた手書き文字
手書き文字の品質は、1つの午後の間に、どの2つの抽出ツールの差よりも大きく変動します。現場作業員が書く11枚目のフォームは、1枚目よりも測定可能なほど読みにくくなります。手書き文字認識の研究は、読みやすさを作り手の特性として扱いますが、現場作業ではそれは環境の特性です。冷たい指、濡れた手袋、トラックのボンネットに載せたクリップボード、次の現場へ移動するプレッシャー。Redditの現場技術者たちは、このトレードオフを正確に表現しています — 「現場では、紙のフォームに数字を書く方が、iPadのロックを解除してアプリを開いて数字を入力するよりずっと速い」 — だからこそ紙はデジタル時代でも生き残り、その紙が生み出すものがまさに抽出が処理しなければならないものなのです。
良い知らせは、現場の筆記のほとんどがブロック体または活字体であり、抽出はそれを高い精度で処理できることです。精度の崖は、急いで書いた筆記体と、3と8、または1と7がぼやけてしまうほど速く書かれた数字にあります。印刷されたラベル、手書きのブロック体の値、丸で囲まれた選択肢、署名が混在するフォームは通常のケースであり、現代のビジョンモデルはページごとに一貫したスタイルを要求するのではなく、混在を全体的に読み取ります。
これに対する制度的な答えはAIより前から存在し、それを借用する価値があります。USDA NRCS Field Book for Describing and Sampling Soils (Version 4.0, 2024)は、土壌科学者に対し、植物種を標準化された記号コードとして記録するよう指示しています。大きなブルーステムは「ANGE」となり、公式の植物リストからの4文字コードです。名前を綴りや長さが異なる形で書き出すのではなく。この設計上の洞察は直接的に応用できます。フォームが要求する自由形式の手書きが少なければ少ないほど、書き込み自体がエラー源となる余地が少なくなります。コード、チェックボックス、数字は、疲れた人間にとっても読みやすいのと同じ理由で、機械にとっても読みやすいのです。当社の手書き文字精度向上ガイドでは、あるフォームの手書き文字が抽出可能になる理由と、別のフォームではそうならない理由について詳しく説明しています。
フォーム設計こそ、誰も語らない精度向上の鍵
フォーム設計は、抽出精度を左右する要素として、あらゆるキャプチャ技術よりも重要です。なぜなら、抽出モデルが最初に解釈すべき内容を決定するからです。 州間技術・規制協議会(ITRC)が発行する環境データ管理ガイダンスは、記録管理の観点からこの点を指摘しています。「フィールドフォームの回答は、それが格納されるデータベースフィールドの想定データ型と長さを考慮して設計する」。宛先データベースを念頭に置いて設計されたフォーム(各ボックスに1つの値、ボックスの横に単位を印刷、コードで済む箇所に複数行の自由記述を置かない)は、最小限の解釈で正しい列にデータを配置します。利便性を優先したフォームは、どの抽出モデルでも完全には解決できない曖昧さを生み出します。
フィールドフォームで繰り返し見られる設計上の選択肢が4つあり、それぞれが既知の精度挙動に対応しています。
| 設計の選択肢 | 問題となる理由 | 精度に優れたバージョン |
|---|---|---|
| すべてを自由記述欄にする | 自由記述欄は略語や単位の混乱を招きやすい——記入者は読み手が持たない文脈を前提にします | 既知の選択肢にはチェックボックス、ラベルに単位を印刷(「pH(単位)」)、繰り返し発生する値にはコードを使用 |
| 値の記入領域に罫線が通っている | 文字を横切る罫線は、文字と競合する視覚的なノイズを生み出します | 間隔を空けた記入欄、または記入領域の手前で止まる薄い罫線 |
| 高密度——すべてを1ページに収める | 窮屈な欄は、記入がラベルや端に押し付けられ、値が混ざり合います | 明確に区切られた各ボックスに1つの値、混雑した1ページ目よりも2ページ目を優先 |
| バッチ内で向きが混在している | 同じバッチ内の横向きと縦向きのページは、それぞれ異なる読み取り経路が必要です | 可能な限りバッチごとに1つの向きに統一、混在する場合は、位置ではなく意味でフィールドを特定できるツールを使用 |
最後の行が重要なのは、抽出アプローチが分岐する点だからです。テンプレートベースのOCRは、各フィールドを参照フォーム上の座標に固定します——フォームを回転させたり、レイアウトを変更したり、ステーションごとに異なるログブックテンプレートを追加したりすると、ボックスが一致しなくなります。ImageToTable.aiが使用するセマンティック抽出、Custom Column Extractionは、その逆を行います。列名(「pH」「Pest Count」「Station ID」など)を入力すると、AIがページ上のどこでも各名前に対応する値を、位置ではなく意味で特定します。レイアウトが異なり、筆跡が異なり、損傷レベルが異なるフィールドフォームのバッチでも、同じ名前の列が返されます。モデルが人間と同じように文書を読むため、フィールドが記憶された座標にある必要はありません。
キャプチャ:写真が精度の半分を決める
同じフォームの2枚の写真でも、キャプチャ品質だけで精度に10〜20ポイントの差が生まれます。これは、当社のフォーム精度テストでも一貫して再現される数値です。その差のほとんどは、4つの簡単な習慣で解消できます。フォームを平らな面に置く、まぶしさや逆光を避ける、スマホをページと平行に保つ、ヘッダー識別子を含むページ全体をフレームに収める。スマホカメラの書類スキャンモードは、これらのほとんどを自動化します。遠近補正、平面化、影の除去は、現代のスマホにはすべて組み込まれています。ただし、現場担当者がそれを使わなければ意味がありません。
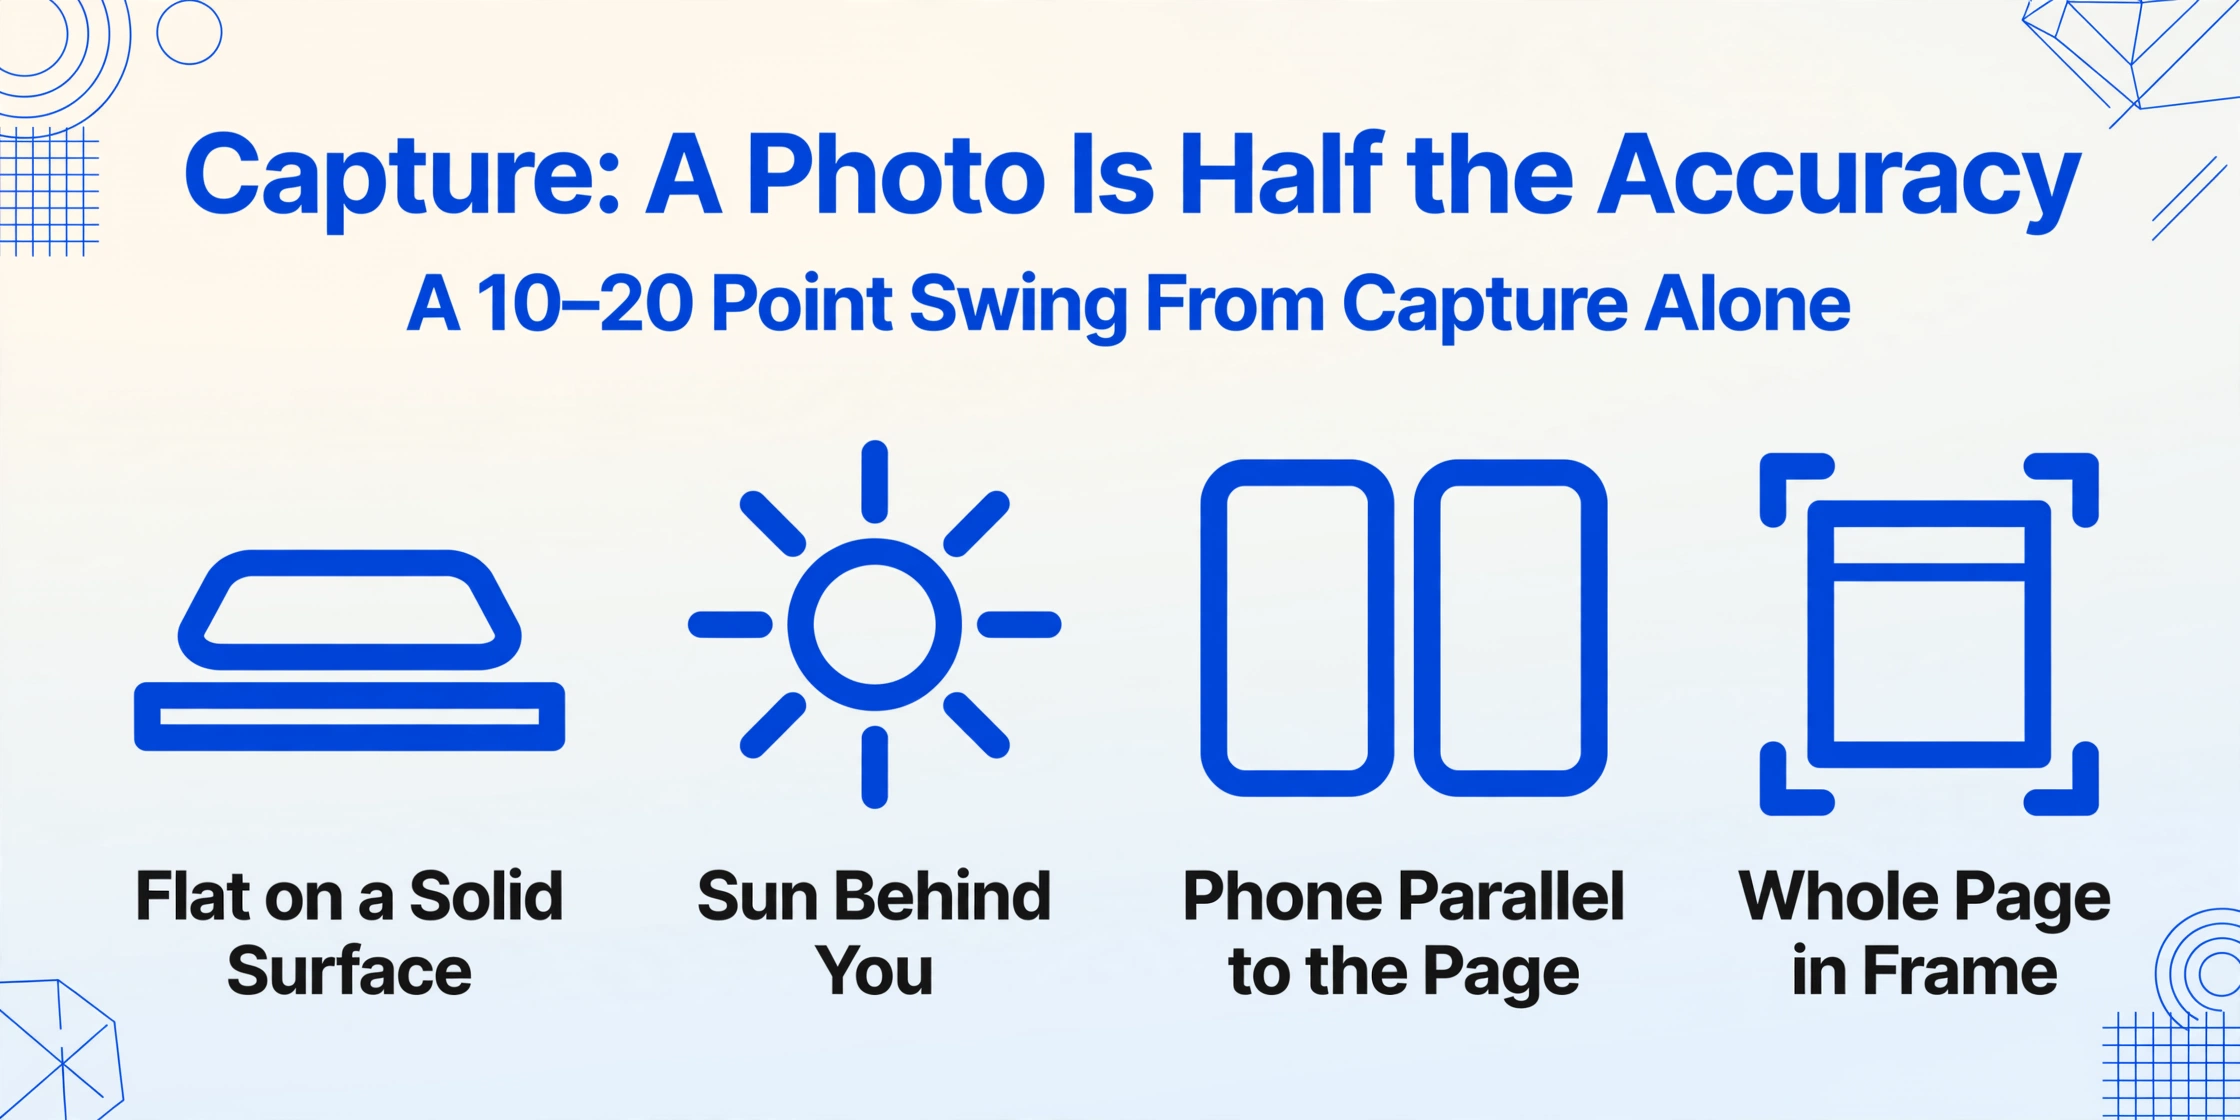
屋外でのキャプチャには、独自の失敗パターンがあります。直射日光でページが白飛びする、撮影者自身の影が文字にかかる、というのが最も多い2つのケースで、どちらも同じ方法で解決できます。太陽が撮影者の背後に来るように向きを変えるか、自分の影でページを日陰にするかです。Redditのスレッドでデジタルフォームを「明るい日差しの下では読みにくい」と表現した技術者が指摘していたのは、明るい空に向けて掲げた紙のフォームが露出不足になるのと同じ物理現象です。ただし、紙のフォームは日陰にしたり、角度を変えたり、動かしたりできますが、写真はカメラが見たものしか記録しません。
解像度は、適度な閾値を超えれば、人々が思うほど重要ではありません。レターサイズのフォームをスマホで撮影すると、通常2,000〜3,000ピクセル幅になり、十分な解像度です。しかし、キャプチャの種類は重要です。平らで明るい場所で撮影した清潔なフォームのスキャンが最良のケースで、夕暮れ時にトラックの中で撮影した同じフォームの写真が最悪のケースです。そして、その両方が同じバッチに含まれることがあります。現場の写真が1週間トラックの中に放置されるなら、フィールドフォームからExcelへのワークフローガイドで説明したコレクションリンクのパターン(現場チームが写真を直接処理キューにアップロードできる共有リンク)を使えば、そのギャップを短縮し、キャプチャ前にフォームが劣化する度合いを抑えられます。
セマンティック抽出がテンプレートOCRより優れている理由
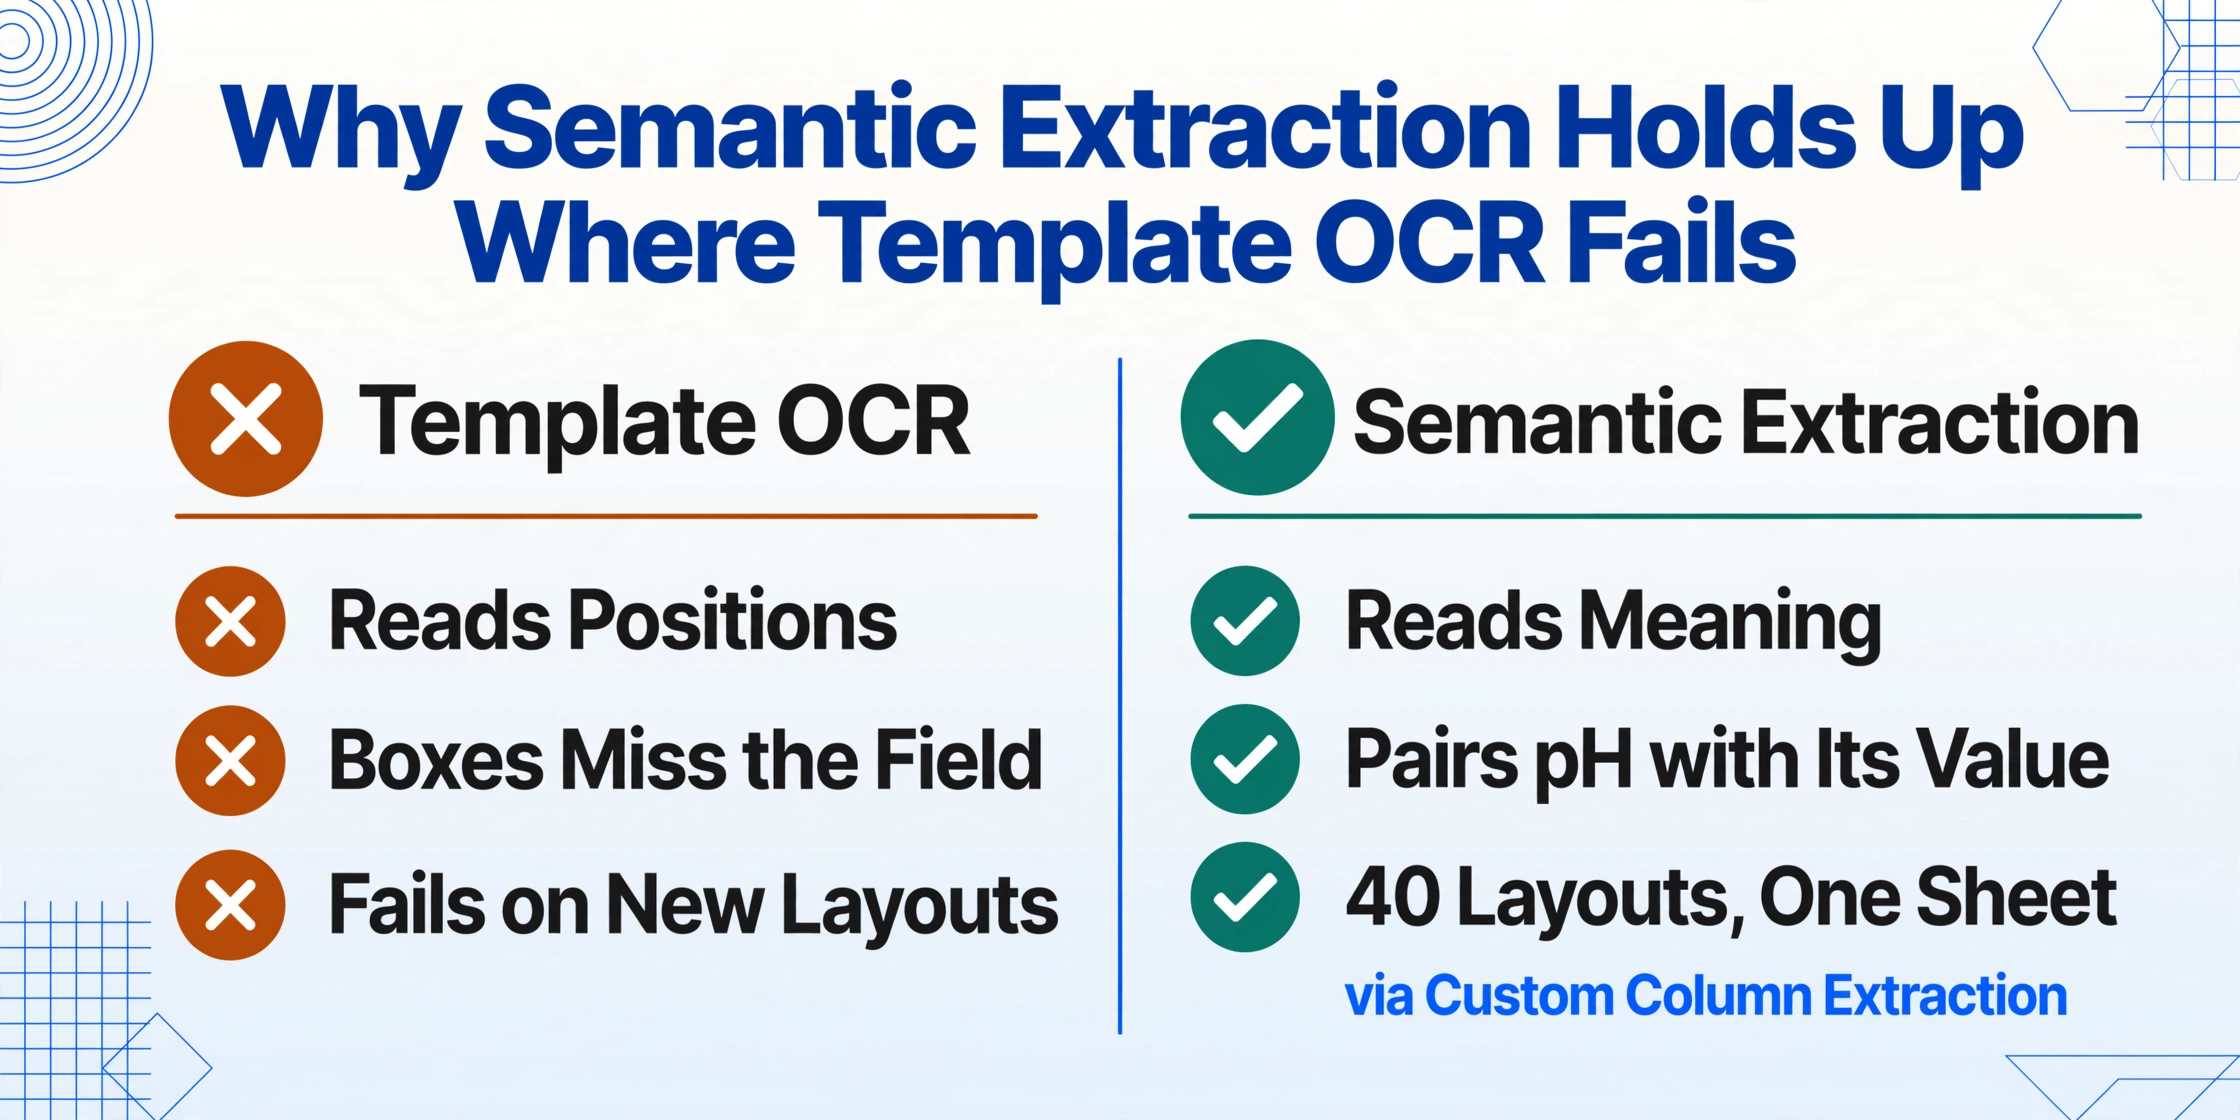
テンプレートOCRは位置を読み取り、セマンティック抽出は意味を読み取ります。フィールドフォームでは、位置は当てになりません。
テンプレートOCRは、毎回同じレイアウトで同じソースから届く請求書やフォームで実績を築いてきました。参照文書にボックスを描き、そのボックス内に入るものを抽出し、それを繰り返す方式です。フィールドデータフォームは、この前提をあらゆる場面で覆します。作業チームによってレイアウトが異なり、ステーションごとに異なるログブックテンプレートを使用し、あるラウンドでは横向きでスキャンされ、次のラウンドでは縦向きで撮影されることもあります。レイアウトが変わると、ボックスがフィールドと一致しなくなり、文字が完全に読み取れるにもかかわらず、抽出精度は崩壊します。
ビジョンモデル抽出は、位置的な失敗を完全に回避します。モデルはページ全体を読み取り、「pH」が測定値であり、その横の値がそれに対応することを理解し、ペアがどこにあっても対応付けを返します。これは、上記で説明したカスタムカラム抽出の背後にあるメカニズムであり、40種類の異なるレイアウトを持つ40枚のフォームのバッチでも、1枚のクリーンなスプレッドシートが生成される理由でもあります。ITRCガイダンスもデータ側から同じ原則を認識しています。フィールドデータは「転記ミスや現場での機器ドリフトなどのエラーが発生する可能性が高いため、特に注意が必要」とされています。これは、フィールドデータのエラーが位置的なものよりも、意味的なもの(間違ったコンテキストに対する間違った値)であることが多いためです。コンテキストを理解するツールは、正しい質問に答えていることになります。
ここで正直に述べるべきことは、セマンティック抽出が修正できないものについてです。読み取れない手書き文字、ペンの一筆で線が引かれ、モデルが数字の一部と誤読する値、雨でインクが水彩画のようになってしまったページなどです。ソース文書に含まれなくなったデータを復元できるツールは、人間でも機械でもありません。抽出が変えるのはエラープロファイルです。エラーが何千ものキーストロークの中に目に見えない形で隠れる状態から、人間が確認できる少数のフラグ付きセルへと移行させます。残りの手書き文字の失敗モードについて詳しくは、手書き文字抽出の失敗モード分析で詳細に分類しています。
重要な項目を検証し、すべてを検証しない
抽出が100%完璧であることはないため、フィールドデータ抽出が機能するかどうかを左右するのは、検証をどこに集中させるかです。その答えは、コンプライアンスフレームワークがすでに重視している項目と同じです。 EPAの大気汚染測定システム品質保証ハンドブック(EPA-600/R-94/038a)およびそれに従う環境プログラムは、データ検証を「データが正確に転記・記録されていること」、電子記録と紙記録が一対一で対応していることを確認するものと定義しています。OSHAの29 CFR 1904記録保持規則は、記録すべき負傷から7日以内にOSHAフォーム301のインシデントレポートを要求します。この期限により、抽出の速さがコンプライアンス機能となり、転記された詳細の正確性がコンプライアンス要件となります。USDAのNRCS栄養管理基準590は、基準に従った土壌サンプリングと試験手順(サンプルが正しく処理されたことを証明する記録を含む)に費用分担の適格性を条件付けています。
これら3つのフレームワークはすべて、同じ運用上のニーズに収束します。つまり、データベースの値がソースフォームの値と一致することを、すべての行を目視で再確認することなく確認する方法です。そのギャップを埋めるのがバウンディングボックス支援検証です。ImageToTable.aiのレビュー画面では、抽出されたセルにカーソルを合わせると、その値が由来する元画像の正確な領域がハイライトされ、画像上の領域をクリックすると対応するセルにジャンプします。再入力して確認する代わりに、レビュー担当者はAIが不確実とフラグした少数のセルを確認し、残りは信頼します。「すべてを検証する」(手動転記が遅い理由)を「リスクのある10%を検証する」(フォームあたり数秒)に変えます。
現実的なワークフローは次のとおりです。ラウンドをバッチ処理し、バウンディングボックスハイライトで抽出行を原本と照合し、フラグされたセルを修正して、エクスポートします。同じパターンは、他のフィールド運用のメンテナンスログブックや検査記録にも適用されます。メンテナンスログからExcelへのワークフローは、産業コンテキストでの同一のキャプチャ・レビュー・エクスポートループを示し、フィールドデータパイプラインが壊れる場所の分析は、検証ステップが手動システムの多くが静かに失敗する場所である理由を説明しています。
よくある質問
雨で濡れたり水染みのあるフォームでも抽出できますか?
文字がどれだけ雨から生き残ったかによります。読み取れる文字の周りのかすかな染みは通常問題なく処理されますが、インクがにじんだり、判読不能になるまで薄れたものは、人間でも機械でもどのツールでも復元できません。実際的な対策は撮影タイミングです。フォームは記入された当日に撮影し、1週間現場に置いた後ではなく、文字がまだ鮮明なうちに撮影してください。現場で保管が必要なフォームには、耐候性紙と消えないインク(現場クルーが共有する雨の中でも書けるハック)が記録を守ります。
クルーの手書きが急いでいて乱れている場合はどうすればいいですか?
ほとんどの現場の筆記はブロック体で、抽出は良好です。精度が急落するのは、急いだ筆記体と曖昧な数字(3と8、1と7)です。2つの対策があります:自由形式の手書きを最小限にするフォーム設計(コード、チェックボックス、1枠に1つの値 — NRCS植物記号方式)、そして検証ステップでAIが不確実とフラグしたセルだけを、元画像に対するバウンディングボックスハイライトで正確に確認することです。
チェックボックス、丸で囲んだ選択肢、署名は抽出できますか?
はい。ビジョンモデルは、チェックされたボックス、丸で囲んだ選択肢、手書きの署名をテキストだけでなく視覚要素として読み取ります。クルーが値を書く代わりに選択肢を丸で囲んだりチェックしたりするフィールドでは、列を選択肢付きで定義してください — 病害虫圧(選択肢:低 / 中 / 高) — これによりモデルがマークを正しいラベルにマッピングします。
スマホの写真で十分ですか、それともスキャナーが必要ですか?
平らで明るいスマホ写真でほとんどの現場フォームには十分です — 現代のスマホの文書スキャンモードは遠近感と影を自動補正します。撮影品質は精度を10〜20ポイント変動させるため、ハードウェアよりも習慣が重要です:平らな面、カメラを平行に、ページ全体をフレームに、映り込みなし。スキャナーが勝るのは、フォームがすでにきれいで、近くにスキャナーがある場合だけです。
各拠点で異なるフォームレイアウトを使用していますが、抽出は機能しますか?
はい、機能します。これは特にテンプレートOCRが対応できないケースです。ImageToTable.aiはページ上の位置ではなく意味に基づいて値を特定するため、異なるレイアウト、向き、手書きスタイルが混在するバッチでも、同じ名前の列が返されます。レイアウトごとにテンプレートを用意する必要はなく、列に一度名前を付ければ、モデルが値を自動的に見つけ出します。
実際にどの程度の精度を期待できますか?
印刷されたフォームのテキストは約99%の精度で抽出されます。読みやすいブロック体の手書きも良好に抽出されますが、急いで書かれた筆記体では70%台に落ちます。これは人間が手書きで転記する際の誤差率(研究により1〜10%)と同様の傾向です。きれいに設計され、適切に撮影されたフォームでは最良の結果が得られ、破損していたり乱雑なフォームでは、最も悪い10%のセルを確認する必要があります。フィールドデータに対して100%を約束するツールは、入力データの現実を正直に伝えていません。
フィールドフォームの精度はAIモデルの特性ではなく、紙、ペン、デザイン、写真、検証ステップという全体のチェーンの特性です。それぞれの要素はすべてあなたが管理できます。
チェーンを順番に改善すれば、結果は予測可能になります。手書きを減らすフォームを設計し、読みやすいうちに撮影し、位置ではなく意味を読み取るツールでバッチ処理し、リスクのあるセルを確認するだけで、すべてを再入力する必要はありません。雨の中で書かれた水質ログブックがコンプライアンス対応のデータセットになり、長い一日の終わりに記入された土壌サンプルフォームの数値がデータベースに正確に保存されるのです。泥は常に仕事の一部でした。それがデータの損失につながらないようにするのが抽出の役割です。実際に現場で使用されたフォームでテストしてみてください。