Cómo extraer datos de formularios a Excel
sin volver a escribir ni un solo campo
El formulario sobre su escritorio ya está cumplimentado. Cada casilla marcada, cada espacio escrito, cada línea de firma firmada. Y aun así, alguien — quizá usted — ahora tiene que escribir todos esos datos en una hoja de cálculo, como si el formulario siguiera en blanco. En la incorporación de personal de RR. HH., la admisión de pacientes, la recopilación de encuestas y las inspecciones de campo, esto es lo habitual: los formularios llegan cumplimentados y el trabajo de introducción de datos comienza.
Conclusiones clave
- Un formulario de 30 campos que usted escribe a mano tiene al menos un error incorporado — no por pereza, sino por el margen de error del 1–4% inherente a la transcripción humana campo por campo.
- El OCR tradicional (reconocimiento óptico de caracteres — convertir el texto de una imagen en datos editables) falla con los formularios no por la escritura a mano, sino porque memoriza las posiciones de los campos en lugar de entender qué significan — cada actualización de versión del formulario, variación de tirada de impresión o cambio de margen del escáner rompe esa memoria posicional.
- Escriba los nombres de sus columnas una sola vez e ImageToTable.ai lee cada formulario por su significado, no por su posición — 150 formularios de encuesta que antes requerían 7 horas de introducción manual se convierten en una pasada de validación de minutos, con cualquier combinación de diseños de formulario.
El cuello de botella de los formularios en papel: datos atrapados en una página
La mayoría de las empresas no tienen problemas por tener datos. El problema es que los datos llegan en el formato incorrecto. Un formulario de admisión de pacientes tiene todos los campos completados — nombre, fecha de nacimiento, ID de seguro, casillas de verificación de historial médico, firma — pero es tinta sobre papel. Un paquete de incorporación de RR. HH. tiene cinco formularios diferentes por contratación, cada uno con su propio diseño, todos completados a mano. Una pila de encuestas de comentarios de eventos tiene 200 respuestas en tres versiones distintas del formulario. La información existe. Simplemente no está en una hoja de cálculo. Lo mismo ocurre con una carpeta de formularios de permiso aprobados que nómina aún ingresa manualmente — convertir una solicitud de permiso a Excel convierte el tipo de permiso, el rango de fechas y la aprobación del gerente en filas listas para nómina.
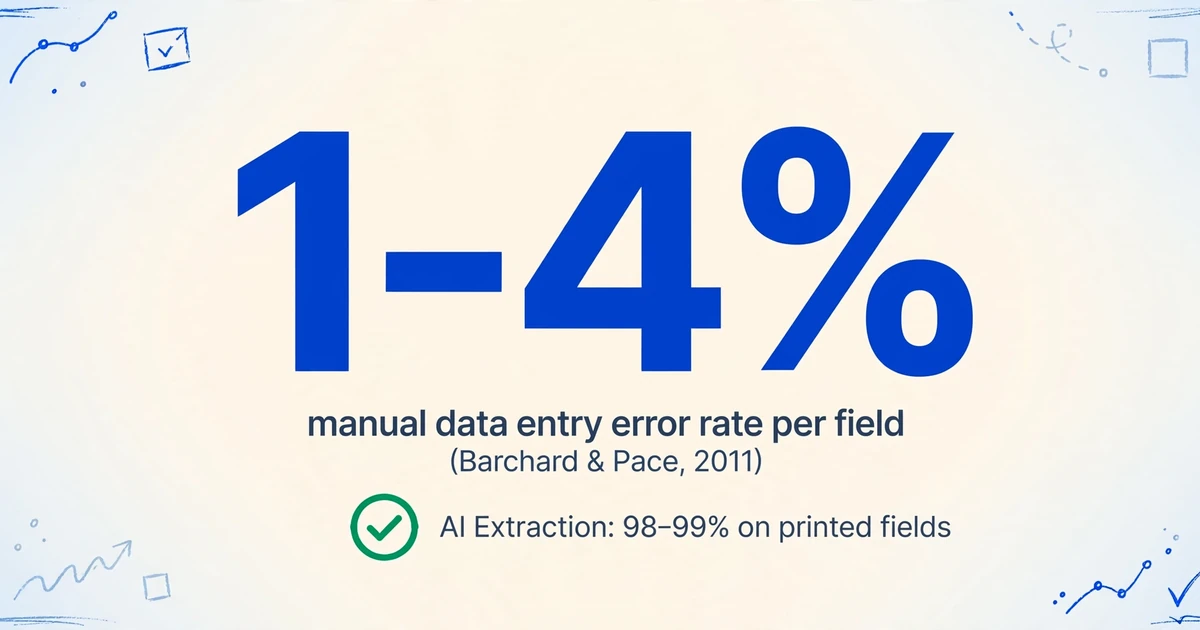
La respuesta convencional ha sido la entrada manual de datos. Un estudio de 2011 publicado en Behavior Research Methods por Barchard y Pace encontró que la entrada manual de datos tiene una tasa de error de 1–4% por campo — lo que significa que un formulario de 30 campos es estadísticamente probable que contenga al menos un error por entrada. La verificación de doble tecleo reduce esto a 0.3–0.5%, pero con el doble del costo laboral. A 3 minutos por página de formulario para entrada manual, un lote de 100 formularios cuesta aproximadamente 5 horas de trabajo puro de tecleo — antes de cualquier revisión o corrección.
Esa es la magnitud del problema. Pero el problema más profundo es que los formularios en papel combinan múltiples tipos de datos en una sola página que las herramientas de OCR tradicionales manejan mal: etiquetas impresas, respuestas escritas a mano, marcas de casillas de verificación, campos condicionales que solo aplican si una respuesta anterior fue "sí". Tratar un formulario como un bloque de texto — como hace el OCR básico — produce resultados donde una casilla marcada se lee como un carácter aleatorio, un nombre escrito a mano se desconecta de su etiqueta impresa, y las explicaciones condicionales aparecen incluso cuando la pregunta desencadenante fue respondida "no".
Para una mirada más profunda sobre por qué el OCR tradicional falla específicamente en formularios con elementos de casillas de verificación y escritura a mano — y cómo la IA de modelos de visión maneja la lógica espacial que el OCR no puede — consulte nuestra guía sobre cómo la IA lee formularios escritos a mano y casillas de verificación a Excel.
Coincidencia de plantillas vs. Lectura semántica: por qué los formularios necesitan un enfoque diferente
La mayoría de las herramientas de extracción de documentos diseñadas para formularios adoptan uno de dos enfoques. Comprender la diferencia es la clave para saber si una herramienta funcionará con sus formularios — o fallará la primera vez que alguien le envíe un diseño ligeramente diferente.
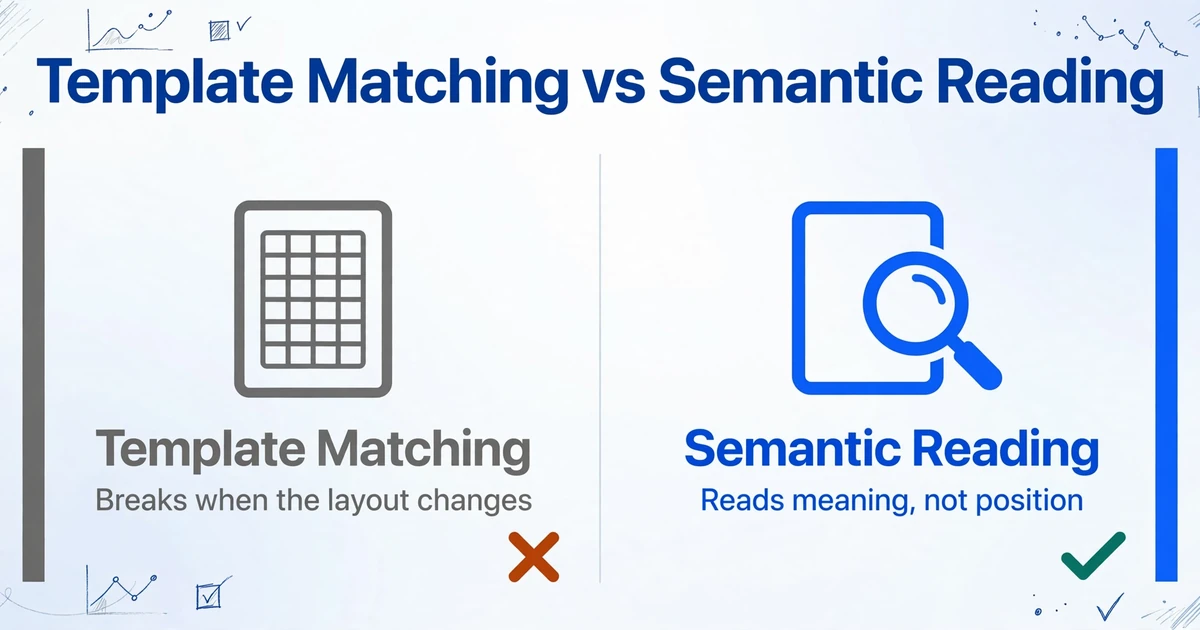
Extracción basada en plantillas — el enfoque utilizado por Docparser, ABBYY y la mayoría de los procesadores de formularios OCR tradicionales — funciona memorizando posiciones de campos. Usted abre un formulario, dibuja un rectángulo alrededor de cada campo que desea capturar ("El nombre va aquí, en las coordenadas X:120 Y:340"), y la herramienta lee cualquier texto que caiga dentro de esa casilla en cada formulario posterior. Esto funciona de manera confiable cuando cada formulario tiene un diseño idéntico — por ejemplo, PDFs rellenables de una sola fuente. Pero en el momento en que el diseño de un formulario cambia — una nueva versión, un remitente diferente, un documento escaneado con márgenes ligeramente distintos — la plantilla se rompe. Cada variante de formulario necesita su propia plantilla. El mantenimiento de plantillas se convierte en una carga de trabajo adicional.
Extracción por nombre de columna adopta el enfoque opuesto. En lugar de decirle a la herramienta dónde se encuentra cada campo en la página, usted le indica qué está buscando al definir los nombres de las columnas de salida: "Nombre completo", "Fecha de nacimiento", "Consentimiento (Sí/No)", "ID de seguro". La IA — impulsada por un VLM (modelo de lenguaje visual) — lee la imagen completa del formulario y localiza cada valor comprendiendo qué representa semánticamente, no memorizando su posición en píxeles. Un campo etiquetado como "DOB" en un formulario y "Fecha de nacimiento" en otro se asignan ambos a su columna "Fecha de nacimiento", porque la IA entiende que significan lo mismo.
Qué significa esto en la práctica: Un solo conjunto de nombres de columnas funciona con todos los diseños de formularios que reciba. Si un formulario cambia — nueva versión, nuevo proveedor, nuevo departamento — usted no reconstruye nada. La IA se adapta porque lee buscando significado, no posición. Este es el mecanismo que hace posible el procesamiento por lotes de formularios con formatos mixtos sin configuración por formulario.
Este enfoque a veces se denomina Extracción de Columnas Personalizadas: usted define las columnas — los encabezados de la hoja de cálculo de salida — y la IA completa las filas leyendo cada documento. Los nombres de columna que usted escribe son los encabezados de salida. Si necesita campos que no están escritos explícitamente en el formulario — como inferir una categoría de riesgo a partir de las respuestas de las casillas de verificación — puede usar columna inferida para que la IA clasifique según el contenido del documento. ¿Necesita columnas que realicen cálculos? Las columna calculada manejan aritmética y lógica condicional durante la extracción, de modo que la hoja de cálculo de salida llegue con los valores calculados ya completados. Para una guía metodológica campo por campo que cubre umbrales de calidad de escaneo, estrategias de nombres de campos y manejo de lotes con formularios mixtos, consulte nuestro artículo dedicado a extraer datos específicos de formularios escaneados.
Qué puede extraer la IA de un formulario — y qué no
Saber qué puede y qué no puede leer la IA de un formulario determina si pasará su tiempo revisando resultados o volviendo a escribir desde cero. Así es como la extracción por nombre de columna maneja cada tipo de dato que aparece en formularios reales:
| Elemento del formulario | Cómo lo lee la IA | Fiabilidad | Ejemplo de nombre de columna |
|---|---|---|---|
| Campos de texto impresos | OCR estándar en entradas mecanografiadas; el VLM confirma la coherencia semántica con la etiqueta del campo | 98–99 % en escaneos limpios a 300 PPP | Full Name |
| Entradas manuscritas (letra de imprenta) | El VLM lee la escritura a mano en el contexto de la etiqueta — infiere caracteres ambiguos según las expectativas del campo | 85–95 % en letra de imprenta clara | Date of Birth |
| Entradas manuscritas (letra cursiva) | El VLM intenta una lectura contextual; la precisión varía significativamente según el estilo de escritura | 60–80 %, reserve tiempo de revisión | Reason for Visit |
| Casillas de verificación | El VLM identifica la estructura de la casilla, detecta cualquier marca (✓, ✗, ○, ■) y la interpreta como booleano | 95 %+ en formularios limpios | Consent (Yes/No) |
| Grupos de botones de opción | El VLM identifica el grupo, lee todas las etiquetas de opciones y devuelve la seleccionada | 95 %+ en grupos bien espaciados | Gender (Male/Female/Other) |
| Campos condicionales («Si sí, explique:____») | Defina una columna que haga referencia al campo desencadenante; la IA verifica la condición antes de extraer | Alta cuando el desencadenante es una casilla de verificación; menor cuando es texto libre | Explain_If_Yes |
| Tablas dentro de formularios | El VLM identifica filas y columnas, extrae celda por celda; salida de varias filas por formulario | 90 %+ en tablas con líneas claras | Item, Qty, Price |
| Presencia de firma | El VLM detecta si el área de firma contiene escritura; no verifica la identidad | Fiable para detección de presencia | Signature Present (Yes/No) |
El texto impreso en escaneos bien iluminados y frontales a 300 PPP se extrae casi a la perfección. La escritura a mano en letra de imprenta — la que la gente usa cuando sabe que otra persona debe leerla — se extrae lo suficientemente bien como para que la revisión tome segundos por campo en lugar de minutos por formulario. La letra cursiva, el lápiz tenue y las fotos tomadas con el teléfono en ángulo pronunciado son donde la precisión se degrada notablemente — prevea una verificación manual en esos campos.
Paso a paso: de una pila de formularios a una sola hoja de Excel limpia
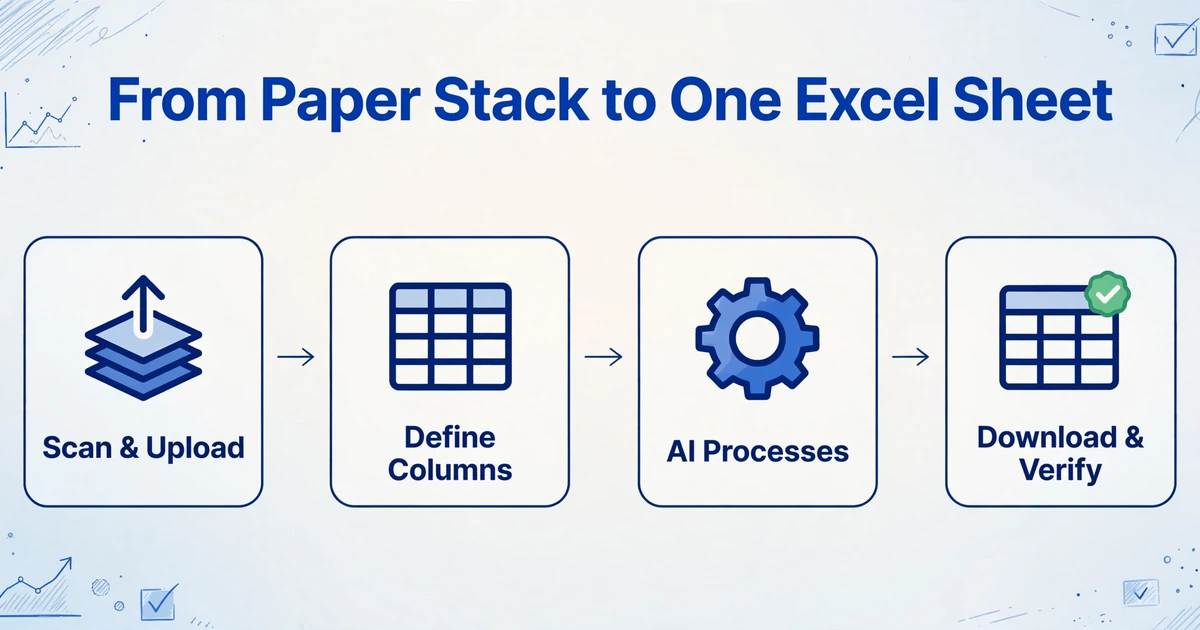
Este es el flujo de trabajo que reemplaza la maratón de captura de datos, usando un escenario de recopilación de encuestas como ejemplo concreto. Tiene 150 formularios de comentarios en papel de una conferencia. Cada formulario solicita nombre, empresa, sesión asistida, calificación de satisfacción (cuadrícula de casillas de verificación del 1 al 5) y un comentario opcional. Los formularios provienen de tres tiradas de impresión diferentes, por lo que los diseños varían ligeramente. Necesita todo esto en un solo archivo de Excel.
Escanee o fotografie todos los formularios y súbalos en un solo lote. Escanee a 300 PPP en escala de grises para obtener los mejores resultados. Las fotos de teléfono también funcionan, pero tome las imágenes de frente y con iluminación uniforme. Los formatos pueden ser JPG, PNG, PDF o WebP; se permiten formatos mixtos en el mismo lote. Los 150 formularios se suben en una sola carga.
Escriba los nombres de columna que desea en su hoja de cálculo de salida. Ingrese: Nombre completo, Empresa, Sesión asistida, Calificación de satisfacción, Comentarios. Estos se convierten en los encabezados de su archivo de Excel. La IA lee cada formulario y localiza cada valor, sin importar el diseño de la tirada de impresión del que provenga ese formulario.
La IA procesa todos los formularios: cada uno se convierte en una fila. El procesamiento toma aproximadamente 5 a 10 segundos por página, en comparación con unos 3 minutos de captura manual. La cuadrícula de casillas de verificación de satisfacción se lee como un valor booleano por opción de calificación, y el campo de comentarios opcional solo se completa donde el encuestado escribió algo.
Descargue el archivo de Excel y verifique una muestra. Exporte como XLSX, CSV o JSON. Ordene por columna, revise si hay celdas vacías donde espera datos y verifique una muestra de campos escritos a mano. El lote de 150 formularios que habría requerido más de 7 horas de captura manual ahora es una pasada de revisión sobre una hoja de cálculo ya completada.
Para ver un recorrido completo del flujo de extracción, incluido cómo configurar los nombres de columna para formularios que combinan varios tipos de datos en una sola página, use nuestra herramienta de extracción de datos de formularios que maneja casillas de verificación, escritura a mano y campos condicionales en una sola pasada.
Cómo manejar formularios con diseños diferentes en un mismo lote
El procesamiento de formularios en el mundo real rara vez involucra un solo tipo de formulario. Un consultorio médico recibe formularios de admisión de pacientes, formularios de verificación de seguro y solicitudes de análisis de laboratorio, mezclados en la misma pila diaria. Un departamento de contratación recibe formularios de solicitud, formularios de verificación de referencias y formularios de retención de impuestos de cada candidato. Ejecutar cada tipo de formulario como un lote de extracción separado duplica o triplica la carga de procesamiento.
El enfoque de nombres de columna maneja los lotes mixtos por diseño. Usted define un conjunto de columnas que cubre todos los campos que necesita en todos los tipos de formularios — por ejemplo, 15 columnas para un lote de contratación. La IA procesa cada formulario de forma independiente: los campos que existen en un formulario determinado se extraen; los campos que no aparecen se dejan en blanco. El resultado es una sola hoja de cálculo con columnas consistentes en todas las filas, independientemente del tipo de formulario que haya producido cada fila.
Para lotes mixtos, incluya una columna como Form Type en sus definiciones. La IA puede identificar el tipo de formulario por su título o estructura, lo que le brinda una columna para filtrar al revisar. Un equipo de RR. HH. que procesa paquetes de incorporación — formularios de información del empleado, W-4, I-9, contactos de emergencia y autorizaciones de depósito directo para múltiples contrataciones — puede subir todos los formularios en un solo lote y recibir una única base de datos de empleados con cada campo consolidado por persona. Nuestra guía sobre extracción de datos de nuevos empleados a partir de formularios de incorporación en masa explica este flujo de trabajo exacto, incluidas las columnas calculadas para cálculos de fechas de prueba y detección de formularios faltantes.
Flujo de trabajo real: Una práctica médica recibe tres tipos de formularios en el mismo lote diario — formularios de admisión de pacientes, formularios de verificación de seguro y solicitudes de análisis de laboratorio — cada uno impreso con un diseño diferente. En lugar de ejecutar tres trabajos de extracción separados y clasificar el papel manualmente, definen un conjunto de columnas (Nombre del paciente, Fecha de nacimiento, ID de seguro, Tipo de visita, Análisis solicitado) y suben todo el papeleo del día de una sola vez. Los formularios de admisión completan los campos del paciente, las solicitudes de laboratorio completan los campos de laboratorio, y los campos que no aparecen en un formulario determinado permanecen en blanco. Una sola hoja de cálculo al final del día, filtrada por Form Type. Para conocer la estrategia de nombres campo por campo detrás de un lote de formularios mixtos — incluido cómo manejar campos de casillas de verificación y fechas en diferentes diseños — consulte nuestra guía sobre extracción de datos específicos de formularios escaneados.
Cuándo funciona la extracción — y cuándo necesita revisión humana
Ninguna herramienta de extracción logra un 100 % de precisión en todos los formularios. La pregunta honesta no es «¿es perfecta?», sino «¿dónde se degrada la precisión y cómo se compara la carga de revisión con la entrada manual?». Esto es lo que puede esperar en diferentes condiciones de entrada:
Condiciones casi perfectas: Escaneos limpios y frontales a 300+ PPP, tinta oscura sobre papel blanco, campos bien espaciados y texto impreso. La precisión del texto impreso alcanza el 98–99 %. La detección de casillas de verificación es confiable. La revisión es rápida: buscar valores atípicos y verificar una muestra.
Condiciones moderadas: Escaneos de 150–200 PPP, ligera inclinación, tinta ligeramente desvanecida, fotos de teléfono tomadas de frente y escritura a mano en letra de molde. El texto impreso sigue siendo confiable (más del 90 %). La escritura a mano comienza a degradarse: las letras de molde aún se extraen bien, pero la escritura pequeña o comprimida puede necesitar corrección en el 10–20 % de los campos. Presupueste unos 30 segundos por formulario para la revisión, en lugar de 3 minutos para volver a ingresar todo.
Condiciones difíciles: Menos de 150 PPP, inclinación pronunciada, fotos de teléfono en ángulo, escritura cursiva, casillas de verificación densamente empaquetadas con marcas superpuestas y fotocopias de tercera generación. El texto impreso cae por debajo del 85 %. La escritura a mano se vuelve poco confiable. Trate la salida de IA como un primer borrador: acertará en la mayoría de los campos, pero planifique una revisión manual más exhaustiva de las entradas escritas a mano. El ahorro de tiempo pasa de «reducción del 90 %» a «reducción del 50–70 %» — sigue siendo sustancial, pero no reemplaza por completo la verificación humana.
La regla práctica: si escanea formularios específicamente para extracción con IA, escanee a 300 PPP en escala de grises (no en blanco y negro), mantenga la cámara frontal si usa un teléfono y use tinta oscura sobre papel claro. Estas tres decisiones producen una mejora de precisión mayor que cualquier paso de posprocesamiento.
Más allá de lotes individuales: Enlaces de recopilación y flujos de trabajo directos a Hojas de cálculo
La extracción de formularios que termina en «subir lote, descargar Excel» resuelve el problema de entrada de datos, pero deja intacto el problema de recopilación. Alguien todavía tiene que reunir todos los formularios en un solo lugar antes de que comience la extracción. Dos capacidades cierran esta brecha:
Enlaces de recopilación eliminan el paso de reunir formularios. Usted genera un enlace compartible desde su cuenta, lo envía a quienes llenan formularios — empleados completando papeleo de incorporación antes de su primer día, pacientes completando formularios de admisión en casa, asistentes a eventos enviando comentarios — y sus cargas llegan directamente a su cola de procesamiento. Cada destinatario abre el enlace, ingresa un código de verificación corto y sube. Sin creación de cuenta, sin instalación de aplicación, sin archivos adjuntos de correo electrónico que organizar. Para cuando usted se sienta a procesar, los formularios ya están recopilados y esperando.
Para equipos de RR. HH. que procesan cohortes de incorporación, un solo Enlace de recopilación enviado en el correo de bienvenida reemplaza la pila de formularios en papel del lunes por la mañana. Los nuevos empleados completan formularios en casa, los suben a través del enlace y su paquete completo está en su cola — extraído y listo — antes de su primer día.
Integración con Hojas de cálculo de Google toma un ángulo diferente: en lugar de descargar e importar, los datos extraídos fluyen directamente a una hoja de cálculo. El complemento se ejecuta como una barra lateral dentro de Sheets — usted sube formularios, especifica columnas y los resultados se agregan a la hoja activa sin salir de la hoja de cálculo. Esto es útil para equipos cuyo flujo de trabajo posterior ya vive en Sheets: analistas de encuestas que construyen tablas dinámicas, contadores que concilian datos de formularios con libros de contabilidad existentes, equipos de operaciones que mantienen paneles en tiempo real.
Tanto los Enlaces de Recopilación como el complemento de Hojas de cálculo de Google están incluidos con una cuenta de ImageToTable.ai. El motor de extracción principal — el enfoque de nombre de columna descrito a lo largo de este artículo — funciona de manera idéntica ya sea que suba formularios a través de la aplicación web, los reciba mediante un Enlace de Recopilación o los procese dentro de Hojas de cálculo de Google.
Preguntas Frecuentes
¿Puede la IA leer casillas de verificación marcadas, rodeadas con un círculo o tachadas, o solo las marcas de verificación estándar?
Sí — las tres. El modelo de visión no clasifica la forma de la marca (¿es una ✓, una ✗ o un ○?). Entiende que cualquier marca dentro de una casilla de verificación indica «seleccionado» y genera un valor booleano coherente. Una columna definida como Consent (Yes/No) devolverá «Yes» tanto si el encuestado marcó, rodeó, cruzó o rellenó la casilla. Esta es una diferencia fundamental con el OCR tradicional, que intenta nombrar el carácter y puede generar una «V» para una marca o una «O» para un círculo, dejándole a usted la tarea de descifrar qué caracteres significan «marcado» en su salida.
¿Qué pasa con los formularios que tienen etiquetas impresas y respuestas escritas a mano — puede la IA conectarlas correctamente?
Sí. La IA lee el formulario completo en una sola pasada visual — etiquetas impresas y valores escritos a mano juntos — y conserva la relación entre ellos. «Full Name» (impreso) junto a «J. Smith» (escrito a mano) se entiende como un par clave-valor. Esto es diferente de los enfoques de OCR en dos pasos que ejecutan el reconocimiento de texto impreso y el de escritura a mano por separado, y luego intentan unir los resultados — lo cual falla cuando un valor escrito a mano aparece en un lugar inesperado o una etiqueta se desplaza ligeramente. La lectura en una sola pasada de la IA se acerca más a cómo una persona mira un formulario: no lee primero todo el texto impreso y luego toda la escritura a mano; lee cada campo como una unidad completa.
¿Necesito separar los formularios por tipo antes de subirlos — las encuestas en un lote y los formularios de admisión en otro?
No. Defina un conjunto de columnas que cubra todos los campos que necesita en todos los tipos de formulario y súbalos todos juntos. La IA procesa cada documento de forma independiente: los campos que existen en un formulario determinado se extraen; los que no aparecen se dejan en blanco. Incluya una columna «Form Type» en sus definiciones para poder filtrar la salida por tipo de documento durante la revisión. Esto elimina el paso de clasificación que requieren las herramientas basadas en plantillas antes de que pueda comenzar el procesamiento.
¿Cómo maneja los campos condicionales — como «If yes, please explain:» que solo deberían completarse cuando la casilla de verificación está seleccionada?
Defina una columna para el campo condicional con un nombre que haga referencia al desencadenante — por ejemplo, Explain_If_Yes. La IA comprueba si la casilla de verificación anterior fue seleccionada antes de extraer el texto de la explicación. Si la casilla no estaba marcada, la celda se deja vacía porque la explicación nunca se activó. Esto evita el error más común en la extracción de formularios: los datos fantasma de campos que no deberían existir. Las herramientas de OCR tradicionales extraen todos los campos completados de la página sin tener en cuenta las dependencias lógicas — un cuadro de «explicación» rellenado con «N/A» se sigue extrayendo como dato.
¿Puedo guardar mi configuración de columnas y reutilizarla para cada lote del mismo tipo de formulario?
Sí. Defina los nombres de sus columnas una vez y guárdelos como una plantilla con nombre. Cada nuevo lote — las encuestas de la próxima semana, los formularios de admisión del próximo mes, los informes de inspección del próximo trimestre — carga el mismo conjunto de columnas. Si su formulario cambia, actualice las columnas una vez y guarde la nueva versión. La extracción se adapta automáticamente a los cambios en el diseño del formulario porque coincide por significado, no por posición — así que incluso si un campo se mueve a otra parte de la página en una nueva versión del formulario, su conjunto de columnas guardado sigue funcionando.
¿Puede procesar formularios en idiomas distintos del inglés?
Sí. La IA lee formularios en la mayoría de los idiomas principales — español, francés, alemán, portugués, japonés, coreano y otros. Las etiquetas de formularios en otros idiomas (p. ej., «Nombre del Empleado» o «Date de Naissance») se relacionan con sus nombres de columna en inglés mediante comprensión semántica. Esto es útil para equipos multilingües, encuestas internacionales o formularios recopilados en diferentes regiones donde la misma información se etiqueta de manera distinta.
¿Se almacenan los datos extraídos de formularios — especialmente campos sensibles como números de seguro social, historial médico o información financiera — después del procesamiento?
Los archivos subidos a ImageToTable.ai se procesan en memoria y no se almacenan de forma permanente. La plataforma está diseñada para la extracción, no para el almacenamiento de documentos — los datos extraídos existen únicamente durante la duración del trabajo de procesamiento. Para organizaciones con requisitos de cumplimiento adicionales, verifique que el entorno de procesamiento cumpla con sus necesidades regulatorias específicas antes de subir documentos sensibles. Para formularios de atención médica sujetos a HIPAA o formularios financieros sujetos a regulaciones específicas de manejo de datos, confirme siempre su postura de cumplimiento con los estándares pertinentes.
El cuello de botella en el procesamiento de formularios no es el formulario en sí — es el paso de traducción entre la página llena y la fila de la hoja de cálculo. Cuando ese paso pasa de 3 minutos de escritura por formulario a 10 segundos de lectura por IA por formulario, la pregunta cambia de "¿podemos procesar estos formularios?" a "¿qué hacemos con el tiempo que recuperamos?"
Suba su próximo lote de formularios — encuestas, formularios de admisión, listas de verificación de inspección, paquetes de incorporación — escriba sus nombres de columna una vez y obtenga los datos en Excel sin volver a escribir un solo campo.
Comenzar a Extraer