Le guide complet de
l'extraction des données des bons de livraison
L'enquête 2024 de WERC sur les coûts d'entreposage et d'exécution évalue la main-d'œuvre de réception à 40,79 $ de l'heure, et les références d'APQC montrent un écart de 44 heures dans le cycle de réception à mise en stock entre les meilleurs et les moins bons performeurs — un écart qui ne tient pas à la vitesse des chariots élévateurs, mais au temps que les données d'expédition passent entre « marchandises arrivées » et « inventaire mis à jour ». L'extraction des données des bons de livraison se situe au cœur de cet écart : elle détermine si chaque expédition fournisseur qui arrive à votre quai devient un enregistrement exploitable dans votre WMS au cours du même quart de travail, ou si elle attend une saisie manuelle qui introduit des erreurs et des retards qui s'amplifient dans le rapprochement à trois voies, la précision de l'inventaire et la réconciliation fournisseur.
Points clés à retenir
- Un bon de livraison de 40 champs a 33 à 70 % de chances de transporter une erreur de frappe dans votre WMS qui reste invisible jusqu'à ce qu'une exception de rapprochement à trois voies ou un inventaire la fasse remonter des semaines plus tard.
- Le coût visible de 32 000 $ de saisie de données par poste de réception masque un coût bien plus important que personne ne suit parce qu'il est dispersé entre les blocages des comptes fournisseurs, les enquêtes de refacturation fournisseur et les corrections d'inventaire fantôme.
- Vous n'avez pas besoin de taper moins de chiffres. Vous avez besoin d'une définition de colonnes qui préserve les trois champs de quantité par ligne d'article, plus une formule de contrôle croisé qui signale les écarts, transformant un quart de 100 champs d'un travail de saisie en une revue de cinq champs.
Avant ce guide : ce qu’est l’extraction de bons de livraison
Nouveau sur le concept ? Commencez par notre article qu’est-ce que l’extraction de données de bon de livraison — il couvre la définition de base, une comparaison manuel vs modèle vs IA, et quand vous avez réellement besoin d’une extraction par rapport aux cas où vous n’en avez pas besoin. Ce guide part de ce contexte et poursuit à partir de là : le coût opérationnel de rester manuel, les défis spécifiques qui séparent une extraction performante des résultats partiels, la liste complète des champs, et comment évaluer les outils face à votre opération de réception réelle.
La distinction qui vaut la peine d’être rappelée ici parce que le reste de ce guide en dépend : un bon de livraison n’est pas une facture. Une facture comporte des prix, des conditions de paiement et des montants de taxes pour la comptabilité fournisseurs. Un bon de livraison comporte des données d’expédition pour la réception en entrepôt — et son trait structurel déterminant est de trois colonnes de quantités par ligne d’article (commandées, expédiées, en attente) au lieu des colonnes prix/taxes d’une facture. Tout ce qui suit part de cette structure.
Pourquoi le traitement manuel des bons de livraison coûte plus cher que vous ne le pensez
Le coût visible est une arithmétique simple. Les données de référence de WERC montrent une main-d’œuvre de réception à 40,79 $ de l’heure. Un agent de réception traitant 60 bons de livraison par équipe à 3 minutes chacun passe 3 heures — 37,5 % de l’équipe — rien qu’en saisie de données. À 40,79 $ de l’heure, cela représente 122 $ par équipe en travail de saisie, soit environ 32 000 $ par poste de réception et par an. Pour un entrepôt de taille moyenne avec 3 postes de réception, cela approche six chiffres avant qu’une seule erreur ne soit comptée.
Mais le coût visible est le nombre le plus petit. Les coûts cachés s’accumulent dans trois domaines.
Rapprochement à trois voies : exceptions. Chaque quantité mal saisie ou numéro de commande transposé sur un bon de livraison crée une discordance lorsque l’équipe de comptabilité fournisseurs compare le bon de commande au bon de livraison puis à la facture fournisseur. Les références AP 2025 d’Ardent Partners indiquent que les équipes d’approvisionnement moyennes font face à un taux d’exceptions de 22 % sur le rapprochement des factures, chaque discordance coûtant environ 30 minutes d’investigation entre réception, approvisionnement et finance. Un bon de livraison où « 80 » a été saisi au lieu de « 100 », une simple erreur de frappe, déclenche un blocage en comptabilité fournisseurs, un appel au fournisseur, une revérification de ce qui est réellement arrivé, et un ajustement. La cause profonde n’est ni le fournisseur ni une erreur de quai ; c’est l’étape de saisie entre le document et le système. Les équipes de premier plan maintiennent des taux d’exceptions à 9 %. La différence tient largement au fait que les données entrant dans le système sont celles imprimées sur le document ou celles qu’une personne a tapées.
Rapprochement des expéditions partielles. Lorsqu’un fournisseur expédie 80 unités sur 100, le bon de livraison affiche trois nombres : commandées, expédiées (80), en attente (20). L’agent de réception doit saisir les trois, et le WMS doit suivre les quantités reçues pour chaque ligne du bon de commande sur plusieurs livraisons. Le traitement manuel des expéditions partielles est là où les taux d’erreur montent en flèche — parce que l’agent ne saisit pas un seul nombre, mais doit distinguer laquelle des trois quantités va dans quel champ, sous pression temporelle, pendant que le prochain camion attend. Une simple transposition — saisir 100 dans la colonne « expédiées » et 80 dans la colonne « commandées » — inverse la quantité reçue et crée un excédent de stock fantôme de 20 unités qui ne sera découvert qu’au prochain inventaire, des semaines plus tard.
Frais de rétrofacturation fournisseur. Les frais de rétrofacturation pour écarts sont l'un des coûts opérationnels les plus sous-estimés. Lorsqu'un fournisseur expédie 100 unités, votre équipe de réception en saisit 80, et la facture du fournisseur pour 100 unités est contestée, le processus de résolution implique généralement : (1) le fournisseur demande une photo comme preuve de livraison, (2) quelqu'un à la réception localise physiquement le bon de livraison signé, (3) l'équipe de comptabilité fournisseurs compare la confirmation de livraison du transporteur à la saisie, (4) une rétrofacturation ou une correction est émise. Chaque enquête de rétrofacturation consomme 30 à 60 minutes réparties sur plusieurs rôles — et le coût n'est suivi dans le budget d'aucun service en particulier. La recherche WERC indique que la précision de la réception est directement corrélée à la fréquence des rétrofacturations, pourtant peu d'entrepôts mesurent le coût des erreurs de saisie qui les déclenchent.
Pour un aperçu plus détaillé des coûts par bon et par équipe, consultez notre analyse des coûts de traitement manuel des bons de livraison.
Les défis uniques de l'extraction des bons de livraison
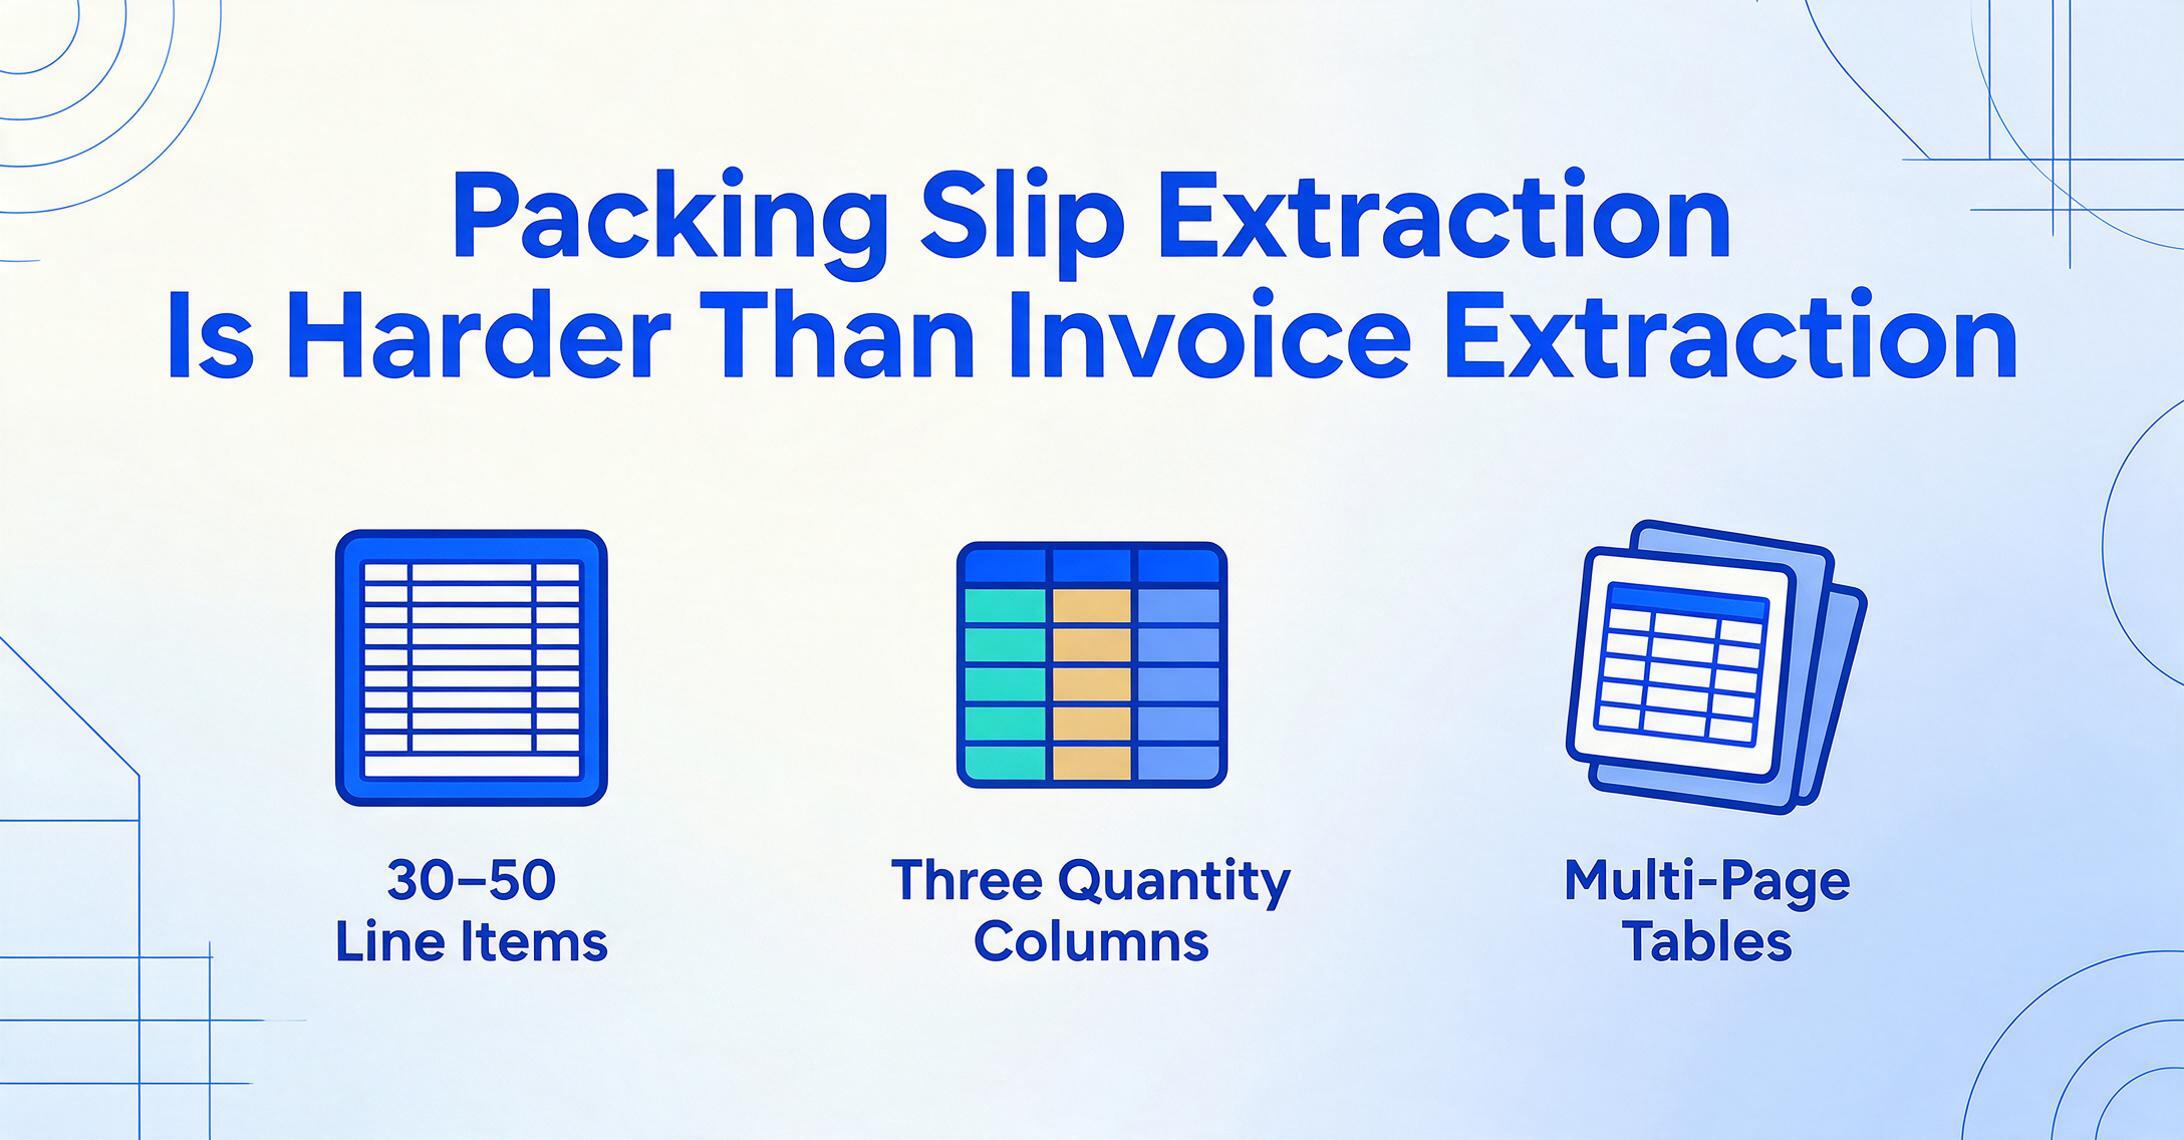
L'extraction des bons de livraison est plus difficile que l'extraction des factures, pour des raisons qui comptent pour quiconque évalue des outils. Comprendre ces défis en amont détermine si l'outil que vous choisirez gérera votre flux de travail quotidien réel ou seulement le scénario de démonstration.
1. Densité des lignes d'articles
Un bon de livraison typique d'un fournisseur industriel comme Grainger ou MSC Industrial peut contenir 30 à 50 lignes d'articles réparties sur deux ou trois pages. Chaque ligne d'article possède sa propre référence article, description, quantité commandée, quantité expédiée, quantité en attente et unité de mesure. Le tableau des lignes d'articles est la charge utile critique — 80 à 90 % des données à extraire s'y trouvent — et c'est là que la plupart des outils d'extraction échouent.
Les tableaux multipages introduisent un problème de continuité : lorsqu'un tableau de 50 lignes s'étend de la page 1 à la page 2, le moteur d'extraction doit reconnaître qu'il s'agit d'un seul tableau qui se poursuit, et non de deux tableaux distincts. Les en-têtes de colonnes peuvent ou non se répéter sur les pages de continuation. Certains fournisseurs impriment les en-têtes sur chaque page ; d'autres ne les impriment que sur la page 1. Un outil d'extraction qui perd l'alignement des colonnes au saut de page décale silencieusement les valeurs dans de mauvaises colonnes à partir de ce point — un code d'article fournisseur atterrit dans la colonne de description, et une quantité expédiée atterrit dans la colonne de commande en attente — et le résultat semble complet mais est structurellement corrompu.
2. Expéditions partielles : trois colonnes de quantités
C'est le défi principal de l'extraction des bordereaux d'expédition. Une facture a une colonne de quantités. Un bordereau d'expédition en a trois : Qté commandée, Qté expédiée et Qté en reliquat. Chaque ligne comporte ces trois nombres, et l'extraction doit préserver leur identité — pas seulement capturer les valeurs numériques.
Scénario d'expédition partielle : vous commandez 100 unités de SKU-00412. Le fournisseur en expédie 80, et met 20 en reliquat. Le bordereau affiche les colonnes intitulées « Cde », « Exp » (80), « Rel » (20). L'outil d'extraction doit comprendre quelle colonne est laquelle et les exporter dans les champs corrects. Un outil qui traite les trois comme un seul champ « Quantité », ou qui confond « Exp » avec « Cde » dans une mise en page d'expédition partielle, produit des données inutilisables pour la vérification de réception — impossible de savoir si l'envoi est complet ou partiel à partir des seules données extraites. Le flux de réception dépend de la visualisation des trois quantités côte à côte par ligne, afin que l'équipe de quai sache ce qui nécessite un suivi auprès du fournisseur.
3. Annotations manuscrites en entrepôt
Les bordereaux d'expédition n'arrivent pas vierges. Les réceptionnaires les annotent : quantités entourées après vérification, mentions manuscrites « manquant » à côté d'une ligne, signatures du réceptionnaire, horodatages, codes de dommage (« 1 CTN écrasé — refusé ») et remarques du transporteur. Ces annotations ont une importance opérationnelle — elles constituent le registre principal de ce qui s'est passé au quai de réception — mais elles se superposent aux données imprimées, chevauchant souvent les cellules du tableau ou encombrant les en-têtes de colonnes.
La ROC traditionnelle est particulièrement faible ici : un « 80 » manuscrit griffonné sur un « 100 » imprimé produit des lectures de caractères contradictoires. Un modèle de vision IA, en revanche, utilise le contexte du document — la structure du tableau, les libellés des en-têtes de colonnes, les données imprimées environnantes — pour distinguer l'annotation du texte original et capturer les deux. L'annotation n'est pas un défaut à contourner ; c'est une donnée à extraire en même temps que les champs imprimés. Pour une analyse ciblée de ce problème, consultez notre article sur l'extraction de notes de livraison manuscrites en réception d'entrepôt.
4. Bordereaux d’expédition multipages
Un fournisseur peut joindre un bordereau multipage lorsque l’envoi contient des cartons mixtes : la page 1 est le récapitulatif de l’expédition et les informations du transporteur, les pages 2 à 4 sont le détail par carton, et la page 5 est une autorisation de retour de marchandise. L’outil d’extraction doit naviguer dans cette structure, reconnaître où un type de document se termine et un autre commence, et extraire uniquement les données pertinentes du bordereau sans être perturbé par le formulaire RMA ou le connaissement du transporteur ajouté à la fin.
5. Traitement par lot de formats mixtes
Un seul quart de réception peut gérer : un bordereau Grainger standard (PDF, une page, portrait), un bon de livraison McMaster-Carr (imprimé depuis le web, deux pages), une étiquette thermique Fastenal (format étroit, paysage), et une photo d’un bon de livraison manuscrit d’un fournisseur local — le tout dans la même fenêtre de 30 minutes. Traiter chaque type de format via un modèle ou un outil séparé va à l’encontre de l’automatisation. La solution d’extraction doit gérer des formats mixtes en un seul lot, en appliquant les mêmes définitions de colonnes à tous, car la sortie doit atterrir dans la même table de réception WMS, quel que soit le fournisseur ou le format.
Champs clés à extraire d’un bordereau d’expédition
Les champs d’un bordereau se divisent en deux catégories. Les champs d’en-tête s’appliquent à l’ensemble de l’expédition ; les champs de ligne se répètent pour chaque ligne du tableau. Comprendre quels champs sont critiques pour votre flux de rapprochement en aval détermine la configuration de vos colonnes d’extraction.
| Champs d’en-tête (un par bordereau) | Difficulté d’extraction | Pourquoi c’est important |
|---|---|---|
| Numéro de bordereau / bon de livraison | Faible | Clé primaire pour le suivi, la recherche fournisseur et la piste d’audit |
| Date (expédition / émission) | Faible | Rapport d’ancienneté des réceptions ouvertes ; détermine le début du délai quai-vers-stock |
| Référence commande / bon de commande | Moyenne | Relie l’expédition au bon de commande pour le rapprochement à 3 niveaux ; formats d’étiquettes variables selon les fournisseurs |
| Adresse d’expédition (fournisseur / entrepôt) | Moyenne | Les fournisseurs multi-sites peuvent expédier depuis différents établissements ; nécessaire pour le routage des retours |
| Adresse de livraison (votre site de réception) | Faible | Confirme le routage de livraison ; signale un cross-dock si le mauvais site reçoit l’envoi |
| Nom du transporteur | Faible | Correspondance des rendez-vous de réception, affectation des coûts de fret entrant |
| Numéro de suivi / PRO | Moyenne | Recherche transporteur, récupération de preuve de livraison ; formats très variables |
| Nombre de cartons / palettes | Moyenne | Vérification pré-réception : les cartons sur le quai correspondent-ils au bordereau ? |
| Poids total | Faible | Audit de fret, vérification de facturation transporteur |
| Signature du réceptionnaire | Élevée | Preuve de livraison ; extraction contextuelle + reconnaissance d’écriture manuscrite nécessaire |
| Champs de ligne (plusieurs par bon) | Difficulté d'extraction | Pourquoi c'est important |
|---|---|---|
| Code article / Référence article / Numéro de pièce | Moyenne | Les références fournisseur et internes diffèrent souvent ; un mappage croisé est nécessaire |
| Description de l'article | Élevée | Texte libre, multi-lignes, peut contenir des spécifications ou numéros de série ; riche mais variable |
| Quantité commandée | Moyenne | Doit correspondre à la ligne du bon de commande ; référence pour la comparaison des livraisons partielles |
| Quantité expédiée | Moyenne | Quantité réellement reçue ; champ clé pour la vérification de réception et le rapprochement à trois voies |
| Quantité en attente | Élevée | Identifie les livraisons incomplètes ; pilote le flux de suivi fournisseur |
| Unité de mesure | Élevée | "EA" / "PCS" / "CTN" / "BOX" — pas de standard ; doit être conservée telle quelle pour le mappage des unités de mesure |
Les trois colonnes de quantités — commandée, expédiée, en attente — sont ce qui distingue l'extraction de bons de livraison de tout autre type de document. Un outil d'extraction qui les fusionne en un seul champ, ou qui les capture sans préserver leur distinction, a échoué dans sa mission principale. Vérifiez cela avant de vous engager avec un outil : téléversez un bon de livraison contenant au moins une ligne de livraison partielle et vérifiez que les trois quantités apparaissent dans les bonnes colonnes de sortie.
Extraction de bons de livraison : approche traditionnelle vs IA
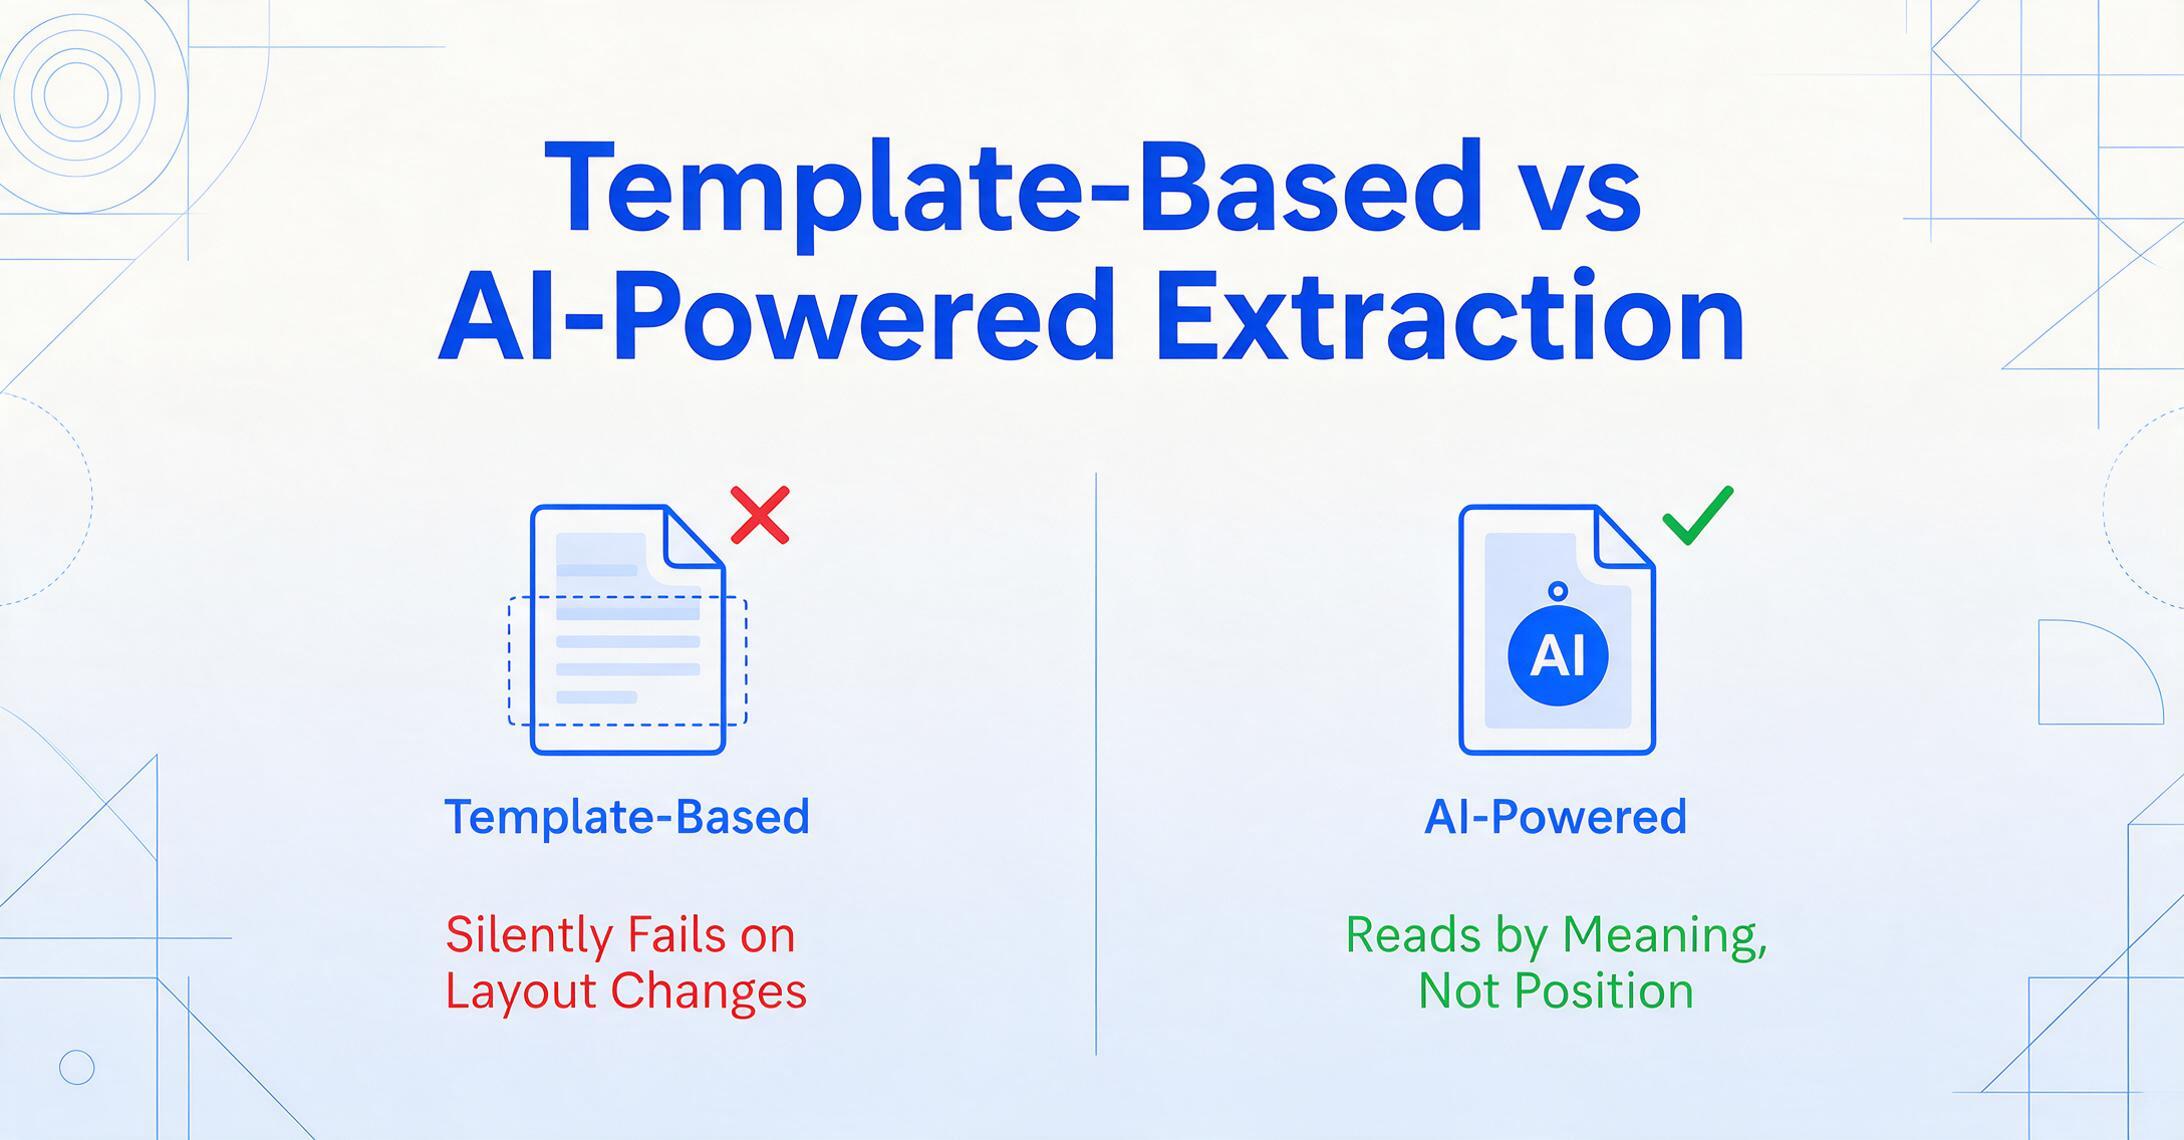
Toutes les technologies d'extraction ne gèrent pas ces défis de la même manière. La distinction fondamentale se situe entre l'extraction basée sur modèle (positionnelle) et l'extraction sémantique (pilotée par IA) — et comprendre cette différence est l'étape d'évaluation la plus importante que vous puissiez faire.
L'extraction basée sur modèle nécessite de configurer une zone d'analyse pour chaque mise en page de document fournisseur. Vous dessinez un rectangle autour de l'endroit où la référence du bon de commande apparaît sur le bon de livraison du fournisseur A, un autre rectangle autour de l'en-tête du tableau des lignes, et vous définissez les largeurs de colonnes. Lorsque le fournisseur A reformate son bon — modifiant la mise en page après une mise à niveau ERP — votre modèle échoue silencieusement. Les valeurs atterrissent dans les mauvaises colonnes. Vous découvrez le problème lorsqu'un employé de réception remarque que les quantités apparaissent dans le champ de description, ou pas du tout.
L'approche par modèle échoue le plus douloureusement sur le tableau des lignes d'article. Un modèle suppose que le tableau commence à une ligne fixe et que les colonnes ont des largeurs fixes. Mais les bons de livraison des fournisseurs varient quant au nombre de lignes d'en-tête précédant le tableau, à la répétition des en-têtes de colonnes, au fait que les lignes s'étendent sur plusieurs lignes de texte, et à la présence de regroupements par carton imbriqués dans le tableau. Un modèle qui fonctionne pour le tableau de 30 lignes d'un fournisseur se désaligne fréquemment sur le tableau de 50 lignes d'un autre, avec des cellules de description fusionnées. L'enquête Levvel Research sur les coûts de saisie manuelle des données note que plus de 30 % des écarts de traitement documentaire proviennent d'un traitement incohérent — ce qui est exactement ce que l'extraction par modèle introduit : un traitement cohérent de l'incohérence, produisant des résultats erronés qui semblent corrects.
Extraction sémantique — extraction par IA utilisant des modèles de langage vision — fonctionne par le sens, pas par la position. Vous définissez les colonnes souhaitées : « Numéro de bon de livraison », « Référence bon de commande », « Référence article », « Qté commandée », « Qté expédiée », « Qté en attente », « Unité de mesure ». L'IA lit l'intégralité du document — la section d'en-tête, le tableau des lignes d'article, les annotations de pied de page — et localise chaque valeur en comprenant ce qu'elle représente sémantiquement, indépendamment de sa position sur la page. Un champ libellé « Ord » sur le bon d'un fournisseur, « Qté » sur celui d'un autre, et « Commandé » sur un troisième est reconnu comme la même chose parce que l'IA comprend le rôle sémantique. C'est l'Extraction de colonnes personnalisées : vous définissez la sortie une fois, et l'IA localise les données correspondantes par le sens, pas par les coordonnées.
La différence opérationnelle réside dans la maintenance des modèles. Avec les modèles, chaque nouveau fournisseur — ou chaque changement de format d'un fournisseur existant — exige un travail de modélisation. Pour un entrepôt qui reçoit de plus de 50 fournisseurs, chacun avec ses variations de format, la maintenance des modèles devient un coût opérationnel permanent qui annule les économies de main-d'œuvre réalisées grâce à l'automatisation. Avec l'extraction sémantique, la même définition de colonnes fonctionne pour tous les fournisseurs, car la logique d'extraction est indépendante du format. Un bon de livraison d'un fournisseur jamais traité auparavant — avec une mise en page que l'IA n'a jamais vue — est extrait correctement dès le premier téléversement, car l'IA lit la sémantique du bon de livraison, pas ses coordonnées.
Pour en savoir plus sur les raisons pour lesquelles les formats de bons de livraison des fournisseurs divergent et divergeront toujours, consultez notre article sur l'incohérence des formats de bons de livraison.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Traitement par lots : recoupement avec les données du bon de commande
L'extraction d'un bon de livraison unique résout le problème de saisie de données pour chaque document. Le traitement par lots résout le défi du débit — et il débloque une capacité que le traitement unitaire ne permet pas : le recoupement automatisé des quantités des bons de livraison avec les données du bon de commande.
Dans un flux de travail par lots, vous téléversez 20, 30 ou 50 bons de livraison provenant de différents fournisseurs en un seul lot — certains en PDF, certains en photos prises au téléphone, certains sur plusieurs pages. Le moteur d'extraction traite tous ces documents avec les mêmes définitions de colonnes et fusionne les résultats dans une seule feuille de calcul. Chaque bon de livraison devient une ligne dans le tableau d'en-tête ; chaque article devient une ligne de détail avec les champs d'en-tête répétés. Pour le processus détaillé, consultez notre guide d'extraction par lots de bons de livraison vers Excel.
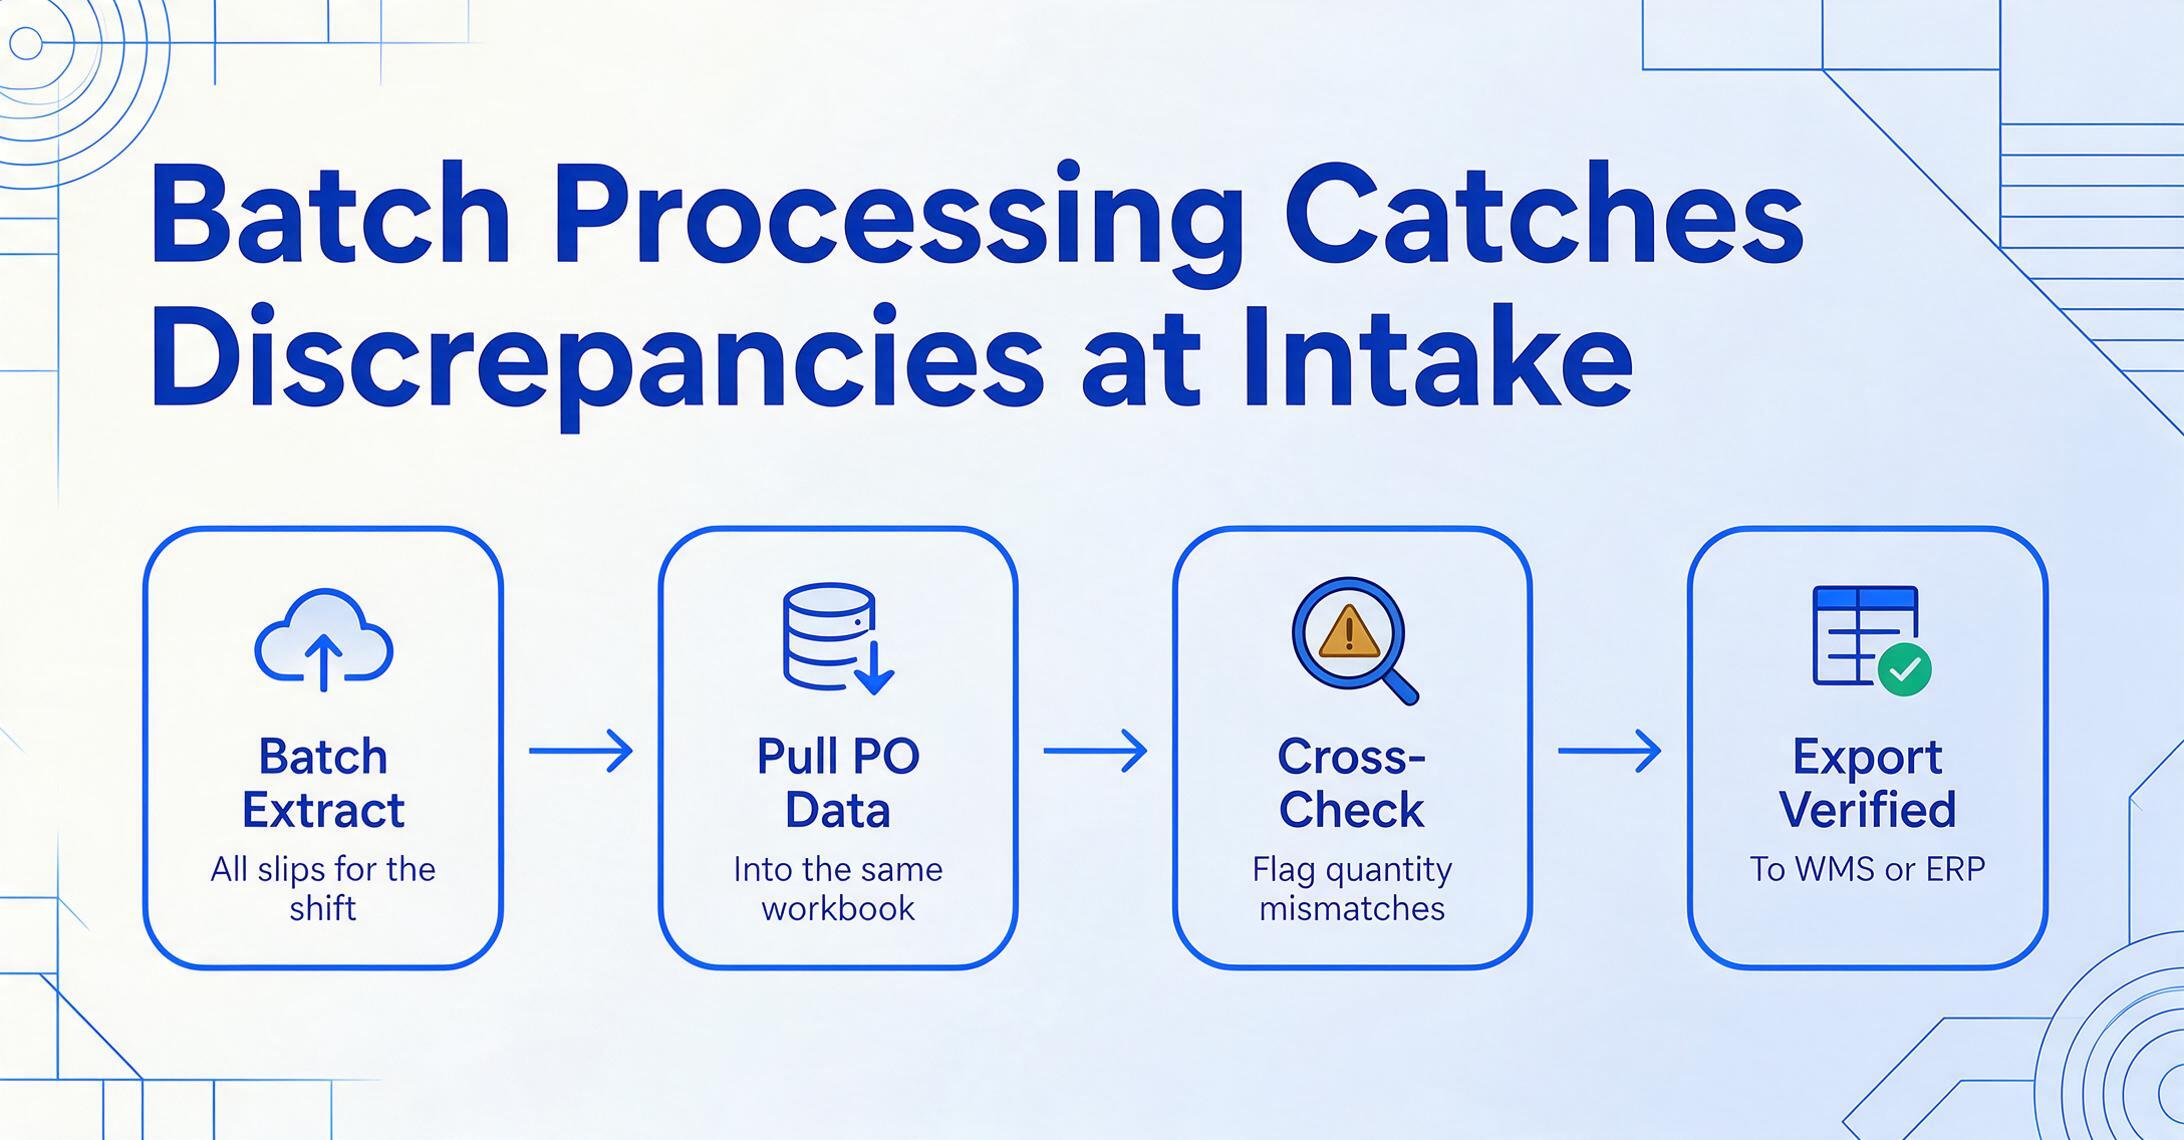
Mais le traitement par lots devient véritablement puissant lorsqu'on le combine à une étape de recoupement avec les données de vos bons de commande. Voici le flux de travail qui distingue une opération de réception qui détecte les écarts à l'arrivée de celle qui les découvre des semaines plus tard lors des inventaires :
Extraire par lots tous les bons de livraison du poste
Téléversez chaque bon de livraison reçu pendant le poste — quel que soit le fournisseur, le format ou le nombre de pages. Le résultat est un tableau structuré unique avec chaque ligne identifiée : référence du bon de commande, référence article, quantité commandée, quantité expédiée et quantité en attente.
Importer les données des bons de commande dans le même classeur
Exportez vos données de bons de commande — depuis SAP, NetSuite ou votre feuille de calcul d'approvisionnement — et chargez-les avec les données extraites des bons de livraison. Chaque bon de commande contient les quantités commandées auxquelles les quantités des bons de livraison doivent correspondre. Pour un guide complet sur l'extraction des données de bons de commande, consultez notre guide complet sur l'extraction de données de bons de commande.
Utiliser les colonnes calculées pour signaler automatiquement les écarts
Définissez une colonne de validation qui calcule Qté commandée PO − Qté expédiée bon de livraison. Toute ligne dont le résultat est non nul est signalée pour examen. Cela transforme le flux de réception de « saisir chaque chiffre en espérant que c'est juste » à « examiner uniquement les exceptions » — réduisant la charge de vérification de 100 % des lignes à 5–15 % de celles présentant un écart.
Exporter et importer les données propres dans votre WMS
Après examen, les données vérifiées des bons de livraison — avec les écarts signalés et résolus — sont prêtes pour l'importation dans le WMS. Exportez en CSV ou XLSX et chargez dans Manhattan Associates, Blue Yonder, SAP WM, NetSuite WMS ou tout système acceptant des données de réception structurées. Les données propres deviennent l'enregistrement de réception de marchandises qui alimente le rapprochement à trois voies.
Ce flux de travail transforme l'extraction d'un simple outil de saisie en un moteur de détection des écarts. Le principal facilitateur est la colonne calculée : une colonne qui n'extrait pas de données du document mais calcule une nouvelle valeur à partir des champs extraits. Vous pouvez définir des colonnes calculées pour la correspondance des quantités (Qté commandée − Qté expédiée), les contrôles de cohérence des unités de mesure, ou même la vérification du nombre de cartons en comparant les totaux de cartons extraits à ceux enregistrés par le transporteur. Pour une explication détaillée du fonctionnement des colonnes calculées dans l'extraction de documents, consultez notre aperçu de l'extraction de documents par IA avec colonnes calculées.
Export et intégration WMS
Le résultat de l'extraction n'est pas la destination. Les données doivent entrer dans un système — votre WMS, votre ERP ou votre feuille de réception — où elles alimentent les mises à jour d'inventaire, le rapprochement à trois voies et la réconciliation fournisseur. Le chemin d'export que vous choisissez détermine la quantité de travail manuel restant entre l'extraction et la saisie dans le système.
| Format d'export | Idéal pour | Points à considérer |
|---|---|---|
| XLSX (Excel) | Vérification manuelle, recoupement avec les données du bon de commande, audit des réceptions partielles, assistants d'import WMS pour les entreprises de taille intermédiaire | Les dates et les nombres doivent survivre à la conversion de format. Les numéros de bon de commande avec des zéros en tête peuvent être tronqués par Excel — vérifiez la préservation du format avant de vous appuyer sur cette voie. |
| CSV | Import SAP WM/EWM, Oracle WMS, NetSuite WMS, Manhattan Associates (WMOS), Blue Yonder, HighJump/Körber | Les descriptions d'articles multilignes contenant des virgules briseront les limites de lignes CSV si elles ne sont pas correctement échappées. Vérifiez que la sortie d'extraction utilise un encodage conforme à la RFC 4180. |
| JSON | Intégrations WMS/ERP personnalisées, pipelines de réception automatisés, flux de travail basés sur API | Les structures imbriquées de lignes d'articles (en-tête → cartons → articles) préservent proprement la hiérarchie d'expédition mais sont plus difficiles à vérifier manuellement. Idéal quand le destinataire est une machine, pas une personne. |
| Google Sheets | Équipes utilisant Google Workspace, vérification collaborative des réceptions, tableaux de bord de réception partagés | Élimine entièrement le cycle export-import si l'outil d'extraction prend en charge la sortie directe vers Sheets. Un module complémentaire Google Sheets pour l'extraction de bons de livraison peut écrire les données de réception directement dans votre feuille de suivi sans gestion intermédiaire de fichiers. |
La conversion de format est l'étape où une extraction propre peut encore devenir un fichier sale. Les dates arrivent avec une douzaine de conventions, les codes articles perdent leurs zéros en tête dès qu'un tableur les traite comme des nombres, et une description multiligne contenant une virgule brise la limite de ligne où elle se trouve. Une étape de post-traitement est ce qui évite que cela atteigne votre WMS : l'outil normalise les dates et les montants selon une convention unique et standardise les formats d'identifiants avant l'export, afin que la valeur imprimée sur le bon soit la valeur qui atterrit dans la colonne. Lorsque cette étape s'exécute avant l'export, le fichier est prêt pour l'assistant d'import WMS au lieu d'une passe de nettoyage manuel.
Pour la plupart des équipes d'entrepôt, le flux de travail pratique est : extraction par lots → vérification dans Excel/Sheets → import CSV dans le WMS. Ce chemin fonctionne avec toutes les grandes plateformes WMS — Manhattan Associates (WMOS) accepte les imports CSV de réception de marchandises, SAP WM/EWM utilise la saisie par lots via LS24, Blue Yonder (anciennement JDA) ingère les données de réception en fichier plat, HighJump/Körber prend en charge le CSV via son framework d'import de données, et Oracle WMS Cloud et NetSuite WMS ont tous deux des assistants d'import CSV pour les transactions de réception.
L'exigence critique sur tous les formats est que la sortie d'extraction préserve la relation ligne d'article-expédition : chaque ligne d'article doit porter le numéro de bon de livraison parent et la référence du bon de commande afin que le système de réception puisse rapprocher les quantités reçues de la bonne ligne de bon de commande. Une sortie plate qui perd cette hiérarchie — même temporairement pendant l'étape de vérification — oblige quelqu'un à reconstruire la relation manuellement, annulant ainsi le gain de temps de l'extraction.
Comment choisir un outil d'extraction de bons de livraison
Les critères suivants permettent de dépasser les arguments marketing pour identifier ce qui distingue réellement les outils dans l'usage quotidien en réception d'entrepôt. Testez-les plutôt que de vous fier aux listes de fonctionnalités.
Testez avec votre pire bon de livraison, pas votre meilleur
Tous les outils gèrent un bon de livraison propre d'une page provenant d'un grand fournisseur. Demandez à tester avec un bon de deux pages comportant plus de 30 lignes réparties sur la coupure de page, une ligne de livraison partielle avec trois colonnes de quantités, et une annotation manuscrite griffonnée sur une cellule du tableau. Si l'outil gère cela, il gérera tout le reste. Si le fournisseur hésite ou ne propose que des documents d'exemple, cette réponse est en soi un signal.
Vérifiez la préservation des colonnes de livraison partielle
Importez un bon de livraison où au moins une ligne affiche des valeurs différentes dans Qté commandée, Qté expédiée et Qté en attente. Vérifiez la sortie : les trois nombres sont-ils présents dans des colonnes distinctes et correctement étiquetées ? Tout outil qui les regroupe dans un seul champ « Quantité », ou qui confond quel nombre appartient à quelle colonne, ne peut pas prendre en charge la réception de livraisons partielles. C'est le test le plus important.
Le sans modèle est la base ; testez la résilience aux formats
Un fournisseur qui se dit « sans modèle » devrait gérer un bon de livraison d'un fournisseur dont il n'a jamais vu le format — en utilisant uniquement vos noms de colonnes comme instructions. Le test décisif : importez le même bon de livraison mais avec la mise en page d'un autre fournisseur — mêmes données, position différente. Si l'extraction échoue ou si la précision diminue, l'outil dépend des modèles, quel que soit le discours marketing.
La sortie par lots doit préserver la hiérarchie expédition-lignes
Lorsque vous extrayez par lots 30 bons de livraison, la sortie doit identifier quelles lignes appartiennent à quelle expédition — en incluant le numéro du bon de livraison et la référence du bon de commande sur chaque ligne de détail. Une sortie plate qui perd cette relation vous oblige à la reconstruire manuellement, ce qui annule le temps que l'extraction était censée faire gagner.
L'export doit survivre au transfert vers votre WMS
Prenez la sortie CSV de l'outil et tentez de l'importer dans votre WMS réel — pas un environnement de démonstration, votre système réel avec ses règles réelles de gestion des données. Vérifiez que les dates conservent leur format, que les quantités gardent leurs décimales, que les codes articles avec des zéros en tête ne sont pas tronqués, et que les descriptions sur plusieurs lignes ne cassent pas les limites de lignes du CSV. Ce test de 10 minutes détecte plus de problèmes d'intégration que n'importe quelle comparaison de fonctionnalités.
Pour une comparaison directe des performances des outils d'extraction sur les documents logistiques, y compris les bons de livraison, consultez notre revue des meilleurs outils d'extraction de documents logistiques.
Questions fréquentes
En quoi l'extraction de bons de livraison diffère-t-elle de l'extraction de notes de livraison ?
En pratique, les deux termes désignent le même type de document avec une différence de timing. Un bon de livraison enregistre ce qui a été emballé au moment de l'expédition — il voyage avec la marchandise et documente le contenu des cartons. Une note de livraison (ou preuve de livraison) confirme ce qui a été reçu à destination, comportant généralement une signature du destinataire et un horodatage. De nombreux fournisseurs utilisent les termes de manière interchangeable. Les équipes d'entrepôt rencontrent les deux documents du même fournisseur pour la même expédition, et un outil d'extraction performant les traite de manière identique — la structure des champs (lignes d'articles avec trois colonnes de quantités) est la même.
L'extraction de bons de livraison peut-elle gérer les avis d'expédition électroniques EDI 856 ?
L'EDI 856 est une norme d'échange de données informatisé — pas un format de document que les outils d'extraction traitent directement. Lorsqu'un fournisseur envoie un EDI 856, les données arrivent dans un format EDI structuré que votre WMS ou ERP peut intégrer sans extraction. L'extraction de bons de livraison comble le vide pour la majorité des fournisseurs qui n'envoient pas d'EDI — ou qui envoient l'EDI 856 mais joignent quand même un bon de livraison PDF. La plupart des opérations utilisent l'EDI pour les grands fournisseurs et l'extraction pour les autres, les traitant comme des méthodes d'admission complémentaires plutôt que comme des alternatives.
Quelle précision puis-je attendre de l'extraction de bons de livraison ?
Sur des bons de livraison PDF numériques propres (imprimés par le fournisseur, sans écriture manuscrite, bon contraste), les données de tableaux imprimés sont extraites avec une précision allant jusqu'à 99 %. Les lignes d'articles sont là où la précision diminue : chaque ligne ajoutée est une occasion supplémentaire de désalignement de colonne, de débordement de description ou d'unité de mesure atterrissant dans le mauvais champ. Un bon de livraison multipage dense obtient donc un score inférieur à celui d'un bon d'une page propre du même fournisseur. Les bons numérisés et les photos de téléphone avec ombres ou inclinaison réduisent encore la précision, et les bons où l'écriture manuscrite domine sont le cas le plus difficile de tous. Comparez cela à la saisie manuelle : des recherches évaluées par des pairs sur les erreurs de saisie de données estiment les erreurs au niveau des champs à environ 1 à 3 % par champ saisi, ce qui signifie qu'un bon de livraison de 40 champs a 33 à 70 % de chances de contenir au moins une erreur de frappe. L'avantage de l'extraction n'est pas que les erreurs sont éliminées. C'est que les erreurs sont signalées pour examen lors de l'étape de vérification plutôt que d'être enfouies dans le WMS jusqu'à ce qu'un inventaire ou une exception de rapprochement les révèle.
L'extraction de bons de livraison fonctionne-t-elle avec des images de qualité photo provenant d'un téléphone ?
Oui, avec des réserves sur la qualité de l'image. Une photo de bon de livraison bien éclairée et nette prise avec un téléphone est extraite avec une précision de 85 à 95 % — proche de la qualité d'un PDF numérisé. Les modes de défaillance sont : les ombres sur le document (fréquentes lors de la photographie sur un quai de réception), une inclinaison importante (le téléphone tenu en angle, pas à plat) et un recadrage partiel qui coupe les en-têtes de colonnes. Un flux de réception incluant des photos de téléphone devrait intégrer un contrôle rapide de la qualité de l'image avant l'extraction — rejeter les photos floues ou fortement ombragées et les reprendre. L'IA de vision moderne gère mieux la dégradation modérée que l'OCR traditionnel, car elle utilise le contexte pour combler les lacunes, mais elle ne peut pas reconstruire des données qui n'ont jamais été capturées dans l'image.
Comment l'extraction gère-t-elle les bons de livraison de fournisseurs internationaux avec des champs non anglais ?
Les modèles d'IA de vision entraînés sur des documents multilingues peuvent extraire les champs des bons de livraison quelle que soit la langue des libellés. Une colonne intitulée « Quantité expédiée » en français, « Versandte Menge » en allemand ou 出荷数 en japonais est reconnue comme le même champ, car l'IA lit le rôle sémantique de la colonne plutôt que de faire correspondre un dictionnaire de libellés étrangers. Les noms des champs de sortie restent en anglais (tels que vous les avez définis), mais les valeurs extraites proviennent du document dans la langue utilisée par le fournisseur. Cela est pertinent pour les entrepôts qui reçoivent des marchandises de fournisseurs internationaux ou qui traitent des documents de livraison multilingues ; notre guide sur le traitement par lots de documents de bon de livraison français montre comment cela fonctionne sur des dizaines de formats de fournisseurs à la fois.
Quelle est la différence entre l'extraction de bon de livraison et la saisie de réception de marchandises (GR) ?
L'extraction de bon de livraison est l'étape de capture des données : transformer le bon imprimé en champs numériques. La saisie de réception de marchandises est la transaction d'inventaire : enregistrer que les articles sont désormais physiquement en stock et disponibles. Ce sont des étapes séquentielles du même flux de travail. L'extraction produit les données structurées qui alimentent la saisie de réception de marchandises. Dans un processus manuel, le magasinier saisit les données du bon de livraison directement dans l'écran de réception de marchandises. Avec l'extraction, les données sont capturées automatiquement à partir du bon, puis vérifiées avant que la transaction de réception de marchandises ne soit validée. L'étape d'extraction supprime la saisie ; la transaction de réception de marchandises reste un point de contrôle.
Comment gérer les bons de livraison qui combinent plusieurs bons de commande dans un même envoi ?
Certains fournisseurs regroupent des articles de plusieurs bons de commande dans un seul envoi et un seul bon de livraison. Le tableau des lignes contient alors plusieurs références de bons de commande — chaque ligne peut référencer un bon de commande différent. L'outil d'extraction doit capturer la référence du bon de commande par ligne, sans supposer qu'un seul bon de commande s'applique à tout l'envoi. C'est un comportement standard pour les outils d'extraction sémantique, car ils lisent chaque ligne individuellement. Après l'extraction, la sortie se divise naturellement : les lignes du BC-1001 vont vers une réception de marchandises, les lignes du BC-1002 vers une autre. La référence du bon de commande par ligne est le champ critique pour ce scénario — vérifiez que l'outil la capture au niveau des lignes, pas seulement au niveau de l'en-tête.
L'extraction de bon de livraison peut-elle s'intégrer directement à mon WMS existant ?
La plupart des outils d'extraction ne proposent pas d'intégrations WMS préconstruites. Le flux de travail standard est : extraire en CSV → importer le CSV dans le WMS. Cette voie fonctionne avec tous les principaux WMS, car chaque WMS dispose d'une fonction d'importation de données pour les transactions de réception — Manhattan Associates, SAP WM/EWM, Blue Yonder, HighJump/Körber, Oracle WMS Cloud et NetSuite WMS acceptent tous des données de réception de marchandises structurées en CSV. Quelques outils proposent une validation directe par API pour les intégrations personnalisées, mais la voie CSV est universelle et ne nécessite aucune configuration informatique. L'exigence clé est que la sortie CSV de l'outil d'extraction soit structurée comme votre WMS attend ses données de réception — avec des en-têtes correspondant au mappage des champs d'importation du WMS.
Quel volume de bordereaux justifie un investissement dans l'extraction ?
En règle générale : si votre réception traite plus de 30 bordereaux par jour provenant de plus de 5 fournisseurs différents, l'extraction génère des gains de temps mesurables. En dessous de ce volume, la revue de 5 minutes par lot peut annuler les économies de saisie. Le vrai seuil est la diversité des formats fournisseurs, pas le volume brut. Trente bordereaux par jour de 20 fournisseurs avec 20 formats différents justifient davantage l'extraction que 100 bordereaux de 2 fournisseurs aux formats identiques. Chaque format unique ajoute une charge cognitive : trouver la référence de commande à un endroit différent sur chaque bordereau, distinguer Qté commandée de Qté expédiée dans des mises en page qui les nomment différemment. L'extraction supprime cette charge entièrement — vous définissez vos colonnes une fois, quel que soit le nombre de formats utilisés par vos fournisseurs.
Que faire si l'outil d'extraction lit mal un champ — puis-je le corriger sans retraiter ?
Oui. Le fichier d'extraction — XLSX ou CSV — est modifiable. Si un champ est mal lu, corrigez-le directement dans le tableur avant l'import dans le WMS. La valeur de l'extraction n'est pas une précision parfaite à 100 % — aucun outil n'y parvient. Sa valeur est de transformer un processus nécessitant la saisie de 100 champs par quart en un processus nécessitant la vérification de 5 à 10 champs. L'étape de revue n'est pas un échec de l'extraction ; c'est le contrôle qualité qui garantit l'exactitude des données entrant dans votre WMS. La question n'est pas « fait-il des erreurs ? » mais « réduit-il le nombre de champs à traiter, passant de tout saisir à en vérifier quelques-uns ? »
De la réception aux données : l'essentiel
L'extraction de bons de livraison ne remplace pas votre WMS — Manhattan, SAP WM, Blue Yonder et HighJump assurent l'essentiel du contrôle des stocks et de l'entrepôt. Ce qu'elle fait, c'est combler l'écart entre l'endroit où les données d'expédition arrivent (un bon papier scotché sur une palette au quai de réception) et l'endroit où elles doivent atterrir (un enregistrement structuré dans votre système de réception, prêt pour la vérification). Cet écart est actuellement comblé par des saisies manuelles avec un taux d'erreur de 1 à 3 % par champ, multiplié par des centaines de champs par équipe — avec des conséquences qui vont des écarts d'inventaire aux blocages de factures fournisseurs en passant par les litiges avec les fournisseurs.
Les trois éléments qui distinguent un déploiement d'extraction efficace d'un déploiement frustrant : (1) l'outil gère les livraisons partielles avec trois colonnes de quantités distinctes, pas une seule ; (2) il traite les formats mixtes de fournisseurs en un seul lot sans travail de modèle par fournisseur ; (3) son export s'importe proprement dans votre WMS réel sans corruption de format. Tout le reste — pourcentages de précision, promesses d'IA, listes de fonctionnalités — est secondaire face à ces trois réalités opérationnelles.
Si vous évaluez une solution d'extraction pour votre opération de réception, commencez par tester sur votre bon de livraison le plus difficile — le bon multi-pages d'un fournisseur industriel avec 40 lignes réparties sur un saut de page, une ligne de livraison partielle indiquant commandé vs expédié vs en attente, et une annotation manuscrite dans la marge. Si un outil gère votre pire cas, il gérera votre cas moyen. Si vous êtes prêt à voir comment l'extraction de bons de livraison fonctionne sur vos propres documents, téléversez un bon de livraison échantillon et voyez quelles données structurées en ressortent — ou si vous utilisez déjà Google Sheets, essayez le flux Sheets pour les données de bons de livraison.