La guía completa para
la extracción de datos de albaranes de entrega
La encuesta de costos de almacenamiento y cumplimiento de WERC 2024 sitúa la mano de obra de recepción en $40.79 por hora, y los puntos de referencia de APQC muestran una diferencia de 44 horas en el tiempo de recepción a almacenamiento entre los mejores y los peores resultados — una brecha impulsada no por la velocidad de las carretillas elevadoras, sino por cuánto tiempo permanecen los datos de envío entre "mercancía recibida" e "inventario actualizado". La extracción de datos de albaranes de entrega se encuentra en el centro de esa brecha: determina si cada envío de proveedor que llega a su muelle se convierte en un registro utilizable en su WMS en el mismo turno, o si espera una entrada manual que introduce errores y retrasos que se acumulan en la conciliación a tres bandas, la precisión del inventario y la conciliación con proveedores.
Conclusiones clave
- Un albarán de entrega de 40 campos tiene una probabilidad del 33 al 70% de llevar un error de tecleo a su WMS que permanece invisible hasta que una excepción de conciliación a tres bandas o un inventario cíclico lo saca a la luz semanas después.
- El costo visible de entrada de datos de $32,000 por puesto de recepción oculta un costo mucho mayor que nadie rastrea porque está disperso entre retenciones de cuentas por pagar, investigaciones de reclamaciones a proveedores y correcciones de inventario fantasma.
- No necesita escribir menos números — necesita una definición de columna que conserve los tres campos de cantidad por línea de artículo y una fórmula de verificación cruzada que señale las discrepancias, convirtiendo un turno de 100 campos de una tarea de tecleo en una revisión de cinco campos.
Antes de Esta Guía: Qué Es la Extracción de Albaranes de Entrega
¿Nuevo en el concepto? Comience con nuestro artículo qué es la extracción de datos de albaranes de entrega — cubre la definición central, una comparación entre manual, plantilla e IA, y cuándo realmente necesita extracción frente a cuándo no. Esta guía asume ese contexto y continúa desde ahí: el costo operativo de seguir en modo manual, los desafíos específicos que separan una extracción capaz de resultados parciales, la lista completa de campos, y cómo evaluar herramientas frente a su operación de recepción real.
La única distinción que vale la pena reiterar aquí porque el resto de esta guía depende de ella: un albarán de entrega no es una factura. Una factura incluye precios, condiciones de pago e importes de impuestos para cuentas por pagar. Un albarán de entrega incluye datos de envío para la recepción del almacén — y su rasgo estructural definitorio son tres columnas de cantidad por línea de artículo (pedido, enviado, pendiente) en lugar de las columnas de precio/impuestos de una factura. Todo lo que sigue asume esa estructura.
Por Qué el Procesamiento Manual de Albaranes de Entrega Cuesta Más de Lo Que Cree
El costo visible es aritmética sencilla. Los datos de referencia de WERC sitúan la mano de obra de recepción en $40.79 por hora. Un empleado de recepción que procesa 60 albaranes de entrega por turno a 3 minutos cada uno dedica 3 horas — el 37.5% del turno — solo a la entrada de datos. A $40.79 por hora, eso son $122 por turno en trabajo de tecleo, o aproximadamente $32,000 por puesto de recepción al año. Para un almacén mediano con 3 estaciones de recepción, se acerca a seis cifras antes de contar un solo error.
Pero el costo visible es el número más pequeño. Los costos ocultos se acumulan en tres áreas.
Excepciones en la conciliación a tres bandas. Cada cantidad mal tecleada o número de pedido transpuesto en un albarán de entrega crea una discrepancia cuando el equipo de cuentas por pagar compara la orden de compra contra el albarán de entrega contra la factura del proveedor. Los puntos de referencia de APQC muestran que los equipos de compras promedio enfrentan una tasa de excepción del 22% en la conciliación de facturas, y cada discrepancia cuesta aproximadamente 30 minutos de investigación entre recepción, compras y finanzas. Un albarán de entrega donde se tecleó "80" en lugar de "100" — un solo error de tecla — provoca una retención en cuentas por pagar, una llamada al proveedor, una re-verificación de lo que realmente llegó y un ajuste. La causa raíz no es el proveedor ni un error en el muelle; es el paso administrativo entre el albarán y el sistema. Los equipos de mejor rendimiento mantienen las tasas de excepción en el 9%. La diferencia radica en gran medida en si los datos que entran al sistema son los datos impresos en el documento o lo que alguien tecleó.
Conciliación de envíos parciales. Cuando un proveedor envía 80 de 100 unidades, el albarán de entrega muestra tres números: pedido, enviado (80), pendiente (20). El empleado de recepción debe teclear los tres, y el WMS debe rastrear las cantidades recibidas contra cada línea de la orden de compra a través de múltiples entregas. El procesamiento manual de envíos parciales es donde las tasas de error se disparan — porque el empleado no está tecleando un número, sino distinguiendo cuál de las tres cantidades pertenece a cada campo, bajo presión de tiempo, mientras el siguiente camión espera. Una sola transposición — teclear 100 en la columna "enviado" y 80 en la columna "pedido" — invierte la cantidad recibida y crea un excedente fantasma de 20 unidades en el inventario que solo se descubrirá en el siguiente inventario cíclico, semanas después.
Reembolsos de proveedores. Los reembolsos por discrepancias de los proveedores son uno de los costos operativos más subestimados. Cuando un proveedor envía 100 unidades, su equipo de recepción registra 80 y la factura del proveedor por 100 unidades se disputa, el proceso de resolución generalmente implica: (1) el proveedor solicita una foto de prueba de entrega, (2) alguien en recepción localiza físicamente el recibo de entrega firmado, (3) el equipo de cuentas por pagar compara la confirmación de entrega del transportista con el registro, (4) se emite un reembolso o una corrección. Cada investigación de reembolso consume 30 a 60 minutos en múltiples roles, y el costo no se rastrea en el presupuesto de ningún departamento en particular. La investigación de WERC indica que la precisión de la recepción se correlaciona directamente con la incidencia de reembolsos, aunque pocos almacenes miden el costo de los errores de entrada de datos que los provocan.
Para un análisis más profundo de los costos por albarán y por turno, consulte nuestro desglose de los costos de procesamiento manual de albaranes de entrega.
Los Desafíos Únicos de la Extracción de Albaranes de Entrega
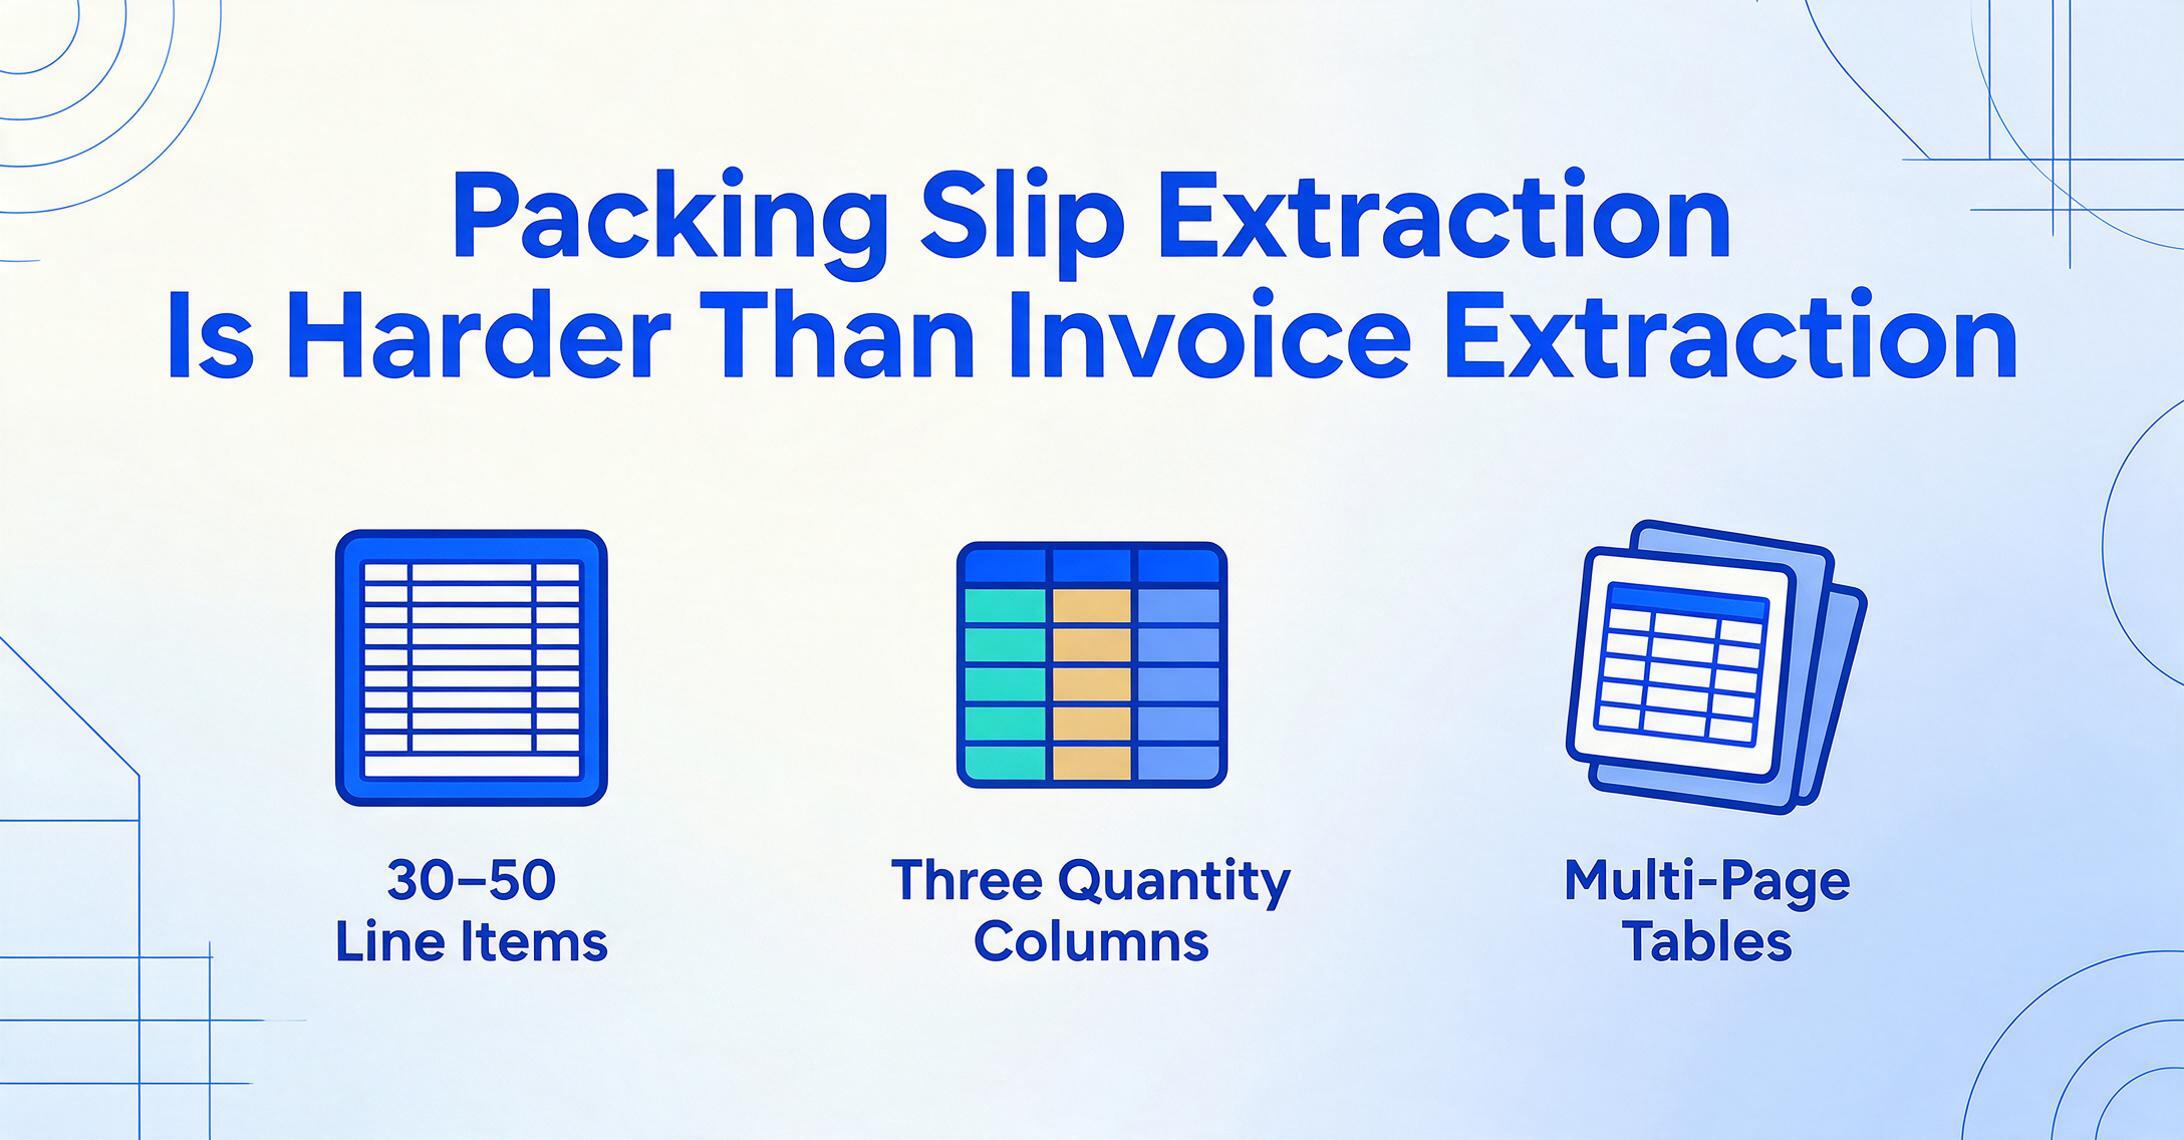
La extracción de albaranes de entrega es más difícil que la extracción de facturas por razones que importan a cualquiera que evalúe herramientas. Comprender estos desafíos de antemano determina si la herramienta que elija manejará su flujo de trabajo diario real o solo el escenario de demostración.
1. Densidad de Líneas de Artículos
Un albarán de entrega típico de un proveedor industrial como Grainger o MSC Industrial puede contener de 30 a 50 líneas de artículos en dos o tres páginas. Cada línea tiene su propio código de artículo, descripción, cantidad pedida, cantidad enviada, cantidad pendiente y unidad de medida. La tabla de líneas de artículos es la carga crítica: el 80–90% de los datos que necesitan extracción se encuentran allí, y es donde fallan la mayoría de las herramientas de extracción.
Las tablas de varias páginas introducen un problema de continuidad: cuando una tabla de 50 filas se extiende de la página 1 a la página 2, el motor de extracción debe reconocer que es una sola tabla que continúa, no dos tablas separadas. Los encabezados de columna pueden repetirse o no en las páginas de continuación. Algunos proveedores imprimen encabezados en cada página; otros los imprimen solo en la página 1. Una herramienta de extracción que pierde la alineación de columnas en el salto de página desplaza silenciosamente los valores a columnas incorrectas desde el salto en adelante: un código de artículo del proveedor termina en la columna de descripción y una cantidad enviada termina en la columna de pedido pendiente, y el resultado parece completo pero está estructuralmente corrupto.
2. Envíos Parciales: Tres Columnas de Cantidad
Este es el desafío principal de la extracción de albaranes. Una factura tiene una columna de cantidad. Un albarán tiene tres: Cant. Pedida, Cant. Enviada y Cant. Pendiente. Cada línea contiene los tres números, y la extracción debe preservar su identidad — no solo capturar los valores numéricos.
Un escenario de envío parcial: pediste 100 unidades del SKU-00412. El proveedor envía 80, deja 20 pendientes. El albarán muestra columnas tituladas "Ped", "Env" (80), "Pte" (20). La herramienta de extracción debe entender qué columna es cuál y enviarlas a los campos correctos. Una herramienta que trata las tres como un solo campo "Cantidad", o que confunde "Env" con "Ped" en un diseño de envío parcial, produce una salida inservible para la verificación de recepción — no se puede determinar si el envío está completo o parcial solo con los datos extraídos. El flujo de recepción depende de ver las tres cantidades lado a lado por cada línea, para que el equipo de muelle sepa qué necesita seguimiento con el proveedor.
3. Anotaciones Manuscritas en el Almacén
Los albaranes no llegan en estado estéril. Los receptores los anotan: cantidades marcadas donde se verificó el conteo, notas manuscritas de "faltante" junto a una línea, firmas del receptor, marcas de tiempo, códigos de daño ("1 CTN aplastado — rechazado") y observaciones del transportista. Estas anotaciones tienen importancia operativa — son el registro principal de lo ocurrido en el muelle de recepción — pero se superponen a los datos impresos, a menudo solapando celdas de tabla o saturando los encabezados de columna.
El OCR tradicional es particularmente débil aquí: un "80" manuscrito sobre un "100" impreso produce lecturas de caracteres contradictorias. Un modelo de IA visual, en cambio, usa el contexto del documento — la estructura de la tabla, las etiquetas de los encabezados, los datos impresos circundantes — para distinguir la anotación del texto original y capturar ambos. La anotación no es un defecto a sortear; son datos que deben extraerse junto con los campos impresos. Para un análisis detallado de este problema, consulta nuestro artículo sobre extracción de notas de entrega manuscritas en recepción de almacén.
4. Albaranes de Varias Páginas
Un proveedor puede adjuntar un albarán de varias páginas cuando el envío contiene cajas mixtas: la página 1 es el resumen del envío y la información del transportista, las páginas 2 a 4 son el detalle a nivel de caja, y la página 5 es una autorización de devolución de material. La herramienta de extracción debe navegar esta estructura, reconocer dónde termina un tipo de documento y comienza otro, y extraer solo los datos relevantes del albarán sin confundirse con el formulario RMA ni con el conocimiento de embarque del transportista adjunto al final.
5. Lote de Entrada con Formatos Mixtos
Un solo turno de recepción puede manejar: un albarán estándar de Grainger (PDF, una página, vertical), una nota de entrega de McMaster-Carr (impresa desde web, dos páginas), una etiqueta térmica de Fastenal (formato estrecho, apaisado) y una foto de una nota de entrega manuscrita de un proveedor local, todo en la misma ventana de 30 minutos. Procesar cada tipo de formato con una plantilla o herramienta separada va en contra del propósito de la automatización. La solución de extracción debe manejar formatos mixtos en un solo lote, aplicando las mismas definiciones de columnas a todos ellos, porque la salida debe llegar a la misma tabla de recepción del WMS independientemente del formato que haya enviado cada proveedor.
Campos Clave para Extraer de un Albarán
Los campos del albarán se dividen en dos categorías. Los campos de cabecera aplican a todo el envío; los campos de línea se repiten por cada fila de la tabla. Comprender qué campos son críticos para su flujo de conciliación posterior determina cómo configura sus columnas de extracción.
| Campos de Cabecera (uno por albarán) | Dificultad de Extracción | Por Qué es Importante |
|---|---|---|
| Número de Albarán / Nota de Entrega | Baja | Clave principal para seguimiento, consulta de proveedor y pista de auditoría |
| Fecha (Envío / Emisión) | Baja | Informe de antigüedad de recepciones abiertas; determina el inicio del reloj de recepción a almacén |
| Referencia de Orden de Compra / SO | Media | Vincula el envío con la OC para conciliación triple; formatos de etiqueta inconsistentes entre proveedores |
| Dirección de Origen (Proveedor / Almacén) | Media | Proveedores con múltiples ubicaciones pueden enviar desde diferentes instalaciones; necesario para enrutar devoluciones |
| Dirección de Destino (Su Ubicación de Recepción) | Baja | Confirma la ruta de entrega; señala cross-dock si la ubicación incorrecta recibe el envío |
| Nombre del Transportista | Baja | Asignación de citas de recepción, asignación de costos de flete de entrada |
| Número de Seguimiento / PRO | Media | Consulta de transportista, recuperación de comprobante de entrega; formatos muy variables |
| Número de Cajas / Palés | Media | Verificación previa a la recepción: ¿coinciden las cajas en el muelle con el albarán? |
| Peso Total | Baja | Auditoría de flete, verificación de facturación del transportista |
| Firma del Receptor | Alta | Comprobante de entrega; se necesita extracción de escritura a mano + contexto |
| Campos de líneas de artículo (varios por albarán) | Dificultad de extracción | Por qué es importante |
|---|---|---|
| Código de artículo / SKU / Número de pieza | Media | Los códigos del proveedor y los internos suelen diferir; se necesita un mapeo de referencias cruzadas |
| Descripción del artículo | Alta | Texto libre, multilínea, puede incluir especificaciones o números de serie; rica pero variable |
| Cantidad pedida | Media | Debe coincidir con la línea de la orden de compra; base para la comparación de envíos parciales |
| Cantidad enviada | Media | Cantidad realmente recibida; campo clave para la verificación de recepción y la conciliación a tres bandas |
| Cantidad pendiente | Alta | Identifica envíos incompletos; impulsa el flujo de seguimiento con el proveedor |
| Unidad de medida | Alta | "EA" / "PCS" / "CTN" / "BOX" — sin estándar; debe conservarse tal cual para el mapeo de unidades de medida |
Las tres columnas de cantidad — pedida, enviada, pendiente — son lo que distingue la extracción de albaranes de entrega de cualquier otro tipo de documento. Una herramienta de extracción que las fusione en un solo campo, o que las capture sin preservar cuál es cuál, ha fallado en su función principal. Verifique esto antes de comprometerse con cualquier herramienta: suba un albarán de entrega con al menos una línea de envío parcial y compruebe si las tres cantidades aparecen en las columnas de salida correctas.
Extracción de albaranes de entrega: tradicional vs. con IA
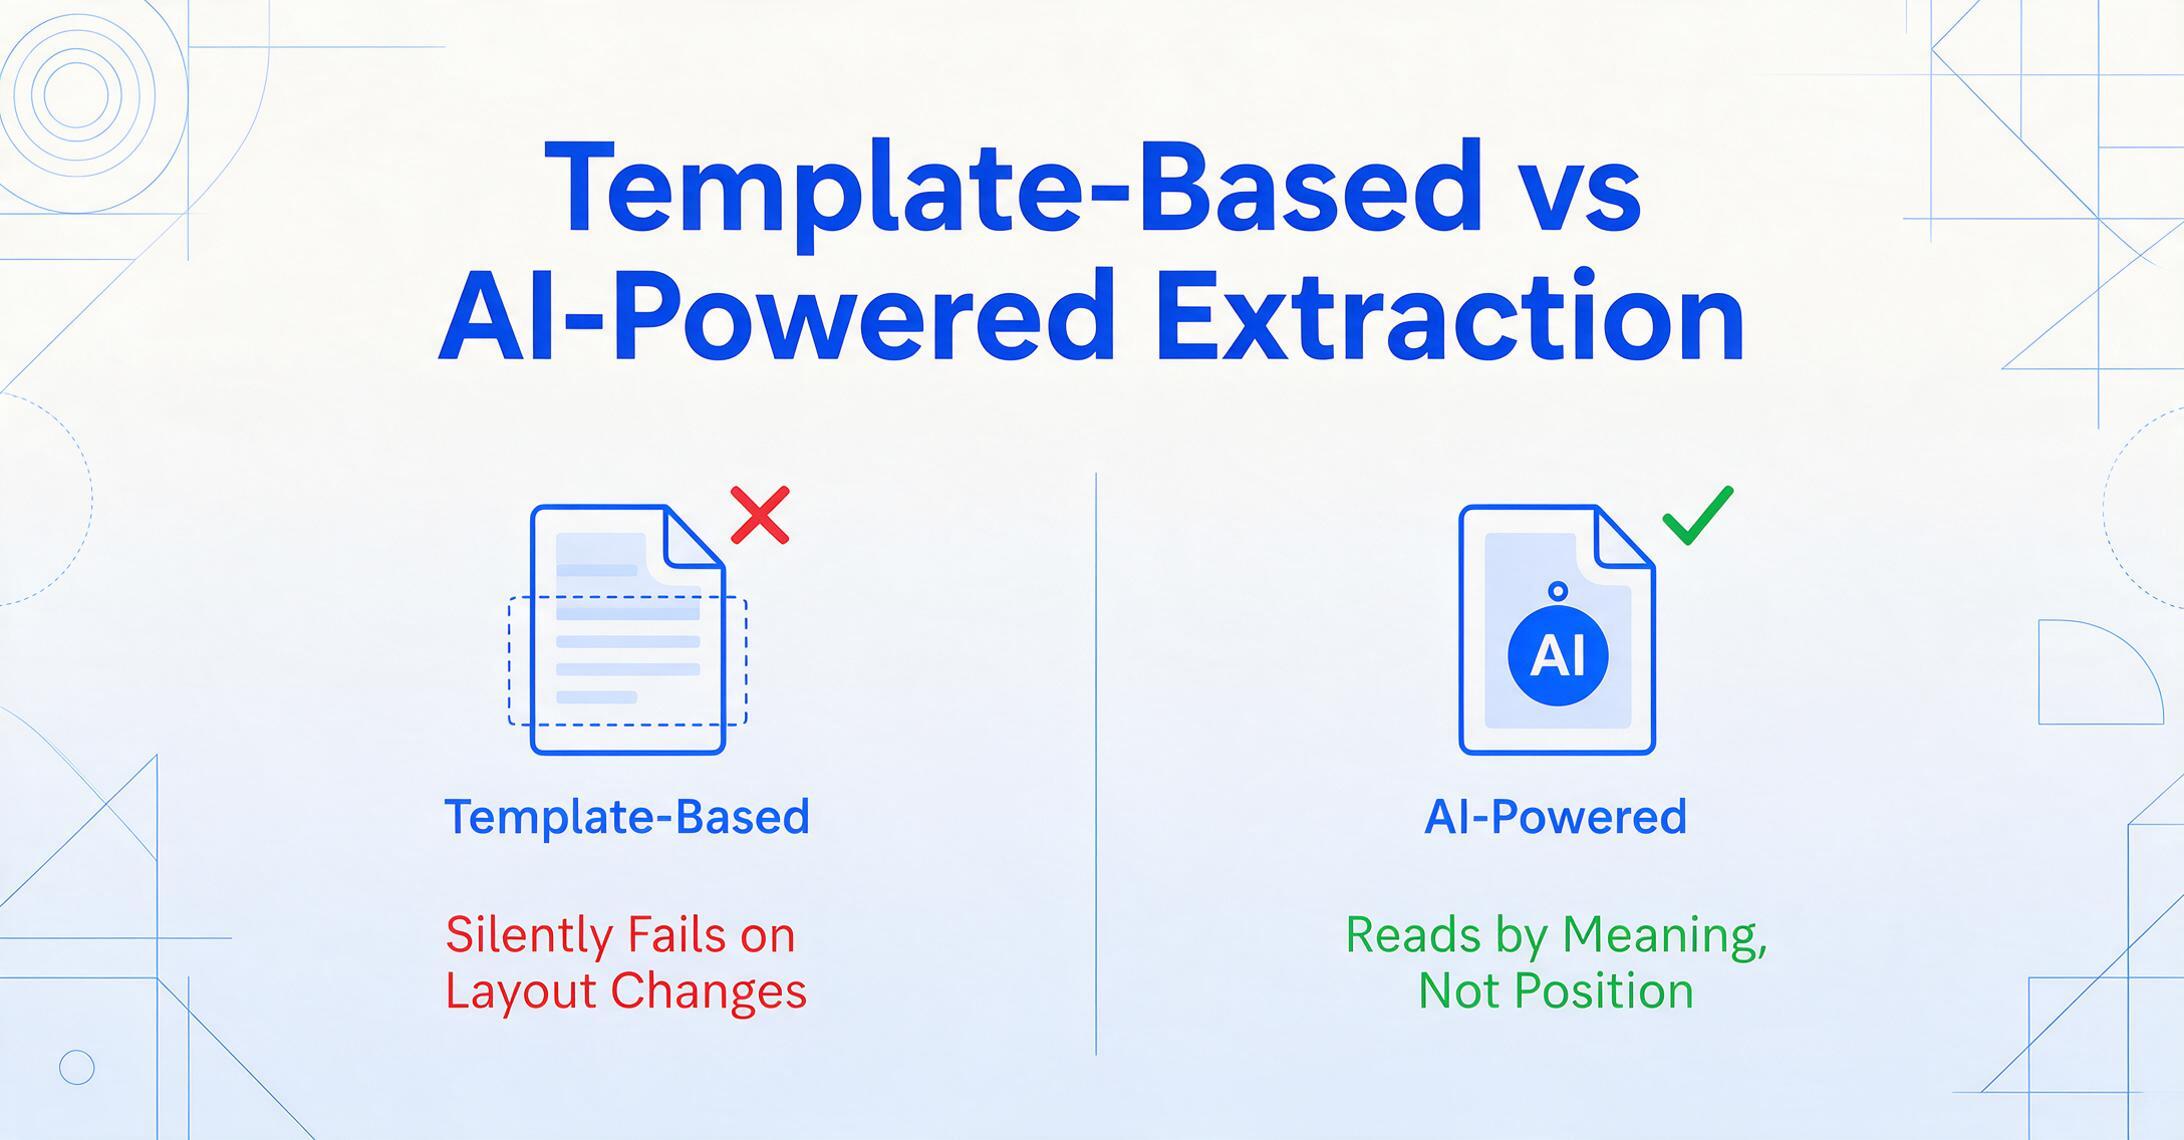
No toda la tecnología de extracción maneja los desafíos anteriores por igual. La distinción fundamental está entre la extracción basada en plantillas (posicional) y la extracción semántica (con IA) — y entender esta diferencia es el paso de evaluación más importante que puede dar.
La extracción basada en plantillas requiere configurar una zona de análisis para el diseño de documento de cada proveedor. Dibuja un rectángulo alrededor de donde aparece la referencia de la orden de compra en el albarán del Proveedor A, otro rectángulo alrededor del encabezado de la tabla de líneas de artículo, y define los anchos de columna. Cuando el Proveedor A reformatea su albarán — cambiando el diseño tras una actualización del ERP — su plantilla falla silenciosamente. Los valores terminan en columnas equivocadas. Descubre el problema cuando un empleado de recepción nota que las cantidades aparecen en el campo de descripción, o no aparecen en absoluto.
El enfoque basado en plantillas falla de forma más evidente en la tabla de líneas de detalle. Una plantilla asume que la tabla comienza en una fila fija y que las columnas tienen anchos fijos. Pero los albaranes de entrega de los proveedores varían en cuántas filas de encabezado preceden a la tabla, si los encabezados de columna se repiten, si las líneas abarcan varias filas de texto y si las agrupaciones a nivel de caja están anidadas dentro de la tabla. Una plantilla que funciona para la tabla de 30 filas de un proveedor con frecuencia se desalinea con la tabla de 50 filas de otro que tiene celdas de descripción combinadas. La encuesta de Levvel Research sobre costos de ingreso de datos señala que más del 30% de las discrepancias en el procesamiento de documentos se atribuyen a un procesamiento inconsistente, que es exactamente lo que introduce la extracción basada en plantillas: procesamiento consistente de la inconsistencia, que produce resultados incorrectos que parecen correctos.
Extracción semántica — extracción impulsada por IA mediante modelos de lenguaje de visión — funciona por significado, no por posición. Usted define las columnas que desea: "Número de albarán de entrega", "Referencia de orden de compra", "Código de artículo", "Cantidad pedida", "Cantidad enviada", "Cantidad pendiente", "Unidad de medida". La IA lee el documento completo — la sección de encabezado, la tabla de líneas de detalle, las anotaciones al pie — y localiza cada valor al comprender qué representa semánticamente, sin importar dónde se encuentre en la página. Un campo etiquetado como "Ord" en el albarán de un proveedor, "Cant." en el de otro y "Pedido" en un tercero se reconoce como lo mismo porque la IA comprende el rol semántico. Esto es Extracción de Columnas Personalizadas: usted define la salida una vez, y la IA localiza los datos coincidentes por significado, no por coordenadas.
La diferencia operativa es el mantenimiento de plantillas. Con plantillas, cada nuevo proveedor — o cada cambio de formato de un proveedor existente — requiere trabajo de plantilla. Para un almacén que recibe de más de 50 proveedores, cada uno con sus propias variaciones de formato, el mantenimiento de plantillas se convierte en un costo operativo continuo que compensa el ahorro de mano de obra de la automatización. Con la extracción semántica, la misma definición de columna funciona en todos los proveedores porque la lógica de extracción es independiente del formato. Un albarán de entrega de un proveedor que nunca haya procesado antes — con un diseño que la IA nunca haya visto — se extrae correctamente en la primera carga, porque la IA lee la semántica del albarán de entrega, no sus coordenadas.
Para obtener más información sobre por qué los formatos de albaranes de entrega de los proveedores divergen y por qué siempre lo harán, consulte nuestro artículo sobre inconsistencia en los formatos de albaranes de entrega.
Los archivos se procesan de forma segura y no se almacenan.
Procesamiento por lotes: verificación cruzada con datos de órdenes de compra
La extracción de un solo albarán resuelve el problema de entrada de datos por documento. El procesamiento por lotes resuelve el desafío del rendimiento y desbloquea una capacidad que el procesamiento individual no puede ofrecer: la verificación cruzada automatizada de las cantidades de los albaranes de entrega contra los datos de la orden de compra.
En un flujo de trabajo por lotes, usted sube 20, 30 o 50 albaranes de entrega de diferentes proveedores en un solo lote: algunos en PDF, algunos como fotos de teléfono, algunos de varias páginas. El motor de extracción procesa todos con las mismas definiciones de columnas y combina los resultados en una sola hoja de cálculo. Cada albarán de entrega se convierte en una fila en la tabla de encabezado; cada línea de artículo se convierte en una fila de detalle con los campos de encabezado repetidos. Para el flujo de trabajo paso a paso, consulte nuestra guía de extracción por lotes de albaranes de entrega a Excel.
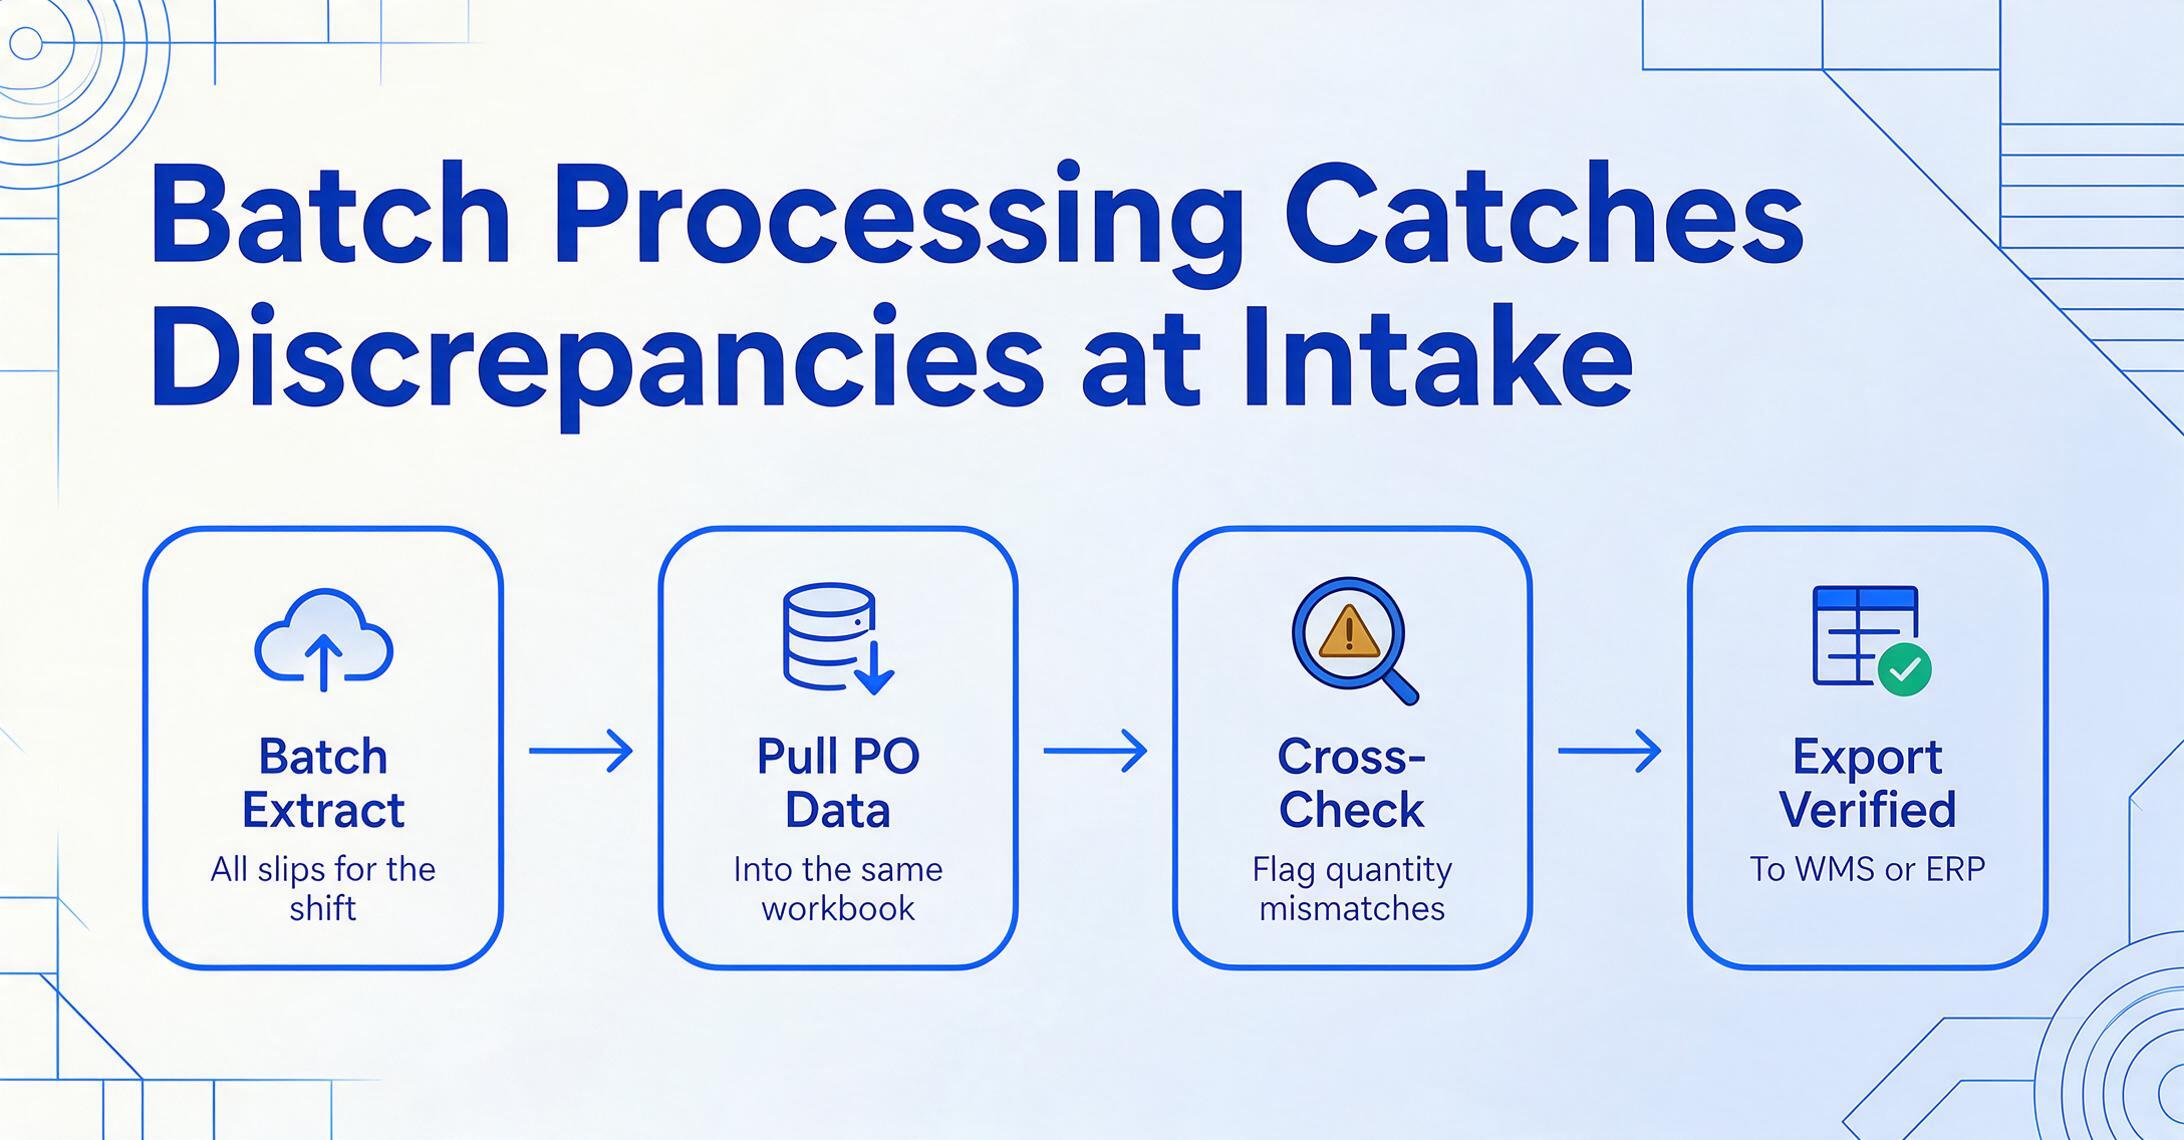
Pero el procesamiento por lotes se vuelve verdaderamente potente cuando se combina con un paso de verificación cruzada contra los datos de su orden de compra. Este es el flujo de trabajo que distingue una operación de recepción que detecta discrepancias en el momento de la entrada de una que las descubre semanas después durante los inventarios cíclicos:
Extraiga por lotes todos los albaranes de entrega del turno
Cargue todos los albaranes de entrega recibidos durante el turno, independientemente del proveedor, formato o número de páginas. El resultado es una única tabla estructurada con cada línea de artículo identificada: referencia de la orden de compra, código de artículo, cantidad pedida, cantidad enviada y cantidad pendiente.
Incorpore los datos de las órdenes de compra al mismo libro de trabajo
Exporte los datos de sus órdenes de compra (desde SAP, NetSuite o su hoja de cálculo de compras) y cárguelos junto a los datos extraídos de los albaranes de entrega. Cada orden de compra contiene las cantidades pedidas con las que deben coincidir las cantidades de los albaranes. Para ver una guía completa sobre cómo extraer datos de órdenes de compra, consulte nuestra guía completa sobre extracción de datos de órdenes de compra.
Use columnas calculadas para marcar automáticamente las discrepancias
Defina una columna de validación que calcule Cantidad pedida en la orden de compra − Cantidad enviada en el albarán. Cualquier línea de artículo cuyo resultado no sea cero se marca para revisión. Esto transforma el flujo de recepción de "teclear cada número y esperar que sea correcto" a "revisar solo las excepciones", reduciendo la carga de verificación del 100% de las líneas de artículo al 5–15% que presentan una discrepancia.
Exporte e importe los datos limpios en su WMS
Tras la revisión, los datos verificados de los albaranes de entrega (con las discrepancias marcadas y resueltas) están listos para la importación en el WMS. Exporte como CSV o XLSX y cárguelos en Manhattan Associates, Blue Yonder, SAP WM, NetSuite WMS o cualquier sistema que acepte datos estructurados de recepción. Los datos limpios se convierten en el registro de recepción de mercancía que alimenta la conciliación a tres bandas.
Este flujo de trabajo convierte la extracción de un simple reemplazo de mecanografía en un motor de detección de discrepancias. El habilitador clave es la columna calculada: una columna que no extrae datos del documento, sino que calcula un nuevo valor a partir de los campos extraídos. Puede definir columnas calculadas para la comparación de cantidades (Cantidad pedida − Cantidad enviada), comprobaciones de coherencia de la unidad de medida o incluso la verificación del número de cajas comparando los totales de cajas extraídos con los registrados por el transportista. Para una explicación detallada de cómo funcionan las columnas calculadas en la extracción de documentos, consulte nuestra descripción general de la extracción de documentos con IA mediante columnas calculadas.
Exportación e integración con WMS
El resultado de la extracción no es el destino. Los datos deben ingresar a un sistema — su WMS, su ERP o su hoja de cálculo de recepción — donde impulsan actualizaciones de inventario, conciliación triple y reconciliación con proveedores. La ruta de exportación que elija determina cuánta manipulación manual queda entre la extracción y la entrada al sistema.
| Formato de exportación | Ideal para | Consideraciones |
|---|---|---|
| XLSX (Excel) | Revisión manual, cotejo con datos de OC, auditoría de envíos parciales, asistentes de importación de WMS de gama media | Las fechas y números deben sobrevivir a la conversión de formato. Los números de OC con ceros a la izquierda pueden truncarse en Excel; verifique la preservación del formato antes de confiar en esta ruta. |
| CSV | Importación en SAP WM/EWM, Oracle WMS, NetSuite WMS, Manhattan Associates (WMOS), Blue Yonder, HighJump/Körber | Las descripciones de artículos con varias líneas y comas incrustadas romperán los límites de las filas CSV si no se escapan correctamente. Verifique que la salida de extracción use comillas compatibles con RFC 4180. |
| JSON | Integraciones WMS/ERP personalizadas, canalizaciones de recepción automatizadas, flujos de trabajo basados en API | Las estructuras de artículos anidadas (encabezado → cajas → artículos) preservan limpiamente la jerarquía del envío, pero son más difíciles de revisar manualmente. Mejor cuando el receptor es una máquina, no una persona. |
| Google Sheets | Equipos en Google Workspace, revisión colaborativa de recepciones, paneles compartidos de recepción | Elimina por completo el ciclo de exportación-importación si la herramienta de extracción admite la salida directa a Sheets. Un complemento de Google Sheets para extracción de albaranes puede escribir los datos de recepción directamente en su hoja de seguimiento sin manipulación intermedia de archivos. |
Para la mayoría de los equipos de almacén, el flujo de trabajo práctico es: extracción por lotes → revisión en Excel/Sheets → importación CSV al WMS. Esta ruta funciona con todas las principales plataformas WMS: Manhattan Associates (WMOS) acepta importaciones CSV de recepción de mercancías, SAP WM/EWM usa entrada por lotes mediante LS24, Blue Yonder (antes JDA) ingiere datos planos de recepción, HighJump/Körber admite CSV a través de su marco de importación de datos, y Oracle WMS Cloud y NetSuite WMS tienen asistentes de importación CSV para transacciones de recepción.
El requisito crítico en todos los formatos es que la salida de extracción preserve la relación artículo-envío: cada artículo debe llevar su número de albarán principal y referencia de OC para que el sistema de recepción pueda cotejar las cantidades recibidas con la línea de OC correcta. Una salida plana que pierda esta jerarquía — incluso temporalmente durante el paso de revisión — obliga a alguien a reconstruir la relación manualmente, anulando el ahorro de tiempo de la extracción.
Cómo elegir una herramienta de extracción de albaranes de entrega
Los siguientes criterios van más allá de las afirmaciones de marketing para identificar qué diferencia realmente a las herramientas en el uso diario en la recepción de almacén. Evalúe según estos criterios en lugar de listas de funciones.
Pruebe con su peor albarán de entrega, no con el mejor
Toda herramienta maneja un albarán de entrega limpio de una página de un proveedor importante. Solicite probar con un albarán de dos páginas con más de 30 líneas de artículo que crucen el salto de página, una línea de envío parcial con tres columnas de cantidad y una anotación manuscrita sobre una celda de tabla. Si la herramienta maneja eso, manejará todo lo demás. Si el proveedor duda u ofrece solo documentos de muestra, esa respuesta ya es una señal.
Verifique la conservación de las columnas de envío parcial
Cargue un albarán de entrega donde al menos una línea de artículo muestre valores diferentes en Cantidad pedida, Cantidad enviada y Cantidad pendiente. Revise el resultado: ¿están los tres números en columnas distintas y correctamente etiquetadas? Cualquier herramienta que los agrupe en un solo campo "Cantidad", o que confunda qué número corresponde a cada columna, no puede respaldar la recepción de envíos parciales. Esta es la prueba más importante.
Sin plantilla es el punto de partida; pruebe la resiliencia al formato
Un proveedor que dice "sin plantilla" debería manejar un albarán de entrega de un proveedor cuyo formato nunca haya visto, usando solo sus nombres de columna como instrucciones. La prueba definitiva: cargue el mismo albarán de entrega pero con el diseño de otro proveedor — mismos datos, diferente posición. Si la extracción falla o la precisión disminuye, la herramienta depende de plantillas, independientemente del lenguaje de marketing.
El resultado por lotes debe conservar la jerarquía envío-línea de artículo
Al extraer por lotes 30 albaranes de entrega, el resultado debe identificar qué líneas de artículo pertenecen a qué envío, incluyendo el número de albarán y la referencia de la orden de compra en cada fila de detalle. Un resultado plano que pierda esta relación le obliga a reconstruirla manualmente, lo que añade de vuelta el tiempo que la extracción debía ahorrar.
La exportación debe sobrevivir el traslado a su WMS
Tome el archivo CSV de la herramienta e intente importarlo en su WMS real — no en un entorno de demostración, sino en su sistema real con sus reglas reales de manejo de datos. Verifique que las fechas conserven su formato, que las cantidades mantengan decimales, que los códigos de artículo con ceros iniciales no se trunquen y que las descripciones multilínea no rompan los límites de las filas del CSV. Esta prueba de 10 minutos detecta más problemas de integración que cualquier comparación de funciones.
Para una comparación directa de cómo se desempeñan las herramientas de extracción en documentos logísticos, incluidos los albaranes de entrega, consulte nuestra reseña de las mejores herramientas de extracción de documentos logísticos.
Preguntas Frecuentes
¿En qué se diferencia la extracción de packing slips de la de albaranes de entrega?
En la práctica, ambos términos se refieren al mismo tipo de documento con una diferencia temporal. Un packing slip registra lo empaquetado en el momento del envío — viaja con la mercancía y documenta el contenido de las cajas. Un albarán de entrega (o comprobante de entrega) confirma lo recibido en el destino, normalmente con firma y sello horario del receptor. Muchos proveedores usan los términos indistintamente. Los equipos de almacén reciben ambos del mismo proveedor para el mismo envío, y una herramienta de extracción competente los procesa de forma idéntica — la estructura de campos (líneas de detalle con tres columnas de cantidad) es la misma.
¿Puede la extracción de packing slips procesar avisos de envío EDI 856?
EDI 856 es un estándar de intercambio electrónico de datos — no un formato de documento que las herramientas de extracción procesen directamente. Cuando un proveedor envía un EDI 856, los datos llegan en un formato EDI estructurado que su WMS o ERP puede ingerir sin extracción. La extracción de packing slips cubre el vacío para la mayoría de proveedores que no envían EDI — o que envían el EDI 856 pero adjuntan un packing slip en PDF de todas formas. La mayoría de operaciones usan EDI para grandes proveedores y extracción para el resto, tratándolos como métodos de ingreso complementarios, no alternativos.
¿Qué precisión puedo esperar en la extracción de packing slips?
En packing slips PDF digitales limpios — impresos por el proveedor, sin escritura a mano, buen contraste — la precisión a nivel de campo para campos de cabecera alcanza 97–99%, y para campos de líneas de detalle, 90–95%. En slips escaneados o fotos de teléfono con sombras, inclinación o anotaciones manuscritas, la precisión baja a 80–90% según la calidad de imagen. Compárelo con la entrada manual: los benchmarks de APQC muestran un 1–3% de error por campo tecleado, lo que significa que un packing slip de 40 campos tiene un 33–70% de probabilidad de al menos un error de tipeo. La ventaja de la extracción no es que los errores se eliminen — es que se detectan para revisión durante el paso de verificación, en lugar de quedar ocultos en el WMS hasta que un conteo cíclico o una excepción de conciliación los revele.
¿Funciona la extracción de packing slips con imágenes de calidad fotográfica desde un teléfono?
Sí, con salvedades de calidad de imagen. Una foto de teléfono bien iluminada y enfocada de un packing slip se extrae con 85–95% de precisión — cerca de la calidad de un PDF escaneado. Los modos de fallo son: sombras sobre el documento (común al fotografiar en un muelle de recepción), inclinación severa (el teléfono en ángulo, no plano) y recorte parcial que corta los encabezados de columna. Un flujo de recepción que incluya fotos de teléfono debe incorporar una verificación rápida de calidad de imagen antes de la extracción — rechazar fotos borrosas o con muchas sombras y repetirlas. La IA de visión moderna maneja la degradación moderada mejor que el OCR tradicional, porque usa contexto para llenar vacíos, pero no puede reconstruir datos que nunca fueron capturados en la imagen.
¿Cómo maneja la extracción los albaranes de entrega de proveedores internacionales con campos que no están en inglés?
Los modelos de IA de visión entrenados con documentos multilingües pueden extraer los campos de los albaranes de entrega independientemente del idioma en que estén escritas las etiquetas. "Quantité expédiée" (FR), "Versandte Menge" (DE) o "出荷数" (JA) se reconocen todos como cantidad enviada porque la IA comprende el rol semántico de la columna, no porque coincida con un diccionario de etiquetas de columnas en francés o alemán. Los nombres de los campos de salida permanecen en inglés (tal como los definió), pero los valores extraídos provienen del documento en el idioma que haya usado el proveedor. Esto es relevante para almacenes que reciben de proveedores internacionales o que manejan documentación de entrega multilingüe; consulte nuestro tutorial sobre el procesamiento por lotes de documentos de bon de livraison en francés para ver un ejemplo concreto de cómo funciona esto con docenas de formatos de proveedores a la vez.
¿Cuál es la diferencia entre la extracción de albaranes de entrega y el registro de recepción de mercancía (GR)?
La extracción de albaranes de entrega es el paso de captura de datos: convertir el albarán impreso en campos digitales. El registro de recepción de mercancía es la transacción de inventario: registrar que los artículos ahora están físicamente en stock y disponibles. Son pasos secuenciales en el mismo flujo de trabajo. La extracción produce los datos estructurados que alimentan el registro de recepción de mercancía. En un proceso manual, el empleado de recepción escribe los datos del albarán directamente en la pantalla de recepción de mercancía. Con la extracción, los datos se capturan del albarán automáticamente y luego se revisan antes de que se registre la transacción de recepción de mercancía. El paso de extracción elimina la escritura; la transacción de recepción de mercancía permanece como punto de control.
¿Cómo manejo los albaranes de entrega que combinan varias órdenes de compra en un solo envío?
Algunos proveedores consolidan artículos de varias órdenes de compra en un solo envío y albarán de entrega. La tabla de líneas de artículo lleva entonces múltiples referencias de orden de compra: cada línea puede hacer referencia a una orden de compra diferente. La herramienta de extracción debe capturar la referencia de la orden de compra por línea de artículo, no asumir que una sola orden de compra aplica a todo el envío. Este es un comportamiento estándar de las herramientas de extracción semántica porque leen cada fila individualmente. Después de la extracción, la salida se divide naturalmente: las líneas de PO-1001 van a una recepción de mercancía, las líneas de PO-1002 van a otra. La referencia de orden de compra por línea es el campo crítico para este escenario: verifique que la herramienta la capture a nivel de línea de artículo, no solo a nivel de encabezado.
¿Puede la extracción de albaranes de entrega integrarse directamente con mi WMS existente?
La mayoría de las herramientas de extracción no ofrecen integraciones WMS preconstruidas. El flujo de trabajo estándar es: extraer a CSV → importar CSV al WMS. Esta ruta funciona con todos los WMS principales porque todos tienen una función de importación de datos para transacciones de recepción: Manhattan Associates, SAP WM/EWM, Blue Yonder, HighJump/Körber, Oracle WMS Cloud y NetSuite WMS aceptan datos de recepción de mercancía en CSV estructurado. Algunas herramientas ofrecen publicación directa basada en API para integraciones personalizadas, pero la ruta CSV es universal y no requiere configuración de TI. El requisito clave es que la salida CSV de la herramienta de extracción esté estructurada de la manera que su WMS espera para sus datos de recepción, con encabezados que coincidan con el mapeo de campos de importación del WMS.
¿Qué volumen de albaranes justifica invertir en extracción?
Como regla general: si su operación de recepción procesa más de 30 albaranes al día de más de 5 proveedores distintos, la extracción genera ahorros de tiempo medibles. Por debajo de ese volumen, la revisión de 5 minutos por lote puede compensar el ahorro de escritura. Sin embargo, el umbral real es la diversidad de formatos de proveedores, no el volumen bruto. Treinta albaranes al día de 20 proveedores con 20 formatos distintos justifica más la extracción que 100 albaranes de 2 proveedores con formatos idénticos. Cada formato único añade carga cognitiva: encontrar la referencia de pedido en una ubicación diferente en cada albarán, distinguir Cantidad Pedida de Cantidad Enviada en diseños que las etiquetan de forma distinta. La extracción elimina por completo esta carga: usted define sus columnas una vez, sin importar cuántos formatos usen sus proveedores.
¿Qué ocurre si la herramienta de extracción lee mal un campo? ¿Puedo corregirlo sin reprocesar?
Sí. El resultado de la extracción —ya sea XLSX o CSV— es un archivo editable. Si un campo se lee mal, lo corrige directamente en la hoja de cálculo antes de importarlo al SGA. El valor de la extracción no es una precisión perfecta del 100% —ninguna herramienta de extracción lo logra—. El valor es convertir un proceso que requiere escribir 100 campos por turno en uno que requiere verificar de 5 a 10 campos. El paso de revisión no es un fallo de la extracción; es el control de calidad que garantiza que los datos que ingresan a su SGA sean correctos. La pregunta no es "¿comete errores?" sino "¿reduce la cantidad de campos que debe manejar de escribir todo a verificar unos pocos?"
De la Recepción a los Datos: El Resultado Final
La extracción de albaranes de entrega no reemplaza su WMS — Manhattan, SAP WM, Blue Yonder y HighJump realizan el trabajo pesado en el control de inventario y almacén. Lo que hace es cerrar la brecha entre dónde llegan los datos de envío (un albarán en papel pegado a un palé en el muelle de recepción) y dónde deben aterrizar (un registro estructurado en su sistema de recepción listo para verificación). Esa brecha se cubre actualmente con pulsaciones de teclado humanas que conllevan una tasa de error del 1–3% por campo, multiplicada por cientos de campos por turno — con consecuencias que se extienden desde discrepancias de inventario hasta retenciones de cuentas por pagar y disputas con proveedores.
Las tres cosas que separan una implementación de extracción útil de una frustrante: (1) la herramienta maneja envíos parciales con tres columnas de cantidad distintas, no una sola; (2) procesa formatos mixtos de proveedores en un solo lote sin trabajo de plantilla por proveedor; (3) su exportación se importa limpiamente en su WMS real sin corrupción de formato. Todo lo demás — porcentajes de precisión, afirmaciones de IA, listas de funciones — es secundario frente a estas tres realidades operativas.
Si está evaluando la extracción para su operación de recepción, comience probando con su albarán más difícil — el albarán industrial de varias páginas con 40 líneas de artículos que cruzan un salto de página, una línea de envío parcial que muestra pedido vs. enviado vs. pedido pendiente, y una anotación manuscrita en el margen. Si una herramienta maneja su peor caso, manejará su caso promedio. Si está listo para ver cómo funciona la extracción de albaranes de entrega con sus propios documentos, cargue un albarán de muestra y vea qué datos estructurados se obtienen — o si ya usa Google Sheets, pruebe el flujo de trabajo de Sheets para datos de albaranes de entrega.