Der vollständige Leitfaden zur
Lieferschein-Datenextraktion
Die WERC-Studie „Warehousing & Fulfillment Costs 2024" beziffert die Wareneingangskosten auf 40,79 $ pro Stunde, und APQC-Benchmarks zeigen eine Spanne von 44 Stunden bei der Durchlaufzeit von der Anlieferung bis zum Lagerbestand zwischen den besten und den schlechtesten Unternehmen – eine Lücke, die nicht von der Gabelstaplergeschwindigkeit abhängt, sondern davon, wie lange Versanddaten zwischen „Ware angekommen" und „Bestand aktualisiert" liegen bleiben. Die Lieferschein-Datenextraktion steht im Zentrum dieser Lücke: Sie entscheidet, ob jede Lieferung, die Ihr Dock erreicht, noch in derselben Schicht zu einem nutzbaren Datensatz in Ihrem WMS wird – oder ob sie auf manuelle Erfassung wartet, die Fehler und Verzögerungen verursacht, die sich über den Drei-Wege-Abgleich, die Bestandsgenauigkeit und die Lieferantenabstimmung hinweg verstärken.
Die wichtigsten Erkenntnisse
- Ein Lieferschein mit 40 Feldern hat eine Wahrscheinlichkeit von 33 bis 70 %, dass ein Tippfehler in Ihr WMS gelangt, der unsichtbar bleibt, bis Wochen später eine Ausnahme beim Drei-Wege-Abgleich oder eine Inventur ihn aufdeckt.
- Die sichtbaren Datenerfassungskosten von 32.000 $ pro Wareneingangsarbeitsplatz verbergen weit größere Kosten, die niemand verfolgt, weil sie sich über AP-Rückstellungen, Lieferanten-Reklamationsuntersuchungen und Phantom-Bestandskorrekturen verteilen.
- Sie müssen nicht weniger Zahlen tippen – Sie brauchen eine Spaltendefinition, die alle drei Mengenfelder pro Position erhält, und eine Querprüfungsformel, die Abweichungen kennzeichnet und so eine 100-Felder-Schicht von einer Tippaufgabe in eine Prüfung von fünf Feldern verwandelt.
Vor diesem Leitfaden: Was Lieferschein-Erfassung ist
Neu im Thema? Beginnen Sie mit unserem Artikel Was ist Lieferschein-Datenerfassung – er behandelt die Kerndefinition, einen Vergleich zwischen manuell, Vorlage und KI sowie wann Sie Erfassung tatsächlich benötigen und wann nicht. Dieser Leitfaden setzt diesen Kontext voraus und knüpft daran an: die operativen Kosten der manuellen Bearbeitung, die spezifischen Herausforderungen, die leistungsfähige Erfassung von Teilergebnissen unterscheiden, die vollständige Feld-Checkliste und die Bewertung von Tools im Hinblick auf Ihren tatsächlichen Wareneingang.
Eine Unterscheidung, die hier wiederholt werden sollte, da der Rest dieses Leitfadens davon abhängt: Ein Lieferschein ist keine Rechnung. Eine Rechnung enthält Preise, Zahlungsbedingungen und Steuerbeträge für die Kreditorenbuchhaltung. Ein Lieferschein enthält Versanddaten für den Wareneingang im Lager – und sein prägendes strukturelles Merkmal sind drei Mengenspalten pro Position (bestellt, geliefert, Rückstand) statt der Preis-/Steuerspalten einer Rechnung. Alles ab hier setzt diese Struktur voraus.
Warum die manuelle Lieferschein-Verarbeitung mehr kostet, als Sie denken
Die sichtbaren Kosten sind einfache Arithmetik. Die Benchmark-Daten von WERC zeigen Arbeitskosten im Wareneingang von 40,79 $ pro Stunde. Ein Wareneingangsmitarbeiter, der 60 Lieferscheine pro Schicht bei je 3 Minuten verarbeitet, verbringt 3 Stunden – 37,5 % der Schicht – allein mit der Dateneingabe. Bei 40,79 $ pro Stunde sind das 122 $ pro Schicht an Tipparbeit oder rund 32.000 $ pro Wareneingangsposition pro Jahr. Für ein mittelgroßes Lager mit 3 Wareneingangsstationen nähert sich das sechsstellige Beträge, bevor auch nur ein Fehler gezählt wird.
Aber die sichtbaren Kosten sind die kleinere Zahl. Die versteckten Kosten summieren sich in drei Bereichen.
Drei-Wege-Abgleich-Ausnahmen. Jede falsch getippte Menge oder vertauschte Bestellnummer auf einem Lieferschein erzeugt eine Abweichung, wenn das AP-Team die Bestellung mit dem Lieferschein und der Lieferantenrechnung abgleicht. APQC-Benchmarks zeigen, dass durchschnittliche Einkaufsteams eine Ausnahmequote von 22 % beim Rechnungsabgleich haben, wobei jede Abweichung rund 30 Minuten Recherche über Wareneingang, Einkauf und Finanzen kostet. Ein Lieferschein, bei dem „80" statt „100" getippt wurde – ein einziger Tippfehler – löst eine AP-Sperre aus, einen Anruf beim Lieferanten, eine erneute Prüfung dessen, was tatsächlich angekommen ist, und eine Korrektur. Die Ursache ist nicht der Lieferant oder ein Fehler am Dock, sondern der klerikale Schritt zwischen Lieferschein und System. Best-in-Class-Teams halten die Ausnahmequote bei 9 %. Der Unterschied liegt weitgehend darin, ob die Daten, die ins System gelangen, die auf dem Dokument gedruckten Daten sind oder das, was jemand getippt hat.
Abgleich von Teillieferungen. Wenn ein Lieferant 80 von 100 Einheiten liefert, zeigt der Lieferschein drei Zahlen: bestellt, geliefert (80), Rückstand (20). Der Wareneingangsmitarbeiter muss alle drei eingeben, und das WMS muss die erhaltenen Mengen gegen jede Bestellposition über mehrere Lieferungen hinweg verfolgen. Die manuelle Verarbeitung von Teillieferungen ist der Punkt, an dem die Fehlerquote steigt – weil der Mitarbeiter nicht eine Zahl tippt, sondern unter Zeitdruck unterscheiden muss, welche der drei Mengen in welches Feld gehört, während der nächste LKW wartet. Eine einzige Vertauschung – 100 in die Spalte „geliefert" und 80 in die Spalte „bestellt" – kehrt die Wareneingangsmenge um und erzeugt einen Phantom-Lagerüberschuss von 20 Einheiten, der erst bei der nächsten Inventur, Wochen später, entdeckt wird.
Lieferantenbelastungen. Differenzbasierte Belastungen von Lieferanten gehören zu den am meisten unterschätzten Betriebskosten. Wenn ein Lieferant 100 Einheiten versendet, Ihr Wareneingangsteam 80 erfasst und die Rechnung des Lieferanten über 100 Einheiten angefochten wird, umfasst der Klärungsprozess in der Regel: (1) der Lieferant fordert ein Foto als Liefernachweis an, (2) jemand im Wareneingang sucht den unterschriebenen Lieferschein physisch heraus, (3) das AP-Team vergleicht die Lieferbestätigung des Spediteurs mit der Erfassung, (4) eine Belastung oder Korrektur wird ausgestellt. Jede Belastungsprüfung verbraucht 30–60 Minuten über mehrere Rollen hinweg – und die Kosten werden in keinem einzelnen Abteilungsbudget erfasst. WERC-Forschung zeigt, dass die Wareneingangsgenauigkeit direkt mit der Häufigkeit von Belastungen korreliert, doch nur wenige Lager messen die Kosten der Datenerfassungsfehler, die sie auslösen.
Für einen genaueren Blick auf die Kosten pro Lieferschein und pro Schicht, siehe unsere Aufschlüsselung der manuellen Bearbeitungskosten von Lieferscheinen.
Die besonderen Herausforderungen der Lieferscheinextraktion
Die Lieferscheinextraktion ist schwieriger als die Rechnungsextraktion – aus Gründen, die für jeden relevant sind, der Tools bewertet. Wenn Sie diese Herausforderungen im Voraus verstehen, entscheidet sich, ob das von Ihnen gewählte Tool Ihren tatsächlichen täglichen Arbeitsablauf bewältigt oder nur das Demo-Szenario.
1. Positionsdichte
Ein typischer Lieferschein eines Industrielieferanten wie Grainger oder MSC Industrial kann 30–50 Positionen über zwei oder drei Seiten enthalten. Jede Position hat ihre eigene Artikelnummer, Beschreibung, bestellte Menge, gelieferte Menge, Rückstandsmenge und Mengeneinheit. Die Positionstabelle ist die kritische Nutzlast – 80–90 % der zu extrahierenden Daten befinden sich dort – und genau dort scheitern die meisten Extraktionstools.
Mehrseitige Tabellen bringen ein Kontinuitätsproblem mit sich: Wenn sich eine Tabelle mit 50 Zeilen von Seite 1 auf Seite 2 erstreckt, muss die Extraktions-Engine erkennen, dass es sich um eine einzige fortlaufende Tabelle handelt, nicht um zwei getrennte Tabellen. Spaltenüberschriften können auf Folgeseiten wiederholt werden oder auch nicht. Manche Lieferanten drucken Überschriften auf jeder Seite; andere nur auf Seite 1. Ein Extraktionstool, das die Spaltenausrichtung am Seitenumbruch verliert, verschiebt Werte stillschweigend in falsche Spalten ab dem Umbruch – eine Lieferanten-Artikelnummer landet in der Beschreibungsspalte und eine gelieferte Menge in der Rückstandsspalte – und die Ausgabe sieht vollständig aus, ist aber strukturell beschädigt.
2. Teillieferungen: Drei Mengenspalten
Dies ist die zentrale Herausforderung bei der Extraktion von Packlisten. Eine Rechnung hat eine Mengenspalte. Eine Packliste hat drei: Bestellte Menge, Gelieferte Menge und Rückstand. Jede Position enthält alle drei Zahlen, und die Extraktion muss deren Identität bewahren – nicht nur die numerischen Werte erfassen.
Ein Teillieferungsszenario: Sie bestellen 100 Einheiten von SKU-00412. Der Lieferant liefert 80, der Rückstand beträgt 20. Die Packliste zeigt Spalten mit den Bezeichnungen „Best.“, „Gel.“ (80) und „Rück.“ (20). Das Extraktionstool muss erkennen, welche Spalte welche ist, und sie den richtigen Feldern zuordnen. Ein Tool, das alle drei als ein einziges Feld „Menge“ behandelt oder in einem Teillieferungslayout „Gel.“ mit „Best.“ verwechselt, liefert Ergebnisse, die für die Wareneingangsprüfung unbrauchbar sind – aus den extrahierten Daten allein lässt sich nicht ablesen, ob die Lieferung vollständig oder unvollständig ist. Der Wareneingangsprozess ist darauf angewiesen, alle drei Mengen pro Position nebeneinander zu sehen, damit das Team am Dock weiß, was beim Lieferanten nachgefasst werden muss.
3. Handschriftliche Lagernotizen
Packlisten treffen nicht im sterilen Zustand ein. Die Wareneingänger versehen sie mit Notizen: eingekreiste Mengen, bei denen die Zählung bestätigt wurde, handschriftliche „Fehlmengen“-Vermerke neben einer Position, Unterschriften des Empfängers, Zeitstempel, Schadenscodes („1 Karton zerquetscht – abgelehnt“) und Hinweise des Spediteurs. Diese Notizen haben operative Bedeutung – sie sind die primäre Aufzeichnung dessen, was am Wareneingangsdock passiert ist –, aber sie liegen über den gedruckten Daten, überlappen oft Tabellenzellen oder drängen sich in Spaltenüberschriften.
Traditionelle OCR ist hier besonders schwach: Eine handschriftliche „80“, die über eine gedruckte „100“ gekritzelt ist, erzeugt widersprüchliche Zeichenerkennungen. Ein Vision-KI-Modell hingegen nutzt den Dokumentkontext – die Tabellenstruktur, die Spaltenüberschriften, die umgebenden gedruckten Daten –, um die Notiz vom Originaltext zu unterscheiden und beide zu erfassen. Die Notiz ist kein zu umgehender Makel; sie sind Daten, die zusammen mit den gedruckten Feldern extrahiert werden müssen. Eine vertiefte Analyse dieses Problems finden Sie in unserem Artikel zur Extraktion handschriftlicher Lieferscheine im Wareneingang.
4. Mehrseitige Packlisten
Ein Lieferant kann bei Sendungen mit gemischten Kartons eine mehrseitige Packliste beifügen: Seite 1 enthält die Sendungsübersicht und Frachtführerinformationen, die Seiten 2–4 enthalten detaillierte Angaben zu den einzelnen Kartons, und Seite 5 ist eine Rücksendegenehmigung. Das Extraktionstool muss diese Struktur erkennen, den Übergang zwischen den Dokumenttypen nachvollziehen und nur die relevanten Packlistendaten extrahieren, ohne durch das RMA-Formular oder den beigefügten Frachtbrief verwirrt zu werden.
5. Gemischter Format-Eingang in einer Charge
In einer einzigen Wareneingangsschicht können folgende Dokumente anfallen: eine Standard-Packliste von Grainger (PDF, einseitig, Hochformat), ein Lieferschein von McMaster-Carr (ausgedruckt aus dem Web, zwei Seiten), ein Thermoetikett von Fastenal (schmales Format, Querformat) und ein Foto eines handschriftlichen Lieferscheins eines lokalen Lieferanten – alles innerhalb von 30 Minuten. Die Verarbeitung jedes Formats über eine separate Vorlage oder ein separates Tool widerspricht dem Automatisierungszweck. Die Extraktionslösung muss gemischte Formate in einem einzigen Durchlauf verarbeiten und dabei für alle dieselben Spaltendefinitionen anwenden, da die Ausgabe unabhängig vom Format des Lieferanten in derselben WMS-Eingangstabelle landen muss.
Wichtige Felder einer Packliste
Die Felder einer Packliste lassen sich in zwei Kategorien unterteilen. Kopffelder gelten für die gesamte Sendung; Positionsfelder wiederholen sich für jede Zeile der Tabelle. Das Verständnis, welche Felder für Ihren nachgelagerten Abstimmungsprozess kritisch sind, bestimmt, wie Sie Ihre Extraktionsspalten konfigurieren.
| Kopffelder (eines pro Lieferschein) | Extraktionsschwierigkeit | Warum wichtig |
|---|---|---|
| Packlisten-/Lieferscheinnummer | Niedrig | Primärschlüssel für Nachverfolgung, Lieferantensuche und Prüfpfad |
| Datum (Versand/Ausstellung) | Niedrig | Altersbericht für offene Eingänge; bestimmt Start der Lagerlaufzeit |
| Bestellnummer / Auftragsreferenz | Mittel | Verknüpft Sendung mit Bestellung für 3-Wege-Abgleich; uneinheitliche Bezeichnungen zwischen Lieferanten |
| Absenderadresse (Lieferant/Lager) | Mittel | Lieferanten mit mehreren Standorten versenden ggf. aus verschiedenen Lagern; wichtig für Retouren |
| Empfängeradresse (Ihr Wareneingang) | Niedrig | Bestätigt Versandweg; markiert Cross-Dock bei falschem Empfänger |
| Frachtführername | Niedrig | Abgleich mit Wareneingangstermin, Zuordnung der Eingangsfrachtkosten |
| Sendungsnummer / PRO-Nummer | Mittel | Frachtführersuche, Abruf der Zustellbestätigung; Formate stark variierend |
| Anzahl Kartons/Paletten | Mittel | Vorabprüfung: Stimmt die Kartons auf dem Dock mit dem Lieferschein überein? |
| Gesamtgewicht | Niedrig | Frachtprüfung, Verifizierung der Frachtführerabrechnung |
| Empfängerunterschrift | Hoch | Zustellnachweis; Handschrift + kontextbezogene Extraktion erforderlich |
| Positionsfelder (mehrere pro Lieferschein) | Extraktionsschwierigkeit | Warum es wichtig ist |
|---|---|---|
| Artikelcode / Artikelnummer / Teilenummer | Mittel | Lieferanten- und interne Artikelnummern weichen oft ab; Zuordnungsabgleich erforderlich |
| Artikelbeschreibung | Hoch | Freitext, mehrzeilig, kann Spezifikationen oder Seriennummern enthalten; umfangreich, aber variabel |
| Bestellmenge | Mittel | Muss mit der Bestellposition übereinstimmen; Basis für den Vergleich von Teillieferungen |
| Liefermenge | Mittel | Tatsächlich empfangene Menge; Kernfeld für die Wareneingangsprüfung und den Drei-Wege-Abgleich |
| Rückstandsmenge | Hoch | Kennzeichnet unvollständige Lieferungen; steuert den Nachfass-Workflow beim Lieferanten |
| Mengeneinheit | Hoch | „EA" / „PCS" / „CTN" / „BOX" — kein Standard; muss für die Mengeneinheiten-Zuordnung unverändert erhalten bleiben |
Die drei Mengenspalten — Bestellt, Geliefert, Rückstand — sind das, was die Lieferscheinextraktion von jedem anderen Dokumenttyp unterscheidet. Ein Extraktionstool, das sie in einem einzigen Feld zusammenfasst oder sie erfasst, ohne zu unterscheiden, welche welche ist, hat seine Hauptaufgabe nicht erfüllt. Vergewissern Sie sich davon, bevor Sie sich für ein Tool entscheiden: Laden Sie einen Lieferschein mit mindestens einer Teillieferungsposition hoch und prüfen Sie, ob alle drei Mengen in den korrekten Ausgabespalten erscheinen.
Traditionelle vs. KI-gestützte Lieferscheinextraktion
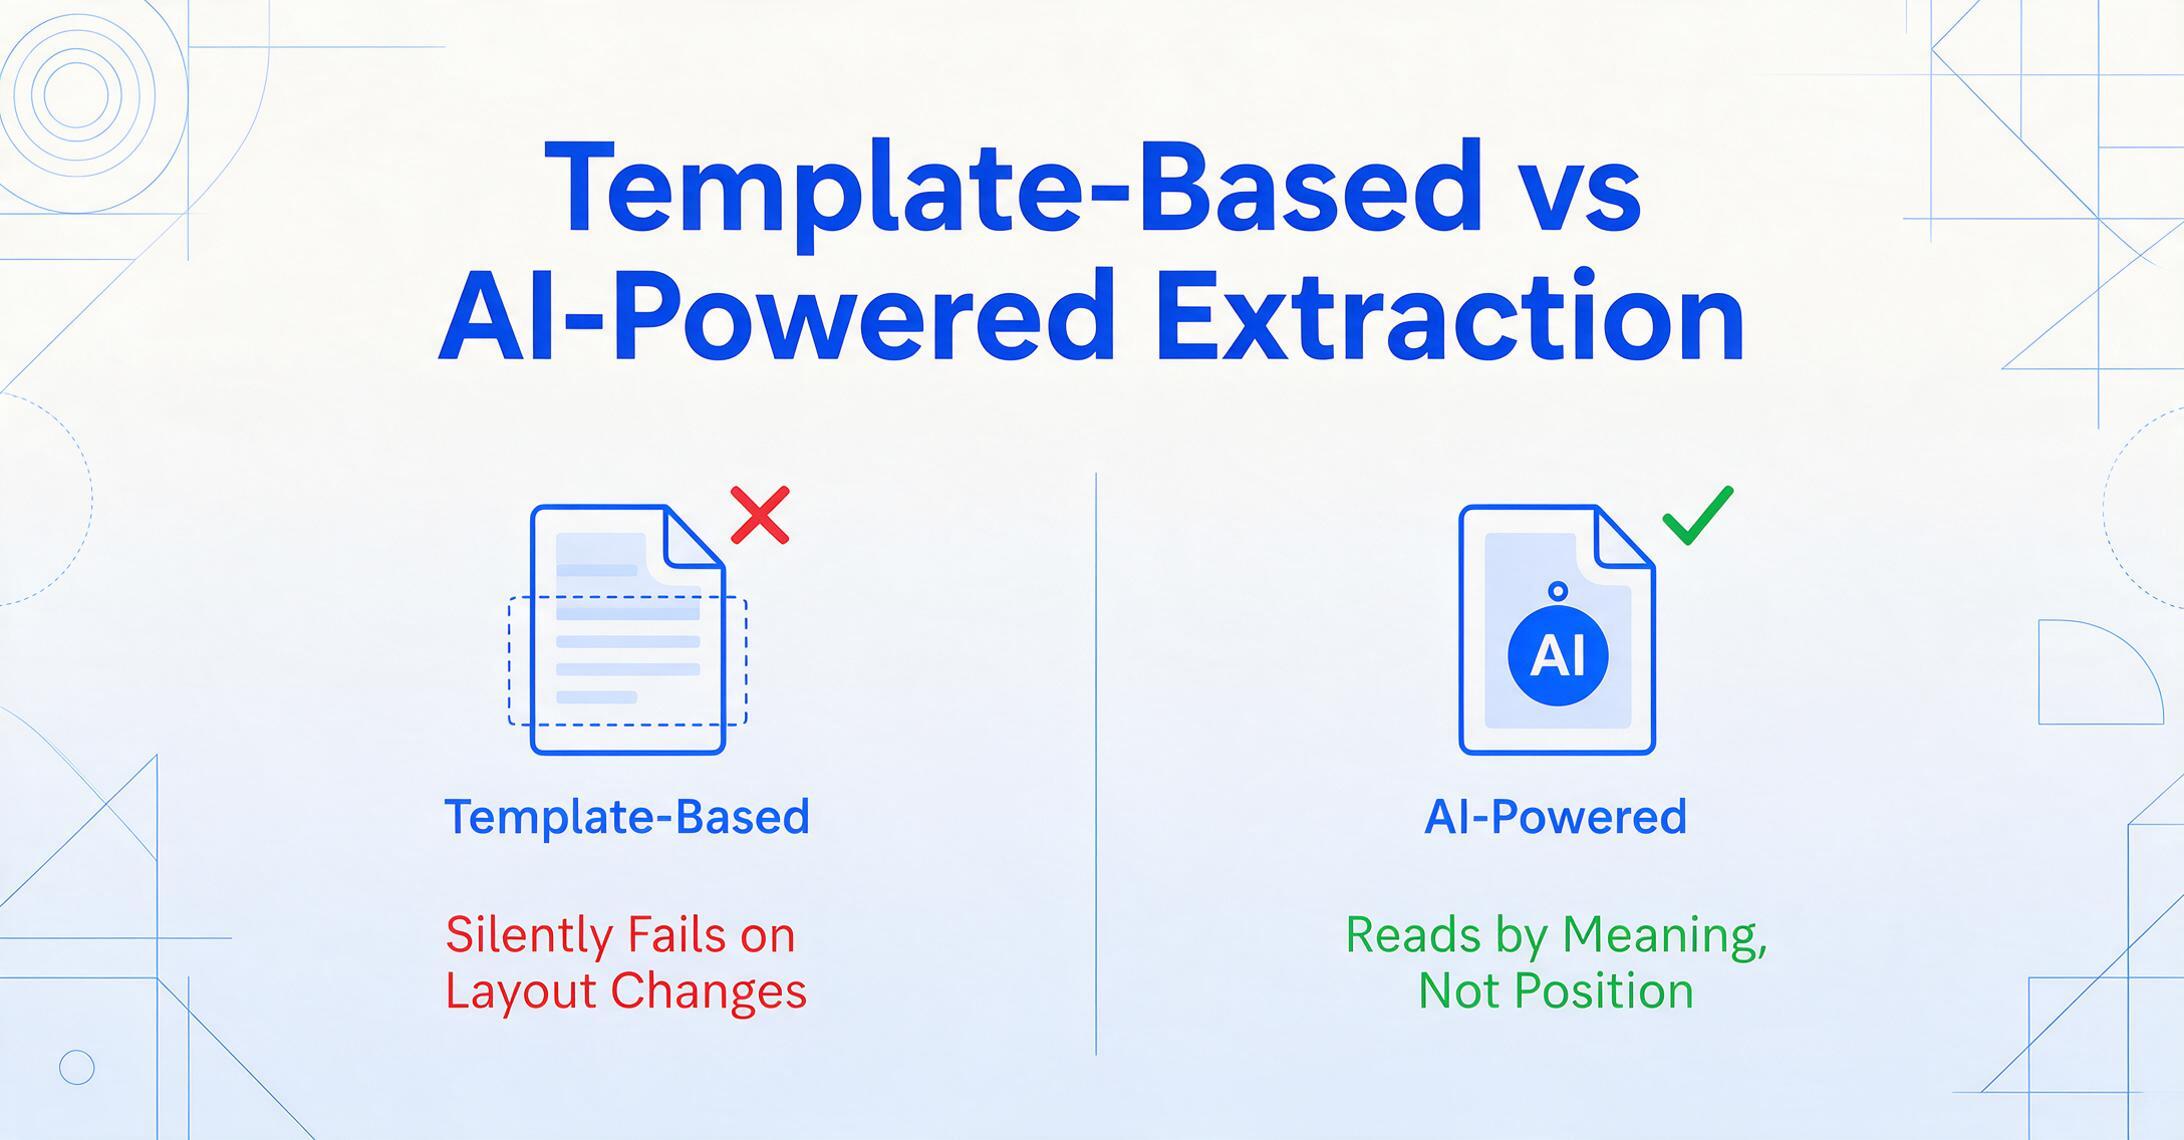
Nicht alle Extraktionstechnologien meistern die oben genannten Herausforderungen gleichermaßen. Der grundlegende Unterschied liegt zwischen vorlagenbasierter (positionsbasierter) Extraktion und semantischer (KI-gestützter) Extraktion — und dieses Verständnis ist der wichtigste Bewertungsschritt, den Sie unternehmen können.
Vorlagenbasierte Extraktion erfordert die Konfiguration einer Parsing-Zone für jedes Lieferanten-Layout. Sie zeichnen ein Rechteck um die Stelle, an der die Bestellreferenz auf dem Lieferschein von Lieferant A erscheint, ein weiteres Rechteck um den Kopf der Positionstabelle und definieren Spaltenbreiten. Wenn Lieferant A seinen Lieferschein umgestaltet — etwa nach einem ERP-Upgrade das Layout ändert — scheitert Ihre Vorlage stillschweigend. Werte landen in falschen Spalten. Sie bemerken das Problem erst, wenn ein Wareneingangsmitarbeiter feststellt, dass Mengen im Beschreibungsfeld erscheinen — oder gar nicht.
Der Template-Ansatz scheitert am deutlichsten an der Positionslistentabelle. Ein Template setzt voraus, dass die Tabelle in einer festen Zeile beginnt und die Spalten feste Breiten haben. Doch Lieferscheine von Lieferanten unterscheiden sich darin, wie viele Kopfzeilen der Tabelle vorausgehen, ob sich Spaltenüberschriften wiederholen, ob Zeilen sich über mehrere Textzeilen erstrecken und ob Kartonebenen-Gruppierungen innerhalb der Tabelle verschachtelt sind. Ein Template, das für die 30-zeilige Tabelle eines Lieferanten funktioniert, ist bei der 50-zeiligen Tabelle eines anderen mit zusammengeführten Beschreibungszellen häufig falsch ausgerichtet. Die Levvel-Research-Studie zu Dateneingabekosten stellt fest, dass über 30 % der Abweichungen bei der Dokumentenverarbeitung auf inkonsistente Verarbeitung zurückzuführen sind – genau das führt die templatebasierte Extraktion ein: konsistente Verarbeitung von Inkonsistenz, die falsche Ergebnisse erzeugt, die korrekt aussehen.
Semantische Extraktion – KI-gestützte Extraktion mithilfe von Vision-Language-Modellen – funktioniert nach Bedeutung, nicht nach Position. Sie definieren die gewünschten Spalten: „Lieferscheinnummer", „Bestellreferenz", „Artikelnummer", „Bestellmenge", „Versandmenge", „Rückstandsmenge", „Mengeneinheit". Die KI liest das gesamte Dokument – den Kopfbereich, die Positionslistentabelle, die Fußzeilen-Anmerkungen – und lokalisiert jeden Wert, indem sie versteht, was er semantisch darstellt, unabhängig davon, wo er auf der Seite steht. Ein Feld mit der Bezeichnung „Ord" auf dem Lieferschein eines Lieferanten, „Qty" auf dem eines anderen und „Ordered" auf dem eines dritten wird als dasselbe erkannt, weil die KI die semantische Rolle versteht. Das ist Benutzerdefinierte Spaltenextraktion: Sie definieren die Ausgabe einmal, und die KI lokalisiert die passenden Daten nach Bedeutung, nicht nach Koordinaten.
Der operative Unterschied liegt in der Template-Pflege. Mit Templates erfordert jeder neue Lieferant – oder jede Formatänderung eines bestehenden Lieferanten – Template-Arbeit. Für ein Lager, das Waren von über 50 Lieferanten mit jeweils eigenen Formatvarianten erhält, wird die Template-Pflege zu einem laufenden operativen Kostenfaktor, der die Arbeitseinsparungen durch Automatisierung aufzehrt. Mit semantischer Extraktion funktioniert dieselbe Spaltendefinition über alle Lieferanten hinweg, weil die Extraktionslogik formatunabhängig ist. Ein Lieferschein von einem Lieferanten, den Sie noch nie verarbeitet haben – mit einem Layout, das die KI noch nie gesehen hat – wird beim ersten Upload korrekt extrahiert, weil die KI Lieferschein-Semantik liest, nicht Lieferschein-Koordinaten.
Weitere Informationen darüber, warum Lieferscheinformate von Lieferanten voneinander abweichen und warum sie das immer tun werden, finden Sie in unserem Artikel zu Inkonsistenz von Lieferscheinformaten.
Dateien werden sicher verarbeitet und nicht gespeichert.
Batch-Verarbeitung: Abgleich mit Bestelldaten
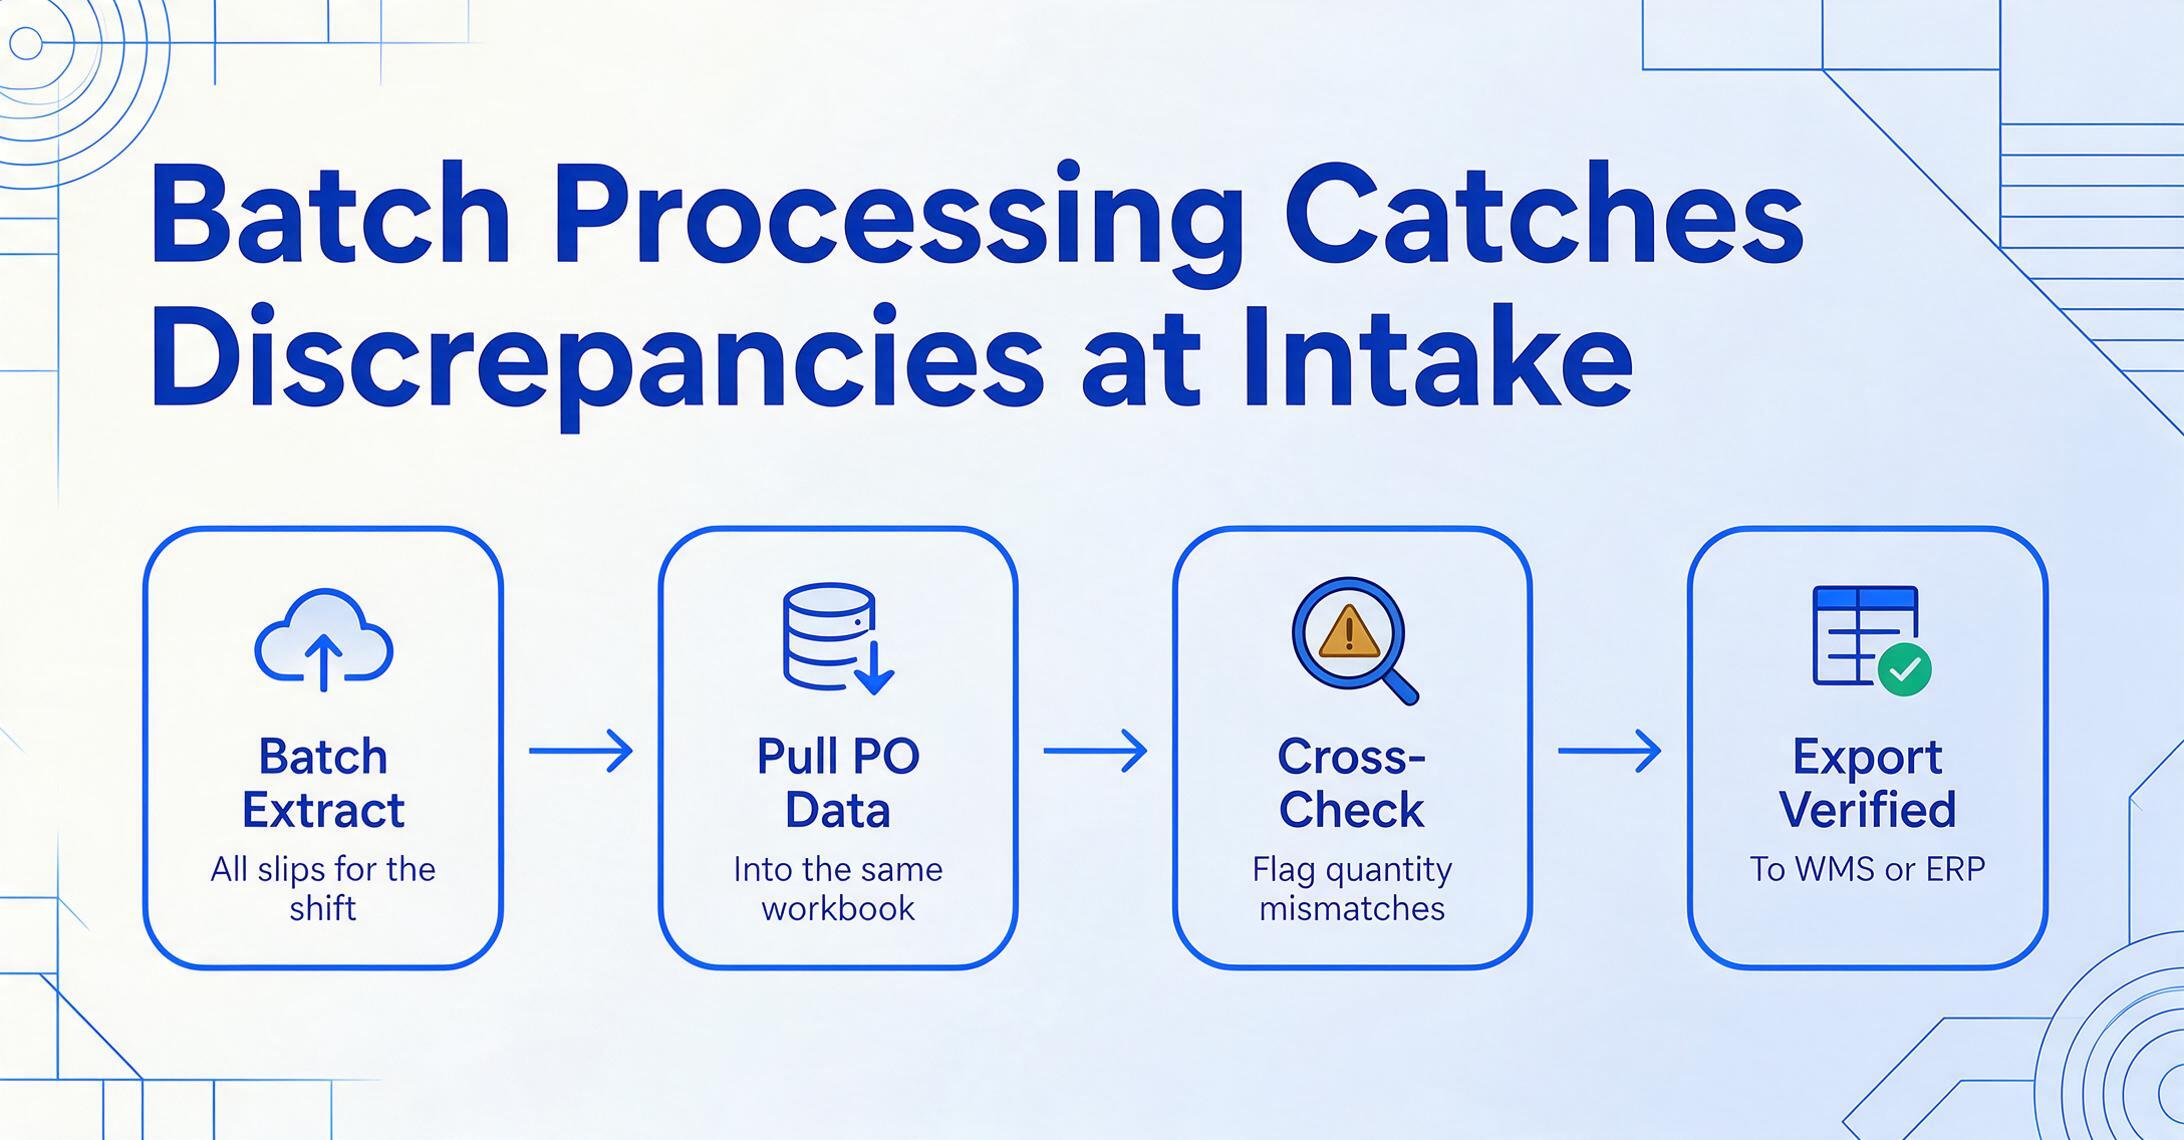
Die Einzelbeleg-Extraktion löst das Datenerfassungsproblem pro Dokument. Die Batch-Verarbeitung löst die Durchsatz-Herausforderung – und sie ermöglicht eine Funktion, die die Einzelbeleg-Verarbeitung nicht bieten kann: den automatisierten Abgleich der Lieferscheinmengen mit den Bestelldaten.
In einem Batch-Workflow laden Sie 20, 30 oder 50 Lieferscheine verschiedener Lieferanten in einem einzigen Batch hoch – einige als PDF, einige als Handyfotos, einige mehrseitig. Die Extraktions-Engine verarbeitet alle mit denselben Spaltendefinitionen und führt die Ergebnisse in einer einzigen Tabelle zusammen. Jeder Lieferschein wird zu einer Zeile in der Kopfzeilentabelle; jede Position wird zu einer Detailzeile mit den wiederholten Kopffeldern. Für den Schritt-für-Schritt-Workflow siehe unseren Leitfaden zur Batch-Extraktion von Lieferscheinen nach Excel.
Die Batch-Verarbeitung wird jedoch wirklich leistungsstark, wenn Sie sie mit einem Abgleichsschritt gegen Ihre Bestelldaten kombinieren. Hier ist der Workflow, der einen Wareneingang, der Abweichungen beim Eingang erkennt, von einem unterscheidet, der sie erst Wochen später bei der Inventur entdeckt:
Alle Lieferscheine der Schicht im Batch extrahieren
Laden Sie jeden Lieferschein hoch, der während der Schicht eingegangen ist – unabhängig von Lieferant, Format oder Seitenzahl. Das Ergebnis ist eine einzige strukturierte Tabelle mit allen identifizierten Positionen: Bestellreferenz, Artikelnummer, bestellte Menge, gelieferte Menge und Rückstandsmenge.
Bestelldaten in dieselbe Arbeitsmappe laden
Exportieren Sie Ihre Bestelldaten – aus SAP, NetSuite oder Ihrer Beschaffungstabelle – und laden Sie sie neben den extrahierten Lieferscheindaten. Jede Bestellung enthält die bestellten Mengen, mit denen die Lieferscheinmengen abgeglichen werden müssen. Eine vollständige Anleitung zur Extraktion von Bestelldaten finden Sie in unserem umfassenden Leitfaden zur Extraktion von Bestelldaten.
Berechnete Spalten verwenden, um Abweichungen automatisch zu kennzeichnen
Definieren Sie eine Validierungsspalte, die Bestellte Menge − Gelieferte Menge laut Lieferschein berechnet. Jede Position mit einem Ergebnis ungleich null wird zur Prüfung markiert. So wird der Wareneingangsprozess von „jede Zahl abtippen und hoffen, dass es stimmt" zu „nur die Ausnahmen prüfen" – der Prüfaufwand sinkt von 100 % der Positionen auf die 5–15 % mit Abweichung.
Bereinigte Daten exportieren und in Ihr WMS importieren
Nach der Prüfung sind die verifizierten Lieferscheindaten – mit gekennzeichneten und behobenen Abweichungen – bereit für den WMS-Import. Exportieren Sie als CSV oder XLSX und laden Sie in Manhattan Associates, Blue Yonder, SAP WM, NetSuite WMS oder ein beliebiges System, das strukturierte Wareneingangsdaten akzeptiert. Die bereinigten Daten werden zum Wareneingangsbeleg, der in den Drei-Wege-Abgleich einfließt.
Dieser Workflow verwandelt die Extraktion von einer Tipp-Ersetzung in eine Abweichungserkennungs-Engine. Der entscheidende Enabler ist die berechnete Spalte: eine Spalte, die keine Daten aus dem Dokument extrahiert, sondern aus extrahierten Feldern einen neuen Wert berechnet. Sie können berechnete Spalten für den Mengenabgleich (Bestellte Menge − Gelieferte Menge), Konsistenzprüfungen der Mengeneinheit oder sogar die Kartonszahl-Prüfung definieren, indem Sie extrahierte Kartonsummen mit den vom Spediteur erfassten Werten vergleichen. Eine ausführliche Erklärung, wie berechnete Spalten bei der Dokumentenextraktion funktionieren, finden Sie in unserer Übersicht zur KI-Dokumentenextraktion mit berechneten Spalten.
Export und WMS-Integration
Das Extraktionsergebnis ist nicht das Ziel. Die Daten müssen in ein System gelangen – Ihr WMS, Ihr ERP oder Ihre Eingangstabelle –, wo sie Bestandsaktualisierungen, Drei-Wege-Abgleiche und Lieferantenabstimmungen ermöglichen. Der gewählte Exportpfad bestimmt, wie viel manuelle Arbeit zwischen Extraktion und Systemeingabe verbleibt.
| Exportformat | Am besten geeignet für | Hinweise |
|---|---|---|
| XLSX (Excel) | Manuelle Prüfung, Abgleich mit Bestelldaten, Teil-Lieferungsprüfung, Import-Assistenten mittelständischer WMS | Daten und Zahlen müssen Formatkonvertierungen überstehen. Bestellnummern mit führenden Nullen können von Excel abgeschnitten werden – überprüfen Sie die Formatierung vor der Nutzung. |
| CSV | Import in SAP WM/EWM, Oracle WMS, NetSuite WMS, Manhattan Associates (WMOS), Blue Yonder, HighJump/Körber | Mehrzeilige Artikelbeschreibungen mit Kommas unterbrechen CSV-Zeilen, wenn sie nicht korrekt maskiert sind. Prüfen Sie, ob die Ausgabe RFC 4180-konforme Anführungszeichen verwendet. |
| JSON | Individuelle WMS/ERP-Integrationen, automatisierte Wareneingangs-Pipelines, API-basierte Workflows | Verschachtelte Positionsstrukturen (Kopf → Kartons → Artikel) erhalten die Lieferhierarchie sauber, sind aber manuell schwer zu prüfen. Am besten, wenn der Empfänger eine Maschine ist. |
| Google Sheets | Teams in Google Workspace, kollaborative Wareneingangsprüfung, gemeinsame Dashboards | Eliminiert den Export-Import-Zyklus, wenn das Tool direkte Sheets-Ausgabe unterstützt. Ein Google Sheets-Add-on zur Packzettel-Extraktion schreibt Wareneingangsdaten direkt in Ihre Tabelle – ohne Datei-Handling. |
Für die meisten Lagerteams ist der praktische Workflow: Stapel-Extraktion → Prüfung in Excel/Sheets → CSV-Import ins WMS. Dieser Pfad funktioniert mit allen großen WMS-Plattformen – Manhattan Associates (WMOS) akzeptiert CSV-Wareneingangsimporte, SAP WM/EWM nutzt Batch-Eingabe via LS24, Blue Yonder (ehemals JDA) verarbeitet flache Wareneingangsdaten, HighJump/Körber unterstützt CSV über sein Datenimport-Framework, und Oracle WMS Cloud sowie NetSuite WMS haben CSV-Import-Assistenten für Wareneingangsbuchungen.
Die entscheidende Anforderung über alle Formate hinweg ist, dass die Extraktion die Beziehung zwischen Position und Lieferung bewahrt: Jede Position muss ihre übergeordnete Packzettelnummer und Bestellreferenz enthalten, damit das Wareneingangssystem die Mengen der richtigen Bestellposition zuordnen kann. Ein flacher Export, der diese Hierarchie aufgibt – selbst nur während der Prüfung –, zwingt jemanden, die Beziehung manuell wiederherzustellen, und macht den Zeitgewinn durch die Extraktion zunichte.
So wählen Sie ein Tool zur Lieferschein-Extraktion
Die folgenden Kriterien durchschauen Marketing-Behauptungen und zeigen, was Tools im täglichen Wareneingang tatsächlich unterscheidet. Testen Sie anhand dieser Kriterien statt an Feature-Checklisten.
Testen Sie mit Ihrem schlechtesten Lieferschein, nicht mit Ihrem besten
Jedes Tool verarbeitet einen sauberen einseitigen Lieferschein eines großen Lieferanten. Bitten Sie um einen Test mit einem zweiseitigen Lieferschein mit 30+ Positionen über den Seitenumbruch hinweg, einer Teillieferungsposition mit drei Mengenspalten und einer handschriftlichen Notiz quer über eine Tabellenzelle. Wenn das Tool das bewältigt, bewältigt es auch alles andere. Wenn der Anbieter zögert oder nur Beispieldokumente anbietet, ist das bereits ein Signal.
Prüfen Sie die Erhaltung der Teillieferungsspalten
Laden Sie einen Lieferschein hoch, bei dem mindestens eine Position unterschiedliche Werte in Bestellmenge, Liefermenge und Rückstandsmenge aufweist. Prüfen Sie die Ausgabe: Sind alle drei Zahlen in getrennten Spalten vorhanden und korrekt beschriftet? Jedes Tool, das sie in ein einziges Feld „Menge" packt oder verwechselt, welche Zahl in welche Spalte gehört, kann den Teillieferungs-Wareneingang nicht unterstützen. Das ist der wichtigste Test überhaupt.
Ohne Vorlage ist die Basis; testen Sie die Formatbeständigkeit
Ein Anbieter, der „ohne Vorlage" sagt, sollte einen Lieferschein eines Lieferanten verarbeiten können, dessen Format er noch nie gesehen hat – nur mit Ihren Spaltennamen als Anweisung. Der Härtetest: Laden Sie denselben Lieferschein hoch, aber mit dem Layout eines anderen Lieferanten – gleiche Daten, andere Position. Wenn die Extraktion scheitert oder die Genauigkeit sinkt, ist das Tool unabhängig von der Marketing-Sprache vorlagenabhängig.
Die Batch-Ausgabe muss die Hierarchie von Lieferung zu Position erhalten
Wenn Sie 30 Lieferscheine per Batch extrahieren, muss die Ausgabe erkennen lassen, welche Positionen zu welcher Lieferung gehören – indem die Lieferscheinnummer und die Bestellreferenz in jeder Detailzeile enthalten sind. Eine flache Ausgabe, die diese Beziehung verliert, zwingt Sie, sie manuell zu rekonstruieren – das macht die Zeit wieder wett, die die Extraktion sparen sollte.
Der Export muss den Weg in Ihr WMS überstehen
Nehmen Sie die CSV-Ausgabe des Tools und versuchen Sie, sie in Ihr tatsächliches WMS zu importieren – nicht in eine Demo-Umgebung, sondern in Ihr echtes System mit echten Datenverarbeitungsregeln. Prüfen Sie, dass Daten ihr Format behalten, Mengen Dezimalstellen bewahren, Artikelnummern mit führenden Nullen nicht abgeschnitten werden und mehrzeilige Beschreibungen keine CSV-Zeilenumbrüche brechen. Dieser 10-Minuten-Test deckt mehr Integrationsprobleme auf als jeder Feature-Vergleich.
Für einen direkten Vergleich, wie Extraktionstools bei Logistikdokumenten einschließlich Lieferscheinen abschneiden, lesen Sie unseren Test der besten Tools zur Extraktion von Logistikdokumenten.
Häufig gestellte Fragen
Worin unterscheidet sich die Packlistenerfassung von der Lieferscheinerfassung?
In der Praxis bezeichnen beide Begriffe denselben Dokumententyp mit einem zeitlichen Unterschied. Ein Packliste erfasst, was zum Zeitpunkt des Versands verpackt wurde – sie begleitet die Ware und dokumentiert den Kartoninhalt. Ein Lieferschein (oder Liefernachweis) bestätigt, was am Zielort eingegangen ist, meist mit Unterschrift und Zeitstempel des Empfängers. Viele Lieferanten verwenden die Begriffe synonym. Lagerteams erhalten von demselben Lieferanten für dieselbe Sendung beide Varianten, und ein leistungsfähiges Erfassungstool behandelt sie identisch – die Feldstruktur (Positionen mit drei Mengenspalten) ist gleich.
Kann die Packlistenerfassung EDI-856-Versandankündigungen verarbeiten?
EDI 856 ist ein elektronischer Datenaustauschstandard – kein Dokumentenformat, das Erfassungstools direkt verarbeiten. Sendet ein Lieferant eine EDI 856, liegen die Daten in einem strukturierten EDI-Format vor, das Ihr WMS oder ERP ohne Erfassung übernehmen kann. Die Packlistenerfassung schließt die Lücke für die Mehrheit der Lieferanten, die kein EDI nutzen – oder die zwar die EDI 856 senden, aber trotzdem eine PDF-Packliste anhängen. Die meisten Betriebe nutzen EDI für große Lieferanten und die Erfassung für den Rest und behandeln beide als komplementäre Eingangsmethoden statt als Alternativen.
Welche Genauigkeit kann ich bei der Packlistenerfassung erwarten?
Bei sauberen digitalen PDF-Packlisten – vom Lieferanten gedruckt, ohne Handschrift, guter Kontrast – erreicht die Feldergenauigkeit für Kopffelder 97–99 % und für Positionsfelder 90–95 %. Bei gescannten Belegen oder Handyfotos mit Schatten, Verzerrung oder handschriftlichen Notizen sinkt die Genauigkeit je nach Bildqualität auf 80–90 %. Zum Vergleich: Bei manueller Eingabe zeigen APQC-Benchmarks 1–3 % Fehler pro getipptem Feld – bei einer 40-Felder-Packliste besteht eine 33–70%ige Wahrscheinlichkeit für mindestens einen Tippfehler. Der Vorteil der Erfassung liegt nicht darin, Fehler zu vermeiden, sondern sie im Prüfschritt sichtbar zu machen, statt sie im WMS zu vergraben, bis eine Inventur oder ein Abgleich sie offenbart.
Funktioniert die Packlistenerfassung mit Handyfotos in Fotoqualität?
Ja, mit Einschränkungen bei der Bildqualität. Ein gut beleuchtetes, scharfes Handyfoto einer Packliste erreicht 85–95 % Genauigkeit – nahe an der Qualität eines gescannten PDFs. Die Fehlerquellen sind: Schatten auf dem Dokument (häufig beim Fotografieren auf der Warenannahme), starke Verzerrung (das Handy schräg gehalten, nicht flach) und teilweises Abschneiden, das Spaltenüberschriften entfernt. Ein Wareneingangsprozess mit Handyfotos sollte eine schnelle Bildqualitätsprüfung vor der Erfassung vorsehen – unscharfe oder stark beschattete Fotos ablehnen und neu aufnehmen lassen. Moderne visuelle KI verarbeitet moderate Beeinträchtigungen besser als traditionelle OCR, da sie Kontext zur Lückenfüllung nutzt, aber sie kann Daten nicht rekonstruieren, die nie im Bild erfasst wurden.
Wie funktioniert die Extraktion bei Lieferscheinen internationaler Lieferanten mit nicht-englischen Feldern?
Vision-KI-Modelle, die auf mehrsprachigen Dokumenten trainiert wurden, können Lieferscheinfelder unabhängig von der Sprache der Beschriftungen extrahieren. „Quantité expédiée" (FR), „Versandte Menge" (DE) oder „出荷数" (JA) werden alle als versandte Menge erkannt, weil die KI die semantische Rolle der Spalte versteht – nicht weil sie ein Wörterbuch französischer oder deutscher Spaltenbeschriftungen abgleicht. Die Ausgabefeldnamen bleiben auf Englisch (wie von Ihnen definiert), aber die extrahierten Werte stammen aus dem Dokument in der Sprache des Lieferanten. Dies ist relevant für Lager, die Waren von internationalen Lieferanten erhalten oder mit mehrsprachigen Lieferdokumenten arbeiten – siehe unsere Anleitung zur Batch-Verarbeitung von französischen Lieferscheindokumenten für ein konkretes Beispiel, wie dies gleichzeitig über Dutzende Lieferantenformate hinweg funktioniert.
Was ist der Unterschied zwischen Lieferscheinextraktion und Wareneingangserfassung?
Die Lieferscheinextraktion ist der Datenerfassungsschritt: die Umwandlung des gedruckten Lieferscheins in digitale Felder. Die Wareneingangserfassung ist die Bestandstransaktion: die Erfassung, dass die Artikel nun physisch auf Lager und verfügbar sind. Es handelt sich um aufeinanderfolgende Schritte im selben Workflow. Die Extraktion erzeugt die strukturierten Daten, die in die Wareneingangserfassung einfließen. Bei einem manuellen Prozess tippt der Wareneingangsmitarbeiter die Lieferscheindaten direkt in den Wareneingangsbildschirm. Mit Extraktion werden die Daten automatisch vom Lieferschein erfasst und vor der Buchung der Wareneingangstransaktion geprüft. Der Extraktionsschritt eliminiert das Abtippen; die Wareneingangstransaktion bleibt als Kontrollpunkt bestehen.
Wie gehe ich mit Lieferscheinen um, die mehrere Bestellungen in einer Lieferung kombinieren?
Einige Lieferanten bündeln Artikel aus mehreren Bestellungen in einer einzigen Lieferung und einem Lieferschein. Die Positionszeilentabelle enthält dann mehrere Bestellreferenzen – jede Positionszeile kann sich auf eine andere Bestellung beziehen. Das Extraktionstool muss die Bestellreferenz pro Positionszeile erfassen und nicht annehmen, dass eine einzige Bestellung für die gesamte Lieferung gilt. Dies ist Standardverhalten für semantische Extraktionstools, da sie jede Zeile einzeln lesen. Nach der Extraktion teilt sich die Ausgabe natürlich auf: Zeilen für Bestellung-1001 gehen an einen Wareneingang, Zeilen für Bestellung-1002 an einen anderen. Die Bestellreferenz pro Zeile ist das kritische Feld für dieses Szenario – stellen Sie sicher, dass das Tool sie auf Positionszeilenebene erfasst, nicht nur auf Kopfebene.
Kann die Lieferscheinextraktion direkt in mein bestehendes WMS integriert werden?
Die meisten Extraktionstools bieten keine vorgefertigten WMS-Integrationen. Der Standard-Workflow ist: Extraktion in CSV → CSV-Import in das WMS. Dieser Weg funktioniert mit jedem gängigen WMS, da jedes WMS eine Datenimportfunktion für Wareneingangstransaktionen hat – Manhattan Associates, SAP WM/EWM, Blue Yonder, HighJump/Körber, Oracle WMS Cloud und NetSuite WMS akzeptieren alle strukturierte CSV-Wareneingangsdaten. Einige Tools bieten API-basiertes direktes Posting für kundenspezifische Integrationen, aber der CSV-Weg ist universell und erfordert keinen IT-Aufwand. Die wichtigste Anforderung ist, dass die CSV-Ausgabe des Extraktionstools so strukturiert ist, wie Ihr WMS seine Wareneingangsdaten erwartet – mit Kopfzeilen, die dem Import-Feldmapping des WMS entsprechen.
Ab welchem Packzettel-Volumen lohnt sich die Extraktion?
Faustregel: Wenn Ihr Wareneingang mehr als 30 Packzettel pro Tag von mehr als 5 verschiedenen Lieferanten verarbeitet, bringt die Extraktion messbare Zeitersparnis. Darunter können die 5 Minuten Prüfzeit pro Charge die Tippeinsparung aufwiegen. Der eigentliche Maßstab ist jedoch die Vielfalt der Lieferantenformate – nicht das reine Volumen. 30 Zettel pro Tag von 20 Lieferanten mit 20 verschiedenen Formaten rechtfertigen die Extraktion mehr als 100 Zettel von 2 Lieferanten mit identischen Formaten. Jedes zusätzliche Format erhöht den kognitiven Aufwand: die PO-Referenz an einer anderen Stelle auf jedem Zettel suchen, Bestellmenge von Liefermenge in Layouts unterscheiden, die sie unterschiedlich benennen. Die Extraktion eliminiert diesen Aufwand komplett – Sie definieren Ihre Spalten einmal, unabhängig davon, wie viele Formate Ihre Lieferanten verwenden.
Was passiert, wenn das Extraktionstool ein Feld falsch liest – kann ich es korrigieren, ohne neu zu verarbeiten?
Ja. Das Extraktionsergebnis – ob XLSX oder CSV – ist eine bearbeitbare Datei. Wird ein Feld falsch gelesen, korrigieren Sie es direkt in der Tabelle vor dem Import ins WMS. Der Wert der Extraktion liegt nicht in 100%iger Perfektion – kein Tool erreicht das. Der Wert liegt darin, einen Prozess, der 100 Felder pro Schicht erfordert, in einen Prozess zu verwandeln, der die Prüfung von 5–10 Feldern erfordert. Der Prüfschritt ist kein Versagen der Extraktion, sondern das Qualitätstor, das sicherstellt, dass die Daten korrekt ins WMS gelangen. Die Frage ist nicht „Macht es Fehler?“, sondern „Reduziert es die Anzahl der Felder, die Sie bearbeiten müssen, vom Abtippen aller auf die Kontrolle weniger?“
Von der Anlieferung bis zum Lagerbestand: Das Fazit
Die Lieferscheinextraktion ersetzt nicht Ihr WMS – Manhattan, SAP WM, Blue Yonder und HighJump übernehmen die schweren Aufgaben bei Inventar und Lagersteuerung. Was sie tut, ist, die Lücke zwischen dem Ort, an dem Versanddaten ankommen (ein Papierlieferschein, der an einer Palette am Wareneingang klebt), und dem Ort, an dem sie landen müssen (ein strukturierter Datensatz in Ihrem Wareneingangssystem, bereit zur Überprüfung), zu schließen. Diese Lücke wird derzeit durch manuelle Eingaben überbrückt, die eine Fehlerquote von 1–3 % pro Feld aufweisen, multipliziert über Hunderte von Feldern pro Schicht – mit Folgen, die von Inventurdifferenzen über AP-Sperren bis hin zu Lieferantenstreitigkeiten reichen.
Die drei Dinge, die eine brauchbare Extraktionsimplementierung von einer frustrierenden unterscheiden: (1) Das Tool verarbeitet Teillieferungen mit drei separaten Mengenspalten, nicht nur einer; (2) es verarbeitet gemischte Lieferantenformate in einem einzigen Batch ohne Vorlagenarbeit pro Lieferant; (3) seine Exportausgabe lässt sich ohne Formatfehler sauber in Ihr tatsächliches WMS importieren. Alles andere – Genauigkeitsprozentsätze, KI-Behauptungen, Funktionslisten – ist zweitrangig gegenüber diesen drei betrieblichen Realitäten.
Wenn Sie die Extraktion für Ihren Wareneingang evaluieren, beginnen Sie mit dem Test an Ihrem schwierigsten Lieferschein – dem mehrseitigen industriellen Lieferantenschein mit 40 Positionen über einen Seitenumbruch hinweg, einer Teillieferungszeile mit bestellten vs. gelieferten vs. rückständigen Mengen und einer handschriftlichen Anmerkung am Rand. Wenn ein Tool Ihren schlimmsten Fall bewältigt, wird es auch Ihren Durchschnittsfall bewältigen. Wenn Sie bereit sind zu sehen, wie die Lieferscheinextraktion mit Ihren eigenen Dokumenten funktioniert, laden Sie einen Muster-Lieferschein hoch und sehen Sie, welche strukturierten Daten zurückkommen – oder wenn Sie bereits Google Sheets verwenden, probieren Sie den Sheets-Workflow für Lieferscheindaten.