O guia completo para
Extração de Dados de Notas de Embarque
A pesquisa de custos de armazenagem e fulfillment de 2024 do WERC estima a mão de obra de recebimento em $40,79 por hora, e os benchmarks da APQC mostram uma variação de 44 horas no ciclo de recebimento ao estoque entre os melhores e os piores desempenhos — uma lacuna impulsionada não pela velocidade das empilhadeiras, mas pelo tempo que os dados de embarque ficam parados entre "mercadoria chegou" e "estoque atualizado". A extração de dados de notas de embarque está no centro dessa lacuna: ela determina se cada remessa de fornecedor que chega ao seu cais se torna um registro utilizável no seu WMS no mesmo turno, ou se espera por entrada manual que introduz erros e atrasos que se acumulam na conciliação em três vias, na precisão do estoque e na reconciliação com fornecedores.
Principais conclusões
- Uma nota de embarque com 40 campos tem 33 a 70% de chance de levar um erro de digitação para o seu WMS que fica invisível até que uma exceção de conciliação em três vias ou um inventário rotativo o revele semanas depois.
- O custo visível de $32.000 de entrada de dados por posição de recebimento esconde um custo muito maior que ninguém rastreia, porque está disperso em retenções de contas a pagar, investigações de estornos com fornecedores e correções de estoque fantasma.
- Você não precisa digitar menos números. Você precisa de uma definição de coluna que preserve todos os três campos de quantidade por item de linha, além de uma fórmula de verificação cruzada que sinalize divergências, transformando um turno de 100 campos de uma tarefa de digitação em uma revisão de cinco campos.
Antes deste Guia: O que é a Extração de Notas de Embarque
Novo no conceito? Comece com nosso artigo o que é extração de dados de notas de embarque — ele cobre a definição central, uma comparação entre manual vs. modelo vs. IA, e quando você realmente precisa de extração versus quando não precisa. Este guia assume esse contexto e continua a partir daí: o custo operacional de permanecer no processo manual, os desafios específicos que separam uma extração capaz de resultados parciais, a lista completa de campos e como avaliar ferramentas em relação à sua operação real de recebimento.
A única distinção que vale repetir aqui, porque o restante deste guia depende dela: uma nota de embarque não é uma fatura. Uma fatura traz preços, condições de pagamento e valores de impostos para a contas a pagar. Uma nota de embarque traz dados de remessa para o recebimento no armazém — e sua característica estrutural definidora são três colunas de quantidade por item de linha (pedido, enviado, pedido em aberto) em vez das colunas de preço/impostos de uma fatura. Tudo a partir daqui pressupõe essa estrutura.
Por que o Processamento Manual de Notas de Embarque Custa Mais do que Você Pensa
O custo visível é aritmética simples. Os dados de referência da WERC mostram a mão de obra de recebimento a $40.79 por hora. Um auxiliar de recebimento processando 60 notas de embarque por turno a 3 minutos cada gasta 3 horas — 37,5% do turno — apenas com entrada de dados. A $40.79 por hora, isso equivale a $122 por turno em trabalho de digitação, ou cerca de $32.000 por posição de recebimento por ano. Para um armazém de médio porte com 3 estações de recebimento, isso se aproxima de seis dígitos antes mesmo de contar um único erro.
Mas o custo visível é o número menor. Os custos ocultos se acumulam em três áreas.
Exceções na conciliação em três vias. Cada quantidade digitada incorretamente ou número de pedido transposto em uma nota de embarque cria uma divergência quando a equipe de contas a pagar compara o pedido de compra com a nota de embarque e com a fatura do fornecedor. Os benchmarks de AP 2025 da Ardent Partners relatam que equipes médias de compras enfrentam uma taxa de exceção de 22% na conciliação de faturas, com cada divergência custando cerca de 30 minutos de investigação entre recebimento, compras e finanças. Uma nota de embarque onde "80" foi digitado em vez de "100" — um único erro de digitação — aciona uma retenção na contas a pagar, uma ligação ao fornecedor, uma reavaliação do que realmente chegou e um ajuste. A causa raiz não é o fornecedor nem um erro no dock; é a etapa administrativa entre a nota e o sistema. Equipes de melhor desempenho mantêm taxas de exceção em 9%. A diferença está, em grande parte, em saber se os dados que entram no sistema são os dados impressos no documento ou o que alguém digitou.
Conciliação de remessas parciais. Quando um fornecedor envia 80 de 100 unidades, a nota de embarque mostra três números: pedido, enviado (80), pedido em aberto (20). O auxiliar de recebimento deve digitar os três, e o WMS deve rastrear as quantidades recebidas contra cada item do pedido de compra em múltiplas entregas. O processamento manual de remessas parciais é onde as taxas de erro disparam — porque o auxiliar não está digitando um número, mas distinguindo qual das três quantidades pertence a qual campo, sob pressão de tempo, enquanto o próximo caminhão espera. Uma única transposição — digitar 100 na coluna "enviado" e 80 na coluna "pedido" — inverte a quantidade recebida e cria um excedente fantasma de 20 unidades no estoque que só será descoberto no próximo inventário rotativo, semanas depois.
Estornos de fornecedores. Os estornos por discrepância de fornecedores são um dos custos operacionais mais subestimados. Quando um fornecedor envia 100 unidades, sua equipe de recebimento registra 80 e a fatura do fornecedor de 100 unidades é contestada, o processo de resolução normalmente envolve: (1) o fornecedor solicita uma foto como prova de entrega, (2) alguém no recebimento localiza fisicamente o recibo de entrega assinado, (3) a equipe de contas a pagar compara a confirmação de entrega da transportadora com o registro, (4) um estorno ou correção é emitido. Cada investigação de estorno consome de 30 a 60 minutos entre várias funções — e o custo não é rastreado no orçamento de nenhum departamento específico. Pesquisa da WERC indica que a precisão do recebimento está diretamente correlacionada com a incidência de estornos, mas poucos armazéns medem o custo dos erros de entrada de dados que os desencadeiam.
Para uma análise mais detalhada dos custos por nota e por turno, consulte nossa análise dos custos de processamento manual de notas de embarque.
Os Desafios Exclusivos da Extração de Notas de Embarque
A extração de notas de embarque é mais difícil que a extração de faturas por motivos que importam para quem avalia ferramentas. Entender esses desafios antecipadamente determina se a ferramenta escolhida lidará com seu fluxo de trabalho diário real ou apenas com o cenário de demonstração.
1. Densidade de Itens de Linha
Uma nota de embarque típica de um fornecedor industrial como Grainger ou MSC Industrial pode conter de 30 a 50 itens de linha em duas ou três páginas. Cada item de linha tem seu próprio código do produto, descrição, quantidade pedida, quantidade enviada, quantidade em pedido em aberto e unidade de medida. A tabela de itens de linha é a carga crítica — 80 a 90% dos dados que precisam ser extraídos estão ali — e é onde a maioria das ferramentas de extração falha.
Tabelas de várias páginas introduzem um problema de continuidade: quando uma tabela de 50 linhas se estende da página 1 para a página 2, o mecanismo de extração deve reconhecer que se trata de uma única tabela contínua, não duas tabelas separadas. Os cabeçalhos de coluna podem ou não se repetir nas páginas de continuação. Alguns fornecedores imprimem cabeçalhos em todas as páginas; outros os imprimem apenas na página 1. Uma ferramenta de extração que perde o alinhamento das colunas na quebra de página desloca silenciosamente os valores para colunas erradas a partir da quebra — um código de item do fornecedor cai na coluna de descrição, e uma quantidade enviada cai na coluna de pedido em aberto — e a saída parece completa, mas está estruturalmente corrompida.
2. Remessas Parciais: Três Colunas de Quantidade
Este é o principal desafio da extração de romaneios. Uma nota fiscal tem uma coluna de quantidade. Um romaneio tem três: Qtd. Pedida, Qtd. Enviada e Qtd. Pendente. Cada item de linha carrega os três números, e a extração deve preservar sua identidade — não apenas capturar os valores numéricos.
Cenário de remessa parcial: você pediu 100 unidades do SKU-00412. O fornecedor envia 80, deixa 20 pendentes. O romaneio mostra colunas intituladas "Ped", "Env" (80), "Pend" (20). A ferramenta de extração deve entender qual coluna é qual e enviá-las aos campos corretos. Uma ferramenta que trata as três como um único campo "Quantidade", ou que confunde "Env" com "Ped" em um layout de remessa parcial, produz uma saída inutilizável para verificação de recebimento — você não consegue saber se a remessa está completa ou parcial apenas com os dados extraídos. O fluxo de recebimento depende de ver as três quantidades lado a lado por item de linha, para que a equipe do cais saiba o que precisa de acompanhamento com o fornecedor.
3. Anotações Manuais no Armazém
Os romaneios não chegam em estado estéril. Os recebedores os anotam: quantidades circuladas onde a contagem foi verificada, anotações manuais de "falta" ao lado de um item, assinaturas do recebedor, carimbos de data/hora, códigos de avaria ("1 caixa amassada — recusada") e observações da transportadora. Essas anotações têm significado operacional — são o registro principal do que aconteceu no cais de recebimento — mas ficam sobre os dados impressos, muitas vezes sobrepondo células da tabela ou apertando os cabeçalhos das colunas.
O OCR tradicional é particularmente fraco aqui: um "80" escrito à mão sobre um "100" impresso gera leituras conflitantes de caracteres. Um modelo de IA de visão, por outro lado, usa o contexto do documento — a estrutura da tabela, os rótulos dos cabeçalhos das colunas, os dados impressos ao redor — para distinguir a anotação do texto original e capturar ambos. A anotação não é um defeito a ser contornado; são dados que precisam ser extraídos junto com os campos impressos. Para uma análise focada neste problema, veja nosso artigo sobre extração de notas de entrega manuscritas no recebimento de armazém.
4. Romaneios com Múltiplas Páginas
Um fornecedor pode anexar um romaneio com várias páginas quando a remessa contém caixas mistas: a página 1 é o resumo da remessa e as informações da transportadora, as páginas 2 a 4 são os detalhes por caixa, e a página 5 é uma autorização de devolução de material. A ferramenta de extração deve navegar por essa estrutura, reconhecer onde um tipo de documento termina e outro começa, e extrair apenas os dados relevantes do romaneio, sem se confundir com o formulário RMA ou com o conhecimento de embarque anexado ao final.
5. Recebimento em Lote com Formatos Mistos
Em um único turno de recebimento, podem ser processados: um romaneio padrão da Grainger (PDF, uma página, retrato), uma nota de entrega da McMaster-Carr (impressa da web, duas páginas), uma etiqueta térmica da Fastenal (formato estreito, paisagem) e uma foto de uma nota de entrega manuscrita de um fornecedor local — tudo na mesma janela de 30 minutos. Processar cada tipo de formato por meio de um modelo ou ferramenta separada anula o propósito da automação. A solução de extração deve lidar com formatos mistos em um único lote, aplicando as mesmas definições de colunas em todos eles, porque a saída precisa ir para a mesma tabela de recebimento do WMS, independentemente de qual fornecedor enviou qual formato.
Campos Principais para Extrair de um Romaneio
Os campos do romaneio se dividem em duas categorias. Os campos de cabeçalho se aplicam a toda a remessa; os campos de item de linha se repetem para cada linha da tabela. Entender quais campos são críticos para seu fluxo de reconciliação downstream determina como você configura suas colunas de extração.
| Campos de Cabeçalho (um por romaneio) | Dificuldade de Extração | Por Que é Importante |
|---|---|---|
| Número do Romaneio / Nota de Entrega | Baixa | Chave primária para rastreamento, consulta ao fornecedor e trilha de auditoria |
| Data (Embarque / Emissão) | Baixa | Relatório de envelhecimento para recebimentos em aberto; determina o início do prazo de doca ao estoque |
| Referência do Pedido de Compra / SO | Média | Vincula a remessa ao PO para conciliação tripla; formatos de rótulo inconsistentes entre fornecedores |
| Endereço de Origem (Fornecedor / Armazém) | Média | Fornecedores com múltiplas localidades podem embarcar de diferentes instalações; necessário para roteamento de devoluções |
| Endereço de Destino (Seu Local de Recebimento) | Baixa | Confirma o roteamento da entrega; sinaliza cross-dock se o local errado receber a remessa |
| Nome da Transportadora | Baixa | Correspondência de agendamento de recebimento, alocação de custos de frete inbound |
| Número de Rastreamento / PRO | Média | Consulta à transportadora, recuperação de comprovante de entrega; formatos variam amplamente |
| Número de Caixas / Paletes | Média | Verificação pré-recebimento: as caixas na doca correspondem ao romaneio? |
| Peso Total | Baixa | Auditoria de frete, verificação de faturamento da transportadora |
| Assinatura do Recebedor | Alta | Comprovante de entrega; necessária extração contextual + de caligrafia |
| Campos de Item de Linha (vários por nota) | Dificuldade de Extração | Por Que Importa |
|---|---|---|
| Código do Item / SKU / Número da Peça | Média | Os códigos do fornecedor e internos costumam diferir; é necessário mapeamento cruzado |
| Descrição do Item | Alta | Texto livre, multilinha, pode conter especificações ou números de série; rico, porém variável |
| Quantidade Pedida | Média | Deve corresponder ao item do pedido de compra; base para comparação de remessas parciais |
| Quantidade Enviada | Média | Quantidade efetivamente recebida; campo essencial para verificação de recebimento e conciliação em três vias |
| Quantidade em Aberto | Alta | Identifica remessas incompletas; direciona o fluxo de acompanhamento com o fornecedor |
| Unidade de Medida | Alta | "EA" / "PCS" / "CTN" / "BOX" — sem padrão; deve ser preservada como está para o mapeamento de unidade de medida |
As três colunas de quantidade — Pedida, Enviada, em Aberto — são o que diferencia a extração de notas de embarque de qualquer outro tipo de documento. Uma ferramenta de extração que as achate em um único campo, ou que as capture sem preservar qual é qual, falhou na tarefa principal. Verifique isso antes de se comprometer com qualquer ferramenta: envie uma nota de embarque com pelo menos um item de remessa parcial e confira se as três quantidades aparecem nas colunas corretas da saída.
Extração de Nota de Embarque: Tradicional vs. com IA
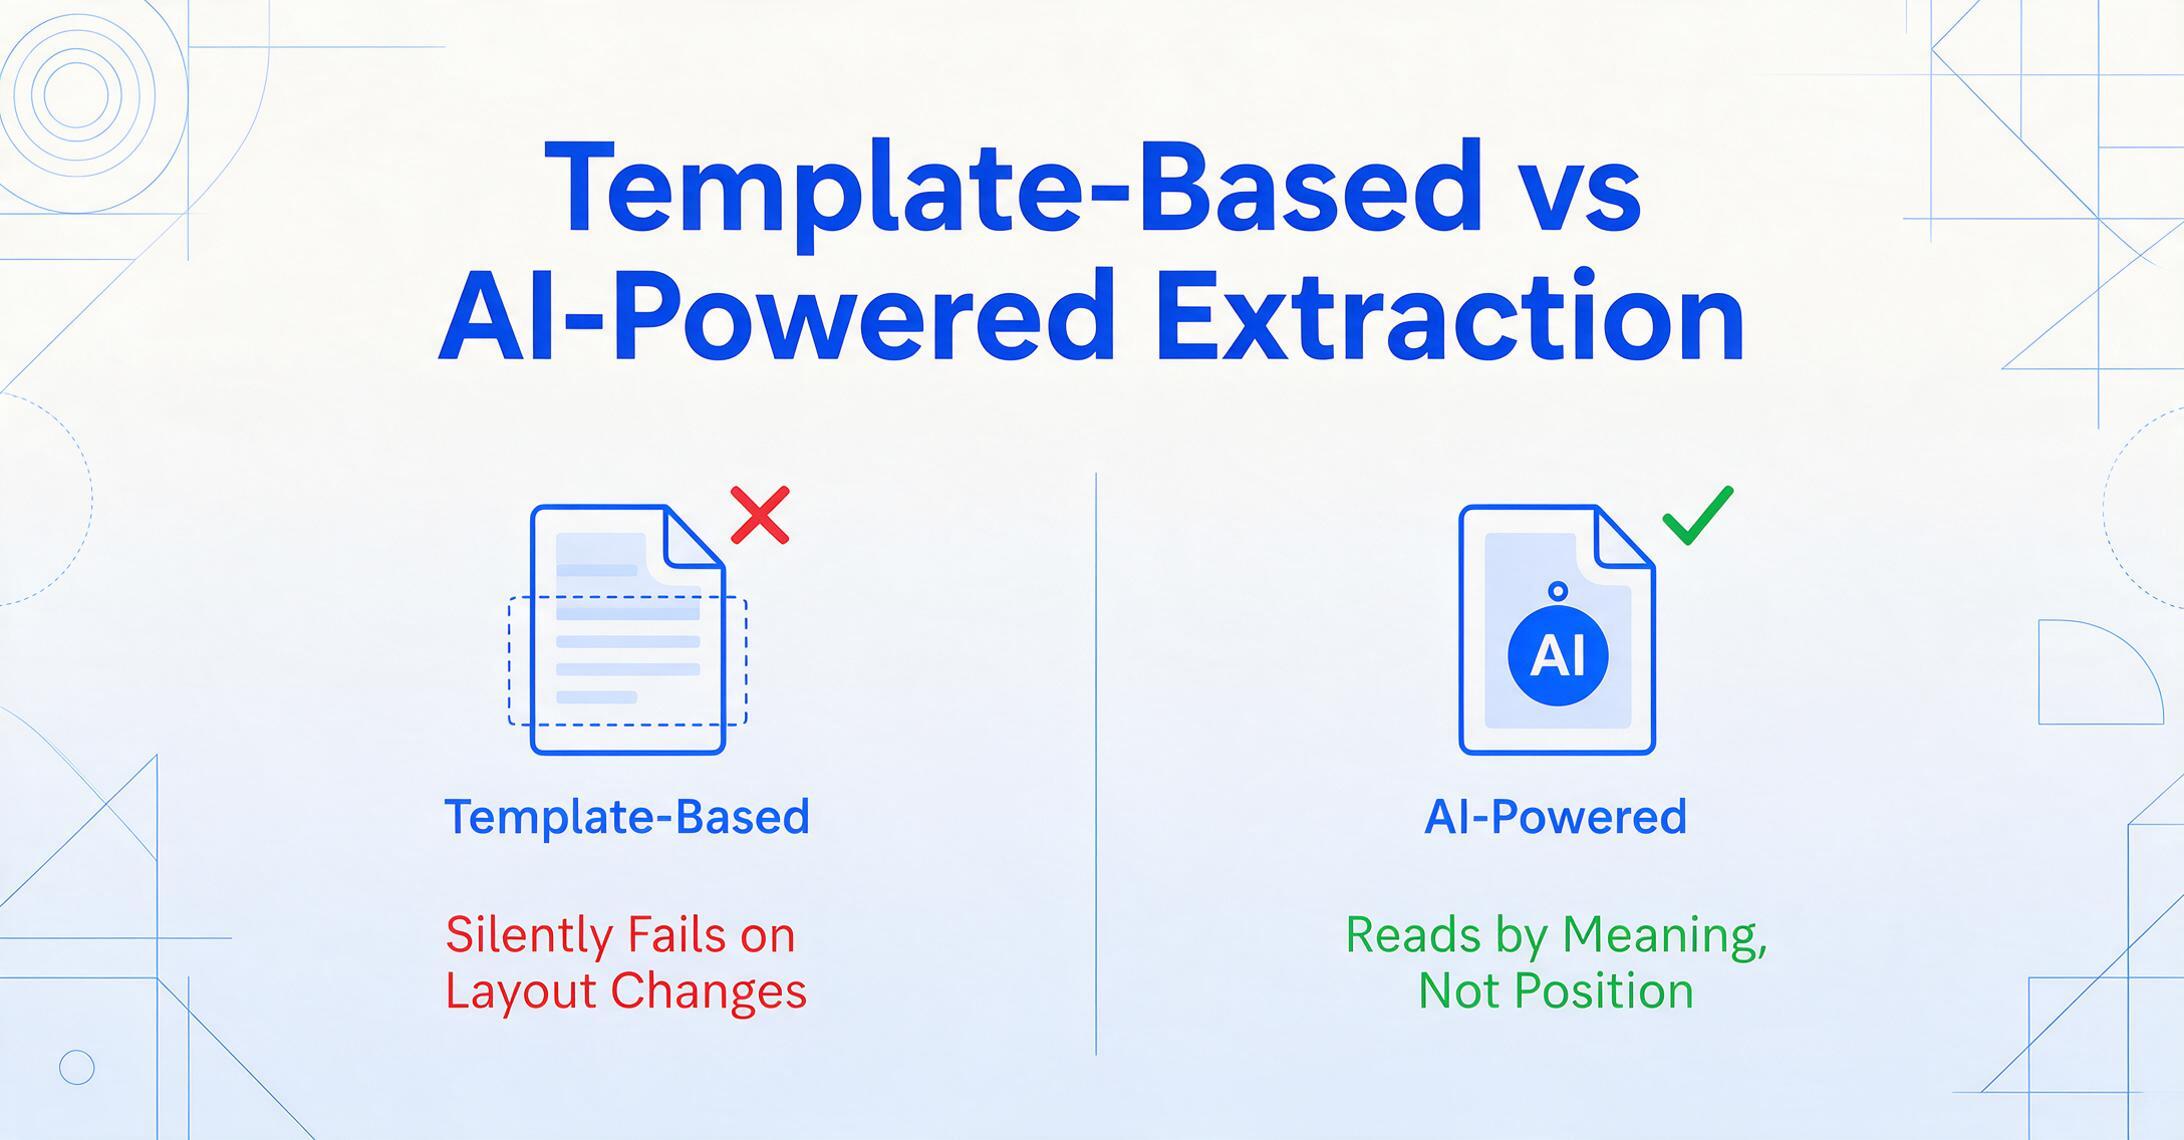
Nem toda tecnologia de extração lida igualmente com os desafios acima. A distinção fundamental é entre extração baseada em modelo (posicional) e extração semântica (com IA) — e entender essa diferença é o passo de avaliação mais importante que você pode dar.
Extração baseada em modelo exige configurar uma zona de análise para o layout do documento de cada fornecedor. Você desenha um retângulo ao redor de onde a referência do pedido de compra aparece na nota de embarque do Fornecedor A, outro retângulo ao redor do cabeçalho da tabela de itens, e define larguras de coluna. Quando o Fornecedor A reformata a nota — mudando o layout após uma atualização do ERP — seu modelo falha silenciosamente. Os valores caem em colunas erradas. Você descobre o problema quando um funcionário do recebimento percebe que as quantidades estão aparecendo no campo de descrição, ou nem aparecem.
A abordagem baseada em modelos falha de forma mais evidente na tabela de itens. Um modelo assume que a tabela começa em uma linha fixa e que as colunas têm larguras fixas. Mas as notas de embarque dos fornecedores variam em quantas linhas de cabeçalho precedem a tabela, se os cabeçalhos das colunas se repetem, se as linhas abarcam várias linhas de texto e se agrupamentos a nível de caixa estão anidados dentro da tabela. Um modelo que funciona para a tabela de 30 linhas de um fornecedor frequentemente se desalinha na tabela de 50 linhas de outro, com células de descrição mescladas. A pesquisa da Levvel Research sobre custos de entrada de dados observa que mais de 30% das discrepâncias no processamento de documentos remontam a um processamento inconsistente — que é exatamente o que a extração baseada em modelos introduz: processamento consistente de inconsistência, produzindo resultados errados que parecen corretos.
Extração semântica — extração com IA usando modelos de linguagem visual — funciona por significado, não por posição. Você define as colunas que deseja: "Número de Nota de Embarque", "Referência de Pedido de Compra", "Código do Produto", "Qtd. Pedida", "Qtd. Enviada", "Qtd. em Atraso", "Unidade de Medida". A IA lê o documento inteiro — a seção de cabeçalho, a tabela de itens, as anotações de rodapé — e localiza cada valor entendendo o que ele representa semanticamente, independentemente de onde esteja na página. Um campo rotulado "Ord" na nota de um fornecedor, "Qty" na de outro e "Ordered" na de um terceiro é reconhecido como a mesma coisa porque a IA entende o papel semântico. Isto é Extração de Colunas Personalizadas: você define a saída uma vez, e a IA localiza os dados correspondentes por significado, não por coordenadas.
A diferença operacional está na manutenção de modelos. Com modelos, cada novo fornecedor — ou cada mudança de formato de um fornecedor existente — exige trabalho de modelo. Para um armazéns que recebe de mais de 50 fornecedores, cada um com suas próprias variações de formato, a manutenção de modelos se torna um custo operacional contínuo que compensa a economia de trabalho da automação. Com a extração semântica, a mesma definição de colunas funciona em todos os fornecedores porque a lógica de extração é independente de formato. Uma nota de embarque de um fornecedor que você nunca processou antes — com um layout que a IA nunca viu — é extraída corretamente no primeiro upload, porque a IA lê a semântica da nota de embarque, não suas coordenadas.
Para saber mais sobre por que os formatos de notas de embarque dos fornecedores divergem e por que sempre divergirão, consulte nosso artigo sobre inconsistência de formato de nota de embarque.
Os arquivos são processados de forma segura e não são armazenados.
Processamento em Lote: Verificação Cruzada com Dados de Pedido de Compra
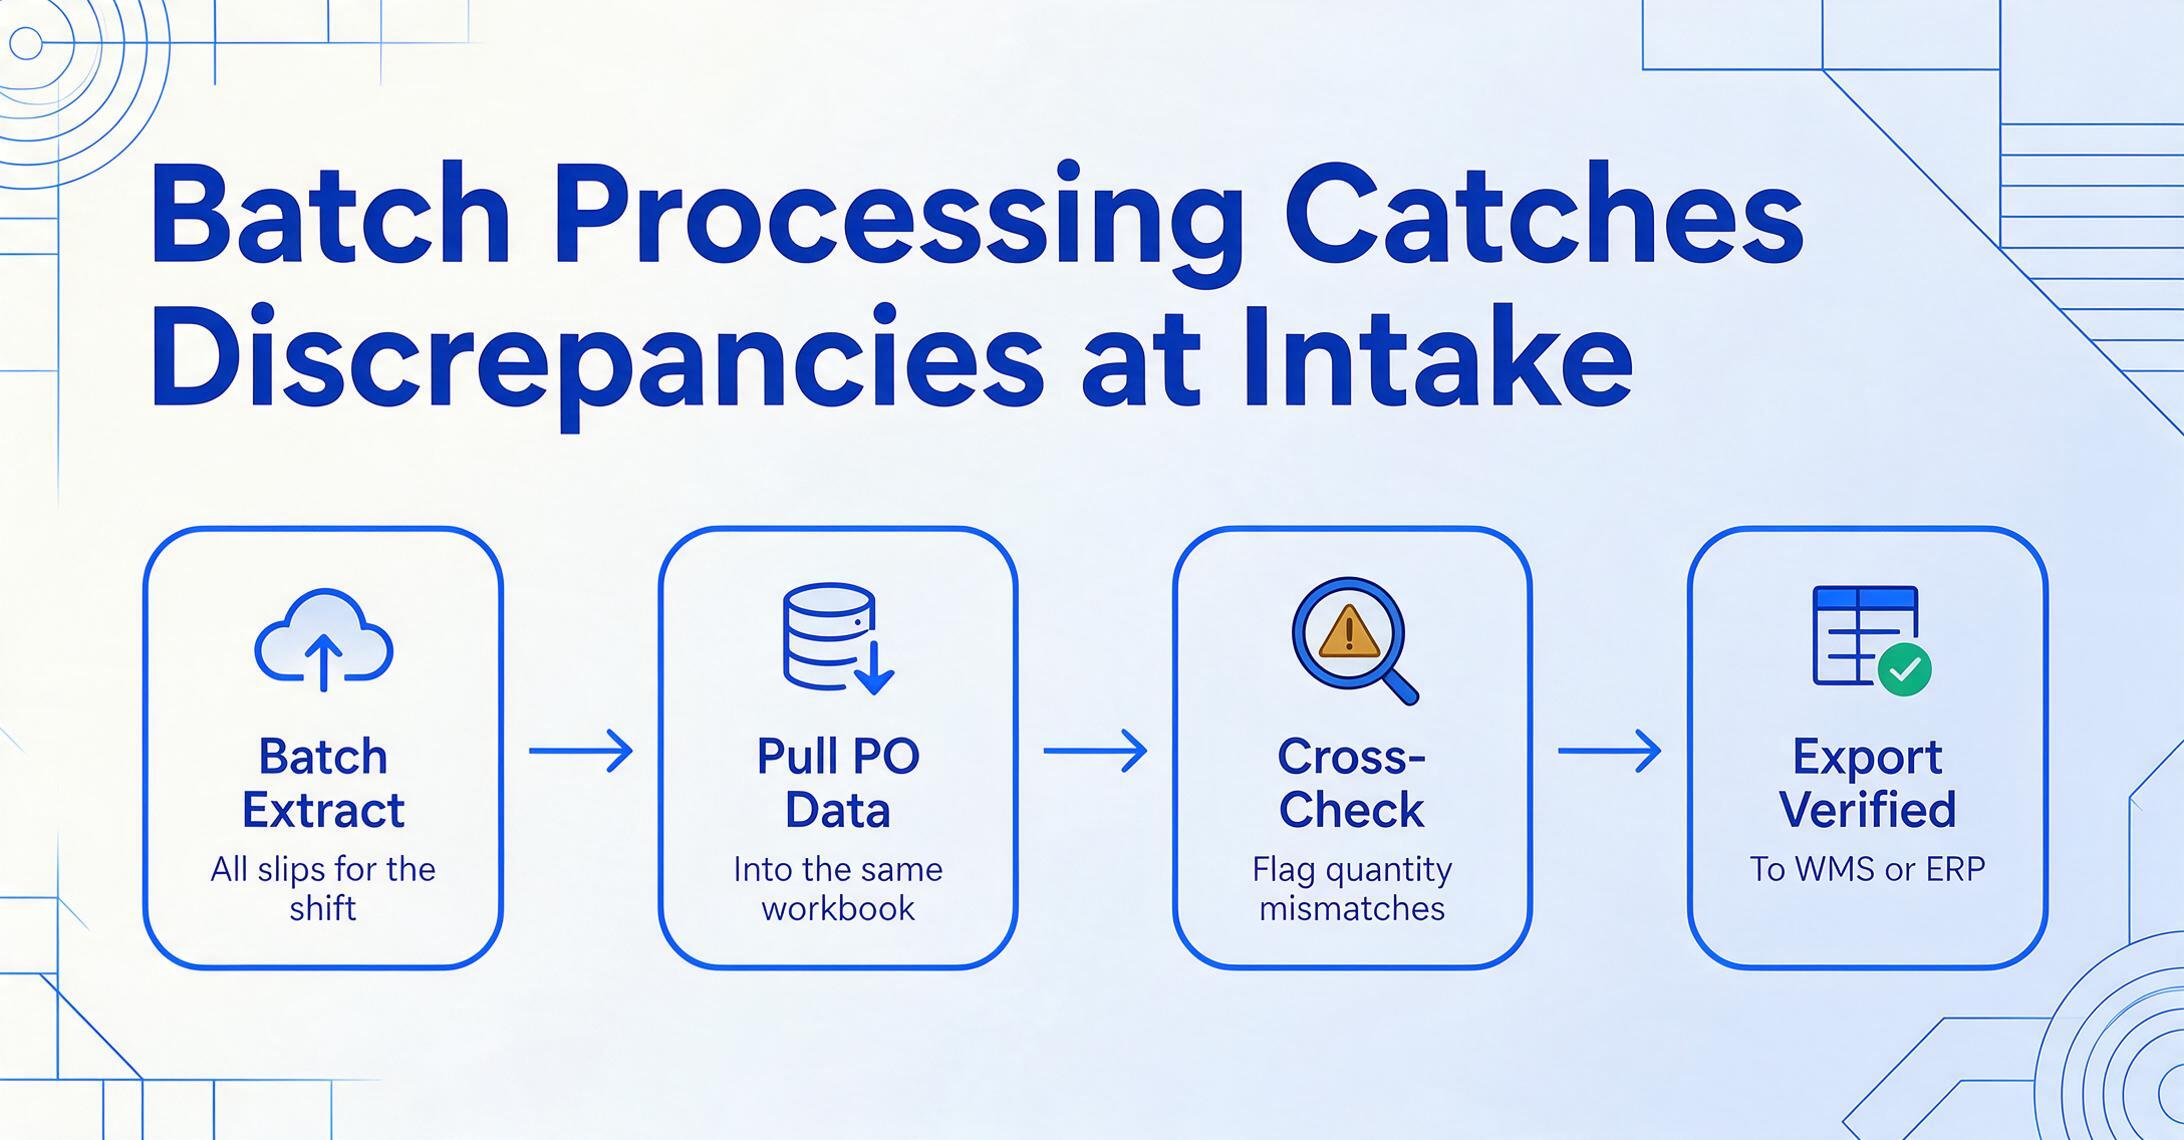
A extração de uma única nota de embarque resolve o problema de entrada de dados por documento. O processamento em lote resolve o desafio de throughput — e desbloquea uma capacidade que o processamento individual não pode: verificação cruzada automatizada das quantidades da nota de embarque contra os dados do pedido de compra.
Em um fluxo de lote, você carrega 20, 30 ou 50 notas de embarque de diferentes fornecedores em um único lote — algumas em PDF, algumas fotos de telefone, algumas de várias páginas. O motor de extração processa todas elas usando as mesmas definições de colunas e combina os resultados em uma única planilha. Cada nota de embarque se torna uma linha na tabela de cabeçalho; cada item de linha se torna uma linha de detalhe com os campos de cabeçalho repetidos. Para o fluxo passo a passo, consulte nosso guía para extração de notas de embarque em lote para Excel.
Mas o processamento em lote se torna verdadeiramente poderoso quando você o combina com uma etapa de verificação cruzada contra seus dados de pedido de compra. Aquí está o fluxo que separa uma operação de recebimento que detecta discrepâncias no momento da entrada de uma que as descubre semanas depois durante inventários rotativos:
Extraia em lote todas as notas de embarque do turno
Envie todas as notas de embarque recebidas durante o turno — independentemente do fornecedor, formato ou número de páginas. O resultado é uma única tabela estruturada com todos os itens identificados: referência do pedido de compra, código do produto, quantidade pedida, quantidade enviada e quantidade em pedido em aberto.
Importe os dados do pedido de compra na mesma pasta de trabalho
Exporte os dados do seu pedido de compra — do SAP, NetSuite ou da sua planilha de compras — e carregue-os junto com os dados extraídos das notas de embarque. Cada pedido de compra contém as quantidades pedidas que devem ser comparadas com as quantidades das notas de embarque. Para um passo a passo completo sobre como extrair dados de pedidos de compra, consulte nosso guia completo de extração de dados de pedidos de compra.
Use colunas calculadas para sinalizar divergências automaticamente
Defina uma coluna de validação que calcule Qtd. Pedida no PC − Qtd. Enviada na Nota de Embarque. Qualquer item com resultado diferente de zero é sinalizado para revisão. Isso transforma o fluxo de recebimento de "digitar cada número e torcer para estar certo" para "revisar apenas as exceções" — reduzindo o trabalho de verificação de 100% dos itens para os 5–15% que apresentam divergência.
Exporte e importe os dados limpos no seu WMS
Após a revisão, os dados verificados das notas de embarque — com divergências sinalizadas e resolvidas — estão prontos para importação no WMS. Exporte como CSV ou XLSX e carregue no Manhattan Associates, Blue Yonder, SAP WM, NetSuite WMS ou qualquer sistema que aceite dados estruturados de recebimento. Os dados limpos se tornam o registro de recebimento de mercadoria que alimenta a conciliação em três vias.
Este fluxo de trabalho transforma a extração de uma simples substituição de digitação em um mecanismo de detecção de divergências. O principal facilitador é a coluna calculada: uma coluna que não extrai dados do documento, mas calcula um novo valor a partir dos campos extraídos. Você pode definir colunas calculadas para correspondência de quantidades (Qtd. Pedida − Qtd. Enviada), verificações de consistência de unidade de medida ou até mesmo validação da contagem de caixas, comparando os totais de caixas extraídos com o que a transportadora registrou. Para uma explicação detalhada de como as colunas calculadas funcionam na extração de documentos, consulte nossa visão geral da extração de documentos com IA usando colunas calculadas.
Exportação e Integração com WMS
O resultado da extração não é o destino final. Os dados precisam entrar em um sistema — seu WMS, seu ERP ou sua planilha de recebimento — onde eles alimentam atualizações de inventário, conciliação em três vias e reconciliação com fornecedores. O caminho de exportação que você escolhe determina quanto trabalho manual permanece entre a extração e a entrada no sistema.
| Formato de Exportação | Melhor Para | Considerações |
|---|---|---|
| XLSX (Excel) | Revisão manual, conferência com dados do pedido de compra, auditoria de remessas parciais, assistentes de importação de WMS para médias empresas | Datas e números precisam sobreviver à conversão de formato. Números de pedido de compra com zeros à esquerda podem ser truncados pelo Excel — verifique a preservação do formato antes de confiar neste caminho. |
| CSV | Importação em SAP WM/EWM, Oracle WMS, NetSuite WMS, Manhattan Associates (WMOS), Blue Yonder, HighJump/Körber | Descrições de itens com várias linhas e vírgulas embutidas podem quebrar as linhas do CSV, a menos que sejam devidamente escapadas. Verifique se o resultado da extração usa aspas em conformidade com RFC 4180. |
| JSON | Integrações personalizadas com WMS/ERP, pipelines automatizados de recebimento, fluxos de trabalho baseados em API | Estruturas aninhadas de itens (cabeçalho → caixas → itens) preservam a hierarquia da remessa de forma limpa, mas são mais difíceis de revisar manualmente. Melhor quando o receptor é uma máquina, não uma pessoa. |
| Google Sheets | Equipes no Google Workspace, revisão colaborativa de recebimento, painéis compartilhados de recebimento | Elimina o ciclo de exportação-importação inteiro se a ferramenta de extração oferecer saída direta para o Sheets. Um complemento do Google Sheets para extração de nota de embarque pode gravar os dados de recebimento diretamente na sua planilha de rastreamento, sem manipulação intermediária de arquivos. |
A conversão de formato é onde uma extração limpa ainda pode se transformar em um arquivo sujo. Datas chegam em uma dúzia de convenções, códigos de item perdem os zeros à esquerda no momento em que uma planilha os trata como números, e uma descrição com várias linhas e uma vírgula embutida quebra a linha em que está. Uma etapa de pós-processamento é o que evita que isso chegue ao seu WMS: a ferramenta normaliza datas e valores para uma única convenção e padroniza formatos de identificador antes da exportação, de modo que o valor impresso na nota seja o valor que chega à coluna. Quando essa etapa é executada antes da exportação, o arquivo está pronto para o assistente de importação do WMS, em vez de exigir uma limpeza manual.
Para a maioria das equipes de armazém, o fluxo de trabalho prático é: extração em lote → revisão no Excel/Sheets → importação do CSV no WMS. Esse caminho funciona com todas as principais plataformas de WMS — Manhattan Associates (WMOS) aceita importações CSV de recebimento de mercadoria, SAP WM/EWM usa entrada em lote via LS24, Blue Yonder (antiga JDA) ingere dados de recebimento em arquivo plano, HighJump/Körber suporta CSV por meio de sua estrutura de importação de dados, e Oracle WMS Cloud e NetSuite WMS ambos têm assistentes de importação CSV para transações de recebimento.
O requisito crítico em todos os formatos é que o resultado da extração preserve a relação item-de-linha-para-remessa: cada item de linha deve carregar o número da nota de embarque pai e a referência do pedido de compra, para que o sistema de recebimento possa corresponder as quantidades recebidas à linha correta do pedido de compra. Uma saída plana que descarte essa hierarquia — mesmo temporariamente durante a etapa de revisão — força alguém a reconstruir a relação manualmente, anulando a economia de tempo da extração.
Como Escolher uma Ferramenta de Extração de Nota de Embarque
Os critérios a seguir cortam as alegações de marketing para o que realmente diferencia as ferramentas no uso diário de recebimento em armazém. Teste com base neles, em vez de listas de recursos.
Teste na sua pior nota de embarque, não na melhor
Toda ferramenta lida com uma nota de embarque limpa de uma página de um fornecedor importante. Peça para testar em uma nota de duas páginas com 30+ itens de linha abrangendo a quebra de página, uma linha de remessa parcial com três colunas de quantidade e uma anotação manuscrita rabiscada em uma célula de tabela. Se a ferramenta lidar com isso, lidará com todo o resto. Se o fornecedor hesitar ou oferecer apenas documentos de amostra, essa resposta já é um sinal.
Verifique a preservação das colunas de remessa parcial
Envie uma nota de embarque em que pelo menos um item de linha mostre valores diferentes em Qtd. Pedida, Qtd. Enviada e Qtd. em Aberto. Verifique a saída: os três números estão presentes em colunas distintas, rotulados corretamente? Qualquer ferramenta que os coloque em um único campo "Quantidade", ou que confunda qual número pertence a qual coluna, não pode suportar o recebimento de remessas parciais. Este é o teste mais importante.
Sem modelo é o ponto de partida; teste a resiliência de formato
Um fornecedor que diz "sem modelo" deve lidar com uma nota de embarque de um fornecedor cujo formato nunca viu — usando apenas os nomes das suas colunas como instruções. O teste decisivo: envie a mesma nota de embarque, mas com o layout de um fornecedor diferente — mesmos dados, posição diferente. Se a extração falhar ou a precisão cair, a ferramenta depende de modelo, independentemente da linguagem de marketing.
A saída em lote deve preservar a hierarquia remessa-item de linha
Ao extrair 30 notas de embarque em lote, a saída deve identificar quais itens de linha pertencem a qual remessa — incluindo o número da nota de embarque e a referência do pedido de compra em cada linha de detalhe. Uma saída plana que perde essa relação força você a reconstruí-la manualmente, o que adiciona de volta o tempo que a extração deveria economizar.
A exportação deve sobreviver ao caminho até o seu WMS
Pegue a saída CSV da ferramenta e tente importá-la para o seu WMS real — não um ambiente de demonstração, mas o seu sistema real com regras reais de manipulação de dados. Verifique se as datas mantêm o formato, se as quantidades retêm casas decimais, se os códigos de item com zeros à esquerda não são truncados e se descrições de várias linhas não quebram os limites das linhas do CSV. Este teste de 10 minutos detecta mais problemas de integração do que qualquer comparação de recursos.
Para uma comparação direta de como as ferramentas de extração se saem em documentos logísticos, incluindo notas de embarque, veja nossa análise das melhores ferramentas de extração de documentos logísticos.
Perguntas Frequentes
Como a extração de nota de embarque difere da extração de nota de entrega?
Na prática, os dois termos se referem ao mesmo tipo de documento, com uma diferença de momento. A nota de embarque registra o que foi embalado no ponto de envio — ela acompanha a mercadoria e documenta o conteúdo das caixas. A nota de entrega (ou comprovante de entrega) confirma o que foi recebido no destino, normalmente com assinatura do recebedor e horário. Muitos fornecedores usam os termos de forma intercambiável. As equipes de armazém encontram ambos do mesmo fornecedor para a mesma remessa, e uma ferramenta de extração capaz lida com eles de forma idêntica — a estrutura de campos (linhas de itens com três colunas de quantidade) é a mesma.
A extração de nota de embarque consegue lidar com avisos antecipados de remessa EDI 856?
EDI 856 é um padrão de intercâmbio eletrônico de dados — não um formato de documento que ferramentas de extração processam diretamente. Quando um fornecedor envia um EDI 856, os dados chegam em um formato EDI estruturado que seu WMS ou ERP pode ingerir sem extração. A extração de nota de embarque preenche a lacuna para a maioria dos fornecedores que não enviam EDI — ou que enviam o EDI 856, mas anexam uma nota de embarque em PDF mesmo assim. A maioria das operações usa EDI para fornecedores grandes e extração para o restante, tratando-os como métodos de entrada complementares, e não alternativos.
Qual precisão posso esperar na extração de nota de embarque?
Em notas de embarque em PDF digital limpas (impressas pelo fornecedor, sem manuscritos, bom contraste), os dados de tabela impressos são extraídos com até 99% de precisão. As linhas de itens são onde a precisão cai: cada linha adicionada é mais uma chance de uma coluna se desalinhar, uma descrição transbordar ou uma unidade de medida cair no campo errado, então uma nota densa de várias páginas pontua menos do que uma nota limpa de uma página do mesmo fornecedor. Notas escaneadas e fotos de celular com sombras ou inclinação caem ainda mais, e notas onde o manuscrito predomina são o caso mais difícil de todos. Compare isso com a entrada manual: pesquisas revisadas por pares sobre erros de entrada de dados apontam erros em nível de campo de aproximadamente 1–3% por campo digitado, o que significa que uma nota de embarque com 40 campos tem 33–70% de chance de ter pelo menos um erro de digitação. A vantagem da extração não é que os erros sejam eliminados. É que os erros são expostos para revisão durante a etapa de verificação, em vez de ficarem enterrados no WMS até que um inventário rotativo ou uma exceção de conciliação os revele.
A extração de nota de embarque funciona com imagens de qualidade fotográfica tiradas pelo celular?
Sim, com ressalvas quanto à qualidade da imagem. Uma foto de nota de embarque bem iluminada e focada extrai com 85–95% de precisão — próxima à qualidade de PDF escaneado. Os modos de falha são: sombras sobre o documento (comum ao fotografar no cais de recebimento), inclinação severa (o celular segurado em ângulo, não reto) e corte parcial que corta os cabeçalhos das colunas. Um fluxo de recebimento que inclui fotos de celular deve incorporar uma verificação rápida de qualidade da imagem antes da extração — rejeitar fotos borradas ou com muitas sombras e tirá-las novamente. A IA de visão moderna lida melhor com degradação moderada do que o OCR tradicional, porque usa contexto para preencher lacunas, mas não consegue reconstruir dados que nunca foram capturados na imagem.
Como a extração lida com notas de embarque de fornecedores internacionais com campos em outros idiomas?
Os modelos de IA de visão treinados em documentos multilíngues podem extrair campos de notas de embarque independentemente do idioma em que os rótulos estão escritos. Uma coluna chamada quantidade enviada em francês ("Quantité expédiée"), alemão ("Versandte Menge") ou japonês (出荷数) é reconhecida como o mesmo campo, porque a IA lê o papel semântico da coluna em vez de comparar com um dicionário de rótulos estrangeiros. Os nomes dos campos de saída permanecem em inglês (como você os definiu), mas os valores extraídos vêm do documento no idioma usado pelo fornecedor. Isso é relevante para armazéns que recebem de fornecedores internacionais ou lidam com documentação de entrega multilíngue; nosso passo a passo sobre processamento em lote de documentos bon de livraison em francês mostra isso funcionando em dezenas de formatos de fornecedores de uma só vez.
Qual é a diferença entre extração de nota de embarque e lançamento de recebimento de mercadoria (GR)?
A extração de nota de embarque é a etapa de captura de dados: transformar a nota impressa em campos digitais. O lançamento de recebimento de mercadoria é a transação de inventário: registrar que os itens agora estão fisicamente em estoque e disponíveis. São etapas sequenciais no mesmo fluxo de trabalho. A extração produz os dados estruturados que alimentam o lançamento de recebimento de mercadoria. Em um processo manual, o funcionário do recebimento digita os dados da nota de embarque diretamente na tela de recebimento de mercadoria. Com a extração, os dados são capturados da nota automaticamente e depois revisados antes de o lançamento de recebimento de mercadoria ser registrado. A etapa de extração elimina a digitação; a transação de recebimento de mercadoria permanece como ponto de controle.
Como lidar com notas de embarque que combinam vários pedidos de compra em uma única remessa?
Alguns fornecedores consolidam itens de vários pedidos de compra em uma única remessa e nota de embarque. A tabela de itens então carrega várias referências de pedido de compra — cada item pode referenciar um pedido diferente. A ferramenta de extração deve capturar a referência do pedido de compra por item, sem presumir que um único pedido se aplica à remessa inteira. Esse é o comportamento padrão das ferramentas de extração semântica, pois elas leem cada linha individualmente. Após a extração, a saída se divide naturalmente: linhas do PO-1001 vão para um recebimento de mercadoria, linhas do PO-1002 vão para outro. A referência do pedido de compra por linha é o campo crítico nesse cenário — verifique se a ferramenta a captura no nível do item, não apenas no nível do cabeçalho.
A extração de nota de embarque pode ser integrada diretamente ao meu WMS existente?
A maioria das ferramentas de extração não oferece integrações WMS pré-construídas. O fluxo de trabalho padrão é: extrair para CSV → importar CSV no WMS. Esse caminho funciona com todos os principais WMS, pois todos têm um recurso de importação de dados para transações de recebimento — Manhattan Associates, SAP WM/EWM, Blue Yonder, HighJump/Körber, Oracle WMS Cloud e NetSuite WMS aceitam dados estruturados de recebimento de mercadoria em CSV. Algumas ferramentas oferecem lançamento direto via API para integrações personalizadas, mas o caminho via CSV é universal e não exige nenhuma configuração de TI. O requisito principal é que a saída CSV da ferramenta de extração seja estruturada da forma que seu WMS espera para dados de recebimento — com cabeçalhos correspondentes ao mapeamento de campos de importação do WMS.
Qual volume de notas fiscais justifica investir em extração?
Como regra geral: se sua operação de recebimento processa mais de 30 notas fiscais por dia de mais de 5 fornecedores diferentes, a extração gera economia de tempo mensurável. Abaixo desse volume, a revisão de 5 minutos por lote pode anular a economia com digitação. O verdadeiro limite, no entanto, é a diversidade de formatos dos fornecedores — não o volume bruto. Trinta notas por dia de 20 fornecedores com 20 formatos diferentes justifica mais a extração do que 100 notas de 2 fornecedores com formatos idênticos. Cada formato único adiciona carga cognitiva: encontrar a referência do pedido em um local diferente em cada nota, distinguir Qtde Pedida de Qtde Enviada em layouts que as rotulam de forma diferente. A extração elimina essa sobrecarga completamente — você define suas colunas uma vez, independentemente de quantos formatos seus fornecedores usam.
O que acontece quando a ferramenta de extração lê um campo incorretamente — posso corrigi-lo sem reprocessar?
Sim. A saída da extração — seja XLSX ou CSV — é um arquivo editável. Se um campo for lido incorretamente, você o corrige diretamente na planilha antes de importar para o WMS. O valor da extração não é 100% de precisão perfeita — nenhuma ferramenta de extração alcança isso. O valor é transformar um processo que exige digitar 100 campos por turno em um processo que exige verificar 5 a 10 campos. A etapa de revisão não é uma falha da extração; é o controle de qualidade que garante que os dados que entram no seu WMS estejam corretos. A questão não é "ela comete erros?" mas sim "ela reduz o número de campos que você precisa manipular, de digitar tudo para verificar alguns?"
Do Recebimento aos Dados: O Resultado Final
A extração de notas de embarque não substitui o seu WMS — Manhattan, SAP WM, Blue Yonder e HighJump fazem o trabalho pesado no controle de inventário e armazém. O que ela faz é fechar a lacuna entre onde os dados de remessa chegam (uma nota de papel presa a um palete no cais de recebimento) e onde precisam estar (um registro estruturado no seu sistema de recebimento, pronto para verificação). Essa lacuna hoje é preenchida por digitação manual, com uma taxa de erro de 1–3% por campo, multiplicada por centenas de campos por turno — com consequências que vão de discrepâncias de inventário a retenções no contas a pagar e disputas com fornecedores.
As três coisas que separam uma implantação de extração útil de uma frustrante: (1) a ferramenta lida com remessas parciais com três colunas distintas de quantidade, não apenas uma; (2) ela processa formatos mistos de fornecedores em um único lote, sem trabalho de modelo por fornecedor; (3) a exportação é importada corretamente no seu WMS real, sem corromper o formato. Todo o resto — percentuais de precisão, alegações de IA, listas de recursos — é secundário diante dessas três realidades operacionais.
Se você está avaliando extração para sua operação de recebimento, comece testando com sua nota de embarque mais difícil — a nota industrial de várias páginas com 40 itens que atravessam uma quebra de página, uma linha de remessa parcial mostrando pedido vs. enviado vs. pedido em aberto, e uma anotação manuscrita na margem. Se uma ferramenta lidar com seu pior caso, ela lidará com o caso médio. Se você está pronto para ver como a extração de notas de embarque funciona com seus próprios documentos, envie uma nota de embarque de exemplo e veja quais dados estruturados retornam — ou, se você já usa o Google Sheets, experimente o fluxo de trabalho no Sheets para dados de notas de embarque.