パッキングスリップデータ抽出の
完全ガイド
WERCの2024年倉庫・フルフィルメントコスト調査によると、受入作業の人件費は1時間あたり$40.79、APQCのベンチマークでは、上位と下位の事業者間で受入から在庫化までのサイクルタイムに44時間もの差があります。この差はフォークリフトの速度ではなく、出荷データが「商品到着」から「在庫更新」までの間にどれだけ滞留するかによって生じます。パッキングスリップデータ抽出は、まさにこのギャップの中心にあります。サプライヤーからのすべての出荷が、同じシフト内でWMSの利用可能なレコードになるか、それとも手入力待ちとなり、3点照合、在庫精度、サプライヤー照合に波及するエラーと遅延を生むかは、この抽出にかかっているのです。
重要なポイント
- 40フィールドのパッキングスリップは、33〜70%の確率でキー入力エラーをWMSに持ち込み、そのエラーは数週間後まで3点照合の例外や棚卸しで表面化するまで見えないままになります。
- 受入ポジション1つあたりの目に見えるデータ入力コスト$32,000の背後には、AP保留、サプライヤー請求差異調査、架空在庫修正に散在するため誰も追跡していない、はるかに大きなコストが隠れています。
- 必要なのは入力する数字を減らすことではありません。必要なのは、明細ごとの3つの数量フィールドをすべて保持する列定義と、不一致を検出するクロスチェック計算式です。これにより、100フィールドの作業がタイピング作業から5フィールドのレビュー作業に変わります。
このガイドの前に:パッキングスリップ抽出とは
この概念に初めて触れる方は、まずパッキングスリップデータ抽出とはの記事をご覧ください。基本定義、手動・テンプレート・AIの比較、そして実際に抽出が必要なケースと不要なケースを解説しています。このガイドはその文脈を前提として、手動運用のコスト、完全な抽出と部分的な結果を分ける具体的な課題、全フィールドのチェックリスト、そして実際の受入業務に照らしたツール評価の方法について掘り下げます。
このガイド全体の前提となるため、ここで改めて強調しておきたい区別が一つあります。パッキングスリップは請求書ではありません。請求書には価格、支払条件、税額が記載され、買掛金管理に使われます。パッキングスリップには倉庫の受入用に出荷データが記載されており、その構造上の特徴は、明細行ごとに数量の列が3つ(注文数・出荷数・欠品数)あることで、請求書の価格・税額の列とは異なります。以降のすべてはこの構造を前提としています。
手動のパッキングスリップ処理が思っている以上にコストがかかる理由
見えるコストは単純な計算で出せます。WERCのベンチマークデータによると、受入作業の労務費は1時間あたり$40.79です。受入担当者が1シフトで60枚のパッキングスリップを1枚3分で処理する場合、データ入力だけで3時間、つまりシフトの37.5%を費やします。1時間あたり$40.79で計算すると、タイピング作業だけで1シフトあたり$122、受入担当者1人あたり年間約$32,000になります。受入ステーションが3つある中規模倉庫では、エラーを1件も数える前に6桁に近づきます。
しかし、見えるコストは小さい方の数字です。隠れたコストは3つの領域に蓄積されます。
3点照合の例外処理。パッキングスリップ上の数量の打ち間違いや注文番号の桁違いは、APチームがPO・パッキングスリップ・仕入先請求書を照合する際に不一致を生みます。Ardent Partnersの2025年APベンチマークによると、平均的な調達チームは請求書照合で22%の例外率に直面し、不一致1件あたり受入・調達・経理をまたいで約30分の調査が必要です。「80」と入力すべきところを「100」と入力したパッキングスリップ、つまり1回のキー入力ミスが、APの保留、仕入先への連絡、実際に到着したものの再確認、そして調整を引き起こします。根本原因は仕入先でもドックのミスでもなく、スリップとシステムの間にある事務作業のステップです。ベストインクラスのチームは例外率を9%に抑えています。その差は、システムに入るデータが文書に印刷されたものなのか、誰かがタイプしたものなのかに大きく依存します。
部分納品の照合。仕入先が100ユニット中80ユニットを出荷した場合、パッキングスリップには3つの数字が表示されます:注文数(100)、出荷数(80)、欠品数(20)です。受入担当者は3つすべてを入力しなければならず、WMSは各PO明細行に対して複数の納品にまたがる受入数量を追跡する必要があります。手動の部分納品処理はエラー率が急上昇する場面です。担当者は1つの数字を入力するのではなく、時間的プレッシャーの下で、次のトラックが待っている中、3つの数量のどれがどのフィールドに入るかを区別しなければならないからです。1回の桁の入れ違い、つまり「出荷数」列に100を、「注文数」列に80を入力すると、受入数量が逆転し、数週間後の次の棚卸しまで発見されない幻の20ユニットの在庫超過が生まれます。
サプライヤーチャージバック。サプライヤーからの差異ベースのチャージバックは、最も過小評価されている運用コストの1つです。サプライヤーが100ユニットを出荷し、受入チームが80ユニットを入力し、100ユニット分のサプライヤー請求書が紛争となった場合、解決プロセスには通常以下が含まれます:(1) サプライヤーが納品証明写真を要求、(2) 受入担当者が署名済みの納品受領書を物理的に探す、(3) APチームが運送会社の配達確認と入力を照合、(4) チャージバックまたは修正が発行される。各チャージバック調査は複数の役割にわたって30〜60分を消費し、そのコストはどの部門の予算にも計上されていません。WERCの調査によると、受入精度はチャージバック発生率と直接相関していますが、それを引き起こすデータ入力エラーのコストを測定している倉庫はほとんどありません。
スリップ単位およびシフト単位のコストの詳細については、パッキングスリップ手動処理コストの内訳をご覧ください。
パッキングスリップ抽出の特有の課題
パッキングスリップ抽出は、ツールを評価するすべての人にとって重要な理由から、請求書抽出よりも困難です。これらの課題を事前に理解することで、選択したツールが実際の日常業務を処理できるか、デモシナリオのみを処理できるかが決まります。
1. 明細項目の密度
GraingerやMSC Industrialなどの産業用サプライヤーからの一般的なパッキングスリップには、2〜3ページにわたって30〜50の明細項目が含まれる場合があります。各明細項目には、独自のSKU、説明、注文数量、出荷数量、欠品数量、およびUOMがあります。明細テーブルは重要なペイロードであり、抽出が必要なデータの80〜90%がそこに存在します。そして、そこがほとんどの抽出ツールが失敗する場所です。
複数ページのテーブルは継続性の問題を引き起こします:50行のテーブルがページ1からページ2にまたがる場合、抽出エンジンはこれが2つの別々のテーブルではなく、継続する単一のテーブルであることを認識する必要があります。列ヘッダーは継続ページで繰り返される場合もあれば、されない場合もあります。一部のサプライヤーはすべてのページにヘッダーを印刷し、他のサプライヤーはページ1のみに印刷します。ページ区切りで列の整列を失う抽出ツールは、その区切り以降、値を静かに間違った列にシフトさせます — サプライヤーの品目コードが説明列に入り、出荷数量が欠品列に入ります — そして出力は完全に見えますが、構造的に破損しています。
2. 部分出荷:数量列が3つあるケース
これが梱包明細書抽出の最大の課題です。請求書には数量列が1つしかありませんが、梱包明細書には「注文数」「出荷数」「バックオーダー数」の3つがあります。すべての明細行に3つの数値が含まれており、抽出では数値を取得するだけでなく、それぞれの意味を正しく保持する必要があります。
部分出荷の例:SKU-00412を100ユニット注文しました。サプライヤーが80ユニットを出荷し、20ユニットをバックオーダーとします。梱包明細書には「注文」(100)、「出荷」(80)、「B/O」(20)という列があります。抽出ツールは各列を正しく識別し、適切なフィールドに出力しなければなりません。3つの列をすべて単一の「数量」フィールドとして扱ったり、部分出荷のレイアウトで「出荷」と「注文」を混同するツールでは、入庫確認に使えるデータは得られません。抽出データだけでは、出荷が完了しているのか部分的なのか判断できないからです。入庫業務では、明細行ごとに3つの数量を並べて確認できることが不可欠であり、それによってドックチームはサプライヤーへのフォローアップが必要かどうかを把握できます。
3. 手書きの倉庫注釈
梱包明細書はクリーンな状態で届くわけではありません。入庫担当者は、確認済みの数量に丸をつけたり、明細行の横に「不足」と手書きで記入したり、署名、タイムスタンプ、破損コード(「1カートン破損のため受領拒否」)、運送会社の備考などを書き加えます。これらの注釈には業務上の重要な意味があり、入庫ドックで何が起こったかを示す主要な記録ですが、印刷データの上に重なり、表のセルや列見出しと重なることもよくあります。
従来のOCRは特にこの点が弱点です。印刷された「100」の上に手書きで「80」と書き込まれると、文字認識が競合します。一方、ビジョンAIモデルは、表の構造、列見出しラベル、周囲の印刷データといった文書コンテキストを活用して、注釈と元のテキストを区別し、両方を抽出します。注釈は回避すべき欠陥ではなく、印刷フィールドとともに抽出すべきデータなのです。この問題の詳細な分析については、倉庫入庫における手書き納品書の抽出に関する記事をご参照ください。
4. 複数ページのパッキングスリップ
出荷に混載カートンが含まれる場合、仕入先が複数ページのパッキングスリップを添付することがあります。1ページ目は出荷サマリーと運送会社情報、2~4ページ目はカートンレベルの明細、5ページ目は返品許可書です。抽出ツールはこの構成を認識し、文書の種類の切り替わりを識別して、末尾に追加されたRMAフォームや運送会社の船荷証券に惑わされずに、関連するパッキングスリップデータのみを抽出する必要があります。
5. 混在フォーマットの一括取込
1回の入荷シフトで、標準的なGraingerのパッキングスリップ(PDF、1ページ、縦向き)、McMaster-Carrの納品書(Web印刷、2ページ)、Fastenalのサーマルラベル(細長いフォーマット、横向き)、地元仕入先の手書き納品書の写真を、すべて同じ30分の間に処理する場合があります。各フォーマットタイプを個別のテンプレートやツールで処理することは、自動化の目的に反します。抽出ソリューションは、単一バッチで混在フォーマットを処理し、すべてに同じ列定義を適用する必要があります。これは、どの仕入先がどのフォーマットを送ってきたかに関係なく、出力を同じWMS入荷テーブルに格納する必要があるためです。
パッキングスリップから抽出する主要項目
パッキングスリップの項目は2つのカテゴリに分類されます。ヘッダー項目は出荷全体に適用され、明細項目はテーブルの各行で繰り返されます。下流の照合ワークフローにとってどの項目が重要かを理解することで、抽出列の設定方法が決まります。
| ヘッダー項目(スリップごとに1つ) | 抽出難易度 | 重要性 |
|---|---|---|
| パッキングスリップ/納品書番号 | 低 | 追跡、仕入先検索、監査証跡の主キー |
| 日付(出荷日/発行日) | 低 | 未処理入庫の滞留レポート用。入庫から棚入れまでの計時開始点を決定 |
| 注文書/受注番号 | 中 | 出荷をPOにリンクして3ウェイマッチングを実行。仕入先間でラベル形式が不統一 |
| 出荷元住所(仕入先/倉庫) | 中 | 複数拠点の仕入先は異なる施設から出荷する場合あり。返品ルーティングに必要 |
| 出荷先住所(貴社の入荷拠点) | 低 | 配送ルートを確認。誤った拠点に出荷された場合にクロスドックを警告 |
| 運送会社名 | 低 | 入荷予約の照合、入荷運賃の配賦 |
| 追跡番号/PRO番号 | 中 | 運送会社検索、配送証明の取得。フォーマットが多様 |
| カートン数/パレット数 | 中 | 入荷前チェック:ドック上のカートン数はスリップと一致するか? |
| 総重量 | 低 | 運賃監査、運送会社請求の検証 |
| 受領者署名 | 高 | 配送証明。手書き文字とコンテキスト抽出が必要 |
| 明細項目フィールド(スリップごとに複数) | 抽出難易度 | 重要な理由 |
|---|---|---|
| 品目コード / SKU / 品番 | 中 | サプライヤーと社内のSKUは異なることが多く、照合マッピングが必要 |
| 品目説明 | 高 | 自由記述・複数行・仕様やシリアル番号が埋め込まれる場合もあり、情報量は多いが形式が不統一 |
| 注文数量 | 中 | PO明細と一致させる必要があり、部分納品の比較基準となる |
| 出荷数量 | 中 | 実際の受領数量であり、受入検証と3点照合の核となる項目 |
| 欠品数量 | 高 | 不完全な出荷を特定し、サプライヤーへのフォローアップ業務につながる |
| 単位(UOM) | 高 | 「EA」「PCS」「CTN」「BOX」など標準がなく、UOMマッピングのためにそのまま保持する必要がある |
注文数量・出荷数量・欠品数量の3つの数量列こそが、パッキングスリップ抽出を他の文書タイプと区別する要素です。これらを1つのフィールドにまとめてしまう抽出ツールや、どれがどれかを保持せずに取得するツールは、本来の役割を果たせていません。ツールを導入する前に必ず確認してください。部分納品の明細が1行以上含まれるパッキングスリップをアップロードし、3つの数量がすべて正しい出力列に表示されるかどうかを確認します。
従来型 vs AI搭載のパッキングスリップ抽出
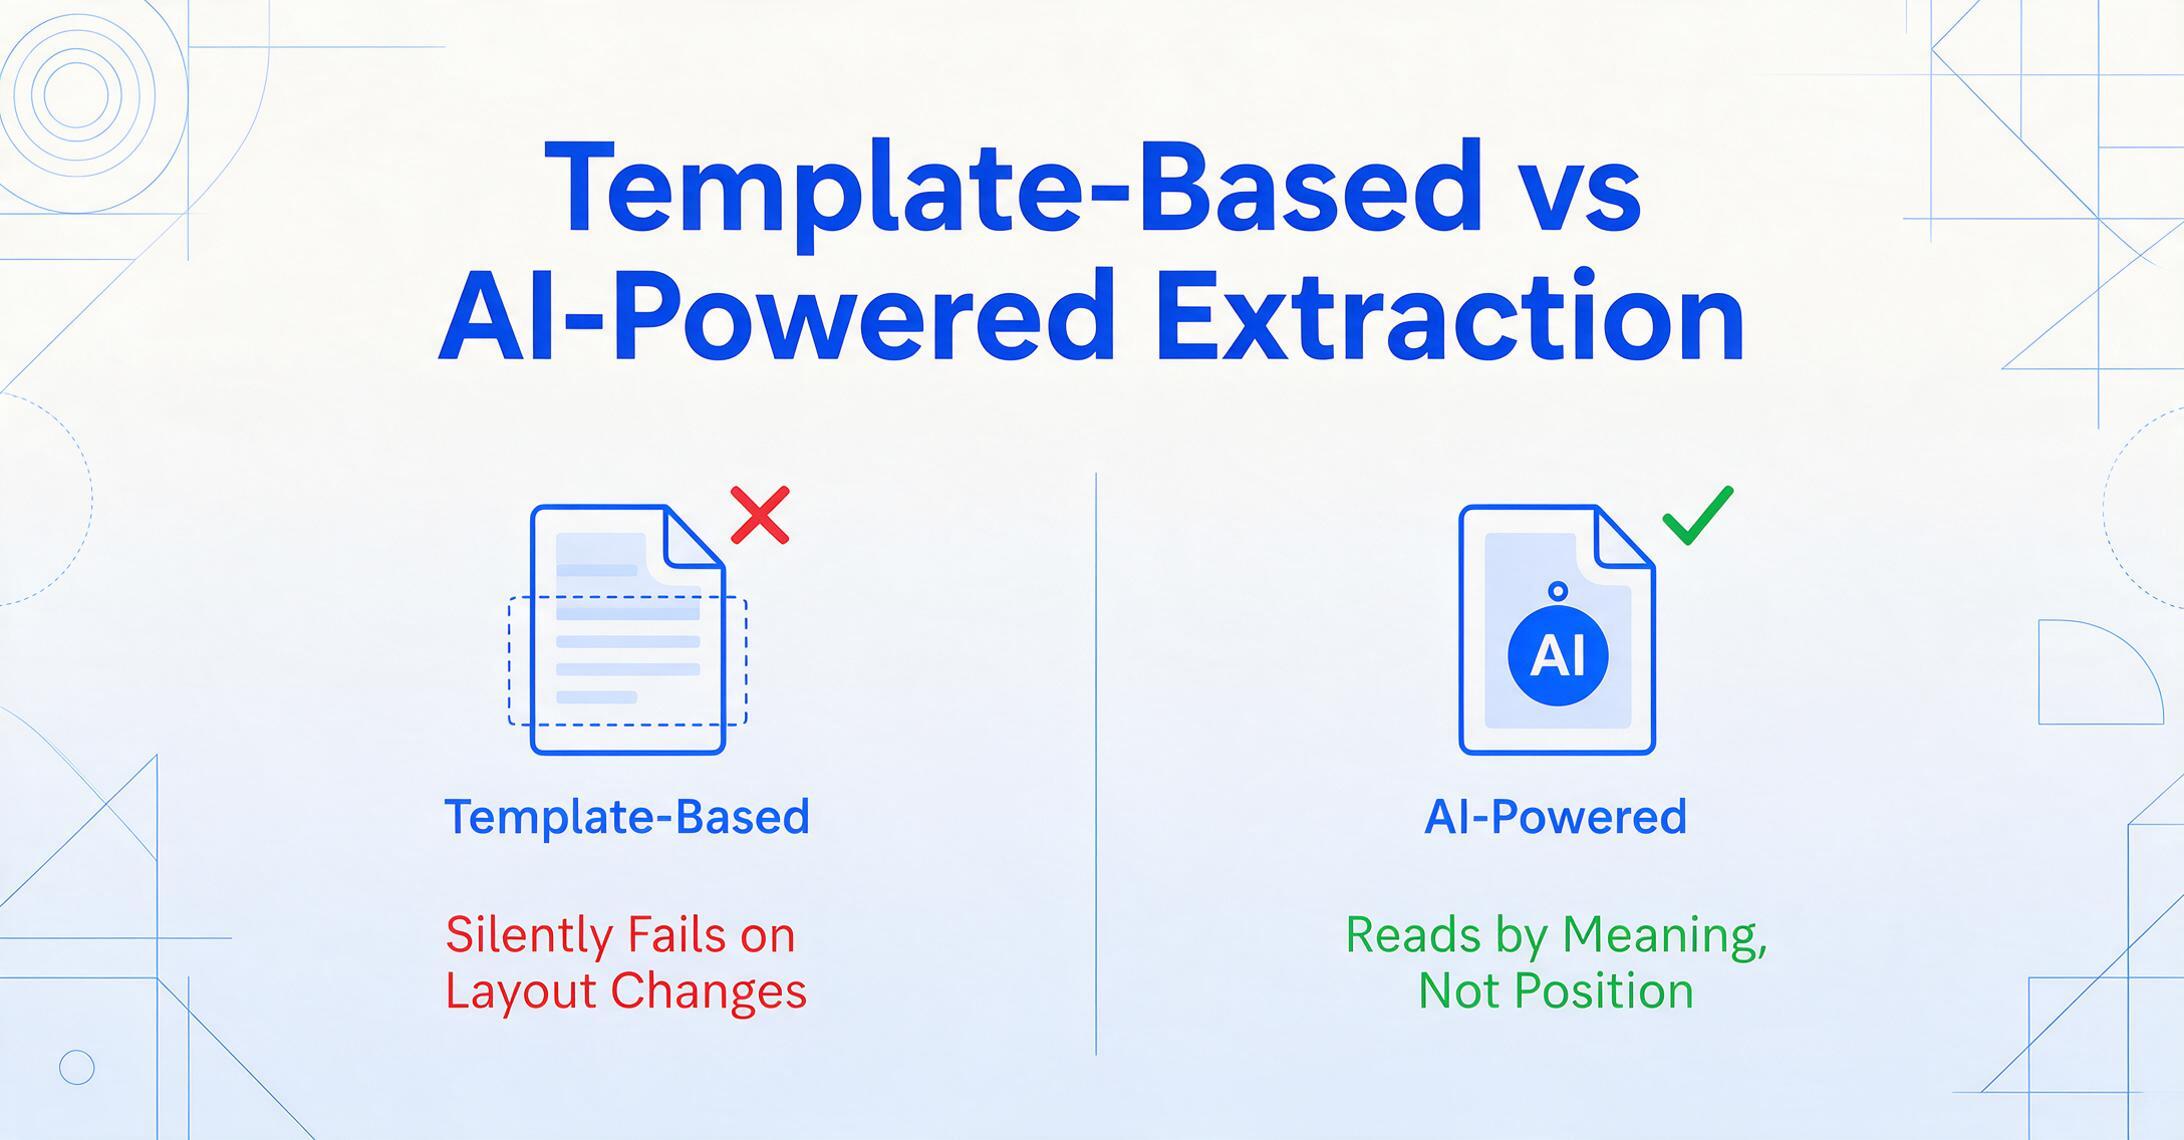
すべての抽出技術が上記の課題に同等に対応できるわけではありません。根本的な違いは、テンプレート型(位置指定)抽出と意味理解型(AI搭載)抽出の間にあります。この違いを理解することが、最も重要な評価ステップです。
テンプレート型抽出は、サプライヤーごとの文書レイアウトに解析領域を設定する必要があります。サプライヤーAのパッキングスリップでPO参照番号が表示される場所に矩形を描き、明細テーブルのヘッダーにもう1つ矩形を描き、列幅を定義します。サプライヤーAがスリップの形式を変更した場合(ERPアップグレード後のレイアウト変更など)、テンプレートは静かに失敗します。値が誤った列に入ってしまいます。受入担当者が数量が説明フィールドに表示されている、またはまったく表示されていないことに気づいたとき、問題が発覚します。
テンプレート方式は、明細行テーブルで最も顕著に破綻します。テンプレートは、テーブルが固定行から始まり、列幅が固定であることを前提としています。しかし、サプライヤーのパッキングスリップは、テーブルの前にあるヘッダー行の数、列ヘッダーが繰り返されるかどうか、行が複数のテキスト行にまたがるかどうか、カートンレベルのグループがテーブル内にネストされているかどうかが異なります。あるサプライヤーの30行テーブルで機能するテンプレートは、結合された説明セルを持つ別のサプライヤーの50行テーブルでは頻繁に位置がずれます。Levvel Researchのデータ入力コストに関する調査によると、文書処理の不一致の30%以上は一貫性のない処理に起因しており、これはまさにテンプレートベースの抽出がもたらすものです。つまり、一貫性のない処理を一貫して行い、正しく見える誤った結果を生み出すのです。
セマンティック抽出 — 視覚言語モデルを使用したAI駆動の抽出 — は、位置ではなく意味によって機能します。「パッキングスリップ番号」「PO参照」「SKU」「注文数量」「出荷数量」「欠品数量」「UOM」など、必要な列を定義します。AIは文書全体(ヘッダーセクション、明細行テーブル、フッター注記)を読み取り、ページ上のどこにあるかに関係なく、各値が意味的に何を表すかを理解して特定します。あるサプライヤーのスリップでは「Ord」、別のサプライヤーでは「Qty」、3つ目のサプライヤーでは「Ordered」とラベル付けされたフィールドも、AIが意味的役割を理解するため、同じものとして認識されます。これがカスタム列抽出です。出力を一度定義すれば、AIは座標ではなく意味によって一致するデータを特定します。
運用上の違いはテンプレートのメンテナンスです。テンプレートでは、新しいサプライヤーごと、または既存サプライヤーのフォーマット変更ごとに、テンプレート作業が必要です。50以上のサプライヤーから仕入れ、それぞれが独自のフォーマットバリエーションを持つ倉庫では、テンプレートのメンテナンスは継続的な運用コストとなり、自動化による人件費削減を相殺します。セマンティック抽出では、抽出ロジックがフォーマット非依存であるため、同じ列定義がすべてのサプライヤーで機能します。これまで処理したことのないサプライヤーのパッキングスリップ(AIが見たことのないレイアウト)でも、AIはパッキングスリップの座標ではなくパッキングスリップの意味を読むため、最初のアップロードで正しく抽出されます。
サプライヤーのパッキングスリップ形式がなぜ分岐し、なぜ今後も分岐し続けるのかについては、パッキングスリップ形式の不整合に関する記事をご覧ください。
ファイルは安全に処理され、保存されません。
バッチ処理:POデータとの照合
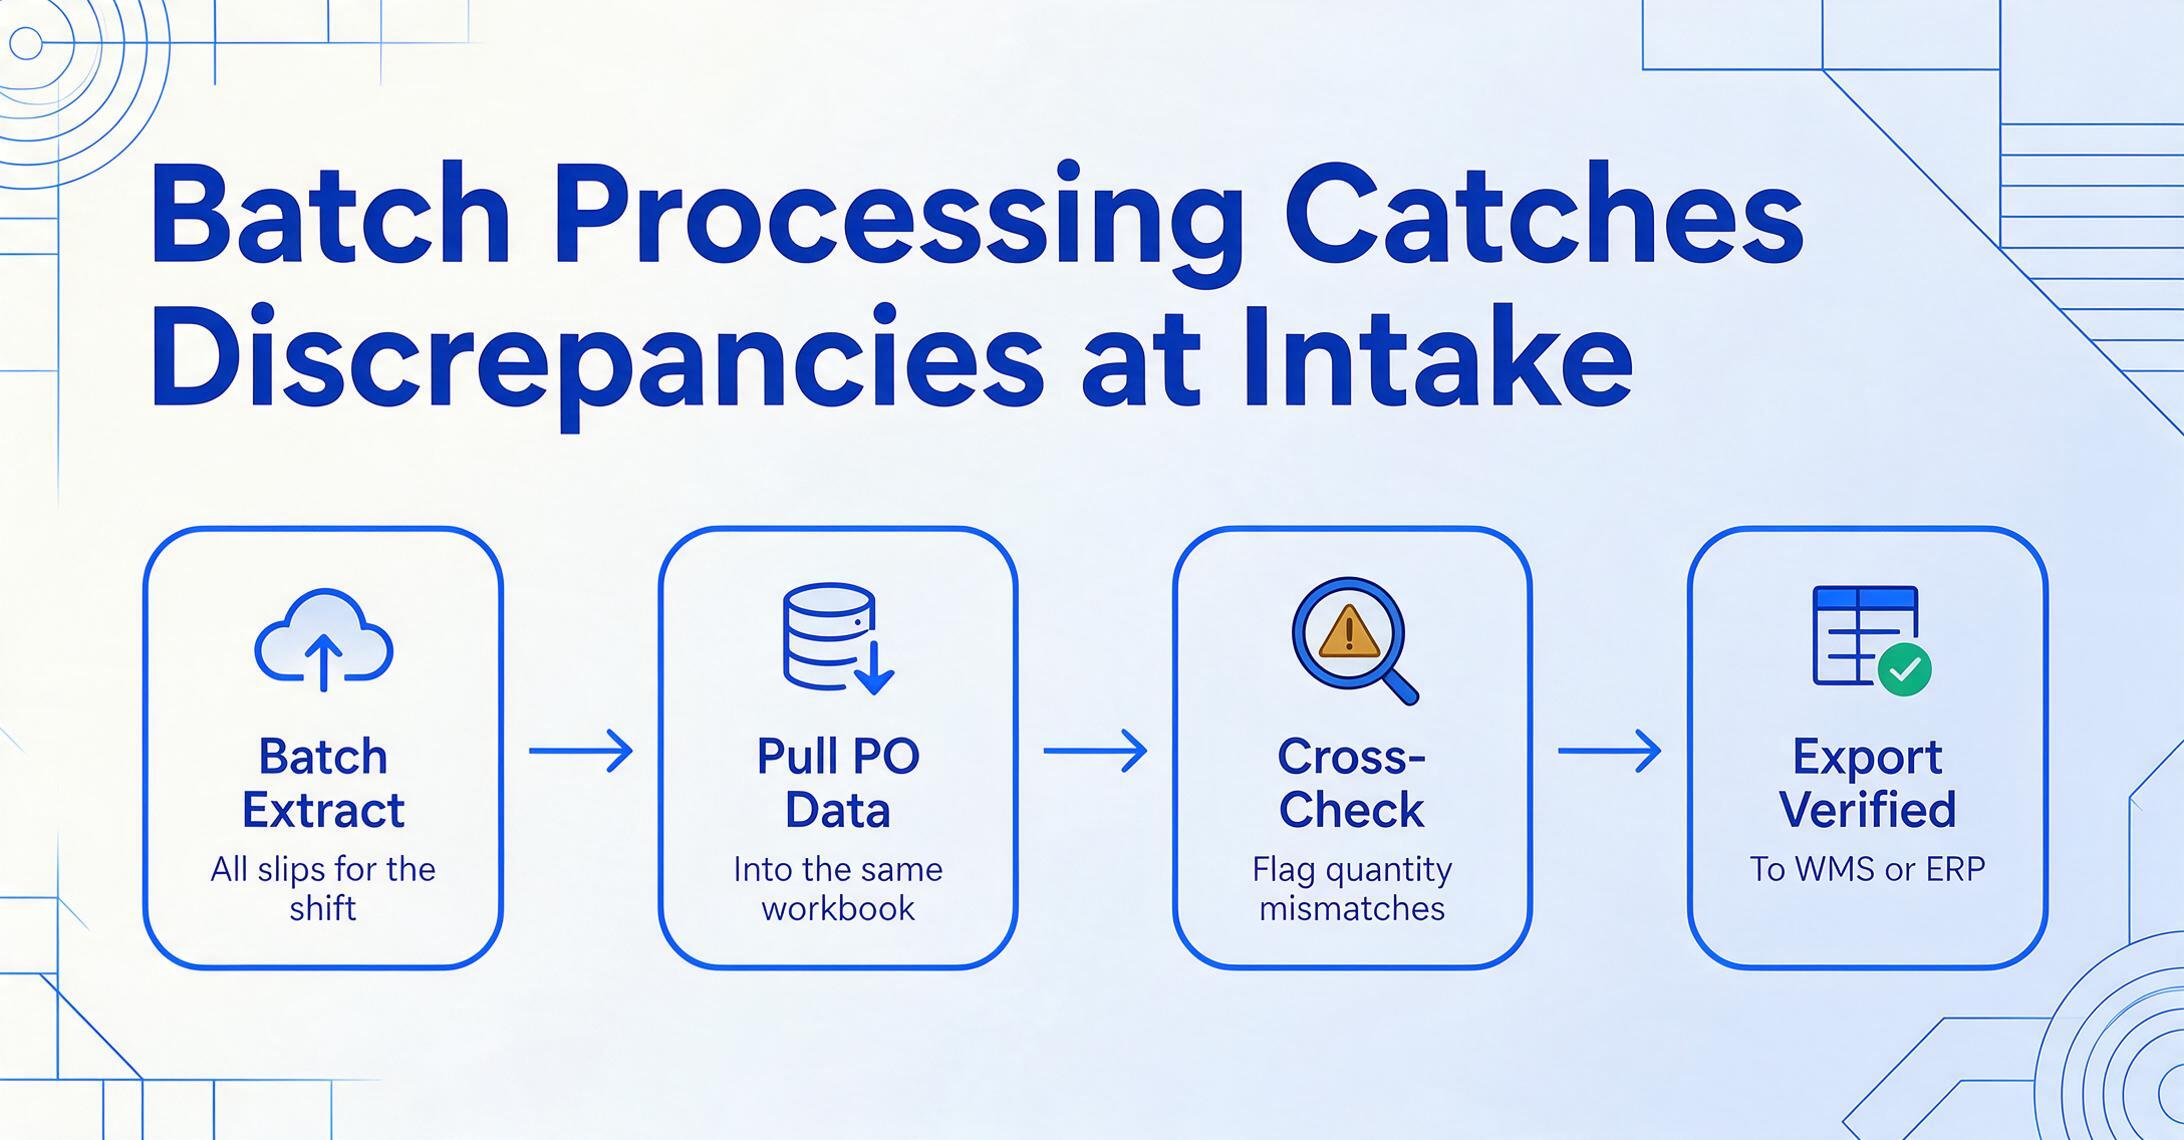
単票抽出は文書ごとのデータ入力問題を解決します。バッチ処理は処理量の課題を解決し、さらに単票処理では実現できない機能を解放します。それは、パッキングスリップの数量をPOデータと自動照合する機能です。
バッチワークフローでは、異なるサプライヤーからのパッキングスリップ20枚、30枚、または50枚を1つのバッチでアップロードします。PDFもあれば、スマホの写真や複数ページのものもあります。抽出エンジンは同じ列定義を使用してすべてを処理し、結果を1つのスプレッドシートに統合します。各パッキングスリップはヘッダーテーブルの1行になり、各ラインアイテムはヘッダーフィールドが繰り返される明細行になります。ステップバイステップのワークフローについては、パッキングスリップのバッチ抽出をExcelに行うガイドをご覧ください。
しかし、バッチ処理はPOデータとの照合ステップと組み合わせることで真価を発揮します。受入時に差異を検出する受入業務と、棚卸しの数週間後に差異を発見する受入業務とを分けるのは、次のワークフローです。
シフト分のパッキングスリップを一括抽出
シフト中に受け取ったすべてのパッキングスリップを、仕入先・形式・ページ数を問わずアップロードします。出力は、各行項目が特定された単一の構造化テーブルです。PO参照、SKU、注文数量、出荷数量、欠品数量が含まれます。
POデータを同じワークブックに取り込む
SAP、NetSuite、または調達スプレッドシートからPOデータをエクスポートし、抽出したパッキングスリップデータと一緒に読み込みます。各POには、パッキングスリップの数量が照合されるべき注文数量が含まれています。POデータの抽出方法の完全な手順については、購買注文データ抽出の完全ガイドをご覧ください。
計算列を使用して不一致を自動的にフラグ付け
PO注文数量 − パッキングスリップ出荷数量を計算する検証列を定義します。結果がゼロ以外の行項目はすべてレビュー対象としてフラグ付けされます。これにより、受入ワークフローが「すべての数値を入力して正しいことを願う」から「例外のみをレビューする」に変わり、検証作業量が全行項目の100%から、不一致が発生する5〜15%に削減されます。
クリーンなデータをエクスポートしてWMSにインポート
レビュー後、不一致がフラグ付けされ解決された検証済みパッキングスリップデータは、WMSインポートの準備が整います。CSVまたはXLSXとしてエクスポートし、Manhattan Associates、Blue Yonder、SAP WM、NetSuite WMS、または構造化された受入データを受け付ける任意のシステムに読み込みます。クリーンなデータは、3点照合に使用される受領記録になります。
このワークフローは、抽出をタイピングの代替から不一致検出エンジンへと変えます。鍵となるのは計算列です。これは文書からデータを抽出するのではなく、抽出されたフィールドから新しい値を計算する列です。数量照合(注文数量 − 出荷数量)、UOM整合性チェック、または抽出されたカートン合計を運送業者の記録と比較することによるカートン数検証のための計算列を定義できます。文書抽出における計算列の仕組みの詳細については、計算列を使用したAI文書抽出の概要をご覧ください。
エクスポートとWMS統合
抽出結果はゴールではありません。データはシステム(WMS、ERP、または受入スプレッドシート)に入力され、在庫更新、3点照合、仕入先調整に活用されます。選択するエクスポート方法によって、抽出からシステム入力までの手動作業の量が決まります。
| エクスポート形式 | 最適な用途 | 考慮事項 |
|---|---|---|
| XLSX(Excel) | 手動レビュー、POデータとの照合、部分納品の監査、中規模WMSのインポートウィザード | 日付と数値は形式変換後も保持される必要があります。先頭ゼロ付きのPO番号はExcelで切り捨てられる可能性があるため、この経路に依存する前に形式の保持を確認してください。 |
| CSV | SAP WM/EWM、Oracle WMS、NetSuite WMS、Manhattan Associates(WMOS)、Blue Yonder、HighJump/Körberのインポート | カンマを含む複数行の品目説明は、適切にエスケープされないとCSVの行境界を壊します。抽出出力がRFC 4180準拠のクォーティングを使用していることを確認してください。 |
| JSON | カスタムWMS/ERP統合、自動受入パイプライン、APIベースのワークフロー | ネストされた明細構造(ヘッダー→カートン→品目)は出荷階層をきれいに保持しますが、手動レビューは難しくなります。受信側が人ではなく機械の場合に最適です。 |
| Google Sheets | Google Workspaceのチーム、共同受入レビュー、共有受入ダッシュボード | 抽出ツールがSheetsへの直接出力に対応していれば、エクスポート・インポートのサイクルを完全に排除できます。パッキングスリップ抽出用のGoogle Sheetsアドオンは、中間ファイルを介さずに受入データを追跡シートに直接書き込めます。 |
形式変換は、きれいな抽出結果が汚れたファイルに変わるポイントです。日付は十数種類の表記で届き、品目コードはスプレッドシートが数値として扱うと先頭ゼロを失い、カンマを含む複数行の説明は行境界を壊します。後処理ステップがこれをWMSに到達させないようにします。ツールはエクスポート前に日付と金額を単一の表記に正規化し、識別子の形式を標準化するため、スリップに記載された値がそのまま列に入ります。このステップがエクスポート前に実行されれば、ファイルは手動クリーンアップではなくWMSインポートウィザードにそのまま使えます。
ほとんどの倉庫チームにとって、実用的なワークフローは次のとおりです。バッチ抽出→Excel/Sheetsでレビュー→CSVをWMSにインポート。この経路は主要なWMSプラットフォームすべてで機能します。Manhattan Associates(WMOS)はCSVの受領インポートを受け付け、SAP WM/EWMはLS24経由のバッチ入力を使用し、Blue Yonder(旧JDA)はフラットファイルの受入データを取り込み、HighJump/Körberはデータインポートフレームワークを通じてCSVをサポートし、Oracle WMS CloudとNetSuite WMSはどちらも受入トランザクション用のCSVインポートウィザードを備えています。
全形式に共通する重要な要件は、抽出出力が明細と出荷の関係を保持することです。各明細には親パッキングスリップ番号とPO参照が含まれている必要があります。これにより、受入システムは受領数量を正しいPO明細に照合できます。この階層を(レビュー段階で一時的にでも)失うフラットな出力は、関係を手動で再構築する作業を強いることになり、抽出による時間削減効果を無効にします。
パッキングスリップ抽出ツールの選び方
以下の基準は、マーケティング上の主張を排除し、日常の倉庫受入業務においてツールを実際に区別する点に焦点を当てています。機能のチェックリストではなく、これらの基準に照らしてテストしてください。
最も良いパッキングスリップではなく、最も悪いものでテストする
どのツールでも、大手サプライヤーからのきれいな1ページのパッキングスリップは処理できます。ページをまたぐ30行以上の明細がある2ページのスリップ、3つの数量列がある部分納品の明細行、表のセルに走り書きされた手書きの注釈をテストしてみてください。それらを処理できれば、他のすべても処理できるはずです。ベンダーが躊躇したり、サンプル文書のみを提供する場合は、それ自体が重要なシグナルです。
部分納品の列保持を確認する
少なくとも1つの明細行で「注文数量」「出荷数量」「欠品数量」に異なる値が表示されているパッキングスリップをアップロードしてください。出力を確認します。3つの数値すべてが、それぞれ別の列に正しくラベル付けされて存在していますか? これらを単一の「数量」フィールドにまとめるツールや、どの数値がどの列に属するかを混同するツールは、部分納品の受入をサポートできません。これは最も重要なテストです。
テンプレート不要が基本条件。フォーマット耐性をテストする
「テンプレート不要」と主張するベンダーは、これまで見たことのないフォーマットのサプライヤーからのパッキングスリップを、列名を指示としてのみ使用して処理できるはずです。究極のテストは、同じパッキングスリップを別のサプライヤーのレイアウトでアップロードすることです。同じデータ、異なる位置です。抽出が失敗するか精度が低下する場合、そのツールはマーケティング上の表現に関係なくテンプレート依存です。
バッチ出力は出荷から明細行への階層を保持する必要がある
30枚のパッキングスリップをバッチ抽出する場合、出力はどの明細行がどの出荷に属するかを識別できる必要があります。そのために、すべての明細行にパッキングスリップ番号とPO参照を含める必要があります。この関係を失うフラットな出力では、手動で再構築する必要があり、抽出によって節約できるはずの時間が元に戻ってしまいます。
エクスポートはWMSへの移行に耐えられるものでなければならない
ツールのCSV出力を実際のWMSにインポートしてみてください。デモ環境ではなく、実際のデータ処理ルールを持つ本番システムです。日付の形式が維持されているか、数量の小数点以下が保持されているか、先頭にゼロが付く品目コードが切り捨てられていないか、複数行の説明がCSVの行境界を壊していないかを確認してください。この10分間のテストは、どの機能比較よりも多くの統合問題を検出します。
パッキングスリップを含む物流文書に対する抽出ツールの直接比較については、物流文書抽出ツールのベストレビューをご覧ください。
よくある質問
パッキングスリップ抽出と納品書抽出の違いは何ですか?
実際には、この2つの用語は同じ文書タイプを指し、タイミングの違いだけです。パッキングスリップは出荷時点で梱包された内容を記録したもので、商品と一緒に移動し、カートンの中身を記載します。納品書(または納品証明書)は、到着先で受け取った内容を確認するもので、通常、受領者の署名とタイムスタンプが記載されています。多くのサプライヤーはこの2つの用語を同じ意味で使用しています。倉庫チームは同じサプライヤーから同じ出荷に対して両方を受け取ることがあり、優れた抽出ツールは両者を同じように処理します。フィールド構造(数量の3列を持つ明細行)も同じです。
パッキングスリップ抽出はEDI 856 Advanced Ship Noticesに対応できますか?
EDI 856は電子データ交換の標準規格であり、抽出ツールが直接処理する文書形式ではありません。サプライヤーがEDI 856を送信する場合、データは構造化されたEDI形式で届くため、WMSやERPは抽出なしで取り込むことができます。パッキングスリップ抽出は、EDIを送信しない大多数のサプライヤー、またはEDI 856を送信してもPDFのパッキングスリップを添付するサプライヤーのギャップを埋めるものです。多くの運用では、大規模サプライヤーにはEDIを、それ以外には抽出を使用し、これらを代替手段ではなく補完的な取り込み方法として扱っています。
パッキングスリップ抽出で期待できる精度はどのくらいですか?
クリーンなデジタルPDFパッキングスリップ(サプライヤー印刷、手書きなし、コントラスト良好)の場合、印刷されたテーブルデータは最大99%の精度で抽出されます。精度が低下するのは明細行です。行が増えるごとに、列のずれ、説明文のオーバーフロー、単位の誤ったフィールドへの配置などが発生する可能性が高まるため、同じサプライヤーの1ページのクリーンなスリップよりも、密集した複数ページのスリップのスコアは低くなります。スキャンしたスリップや、影や歪みのあるスマホ写真はさらに精度が低下し、手書きが大半を占めるスリップは最も困難なケースです。手動入力と比較すると、査読付きのデータ入力エラーに関する研究では、フィールドレベルのエラー率は入力フィールドあたり約1〜3%であり、40フィールドのパッキングスリップでは、少なくとも1つのキーストロークエラーが発生する確率は33〜70%です。抽出の利点はエラーがなくなることではありません。エラーが検証ステップで確認のために表面化し、棚卸しや照合例外で明らかになるまでWMSに埋もれないことです。
パッキングスリップ抽出はスマホの写真画質の画像でも機能しますか?
はい、画質に関する注意点はあります。照明が良く、ピントの合ったパッキングスリップのスマホ写真は85〜95%の精度で抽出でき、スキャンしたPDFの品質に近くなります。失敗の原因は次のとおりです。文書全体に影ができる(受入ドックで撮影する場合に一般的)、ひどい傾き(スマホを平らにせず角度をつけて持つ)、列ヘッダーが切れる部分的なトリミングです。スマホ写真を含む受入ワークフローでは、抽出前に簡単な画質チェックを組み込み、ぼやけた写真や影の強い写真は拒否して再撮影する必要があります。最新のビジョンAIは、コンテキストを使用してギャップを補完するため、従来のOCRよりも中程度の画質低下にうまく対応できますが、画像に写っていないデータを再構築することはできません。
海外サプライヤーからの英語以外のフィールドを含むパッキングスリップは、抽出はどのように処理しますか?
多言語ドキュメントでトレーニングされたVision AIモデルは、ラベルがどの言語で書かれていてもパッキングスリップのフィールドを抽出できます。フランス語(「Quantité expédiée」)、ドイツ語(「Versandte Menge」)、日本語(出荷数)で書かれた数量の列は、AIが辞書の照合ではなく列の意味的な役割を読み取るため、同じフィールドとして認識されます。出力されるフィールド名は(定義したとおり)英語のままですが、抽出された値はサプライヤーが使用した言語のドキュメントから取得されます。これは海外サプライヤーから仕入れている倉庫や、多言語の納品書類を扱う場合に関連します。フランス語の納品書ドキュメントのバッチ処理に関するウォークスルーでは、数十のサプライヤー形式を一度に処理する様子をご紹介しています。
パッキングスリップ抽出と受領(GR)入力の違いは何ですか?
パッキングスリップ抽出はデータ取得のステップです。印刷されたスリップをデジタルフィールドに変換します。受領入力は在庫トランザクションです。品目が物理的に在庫として利用可能になったことを記録します。これらは同じワークフロー内の連続したステップです。抽出により、受領入力に取り込む構造化データが生成されます。手動プロセスでは、受入担当者がパッキングスリップのデータを受領画面に直接入力します。抽出を使用する場合、データはスリップから自動的に取得され、受領トランザクションが転記される前にレビューされます。抽出ステップで入力作業が不要になり、受領トランザクションは管理ポイントとして残ります。
1つの出荷に複数のPOが含まれるパッキングスリップはどのように処理しますか?
一部のサプライヤーは、複数のPOの品目を1つの出荷とパッキングスリップにまとめます。その場合、明細テーブルには複数のPO参照が含まれます。各明細は異なるPOを参照する場合があります。抽出ツールは、出荷全体に単一のPOが適用されると想定せず、明細ごとにPO参照を取得する必要があります。これはセマンティック抽出ツールの標準的な動作です。各行を個別に読み取るためです。抽出後、出力は自然に分割されます。PO-1001の明細は1つの受領に、PO-1002の明細は別の受領に送られます。明細ごとのPO参照はこのシナリオの重要なフィールドです。ツールがヘッダーレベルだけでなく明細レベルでこれを取得することを確認してください。
パッキングスリップ抽出は既存のWMSと直接統合できますか?
ほとんどの抽出ツールは、事前構築されたWMS統合を提供していません。標準的なワークフローは、CSVに抽出 → CSVをWMSにインポートです。この方法は、すべての主要なWMSで機能します。すべてのWMSに受領トランザクション用のデータインポート機能があるためです。Manhattan Associates、SAP WM/EWM、Blue Yonder、HighJump/Körber、Oracle WMS Cloud、NetSuite WMSはすべて、構造化されたCSVの受領データを受け入れます。一部のツールはカスタム統合用のAPIベースの直接転記を提供していますが、CSV方式は普遍的でIT設定が不要です。重要な要件は、抽出ツールのCSV出力がWMSが受領データに期待する構造になっていることです。つまり、ヘッダーがWMSのインポートフィールドマッピングと一致している必要があります。
どの程度の納品書量があれば、抽出ツールへの投資が正当化されますか?
目安として、入荷業務で1日あたり30枚以上の納品書を5社以上の異なる仕入先から処理している場合、抽出による時間節約効果が顕著になります。それ以下の量では、バッチごとの5分間の確認作業が、入力の手間削減効果を相殺する可能性があります。しかし、本当の判断基準は単なる量ではなく、仕入先ごとのフォーマットの多様性です。20社からそれぞれ異なるフォーマットで30枚の納品書が届く場合は、同じフォーマットの2社から100枚届く場合よりも抽出の価値が高まります。フォーマットが異なるごとに、発注書番号を探す位置が変わり、注文数と出荷数の表記が異なるレイアウトを読み分けるなど、認知的な負荷が増大します。抽出ツールはこの負荷を完全に排除します。仕入先のフォーマット数に関わらず、一度カラムを定義するだけで済みます。
抽出ツールがフィールドを誤認識した場合、再処理せずに修正できますか?
はい、可能です。抽出結果(XLSXまたはCSV)は編集可能なファイルです。フィールドが誤認識された場合は、WMSにインポートする前にスプレッドシート上で直接修正してください。抽出の価値は100%の完全な精度ではありません。どの抽出ツールもそれを達成できません。その価値は、1シフトあたり100フィールドの入力を必要とするプロセスを、5~10フィールドの確認で済むプロセスに変えることにあります。確認工程は抽出の失敗ではなく、WMSに入力されるデータの正確性を保証する品質管理ゲートです。重要なのは「誤認識があるか」ではなく、「すべてのフィールドを手入力する必要から、数フィールドの確認だけで済むようになるか」です。
受入からデータへ:最終的な結論
パッキングスリップ抽出はWMSを置き換えるものではありません。Manhattan、SAP WM、Blue Yonder、HighJumpは在庫と倉庫管理の主要業務を担っています。抽出が行うのは、出荷データが届く場所(受入ドックのパレットに貼られた紙のスリップ)と、それが到達すべき場所(検証の準備が整った受入システム内の構造化レコード)との間のギャップを埋めることです。そのギャップは現在、フィールドあたり1〜3%のエラー率を持つ人間のキー入力によって埋められており、シフトごとに数百のフィールドにわたって増幅されます。その結果は、在庫差異からAP保留、サプライヤー紛争にまで波及します。
使いやすい抽出導入と使いにくい導入を分ける3つのポイント:(1) ツールが3つの異なる数量列を持つ部分納品を処理できること(1列だけではないこと)、(2) サプライヤーごとのテンプレート作業なしで、混合サプライヤー形式を単一バッチで処理できること、(3) エクスポート出力が形式破損なしで実際のWMSにクリーンにインポートできること。その他すべて — 精度パーセンテージ、AIの主張、機能リスト — は、これら3つの運用上の現実に比べれば二次的です。
受入業務向けの抽出を評価している場合は、最も難しいパッキングスリップでテストを始めてください。ページをまたぐ40行の明細を含む複数ページの産業用サプライヤースリップ、注文数・出荷数・欠品数を示す部分納品行、欄外の手書き注記があるものを選びましょう。ツールが最悪のケースを処理できれば、平均的なケースも処理できます。自社の文書でパッキングスリップ抽出がどのように機能するかを確認する準備ができたら、サンプルのパッキングスリップをアップロードして、どのような構造化データが返ってくるかを確認してください。すでにGoogle Sheetsを使用している場合は、パッキングスリップデータ用のSheetsワークフローをお試しください。