Tesseract vs EasyOCR 2026:
Welche Open-Source-OCR passt zu Ihrem Projekt?
Dieser Vergleich ist aus der Perspektive eines Entwicklers oder Dateningenieurs geschrieben, der zwischen zwei kostenlosen, selbst gehosteten OCR-Engines für eine Dokumentenverarbeitungspipeline wählt. Tesseract — Googles 40 Jahre alte Open-Source-Engine — ist leichtgewichtig, CPU-schnell und zeichnet sich durch sauberen gedruckten Text aus. EasyOCR — eine PyTorch-native Bibliothek von Jaided AI — nutzt Deep Learning für Erkennung und Texterkennung in einem Durchgang, tauscht Geschwindigkeit gegen Genauigkeit bei schwierigen Dokumenten und bietet GPU-Beschleunigung, wenn Sie sie brauchen. Die Frage ist nicht, welche "besser" ist. Es geht darum, welche Kompromisse zu Ihren Dokumenten, Ihrer Hardware und Ihrer Toleranz für Nachbearbeitung passen.
Wichtigste Erkenntnisse
- Zwei kostenlose OCR-Engines, beide Apache 2.0, beide mit ~90%+ Genauigkeit — jeder Vergleichsartikel lässt Tesseract und EasyOCR wie dasselbe Tool mit verschiedenen Namen aussehen.
- Die Zahl, die sie tatsächlich unterscheidet, ist nicht die Genauigkeit, sondern die Fehlerbehebbarkeit: Tesseracts Fehler sind still und dauerhaft, EasyOCRs Fehler hinterlassen Signaturen, die Sie erkennen und mit einem Regex bereinigen können.
- Vergessen Sie Genauigkeitsrankings — wählen Sie die Engine, deren Fehler Ihre Nachbearbeitungspipeline überstehen kann, denn Fehler werden kommen und die einzige Frage ist, ob Sie sie bemerken.
Kurzvergleich: Tesseract vs. EasyOCR
Die folgende Tabelle fasst die wichtigsten Unterschiede in den für reale Projekte relevanten Bereichen zusammen. Die Zahlen stammen aus unabhängigen Benchmarks von GigaGPU und CodeSOTA mit standardisierten Dokumententestsätzen. Ihre Ergebnisse können je nach Bildqualität, Vorverarbeitung und Dokumenttyp abweichen.
| Kriterium | Tesseract 5.5 | EasyOCR |
|---|---|---|
| Kerntechnologie | LSTM-Neuronales Netz + klassischer Mustervergleich | PyTorch-basiertes Deep Learning (CRAFT-Detektor + CRNN-Erkenner) |
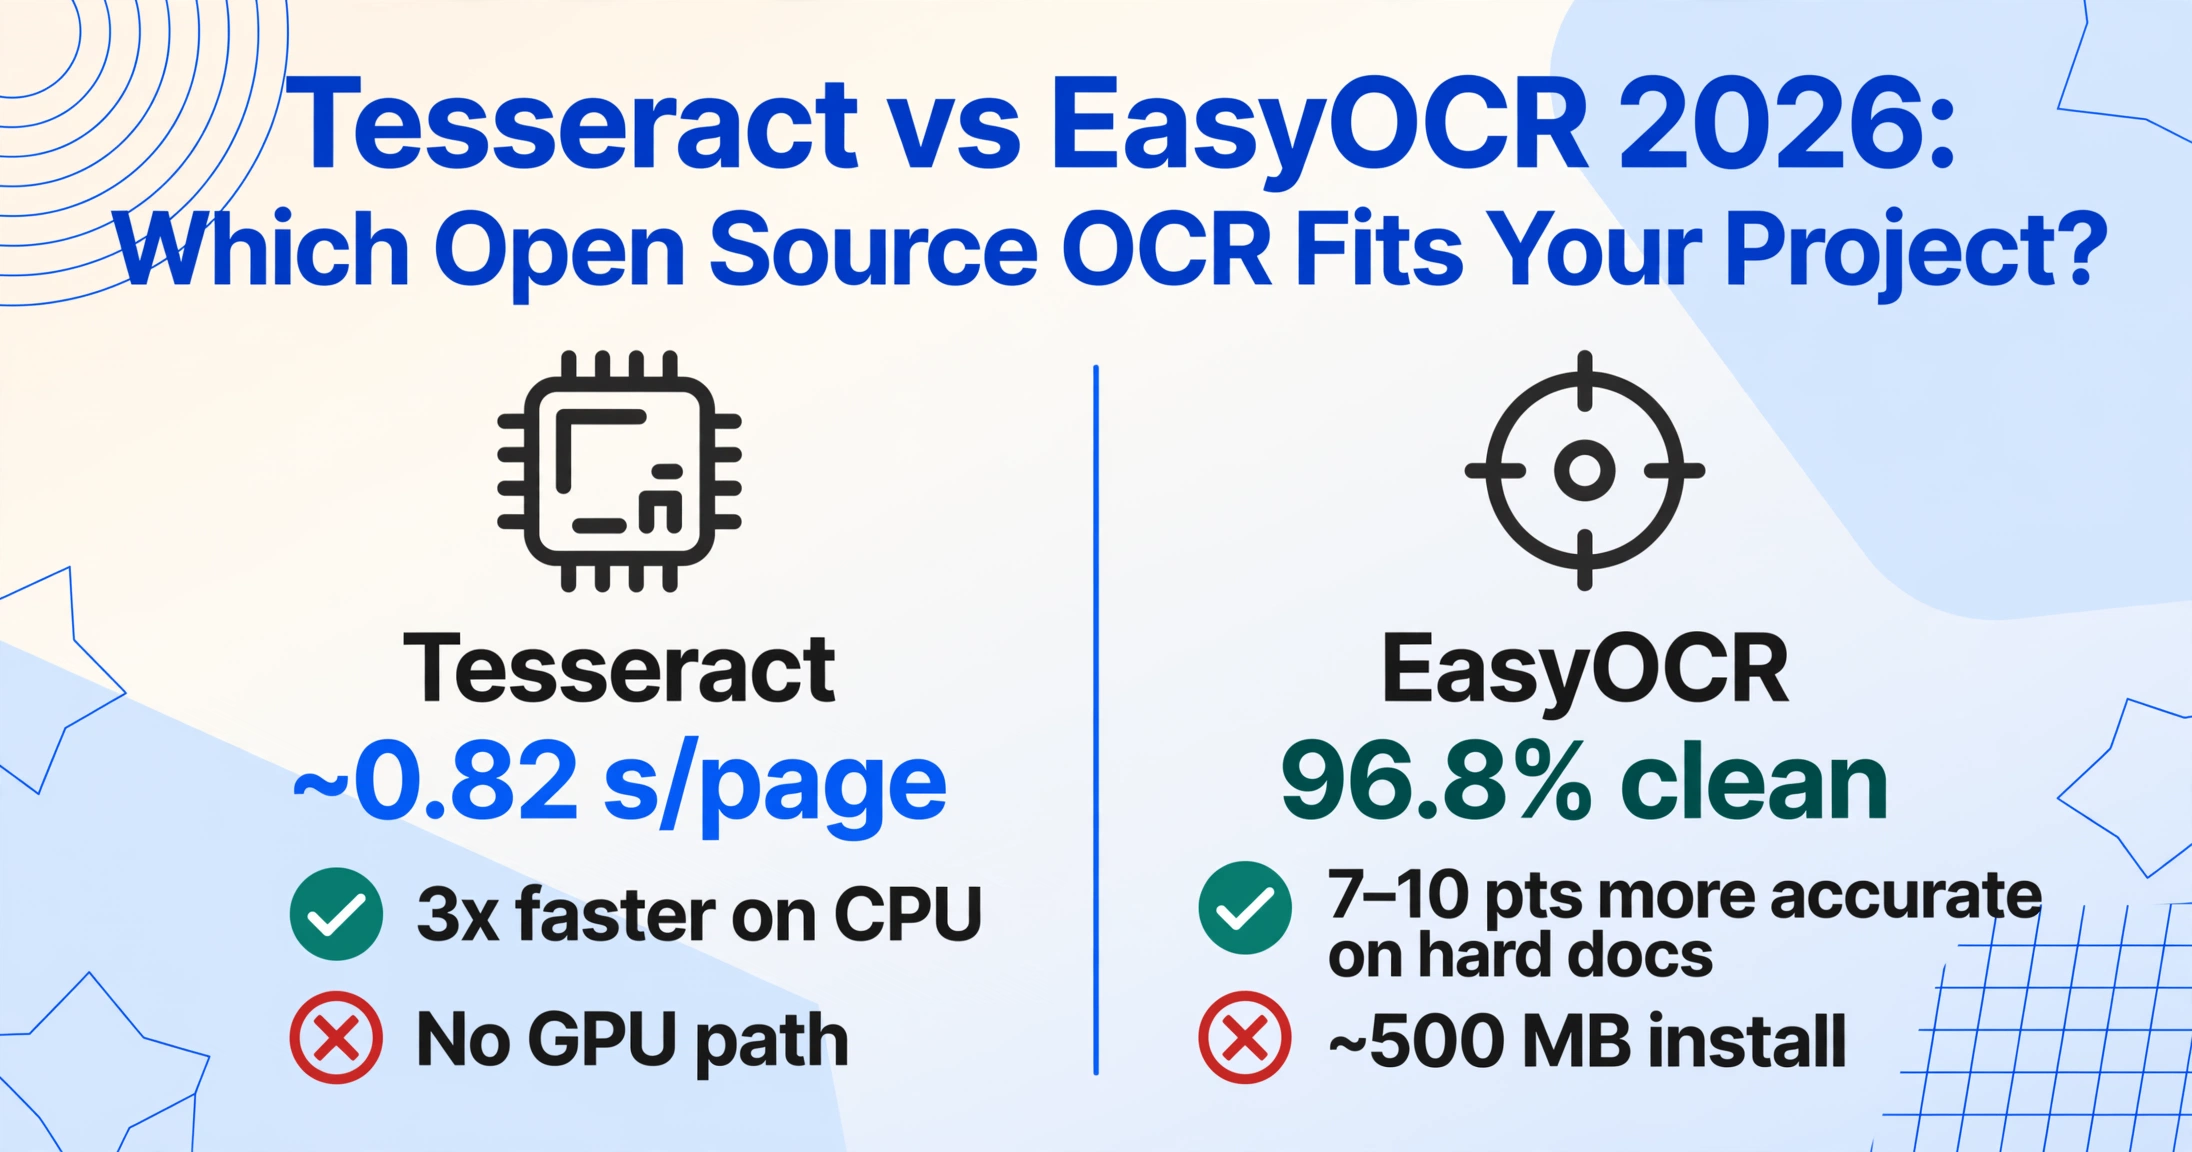
| Verarbeitungszeit (pro Seite) | ~0,82 s | ~2,45 s (CPU) / ~0,85 s (GPU) |
| Genauigkeit (sauberer Drucktext) | ~89,3% | ~96,8% |
| Installationsgröße | ~10 MB + Sprachdaten | ~500 MB (PyTorch-Backend) |
| GPU-Unterstützung | Nein (nur CPU) | Ja (CUDA 12.x) |
| Unterstützte Sprachen | 100+ | 80+ |
| Ausgabeformat | Reiner Text (standardmäßig ohne Konfidenz und Begrenzungsrahmen) | Strukturierte Liste (Text + Konfidenz + Begrenzungsrahmen pro Erkennung) |
| Lizenz | Apache 2.0 | Apache 2.0 |
| GitHub-Sterne | ~73.000+ | ~29.000+ |
Das Fazit: Tesseract ist auf der CPU 3x schneller, aber EasyOCR ist bei allen nicht perfekt sauberen Dokumenten um 7–10 Prozentpunkte genauer. Der Abstand wird bei schwierigeren Dokumenten noch deutlich größer.
Installation & Einrichtung
Tesseract punktet mit Einfachheit, wenn Sie bereits auf einem Linux-Server arbeiten. Ein einzelner Befehl apt-get install tesseract-ocr oder brew install tesseract liefert Ihnen in unter 30 Sekunden eine funktionsfähige OCR-Engine. Der Python-Wrapper (pytesseract) ist eine dünne Hülle um die System-Binary. Gesamter Abhängigkeitsaufwand: etwa 10 MB für die Engine plus ggf. zusätzliche Sprachdateien. Wenn Sie Tesseract noch nie installiert haben, behandelt unser Einrichtungsleitfaden für Einsteiger alle drei Betriebssysteme und die häufigsten Anfängerfehler.
Der Kompromiss: Tesseract erfordert die manuelle Installation von Sprachdaten. Für jede Sprache muss eine eigene .traineddata-Datei heruntergeladen und im Verzeichnis tessdata platziert werden. Für Pipelines mit 5+ Sprachen wird dies eher zu einem Deployment-Skript-Problem als zu einem Einzeiler.
EasyOCR ist schwergewichtiger in der Installation, aber eigenständig. Sie führen pip install easyocr aus und PyTorch kommt als Abhängigkeit mit – etwa 500 MB für das CUDA-fähige Backend. Beim ersten Erstellen einer Reader-Instanz lädt EasyOCR automatisch die benötigten Sprachmodelle herunter. Es gibt keine manuelle Dateiverwaltung, keine Umgebungsvariablen-Konfiguration und keine System-Binary-Abhängigkeit.
Für lokale Entwicklung und Prototyping ist EasyOCRs reibungslose Einrichtung ein echter Vorteil. Für Docker-basierte Deployments ist die 500-MB-PyTorch-Ebene eine einmalige Kosten, die Sie cachen – die langfristige Auswirkung ist also minimal.
Fazit zur Einrichtung:
- CI/CD-Pipelines, Server-Images, eingebettete Geräte: Tessercats 10-MB-Installation ist schwer zu übertreffen.
- Lokale Prototypen, Notebooks, mehrsprachige Projekte: EasyOCRs Auto-Download und Setup ohne Systemabhängigkeiten gewinnen.
Genauigkeit nach Dokumenttyp
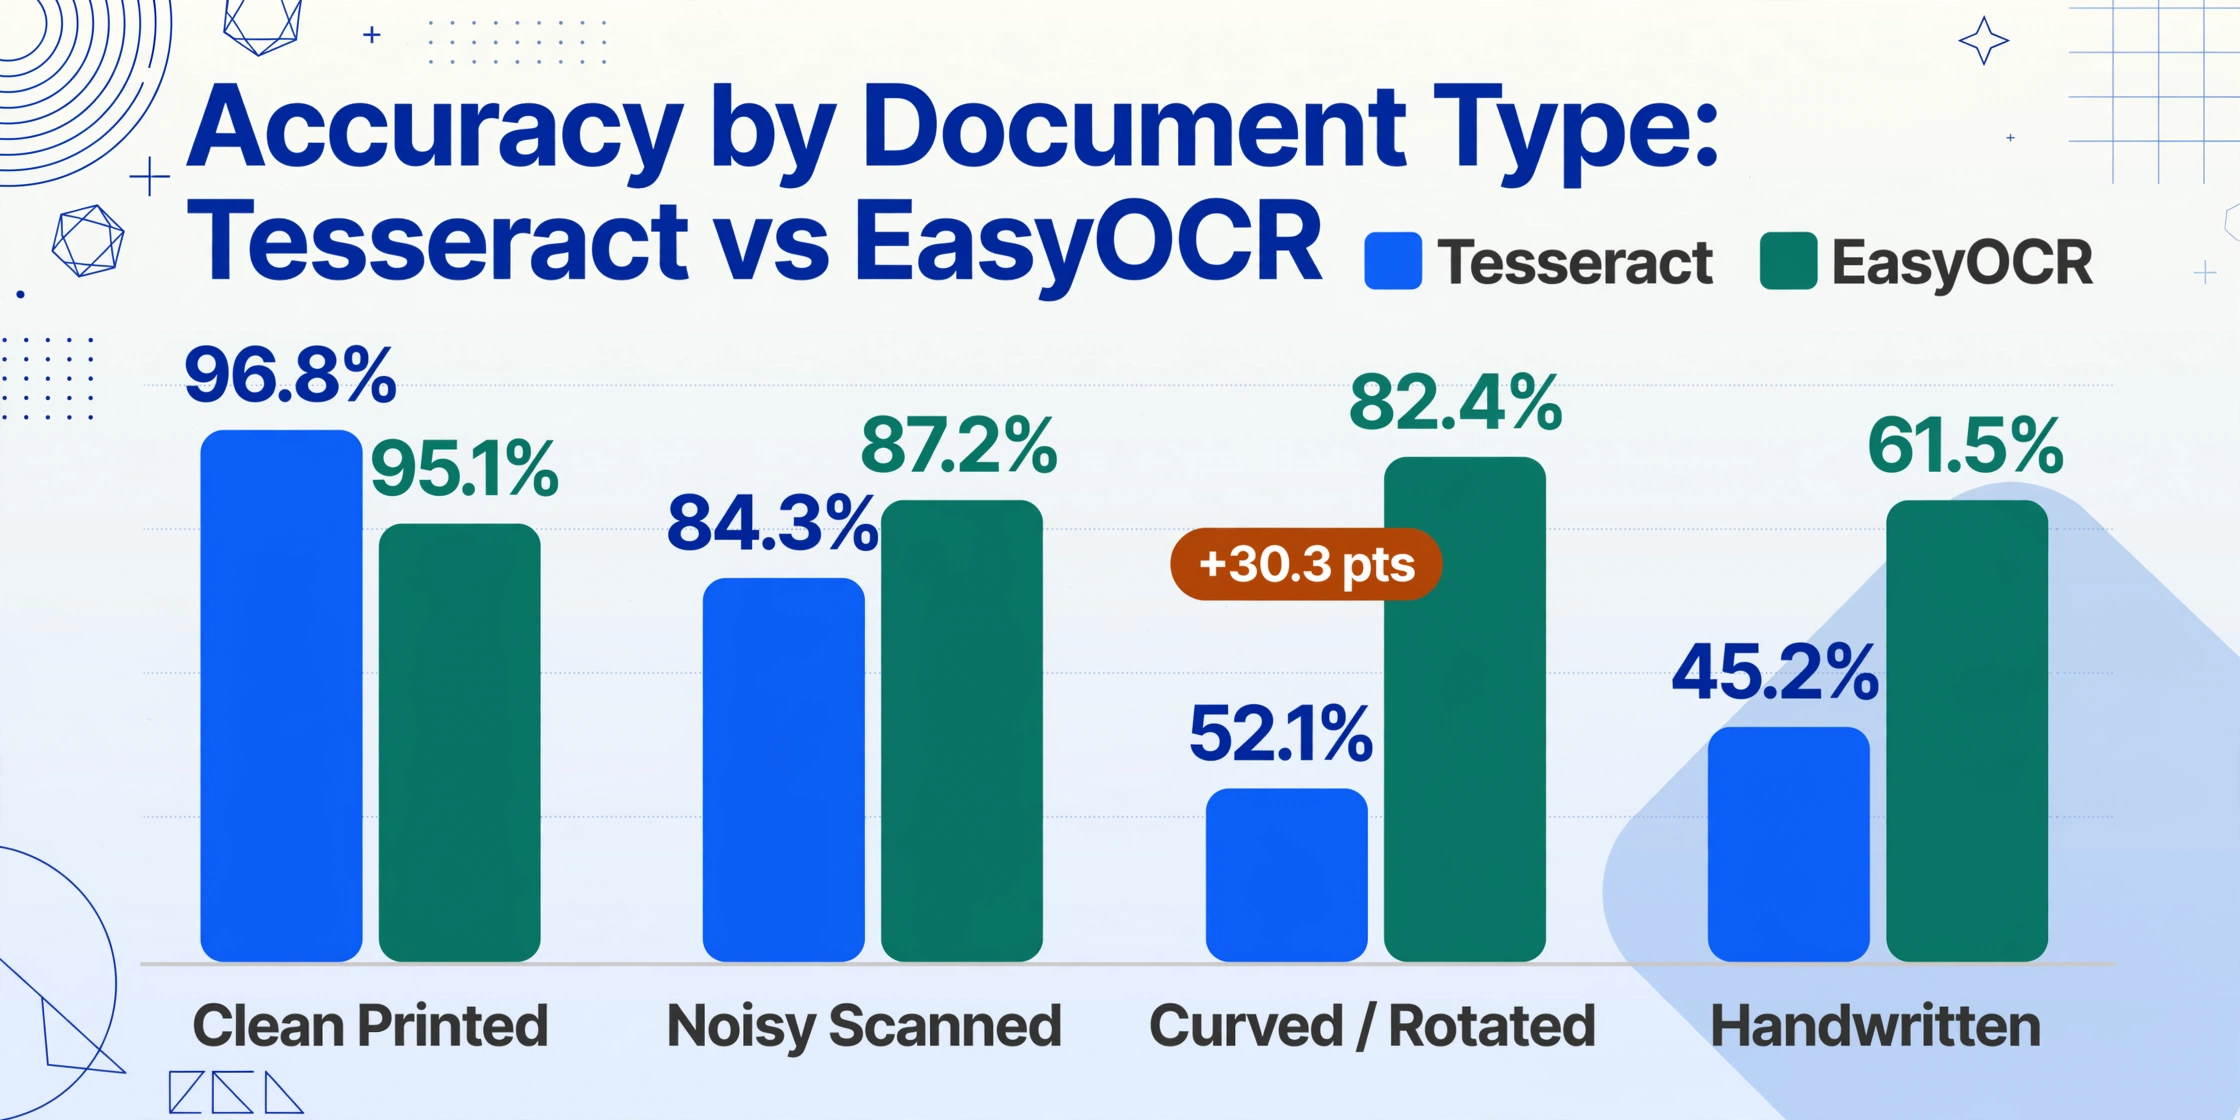
Hier unterscheiden sich die beiden Engines am deutlichsten. Unabhängige Benchmarks von GigaGPU testeten Tesseract 5 und EasyOCR auf vier Dokument-Schwierigkeitsstufen. Die Ergebnisse zeigen ein klares Muster: Bei sauberem, geradem, gedrucktem Text ist der Unterschied gering. Bei allem anderen wächst er schnell.
| Dokumenttyp | Tesseract 5 | EasyOCR | Abstand |
|---|---|---|---|
| Sauberer gedruckter englischer Text | 96.8% | 95.1% | Tesseract +1.7% |
| Verrauschte gescannte Dokumente | 84.3% | 87.2% | EasyOCR +2.9% |
| Gekrümmter / rotierter Text | 52.1% | 82.4% | EasyOCR +30.3% |
| Handschriftlicher Text | 45.2% | 61.5% | EasyOCR +16.3% |
Die Zahl für gekrümmten/rotierten Text ist kein Tippfehler. Tesseracts traditionelle Computer-Vision-Pipeline bricht zusammen, wenn Text nicht perfekt horizontal ist – die Legacy-Engine wurde für aufrechte, einspaltige gescannte Seiten entwickelt. EasyOCRs CRAFT-basierter Texterkenner verarbeitet beliebige Ausrichtungen standardmäßig, da er mit Szenentextdaten trainiert wurde, bei denen Rotation die Norm ist.
Der Unterschied bei Handschrift ist ebenso strukturell. Tesseract 5s LSTM-Engine wurde hauptsächlich mit gedruckten Korpusdaten trainiert. EasyOCRs Erkennungsmodell wurde mit einer Mischung trainiert, die handschriftliche Beispiele in vielen seiner 80+ Sprachen enthält, was ihm einen deutlichen Vorsprung verschafft – obwohl 61.5% für den Produktionseinsatz ohne Nachbearbeitung immer noch zu niedrig ist.
Kritische Nuance, die die meisten Vergleiche übersehen – Fehlermuster: Tesseract-Fehler sind tendenziell nicht behebbar – eine falsch gelesene Zeichenfolge („ay" statt „Qty") erzeugt eine Ausgabe, die für einen String-Vergleich korrekt aussieht, aber semantisch falsch ist. EasyOCR-Fehler hinterlassen häufiger vorhersehbare Signaturen: wiederholte Zeichen, Erkennungen mit geringer Konfidenz (< 0.5) oder Auffüll-Artefakte (~ und [ Zeichen). Wie das EasyOCR-Audit 2026 zeigte, können diese Signaturen mit Regex und Fuzzy-Matching bereinigt werden. Tesseracts Fehler können nicht durch Nachbearbeitung behoben werden – stattdessen benötigen Sie eine bessere Eingabevorverarbeitung.
Geschwindigkeit: CPU vs. GPU
Dies ist die am meisten missverstandene Dimension in jeder Diskussion über Tesseract vs. EasyOCR. Die beliebte Behauptung „Tesseract ist schneller" gilt nur auf der CPU — und selbst das hängt von Batch-Größe und Bildauflösung ab.
| Metrik | Tesseract 5 | EasyOCR (CPU) | EasyOCR (GPU, RTX 3090) |
|---|---|---|---|
| Seiten pro Minute | ~25 | ~8 | ~60 |
| Zeit pro Seite | ~0,82 s | ~2,45 s | ~0,85 s |
| Batch von 100 Seiten | ~82 s | ~245 s | ~85 s |
Auf der CPU: Tesseract ist pro Seite etwa 3x schneller als EasyOCR. Bei der Batch-Verarbeitung von Tausenden Dokumenten summiert sich dieser Unterschied zu Stunden. Wenn Sie auf einem reinen CPU-Server arbeiten — üblich in eingeschränkten Umgebungen wie abgeschotteten Systemen oder älteren Cloud-Instanzen — ist Tesseract die praktische Wahl.
Auf der GPU: EasyOCR mit CUDA-Beschleunigung schließt die Lücke fast vollständig und liefert ~60 Seiten pro Minute auf einer RTX 3090. Bei diesem Durchsatz ist ein Batch von 10.000 Rechnungen in unter drei Stunden fertig. Tesseract hat überhaupt keinen GPU-Pfad — es läuft immer auf der CPU, und sein Geschwindigkeitsvorteil verpufft, sobald die andere Seite eine GPU hat.
Die eigentliche Frage ist also nicht „Was ist schneller?", sondern „Haben Sie eine GPU in Ihrer Pipeline?" Wenn ja, verschwindet das Geschwindigkeitsargument für Tesseract. Wenn nein, ist Tesseract deutlich schneller.
Sprachunterstützung
Beide Engines decken die wichtigsten Weltsprachen ab, unterscheiden sich jedoch in Umfang, Benutzerfreundlichkeit und Qualität pro Sprache.
Tesseract unterstützt über 100 Sprachen über das tessdata-Repository. Die Community trägt seit zwei Jahrzehnten trainierte Modelle bei, sodass auch weniger verbreitete Schriften wie Altgriechisch, Inuktitut und mehrere indigene Sprachen abgedeckt sind. Die Qualität variiert jedoch stark — Sprachen mit kleinen Trainingskorpora (weniger als 10.000 Trainingsseiten) erzielen deutlich geringere Genauigkeit. Sie müssen die .traineddata-Datei jeder Sprache manuell herunterladen und mit dem -l-Flag angeben, was die Bereitstellung für mehrsprachige Projekte komplexer macht.
EasyOCR deckt über 80 Sprachen ab, liefert jedoch vorab heruntergeladene Modelle mit, die bei der ersten Verwendung automatisch abgerufen werden. Die Qualitätsuntergrenze ist höher, da jede unterstützte Sprache durch dieselbe Deep-Learning-Pipeline läuft, die mit modernen Korpusdaten trainiert wurde. Sprachen mit nicht-lateinischen Schriften — Chinesisch, Japanisch, Koreanisch, Arabisch, Devanagari — sind besondere Stärken von EasyOCR, da das Modell von Grund auf für sie entwickelt wurde. Die r/MachineLearning-Community auf Reddit hat EasyOCRs Vorteil bei japanischen und gemischtsprachigen Dokumenten hervorgehoben.
Praktische Empfehlung: Für reine Englisch- oder Lateinschrift-Pipelines schneiden beide Engines ähnlich ab. Für jedes Projekt, das CJK, Arabisch oder gemischtsprachige Dokumente benötigt, liefert EasyOCR deutlich bessere Ergebnisse mit weniger Konfigurationsaufwand. Wenn Sie eine seltene Sprache benötigen, die nur Tesseract abdeckt, lohnt sich der zusätzliche Einrichtungsaufwand.
Ausgabequalität & API-Design
Über die reinen Genauigkeitszahlen hinaus hat die Art und Weise, wie jede Engine ihre Ausgabe liefert, praktische Auswirkungen auf die nachgelagerte Verarbeitung.
Tesseract gibt standardmäßig reinen Text über pytesseract.image_to_string() zurück. Wenn Sie Begrenzungsrahmen benötigen, verwenden Sie image_to_data() oder image_to_boxes(), die TSV-formatierte Daten mit Koordinaten pro Zeichen oder pro Wort ausgeben. Um strukturierte Ausgaben zu erhalten – etwa eine Tabelle mit Rechnungsnummer, Datum und Gesamtsumme – müssen Sie Layout-Analysecode auf Basis der Begrenzungsrahmen von Tesseract schreiben, da die Engine kein Konzept von Dokumentstruktur hat. Sie liest Zeilen; sie versteht nicht, dass eine Zahl oben rechts die Rechnungssumme ist.
EasyOCR gibt eine Liste von Wörterbüchern zurück, die jeweils [bounding_box, text, confidence] enthalten. Dieses strukturierte Format ist sofort nutzbar zum Filtern nach Konfidenzschwellen, Sortieren nach Position oder zur Weiterleitung an einen nachgelagerten Layout-Parser. Die Einbeziehung eines Konfidenzwerts pro Erkennung ist ein erheblicher praktischer Vorteil: Sie können Ergebnisse mit niedriger Konfidenz programmatisch verwerfen, zur manuellen Prüfung markieren oder über ein anderes OCR-Backend leiten.
Der praktische Unterschied: Wenn Sie bestimmte Felder aus einem halbstrukturierten Dokument extrahieren müssen (eine Bestellung, einen Führerschein, ein Zertifikat), spart Ihnen das umfangreichere Ausgabeformat von EasyOCR einen Integrationsschritt. Wenn Sie nur Rohtext von einer ganzen Seite benötigen (einen Buchscan, einen Zeitungsartikel, einen Brief), ist die reine Textausgabe von Tesseract ausreichend und schneller zu verarbeiten.
Keine der beiden Engines erzeugt die Art von strukturierter Ausgabe, die eine Dokumentextraktions-Pipeline letztlich benötigt – Spaltendaten, die semantischen Feldern zugeordnet sind. Diese Lücke ist der Grund, warum die Unstract-OCR-Bewertung 2026 sowohl Tesseract als auch EasyOCR als „traditionelle“ Engines einstufte, im Gegensatz zu VLM-basierten Modellen, die Feld-Wert-Paare direkt ausgeben können. Wenn Ihr Endziel eine Tabellenkalkulation mit extrahierten Rechnungsfeldern ist und nicht roher OCR-Text, benötigen Sie dennoch eine semantische Extraktionsebene über beiden Engines. Für einen tieferen Einblick, wie sich moderne KI-Extraktion von traditioneller OCR unterscheidet, behandelt unser Vergleich OCR vs. KI-Extraktion den Architekturwechsel.
Wann Tesseract sinnvoller ist
Tesseract ist die richtige Wahl, wenn Ihre Dokumente vorhersehbar sind und Ihre Infrastruktur eingeschränkt ist.
- Serverumgebungen nur mit CPU — Tesseracts 25 Seiten/min auf der CPU ist schneller als EasyOCRs 8 Seiten/min, und auf der anderen Seite gibt es keine GPU-Option.
- Große Mengen sauberer Dokument-Batches — Wenn jede Rechnung aus demselben ERP stammt, jede Quittung vom selben Kassensystem kommt und der Text durchgehend aufrecht und gut beleuchtet ist, reicht Tesseracts 96,8 % Genauigkeit bei sauberem Text aus. Der gelegentliche Fehler ist günstiger zu beheben als die zusätzlichen Rechenkosten einer Deep-Learning-Engine.
- Eingebettete Systeme und Docker-Images — Die Installationsgröße von ca. 10 MB passt problemlos in ressourcenbeschränkte Umgebungen, in denen jedes Megabyte zählt.
- Pipelines, die bereits Bildvorverarbeitung enthalten — Wenn Sie bereits einen OpenCV-basierten Vorverarbeitungsschritt haben (Deskew, Denoise, Binarize), verbessert sich Tesseracts Ausgabe deutlich. Teams, die in Vorverarbeitung investieren, schließen die Genauigkeitslücke zu EasyOCR oft bei allem außer gekrümmtem Text und Handschrift.
- Compliance-Anforderungen, die reine CPU-Verarbeitung vorschreiben — Einige regulierte Branchen verlangen, dass die gesamte Verarbeitung auf reiner CPU-Hardware erfolgt. In diesem Szenario ist Tesseract nicht nur besser — es ist die einzige praktikable Option der beiden.
Für einen breiteren Überblick über kostenlose OCR-Optionen über diese beiden hinaus, lesen Sie unseren Leitfaden zu den besten kostenlosen OCR-Software 2026.
Wann EasyOCR sinnvoller ist
EasyOCR rechtfertigt seine schwerere Installation und langsamere CPU-Leistung, wenn Dokumentvielfalt oder Genauigkeitsanforderungen Tesseract an seine Grenzen bringen.
- Verrauschte oder reale Dokumentbilder — Fotos von Quittungen, die mit dem Handy aufgenommen wurden, gescannte Formulare mit Kaffeeflecken, gefaxte Dokumente mit Komprimierungsartefakten. EasyOCRs Deep-Learning-Erkennungspipeline kommt mit diesen Bedingungen deutlich besser zurecht als Tesseracts schwellenwertbasierter Ansatz.
- Mehrsprachige Dokumente — EasyOCRs automatischer Modell-Download und gleichbleibende Qualität in über 80 Sprachen macht es zur einfacheren Wahl für jedes Projekt, das mehr als zwei Schriften verarbeitet.
- Umgebungen mit GPU — Mit CUDA-Beschleunigung erreicht EasyOCR Tesseracts Geschwindigkeit und liefert dabei je nach Dokumentschwierigkeit 5–30 Prozentpunkte höhere Genauigkeit.
- Anforderungen an strukturierte Ausgaben — Wenn Ihre Pipeline Konfidenzwerte, Begrenzungsrahmen oder Metadaten pro Erkennung benötigt, liefert EasyOCR diese ohne zusätzlichen Parsing-Code.
- Schnelles Prototyping und Notebooks — EasyOCRs Drei-Zeilen-Setup und automatische Modell-Downloads machen es ideal für Jupyter-Notebook-Erkundungen, Hackathon-Projekte und Proof-of-Concept-Arbeiten, bei denen die Einrichtungsgeschwindigkeit wichtiger ist als die Produktionsoptimierung.
Wenn Ihr Projekt sowohl rohe OCR als auch letztendliche semantische Extraktion in strukturierte Felder wie Rechnungsnummer, Gesamtsumme und Lieferantenname benötigt, lesen Sie nach diesem Vergleich vielleicht unseren Leitfaden zu OCR-APIs für strukturierte Ausgaben.
Das Urteil: Eine szenariobasierte Entscheidung
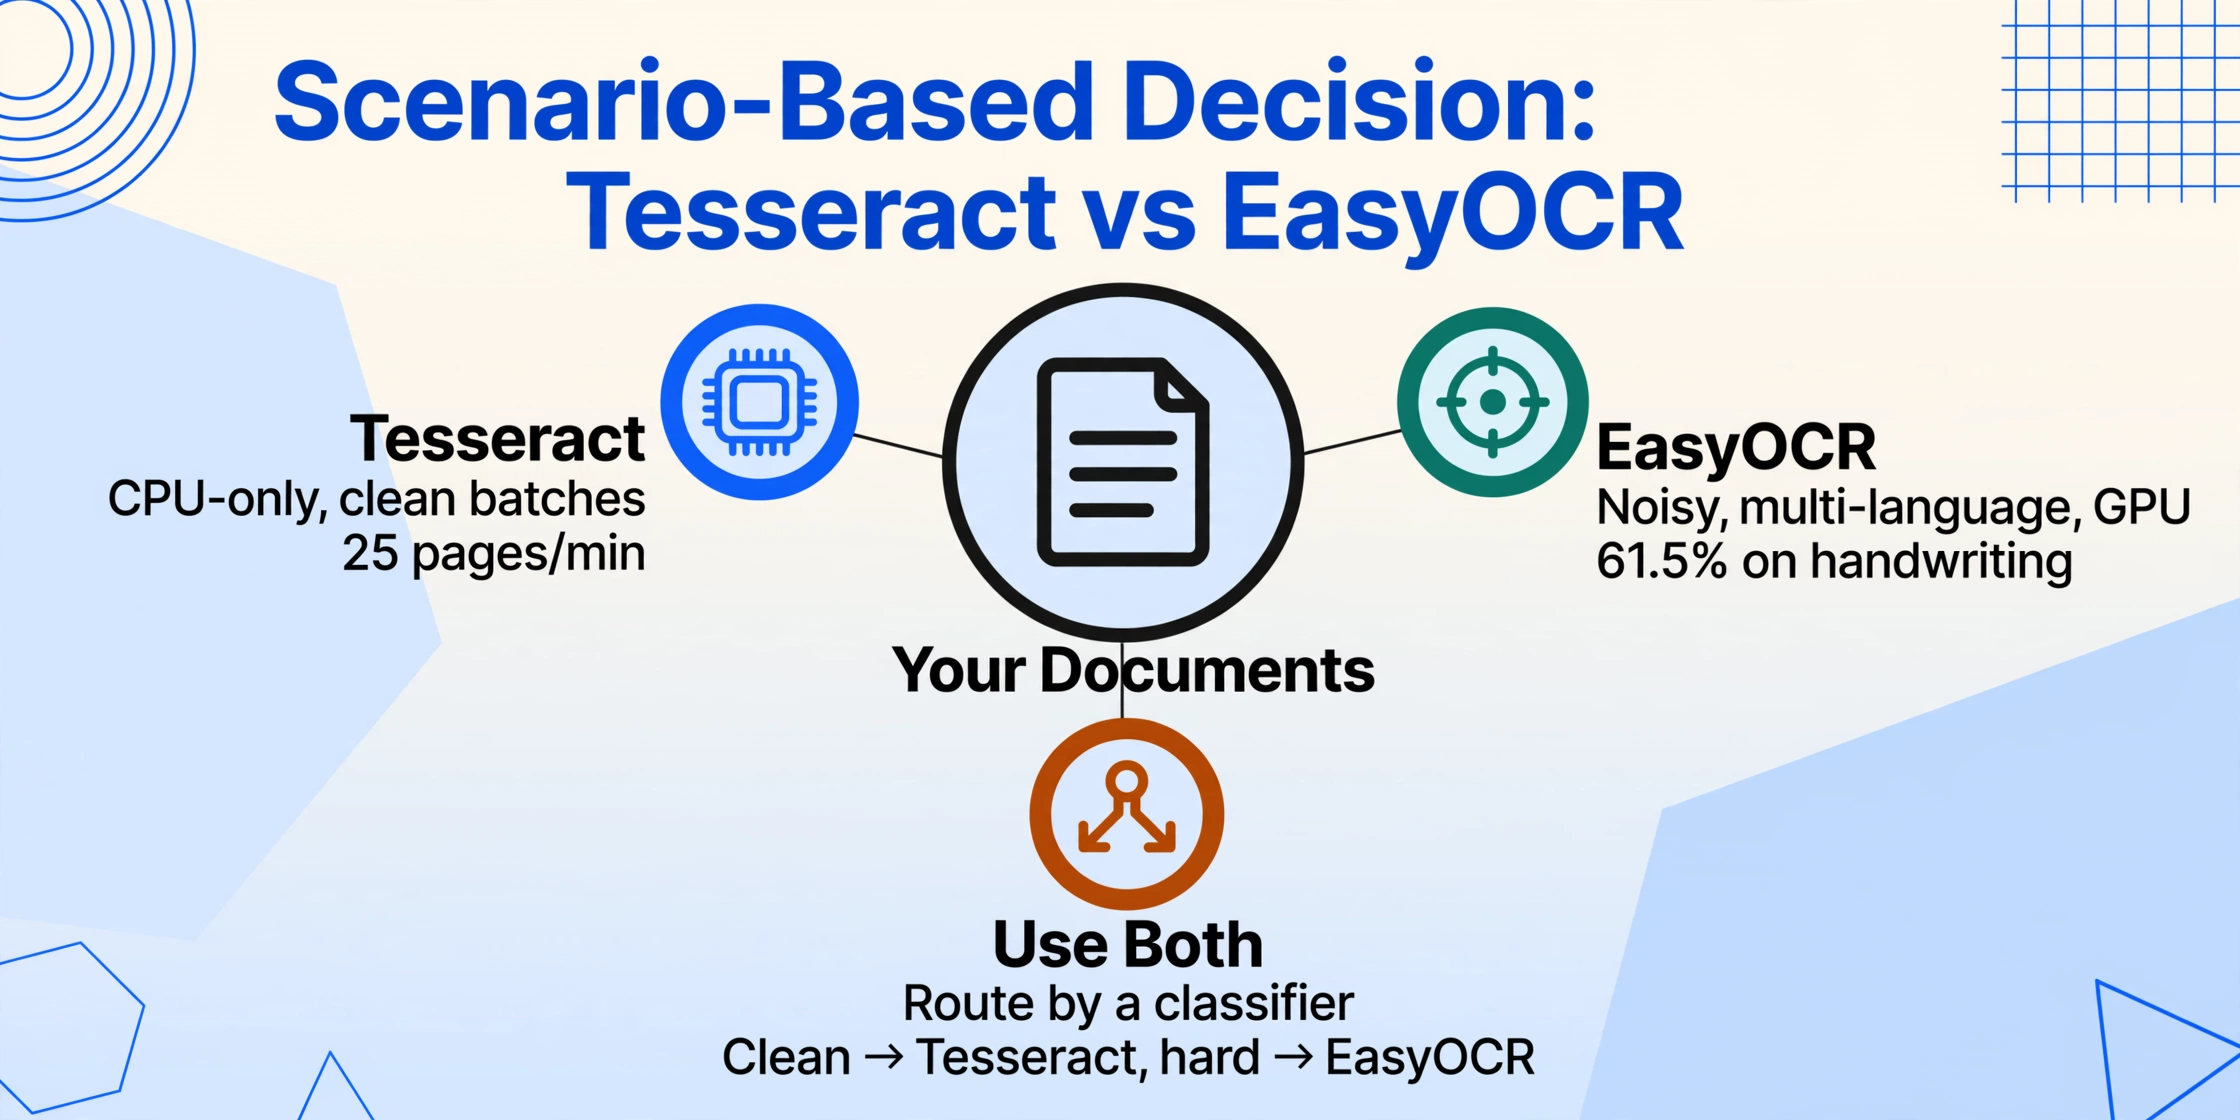
Keine Engine ist universell „besser". Die richtige Wahl hängt von Ihren Dokumenten, Ihrer Hardware und Ihrer Toleranz für Nachbearbeitung ab. Die Entscheidungsmatrix unten ordnet die häufigsten Szenarien der empfohlenen Engine zu.
| Ihr Szenario | Empfohlene Engine | Warum |
|---|---|---|
| Saubere gescannte Rechnungen, gleiches Lieferantenformat, hohes Volumen | Tesseract | CPU-schnell, 96,8 % Genauigkeit ausreichend, geringe Ressourcenlast |
| Belegfotos vom Handy, wechselnde Qualität | EasyOCR | Deep Learning verarbeitet Rauschen, Rotation, gemischte Schriften |
| Mehrsprachige Dokumente (CJK, Arabisch, gemischt) | EasyOCR | Bessere CJK/Arabisch-Unterstützung, Auto-Download, höhere Genauigkeit |
| Nur-CPU-Docker-Container, 500-MB-Budget | Tesseract | 10-MB-Installation, keine GPU-Abhängigkeit, 3-fache CPU-Geschwindigkeit |
| Handschriftliche Formulare, historische Dokumente | EasyOCR | 61,5 % gegenüber 45,2 % — immer noch niedrig, aber mit Nachbearbeitung verwertbar |
| Batch-Pipeline, GPU verfügbar, 10.000+ Dokumente/Tag | EasyOCR | GPU erreicht Tesseract-Geschwindigkeit, bessere Genauigkeit, strukturierte Ausgabe |
| Sie benötigen Feldextraktion (Rechnungsnr., Gesamtbetrag, Datum) | Keine allein | Beide liefern Rohtext, keine strukturierten Felder. Fügen Sie eine semantische Extraktionsebene hinzu oder sehen Sie unseren KI-Extraktionsvergleich |
Eine praktische Strategie, die viele Produktionspipelines nutzen: beide verwenden. Leiten Sie saubere Dokumente zur Geschwindigkeit an Tesseract und schwierige Dokumente zur Genauigkeit an EasyOCR. Mit einem einfachen Klassifikator davor — Bildauflösung, Dateigröße oder ein schneller Entropie-Check — können Sie das Beste aus beiden Welten nutzen, ohne sich für alles auf eine Engine festzulegen.
Und wenn Ihr Projekt letztendlich strukturierte Daten benötigt (Rechnungsnummer, Gesamtbetrag, Lieferantenname) statt nur OCR-Text, bringt Sie weder Tesseract noch EasyOCR allein dorthin. Das erfordert eine semantische Extraktionsebene darüber — ob Sie sie selbst mit einem VLM bauen oder ein Tool für strukturierte Ausgabe nutzen. Unser Vergleich von Open-Source-OCR-Tools deckt die gesamte Landschaft ab, einschließlich VLM-basierter Optionen.
Wichtige Erkenntnis
Der Unterschied zwischen Tesseract und EasyOCR liegt nicht an der Technologie an sich – sondern an der Schwierigkeit der Dokumente. Tesseract verarbeitet 80 % sauberer, gedruckter Dokumente gut. EasyOCR übernimmt die restlichen 20 %, die verrauscht, gedreht oder handschriftlich sind. Ein gutes Pipeline-Design berücksichtigt beide Bereiche und leitet entsprechend weiter.
Häufig gestellte Fragen
Welche OCR ist schneller: Tesseract oder EasyOCR?
Auf der CPU ist Tesseract etwa 3x schneller – ungefähr 25 Seiten pro Minute gegenüber 8 Seiten pro Minute bei EasyOCR. Auf der GPU erreicht EasyOCR bis zu ~60 Seiten pro Minute und übertrifft oder erreicht damit den Durchsatz von Tesseract bei höherer Genauigkeit. Die Antwort hängt ganz davon ab, ob GPU-Beschleunigung verfügbar ist.
Welche ist insgesamt genauer?
Bei sauberem, geradem Drucktext sind sie nahezu gleichauf (96,8 % Tesseract vs. 95,1 % EasyOCR). Bei verrauschten, gekrümmten oder handschriftlichen Dokumenten führt EasyOCR mit 3 bis 30 Prozentpunkten. Wenn Ihre Dokumente immer sauber sind, ist der Genauigkeitsunterschied vernachlässigbar. Wenn die Qualität variiert, bietet die Deep-Learning-Pipeline von EasyOCR einen deutlichen Vorsprung.
Können Tesseract oder EasyOCR Handschrift verarbeiten?
Beide haben Probleme mit Handschrift, aber EasyOCR schneidet besser ab (61,5 % vs. 45,2 % Genauigkeit). Keine der beiden ist ohne zusätzliches Training oder eine handschriftenspezifische Modell-Pipeline für die Produktion geeignet. Zum Vergleich: Moderne Vision-Language-Modelle wie olmOCR und Qwen2.5-VL erreichen deutlich höhere Handschriftgenauigkeit, allerdings mit wesentlich höherem Rechenaufwand.
Unterstützt Tesseract GPU-Beschleunigung?
Nein. Tesseract 5.x ist von Natur aus nur für die CPU ausgelegt. Es gibt laufende Diskussionen in der Community über GPU-Unterstützung für zukünftige Versionen (siehe den Thread zu den Tesseract-2026-Plänen), aber Stand Mitte 2026 gibt es keinen GPU-Pfad. EasyOCR nutzt CUDA für die GPU-Beschleunigung und läuft auf jeder PyTorch-kompatiblen GPU.
Sind beide komplett kostenlos?
Ja. Sowohl Tesseract (Apache 2.0, von Google gepflegt) als auch EasyOCR (Apache 2.0, Jaided AI) sind vollständig Open Source und kostenlos für die kommerzielle Nutzung, ohne Nutzungslimits, Ratenbegrenzungen oder API-Kosten. Die einzigen Kosten entstehen durch die Infrastruktur, die zum Ausführen benötigt wird – CPU-Zeit, Speicher und optional GPU-Rechenleistung.
Können diese Tools strukturierte Daten wie Rechnungsnummer und Gesamtsumme extrahieren?
Nicht direkt. Beide Engines erzeugen OCR-Text – Zeichen und Wörter auf der Seite. Das Extrahieren bestimmter Felder (Rechnungsnummer, Fälligkeitsdatum, Positionszeilen) erfordert zusätzliche Logik: entweder regex-basiertes Parsing, Layout-Analyse auf Basis von Begrenzungsrahmen oder eine semantische Extraktionsebene. Für Projekte, die feldgenaue strukturierte Ausgaben aus Rechnungen, Belegen oder Formularen benötigen, sollten Sie möglicherweise KI-native Extraktionstools in Betracht ziehen, die Dokument-Semantik nativ verstehen, anstatt sich auf OCR + Parsing zu verlassen.
Vom OCR-Text zu strukturierten Daten — ohne Pipeline-Aufwand
Wenn Sie bis hierher gelesen haben, haben Sie die zentrale Herausforderung verstanden: Tesseract und EasyOCR liefern Text, aber nicht die strukturierten Felder, die Ihre Geschäftsprozesse benötigen. Die KI-Extraktion von ImageToTable.ai geht direkt vom Dokument zur Tabelle — ohne OCR-Engine-Tuning, ohne Post-Processing-Regex, ohne Layout-Analyse. Laden Sie eine Rechnung hoch, benennen Sie die gewünschten Spalten (Rechnungsnummer, Gesamtbetrag, Lieferant), und die KI lokalisieret jeden Wert, indem sie versteht, was er bedeutet, nicht wo er auf der Seite steht.
Mit bis zu 99 % Genauigkeit bei gedruckten Dokumenten, Batch-Verarbeitung für Hunderte von Dateien und direktem Excel/Google Sheets-Export überbrückt sie die Lücke, die dieser Vergleich beschrieben hat: die Distanz zwischen OCR-Text und nutzbaren Daten.