Tesseract vs EasyOCR 2026:
あなたのプロジェクトに適したオープンソースOCRは?
この比較は、文書処理パイプライン用に2つの無料のセルフホスト型OCRエンジンを選ぶ開発者またはデータエンジニアの視点から書かれています。Tesseract — Googleの40年歴史のあるオープンソースエンジン — は、軽量でCPU処理が速く、きれいな印刷テキストに優れています。EasyOCR — Jaided AIによるPyTorchネイティブライブラリ — は、深層学習を使用して単一パスで検出と認識を行い、難しい文書では精度と引き換えに速度を犠牲にし、必要な場合にはGPUアクセラレーションを提供します。問題はどちらが「優れているか」ではありません。どちらのトレードオフが、あなたの文書、ハードウェア、後処理に対する許容度に合っているかです。
重要なポイント
- 2つの無料OCRエンジン、両方ともApache 2.0ライセンスで、両方とも約90%以上の精度を主張 — すべての比較記事でTesseractとEasyOCRは名前が違うだけで同じツールのように見えます。
- 実際に両者を分けるのは精度ではなくエラーからの回復可能性です:Tesseractの誤読は静かで永続的ですが、EasyOCRの失敗は正規表現で発見して除去できる痕跡を残します。
- 精度ランキングは忘れてください — 後処理パイプラインが耐えられるミスの種類を持つエンジンを選んでください。エラーは必ず発生し、唯一の問題はそれに気づけるかどうかです。
簡単比較:Tesseract vs EasyOCR
以下の表は、実際のプロジェクトで重要な各項目における主な違いをまとめたものです。これらの数値は、GigaGPUおよびCodeSOTAが標準文書テストセットで実施した独立したベンチマークに基づいています。画像品質、前処理、文書の種類によって結果は異なります。
| 項目 | Tesseract 5.5 | EasyOCR |
|---|---|---|
| コア技術 | LSTMニューラルネット + 従来のパターンマッチング | PyTorchベースの深層学習(CRAFT検出器 + CRNN認識器) |
| 処理時間(1ページあたり) | 約0.82秒 | 約2.45秒(CPU)/ 約0.85秒(GPU) |
| 精度(鮮明な印刷テキスト) | 約89.3% | 約96.8% |
| インストールサイズ | 約10MB + 言語データ | 約500MB(PyTorchバックエンド) |
| GPU対応 | なし(CPUのみ) | あり(CUDA 12.x) |
| 対応言語数 | 100以上 | 80以上 |
| 出力形式 | プレーンテキスト(デフォルトでは信頼度・バウンディングボックスなし) | 構造化リスト(検出ごとにテキスト+信頼度+バウンディングボックス) |
| ライセンス | Apache 2.0 | Apache 2.0 |
| GitHubスター数 | 約73,000以上 | 約29,000以上 |
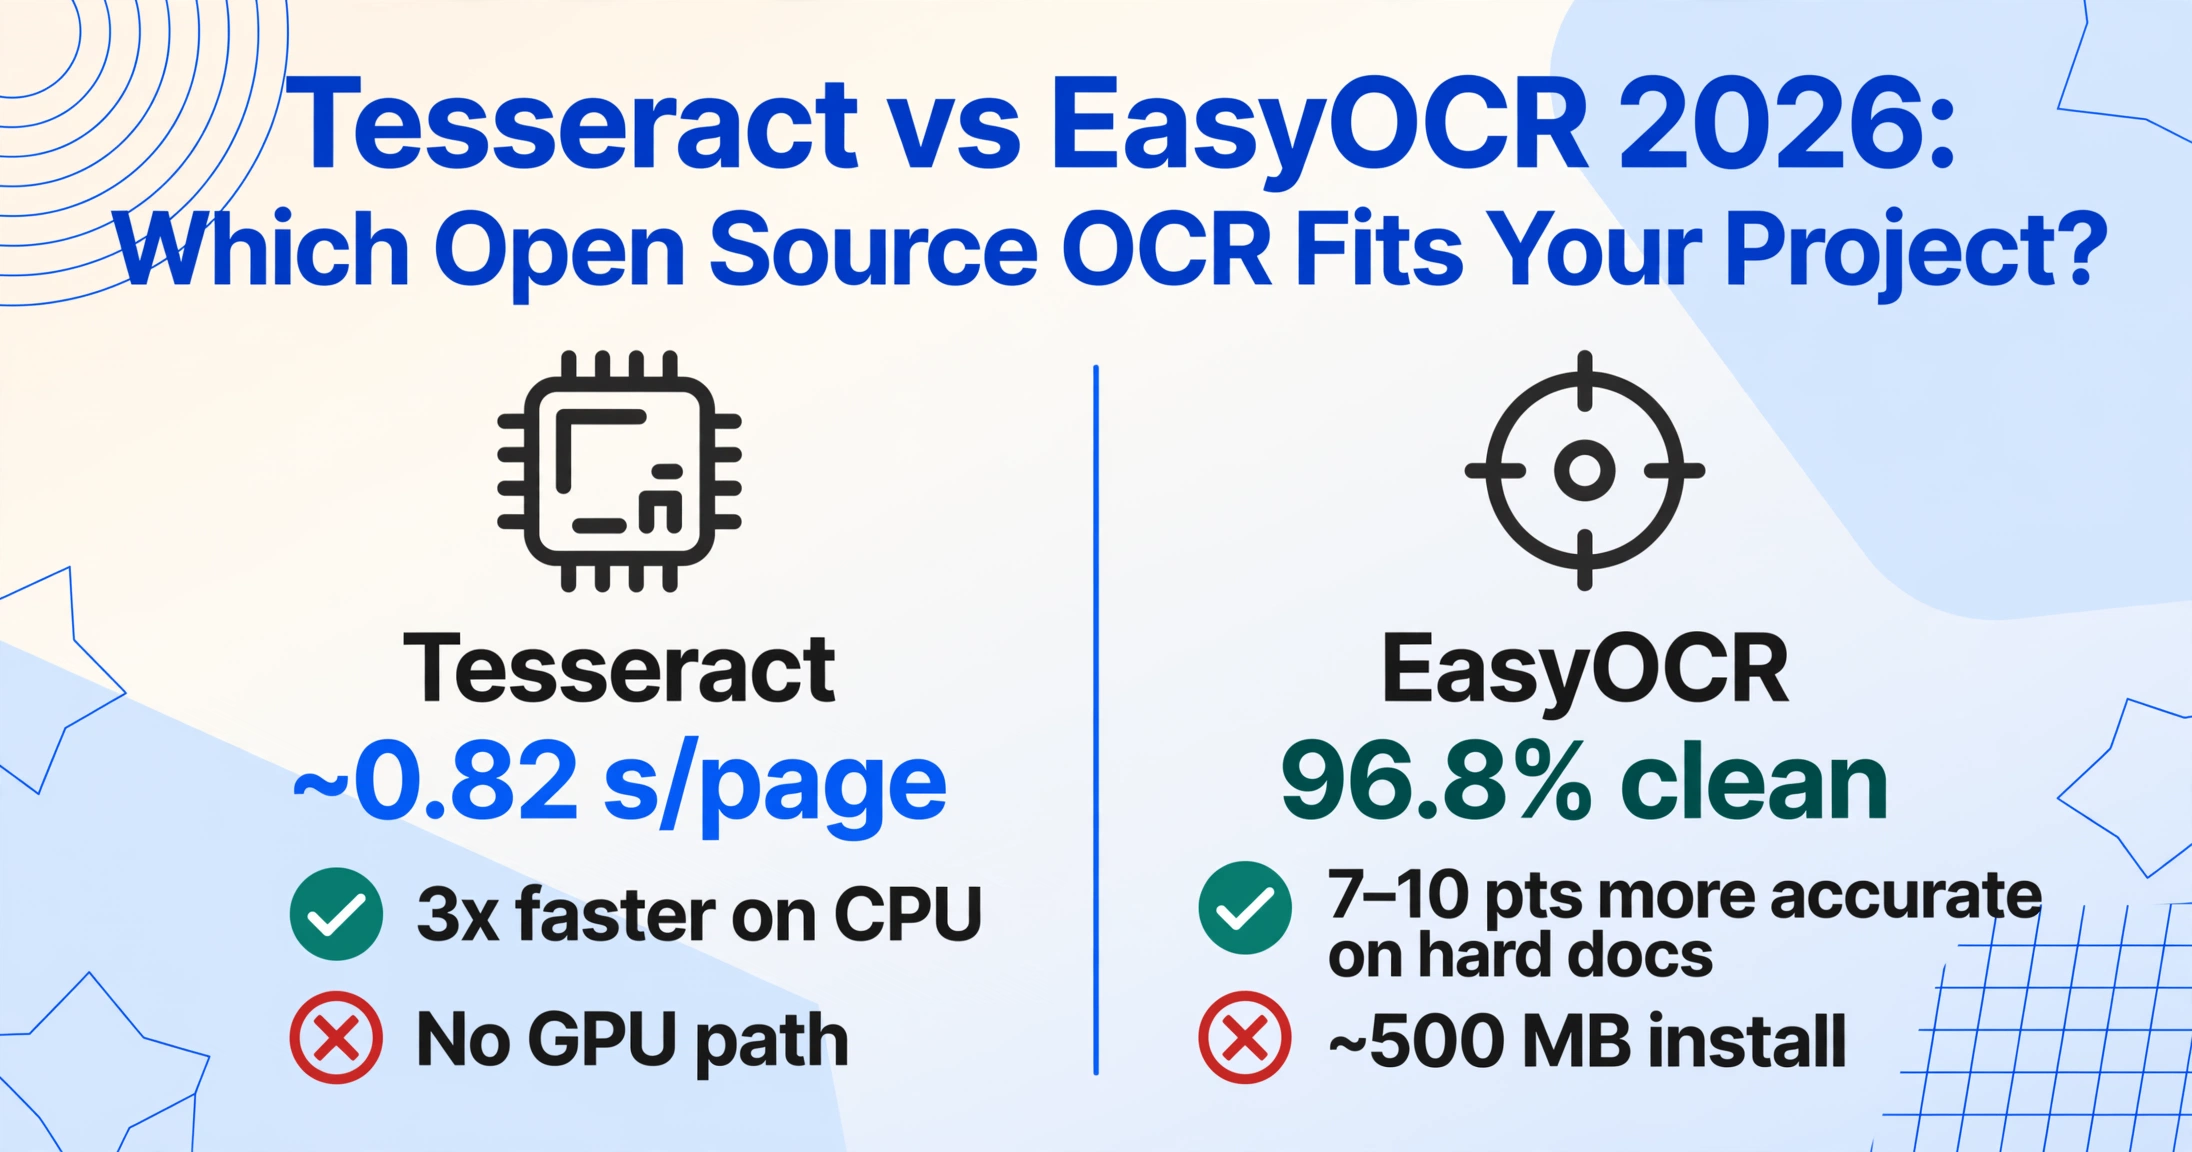
主なポイント:TesseractはCPUで3倍高速ですが、EasyOCRは完全に鮮明でない文書では7~10ポイント精度が高くなります。文書が難しくなるほど、その差は顕著になります。
インストールとセットアップ
すでにLinuxサーバーを利用している場合、Tesseractはシンプルさで優れています。 apt-get install tesseract-ocrまたはbrew install tesseractを実行するだけで、30秒以内に動作するOCRエンジンを入手できます。Pythonラッパー(pytesseract)はシステムバイナリの薄いシェルです。依存関係の総重量は、エンジンで約10 MB、必要に応じて追加の言語データファイルが加わります。Tesseractを初めてインストールする場合は、初心者向けセットアップガイドで3つのOSすべてと、よくある初回の落とし穴を解説しています。
トレードオフ:Tesseractでは言語データの手動インストールが必要です。各言語には専用の.traineddataファイルをダウンロードしてtessdataディレクトリに配置する必要があります。5言語以上を扱うパイプラインでは、これはワンライナーではなくデプロイスクリプトの考慮事項になります。
EasyOCRはインストールが重いものの、自己完結型です。 pip install easyocrを実行すると、依存関係としてPyTorchもインストールされます(CUDA対応バックエンドで約500 MB)。初めてReaderインスタンスを作成する際、EasyOCRは必要な言語モデルを自動的にダウンロードします。手動のデータファイル管理、環境変数の設定、システムバイナリへの依存は一切ありません。
ローカル開発やプロトタイピングでは、EasyOCRの手間のかからないセットアップは大きな利点です。Docker化されたデプロイでは、500 MBのPyTorchレイヤーは一度支払ってキャッシュするコストであり、長期的な影響は最小限です。
セットアップに関する結論:
- CI/CDパイプライン、サーバーイメージ、組み込みデバイス: Tesseractの10 MBインストールは非常に魅力的です。
- ローカルプロトタイプ、ノートブック、多言語プロジェクト: EasyOCRの自動ダウンロードとシステム依存ゼロのセットアップが優れています。
文書タイプ別の精度
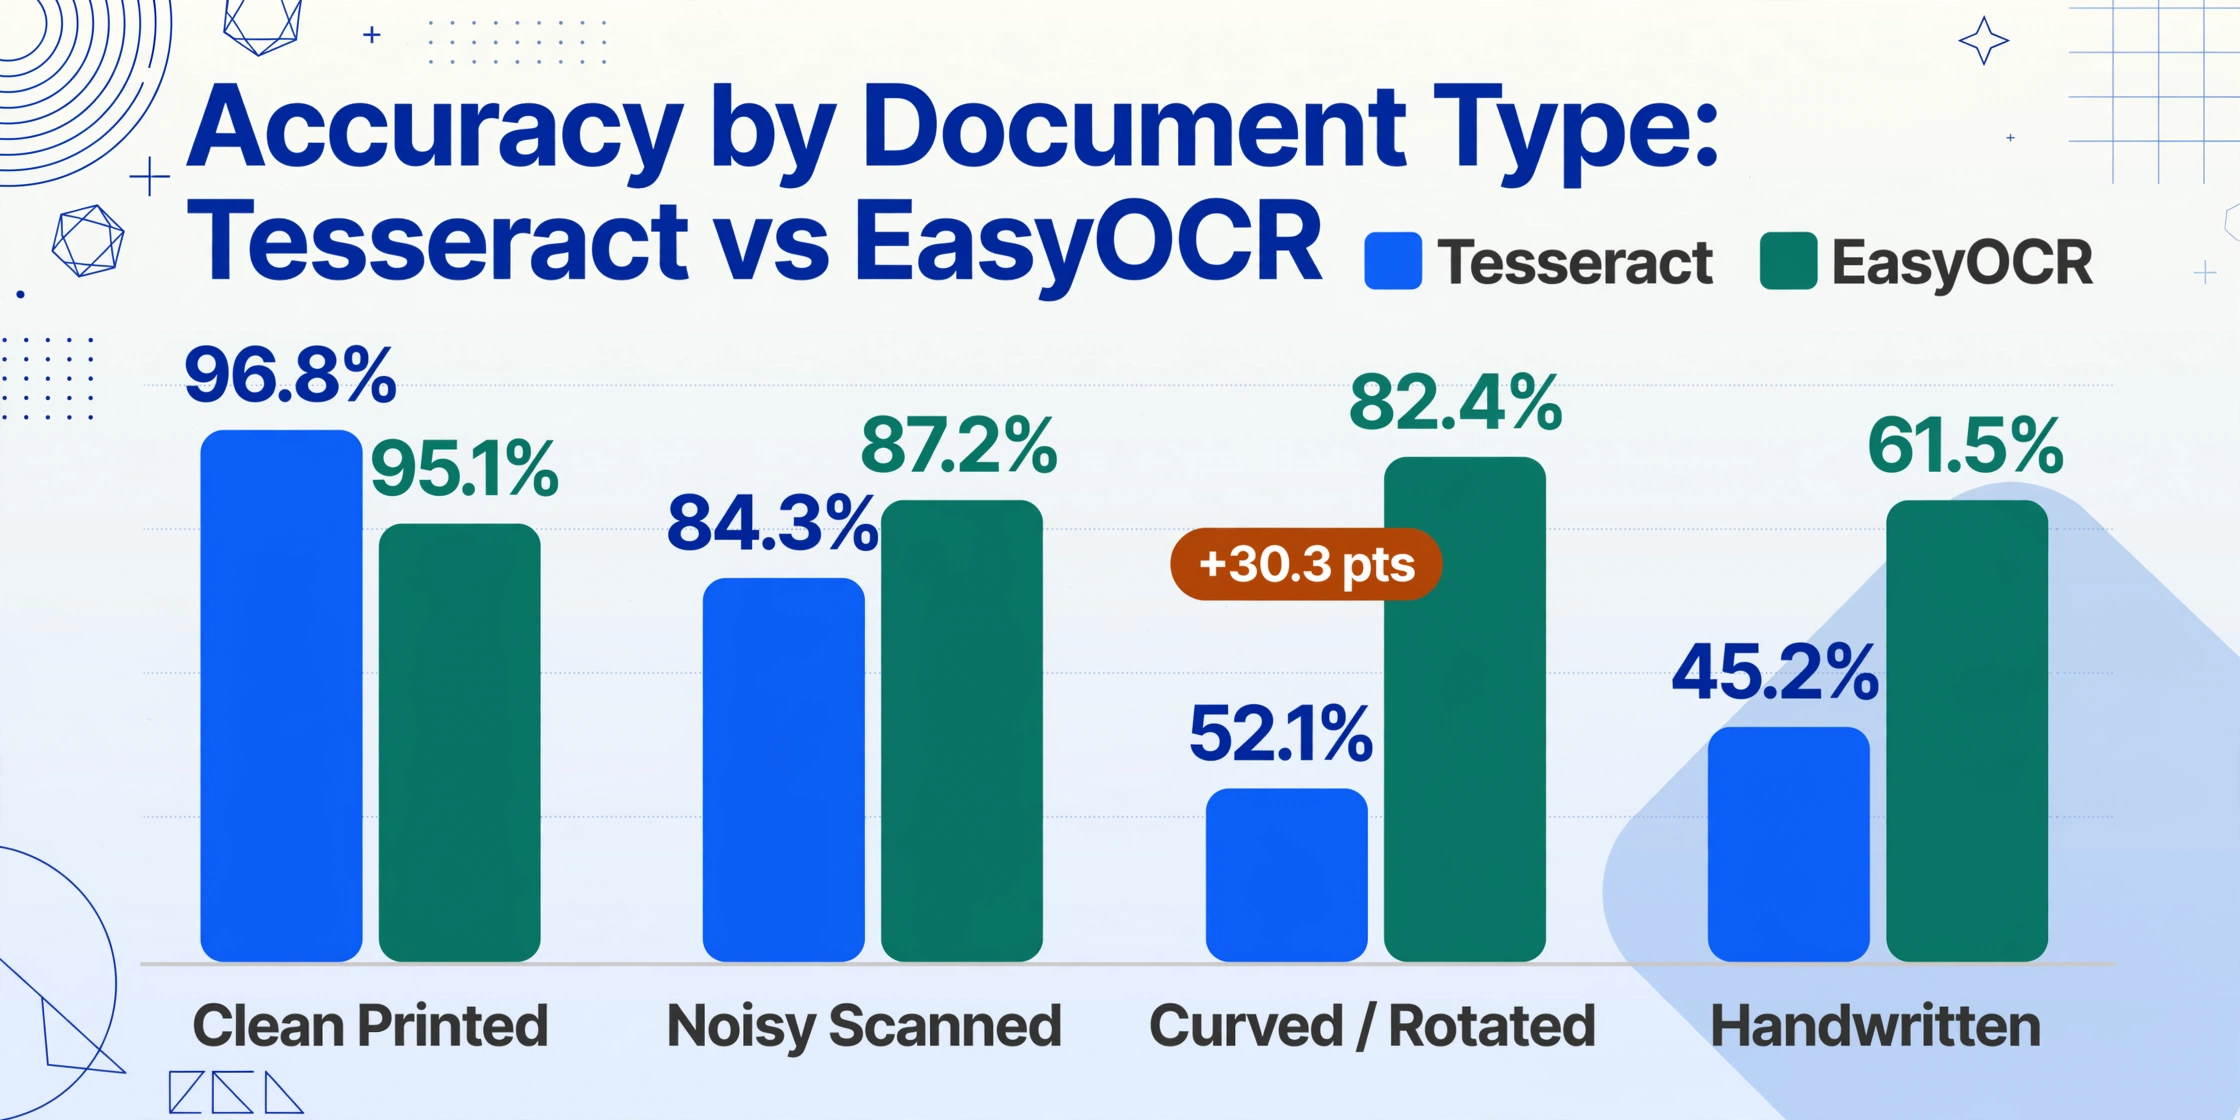
ここが両エンジンの違いが最も顕著に表れる点です。GigaGPUによる独立したベンチマークでは、Tesseract 5とEasyOCRを4つの文書難易度レベルでテストしました。その結果、明確なパターンが明らかになっています。きれいでまっすぐな印刷テキストでは差は小さいものの、それ以外のケースでは急速に差が広がります。
| 文書タイプ | Tesseract 5 | EasyOCR | 差 |
|---|---|---|---|
| きれいな印刷英語 | 96.8% | 95.1% | Tesseract +1.7% |
| ノイズのあるスキャン文書 | 84.3% | 87.2% | EasyOCR +2.9% |
| 湾曲・回転テキスト | 52.1% | 82.4% | EasyOCR +30.3% |
| 手書きテキスト | 45.2% | 61.5% | EasyOCR +16.3% |
湾曲・回転テキストの数値は誤植ではありません。Tesseractの従来型コンピュータビジョンパイプラインは、テキストが完全に水平でない場合に機能しなくなります。このレガシーエンジンは、縦横が揃った単一カラムのスキャン文書向けに設計されたためです。EasyOCRのCRAFTベースのテキスト検出器は、回転が標準であるシーンテキストデータでトレーニングされているため、任意の向きをそのまま処理できます。
手書き文字の差も同様に構造的なものです。Tesseract 5のLSTMエンジンは主に印刷コーパスデータでトレーニングされています。一方、EasyOCRの認識モデルは、80以上の言語の多くで手書きサンプルを含む混合データでトレーニングされており、大きなアドバンテージを持っています。ただし、61.5%は後処理なしでは本番運用にはまだ低すぎます。
ほとんどの比較が見落とす重要なニュアンス — 障害モードのパターン:Tesseractのエラーは回復不能な傾向があります。文字の誤読(「Qty」の代わりに「ay」)は、文字列比較では正しく見えるが意味的には間違った出力を生成します。EasyOCRのエラーは、予測可能なシグネチャを残すことが多くなります。文字の繰り返し、低信頼度の検出(< 0.5)、パディングアーティファクト(~ や [ の文字)などです。2026 EasyOCR監査で実証されたように、これらのシグネチャは正規表現とファジーマッチングのパスでクリーンアップできます。Tesseractの失敗は後処理では回復できません。代わりに、より良い入力前処理が必要です。
速度:CPU vs GPU
これは、TesseractとEasyOCRのあらゆる議論の中で最も誤解されている点です。「Tesseractの方が速い」という一般的な主張は、CPU上でのみ正しく、それもバッチサイズと画像解像度に依存します。
| 指標 | Tesseract 5(CPU) | EasyOCR(CPU) | EasyOCR(GPU、RTX 3090) |
|---|---|---|---|
| 1分あたりのページ数 | 約25 | 約8 | 約60 |
| 1ページあたりの時間 | 約0.82秒 | 約2.45秒 | 約0.85秒 |
| 100ページのバッチ | 約82秒 | 約245秒 | 約85秒 |
CPUの場合:Tesseractは1ページあたりEasyOCRより約3倍高速です。数千枚の文書をバッチ処理する場合、その差は時間単位に膨らみます。CPUのみのサーバー(エアギャップシステムや古いクラウドインスタンスなど、制限された環境で一般的)で実行している場合、Tesseractが実用的な選択肢です。
GPUの場合:CUDAアクセラレーションを備えたEasyOCRは、その差をほぼ完全に埋め、RTX 3090で1分あたり約60ページを処理します。このスループットでは、10,000枚の請求書のバッチは3時間未満で完了します。TesseractにはGPUパスがまったくなく、常にCPUで実行されるため、相手側にGPUがある瞬間にその速度面での利点は消滅します。
したがって、本当の問いは「どちらが速いか」ではなく、「パイプラインにGPUがあるかどうか」です。ある場合、Tesseractの速度面での主張は消えます。ない場合、Tesseractの方が大幅に高速です。
言語サポート
両エンジンとも主要な世界言語をカバーしていますが、対応範囲、使いやすさ、言語ごとの品質に違いがあります。
Tesseract は tessdata リポジトリを通じて100以上の言語をサポートしています。コミュニティは20年にわたり学習済みモデルを提供し続けており、古代ギリシャ語、イヌクティトゥット語、いくつかの先住民族言語などのあまり一般的でない文字体系もカバーしています。ただし、品質にはばらつきがあり、学習コーパスが少ない言語(10,000ページ未満の学習ページ)では精度が大幅に低下します。各言語の .traineddata ファイルを手動でダウンロードし、-l フラグで指定する必要があるため、多言語プロジェクトでは導入の複雑さが増します。
EasyOCR は80以上の言語をカバーし、初回使用時に自動的に取得される事前ダウンロード済みモデルを同梱しています。すべてのサポート言語が同じ深層学習パイプラインを通過し、最新のコーパスデータで学習されているため、品質の下限が高くなっています。中国語、日本語、韓国語、アラビア語、デーヴァナーガリー文字などの非ラテン文字言語は、モデルが最初からそれらを処理するように設計されているため、EasyOCR の特に強みとなっています。Reddit の r/MachineLearning コミュニティは、日本語および混在スクリプト文書における EasyOCR の優位性に言及しています。
実用的な推奨事項: 英語のみ、またはラテン文字のみのパイプラインでは、両エンジンの性能は同程度です。CJK、アラビア語、または混在スクリプト文書を必要とするプロジェクトでは、EasyOCR の方が設定の手間が少なく、はるかに優れた結果を生み出します。Tesseract のみがカバーする希少な言語が必要な場合は、追加のセットアップコストを支払う価値があります。
出力品質とAPI設計
生の精度数値に加えて、各エンジンが出力を提供する方法は、下流の処理に実際的な影響を与えます。
Tesseractは、デフォルトでpytesseract.image_to_string()を介してプレーンテキストを返します。バウンディングボックスが必要な場合は、image_to_data()またはimage_to_boxes()を使用します。これらは、文字単位または単語単位の座標を持つTSV形式のデータを出力します。構造化出力(たとえば、Invoice Number、Date、Totalを含むテーブル)を取得するには、Tesseractのバウンディングボックスの上にレイアウト解析コードを記述する必要があります。これは、エンジンにドキュメント構造の概念がないためです。行を読み取りますが、右上の数字が請求書の合計であることは理解しません。
EasyOCRは、それぞれ[bounding_box, text, confidence]を含む辞書のリストを返します。この構造化形式は、信頼度しきい値によるフィルタリング、位置による並べ替え、または下流のレイアウトパーサーへの供給にすぐに使用できます。検出ごとに信頼度スコアが含まれることは、実際的な大きな利点です。低信頼度の結果をプログラムで破棄したり、人間によるレビューのためにフラグを立てたり、別のOCRバックエンドにルーティングしたりできます。
実際的な違い: 半構造化ドキュメント(発注書、運転免許証、証明書)から特定のフィールドを抽出する必要がある場合、EasyOCRのより豊富な出力形式により、統合ステップが1つ省けます。全ページから生のテキストだけが必要な場合(書籍のスキャン、新聞記事、手紙)、Tesseractのプレーンテキスト出力で十分であり、処理も高速です。
どちらのエンジンも、ドキュメント抽出パイプラインが最終的に必要とする種類の構造化出力(意味的フィールドにマッピングされた列データ)を生成しません。このギャップこそが、Unstract 2026 OCR評価でTesseractとEasyOCRの両方が「従来型」エンジンに分類され、フィールドと値のペアを直接出力できるVLMベースのモデルとは区別された理由です。最終目標が生のOCRテキストではなく、抽出された請求書フィールドのスプレッドシートである場合、どちらのエンジンの上にも意味的抽出レイヤーがまだ必要です。現代のAI抽出が従来のOCRとどう異なるかを詳しく知りたい場合は、比較記事OCRとAI抽出でアーキテクチャの移行について説明しています。
Tesseractが適しているケース
Tesseractは、ドキュメントが予測可能で、インフラに制約がある場合に適した選択肢です。
- CPUのみのサーバー環境 — TesseractのCPUでの処理速度は毎分25ページで、EasyOCRの毎分8ページよりも高速です。また、EasyOCRにはGPUオプションがありません。
- 高品質なクリーン文書の大量バッチ — すべての請求書が同じERPから、すべてのレシートが同じPOSシステムから来ており、テキストが常に正立で明るく撮影されている場合、Tesseractのクリーンテキストに対する96.8%の精度で十分です。偶発的なエラーを修正するコストは、深層学習エンジンの追加計算コストよりも低く抑えられます。
- 組み込みシステムとDockerイメージ — 約10MBのインストールサイズは、1メガバイト単位でリソースが重視される制約のある環境に簡単に収まります。
- 画像前処理をすでに含むパイプライン — OpenCVベースの前処理ステップ(傾き補正、ノイズ除去、2値化)がすでにある場合、Tesseractの出力は大幅に向上します。前処理に投資するチームは、湾曲テキストと手書き文字を除けば、EasyOCRとの精度差を埋めることがよくあります。
- CPUのみの処理を義務付けるコンプライアンス要件 — 一部の規制業界では、すべての処理をCPUのみのハードウェアで行うことが求められます。そのシナリオでは、Tesseractは単に優れているだけでなく、2つのうちで唯一実用的な選択肢です。
これら2つ以外の無料OCRオプションの広範な概要については、2026年の最高の無料OCRソフトウェアガイドをご覧ください。
EasyOCRが適しているケース
EasyOCRは、文書の多様性や精度要件がTesseractの限界を超える場合に、より重いインストールと遅いCPUパフォーマンスを正当化します。
- ノイズのある文書や実世界の文書画像 — スマートフォンで撮影したレシートの写真、コーヒーの染みがあるスキャン済みフォーム、圧縮アーティファクトのあるFAX文書など。EasyOCRの深層学習検出パイプラインは、Tesseractのしきい値ベースのアプローチよりもこれらの条件を大幅にうまく処理します。
- 多言語文書 — EasyOCRの自動モデルダウンロードと80以上の言語にわたる一貫した品質により、2つ以上のスクリプトを扱うプロジェクトでは労力が少ない選択肢となります。
- GPU利用可能な環境 — CUDAアクセラレーションにより、EasyOCRはTesseractの速度に匹敵しながら、文書の難易度に応じて5〜30パーセントポイント高い精度を提供します。
- 構造化出力の要件 — パイプラインで信頼度スコア、バウンディングボックス、または検出ごとのメタデータが必要な場合、EasyOCRは追加の解析コードなしでこれらを標準で提供します。
- 迅速なプロトタイピングとノートブック — EasyOCRの3行のセットアップと自動モデルダウンロードにより、Jupyter Notebookでの探索、ハッカソンプロジェクト、セットアップ速度が本番最適化よりも重要となる概念実証作業に最適です。
プロジェクトで生のOCRと、請求書番号、合計、ベンダー名などの構造化フィールドへの最終的な意味的抽出の両方が必要な場合は、この比較の後に構造化出力のためのOCR APIガイドを読むことをお勧めします。
結論:シナリオに基づく判断
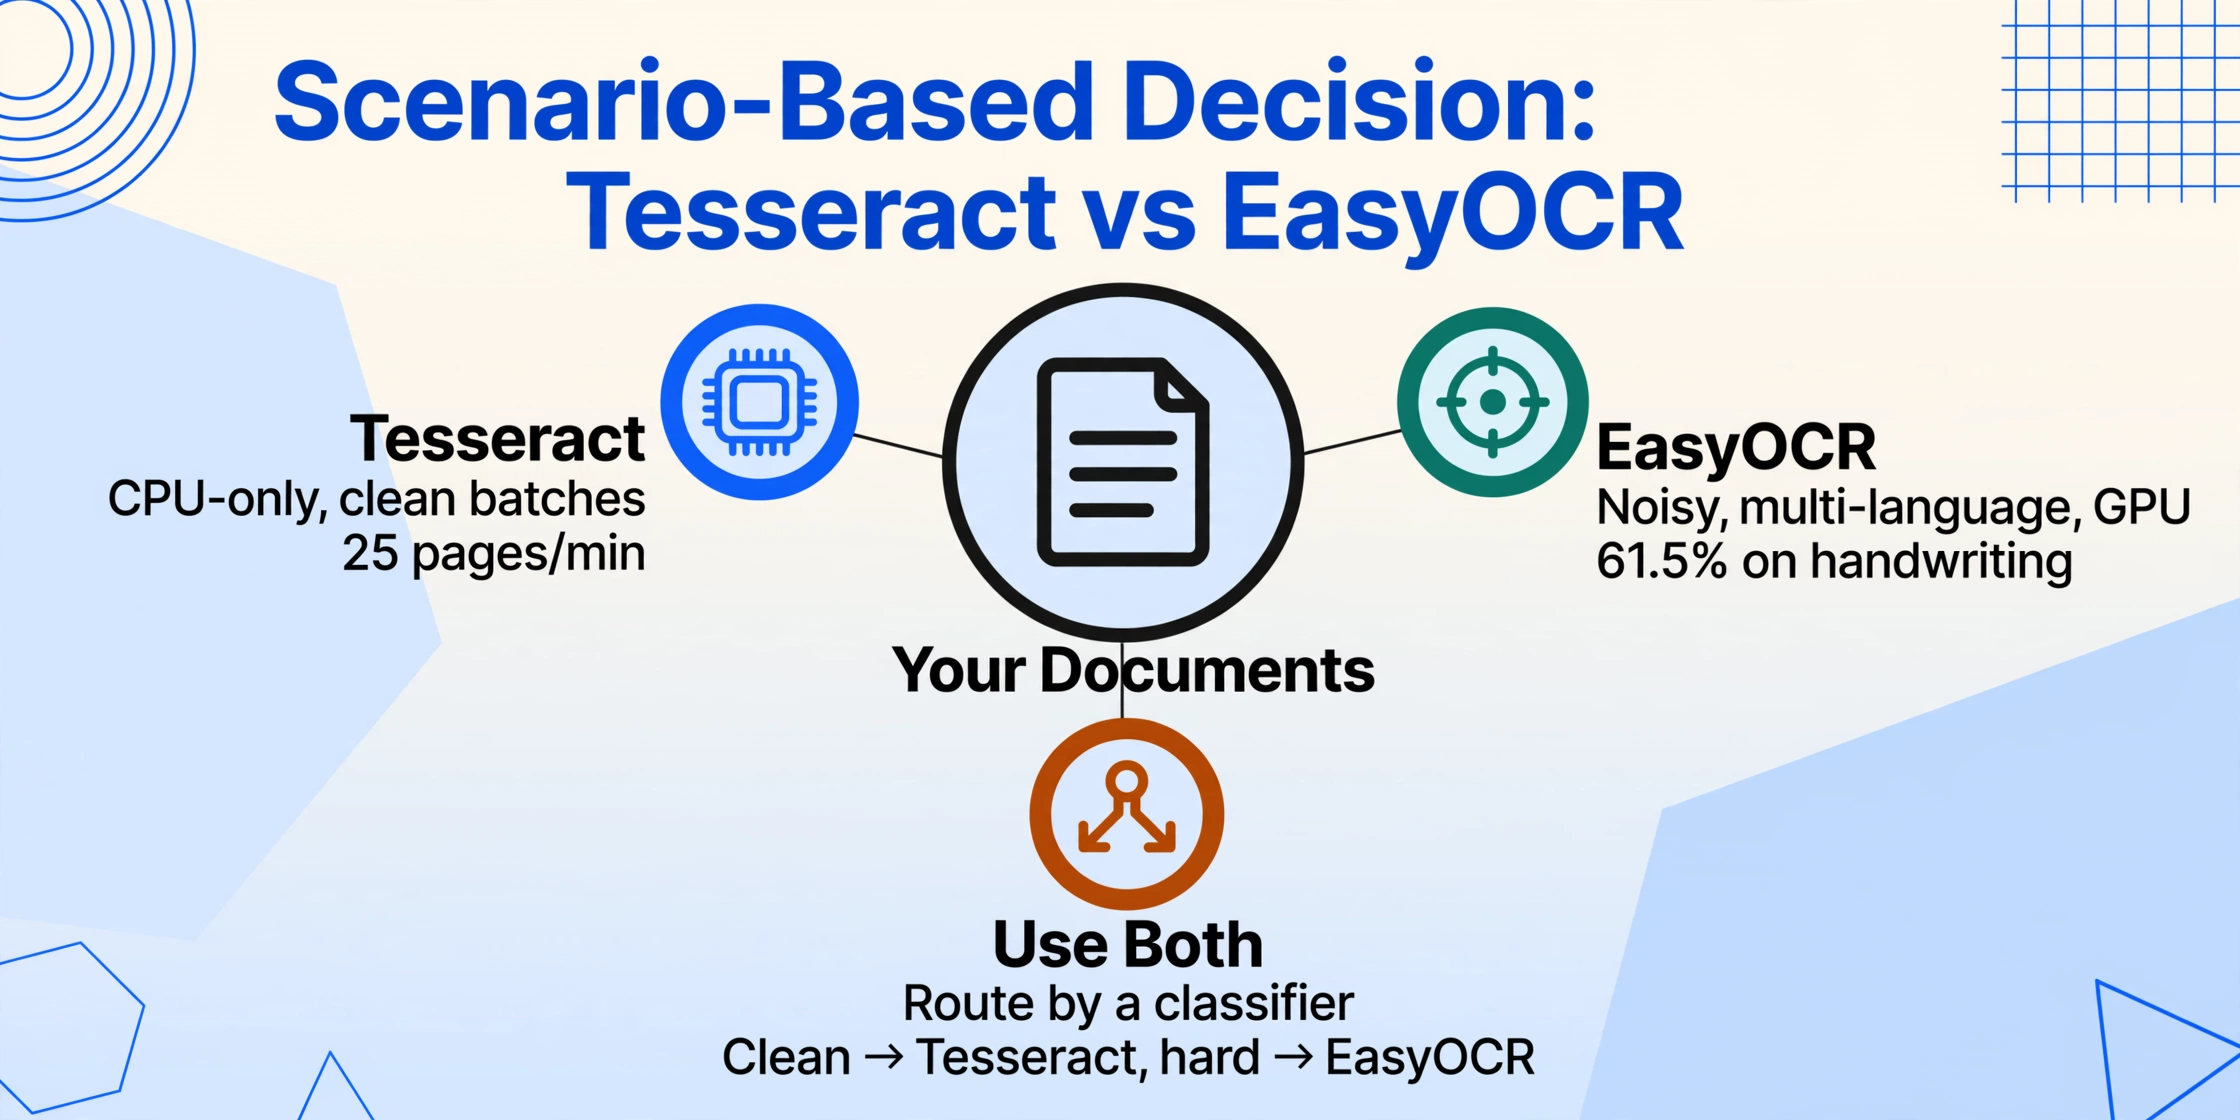
どちらのエンジンも、普遍的に「優れている」わけではありません。適切な選択は、ドキュメントの種類、ハードウェア、後処理への許容度によって異なります。以下の判断マトリクスは、最も一般的なシナリオを推奨エンジンに対応づけたものです。
| シナリオ | 推奨エンジン | 理由 |
|---|---|---|
| クリーンなスキャン済み請求書、同一ベンダー形式、大量処理 | Tesseract | CPUで高速、96.8%の精度で十分、軽量 |
| モバイルで撮影したレシート写真、品質が不安定 | EasyOCR | 深層学習がノイズ、回転、混在フォントに対応 |
| 多言語ドキュメント | EasyOCR | CJK/アラビア語のサポートが優れ、自動ダウンロード、高精度 |
| CPUのみのDockerコンテナ、500 MBの予算 | Tesseract | 10 MBのインストール、GPU非依存、CPU速度3倍 |
| 手書きのフォーム、歴史的資料 | EasyOCR | 61.5%対45.2% — 依然として低いが、後処理で回復可能 |
| バッチパイプライン、GPU利用可能、1日1万件以上 | EasyOCR | GPUでTesseractと同等の速度、高精度、構造化出力 |
| フィールドレベルの抽出が必要 | 単独では不十分 | どちらも生のテキストを出力するだけで、構造化フィールドは生成しない。意味的抽出レイヤーを追加するか、AI抽出の比較を参照 |
多くの本番パイプラインで採用されている実用的な戦略は、両方を使うことです。クリーンなドキュメントはTesseractにルーティングして速度を確保し、難しいドキュメントはEasyOCRに送って精度を確保します。画像解像度、ファイルサイズ、または簡単なエントロピーチェックによる単純な分類器を前面に配置すれば、1つのエンジンに依存することなく、両方の利点を活かせます。
また、プロジェクトで最終的に構造化データが必要な場合、OCRテキストだけではTesseractもEasyOCRも単独では対応できません。その場合は、VLMで自前で構築するか、構造化出力向けに設計されたツールを使用するかに関わらず、その上に意味的抽出レイヤーが必要です。オープンソースOCRツールの比較では、VLMベースのオプションを含む全体像を解説しています。
重要な洞察
TesseractとEasyOCRの差は、技術そのものではなく文書の難易度にあります。Tesseractは、きれいな印刷文書の80%をうまく処理します。EasyOCRは、ノイズがある、回転している、または手書きの残り20%を処理します。適切なパイプライン設計は、両方の範囲を認識し、それに応じてルーティングします。
よくある質問
TesseractとEasyOCRではどちらが高速ですか?
CPUでは、Tesseractが約3倍高速で、毎分約25ページに対し、EasyOCRは毎分8ページです。GPUでは、EasyOCRは毎分約60ページに達し、Tesseractのスループットに匹敵または上回りながら、より高い精度を実現します。答えは、GPUアクセラレーションが利用可能かどうかに完全に依存します。
全体的にどちらがより正確ですか?
きれいでまっすぐな印刷テキストでは、ほぼ互角です(Tesseract 96.8% vs EasyOCR 95.1%)。ノイズがある、湾曲した、または手書きの文書では、EasyOCRが3〜30パーセントポイントリードします。文書が常にきれいであれば、精度の差は無視できます。品質がさまざまな場合は、EasyOCRの深層学習パイプラインが有意な差をもたらします。
TesseractやEasyOCRは手書きを処理できますか?
どちらも手書きには苦労しますが、EasyOCRの方が優れています(精度61.5% vs 45.2%)。追加のトレーニングや手書き専用のモデルパイプラインなしでは、本番環境での手書き認識にはどちらも適していません。参考までに、olmOCRやQwen2.5-VLなどの最新のVLMは、はるかに高い計算要件を犠牲にして、手書き精度を大幅に向上させます。
TesseractはGPUアクセラレーションをサポートしていますか?
いいえ。Tesseract 5.xは設計上CPUのみです。将来のバージョンでのGPUサポートについてはコミュニティで議論が続いていますが(Tesseract 2026年の計画スレッドを参照)、2026年半ば時点ではGPUパスはありません。EasyOCRはCUDAを使用してGPUアクセラレーションを実現し、PyTorch互換のGPUで動作します。
両方とも完全に無料ですか?
はい。Tesseract(Apache 2.0、Google管理)とEasyOCR(Apache 2.0、Jaided AI)はどちらも完全なオープンソースであり、商用利用も無料です。利用制限、レート制限、APIコストはありません。唯一のコストは、それらを実行するためのインフラストラクチャ(CPU時間、メモリ、必要に応じてGPUコンピューティング)です。
これらのツールは、請求書番号や合計金額などの構造化データを抽出できますか?
直接はできません。両エンジンはOCRテキスト(ページ上の文字や単語)を生成します。特定のフィールド(請求書番号、支払期日、明細項目)を抽出するには、追加のロジック(正規表現ベースの解析、バウンディングボックス上のレイアウト解析、または意味的抽出レイヤー)が必要です。請求書、領収書、フォームからフィールドレベルの構造化出力が必要なプロジェクトでは、OCR+解析に依存するのではなく、文書の意味をネイティブに理解するAIネイティブ抽出ツールを評価することをお勧めします。
OCRテキストから構造化データへ — パイプライン作業なしで
ここまで読んでいただければ、核心的な課題をご理解いただけたはずです:TesseractやEasyOCRはテキストを出力しますが、ビジネスプロセスに必要な構造化フィールドは出力しません。ImageToTable.aiのAI抽出は、ドキュメントからスプレッドシートへ直接変換します — OCRエンジンの調整も、後処理の正規表現も、レイアウト解析も不要です。請求書をアップロードし、必要な列(請求書番号、合計金額、取引先)を指定するだけで、AIが各値をページ上の位置ではなく意味を理解して特定します。
印刷ドキュメントで最大99%の精度、数百ファイルのバッチ処理、Excel/Google Sheetsへの直接エクスポートにより、この比較が説明してきたギャップ — OCRテキストと実用的なデータの距離 — を埋めます。