Tesseract vs EasyOCR 2026:
¿Qué OCR de código abierto se adapta a tu proyecto?
Esta comparación está escrita desde la perspectiva de un desarrollador o ingeniero de datos que elige entre dos motores OCR gratuitos y autohospedados para un pipeline de procesamiento de documentos. Tesseract — el motor de código abierto de Google con 40 años de antigüedad — es ligero, rápido en CPU y destaca con texto impreso limpio. EasyOCR — una biblioteca nativa de PyTorch de Jaided AI — utiliza aprendizaje profundo para detección y reconocimiento en una sola pasada, sacrifica velocidad por precisión en documentos difíciles y te ofrece aceleración por GPU cuando la necesitas. La pregunta no es cuál es "mejor". Es cuál de sus ventajas y desventajas coincide con tus documentos, tu hardware y tu tolerancia al postprocesamiento.
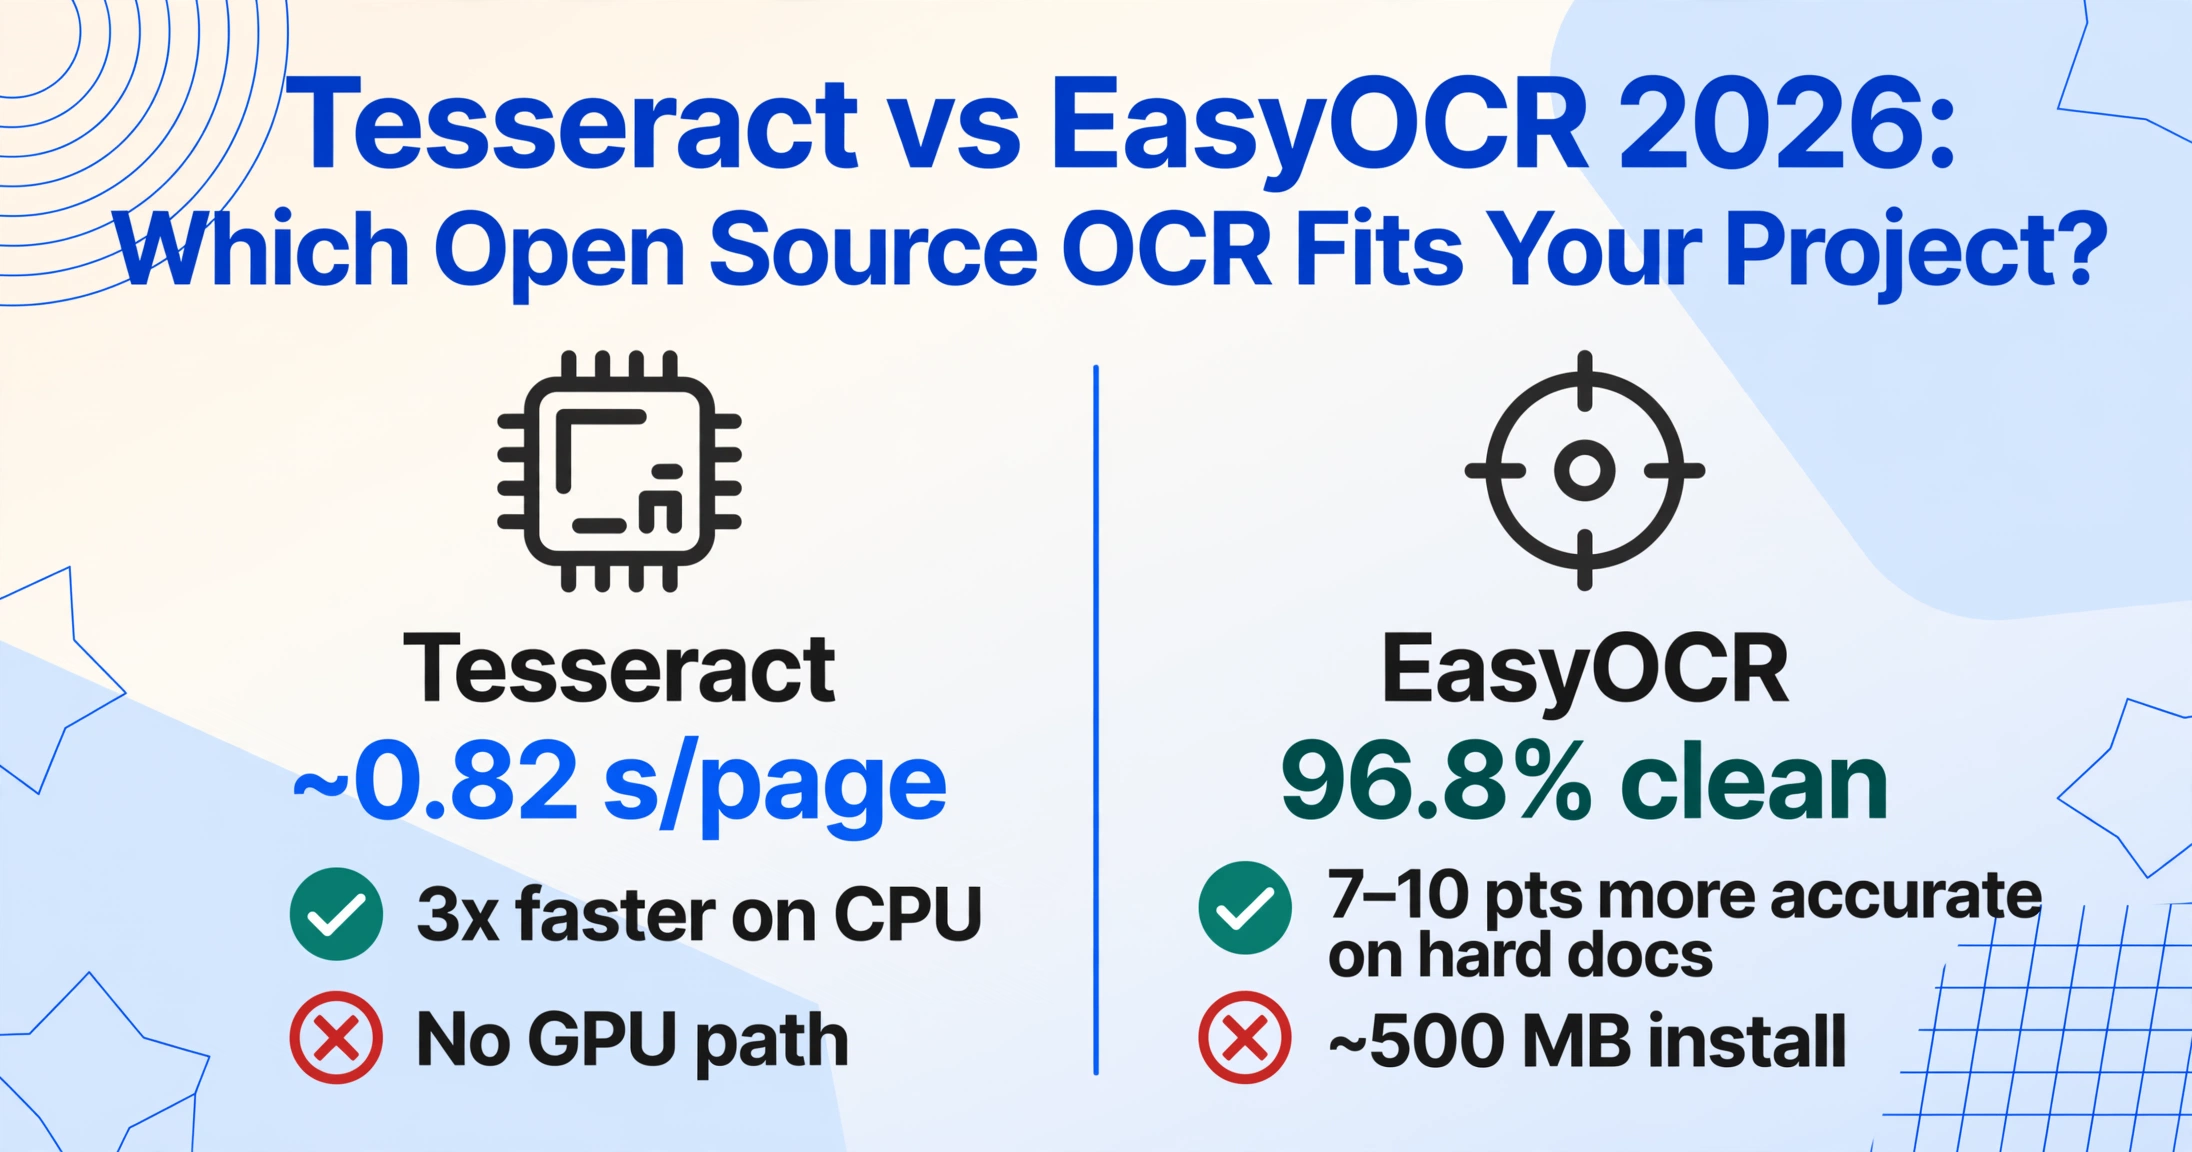
Conclusiones clave
- Dos motores OCR gratuitos, ambos con licencia Apache 2.0, ambos con una precisión declarada de ~90%+ — todos los artículos de comparación hacen que Tesseract y EasyOCR parezcan la misma herramienta con nombres diferentes.
- El número que realmente los diferencia no es la precisión sino la capacidad de recuperación de errores: los errores de lectura de Tesseract son silenciosos y permanentes, mientras que los fallos de EasyOCR dejan firmas que puedes detectar y limpiar con una expresión regular.
- Olvídate de los rankings de precisión — elige el motor cuyos errores tu pipeline de postprocesamiento pueda sobrevivir, porque los errores llegarán y la única pregunta es si los notarás.
Comparativa rápida: Tesseract vs EasyOCR
La siguiente tabla resume las diferencias clave en las dimensiones que más importan en un proyecto real. Estas cifras provienen de evaluaciones independientes realizadas por GigaGPU y CodeSOTA sobre conjuntos de prueba de documentos estándar. Los resultados pueden variar según la calidad de la imagen, el preprocesamiento y el tipo de documento.
| Dimensión | Tesseract 5.5 | EasyOCR |
|---|---|---|
| Tecnología central | Red neuronal LSTM + coincidencia de patrones heredada | Aprendizaje profundo basado en PyTorch (detector CRAFT + reconocedor CRNN) |
| Tiempo de procesamiento (por página) | ~0.82 s | ~2.45 s (CPU) / ~0.85 s (GPU) |
| Precisión (texto impreso limpio) | ~89.3% | ~96.8% |
| Tamaño de instalación | ~10 MB + datos de idioma | ~500 MB (backend PyTorch) |
| Soporte GPU | No (solo CPU) | Sí (CUDA 12.x) |
| Idiomas compatibles | 100+ | 80+ |
| Formato de salida | Texto plano (sin confianza ni cuadros delimitadores por defecto) | Lista estructurada (texto + confianza + cuadro delimitador por detección) |
| Licencia | Apache 2.0 | Apache 2.0 |
| Estrellas en GitHub | ~73,000+ | ~29,000+ |
La conclusión principal: Tesseract es 3 veces más rápido en CPU, pero EasyOCR es 7–10 puntos porcentuales más preciso en cualquier documento que no esté perfectamente limpio. La brecha se amplía drásticamente a medida que los documentos se vuelven más difíciles.
Instalación y Configuración
Tesseract gana en simplicidad si ya estás en un servidor Linux. Un solo apt-get install tesseract-ocr o brew install tesseract te da un motor OCR funcionando en menos de 30 segundos. El envoltorio de Python (pytesseract) es una capa delgada alrededor del binario del sistema. Peso total de dependencias: aproximadamente 10 MB para el motor, más archivos de datos de idioma adicionales según sea necesario. Si nunca has instalado Tesseract antes, nuestra guía de configuración para principiantes cubre los tres sistemas operativos y los errores comunes de la primera vez.
La desventaja: Tesseract requiere instalación manual de datos de idioma. Cada idioma necesita su propio archivo .traineddata descargado y colocado en el directorio tessdata. Para procesos que manejan 5 o más idiomas, esto se convierte en una preocupación de script de implementación, no en un comando de una sola línea.
EasyOCR es más pesado de instalar pero autónomo. Haces pip install easyocr y PyTorch viene como dependencia — aproximadamente 500 MB para el backend habilitado para CUDA. La primera vez que creas una instancia de Reader, EasyOCR descarga automáticamente los modelos de idioma necesarios. No hay gestión manual de archivos de datos, ni configuración de variables de entorno, ni dependencia de binarios del sistema.
Para desarrollo local y creación de prototipos, la instalación sin fricción de EasyOCR es una ventaja genuina. Para implementaciones con Docker, la capa de 500 MB de PyTorch es un costo que pagas una vez y almacenas en caché, por lo que el impacto a largo plazo es mínimo.
Veredicto sobre la instalación:
- Canales de CI/CD, imágenes de servidor, dispositivos integrados: la instalación de 10 MB de Tesseract es difícil de superar.
- Prototipos locales, cuadernos, proyectos multilingües: la descarga automática de EasyOCR y su configuración sin dependencias del sistema ganan.
Precisión por tipo de documento
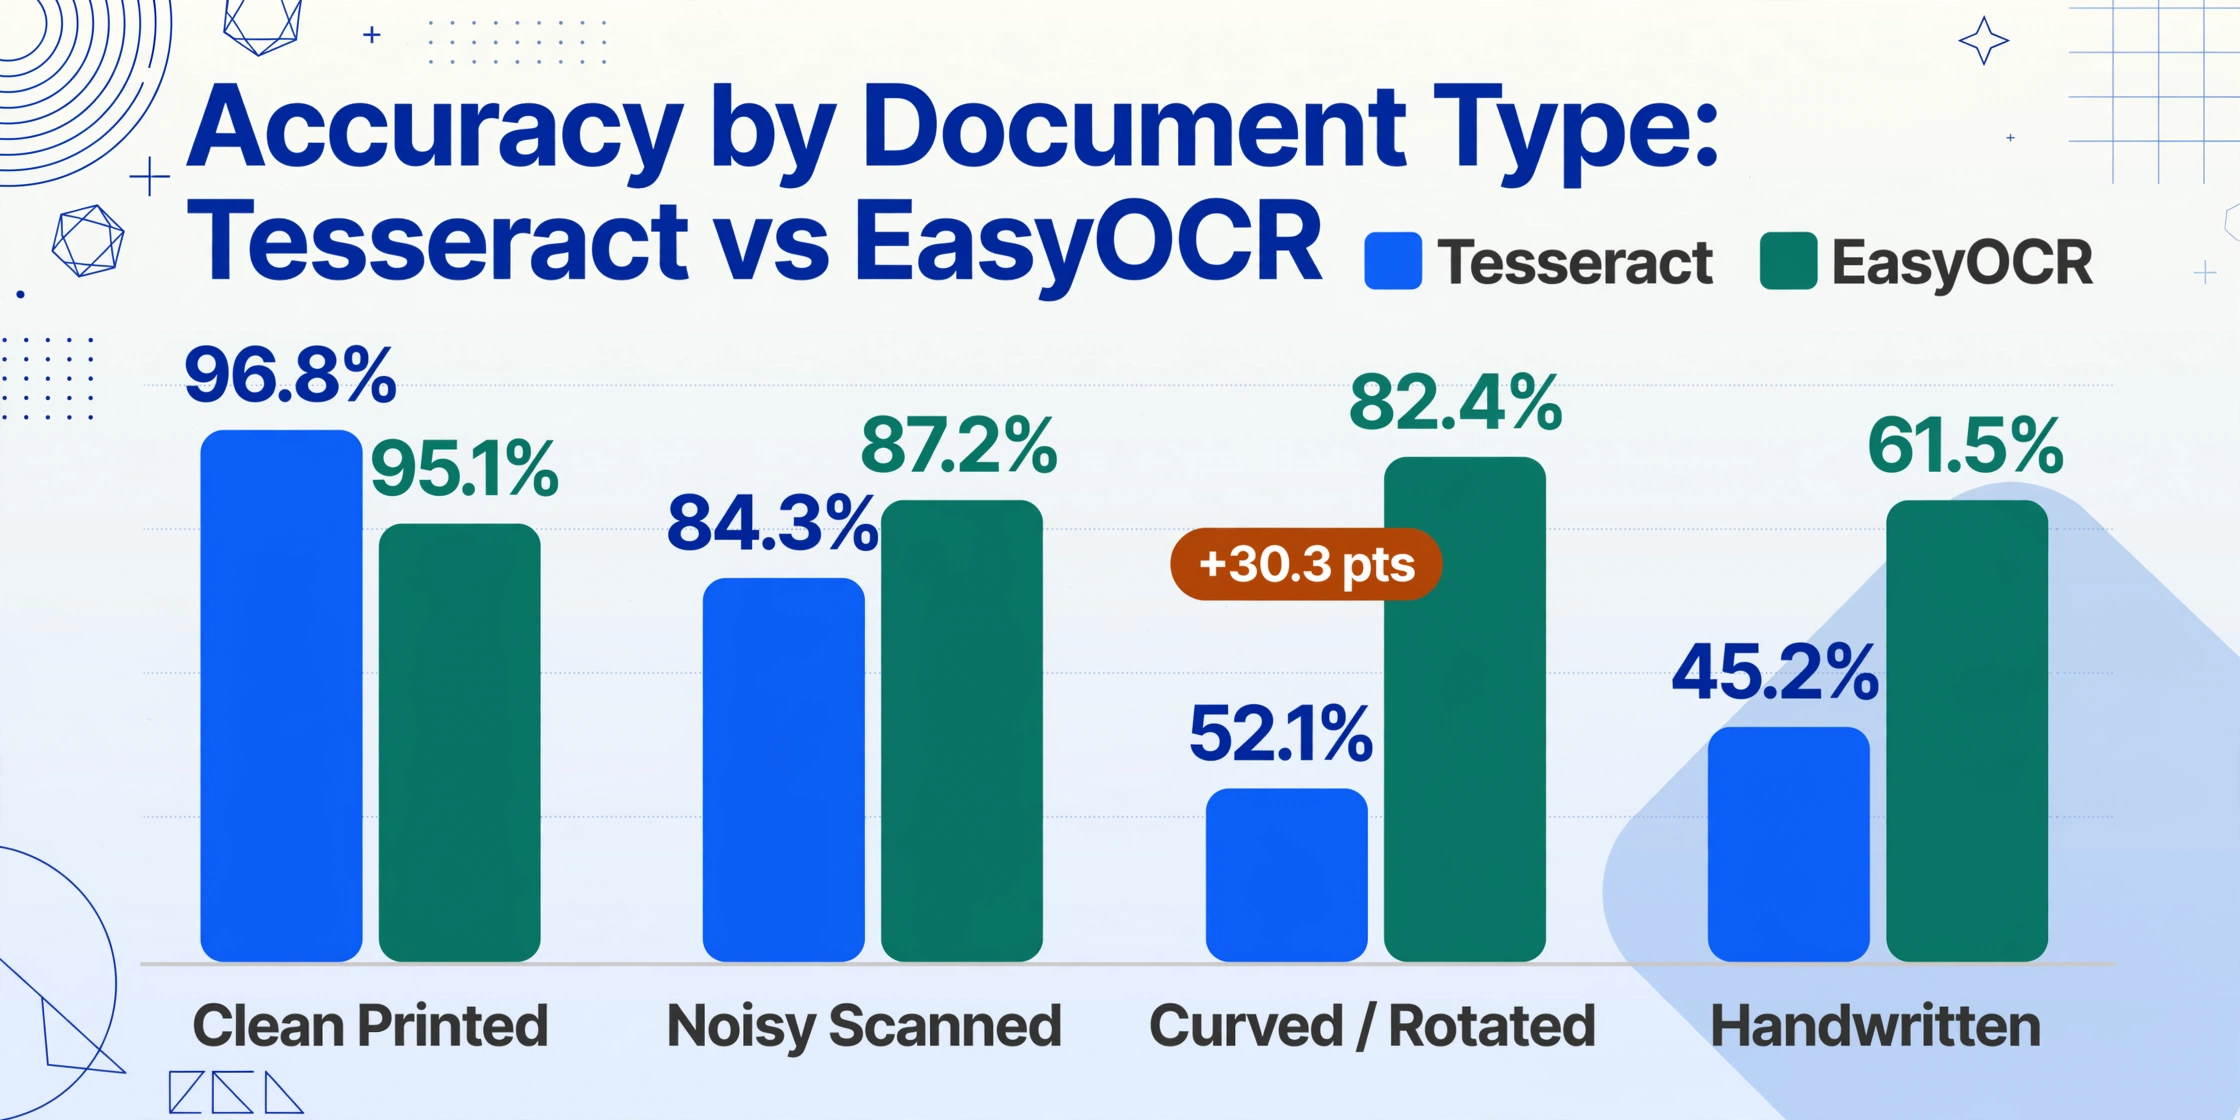
Aquí es donde los dos motores divergen de forma más significativa. Pruebas independientes de GigaGPU evaluaron Tesseract 5 y EasyOCR en cuatro niveles de dificultad documental. Los resultados revelan un patrón claro: en texto impreso limpio y recto, la diferencia es pequeña. En todo lo demás, se amplía rápidamente.
| Tipo de documento | Tesseract 5 | EasyOCR | Diferencia |
|---|---|---|---|
| Impreso limpio en inglés | 96.8% | 95.1% | Tesseract +1.7% |
| Documentos escaneados con ruido | 84.3% | 87.2% | EasyOCR +2.9% |
| Texto curvado / rotado | 52.1% | 82.4% | EasyOCR +30.3% |
| Texto manuscrito | 45.2% | 61.5% | EasyOCR +16.3% |
El número de texto curvado/rotado no es un error tipográfico. El pipeline tradicional de visión por computadora de Tesseract falla cuando el texto no está perfectamente horizontal: el motor heredado fue diseñado para páginas escaneadas verticales de una sola columna. El detector de texto basado en CRAFT de EasyOCR maneja orientaciones arbitrarias de forma nativa porque fue entrenado con datos de texto de escena donde la rotación es la norma.
La brecha en manuscritos es igualmente estructural. El motor LSTM de Tesseract 5 fue entrenado principalmente con datos de corpus impresos. El modelo de reconocimiento de EasyOCR fue entrenado con una mezcla que incluye muestras manuscritas en muchos de sus más de 80 idiomas, lo que le da una ventaja significativa — aunque 61.5% sigue siendo demasiado bajo para producción sin postprocesamiento.
Matiz crítico que la mayoría de las comparaciones omiten — patrones de modo de fallo: Los errores de Tesseract tienden a ser irrecuperables — una lectura incorrecta de un carácter ("ay" en lugar de "Qty") produce una salida que parece correcta en una comparación de cadenas pero es semánticamente errónea. Los errores de EasyOCR suelen dejar firmas predecibles: caracteres repetidos, detecciones de baja confianza (< 0.5) o artefactos de relleno (caracteres ~ y [). Como demostró la auditoría de EasyOCR 2026, estas firmas pueden limpiarse con una pasada de expresiones regulares y coincidencia difusa. Los fallos de Tesseract no pueden recuperarse con postprocesamiento — en su lugar, necesitas un mejor preprocesamiento de entrada.
Velocidad: CPU vs GPU
Esta es la dimensión más incomprendida en toda discusión entre Tesseract y EasyOCR. La afirmación popular de que "Tesseract es más rápido" es cierta solo en CPU — e incluso eso depende del tamaño del lote y la resolución de la imagen.
| Métrica | Tesseract 5 | EasyOCR (CPU) | EasyOCR (GPU, RTX 3090) |
|---|---|---|---|
| Páginas por minuto | ~25 | ~8 | ~60 |
| Tiempo por página | ~0.82 s | ~2.45 s | ~0.85 s |
| Lote de 100 páginas | ~82 s | ~245 s | ~85 s |
En CPU: Tesseract es aproximadamente 3 veces más rápido que EasyOCR por página. Para el procesamiento por lotes de miles de documentos, esa diferencia se acumula en horas. Si ejecutas en un servidor solo con CPU — común en entornos restringidos como sistemas aislados o instancias de nube más antiguas — Tesseract es la opción práctica.
En GPU: EasyOCR con aceleración CUDA casi cierra la brecha por completo, entregando ~60 páginas por minuto en una RTX 3090. Con ese rendimiento, un lote de 10,000 facturas se completa en menos de tres horas. Tesseract no tiene ruta de GPU en absoluto — siempre se ejecutará en CPU, y su ventaja de velocidad se desvanece en el momento en que el otro lado tiene una GPU.
La pregunta real, entonces, no es "cuál es más rápido" sino "¿tienes una GPU en tu flujo de trabajo?" Si es así, el argumento de velocidad a favor de Tesseract desaparece. Si no, Tesseract es sustancialmente más rápido.
Soporte de Idiomas
Ambos motores cubren los principales idiomas globales, pero difieren en amplitud, facilidad de uso y calidad por idioma.
Tesseract es compatible con más de 100 idiomas mediante su repositorio tessdata. La comunidad ha contribuido con modelos entrenados durante dos décadas, por lo que la cobertura incluye escrituras menos comunes como griego antiguo, inuktitut y varios idiomas indígenas. Sin embargo, la calidad varía mucho: los idiomas con corpus de entrenamiento pequeños (menos de 10 000 páginas de entrenamiento) producen una precisión significativamente menor. Debes descargar manualmente el archivo .traineddata de cada idioma y especificarlo con la bandera -l, lo que añade complejidad de implementación para proyectos multilingües.
EasyOCR cubre más de 80 idiomas e incluye modelos precargados que se descargan automáticamente en el primer uso. El nivel mínimo de calidad es mayor porque cada idioma compatible pasa por el mismo proceso de aprendizaje profundo, entrenado con datos de corpus modernos. Los idiomas con escrituras no latinas — chino, japonés, coreano, árabe, devanagari — son puntos fuertes particulares de EasyOCR, ya que el modelo se diseñó desde cero para manejarlos. La comunidad de Reddit r/MachineLearning ha señalado la ventaja de EasyOCR en documentos japoneses y de escritura mixta.
Recomendación práctica: Para flujos de trabajo solo en inglés o con escritura latina, ambos motores rinden de forma similar. Para cualquier proyecto que necesite CJK, árabe o documentos de escritura mixta, EasyOCR produce resultados sustancialmente mejores con menos esfuerzo de configuración. Si necesitas un idioma poco común que solo cubre Tesseract, el costo adicional de configuración vale la pena.
Calidad de Salida y Diseño de API
Más allá de las cifras de precisión, la forma en que cada motor entrega su salida tiene consecuencias prácticas para el procesamiento posterior.
Tesseract devuelve texto plano por defecto mediante pytesseract.image_to_string(). Si necesitas cuadros delimitadores, usas image_to_data() o image_to_boxes(), que generan datos en formato TSV con coordenadas por carácter o por palabra. Obtener una salida estructurada — por ejemplo, una tabla con Número de Factura, Fecha y Total — requiere que escribas código de análisis de diseño sobre los cuadros delimitadores de Tesseract, porque el motor no tiene concepto de estructura de documento. Lee líneas; no entiende que un número en la esquina superior derecha es el total de la factura.
EasyOCR devuelve una lista de diccionarios, cada uno con [bounding_box, text, confidence]. Este formato estructurado es inmediatamente utilizable para filtrar por umbral de confianza, ordenar por posición o alimentar un analizador de diseño posterior. La inclusión de una puntuación de confianza por detección es una ventaja práctica significativa: puedes descartar programáticamente resultados de baja confianza, marcarlos para revisión humana o enrutarlos a través de un backend de OCR diferente.
La diferencia práctica: Si necesitas extraer campos específicos de un documento semiestructurado (una orden de compra, una licencia de conducir, un certificado), el formato de salida más rico de EasyOCR te ahorra un paso de integración. Si solo necesitas texto sin formato de una página completa (un escaneo de libro, un artículo de periódico, una carta), la salida de texto plano de Tesseract es suficiente y más rápida de procesar.
Ninguno de los dos motores produce el tipo de salida estructurada que un pipeline de extracción de documentos necesita en última instancia — datos tabulares mapeados a campos semánticos. Esa brecha es la razón por la que la evaluación de OCR de Unstract 2026 clasificó tanto a Tesseract como a EasyOCR como motores "tradicionales", distintos de los modelos basados en VLM que pueden generar pares campo-valor directamente. Si tu objetivo final es una hoja de cálculo con campos de factura extraídos en lugar de texto OCR sin procesar, aún necesitas una capa de extracción semántica sobre cualquiera de los dos motores. Para un análisis más profundo de cómo la extracción moderna con IA difiere del OCR tradicional, nuestra comparación OCR vs extracción con IA cubre el cambio de arquitectura.
Cuándo Tesseract Tiene Más Sentido
Tesseract es la opción correcta cuando tus documentos son predecibles y tu infraestructura está limitada.
- Entornos de servidor solo con CPU — Las 25 páginas/min de Tesseract en CPU son más rápidas que las 8 páginas/min de EasyOCR, y no hay opción de GPU al otro lado.
- Lotes de documentos limpios de alto volumen — Si cada factura proviene del mismo ERP, cada recibo es del mismo sistema POS, y el texto está constantemente vertical y bien iluminado, la precisión del 96.8% de Tesseract en texto limpio es suficiente. El error ocasional es más barato de corregir que el costo computacional adicional de un motor de aprendizaje profundo.
- Sistemas embebidos e imágenes Docker — El tamaño de instalación de ~10 MB cabe fácilmente en entornos con recursos limitados donde cada megabyte importa.
- Pipelines que ya incluyen preprocesamiento de imágenes — Si ya tienes un paso de preprocesamiento basado en OpenCV (deskew, denoise, binarize), la salida de Tesseract mejora significativamente. Los equipos que invierten en preprocesamiento a menudo cierran la brecha de precisión con EasyOCR en todo excepto texto curvo y escritura a mano.
- Requisitos de cumplimiento que exigen procesamiento solo con CPU — Algunas industrias reguladas requieren que todo el procesamiento ocurra en hardware solo con CPU. En ese escenario, Tesseract no solo es mejor — es la única opción práctica entre los dos.
Para una visión más amplia de las opciones gratuitas de OCR más allá de estos dos, consulta nuestra guía del mejor software de OCR gratuito en 2026.
Cuándo EasyOCR Tiene Más Sentido
EasyOCR justifica su instalación más pesada y su rendimiento de CPU más lento cuando la variedad de documentos o los requisitos de precisión empujan a Tesseract más allá de sus límites.
- Imágenes de documentos ruidosas o del mundo real — Fotos de recibos tomadas con un teléfono, formularios escaneados con manchas de café, documentos por fax con artefactos de compresión. El pipeline de detección de aprendizaje profundo de EasyOCR maneja estas condiciones significativamente mejor que el enfoque basado en umbrales de Tesseract.
- Documentos multilingües — La descarga automática de modelos y la calidad consistente de EasyOCR en más de 80 idiomas lo convierte en la opción de menor esfuerzo para cualquier proyecto que maneje más de dos escrituras.
- Entornos con GPU disponible — Con aceleración CUDA, EasyOCR iguala la velocidad de Tesseract mientras ofrece 5–30 puntos porcentuales más de precisión, dependiendo de la dificultad del documento.
- Requisitos de salida estructurada — Si tu pipeline necesita puntuaciones de confianza, cuadros delimitadores o metadatos por detección, EasyOCR los proporciona de serie sin código de análisis adicional.
- Prototipado rápido y notebooks — La configuración de tres líneas de EasyOCR y las descargas automáticas de modelos lo hacen ideal para exploración en Jupyter notebook, proyectos de hackathon y trabajo de prueba de concepto donde la velocidad de configuración importa más que la optimización de producción.
Si tu proyecto necesita tanto OCR bruto como extracción semántica eventual en campos estructurados como Número de Factura, Total y Nombre del Proveedor, quizás quieras leer nuestra guía de APIs de OCR para salida estructurada después de esta comparación.
El Veredicto: Una Decisión Basada en Escenarios
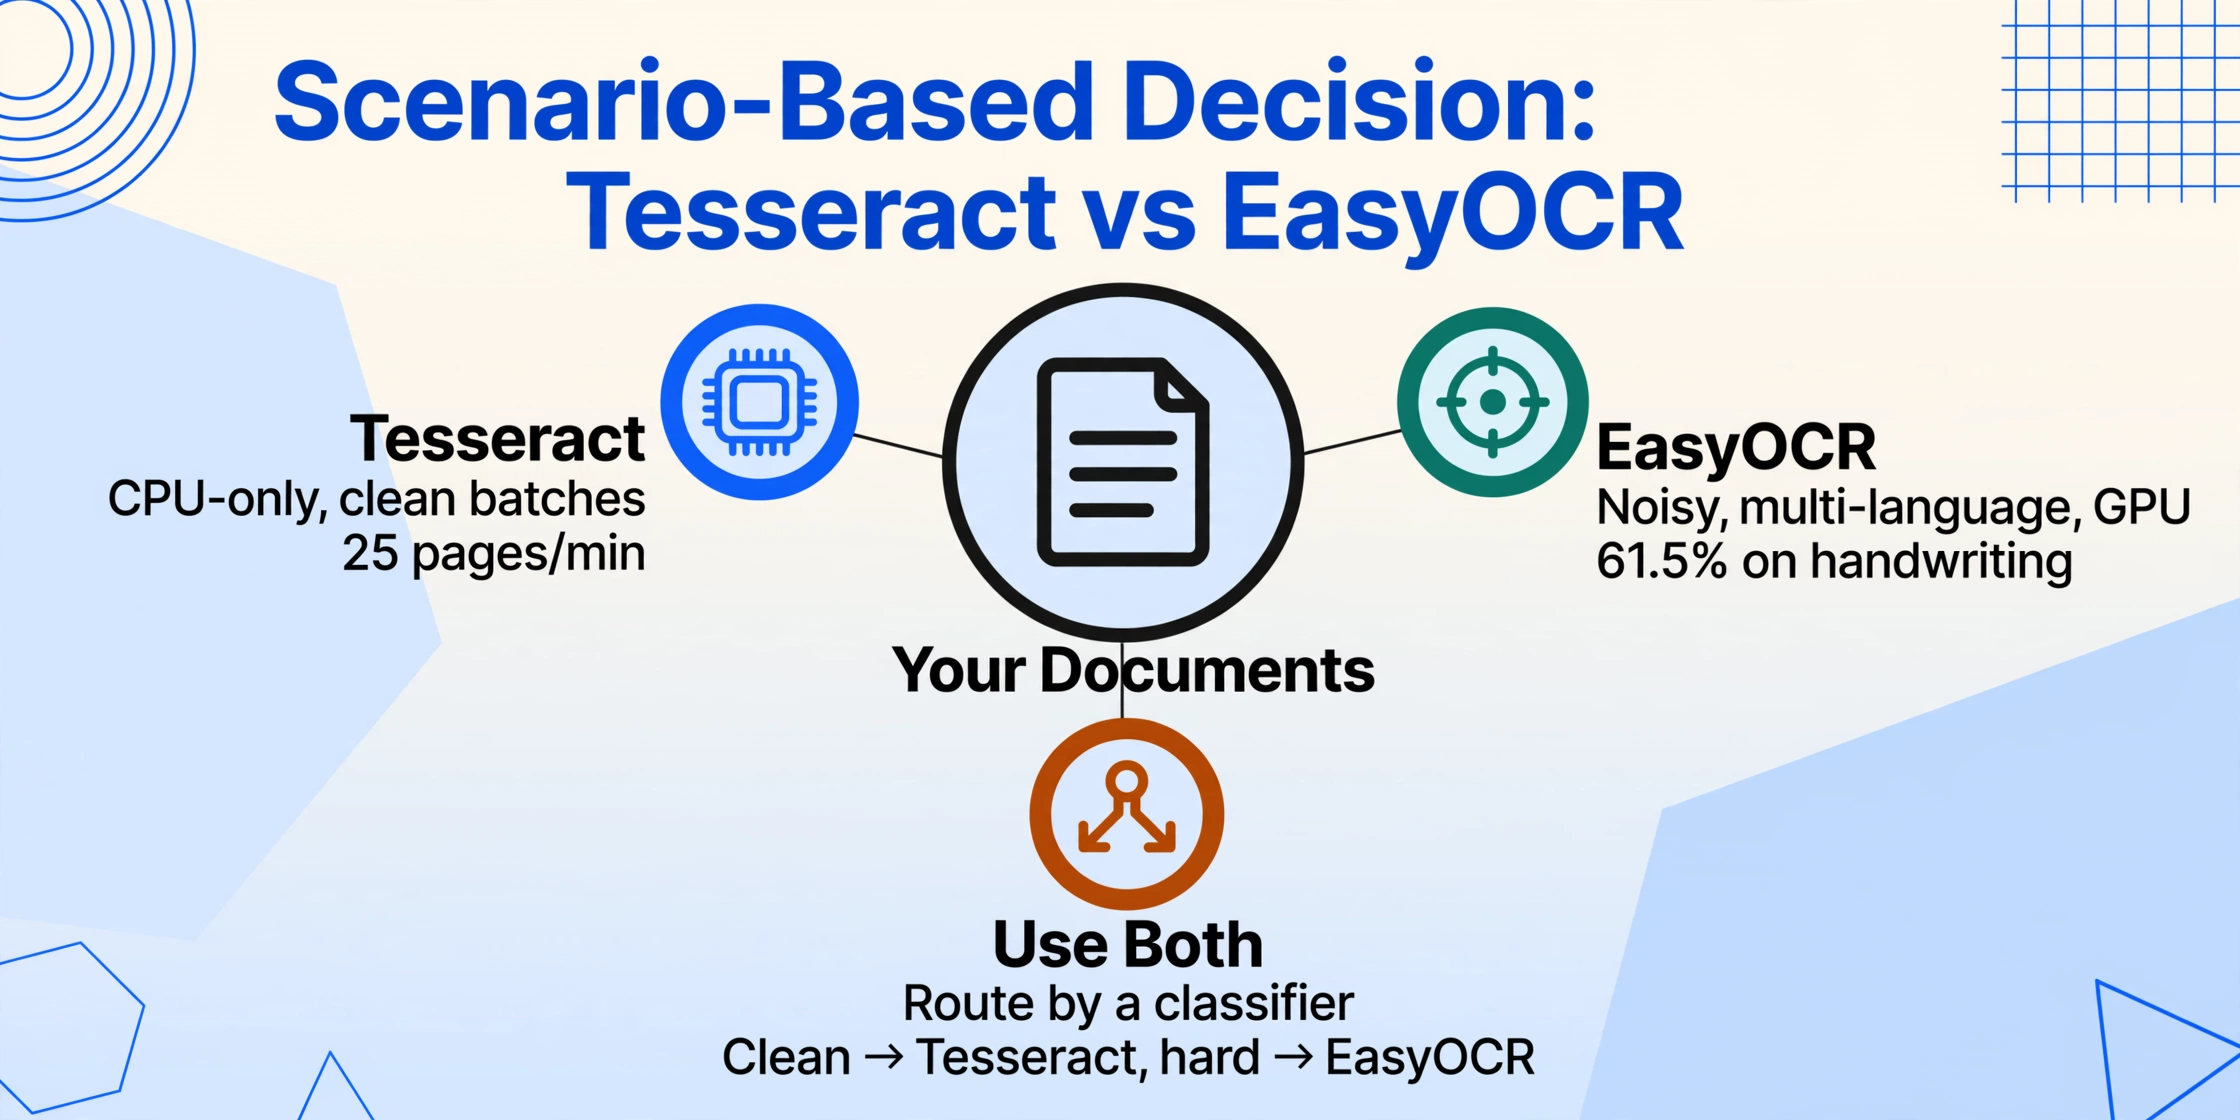
Ningún motor es universalmente "mejor". La elección correcta depende de tus documentos, tu hardware y tu tolerancia al postprocesamiento. La matriz de decisión a continuación asigna los escenarios más comunes al motor recomendado.
| Tu Escenario | Motor Recomendado | Por Qué |
|---|---|---|
| Facturas escaneadas limpias, mismo formato de proveedor, alto volumen | Tesseract | Rápido en CPU, precisión del 96.8% suficiente, huella ligera |
| Fotos de recibos desde móvil, calidad variable | EasyOCR | El aprendizaje profundo maneja ruido, rotación y fuentes mixtas |
| Documentos multilingües (CJK, árabe, mixtos) | EasyOCR | Mejor soporte para CJK/árabe, descarga automática, mayor precisión |
| Contenedor Docker solo con CPU, presupuesto de 500 MB | Tesseract | Instalación de 10 MB, sin dependencia de GPU, 3x velocidad en CPU |
| Formularios manuscritos, documentos históricos | EasyOCR | 61.5% frente al 45.2% — sigue siendo bajo, pero recuperable con postprocesamiento |
| Pipeline por lotes, GPU disponible, 10K+ documentos/día | EasyOCR | La GPU iguala la velocidad de Tesseract, mejor precisión, salida estructurada |
| Necesitas extracción a nivel de campo (N.º de factura, Total, Fecha) | Ninguno solo | Ambos producen texto sin formato, no campos estructurados. Añade una capa de extracción semántica o consulta nuestra comparación de extracción con IA |
Una estrategia práctica utilizada por muchos pipelines de producción: usa ambos. Enruta los documentos limpios a Tesseract para velocidad y envía los difíciles a EasyOCR para precisión. Con un clasificador simple al frente — resolución de imagen, tamaño de archivo o una verificación rápida de entropía — puedes capturar lo mejor de ambos mundos sin comprometerte con un solo motor para todo.
Y si tu proyecto finalmente necesita datos estructurados (Número de Factura, Monto Total, Nombre del Proveedor) en lugar de solo texto OCR, ni Tesseract ni EasyOCR te llevan allí por sí solos. Eso requiere una capa de extracción semántica encima — ya sea que la construyas tú mismo con un VLM o uses una herramienta diseñada para salida estructurada. Nuestra comparación de herramientas OCR de código abierto cubre todo el panorama, incluidas las opciones basadas en VLM.
Información clave
La diferencia entre Tesseract y EasyOCR no radica en la tecnología en sí, sino en la dificultad de los documentos. Tesseract maneja bien el 80% de documentos impresos y limpios. EasyOCR maneja el 20% restante que son ruidosos, rotados o manuscritos. Un diseño de pipeline adecuado reconoce ambos rangos y enruta en consecuencia.
Preguntas Frecuentes
¿Qué OCR es más rápido: Tesseract o EasyOCR?
En CPU, Tesseract es aproximadamente 3 veces más rápido — unas 25 páginas por minuto frente a las 8 páginas por minuto de EasyOCR. En GPU, EasyOCR alcanza ~60 páginas por minuto, igualando o superando el rendimiento de Tesseract con mayor precisión. La respuesta depende completamente de si dispones de aceleración por GPU.
¿Cuál es más preciso en general?
En texto impreso limpio y recto, están casi empatados (96.8% Tesseract vs 95.1% EasyOCR). En documentos ruidosos, curvados o manuscritos, EasyOCR lidera por 3 a 30 puntos porcentuales. Si tus documentos son siempre limpios, la diferencia de precisión es insignificante. Si varían en calidad, el pipeline de aprendizaje profundo de EasyOCR ofrece una ventaja significativa.
¿Pueden Tesseract o EasyOCR manejar escritura a mano?
Ambos tienen dificultades con la escritura a mano, pero EasyOCR rinde mejor (61.5% vs 45.2% de precisión). Ninguno es adecuado para reconocimiento de escritura a mano en producción sin entrenamiento adicional o un pipeline de modelos específico para manuscritos. Para contexto, los modelos modernos de visión-lenguaje como olmOCR y Qwen2.5-VL logran una precisión significativamente mayor en escritura a mano, a costa de requisitos de cómputo mucho más altos.
¿Tesseract admite aceleración por GPU?
No. Tesseract 5.x es solo CPU por diseño. Hay discusión comunitaria en curso sobre soporte de GPU para versiones futuras (ver el hilo de planes de Tesseract 2026), pero a mediados de 2026 no hay ruta de GPU. EasyOCR usa CUDA para aceleración por GPU y funciona en cualquier GPU compatible con PyTorch.
¿Ambos son completamente gratuitos?
Sí. Tanto Tesseract (Apache 2.0, mantenido por Google) como EasyOCR (Apache 2.0, Jaided AI) son totalmente de código abierto y gratuitos para uso comercial, sin límites de uso, restricciones de tarifa ni costos de API. El único costo es la infraestructura para ejecutarlos: tiempo de CPU, memoria y, opcionalmente, cómputo de GPU.
¿Pueden estas herramientas extraer datos estructurados como N.º de Factura y Total?
No directamente. Ambos motores producen texto OCR: caracteres y palabras en la página. Extraer campos específicos (Número de Factura, Fecha de Vencimiento, Partidas) requiere lógica adicional: ya sea análisis basado en expresiones regulares, análisis de diseño sobre cuadros delimitadores o una capa de extracción semántica. Para proyectos que necesitan salida estructurada a nivel de campo de facturas, recibos o formularios, es posible que desees evaluar herramientas de extracción nativas de IA que comprenden la semántica del documento de forma nativa en lugar de depender de OCR + análisis.
De Texto OCR a Datos Estructurados — Sin el Trabajo de Tubería
Si has llegado hasta aquí, ya entiendes el desafío principal: Tesseract y EasyOCR te dan texto, pero no los campos estructurados que tus procesos de negocio necesitan. La extracción con IA de ImageToTable.ai va directamente del documento a la hoja de cálculo — sin ajustes del motor OCR, sin expresiones regulares de post-procesamiento, sin análisis de diseño. Sube una factura, nombra las columnas que quieras (Número de Factura, Total, Proveedor), y la IA localiza cada valor entendiendo qué significa, no dónde está en la página.
Con hasta un 99% de precisión en documentos impresos, procesamiento por lotes para cientos de archivos y exportación directa a Excel/Google Sheets, cierra la brecha que esta comparación ha estado describiendo: la distancia entre el texto OCR y los datos utilizables.