Der vollständige Leitfaden zur
Extraktion von Konnossementdaten
Ein Konnossement ist nicht nur ein Dokument. Es ist eine Familie rechtlich unterschiedlicher Dokumenttypen – Namenskonnossemente, Seekonnossemente, multimodale Transporte, Master- und Hauskonnossemente – jeweils mit unterschiedlichen Feldern, Ausstellern und Datenzielen. Ein Spediteur, der 100 BOL pro Tag verarbeitet, könnte vor dem Mittagessen acht verschiedene Dokumentlayouts von fünf Reedereien in den Händen halten. Eine Extraktion, die bei einem BOL-Typ funktioniert und beim nächsten versagt, ist keine Extraktion – sie ist eine Teillösung mit manuellem Notfallplan. Dieser Leitfaden behandelt, was Sie tatsächlich wissen müssen, um BOL-Daten zuverlässig über jeden Typ, jede Reederei und jeden Standardcode zu extrahieren, den Ihr Transportmanagementsystem (TMS) erwartet.
Wichtigste Erkenntnisse
- Vorlagenbasierte Extraktion für Konnossemente bedeutet, 750 Koordinatenrechtecke über 50 Reedereien zu pflegen – und wenn Maersk die Containernummer vom oberen rechten Quadranten in die Seitenmitte verschiebt, erzeugt jedes von ihnen gesendete BOL ein leeres Feld, bis jemand die Vorlage bearbeitet.
- Die Absurdität liegt nicht nur in der Wartungslast – sondern darin, dass jede Vorlagenänderung eine neue Chance für eine falsch gelesene Container-ID ist, die Ihr TMS, das Tracking-Portal Ihres Kunden oder eine Zollanmeldung erreicht, bevor jemand merkt, dass der Container seit drei Tagen fehlt.
- Eine einzige semantische Spaltendefinition ersetzt alle 750 Vorlagen und validiert Containernummern während der Extraktion gegen ISO-6346-Prüfziffern – ein Tippfehler wird abgefangen, bevor er die Extraktionsebene verlässt, und nicht erst, wenn die Standgelduhr zu ticken beginnt.
Was die BOL-Erfassung von anderen Dokumentenerfassungen unterscheidet
Die meisten Artikel über Dokumentenerfassung behandeln ein Konnossement wie eine Rechnung mit einem Schiff darauf. Diese Annahme erzeugt Tools, die in Demos funktionieren und in der Praxis versagen. Hier ist der Grund, warum sich Konnossemente strukturell von jedem anderen Dokument unterscheiden, aus dem Sie Daten erfassen.
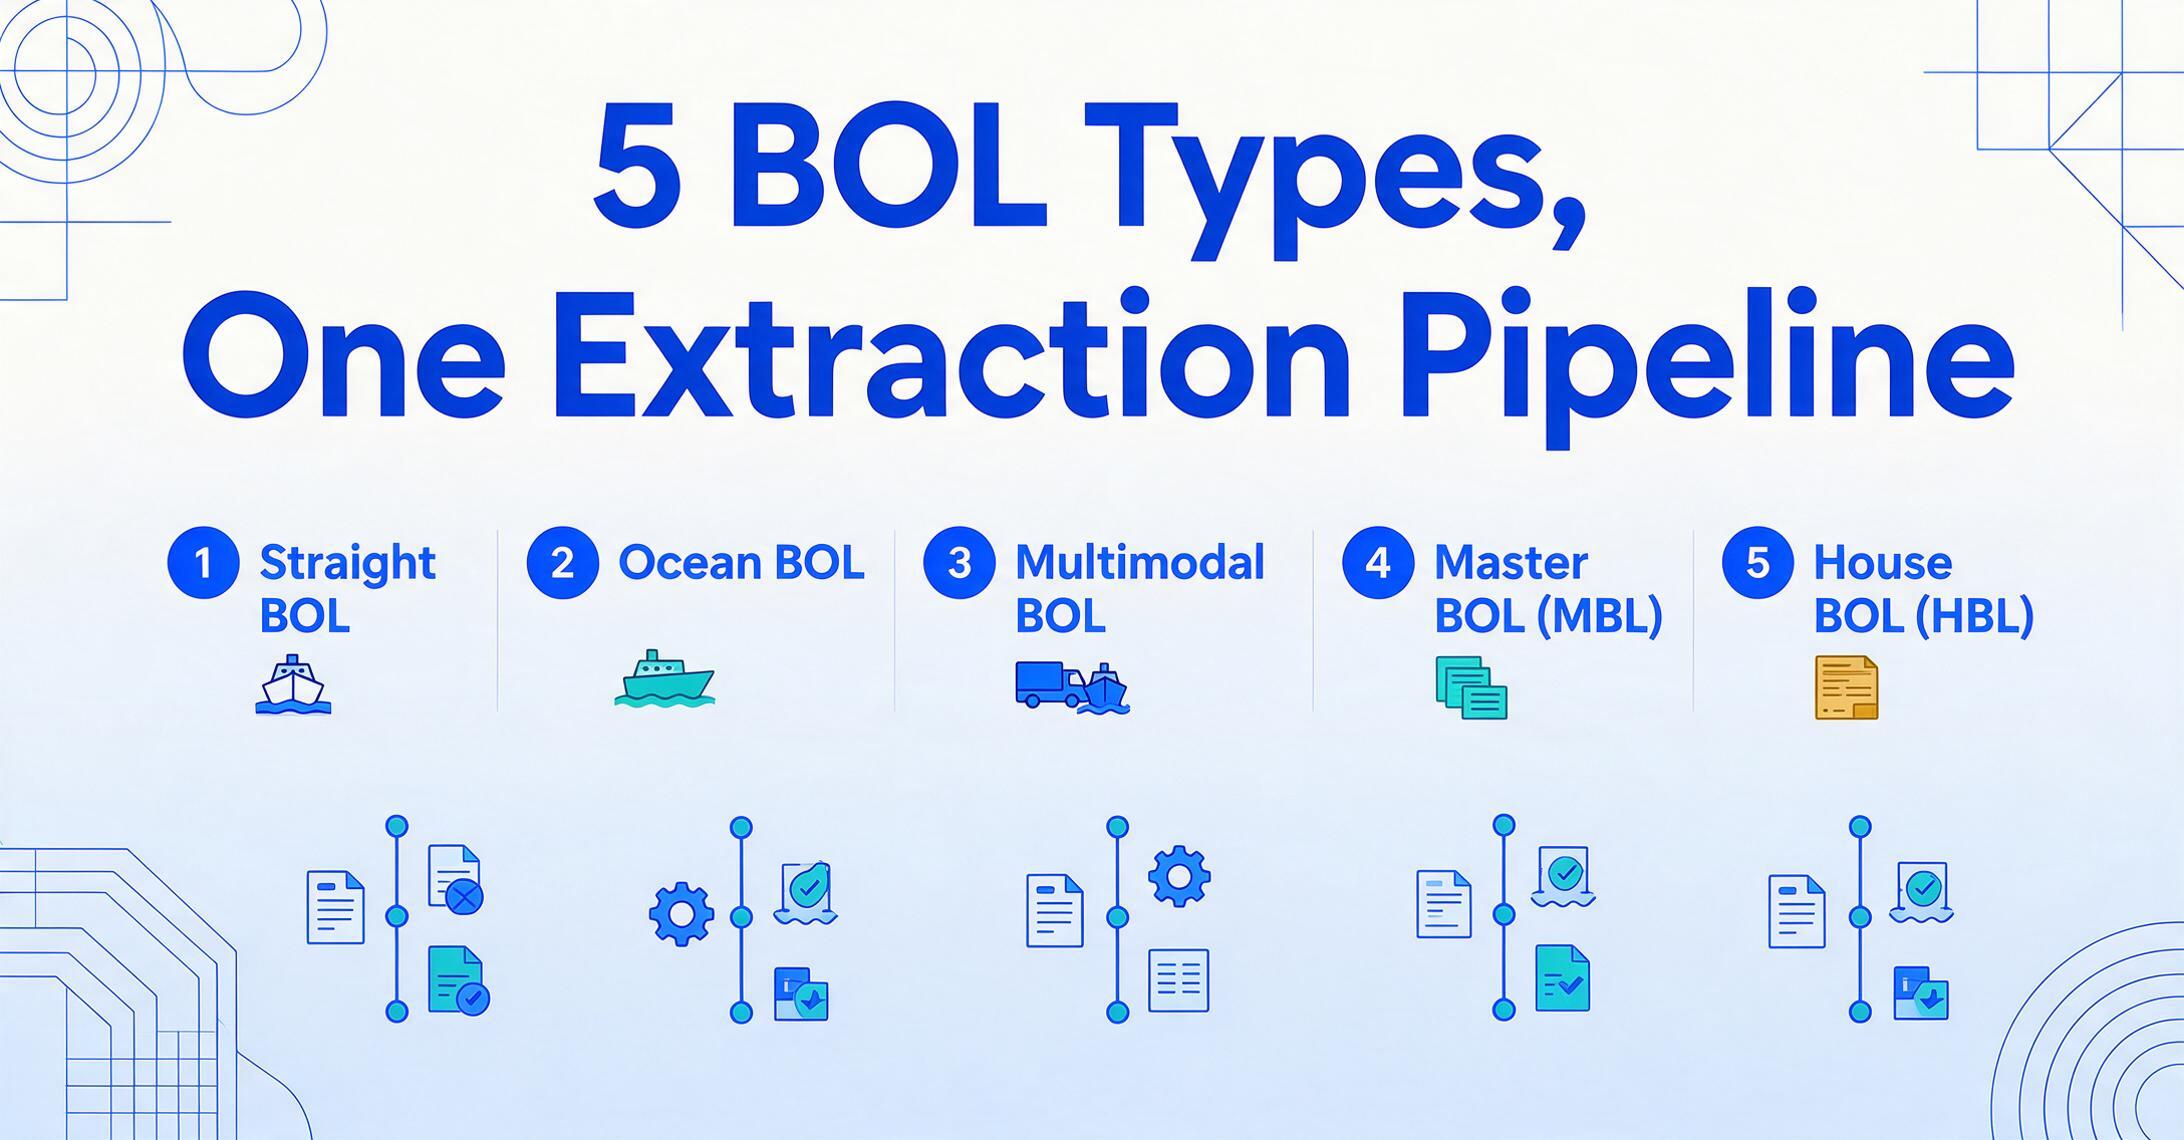
Fünf rechtlich unterschiedliche Dokumenttypen, eine Erfassungspipeline. Ein Namenskonnossement (nicht übertragbar) benennt einen bestimmten Empfänger und kann nicht übertragen werden – die einfachste Form, üblich im LTL-LKW-Verkehr. Ein Seekonnossement ist übertragbar und dient gemäß den Haag-Visby-Regeln als Traditionspapier – wer das Original besitzt, kann die Fracht beanspruchen. Ein Multimodales Konnossement (auch Durchkonnossement genannt) deckt See-, Schienen- und LKW-Strecken in einem einzigen Dokument ab, das den UNCTAD/ICC-Regeln für multimodale Transportdokumente unterliegt. Dann kommt die Trennung, mit der jeder Spediteur täglich arbeitet: das Masterkonnossement (MBL), das der Carrier an den Spediteur ausstellt, und das Hauskonnossement (HBL), das der Spediteur an den Versender ausstellt – zwei Dokumente für dieselbe Sendung, die Felder wie Containernummern und Häfen gemeinsam haben, aber unterschiedliche Ausstellernamen, Referenznummern und Frachtzahlungsbedingungen aufweisen.
Jeder Typ ordnet Felder anders an. Ein Maersk-Seekonnossement platziert die Containernummer im oberen rechten Quadranten neben dem Schiffsnamen. Ein MSC-Konnossement setzt sie in die Seitenmitte über dem Warenbeschreibungsraster. Ein Hauskonnossement fügt eine HBL-Referenznummer hinzu, die auf das Masterkonnossement verweist – ein Feld, das ein Namenskonnossement gar nicht besitzt. Ein Erfassungstool, das nicht alle fünf Typen ohne typspezifische Konfiguration verarbeiten kann, lässt Ihr Team Vorlagen pflegen, statt Fracht zu bewegen.
Die Daten müssen nicht nur gelesen – sie müssen übersetzt werden. Ein Konnossement kann den Verladehafen als „CNSHA", „Shanghai" oder „Port of Shanghai, CN" angeben. Ihr TMS erwartet CN SHA, den fünfstelligen UN/LOCODE, der seit 1981 von der Wirtschaftskommission der Vereinten Nationen für Europa (UNECE) gepflegt wird – ein System mit über 100.000 Orten in 249 Ländern. Ein Konnossement kann den Carriernamen als „Maersk Line" drucken, während Ihr TMS den SCAC-Code (Standard Carrier Alpha Code) MAEU verlangt, der von der NMFTA verwaltet wird. Waren benötigen HS-Codes – das Harmonisierte System, das von der Weltzollorganisation gepflegt und in über 200 Ländern verwendet wird – die aus einer natürlichsprachigen Warenbeschreibung wie „gewebte Polypropylen-Schüttgutsäcke" auf 6305.33 abgebildet werden. Ein BOL-Erfassungstool, das Klartext ausgibt, ist nicht fertig. Eines, das standardisierte Codes ausgibt, schon.
Dies ist die Kernherausforderung, die die BOL-Erfassung zu einem anderen Problem macht als die Rechnungserfassung oder Belegerfassung. Eine vollständige Definition der BOL-Datenerfassung und wie sie sich von verwandten Konzepten wie der TMS-Dateneingabe unterscheidet, finden Sie in unserem Leitfaden Was ist BOL-Datenerfassung.
Warum klassische OCR und vorlagenbasierte Ansätze bei Frachtbriefen versagen
Vorlagenbasierte OCR wurde für Dokumente mit kontrolliertem Layout entwickelt – Ihre eigenen Rechnungen, Ihre eigenen Bestellungen, selbst entworfene Formulare. Frachtbriefe durchbrechen diese Annahme auf jeder Ebene.
Explosion der Speditionsformate. Ein Frachtmakler, der täglich 100 Frachtbriefe erhält, hat keine Kontrolle darüber, welche Spediteure seine Versender nutzen. Diese Frachtbriefe kommen in den Formaten von Maersk (MAEU), MSC (MSCU), CMA CGM (CMDU), Hapag-Lloyd (HLCU), COSCO (COSU), ONE (ONEY), Evergreen (EMCU) und einem Dutzend regionaler Speditionen – jedes mit eigenem Layout. Vorlagenbasierte OCR erfordert das Zeichnen von Begrenzungsrahmen um jedes Feld pro Speditionsformat. Für 50 Spediteure und 15 Felder pro Frachtbrief sind das 750 Koordinatenrechtecke, die definiert und gewartet werden müssen. Wenn ein Spediteur sein Formular aktualisiert – und das tun sie –, brechen diese Vorlagen stillschweigend und liefern falsche Daten in den richtigen Spalten, bis jemand das Muster der Korrekturgebühren für Konnossemente beim Zoll bemerkt.
Handschrift, Stempel und Durchschläge sind keine Ausnahmen. Ein an einer Verladerampe ausgefüllter Frachtbrief ist kein sauberes digitales PDF. Der Empfängername wurde mit Kugelschreiber gekritzelt. Die Stückzahl wurde mit rotem Stempel überdruckt. Die Frachtbedingungen – „PREPAID" – wurden mit einem Marker eingekreist. Der Scan ist ein Durchschlag dritter Generation, bei dem Text aus dem Original in das Frachtbeschreibungsfeld durchscheint. Herkömmliche OCR behandelt Stempel als Rauschen, Durchschlag als zusätzliche Zeichen und Handschrift unter 90 DPI als unlesbar. Aber bei einem Frachtbrief tragen diese „Rauschelemente" die drei Datenpunkte, die am ehesten eine Speditionsrechnungsstreitigkeit auslösen: die handschriftliche Stückzahl, das gestempelte Gewicht und die markierten Frachtbedingungen.
NMFC-Frachtklasse erfordert semantisches Verständnis. Das National Motor Freight Classification-System definiert 18 Frachtklassen (50 bis 500) basierend auf Dichte, Stapelbarkeit, Handhabung und Haftung. Ein Frachtbrief könnte „Klasse 70" neben der Warenbeschreibung „Holzmöbel, zerlegt" aufführen – oder die Ware ohne Klasse nennen, in der Erwartung, dass der Spediteur sie anwendet. Vorlagen-OCR liest beide als Textzeichenfolgen im selben Feld. Semantische Extraktion versteht, dass „Klasse 70" „Holzmöbel" modifiziert und in die Spalte Frachtklasse gehört, nicht in die Spalte Warenbeschreibung. Diese Unterscheidung bestimmt, ob eine Frachtrechnung korrekt ist oder drei Wochen später eine Nachklassifizierungsgebühr von 300 € auslöst.
Diese drei Fehlermodi verstärken sich gegenseitig. Ein Tool, das pro Spediteur Vorlagen benötigt, keine Handschrift lesen kann und Frachtklassen nicht von Warenbeschreibungen unterscheiden kann, spart keine Arbeit – es erzeugt eine Prüfwarteschlange, die so groß ist wie die ursprüngliche Dateneingabeaufgabe.
So liest moderne KI-Extraktion ein Konnossement
Die Pipeline, die die manuelle BOL-Datenerfassung ersetzt, reicht von der Erfassung über das visuelle Verständnis und die Feldzuordnung bis hin zur Standardisierung und Ausgabe – für die vollständige, schrittweise Mechanik, wie ein Vision-KI-Modell eine BOL-Seite liest und Felder nach Bedeutung statt nach Position zuordnet, siehe unseren Leitfaden zur BOL-Datenextraktion. Was hier näher erläutert werden sollte – weil es die Stufe ist, die ein echtes BOL-Extraktionstool von einem generischen Dokumentenleser unterscheidet – ist die Standardisierung und Code-Validierung.
Wichtige BOL-Felder und die Standards, die sie validieren
Jedes BOL-Extraktionsprojekt beginnt mit der Definition der relevanten Felder. Die folgende Tabelle umfasst die fünf Gruppen, die jeder Logistikbetrieb benötigt, die spezifischen Felder innerhalb jeder Gruppe sowie den Validierungsstandard, der bestimmt, ob der extrahierte Wert korrekt ist – nicht nur vorhanden.
| Feldgruppe | Zu extrahierende Felder | Validierungsstandard | Warum es wichtig ist |
|---|---|---|---|
| Parteien | Name und Adresse des Versenders, Empfänger, Notifyadresse, Carrier/SCAC-Code | SCAC (NMFTA): 2-4-Buchstaben-Carrier-Code; EORI-Nummern für den EU-Zoll | Fehlgeleitete Lieferung verursacht Standgeld von 100–500 $/Tag; falsche Notifyadresse bedeutet, dass die Ankunft der Sendung unbemerkt bleibt |
| Routing | Verladehafen, Löschhafen, Übernahmeort, Auslieferungsort, Schiff/Reise, Containernummer, Plombennummer | UN/LOCODE (UNECE): 5-stelliger Code (z. B. CN SHA, NL RTM); ISO 6346: Prüfziffer des Containers | ISF-Anmeldung erfordert korrekte Hafencodes 24 Stunden vor dem Verladen; Container-ID-Abweichung löst einen Zollstopp aus |
| Fracht | Warenbezeichnung, Kollianzahl und Verpackungsart, Bruttogewicht (kg/lbs), Nettogewicht, Volumen/Abmessungen, Frachtklasse, NMFC-Code, HS-Code | NMFC: 18 Frachtklassen (50–500); HS: 6-stellig international + länderspezifische Erweiterung; SOLAS VGM: verifizierte Bruttomasse für Container seit Juli 2016 verpflichtend | Neueinstufung der Frachtklasse kostet 150–300 $ pro Sendung; HS-Code-Fehler führen zu Zollstrafen von bis zu dem 10-fachen des Zolldefizits |
| Kosten & Bedingungen | Frachtzahlung (vorausbezahlt/per Nachnahme), Seefracht, Bunkerzuschlag, Terminalabfertigung, Nebenkosten | Incoterms 2020: definiert Kosten- und Risikoübergangspunkte | Falsche Frachtzahlungsbedingungen bedeuten, dass der falsche Partner in Rechnung gestellt wird und Kosten von einem Kunden eingezogen werden, der den Spediteur bereits bezahlt hat |
| Referenz | BOL-Nummer, HBL/MBL-Querverweis, Buchungsnummer, PO-/Handelsrechnungsreferenzen, Abholdatum, Lieferdatum/ETA | Format variiert je nach Carrier; Querverweisvalidierung zwischen HBL und MBL für Spediteure, die beide bearbeiten | Sendung ohne BOL-Nummer im Transportmanagementsystem (TMS) nicht nachverfolgbar; verpasste Lieferfenster untergraben Service-Level-Verpflichtungen |
Die Prüfziffer der Containernummer ist ein besonders wertvolles Validierungsinstrument. Gemäß ISO 6346 besteht jede Container-Kennung aus einem dreistelligen Eigentümercode (z. B. MSK für Maersk), einem einstelligen Gerätekategorie-Identifikator (U für Frachtcontainer), sechs Serienziffern und einer aus den vorherigen Zeichen berechneten Prüfziffer. Wenn Ihre Extraktion MSKU 907082 3 ausgibt, der tatsächliche Container aber MSKU 907082 8 ist, weist die Prüfziffern-Abweichung den Fehler sofort aus – bevor diese Containernummer Ihr TMS, das Tracking-Portal Ihres Kunden oder eine Zollanmeldung erreicht. Ein Tool, das diese Validierung während der Extraktion durchführt, erkennt Fehler, die sonst bestehen bleiben würden, bis ein Container in einem Terminal verloren geht.
Die Frachtgruppe — Warenbezeichnungen, Gewichte, Frachtklasse, HS-Codes — ist der datenintensivste Abschnitt eines jeden Konnossements und der fehleranfälligste. Sie ist auch der Abschnitt, der je nach Carrier am stärksten variiert. Ein Konnossement listet fünf Warenpositionen mit Einzelgewichten und einer Sammelfrachtklasse auf; ein anderes fasst alles in einer Zeile mit „FAK“ (Fracht aller Art) zusammen. Ein drittes fügt am Rand einen handschriftlich vom Versender notierten HS-Code hinzu. Ein Tool zur Konnossement-Extraktion muss das Layout pro Carrier nicht kennen. Es muss wissen, wie jeder Datentyp in all den Darstellungsweisen aussieht, die Carrier und Versender verwenden.
Batch-Verarbeitung: Konnossemente mehrerer Carrier, eine Tabelle
Die Konnossement-Extraktion entfaltet ihren vollen Wert erst, wenn sie Batches verarbeitet — nicht ein Dokument nach dem anderen, sondern dutzende oder hunderte in einem einzigen Durchlauf. Hier kommt die Designannahme der Batch-First-Verarbeitung ins Spiel.
Stellen Sie sich einen Spediteur vor, der 80 Konnossemente aus den E-Mails eines Morgens verarbeitet. Diese 80 Dokumente könnten von 12 verschiedenen Carriern stammen, vier Konnossementstypen abdecken (See-, Haus-, Master-, Namenskonnossement) und eine Mischung aus sauberen digitalen PDFs und gescannten Durchschlägen regionaler Speditionsunternehmen enthalten. Der Workflow, der diese Skalierung ermöglicht:
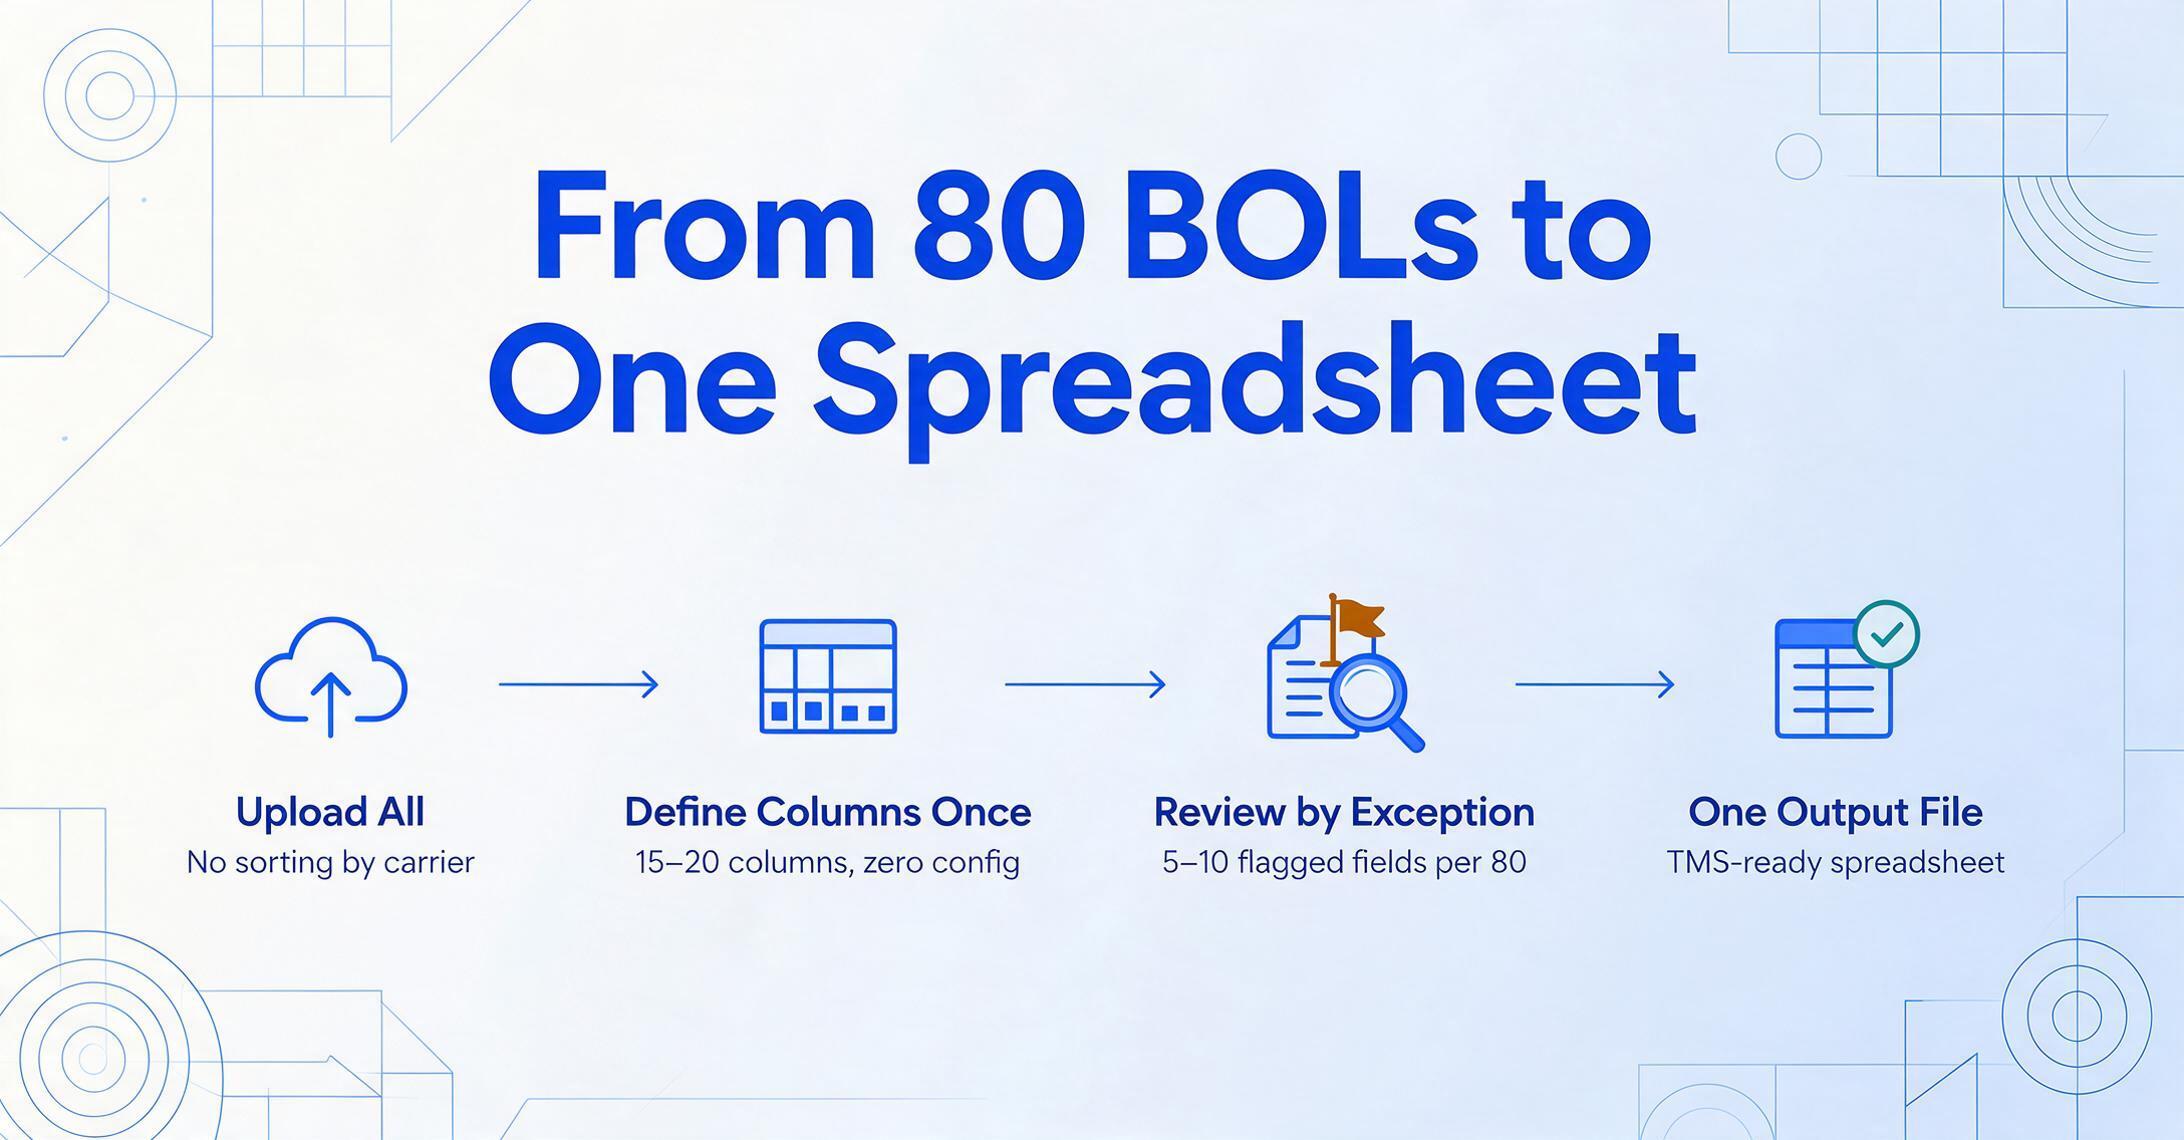
1. Laden Sie alle Konnossemente auf einmal hoch. Keine Sortierung nach Carrier, keine Vorklassifizierung nach Konnossementstyp. Der Batch akzeptiert PDF, JPG, PNG und mehrseitige Dokumente ohne Unterschied.
2. Definieren Sie Ihre Spalten einmal. Dieselben 15–20 Spaltennamen gelten für jedes Konnossement im Batch. Die KI übernimmt die Zuordnung: Wenn sie auf ein Namenskonnossement stößt (ohne HBL/MBL-Kreuzreferenz), lässt sie diese Spalte leer. Wenn sie auf ein Seekonnossement mit einem mehrzeiligen Frachtraster stößt, erweitert sie es in separate Zeilen pro Warenposition. Keine Konfiguration pro Dokument.
3. Prüfung nach Ausnahmen. Felder, die die KI mit hoher Konfidenz extrahiert, werden automatisch durchgereicht. Felder mit geringerer Konfidenz — ein verblasstes Gewicht auf einem Durchschlag, eine verschmierte Containernummer — werden zur manuellen Prüfung markiert. Ein Logistiksachbearbeiter prüft 5–10 markierte Felder pro 80-Dokumente-Batch, anstatt 1.200 Felder manuell einzutippen. Das ist der Unterschied zwischen dem Ersetzen von Datenerfassungsarbeit und dem bloßen Umbenennen in „Datenprüfung“.
4. Eine Ausgabedatei. Das Ergebnis ist eine einzige Excel-Tabelle — eine Zeile pro Konnossement (oder pro Warenposition bei Sendungen mit mehreren Positionen), mit Spalten, die den von Ihnen definierten Feldern entsprechen. Diese Ausgabe ist tabellen-nativ: Sie landet direkt in Excel oder Google Sheets, bereit für den TMS-Import. Für Teams, die Google Sheets verwenden, kann der BOL-zu-TMS-Workflow die Extraktion direkt in der Tabelle über ein Seitenleisten-Add-on ausführen, wodurch der Dateiübergabeschritt vollständig entfällt. Weitere Informationen zur Skalierung der Batch-Verarbeitung ohne Integrationsaufwand finden Sie unter Multi-Carrier-Batch-Konnossement-Extraktion.
Exportoptionen: Extrahierte Daten dorthin bringen, wo sie hin müssen
Extrahierte BOL-Daten haben einen Zweck: in ein anderes System zu gelangen. Welches System, hängt von Ihrem Betrieb ab. Der gewählte Exportpfad bestimmt, wie viel manuelle Übergabe zwischen Extraktion und Ihrem Workflow verbleibt.
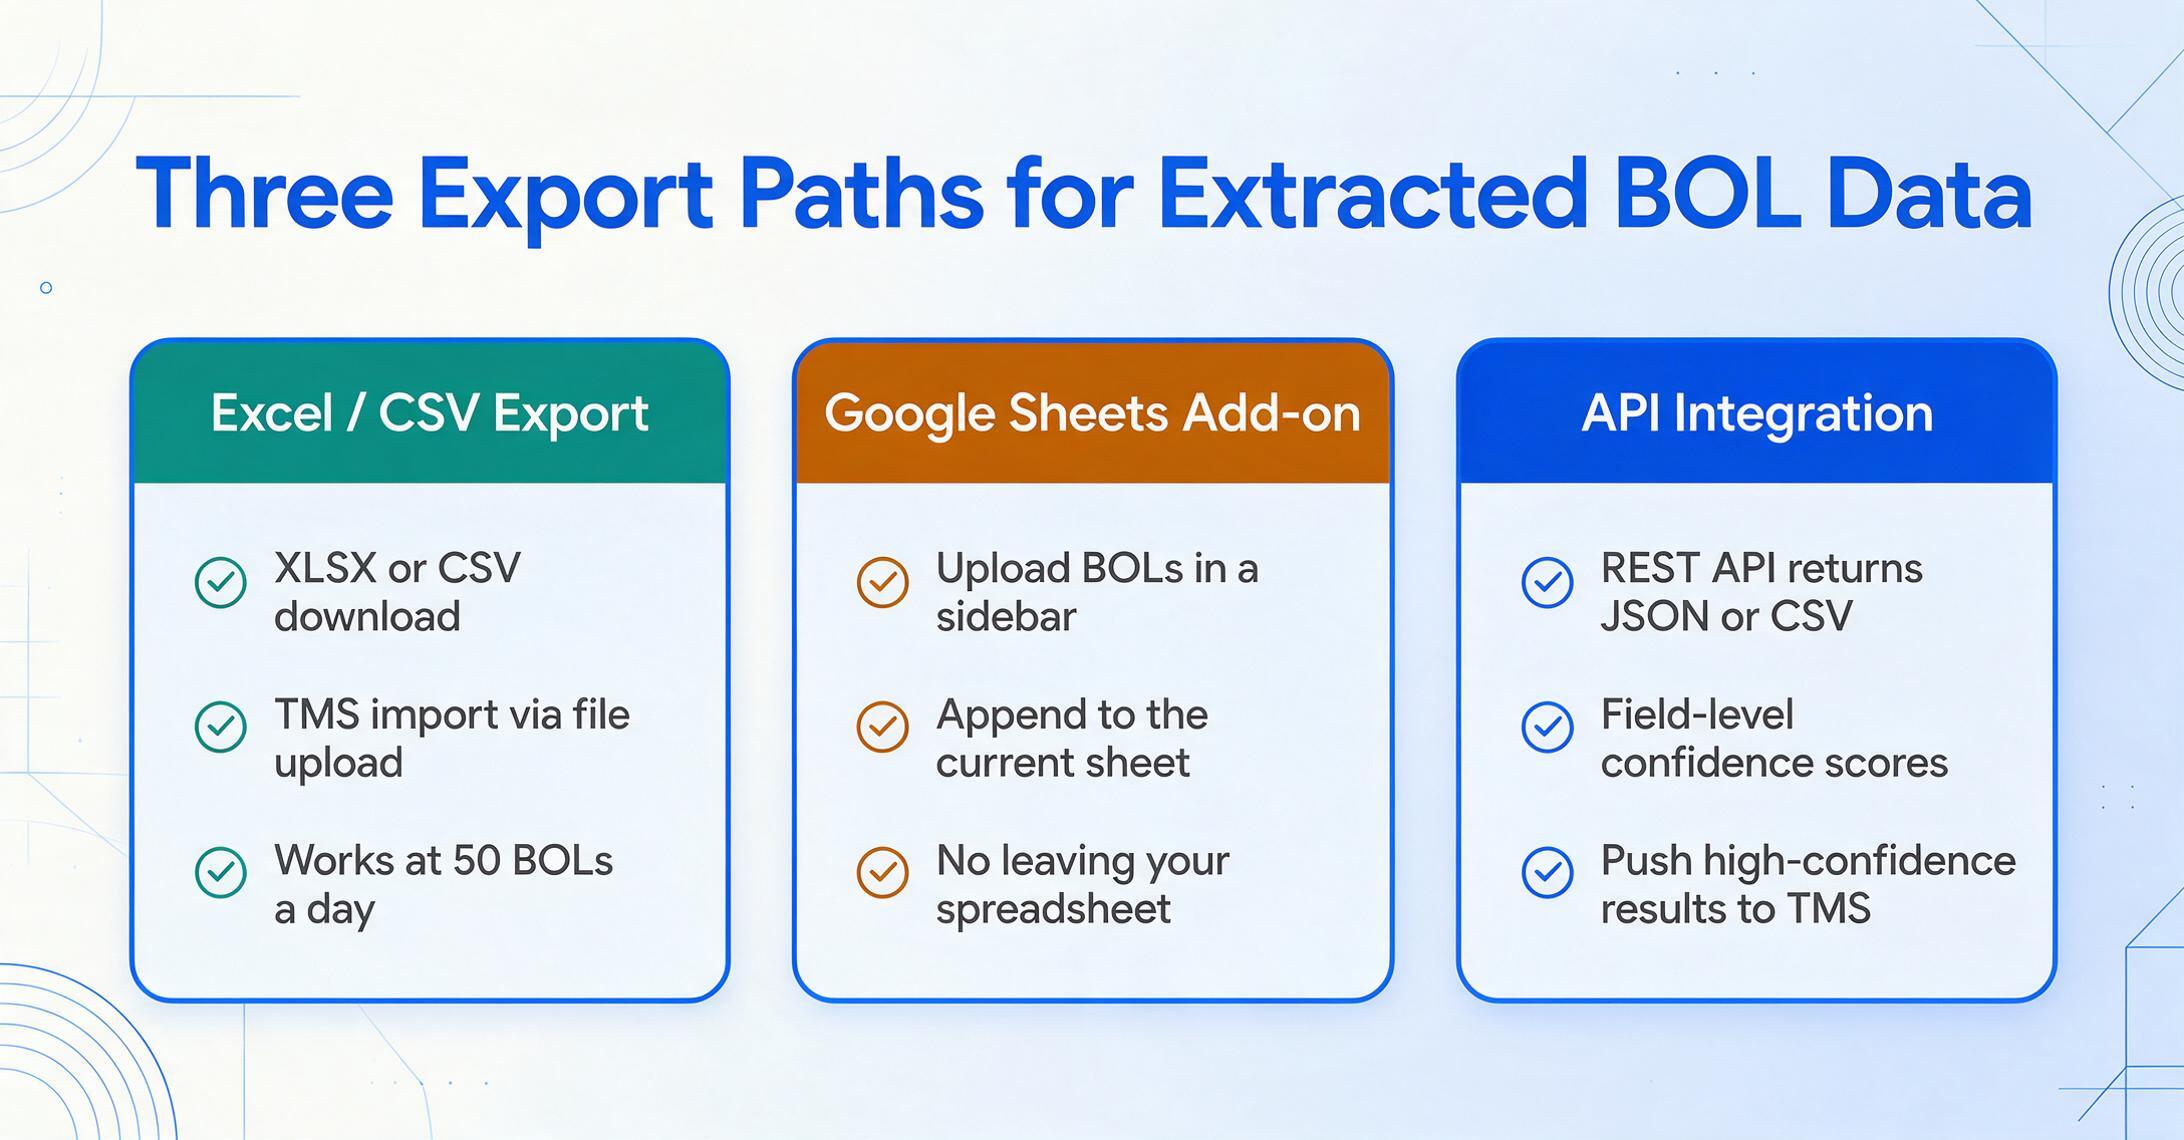
Excel / CSV-Export
Für: Teams, die per Datei-Upload in ein TMS importieren
Laden Sie extrahierte BOL-Daten als XLSX oder CSV herunter. Ordnen Sie Spalten Ihrer TMS-Importvorlage zu – CargoWise, Descartes, McLeod und andere unterstützen den CSV-Import. Eine Datei, ein Import, kein Tippen.
Google Sheets Add-on
Für: Teams, die Betrieb über Tabellenkalkulationen abwickeln
Ein Google-Sheets-Seitenleisten-Add-on ermöglicht das Hochladen von BOLs, das Definieren von Extraktionsspalten und das direkte Anhängen strukturierter Daten an das aktuelle Blatt – ohne Ihre Tracking-Tabelle zu verlassen. Die Extraktion erfolgt im Tool, das Ihr Team bereits nutzt.
API-Integration
Für: Volumenbetriebe mit internen Systemen
Eine REST-API empfängt BOL-Dateien und liefert strukturierte Daten programmatisch zurück – JSON oder CSV mit Konfidenzwerten auf Feldebene. Ihr System kann Extraktionen mit niedriger Konfidenz automatisch zur manuellen Prüfung weiterleiten und Ergebnisse mit hoher Konfidenz direkt ins TMS übertragen.
Der richtige Exportpfad hängt von Ihrem Volumen und Ihren technischen Ressourcen ab. Bei 50 BOLs pro Tag funktioniert der Excel-Export plus TMS-Import. Bei 500 pro Tag wird die manuelle Dateiübergabe zum neuen Engpass. Die meisten Teams starten mit dem Excel-Export und wechseln zur API-Integration, sobald das Volumen die Entwicklungsarbeit rechtfertigt. Die Extraktions-Engine sollte beide Pfade unterstützen, damit Sie die Tools nicht wechseln müssen, wenn Sie die Exportmethode wechseln.
So wählen Sie ein BOL-Extraktionstool aus
Fünf Kriterien trennen Tools, die produktive BOL-Volumen bewältigen, von solchen, die für den gelegentlichen Einsatz mit sauberen digitalen Dokumenten konzipiert sind.
1. Multi-Spediteur-Handling ohne Einrichtung pro Spediteur. Der Härtetest: Verarbeiten Sie einen Maersk-Seefrachtbrief, einen MSC-Seefrachtbrief, einen Old-Dominion-Straight-BOL und eine gescannte Durchschrift eines regionalen LTL-Spediteurs – im selben Batch, mit denselben Spaltendefinitionen, ohne eine einzige Vorlage zu erstellen. Wenn das Tool verlangt, dass Sie Feldpositionen pro Spediteur definieren, kaufen Sie einen Vorlagenwartungsjob, kein Extraktionstool.
2. Standard-Code-Validierung und -Normalisierung. Das Tool sollte Containernummern gemäß den ISO-6346-Prüfziffernregeln validieren, Hafennamen in ein Standardformat (idealerweise UN/LOCODE) normalisieren und erkennen, dass "Maersk", "MAERSK LINE" und "MAEU" denselben Spediteur bezeichnen. Ohne diese Ebene tauschen Sie manuelles Tippen gegen manuelle Datenbereinigung – gleiche Arbeit, anderer Schritt.
3. Mehrseitige und positionsgenaue Extraktion. Seefrachtbriefe mit Containerfracht umfassen oft 3–5 Seiten. Warenbeschreibungen, Containernummern, Plombennummern und Packstückzahlen verteilen sich über Fortsetzungsseiten. Ein Tool, das nur Seite eins liest, lässt die Hälfte der Daten unextrahiert. Die Unterstützung von Positionen – bei der jede Warenzeile zu einer separaten Datenzeile wird – ist für die Zollklassifikation und den Bestandsabgleich unerlässlich.
4. Feldgenaue Konfidenzbewertung. Kein Extraktionstool erreicht eine 100%ige Durchlaufverarbeitung bei der Mischung an Dokumentqualität, die ein echter Logistikbetrieb erhält. Entscheidend ist, dass das Tool Ihnen mitteilt, bei welchen Feldern es unsicher ist. Ein Konfidenzindikator pro extrahiertem Feld (hoch/mittel/niedrig) ermöglicht Ihrem Team, nur die unsicheren Extraktionen zu prüfen – typischerweise 5–10 % der Felder – und den Rest direkt in nachgelagerte Systeme fließen zu lassen.
5. Batch-first-Design mit konsolidierter Ausgabe. Die Verarbeitung eines BOL nach dem anderen funktioniert bei fünf Sendungen pro Tag. Bei 50 benötigen Sie Batch-Upload, Batch-Verarbeitung und eine einzige konsolidierte Ausgabe – eine Tabelle, eine Zeile pro BOL, ein Exportschritt. Das Tool sollte von Grund auf für Batch-Workflows ausgelegt sein, nicht mit einem "Batch-Modus" nachgerüstet werden, der Dokumente sequenziell hinter einem Mehrfachauswahl-Dialog verarbeitet.
Testen Sie diese Kriterien mit Ihren eigenen Dokumenten – den BOLs, die Sie tatsächlich erhalten, von den Spediteuren, mit denen Sie tatsächlich arbeiten. Eine Demo mit einem sauberen digitalen BOL eines einzelnen Spediteurs beweist nichts darüber, wie das Tool Ihren Dienstagmorgen-Batch mit 40 BOLs von 15 Spediteuren verarbeitet.
Häufig gestellte Fragen
Welche Frachtbrief-Typen kann KI-Extraktion verarbeiten?
Ein KI-Extraktionstool ohne Vorlagen verarbeitet alle gängigen Frachtbrief-Typen – direkte Frachtbriefe, Seefrachtbriefe, multimodale/kombinierte Frachtbriefe, Master-Frachtbriefe (MBL) und House-Frachtbriefe (HBL) – mit derselben Einrichtung. Die KI identifiziert Felder nach Bedeutung, nicht nach Vorlagenposition, sodass ein direkter Frachtbrief eines Speditionsunternehmens und ein Seefrachtbrief von Maersk mit denselben Spaltendefinitionen verarbeitet werden. Für Dokumente mit frachtbriefspezifischen Feldern (wie die HBL-Referenznummer, die auf den Master-Frachtbrief verweist), definieren Sie die Vereinigungsmenge aller benötigten Felder über alle Dokumenttypen hinweg, und das Tool lässt jedes Feld leer, das in einem bestimmten Dokument nicht vorkommt.
Kann die Frachtbrief-Extraktion Containernummern nach ISO 6346 validieren?
Einige Tools können das, aber nicht alle. Die ISO-6346-Containernummernvalidierung – Berechnung der Prüfziffer aus Eigentümercode und Seriennummer und Vergleich mit der extrahierten Ziffer – ist eine Validierungsebene nach der Extraktion, die Übertragungsfehler abfängt, bevor sie Ihr TMS erreichen. Wenn die Containervalidierung für Ihren Workflow wichtig ist (und das sollte sie sein, wenn Sie Seefracht abwickeln), bestätigen Sie mit dem Anbieter, dass seine Extraktionspipeline diesen Schritt enthält. Eine Abweichung zwischen extrahierter und berechneter Prüfziffer sollte das Feld zur manuellen Prüfung markieren.
Verarbeitet die Frachtbrief-Extraktion handschriftliche Einträge und Dock-Frachtbriefe?
Ja – innerhalb von Grenzen. Moderne Vision-KI-Modelle lesen handschriftliche Frachtbrief-Felder bei leserlicher Handschrift mit guter Genauigkeit: Druckbuchstaben, die meisten Schreibschriften und standardisierte Felder wie Frachtbriefnummern und Stückzahlen, die Fahrer normalerweise deutlich schreiben. Die Genauigkeit sinkt bei stark verblassten Durchschlägen, Stempeln über Handschrift oder Dokumenten, bei denen der Stiftdruck zu leicht war, um eine scanbare Markierung zu erzeugen. In diesen Fällen markiert ein gut konzipiertes Extraktionstool das Feld mit einer niedrigen Konfidenz zur manuellen Prüfung, anstatt eine Schätzung auszugeben.
Wie verarbeitet die Extraktion mehrseitige Konnossemente mit Frachtangaben auf Folgeseiten?
Moderne Extraktionssysteme erfassen alle Seiten eines mehrseitigen Konnossements als ein einziges Dokument und führen die extrahierten Felder in einem Ausgabedatensatz zusammen. Parteieninformationen (Versender, Empfänger, Benachrichtigungspartei) befinden sich in der Regel auf Seite 1. Frachtangaben, Containernummern, Plombennummern und Packstückzahlen erscheinen oft auf Folgeseiten. Das Tool erkennt, dass diese zur selben Sendung gehören, und kombiniert sie. Bei mehrzeiligen Frachtbeschreibungen wird jede Warenposition zu einer separaten Ausgabezeile, wobei die Kopffelder (Konnossementnummer, Versender, Häfen) wiederholt werden – das Format, das Ihr TMS für Einzelpostendaten erwartet.
Kann die KI zwischen einem Hauskonnossement und einem Hauptkonnossement unterscheiden?
Ja. Haus- und Hauptkonnossemente unterscheiden sich strukturell in den Ausstellerinformationen – das HBL wird vom Spediteur ausgestellt (typischerweise mit Logo und Kontaktdaten des Spediteurs), während das MBL von der Reederei ausgestellt wird. Die KI erkennt diese strukturellen Unterschiede und kann beide Typen im selben Durchlauf extrahieren, wobei gemeinsame Felder (Häfen, Containernummern, Versender, Empfänger) denselben Spalten zugeordnet werden, während typspezifische Felder wie HBL-Referenznummern oder Carrier-Buchungsnummern separat behandelt werden.
Was passiert, wenn Carrier unterschiedliche Bezeichnungen für dasselbe Konnossementfeld verwenden?
Hier liegt der entscheidende Vorteil der semantischen Extraktion gegenüber vorlagenbasierten Ansätzen. Wenn Carrier A das Feld "Shipper", Carrier B "Shipper/Exporter" und Carrier C "Consignor" nennt, versteht die KI, dass alle drei dieselbe Entität bezeichnen – die Partei, die die Güter zur Beförderung aufgibt. Sie definieren Ihre Ausgabespalte einmal als "Versendername", und die KI ordnet die Varianten jedes Carriers automatisch dieser Spalte zu. Keine carrier-spezifische Feldzuordnung, keine Übersetzungstabelle, keine "Wenn Carrier = Maersk dann Spalte A, sonst wenn Carrier = MSC dann Spalte B"-Logik.
Können extrahierte Konnossementdaten direkt in mein TMS eingespeist werden?
Die meisten Extraktionstools exportieren nach Excel oder CSV, die über die Standard-Importfunktion der Plattform in Ihr TMS importiert werden können. Plattformen wie CargoWise, Descartes, Turvo und McLeod unterstützen strukturierten Dateiimport – Sie exportieren die Extraktionsergebnisse, ordnen Spalten Ihrer TMS-Importvorlage zu und laden hoch. Für direkte Übergabe ohne Datei-Handling können Tools mit einer REST-API programmatisch integriert werden. Wenn Ihr Team über Google Sheets arbeitet, ermöglicht ein Sidebar-Add-on-Ansatz die direkte Extraktion von Konnossementdaten in die Tabelle, die Ihren TMS-Import speist – kein Datei-Download-und-Upload-Zyklus.
Welche Genauigkeit kann ich bei Konnossementen verschiedener Carrier erwarten?
Moderne KI-Extraktion erreicht 95–99 % Feldgenauigkeit bei sauberen digitalen Konnossementen großer Carrier (Maersk, MSC, CMA CGM, Hapag-Lloyd, COSCO, ONE, Evergreen). Die Genauigkeit sinkt bei niedrig aufgelösten Scans, stark degradierten Durchschlägen oder handschriftlichen Dock-Konnossementen – liegt aber dennoch deutlich über dem, was Template-OCR bei denselben Dokumenten erreicht. Die Kennzahl, die zählt, ist nicht die rohe Genauigkeit. Es ist der vertrauenswürdige Durchsatz: wie viele Konnossemente ohne manuellen Eingriff durchlaufen. Bei 95 % Feldgenauigkeit mit Konfidenzbewertung prüfen Sie etwa 5 % der Felder – ungefähr ein Feld pro Konnossement bei einer Extraktion mit 20 Feldern. Das ist der Unterschied zwischen der Prüfung von 80 Feldern über einen Batch von 80 Dokumenten und der manuellen Eingabe von 1.600 Feldern.
Ersetzt die Konnossement-Extraktion einen Zollagenten?
Nein. Die Konnossement-Extraktion automatisiert den Datenerfassungsschritt – das Auslesen von Feldern aus einem Konnossement und deren Überführung in ein strukturiertes Format. Sie ersetzt nicht das regulatorische Urteilsvermögen eines lizenzierten Zollagenten: HS-Code-Klassifizierungsentscheidungen, Zollbewertungsprüfungen, Feststellungen der Anspruchsberechtigung nach Freihandelsabkommen und die Strategie der Einfuhranmeldung. Die Extraktion übernimmt die Tipparbeit, sodass Ihr Agent Zeit für Klassifizierungs- und Compliance-Entscheidungen hat, die Fachwissen erfordern. Eine vollständige Übersicht, wie die Extraktion in die breitere Logistikdokumentlandschaft passt, finden Sie in unserem Leitfaden zur Konnossement-Extraktion, und wie das Konnossement mit dem gesamten Sendungspaket – Manifeste, Packlisten, Handelsrechnungen – abgeglichen wird, erfahren Sie in unserem Leitfaden zur Extraktion von Versand- und Frachtdokumenten.
Was ist der Unterschied zwischen Konnossement-Extraktion und EDI für den Erhalt von Sendungsdaten?
EDI (Elektronischer Datenaustausch) liefert strukturierte Sendungsdaten direkt von Carriern – keine Extraktion erforderlich. EDI erfordert jedoch eine Einrichtung pro Carrier, Tests und laufende Wartung, und viele kleinere Carrier und Spediteure unterstützen es nicht. In der Praxis erhalten die meisten Logistikbetriebe eine Mischung: EDI von großen Carriern für reguläre Routen und PDF-Konnossemente von allen anderen. Die Konnossement-Extraktion übernimmt die PDF-Seite. Die beiden Ansätze ergänzen sich, sie konkurrieren nicht. Den vollständigen Vergleich finden Sie unter EDI vs. KI-Konnossement-Extraktion.
Bei der Konnossement-Extraktion geht es nicht darum, einen langsamen Datenerfassungsprozess zu beschleunigen. Es geht darum, den Schritt vollständig zu eliminieren – den Schritt, in dem ein menschlicher Bediener Felder aus einem Dokument überträgt, das er nicht erstellt hat, mit Carrier-Abkürzungen, die er auswendig lernen musste, in ein Transportmanagementsystem, das nicht erkennen kann, ob er sich vertippt hat. Jede Stunde, die ein Konnossement in der Lücke zwischen Ihrem Posteingang und Ihrem Transportmanagementsystem liegt, ist eine Stunde, in der ein Kunde seine Sendung nicht verfolgen kann, eine Zollanmeldung noch nicht begonnen hat und eine Carrier-Rechnung nicht gegen die tatsächlich erhaltene Fracht geprüft werden kann. Die Extraktion schließt diese Lücke in Sekunden. Was Sie mit den gewonnenen Stunden tun, liegt bei Ihnen.
Konnossement-Extraktion mit Ihren eigenen Dokumenten testen →