船荷証券データ抽出の
完全ガイド
船荷証券はひとつの書類ではありません。記名式船荷証券、海上船荷証券、複合輸送、元地船荷証券とハウス船荷証券など、法的に異なる書類のファミリーであり、それぞれに異なる項目、異なる発行者、異なるデータの送り先があります。1日に100件の船荷証券を処理するフォワーダーは、昼食前に5つの運送会社から8種類の異なる書類レイアウトに触れるかもしれません。ある船荷証券の種類では機能しても、次の種類では機能しない抽出は、抽出とは言えません。それは手作業のフォールバックを伴う部分的な解決策にすぎません。このガイドでは、あらゆる種類、あらゆる運送会社、そしてお客様のTMSが期待するあらゆる標準コードにわたって、船荷証券データを確実に抽出するために実際に知っておくべきことを解説します。
重要ポイント
- 船荷証券向けのテンプレートベースの抽出では、50の運送会社にわたって750個の座標矩形を維持する必要があります。そして、Maerskがコンテナ番号を右上の象限からページ中央に移動した場合、誰かがテンプレートを編集するまで、彼らが送るすべての船荷証券で空白のフィールドが発生します。
- 不合理なのは、メンテナンスの負担だけではありません。テンプレートを変更するたびに、誤読されたコンテナIDがTMS、顧客の追跡ポータル、または通関申告に到達し、誰もコンテナが3日間行方不明になっていることに気づかないという新たなリスクが生まれるのです。
- 単一のセマンティック列定義が750個すべてのテンプレートを置き換え、抽出中にISO 6346のチェックディジットに対してコンテナ番号を検証します。これにより、滞船料の時計が動き始めた後ではなく、抽出レイヤーを離れる前に、誤入力された数字を検出できます。
BOL抽出が他の文書抽出と異なる点
ほとんどの文書抽出に関する記事は、船荷証券を「船が載っている請求書」のように扱います。その前提から生まれるツールはデモでは機能しても、本番環境では失敗します。BOLが他のどの文書よりも構造的に異なる理由を説明します。
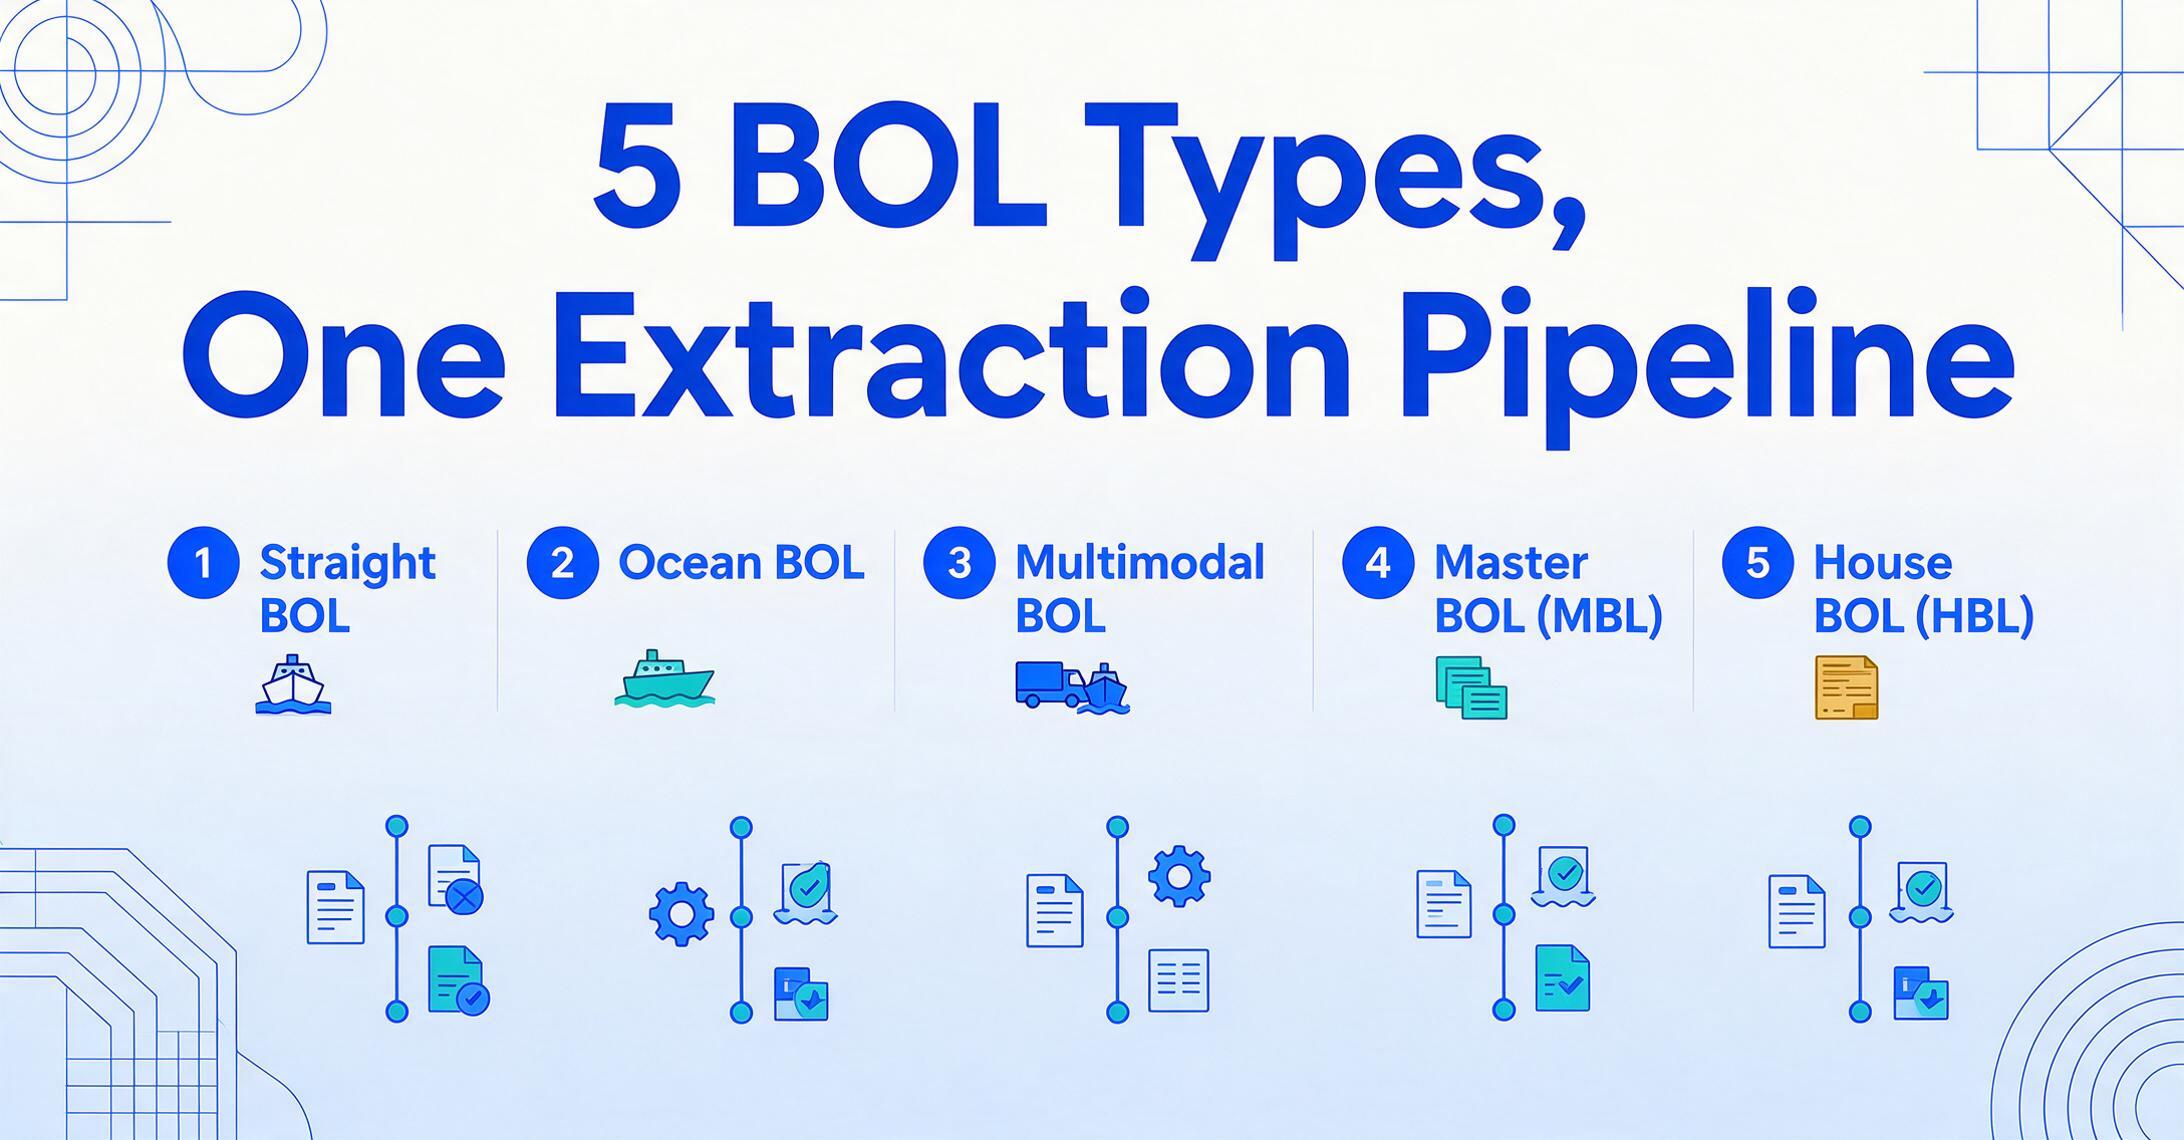
法的に異なる5種類の文書を、1つの抽出パイプラインで処理する。 記名式船荷証券(非流通性)は特定の荷受人を指定し、譲渡できません。最も単純な形式で、LTL(小口混載貨物)トラック輸送で一般的です。海上船荷証券は流通性があり、ヘーグ・ヴィスビー・ルールの下で権原証券として機能します。原本を保有する者が貨物を請求できます。複合輸送船荷証券(複合輸送書類とも呼ばれる)は、複合輸送書類に関するUNCTAD/ICC規則に基づき、海運・鉄道・トラック輸送区間を1つの書類でカバーします。そして、すべてのフォワーダーが日常的に扱う分割があります。運送人がフォワーダーに発行する元地船荷証券(MBL)と、フォワーダーが荷主に発行するハウス船荷証券(HBL)です。同じ貨物に対する2つの書類で、コンテナ番号や港などのフィールドを共有しますが、発行者名、参照番号、運賃支払条件は異なります。
各タイプはフィールドの配置が異なります。マースクの海上船荷証券は、コンテナ番号を船名の隣の右上の象限に配置します。MSCのBOLは、貨物明細グリッドの上の中段に配置します。ハウスBOLには、元地船荷証券を相互参照するHBL参照番号が追加されます。これは記名式船荷証券には存在しないフィールドです。タイプごとの設定なしに5種類すべてを処理できない抽出ツールでは、チームは貨物を動かす代わりにテンプレートの保守に追われることになります。
データは読み取るだけでなく、変換する必要がある。 BOLには船積港が「CNSHA」「Shanghai」「Port of Shanghai, CN」と記載されることがあります。TMS(輸送管理システム)が期待するのは、国連欧州経済委員会(UNECE)が1981年から管理する5文字のUN/LOCODEであるCN SHAです。このシステムは249か国、10万以上の地点をカバーしています。BOLに運送人名が「Maersk Line」と印刷されていても、TMSが要求するのはNMFTAが管理するSCACコード(標準運送人アルファコード)MAEUかもしれません。貨物にはHSコードが必要です。世界税関機構が管理し、200か国以上で使用される調和システムに基づき、「woven polypropylene bulk bags」のような自然言語の貨物明細を6305.33にマッピングします。プレーンテキストを出力するだけのBOL抽出ツールは完成ではありません。標準化されたコードを出力するツールこそが完成形です。
これが、BOL抽出が請求書抽出やレシート抽出とは異なる問題である核心的な理由です。BOLデータ抽出の完全な定義と、TMSデータ入力などの関連概念との違いについては、BOLデータ抽出とはのガイドをご覧ください。
従来のOCRやテンプレート方式がBOLで通用しない理由
テンプレートベースのOCRは、レイアウトが固定された書類(自社の請求書、発注書、自社で設計したフォーム)向けに設計されています。船荷証券(BOL)は、その前提をあらゆるレベルで覆します。
マルチキャリアによるフォーマットの爆発的増加。 1日に100通のBOLを受け取るフレイトブローカーは、荷主がどのキャリアを利用したかを管理できません。BOLは、マースク(MAEU)、MSC(MSCU)、CMA CGM(CMDU)、ハパックロイド(HLCU)、COSCO(COSU)、ONE(ONEY)、エバーグリーン(EMCU)、そして十数社の地域トラック運送会社など、各社独自のレイアウトで届きます。テンプレートベースのOCRでは、キャリアのフォーマットごとに各フィールドのバウンディングボックスを描画する必要があります。50のキャリアとBOLあたり15フィールドの場合、定義・維持すべき座標長方形は750個になります。キャリアがフォームを更新すると(実際に頻繁にあります)、これらのテンプレートは静かに破綻し、誰かが税関からのB/L訂正手数料のパターンに気づくまで、正しい列に誤ったデータを出力し続けます。
手書き、スタンプ、カーボンコピーは例外ではない。 荷降ろしドックで記入されたBOLは、きれいなデジタルPDFではありません。荷受人名はペンで走り書きされ、個数は赤インクのスタンプが重ねられ、運賃条件「PREPAID」はマーカーで丸で囲まれています。スキャンは三代目のカーボンコピーで、元の文字が貨物記述フィールドに透けて見えます。従来のOCRは、スタンプをノイズ、カーボンの透けを余分な文字、90 DPI未満の手書きを判読不能として扱います。しかしBOLでは、これらの「ノイズ」要素こそが、キャリアの請求書紛争を引き起こす可能性が最も高い3つのデータポイント、すなわち手書きの個数、スタンプされた重量、マークされた運賃条件を保持しています。
NMFC貨物クラスには意味理解が必要。 全米自動車貨物分類システムは、密度、積載性、取扱性、責任に基づいて18の貨物クラス(50~500)を定義しています。BOLには、商品説明「木製家具、KD」の横に「クラス70」と記載されている場合もあれば、クラスを記載せずに商品のみを記載し、キャリアがクラスを適用することを期待する場合もあります。テンプレートOCRは、両方を同じボックス内のテキスト文字列として読み取ります。意味抽出は、「クラス70」が「木製家具」を修飾し、商品説明列ではなく貨物クラス列に属することを理解します。この区別が、運送状が正確であるか、3週間後に300ドルの再分類手数料を引き起こすかを決定します。
これらの3つの障害は複合的に作用します。キャリアごとのテンプレートが必要で、手書きが読めず、貨物クラスと商品説明を区別できないツールは、労力を節約するどころか、元のデータ入力タスクと同じくらい大きな確認待ちキューを生み出しているにすぎません。
最新のAI抽出が船荷証券を読み取る仕組み
手作業によるBOLデータ入力を置き換えるパイプラインは、取り込みから視覚的理解、フィールドマッピング、標準化、出力までを一貫して処理します。視覚AIモデルがBOLページを読み取り、位置ではなく意味に基づいてフィールドをマッピングする段階ごとの仕組みの詳細については、BOLデータ抽出ガイドをご覧ください。ここで詳しく説明する価値があるのは、本当のBOL抽出ツールと一般的なドキュメントリーダーを分ける段階、つまり標準化とコード検証です。
主要な船荷証券項目とそれを検証する基準
船荷証券の抽出プロジェクトは、どの項目が重要かを定義することから始まります。以下の表は、物流業務に必要な5つのグループ、各グループ内の具体的な項目、そして抽出された値が単に存在するだけでなく正しいかどうかを判断する検証基準を示しています。
| 項目グループ | 抽出する項目 | 検証基準 | 重要な理由 |
|---|---|---|---|
| 当事者 | 荷送人の名称・住所、荷受人、着荷通知先、運送会社/SCACコード | SCAC (NMFTA): 2〜4文字の運送会社コード; EU通関用のEORI番号 | 誤った配送先は1日あたり100〜500ドルの滞船料を発生させます。着荷通知先の誤りは、貨物の到着に気づかない事態を招きます。 |
| ルーティング | 船積港、荷揚港、貨物受取地、貨物引渡地、船舶/航海番号、コンテナ番号、シール番号 | UN/LOCODE (UNECE): 5文字コード(例: CN SHA、NL RTM);ISO 6346: コンテナのチェックディジット | ISF申告では、船積み24時間前までに正しい港コードが必要です。コンテナIDの不一致は税関の保留を引き起こします。 |
| 貨物 | 貨物明細、個数・梱包タイプ、総重量(kg/lbs)、正味重量、容積/寸法、貨物等級、NMFCコード、HSコード | NMFC: 18の貨物等級(50〜500);HS: 6桁の国際コード+国別拡張;SOLAS VGM: 2016年7月以降、コンテナの検証済み総重量が必須 | 貨物等級の再分類には1回の出荷あたり150〜300ドルのコストがかかります。HSコードの誤りは、関税不足額の最大10倍の税関罰金を招く可能性があります。 |
| 料金と条件 | 運賃支払条件(前払/着払)、海上運賃、燃料サーチャージ、ターミナル取扱料、付随費用 | インコタームズ2020: 費用とリスクの移転ポイントを定義 | 運賃支払条件の誤りは、誤った当事者への請求につながり、すでにフォワーダーに支払い済みの顧客からコストを回収することになります。 |
| 参照情報 | 船荷証券番号、HBL/MBL相互参照、予約番号、注文書/商業送り状の参照、ピックアップ日、納品日/到着予定日 | 形式は運送会社によって異なります。両方を扱うフォワーダー向けに、HBLとMBL間の相互参照検証 | 船荷証券番号がTMSにないと、出荷を追跡できません。納期の遅れはサービスレベル契約を損ないます。 |
コンテナ番号のチェックディジットは、特に価値の高い検証ゲートです。 ISO 6346では、各コンテナ識別子は、3文字の所有者コード(例: マースクのMSK)、1文字の機器カテゴリ識別子(貨物コンテナのU)、6桁のシリアル番号、および前の文字から計算されるチェックディジットで構成されます。抽出結果がMSKU 907082 3であるのに実際のコンテナがMSKU 907082 8だった場合、チェックディジットの不一致により、そのコンテナ番号がTMS、顧客の追跡ポータル、または税関申告に到達する前に、エラーが即座に検出されます。抽出中にこの検証を実行するツールは、コンテナがターミナルで紛失するまで気づかれない可能性のあるエラーを検出します。
貨物グループ(貨物明細、重量、貨物等級、HSコード)は、あらゆる船荷証券の中で最もデータ密度が高く、最もエラーが発生しやすいセクションです。また、運送会社によって最も大きく異なるセクションでもあります。ある船荷証券では、個別の重量と一括の貨物等級を持つ5つの貨物明細が記載されています。別のものでは、すべてを「FAK」(品目無差別運賃)という1行にまとめています。さらに別のものでは、荷主が手書きで余白にHSコードを追加しています。船荷証券の抽出ツールに必要なのは、運送会社ごとのレイアウトを知ることではありません。運送会社と荷主がデータを表現するあらゆる方法において、各データタイプがどのように見えるかを知ることです。
バッチ処理:複数運送会社の船荷証券を1つのスプレッドシートに
船荷証券の抽出は、1枚ずつではなく、一度に数十枚または数百枚を処理するバッチに対応して初めて、その真価を発揮します。ここでバッチファースト処理という設計思想が重要になります。
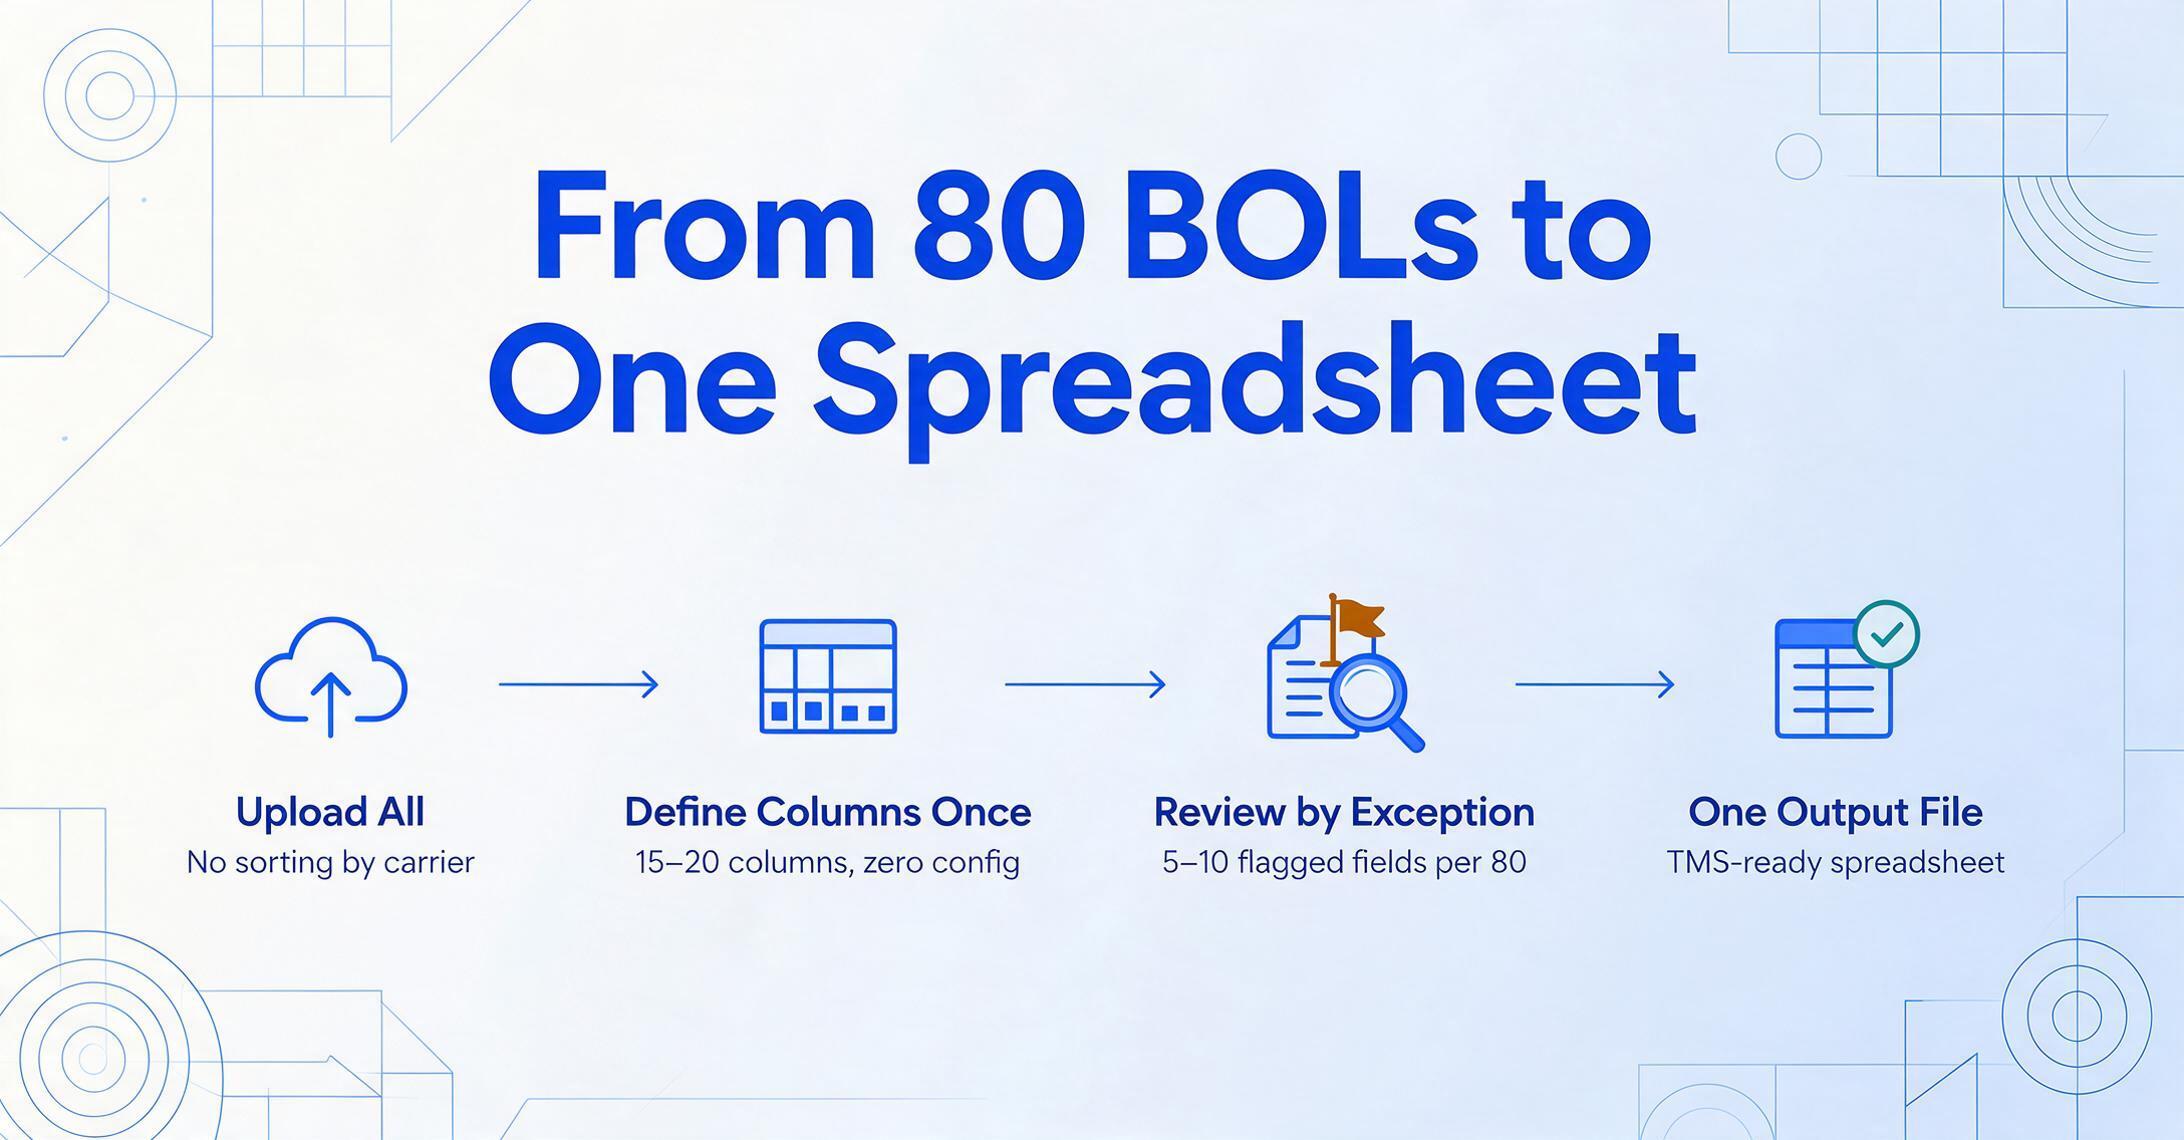
朝のメールから80枚の船荷証券を処理するフォワーダーを考えてみましょう。これら80枚のドキュメントは、12社の異なる運送会社からのもので、4種類の船荷証券(海上、ハウス、元地、記名式)にわたり、クリーンなデジタルPDFと地域のトラック会社からのスキャンされたカーボンコピーが混在しているかもしれません。この規模を実現するワークフローは次のとおりです。
1. すべての船荷証券を一度にアップロードします。運送会社ごとの仕分けも、船荷証券の種類による事前分類も不要です。バッチはPDF、JPG、PNG、複数ページのドキュメントを区別なく受け付けます。
2. 列を一度だけ定義します。同じ15〜20個の列名が、バッチ内のすべての船荷証券に適用されます。AIがマッピングを処理します:記名式船荷証券(HBL/MBLの相互参照なし)に遭遇した場合は、その列は空白のままにします。複数行の貨物グリッドを持つ海上船荷証券に遭遇した場合は、貨物明細ごとに別々の行に展開します。ドキュメントごとの設定は不要です。
3. 例外のみレビューします。AIが高い信頼度で抽出したフィールドは自動的に通過します。信頼度の低いフィールド(かすれたカーボンコピーの重量、にじんだシール番号など)は、人間によるレビューのためにフラグが付けられます。物流担当者は、80枚のバッチにつき5〜10個のフラグ付きフィールドを確認するだけで、1,200個のフィールドを手入力する必要はありません。これが、データ入力作業を置き換えることと、「データレビュー」と名前を変えるだけの違いです。
4. 1つの出力ファイル。結果は1つのExcelスプレッドシートです。船荷証券ごとに1行(複数行の貨物の場合は貨物明細ごとに1行)で、定義したフィールドに一致する列が含まれます。この出力はスプレッドシートネイティブです:ExcelまたはGoogle Sheetsに直接取り込まれ、TMSへのインポートにすぐ使えます。Google Sheetsを使用するチームの場合、船荷証券からTMSへのワークフローはサイドバーアドオンを介してスプレッドシート内で抽出を実行でき、ファイルの受け渡しステップを完全に排除できます。統合のオーバーヘッドなしでバッチ処理を拡張する詳細については、複数運送会社のバッチ船荷証券抽出をご覧ください。
エクスポートオプション: 抽出データを必要な場所へ届ける
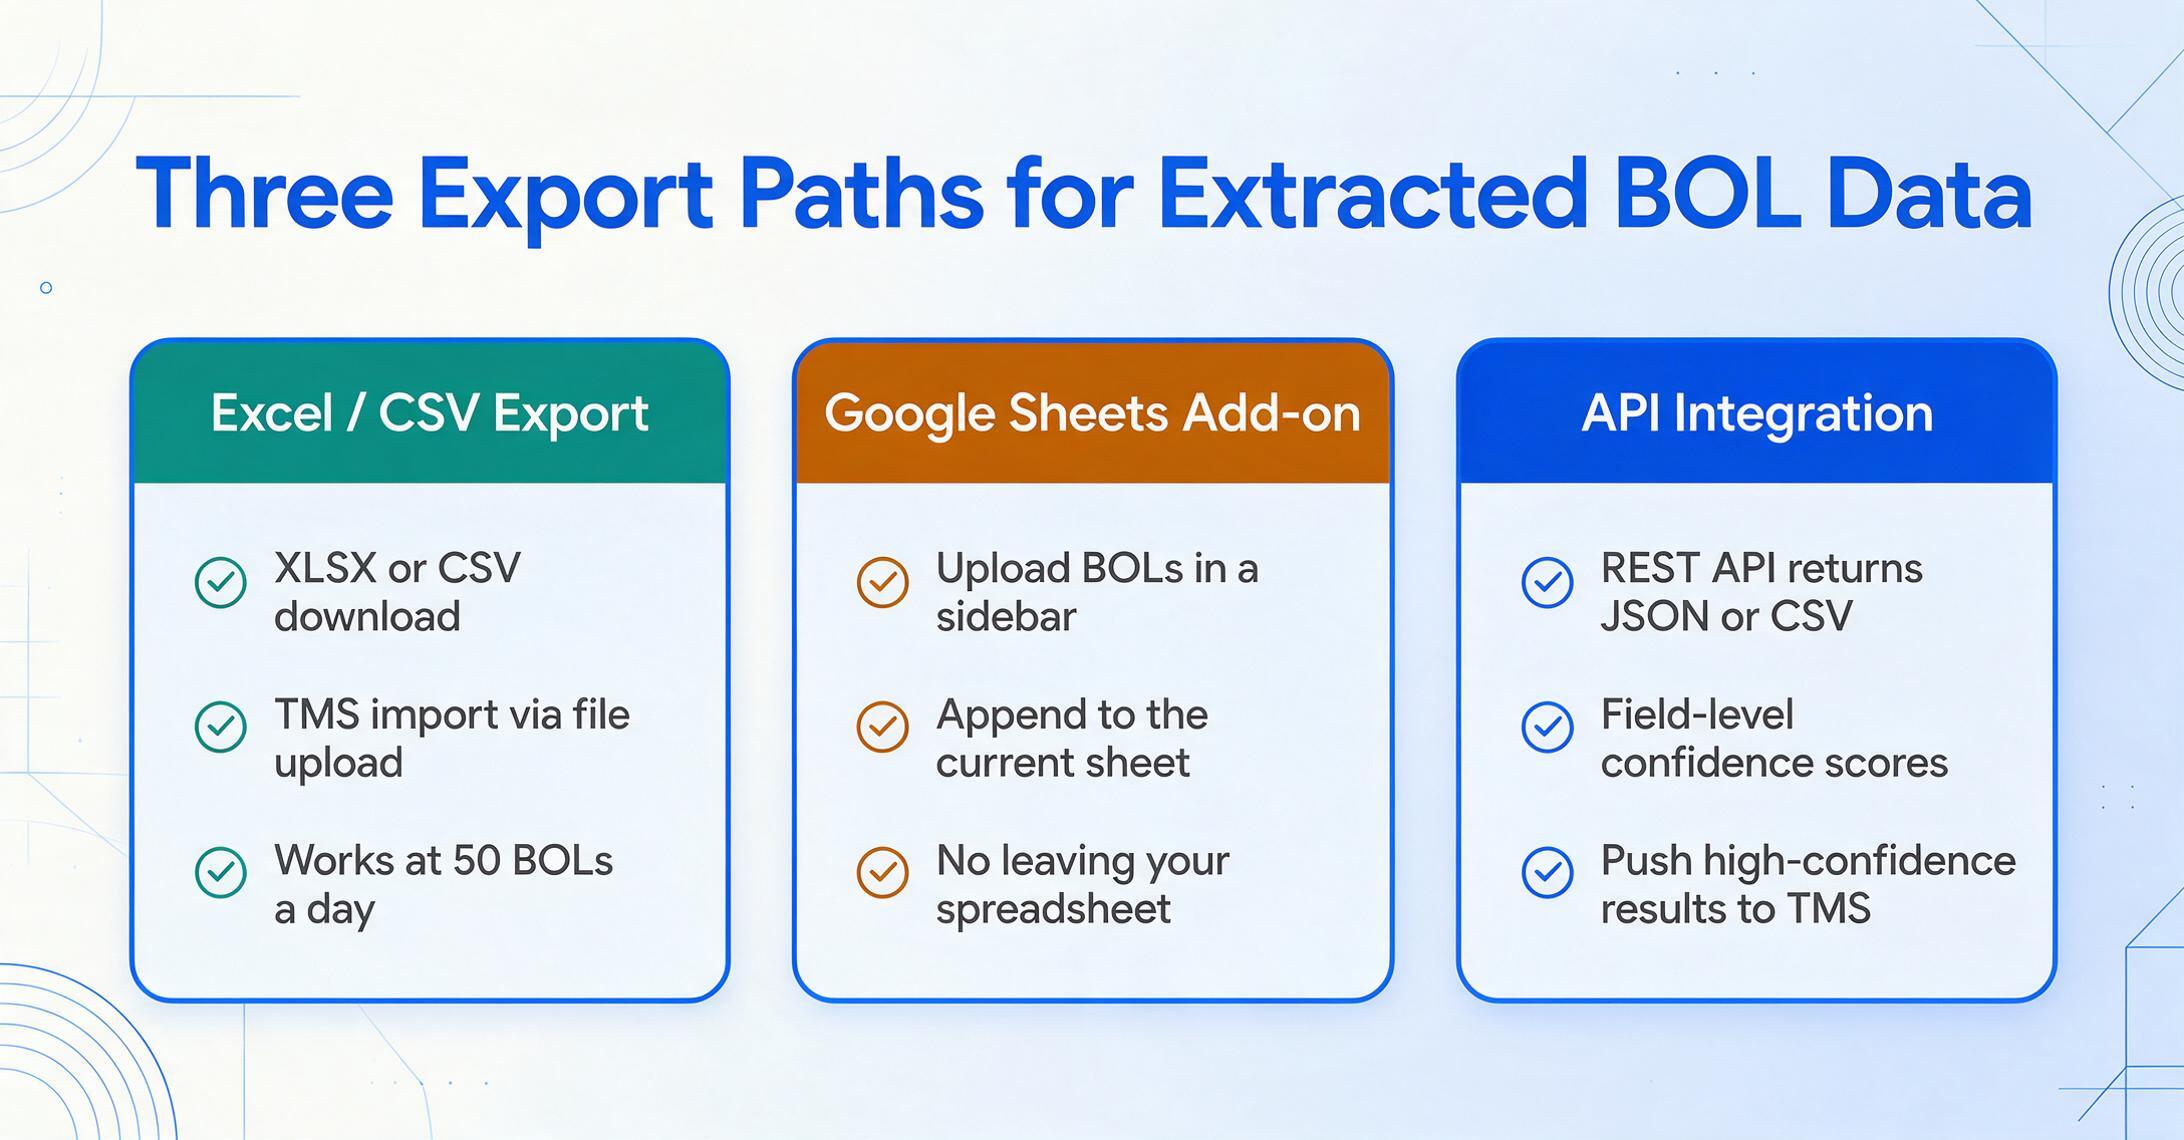
抽出されたBOLデータの目的は一つ、別のシステムに取り込むことです。どのシステムを使うかは、お客様の運用次第です。選択するエクスポート方法によって、抽出からワークフローまでの手作業の引き継ぎ量が決まります。
Excel / CSVエクスポート
対象: ファイルアップロードでTMSに取り込むチーム
抽出したBOLデータをXLSXまたはCSVでダウンロードします。列をTMSのインポートテンプレートにマッピングしてください。CargoWise、Descartes、McLeodなどはCSVインポートに対応しています。ファイル1つ、インポート1回、手入力は不要です。
Google Sheetsアドオン
対象: スプレッドシートで運用しているチーム
Google Sheetsのサイドバーアドオンを使えば、BOLをアップロードし、抽出列を定義し、構造化データを現在のシートに直接追加できます。追跡用スプレッドシートから離れる必要はありません。抽出は、チームがすでに使っているツール内で行われます。
API連携
対象: 社内システムで大量処理を行うチーム
REST APIがBOLファイルを受け取り、フィールド単位の信頼度スコア付きで構造化データ(JSONまたはCSV)をプログラム的に返します。低信頼度の抽出結果は自動的に人のレビューへ回し、高信頼度の結果はそのままTMSに取り込むことができます。
適切なエクスポート方法は、処理量と技術リソースによって異なります。1日50件のBOLなら、Excelエクスポート+TMSインポートで十分です。1日500件になると、手作業のファイル引き継ぎが新たなボトルネックになります。多くのチームはExcelエクスポートから始め、処理量が開発コストに見合うようになるとAPI連携へ移行します。抽出エンジンは両方の方法に対応しているべきです。エクスポート方法を変えてもツールを切り替える必要がないように。
BOL抽出ツールの選び方
本番レベルのBOLを処理できるツールと、クリーンなデジタル文書をたまに使うだけのツールを分ける5つの基準。
1. キャリアごとの設定不要で複数キャリアに対応。 試金石:マースクの海上BOL、MSCの海上BOL、オールドドミニオンのストレートBOL、地域LTLキャリアのスキャンカーボンコピーを、同じバッチ、同じ列定義で、テンプレートを1つも作らずに処理できるか。キャリアごとにフィールド位置の定義が必要なら、それは抽出ツールではなく、テンプレート保守作業を買っていることになる。
2. 標準コードの検証と正規化。 コンテナ番号をISO 6346チェックデジットルールで検証し、港名を標準形式(理想的にはUN/LOCODE)に正規化し、「Maersk」「MAERSK LINE」「MAEU」が同一キャリアを指すと認識できること。この層がなければ、手入力が手作業のデータクレンジングに変わるだけ——同じ労力、違う工程。
3. 複数ページと明細レベルの抽出。 コンテナ化貨物の海上BOLは3~5ページになることが多い。商品説明、コンテナ番号、シール番号、パッケージ数は継続ページに分散している。1ページ目しか読めないツールではデータの半分が未抽出のまま。各商品行が個別のデータ行になる明細対応は、税関分類や在庫照合に不可欠。
4. フィールドレベルの信頼度スコアリング。 実際の物流業務で受け取る文書品質の混在に対し、100%のストレートスルー処理を達成する抽出ツールは存在しない。重要なのは、ツールがどのフィールドに確信がないかを教えてくれること。抽出フィールドごとの信頼度インジケーター(高/中/低)があれば、チームは不確実な抽出(通常フィールドの5~10%)だけを確認し、残りはそのまま下流システムに流せる。
5. バッチファースト設計と統合出力。 1日5件の出荷なら1件ずつ処理でも問題ない。50件なら、バッチアップロード、バッチ処理、単一の統合出力——1つのスプレッドシート、BOLごとに1行、1回のエクスポート——が必要。ツールはバッチワークフロー用にゼロから設計されているべきで、複数選択ダイアログの裏で文書を順次処理する「バッチモード」を後付けしたものでは不十分。
これらの基準を、実際に受け取るBOL、実際に取引のあるキャリアの書類でテストすること。単一キャリアのクリーンなデジタルBOLのデモでは、火曜の朝に15キャリアから届く40件のBOLバッチをツールがどう処理するかは何も証明できない。
よくある質問
AI抽出はどのようなBOLタイプに対応できますか?
テンプレート不要のAI抽出ツールは、ストレートBOL、海上BOL、複合一貫輸送BOL、マスターBOL(MBL)、ハウスBOL(HBL)など、主要なBOLタイプすべてを同じ設定で処理できます。AIはテンプレート上の位置ではなく、意味に基づいてフィールドを識別するため、運送会社のストレートBOLとマースクの海上BOLが同じ列定義で処理されます。HBLのマスターBOL参照番号のようにBOLタイプ固有のフィールドがある場合は、全ドキュメントタイプにわたって必要なフィールドの和集合を定義し、該当ドキュメントに存在しないフィールドは空白のまま出力されます。
BOL抽出でISO 6346に基づくコンテナ番号の検証は可能ですか?
可能なツールもありますが、すべてではありません。ISO 6346コンテナ番号検証(所有者コードとシリアル番号からチェックデジットを計算し、抽出された数字と比較する処理)は、抽出後の検証レイヤーであり、転記ミスがTMSに到達する前に検出します。コンテナ検証がワークフロー上重要である場合(海上貨物を扱うなら重要です)、ベンダーに抽出パイプラインにこのステップが含まれているか確認してください。抽出されたチェックデジットと計算されたチェックデジットが一致しない場合は、そのフィールドを人間による確認対象としてフラグ付けする必要があります。
BOL抽出は手書き入力やドックレベルのBOLに対応していますか?
はい、ただし限定的です。最新のビジョンAIモデルは、判読可能な手書き(活字体のブロック体、ほとんどの筆記体、運転手が通常明確に記入するBOL番号や個数などの標準化されたフィールド)に対して、高い精度でBOLフィールドを読み取ることができます。ただし、薄くなったカーボンコピー、手書きに重なったスタンプ、ペン圧が弱すぎてスキャン可能な跡が残っていない文書では精度が低下します。このような場合、適切に設計された抽出ツールは推測値を出力するのではなく、低い信頼度スコアでフィールドをフラグ付けし、人間による確認を促します。
複数ページにわたるBOLで、貨物詳細が継続ページにある場合の抽出方法は?
最新の抽出システムは、複数ページのBOLを1つのドキュメントとして取り込み、抽出したフィールドを1つの出力レコードに統合します。荷主情報(荷送人、荷受人、通知先)は通常1ページ目にあります。貨物詳細、コンテナ番号、シール番号、梱包数は継続ページに記載されることが多く、ツールはこれらを同一貨物と認識して結合します。複数行の貨物明細の場合、各商品行はヘッダーフィールド(BOL番号、荷送人、港)を繰り返した個別の出力行になります。これは、明細レベルデータを期待するTMSの形式に準拠しています。
AIはハウスBOLとマスターBOLを区別できますか?
はい。ハウスBOLとマスターBOLは発行者の情報構造が異なります。HBLはフォワーダー(通常、フォワーダーのロゴと連絡先が記載)が発行し、MBLは船会社が発行します。AIはこれらの構造の違いを認識し、同一バッチで両方のタイプを抽出可能です。共通フィールド(港、コンテナ番号、荷送人、荷受人)は同じ列にマッピングし、HBLの参照番号や船会社のブッキング番号など、タイプ固有のフィールドは個別に処理します。
運送会社が同じBOLフィールドに異なる名称を使用する場合は?
ここで、テンプレートベースの手法に対するセマンティック抽出の優位性が発揮されます。運送会社Aが「Shipper」、運送会社Bが「Shipper/Exporter」、運送会社Cが「Consignor」とラベル付けしても、AIはこれらすべてが同一の主体(貨物を運送に委託する当事者)を指すと理解します。出力列を「荷送人名」と一度定義すれば、AIが各運送会社のバリエーションを自動的にその列にマッピングします。運送会社ごとのフィールドマッピングや変換テーブル、「もし運送会社がMaerskなら列A、MSCなら列B」といった条件分岐ロジックは不要です。
抽出したBOLデータをTMSに直接取り込めますか?
ほとんどの抽出ツールはExcelまたはCSVにエクスポート可能で、プラットフォームの標準インポート機能を介してTMSに取り込めます。CargoWise、Descartes、Turvo、McLeodなどのプラットフォームは構造化ファイルのインポートに対応しています。抽出結果をエクスポートし、列をTMSのインポートテンプレートにマッピングしてアップロードします。ファイルを介さず直接プッシュする場合は、REST APIを備えたツールでプログラムによる統合が可能です。チームがGoogle Sheetsで運用している場合、サイドバーアドオンアプローチにより、TMSインポートに使用するスプレッドシートにBOLデータを直接抽出できます。ファイルのダウンロードとアップロードのサイクルは不要です。
異なる船会社のBOLで期待できる精度はどのくらいですか?
最新のAI抽出技術では、主要船会社(Maersk、MSC、CMA CGM、Hapag-Lloyd、COSCO、ONE、Evergreen)の鮮明なデジタルBOLに対して、フィールドレベルで95〜99%の精度を達成しています。低解像度のスキャン、カーボンコピーの劣化が激しい文書、手書きのドックBOLでは精度は低下しますが、それでも同じ文書に対するテンプレートOCRの精度をはるかに上回ります。重要なのは生の精度ではなく、信頼できる処理量です。つまり、手作業による介入なしに処理できるBOLの数です。信頼スコア付きでフィールドレベル95%の精度があれば、約5%のフィールドを確認するだけで済みます。20フィールドの抽出であれば、BOL1枚あたり約1フィールドの確認ですみます。これは、80枚のバッチで80フィールドを確認するのと、1,600フィールドを手入力するのとの違いです。
BOL抽出は通関士の代わりになりますか?
いいえ。BOL抽出はデータ入力のステップ(BOLからフィールドを読み取り、構造化された形式に変換する作業)を自動化するものです。ライセンスを持つ通関士が提供する規制上の判断(HSコード分類の決定、関税評価の評価、自由貿易協定の適格性判断、輸入申告戦略)に取って代わるものではありません。抽出により入力作業がなくなるため、通関士は専門知識を要する分類やコンプライアンスの判断に時間を費やすことができます。抽出が物流文書全体の中でどのように位置づけられるかの詳細については、BOL抽出とは何かに関するガイドを、またBOLが船積書類一式(マニフェスト、梱包明細書、商業送り状)とどのように照合されるかについては、海運・貨物書類の抽出に関するガイドをご覧ください。
船積データを取得する際のBOL抽出とEDIの違いは何ですか?
EDI(電子データ交換)は、船会社から構造化された船積データを直接提供するため、抽出は不要です。ただし、EDIは船会社ごとの設定、テスト、継続的なメンテナンスが必要であり、多くの中小の船会社やフォワーダーはEDIに対応していません。実際には、ほとんどの物流業務では、主要船会社からの定期航路はEDI、その他はPDFのBOLというように、両方を受け取っています。BOL抽出はPDF側を処理します。この2つのアプローチは競合するものではなく、補完的なものです。完全な比較については、EDIとAIによるBOL抽出をご覧ください。
船荷証券の抽出は、遅いデータ入力プロセスを速くすることではありません。そのステップ自体をなくすことです。つまり、人間のオペレーターが、自分が作成したわけではない文書から、覚えなければならなかった船会社の略語を使ってフィールドを転記し、タイプミスを検出できないTMSに入力する、そのステップをなくすことです。BOLが受信箱とTMSの間で滞留する1時間ごとに、顧客は荷物を追跡できず、通関申告は開始されず、船会社の請求書を実際に受け取った貨物と照合することができません。抽出はそのギャップを数秒に縮めます。取り戻した時間をどう使うかは、あなた次第です。