La guía completa para
la extracción de datos de conocimientos de embarque
Un conocimiento de embarque no es un solo documento. Es una familia de tipos de documentos legalmente distintos: conocimientos de embarque nominativos, conocimientos de embarque marítimos, transportes multimodales, conocimientos de embarque máster y house. Cada uno tiene campos diferentes, emisores diferentes y destinos de datos diferentes. Un agente de carga que procesa 100 B/L al día podría tocar ocho diseños de documentos distintos de cinco transportistas antes del almuerzo. La extracción que funciona con un tipo de B/L y falla con el siguiente no es extracción: es una solución parcial con un respaldo manual. Esta guía cubre lo que realmente necesita saber para extraer datos de B/L de manera confiable en todos los tipos, todos los transportistas y todos los códigos estándar que su TMS espera.
Conclusiones clave
- La extracción basada en plantillas para conocimientos de embarque significa mantener 750 rectángulos de coordenadas en 50 transportistas, y cuando Maersk mueve el número de contenedor del cuadrante superior derecho a la mitad de la página, cada B/L que envían produce un campo vacío hasta que alguien edita la plantilla.
- El absurdo no es solo la carga de mantenimiento: es que cada cambio de plantilla es una nueva oportunidad para que una identificación de contenedor mal leída llegue a su TMS, al portal de seguimiento de su cliente o a una declaración aduanera antes de que alguien note que el contenedor ha estado desaparecido durante tres días.
- Una sola definición de columna semántica reemplaza las 750 plantillas y valida los números de contenedor contra los dígitos de verificación de ISO 6346 durante la extracción, detectando un dígito mal escrito antes de que salga de la capa de extracción, no después de que el reloj de demora comience a correr.
Qué hace que la extracción de BOL sea diferente de la extracción de otros documentos
La mayoría de los artículos sobre extracción de documentos tratan un conocimiento de embarque como si fuera una factura con un barco encima. Esa suposición produce herramientas que funcionan en demostraciones y fallan en producción. He aquí por qué los BOL son estructuralmente diferentes de cualquier otro documento del que extraiga datos.
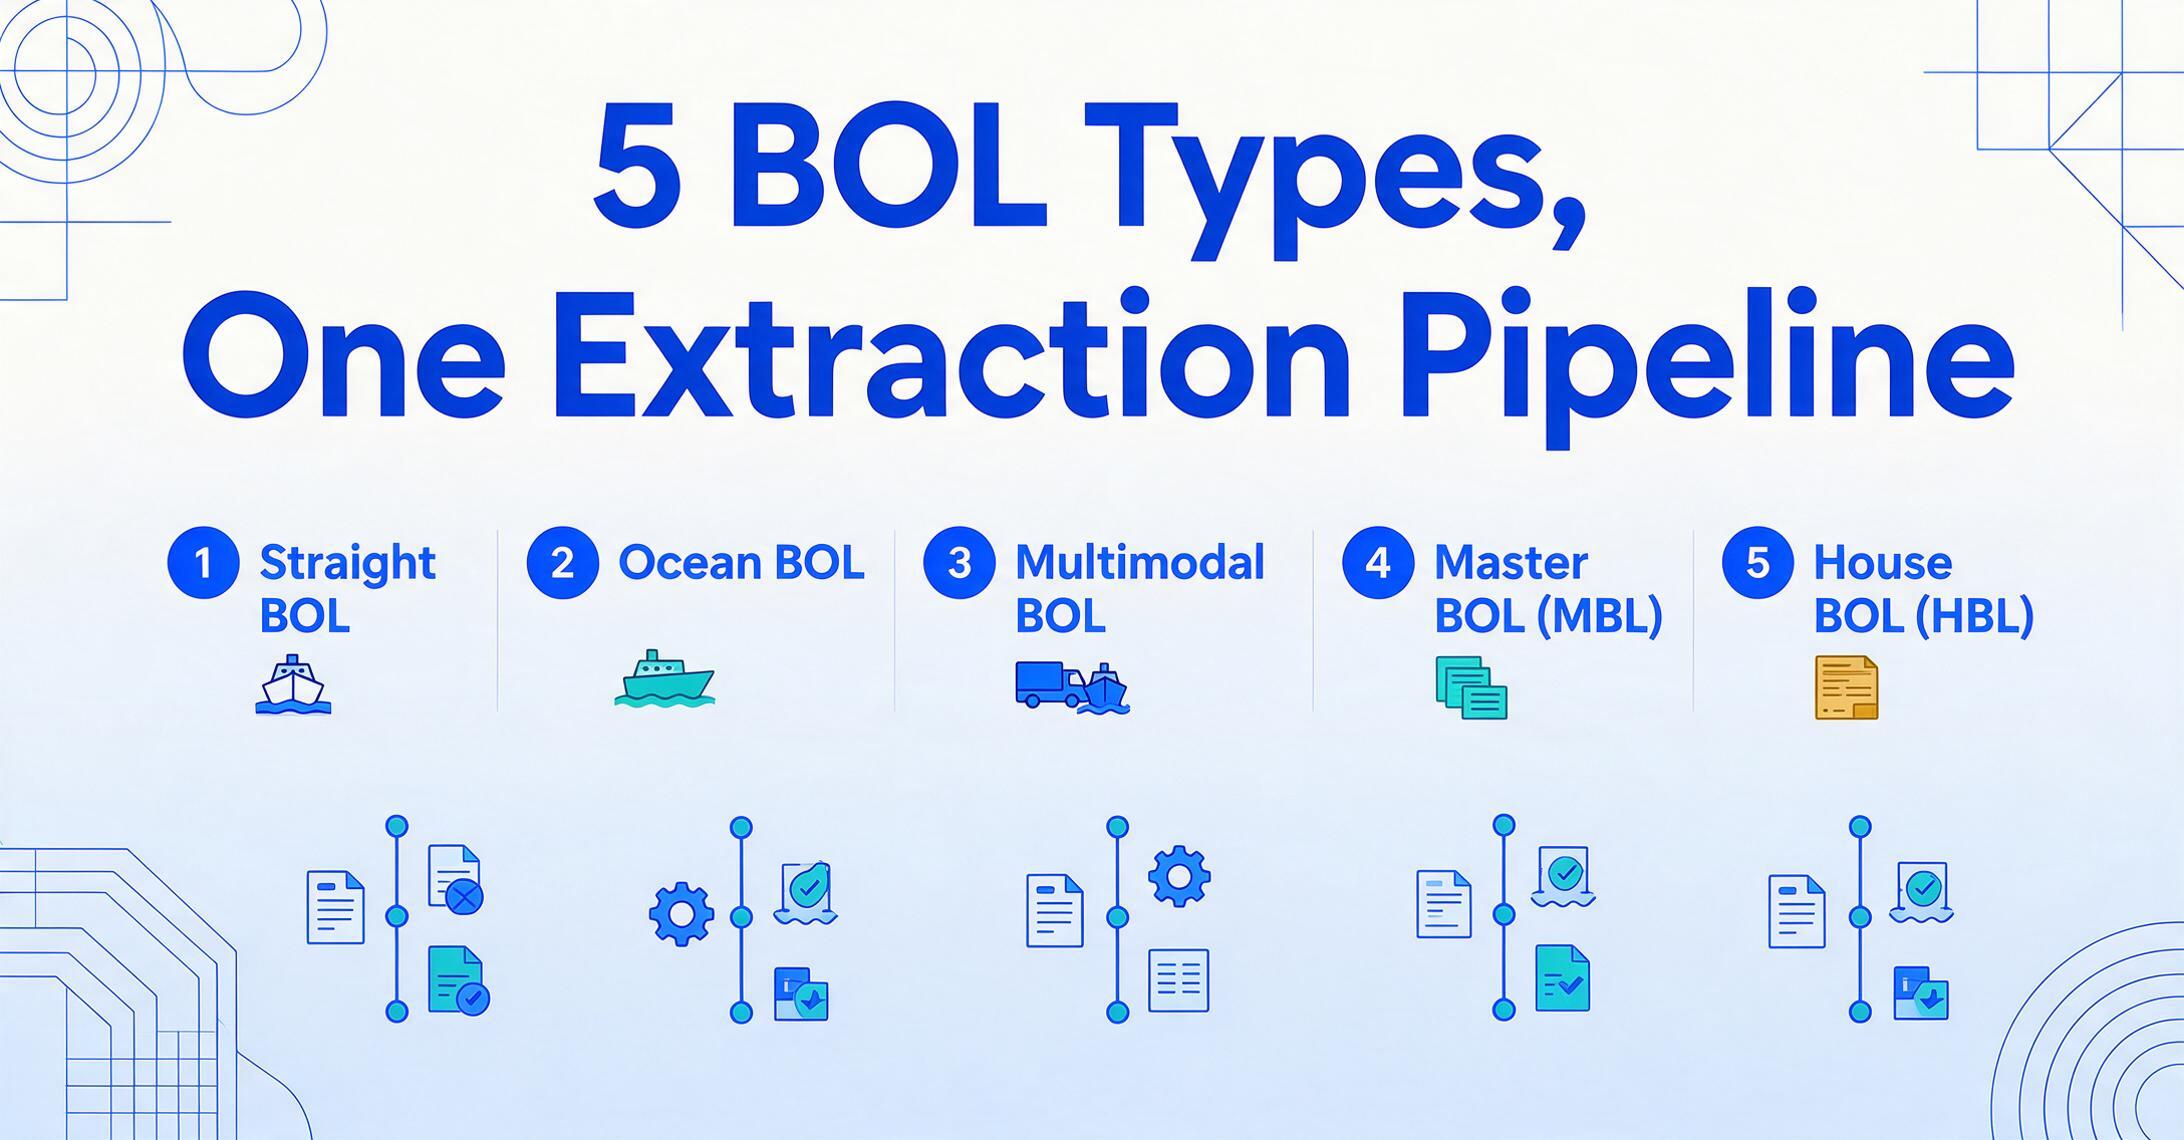
Cinco tipos de documentos legalmente distintos, un solo proceso de extracción. Un conocimiento de embarque nominativo (no negociable) designa a un consignatario específico y no puede transferirse: es la forma más simple, común en el transporte LTL (carga fraccionada). Un conocimiento de embarque marítimo es negociable y sirve como título de propiedad según las Reglas de La Haya-Visby: quien posea el original puede reclamar la carga. Un conocimiento de embarque multimodal (también llamado de transporte combinado) cubre tramos marítimos, ferroviarios y por carretera bajo un solo documento regido por las Reglas UNCTAD/CCI para documentos de transporte multimodal. Luego viene la división que todo agente de carga maneja a diario: el conocimiento de embarque máster (MBL) emitido por el transportista al agente, y el conocimiento de embarque house (HBL) emitido por el agente al cargador: dos documentos para el mismo envío, que comparten campos como números de contenedor y puertos, pero con diferentes nombres de emisor, números de referencia y condiciones de pago de flete.
Cada tipo reorganiza los campos de manera diferente. Un BOL marítimo de Maersk coloca el número de contenedor en el cuadrante superior derecho, junto al nombre del buque. Un BOL de MSC lo coloca a mitad de página, encima de la cuadrícula de descripción de la carga. Un BOL house añade un número de referencia HBL que hace referencia cruzada al BOL máster, un campo que un BOL nominativo no tiene en absoluto. Una herramienta de extracción que no pueda manejar los cinco tipos sin configuración específica por tipo deja a su equipo manteniendo plantillas en lugar de mover carga.
Los datos no solo necesitan leerse, necesitan traducirse. Un BOL puede indicar el puerto de carga como "CNSHA", "Shanghai" o "Puerto de Shanghai, CN". Su sistema de gestión de transporte (TMS) espera CN SHA, el UN/LOCODE de cinco caracteres mantenido por la Comisión Económica de las Naciones Unidas para Europa (UNECE) desde 1981, un sistema que cubre más de 100 000 ubicaciones en 249 países. Un BOL puede imprimir el nombre del transportista como "Maersk Line" mientras su TMS requiere el código SCAC (Código Alfabético Estándar de Transportistas) MAEU, gestionado por la NMFTA. Las mercancías necesitan códigos SA: el Sistema Armonizado mantenido por la Organización Mundial de Aduanas, utilizado por más de 200 países — asignados a partir de una descripción de carga en lenguaje natural como "bolsas tejidas de polipropileno a granel" hasta 6305.33. Una herramienta de extracción de BOL que genera texto plano no está terminada. Una que genera códigos estandarizados sí lo está.
Este es el desafío central que hace que la extracción de BOL sea un problema diferente de la extracción de facturas o recibos. Para una definición completa de la extracción de datos de BOL y en qué se diferencia de conceptos adyacentes como el ingreso de datos en un TMS, consulte nuestra guía qué es la extracción de datos de BOL.
Por qué el OCR tradicional y los enfoques basados en plantillas fallan con los B/L
El OCR basado en plantillas fue diseñado para documentos con un diseño controlado: tus propias facturas, tus propias órdenes de compra, formularios que diseñaste tú mismo. Los conocimientos de embarque rompen esa suposición en todos los niveles.
Explosión de formatos de múltiples transportistas. Un agente de carga que recibe 100 B/L al día no controla qué transportistas usaron sus cargadores. Esos B/L llegan en los formatos de Maersk (MAEU), MSC (MSCU), CMA CGM (CMDU), Hapag-Lloyd (HLCU), COSCO (COSU), ONE (ONEY), Evergreen (EMCU) y una docena de empresas de camiones regionales, cada una con su propio diseño. El OCR basado en plantillas requiere dibujar cuadros delimitadores alrededor de cada campo por formato de transportista. Para 50 transportistas y 15 campos por B/L, eso son 750 rectángulos de coordenadas que definir y mantener. Cuando un transportista actualiza su formulario — y lo hacen — esas plantillas fallan silenciosamente, produciendo datos incorrectos en las columnas correctas hasta que alguien nota el patrón de cargos por corrección de B/L de aduanas.
Escritura a mano, sellos y copias carbón no son casos excepcionales. Un B/L completado en un muelle de carga no es un PDF digital limpio. El nombre del consignatario fue garabateado con bolígrafo. El recuento de piezas fue estampado en tinta roja. Los términos de flete — "PREPAID" — fueron marcados con un rotulador. El escaneo es una copia carbón de tercera generación donde el texto original traspasa al campo de descripción de la carga. El OCR tradicional trata los sellos como ruido, el traspaso de carbón como caracteres extra y la escritura a mano por debajo de 90 DPI como ilegible. Pero en un B/L, esos elementos de "ruido" contienen los tres datos con más probabilidades de desencadenar una disputa de factura de transportista: el recuento de piezas escrito a mano, el peso estampado y los términos de flete marcados.
La clase de flete NMFC requiere comprensión semántica. El sistema de Clasificación Nacional de Flete Motorizado define 18 clases de flete (50 a 500) basadas en densidad, estibabilidad, manejo y responsabilidad. Un B/L puede listar "Clase 70" junto a la descripción de la mercancía "Muebles de Madera, KD" — o puede listar la mercancía sin la clase, esperando que el transportista la aplique. El OCR de plantillas lee ambas como cadenas de texto en la misma casilla. La extracción semántica entiende que "Clase 70" modifica "Muebles de Madera" y pertenece a la columna de Clase de Flete, no a la de Descripción de la Mercancía. Esa distinción determina si una factura de flete es precisa o desencadena un cargo de reclasificación de $300 tres semanas después.
Estos tres modos de fallo se combinan. Una herramienta que necesita plantillas por transportista, no puede leer escritura a mano y no puede distinguir clases de flete de descripciones de mercancía no está ahorrando trabajo — está creando una cola de revisión tan grande como la tarea original de ingreso de datos.
Cómo la extracción moderna con IA lee un conocimiento de embarque
El proceso que reemplaza la captura manual de datos de BOL abarca desde la recepción hasta la comprensión visual, el mapeo de campos, la estandarización y la salida. Para conocer el mecanismo completo, etapa por etapa, de cómo un modelo de IA de visión lee una página de BOL y mapea los campos por significado y no por posición, consulte nuestra guía sobre extracción de datos de BOL. Lo que vale la pena ampliar aquí —porque es la etapa que distingue una herramienta real de extracción de BOL de un lector de documentos genérico— es la estandarización y la validación de códigos.
Campos clave del B/L y los estándares que los validan
Cada proyecto de extracción de B/L comienza definiendo qué campos son importantes. La tabla a continuación cubre los cinco grupos que toda operación logística necesita, los campos específicos dentro de cada uno y el estándar de validación que determina si el valor extraído es correcto, no solo que esté presente.
| Grupo de campos | Campos a extraer | Estándar de validación | Por qué es importante |
|---|---|---|---|
| Partes | Nombre y dirección del embarcador, Consignatario, Notificar a, Transportista/Código SCAC | SCAC (NMFTA): código de transportista de 2 a 4 letras; números EORI para aduanas de la UE | Una entrega mal dirigida genera demoras de $100–500 por día; un notificar a incorrecto significa que la llegada del envío pase desapercibida |
| Ruta | Puerto de carga, Puerto de descarga, Lugar de recepción, Lugar de entrega, Buque/Viaje, Número de contenedor, Número de sello | UN/LOCODE (UNECE): código de 5 caracteres (p. ej., CN SHA, NL RTM); ISO 6346: dígito verificador del contenedor | La declaración ISF requiere códigos de puerto correctos 24 horas antes de la carga; una discrepancia en el ID del contenedor provoca retención aduanera |
| Carga | Descripción de la mercancía, Número de bultos y tipo de empaque, Peso bruto (kg/lbs), Peso neto, Volumen/Dimensiones, Clase de carga, Código NMFC, Código SA | NMFC: 18 clases de carga (50–500); SA: 6 dígitos internacionales + extensión específica por país; SOLAS VGM: masa bruta verificada obligatoria para contenedores desde julio de 2016 | La reclasificación de la clase de carga cuesta $150–300 por envío; los errores en el código SA generan multas aduaneras de hasta 10 veces el faltante de aranceles |
| Cargos y condiciones | Condiciones de flete (Prepago/Debido), Flete marítimo, Recargo por combustible, Manejo en terminal, Cargos accesorios | Incoterms 2020: define los puntos de transferencia de costos y riesgos | Condiciones de pago de flete incorrectas implican facturar a la parte equivocada y recuperar costos de un cliente que ya pagó al agente de carga |
| Referencia | Número de B/L, Referencia cruzada HBL/MBL, Número de reserva, Referencias de OC/Factura comercial, Fecha de recogida, Fecha de entrega/ETA | El formato varía según el transportista; validación de referencia cruzada entre HBL y MBL para agentes de carga que manejan ambos | El envío no se puede rastrear sin el número de B/L en el TMS; las ventanas de entrega incumplidas erosionan los compromisos de nivel de servicio |
El dígito verificador del número de contenedor es una puerta de validación particularmente valiosa. Según ISO 6346, cada identificador de contenedor consta de un código de propietario de tres letras (p. ej., MSK para Maersk), un identificador de categoría de equipo de una letra (U para contenedor de carga), seis dígitos de serie y un dígito verificador calculado a partir de los caracteres anteriores. Si su extracción genera MSKU 907082 3 pero el contenedor real era MSKU 907082 8, la discrepancia en el dígito verificador señala el error de inmediato, antes de que ese número de contenedor llegue a su TMS, al portal de seguimiento de su cliente o a una declaración aduanera. Una herramienta que realiza esta validación durante la extracción detecta errores que de otro modo sobrevivirían hasta que un contenedor se pierda en una terminal.
El grupo de carga (descripciones de mercancía, pesos, clase de carga, códigos SA) es la sección con mayor densidad de datos de cualquier B/L y la más propensa a errores. También es la sección que más varía entre transportistas. Un B/L lista cinco líneas de mercancía con pesos individuales y una clase de carga general; otro consolida todo en una sola línea con "FAK" (Flete de toda clase). Un tercero añade un código SA en el margen escrito a mano por el embarcador. Una herramienta de extracción de B/L no necesita conocer el diseño de cada transportista. Necesita saber cómo se ve cada tipo de dato en todas las formas en que transportistas y embarcadores lo representan.
Procesamiento por lotes: B/L de múltiples transportistas, una sola hoja de cálculo
La extracción de B/L solo ofrece su valor completo cuando maneja lotes, no un documento a la vez, sino docenas o cientos en una sola ejecución. Aquí es donde importa la premisa de diseño del procesamiento por lotes prioritario.
Considere un agente de carga que procesa 80 B/L de los correos de una mañana. Esos 80 documentos pueden provenir de 12 transportistas diferentes, abarcar cuatro tipos de B/L (marítimo, house, máster, nominativo) e incluir una mezcla de PDF digitales limpios y copias carbón escaneadas de empresas de camiones regionales. El flujo de trabajo que permite esta escala:
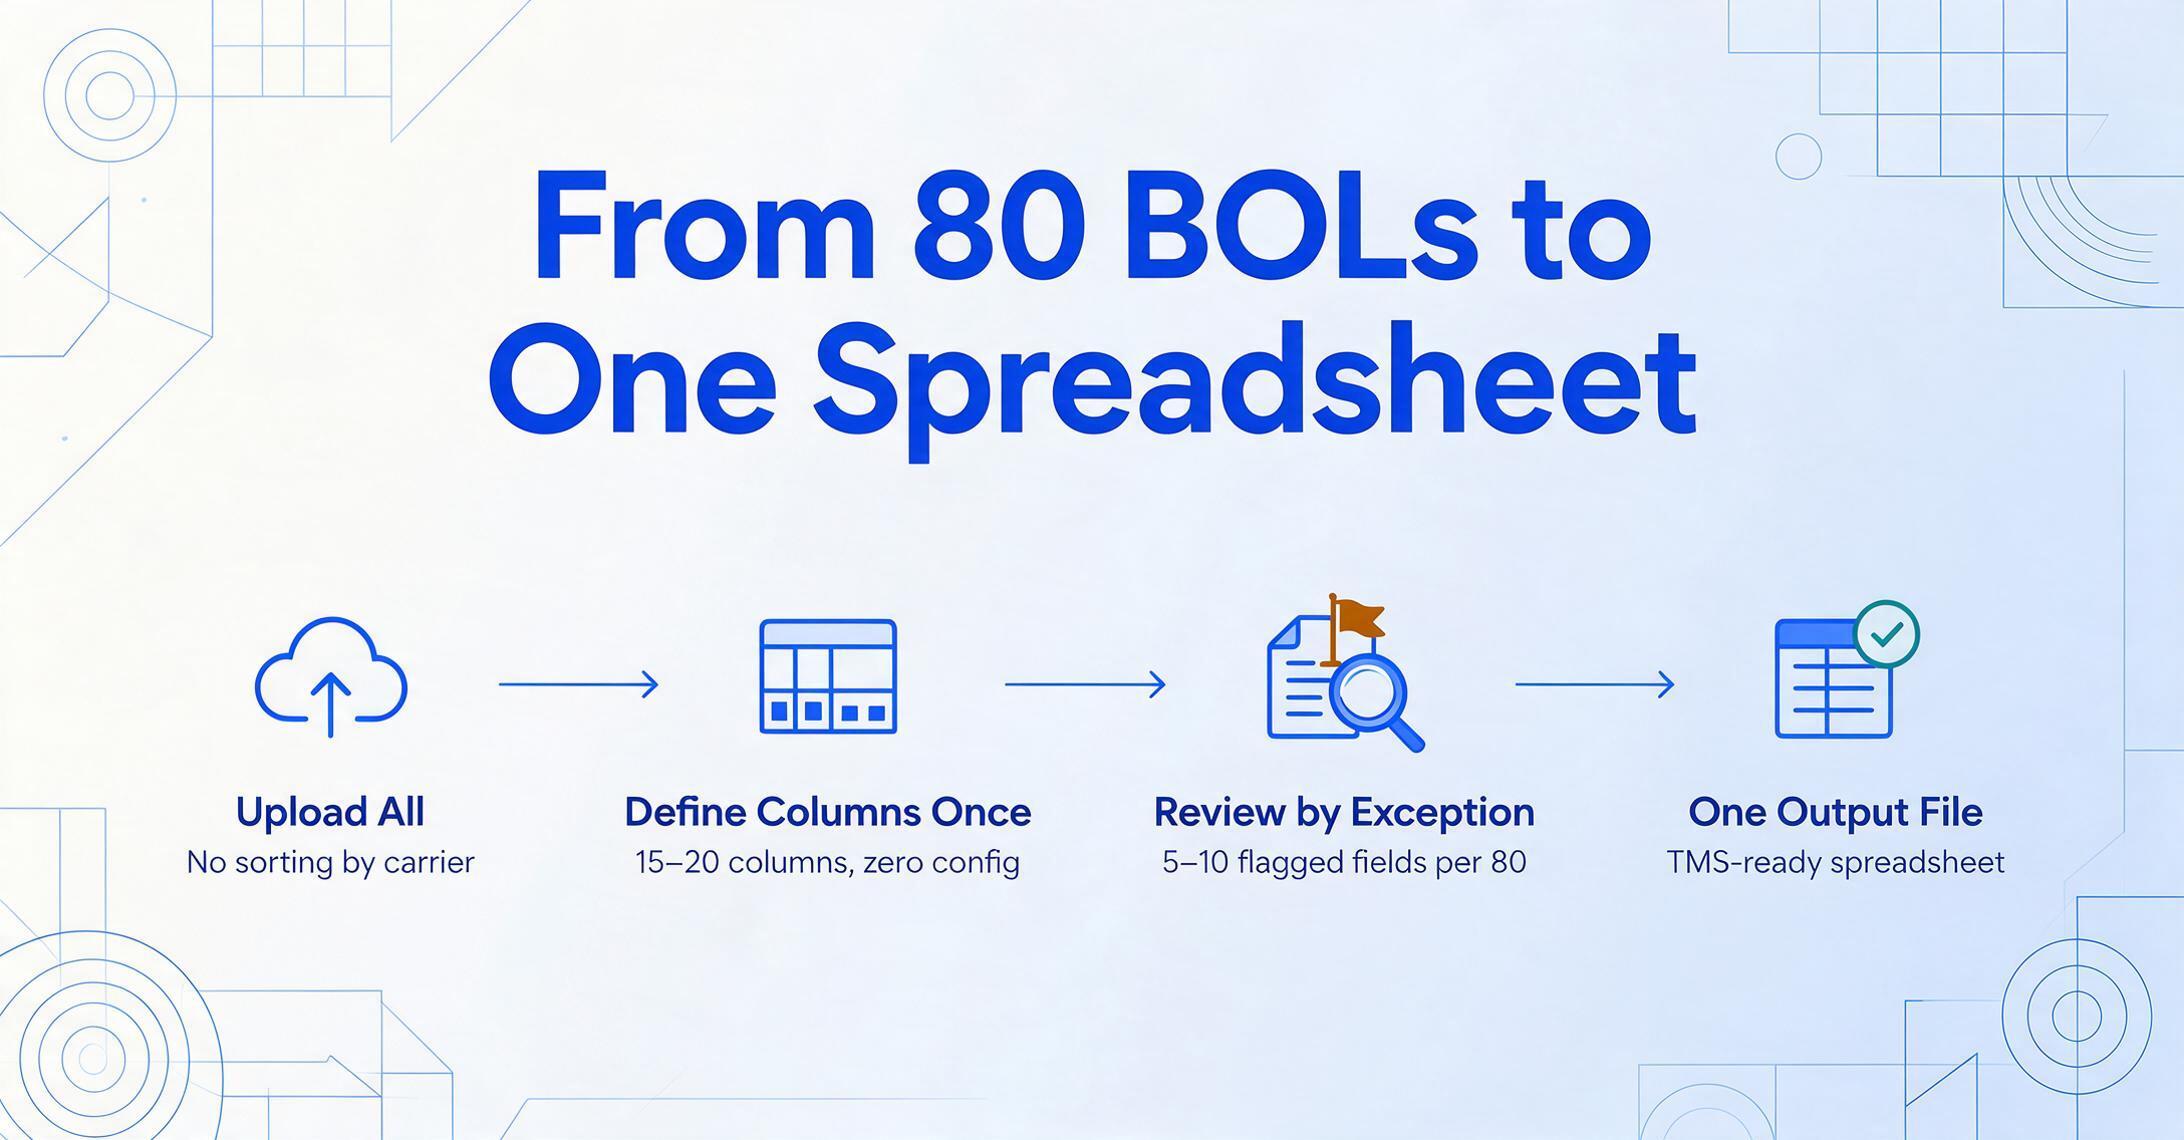
1. Suba todos los B/L a la vez. Sin clasificar por transportista, sin preclasificación por tipo de B/L. El lote acepta PDF, JPG, PNG y documentos de varias páginas sin distinción.
2. Defina sus columnas una sola vez. Los mismos 15–20 nombres de columna se aplican a cada B/L del lote. La IA maneja el mapeo: cuando encuentra un B/L nominativo (sin referencia cruzada HBL/MBL), deja esa columna en blanco. Cuando encuentra un B/L marítimo con una cuadrícula de carga de varias líneas, se expande en filas separadas por línea de mercancía. Sin configuración por documento.
3. Revise por excepción. Los campos que la IA extrae con alta confianza pasan automáticamente. Los campos con menor confianza (un peso de copia carbón desvanecido, un número de sello borroso) se marcan para revisión humana. Un empleado de logística verifica de 5 a 10 campos marcados por lote de 80 documentos en lugar de escribir 1,200 campos manualmente. Esta es la diferencia entre reemplazar el trabajo de captura de datos y simplemente renombrarlo como "revisión de datos".
4. Un solo archivo de salida. El resultado es una sola hoja de cálculo de Excel: una fila por B/L (o por línea de mercancía, para envíos de varias líneas), con columnas que coinciden con los campos que usted definió. Esta salida es nativa de hojas de cálculo: llega directamente a Excel o Google Sheets, lista para importar al TMS. Para equipos que usan Google Sheets, el flujo de trabajo de B/L a TMS puede ejecutar la extracción dentro de la hoja de cálculo mediante un complemento de barra lateral, eliminando por completo el paso de transferencia de archivos. Para más información sobre cómo escalar el procesamiento por lotes sin sobrecarga de integración, consulte extracción de B/L por lotes de múltiples transportistas.
Opciones de exportación: cómo llevar los datos extraídos a donde deben ir
Los datos extraídos de un BOL tienen un solo propósito: ingresar a otro sistema. Cuál depende de su operación. La ruta de exportación que elija determina cuánta transferencia manual queda entre la extracción y su flujo de trabajo.
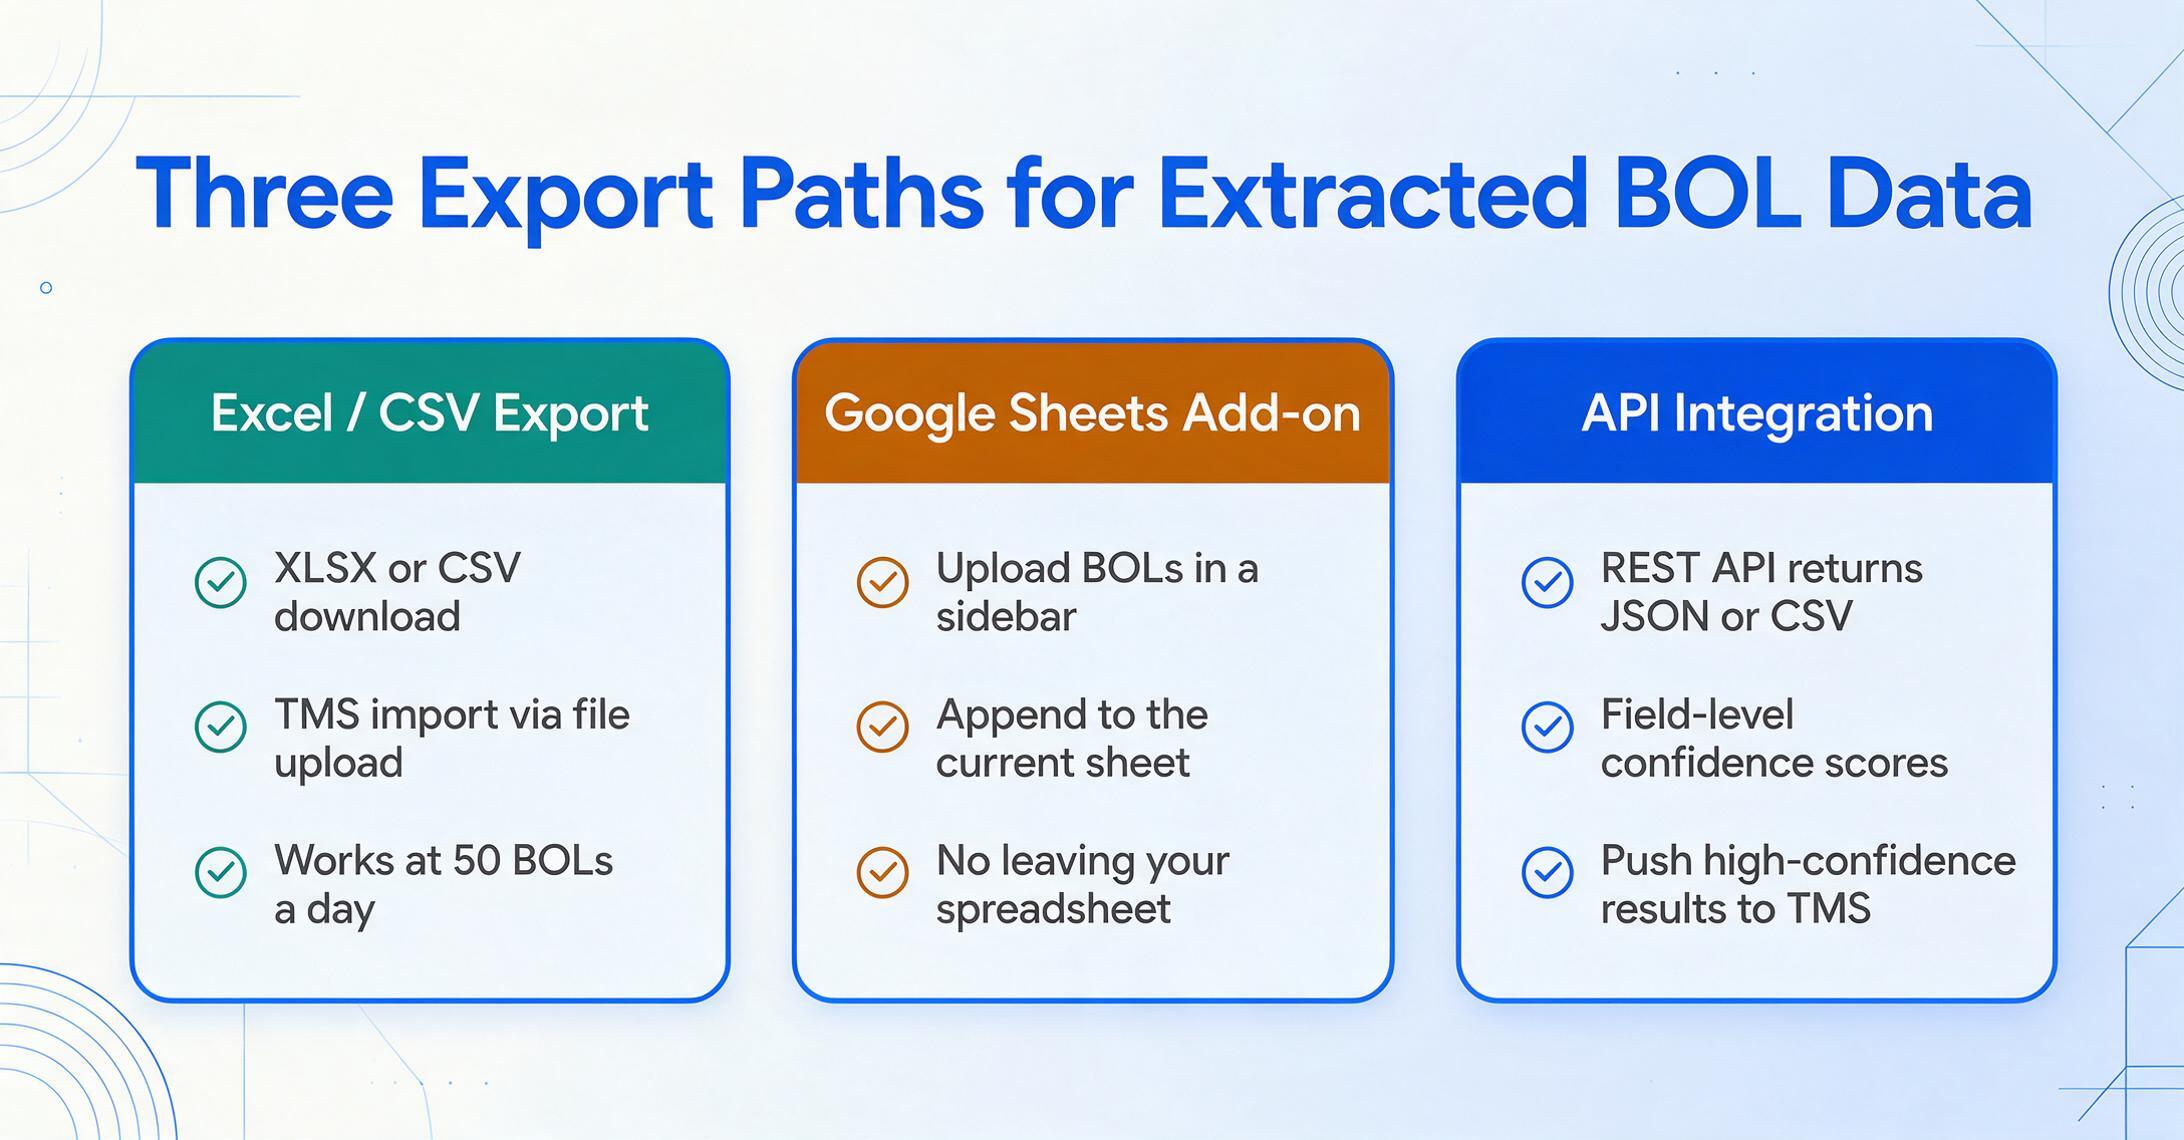
Exportación a Excel / CSV
Para: Equipos que importan al TMS mediante carga de archivos
Descargue los datos extraídos del BOL como XLSX o CSV. Asigne las columnas a su plantilla de importación del TMS: CargoWise, Descartes, McLeod y otros admiten importación CSV. Un archivo, una importación, sin teclear.
Complemento de Google Sheets
Para: Equipos que operan mediante hojas de cálculo
Un complemento lateral de Google Sheets le permite cargar BOL, definir columnas de extracción y añadir datos estructurados directamente a la hoja actual, sin salir de su hoja de seguimiento. La extracción ocurre dentro de la herramienta que su equipo ya usa.
Integración API
Para: Operaciones de alto volumen con sistemas internos
Una API REST recibe archivos BOL y devuelve datos estructurados de forma programática: JSON o CSV con puntuaciones de confianza a nivel de campo. Su sistema puede enrutar automáticamente las extracciones de baja confianza a revisión humana y enviar los resultados de alta confianza directamente al TMS.
La ruta de exportación adecuada depende de su volumen y recursos técnicos. Con 50 BOL al día, la exportación a Excel + importación al TMS funciona. Con 500 al día, la transferencia manual de archivos se convierte en el nuevo cuello de botella. La mayoría de los equipos comienzan con la exportación a Excel y pasan a la integración API cuando el volumen justifica el trabajo de desarrollo. El motor de extracción debe admitir ambas rutas para que no cambie de herramienta al cambiar de método de exportación.
Cómo elegir una herramienta de extracción de BOL
Cinco criterios separan las herramientas que manejan volúmenes de producción de BOL de aquellas diseñadas para uso ocasional en documentos digitales limpios.
1. Manejo de múltiples transportistas sin configuración por transportista. La prueba de fuego: procesar un BOL marítimo de Maersk, un BOL marítimo de MSC, un BOL directo de Old Dominion y una copia carbón escaneada de un transportista LTL regional — en el mismo lote, con las mismas definiciones de columna, sin crear una sola plantilla. Si la herramienta requiere definir posiciones de campo por transportista, está comprando un trabajo de mantenimiento de plantillas, no una herramienta de extracción.
2. Validación y normalización de códigos estándar. La herramienta debe validar números de contenedor según las reglas de dígito de control ISO 6346, normalizar nombres de puertos a un formato estándar (idealmente UN/LOCODE) y reconocer que "Maersk", "MAERSK LINE" y "MAEU" se refieren al mismo transportista. Sin esta capa, está cambiando escritura manual por limpieza manual de datos — mismo trabajo, paso diferente.
3. Extracción multipágina y a nivel de partida. Los BOL marítimos con carga contenerizada suelen tener 3–5 páginas. Las descripciones de mercancía, números de contenedor, precintos y bultos se distribuyen en páginas de continuación. Una herramienta que solo lee la página uno deja la mitad de los datos sin extraer. El soporte de partidas — donde cada fila de mercancía se convierte en una fila de datos independiente — es esencial para clasificación aduanera y conciliación de inventario.
4. Puntuación de confianza a nivel de campo. Ninguna herramienta de extracción logra un 100% de procesamiento directo con la mezcla de calidad documental que recibe una operación logística real. Lo importante es que la herramienta indique qué campos le generan dudas. Un indicador de confianza por campo extraído (alto/medio/bajo) permite que su equipo revise solo las extracciones inciertas — típicamente 5–10% de los campos — mientras confía que el resto fluya directamente a los sistemas posteriores.
5. Diseño priorizando lotes con salida consolidada. Procesar un BOL a la vez funciona con cinco envíos al día. A 50, necesita carga por lotes, procesamiento por lotes y una salida consolidada única — una hoja de cálculo, una fila por BOL, un paso de exportación. La herramienta debe estar diseñada desde cero para flujos de trabajo por lotes, no adaptada con un "modo lote" que procesa documentos secuencialmente tras un diálogo de selección múltiple.
Pruebe estos criterios con sus propios documentos — los BOL que realmente recibe, de los transportistas con los que realmente trabaja. Una demostración con un BOL digital limpio de un solo transportista no prueba nada sobre cómo la herramienta manejará su lote de 40 BOL de 15 transportistas un martes por la mañana.
Preguntas Frecuentes
¿Qué tipos de BOL puede procesar la extracción por IA?
Una herramienta de extracción por IA sin plantillas procesa todos los tipos principales de BOL — BOL directos, BOL marítimos, BOL multimodales/combinados, BOL maestro (MBL) y BOL doméstico (HBL) — desde la misma configuración. La IA identifica los campos por su significado, no por su posición en la plantilla, por lo que un BOL directo de una empresa de transporte y un BOL marítimo de Maersk se procesan con las mismas definiciones de columnas. Para documentos con campos específicos del tipo de BOL (como el número de referencia cruzada del HBL que referencia al BOL maestro), se define la unión de campos necesarios para todos los tipos de documento, y la herramienta deja en blanco cualquier campo que no aparezca en un documento determinado.
¿Puede la extracción de BOL validar números de contenedor según ISO 6346?
Algunas herramientas sí, pero no todas. La validación del número de contenedor ISO 6346 — calcular el dígito de control a partir del código del propietario y el número de serie, y compararlo con el dígito extraído — es una capa de validación posterior a la extracción que detecta errores de transcripción antes de que lleguen a su TMS. Si la validación de contenedores es importante para su flujo de trabajo (y debería serlo si maneja carga marítima), confirme con el proveedor que su proceso de extracción incluya este paso. Una discrepancia entre el dígito de control extraído y el calculado debe marcar el campo para revisión humana.
¿La extracción de BOL maneja entradas manuscritas y BOL de nivel de muelle?
Sí, dentro de ciertos límites. Los modelos modernos de IA visual pueden leer campos manuscritos de BOL con buena precisión en escritura legible: letras mayúsculas de molde, la mayoría de la escritura cursiva y campos estandarizados como números de BOL y conteos de piezas que los conductores suelen escribir claramente. La precisión disminuye en copias carbón muy desvaídas, sellos superpuestos sobre escritura a mano o documentos donde la presión del bolígrafo fue demasiado ligera para producir una marca escaneable. En estos casos, una herramienta de extracción bien diseñada marca el campo con una puntuación de confianza baja para revisión humana, en lugar de generar una suposición.
¿Cómo maneja la extracción los BOL de varias páginas con detalles de carga en páginas de continuación?
Los sistemas de extracción modernos procesan todas las páginas de un BOL de varias páginas como un solo documento y fusionan los campos extraídos en un único registro de salida. La información de las partes (embarcador, consignatario, parte notificada) suele estar en la página 1. Los detalles de la carga, números de contenedor, números de precinto y recuentos de bultos suelen aparecer en páginas de continuación. La herramienta reconoce que pertenecen al mismo envío y los combina. Para descripciones de carga con varias líneas, cada línea de mercancía se convierte en una fila de salida independiente con los campos de cabecera (número de BOL, embarcador, puertos) repetidos, el formato que su TMS espera para datos a nivel de detalle de línea.
¿Puede la IA distinguir entre un BOL de Casa y un BOL Maestro?
Sí. Los BOL de casa y los BOL maestros tienen información del emisor estructuralmente diferente: el HBL lo emite el transitario (normalmente con el logotipo y datos de contacto del transitario), mientras que el MBL lo emite la naviera. La IA reconoce estas diferencias estructurales y puede extraer ambos tipos en el mismo lote, asignando campos compartidos (puertos, números de contenedor, embarcador, consignatario) a las mismas columnas, mientras maneja campos específicos del tipo, como números de referencia cruzada del HBL o números de reserva del transportista, por separado.
¿Qué sucede cuando los transportistas usan nombres diferentes para el mismo campo del BOL?
Aquí es donde la extracción semántica gana decisivamente frente a los enfoques basados en plantillas. Cuando el Transportista A etiqueta el campo "Shipper", el Transportista B lo etiqueta "Shipper/Exporter" y el Transportista C lo etiqueta "Consignor", la IA entiende que los tres se refieren a la misma entidad: la parte que entrega la mercancía para el transporte. Usted define su columna de salida una vez como "Nombre del Embarcador", y la IA asigna automáticamente la variante de cada transportista a esa columna. Sin mapeo de campos por transportista, sin tabla de traducción, sin lógica de "si Transportista = Maersk entonces columna A, si no, si Transportista = MSC entonces columna B".
¿Pueden los datos extraídos del BOL alimentar directamente mi TMS?
La mayoría de las herramientas de extracción exportan a Excel o CSV, que se pueden importar a su TMS mediante la función de importación estándar de la plataforma. Plataformas como CargoWise, Descartes, Turvo y McLeod admiten la importación de archivos estructurados: exporta los resultados de la extracción, asigna las columnas a la plantilla de importación de su TMS y carga. Para una inserción directa sin transferencia de archivos, las herramientas con una API REST pueden integrarse mediante programación. Si su equipo opera con Google Sheets, un enfoque de complemento en barra lateral le permite extraer datos del BOL directamente en la hoja de cálculo que alimenta la importación de su TMS, sin ciclo de descarga y carga de archivos.
¿Qué precisión puedo esperar en los conocimientos de embarque de diferentes transportistas?
La extracción moderna con IA alcanza una precisión del 95–99 % a nivel de campo en conocimientos de embarque digitales limpios de los principales transportistas (Maersk, MSC, CMA CGM, Hapag-Lloyd, COSCO, ONE, Evergreen). La precisión disminuye con escaneos de baja resolución, degradación severa por copias carbón o conocimientos de embarque portuarios manuscritos, aunque sigue siendo muy superior a la del OCR con plantillas en los mismos documentos. La métrica que importa no es la precisión bruta, sino el rendimiento confiable: cuántos conocimientos de embarque fluyen sin intervención manual. Con una precisión del 95 % a nivel de campo y puntuación de confianza, usted revisa aproximadamente el 5 % de los campos, es decir, alrededor de un campo por conocimiento de embarque en una extracción de 20 campos. Esa es la diferencia entre revisar 80 campos en un lote de 80 documentos y escribir 1,600 campos manualmente.
¿La extracción de conocimientos de embarque reemplaza a un agente de aduanas?
No. La extracción de conocimientos de embarque automatiza el paso de ingreso de datos: leer los campos de un conocimiento de embarque y colocarlos en un formato estructurado. No reemplaza el criterio regulatorio que brinda un agente de aduanas con licencia: decisiones de clasificación de código SA, evaluaciones de valor en aduana, determinaciones de elegibilidad para acuerdos de libre comercio y estrategia de presentación de declaraciones. La extracción elimina el trabajo de tipeo para que su agente dedique tiempo a las decisiones de clasificación y cumplimiento que requieren experiencia. Para conocer el desglose completo de cómo encaja la extracción en el panorama más amplio de documentos logísticos, consulte nuestra guía sobre qué es la extracción de conocimientos de embarque, y para saber cómo se concilia el conocimiento de embarque con el paquete completo de envío (manifiestos, listas de empaque, facturas comerciales), consulte nuestra guía sobre extracción de documentos de envío y carga.
¿Cuál es la diferencia entre la extracción de conocimientos de embarque y el EDI para obtener datos de envío?
El EDI (Intercambio electrónico de datos) entrega datos de envío estructurados directamente de los transportistas, sin necesidad de extracción. Pero el EDI requiere configuración por transportista, pruebas y mantenimiento continuo, y muchos transportistas y agentes de carga más pequeños no lo admiten. En la práctica, la mayoría de las operaciones logísticas reciben una combinación: EDI de los principales transportistas para rutas habituales y conocimientos de embarque en PDF de todos los demás. La extracción de conocimientos de embarque se encarga del lado del PDF. Ambos enfoques son complementarios, no competitivos. Para la comparación completa, consulte EDI vs extracción de conocimientos de embarque con IA.
La extracción de conocimientos de embarque no consiste en acelerar un proceso de ingreso de datos lento. Se trata de eliminar el paso por completo: el paso en el que un operador humano transcribe campos de un documento que no creó, usando abreviaturas de transportistas que tuvo que memorizar, hacia un sistema de gestión de transporte (TMS) que no puede detectar si cometió un error de tipeo. Cada hora que un conocimiento de embarque permanece en la brecha entre su bandeja de entrada y su TMS es una hora en la que un cliente no puede rastrear su envío, una declaración de aduanas no ha comenzado y una factura de transportista no puede verificarse contra la carga realmente recibida. La extracción reduce esa brecha a segundos. Lo que haga con las horas que recupera depende de usted.
Pruebe la extracción de conocimientos de embarque con sus propios documentos →