Le guide complet de
l'extraction de données des connaissements
Un connaissement n'est pas un document unique. C'est une famille de types de documents juridiquement distincts — connaissements nominatifs, connaissements maritimes, transports multimodaux, connaissements mère et maison — chacun avec des champs, des émetteurs et des destinations de données différents. Un transitaire qui traite 100 connaissements par jour peut toucher huit mises en page différentes de cinq transporteurs avant le déjeuner. Une extraction qui fonctionne sur un type de connaissement et échoue sur le suivant n'est pas une extraction — c'est une solution partielle avec un repli manuel. Ce guide couvre ce que vous devez réellement savoir pour extraire les données des connaissements de manière fiable, quel que soit le type, le transporteur et le code standard attendu par votre TMS.
Points clés à retenir
- L'extraction basée sur des modèles pour les connaissements signifie maintenir 750 rectangles de coordonnées sur 50 transporteurs — et lorsque Maersk déplace le numéro de conteneur du quadrant supérieur droit au milieu de la page, chaque connaissement qu'ils envoient produit un champ vide jusqu'à ce que quelqu'un modifie le modèle.
- L'absurdité ne réside pas seulement dans la charge de maintenance — c'est que chaque modification de modèle est une nouvelle occasion pour qu'un identifiant de conteneur mal lu atteigne votre TMS, le portail de suivi de votre client ou une déclaration en douane avant que quiconque ne remarque que le conteneur est manquant depuis trois jours.
- Une seule définition de colonne sémantique remplace les 750 modèles et valide les numéros de conteneur par rapport aux chiffres de contrôle ISO 6346 pendant l'extraction — détectant un chiffre mal saisi avant qu'il ne quitte la couche d'extraction, et non après que le compteur de surestaries commence à tourner.
Ce qui distingue l'extraction de connaissements des autres extractions de documents
La plupart des articles sur l'extraction de documents traitent un connaissement comme une facture avec un navire dessus. Cette hypothèse produit des outils qui fonctionnent en démonstration et échouent en production. Voici pourquoi les connaissements sont structurellement différents de tout autre document dont vous extrairez des données.
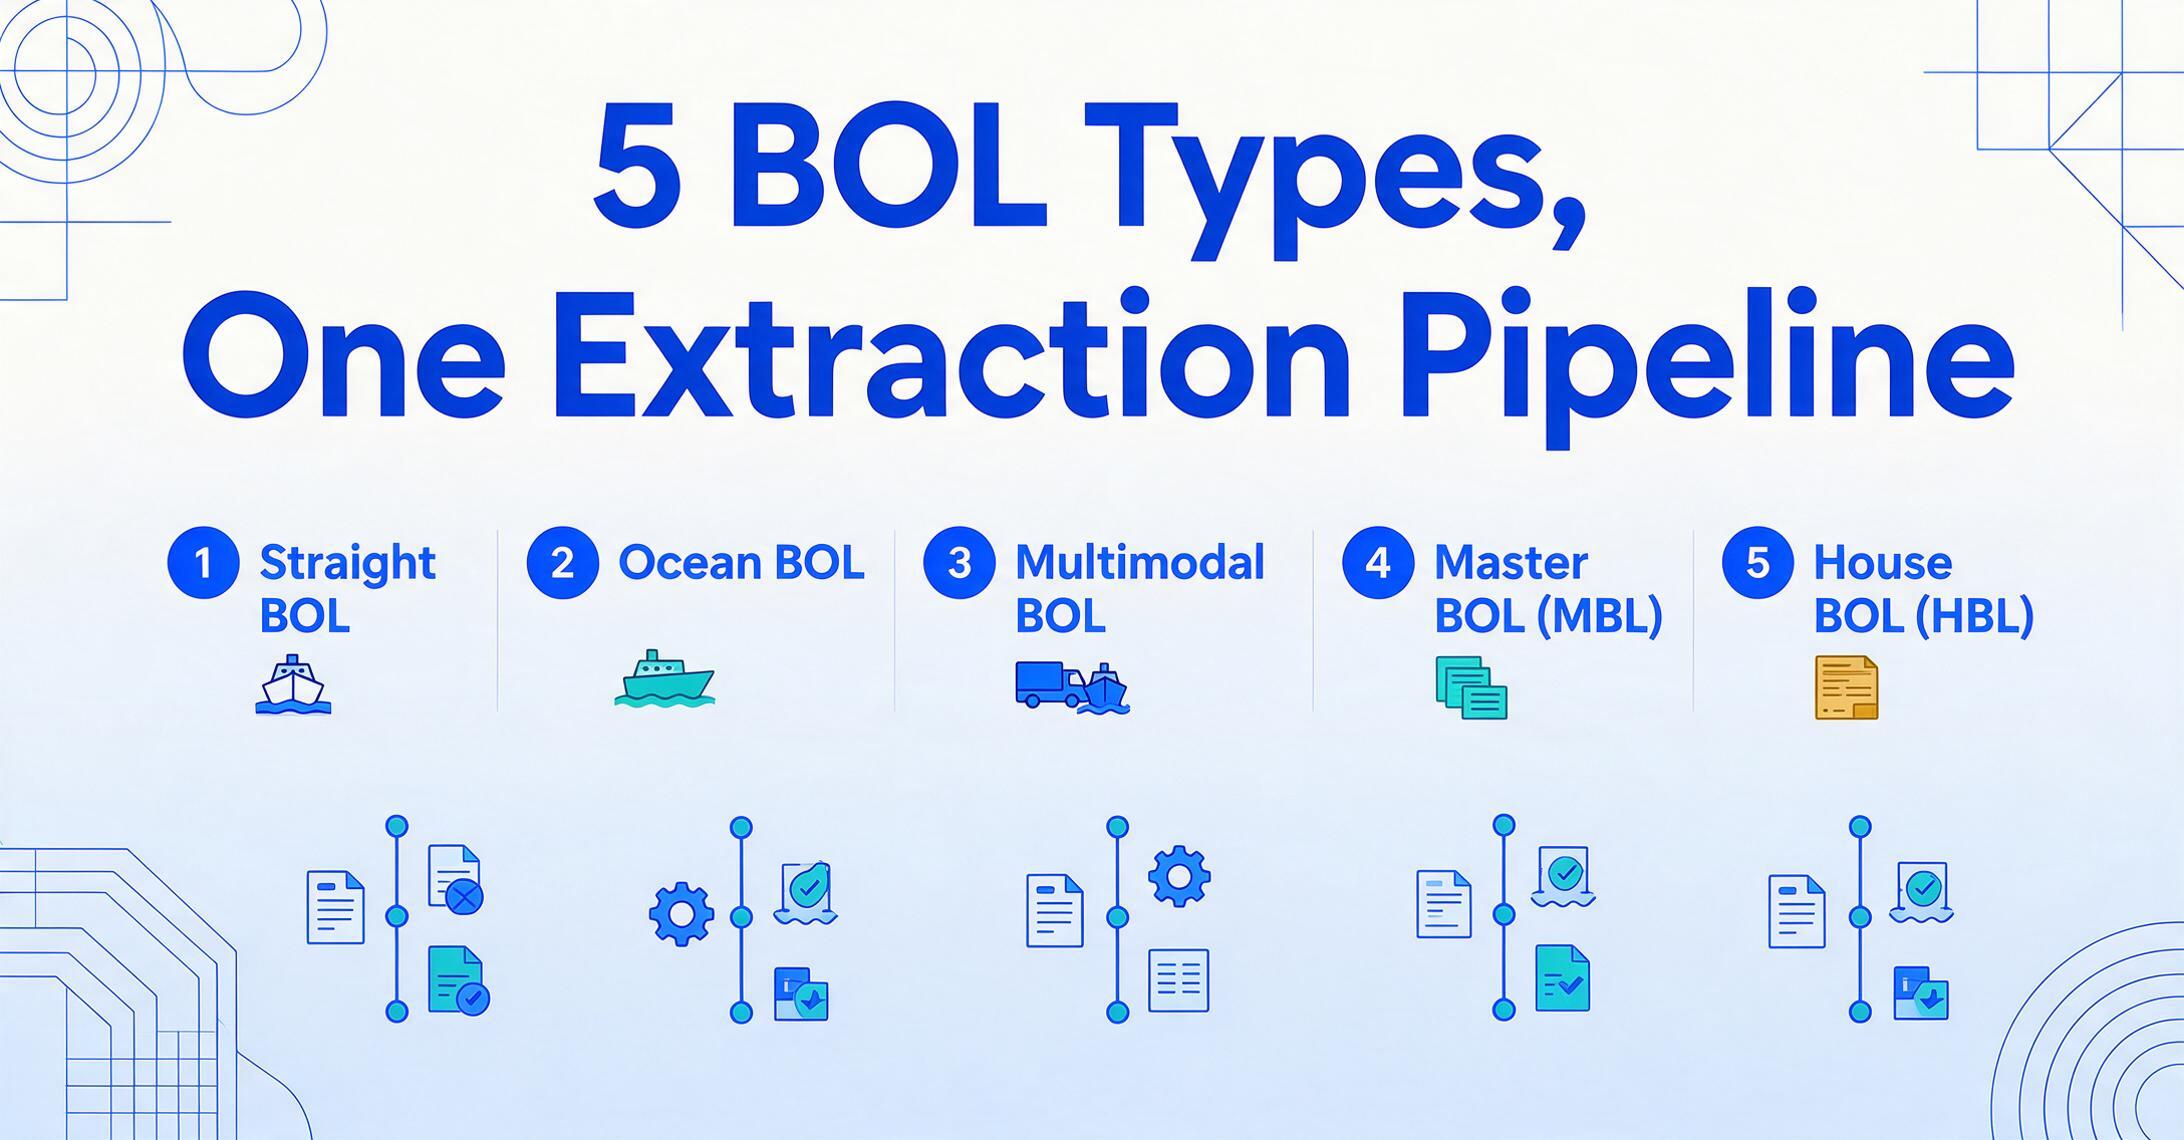
Cinq types de documents juridiquement distincts, un seul pipeline d'extraction. Un connaissement nominatif (non négociable) désigne un destinataire spécifique et ne peut être transféré — la forme la plus simple, courante dans le transport LTL (lot partiel). Un connaissement maritime est négociable et sert de titre de propriété en vertu des Règles de La Haye-Visby — quiconque détient l'original peut réclamer la cargaison. Un connaissement multimodal (également appelé connaissement de transport combiné) couvre les segments maritime, ferroviaire et routier sous un seul document régi par les Règles CNUCED/CCI pour les documents de transport multimodal. Vient ensuite la répartition que tout transitaire gère quotidiennement : le connaissement mère (MBL) émis par le transporteur au transitaire, et le connaissement maison (HBL) émis par le transitaire à l'expéditeur — deux documents pour le même envoi, partageant des champs comme les numéros de conteneur et les ports, mais avec des noms d'émetteurs, des numéros de référence et des conditions de fret différents.
Chaque type réorganise les champs différemment. Un connaissement maritime Maersk place le numéro de conteneur dans le quadrant supérieur droit, à côté du nom du navire. Un connaissement MSC le place au milieu de la page, au-dessus de la grille de désignation de la marchandise. Un connaissement maison ajoute un numéro de référence HBL qui recoupe le connaissement mère — un champ qu'un connaissement nominatif ne possède pas du tout. Un outil d'extraction qui ne peut pas gérer les cinq types sans configuration par type laisse votre équipe à entretenir des modèles au lieu de déplacer du fret.
Les données ne doivent pas seulement être lues — elles doivent être traduites. Un connaissement peut indiquer le port de chargement comme « CNSHA », « Shanghai » ou « Port de Shanghai, CN ». Votre TMS attend CN SHA, le UN/LOCODE à cinq caractères maintenu par la Commission économique des Nations Unies pour l'Europe (CEE-ONU) depuis 1981 — un système couvrant plus de 100 000 emplacements dans 249 pays. Un connaissement peut imprimer le nom du transporteur comme « Maersk Line » tandis que votre TMS exige le code SCAC (Standard Carrier Alpha Code) MAEU, géré par la NMFTA. Les marchandises nécessitent des codes SH — le Système harmonisé maintenu par l'Organisation mondiale des douanes, utilisé par plus de 200 pays — mappés à partir d'une désignation de marchandise en langage naturel comme « grands sacs en polypropylène tissé » vers 6305.33. Un outil d'extraction de connaissements qui produit du texte brut n'est pas terminé. Celui qui produit des codes standardisés l'est.
C'est le défi central qui fait de l'extraction de connaissements un problème différent de l'extraction de factures ou de reçus. Pour une définition complète de l'extraction de données de connaissement et de sa différence avec des concepts adjacents comme la saisie de données TMS, consultez notre guide qu'est-ce que l'extraction de données de connaissement.
Pourquoi l'OCR traditionnel et les approches basées sur des modèles échouent avec les connaissements
L'OCR basé sur des modèles a été conçu pour des documents dont la mise en page est contrôlée — vos propres factures, vos propres bons de commande, des formulaires que vous avez conçus vous-même. Les connaissements brisent cette hypothèse à tous les niveaux.
Explosion des formats multi-transporteurs. Un courtier en fret recevant 100 connaissements par jour ne contrôle pas les transporteurs utilisés par ses expéditeurs. Ces connaissements arrivent dans les formats de Maersk (MAEU), MSC (MSCU), CMA CGM (CMDU), Hapag-Lloyd (HLCU), COSCO (COSU), ONE (ONEY), Evergreen (EMCU) et une douzaine de compagnies de camionnage régionales — chacune avec sa propre mise en page. L'OCR basé sur des modèles vous oblige à dessiner des cadres de délimitation autour de chaque champ par format de transporteur. Pour 50 transporteurs et 15 champs par connaissement, cela représente 750 rectangles de coordonnées à définir et à maintenir. Lorsqu'un transporteur met à jour son formulaire — et ils le font — ces modèles échouent silencieusement, produisant des données erronées dans les bonnes colonnes jusqu'à ce que quelqu'un remarque la tendance des frais de correction de connaissement de la part des douanes.
L'écriture manuscrite, les tampons et les copies carbone ne sont pas des cas marginaux. Un connaissement rempli sur un quai de chargement n'est pas un PDF numérique propre. Le nom du destinataire a été griffonné au stylo. Le nombre de colis a été tamponné à l'encre rouge. Les conditions de fret — « PREPAID » — ont été entourées au marqueur. Le scan est une copie carbone de troisième génération où le texte de l'original transparaît dans le champ de description de la cargaison. L'OCR traditionnel traite les tampons comme du bruit, les transparences de carbone comme des caractères supplémentaires et l'écriture manuscrite en dessous de 90 DPI comme illisible. Mais sur un connaissement, ces éléments « bruyants » contiennent les trois points de données les plus susceptibles de déclencher un litige de facture de transporteur : le nombre de colis manuscrit, le poids tamponné et les conditions de fret marquées.
La classe de fret NMFC nécessite une compréhension sémantique. Le système National Motor Freight Classification définit 18 classes de fret (50 à 500) basées sur la densité, la gerbabilité, la manutention et la responsabilité. Un connaissement peut indiquer « Classe 70 » à côté de la description de la marchandise « Meubles en bois, KD » — ou il peut indiquer la marchandise sans la classe, s'attendant à ce que le transporteur l'applique. L'OCR basé sur des modèles lit les deux comme des chaînes de texte dans la même case. L'extraction sémantique comprend que « Classe 70 » modifie « Meubles en bois » et appartient à la colonne Classe de fret, pas à la colonne Description de la marchandise. Cette distinction détermine si une facture de fret est exacte ou déclenche des frais de reclassement de 300 $ trois semaines plus tard.
Ces trois modes de défaillance se cumulent. Un outil qui nécessite des modèles par transporteur, ne peut pas lire l'écriture manuscrite et ne peut pas distinguer les classes de fret des descriptions de marchandises ne fait pas gagner de temps — il crée une file d'attente de révision aussi grande que la tâche de saisie de données initiale.
Comment l'extraction IA moderne lit un connaissement
Le processus qui remplace la saisie manuelle des données de connaissement va de la réception à la compréhension visuelle, au mappage des champs, puis à la normalisation et à la sortie — pour le détail complet des étapes de la mécanique de lecture d'un connaissement par un modèle d'IA visuelle et du mappage des champs par sens plutôt que par position, consultez notre guide sur l'extraction des données de connaissement. Ce qui mérite d'être développé ici — parce que c'est l'étape qui distingue un véritable outil d'extraction de connaissements d'un lecteur de documents générique — c'est la normalisation et la validation des codes.
Champs clés du connaissement et normes de validation
Chaque projet d'extraction de connaissement commence par la définition des champs pertinents. Le tableau ci-dessous couvre les cinq groupes essentiels à toute opération logistique, les champs spécifiques de chacun, et la norme de validation qui détermine si la valeur extraite est correcte — et non simplement présente.
| Groupe de champs | Champs à extraire | Norme de validation | Pourquoi c'est important |
|---|---|---|---|
| Parties | Nom et adresse de l'expéditeur, Destinataire, Notify, Transporteur/Code SCAC | SCAC (NMFTA) : code transporteur de 2 à 4 lettres ; numéros EORI pour les douanes de l'UE | Une livraison mal acheminée entraîne des surestaries de 100 à 500 $/jour ; un mauvais Notify signifie que l'arrivée de la cargaison passe inaperçue |
| Acheminement | Port de chargement, Port de déchargement, Lieu de réception, Lieu de livraison, Navire/Voyage, Numéro de conteneur, Numéro de scellé | UN/LOCODE (UNECE) : code à 5 caractères (ex. CN SHA, NL RTM) ; ISO 6346 : clé de contrôle du conteneur | La déclaration ISF exige des codes de port corrects 24 h avant le chargement ; une non-concordance de l'ID du conteneur déclenche une retenue douanière |
| Cargaison | Désignation de la marchandise, Nombre de colis et type d'emballage, Poids brut (kg/lbs), Poids net, Volume/Dimensions, Classe de fret, Code NMFC, Code SH | NMFC : 18 classes de fret (50–500) ; SH : 6 chiffres internationaux + extension nationale ; SOLAS VGM : masse brute vérifiée obligatoire pour les conteneurs depuis juillet 2016 | La reclassification de la classe de fret coûte 150 à 300 $ par envoi ; les erreurs de code SH entraînent des pénalités douanières pouvant atteindre 10 fois le manque à gagner |
| Frais et conditions | Conditions de fret (Prépayé/Dû), Fret maritime, Surcharge carburant, Manutention terminale, Frais accessoires | Incoterms 2020 : définit les points de transfert des coûts et des risques | Des conditions de paiement du fret incorrectes signifient facturer la mauvaise partie et tenter de récupérer les coûts auprès d'un client qui a déjà payé le transitaire |
| Référence | Numéro de connaissement, Référence croisée HBL/MBL, Numéro de réservation, Références PO/Facture commerciale, Date de ramassage, Date de livraison/ETA | Format variable selon le transporteur ; validation croisée entre HBL et MBL pour les transitaires gérant les deux | Un envoi introuvable sans numéro de connaissement dans le TMS ; les fenêtres de livraison manquées érodent les engagements de niveau de service |
La clé de contrôle du numéro de conteneur est un contrôle de validation particulièrement précieux. Selon la norme ISO 6346, chaque identifiant de conteneur se compose d'un code propriétaire de trois lettres (ex. MSK pour Maersk), d'un identifiant de catégorie d'équipement d'une lettre (U pour conteneur de fret), de six chiffres de série et d'une clé de contrôle calculée à partir des caractères précédents. Si votre extraction produit MSKU 907082 3 alors que le conteneur réel est MSKU 907082 8, la non-concordance de la clé signale immédiatement l'erreur — avant que ce numéro de conteneur n'atteigne votre TMS, le portail de suivi de votre client ou une déclaration douanière. Un outil qui effectue cette validation pendant l'extraction détecte des erreurs qui, autrement, ne seraient découvertes qu'à la disparition d'un conteneur dans un terminal.
Le groupe de fret — désignations de marchandises, poids, classe de fret, codes SH — est la section la plus dense en données de tout connaissement et la plus sujette aux erreurs. C'est aussi la section qui varie le plus d'un transporteur à l'autre. Un connaissement liste cinq lignes de marchandises avec des poids individuels et une classe de fret globale ; un autre regroupe tout en une seule ligne avec « FAK » (Fret toutes marchandises). Un troisième ajoute un code SH en marge, écrit à la main par l'expéditeur. Un outil d'extraction de connaissement n'a pas besoin de connaître la mise en page de chaque transporteur. Il doit savoir à quoi ressemble chaque type de données dans toutes les représentations utilisées par les transporteurs et les expéditeurs.
Traitement par lots : connaissements multi-transporteurs, une seule feuille de calcul
L'extraction de connaissements n'apporte toute sa valeur que lorsqu'elle traite des lots — pas un document à la fois, mais des dizaines ou des centaines en une seule exécution. C'est là que l'hypothèse de conception du traitement par lots en priorité prend tout son sens.
Prenons l'exemple d'un transitaire qui traite 80 connaissements issus des e-mails d'une matinée. Ces 80 documents peuvent provenir de 12 transporteurs différents, couvrir quatre types de connaissements (maritime, maison, mère, nominatif) et inclure un mélange de PDF numériques propres et de copies carbone scannées de transporteurs régionaux. Le flux de travail qui permet cette échelle :
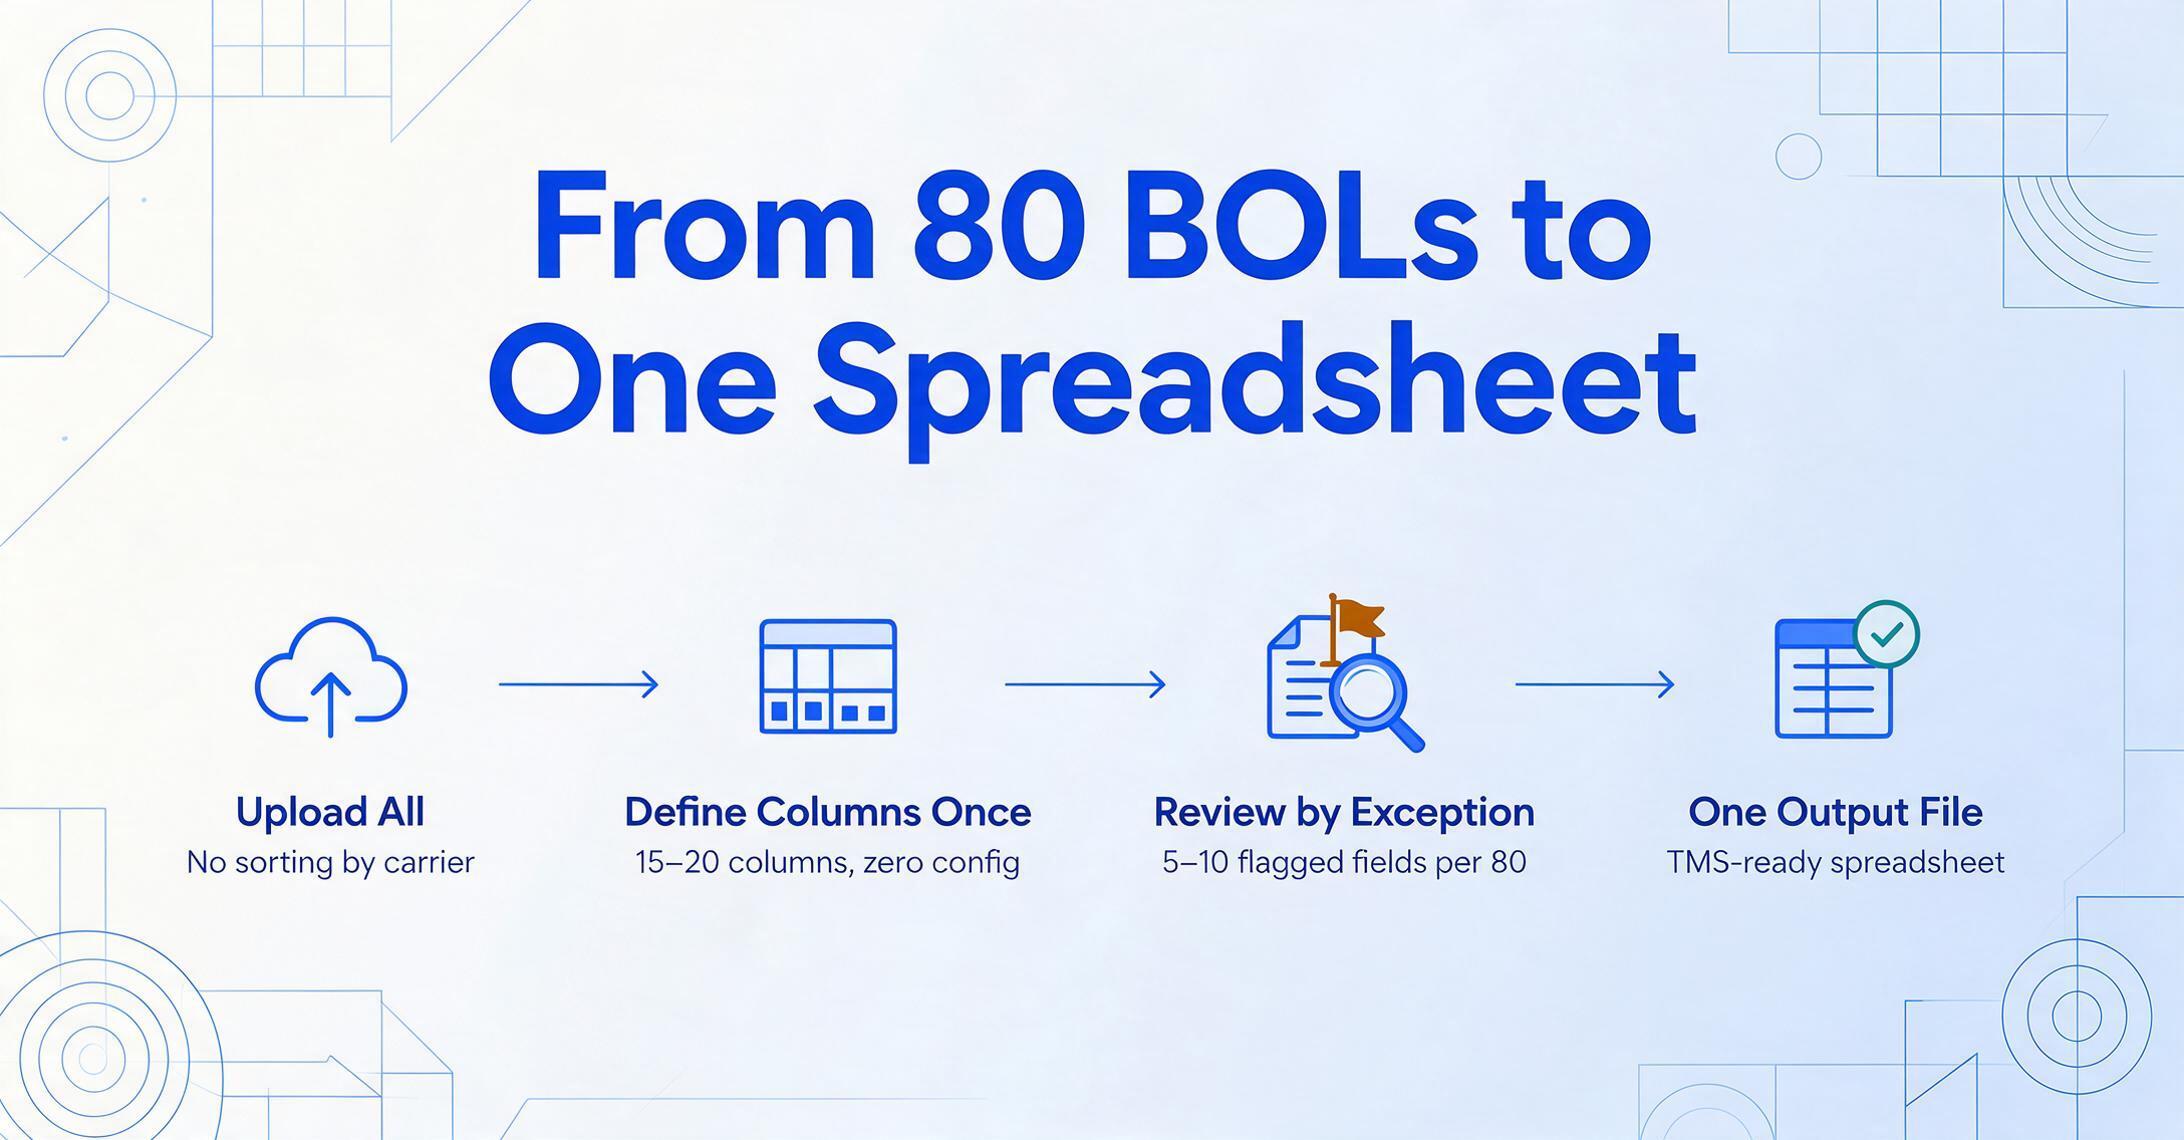
1. Téléchargez tous les connaissements en une fois. Pas de tri par transporteur, pas de pré-classification par type de connaissement. Le lot accepte indifféremment les PDF, JPG, PNG et les documents multipages.
2. Définissez vos colonnes une seule fois. Les mêmes 15 à 20 noms de colonnes s'appliquent à chaque connaissement du lot. L'IA gère le mappage : lorsqu'elle rencontre un connaissement nominatif (sans référence croisée HBL/MBL), elle laisse cette colonne vide. Lorsqu'elle rencontre un connaissement maritime avec une grille de fret multi-lignes, elle se développe en lignes séparées pour chaque ligne de marchandise. Aucune configuration par document.
3. Vérifiez par exception. Les champs extraits par l'IA avec une grande confiance passent automatiquement. Les champs avec une confiance plus faible — un poids sur copie carbone délavée, un numéro de scellé maculé — sont signalés pour examen humain. Un agent logistique vérifie 5 à 10 champs signalés par lot de 80 documents au lieu de saisir 1 200 champs manuellement. C'est la différence entre remplacer le travail de saisie de données et se contenter de le renommer « vérification des données ».
4. Un seul fichier de sortie. Le résultat est une seule feuille de calcul Excel — une ligne par connaissement (ou par ligne de marchandise, pour les expéditions multi-lignes), avec des colonnes correspondant aux champs que vous avez définis. Cette sortie est native pour les feuilles de calcul : elle arrive directement dans Excel ou Google Sheets, prête pour l'importation dans le TMS. Pour les équipes utilisant Google Sheets, le flux de travail connaissement-vers-TMS peut exécuter l'extraction directement dans la feuille de calcul via un module complémentaire en barre latérale, éliminant ainsi l'étape de transfert de fichier. Pour en savoir plus sur la mise à l'échelle du traitement par lots sans frais d'intégration, consultez l'extraction par lots de connaissements multi-transporteurs.
Options d'exportation : Acheminer les données extraites là où elles doivent aller
Les données de connaissement extraites n'ont qu'un seul but : entrer dans un autre système. Lequel dépend de votre exploitation. La voie d'exportation que vous choisissez détermine la quantité de travail manuel restant entre l'extraction et votre flux de travail.
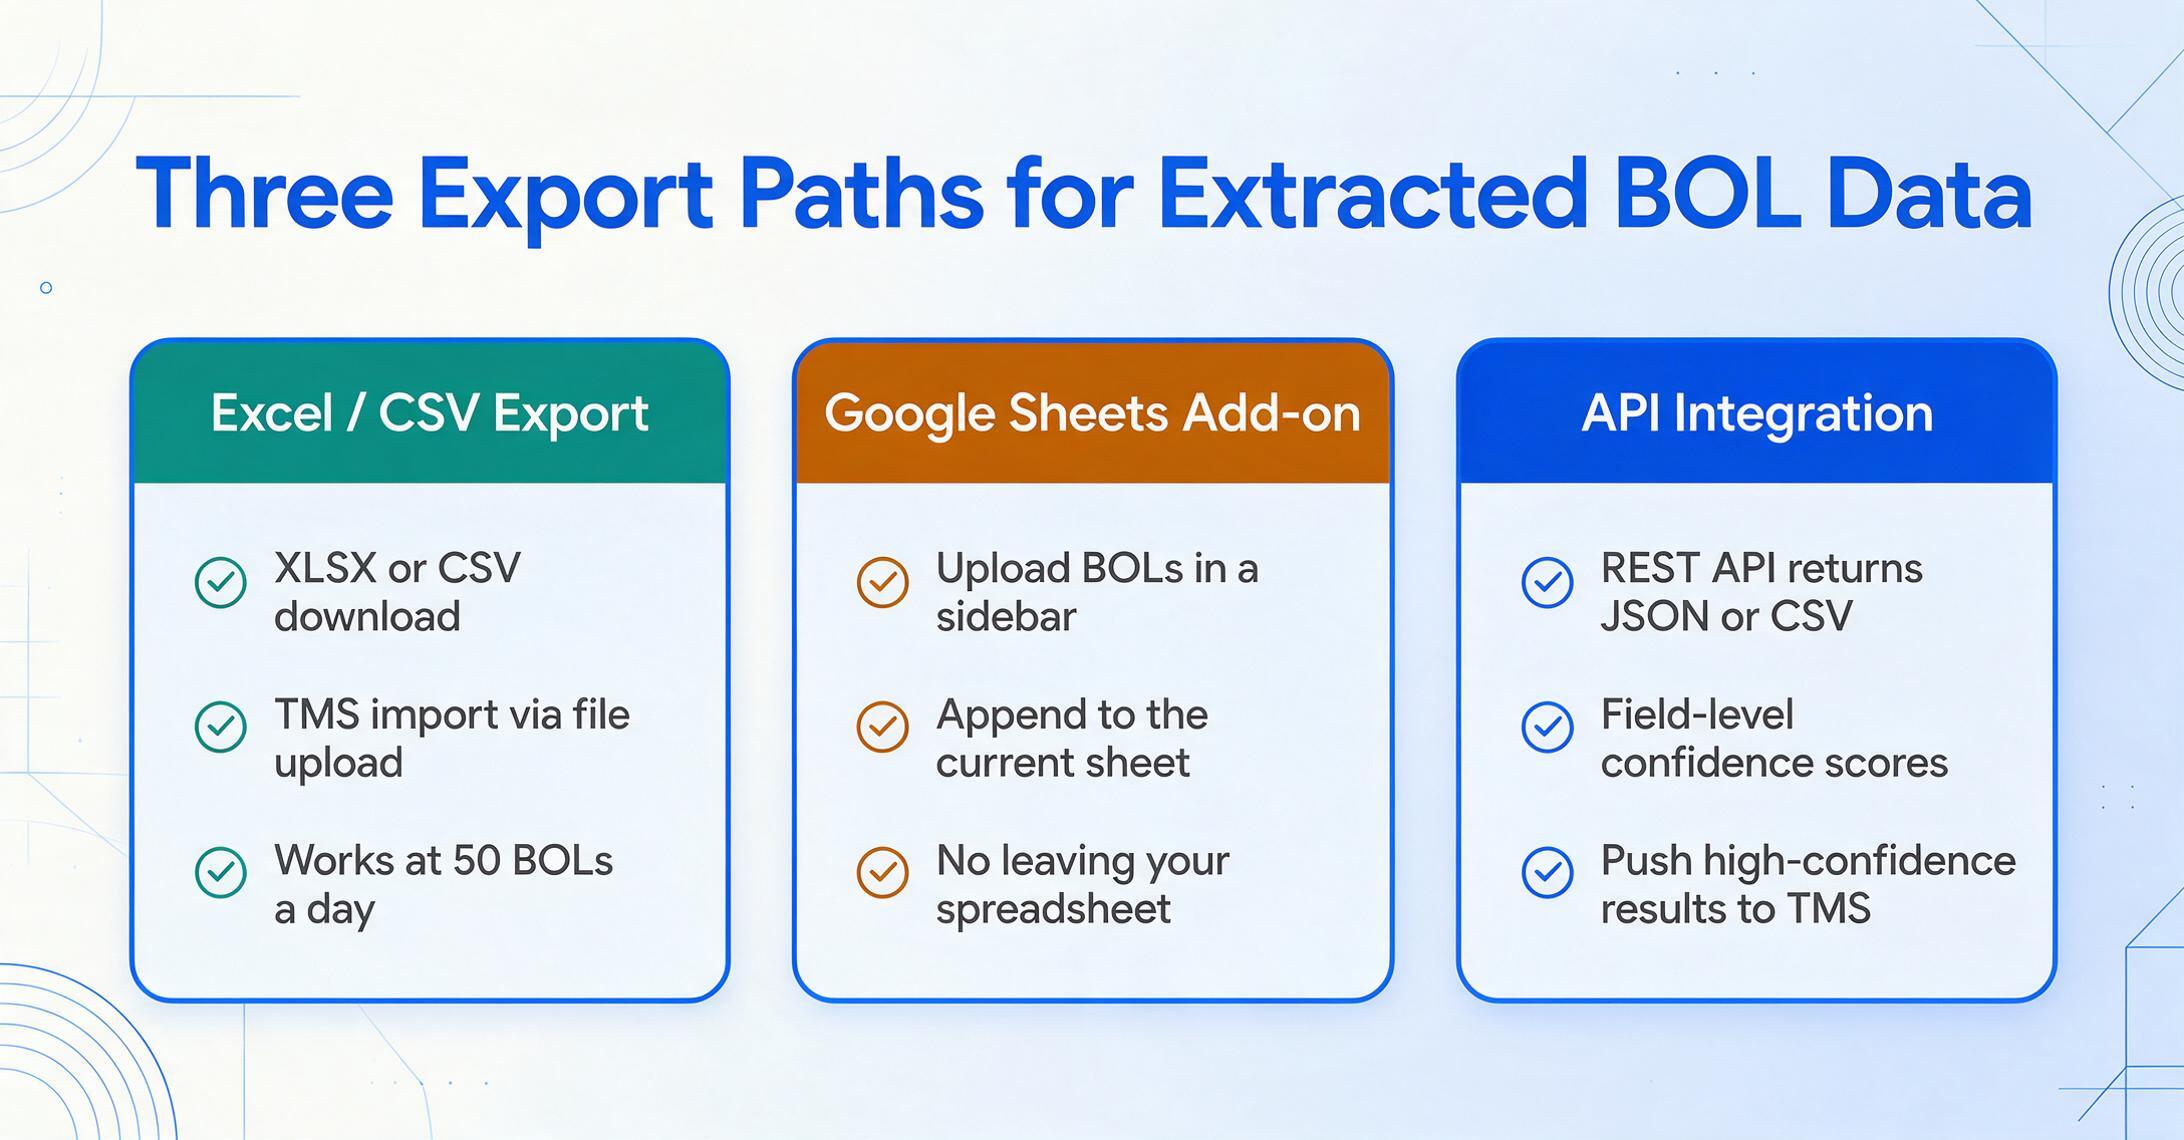
Exportation Excel / CSV
Pour : Les équipes qui importent dans un TMS via un téléchargement de fichier
Téléchargez les données de connaissement extraites au format XLSX ou CSV. Mappez les colonnes vers votre modèle d'importation TMS — CargoWise, Descartes, McLeod et d'autres prennent en charge l'importation CSV. Un fichier, une importation, aucune saisie.
Module complémentaire Google Sheets
Pour : Les équipes qui gèrent leurs opérations via des feuilles de calcul
Un module complémentaire Google Sheets en barre latérale vous permet de télécharger des connaissements, de définir des colonnes d'extraction et d'ajouter des données structurées directement à la feuille active — sans quitter votre feuille de suivi. L'extraction se fait dans l'outil que votre équipe utilise déjà.
Intégration API
Pour : Les opérations à volume élevé avec des systèmes internes
Une API REST reçoit les fichiers de connaissement et renvoie des données structurées par programmation — JSON ou CSV avec des scores de confiance au niveau des champs. Votre système peut acheminer automatiquement les extractions à faible confiance vers une révision humaine et pousser les résultats à haute confiance directement dans le TMS.
La bonne voie d'exportation dépend de votre volume et de vos ressources techniques. À 50 connaissements par jour, l'exportation Excel + l'importation TMS fonctionnent. À 500 par jour, le transfert manuel de fichiers devient le nouveau goulot d'étranglement. La plupart des équipes commencent avec l'exportation Excel puis passent à l'intégration API lorsque le volume justifie le travail de développement. Le moteur d'extraction doit prendre en charge les deux voies afin que vous ne changiez pas d'outil lorsque vous changez de méthode d'exportation.
Comment choisir un outil d'extraction de connaissement
Cinq critères distinguent les outils capables de gérer des volumes de production de ceux conçus pour un usage occasionnel sur des documents numériques propres.
1. Gestion multi-transporteur sans configuration par transporteur. Le test décisif : traiter un connaissement maritime Maersk, un connaissement maritime MSC, un connaissement direct Old Dominion et une copie carbone scannée d'un transporteur régional LTL — dans le même lot, avec les mêmes définitions de colonnes, sans créer un seul modèle. Si l'outil vous oblige à définir les positions des champs par transporteur, vous achetez un travail de maintenance de modèles, pas un outil d'extraction.
2. Validation et normalisation des codes standard. L'outil doit valider les numéros de conteneur selon les règles de chiffre de contrôle ISO 6346, normaliser les noms de ports dans un format standard (idéalement UN/LOCODE), et reconnaître que « Maersk », « MAERSK LINE » et « MAEU » désignent le même transporteur. Sans cette couche, vous échangez la saisie manuelle contre un nettoyage manuel des données — même travail, étape différente.
3. Extraction multi-page et au niveau des lignes d'article. Les connaissements maritimes pour marchandises conteneurisées font souvent 3 à 5 pages. Les descriptions de marchandises, numéros de conteneur, numéros de scellé et quantités de colis sont répartis sur les pages de suite. Un outil qui ne lit que la première page laisse la moitié des données non extraites. La prise en charge des lignes d'article — où chaque ligne de marchandise devient une ligne de données distincte — est essentielle pour le classement douanier et le rapprochement des stocks.
4. Score de confiance au niveau du champ. Aucun outil d'extraction n'atteint 100 % de traitement direct sur la diversité de qualité de documents qu'une opération logistique réelle reçoit. L'important est que l'outil vous indique les champs dont il n'est pas sûr. Un indicateur de confiance par champ extrait (élevé/moyen/faible) permet à votre équipe de ne vérifier que les extractions incertaines — généralement 5 à 10 % des champs — tout en laissant le reste alimenter directement les systèmes en aval.
5. Conception axée sur le traitement par lots avec sortie consolidée. Traiter un connaissement à la fois fonctionne pour cinq expéditions par jour. À 50, vous avez besoin d'un chargement par lots, d'un traitement par lots et d'une sortie consolidée unique — un tableur, une ligne par connaissement, une étape d'exportation. L'outil doit être conçu dès le départ pour les flux de travail par lots, pas adapté avec un « mode lot » qui traite les documents séquentiellement derrière une boîte de dialogue de sélection multiple.
Testez ces critères avec vos propres documents — les connaissements que vous recevez réellement, des transporteurs avec lesquels vous travaillez réellement. Une démo avec un connaissement numérique propre d'un seul transporteur ne prouve rien sur la façon dont l'outil gère votre lot du mardi matin de 40 connaissements de 15 transporteurs.
Questions fréquentes
Quels types de connaissements l'extraction IA peut-elle traiter ?
Un outil d'extraction IA sans modèle gère tous les grands types de connaissements — connaissements directs, connaissements maritimes, connaissements multimodaux/transport combiné, connaissements maîtres (MBL) et connaissements maison (HBL) — à partir de la même configuration. L'IA identifie les champs par leur sens, non par leur position dans un modèle, donc un connaissement direct d'une entreprise de camionnage et un connaissement maritime de Maersk sont traités via les mêmes définitions de colonnes. Pour les documents avec des champs spécifiques au type de connaissement (comme le numéro de référence croisée HBL qui renvoie au connaissement maître), vous définissez l'union des champs nécessaires pour tous les types de documents, et l'outil laisse vide tout champ absent d'un document donné.
L'extraction de connaissements peut-elle valider les numéros de conteneur selon la norme ISO 6346 ?
Certains outils le peuvent, mais pas tous. La validation du numéro de conteneur ISO 6346 — calcul du chiffre de contrôle à partir du code propriétaire et du numéro de série, puis comparaison avec le chiffre extrait — est une couche de validation post-extraction qui détecte les erreurs de transcription avant qu'elles n'atteignent votre TMS. Si la validation des conteneurs est importante pour votre flux de travail (et elle devrait l'être si vous gérez du fret maritime), confirmez avec le fournisseur que leur pipeline d'extraction inclut cette étape. Une discordance entre le chiffre de contrôle extrait et le chiffre de contrôle calculé doit signaler le champ pour révision humaine.
L'extraction de connaissements gère-t-elle les écritures manuscrites et les connaissements de quai ?
Oui — dans une certaine mesure. Les modèles d'IA visuelle modernes lisent les champs manuscrits des connaissements avec une bonne précision sur une écriture lisible : lettres majuscules d'imprimerie, la plupart des écritures cursives, et les champs standardisés comme les numéros de connaissement et les quantités de pièces que les conducteurs écrivent généralement clairement. La précision diminue sur les copies carbone très délavées, les tampons superposés à l'écriture manuscrite, ou les documents où la pression du stylo était trop légère pour produire une marque scannable. Dans ces cas, un outil d'extraction bien conçu signale le champ avec un faible score de confiance pour révision humaine plutôt que de produire une estimation.
Comment l'extraction gère-t-elle les connaissements multipages avec des détails de cargaison sur les pages suivantes ?
Les systèmes d'extraction modernes ingèrent toutes les pages d'un connaissement multipage comme un seul document et fusionnent les champs extraits en un seul enregistrement de sortie. Les informations sur les parties (chargeur, destinataire, partie à aviser) se trouvent généralement à la page 1. Les détails de la cargaison, les numéros de conteneur, les numéros de scellé et les nombres de colis apparaissent souvent sur les pages suivantes. L'outil reconnaît qu'ils appartiennent au même envoi et les combine. Pour les descriptions de cargaison à plusieurs lignes, chaque ligne de marchandise devient une ligne de sortie distincte avec les champs d'en-tête (numéro de connaissement, chargeur, ports) répétés — le format attendu par votre TMS pour les données au niveau des lignes d'article.
L'IA peut-elle distinguer un connaissement maison d'un connaissement maître ?
Oui. Les connaissements maison et les connaissements maîtres ont des informations d'émetteur structurellement différentes — le connaissement maison est émis par le transitaire (généralement avec le logo et les coordonnées du transitaire), tandis que le connaissement maître est émis par le transporteur maritime. L'IA reconnaît ces différences structurelles et peut extraire les deux types dans le même lot, en mappant les champs partagés (ports, numéros de conteneur, chargeur, destinataire) aux mêmes colonnes tout en traitant séparément les champs spécifiques au type comme les numéros de référence croisée du connaissement maison ou les numéros de réservation du transporteur.
Que se passe-t-il lorsque les transporteurs utilisent des noms différents pour le même champ de connaissement ?
C'est là que l'extraction sémantique l'emporte de manière décisive sur les approches basées sur des modèles. Lorsque le transporteur A nomme le champ « Chargeur », le transporteur B le nomme « Chargeur/Exportateur » et le transporteur C le nomme « Expéditeur », l'IA comprend que les trois se réfèrent à la même entité — la partie qui remet les marchandises pour le transport. Vous définissez votre colonne de sortie une fois comme « Nom du chargeur », et l'IA mappe automatiquement la variante de chaque transporteur à cette colonne. Pas de mappage de champ par transporteur, pas de table de traduction, pas de logique « si Transporteur = Maersk alors colonne A sinon si Transporteur = MSC alors colonne B ».
Les données extraites du connaissement peuvent-elles alimenter directement mon TMS ?
La plupart des outils d'extraction exportent vers Excel ou CSV, qui peuvent être importés dans votre TMS via la fonction d'importation standard de la plateforme. Des plateformes comme CargoWise, Descartes, Turvo et McLeod prennent en charge l'importation de fichiers structurés — vous exportez les résultats d'extraction, mappez les colonnes au modèle d'importation de votre TMS et téléchargez. Pour un push direct sans transfert de fichier, les outils dotés d'une API REST peuvent s'intégrer par programmation. Si votre équipe travaille via Google Sheets, une approche par add-on de panneau latéral vous permet d'extraire les données du connaissement directement dans la feuille de calcul qui alimente votre importation TMS — sans cycle de téléchargement et de téléversement de fichier.
Quelle précision puis-je attendre des connaissements (B/L) des différents transporteurs ?
L'extraction IA moderne atteint une précision de 95 à 99 % au niveau des champs sur les connaissements numériques propres des grands transporteurs (Maersk, MSC, CMA CGM, Hapag-Lloyd, COSCO, ONE, Evergreen). La précision diminue pour les scans en basse résolution, les dégradations importantes dues aux copies carbone ou les connaissements de quai manuscrits — bien qu'elle reste nettement supérieure à ce que la OCR basée sur des modèles obtient sur les mêmes documents. La mesure qui compte n'est pas la précision brute. C'est le débit fiable : combien de connaissements passent sans intervention manuelle. Avec une précision de 95 % au niveau des champs et un score de confiance, vous vérifiez environ 5 % des champs — soit à peu près un champ par connaissement sur une extraction de 20 champs. C'est la différence entre vérifier 80 champs sur un lot de 80 documents et saisir 1 600 champs manuellement.
L'extraction de connaissements remplace-t-elle un courtier en douane ?
Non. L'extraction de connaissements automatise l'étape de saisie des données — lire les champs d'un connaissement et les mettre dans un format structuré. Elle ne remplace pas le jugement réglementaire qu'un courtier en douane agréé fournit : les décisions de classification des codes SH, les évaluations de la valeur en douane, les déterminations d'éligibilité aux accords de libre-échange et la stratégie de dépôt des déclarations. L'extraction élimine le travail de saisie afin que votre courtier consacre son temps aux décisions de classification et de conformité qui exigent une expertise. Pour le détail complet sur la place de l'extraction dans le paysage plus large des documents logistiques, consultez notre guide sur ce qu'est l'extraction de connaissements, et pour comprendre comment le connaissement se concilie avec le dossier d'expédition complet — manifestes, listes de colisage, factures commerciales — consultez notre guide sur l'extraction de documents d'expédition et de fret.
Quelle est la différence entre l'extraction de connaissements et l'EDI pour obtenir les données d'expédition ?
L'EDI (Échange de données informatisé) fournit des données d'expédition structurées directement des transporteurs — aucune extraction nécessaire. Mais l'EDI exige une configuration, des tests et une maintenance continue par transporteur, et de nombreux petits transporteurs et transitaires ne le prennent pas en charge. En pratique, la plupart des opérations logistiques reçoivent un mélange : l'EDI des grands transporteurs pour les lignes régulières, et des connaissements PDF pour tous les autres. L'extraction de connaissements gère le côté PDF. Les deux approches sont complémentaires, pas concurrentes. Pour la comparaison complète, voir EDI vs extraction de connaissements par IA.
L'extraction de connaissements ne consiste pas à accélérer un processus de saisie de données lent. Il s'agit de supprimer complètement l'étape — l'étape où un opérateur humain transcrit des champs d'un document qu'il n'a pas créé, en utilisant des abréviations de transporteur qu'il a dû mémoriser, dans un TMS qui ne peut pas détecter s'il a fait une faute de frappe. Chaque heure qu'un connaissement passe dans l'écart entre votre boîte de réception et votre TMS est une heure où un client ne peut pas suivre son envoi, où une déclaration en douane n'a pas commencé et où une facture de transporteur ne peut pas être vérifiée par rapport à la cargaison réellement reçue. L'extraction réduit cet écart à quelques secondes. Ce que vous faites des heures que vous récupérez ne dépend que de vous.
Essayez l'extraction de connaissements sur vos propres documents →