A IA Consegue Extrair Dados de EOB com Precisão?
Sim — Uma Análise Detalhada por Campo
Sim — os modelos modernos de visão por IA extraem dados de EOB com 95-99% de precisão em nível de campo para campos críticos como códigos CPT, valores permitidos e identificadores de sinistros, reduzindo a taxa de erro manual padrão do setor de 8-12% para menos de 2%. Mas esse número principal esconde uma verdade mais útil: alguns campos de EOB são quase perfeitos de imediato, enquanto outros — responsabilidade do paciente, códigos de motivo de negação e alocações de franquia — exigem verificação específica por campo, porque cada pagadora define e posiciona esses campos de forma diferente, mesmo quando os rótulos parecem iguais.
Principais Conclusões
- A precisão de 95-99% na extração de EOB parece um problema resolvido — mas o número principal esconde uma diferença de 17 pontos entre os códigos CPT com 99% e os códigos de motivo de negação com 82% no mesmo documento.
- O maior limite de precisão para extração de EOB não é o modelo de IA — é a fonte de 6 pontos que as pagadoras governamentais usam para imprimir suas tabelas de itens de linha, onde um 6 e um 8 diferem por um único pixel a 200 DPI e a informação está fisicamente ausente da imagem para qualquer modelo ler.
- Você não precisa de um modelo separado para cada pagadora — defina suas colunas como Responsabilidade do Paciente uma única vez e a IA encontra o valor, seja a BCBS chamando de Responsabilidade do Membro, a UnitedHealthcare imprimindo Valor que Você Deve, ou a Cigna escrevendo Devido pelo Paciente.
Como Funciona de Verdade — pelos Números
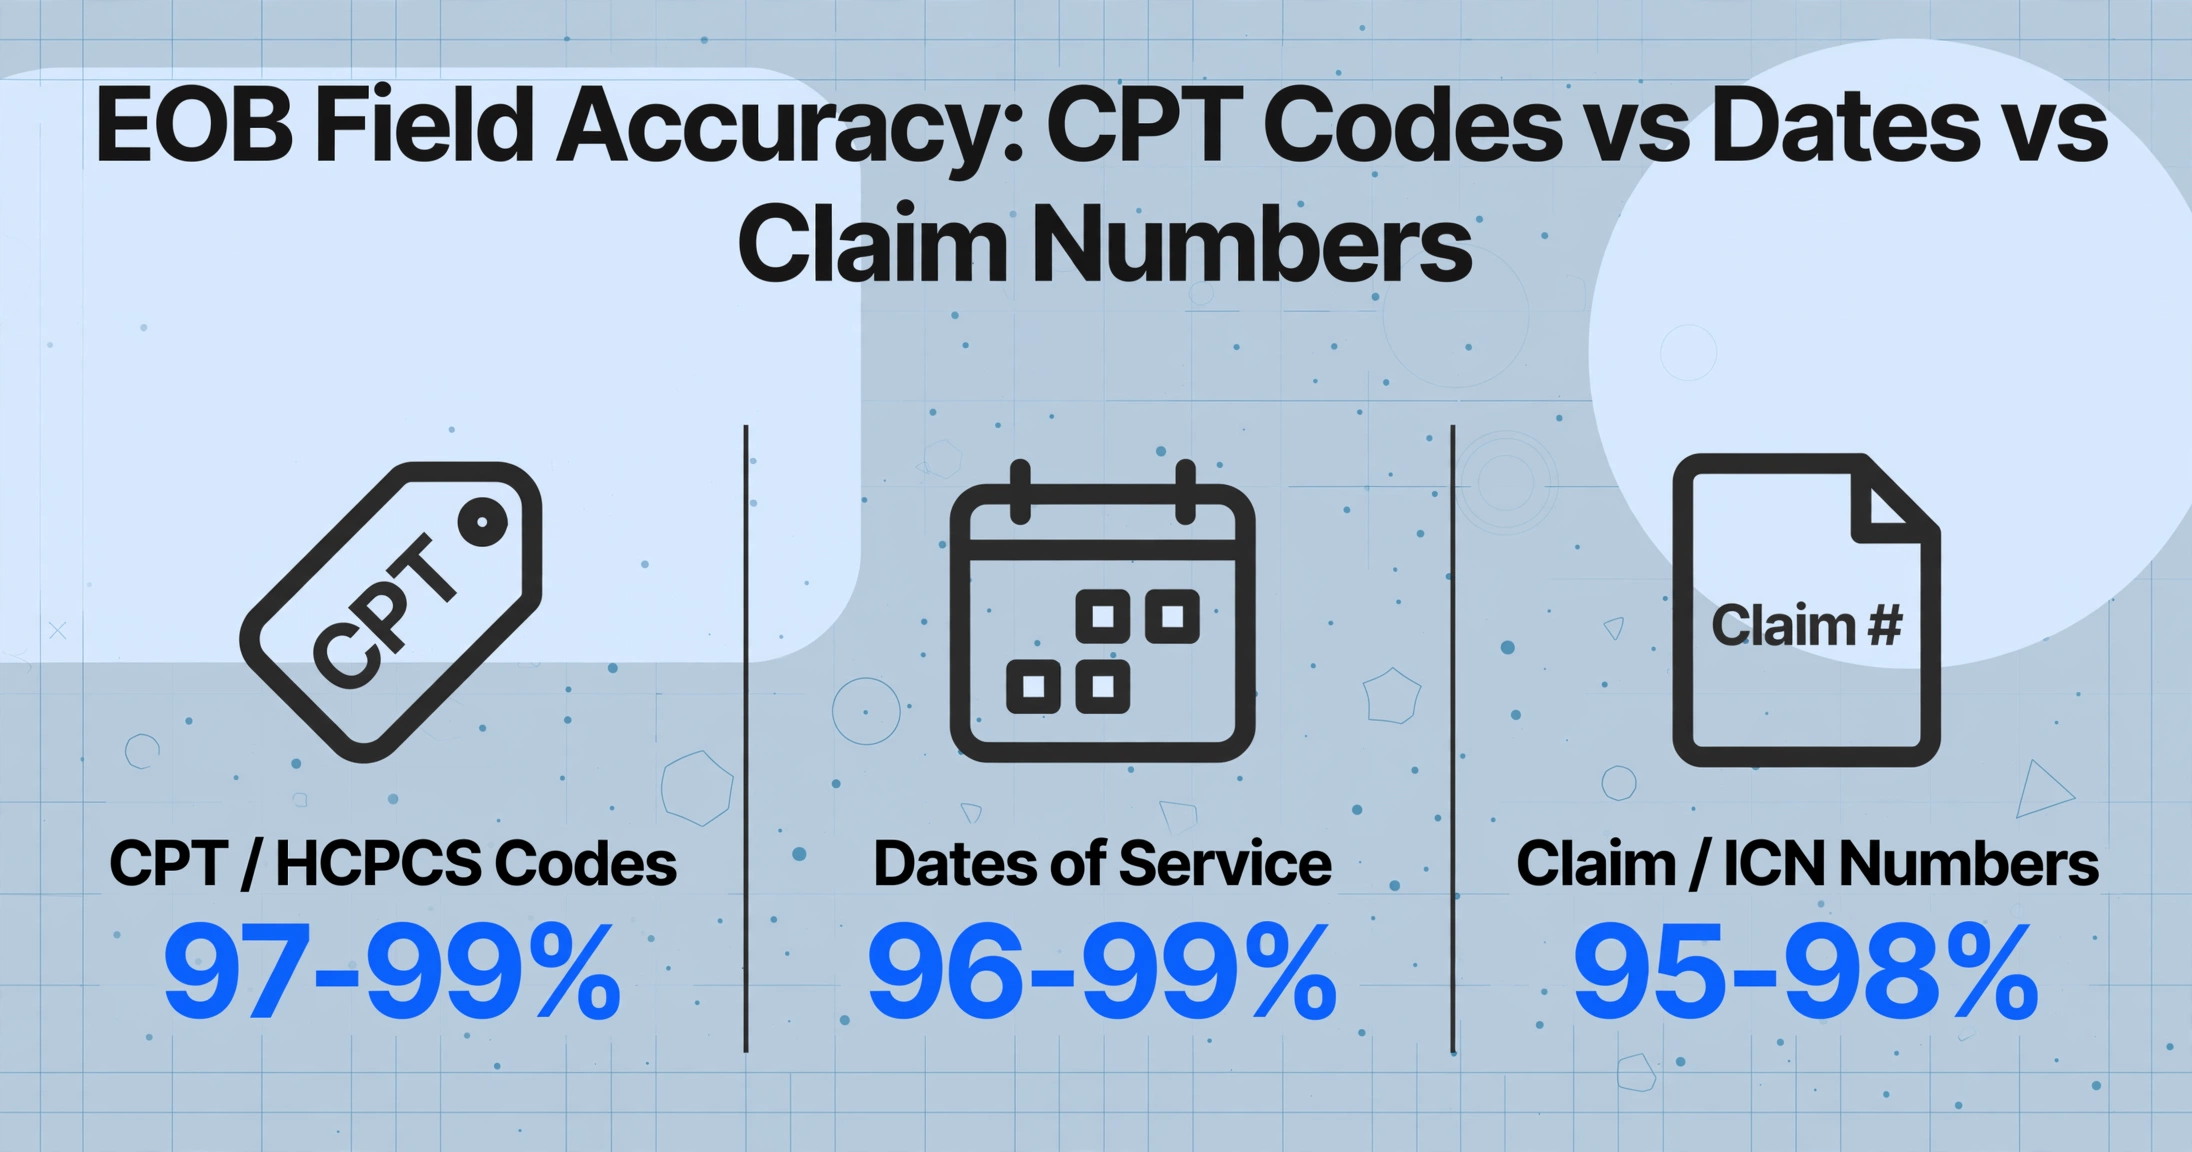
A precisão geral da extração de EOB é forte — mais forte do que a maioria dos profissionais de faturamento de saúde espera antes de testá-la. Os dados de implantações modernas de extração com IA mostram que a precisão em nível de campo para campos financeiros estruturados — valor cobrado, valor permitido, valor pago pelo plano, franquia, coparticipação — fica consistentemente entre 95% e 99% quando os documentos são digitalizados com qualidade razoável e os nomes das colunas são definidos semanticamente. Os mesmos sistemas reduzem as taxas de erro totais da linha de base de 8-12%, normal na entrada manual de dados de EOB, para menos de 2%, de acordo com benchmarks relatados em várias implantações de automação de saúde em 2025-2026.
Mas a faixa de "95-99%" é uma média entre todos os campos. Ela esconde uma variação significativa entre os tipos de campo. Para entender onde a IA realmente entrega e onde ela ainda precisa de suporte, você precisa analisar a precisão por categoria de campo, não como um número único.
| Categoria do Campo | Precisão Típica | Por Que Funciona ou Não |
|---|---|---|
| Códigos de procedimento CPT / HCPCS | 97-99% | Formato altamente padronizado — alfanumérico de 5 dígitos com modificador opcional de 2 dígitos. A IA treinada em documentos médicos reconhece o padrão mesmo em tabelas densas. |
| Datas de serviço | 96-99% | Formato inequívoco (MM/DD/AAAA ou MM/DD/AA). A posição na estrutura de itens de linha do EOB é consistente em relação aos códigos de procedimento. |
| Números de sinistro / ICN | 95-98% | Geralmente em uma posição de destaque no cabeçalho com um rótulo claro. Mas o rótulo varia — "Claim #", "ICN", "Control Number" — o que confunde o OCR de modelo e exige compreensão semântica. |
| Valores em dólar (cobrado/permitido/pago) | 94-98% | A extração semântica identifica os valores pelo contexto (coluna "Allowed" vs coluna "Billed"). A precisão cai quando as colunas de valores estão muito compactadas, sem bordas de célula visíveis. |
| Responsabilidade do paciente | 88-95% | Cada pagadora a posiciona e rotula de forma diferente — "Patient Responsibility", "Amount You Owe", "Member Liability", "Patient Due". O conceito é o mesmo; o rótulo e a localização não são. |
| Divisão de franquia / coparticipação / co-seguro | 85-93% | Os campos financeiros mais difíceis. Alguns EOBs mostram a franquia como um item de linha; outros a incorporam em uma caixa de resumo; outros a calculam implicitamente no valor pago. Exige referência cruzada que nem todos os formatos de EOB fornecem. |
| Códigos de motivo de negação / ajuste | 82-92% | Frequentemente em seções separadas de observações na parte inferior do EOB, vinculados a itens de linha por códigos de referência que precisam ser cruzados. O texto costuma ser a menor fonte da página. |
Para entender o contexto sobre o que é a extração de EOB e por que ela é importante para os fluxos de trabalho de faturamento, consulte o que é a extração de dados de EOB e como ela funciona.
O que a IA acerta nos EOBs — e por quê
Os campos que a IA processa com mais confiabilidade compartilham uma característica comum: são semanticamente inequívocos. Um código CPT é sempre um código CPT. Uma data de serviço é sempre uma data. Um valor permitido é o valor que o pagador concordou em reembolsar. Mesmo quando esses valores mudam de posição entre os mais de 1.500 formatos de EOB conhecidos — e isso acontece com frequência — a IA os encontra pelo que eles significam, não por uma coordenada pré-configurada. Essa é a diferença fundamental entre OCR baseado em modelo e extração por visão computacional com IA.
Quatro categorias de campos apresentam desempenho consistentemente bom:
Códigos de procedimento CPT e HCPCS
Esses são os dados mais padronizados em todos os formatos de EOB. Um código CPT tem sempre 5 dígitos, é sempre impresso próximo à descrição do serviço e quase sempre vem acompanhado de um modificador. O padrão alfanumérico é tão característico que modelos de visão treinados em documentos médicos o identificam e extraem com confiabilidade quase perfeita — mesmo quando as células da tabela ao redor estão cheias.
Valores em dólares em colunas
Os EOBs quase sempre apresentam valores cobrados, permitidos, pagos e de ajustes em uma tabela com várias colunas. Os modelos de visão computacional com IA analisam essas tabelas lendo o cabeçalho das colunas para entender qual é a coluna "cobrado" e qual é a "pago", extraindo então o valor em dólares de cada linha de acordo. Isso funciona bem quando as colunas têm cabeçalhos claros. Onde fica mais difícil — e onde a precisão cai — é quando os cabeçalhos estão rotacionados, abreviados ou totalmente ausentes, algo comum em EOBs enviados em papel por seguradoras menores.
Datas de serviço e datas de sinistro
As datas seguem um conjunto restrito de convenções de formato e quase sempre aparecem adjacentes ao código do procedimento ou à descrição do serviço na tabela de itens. A combinação de consistência de formato e contexto posicional torna a extração de datas um dos campos de EOB mais confiáveis.
Nome do prestador e NPI
As informações do prestador responsável normalmente aparecem em um bloco de cabeçalho consistente. O nome do prestador, o Identificador Nacional do Prestador (NPI) e o ID fiscal são impressos em uma seção estruturada perto do topo do EOB, com rótulos claros. Para organizações de saúde que precisam conciliar EOBs com seu quadro de prestadores, esse grupo de campos é extraído com precisão consistente acima de 95%.
Onde a IA Ainda Tropeça em EOBs
A resposta honesta é que três características estruturais dos EOBs criam desafios recorrentes de precisão que nenhum sistema de IA atual elimina completamente.
Tamanhos de fonte minúsculos em tabelas de colunas densas
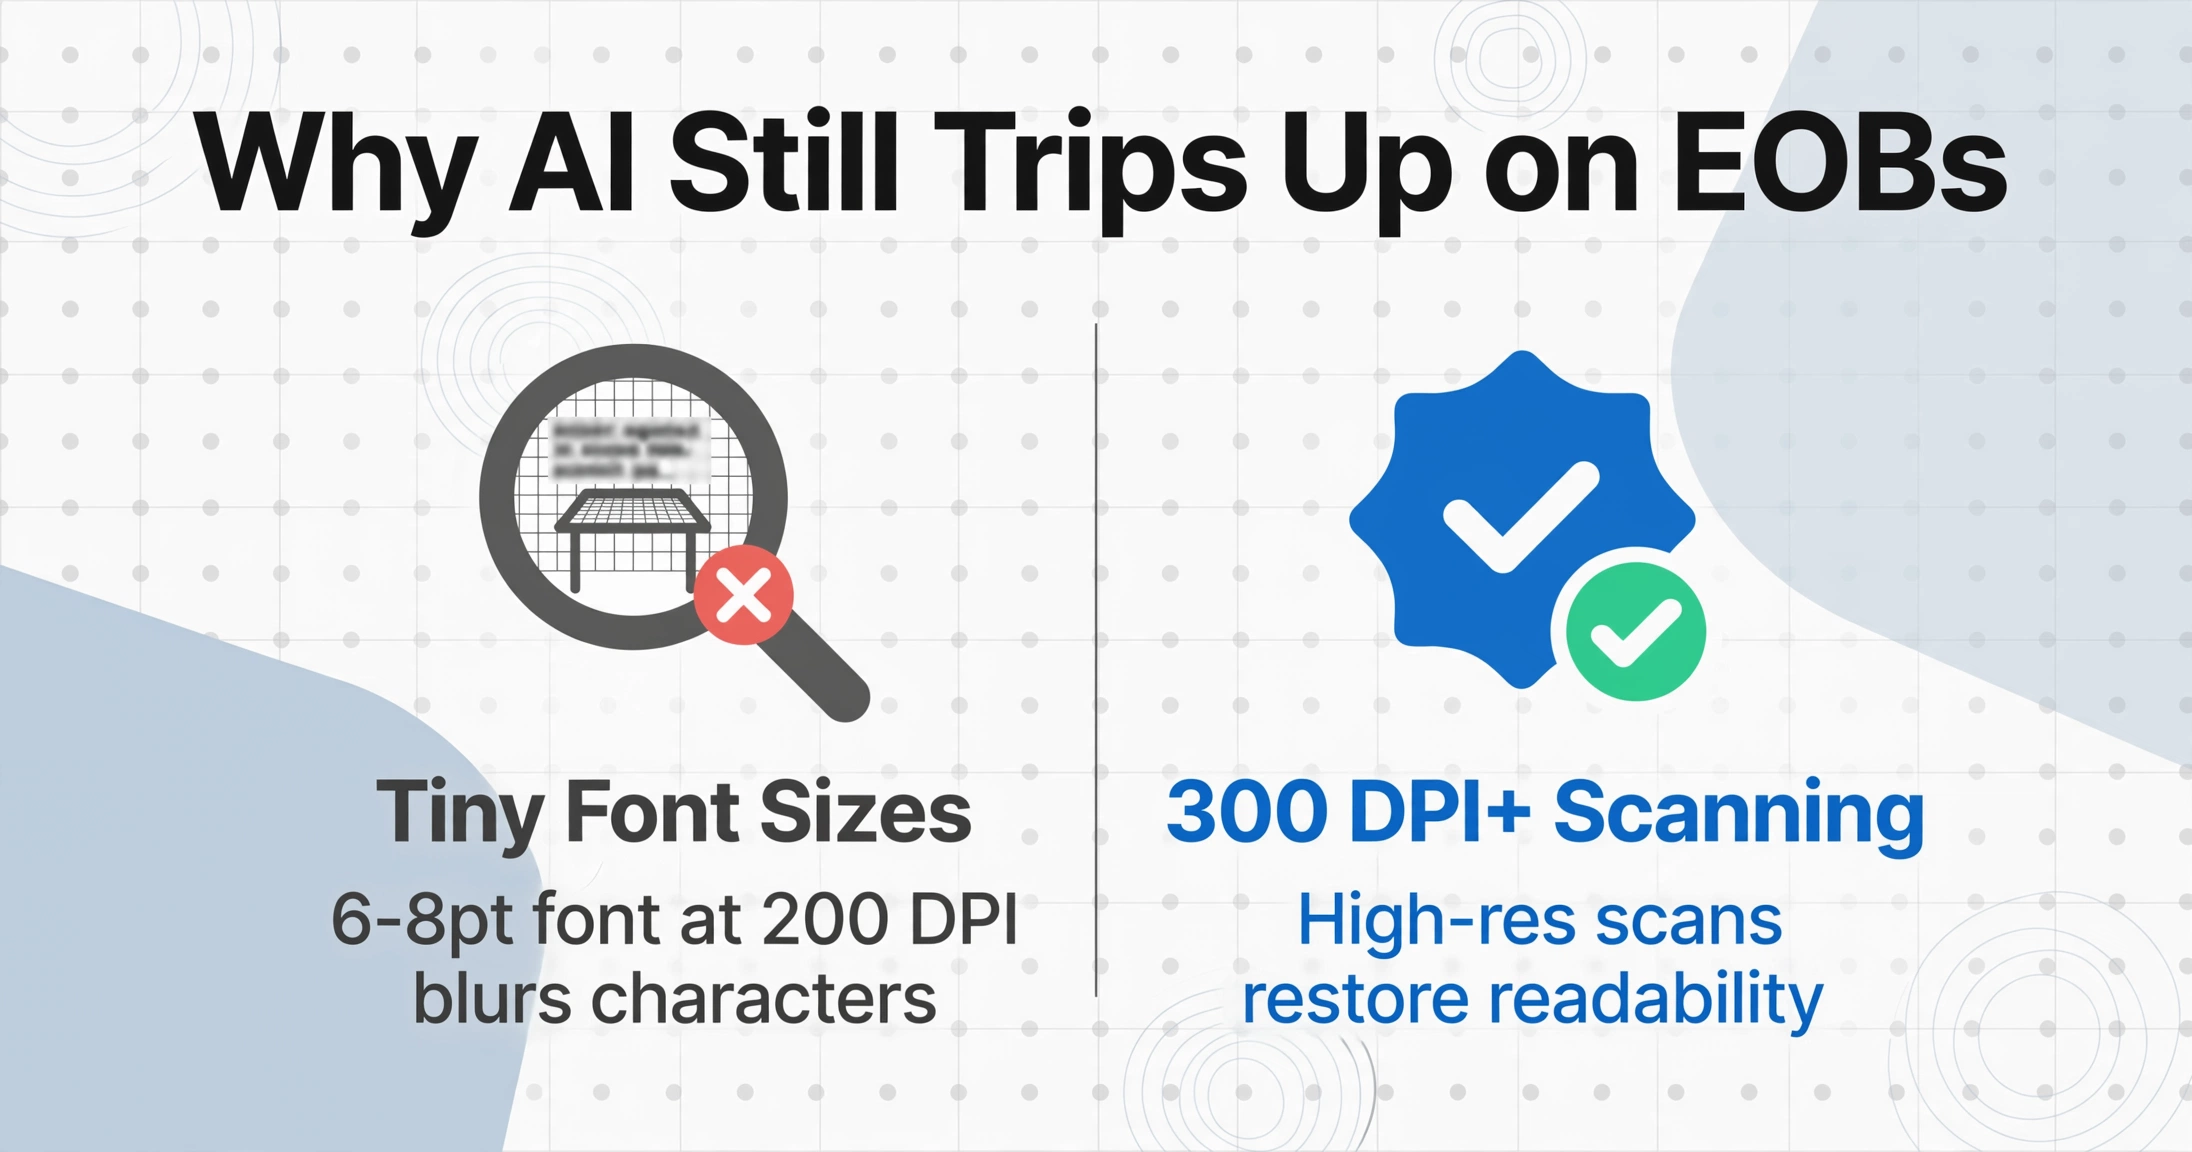
Muitos EOBs enviados em papel — especialmente de pagadores governamentais e seguradoras regionais — imprimem a tabela de itens de linha em fonte de 6 a 8 pontos. Isso é fisicamente pequeno o suficiente para que os limites dos caracteres fiquem borrados mesmo em digitalizações de alta resolução. Quando um "6" e um "8" diferem por um único pixel a 200 DPI, a IA lê o contexto ao redor para adivinhar qual é, e o contexto nem sempre é decisivo. A solução é direta — digitalizar a 300 DPI ou mais — mas essa é uma limitação física que apenas melhorias no modelo de IA não conseguem resolver.
Este é um desafio genuinamente diferente do problema de variabilidade de formato que a maioria dos fornecedores discute. A variabilidade de formato é um problema de engenharia: treine com mais formatos. O tamanho da fonte é um problema de física: em resolução pequena o suficiente, a informação não está presente na imagem para nenhum modelo ler. É a limitação menos discutida na categoria de extração de EOB.
Códigos de motivo de negação em seções de observações separadas
Os códigos de negação (como CO-4, PR-16, OA-23 dos códigos de motivo de ajuste de reivindicação padrão da HIPAA) geralmente são impressos em uma seção de observações separada na parte inferior ou no verso do EOB, vinculados aos itens de linha por números de referência de linha. Extrair o código em si é fácil. Mapeá-lo para a linha de serviço correta — e interpretar o que ele significa junto ao valor do ajuste — exige referência cruzada entre duas estruturas de tabela separadas na mesma página. A IA pode fazer isso, mas a precisão cai porque a conexão visual entre o item de linha e sua observação de negação correspondente geralmente é um alinhamento implícito de colunas, em vez de uma referência cruzada explícita.
Inconsistência no rótulo de responsabilidade do paciente
Um conceito, doze rótulos. A BCBS do Texas chama de "Patient Responsibility." A Aetna usa "Member Liability." A UnitedHealthcare imprime "Amount You Owe." A Cigna escreve "Patient Due." Os planos Medicare Advantage frequentemente usam "Patient Pay Amount." Cada um desses significa a mesma coisa para fins de conciliação — o valor que o paciente deve pagar ao prestador — mas um sistema de OCR baseado em modelo exigiria uma configuração separada para cada variante de rótulo. Um sistema de IA semântica lida com essa variação entendendo o conceito, mas a precisão não é tão alta quanto para campos de formato fixo, porque o modelo deve inferir a intenção do contexto em vez de corresponder a um padrão conhecido. É aqui que a Extração de Colunas Personalizadas — definir sua coluna como "Patient Responsibility" e deixar a IA encontrar o valor semanticamente correspondente, independentemente de como a seguradora o chama — faz a diferença entre um sistema que exige configuração constante e um que se adapta.
Para uma análise mais aprofundada de como os EOBs variam entre as seguradoras e por que isso desafia os sistemas de extração, consulte nosso guia completo para extração de dados de EOB.
Como Obter a Melor Precisão de Extração dos Seus EOBs
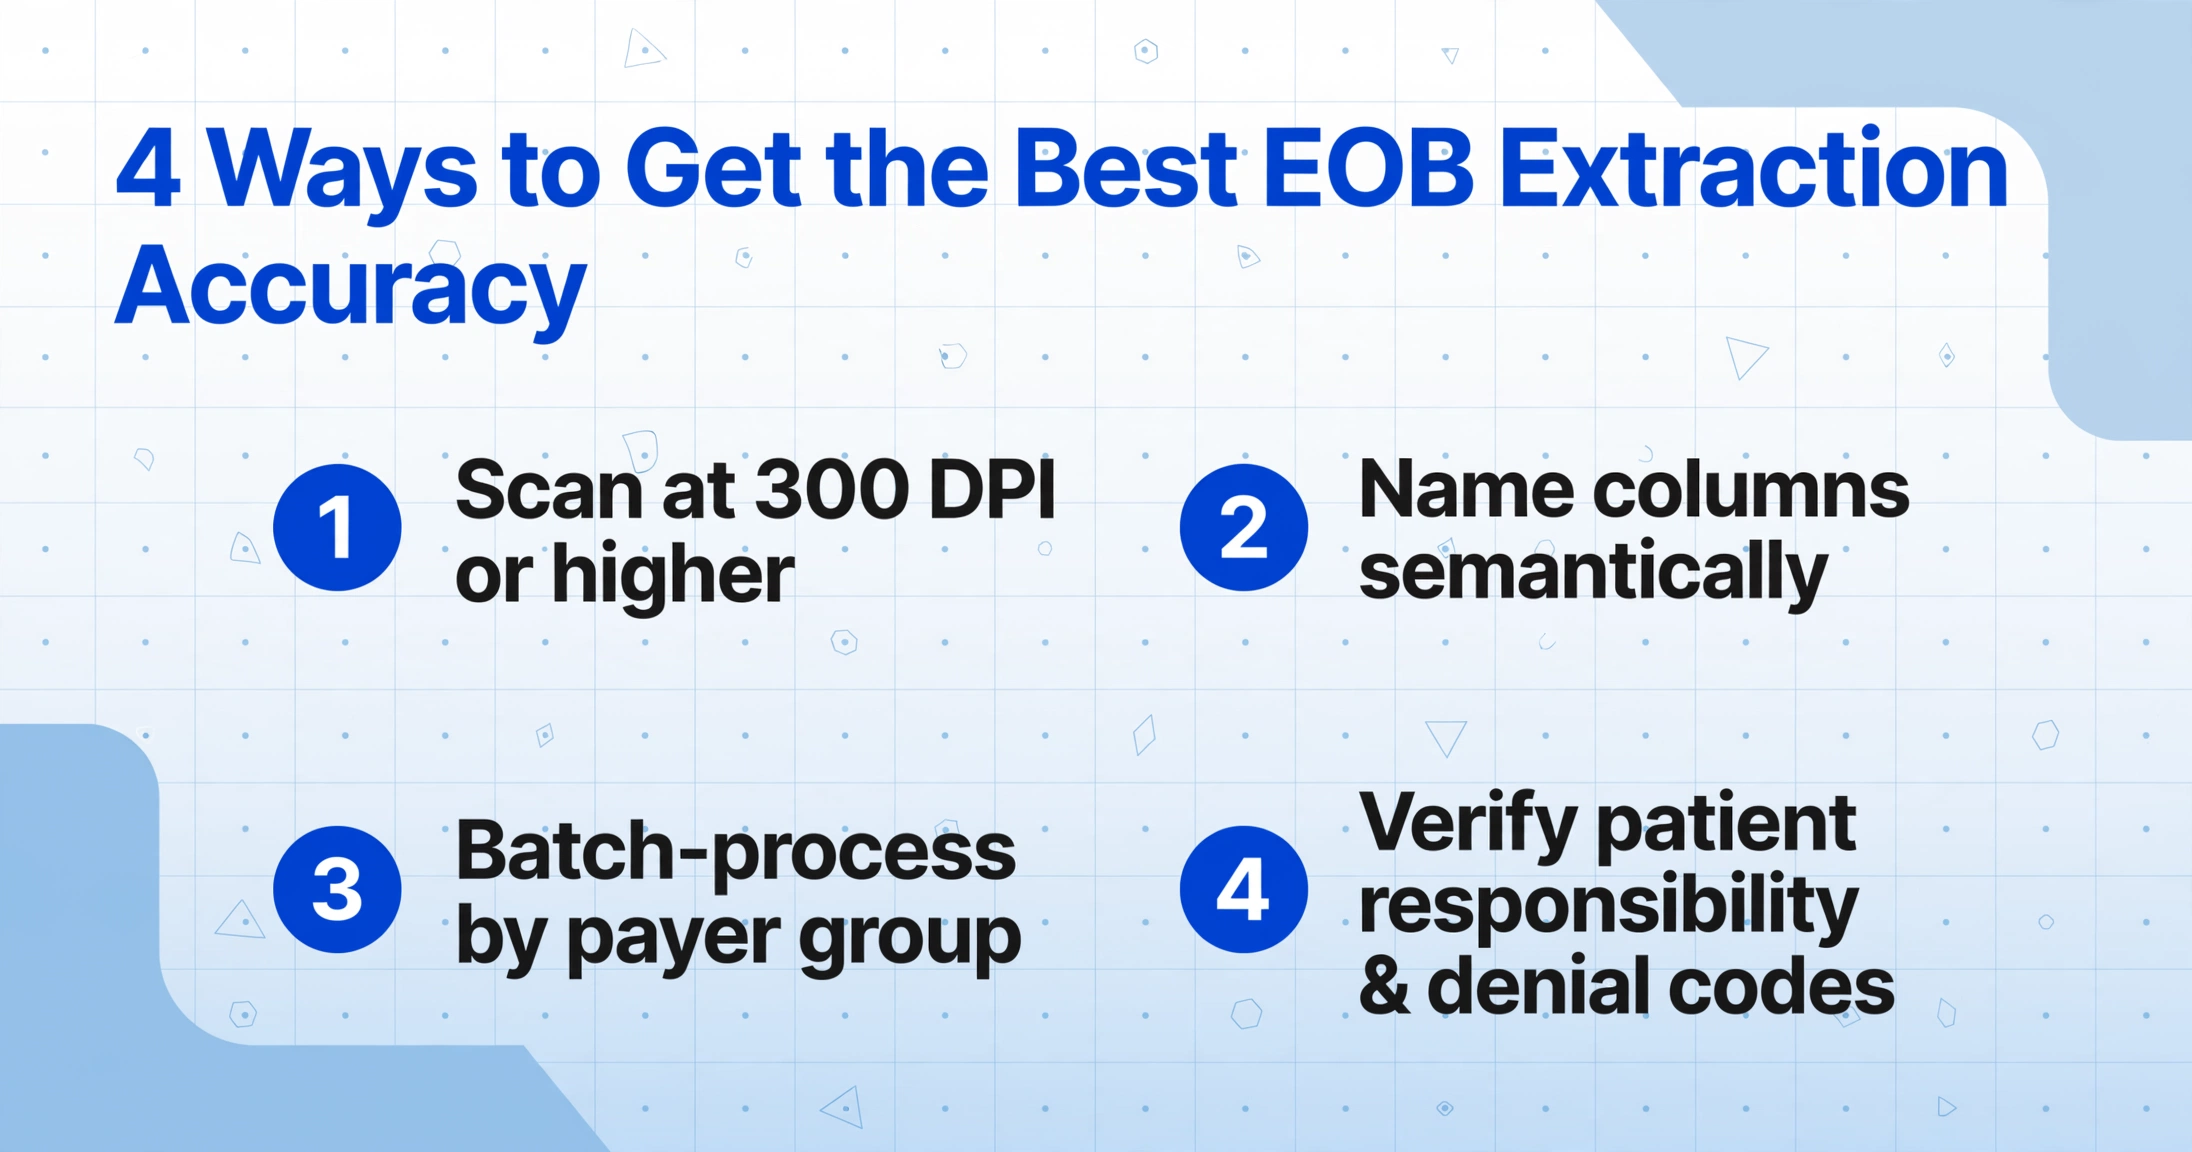
A precisão que você realmente obtiene de uma ferramenta de extração de EOB com IA depende menos do modelo e mais de como você prepara a entrada e define a saída. Estes quatro ajustes fazem a maior diferença:
A fonte de 6-8 pontos usada por muitos EOBs de pagadores está no limite do que a IA de visão consegue ler de forma confiable na resolução padrão de fax (200 DPI). Digitalizar a 300 DPI ou solicitar PDFs digitais em vez de cópias em papel elimina o teto de precisão mais comum sem nenhuna alteração de configuração da ferramenta.
Uma coluna chamada "Código CPT" ou "Monto Permitido" dá à IA um objetivo preciso. Uma coluna chamada "Código" ou "Monto 1" deixa espaço para ambiguidade. Quanto mais específico seja o nome da sua coluna, melhor a IA poderá distinguir entre os quatro ou cinco montos em dólares diferentes em uma única página de EOB.
Um EOB individual de BCBS do Texas e um EOB individual de Aetna podem parecer diferentes, mas um lote de 20 EOBs de BCBS todos seguem o mesmo layout. Processar EOBs em lotes específicos por pagador — mesmo que isso signifique cargar dois lotes separados — dá à IA a consistência visual que ela necesita para a maior precisão a nível de campo.
Estos dois grupos de campos têm a maior variação de precisão porque cada pagador os formata de maneira diferente. Incorpore uma etapa de verificação em seu fluxo de trabalho: faça que um especialista em faturamento revise os montos de responsabilidade do paciente e os mapeamentos de razones de negação em comparação com o EOB original, capturando os 5-15% dos casos que precisan correção antes de que cheguem a seus estados de conta do paciente ou a suas cuentas por cobrar.
O Que Isso Significa para Seu Fluxo de Trabalho com EOB
Aqui está a conclusão prática: a extração de EOB por IA não elimina a revisão humana, mas transforma como ela é feita. Em vez de um especialista em faturamento gastar de 15 a 20 minutos por EOB digitando manualmente cada campo — com uma taxa de erro de 8 a 12% que gera sinistros negados custando de US$ 25 a US$ 50 cada um para retrabalho — a IA extrai automaticamente os campos confiáveis, e o especialista concentra a verificação nas 2 a 3 categorias de campo com maior variabilidade entre operadoras.
A mudança no fluxo de trabalho é de transcrição para tratamento de exceções. Os campos rotineiros — códigos CPT, datas, números de sinistro, informações do prestador, valores padrão em dólar — chegam com 95 a 99% de precisão e precisam apenas de amostragem aleatória para garantia de qualidade. A atenção se volta para valores de responsabilidade do paciente, mapeamentos de códigos de negação e divisões de franquia/coparticipação/co-seguro, onde uma lacuna de precisão de 5 a 15% significa que o julgamento humano ainda é a ferramenta certa para o trabalho.
Para uma visão mais ampla de como a extração automatizada se encaixa nos fluxos de trabalho de documentos de saúde, incluindo EOBs, veja como o OCR lida com prontuários médicos, EOBs e formulários de sinistro.
Perguntas Frequentes
Qual é a precisão da IA na extração de dados de EOB?
A extração moderna de EOB por IA atinge 95-99% de precisão em campos estruturados como códigos CPT, datas de serviço, números de sinistro e valores padrão (cobrado, permitido, pago). A responsabilidade do paciente e códigos de motivo de negação são tipicamente menores, entre 85-95%. A taxa geral de erro cai de 8-12% no processamento manual para menos de 2% com IA — mas esses "menos de 2%" incluem uma mistura de campos com perfis de confiabilidade muito diferentes, então verificar os campos variáveis continua importante.
A IA consegue processar EOBs de diferentes seguradoras em um único lote?
Sim — esta é uma vantagem clara da IA de visão sobre o OCR baseado em template. Um sistema de extração semântica lê os valores dos campos pelo que significam, não por onde aparecem na página. Assim, um EOB da BCBS e um da Aetna com layouts diferentes podem ser processados no mesmo lote. A precisão é maior, no entanto, quando você agrupa EOBs do mesmo pagador, pois a consistência do layout dentro de um grupo de pagadores dá à IA contexto visual adicional para mapear os campos corretamente.
A precisão da extração de EOB exige treinar a IA com meus pagadores específicos?
Não — e este é um diferencial importante em relação a plataformas como Nanonets ou Rossum, que exigem amostras de treinamento rotuladas. Ferramentas de IA que usam Extração de Colunas Personalizadas não exigem treinamento: você digita os nomes das colunas desejadas (como "Código CPT", "Valor Permitido", "Responsabilidade do Paciente") e a IA localiza os valores correspondentes em qualquer formato de pagador, entendendo a semântica do documento. Funciona no primeiro upload, não após um ciclo de treinamento.
Por que a responsabilidade do paciente é mais difícil de extrair do que outros campos do EOB?
Porque não há um rótulo padrão para isso entre os pagadores. Um EOB imprime "Responsabilidade do Paciente" no final de uma tabela resumo. Outro chama de "Valor Devido pelo Membro" dentro de um parágrafo de texto. Um terceiro calcula implicitamente como a diferença entre o cobrado e o pago, sem imprimir um campo rotulado. Um sistema de IA semântica o encontra entendendo o contexto, em vez de corresponder a um rótulo, o que funciona na maioria das vezes, mas não sempre. Este é o grupo de campos que mais vale a pena verificar manualmente.
A IA extrai códigos de motivo de negação dos EOBs?
Ela extrai os códigos de forma confiável — códigos padrão de motivo de ajuste de reclamação HIPAA, como CO-4, PR-16 ou OA-23, seguem um formato fixo. A parte mais difícil é mapear cada código de negação para a linha de serviço correta, porque a seção de observações que lista as negações geralmente fica fisicamente separada da tabela de itens na página do EOB. Alguns EOBs usam números de linha de referência para vinculá-los; outros dependem do alinhamento da ordem das linhas. A IA lida bem com os números de referência explícitos, mas o mapeamento implícito por ordem de linhas pode introduzir erros.
Teste um lote de EOBs das suas pagadoras reais. Veja quais campos saem com 99% de precisão e quais precisam de uma segunda análise — antes de redesenhar seu fluxo de trabalho com base em suposições que podem não se aplicar à sua combinação específica de pagadoras.
Teste com Seus EOBs