L'IA peut-elle extraire les données EOB avec précision ?
Oui — Une analyse détaillée par champ
Oui — les modèles de vision par IA modernes extraient les données EOB avec une précision de 95 à 99 % au niveau des champs critiques comme les codes CPT, les montants autorisés et les identifiants de réclamation, réduisant le taux d'erreur manuel standard de l'industrie de 8-12 % à moins de 2 %. Mais ce chiffre global masque une vérité plus utile : certains champs EOB sont presque parfaits dès le départ, tandis que d'autres — responsabilité du patient, codes de motif de refus et allocations de franchise — nécessitent une vérification spécifique au champ, car chaque payeur les définit et les positionne différemment, même lorsque les libellés semblent identiques.
Points clés à retenir
- Une précision de 95-99 % sur l'extraction EOB semble être un problème résolu — mais le chiffre global masque un écart de 17 points entre les codes CPT à 99 % et les codes de motif de refus à 82 % sur le même document.
- Le principal plafond de précision pour l'extraction EOB n'est pas le modèle d'IA — c'est la police de 6 points que les payeurs gouvernementaux utilisent pour imprimer leurs tableaux de lignes, où un 6 et un 8 diffèrent d'un seul pixel à 200 DPI et où l'information est physiquement absente de l'image pour tout modèle à lire.
- Vous n'avez pas besoin d'un modèle distinct pour chaque payeur — définissez vos colonnes comme Responsabilité du patient une seule fois et l'IA trouve la valeur, que BCBS l'appelle Part du membre, que UnitedHealthcare imprime Montant que vous devez, ou que Cigna écrive Dû par le patient.
Son efficacité réelle — en chiffres
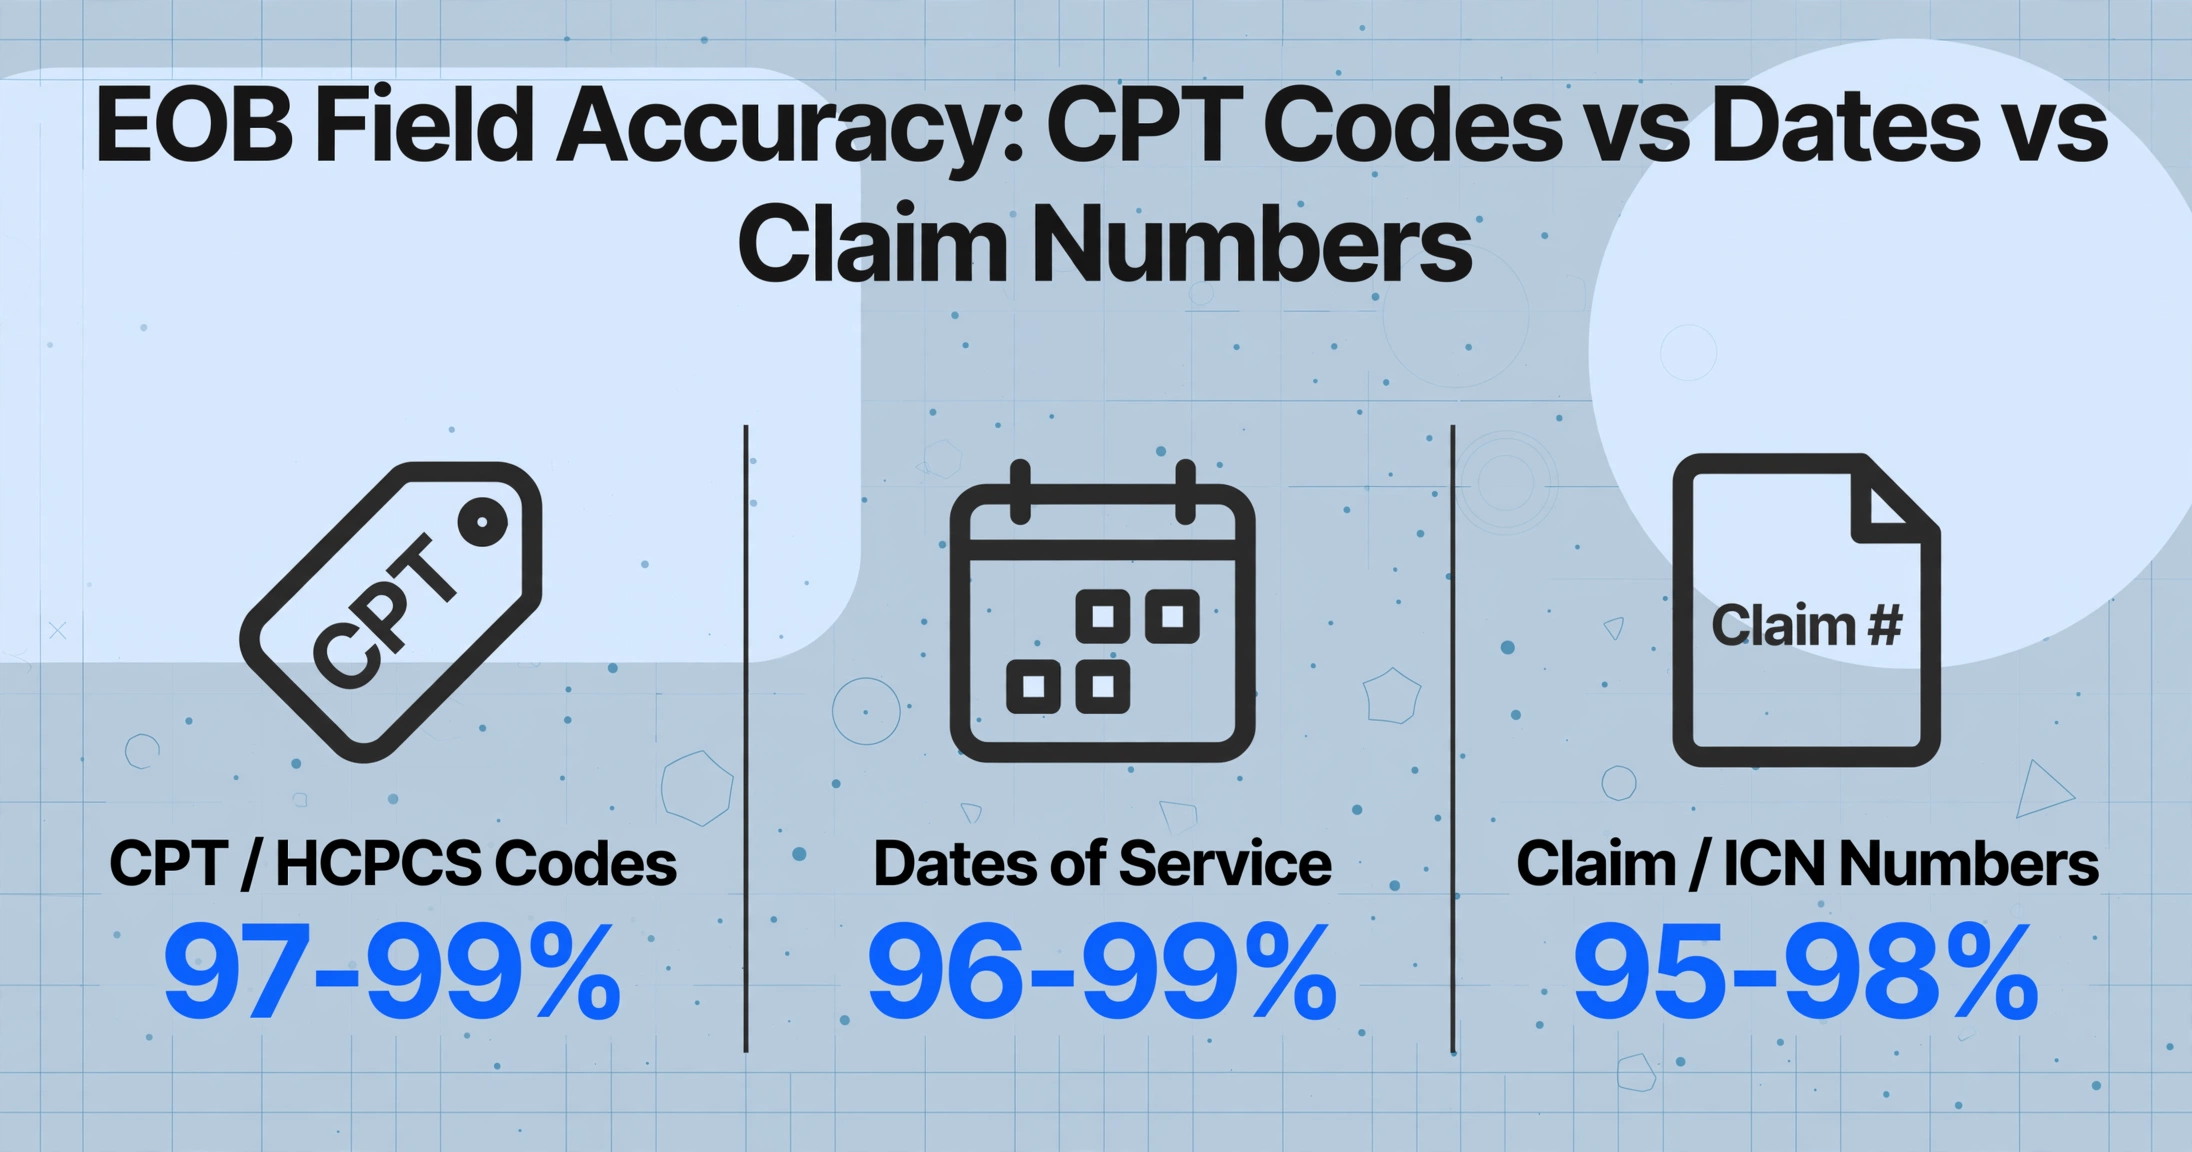
La précision globale de l'extraction EOB est solide — plus solide que ce que la plupart des professionnels de la facturation de santé attendent avant de la tester. Les données issues des déploiements modernes d'extraction basée sur l'IA montrent que la précision au niveau des champs pour les données financières structurées — montant facturé, montant autorisé, montant payé par le régime, franchise, ticket modérateur — se situe systématiquement entre 95 % et 99 % lorsque les documents sont numérisés à une qualité raisonnable et que les noms de colonnes sont définis sémantiquement. Les mêmes systèmes réduisent les taux d'erreur globaux de la base de 8 à 12 % normale dans la saisie manuelle de données EOB à moins de 2 %, selon les références rapportées dans plusieurs déploiements d'automatisation de la santé en 2025-2026.
Mais la fourchette « 95-99 % » est une moyenne sur tous les champs. Elle masque un écart significatif entre les types de champs. Pour comprendre où l'IA apporte réellement de la valeur et où elle nécessite encore un soutien, vous devez examiner la précision par catégorie de champ, et non comme un chiffre unique.
| Catégorie de champ | Précision typique | Pourquoi cela fonctionne ou non |
|---|---|---|
| Codes de procédure CPT / HCPCS | 97-99 % | Format hautement standardisé — alphanumérique à 5 chiffres avec modificateur facultatif à 2 chiffres. L'IA formée sur des documents médicaux reconnaît le motif même dans des tableaux denses. |
| Dates de service | 96-99 % | Format sans ambiguïté (MM/JJ/AAAA ou MM/JJ/AA). La position dans la structure des lignes de l'EOB est cohérente par rapport aux codes de procédure. |
| Numéros de réclamation / ICN | 95-98 % | Généralement dans une position d'en-tête proéminente avec une étiquette claire. Mais l'étiquette varie — « Claim # », « ICN », « Control Number » — ce qui perturbe l'OCR basé sur des modèles et nécessite une compréhension sémantique. |
| Montants en dollars (facturé/autorisé/payé) | 94-98 % | L'extraction sémantique identifie les montants par contexte (colonne « Autorisé » vs colonne « Facturé »). La précision diminue lorsque les colonnes de dollars sont densément regroupées sans bordures de cellules visibles. |
| Responsabilité du patient | 88-95 % | Chaque payeur la positionne et la libelle différemment — « Patient Responsibility », « Amount You Owe », « Member Liability », « Patient Due ». Le concept est le même ; l'étiquette et l'emplacement ne le sont pas. |
| Répartition franchise / ticket modérateur / co-assurance | 85-93 % | Les champs financiers les plus difficiles. Certains EOB présentent la franchise comme une ligne ; d'autres l'intègrent dans un encadré récapitulatif ; d'autres la calculent implicitement dans le montant payé. Nécessite une recoupement que tous les formats EOB ne fournissent pas. |
| Codes de motif de refus / d'ajustement | 82-92 % | Souvent dans des sections de remarques séparées en bas de l'EOB, liées aux lignes par des codes de référence qui doivent être recoupés. Le texte est fréquemment la plus petite police de la page. |
Pour comprendre ce qu'est l'extraction d'EOB et pourquoi elle est importante pour les flux de travail de facturation, voir ce qu'est l'extraction de données EOB et comment elle fonctionne.
Ce que l'IA réussit bien sur les EOB — et pourquoi
Les champs que l'IA traite de manière la plus fiable partagent une caractéristique commune : ils sont sémantiquement sans ambiguïté. Un code CPT est toujours un code CPT. Une date de service est toujours une date. Un montant autorisé est le chiffre que le payeur a accepté de rembourser. Même lorsque ces valeurs changent de position parmi les plus de 1 500 formats d'EOB connus — et c'est fréquent — l'IA les trouve par ce qu'elles signifient, et non par une coordonnée préconfigurée. C'est la différence fondamentale entre l'OCR basé sur des modèles et l'extraction par IA de vision.
Quatre catégories de champs obtiennent systématiquement de bons résultats :
Codes de procédure CPT et HCPCS
Ce sont les données les plus standardisées de tous les formats d'EOB. Un code CPT est toujours composé de 5 chiffres, toujours imprimé près de sa description de service, et presque toujours associé à un modificateur. Le motif alphanumérique est si distinctif que les modèles de vision entraînés sur des documents médicaux l'identifient et l'extraient avec une fiabilité quasi parfaite — même lorsque les cellules du tableau environnant sont encombrées.
Montants en dollars en colonnes
Les EOB présentent presque toujours les montants facturés, autorisés, payés et les ajustements dans un tableau à plusieurs colonnes. Les modèles de vision IA analysent ces tableaux en lisant l'en-tête de colonne pour comprendre quelle colonne est « facturée » et laquelle est « payée », puis extraient la valeur en dollars de chaque ligne en conséquence. Cela fonctionne bien lorsque les colonnes ont des en-têtes clairs. Là où cela devient plus difficile — et où la précision diminue — c'est lorsque les en-têtes sont pivotés, abrégés ou totalement absents, une occurrence courante sur les EOB envoyés par courrier par les petits assureurs.
Dates de service et dates de réclamation
Les dates suivent un ensemble restreint de conventions de format, et elles apparaissent presque toujours à côté du code de procédure ou de la description du service dans le tableau des lignes. La combinaison de la cohérence du format et du contexte positionnel fait de l'extraction des dates l'un des champs d'EOB les plus fiables.
Nom du prestataire et NPI
Les informations sur le prestataire de facturation apparaissent généralement dans un bloc d'en-tête cohérent. Le nom du prestataire, l'identifiant national du prestataire (NPI) et le numéro d'identification fiscale sont imprimés dans une section structurée près du haut de l'EOB, avec des libellés clairs. Pour les organismes de santé qui doivent rapprocher les EOB de leur liste de prestataires, ce groupe de champs est extrait avec une précision constante de 95 % ou plus.
Là où l'IA bute encore sur les EOB
La réponse honnête est que trois caractéristiques structurelles des EOB créent des défis récurrents en matière de précision qu'aucun système d'IA actuel n'élimine complètement.
Tailles de police minuscules dans les tableaux de colonnes denses
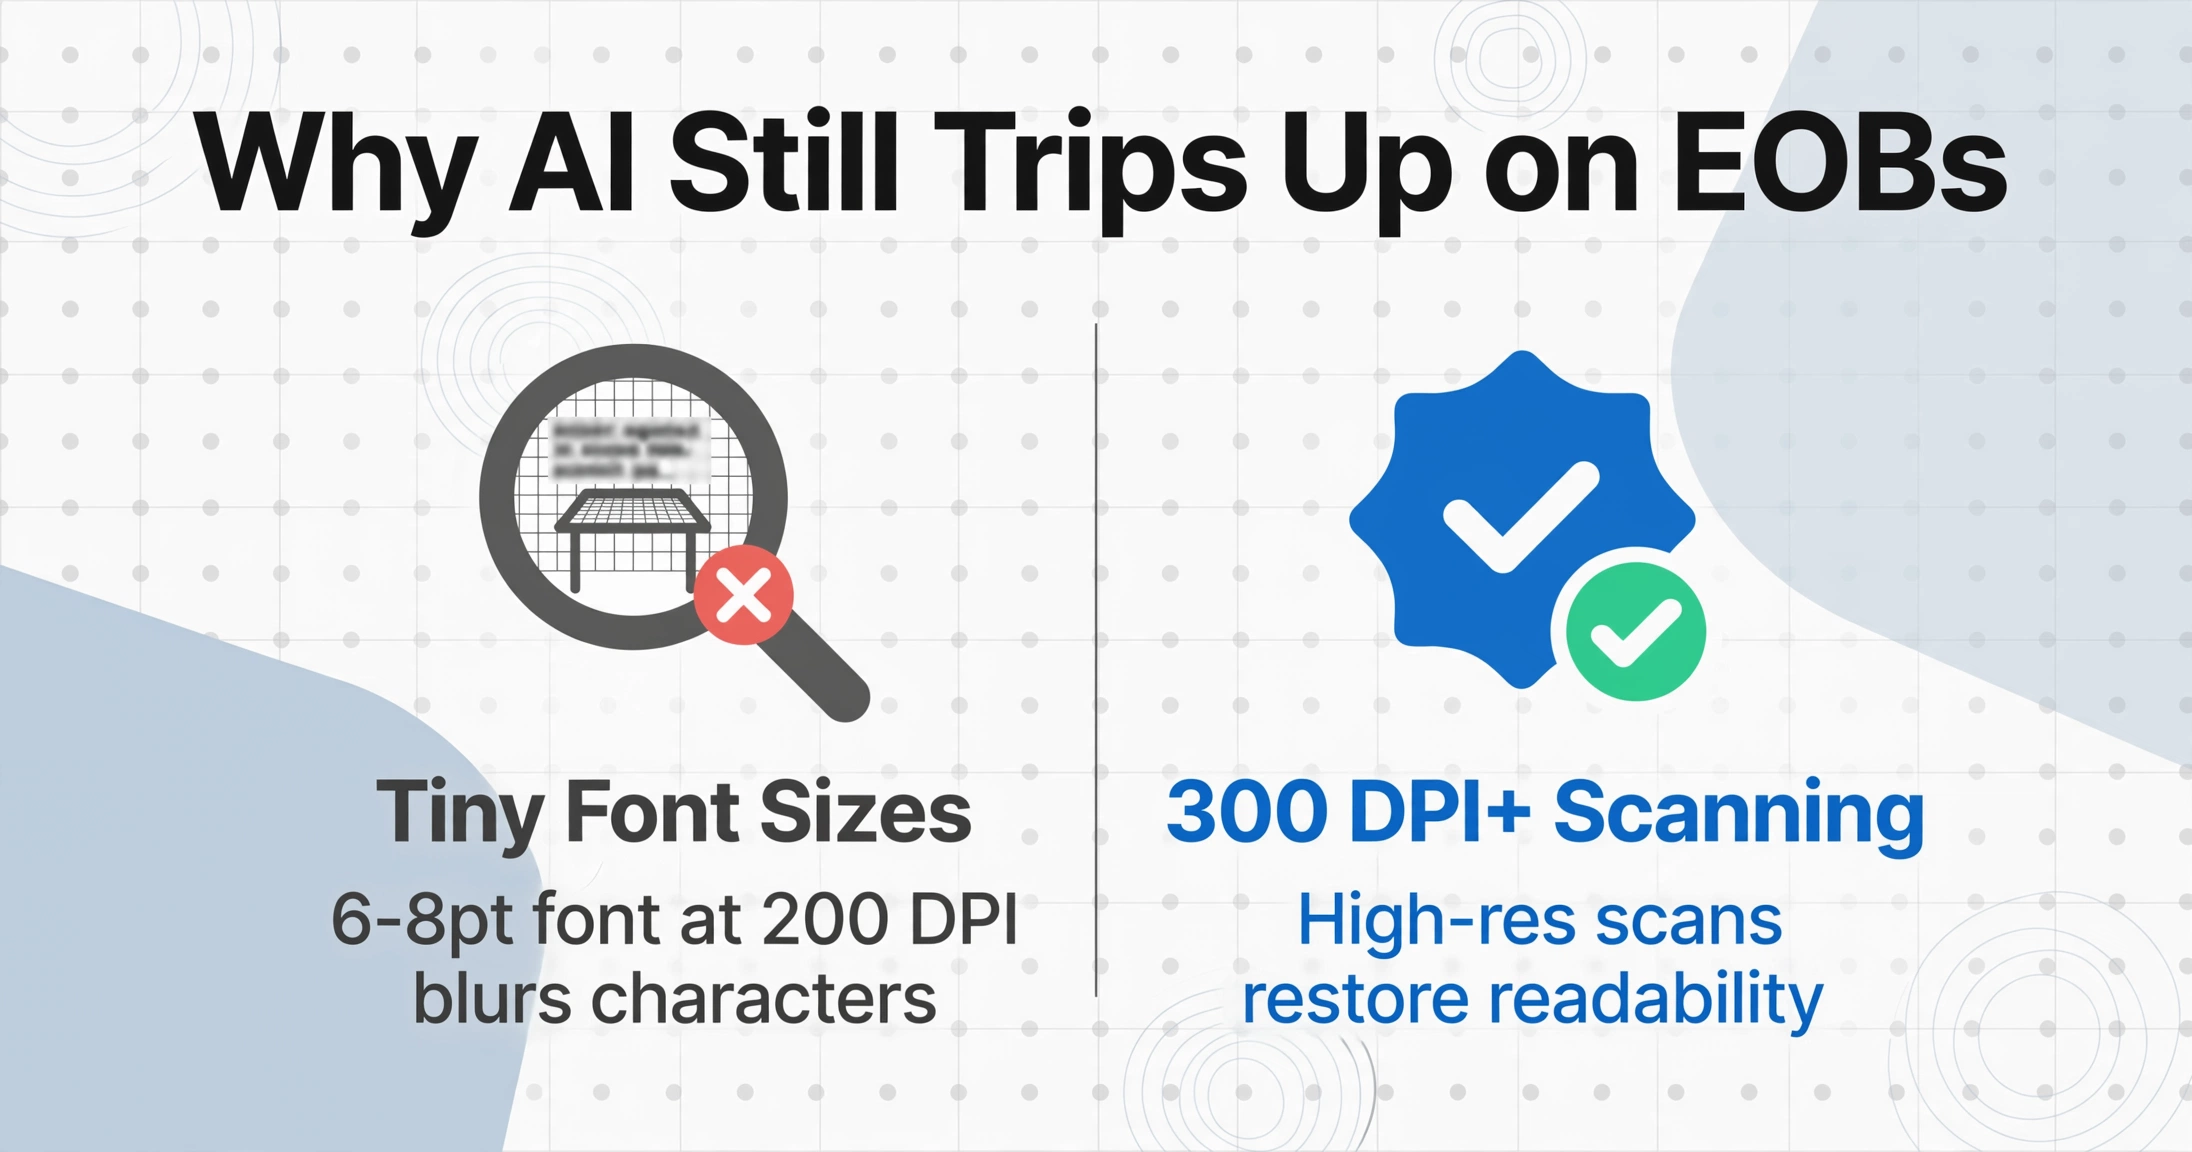
De nombreux EOB envoyés sur papier — en particulier ceux des payeurs gouvernementaux et des assureurs régionaux — impriment le tableau des lignes de détail dans une police de 6 à 8 points. C'est physiquement assez petit pour que les limites des caractères se brouillent même avec des numérisations haute résolution. Lorsqu'un « 6 » et un « 8 » ne diffèrent que d'un seul pixel à 200 DPI, l'IA lit le contexte environnant pour deviner lequel il s'agit, et le contexte n'est pas toujours décisif. La solution est simple — numériser à 300 DPI ou plus — mais c'est une contrainte physique que les seules améliorations des modèles d'IA ne peuvent pas résoudre.
C'est un défi véritablement différent du problème de variabilité des formats que la plupart des fournisseurs évoquent. La variabilité des formats est un problème d'ingénierie : s'entraîner sur davantage de formats. La taille de la police est un problème de physique : à une résolution suffisamment faible, l'information n'est pas présente dans l'image pour qu'un modèle puisse la lire. C'est la limitation la plus sous-estimée de la catégorie d'extraction des EOB.
Codes de motif de refus dans les sections de remarques détachées
Les codes de refus (tels que CO-4, PR-16, OA-23 de la norme HIPAA relative aux codes de motif d'ajustement de réclamation) sont généralement imprimés dans une section de remarques distincte en bas ou au dos de l'EOB, liés aux postes de la facture par des numéros de ligne de référence. Extraire le code lui-même est facile. Le mapper au bon poste de service — et interpréter sa signification en parallèle du montant de l'ajustement — nécessite une mise en correspondance croisée entre deux structures de tableau distinctes sur la même page. L'IA peut le faire, mais la précision diminue car la connexion visuelle entre le poste de la facture et sa remarque de refus correspondante est souvent un alignement de colonnes implicite plutôt qu'un renvoi explicite.
Incohérence des libellés de responsabilité du patient
Un concept, douze libellés. BCBS du Texas l'appelle « Patient Responsibility ». Aetna utilise « Member Liability ». UnitedHealthcare imprime « Amount You Owe ». Cigna écrit « Patient Due ». Les plans Medicare Advantage utilisent fréquemment « Patient Pay Amount ». Chacun de ces termes signifie la même chose à des fins de rapprochement — le montant que le patient doit au prestataire — mais un système OCR basé sur des modèles exigerait une configuration distincte pour chaque variante de libellé. Un système d'IA sémantique gère cette variation en comprenant le concept, mais la précision n'est pas aussi élevée que pour les champs à format fixe, car le modèle doit déduire l'intention du contexte plutôt que de correspondre à un modèle connu. C'est là que l'Extraction de colonnes personnalisées — définir votre colonne comme « Patient Responsibility » et laisser l'IA trouver la valeur sémantiquement correspondante, quel que soit le nom que lui donne le payeur — fait la différence entre un système qui nécessite une configuration constante et un système qui s'adapte.
Pour un aperçu plus approfondi de la façon dont les EOB varient selon les payeurs et pourquoi cela pose des défis aux systèmes d'extraction, consultez notre guide complet sur l'extraction de données EOB.
Comment obtenir la meilleure précision d'extraction de vos EOB
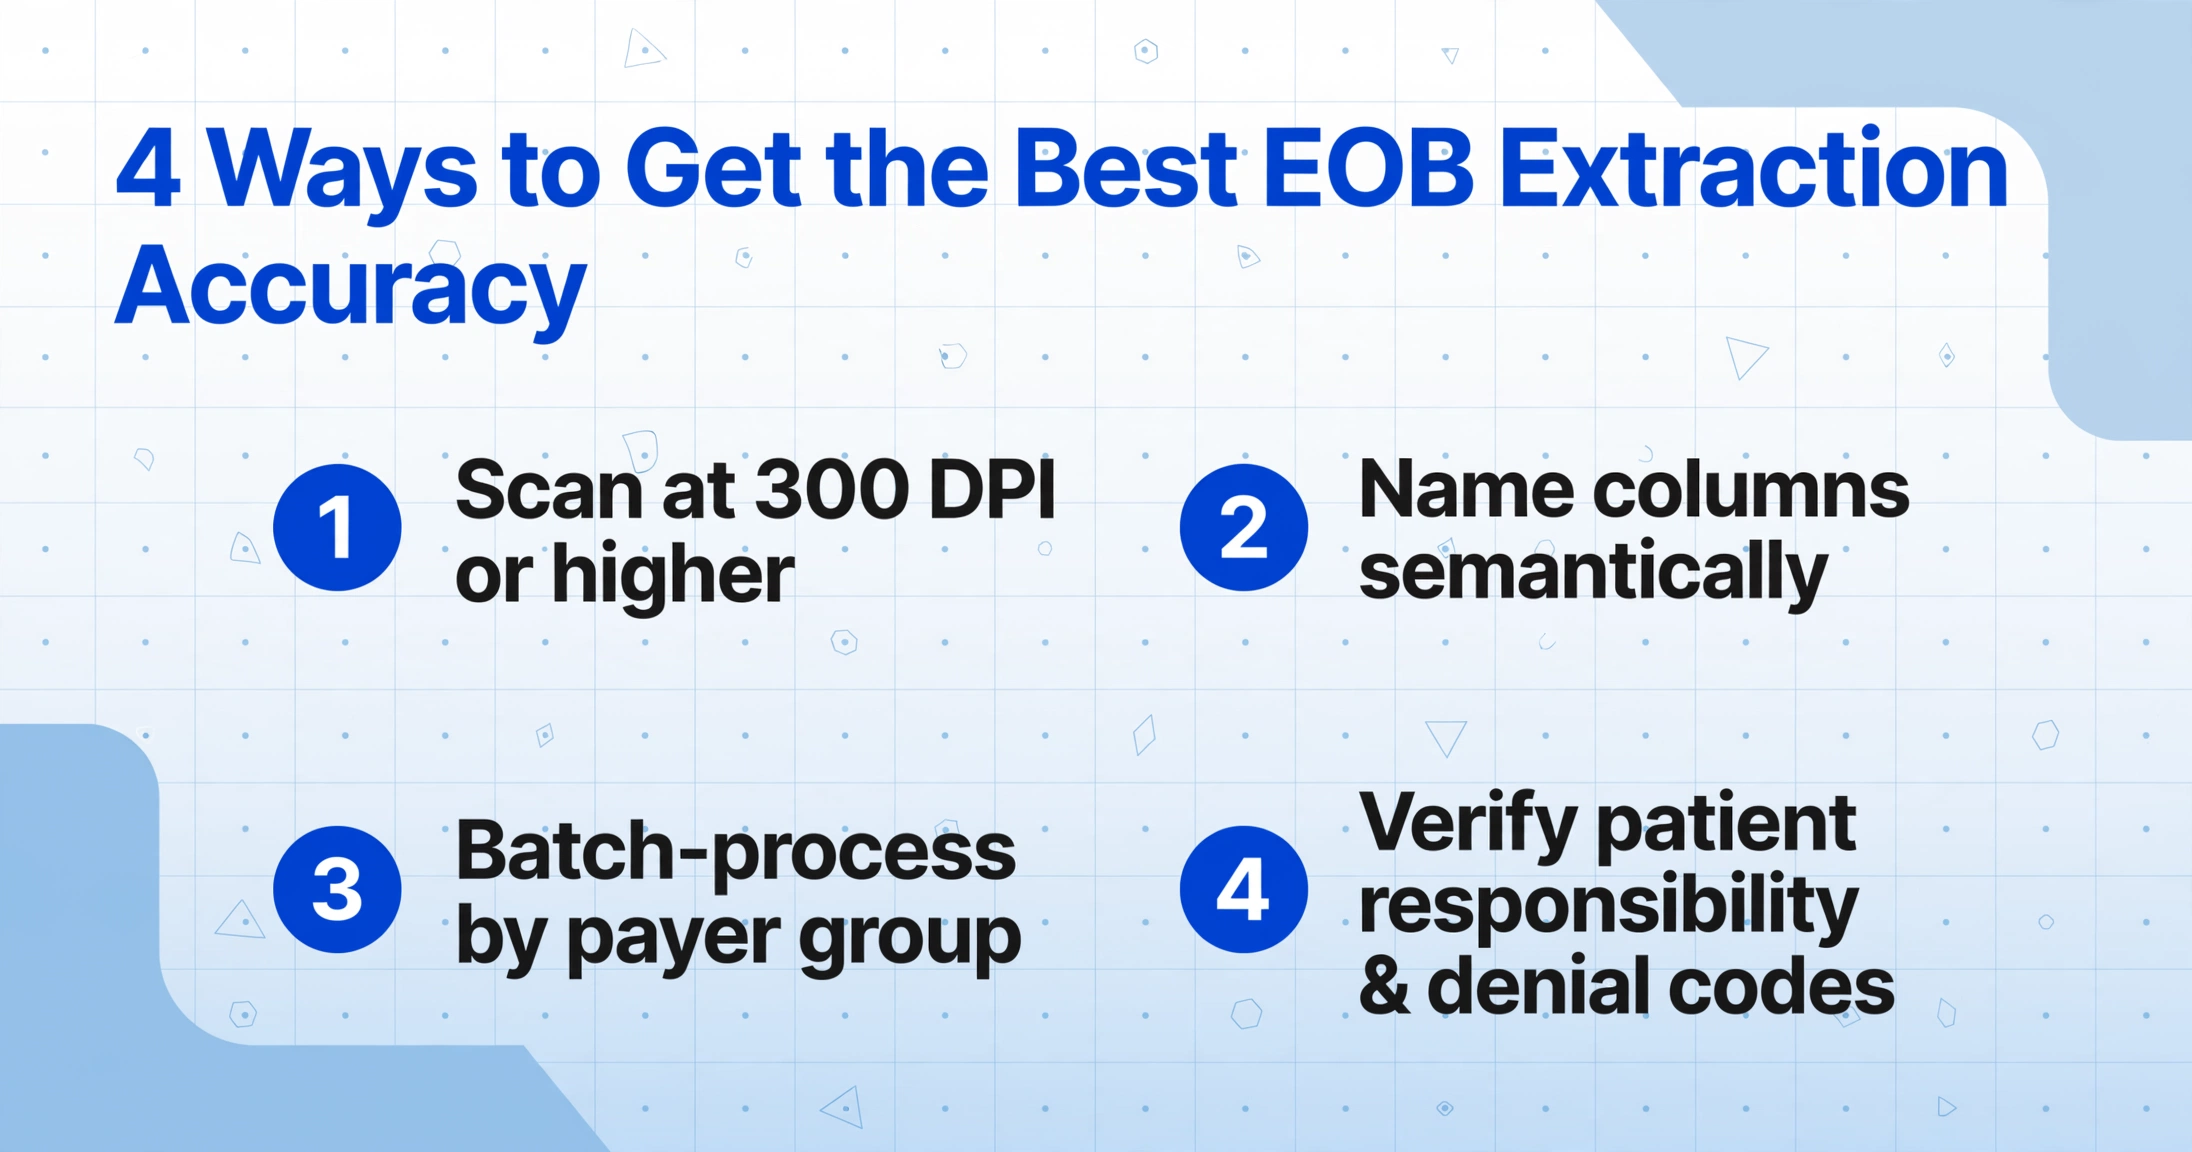
La précision que vous obtenez réellement d'un outil d'extraction d'EOB par IA dépend moins du modèle que de la façon dont vous préparez les entrées et définissez les sorties. Ces quatre ajustements font la plus grande différence :
La police de 6 à 8 points utilisée par de nombreux EOB de payeurs est à la limite de ce que l'IA de vision peut lire de manière fiable à la résolution de télécopie standard (200 DPI). La numérisation à 300 DPI ou la demande de PDF numériques plutôt que de copies papier élimine le plafond de précision le plus courant sans aucune modification de configuration de l'outil.
Une colonne nommée « code CPT » ou « montant autorisé » donne à l'IA une cible précise. Une colonne nommée « code » ou « montant 1 » laisse place à l'ambiguïté. Plus le nom de votre colonne est spécifique, mieux l'IA peut faire la distinction entre les quatre ou cinq montants en dollars différents sur une seule page d'EOB.
Un EOB unique de BCBS du Texas et un EOB unique d'Aetna peuvent sembler différents, mais un lot de 20 EOB de BCBS suit tous la même mise en page. Le traitement des EOB en lots spécifiques au payeur — même si cela implique de téléverser deux lots séparés — donne à l'IA la cohérence visuelle dont elle a besoin pour la plus grande précision au niveau des champs.
Ces deux groupes de champs présentent la plus grande variance de précision, car chaque payeur les formate différemment. Intégrez une étape de vérification à votre flux de travail : demandez à un spécialiste de la facturation de contrôler les montants de responsabilité du patient et les correspondances des motifs de refus par rapport à l'EOB d'origine, en détectant les 5 à 15 % de cas nécessitant une correction avant qu'ils n'atteignent vos relevés patients ou vos comptes clients.
Ce que cela signifie pour votre flux de travail EOB
Voici l'essentiel : l'extraction IA des EOB ne supprime pas la relecture humaine, mais elle en transforme la nature. Au lieu qu'un spécialiste de la facturation passe 15 à 20 minutes par EOB à saisir manuellement chaque champ — avec un taux d'erreur de 8 à 12 % générant des demandes refusées dont le retraitement coûte entre 25 et 50 $ chacune — l'IA extrait automatiquement les champs fiables, et le spécialiste concentre sa vérification sur les 2 à 3 catégories de champs où la variabilité des payeurs est la plus élevée.
Le flux de travail passe de la transcription à la gestion des exceptions. Les champs courants — codes CPT, dates, numéros de réclamation, informations sur le prestataire, montants standard — sont extraits avec une précision de 95 à 99 % et ne nécessitent qu'un échantillonnage aléatoire pour l'assurance qualité. L'attention se porte sur les montants à la charge du patient, les correspondances des codes de motif de refus et les répartitions franchise/quote-part/coassurance, où un écart de précision de 5 à 15 % signifie que le jugement humain reste l'outil approprié.
Pour une vue d'ensemble de l'intégration de l'extraction automatisée dans les flux de documents de santé, y compris les EOB, consultez comment l'OCR traite les dossiers médicaux, les EOB et les formulaires de réclamation.
Questions fréquemment posées
Quelle est la précision de l'IA pour l'extraction des données des EOB ?
L'extraction moderne par IA des EOB atteint une précision de 95 à 99 % au niveau des champs structurés comme les codes CPT, les dates de service, les numéros de réclamation et les montants standard (facturés, autorisés, payés). La responsabilité du patient et les codes de motif de refus sont généralement moins précis, entre 85 et 95 %. Le taux d'erreur global passe de 8 à 12 % en traitement manuel à moins de 2 % avec l'IA — mais ces « moins de 2 % » incluent un mélange de champs aux profils de fiabilité très différents, donc vérifier les champs variables reste important.
L'IA peut-elle traiter des EOB de différentes compagnies d'assurance en un seul lot ?
Oui — c'est là que l'IA visuelle a un net avantage sur l'OCR basée sur des modèles. Un système d'extraction sémantique lit les valeurs des champs par leur signification, et non par leur emplacement sur la page. Ainsi, un EOB de BCBS et un EOB d'Aetna avec des mises en page différentes peuvent être traités dans le même lot. La précision est cependant maximale lorsque vous regroupez les EOB d'un même payeur, car la cohérence de la mise en page au sein d'un groupe de payeurs donne à l'IA un contexte visuel supplémentaire pour mapper correctement les champs.
La précision de l'extraction des EOB nécessite-t-elle d'entraîner l'IA sur mes payeurs spécifiques ?
Non — et c'est un différenciateur clé par rapport à des plateformes comme Nanonets ou Rossum qui nécessitent des échantillons d'entraînement étiquetés. Les outils d'IA utilisant l'extraction de colonnes personnalisées ne nécessitent aucun entraînement : vous tapez les noms de colonnes souhaités (comme « Code CPT », « Montant autorisé », « Responsabilité du patient ») et l'IA localise les valeurs correspondantes dans n'importe quel format de payeur en comprenant la sémantique du document. Cela fonctionne dès le premier téléchargement, et non après un cycle d'entraînement.
Pourquoi la responsabilité du patient est-elle plus difficile à extraire que les autres champs des EOB ?
Parce qu'il n'existe pas d'étiquette standard pour ce champ selon les payeurs. Un EOB imprime « Responsabilité du patient » en bas d'un tableau récapitulatif. Un autre l'appelle « Montant dû par le membre » dans un paragraphe de texte. Un troisième le calcule implicitement comme la différence entre le montant facturé et le montant payé, sans imprimer de champ étiqueté. Un système d'IA sémantique le trouve en comprenant le contexte plutôt qu'en faisant correspondre une étiquette, ce qui fonctionne la plupart du temps, mais pas toujours. C'est le groupe de champs qui mérite le plus d'être vérifié manuellement.
L'IA extrait-elle les codes de motif de refus des EOB ?
Elle extrait les codes eux-mêmes de manière fiable — les codes standard de motif d'ajustement de réclamation HIPAA comme CO-4, PR-16 ou OA-23 suivent un format fixe. La partie la plus difficile consiste à associer chaque code de refus à la bonne ligne de service, car la section des remarques listant les refus est souvent physiquement séparée du tableau des lignes d'articles sur la page EOB. Certains EOB utilisent des numéros de ligne de référence pour les lier ; d'autres s'appuient sur l'alignement de l'ordre des lignes. L'IA gère bien les numéros de référence explicites, mais le mappage implicite par ordre de lignes peut introduire des erreurs.
Testez un lot d'EOB provenant de vos payeurs réels. Voyez quels champs arrivent à 99 % et lesquels nécessitent un second examen — avant de repenser votre flux de travail autour d'hypothèses qui pourraient ne pas tenir pour votre combinaison spécifique de payeurs.
Essayez avec vos EOB