Kann KI EOB-Daten präzise extrahieren?
Ja — eine feldgenaue Aufschlüsselung
Ja — moderne KI-Vision-Modelle extrahieren EOB-Daten mit einer feldgenauen Genauigkeit von 95-99 % bei kritischen Feldern wie CPT-Codes, zulässigen Beträgen und Anspruchskennungen und senken die branchenübliche manuelle Fehlerquote von 8-12 % auf unter 2 %. Doch diese Schlagzahl verbirgt eine nützlichere Wahrheit: Einige EOB-Felder sind nahezu perfekt aus dem Stand, während andere — Patientenzahlungspflicht, Ablehnungsbegründungscodes und Selbstbehaltszuordnungen — eine feldspezifische Verifizierung erfordern, da jeder Kostenträger sie unterschiedlich definiert und positioniert, selbst wenn die Bezeichnungen gleich klingen.
Wichtigste Erkenntnisse
- Eine Genauigkeit von 95-99 % bei der EOB-Extraktion klingt nach einem gelösten Problem — doch die Schlagzahl verbirgt eine Lücke von 17 Prozentpunkten zwischen CPT-Codes bei 99 % und Ablehnungsbegründungscodes bei 82 % auf demselben Dokument.
- Die größte einzelne Genauigkeitsgrenze bei der EOB-Extraktion ist nicht das KI-Modell — es ist die 6-Punkt-Schrift, in der staatliche Kostenträger ihre Positionszeilentabellen drucken, wo sich eine 6 und eine 8 bei 200 DPI nur durch ein einzelnes Pixel unterscheiden und die Information physisch nicht im Bild vorhanden ist, damit ein Modell sie lesen kann.
- Sie benötigen keine separate Vorlage für jeden Kostenträger — definieren Sie Ihre Spalten einmal als Patientenzahlungspflicht und die KI findet den Wert, egal ob BCBS ihn als Member Liability bezeichnet, UnitedHealthcare Amount You Owe druckt oder Cigna Patient Due schreibt.
Wie gut es tatsächlich funktioniert — in Zahlen
Die Gesamtbilanz zur Genauigkeit der EOB-Extraktion ist stark — stärker, als die meisten Fachkräfte im Gesundheitswesen vor einem Test erwarten. Die Daten aus modernen KI-gestützten Extraktionssystemen zeigen, dass die Feldgenauigkeit bei strukturierten Finanzfeldern — Rechnungsbetrag, erstattungsfähiger Betrag, gezahlter Betrag der Versicherung, Selbstbehalt, Zuzahlung — konsistent zwischen 95 % und 99 % liegt, wenn Dokumente in angemessener Qualität gescannt und Spaltennamen semantisch definiert werden. Dieselben Systeme senken die Gesamtfehlerquote von der bei manueller EOB-Dateneingabe üblichen Basis von 8-12 % auf unter 2 %, so die Benchmarks aus mehreren Healthcare-Automatisierungsprojekten in den Jahren 2025-2026.
Der Bereich „95-99 %" ist jedoch ein Durchschnitt über alle Felder. Er verbirgt eine aussagekräftige Spannweite zwischen den Feldtypen. Um zu verstehen, wo KI tatsächlich liefert und wo sie noch Unterstützung benötigt, müssen Sie die Genauigkeit nach Feldkategorie betrachten, nicht als einzelne Zahl.
| Feldkategorie | Typische Genauigkeit | Warum es funktioniert oder nicht |
|---|---|---|
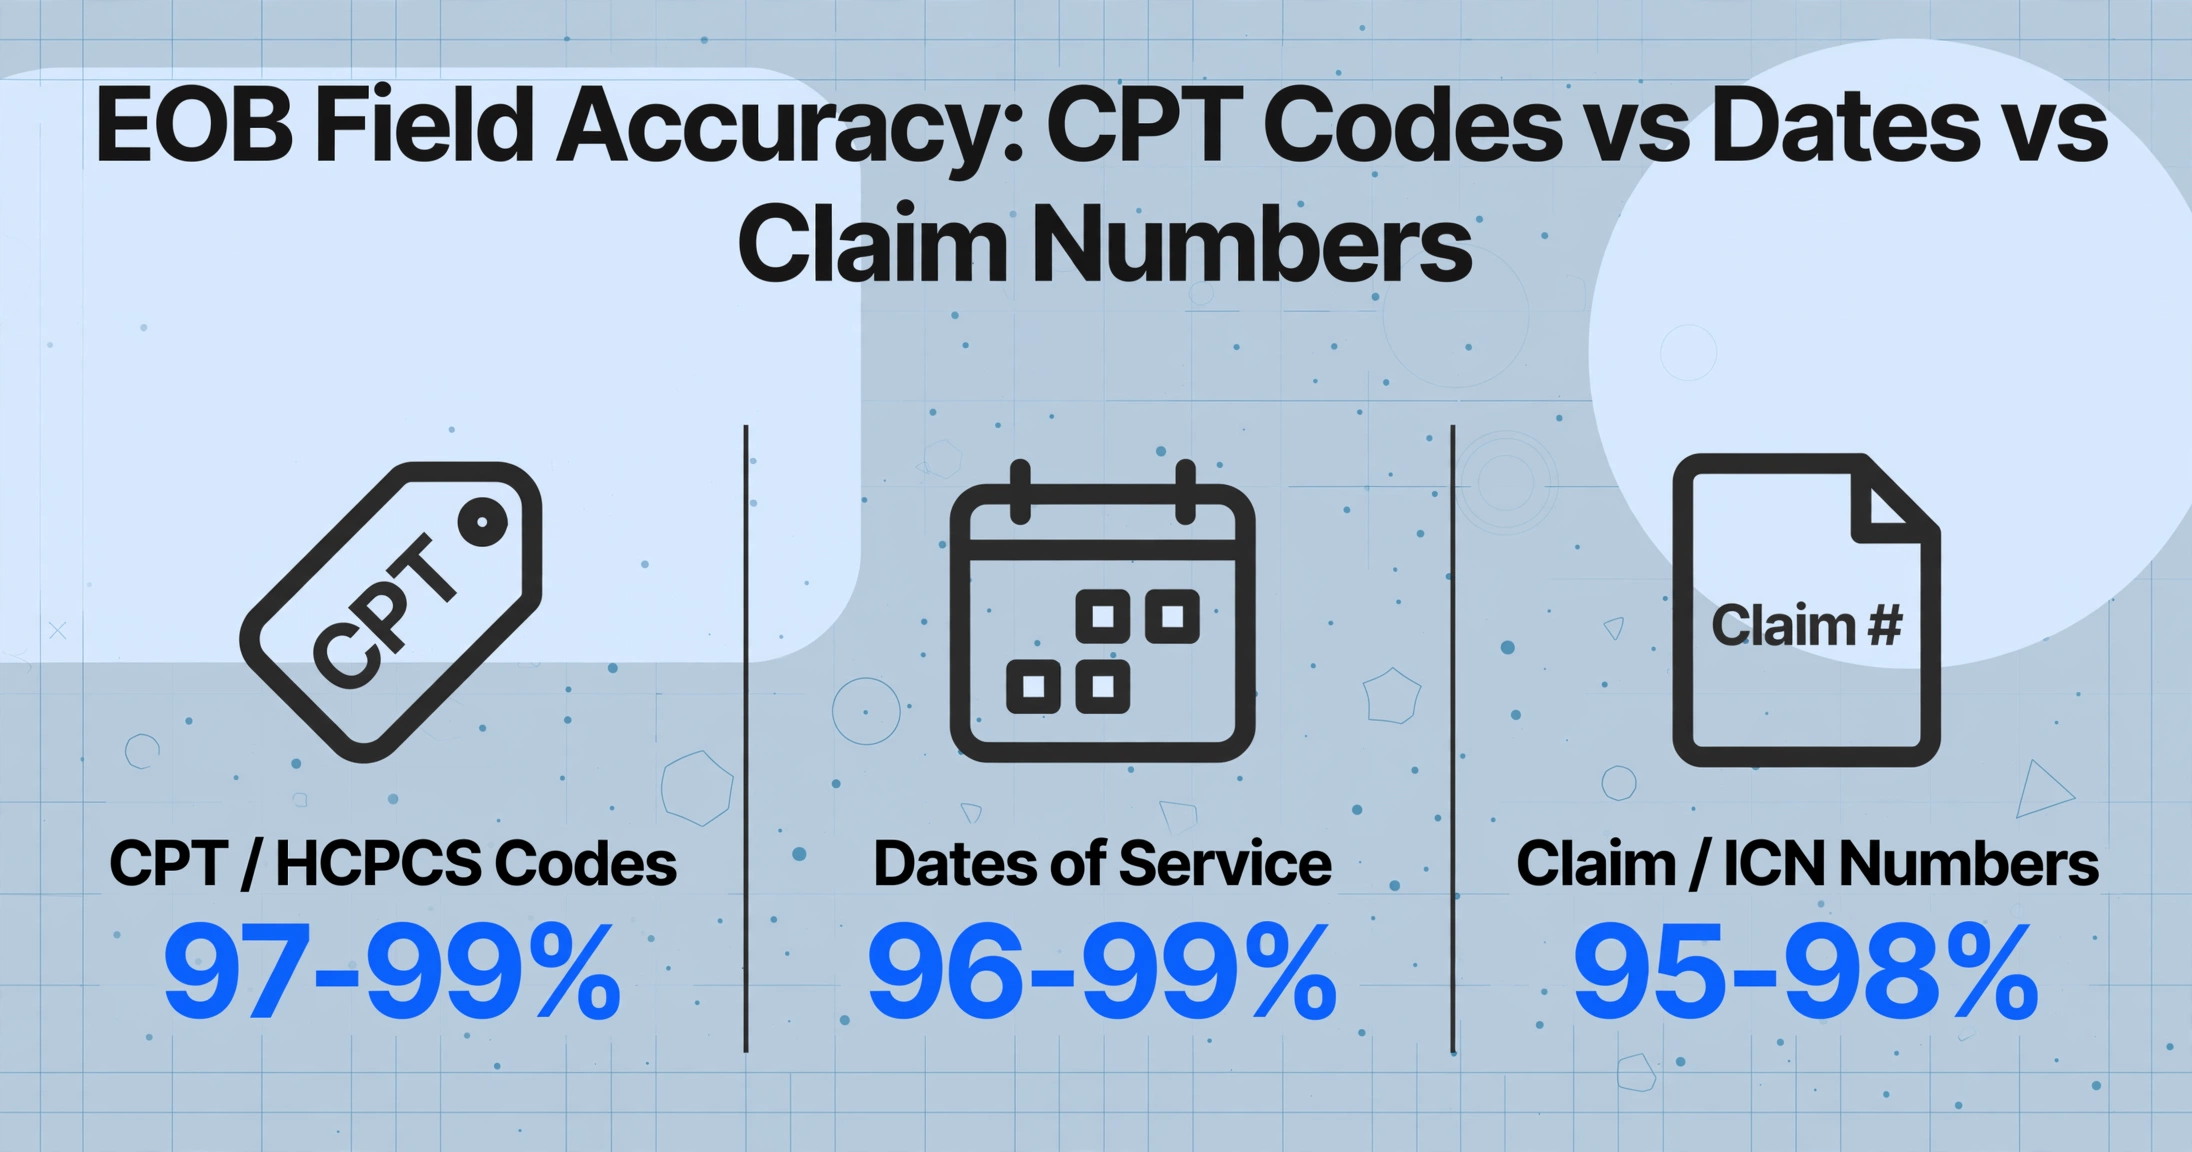
| CPT-/HCPCS-Prozedurcodes | 97-99 % | Hochstandardisiertes Format — 5-stellig alphanumerisch mit optionalem 2-stelligem Modifikator. KI, die auf medizinischen Dokumenten trainiert wurde, erkennt das Muster auch in dichten Tabellen. |
| Leistungsdaten | 96-99 % | Eindeutiges Format (MM/TT/JJJJ oder MM/TT/JJ). Die Position innerhalb der EOB-Positionsstruktur ist relativ zu den Prozedurcodes konsistent. |
| Anspruchs-/ICN-Nummern | 95-98 % | Meist an prominenter Kopfposition mit klarer Beschriftung. Die Beschriftung variiert jedoch — „Claim #", „ICN", „Control Number" — was Template-OCR überfordert und semantisches Verständnis erfordert. |
| Geldbeträge (Rechnungs-/Erstattungs-/Zahlbetrag) | 94-98 % | Semantische Extraktion identifiziert Beträge über den Kontext (Spalte „Erstattet" vs. Spalte „Berechnet"). Die Genauigkeit sinkt, wenn Geldspalten ohne sichtbare Zellränder eng gepackt sind. |
| Eigenanteil des Patienten | 88-95 % | Jeder Kostenträger positioniert und beschriftet ihn anders — „Patient Responsibility", „Amount You Owe", „Member Liability", „Patient Due". Das Konzept ist dasselbe; Beschriftung und Position sind es nicht. |
| Aufteilung Selbstbehalt / Zuzahlung / Kostenbeteiligung | 85-93 % | Die schwierigsten Finanzfelder. Manche EOBs zeigen den Selbstbehalt als Position; andere betten ihn in eine Übersichtsbox ein; wieder andere berechnen ihn implizit im Zahlbetrag. Erfordert Querverweise, die nicht alle EOB-Formate bieten. |
| Ablehnungs-/Anpassungsbegründungscodes | 82-92 % | Oft in separaten Anmerkungsabschnitten am Ende der EOB, verknüpft mit Positionen über Referenzcodes, die abgeglichen werden müssen. Der Text ist häufig die kleinste Schrift auf der Seite. |
Für den Kontext, was EOB-Extraktion ist und warum sie für Abrechnungsworkflows wichtig ist, siehe was EOB-Datenextraktion ist und wie sie funktioniert.
Was KI bei EOBs richtig macht – und warum
Die Felder, die KI am zuverlässigsten verarbeitet, haben eines gemeinsam: Sie sind semantisch eindeutig. Ein CPT-Code ist immer ein CPT-Code. Ein Leistungsdatum ist immer ein Datum. Ein zugelassener Betrag ist die Summe, die der Kostenträger zur Erstattung zugesagt hat. Selbst wenn diese Werte bei den über 1.500 bekannten EOB-Formaten an unterschiedlichen Positionen stehen – und das tun sie häufig – findet die KI sie über ihre Bedeutung, nicht über eine vorkonfigurierte Koordinate. Dies ist der grundlegende Unterschied zwischen template-basierter OCR und Vision-KI-Extraktion.
Vier Feldkategorien schneiden durchweg gut ab:
CPT- und HCPCS-Prozedurcodes
Dies sind die am stärksten standardisierten Daten über alle EOB-Formate hinweg. Ein CPT-Code hat immer 5 Ziffern, steht fast immer in der Nähe seiner Leistungsbeschreibung und ist fast immer mit einem Modifikator gepaart. Das alphanumerische Muster ist so charakteristisch, dass Vision-Modelle, die auf medizinischen Dokumenten trainiert wurden, es mit nahezu perfekter Zuverlässigkeit identifizieren und extrahieren – selbst wenn die umgebenden Tabellenzellen überfüllt sind.
Spaltenweise Dollar-Beträge
EOBs präsentieren abgerechnete, zugelassene, gezahlte und Anpassungsbeträge fast immer in einer mehrspaltigen Tabelle. KI-Vision-Modelle parsen diese Tabellen, indem sie die Spaltenüberschrift lesen, um zu verstehen, welche Spalte „abgerechnet“ und welche „gezahlt“ ist, und extrahieren dann den Dollar-Wert jeder Zeile entsprechend. Dies funktioniert gut, wenn die Spalten klare Überschriften haben. Schwieriger wird es – und die Genauigkeit sinkt – wenn Überschriften gedreht, abgekürzt oder ganz fehlen, was bei per Post versandten EOBs kleinerer Versicherer häufig vorkommt.
Leistungsdaten und Abrechnungsdaten
Daten folgen einer begrenzten Reihe von Formatkonventionen und erscheinen fast immer neben dem Prozedurcode oder der Leistungsbeschreibung in der Positionstabelle. Die Kombination aus Formatkonsistenz und Positionskontext macht die Datumsextraktion zu einem der zuverlässigsten EOB-Felder.
Name des Leistungserbringers und NPI
Die Informationen zum abrechnenden Leistungserbringer erscheinen in der Regel in einem konsistenten Kopfbereich. Name des Leistungserbringers, National Provider Identifier (NPI) und Steuer-ID werden in einem strukturierten Abschnitt nahe dem oberen Rand der EOB mit klaren Beschriftungen gedruckt. Für Gesundheitsorganisationen, die EOBs mit ihrem Leistungserbringerverzeichnis abgleichen müssen, wird diese Feldgruppe mit einer konstanten Genauigkeit von über 95 % extrahiert.
Wo KI bei EOBs weiterhin scheitert
Die ehrliche Antwort ist, dass drei strukturelle Merkmale von EOBs wiederkehrende Genauigkeitsprobleme verursachen, die kein aktuelles KI-System vollständig beseitigt.
Winzige Schriftgrößen in dichten Spaltentabellen
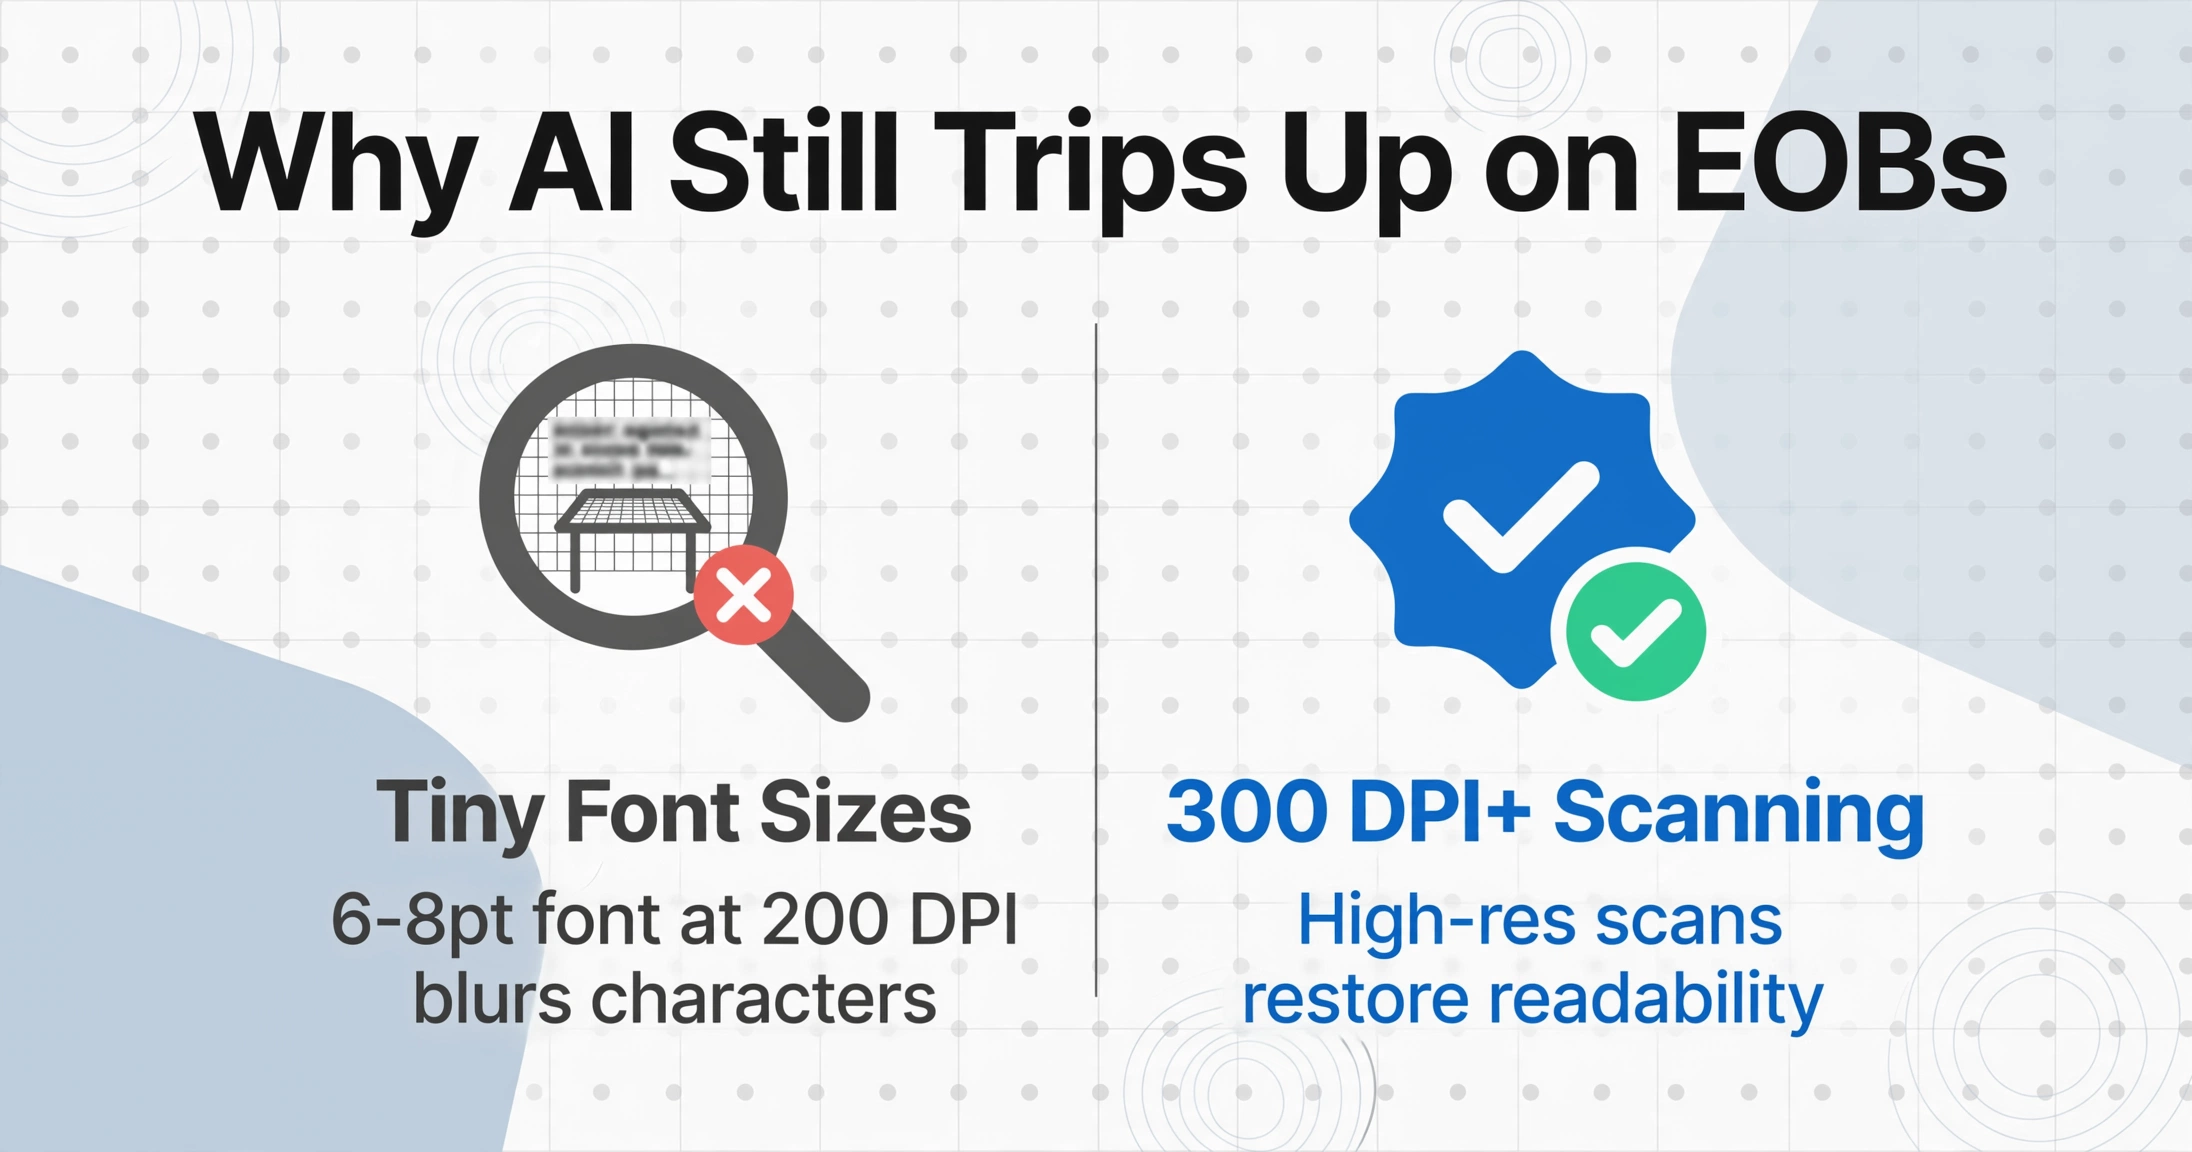
Viele per Post versandte EOBs – insbesondere von staatlichen Kostenträgern und regionalen Versicherern – drucken die Positionstabelle in einer Schriftgröße von 6-8 Punkt. Das ist physisch so klein, dass Zeichengrenzen selbst bei hochauflösenden Scans verschwimmen. Wenn sich eine „6“ und eine „8“ bei 200 DPI nur um ein einziges Pixel unterscheiden, liest die KI den umgebenden Kontext, um zu erraten, welche Ziffer es ist – und der Kontext ist nicht immer entscheidend. Die Lösung ist einfach – scannen Sie mit 300 DPI oder höher –, aber dies ist eine physische Einschränkung, die allein durch verbesserte KI-Modelle nicht gelöst werden kann.
Dies ist eine grundlegend andere Herausforderung als das Problem der Formatvariabilität, das die meisten Anbieter diskutieren. Formatvariabilität ist ein technisches Problem: Trainieren Sie mit mehr Formaten. Schriftgröße ist ein physikalisches Problem: Bei einer zu geringen Auflösung sind die Informationen im Bild für kein Modell vorhanden. Dies ist die am wenigsten diskutierte Einschränkung in der Kategorie der EOB-Extraktion.
Ablehnungsgründe-Codes in separaten Bemerkungsabschnitten
Ablehnungscodes (wie CO-4, PR-16, OA-23 aus den HIPAA-Standard-Codes für Leistungsanpassungsgründe) werden in der Regel in einem separaten Bemerkungsabschnitt unten oder auf der Rückseite der EOB gedruckt und über Referenzpositionsnummern mit den Positionen verknüpft. Das Extrahieren des Codes selbst ist einfach. Die Zuordnung zur korrekten Leistungsposition – und die Interpretation der Bedeutung zusammen mit dem Anpassungsbetrag – erfordert eine Querverbindung zwischen zwei separaten Tabellenstrukturen auf derselben Seite. KI kann dies leisten, aber die Genauigkeit sinkt, da die visuelle Verbindung zwischen der Position und der zugehörigen Ablehnungsbemerkung oft eine implizite Spaltenausrichtung und keine explizite Querverweisung ist.
Inkonsistente Bezeichnungen für den Patientenzahlungsanteil
Ein Konzept, zwölf Bezeichnungen. BCBS of Texas nennt es „Patient Responsibility.“ Aetna verwendet „Member Liability.“ UnitedHealthcare druckt „Amount You Owe.“ Cigna schreibt „Patient Due.“ Medicare-Advantage-Pläne verwenden häufig „Patient Pay Amount.“ Jede dieser Bezeichnungen bedeutet für Abstimmungszwecke dasselbe – den Betrag, den der Patient an den Leistungserbringer zahlen muss –, aber ein templatebasiertes OCR-System würde für jede Bezeichnungsvariante eine separate Konfiguration erfordern. Ein semantisches KI-System bewältigt diese Variation, indem es das Konzept versteht, aber die Genauigkeit ist nicht so hoch wie bei Feldern mit festem Format, da das Modell die Absicht aus dem Kontext ableiten muss, anstatt ein bekanntes Muster abzugleichen. Hier macht Benutzerdefinierte Spaltenextraktion – die Definition Ihrer Spalte als „Patient Responsibility“ und das KI-System findet den semantisch passenden Wert, unabhängig davon, wie der Kostenträger ihn nennt – den Unterschied zwischen einem System, das ständige Konfiguration erfordert, und einem, das sich anpasst.
Für einen tieferen Einblick, wie sich EOBs zwischen Kostenträgern unterscheiden und warum dies Extraktionssysteme herausfordert, lesen Sie unseren vollständigen Leitfaden zur EOB-Datenextraktion.
So erzielen Sie die beste Extraktionsgenauigkeit aus Ihren EOBs
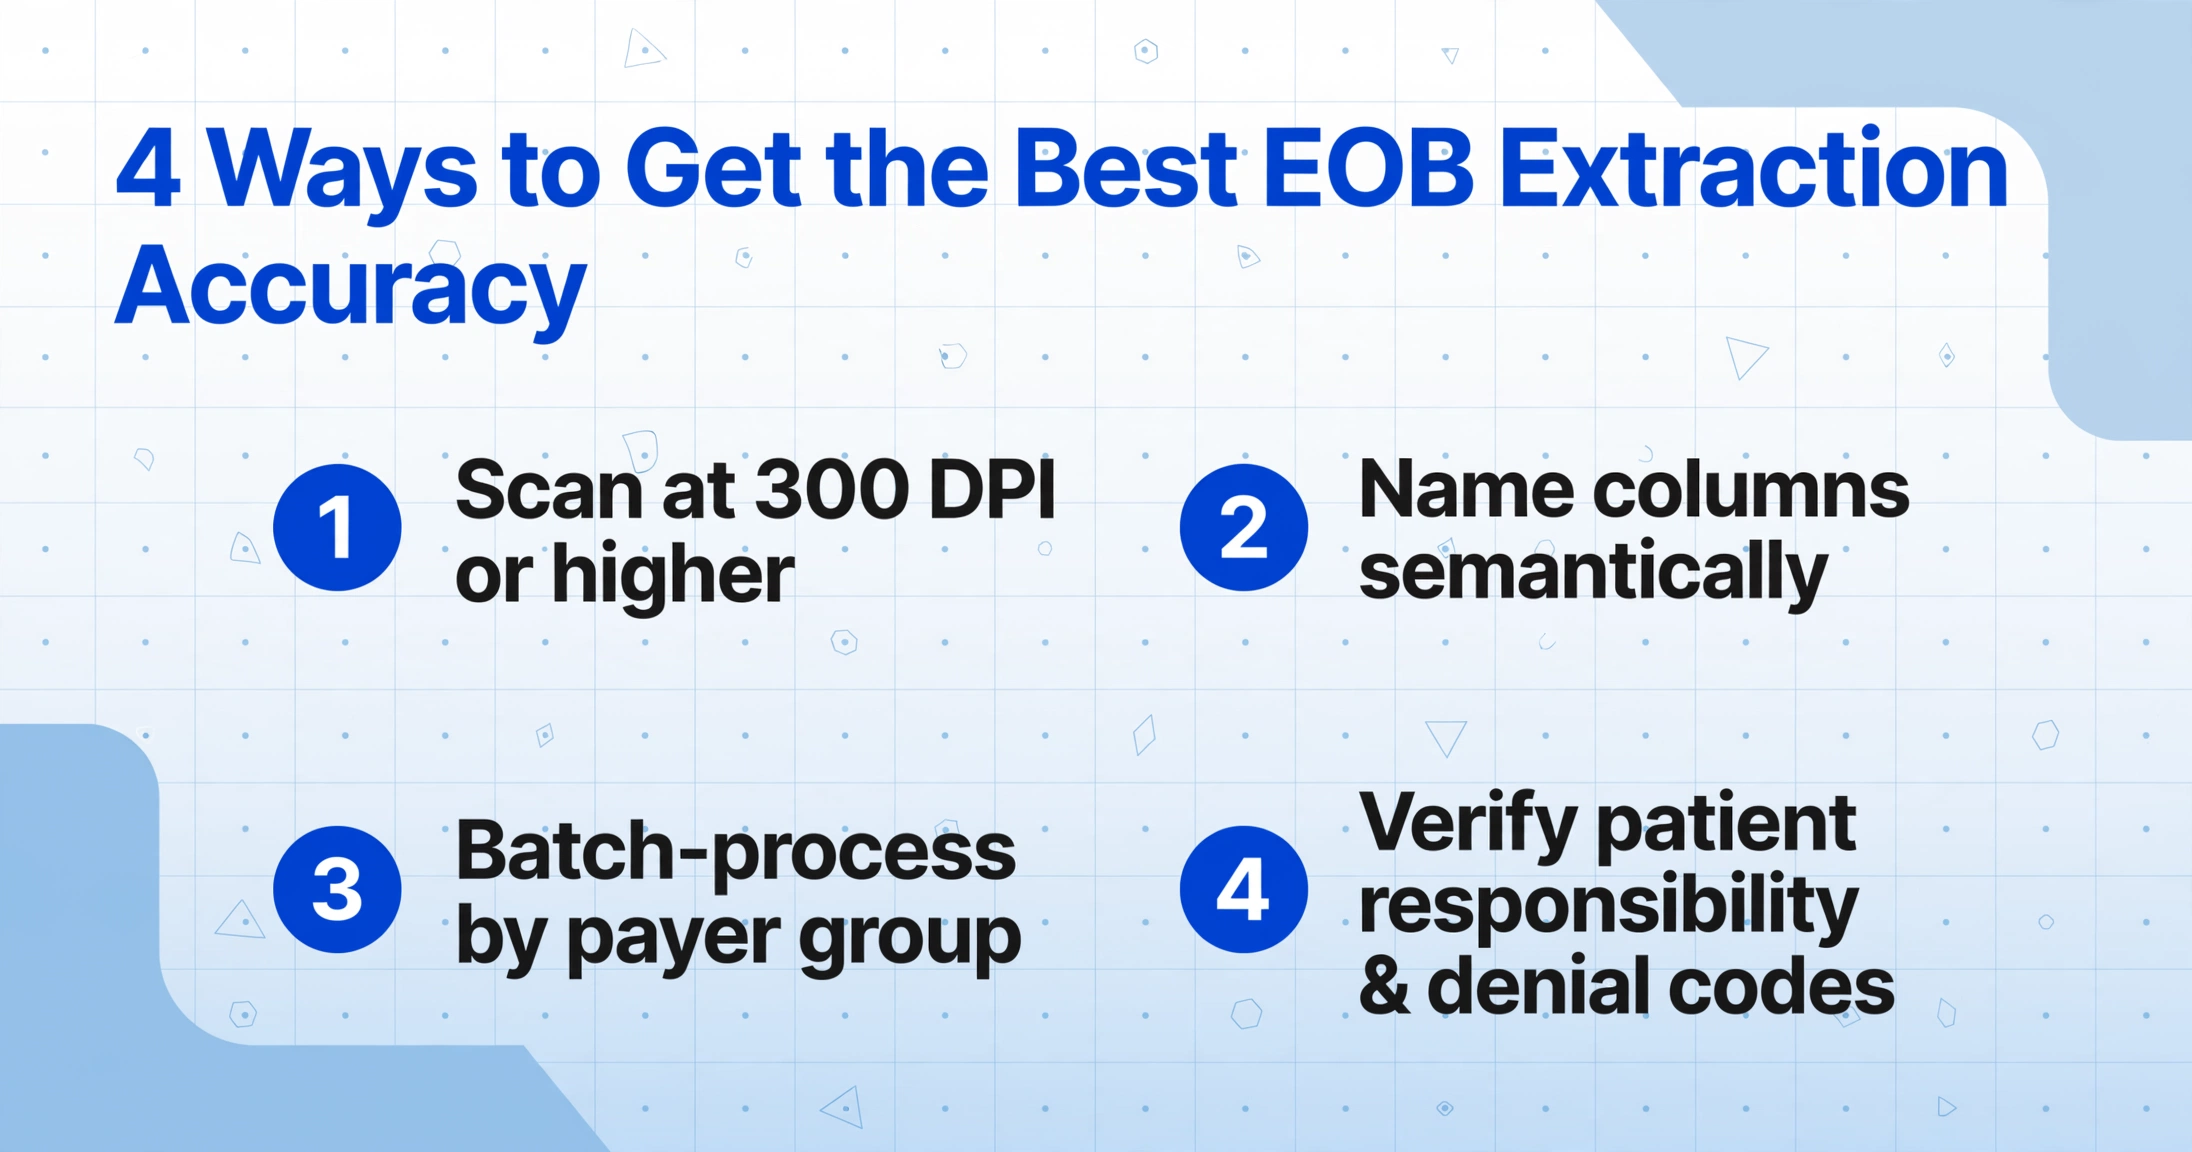
Die Genauigkeit, die Sie tatsächlich mit einem KI-EOB-Extraktionstool erzielen, hängt weniger vom Modell ab als vielmehr davon, wie Sie die Eingabe vorbereiten und die Ausgabe definieren. Diese vier Anpassungen machen den größten Unterschied:
Die von vielen Zahlern verwendete Schriftgröße von 6-8 Punkt liegt an der Grenze dessen, was visuelle KI bei Standard-Faxauflösung (200 DPI) zuverlässig lesen kann. Das Scannen mit 300 DPI oder das Anfordern digitaler PDFs anstelle von Papierkopien beseitigt die häufigste Genauigkeitsgrenze, ohne dass Tool-Konfigurationen geändert werden müssen.
Eine Spalte mit dem Namen „CPT-Code“ oder „Zulässiger Betrag“ gibt der KI ein präzises Ziel. Eine Spalte mit dem Namen „Code“ oder „Betrag 1“ lässt Raum für Mehrdeutigkeit. Je spezifischer Ihr Spaltenname ist, desto besser kann die KI zwischen den vier oder fünf verschiedenen Dollar-Beträgen auf einer einzelnen EOB-Seite unterscheiden.
Eine einzelne BCBS of Texas EOB und eine einzelne Aetna EOB mögen unterschiedlich aussehen, aber eine Charge von 20 BCBS-EOBs folgt alle demselben Layout. Die Verarbeitung von EOBs in zahlerspezifischen Chargen – auch wenn dies das Hochladen von zwei separaten Chargen bedeutet – gibt der KI die visuelle Konsistenz, die sie für die höchste Feldgenauigkeit benötigt.
Diese beiden Feldgruppen weisen die größte Genauigkeitsschwankung auf, da jeder Zahler sie anders formatiert. Bauen Sie einen Verifizierungsschritt in Ihren Workflow ein: Lassen Sie einen Abrechnungsspezialisten die Beträge der Patientenverantwortung und die Zuordnungen der Ablehnungsgründe stichprobenartig mit der ursprünglichen EOB abgleichen, um die 5-15 % der Fälle zu erfassen, die korrigiert werden müssen, bevor sie Ihre Patientenabrechnungen oder Forderungen erreichen.
Was das für Ihren EOB-Workflow bedeutet
Die praktische Erkenntnis: KI-gestützte EOB-Extraktion ersetzt die menschliche Prüfung nicht, verändert aber deren Form. Statt dass ein Abrechnungsspezialist 15–20 Minuten pro EOB manuell jedes Feld ausfüllt – bei einer Fehlerquote von 8–12 %, die abgelehnte Ansprüche mit Nachbearbeitungskosten von 25–50 $ pro Stück verursacht – extrahiert die KI die zuverlässigen Felder automatisch, und der Spezialist konzentriert sich bei der Überprüfung auf die 2–3 Feldkategorien mit der höchsten Variabilität zwischen den Kostenträgern.
Der Workflow verschiebt sich von der Transkription zur Ausnahmebehandlung. Die Routinefelder – CPT-Codes, Daten, Anspruchsnummern, Anbieterinformationen, Standardbeträge – werden mit 95–99 % Genauigkeit erfasst und benötigen nur Stichproben zur Qualitätssicherung. Die Aufmerksamkeit gilt den Eigenanteilen der Patienten, den Zuordnungen von Ablehnungsgründen und den Aufteilungen von Selbstbehalt/Zuzahlung/Kostenbeteiligung, wo eine Genauigkeitslücke von 5–15 % bedeutet, dass menschliches Urteilsvermögen weiterhin das richtige Werkzeug ist.
Für einen umfassenderen Überblick, wie automatisierte Extraktion in Workflows für medizinische Dokumente, einschließlich EOBs, passt, siehe wie OCR medizinische Unterlagen, EOBs und Abrechnungsformulare verarbeitet.
Häufig gestellte Fragen
Wie genau ist die KI bei der EOB-Datenextraktion?
Moderne KI-EOB-Extraktion erreicht 95-99% Feldgenauigkeit bei strukturierten Feldern wie CPT-Codes, Leistungsdaten, Anspruchsnummern und Standardbeträgen (berechnet, zulässig, gezahlt). Eigenanteil und Ablehnungsgrundcodes liegen typischerweise niedriger, bei 85-95%. Die Gesamtfehlerrate sinkt von 8-12% bei manueller Verarbeitung auf unter 2% mit KI – aber diese „unter 2%" umfassen eine Mischung von Feldern mit sehr unterschiedlichen Zuverlässigkeitsprofilen, daher bleibt die Überprüfung der variablen Felder wichtig.
Kann KI EOBs verschiedener Versicherungen in einem Batch verarbeiten?
Ja – hier hat visuelle KI einen klaren Vorteil gegenüber templatebasierter OCR. Ein semantisches Extraktionssystem liest Feldwerte nach ihrer Bedeutung, nicht nach ihrer Position auf der Seite. So können eine BCBS-EOB und eine Aetna-EOB mit unterschiedlichen Layouts im selben Batch verarbeitet werden. Die höchste Genauigkeit wird jedoch erreicht, wenn Sie EOBs desselben Zahlers bündeln, da die Layoutkonsistenz innerhalb einer Zahlergruppe der KI zusätzlichen visuellen Kontext zur korrekten Feldzuordnung bietet.
Erfordert die EOB-Extraktionsgenauigkeit ein Training der KI auf meine spezifischen Zahler?
Nein – und das ist ein entscheidender Unterschied zu Plattformen wie Nanonets oder Rossum, die beschriftete Trainingsbeispiele benötigen. KI-Tools mit benutzerdefinierter Spaltenextraktion benötigen kein Training: Sie geben die gewünschten Spaltennamen ein (z. B. „CPT-Code", „Zulässiger Betrag", „Eigenanteil") und die KI findet die passenden Werte in jedem Zahlerformat, indem sie die Dokumentbedeutung versteht. Es funktioniert beim ersten Hochladen, nicht erst nach einem Trainingszyklus.
Warum ist der Eigenanteil schwieriger zu extrahieren als andere EOB-Felder?
Weil es kein einheitliches Label dafür bei allen Zahlern gibt. Eine EOB druckt „Eigenanteil" am Ende einer Übersichtstabelle. Eine andere nennt es „Mitglied schuldet" in einem Textabsatz. Eine dritte berechnet es implizit als Differenz zwischen berechnetem und gezahltem Betrag, ohne ein beschriftetes Feld zu drucken. Ein semantisches KI-System findet es durch Kontextverständnis statt Labelabgleich, was meistens, aber nicht immer funktioniert. Diese Feldgruppe ist die, die sich am ehesten manuell zu überprüfen lohnt.
Extrahiert KI Ablehnungsgrund-Codes aus EOBs?
Sie extrahiert die Codes selbst zuverlässig – standardisierte HIPAA-Ablehnungsgrund-Codes wie CO-4, PR-16 oder OA-23 folgen einem festen Format. Schwieriger ist die korrekte Zuordnung jedes Ablehnungscodes zur richtigen Leistungsposition, da der Bemerkungsabschnitt mit den Ablehnungen auf der EOB-Seite oft räumlich von der Tabellenzeile getrennt ist. Manche EOBs verwenden Referenzzeilennummern zur Verknüpfung; andere verlassen sich auf die Ausrichtung der Zeilenreihenfolge. KI verarbeitet die expliziten Referenznummern gut, aber die implizite Zuordnung über die Zeilenreihenfolge kann zu Fehlern führen.
Testen Sie einen Stapel EOBs von Ihren tatsächlichen Kostenträgern. Sehen Sie, welche Felder mit 99 % Genauigkeit durchkommen und welche einen zweiten Blick benötigen — bevor Sie Ihren Workflow auf Annahmen umgestalten, die für Ihre spezifische Kostenträger-Mischung möglicherweise nicht zutreffen.
Auf Ihren EOBs testen