AIはEOBデータを正確に抽出できる?
はい — フィールド別精度の詳細解説
はい — 最新のAIビジョンモデルは、CPTコード、承認額、請求識別子などの重要フィールドにおいて、EOBデータを95〜99%のフィールド別精度で抽出し、業界標準の手作業エラー率を8〜12%から2%未満に削減します。しかし、この代表的な数字の背後には、より有用な事実が隠れています。一部のEOBフィールドは初期状態でほぼ完璧に抽出できる一方、患者自己負担額、拒否理由コード、控除額の割り当てなどのフィールドは、各保険者が同じようなラベルでも定義や配置が異なるため、フィールド固有の検証が必要です。
重要ポイント
- EOB抽出の95〜99%精度は解決済みの問題のように聞こえますが、この代表的な数字は、同じ文書内でCPTコードの99%と拒否理由コードの82%という17ポイントの差を隠しています。
- EOB抽出における最大の精度の壁はAIモデルではなく、政府系保険者が明細表を印刷する際の6ポイントフォントです。200 DPIでは6と8が1ピクセルしか違わず、情報自体が画像上に物理的に存在しないため、どのモデルも読み取ることができません。
- 保険者ごとに個別のテンプレートは不要です — 患者自己負担額として列を一度定義すれば、BCBSがMember Liabilityと呼び、ユナイテッドヘルスケアがAmount You Oweと印刷し、シグナがPatient Dueと記載しても、AIが値を自動的に見つけ出します。
実際の精度はどの程度か — 数字で見る
EOB抽出の全体的な精度は、医療請求の専門家がテスト前に予想するよりもはるかに高い水準にあります。最新のAI搭載抽出システムの導入データによると、請求額、承認額、保険支払額、自己負担額、免責額といった構造化された財務フィールドのフィールドレベル精度は、文書が適切な品質でスキャンされ、列名が意味的に定義されている場合、一貫して95%〜99%の範囲に収まります。同じシステムは、手動によるEOBデータ入力で一般的な8〜12%のエラー率を、2025〜2026年に複数の医療自動化導入で報告されたベンチマークによると、2%未満にまで削減しています。
ただし、「95〜99%」という範囲は全フィールドの平均値です。この数字は、フィールドタイプ間の有意なばらつきを隠しています。AIが実際にどこで成果を上げ、どこでまだサポートが必要なのかを理解するには、単一の数字ではなく、フィールドカテゴリ別の精度を見る必要があります。
| フィールドカテゴリ | 標準的な精度 | 精度が高い・低い理由 |
|---|---|---|
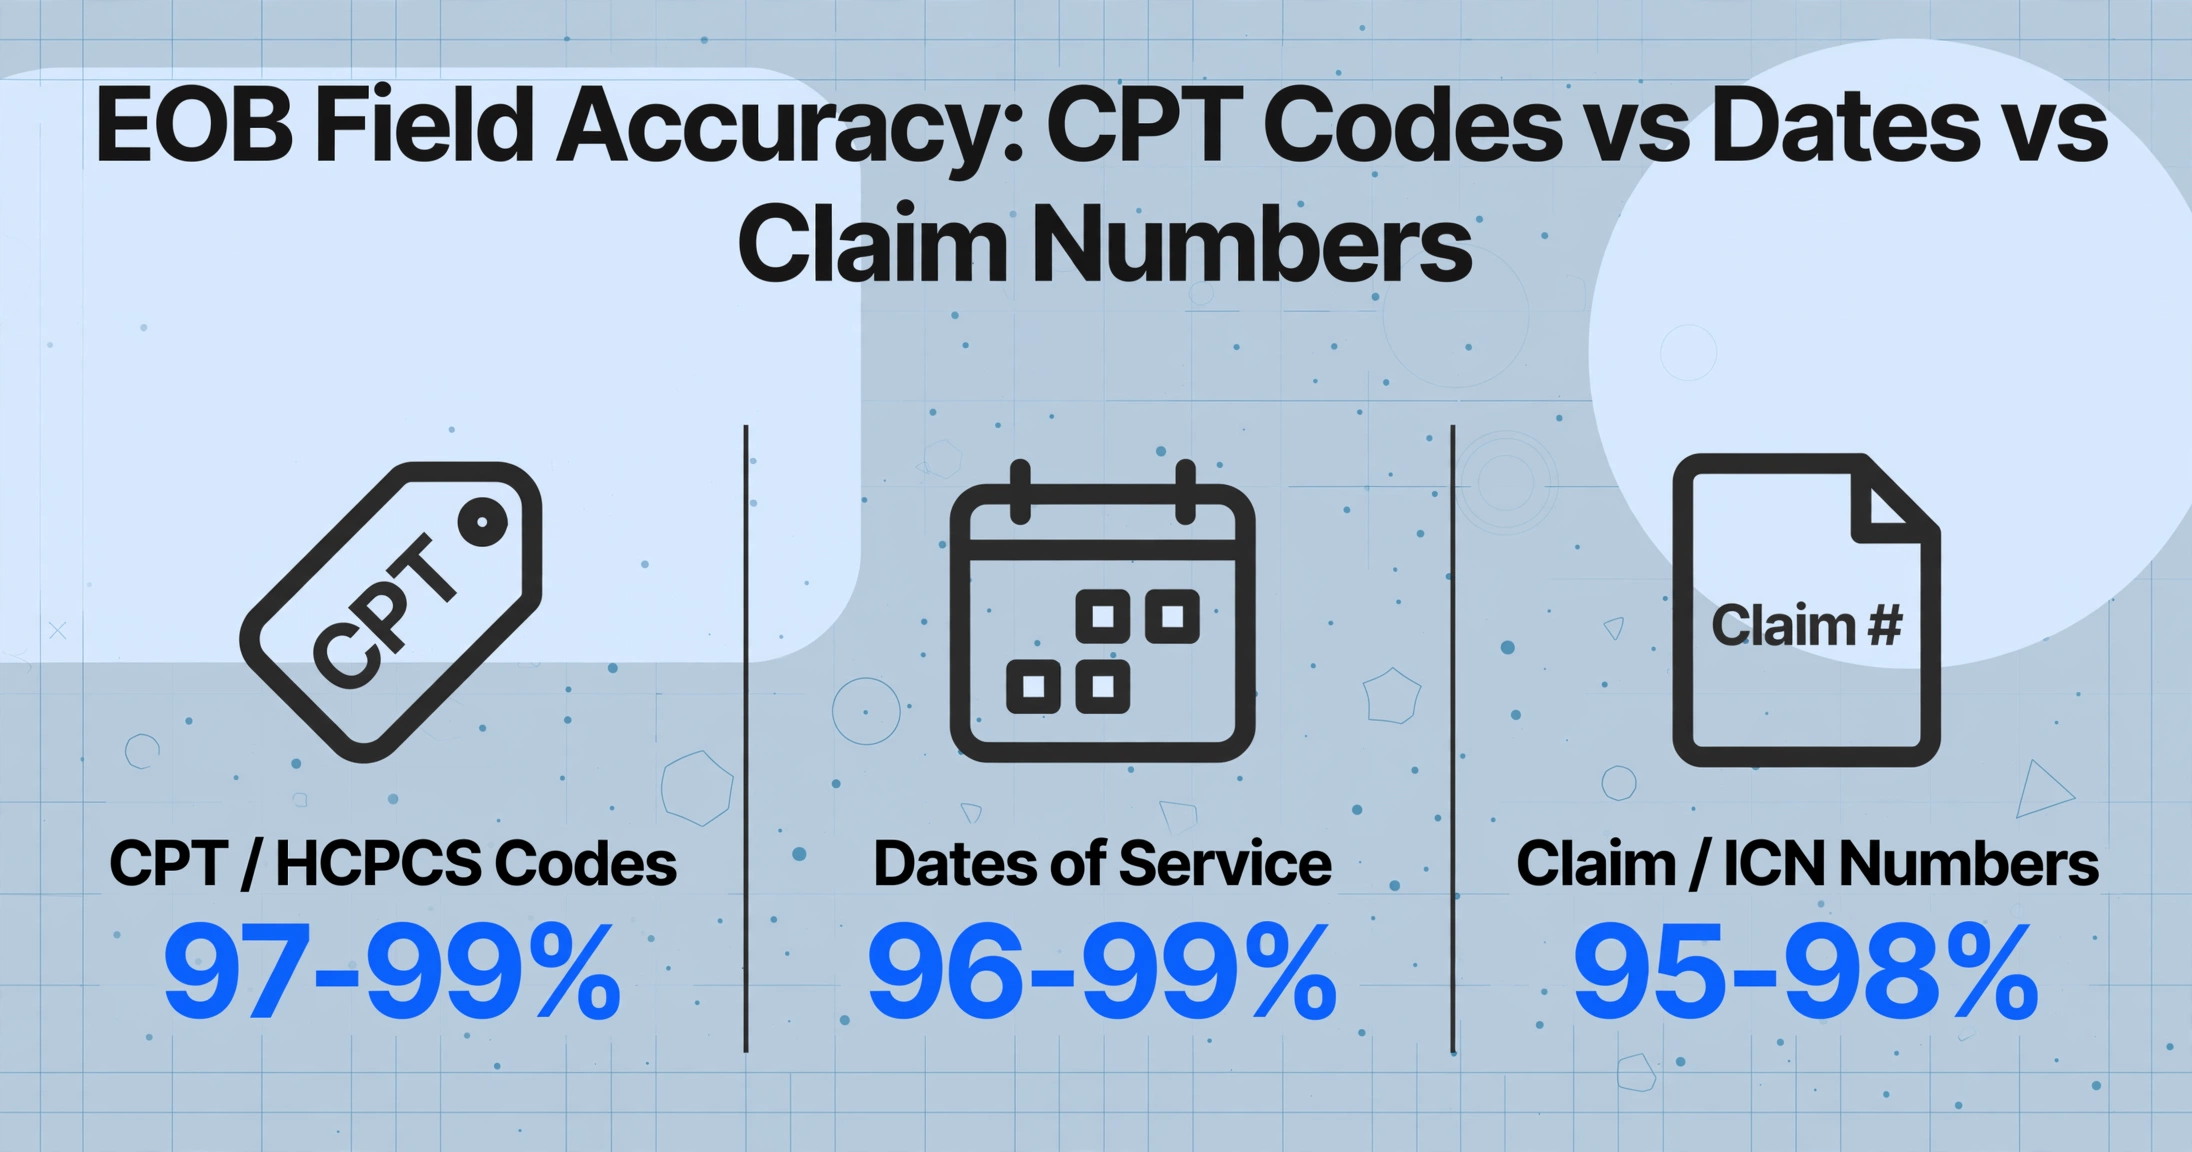
| CPT / HCPCSプロシージャコード | 97〜99% | 5桁の英数字に任意の2桁の修飾子が付く、高度に標準化された形式。医療文書で学習したAIは、密集したテーブルでもこのパターンを認識します。 |
| サービス日 | 96〜99% | 曖昧さのない形式(MM/DD/YYYYまたはMM/DD/YY)。EOBの明細行構造内での位置がプロシージャコードに対して一貫しています。 |
| 請求 / ICN番号 | 95〜98% | 通常、明確なラベル付きでヘッダーの目立つ位置にあります。ただし、ラベルは「Claim #」「ICN」「Control Number」とさまざまで、テンプレートOCRでは対応できず、意味的な理解が必要です。 |
| 金額(請求額/承認額/支払額) | 94〜98% | 意味的抽出により、文脈(「承認額」列と「請求額」列など)から金額を識別します。金額列がセルの境界線なしに密集している場合、精度は低下します。 |
| 患者負担額 | 88〜95% | 支払者ごとに表示位置とラベルが異なります —「Patient Responsibility」「Amount You Owe」「Member Liability」「Patient Due」など。概念は同じでも、ラベルと位置は統一されていません。 |
| 免責額 / 自己負担額 / 共同保険の内訳 | 85〜93% | 最も難しい財務フィールドです。一部のEOBでは免責額を明細項目として表示し、他のEOBではサマリーボックスに埋め込み、さらに他のEOBでは支払額に暗黙的に含めています。すべてのEOB形式が提供するわけではない相互参照が必要です。 |
| 拒否 / 調整理由コード | 82〜92% | 多くの場合、EOB下部の別の備考セクションにあり、照合が必要な参照コードで明細項目にリンクされています。このテキストはページ上で最も小さいフォントであることが多いです。 |
EOB抽出の背景と、それが請求ワークフローにとって重要な理由については、EOBデータ抽出とは何か、その仕組みをご覧ください。
AIがEOBで正確に処理できる項目とその理由
AIが最も確実に処理できる項目には、共通する特徴があります。それは意味的に曖昧さがないことです。CPTコードは常にCPTコードです。サービス日は常に日付です。許容額は、支払い者が払い戻しに同意した金額です。これらの値が1,500以上の既知のEOB形式で異なる位置に移動しても(実際に頻繁に移動します)、AIは事前設定された座標ではなく、その意味によってそれらを見つけます。これがテンプレートベースのOCRとビジョンAI抽出の根本的な違いです。
以下の4つの項目カテゴリは、一貫して良好なパフォーマンスを示します:
CPTおよびHCPCS手技コード
これらは、すべてのEOB形式の中で最も標準化されたデータです。CPTコードは常に5桁で、常にサービス説明の近くに印刷され、ほぼ常に修飾子とペアになっています。英数字パターンが非常に特徴的なため、医療文書でトレーニングされたビジョンモデルは、周囲の表セルが混雑していても、ほぼ完璧な信頼性でそれを識別して抽出します。
列形式のドル金額
EOBはほぼ常に、請求額、許容額、支払額、調整額を複数列のテーブルで表示します。AIビジョンモデルは、列ヘッダーを読み取ってどの列が「請求」でどの列が「支払」かを理解し、それに応じて各行のドル値を抽出することで、これらのテーブルを解析します。これは、列に明確なヘッダーがある場合にうまく機能します。精度が低下するのは、ヘッダーが回転していたり、省略されていたり、完全に欠落している場合で、これは小規模保険会社から紙で送付されるEOBでよく見られます。
サービス日と請求日
日付は限られた形式の規則に従い、ほぼ常に明細テーブルの手技コードまたはサービス説明の隣に表示されます。形式の一貫性と位置的な文脈の組み合わせにより、日付抽出は最も信頼性の高いEOB項目の1つとなっています。
プロバイダー名とNPI
レンダリングプロバイダー情報は通常、一貫したヘッダーブロックに表示されます。プロバイダーの名前、National Provider Identifier(NPI)、およびタックスIDは、明確なラベルとともにEOBの上部近くの構造化されたセクションに印刷されます。EOBをプロバイダー名簿と照合する必要がある医療機関にとって、このフィールドグループは95%以上の一貫した精度で抽出されます。
AIがEOBでまだつまずく点
正直な答えは、EOBの3つの構造的特徴が、現在のAIシステムでは完全には解消されない再発的な精度上の課題を生み出しているということです。
密集した列テーブルにおける極小フォントサイズ
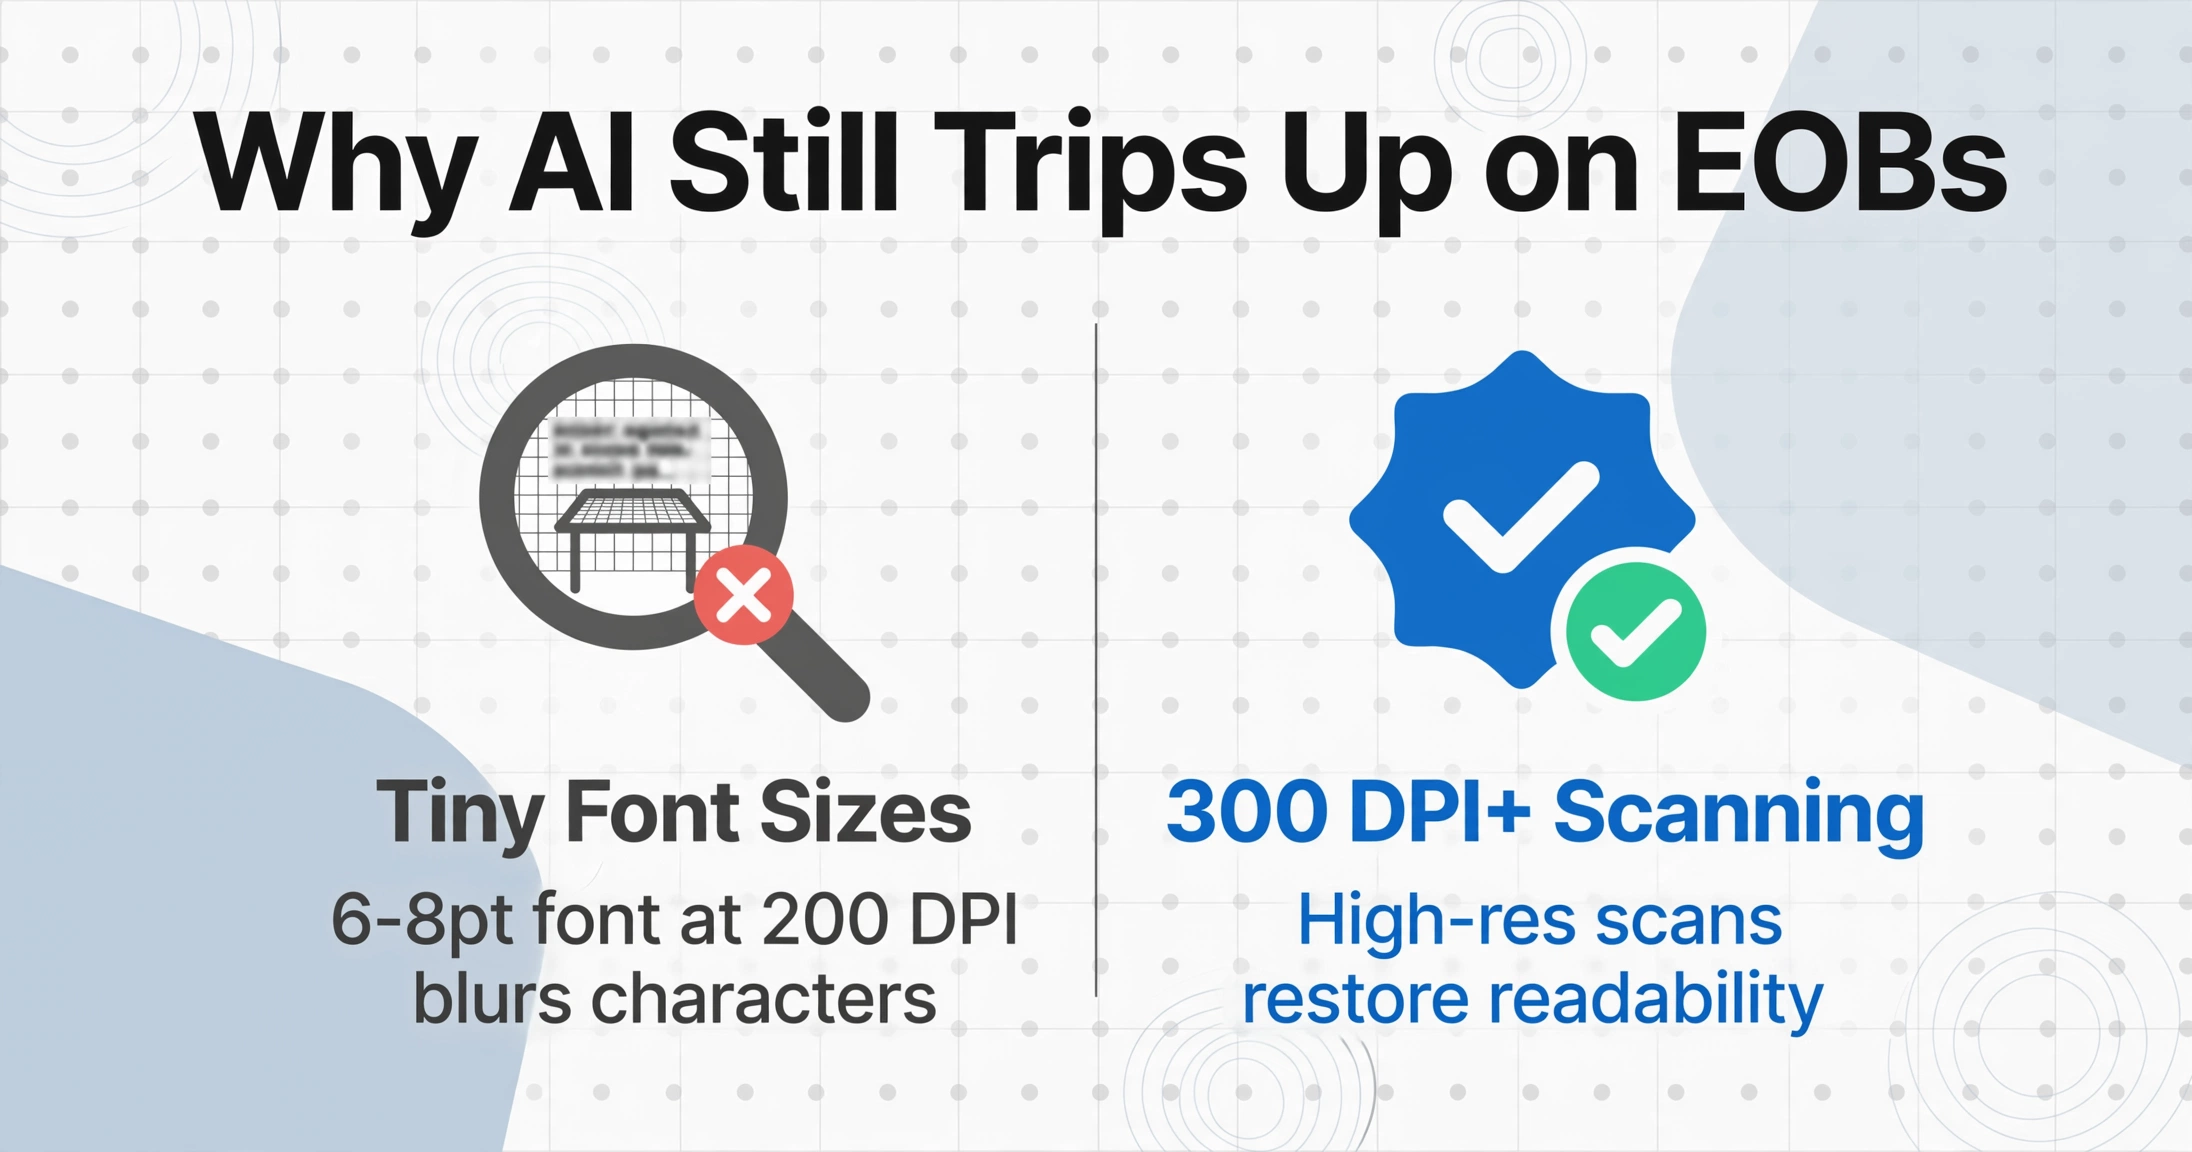
紙で送付されるEOBの多く(特に政府系保険者や地域の保険会社からのもの)は、明細行テーブルを6〜8ポイントのフォントで印刷しています。これは物理的に十分小さいため、高解像度のスキャンでも文字の境界がぼやけます。「6」と「8」が200 DPIで1ピクセルしか違わない場合、AIは周囲の文脈を読んでどちらかを推測しますが、文脈が常に決定的であるとは限りません。解決策は明白です—300 DPI以上でスキャンすることですが、これはAIモデルの改善だけでは解決できない物理的な制約です。
これは、多くのベンダーが議論するフォーマットの多様性の問題とは根本的に異なる課題です。フォーマットの多様性はエンジニアリングの問題です:より多くのフォーマットでトレーニングすればよいのです。フォントサイズは物理の問題です:解像度が十分に低い場合、どのモデルが読んでも情報は画像内に存在しないのです。これはEOB抽出カテゴリーにおいて最も議論されていない限界です。
別紙の備考欄における拒否理由コード
拒否コード(HIPAA標準の請求調整理由コードであるCO-4、PR-16、OA-23など)は通常、EOBの下部または裏面の別の備考欄に印刷され、参照行番号によって明細項目にリンクされています。コード自体の抽出は簡単です。しかし、それを正しいサービス行にマッピングし、調整額と併せてその意味を解釈するには、同じページ上の2つの別々のテーブル構造を相互参照する必要があります。AIはこれを実行できますが、明細項目と対応する拒否備考との視覚的な関連が明示的な相互参照ではなく暗黙の列整合であることが多いため、精度は低下します。
患者負担額ラベルの不統一
1つの概念に対して12種類のラベルが存在します。BCBS of Texasは「Patient Responsibility」、アエトナは「Member Liability」、ユナイテッドヘルスケアは「Amount You Owe」、シグナは「Patient Due」、メディケア・アドバンテージプランでは「Patient Pay Amount」と表記されることがよくあります。これらはすべて、調整目的において同じ意味—患者が医療提供者に支払うべき金額—ですが、テンプレートベースのOCRシステムでは、ラベルのバリエーションごとに個別の設定が必要になります。セマンティックAIシステムは概念を理解することでこのばらつきを処理しますが、既知のパターンに一致させるのではなく、文脈から意図を推測する必要があるため、固定形式のフィールドほど精度は高くありません。ここで重要になるのがカスタム列抽出です。列を「患者負担額」として定義し、支払い者側がどのように呼ぶかに関係なく、AIに意味的に一致する値を見つけさせることで、絶えず設定が必要なシステムと、適応するシステムとの差が生まれます。
支払い者ごとのEOBの違いと、それが抽出システムにどのような課題をもたらすかについて詳しくは、EOBデータ抽出の完全ガイドをご覧ください。
EOBから最高の抽出精度を得る方法
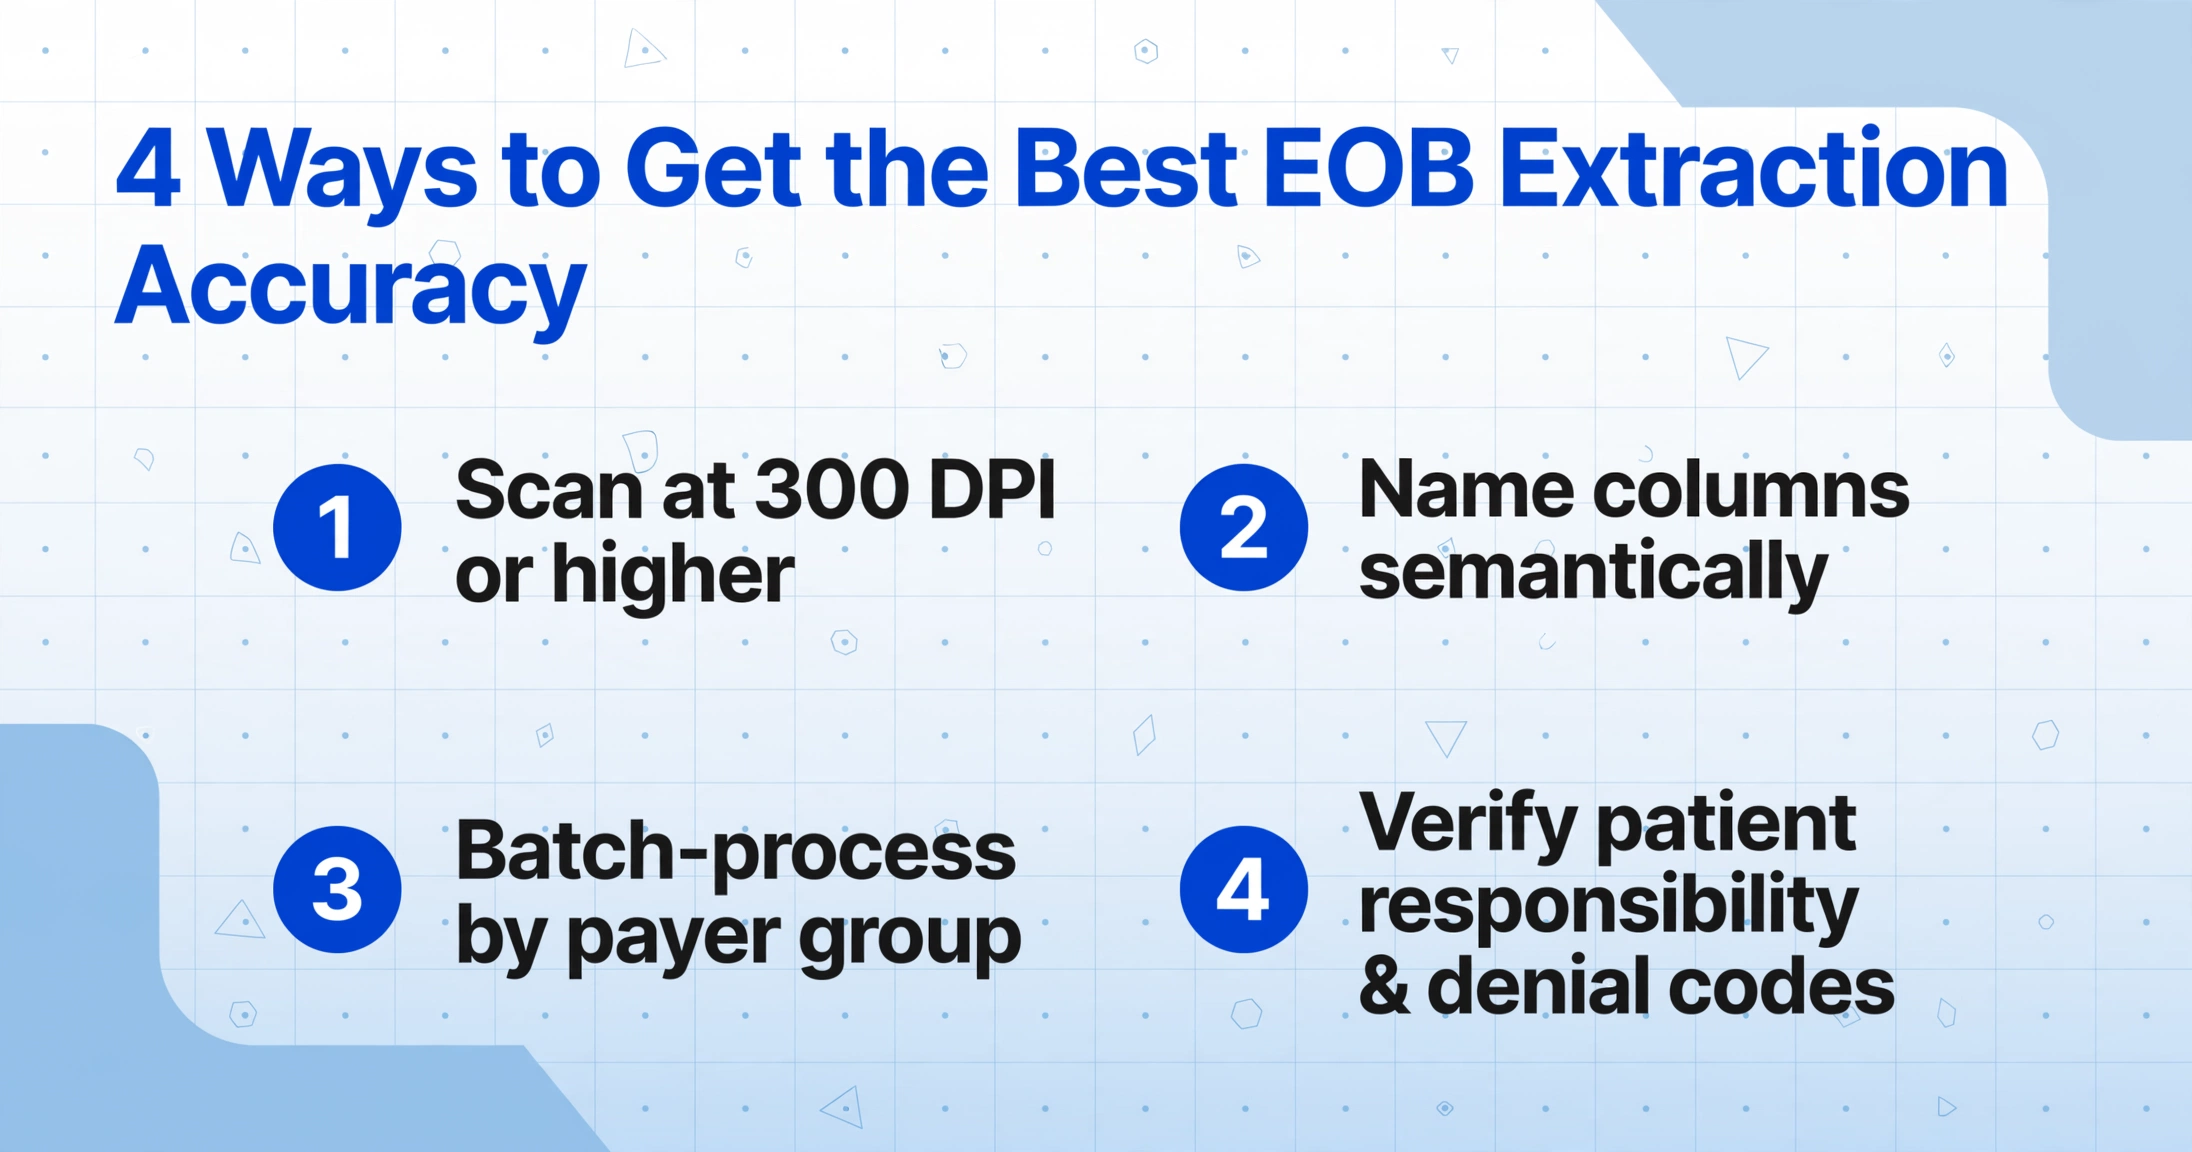
AIによるEOB抽出ツールの実際の精度は、モデル自体よりも、入力の準備方法と出力の定義方法に左右されます。以下の4つの調整が最も大きな違いを生みます。
多くの支払者のEOBで使用されている6〜8ポイントのフォントは、標準的なファックス解像度(200 DPI)では、ビジョンAIが確実に読み取れる限界にあります。300 DPIでスキャンするか、紙のコピーではなくデジタルPDFをリクエストすることで、ツールの設定変更なしに、最も一般的な精度の上限を解消できます。
「CPTコード」や「許容額」という列名は、AIに正確なターゲットを与えます。「コード」や「金額1」のような列名では、曖昧さが残ります。列名が具体的であればあるほど、AIはEOBの1ページに記載された4〜5種類の異なる金額をより正確に区別できます。
テキサス州のBCBSのEOB1枚とアエトナのEOB1枚は見た目が異なるかもしれませんが、BCBSのEOBを20枚まとめて処理する場合、それらはすべて同じレイアウトに従います。EOBを支払者別のバッチで処理することで(たとえ2つの別々のバッチをアップロードすることになっても)、AIは最高のフィールドレベル精度に必要な視覚的な一貫性を得られます。
この2つのフィールドグループは、支払者ごとにフォーマットが異なるため、精度のばらつきが最も大きくなります。ワークフローに検証ステップを組み込みましょう。請求専門スタッフが患者負担額と拒否理由のマッピングを元のEOBと照合してスポットチェックし、修正が必要なケースの5〜15%を、患者明細書や売掛金に反映される前に検出します。
EOBワークフローにおける意味
実用的な結論は次の通りです。AIによるEOB抽出は人間による確認を不要にするものではなく、その内容を変えるものです。請求担当者が1件のEOBにつき15~20分かけて手動で全項目を入力し、8~12%のエラー率で発生する否認請求の再処理に1件あたり25~50ドルかかっていた状況から、AIが信頼できる項目を自動抽出し、担当者は支払者ごとにばらつきの大きい2~3の項目カテゴリに確認作業を集中できるようになります。
ワークフローは「転記」から「例外処理」へと移行します。CPTコード、日付、請求番号、プロバイダ情報、標準的な金額といった定型項目は95~99%の精度で抽出され、品質保証のための抜き取りチェックのみで済みます。注目すべきは、患者負担額、否認理由コードのマッピング、自己負担額・共済額・保険分割の項目です。ここでは5~15%の精度ギャップが存在するため、人間の判断が依然として適切です。
EOBを含む医療文書ワークフローにおける自動抽出の全体像については、医療記録、EOB、請求書フォームにおけるOCRの活用方法をご覧ください。
よくある質問
EOBデータ抽出におけるAIの精度はどのくらいですか?
最新のAIによるEOB抽出は、CPTコード、診療日、請求番号、標準的な金額(請求額、許容額、支払額)などの構造化フィールドで95~99%のフィールドレベル精度を達成します。患者負担額や拒否理由コードは通常85~95%と低くなります。全体のエラー率は手動処理の8~12%からAIでは2%未満に低下しますが、この「2%未満」には信頼性プロファイルが大きく異なるフィールドが混在しているため、変動しやすいフィールドの確認は依然として重要です。
異なる保険会社のEOBを一括で処理できますか?
はい — ここがビジョンAIがテンプレートベースのOCRより明らかに優れている点です。セマンティック抽出システムは、画面上の位置ではなく意味に基づいてフィールド値を読み取るため、レイアウトの異なるBCBSのEOBとAetnaのEOBを同じバッチで処理できます。ただし、同一の支払者からのEOBをまとめてバッチ処理する場合に精度が最も高くなります。これは、支払者グループ内のレイアウトの一貫性により、AIがフィールドを正しくマッピングするための追加の視覚的コンテキストを得られるためです。
EOB抽出精度を上げるには、特定の支払者でAIを訓練する必要がありますか?
いいえ — ここがラベル付き訓練サンプルを必要とするNanonetsやRossumなどのプラットフォームとの重要な違いです。カスタムカラム抽出を使用するAIツールは訓練不要です。「CPTコード」「許容額」「患者負担額」など、必要な列名を入力するだけで、AIがドキュメントのセマンティクスを理解し、あらゆる支払者フォーマットから該当する値を特定します。訓練サイクルを経ずに、最初のアップロードから機能します。
患者負担額の抽出が他のEOBフィールドより難しいのはなぜですか?
支払者間で統一されたラベルがないためです。あるEOBでは集計表の下部に「Patient Responsibility」と印刷されます。別のEOBではテキスト段落内で「Member Owes」と呼びます。さらに別のEOBでは、ラベル付きフィールドを印刷せずに、請求額と支払額の差額として暗黙的に計算します。セマンティックAIシステムはラベルを照合するのではなく、コンテキストを理解することでこのフィールドを見つけますが、それが常に機能するとは限りません。このフィールドグループは、手動で確認する価値が最も高いものです。
AIはEOBから否認理由コードを抽出できますか?
コード自体は確実に抽出できます。CO-4、PR-16、OA-23といった標準的なHIPAA請求調整理由コードは固定フォーマットに従っています。難しいのは、各否認コードを正しいサービス明細にマッピングすることです。否認を記載する備考セクションが、EOBページの明細テーブルと物理的に離れていることが多いからです。一部のEOBでは参照行番号でリンクしていますが、他のEOBでは行の順序の対応に依存しています。AIは明示的な参照番号をうまく処理しますが、暗黙的な行順序のマッピングではエラーが発生する可能性があります。
実際の保険者からのEOBバッチをテストしてください。99%の精度で抽出できるフィールドと、再確認が必要なフィールドを確認できます — 特定の保険者構成に当てはまらない可能性のある前提でワークフローを再設計する前に、実際のデータで検証しましょう。
EOBで試す