¿Puede la IA extraer datos de EOB con precisión?
Sí: un desglose por campo
Sí: los modelos modernos de visión por IA extraen datos de EOB con una precisión por campo del 95-99 % en campos críticos como códigos CPT, montos permitidos e identificadores de reclamaciones, reduciendo la tasa de error manual estándar de la industria del 8-12 % a menos del 2 %. Pero esa cifra general oculta una verdad más útil: algunos campos de EOB son casi perfectos de forma inmediata, mientras que otros —responsabilidad del paciente, códigos de motivo de denegación y asignaciones de deducible— requieren verificación específica por campo, porque cada pagador los define y posiciona de manera distinta, incluso cuando las etiquetas suenan igual.
Conclusiones clave
- Una precisión del 95-99 % en la extracción de EOB parece un problema resuelto, pero la cifra general oculta una brecha de 17 puntos entre los códigos CPT al 99 % y los códigos de motivo de denegación al 82 % en el mismo documento.
- El mayor límite de precisión en la extracción de EOB no es el modelo de IA: es la fuente de 6 puntos con la que los pagadores gubernamentales imprimen sus tablas de partidas, donde un 6 y un 8 se diferencian por un solo píxel a 200 DPI y la información está físicamente ausente de la imagen para que cualquier modelo la lea.
- No necesita una plantilla separada para cada pagador: defina sus columnas como Responsabilidad del Paciente una sola vez y la IA encontrará el valor ya sea que BCBS lo llame Obligación del Afiliado, UnitedHealthcare imprima Monto que Usted Debe o Cigna escriba Deuda del Paciente.
Qué tan bien funciona realmente, en cifras
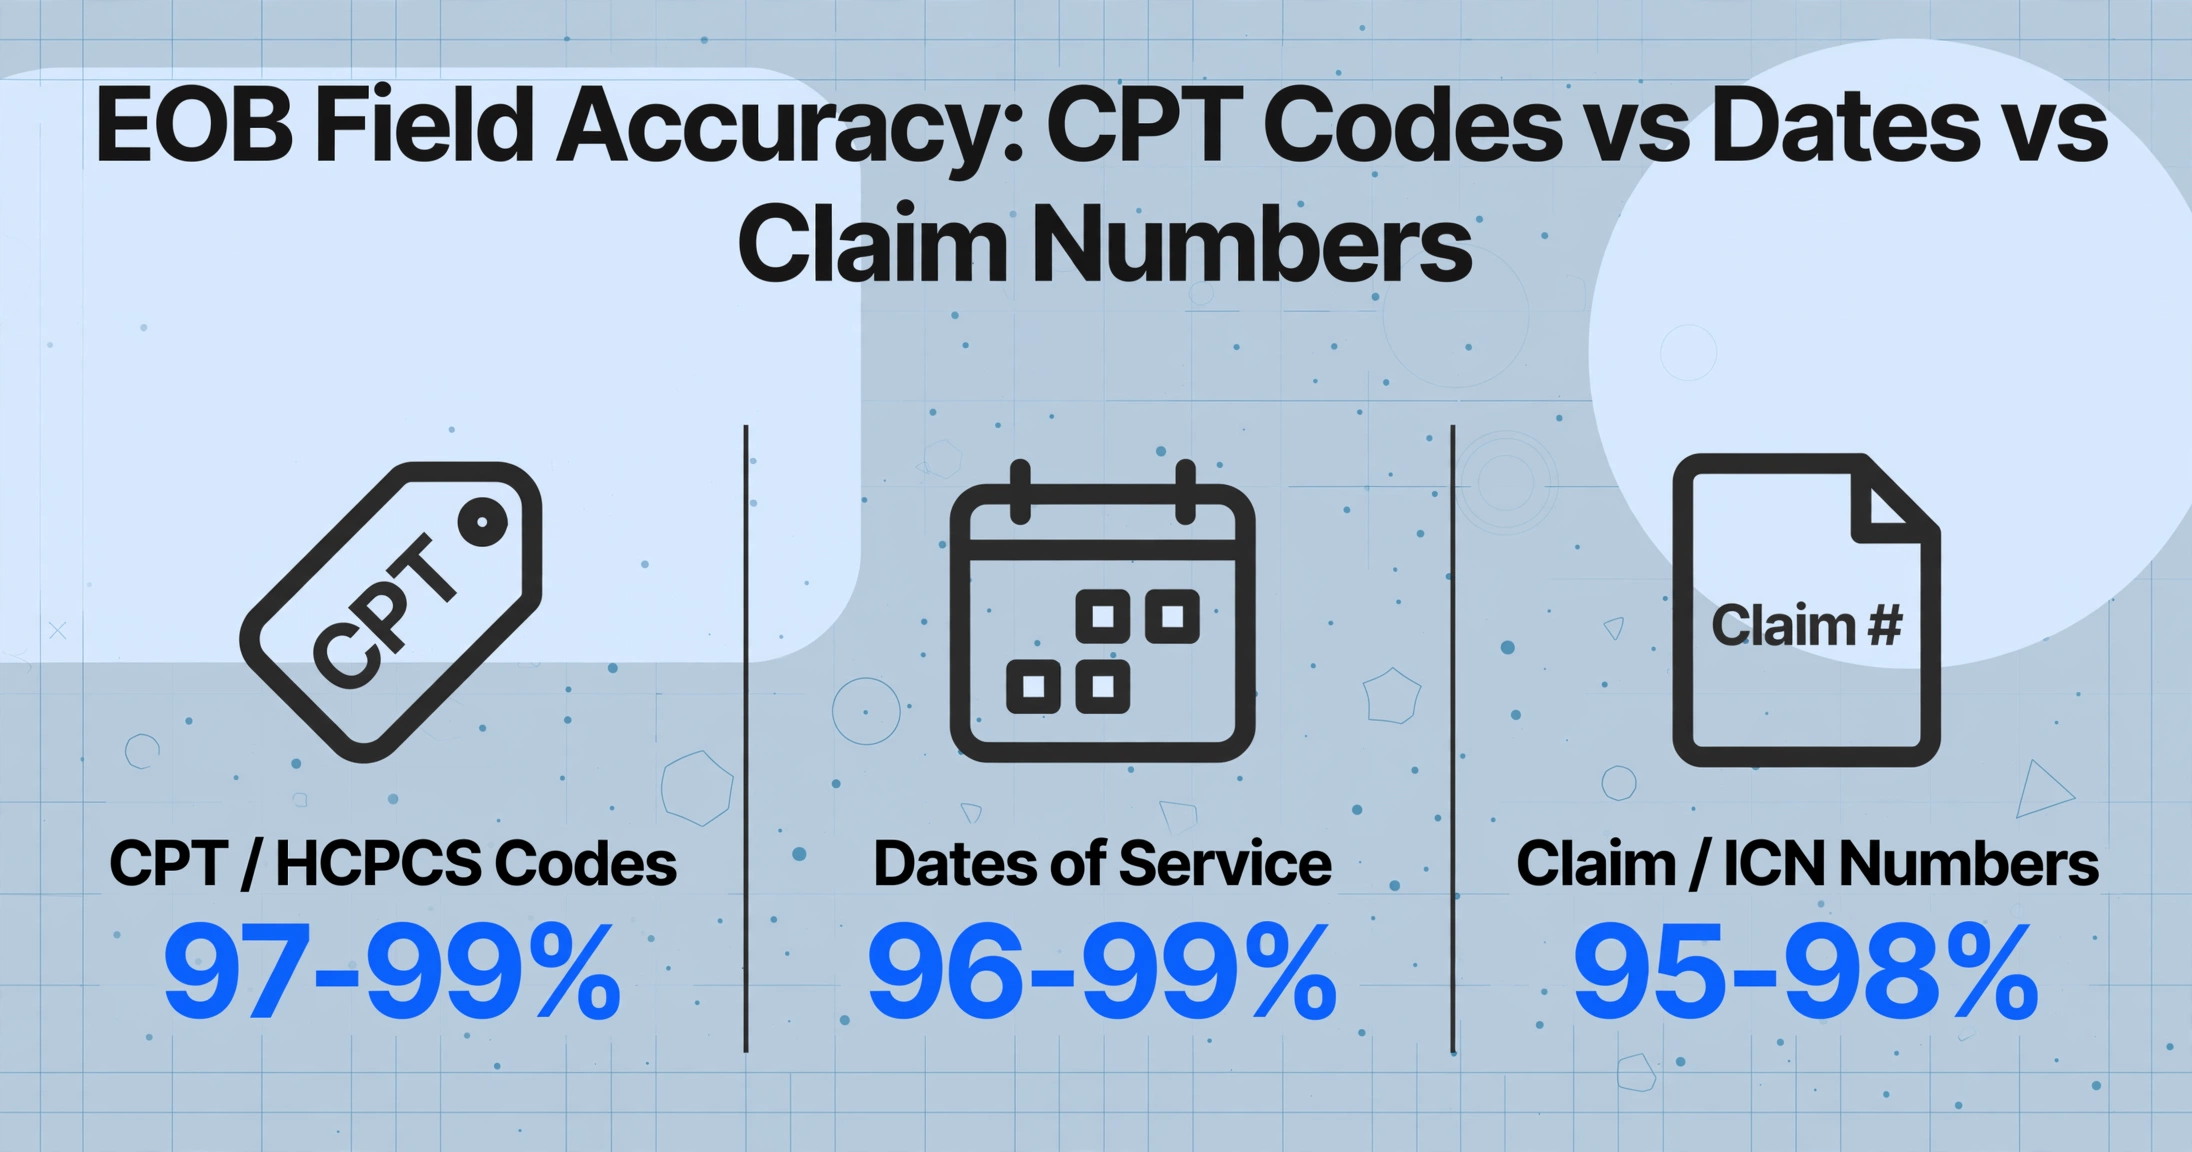
La historia general de precisión en la extracción de EOB es sólida, más sólida de lo que la mayoría de los profesionales de facturación sanitaria esperan antes de probarla. Los datos de implementaciones modernas de extracción impulsadas por IA muestran que la precisión a nivel de campo para los campos financieros estructurados (monto facturado, monto permitido, pago del plan, deducible, copago) se sitúa de forma constante entre el 95 % y el 99 % cuando los documentos se escanean con una calidad razonable y los nombres de las columnas se definen semánticamente. Los mismos sistemas reducen las tasas de error totales desde la base del 8-12 % que es normal en la entrada manual de datos de EOB hasta menos del 2 %, según los puntos de referencia reportados en múltiples implementaciones de automatización sanitaria en 2025-2026.
Pero el rango del «95-99 %» es un promedio de todos los campos. Oculta una diferencia significativa entre los tipos de campo. Para entender dónde la IA realmente ofrece resultados y dónde aún necesita apoyo, debe observar la precisión por categoría de campo, no como un número único.
| Categoría de campo | Precisión típica | Por qué funciona o no |
|---|---|---|
| Códigos de procedimiento CPT / HCPCS | 97-99 % | Formato altamente estandarizado: alfanumérico de 5 dígitos con modificador opcional de 2 dígitos. La IA entrenada con documentos médicos reconoce el patrón incluso en tablas densas. |
| Fechas de servicio | 96-99 % | Formato inequívoco (MM/DD/AAAA o MM/DD/AA). La posición dentro de la estructura de partidas del EOB es consistente en relación con los códigos de procedimiento. |
| Números de reclamo / ICN | 95-98 % | Generalmente en una posición destacada del encabezado con una etiqueta clara. Pero la etiqueta varía: «Claim #», «ICN», «Control Number», lo que confunde al OCR de plantillas y requiere comprensión semántica. |
| Montos en dólares (facturado/permitido/pagado) | 94-98 % | La extracción semántica identifica los montos por contexto (columna «Allowed» vs. columna «Billed»). La precisión disminuye cuando las columnas de dólares están muy juntas sin bordes de celda visibles. |
| Responsabilidad del paciente | 88-95 % | Cada pagador la posiciona y etiqueta de manera diferente: «Patient Responsibility», «Amount You Owe», «Member Liability», «Patient Due». El concepto es el mismo; la etiqueta y la ubicación no lo son. |
| Desglose de deducible / copago / coseguro | 85-93 % | Los campos financieros más difíciles. Algunos EOB muestran el deducible como una partida; otros lo integran en un cuadro resumen; otros lo calculan implícitamente en el monto pagado. Requiere referencias cruzadas que no todos los formatos de EOB proporcionan. |
| Códigos de denegación / motivo de ajuste | 82-92 % | A menudo en secciones de observaciones separadas al final del EOB, vinculadas a partidas mediante códigos de referencia que deben cotejarse. El texto suele estar en la fuente más pequeña de la página. |
Para conocer el contexto sobre qué es la extracción de EOB y por qué es importante para los flujos de trabajo de facturación, consulte qué es la extracción de datos EOB y cómo funciona.
Lo que la IA hace bien en los EOB — y por qué
Los campos que la IA maneja con mayor fiabilidad comparten una característica común: son semánticamente inequívocos. Un código CPT siempre es un código CPT. Una fecha de servicio siempre es una fecha. Un monto permitido es la cifra que el pagador acordó reembolsar. Incluso cuando estos valores cambian de posición entre los más de 1.500 formatos EOB conocidos — y lo hacen con frecuencia — la IA los encuentra por lo que significan, no por una coordenada preconfigurada. Esta es la diferencia fundamental entre el OCR basado en plantillas y la extracción con IA de visión.
Cuatro categorías de campos rinden de manera consistente:
Códigos de procedimiento CPT y HCPCS
Estos son los datos más estandarizados en todos los formatos de EOB. Un código CPT siempre tiene 5 dígitos, siempre se imprime cerca de su descripción de servicio y casi siempre se acompaña de un modificador. El patrón alfanumérico es tan distintivo que los modelos de visión entrenados con documentos médicos lo identifican y extraen con una fiabilidad casi perfecta — incluso cuando las celdas de la tabla circundante están abarrotadas.
Montos en dólares en columnas
Los EOB casi siempre presentan los montos facturados, permitidos, pagados y de ajuste en una tabla de varias columnas. Los modelos de IA de visión analizan estas tablas leyendo el encabezado de la columna para entender cuál es la columna de "facturado" y cuál la de "pagado", y luego extraen el valor en dólares de cada fila en consecuencia. Esto funciona bien cuando las columnas tienen encabezados claros. Donde se vuelve más difícil — y donde la precisión disminuye — es cuando los encabezados están rotados, abreviados o faltan por completo, algo común en los EOB enviados en papel por aseguradoras más pequeñas.
Fechas de servicio y fechas de reclamación
Las fechas siguen un conjunto limitado de convenciones de formato y casi siempre aparecen adyacentes al código de procedimiento o a la descripción del servicio en la tabla de partidas. La combinación de consistencia de formato y contexto posicional hace que la extracción de fechas sea uno de los campos de EOB más fiables.
Nombre del proveedor y NPI
La información del proveedor que factura suele aparecer en un bloque de encabezado uniforme. El nombre del proveedor, el Identificador Nacional de Proveedor (NPI) y el número de identificación fiscal se imprimen en una sección estructurada cerca de la parte superior del EOB, con etiquetas claras. Para las organizaciones de atención médica que necesitan conciliar los EOB con su lista de proveedores, este grupo de campos se extrae con una precisión constante superior al 95 %.
Dónde la IA todavía falla con los EOB
La respuesta honesta es que tres características estructurales de los EOB crean desafíos de precisión recurrentes que ningún sistema de IA actual elimina por completo.
Tamaños de fuente diminutos en tablas de columnas densas
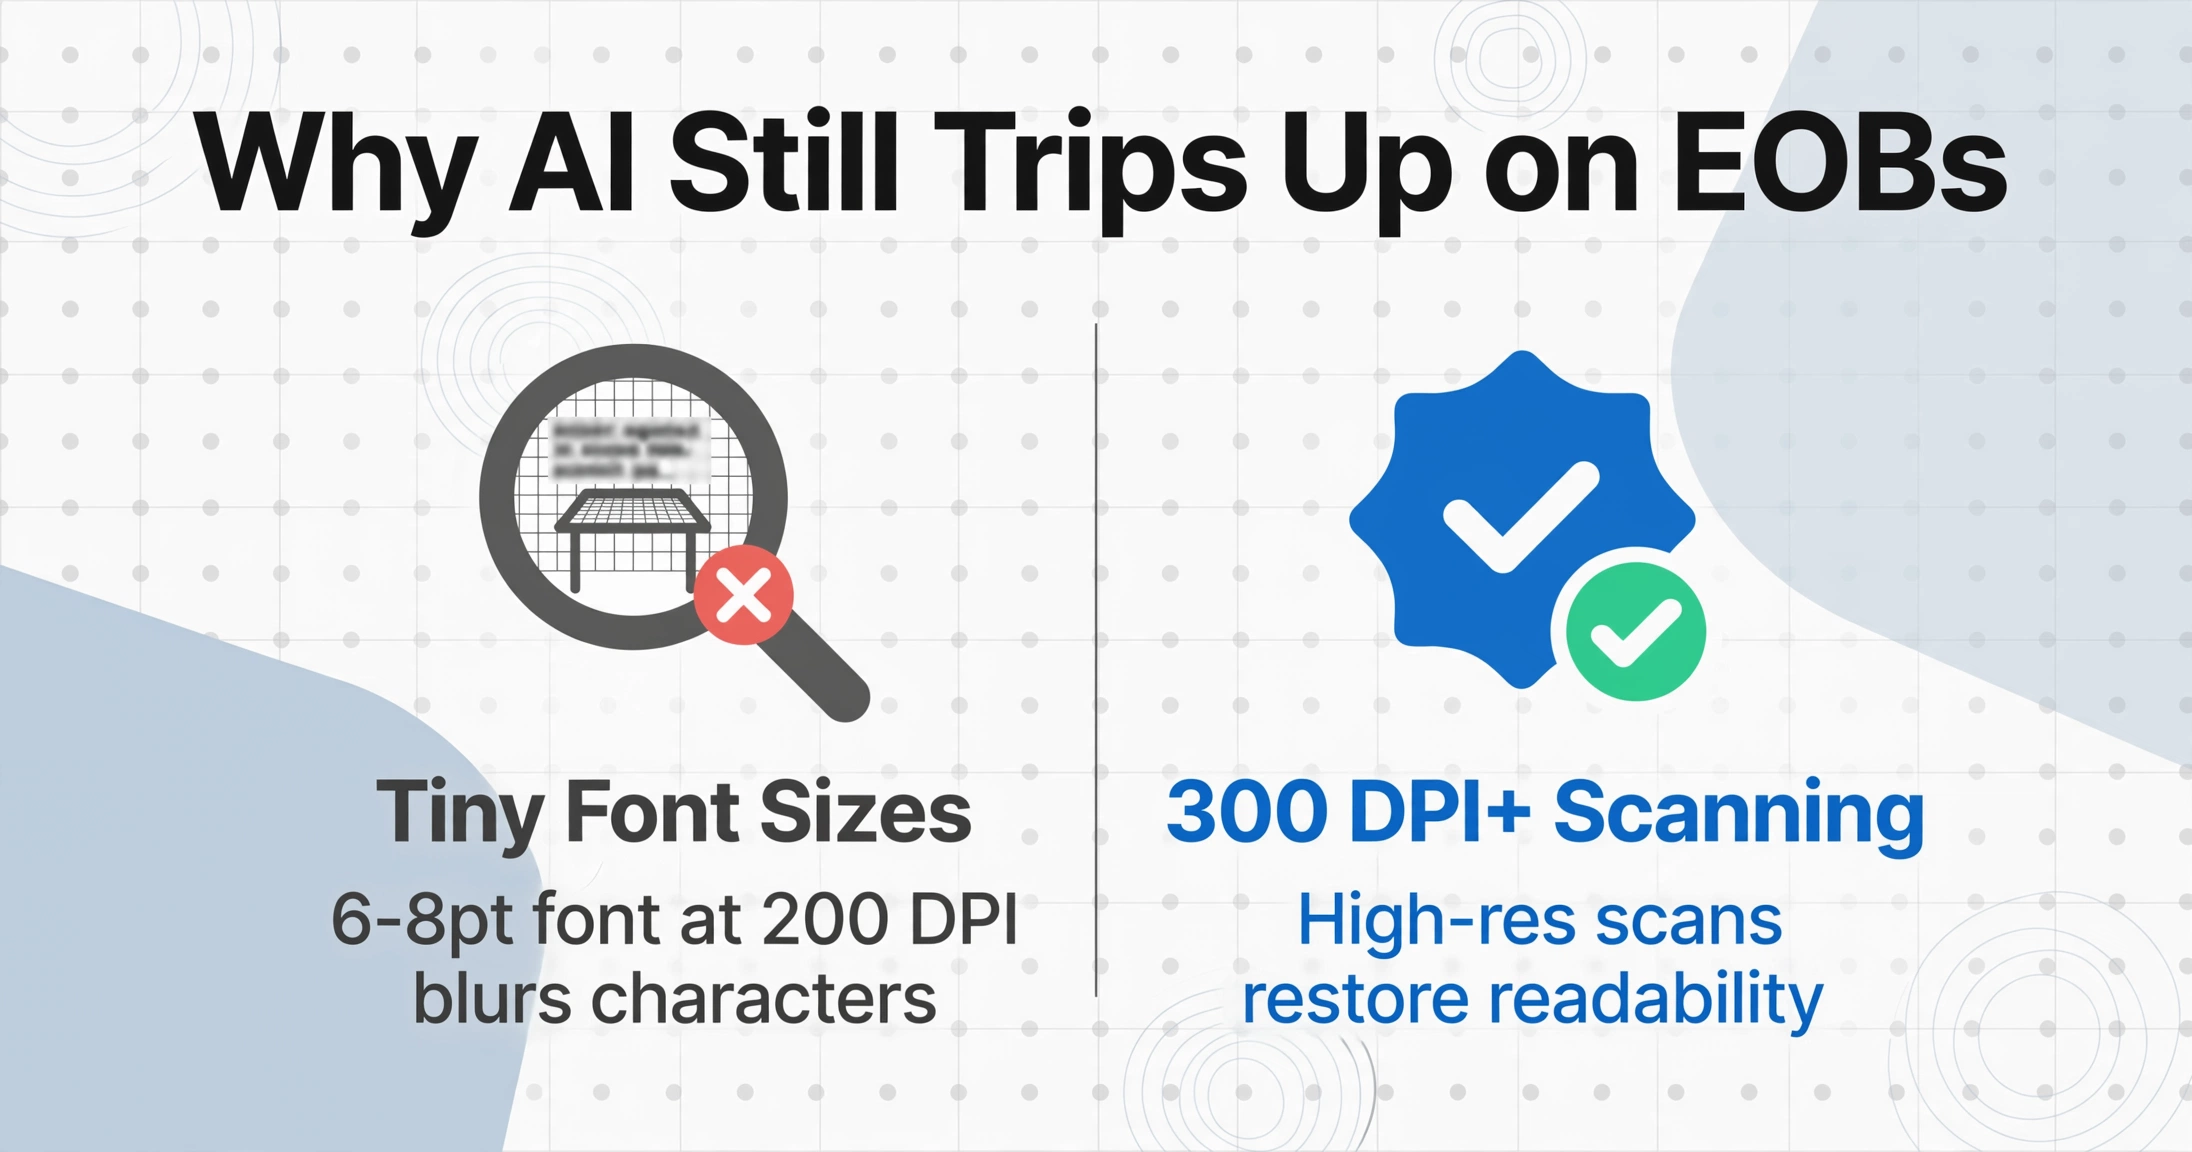
Muchos EOB enviados en papel —particularmente de pagadores gubernamentales y aseguradoras regionales— imprimen la tabla de partidas en un tamaño de fuente de 6 a 8 puntos. Esto es físicamente tan pequeño que los límites de los caracteres se difuminan incluso en escaneos de alta resolución. Cuando un «6» y un «8» difieren por un solo píxel a 200 DPI, la IA lee el contexto circundante para adivinar cuál es, y el contexto no siempre es decisivo. La solución es sencilla: escanear a 300 DPI o más, pero esta es una limitación física que las mejoras en los modelos de IA por sí solas no pueden resolver.
Este es un desafío genuinamente diferente del problema de variabilidad de formatos que discuten la mayoría de los proveedores. La variabilidad de formatos es un problema de ingeniería: entrenar con más formatos. El tamaño de fuente es un problema de física: a una resolución lo suficientemente baja, la información no está presente en la imagen para que ningún modelo la lea. Es la limitación menos discutida en la categoría de extracción de EOB.
Códigos de motivo de denegación en secciones de observaciones separadas
Los códigos de denegación (como CO-4, PR-16, OA-23 del estándar HIPAA de códigos de motivo de ajuste de reclamaciones) generalmente se imprimen en una sección de observaciones separada en la parte inferior o posterior del EOB, vinculados a las líneas de detalle mediante números de línea de referencia. Extraer el código en sí es fácil. Mapearlo a la línea de servicio correcta — e interpretar su significado junto con el monto del ajuste — requiere hacer referencias cruzadas entre dos estructuras de tabla separadas en la misma página. La IA puede hacer esto, pero la precisión disminuye porque la conexión visual entre la línea de detalle y su observación de denegación correspondiente suele ser una alineación de columnas implícita en lugar de una referencia cruzada explícita.
Inconsistencia en la etiqueta de responsabilidad del paciente
Un concepto, doce etiquetas. BCBS of Texas lo llama "Patient Responsibility". Aetna usa "Member Liability". UnitedHealthcare imprime "Amount You Owe". Cigna escribe "Patient Due". Los planes de Medicare Advantage usan frecuentemente "Patient Pay Amount". Cada uno de estos significa lo mismo para fines de conciliación — el monto que el paciente debe pagar al proveedor — pero un sistema OCR basado en plantillas requeriría una configuración separada para cada variante de etiqueta. Un sistema de IA semántica maneja esta variación al comprender el concepto, pero la precisión no es tan alta como en los campos de formato fijo porque el modelo debe inferir la intención del contexto en lugar de coincidir con un patrón conocido. Aquí es donde la Extracción de Columnas Personalizadas — definir su columna como "Patient Responsibility" y dejar que la IA encuentre el valor semánticamente coincidente, sin importar cómo lo llame el pagador — marca la diferencia entre un sistema que requiere configuración constante y uno que se adapta.
Para un análisis más profundo de cómo varían los EOB entre pagadores y por qué esto desafía a los sistemas de extracción, consulte nuestra guía completa de extracción de datos de EOB.
Cómo Obtener la Mayor Precisión de Extracción de Sus EOB
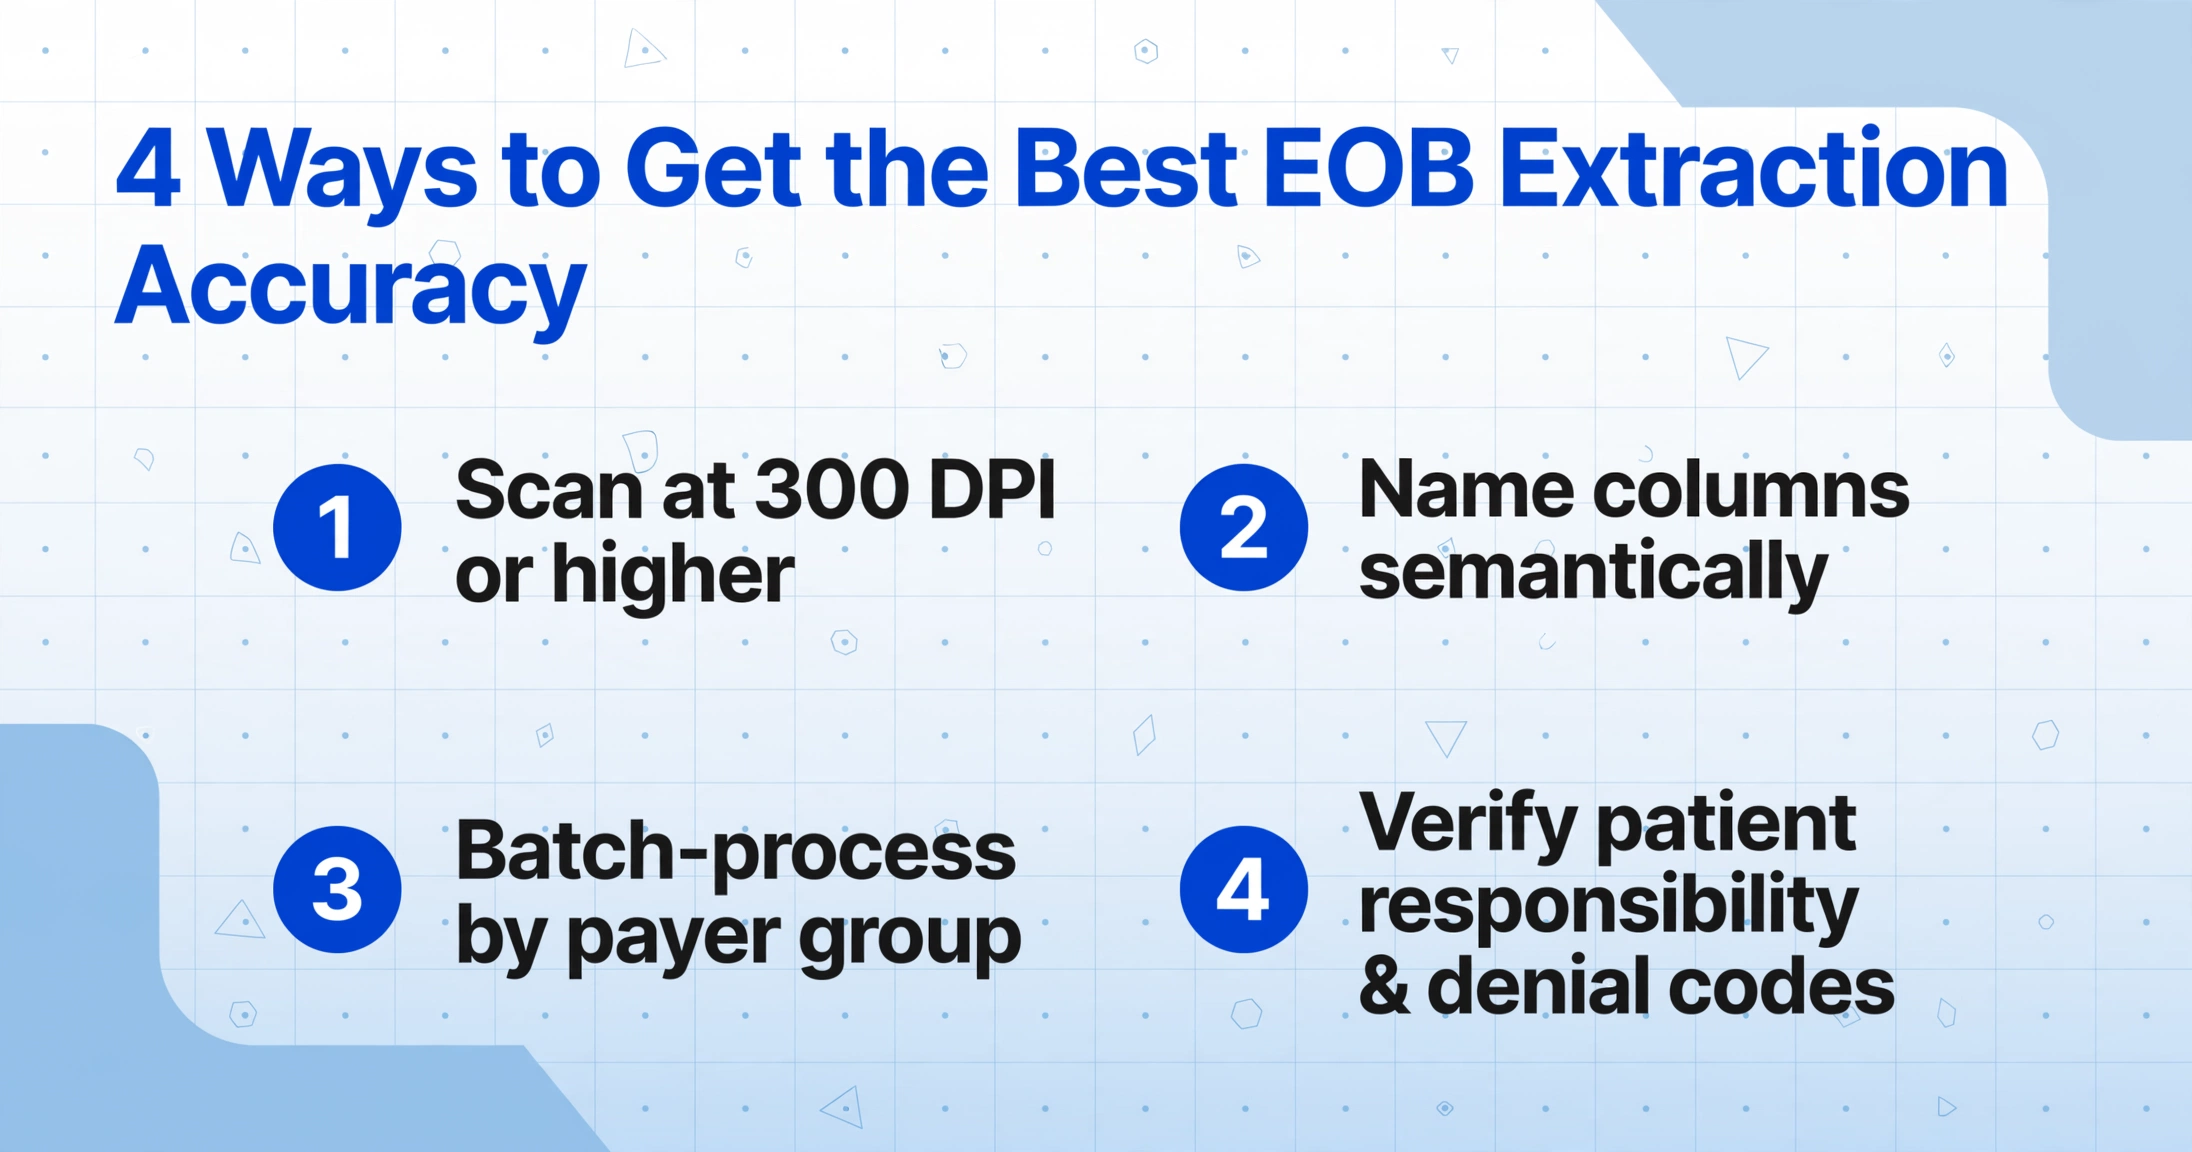
La precisión que usted obtiene realmente de una herramienta de extracción de EOB con IA depende menos del modelo y más de cómo prepare la entrada y defina la salida. Estos cuatro ajustes marcan la mayor diferencia:
La fuente de 6 a 8 puntos que usan muchos EOB de pagadores está en el umbral de lo que la IA de visión puede leer de forma fiable con la resolución estándar de fax (200 DPI). Escanear a 300 DPI o solicitar PDF digitales en lugar de copias en papel elimina el límite de precisión más común sin necesidad de cambiar la configuración de la herramienta.
Una columna llamada «código CPT» o «Monto Permitido» le da a la IA un objetivo preciso. Una columna llamada «Código» o «Monto 1» deja lugar a la ambigüedad. Cuanto más específico sea el nombre de su columna, mejor podrá la IA distinguir entre los cuatro o cinco montos en dólares diferentes que aparecen en una sola página de EOB.
Un EOB individual de BCBS de Texas y un EOB individual de Aetna pueden verse diferentes, pero un lote de 20 EOB de BCBS sigue el mismo diseño. Procesar los EOB en lotes específicos por pagador — incluso si eso significa cargar dos lotes separados — le da a la IA la consistencia visual que necesita para lograr la mayor precisión a nivel de campo.
Estos dos grupos de campos tienen la mayor variación de precisión porque cada pagador los formatea de manera diferente. Incorpore un paso de verificación en su flujo de trabajo: haga que un especialista en facturación revise los montos de responsabilidad del paciente y las asignaciones de motivos de denegación contra el EOB original, detectando el 5-15% de los casos que necesitan corrección antes de que lleguen a los estados de cuenta de sus pacientes o a las cuentas por cobrar.
Lo que esto significa para su flujo de trabajo con EOB
La conclusión práctica es la siguiente: la extracción de EOB con IA no elimina la revisión humana, pero cambia su naturaleza. En lugar de que un especialista en facturación dedique de 15 a 20 minutos por EOB escribiendo manualmente cada campo —con una tasa de error del 8-12 % que genera reclamaciones denegadas cuyo reprocesamiento cuesta entre 25 y 50 dólares cada una—, la IA extrae automáticamente los campos fiables, y el especialista centra la verificación en las 2 o 3 categorías de campos con mayor variabilidad entre pagadores.
El flujo de trabajo pasa de ser de transcripción a ser de gestión de excepciones. Los campos rutinarios (códigos CPT, fechas, números de reclamación, información del proveedor, importes estándar) se obtienen con una precisión del 95-99 % y solo requieren un muestreo aleatorio para el control de calidad. La atención se centra en los importes de responsabilidad del paciente, las asignaciones de códigos de motivo de denegación y los desgloses de deducible/copago/coaseguro, donde un margen de error del 5-15 % indica que el juicio humano sigue siendo la herramienta adecuada.
Para una visión más amplia de cómo la extracción automatizada se integra en los flujos de trabajo de documentos sanitarios, incluidos los EOB, consulte cómo el OCR procesa historiales médicos, EOB y formularios de reclamación.
Preguntas frecuentes
¿Qué precisión tiene la IA para extraer datos de EOB?
La extracción moderna de EOB con IA alcanza una precisión del 95-99% a nivel de campo en datos estructurados como códigos CPT, fechas de servicio, números de reclamo y montos estándar (facturado, permitido, pagado). La responsabilidad del paciente y los códigos de motivo de denuncia suelen ser más bajos, entre 85-95%. La tasa de error general baja del 8-12% en el procesamiento manual a menos del 2% con IA, pero ese "menos del 2%" incluye una mezcla de campos con perfiles de confiabilidad muy diferentes, por lo que verificar los campos variables sigue siendo importante.
¿Puede la IA manejar EOB de diferentes aseguradoras en un solo lote?
Sí, aquí es donde la IA de visión tiene una clara ventaja sobre el OCR basado en plantillas. Un sistema de extracción semántica lee los valores de los campos por lo que significan, no por dónde aparecen en la página, por lo que un EOB de BCBS y uno de Aetna con diseños diferentes pueden procesarse en el mismo lote. Sin embargo, la precisión es mayor cuando se agrupan EOB del mismo pagador, porque la consistencia del diseño dentro de un grupo de pagadores le da a la IA un contexto visual adicional para mapear los campos correctamente.
¿La precisión de la extracción de EOB requiere entrenar la IA con mis pagadores específicos?
No, y este es un diferenciador clave frente a plataformas como Nanonets o Rossum que requieren muestras de entrenamiento etiquetadas. Las herramientas de IA que usan Extracción de Columnas Personalizadas no requieren entrenamiento: escribes los nombres de las columnas que deseas (como "Código CPT", "Monto Permitido", "Responsabilidad del Paciente") y la IA localiza los valores coincidentes en cualquier formato de pagador al comprender la semántica del documento. Funciona desde la primera carga, no después de un ciclo de entrenamiento.
¿Por qué la responsabilidad del paciente es más difícil de extraer que otros campos de EOB?
Porque no existe una etiqueta estándar para ello entre los pagadores. Un EOB imprime "Responsabilidad del Paciente" al pie de una tabla resumen. Otro lo llama "El Miembro Debe" dentro de un párrafo de texto. Un tercero lo calcula implícitamente como la diferencia entre lo facturado y lo pagado, sin imprimir un campo etiquetado. Un sistema de IA semántico lo encuentra al comprender el contexto en lugar de coincidir con una etiqueta, lo que funciona la mayoría de las veces, pero no siempre. Este es el grupo de campos que más vale la pena verificar manualmente.
¿La IA extrae códigos de motivo de denegación de los EOB?
Extrae los códigos de forma confiable — los códigos estándar de motivo de ajuste de reclamo HIPAA como CO-4, PR-16 u OA-23 siguen un formato fijo. La parte más difícil es asignar cada código de denegación a la línea de servicio correcta, porque la sección de observaciones que enumera las denegaciones a menudo está físicamente separada de la tabla de líneas de detalle en la página del EOB. Algunos EOB usan números de línea de referencia para vincularlos; otros dependen de la alineación del orden de las filas. La IA maneja bien los números de referencia explícitos, pero el mapeo implícito por orden de filas puede introducir errores.
Pruebe un lote de EOB de sus pagadores reales. Vea qué campos llegan al 99 % y cuáles necesitan una segunda revisión, antes de rediseñar su flujo de trabajo basándose en suposiciones que podrían no cumplirse con su combinación específica de pagadores.
Pruébelo con sus EOB