処方箋の再入力:
紙の処方箋と薬局のデータ入力負担
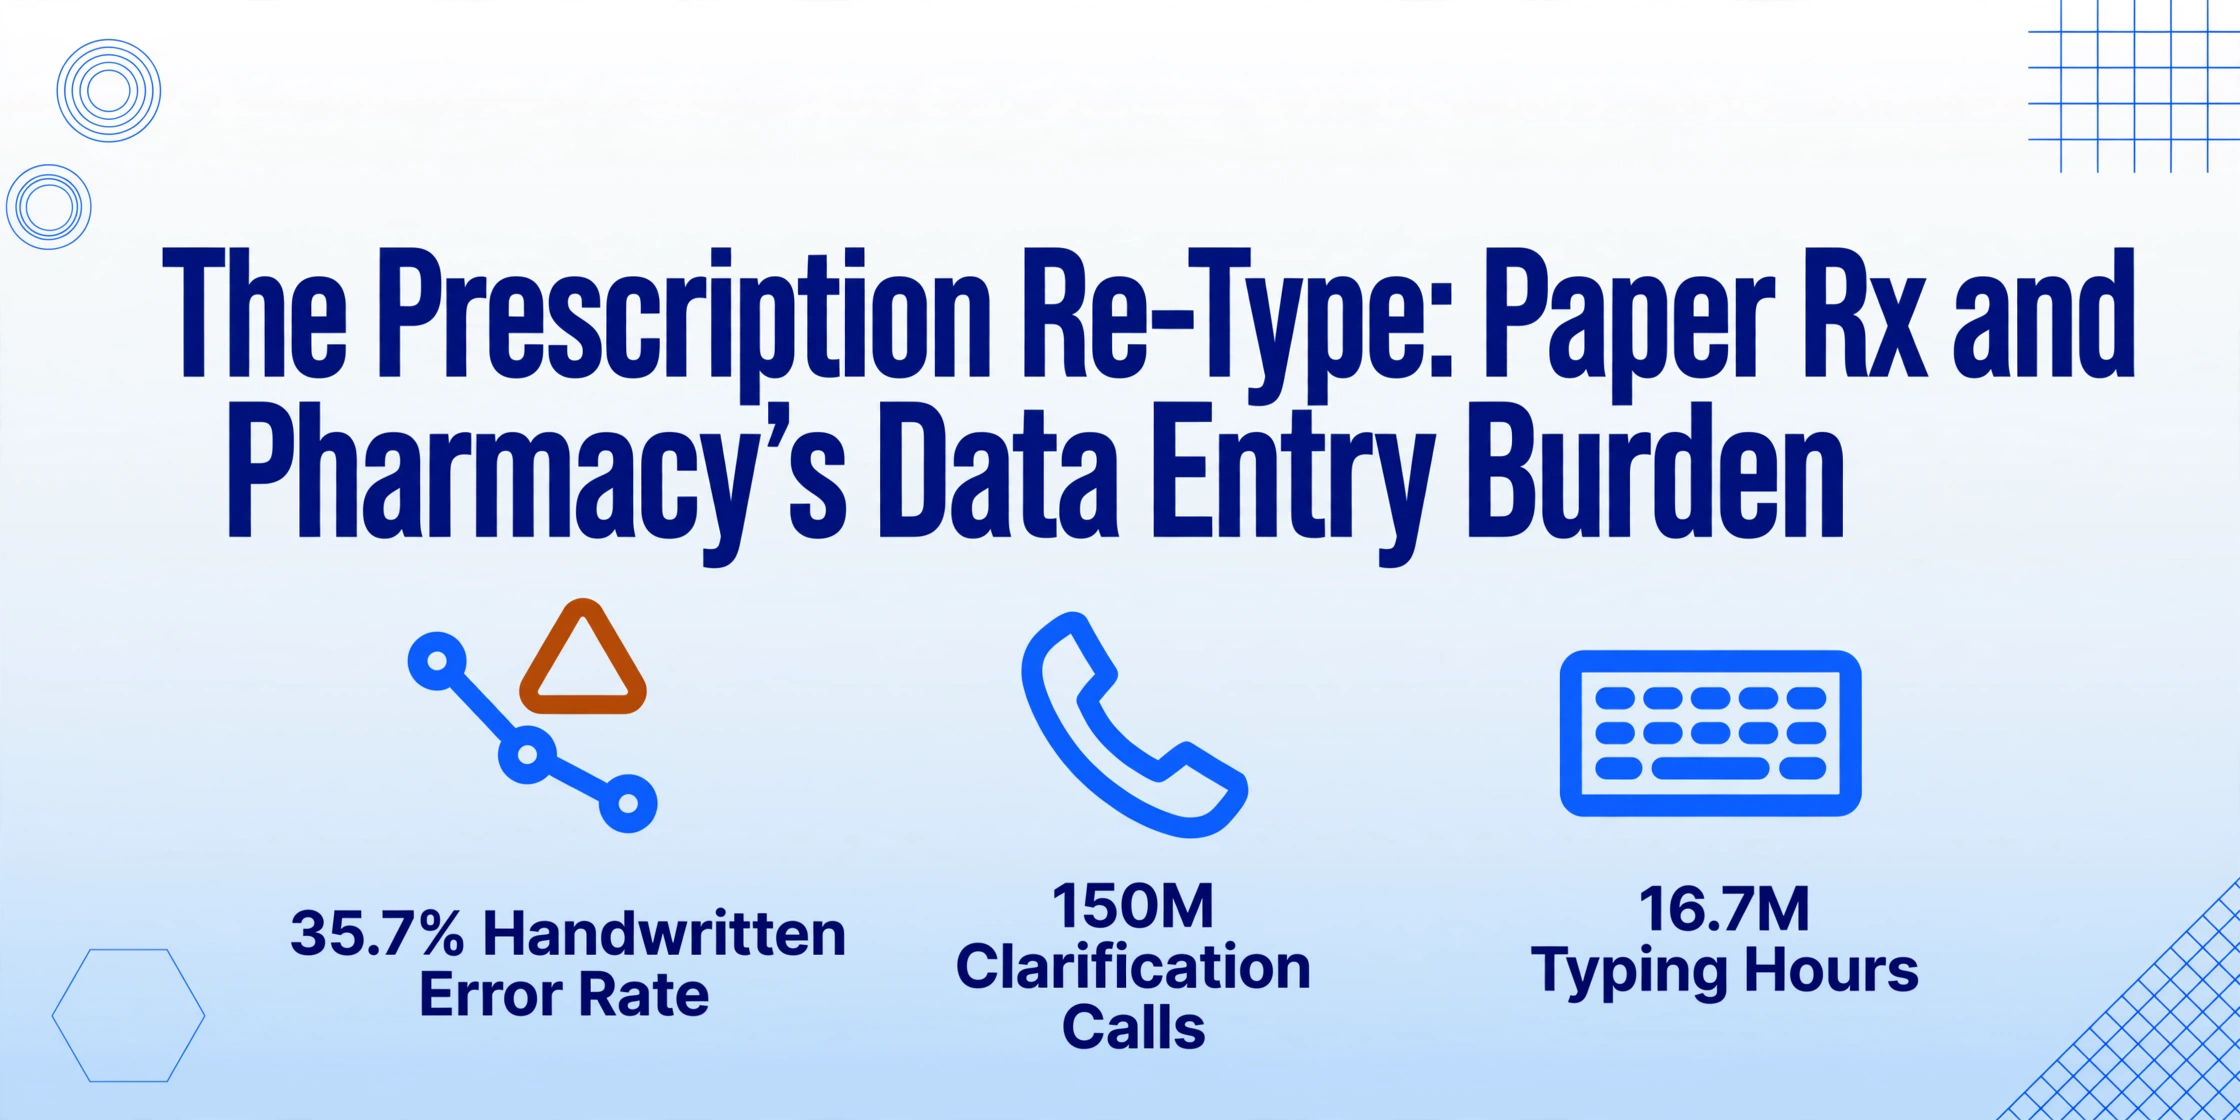
2025年、米国の薬局は推定50億件の処方箋を調剤しました。そのうち約26.4億件がSurescriptsネットワークを通じて電子的に届きました。残りの20億件以上は、紙、電話、またはFAXで薬局のカウンターに届きました。そのすべてが、全国49万人の薬局テクニシャンによって、フィールドごとに、キーストロークごとに、薬局管理システム(PMS)への手入力を余儀なくされています。これは、ヘルスケアの他のどの分野にも類を見ない手動データ入力の量であり、薬局の外でその実態を見た人はほとんどいません。
重要ポイント
- 毎年約20億件の処方箋が紙または電話で米国の薬局に届き、そのすべてがテクニシャンによってキーボードでフィールドごとに薬局ソフトウェアへ手入力されている。
- 電子処方の導入率92%は恒久的な上限に達している。規制物質、歯科医院、獣医クリニック、価格比較をする患者が、ネットワーク拡大では排除できない紙の構造的な下限を生み出している。
- テンプレート位置ではなく意味内容で手書き文字を読み取るAIは、30秒の手動転記を5秒の確認ステップに変えることができる。薬剤師の安全確認は残り、再入力作業は消える。
紙の処方箋の旅は、電子処方が止まったところから始まる
まず理解すべきことは、紙の処方箋が実際にどのように動くかである。小規模な個人診療所の医師 — おそらくONCのデータによると、まだ電子処方を導入していない約8%の処方者の一人 — が処方箋をパッドに書く。患者はそれを薬局に持っていく。受付カウンターのテクニシャンがそれをスキャンして薬局管理システム(PMS)に取り込む。そしてそのスキャン、つまり医師の手書き文字が書かれた紙の画像こそが、手作業の始まりなのである。
薬局管理システムはその画像を理解しない。手書き文字を解析できない。処方箋が何を意味するかという意味論的モデルを持っていない。画像は参照画像としてそこにあるだけで、テクニシャンの仕事は、そこに含まれるすべてを抽出し、構造化データに変換し、システムのデータ入力画面に入力することである。詰め替えカウンターは、ボトルに印刷されたラベルからそれらのフィールドを読み取る — 処方箋ラベルの写真に写る薬剤名、用量、服用頻度。
その画面は、薬局が使用するPMS — PioneerRx、QS/1 NRx、Computer-Rx、Rx30、あるいはRedSail TechnologiesやOutcomesなどの企業が保守する他多数のシステム — によって、15〜20個の個別フィールドを表示する。それぞれを入力しなければならない。それぞれが判断ポイントである。それぞれがエラーの機会である。
このワークフローの規模は、簡単には視覚化できない。年間20億件の非電子処方箋と、処方箋あたり平均約30秒のデータ入力時間 — r/pharmacyのようなフォーラムでテクニシャンが頻繁に引用する数字 — を考えると、総労働コストは驚異的である:年間約1,670万時間の手動データ入力作業であり、そのほぼすべてを、労働統計局の中央値で年間$43,460(2024年5月)を稼ぐ薬局テクニシャンが行っている。
15項目の関門:キーボードの前で実際に何が起きているのか
これが単なる「タイピング」ではない理由——事務作業ではなく認知的な関門である理由——を理解するには、フィールドを見る必要がある。以下は、薬局テクニシャンが1つの処方箋について典型的なデータ入力画面で遭遇する項目であり、薬局テクニシャン養成カリキュラムで教えられる標準的なフィールド構成と、Pharmacy Skills Labのデータ入力キューのシミュレーターに基づいている:
| フィールド区分 | 個別フィールド | データの出所 |
|---|---|---|
| 患者 | 氏名、生年月日、住所、電話番号 | 紙の処方箋+患者からの口頭情報 |
| 処方者 | 氏名、NPI(10桁)、DEA番号、診療所住所、電話番号 | 紙の処方箋(しばしば走り書き) |
| 医薬品 | 薬剤名、規格、剤形、NDC(11桁) | 紙の処方箋——手書きの薬剤名を解読 |
| 調剤 | 数量、日数、承認済みリフィル数、DAWコード | 紙の処方箋+テクニシャンの計算 |
| 服用方法 | SIG(動詞+用量+経路+頻度+補足情報) | 紙の処方箋——しばしば略語・筆記体・曖昧 |
| 管理情報 | 処方日、調剤開始日、処方元コード | 紙の処方箋+州の規制要件 |
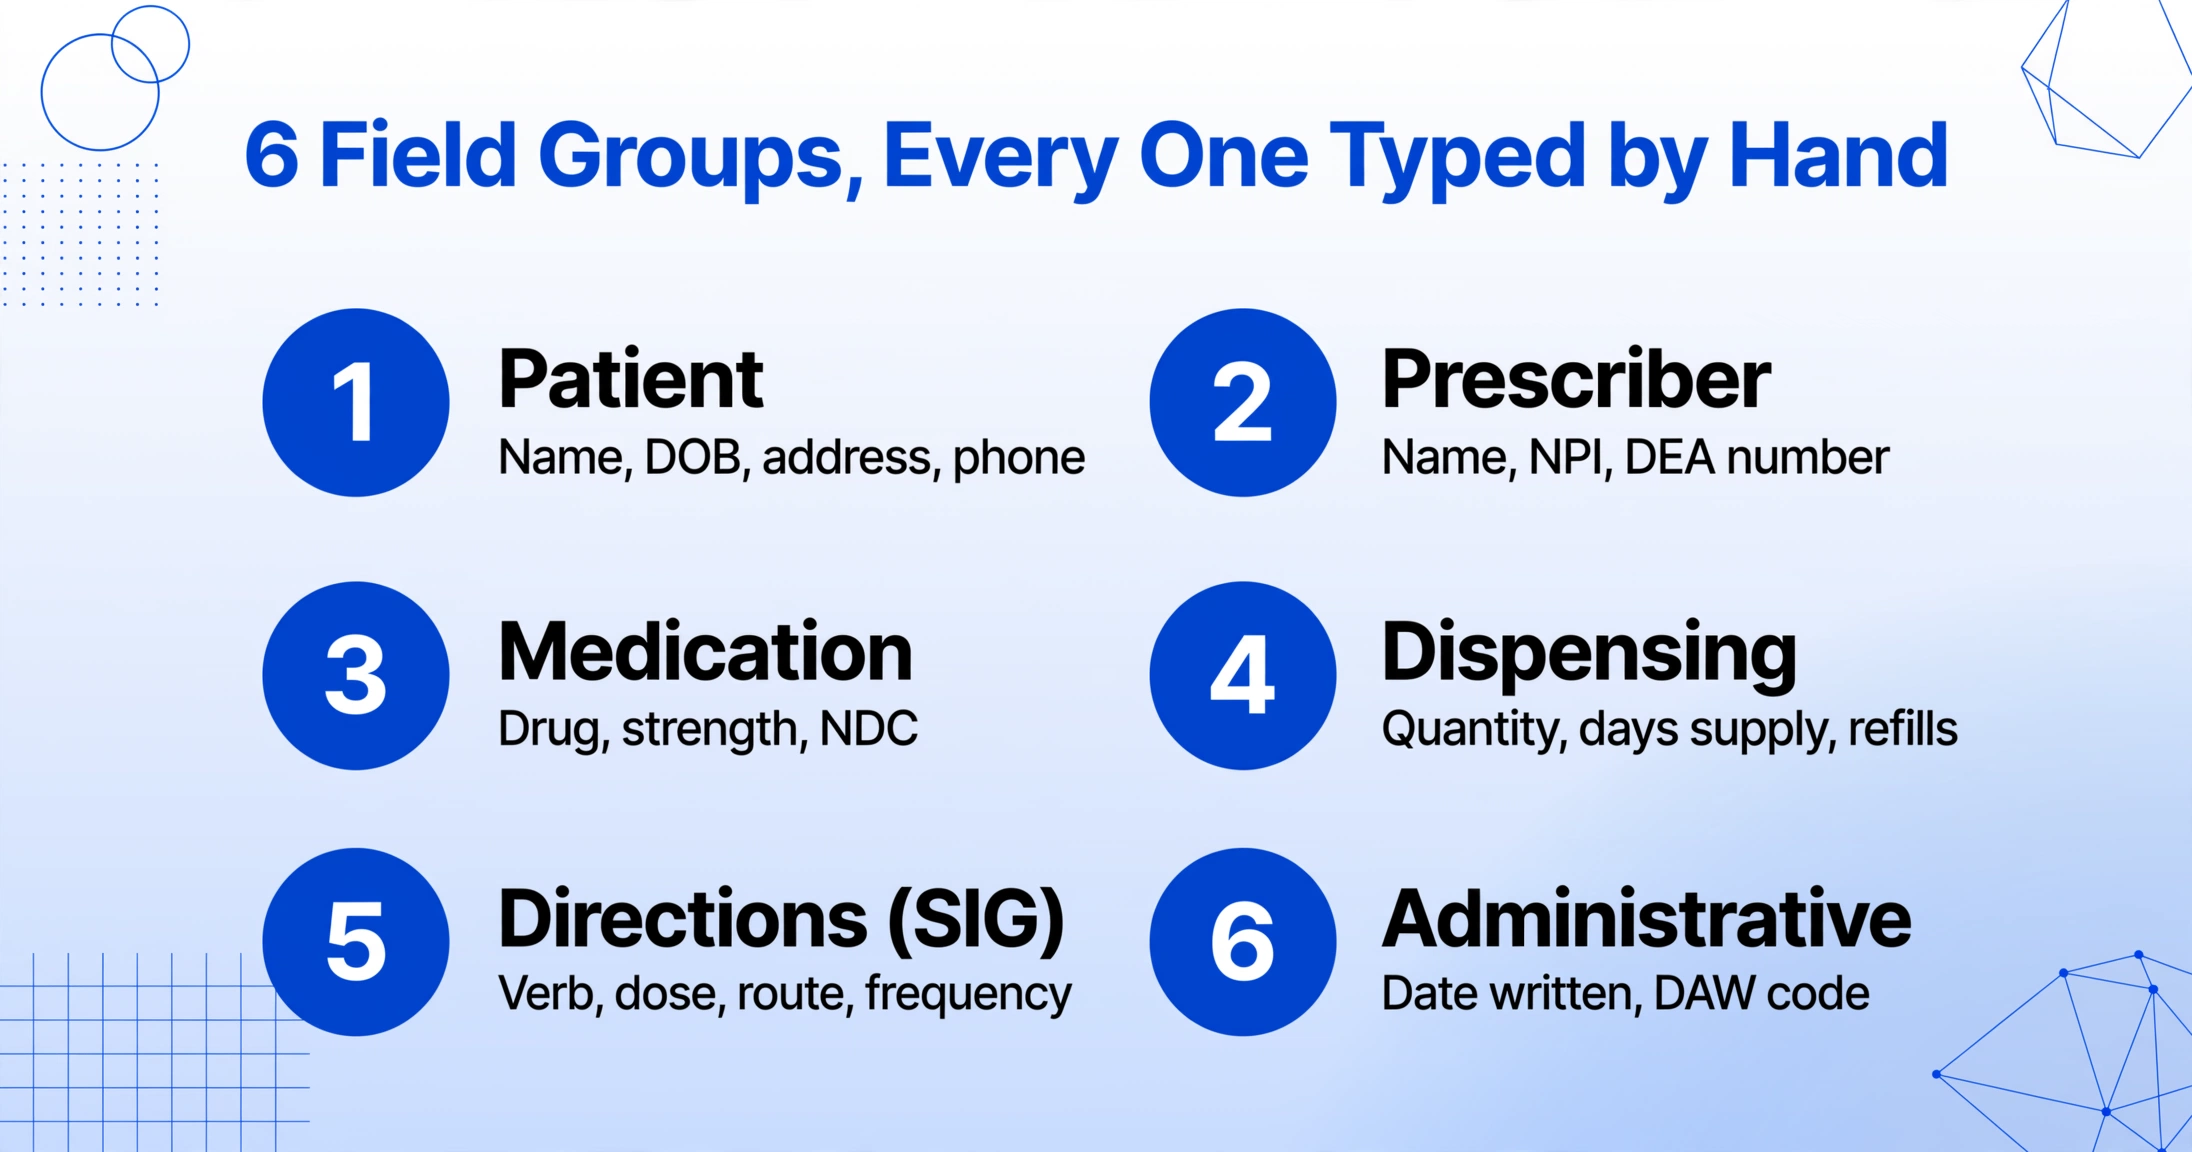
つまり、1枚の処方箋につき約18〜20個の情報があり、それぞれ紙の原本との照合が必要となる。そして紙の原本——テクニシャンが照合すべき証拠——こそが問題の核心である。手書きであり、しばしば筆記体で、頻繁に急いで書かれ、時にはテクニシャンが一度も見たことのない処方者の筆跡であることもある。
Redditのr/PharmacyTechnicianで、ある研修生がその経験を率直に語っている:「誓って言いますが、半分は解読不能でした!提供者が正しく書けないのに、私たちがその意図を理解できるはずがあるんですか?」
その質問は単なる不満ではない。そこには構造的なミスマッチが表れている。処方システムは、処方者のペンの速度で、ある人間が別の人間の手書き文字を読むように設計されている。一方、調剤システムは、待っている患者の列の速度で、構造化された機械可読データを要求する。薬局テクニシャンは、この互換性のない2つのシステムの間の変換層であり、その変換は設計上エラーが発生しやすい。
手書き文字の実際のコスト:エラー、電話、そして命
エラー率は無視できるものではない。米国国立衛生研究所の研究では、398件の処方箋(手書き199件、電子199件)をレビューし、手書き処方箋の35.7%にエラーが見つかったのに対し、電子処方箋ではわずか2.5%だった。別の研究群をまとめた2023年のAnnals of Medicine & Surgery誌の系統的レビューでは、全処方箋の1.7%から24%が誤って調剤され、そのうち1.5%から4%のエラーが患者の傷害につながると推定されている。米国医学研究所は、年間7,000人以上の死亡を、読みにくい手書き文字と処方箋の記入ミスに起因する投薬エラーと関連付けている。
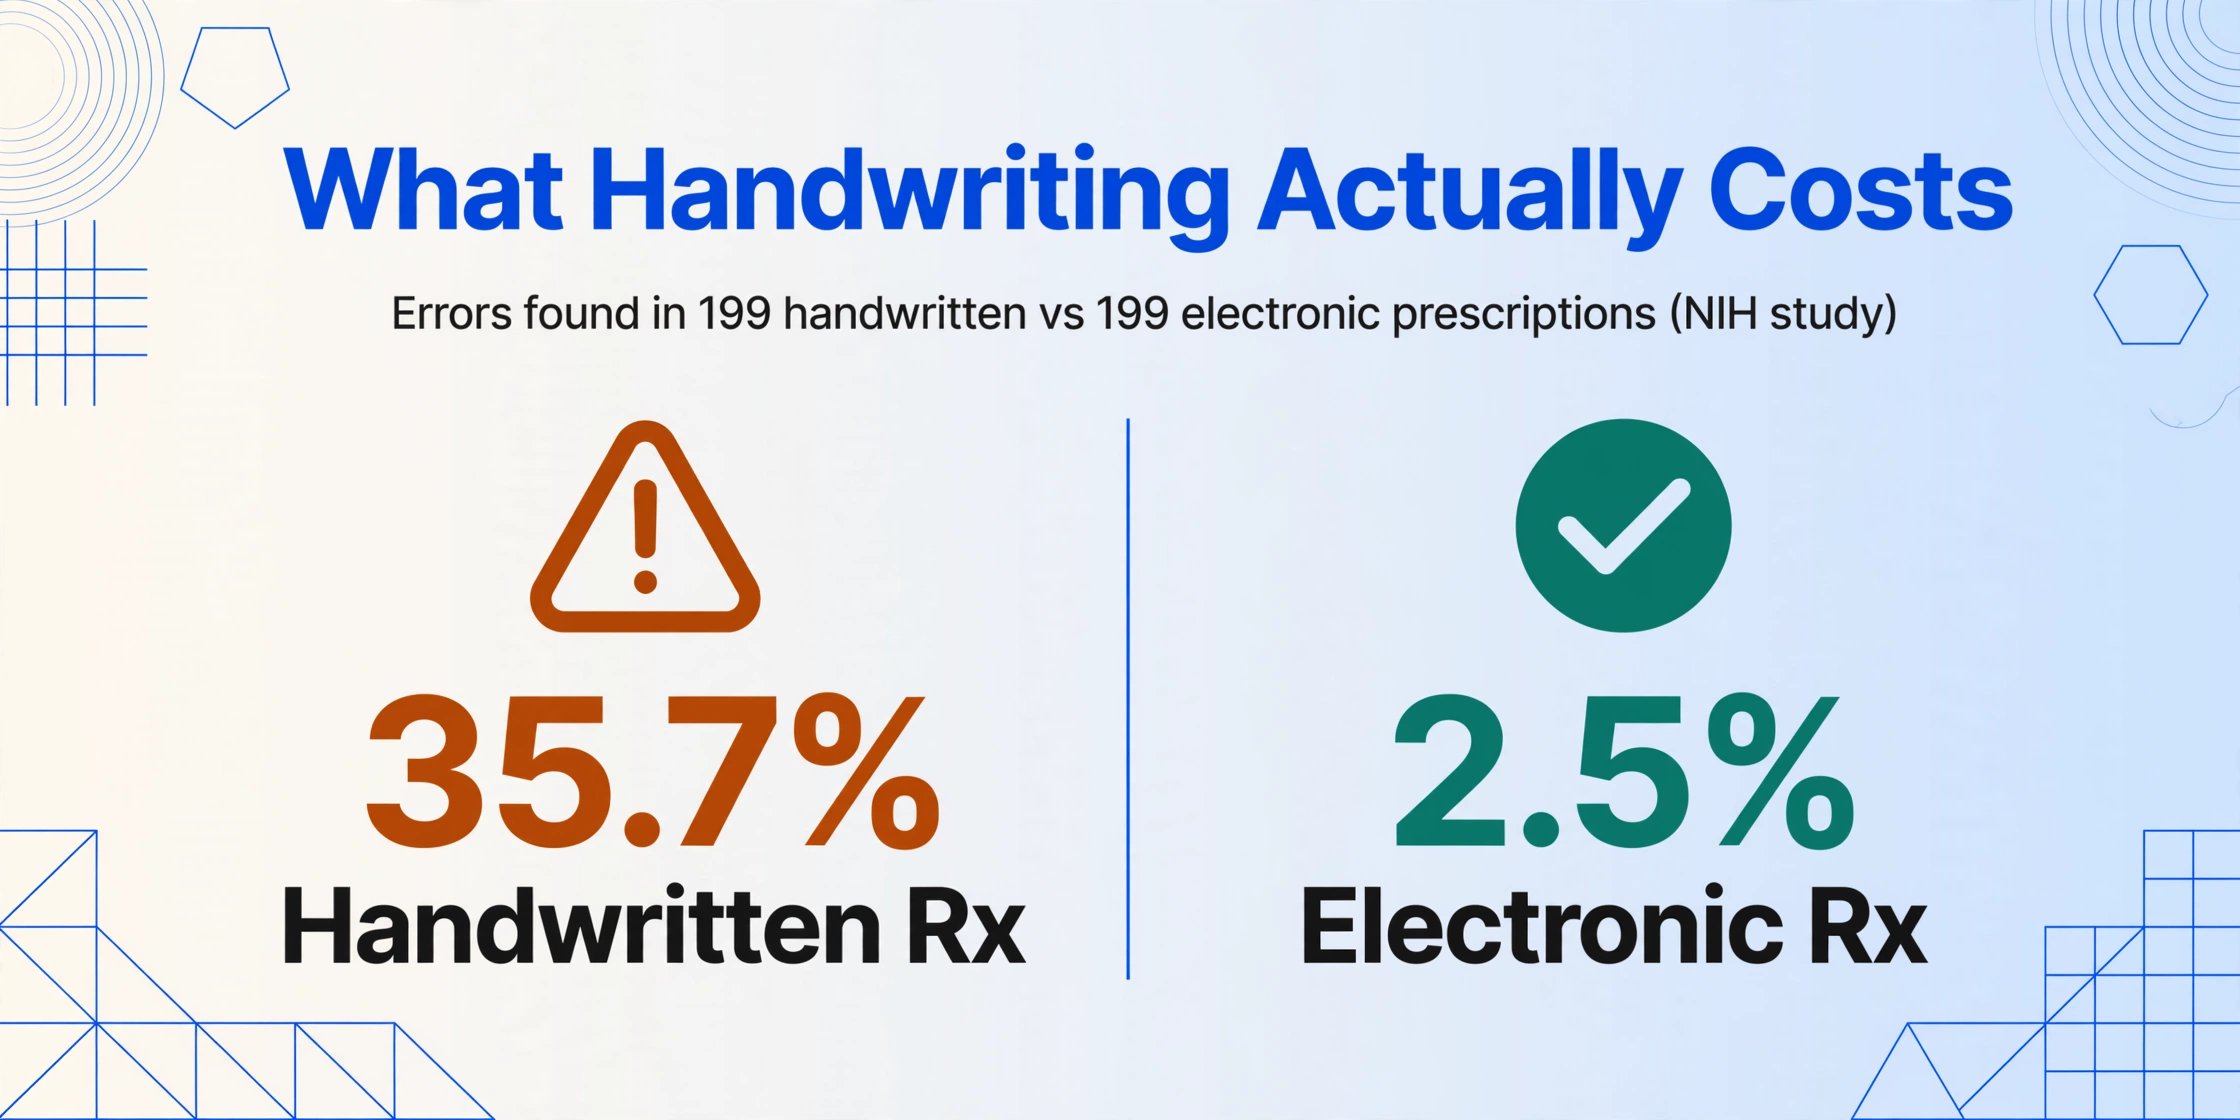
しかし、エラー率は検出されたものだけを測定している。摩擦、つまり紙の処方箋ごとに食い込む不確実性のシステム全体のコストは測定していない。
テクニシャンが薬剤名を読めない、SIGが「QD」(1日1回)なのか「QID」(1日4回)なのか判断できない、数量欄の手書き数字が7なのか9なのか確信が持てない場合、処方箋は停止する。テクニシャンはフラグを立てる。薬剤師は処方者のオフィスに電話する。オフィススタッフはカルテを確認する。処方者が折り返し電話する。薬剤師が確認する。データ入力が再開される。
米国では、薬局から処方者への年間推定1億5,000万件の確認電話が行われていると、業界データは示している。これは、投薬サプライチェーンにおける1億5,000万回の中断であり、それぞれが走り書きの紙と精度を要求するデータベースの間のギャップによって引き起こされている。
最も危険なエラーは、薬剤師が「LASA(名称類似)」薬剤と呼ぶもの、つまり外観・名称が類似したペアに集中する。プレドニゾンとプレドニゾロン。クロニジンとクロノピン。セレブレックスとセレクサ。処方者の手書き文字が「Celebrex 200 mg」をどちらの薬にもなり得る走り書きに変えてしまった場合、抗炎症薬と抗うつ薬の違い、あるいはワルファリン1 mgと10 mgの違いは、Pharmacy Timesがデータ入力精度の詳細な分析で記録したように、テクニシャンに委ねられたキーストロークレベルの判断となる。
電子処方が課題を解決しきれなかった理由
問題の規模を考えると、当然の疑問が浮かぶ。なぜ今ですべてが電子化されていないのか? Surescriptsネットワークは2025年に26.4億件の電子処方を処理した。ONCによると、92%の処方者が電子処方機能を導入している。インフラは存在する。エラー削減効果も実証されている。では、なぜ普遍的な導入が進まないのか?
答えは単一の理由ではない。電子処方が到達できない紙の処方箋のカテゴリをそれぞれ生み出す、積み重なった構造的な理由がある。
規制物質。 DEAの規則(21 CFR Part 1311)は規制物質の電子処方(EPCS)を許可しており、現在35の州がこれを義務化している。しかし、スケジュールII薬物(オピオイド、覚醒剤、その他乱用リスクの高い医薬品)は、依然としてかなりの量が紙で届く。DEAはEPCSに対し、二要素認証、身元確認、第三者監査を受けたソフトウェアを要求している。DEA自身のEPCSに関するFAQによると、連邦レベルでの参加は任意である。多くの小規模な処方者は、EPCS認証ソフトウェアのコンプライアンス負担が診療に見合わないとして、紙を選択する。スケジュールIIの麻薬については、2026年現在も、改ざん防止処方箋用紙への手書き署名が法的な代替手段として残っている。
小規模診療所のギャップ。 92%の処方者が電子処方の機能を持っている一方で、実際の一貫した使用は別問題である。独立開業医、個人診療医、歯科医、獣医、地方の専門医は、機能を持たない8%の中に、また機能を持ちながらも一貫して使用しない人々の中に、不均衡に多く含まれる。術後の痛み止めを処方する歯科医はEHRを持っていない。犬を治療する獣医は、地域の薬局との間にNCPDP SCRIPT標準インターフェースを持っていない。これらは例外的なケースではない。これらを合計すると(米国では歯科医だけで約155,000人の開業医がいる)、紙の処方箋の永続的な供給源となる。
州法のパッチワーク。 35の州がEPCSを義務化しているが、その範囲は州によって異なる。すべての規制物質を対象とする州もあれば、オピオイドのみを対象とする州、すべての処方箋を対象とする州(ニューヨーク州教育法に基づき2016年以降のニューヨーク州)もある。残りの州には義務化がない。義務化されていない州で発行され、義務化されている州で調剤される処方箋、あるいはその逆は、法的なグレーゾーンで運用され、多くの場合、紙に戻ってしまう。
患者の好みと携帯性。 すべての患者が、価格を比較する前に処方箋を特定の薬局に固定されることを望むわけではない。紙の処方箋は、患者に価格を比較する自由を与える。現金払いの無保険患者にとって、これは重要である。薬局のカウンターで価格に驚いた経験のある人にとって(Surescriptsのデータによると、紙の処方箋の28%はどの薬局にも届けられない。研究者はこれを「一次ノンアドヒアランス」または「処方漏れ」と呼ぶ)、手元にある紙の処方箋は、少なくとも患者にどこでいつ調剤するかの裁量を与える。
その結果、紙の処方箋の取扱量には、ネットワークをどれだけ拡大しても解消できない構造的な下限が生じている。紙は自然に消えていく過渡的な問題ではない。それは処方エコシステムの恒久的な特徴であり、恒久的な紙は恒久的な手動データ入力を意味する。
キーボードの向こう側にいる人間
これまでのコストは、エラー、電話、システムの非効率性として測定されてきた。しかし、別の台帳が存在する。それは、手動データ入力がそれを実行する人々に何をもたらすかを追跡するものだ。
BLSが2024年に計上した490,400人の薬局テクニシャンは、圧倒的に女性が多い(Data USAによると77.7%)。彼女たちの賃金中央値は43,460ドルで、全職業の全国中央値を下回っている。その仕事は、キーを打つたびに患者の安全に直接影響を与えるという責任を負っている。この仕事は、臨床データ検証の認知的負荷と、小売店のレジのような処理速度のプレッシャーを兼ね備えており、手動データ入力はその両方の交差点に位置している。
「データ入力は、薬局業務における隠れたボトルネックとなっています。特に、早朝、週末明け、または休日期の backlog の後が顕著です」と、Rx30およびComputer-Rx薬局プラットフォームを手掛けるOutcomes社による2024年の分析は指摘する。「テクニシャンや薬剤師は、他の何かを進める前に、手動入力を必要とする処方箋のキューに埋もれて一日を始めることがよくあります。」
そのボトルネックは、アメリカ中のすべての薬局で毎週月曜日の朝に感じられている。1日300件の処方箋を処理する小売薬局では、地域の処方医の構成や規制物質の量にもよるが、そのうち60~90件が紙で届く可能性がある。1件あたり30秒の入力として、1日あたり30~45分の途切れないタイピングが必要となる。これは、患者からの質問、保険の却下、電話、薬剤師による確認作業といった中断を一切考慮しない場合の数字だ。PioneerRxやQS/1 NRxを導入する薬局のように、1日500件以上の処方箋を処理する繁忙店では、専門ステーションにワークフローを再編成するのが一般的だが、データ入力だけで1日に数時間のテクニシャン労働を消費する可能性がある。
r/PharmacyTechnicianでは、身体的および認知的負担が繰り返し話題に上る。あるベテランテクニシャンは次のように述べている。「私の薬局では、患者一人に対応する間に処方箋を一件入力する、という経験則を使っています。」このリズム——処方箋を入力し、患者に対応し、処方箋を入力し、電話に出る——は、紙で届く処方箋に対する手動データ入力から逃れられない職業の日常的なテンポである。BLSによると、この業界の雇用は2034年までに6.4%成長すると予測されており、労働力は拡大する。しかし、テクニシャンを burnout に追い込む根本的なワークフローは、データ入力のパラダイム自体が変わらない限り、変わらないだろう。
入力方法の別の選択肢
分析のこの時点で、問いは「どれほど深刻か」から「何ができるか」へと移る。そして2026年における答えは、推測ではなく、実運用レベルにある。
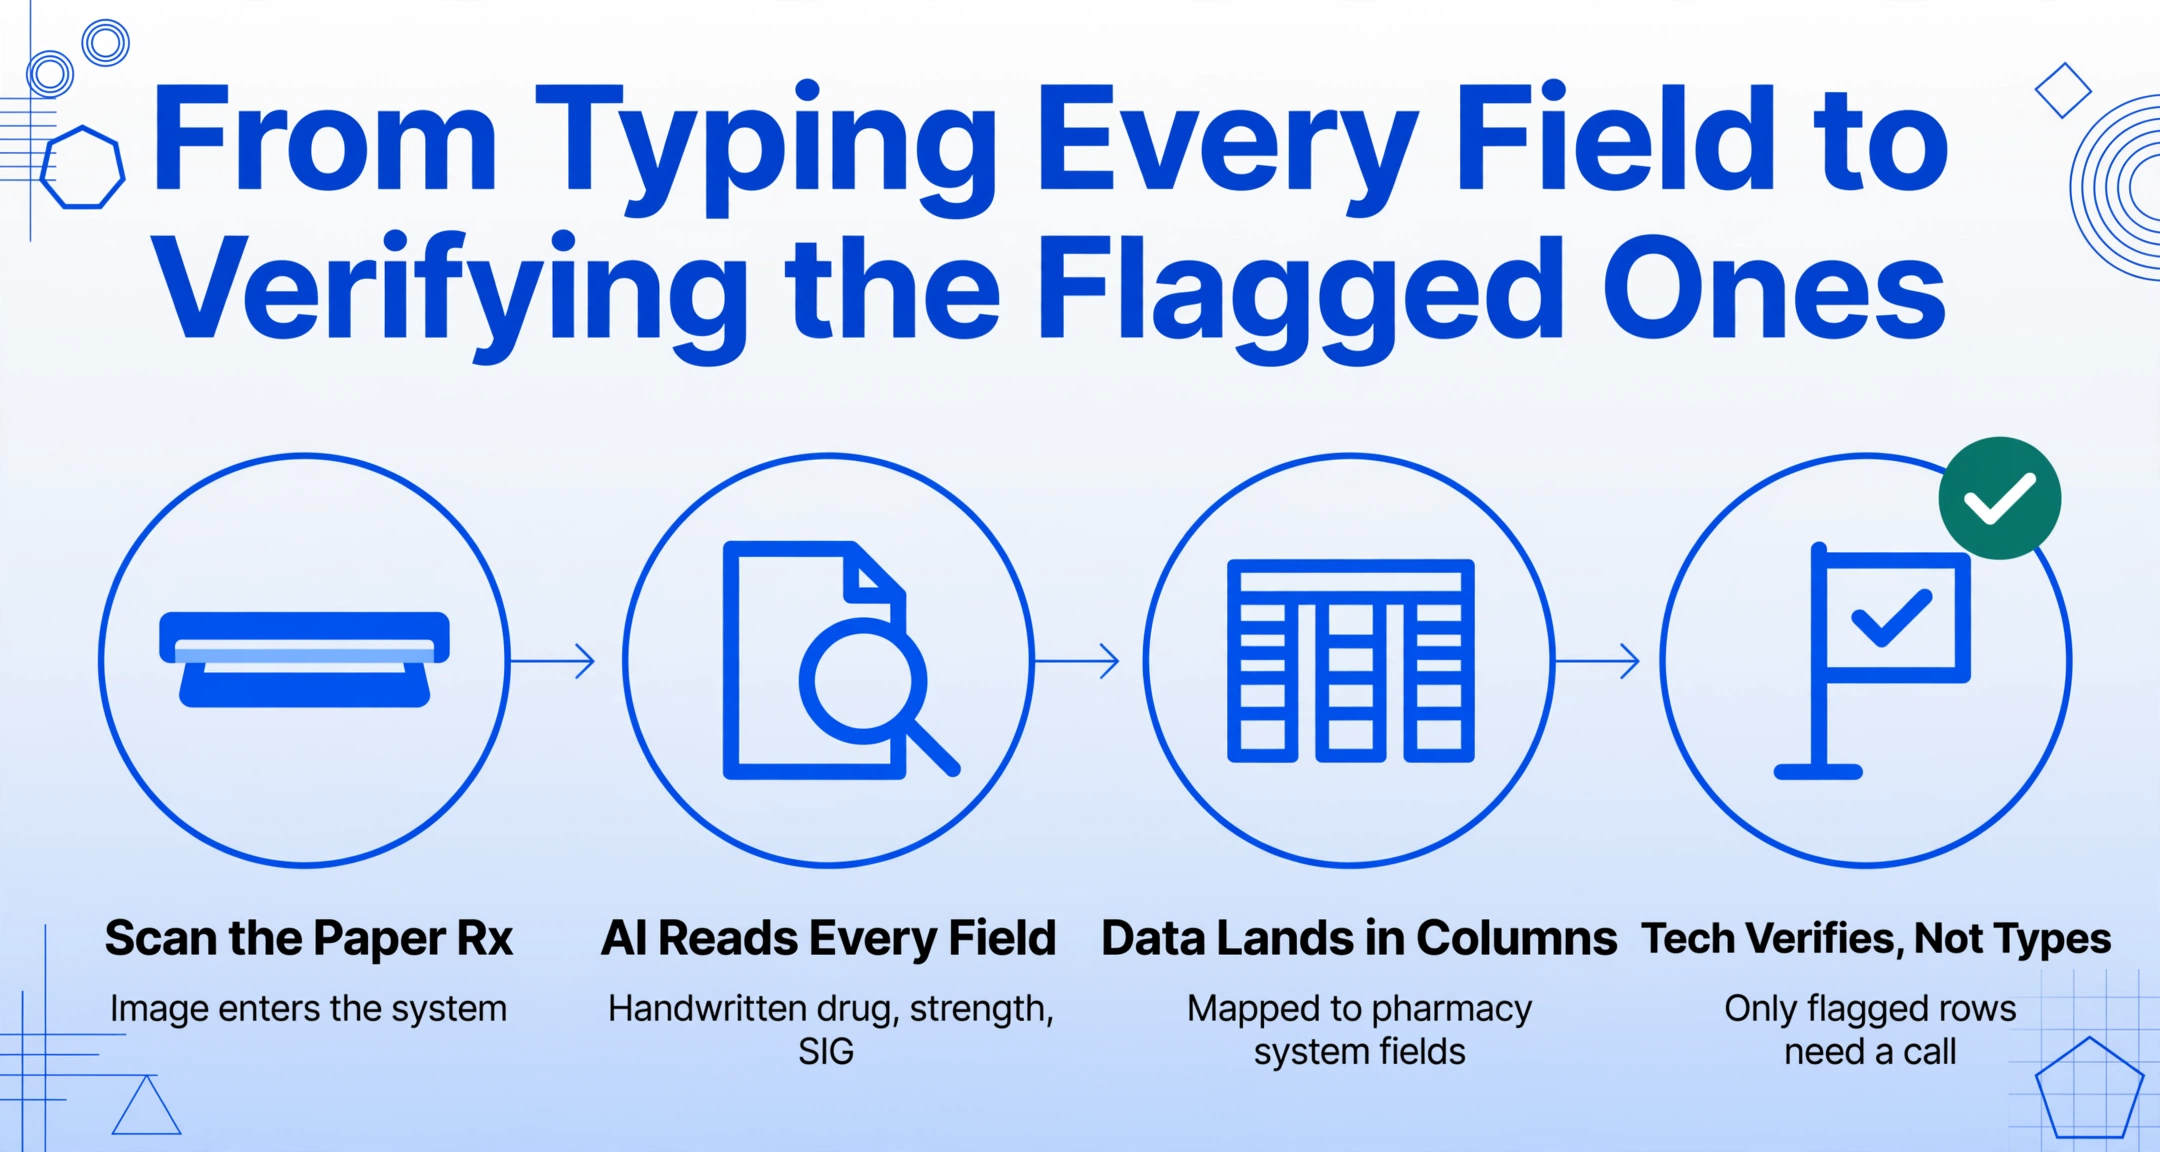
スキャンされた処方箋画像を読み取り、構造化データ(薬剤名、用量、NDC、SIG、数量、処方医のDEA番号など)を抽出することを可能にする基盤技術は、さまざまな業界で最新の文書抽出を支えているものと同じ種類のビジュアルAIである。これはテンプレートの照合(スミス医師の処方箋とパテル医師の処方箋は見た目が異なる)ではなく、文書の意味内容を理解することで機能する。手書き文字を読み取り、フィールドを識別し、それらをターゲットのデータ構造(この場合は薬局管理システムの入力画面)にマッピングする。
このアプローチは、カスタム列抽出として知られ、従来のワークフローを逆転させる。文書がどのデータがどこに存在するかを決定する代わりに、ユーザーが必要とする出力列(薬剤名、力価、NDC、数量、日数分、SIG、処方医NPI)を定義する。AIは、ページ上の位置を照合するのではなく、各値の意味を理解することで処方箋上の各値を特定する。手書きの「Amoxicillin 500 mg」は、筆記体がどれほど傾いていようと、どの行にあるか、パッドの上部か下部かに関係なく、薬剤名と力価のペアとして認識される。
薬局の文脈では、これはテクニシャンの仕事が転記(紙の処方箋を読んで全フィールドを入力する)から検証(AIの抽出結果が原本と一致するかを確認する)へと変わることを意味する。この検証ステップは薬局のワークフローにすでに存在する。薬剤師は、データが人間の手で入力されたかAIによるものかにかかわらず、州委員会の規制に従い、調剤前にすべての処方箋の最終チェックを行わなければならない。AIは安全性チェックを迂回しない。臨床的価値のないワークフロー部分、つまり機械的な再入力だけを排除する。
規制の側面にも直接言及する価値がある。HIPAAの下では、処方データ(患者名、生年月日、投薬履歴などの保護対象保健情報(PHI)を含む)を処理するシステムは、適切な保護措置を維持しなければならない。これは薬局管理システム、電子処方ネットワーク、保険審査プラットフォームを統治するものと同じコンプライアンス枠組みである。処方箋画像を処理するデータ抽出ツールはこの枠組みの中で動作する。重要な選定基準は、ベンダーがHIPAA準拠の処理環境とビジネスアソシエイト契約(BAA)を提供しているかどうかである。AI抽出とHIPAA要件の交差点についてさらに詳しく知りたい場合は、医療文書抽出のHIPAAコンプライアンスガイドで解説している。
これは仮想的なインフラではない。メニュー形式のレストラン領収書から15以上の項目を抽出し、入れ子構造のテーブルを持つ複数ページの保険給付明細書(EOB)を解析できるのと同じビジュアルAIが、1ページの手書き処方箋も処理できる。処方箋は、多くの点でより単純なドキュメントである。データポイントが少なく、レイアウトがより標準化され、薬剤名、用量、SIGコードの語彙も限られている。課題は技術的な実現可能性ではなかった。課題は、既存システムが深く根を張る老舗企業が支配する薬局ソフトウェア市場が、データ入力ワークフローへの抽出機能の統合に時間がかかってきたことだ。しかし、それは変わりつつある。Rx30とComputer-Rxを手がけるOutcomesは、2024年に自社プラットフォーム上で電子処方箋の自動データ入力を開始した。次の論理的なステップである紙の処方箋画像からの自動抽出は、テクノロジーがすでに能力を備え、需要が待っている領域だ。
薬局テクニシャンにとって、その影響は即時的かつ測定可能だろう。現在30秒かかる処方箋の入力が、AI抽出に対する5〜10秒の検証になるかもしれない。その差は量に応じて積み重なる。1日60枚の紙の処方箋は、30分のタイピングから5〜10分の検証に短縮される。テクニシャンの認知的負荷は、手書き文字の解読から出力のスポットチェックへと移行する。これは、彼らが訓練を受けた臨床検証に近いタスクであり、従事させられたデータ入力ではない。
処方箋フィールド(薬剤名、用量、NDC、数量、リフィル、処方医のDEA/NPI)を構造化スプレッドシートに抽出するステップバイステップのワークフローに興味があれば、薬局在庫と保険請求のための処方箋データ抽出ガイドで全プロセスを詳述している。処方箋の文脈で抽出精度に影響を与える項目別の分析(NDC形式の複雑さ、LASA(名称類似)薬剤の混同、州のPMP要件を含む)については、処方箋抽出精度ガイドを参照してほしい。
この問題、つまり紙ベースのワークフローに対する見えない税金としての手動データ入力は、薬局に限ったことではない。同じ力学は医療請求でも見られる。EOBフォームが郵便で届き、診療管理システムに再入力しなければならないのだ。私たちは、医療請求における手動EOBデータ入力コストに関する詳細な分析で、並行するコストを分析した。パターンは医療全体で同じだ。紙が入り、人間がタイピングし、エラーが蓄積し、コストが膨らむ。そのパターンを打ち破るテクノロジーは今、存在する。
よくある質問
現在も紙で処方される処方箋はどのくらいありますか?
92%の処方者が電子処方を採用し、2025年にはSurescriptsネットワークを通じて約26.4億件の電子処方箋が調剤されましたが、依然としてかなりの量が紙、電話、またはFAXで届いています。総小売処方箋数は年間約50億件と推定されており、約20億件の非電子処方箋が薬局ワークフローに投入されています。ただし、これらすべてが文字通りの「紙」処方箋というわけではありません。電話注文、FAX、規制物質の紙処方箋はすべて、薬局管理システムへの手動データ入力が必要です。電子処方箋と手動入力処方箋の正確な割合は、州、薬局の種類、処方者の構成によって異なります。
薬局は処方箋をスキャンしてコンピューターに読み取らせればよいのでは?
PioneerRx、QS/1 NRx、Computer-Rx、Rx30などの従来の薬局管理システムは、手書き文字認識や意味的文書理解を目的として構築されていません。これらはトランザクション処理および調剤ワークフロープラットフォームです。スキャンは画像(参照ファイル)を作成しますが、システムはその画像から構造化データを抽出する機能を持ちません。薬局テクニシャンは画像を読み取り、各フィールドを手入力する必要があります。新しいAIベースの文書抽出ツールは、スキャン画像を読み取り、フィールドを意味的に理解し、構造化データを出力することでこのギャップを埋めることができますが、レガシーPMSプラットフォームとの統合はまだ標準化されていません。
手動処方データ入力で最も一般的なエラーは何ですか?
最も頻繁に発生するエラーは、主に3つの領域に集中しています。薬剤名の混同(特にprednisone/prednisoloneやclonidine/KlonopinなどのLASAペア)、SIGの誤解釈(QDとQID、「1日1回」と「1日4回」—手書きでは1文字違いですが、投与量は4倍の差があります)、および数量の数値エラー(手書きの7を9と、1を7と誤読するケースが多く、特にリフィル数や日数供給フィールドで発生します)。2023年のAnnals of Medicine & Surgeryの系統的レビューでは、処方箋の1.7%から24%が誤って調剤されており、主な原因として手書きの判読困難性が挙げられています。
AI処方箋抽出は規制物質の処方箋でも機能しますか?
はい — ビジュアルAIは、スケジュールII〜Vの処方箋からも、非規制処方箋と同様にデータを読み取り抽出できます。筆跡、フィールド、データ構造は同一です。異なるのは抽出データの規制上の取り扱いです。規制物質の処方箋には、DEA番号の確認、処方監視プログラム(PMP)のチェック、記録保存に関する追加の法的要件があります。AI抽出ツールはこれらのコンプライアンス手順を代替するものではなく、データ入力部分を処理し、規制物質確認に関する既存の薬局ワークフローはそのまま維持されます。重要な要件は、抽出ツールがHIPAA準拠の環境で、署名済みのビジネスアソシエイト契約(BAA)のもとで運用されることです。
これは薬剤師による確認ステップを代替しますか?
いいえ。すべての州において、薬剤師は調剤前にすべての処方箋に対して最終確認を行うことが法的に義務付けられています — 元の処方箋と入力データの照合、薬物相互作用の確認、臨床的妥当性の検証、ラベルの正確性の確認などです。AI抽出は、確認に先立つデータ入力ステップ、すなわち手書き処方箋を読み取りPMSフィールドに入力する部分を処理します。薬剤師の臨床的判断、薬剤使用評価(DUR)、最終的な正確性チェックは変わりません。変わるのは、薬剤師とテクニシャンが転記に費やす時間が減り、その分、資格を活かした臨床業務に多くの時間を割けるようになることです。
薬局のデータ入力ボトルネックは自然には解決しません。紙の処方箋はなくならないからです。しかし、それらを読み取り、内容を抽出し、PMSのフィールドに入力する技術はすでに存在します。
処方箋をアップロードファイルは安全に処理され、保存されません。