Das Rezept-Neuabtippen:
Papier-Rezepte und die Dateneingabelast der Apotheken
Im Jahr 2025 füllten amerikanische Apotheken schätzungsweise 5 Milliarden Rezepte aus. Davon kamen etwa 2,64 Milliarden elektronisch über das Surescripts-Netzwerk an. Der Rest – mehr als 2 Milliarden Rezepte – erreichte die Apothekenschalter per Papier, Telefon oder Fax. Jedes einzelne davon musste manuell in ein Apothekenverwaltungssystem eingetippt werden, Feld für Feld, Tastendruck für Tastendruck, von einem von 490.000 Apothekentechnikern im ganzen Land. Es ist ein Volumen manueller Dateneingabe, das in keinem anderen Sektor des Gesundheitswesens seinesgleichen hat – und fast niemand außerhalb der Apotheke hat es je mit eigenen Augen gesehen.
Wichtigste Erkenntnisse
- Rund 2 Milliarden Rezepte erreichen US-Apotheken jedes Jahr auf Papier oder per Telefon – und jedes einzelne wird manuell in die Apothekensoftware neu abgetippt, Feld für Feld, von einem Techniker an der Tastatur.
- Die 92-prozentige Einführung des E-Rezepts stößt an eine dauerhafte Grenze – kontrollierte Substanzen, Zahnarztpraxen, Tierkliniken und preisbewusste Patienten bilden ein strukturelles Mindestmaß an Papier, das keine Netzerweiterung beseitigen kann.
- KI, die Handschrift nach semantischer Bedeutung statt nach Vorlagenposition liest, kann eine 30-sekündige manuelle Übertragung in einen 5-sekündigen Prüfschritt verwandeln – die Sicherheitskontrolle des Apothekers bleibt, das Neuabtippen verschwindet.
Die Reise des Papierrezepts beginnt dort, wo E-Prescribing aufhört
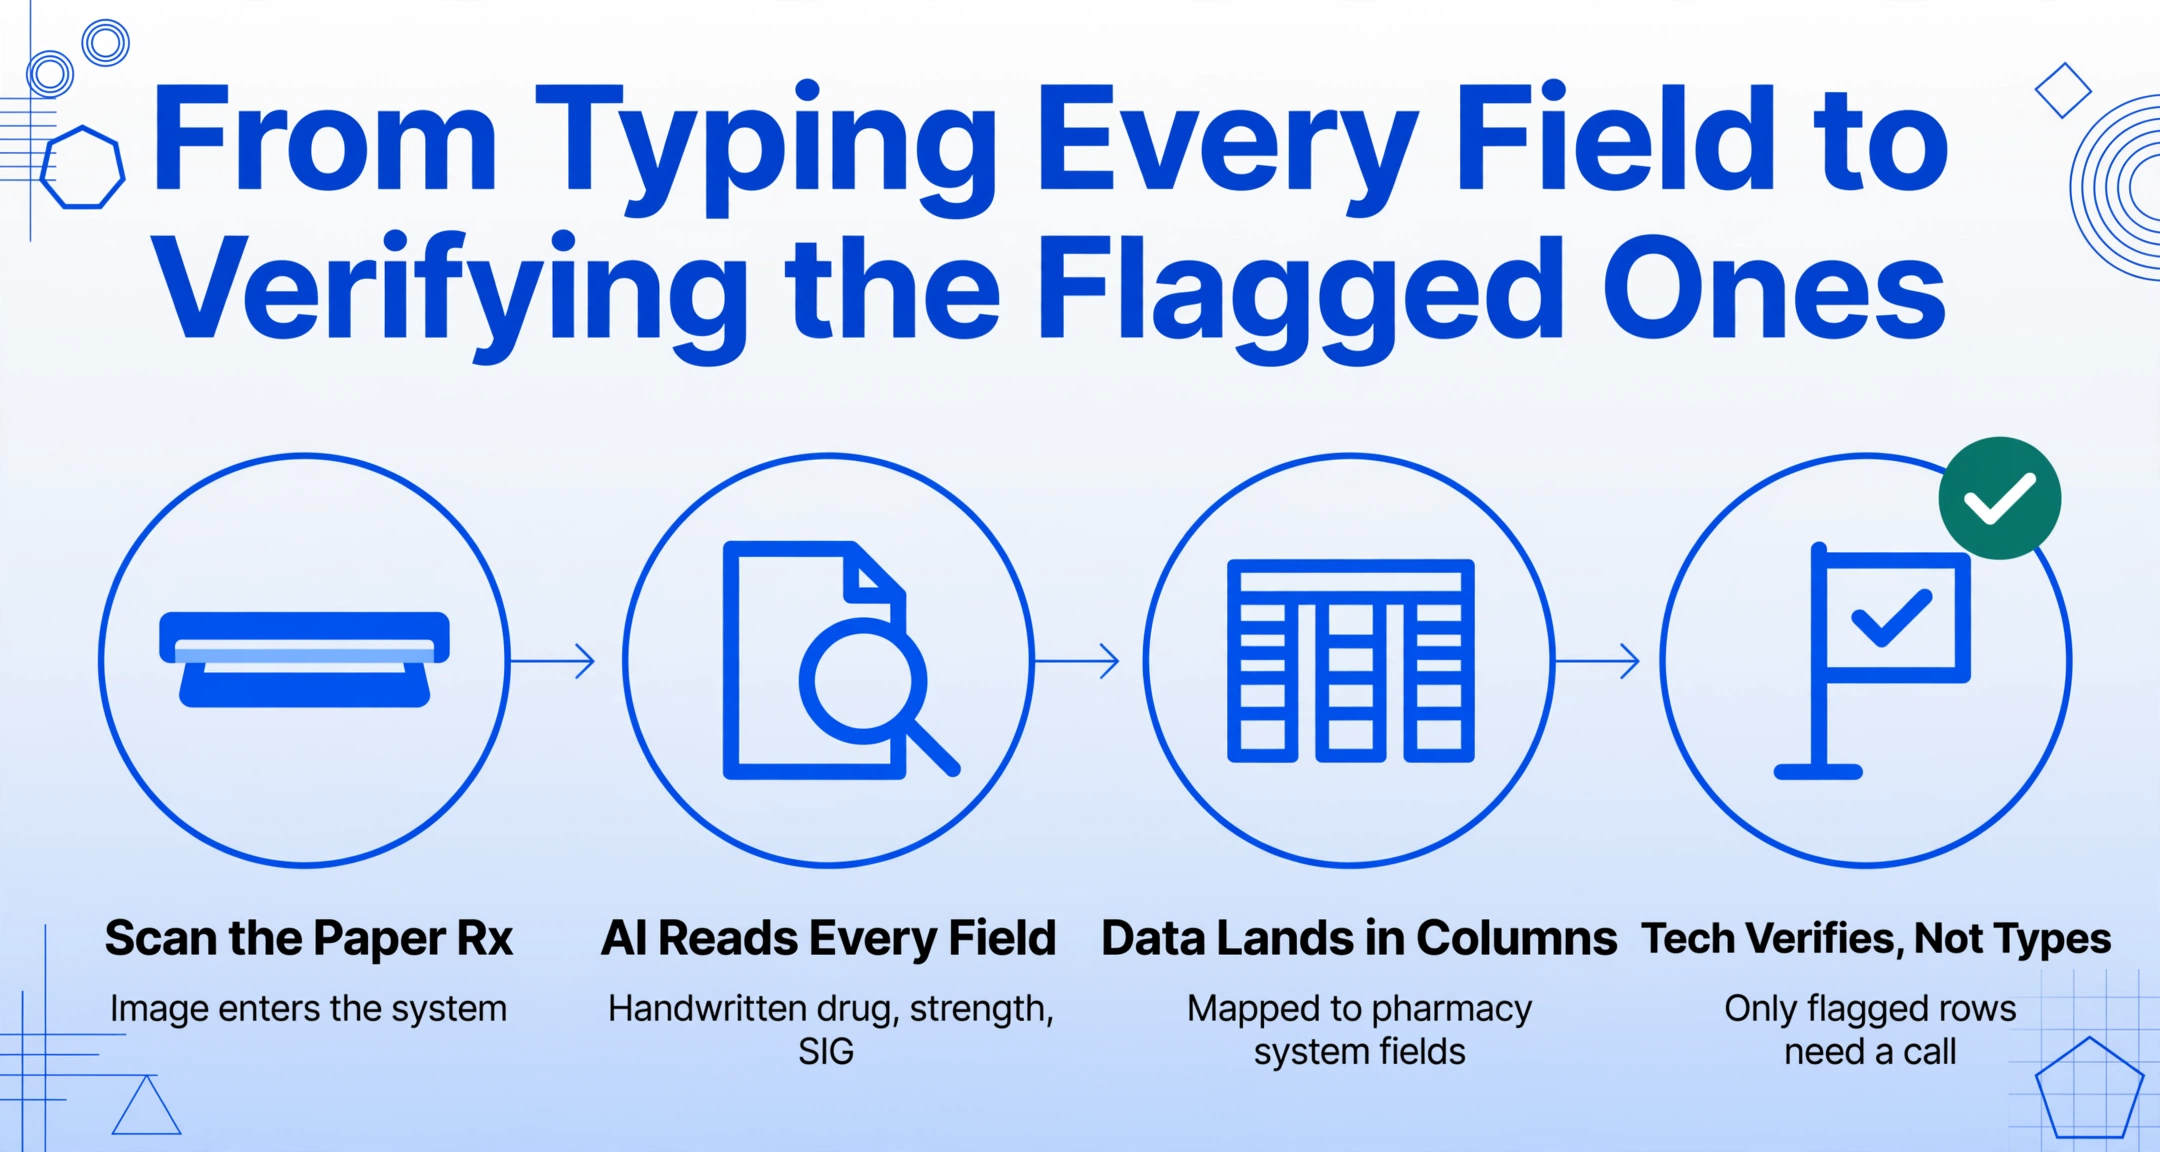
Zunächst gilt es zu verstehen, wie sich ein Papierrezept tatsächlich bewegt. Ein Arzt in einer kleinen Privatpraxis — vielleicht einer der rund 8 % der Verschreiber, die laut ONC-Daten die E-Prescribing noch nicht eingeführt haben — schreibt ein Rezept auf einem Block. Der Patient bringt es in die Apotheke. Ein Techniker am Annahmeschalter scannt es in das Apothekenverwaltungssystem (PMS). Und dieser Scan, dieses Bild eines Blattes Papier mit der Handschrift eines Arztes darauf, ist der Punkt, an dem die manuelle Arbeit beginnt.
Das Apothekenverwaltungssystem versteht das Bild nicht. Es kann die Handschrift nicht parsen. Es hat kein semantisches Modell dafür, was ein Rezept bedeutet. Das Bild liegt dort als Referenzbild — und die Aufgabe des Technikers besteht darin, alles darauf zu extrahieren, in strukturierte Daten zu übersetzen und in die Datenerfassungsmaske des Systems einzutippen. Nachfüllzähler lesen diese Felder von der Flasche ab — die Medikamentenname, Dosierung und Häufigkeit auf einem Foto des Rezepturetiketts.
Diese Maske — je nachdem, welches PMS die Apotheke verwendet: PioneerRx, QS/1 NRx, Computer-Rx, Rx30 oder eines der Dutzenden anderen, die von Unternehmen wie RedSail Technologies und Outcomes gepflegt werden — zeigt zwischen 15 und 20 einzelne Felder. Jedes muss ausgefüllt werden. Jedes ist ein Entscheidungspunkt. Jedes ist eine Gelegenheit für Fehler.
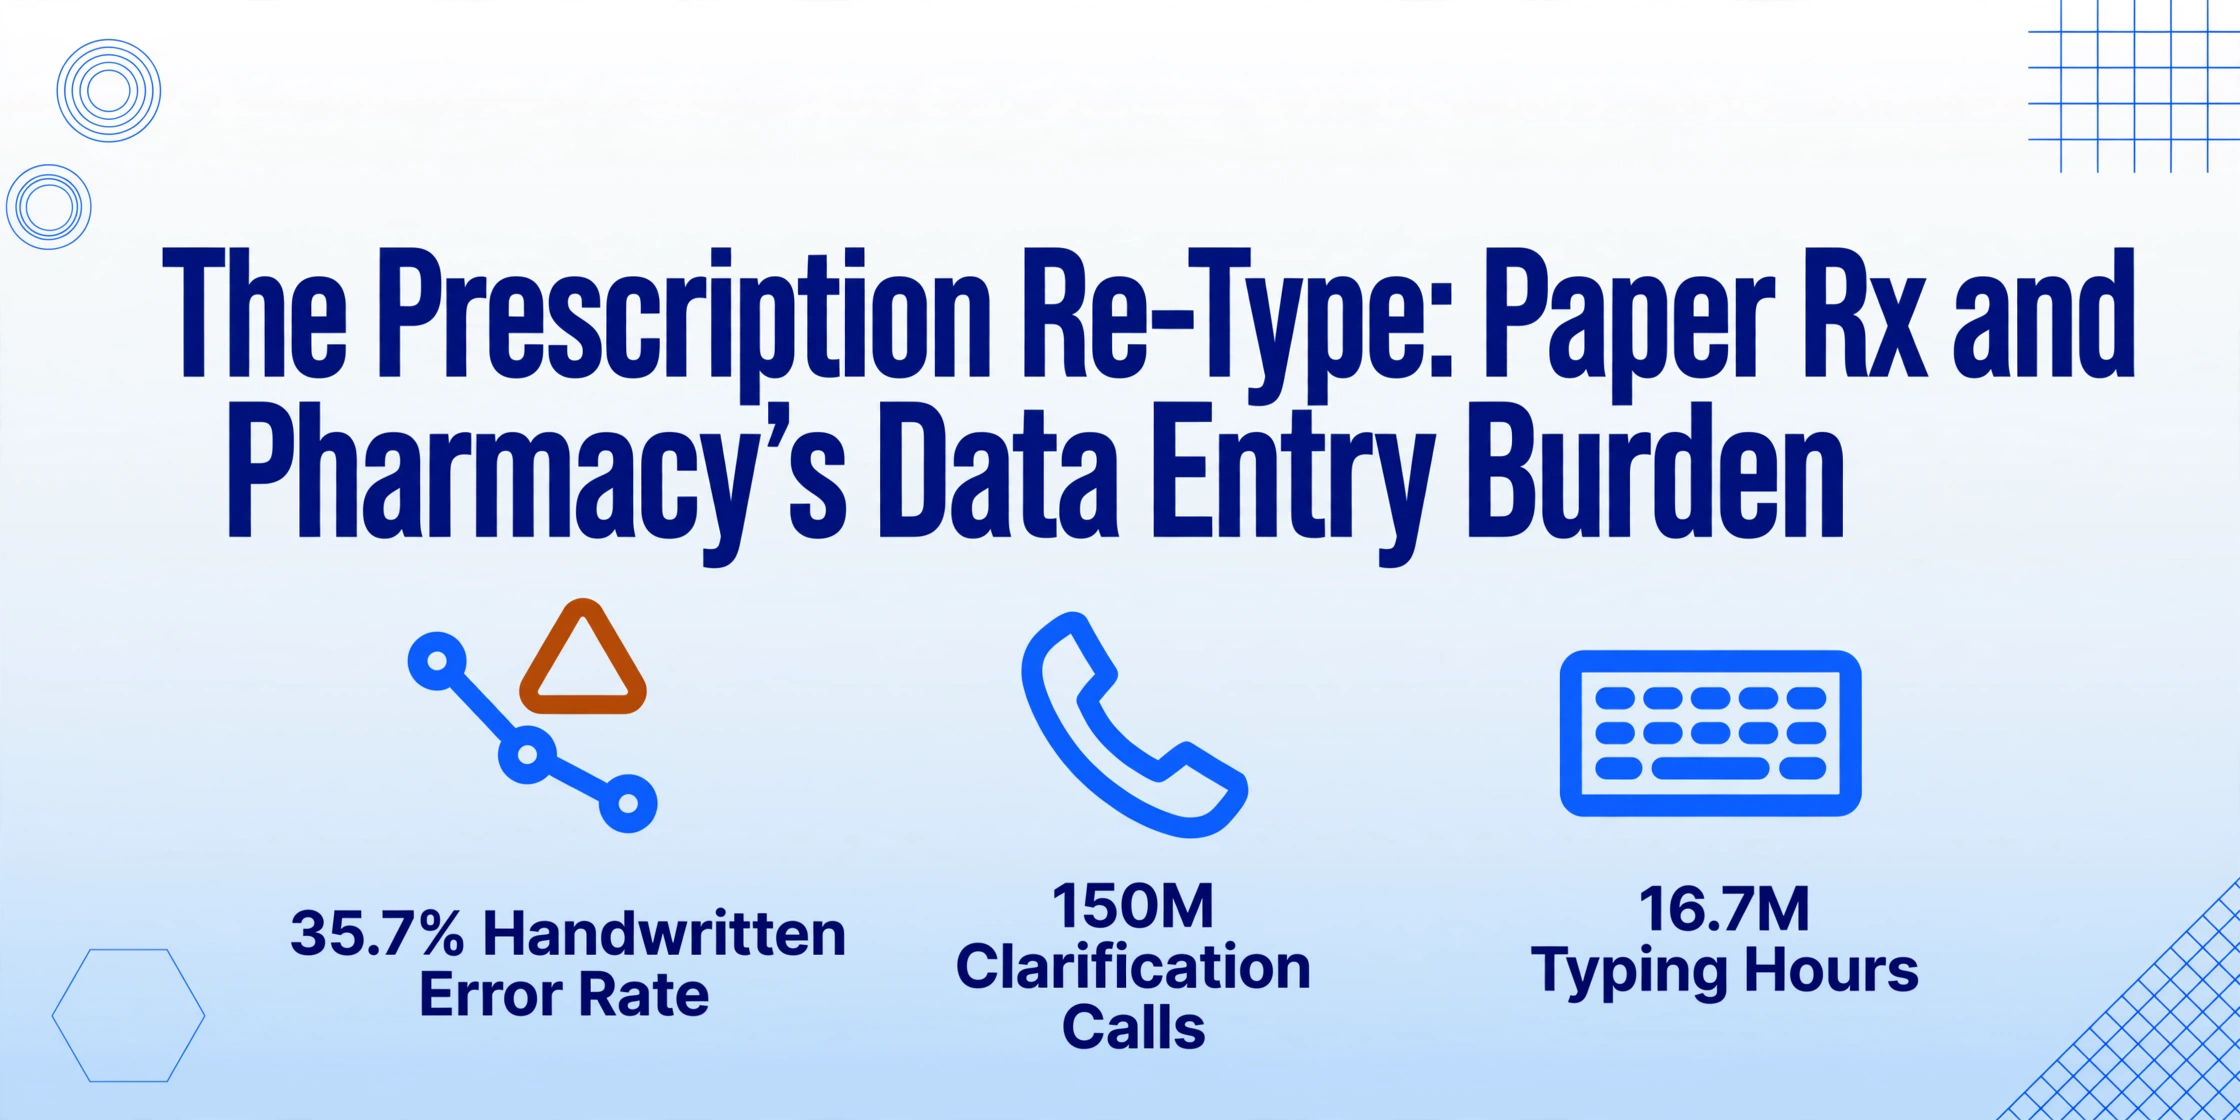
Das schiere Ausmaß dieses Workflows entzieht sich einer einfachen Veranschaulichung. Bei 2 Milliarden nicht-elektronischen Rezepten pro Jahr und einer durchschnittlichen Dateneingabezeit von etwa 30 Sekunden pro Rezept — eine Zahl, die von Technikern in Foren wie r/pharmacy häufig genannt wird — sind die gesamten Arbeitskosten atemberaubend: etwa 16,7 Millionen Stunden manueller Dateneingabe pro Jahr, die fast ausschließlich von Apothekentechnikern geleistet werden, die laut Bureau of Labor Statistics einen Median von $43.460 pro Jahr verdienen (Mai 2024).
Der 15-Felder-Parcours: Was an der Tastatur wirklich passiert
Um zu verstehen, warum das nicht nur „Tippen" ist – warum es ein kognitiver Parcours und keine reine Schreibarbeit ist –, muss man die Felder sehen. Hier ist, was ein Techniker an einem typischen Dateneingabebildschirm für ein einzelnes Rezept erlebt, basierend auf dem Standard-Feldlayout aus Lehrplänen für Pharmazie-Techniker und sichtbar im Dateneingabe-Simulator des Pharmacy Skills Lab:
| Feldkategorie | Einzelne Felder | Datenquelle |
|---|---|---|
| Patient | Name, Geburtsdatum, Adresse, Telefon | Papierrezept + mündlich vom Patienten |
| Verschreiber | Name, NPI (10-stellig), DEA-Nummer, Praxisadresse, Telefon | Papierrezept (oft gekritzelt) |
| Medikation | Medikamentenname, Stärke, Darreichungsform, NDC (11-stellig) | Papierrezept – handschriftlicher Medikamentenname entziffert |
| Abgabe | Menge, Tageversorgung, genehmigte Nachbestellungen, DAW-Code | Papierrezept + Berechnung durch den Techniker |
| Anweisungen | SIG (Verb + Dosis + Einnahmeweg + Häufigkeit + Zusatzinfo) | Papierrezept – oft abgekürzt, in Schreibschrift, mehrdeutig |
| Verwaltung | Ausstellungsdatum, Nicht-vor-Datum, Rezeptursprung-Code | Papierrezept + behördliche Anforderungen des Bundesstaats |
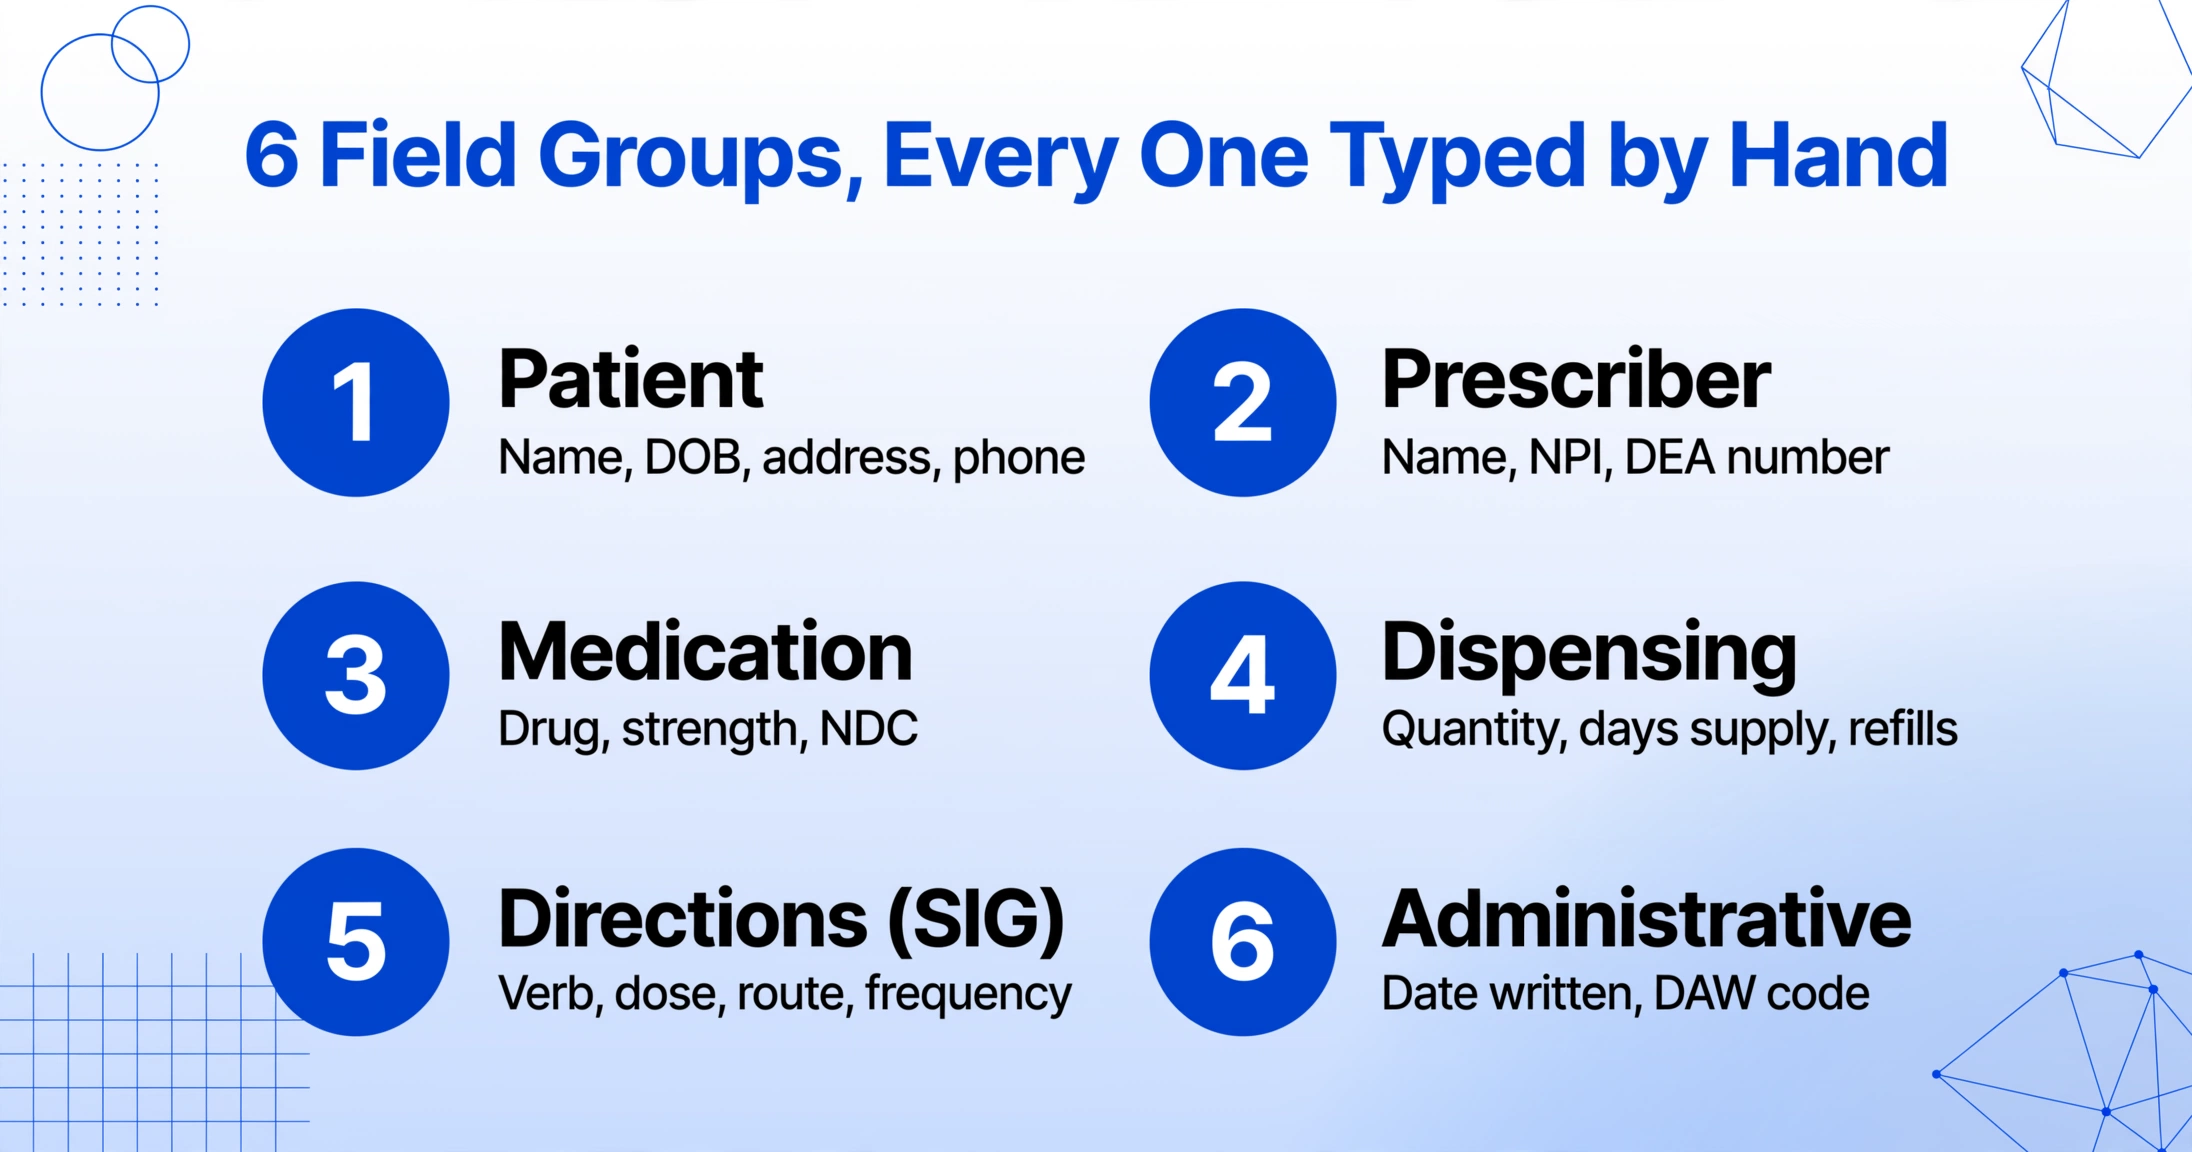
Das sind ungefähr 18 bis 20 einzelne Informationen pro Rezept, die jeweils gegen das Papieroriginal geprüft werden müssen. Und das Papieroriginal – das Beweisstück, mit dem der Techniker abgleichen soll – ist der Kern des Problems. Es ist handschriftlich. Oft in Schreibschrift. Häufig hastig. Manchmal von einem Verschreiber, dessen Handschrift der Techniker noch nie gesehen hat.
Auf Reddits r/PharmacyTechnician beschrieb ein Auszubildender die Erfahrung unverblümt: „Ich schwöre, die Hälfte davon war unleserlich! Sollen wir wirklich wissen, was die Verschreiber wollen, wenn sie nicht einmal richtig schreiben können?"
Diese Frage ist nicht nur ein Ausdruck von Frustration. Sie offenbart einen strukturellen Konflikt: Das Verschreibungssystem ist darauf ausgelegt, dass ein Mensch die Handschrift eines anderen Menschen liest – im Tempo des Stifts des Verschreibers. Das Abgabesystem hingegen verlangt strukturierte, maschinenlesbare Daten – im Tempo einer Schlange wartender Patienten. Der Pharmazie-Techniker ist die Übersetzungsebene zwischen diesen beiden inkompatiblen Systemen – und die Übersetzung ist konstruktionsbedingt fehleranfällig.
Was Handschrift wirklich kostet: Fehler, Rückfragen und Leben
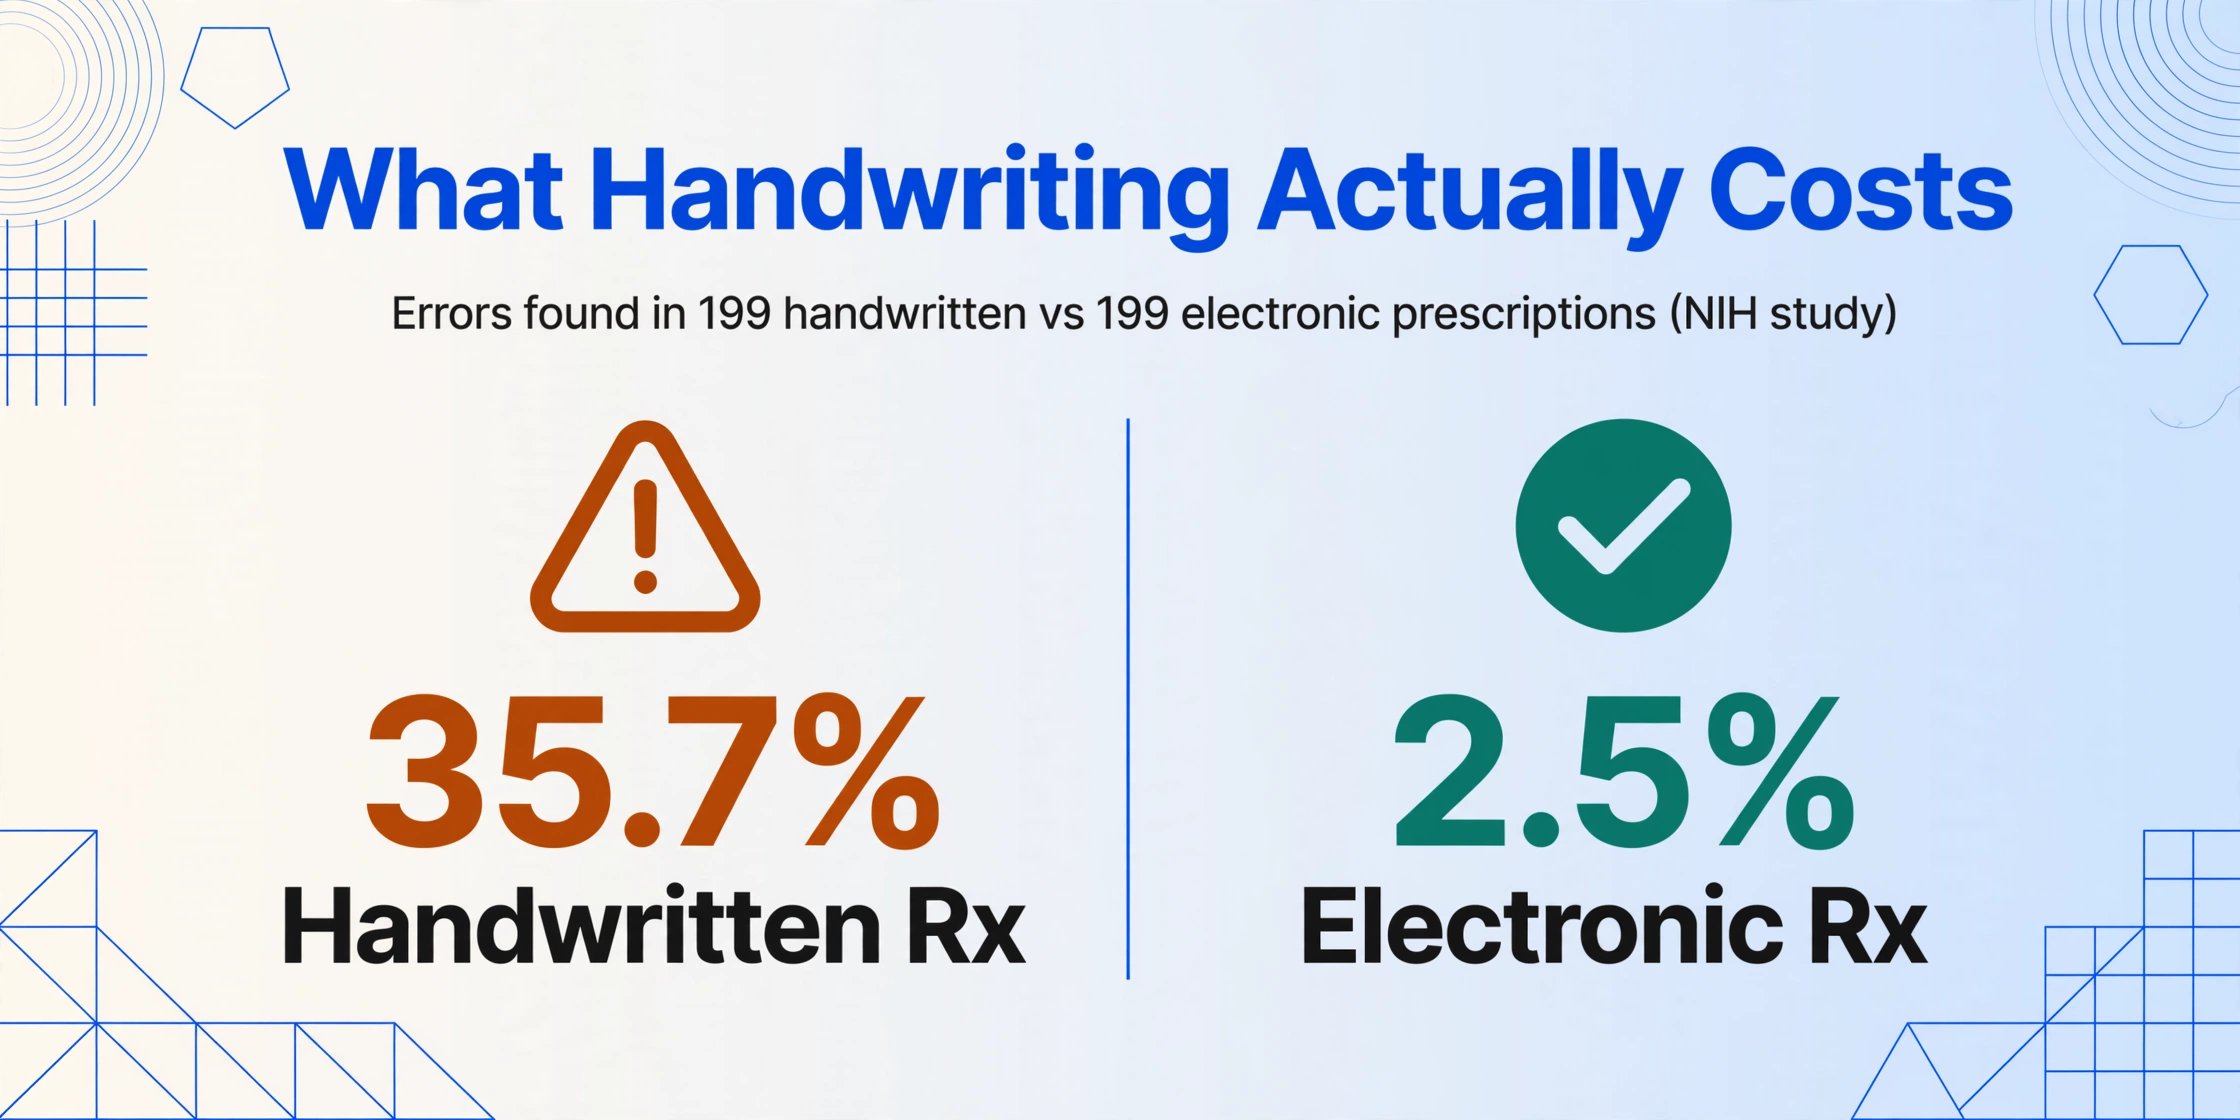
Die Fehlerraten sind nicht marginal. Eine Studie der National Institutes of Health untersuchte 398 Rezepte – 199 handschriftliche, 199 elektronische – und fand Fehler bei 35,7 % der handschriftlichen Rezepte gegenüber nur 2,5 % der elektronischen. Eine separate Forschungsarbeit, zusammengefasst in einem systematischen Review von 2023 in den Annals of Medicine & Surgery, schätzt, dass zwischen 1,7 % und 24 % aller Rezepte fehlerhaft ausgeliefert werden, wobei 1,5 % bis 4 % dieser Fehler zu Patientenschäden führen. Das Institute of Medicine bringt jährlich mehr als 7.000 Todesfälle mit Medikationsfehlern in Verbindung, die auf schlechte Handschrift und Fehler bei der Rezeptabwicklung zurückzuführen sind.
Aber die Fehlerzahlen messen nur, was erwischt wird. Sie messen nicht die Reibung – die systemweiten Kosten der Unsicherheit, die jedes Papierrezept belasten.
Wenn ein Techniker einen Medikamentennamen nicht lesen kann, oder nicht erkennen kann, ob die SIG „QD“ (einmal täglich) oder „QID“ (viermal täglich) bedeutet, oder nicht sicher ist, ob die handschriftliche Zahl im Mengenfeld eine 7 oder eine 9 ist, stoppt das Rezept. Der Techniker markiert es. Der Apotheker ruft die Praxis des Verschreibers an. Das Praxispersonal prüft die Akte. Der Verschreiber ruft zurück. Der Apotheker verifiziert. Die Dateneingabe wird fortgesetzt.
Schätzungsweise 150 Millionen solcher Klärungsanrufe gehen jährlich in den USA von Apotheken an Verschreiber, laut Branchendaten. Das sind 150 Millionen Unterbrechungen in der Medikamentenversorgungskette – jede einzelne ausgelöst durch die Kluft zwischen einem hingekritzelten Stück Papier und einer Datenbank, die Präzision verlangt.
Die gefährlichsten Fehler häufen sich bei den sogenannten „LASA“-Medikamenten – Look-Alike-, Sound-Alike-Paaren. Prednison und Prednisolon. Clonidin und Klonopin. Celebrex und Celexa. Wenn die Handschrift eines Verschreibers „Celebrex 200 mg“ in ein Gekritzel verwandelt, das für beide Medikamente stehen könnte, ist der Unterschied zwischen einem Entzündungshemmer und einem Antidepressivum – oder der Unterschied zwischen 1 mg und 10 mg Warfarin, wie Pharmacy Times in einer detaillierten Analyse der Dateneingabegenauigkeit dokumentierte – eine Entscheidung auf Tastendruck-Ebene, die auf dem Techniker lastet.
Warum E-Rezepte die Arbeit nicht beendet haben
Angesichts des Ausmaßes des Problems liegt die Frage nahe: Warum läuft nicht längst alles elektronisch? Das Surescripts-Netzwerk verarbeitete 2025 2,64 Milliarden E-Rezepte. Laut ONC haben 92 % der Verschreiber die E-Rezept-Funktion eingeführt. Die Infrastruktur existiert. Die Fehlerreduktion ist belegt. Was bremst die flächendeckende Nutzung?
Die Antwort ist nicht eine einzelne Sache. Es ist ein Bündel struktureller Gründe, die jeweils eine Kategorie von Papierrezepten schaffen, die E-Rezepte nicht erreichen:
Betäubungsmittel. Die DEA-Regeln nach 21 CFR Part 1311 erlauben elektronische Verschreibung von Betäubungsmitteln (EPCS), und 35 Bundesstaaten schreiben sie inzwischen vor. Doch Substanzen nach Schedule II – Opioide, Stimulanzien und andere stark suchtgefährdende Medikamente – kommen weiterhin in erheblichem Umfang auf Papier. Die DEA verlangt für EPCS eine Zwei-Faktor-Authentifizierung, Identitätsnachweise und eine von Dritten geprüfte Software. Laut DEA-eigenen FAQ zu EPCS bleibt die Teilnahme auf Bundesebene freiwillig. Viele kleine Praxen wählen Papier, weil der Compliance-Aufwand für EPCS-zertifizierte Software für ihre Praxis nicht lohnt. Bei Schedule-II-Betäubungsmitteln bleibt eine handschriftliche Unterschrift auf einem manipulationssicheren Rezeptblock auch 2026 der rechtliche Ausweg.
Die Lücke bei kleinen Praxen. Zwar haben 92 % der Verschreiber die E-Rezept-Funktion, doch die tatsächliche, konsequente Nutzung ist eine andere Sache. Niedergelassene Ärzte, Einzelpraktiker, Zahnärzte, Tierärzte und Fachärzte in ländlichen Gebieten sind überproportional unter den 8 % ohne Funktion vertreten – und unter denen, die sie haben, aber nicht konsequent nutzen. Ein Zahnarzt, der postoperative Schmerzmittel verschreibt, hat kein EHR. Ein Tierarzt, der einen Hund behandelt, hat keine NCPDP-SCRIPT-Schnittstelle zur örtlichen Apotheke. Das sind keine Randfälle. Zusammengenommen – allein die Zahnmedizin umfasst in den USA etwa 155.000 Praktiker – stellen sie ein dauerhaftes Reservoir an Papierrezepten dar.
Flickenteppich der Landesgesetze. Zwar schreiben 35 Bundesstaaten EPCS vor, doch die Vorschriften unterscheiden sich im Umfang. Manche decken alle Betäubungsmittel ab, andere nur Opioide, wieder andere alle Rezepte generell (New York seit 2016, gemäß New York Education Law). Die übrigen Staaten haben keine Vorschrift. Ein Rezept, das in einem Staat ohne Vorschrift ausgestellt und in einem Staat mit Vorschrift eingelöst wird – oder umgekehrt – bewegt sich in einer rechtlichen Grauzone, die oft auf Papier zurückfällt.
Patientenpräferenz und Portabilität. Nicht jeder Patient möchte sein Rezept an eine bestimmte Apotheke binden, bevor er Preise verglichen hat. Ein Papierrezept gibt dem Patienten die Freiheit, zu vergleichen. Für unversicherte Patienten, die bar zahlen, ist das wichtig. Für jeden, der schon einmal einen Preisschock an der Apothekentheke erlebt hat – und Surescripts-Daten zeigen, dass 28 % der Papierrezepte nie in einer Apotheke landen, ein Phänomen, das Forscher „primäre Nicht-Adhärenz" oder „Rezept-Leckage" nennen – gibt das Papier in der Hand dem Patienten zumindest die Kontrolle darüber, wo und wann er es einlöst.
Das Ergebnis: eine strukturelle Untergrenze für das Papier-Rezeptvolumen, die durch keine noch so große Filialerweiterung beseitigt werden kann. Papier ist kein Restproblem, das sich von selbst erledigt. Es ist ein permanentes Merkmal des Rezept-Ökosystems – und permanentes Papier bedeutet permanente manuelle Dateneingabe.
Der Mensch hinter der Tastatur
Bisher wurden die Kosten in Fehlern, Rückfragen und Systemineffizienz gemessen. Aber es gibt noch ein ganz anderes Konto – das, was die manuelle Dateneingabe mit den Menschen macht, die sie ausführen.
Die 490.400 Apothekenfachkräfte, die das BLS 2024 zählte, sind überwiegend Frauen (77,7 %, laut Data USA). Ihr Mediangehalt von 43.460 US-Dollar liegt unter dem nationalen Median aller Berufe – obwohl sie mit jedem Tastendruck direkt die Patientensicherheit beeinflussen. Der Job vereint die kognitiven Anforderungen der klinischen Datenprüfung mit dem Durchsatzdruck einer Kassenschlange – und die manuelle Dateneingabe liegt genau im Schnittpunkt beider.
„Die Dateneingabe ist zu einem versteckten Engpass im Apothekenbetrieb geworden, besonders früh morgens, nach Wochenenden oder nach Feiertagsrückständen", stellt eine Analyse von Outcomes aus dem Jahr 2024 fest, dem Unternehmen hinter den Apothekensystemen Rx30 und Computer-Rx. „Fachkräfte und Apotheker beginnen ihren Tag oft damit, in Warteschlangen von Rezepten zu versinken, die manuell eingegeben werden müssen, bevor irgendetwas anderes weitergehen kann."
Dieser Engpass ist jeden Montagmorgen in jeder Apotheke in Amerika spürbar. Eine Apotheke, die 300 Rezepte pro Tag bearbeitet, könnte je nach Zusammensetzung der verschreibenden Ärzte und dem Volumen an Betäubungsmitteln 60 bis 90 davon auf Papier erhalten. Bei 30 Sekunden pro Eingabe sind das 30 bis 45 Minuten ununterbrochenes Tippen pro Tag – vor Unterbrechungen durch Patientenfragen, Kassenablehnungen, Telefonate oder die Prüfung durch den Apotheker. In geschäftigeren Apotheken mit über 500 Rezepten pro Tag – der Schwelle, ab der Apotheken wie die mit PioneerRx oder QS/1 NRx ihren Arbeitsablauf in spezialisierte Stationen umorganisieren – kann die Dateneingabe mehrere Fachkraftstunden pro Tag verschlingen.
Auf r/PharmacyTechnician sind die physischen und kognitiven Belastungen ein wiederkehrendes Thema. Ein erfahrener Fachkraft bemerkte: „Meine Apotheke verwendet die Faustregel, zwischen jedem Patienten ein Rezept zu tippen." Dieser Rhythmus – ein Rezept tippen, einen Patienten bedienen, ein Rezept tippen, ein Telefonat annehmen – ist der tägliche Takt eines Berufs, der keinen Ausweg aus der manuellen Dateneingabe für Rezepte auf Papier bietet. Das vom BLS prognostizierte Stellenwachstum von 6,4 % bis 2034 bedeutet, dass die Belegschaft wachsen wird – aber der grundlegende Arbeitsablauf, der Fachkräfte ausbrennt, wird sich nicht ändern, es sei denn, das Paradigma der Dateneingabe selbst ändert sich.
Eine andere Art zu tippen
An diesem Punkt der Analyse verschiebt sich die Frage von „Wie schlimm ist es?" zu „Was kann getan werden?" Und die Antwort ist im Jahr 2026 nicht spekulativ. Sie ist operativ.
Die zugrunde liegende Technologie, die es ermöglicht, ein gescanntes Rezeptbild zu lesen und strukturierte Daten daraus zu extrahieren — Medikamentenname, Dosierung, NDC, SIG, Menge, DEA des Verschreibers — ist dieselbe Klasse visueller KI, die moderne Dokumentextraktion in allen Branchen antreibt. Sie funktioniert nicht durch Abgleich von Vorlagen (das Rezeptformular von Dr. Smith sieht anders aus als das von Dr. Patel), sondern durch das Verständnis des semantischen Inhalts des Dokuments. Sie liest die Handschrift. Sie identifiziert die Felder. Sie ordnet sie der Ziel-Datenstruktur zu — in diesem Fall der Eingabemaske des Apothekenverwaltungssystems.
Dieser Ansatz — bekannt als Benutzerdefinierte Spaltenextraktion — kehrt den traditionellen Arbeitsablauf um. Statt dass das Dokument vorgibt, welche Daten vorhanden sind und wo, definiert der Benutzer, welche Ausgabespalten er benötigt: Medikamentenname, Stärke, NDC, Menge, Tagesversorgung, SIG, NPI des Verschreibers. Die KI lokalisiert jeden Wert auf dem Rezept, indem sie versteht, was er bedeutet, nicht indem sie abgleicht, wo er auf der Seite steht. Ein handschriftliches „Amoxicillin 500 mg" wird als Medikamentenname- und Stärkepaar erkannt, unabhängig davon, wie schräg die Schreibschrift ist, in welcher Zeile es steht oder ob es oben oder unten auf dem Formular ist.
Für den Apothekenkontext bedeutet dies, dass sich die Aufgabe des Technikers von Transkribieren (das Papierrezept lesen und jedes Feld eintippen) zu Verifizieren (prüfen, ob die KI-Extraktion mit dem Original übereinstimmt) ändert. Dieser Verifizierungsschritt existiert bereits im Apothekenarbeitsablauf — der Apotheker muss vor der Abgabe jedes Rezept endgültig prüfen, gemäß den Vorschriften der Landesbehörden, unabhängig davon, ob die Daten von menschlichen Händen oder von KI eingegeben wurden. Die KI umgeht die Sicherheitsprüfung nicht. Sie eliminiert den Teil des Arbeitsablaufs, der keinen klinischen Mehrwert bietet: das mechanische Neuabtippen.
Die regulatorische Dimension sollte direkt angesprochen werden. Gemäß HIPAA muss jedes System, das Rezeptdaten verarbeitet — die geschützte Gesundheitsinformationen (PHI) einschließlich Patientennamen, Geburtsdaten und Medikamentenhistorien enthalten — angemessene Sicherheitsvorkehrungen treffen. Dies ist derselbe Compliance-Rahmen, der Apothekenverwaltungssysteme, E-Prescribing-Netzwerke und Versicherungsabrechnungsplattformen regelt. Datenextraktionstools, die Rezeptbilder verarbeiten, arbeiten innerhalb dieses Rahmens; das wichtigste Auswahlkriterium ist, ob der Anbieter eine HIPAA-konforme Verarbeitungsumgebung und eine Business Associate Agreement (BAA) bereitstellt. Für einen tieferen Einblick, wie KI-Extraktion mit HIPAA-Anforderungen zusammenhängt, haben wir dies in unserem HIPAA-Compliance-Leitfaden für medizinische Dokumentextraktion behandelt.
Dies ist keine hypothetische Infrastruktur. Dieselbe visuelle KI, die 15+ Felder aus einem menüartigen Restaurantbeleg extrahieren oder eine mehrseitige Versicherungs-Erklärung mit verschachtelten Tabellenstrukturen parsen kann, kann auch ein einseitiges handschriftliches Rezept verarbeiten. Das Rezept ist in vielerlei Hinsicht das einfachere Dokument – es hat weniger Datenpunkte, ein standardisierteres Layout und einen begrenzten Wortschatz an Medikamentennamen, Stärken und SIG-Codes. Die Herausforderung war nie die technologische Machbarkeit. Es war die Tatsache, dass der Markt für Apothekensoftware – dominiert von Altsystemen mit tiefer Verankerung – nur langsam Extraktionsfunktionen in den Dateneingabe-Workflow integriert hat. Aber das ändert sich. Outcomes, das Unternehmen hinter Rx30 und Computer-Rx, hat 2024 die automatisierte Dateneingabe für E-Rezepte auf seiner Plattform eingeführt. Der logische nächste Schritt – die automatisierte Extraktion aus Papier-Rezeptbildern – ist dort, wo die Technologie bereits leistungsfähig ist und die Nachfrage wartet.
Für pharmazeutisch-technische Assistenten wäre die Auswirkung unmittelbar und messbar. Ein Rezept, das derzeit 30 Sekunden Tipparbeit erfordert, könnte 5 bis 10 Sekunden zur Überprüfung einer KI-Extraktion benötigen. Der Unterschied summiert sich über das Volumen: 60 Papierrezepte pro Tag sinken von 30 Minuten Tipparbeit auf 5 bis 10 Minuten Überprüfung. Die kognitive Belastung des Technikers verschiebt sich vom Entziffern der Handschrift zur Stichprobenprüfung der Ausgabe – eine Aufgabe, die näher an der klinischen Verifizierung liegt, für die sie ausgebildet wurden, als an der Dateneingabe, zu der sie verpflichtet wurden.
Wenn Sie am schrittweisen Workflow zur Extraktion von Rezeptfeldern – Medikamentenname, Dosierung, NDC, Menge, Wiederholungen, DEA/NPI des Verschreibers – in eine strukturierte Tabelle interessiert sind, haben wir den vollständigen Prozess in unserem Leitfaden zur Rezeptdatenextraktion für Apothekeninventar und Versicherungsansprüche detailliert beschrieben. Für eine feldweise Analyse dessen, was die Extraktionsgenauigkeit im Rezeptkontext beeinflusst – einschließlich NDC-Formatkomplexität, LASA-Medikamentenverwechslungen und staatlicher PMP-Anforderungen – siehe unseren Leitfaden zur Genauigkeit der Rezeptextraktion.
Dieses Problem – manuelle Dateneingabe als unsichtbare Steuer auf papierbasierte Workflows – ist nicht nur in der Apotheke anzutreffen. Dieselbe Dynamik spielt sich in der medizinischen Abrechnung ab, wo EOB-Formulare per Post eintreffen und in Praxisverwaltungssysteme neu eingegeben werden müssen. Wir haben die parallelen Kosten in unserer ausführlichen Analyse zu manuellen EOB-Dateneingabekosten in der medizinischen Abrechnung untersucht. Das Muster ist im gesamten Gesundheitswesen dasselbe: Papier kommt herein, Menschen tippen, Fehler häufen sich, Kosten steigen. Die Technologie, um dieses Muster zu durchbrechen, existiert jetzt.
Häufig gestellte Fragen
Wie viele Rezepte werden noch auf Papier ausgestellt?
Obwohl 92 % der Verschreiber auf E-Rezepte umgestiegen sind und im Jahr 2025 rund 2,64 Milliarden E-Rezepte über das Surescripts-Netzwerk abgewickelt wurden, kommt immer noch eine erhebliche Menge per Papier, Telefon oder Fax. Bei geschätzt insgesamt rund 5 Milliarden Rezepten pro Jahr gelangten etwa 2 Milliarden nicht-elektronische Rezepte in den Apotheken-Workflow – wobei nicht alle im wörtlichen Sinne „Papier" sind. Telefonbestellungen, Faxe und Papierrezepte für Betäubungsmittel erfordern alle eine manuelle Dateneingabe in das Apothekenverwaltungssystem. Die genaue Aufteilung zwischen E-Rezepten und manuell erfassten Rezepten variiert je nach Bundesstaat, Apothekentyp und Verschreibermix.
Warum können Apotheken Rezepte nicht einfach scannen und vom Computer lesen lassen?
Traditionelle Apothekenverwaltungssysteme wie PioneerRx, QS/1 NRx, Computer-Rx und Rx30 wurden nicht für Handschrifterkennung oder semantisches Dokumentenverständnis entwickelt. Sie sind Plattformen für Transaktionsverarbeitung und Ablauf-Workflow. Der Scan erzeugt ein Bild – eine Referenzdatei – aber das System hat keine Möglichkeit, strukturierte Daten aus diesem Bild zu extrahieren. Der Techniker muss das Bild lesen und die Felder eingeben. Neuere KI-basierte Dokumentextraktionstools können diese Lücke schließen, indem sie das gescannte Bild lesen, die Felder semantisch verstehen und strukturierte Daten ausgeben – die Integration mit älteren PMS-Plattformen ist jedoch noch nicht Standard.
Was sind die häufigsten Fehler bei der manuellen Rezeptdateneingabe?
Die häufigsten Fehler konzentrieren sich auf drei Bereiche: Verwechslung von Arzneimittelnamen (insbesondere LASA-Paare wie Prednison/Prednisolon oder Clonidin/Klonopin), Fehlinterpretation der Dosieranweisung (QD vs. QID, „einmal täglich" vs. „viermal täglich" – in der Handschrift nur einen Buchstaben auseinander, aber ein 4-facher Dosierungsunterschied) und numerische Mengenfehler (falsches Lesen von handschriftlicher 7 als 9, 1 als 7, insbesondere bei Nachfüll- und Tagesversorgungsfeldern). Eine systematische Überprüfung aus dem Jahr 2023 in den Annals of Medicine & Surgery dokumentierte, dass 1,7 % bis 24 % der Rezepte fehlerhaft ausgeliefert werden, wobei unleserliche Handschrift ein Hauptfaktor ist.
Funktioniert die KI-Rezeptextraktion auch mit Betäubungsmittelrezepten?
Ja – die visuelle KI kann Rezepte der Schedule II-V genauso lesen und extrahieren wie nicht-betäubungsmittelhaltige Rezepte. Handschrift, Felder und Datenstruktur sind identisch. Der Unterschied liegt in der regulatorischen Handhabung der extrahierten Daten: Betäubungsmittelrezepte unterliegen zusätzlichen gesetzlichen Anforderungen wie DEA-Nummer-Prüfung, Abfrage des Verschreibungsmonitoring-Programms (PMP) und Aufbewahrungspflichten. KI-Extraktionstools ersetzen diese Compliance-Schritte nicht – sie übernehmen die Dateneingabe, während der bestehende Apotheken-Workflow für die Betäubungsmittelprüfung intakt bleibt. Voraussetzung ist, dass das Extraktionstool in einer HIPAA-konformen Umgebung mit einer unterzeichneten Business Associate Agreement betrieben wird.
Ersetzt dies den Prüfschritt des Apothekers?
Nein. In jedem Bundesstaat ist der Apotheker gesetzlich verpflichtet, vor der Abgabe jedes Rezepts eine abschließende Prüfung durchzuführen – das Originalrezept mit den eingegebenen Daten abzugleichen, auf Wechselwirkungen zu prüfen, die klinische Angemessenheit zu bestätigen und die Etikettierungsgenauigkeit sicherzustellen. Die KI-Extraktion übernimmt den Dateneingabeschritt vor der Prüfung: das Lesen des handschriftlichen Rezepts und das Befüllen der PMS-Felder. Die klinische Beurteilung des Apothekers, die Drug Utilization Review (DUR) und die abschließende Genauigkeitsprüfung bleiben unverändert. Was sich ändert, ist, dass Apotheker und Techniker weniger Zeit mit Transkription und mehr Zeit mit den klinischen Aufgaben verbringen, für die ihre Zulassungen gedacht sind.
Der Dateneingabe-Engpass in der Apotheke wird sich nicht von selbst lösen – Papierrezepte verschwinden nicht. Aber die Technologie, sie zu lesen, ihre Inhalte zu extrahieren und die PMS-Felder zu befüllen, existiert bereits.
Rezept hochladenDateien werden sicher verarbeitet und nicht gespeichert.