La ressaisie des ordonnances :
les ordonnances papier et le fardeau de la saisie de données en pharmacie
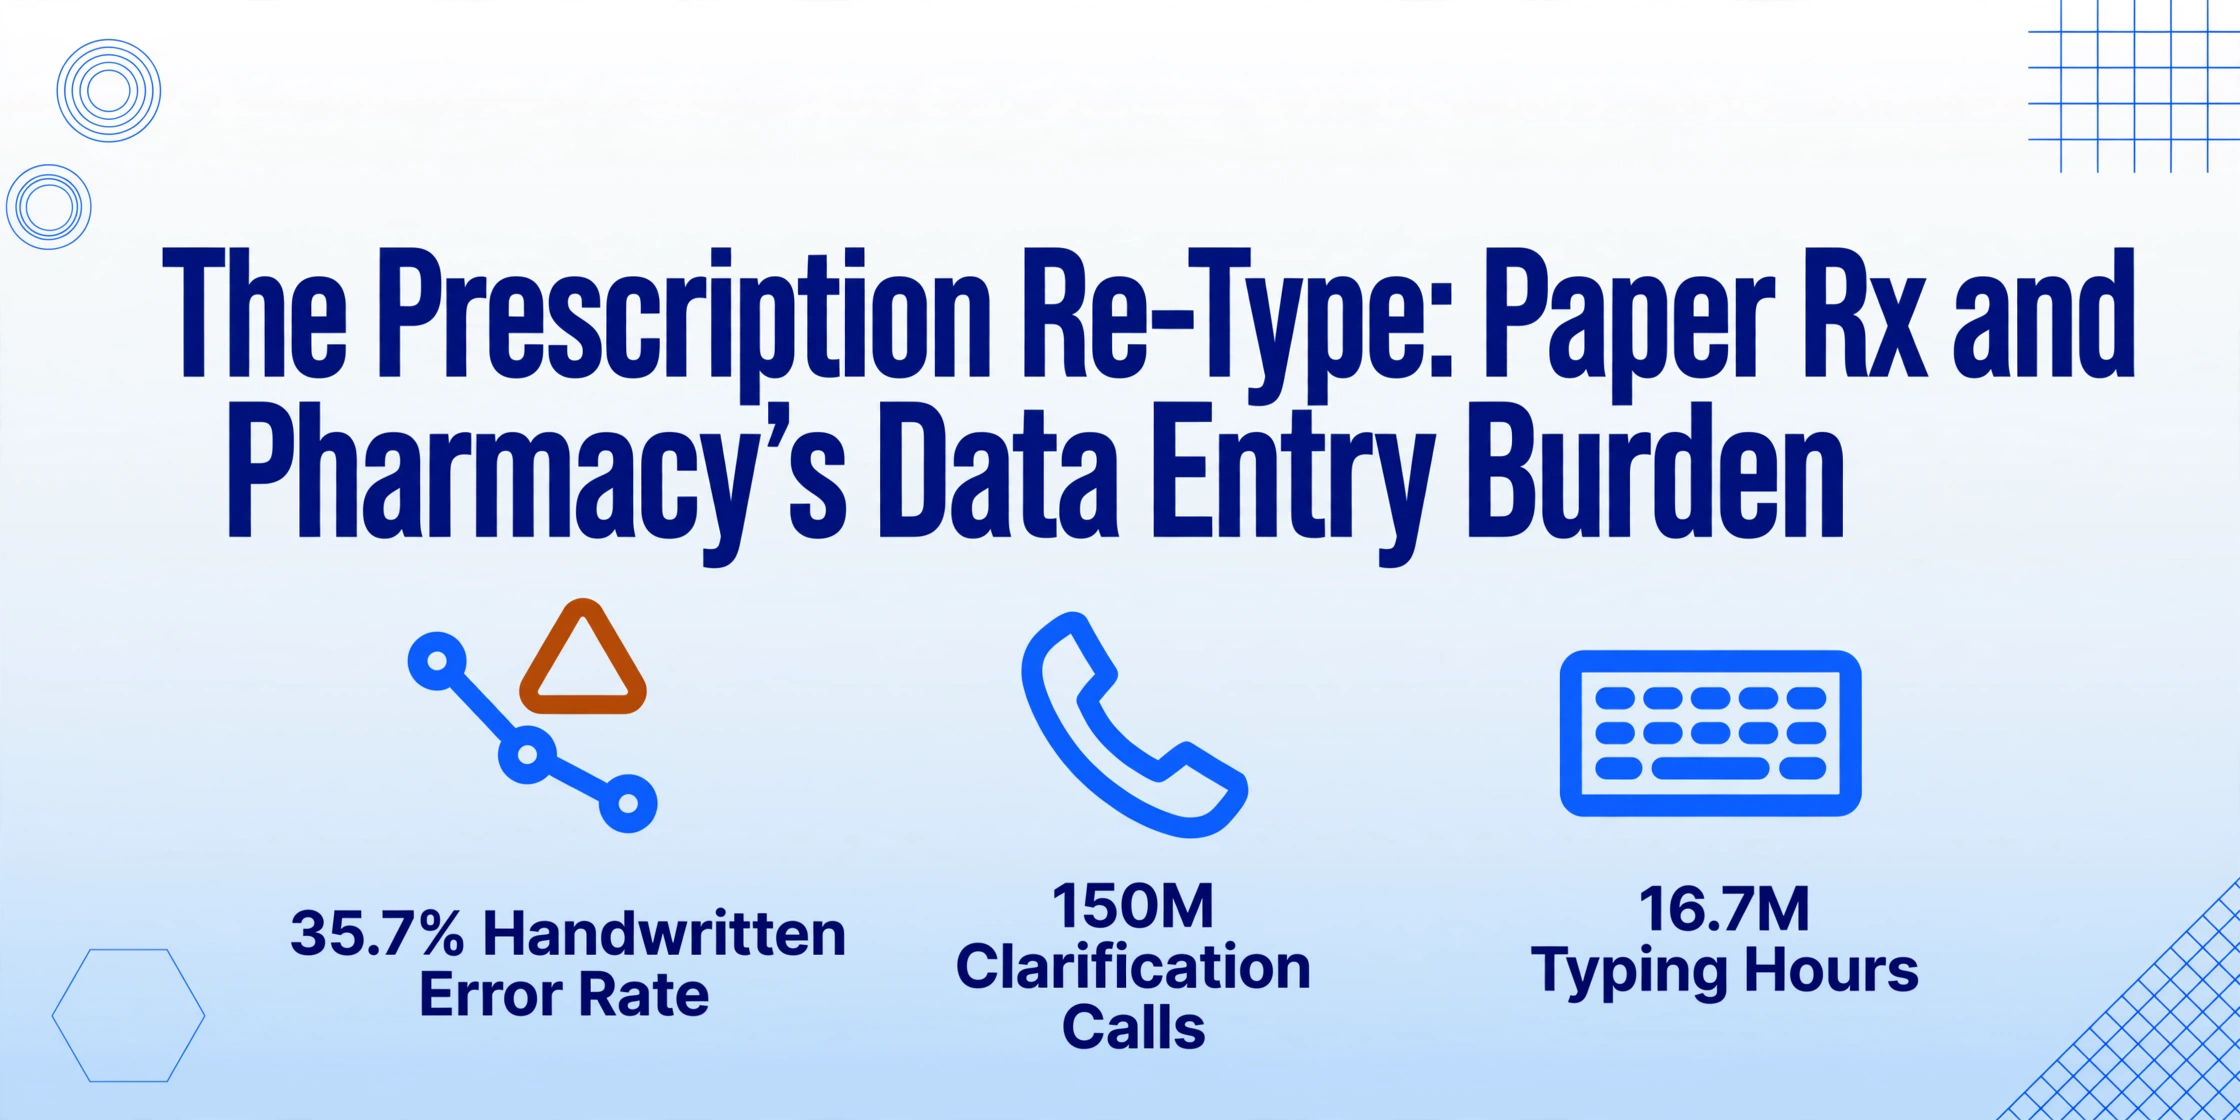
En 2025, les pharmacies américaines ont délivré environ 5 milliards d'ordonnances. Parmi celles-ci, environ 2,64 milliards sont arrivées électroniquement via le réseau Surescripts. Le reste — plus de 2 milliards d'ordonnances — est arrivé aux comptoirs des pharmacies par papier, téléphone ou télécopie. Chacune d'entre elles a dû être saisie manuellement dans un système de gestion de pharmacie, champ par champ, frappe par frappe, par l'un des 490 000 techniciens de pharmacie du pays. C'est un volume de saisie manuelle de données sans équivalent dans aucun autre secteur de la santé — et presque personne en dehors de la pharmacie n'a jamais vu cela se produire.
Points clés à retenir
- Environ 2 milliards d'ordonnances arrivent chaque année dans les pharmacies américaines sur papier ou par téléphone — et chacune d'elles est ressaisie manuellement dans le logiciel de pharmacie, champ par champ, par un technicien au clavier.
- Le taux d'adoption de 92 % de la prescription électronique atteint un plafond permanent — les substances contrôlées, les cabinets dentaires, les cliniques vétérinaires et les patients qui comparent les prix créent un plancher structurel de volume papier qu'aucune extension de réseau ne peut éliminer.
- Une IA qui lit l'écriture manuscrite par le sens sémantique plutôt que par la position dans le modèle peut transformer une transcription manuelle de 30 secondes en une étape de vérification de 5 secondes — le contrôle de sécurité du pharmacien reste, la ressaisie disparaît.
Le parcours de l'ordonnance papier commence là où la prescription électronique s'arrête
La première chose à comprendre est la façon dont une ordonnance papier circule réellement. Un médecin dans un petit cabinet privé — peut-être l'un des quelque 8 % de prescripteurs qui, selon les données ONC, n'ont toujours pas adopté la prescription électronique — rédige une ordonnance sur un bloc. Le patient l'apporte à la pharmacie. Un technicien au comptoir d'accueil la numérise dans le système de gestion de pharmacie (PMS). Et cette numérisation, cette image d'un morceau de papier avec l'écriture d'un médecin dessus, c'est là que le travail manuel commence.
Le système de gestion de pharmacie ne comprend pas l'image. Il ne peut pas déchiffrer l'écriture manuscrite. Il n'a aucun modèle sémantique de ce que signifie une ordonnance. L'image reste là comme image de référence — et le travail du technicien est d'en extraire chaque élément, de le traduire en données structurées et de le saisir dans l'écran de saisie de données du système. Les compteurs de renouvellement relisent ces champs à partir du flacon — le nom du médicament, le dosage et la fréquence sur une photo d'étiquette d'ordonnance.
Cet écran, selon le PMS utilisé par la pharmacie — PioneerRx, QS/1 NRx, Computer-Rx, Rx30, ou l'un des dizaines d'autres maintenus par des entreprises comme RedSail Technologies et Outcomes — présentera entre 15 et 20 champs distincts. Chacun doit être rempli. Chacun est un point de décision. Chacun est une opportunité d'erreur.
L'ampleur de ce flux de travail défie toute visualisation facile. Avec 2 milliards d'ordonnances non électroniques par an et un temps moyen de saisie de données d'environ 30 secondes par ordonnance — un chiffre fréquemment cité par les techniciens sur des forums comme r/pharmacy — le coût cumulé de main-d'œuvre est stupéfiant : environ 16,7 millions d'heures de saisie manuelle de données par an, effectuées presque exclusivement par des techniciens de pharmacie gagnant un salaire médian du Bureau of Labor Statistics de 43 460 $ par an (mai 2024).
Le parcours du combattant des 15 champs : ce qui se passe vraiment au clavier
Pour comprendre pourquoi ce n'est pas qu'une simple « saisie » — mais un véritable parcours cognitif, et non une tâche administrative — il faut voir les champs. Voici ce qu'un technicien rencontre sur un écran de saisie typique pour une seule ordonnance, selon la disposition standard des champs enseignée dans les programmes de formation des techniciens en pharmacie et visible dans le simulateur de file d'attente de saisie du Pharmacy Skills Lab :
| Catégorie de champ | Champs individuels | Source des données |
|---|---|---|
| Patient | Nom, date de naissance, adresse, téléphone | Ordonnance papier + informations verbales du patient |
| Prescripteur | Nom, NPI (10 chiffres), numéro DEA, adresse du cabinet, téléphone | Ordonnance papier (souvent griffonnée) |
| Médicament | Nom du médicament, dosage, forme galénique, NDC (11 chiffres) | Ordonnance papier — nom du médicament manuscrit déchiffré |
| Délivrance | Quantité, durée du traitement, renouvellements autorisés, code DAW | Ordonnance papier + calcul du technicien |
| Posologie | SIG (verbe + dose + voie + fréquence + informations auxiliaires) | Ordonnance papier — souvent abrégée, en cursive, ambiguë |
| Administratif | Date de rédaction, date de non-délivrance avant, code d'origine de l'ordonnance | Ordonnance papier + exigences réglementaires de l'État |
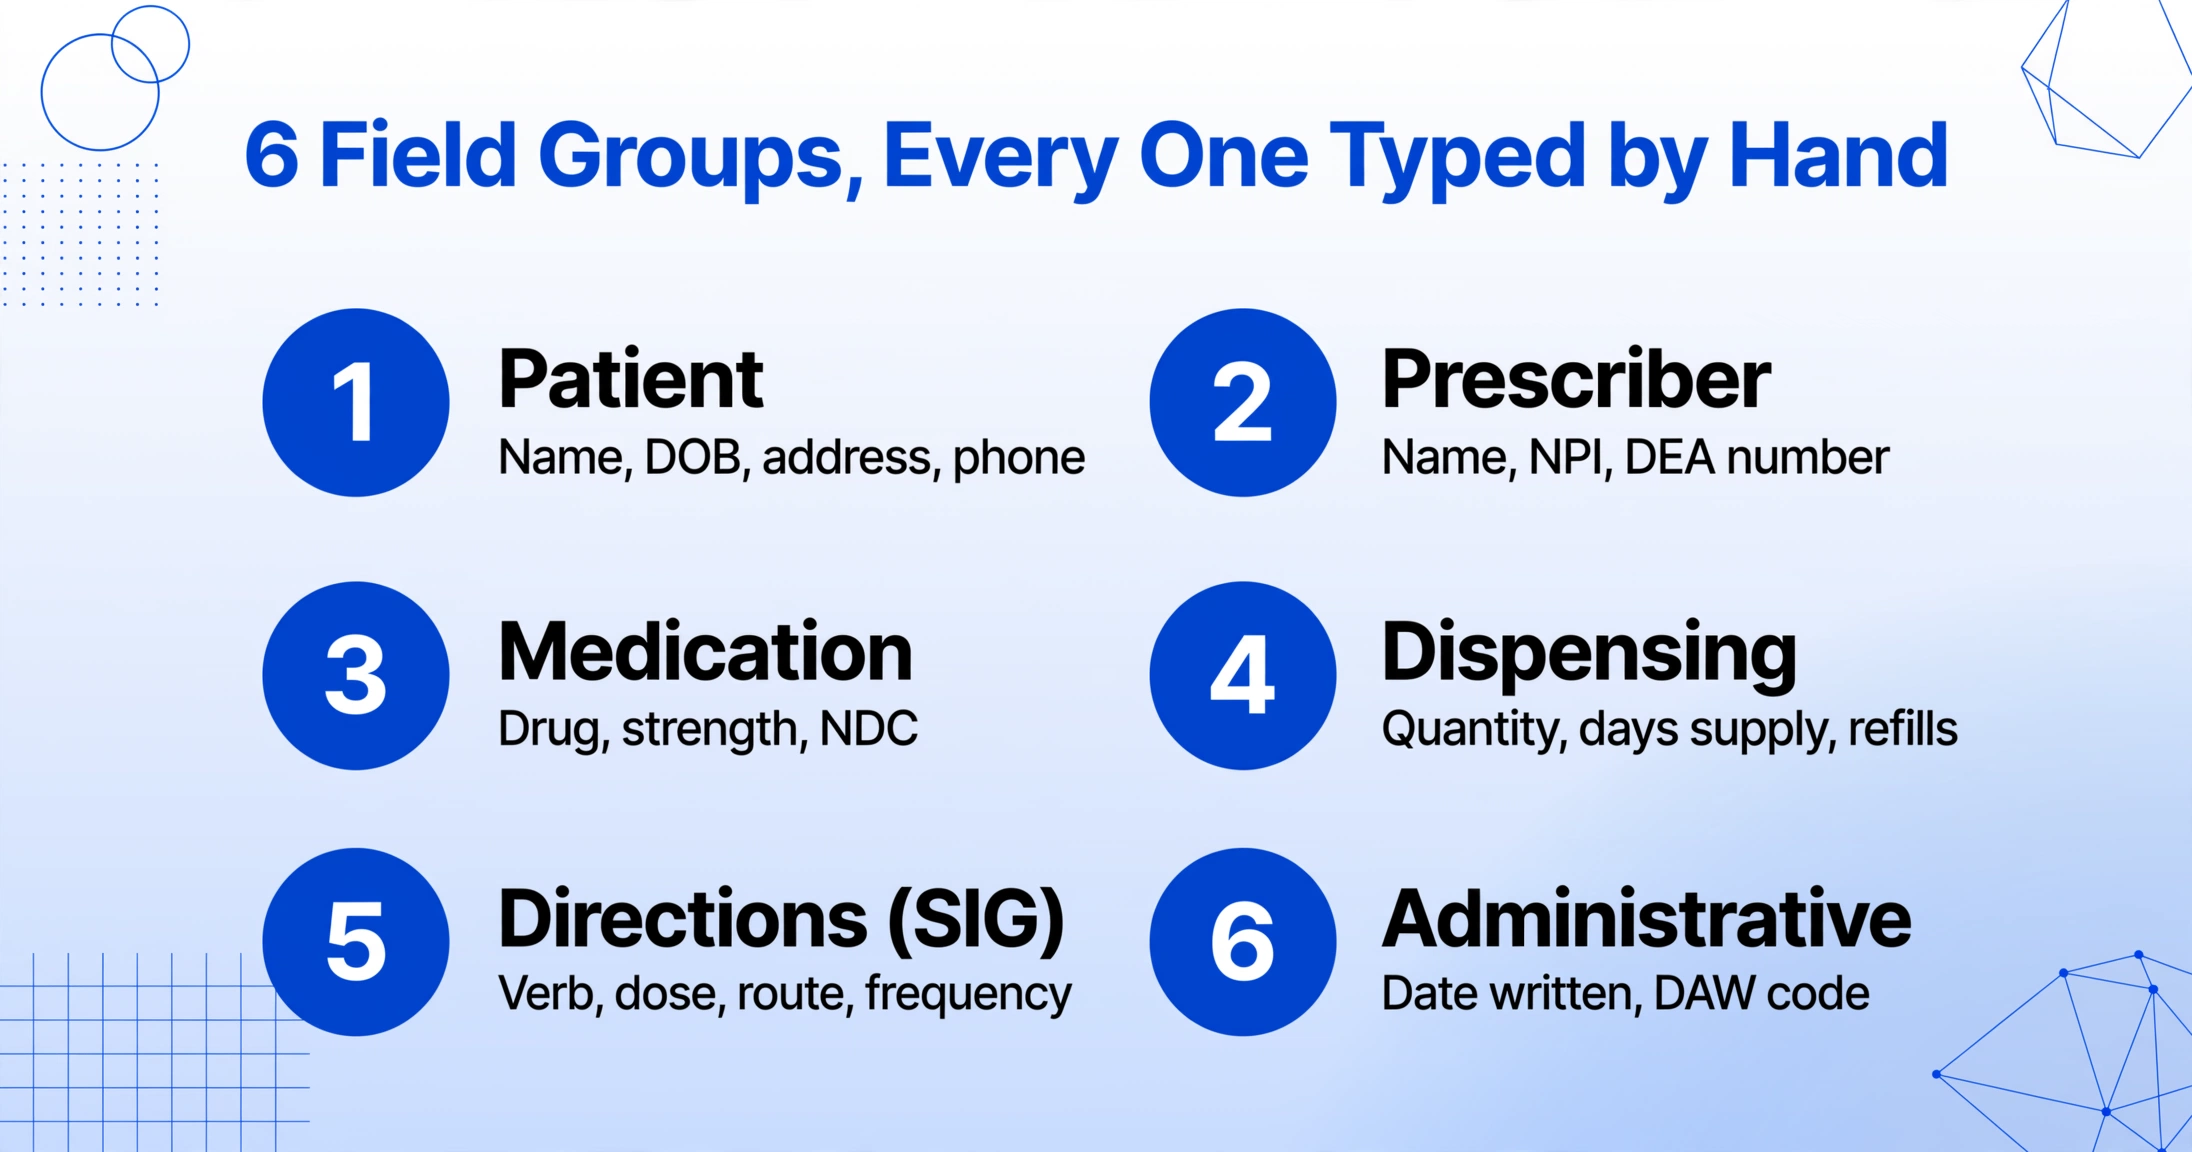
Cela représente environ 18 à 20 informations individuelles par ordonnance, chacune nécessitant une vérification par rapport à l'original papier. Et l'original papier — la pièce de preuve à laquelle le technicien est censé se référer — est au cœur du problème. Il est manuscrit. Souvent en cursive. Fréquemment rédigé à la hâte. Parfois par un prescripteur dont le technicien n'a jamais vu l'écriture auparavant.
Sur le subreddit r/PharmacyTechnician, un stagiaire a décrit l'expérience sans détour : « Je vous jure, la moitié étaient illisibles ! Sommes-nous vraiment censés savoir ce que les prescripteurs veulent, alors qu'ils ne savent même pas écrire correctement ? »
Cette question n'est pas qu'une simple plainte. Elle révèle un décalage structurel : le système de prescription est conçu pour qu'un humain lise l'écriture manuscrite d'un autre humain, au rythme dicté par le stylo du prescripteur. Mais le système de délivrance exige des données structurées et lisibles par machine, au rythme dicté par une file de patients qui attendent. Le technicien est la couche de traduction entre ces deux systèmes incompatibles — et la traduction est sujette aux erreurs par conception.
Ce que coûte réellement l'écriture manuscrite : erreurs, appels et vies
Les taux d'erreur ne sont pas marginaux. Une étude des National Institutes of Health a examiné 398 ordonnances — 199 manuscrites, 199 électroniques — et a constaté des erreurs dans 35,7 % des ordonnances manuscrites contre seulement 2,5 % des ordonnances électroniques. Un autre corpus de recherche, compilé dans une revue systématique de 2023 dans les Annals of Medicine & Surgery, estime qu'entre 1,7 % et 24 % de toutes les ordonnances sont délivrées de manière erronée, 1,5 % à 4 % de ces erreurs entraînant des préjudices pour les patients. L'Institute of Medicine a associé plus de 7 000 décès par an à des erreurs médicamenteuses imputables à une mauvaise écriture manuscrite et à des erreurs de saisie des ordonnances.
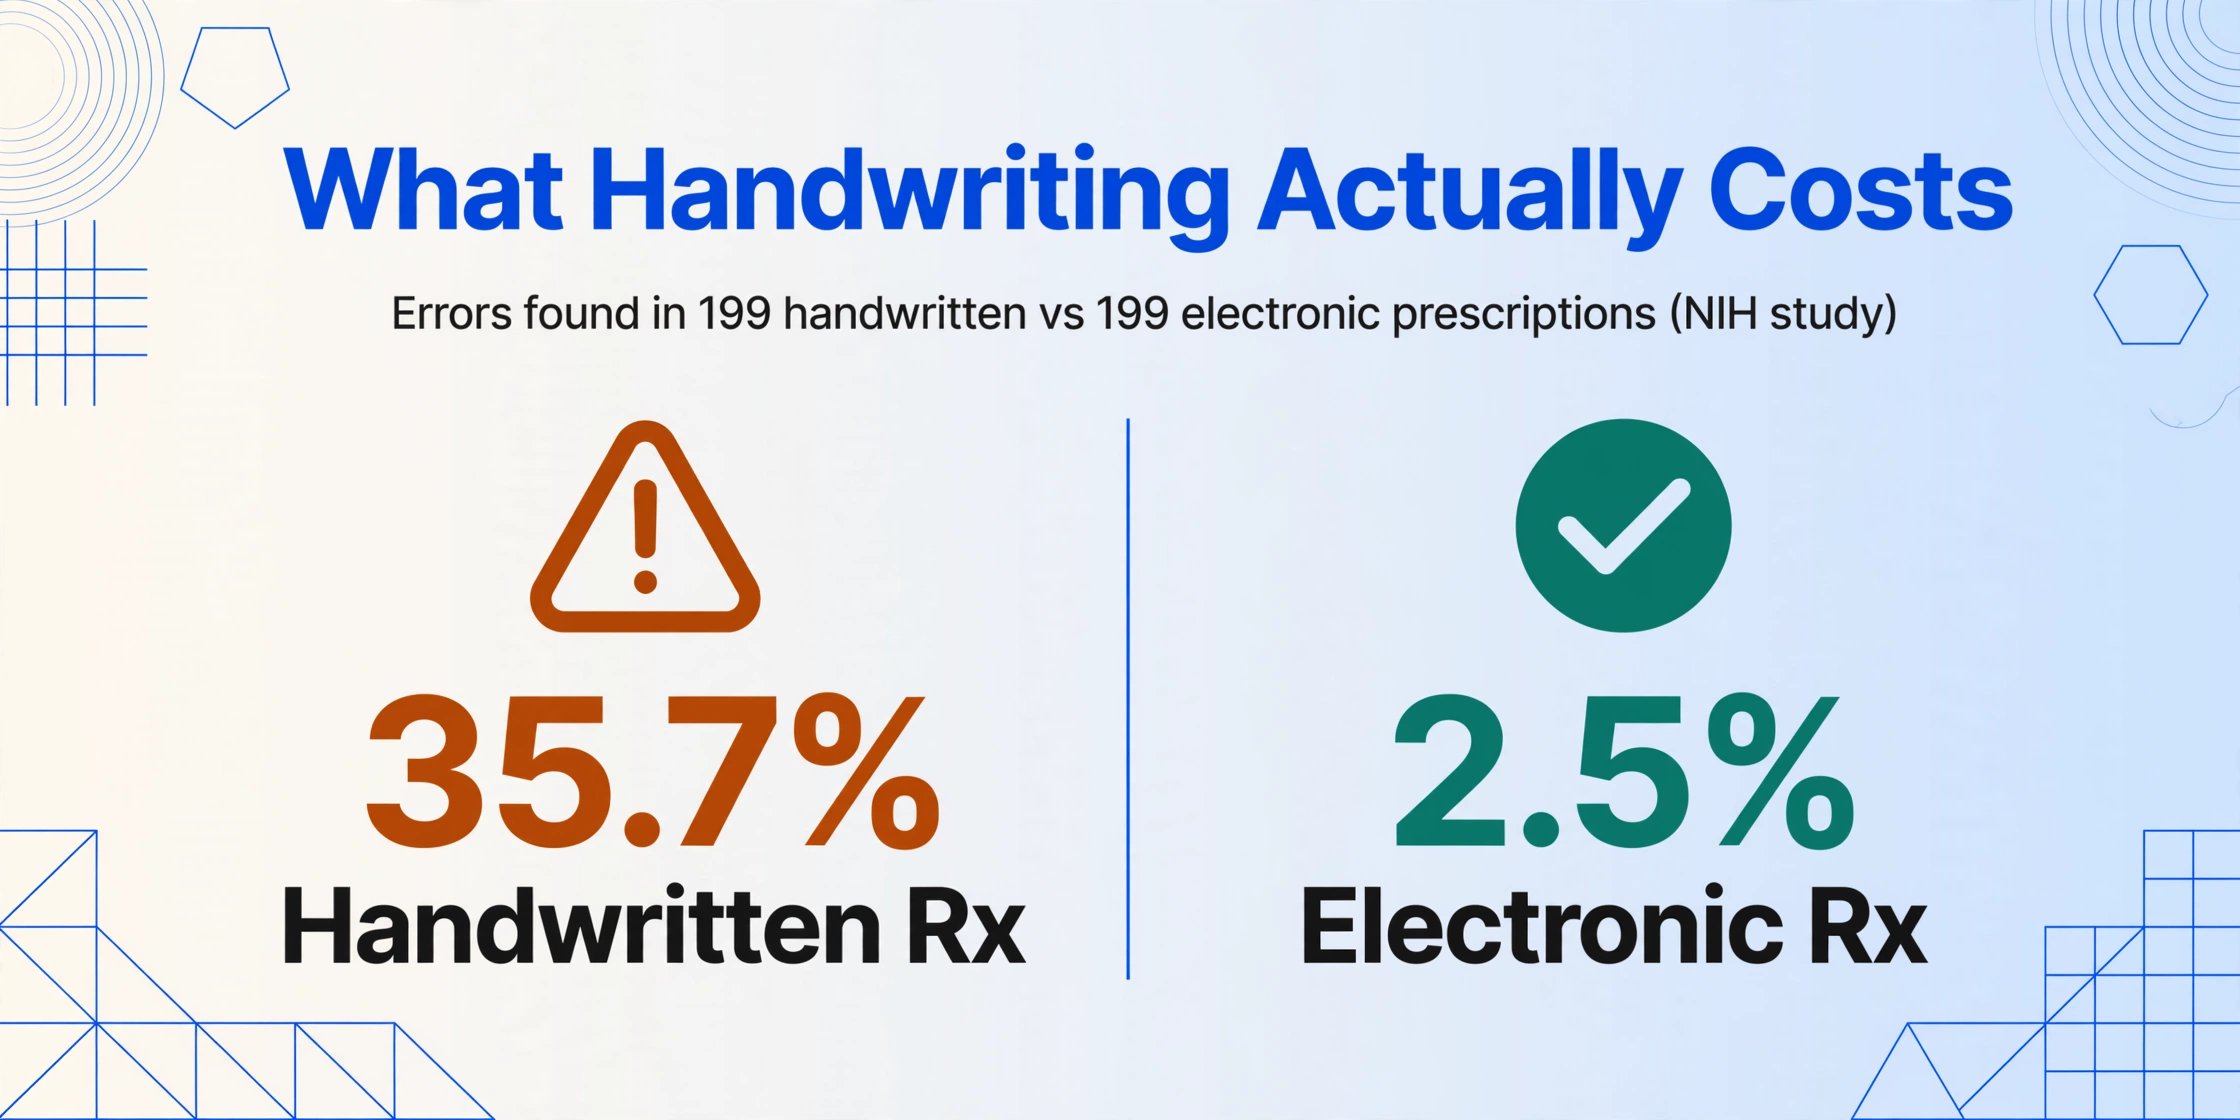
Mais les chiffres d'erreurs ne mesurent que ce qui est détecté. Ils ne mesurent pas la friction — le coût systémique de l'incertitude qui ronge chaque ordonnance papier.
Lorsqu'un technicien ne peut pas lire le nom d'un médicament, ou ne peut pas dire si la mention indique « QD » (une fois par jour) ou « QID » (quatre fois par jour), ou n'est pas sûr de savoir si le chiffre manuscrit est un 7 ou un 9 dans le champ de quantité, l'ordonnance s'arrête. Le technicien la signale. Le pharmacien appelle le cabinet du prescripteur. Le personnel du cabinet vérifie le dossier. Le prescripteur rappelle. Le pharmacien vérifie. La saisie des données reprend.
On estime à 150 millions le nombre d'appels de clarification passés chaque année des pharmacies aux prescripteurs aux États-Unis, selon des données sectorielles. Cela représente 150 millions d'interruptions dans la chaîne d'approvisionnement en médicaments, chacune déclenchée par l'écart entre un bout de papier griffonné et une base de données qui exige de la précision.
Les erreurs les plus dangereuses se concentrent autour de ce que les pharmaciens appellent les médicaments « LASA » — les paires à l'orthographe et à la prononciation similaires. Prednisone et prednisolone. Clonidine et Klonopin. Celebrex et Celexa. Lorsque l'écriture d'un prescripteur transforme « Celebrex 200 mg » en un gribouillis qui pourrait correspondre à l'un ou l'autre médicament, la différence entre un anti-inflammatoire et un antidépresseur — ou la différence entre 1 mg et 10 mg de warfarine, comme Pharmacy Times l'a documenté dans une analyse détaillée de la précision de la saisie des données — est une décision au niveau de la frappe qui incombe au technicien.
Pourquoi la prescription électronique n'a pas fini le travail
Face à l'ampleur du problème, la question évidente est : pourquoi tout n'est-il pas encore électronique ? Le réseau Surescripts a traité 2,64 milliards d'ordonnances électroniques en 2025. Selon l'ONC, 92 % des prescripteurs ont adopté la capacité de prescription électronique. L'infrastructure existe. La réduction des erreurs est prouvée. Qu'est-ce qui freine l'adoption universelle ?
La réponse n'est pas unique. C'est un ensemble de raisons structurelles qui créent chacune une catégorie d'ordonnances papier que la prescription électronique ne peut pas atteindre :
Substances contrôlées. Les règles de la DEA en vertu du 21 CFR Partie 1311 autorisent la prescription électronique de substances contrôlées (EPCS), et 35 États l'imposent désormais. Mais les médicaments de l'annexe II — les opioïdes, les stimulants et autres médicaments à fort potentiel d'abus — arrivent encore en volumes importants sur papier. La DEA exige une authentification à deux facteurs, une vérification d'identité et un logiciel audité par un tiers pour l'EPCS. Selon la FAQ de la DEA sur l'EPCS, la participation reste volontaire au niveau fédéral. De nombreux petits prescripteurs choisissent le papier car la charge de conformité du logiciel certifié EPCS n'en vaut pas la peine pour leur cabinet. Pour les stupéfiants de l'annexe II, une signature manuscrite sur un bloc d'ordonnances inviolable reste, en 2026, le recours légal.
Le fossé des petits cabinets. Bien que 92 % des prescripteurs aient la capacité de prescription électronique, l'utilisation réelle et constante est une autre affaire. Les médecins indépendants, les praticiens seuls, les dentistes, les vétérinaires et les spécialistes en zones rurales sont représentés de manière disproportionnée parmi les 8 % sans capacité — et parmi ceux qui l'ont mais ne l'utilisent pas régulièrement. Un dentiste prescrivant des analgésiques postopératoires n'a pas de DSE. Un vétérinaire traitant un chien n'a pas d'interface standard SCRIPT NCPDP avec la pharmacie locale. Ce ne sont pas des cas marginaux. Additionnés — la dentisterie seule représente environ 155 000 praticiens aux États-Unis — ils constituent un réservoir permanent d'ordonnances papier.
La mosaïque des lois des États. Alors que 35 États imposent l'EPCS, les obligations varient en portée. Certaines couvrent toutes les substances contrôlées ; d'autres seulement les opioïdes ; certaines couvrent toutes les ordonnances, point final (New York depuis 2016, en vertu de la loi sur l'éducation de New York). Les États restants n'ont aucune obligation. Une ordonnance rédigée dans un État sans obligation et exécutée dans un État avec obligation — ou vice versa — opère dans une zone grise juridique qui revient souvent au papier.
Préférence et portabilité du patient. Tous les patients ne veulent pas que leur ordonnance soit verrouillée sur une pharmacie spécifique avant d'avoir comparé les prix. Une ordonnance papier donne au patient la liberté de magasiner. Pour les patients non assurés payant comptant, cela compte. Pour quiconque a subi un choc tarifaire au comptoir d'une pharmacie — et les données de Surescripts montrent que 28 % des ordonnances papier n'arrivent jamais dans aucune pharmacie, un phénomène que les chercheurs appellent « non-adhésion primaire » ou « fuite d'ordonnance » — le papier en main donne au moins au patient le pouvoir de décider où et quand exécuter l'ordonnance.
Le résultat : un plancher structurel sous le volume d'ordonnances papier qu'aucune expansion du réseau ne peut éliminer. Le papier n'est pas un problème résiduel qui disparaîtra naturellement. C'est une caractéristique permanente de l'écosystème des ordonnances — et un papier permanent signifie une saisie manuelle permanente.
L'humain derrière le clavier
Les coûts jusqu'à présent ont été mesurés en erreurs, en appels et en inefficacité du système. Mais il existe un autre registre — celui qui suit ce que la saisie manuelle fait aux personnes qui l'effectuent.
Les 490 400 techniciens en pharmacie recensés par le BLS en 2024 sont en grande majorité des femmes (77,7 %, selon Data USA). Leur salaire médian de 43 460 $ les place en dessous de la médiane nationale pour toutes les professions, bien qu'ils effectuent une tâche qui affecte directement la sécurité des patients à chaque frappe. Le poste combine les exigences cognitives de la vérification clinique des données avec la pression de débit d'une file d'attente de vente au détail — et la composante de saisie manuelle se situe exactement à l'intersection des deux.
« La saisie de données est devenue un goulot d'étranglement caché dans les opérations de pharmacie, surtout tôt le matin, après les week-ends ou après les retards de jours fériés », note une analyse de 2024 d'Outcomes, la société derrière les plateformes de pharmacie Rx30 et Computer-Rx. « Les techniciens et les pharmaciens commencent souvent leur journée enfouis dans des files d'ordonnances nécessitant une saisie manuelle avant que quoi que ce soit d'autre ne puisse avancer. »
Ce goulot d'étranglement se fait sentir dans chaque pharmacie américaine chaque lundi matin. Une pharmacie de détail traitant 300 ordonnances par jour peut en recevoir 60 à 90 sur papier, selon le mélange local de prescripteurs et le volume de substances contrôlées. À 30 secondes par saisie, cela représente 30 à 45 minutes de frappe ininterrompue par jour — avant toute interruption due aux questions des patients, aux refus d'assurance, aux appels téléphoniques ou à la vérification du pharmacien. Dans les magasins plus fréquentés traitant plus de 500 ordonnances par jour — le seuil auquel les pharmacies comme celles utilisant PioneerRx ou QS/1 NRx réorganisent généralement leur flux de travail en postes spécialisés — la saisie de données peut consommer plusieurs heures-technicien par jour.
Sur r/PharmacyTechnician, le tribut physique et cognitif est un thème récurrent. Un technicien vétéran a observé : « Ma pharmacie utilise la règle empirique de taper une ordonnance entre chaque patient. » Ce rythme — taper une ordonnance, servir un patient, taper une ordonnance, répondre au téléphone — est la cadence quotidienne d'une profession qui n'a pas de sortie de secours de la saisie manuelle pour les ordonnances qui arrivent sur papier. La croissance projetée de l'emploi de 6,4 % d'ici 2034, selon le BLS, signifie que la main-d'œuvre va s'étendre — mais le flux de travail fondamental qui épuise les techniciens ne changera pas à moins que le paradigme de la saisie de données lui-même ne change.
Une autre façon de saisir
C'est à ce stade de l'analyse que la question passe de « à quel point c'est grave » à « que peut-on faire ». Et la réponse, en 2026, n'est pas spéculative. Elle est opérationnelle.
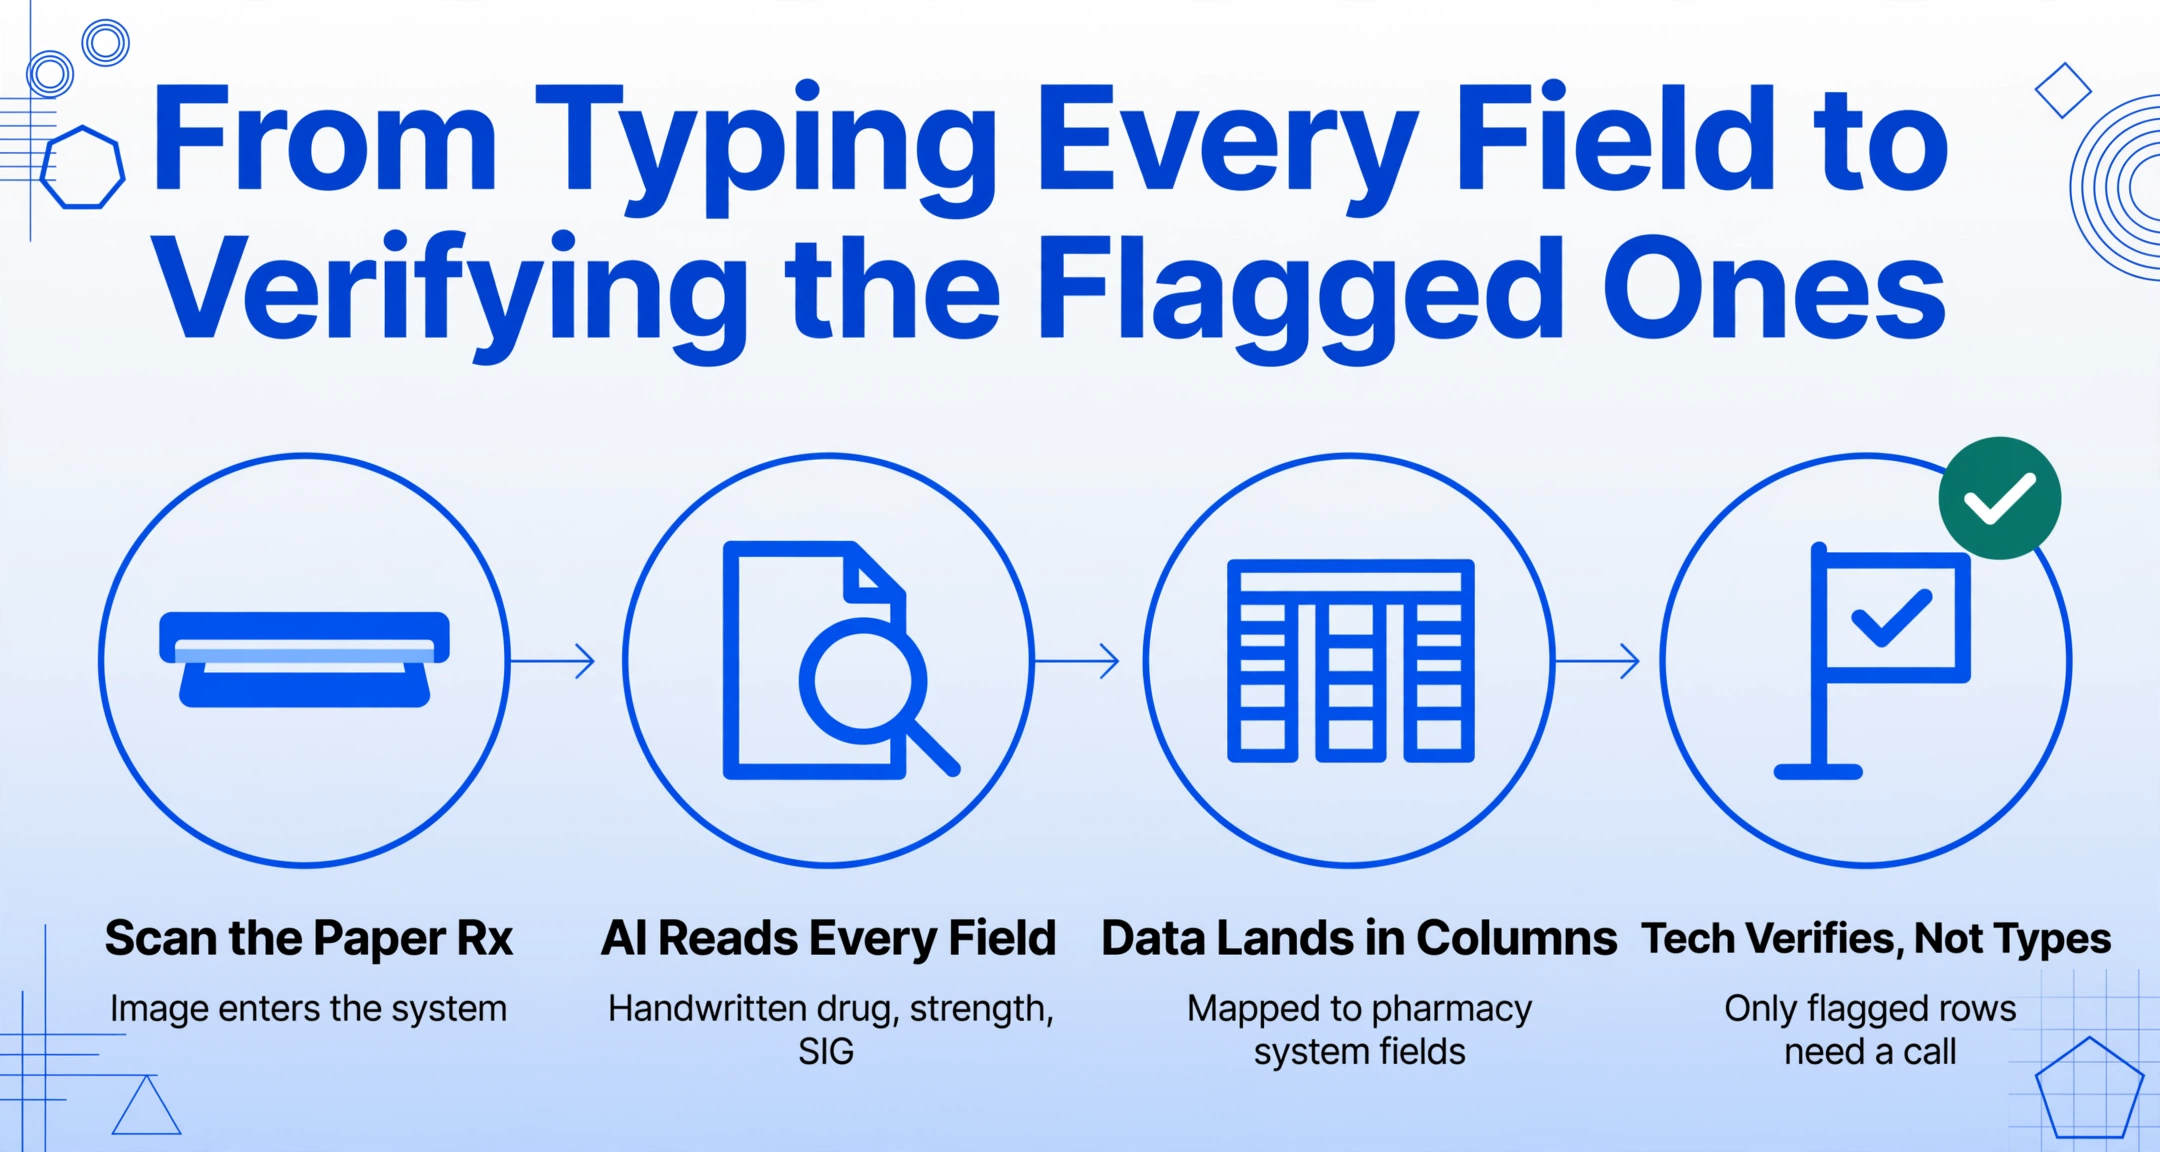
La technologie sous-jacente qui permet de lire une image d'ordonnance scannée et d'en extraire des données structurées — nom du médicament, dosage, NDC, SIG, quantité, DEA du prescripteur — est la même classe d'IA visuelle qui alimente l'extraction moderne de documents dans tous les secteurs. Elle fonctionne non pas en faisant correspondre des modèles (le bloc d'ordonnance du Dr Smith diffère de celui du Dr Patel) mais en comprenant le contenu sémantique du document. Elle lit l'écriture manuscrite. Elle identifie les champs. Elle les mappe à la structure de données cible — en l'occurrence, l'écran de saisie du système de gestion de pharmacie.
Cette approche — connue sous le nom d'Extraction de colonnes personnalisées — inverse le flux de travail traditionnel. Au lieu que le document dicte quelles données sont présentes et où, l'utilisateur définit les colonnes de sortie dont il a besoin : nom du médicament, dosage, NDC, quantité, jours de traitement, SIG, NPI du prescripteur. L'IA localise chaque valeur sur l'ordonnance en comprenant ce qu'elle signifie, et non en faisant correspondre sa position sur la page. Un « Amoxicilline 500 mg » manuscrit est reconnu comme une paire nom de médicament/dosage, quelle que soit l'inclinaison de l'écriture cursive, la ligne sur laquelle il se trouve, ou qu'il soit en haut ou en bas du bloc.
Pour le contexte de la pharmacie, cela signifie que le travail du technicien passe de la transcription (lire l'ordonnance papier et saisir chaque champ) à la vérification (contrôler que l'extraction de l'IA correspond à l'original). Cette étape de vérification existe déjà dans le flux de travail de la pharmacie — le pharmacien doit effectuer un contrôle final sur chaque ordonnance avant la délivrance, conformément aux règlements des conseils d'État, que les données aient été saisies par des mains humaines ou par l'IA. L'IA ne contourne pas le contrôle de sécurité. Elle élimine la partie du flux de travail qui n'apporte aucune valeur clinique : la ressaisie mécanique.
La dimension réglementaire mérite d'être abordée directement. En vertu de la HIPAA, tout système traitant des données d'ordonnance — qui contiennent des informations de santé protégées (PHI) incluant les noms des patients, les dates de naissance et les historiques de médicaments — doit maintenir des garanties appropriées. C'est le même cadre de conformité qui régit les systèmes de gestion de pharmacie, les réseaux de prescription électronique et les plateformes d'adjudication d'assurance. Les outils d'extraction de données qui traitent des images d'ordonnances opèrent dans ce cadre ; le critère de sélection clé est de savoir si le fournisseur propose un environnement de traitement conforme à la HIPAA et un accord de partenariat commercial (BAA). Pour une analyse plus approfondie de l'intersection entre l'extraction par IA et les exigences de la HIPAA, nous avons couvert ce sujet dans notre guide de conformité HIPAA pour l'extraction de documents médicaux.
Il ne s'agit pas d'une infrastructure hypothétique. La même IA visuelle capable d'extraire plus de 15 champs d'un reçu de restaurant au format menu, ou de parser une explication des prestations (EOB) d'assurance multipage avec des structures de tableaux imbriquées, peut traiter une ordonnance manuscrite d'une seule page. L'ordonnance est, à bien des égards, le document le plus simple — elle contient moins de points de données, une mise en page plus standardisée et un vocabulaire restreint de noms de médicaments, de dosages et de codes SIG. Le défi n'a jamais été la faisabilité technologique. Il réside dans le fait que le marché des logiciels de pharmacie — dominé par des systèmes hérités profondément implantés — a tardé à intégrer les capacités d'extraction dans le flux de saisie des données. Mais cela change. Outcomes, la société derrière Rx30 et Computer-Rx, a lancé la saisie automatisée des données pour les e-ordonnances sur sa plateforme en 2024. La prochaine étape logique — l'extraction automatisée à partir d'images d'ordonnances papier — est là où la technologie est déjà capable et où la demande attend.
Pour les techniciens en pharmacie, l'impact serait immédiat et mesurable. Une ordonnance qui prend actuellement 30 secondes à saisir pourrait prendre 5 à 10 secondes à vérifier par rapport à une extraction IA. La différence se cumule sur le volume : 60 ordonnances papier par jour passent de 30 minutes de saisie à 5 à 10 minutes de vérification. La charge cognitive du technicien passe du déchiffrage de l'écriture manuscrite à la vérification ponctuelle des résultats — une tâche plus proche de la vérification clinique pour laquelle il a été formé que de la saisie de données à laquelle il a été assigné.
Si vous êtes intéressé par le processus étape par étape pour extraire les champs d'une ordonnance — nom du médicament, dosage, NDC, quantité, renouvellements, DEA/NPI du prescripteur — vers une feuille de calcul structurée, nous avons détaillé l'ensemble du processus dans notre guide d'extraction de données d'ordonnances pour l'inventaire pharmaceutique et les réclamations d'assurance. Pour une analyse champ par champ de ce qui affecte la précision de l'extraction dans le contexte des ordonnances — y compris la complexité du format NDC, la confusion des médicaments LASA et les exigences des PMP d'État — consultez notre guide de précision d'extraction d'ordonnances.
Ce problème — la saisie manuelle des données comme taxe invisible sur les flux de travail papier — n'est pas propre à la pharmacie. La même dynamique se joue dans la facturation médicale, où les formulaires EOB arrivent par courrier et doivent être ressaisis dans les systèmes de gestion de cabinet. Nous avons analysé les coûts parallèles dans notre analyse approfondie sur les coûts de saisie manuelle des données EOB dans la facturation médicale. Le schéma est le même dans tous les soins de santé : le papier entre, les humains tapent, les erreurs s'accumulent, les coûts se multiplient. La technologie pour briser ce schéma existe désormais.
Foire aux questions
Combien d'ordonnances sont encore rédigées sur papier ?
Bien que 92 % des prescripteurs aient adopté la prescription électronique et qu'environ 2,64 milliards d'e-prescriptions aient été délivrées via le réseau Surescripts en 2025, un volume important arrive encore sur papier, par téléphone ou par fax. Avec un total d'ordonnances au détail estimé à environ 5 milliards par an, près de 2 milliards d'ordonnances non électroniques sont entrées dans le flux de travail de la pharmacie — même si toutes ne sont pas littéralement « papier ». Les commandes téléphoniques, les fax et les ordonnances papier pour substances contrôlées nécessitent une saisie manuelle dans le système de gestion de la pharmacie. La répartition exacte entre e-prescriptions et prescriptions à saisie manuelle varie selon l'État, le type de pharmacie et la composition des prescripteurs.
Pourquoi les pharmacies ne peuvent-elles pas simplement scanner les ordonnances et les faire lire par l'ordinateur ?
Les systèmes de gestion de pharmacie traditionnels comme PioneerRx, QS/1 NRx, Computer-Rx et Rx30 n'ont pas été conçus avec la reconnaissance d'écriture manuscrite ou la compréhension sémantique de documents. Ce sont des plateformes de traitement des transactions et de flux de délivrance. Le scan crée une image — un fichier de référence — mais le système n'a pas la capacité d'extraire des données structurées de cette image. Le technicien doit lire l'image et saisir les champs. Les nouveaux outils d'extraction de documents basés sur l'IA peuvent combler cette lacune en lisant l'image scannée, en comprenant les champs de manière sémantique et en produisant des données structurées — mais l'intégration avec les plateformes PMS héritées n'est pas encore standard.
Quelles sont les erreurs les plus courantes dans la saisie manuelle des ordonnances ?
Les erreurs les plus fréquentes se regroupent autour de trois domaines : la confusion des noms de médicaments (en particulier les paires LASA comme prednisone/prednisolone ou clonidine/Klonopin), la mauvaise interprétation des SIG (QD vs. QID, « une fois par jour » vs. « quatre fois par jour » — une seule lettre d'écart dans l'écriture manuscrite mais une différence de dosage quadruple), et les erreurs de quantité numérique (lecture erronée du 7 manuscrit pour 9, du 1 pour 7, en particulier dans les champs de renouvellement et de jours de traitement). Une revue systématique de 2023 dans les Annales de Médecine & Chirurgie a documenté que 1,7 % à 24 % des ordonnances sont délivrées de manière erronée, l'illisibilité de l'écriture manuscrite étant un facteur principal.
L'extraction par IA fonctionne-t-elle avec les ordonnances de substances contrôlées ?
Oui — l'IA visuelle peut lire et extraire les données des ordonnances des annexes II à V de la même manière que pour les ordonnances non contrôlées. L'écriture manuscrite, les champs et la structure des données sont identiques. Ce qui diffère, c'est le traitement réglementaire des données extraites : les ordonnances de substances contrôlées sont soumises à des exigences légales supplémentaires concernant la vérification du numéro DEA, les vérifications du programme de surveillance des ordonnances (PMP) et la conservation des dossiers. Les outils d'extraction par IA ne remplacent pas ces étapes de conformité — ils gèrent la partie saisie des données, et le flux de travail existant en pharmacie pour la vérification des substances contrôlées reste inchangé. La condition essentielle est que l'outil d'extraction fonctionne dans un environnement conforme à la HIPAA avec un contrat de sous-traitance signé.
Cela remplace-t-il l'étape de vérification du pharmacien ?
Non. Dans tous les États, le pharmacien est légalement tenu d'effectuer une vérification finale de chaque ordonnance avant la délivrance — en comparant l'ordonnance originale aux données saisies, en vérifiant les interactions médicamenteuses, en confirmant la pertinence clinique et en s'assurant de l'exactitude de l'étiquetage. L'extraction par IA gère l'étape de saisie des données qui précède la vérification : lire l'ordonnance manuscrite et remplir les champs du PMS. Le jugement clinique du pharmacien, la revue d'utilisation des médicaments (DUR) et la vérification finale de l'exactitude restent inchangés. Ce qui change, c'est que le pharmacien et le technicien passent moins de temps sur la transcription et plus de temps sur les tâches cliniques pour lesquelles leurs licences existent.
Le goulot d'étranglement de la saisie de données en pharmacie ne va pas se résoudre tout seul — les ordonnances papier ne disparaissent pas. Mais la technologie pour les lire, extraire leur contenu et remplir les champs du PMS existe déjà.
Téléverser une ordonnanceLes fichiers sont traités en toute sécurité et ne sont pas stockés.