色付き背景でOCRが失敗するのはなぜ?
4つの原因と具体的な修正方法
あなたのOCRは白い紙に黒い文字を完璧に読み取ります。同じ文字を薄い青の請求書ヘッダー、黄色い納品書、または「DRAFT」透かしの背後に置くと、精度は20〜40%低下します。これはランダムな失敗ではありません。予測可能な原因と具体的な修正方法があるコントラストの問題です。
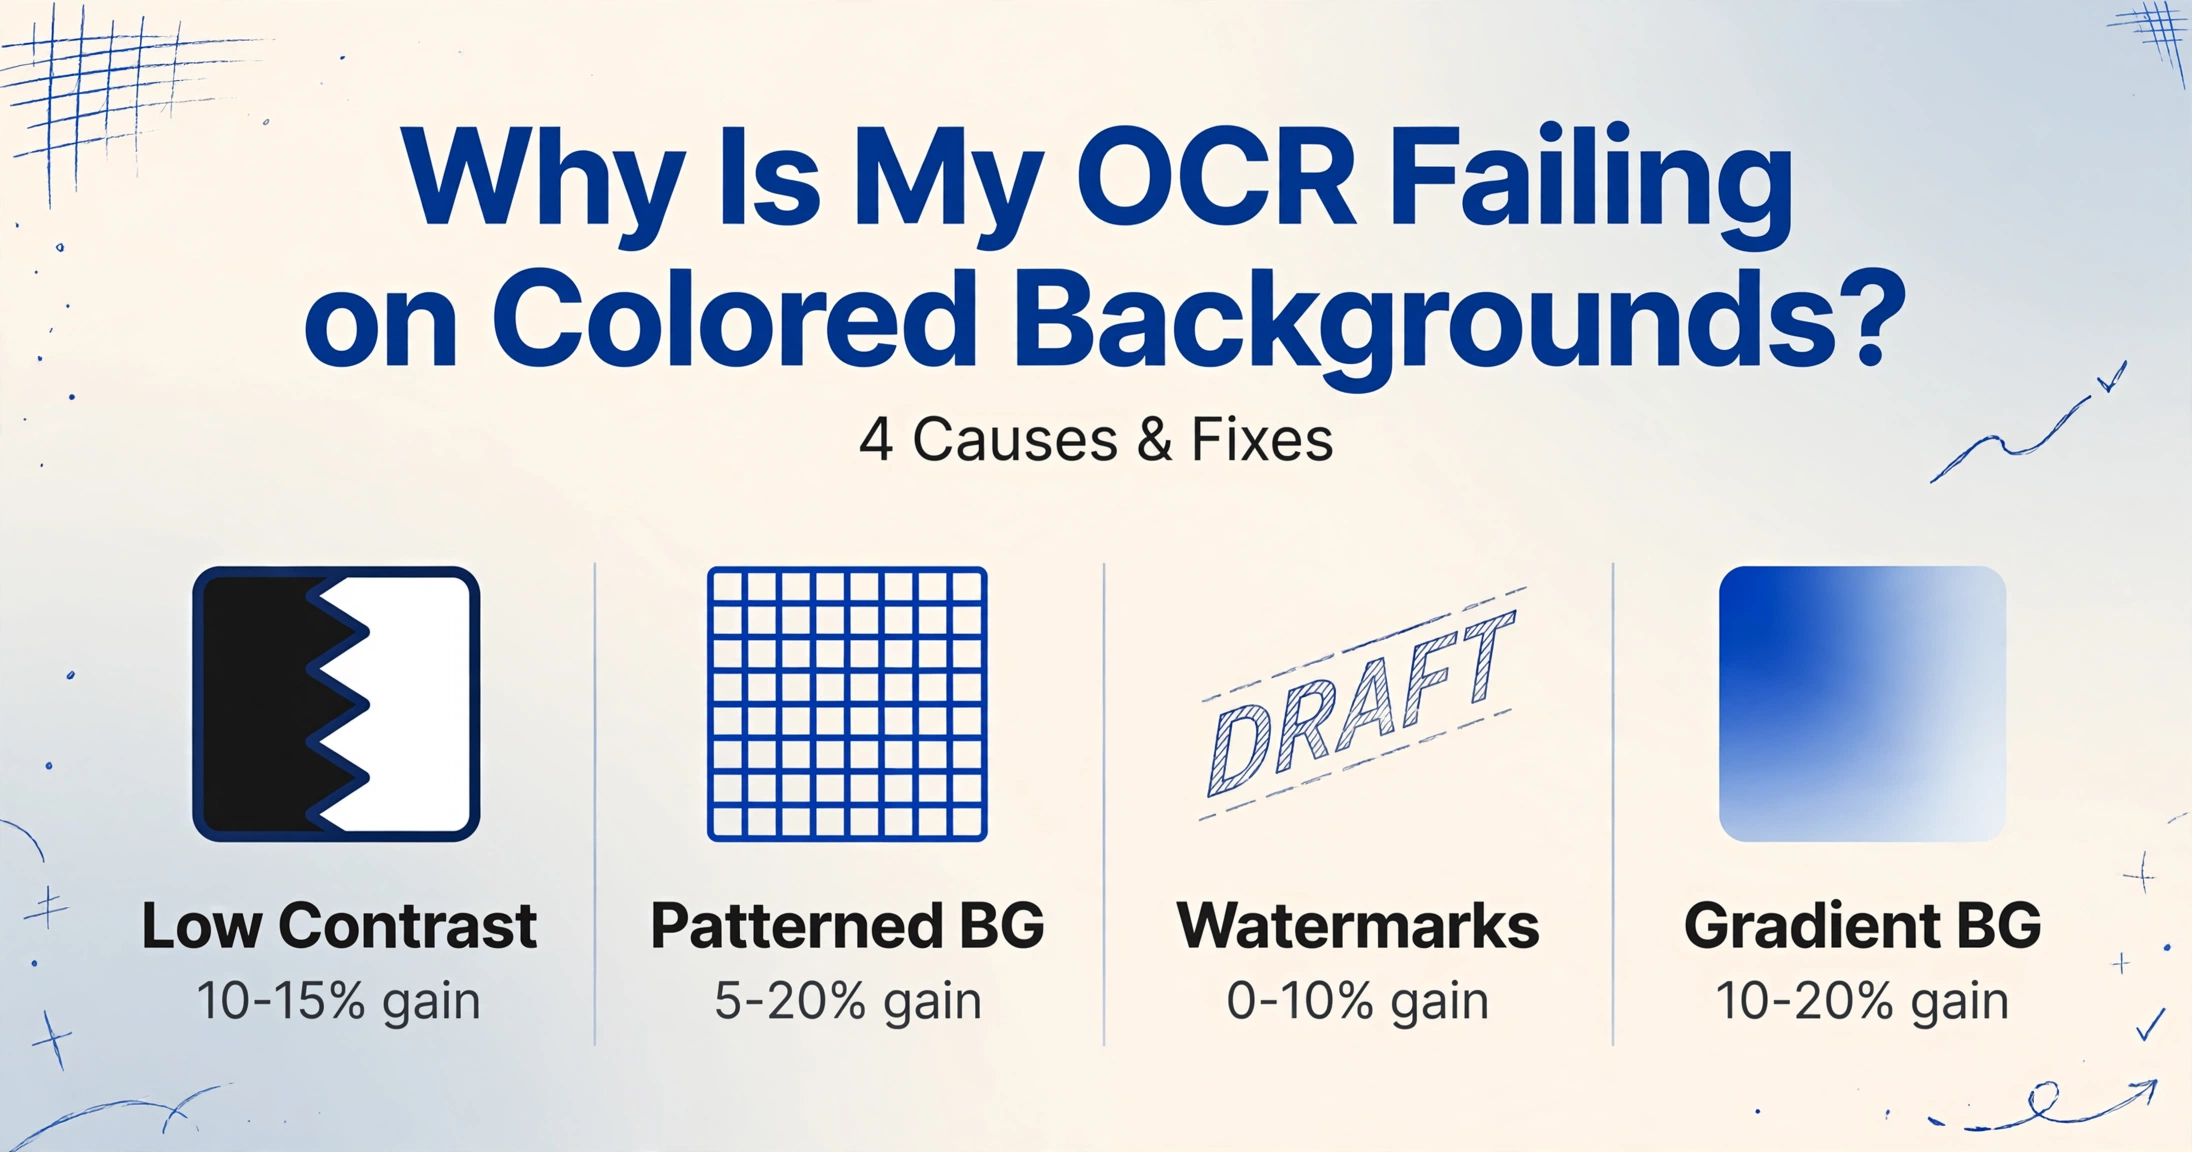
重要なポイント
- あなたのOCRは白い紙の上で同じフォントを98%の精度で読み取りますが、背景が薄い青に変わった瞬間に60%まで低下します。あなたは両方を読むことができます。機械はそもそもそのように設計されていませんでした。
- 4つの無関係な問題が同じ症状を共有しています。低コントラストにはレベル調整が必要です。セキュリティパターンには局所適応しきい値処理が必要です。透かしは、そのピクセルが文字と物理的に重なるため、すべての前処理を無効にします。グラデーションにはウィンドウごとのしきい値が必要です。間違った修正では、改善はゼロです。
- 従来のOCRは、すべてのピクセルで「文字かノイズか」に答えなければならないため失敗します。色付き背景はその質問に答えられなくします。ビジョンAIはその質問を完全にスキップし、各ピクセルを一つずつ見つめる代わりに、ドキュメントが何を言っているかを理解することで、人間が読むようにページを読み取ります。
もどかしいのは、文書はあなたには問題なく読めることです。OCRツールは正しいフォントを学習済みで、白いページ上の同じテキストは完璧に処理できます。しかし、淡い色の背景、セキュリティパターン、または薄い「CONFIDENTIAL」スタンプが加わると、98%の精度だった同じエンジンが、文字化けしたフィールドだらけのスプレッドシートを返してきます。
重要なポイント:「背景の問題」は1つの問題ではありません。それぞれ異なる根本原因と異なる修正方法を持つ、4つの異なる障害メカニズムです。間違った修正を適用しても—例えば、実際には透かしの問題がある文書にコントラストを追加しても—間違った層を修正していることになるので効果はありません。それぞれの診断方法は次のとおりです。
原因1:テキストと背景のコントラストが低い
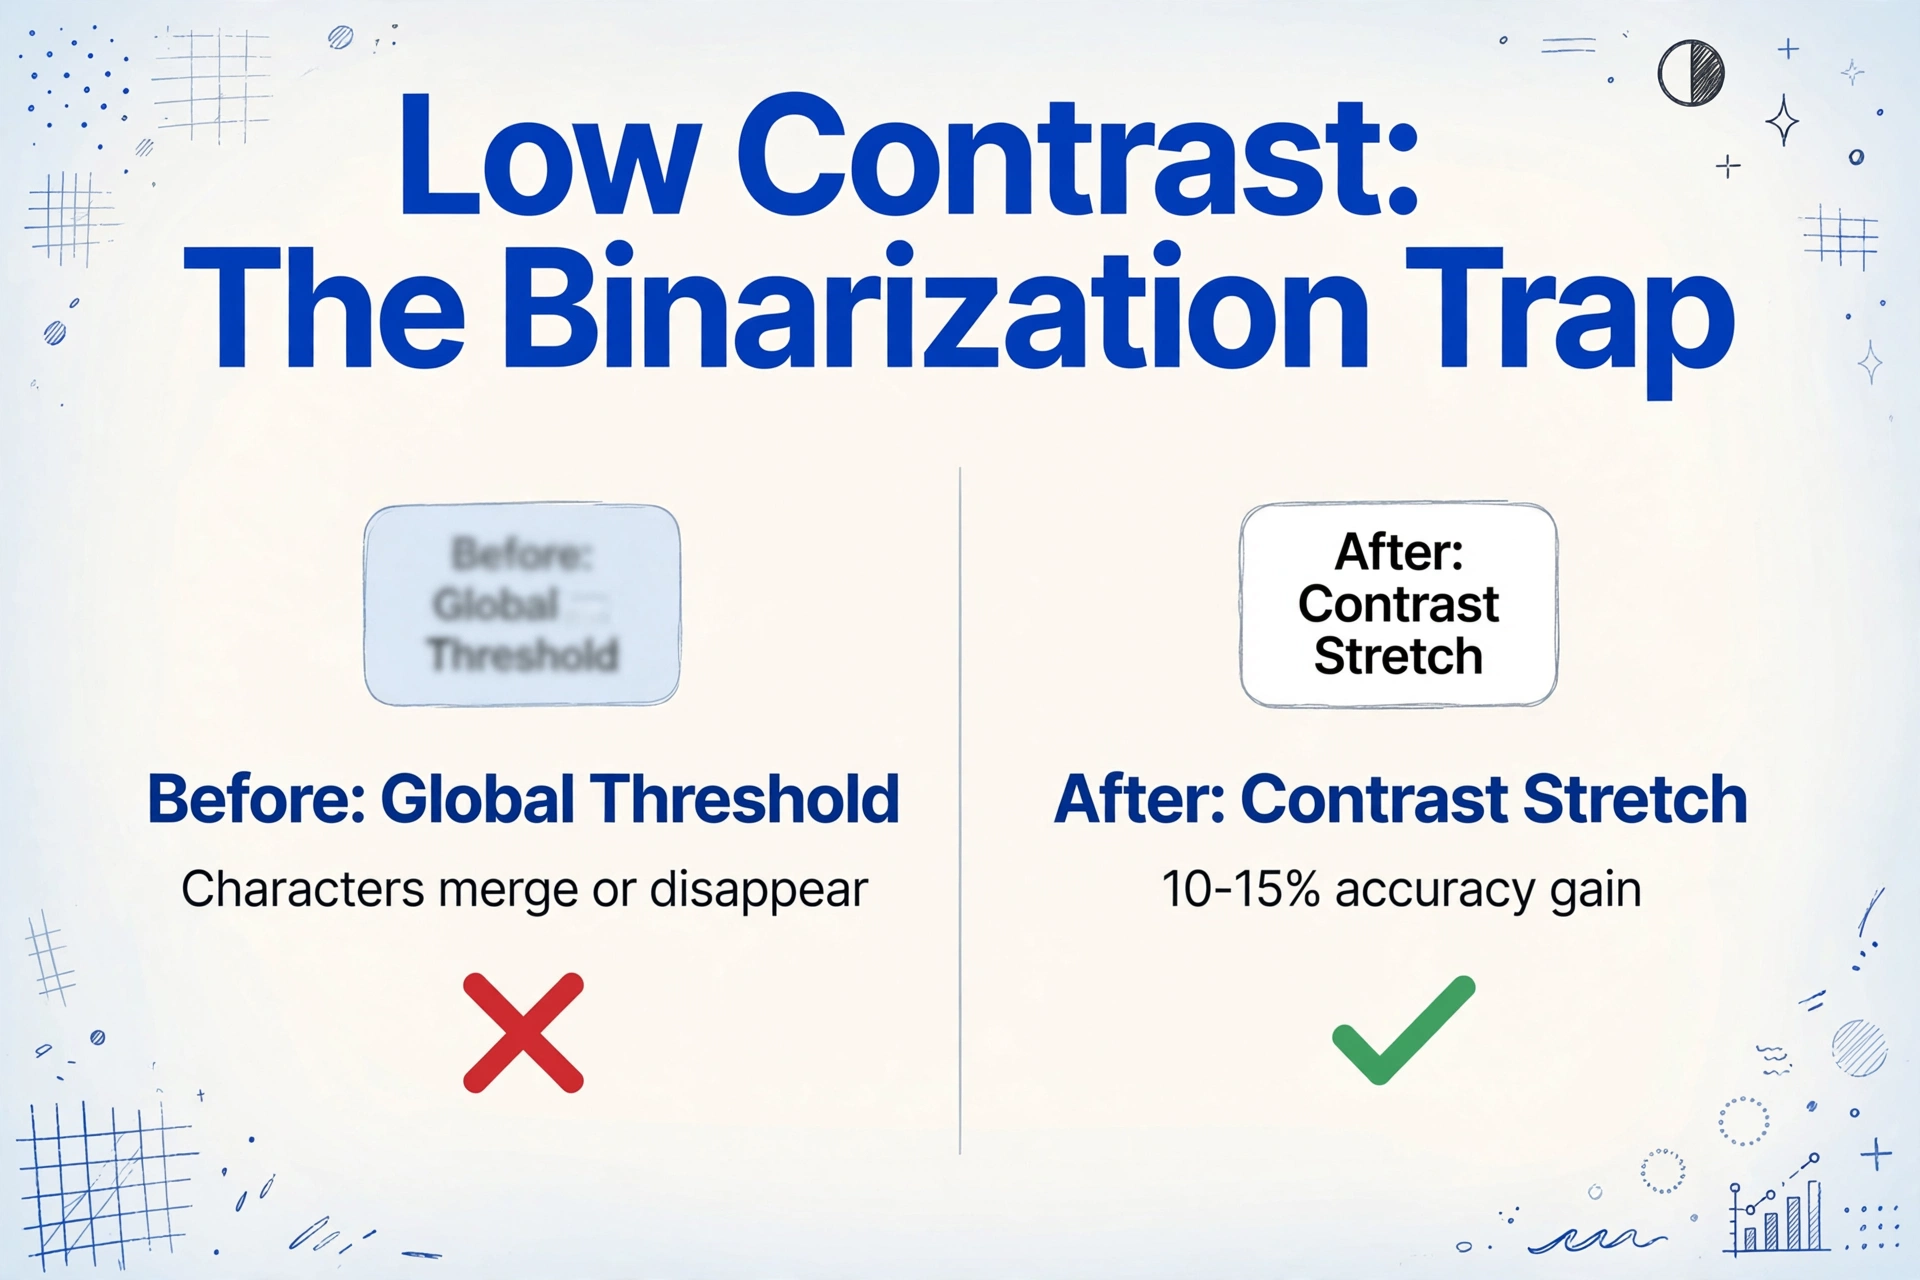
これは最も一般的な原因であり、修正も最も簡単です。従来のOCRは画像を二値化—明るさのしきい値に基づいて各ピクセルを黒か白かに変換する—ことで機能します。ピクセルがしきい値より暗ければテキスト、明るければ背景です。これは文書が白い紙に黒いテキストの場合にうまく機能します。インクと紙の明るさの差が十分に大きいため、単一のグローバルなしきい値で2つをきれいに分離できます。
では、薄い青の背景にグレーのテキストを置いてみましょう。テキストのピクセルは背景のピクセルよりわずかに暗いだけです。Tesseractのような従来のOCRエンジンがデフォルトで使用するグローバルなしきい値では、これらをきれいに分離できません。一部のテキストピクセルが間違った側に渡ります。文字が結合したり消えたりします。「7」は横棒が消えて「1」と読まれます。「8」は上のループがしきい値を背景として越えたため「3」になります。
診断方法:スキャンした画像を任意のフォトエディタで開き、グレースケールに変換します。彩度を落とした後、テキストが自分の目で読みにくくなった場合、従来のOCRにはコントラストが低すぎます。
修正方法:OCRを実行する前に、コントラストストレッチまたはレベル調整を適用します。ほとんどのスキャンソフトウェアと画像エディタには「オートコントラスト」または「オートレベル」機能があります—これだけで失われた精度の10〜15%を回復できることがよくあります。業務文書の場合は、グレースケールモード(カラーでもビットナルの白黒でもなく)でスキャンしてみてください。米国政府印刷局のOCR最適化に関する調査では、グレースケールスキャンは標準文書で98.26%の精度を達成しましたが、ビットナル(純粋な白黒)スキャンは77.12%に低下しました—二値化のステップがOCRに必要な情報そのものを除去してしまうのです(GPO、OCR精度の最適化)。
原因2:パターン背景
低コントラスト(偶発的に発生)とは異なり、パターン背景はOCRを無効化するために意図的に設計されることがあります。小切手のセキュリティパターン(細線のギヨシェ背景、マイクロ印刷、虹色の帯)、証明書の偽造防止シール、さらにはエンジニアリング記録用紙の方眼紙などは、OCRエンジンが除去できない視覚ノイズの層を作り出します。
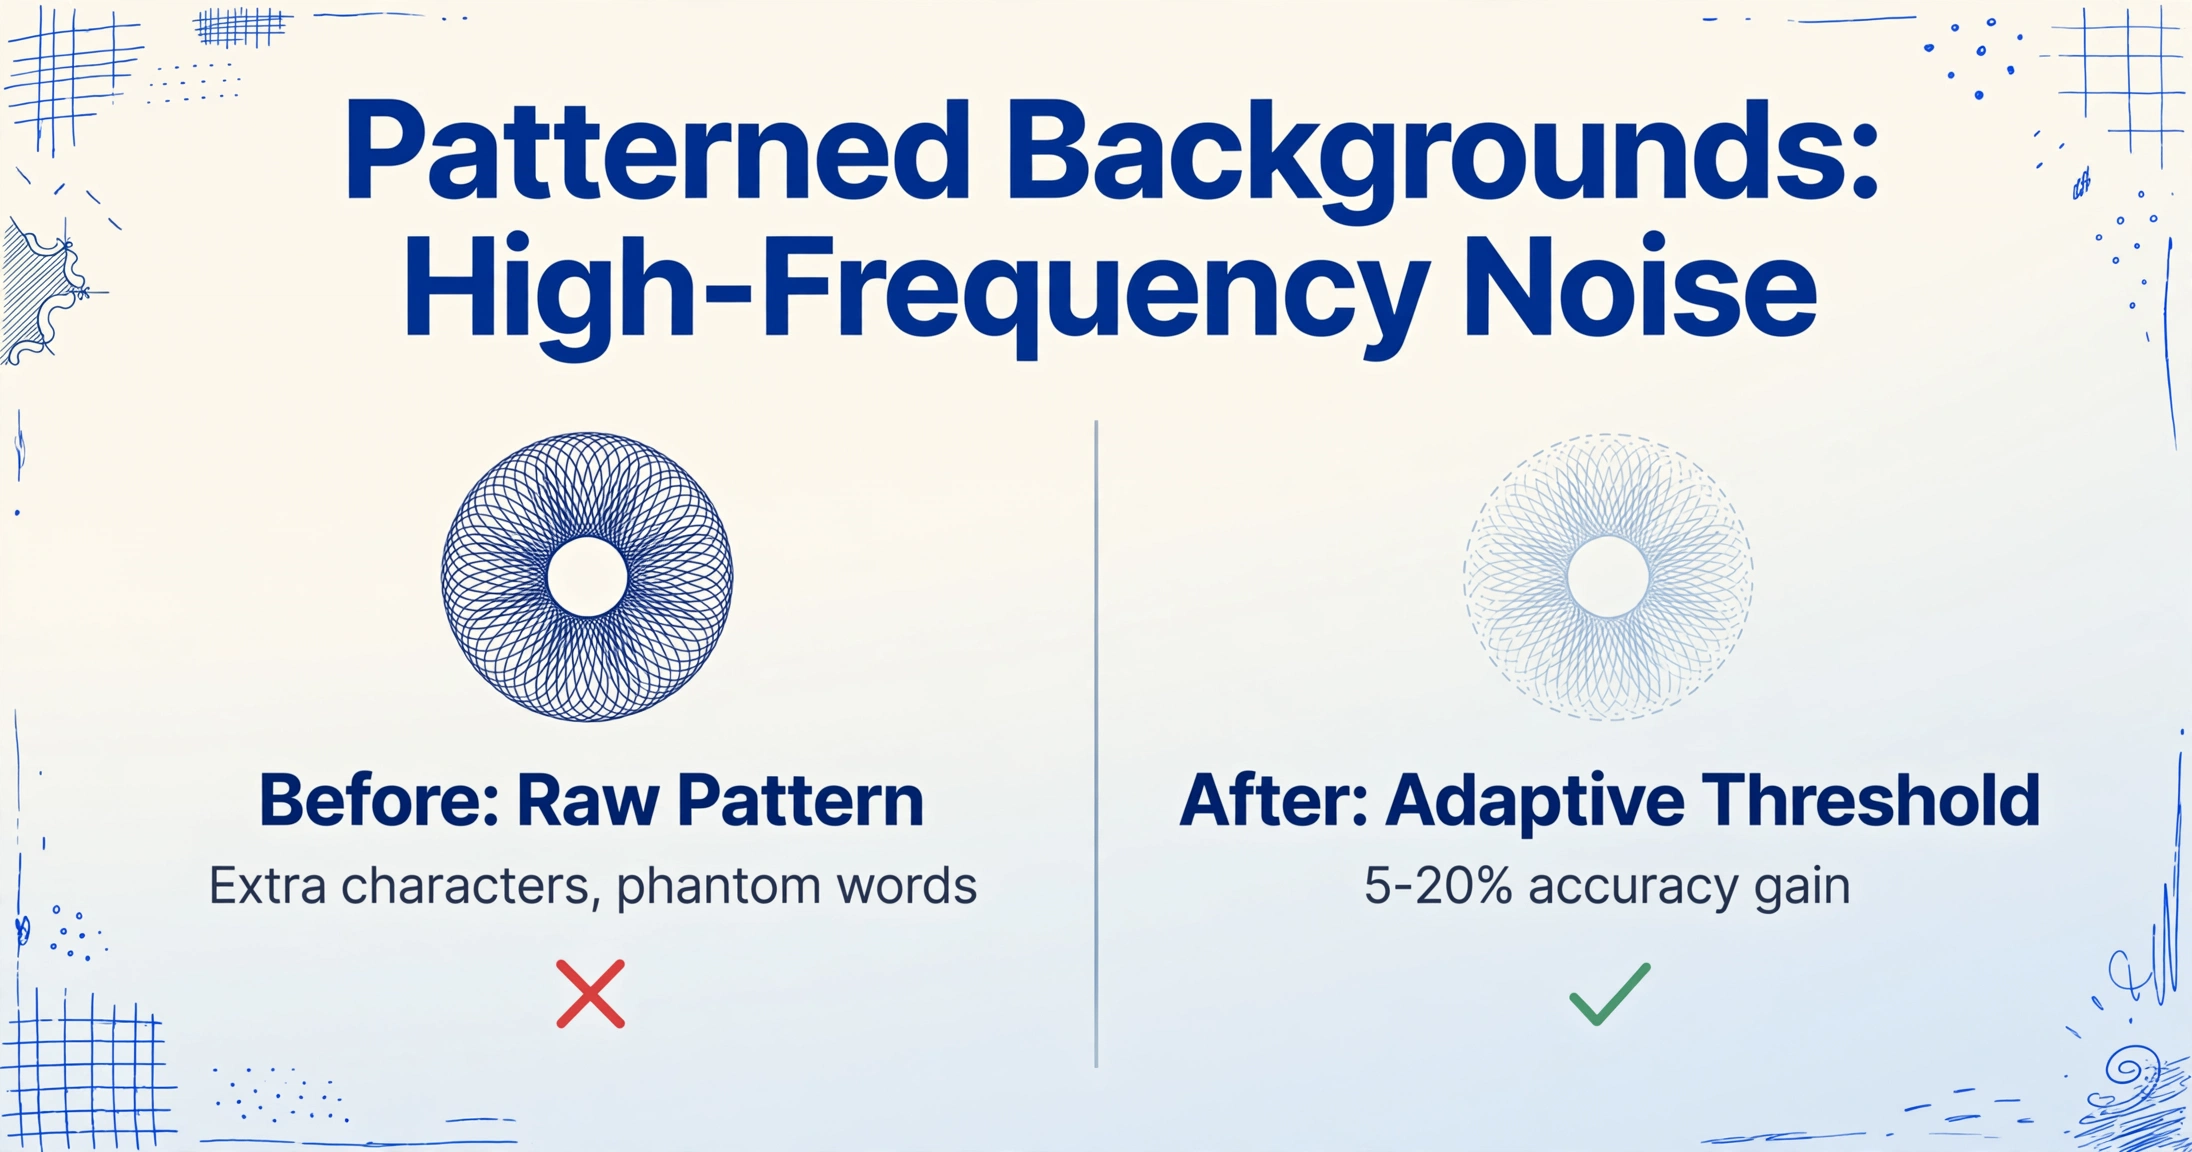
その仕組みは低コントラストとは異なります。小切手のセキュリティ背景は低コントラストではなく、高周波のディテールです。OCRエンジンは二値化処理中に、パターンに属する何百万もの小さな暗いピクセルを認識します。エンジンは「無視すべきパターンピクセル」と「保持すべきテキストピクセル」を区別できません。その結果、テキストがノイズの斑点状のフィールド上に配置された二値画像が生成されます。エンジンは実際のテキストと背景のアーティファクトの混在から文字を形成しようとします。余分な文字、壊れた文字、元の文書には存在しない幻の単語が生成されます。
診断方法:文書を200〜400%にズームインします。主テキストの周囲に細い線、ドット、波模様、またはマイクロテキストが織り交ざっている場合、背景パターンが問題です。テキスト領域が銀行小切手の背景や証明書の枠線のように見える場合、これが原因です。
修正方法:前処理だけではパターン背景を修正することはほとんどありません。パターンを消去するのに十分な強力なノイズ除去は、テキストもぼやけさせます。最も実用的な修正は、グレースケール変換後に局所適応しきい値処理(大津の二値化法、Sauvolaアルゴリズム)をグローバルしきい値の代わりに使用することです。画像全体を単一の輝度レベルで切り取る単一のグローバルしきい値とは異なり、適応しきい値処理は画像を小さなウィンドウに分割し、ウィンドウごとに最適なしきい値を計算します。これにより、パターンが最も密集している領域でもテキストのエッジが保持されます。
別の正直な注意点:一部のセキュリティパターンは機械が読み取ることを意図していません。銀行小切手の複雑な背景は不正抑止機能です。銀行や決済処理業者は、従来のOCRが小切手のセキュリティ背景からデータを確実に抽出できないため、画像ベースの決済システム(米国のCheck 21)に移行しました。標準的なOCRで小切手を処理し、受取人欄や金額で一貫して失敗する場合、これはツールのバグではありません。設計どおりに動作しているのです。
原因3:透かし
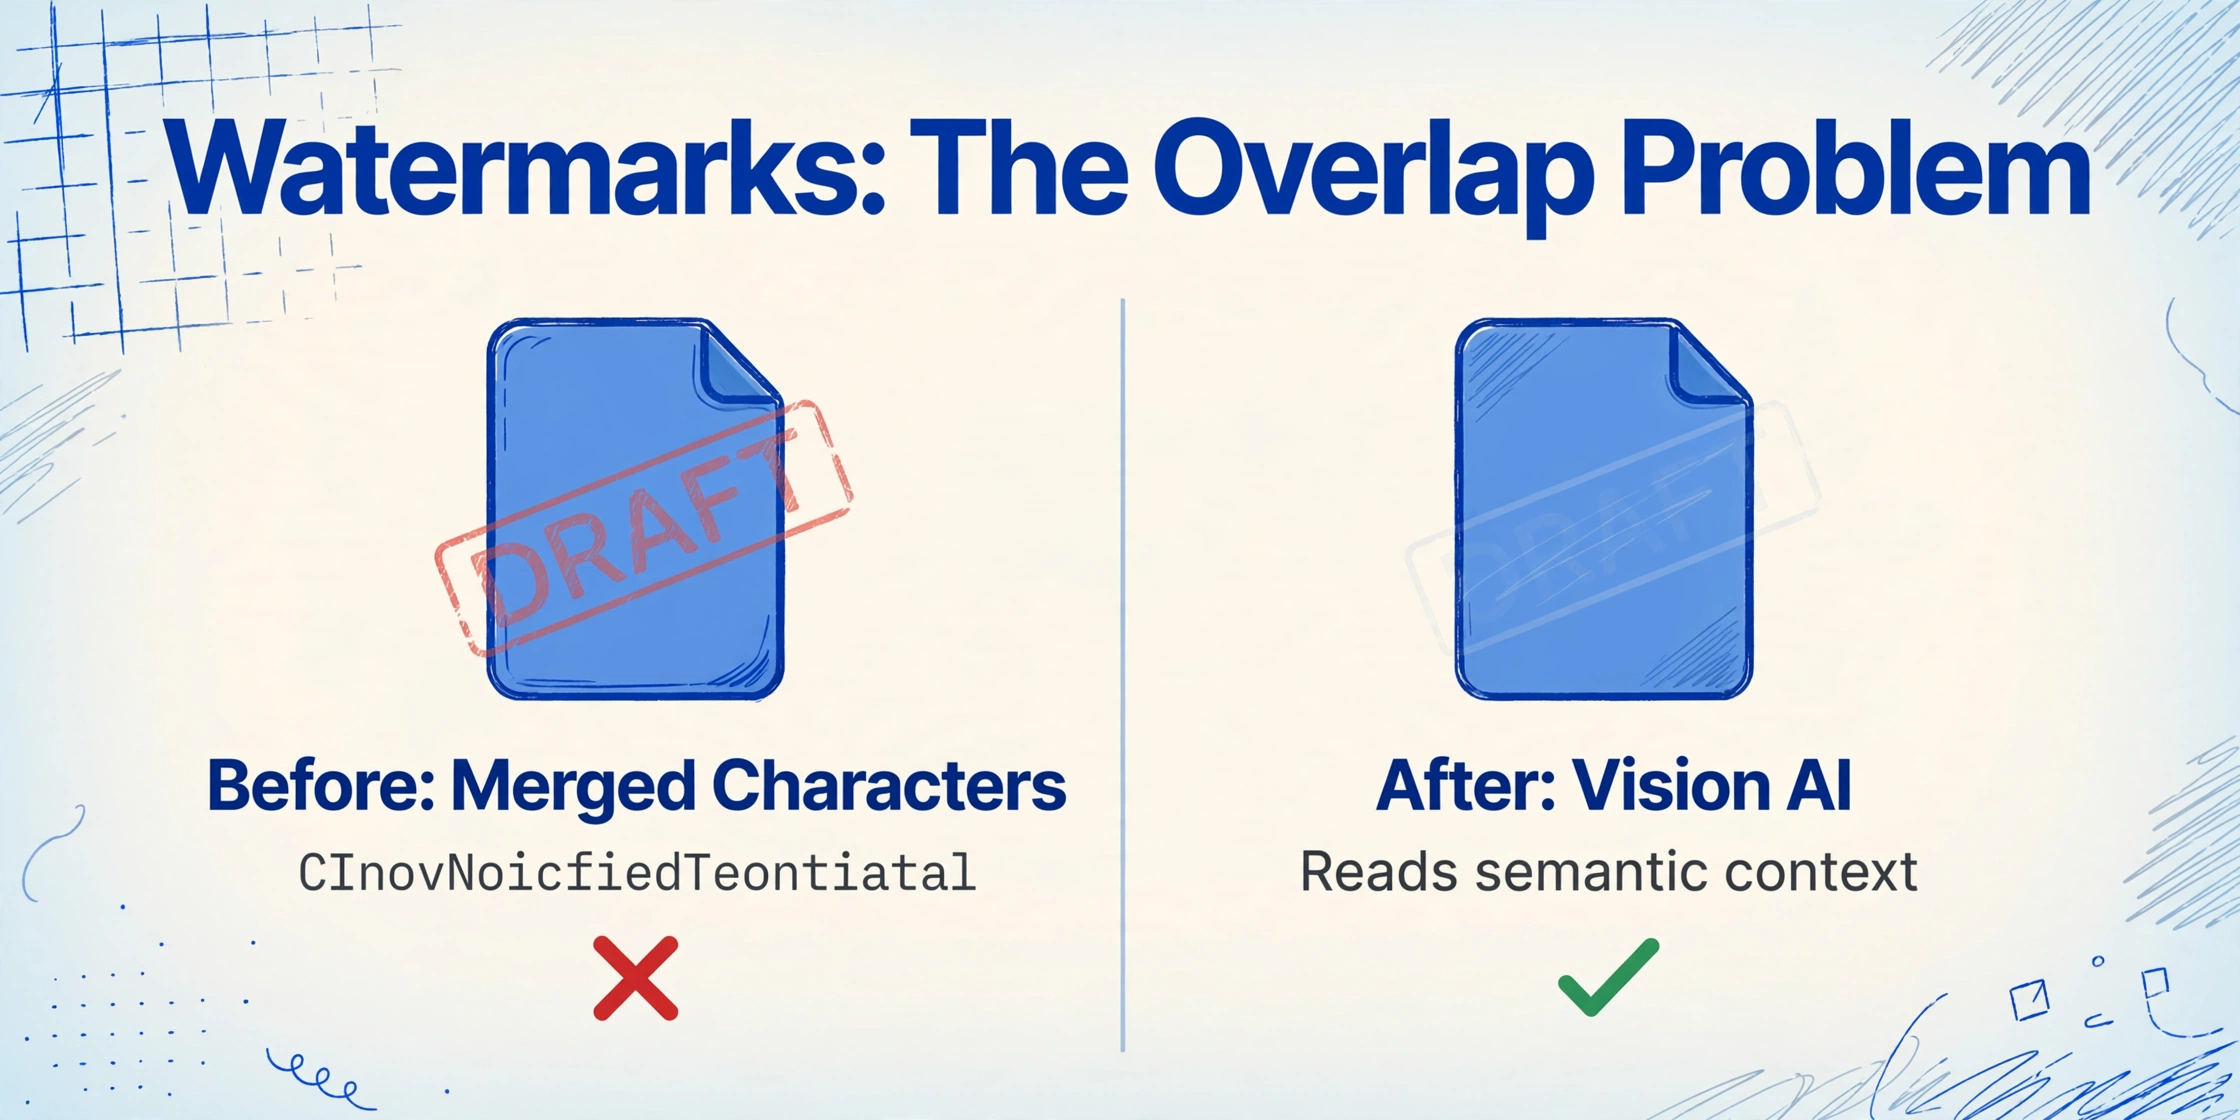
この原因は、文書が人間の目には完全に読みやすく見えるため、最も経験豊富なユーザーでさえつまずくポイントです。「DRAFT」や「CONFIDENTIAL」といった透かしは、ページ上に斜めに重ねられた半透明のテキストです。読む際、あなたは無意識に透かしをフィルタリングし、実際のコンテンツだけを読み取ります。従来のOCRにはそのようなフィルタはありません。実際のテキストと重なる透かしのピクセルを含む、すべての可視ピクセルを読み取ります。
その結果、文字が混ざり合ったストリームが生成されます。文書に「Invoice Total: $1,250.00」と記載され、斜めの「CONFIDENTIAL」透かしが「Total」を横切る場合、OCRは「CInovNoicfiedTeontiatal: $1,C20E0.N00T」と出力する可能性があります。透かしはPDF編集アプリケーションのように別レイヤーではなく、半透明オーバーレイとしてピクセルデータに焼き込まれています。OCRエンジンは1つのレイヤーしか認識できず、それはすべてノイズです。
診断方法:テキスト領域に、角度(水平または斜め)で走るかすかな2番目のテキスト文字列があり、特に「DRAFT」「SAMPLE」「COPY」「CONFIDENTIAL」のような繰り返しの単語がある場合、透かしの問題があります。透かしが非常に薄くほとんど認識できない場合は、本文が正しく読み取られることもあります。危険ゾーンは中程度の不透明度の透かしで、実際のテキストと透かしの両方が文字認識に影響を与えるのに十分なピクセル密度を持つ場合です。
修正方法:これは最も難しい前処理修正です。コントラストやパターンの問題とは異なり、透かしは実際のテキストと同じピクセルに物理的に重なっています。しきい値調整では、ソース画像にきれいな分離がないため、それらをきれいに分離することはできません。
限られたケースで役立ついくつかのアプローチがあります:明るさを上げると、かすかな透かしピクセルが検出しきい値以下に減少する可能性があります。周波数領域フィルタ(FFTベースのバンドストップ)は、一貫した斜めの角度と間隔を持つ透かしを除去できます。ただし、どちらの手法も文書ごとの調整が必要で、その過程で実際のテキスト品質が低下します。Microsoft Azure Form Recognizerの製品チームは、透かし干渉を既知の制限として確認しており、一般的な回避策はありません(Microsoft Q&A、2023-2024)。
信頼できる修正はアーキテクチャ上のものです:ピクセル単位ではなく、文書を意味的に読み取るツールを使用することです。
原因4: グラデーション背景
グラデーションはコントラスト問題の特殊ケースであり、大域的な閾値処理の根本的な限界を露呈します。 グラデーション背景は、ページ上部の暗い色から下部の明るい色へ、またはヘッダーの青から本文の白へと変化します。グラデーション上に配置されたテキストは、複数の明るさ領域を横断します。グラデーションの暗い部分では、テキストの背景に対するコントラストが低くなります。明るい部分では、同じテキストでもコントラストが高くなります。
大域的な閾値(ページ全体に適用される単一の明るさの閾値)では、両方の領域を同時に解決できません。暗い領域のテキストを捉えるように閾値を設定すると、明るい領域の背景がテキストとして分類されます(誤検出)。明るい領域をきれいにするように設定すると、暗い領域のテキストが消失します。同じ文字「5」が、グラデーションの下部では正しく読み取られても、上部では完全に見逃される可能性があります。
診断方法: ドキュメントのヘッダーやバナー領域を確認します。背景色が徐々に別の色合いに変化している場合(濃いネイビーのヘッダーが薄い青にフェードする、または請求書上部の赤いバナーが白い本文にフェードするなど)、かつテキストがその遷移部分を横断している場合、原因はグラデーションです。症状は一貫性がありません。同じフォント、同じサイズ、同じドキュメントでも、ある領域では正しく抽出され、別の領域ではエラーが発生します。
修正方法: 適応的閾値処理がグラデーションに対する標準的な解決策です。各ローカルウィンドウに対して個別の閾値を計算するため、グラデーションの暗い側のテキストと明るい側のテキストのそれぞれに最適な二値化が適用されます。ほとんどの画像処理ライブラリ(OpenCV、Pillow、LEADTOOLS)は適応的手法をサポートしています。ウィンドウサイズは平均的な文字幅の約3倍に設定して適用します。小さすぎると、大きな均一領域をノイズとして扱います。大きすぎると、再び大域的な閾値のように動作します。
4つの原因すべてに共通する点: 従来のOCRはピクセルレベルの読み取り戦略に依存しています。低コントラスト、パターンの重なり、透かしテキストのオーバーレイ、グラデーションの明るさの変化などにより、ピクセルだけではテキストと背景をきれいに分離できない場合、エンジンは頼れる高次の理解を持ち合わせていません。「合計」フィールドがどのように見えるべきか、金額に何が含まれるべきか、または「CONFIDENTIAL」が請求書本文の一部ではないことを認識しません。
前処理が有効なケースとそうでないケース
原因別に最適な前処理手法をまとめた実践的な判断基準です:
| 原因 | 最適な前処理 | 期待される改善効果 | 限界 |
|---|---|---|---|
| 低コントラスト | グレースケール化+自動レベル補正/コントラスト伸張 | 精度が10~15%向上 | 文字と背景の輝度がほぼ同じ場合、どんなに伸張しても復元不可 |
| パターン背景 | 局所適応的二値化(Sauvola/Niblack) | パターン密度により5~20%向上 | セキュリティパターン(小切手、証明書)はこの手法への耐性が高く、文書により結果が異なる |
| 透かし | 輝度強調/周波数領域フィルタ | 0~10%と非常に不安定 | 透かしの画素が文字画素と物理的に重なるため、文字を損なわずに完全分離する前処理は不可能 |
| グラデーション背景 | 局所適応的二値化 | 精度が10~20%向上 | 滑らかな線形グラデーションには有効だが、複雑な多段グラデーションでは失敗する場合がある |
高度な手法へ:Vision AIが4つの問題すべてに優れる理由
上記の前処理を試しても、特に透かし入り文書や高密度パターン背景で抽出が不安定な場合、問題は画像ではなく抽出アーキテクチャにあります。従来のOCRはピクセルレベルの技術です。各ピクセルを文字か背景かに二値化し、その結果から文字を構成します。ピクセルが曖昧な場合、エンジンは代替戦略を持たないため失敗します。
Vision AIモデル(VLMベースまたはLLM OCRとも呼ばれる)は、意味レベルで文書を読み取ります。画像を二値化せず、フルカラー画像を処理し、文書構造を理解し、テキスト領域を特定した上で、文脈に沿ってテキストを読み取ります。これは人間が透かし入り文書を読む際に、無意識にオーバーレイを無視するのと同じ仕組みです。このアーキテクチャ上の違いにより、Vision AIは4つの背景問題すべてに、多くの場合前処理なしで対応できます:
- 低コントラスト:白黒の明確な境界を探すのではなく、文字形状と単語の文脈から薄い文字を認識
- パターン背景:学習時に文字と背景パターンを区別する方法を習得し、パターンを文字候補ではなく視覚的ノイズとして処理
- 透かし:文書の意味内容を理解することで本来の文字を読み取る。重なった「DRAFT」表記に惑わされず、文脈から本文の文字を識別
- グラデーション:単一の輝度閾値に依存しないため、グラデーションの変化が文字単位の認識失敗を引き起こさない
ImageToTable.aiは、このビジョンAIアプローチを使用します。色付き背景、透かし、グラデーション、またはその3つすべてが含まれたドキュメントをそのままアップロードし、必要なデータを指定するだけです。AIは人間が読むのと同じようにページ全体を読み取り、指定したフィールドをドキュメント上のどこからでも抽出します。これが、位置ベース抽出(標準的でない背景では脆弱)とセマンティックベース抽出(ドキュメントの見た目に関係なく機能)の違いです。
関連する議論として、AIはぼやけたドキュメントを読めるか?では、ビジョンAIが画質の問題に対してどのように優雅に劣化するかを説明しています。同じアーキテクチャ上の利点が背景干渉にも当てはまります。また、テキストベースと画像のみのコンテンツが混在するドキュメントを扱う場合は、PDFタイプの解説が、お使いのツールがどのレイヤーから読み取っているかを特定するのに役立ちます。
よくある質問
OCRを実行する前に透かしを削除してもいいですか?
確実にはできません。半透明の透かしは画像ピクセルにブレンドされています。削除するには、その下にある元のピクセル値を推定する必要がありますが、これは数学的に不良設定問題であり、単一の正解はありません。「透かし除去」を謳うツールは、微細なテキストの詳細も除去する周波数フィルターか、欠落したコンテンツを推測するインペインティングアルゴリズムのいずれかを使用します。重要なドキュメントデータの場合、透かし除去は解決するよりも多くのエラーを引き起こします。
グレースケールでスキャンすれば、すべての背景の問題は解決しますか?
いいえ、しかし最も一般的な問題は解決します。グレースケールスキャンは、OCRがテキストと背景を区別するのに役立つ輝度情報を保持します。前述のGovernment Printing Officeの調査では、グレースケールにより標準的なドキュメントの精度が77%(ビトーナル)から98%に向上しました。しかし、グレースケールだけでは、透かし(オーバーレイはグレースケール画像にも残ります)、高密度のセキュリティパターン、または極端な低コントラストを修正することはできません。
銀行の小切手がどのOCRツールでも機能しないのはなぜですか?
銀行の小切手は、改ざんや偽造を防ぐために特別に設計されたセキュリティ背景(細線のギヨシェパターン、マイクロプリンティング、色が変化するデザイン)を使用しています。これらのパターンは、意図的に機械での処理を困難にしています。ほとんどの自動小切手処理システム(米国のCheck 21など)は、まさにこの理由から、全ページOCRではなく、画像ベースのキャプチャと磁気インク文字認識(MICR)を使用しています。小切手からデータを抽出する必要がある場合は、従来のOCRよりもビジョンAIツールの方が優れたパフォーマンスを発揮しますが、それでも小切手のセキュリティ機能は課題として残ります。
AIツールは従来のOCRよりも色付き背景の処理に優れていますか?
はい、大きな差があります。従来のOCRは色付き背景をピクセルレベルの問題として扱いますが、Vision AIは文書全体を視覚的なシーンとして捉え、各ピクセルを二値化するのではなく、文脈の中でテキストを読み取ります。低コントラストやグラデーション背景ではその差は顕著で、Vision AIは90%以上の精度を維持できるのに対し、従来のOCRは60〜70%に低下します。透かしやセキュリティパターンについても、Vision AIは背景を「除去」しようとせず、そのまま読み取るため、依然として優位性があります。
ドキュメントにコントラストの問題があるか不明ですか?アップロードして確認しましょう。
抽出の失敗が前処理で修正できるのか、それとも別のツールが必要なのかを確認する最速の方法は、試してみることです。ImageToTable.aiは、色付き背景、透かし、グラデーションを含むドキュメントを、セットアップ不要、テンプレート不要、前処理の調整なしでそのまま処理します。ファイルをアップロードして、結果を確認してください。
ドキュメントをアップロード →サインアップは不要です。10秒で結果が表示されます。