¿Por qué falla mi OCR en fondos de colores?
4 causas y soluciones específicas
Su OCR lee texto negro sobre papel blanco a la perfección. Ponga el mismo texto en un encabezado de factura azul claro, un albarán amarillo o detrás de una marca de agua de "BORRADOR", y la precisión cae un 20-40%. Esto no es un fallo aleatorio. Es un problema de contraste con causas predecibles y soluciones específicas.
Conclusiones clave
- Su OCR lee la misma fuente con un 98% de precisión en papel blanco, y cae al 60% en cuanto el fondo se vuelve azul claro. Usted puede leer ambos. La máquina nunca fue diseñada para ello.
- Cuatro problemas no relacionados comparten el mismo síntoma. El bajo contraste necesita un ajuste de niveles. Los patrones de seguridad necesitan umbralización adaptativa local. Las marcas de agua vencen a todo el preprocesamiento porque sus píxeles se superponen físicamente al texto. Los degradados necesitan umbrales por ventana. Solución equivocada, cero mejora.
- El OCR tradicional falla porque debe responder "¿texto o ruido?" en cada píxel, y los fondos de colores hacen esa pregunta imposible de responder. La Vision AI omite la pregunta por completo, leyendo la página como lo haría una persona, entendiendo lo que dice el documento en lugar de mirar cada píxel uno por uno.
La parte frustrante es que el documento se ve bien para usted. Puede leerlo. La herramienta de OCR claramente tiene la fuente correcta entrenada: maneja el mismo texto perfectamente en una página blanca. Pero agregue un fondo de color claro, un patrón de seguridad o un sello tenue de "CONFIDENCIAL", y el mismo motor que le dio 98% de precisión le entrega una hoja de cálculo llena de campos corruptos.
La idea clave: Los "problemas de fondo" no son un solo problema. Son cuatro mecanismos de falla distintos, cada uno con una causa raíz diferente y una solución diferente. Aplicar la solución incorrecta — por ejemplo, agregar más contraste a un documento que en realidad tiene un problema de marca de agua — no ayudará porque está resolviendo la capa equivocada. Así es como se diagnostica cada uno.
Causa 1: Bajo Contraste Entre Texto y Fondo
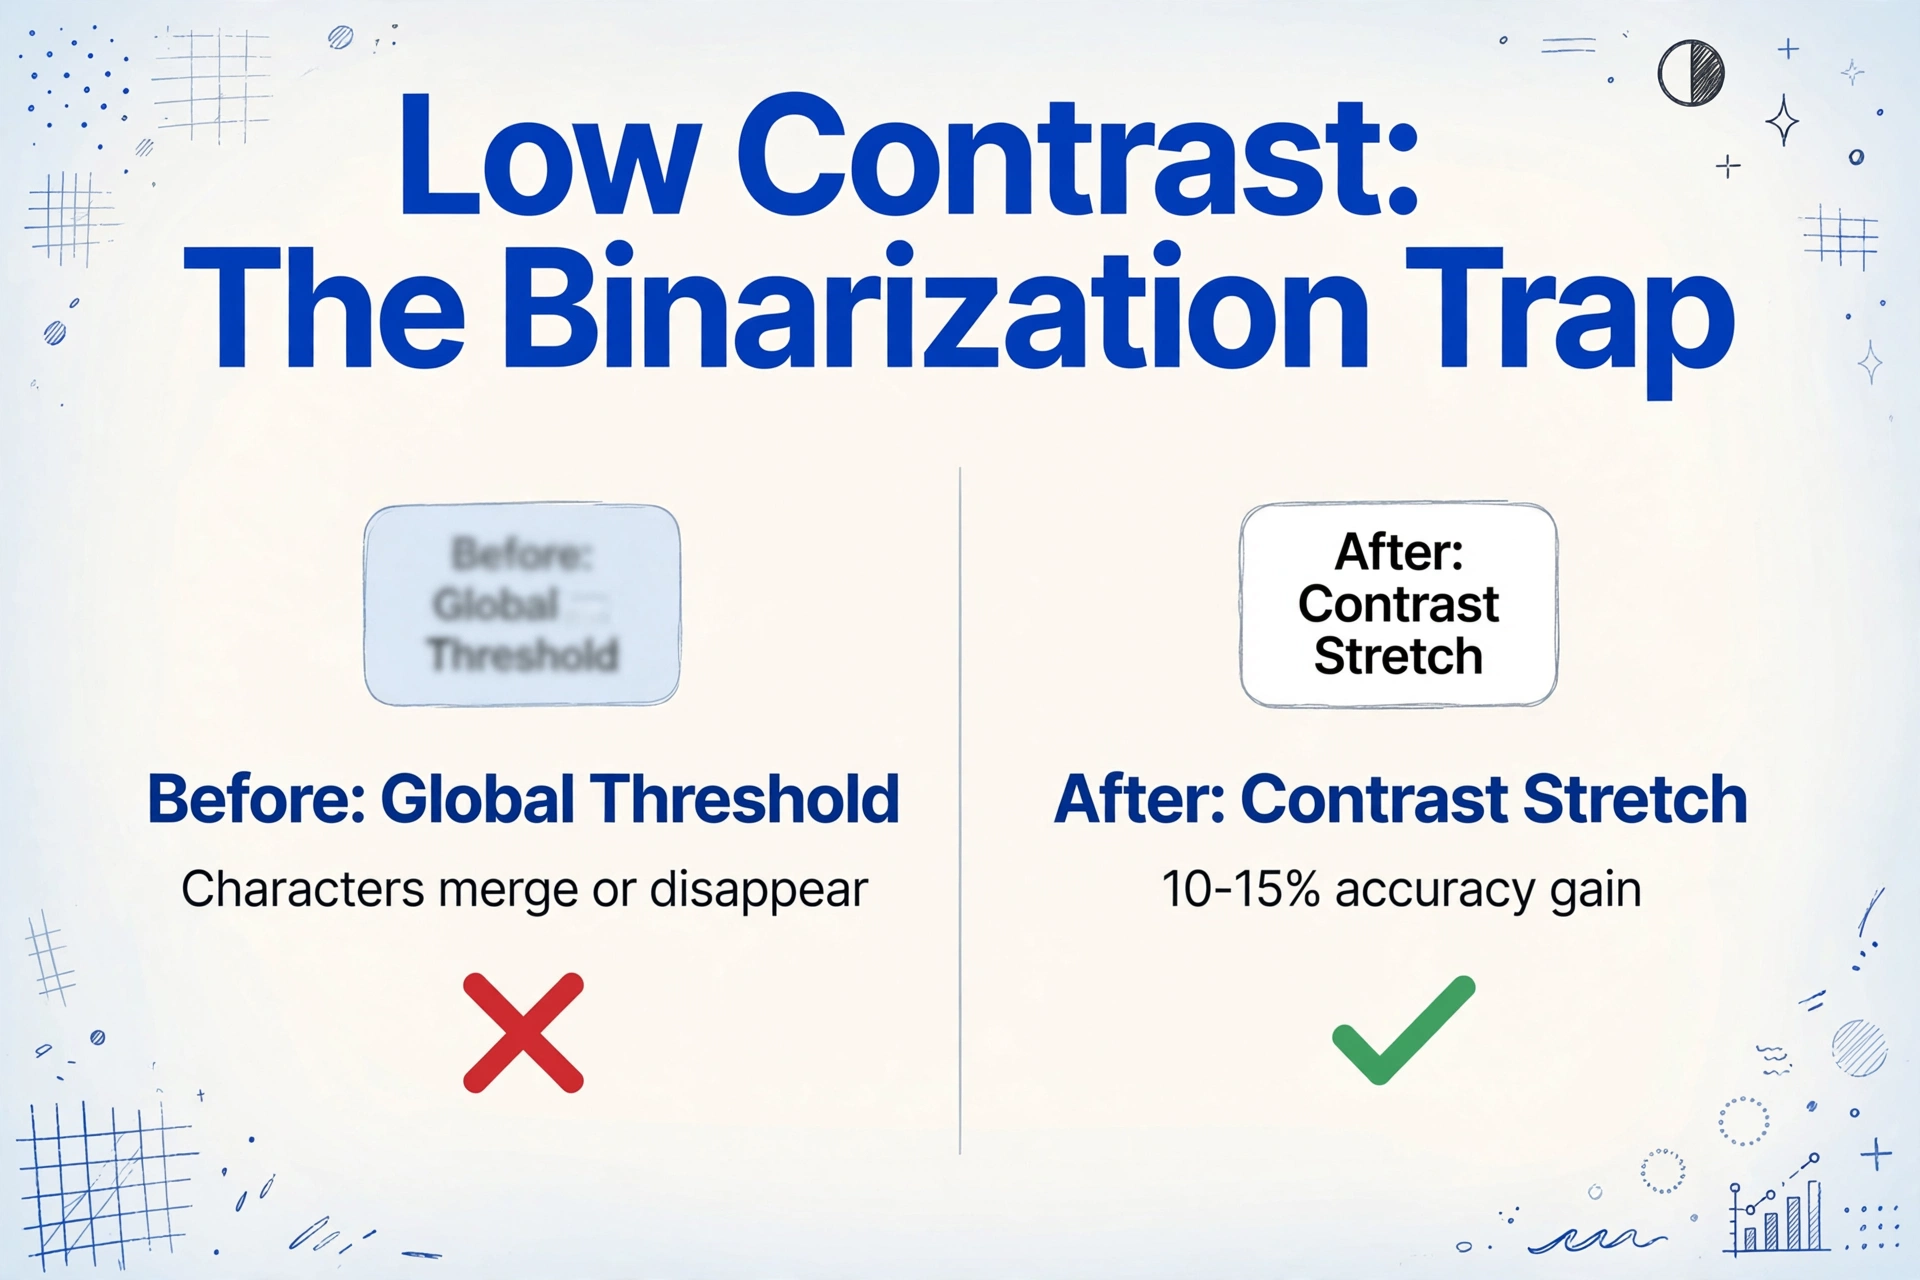
Esta es la causa más común y la más fácil de solucionar. El OCR tradicional funciona binarizando una imagen: convierte cada píxel a negro o blanco según un umbral de brillo. Si un píxel es más oscuro que el umbral, es texto. Si es más claro, es fondo. Esto funciona bien cuando el documento es texto negro sobre papel blanco: la brecha de brillo entre tinta y papel es lo suficientemente grande como para que un solo umbral global separe limpiamente ambos.
Ahora ponga texto gris sobre un fondo azul claro. Los píxeles del texto son solo ligeramente más oscuros que los del fondo. Un umbral global — el tipo que los motores de OCR tradicionales como Tesseract usan por defecto — no puede dividirlos limpiamente. Algunos píxeles de texto cruzan al lado equivocado. Los caracteres se fusionan o desaparecen. Un "7" se lee como "1" porque la barra horizontal se desvaneció. Un "8" se convierte en "3" porque el bucle superior cruzó el umbral como fondo.
Cómo diagnosticar: Abra la imagen escaneada en cualquier editor de fotos y conviértala a escala de grises. Si el texto se vuelve difícil de leer con sus propios ojos después de la desaturación, el contraste es demasiado bajo para el OCR tradicional.
Solución: Aplique un estiramiento de contraste o ajuste de niveles antes de ejecutar el OCR. La mayoría del software de escaneo y los editores de imágenes tienen una función de "Contraste automático" o "Niveles automáticos" — esto solo a menudo recupera 10-15% de la precisión perdida. Para documentos comerciales, también intente escanear en modo de escala de grises (no color, no bitonal blanco y negro). Un estudio de la Oficina de Imprenta del Gobierno de EE. UU. sobre optimización de precisión de OCR encontró que el escaneo en escala de grises logró 98.26% de precisión en documentos estándar, mientras que el escaneo bitonal (blanco y negro puro) cayó a 77.12% — el paso de binarización elimina precisamente la información que el OCR necesita (GPO, Optimización de la precisión del OCR).
Causa 2: Fondos con Patrones
A diferencia del bajo contraste — que es accidental — los fondos con patrones a veces se diseñan deliberadamente para frustrar el OCR. Los patrones de seguridad en cheques (fondos guilloché de líneas finas, microimpresión, bandas de colores arcoíris), los sellos antifalsificación en certificados e incluso el papel cuadriculado en hojas de registro de ingeniería crean una capa de ruido visual que el motor de OCR no puede filtrar.
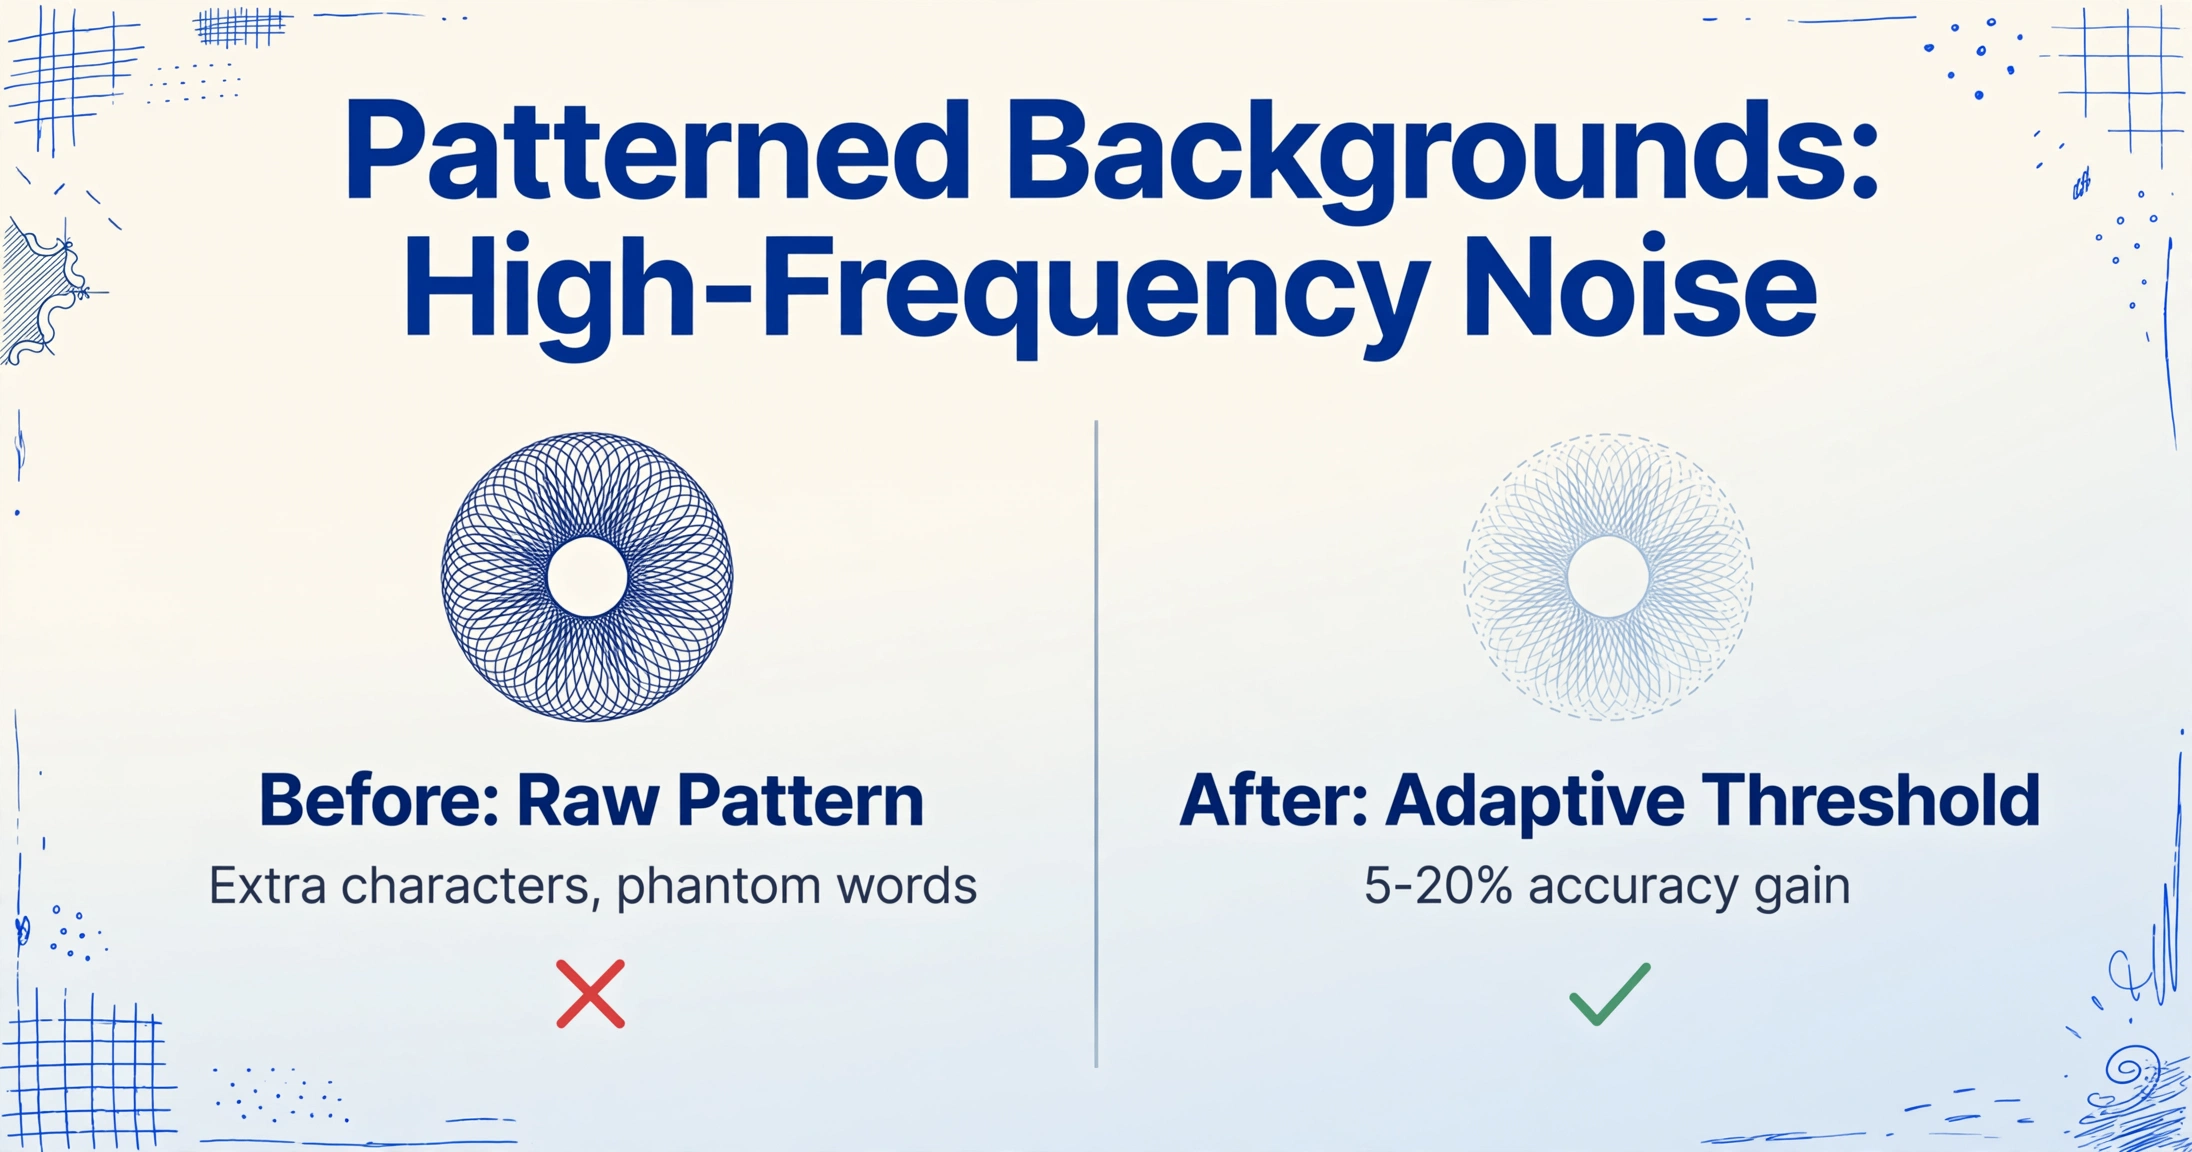
El mecanismo es diferente al del bajo contraste. El fondo de seguridad de un cheque no tiene bajo contraste — tiene detalle de alta frecuencia. El motor de OCR, durante la binarización, ve millones de píxeles oscuros diminutos que pertenecen al patrón. No puede distinguir entre "píxeles de patrón que deben ignorarse" y "píxeles de texto que deben conservarse". El resultado es una imagen binaria donde el texto se asienta sobre un campo moteado de ruido. El motor intenta formar caracteres a partir de una mezcla de texto real y artefactos del fondo. Produce caracteres adicionales, caracteres rotos y palabras fantasma que no existen en el original.
Cómo diagnosticarlo: Amplíe el documento al 200-400%. Si ve líneas finas, puntos, patrones ondulados o microtexto entrelazado alrededor del texto principal, el patrón de fondo es el problema. Si el área de texto parece el fondo de un cheque bancario o el borde de un certificado, esta es su causa.
Solución: El preprocesamiento por sí solo rara vez corrige los fondos con patrones — una eliminación agresiva de ruido lo suficientemente fuerte como para borrar el patrón también desenfocará el texto. La solución más práctica es la conversión a escala de grises seguida de un umbral adaptativo local (método de Otsu, algoritmo de Sauvola) en lugar de un umbral global. A diferencia de un umbral global único que corta toda la imagen en un solo nivel de brillo, el umbral adaptativo divide la imagen en ventanas pequeñas y calcula un umbral óptimo por ventana. Esto preserva los bordes del texto en las áreas donde el patrón es más denso.
Una nota honesta aparte: algunos patrones de seguridad no están diseñados para ser leídos por máquinas. El fondo intrincado de un cheque bancario es una característica disuasoria del fraude. Los bancos y procesadores de pagos han migrado a sistemas de compensación basados en imágenes (Check 21 en EE. UU.) precisamente porque el OCR tradicional no puede extraer datos de manera confiable de los fondos de seguridad de los cheques. Si usted procesa cheques con OCR estándar y falla consistentemente en el nombre del beneficiario o el monto — esto no es un error de la herramienta. Funciona según lo diseñado.
Causa 3: Marcas de agua
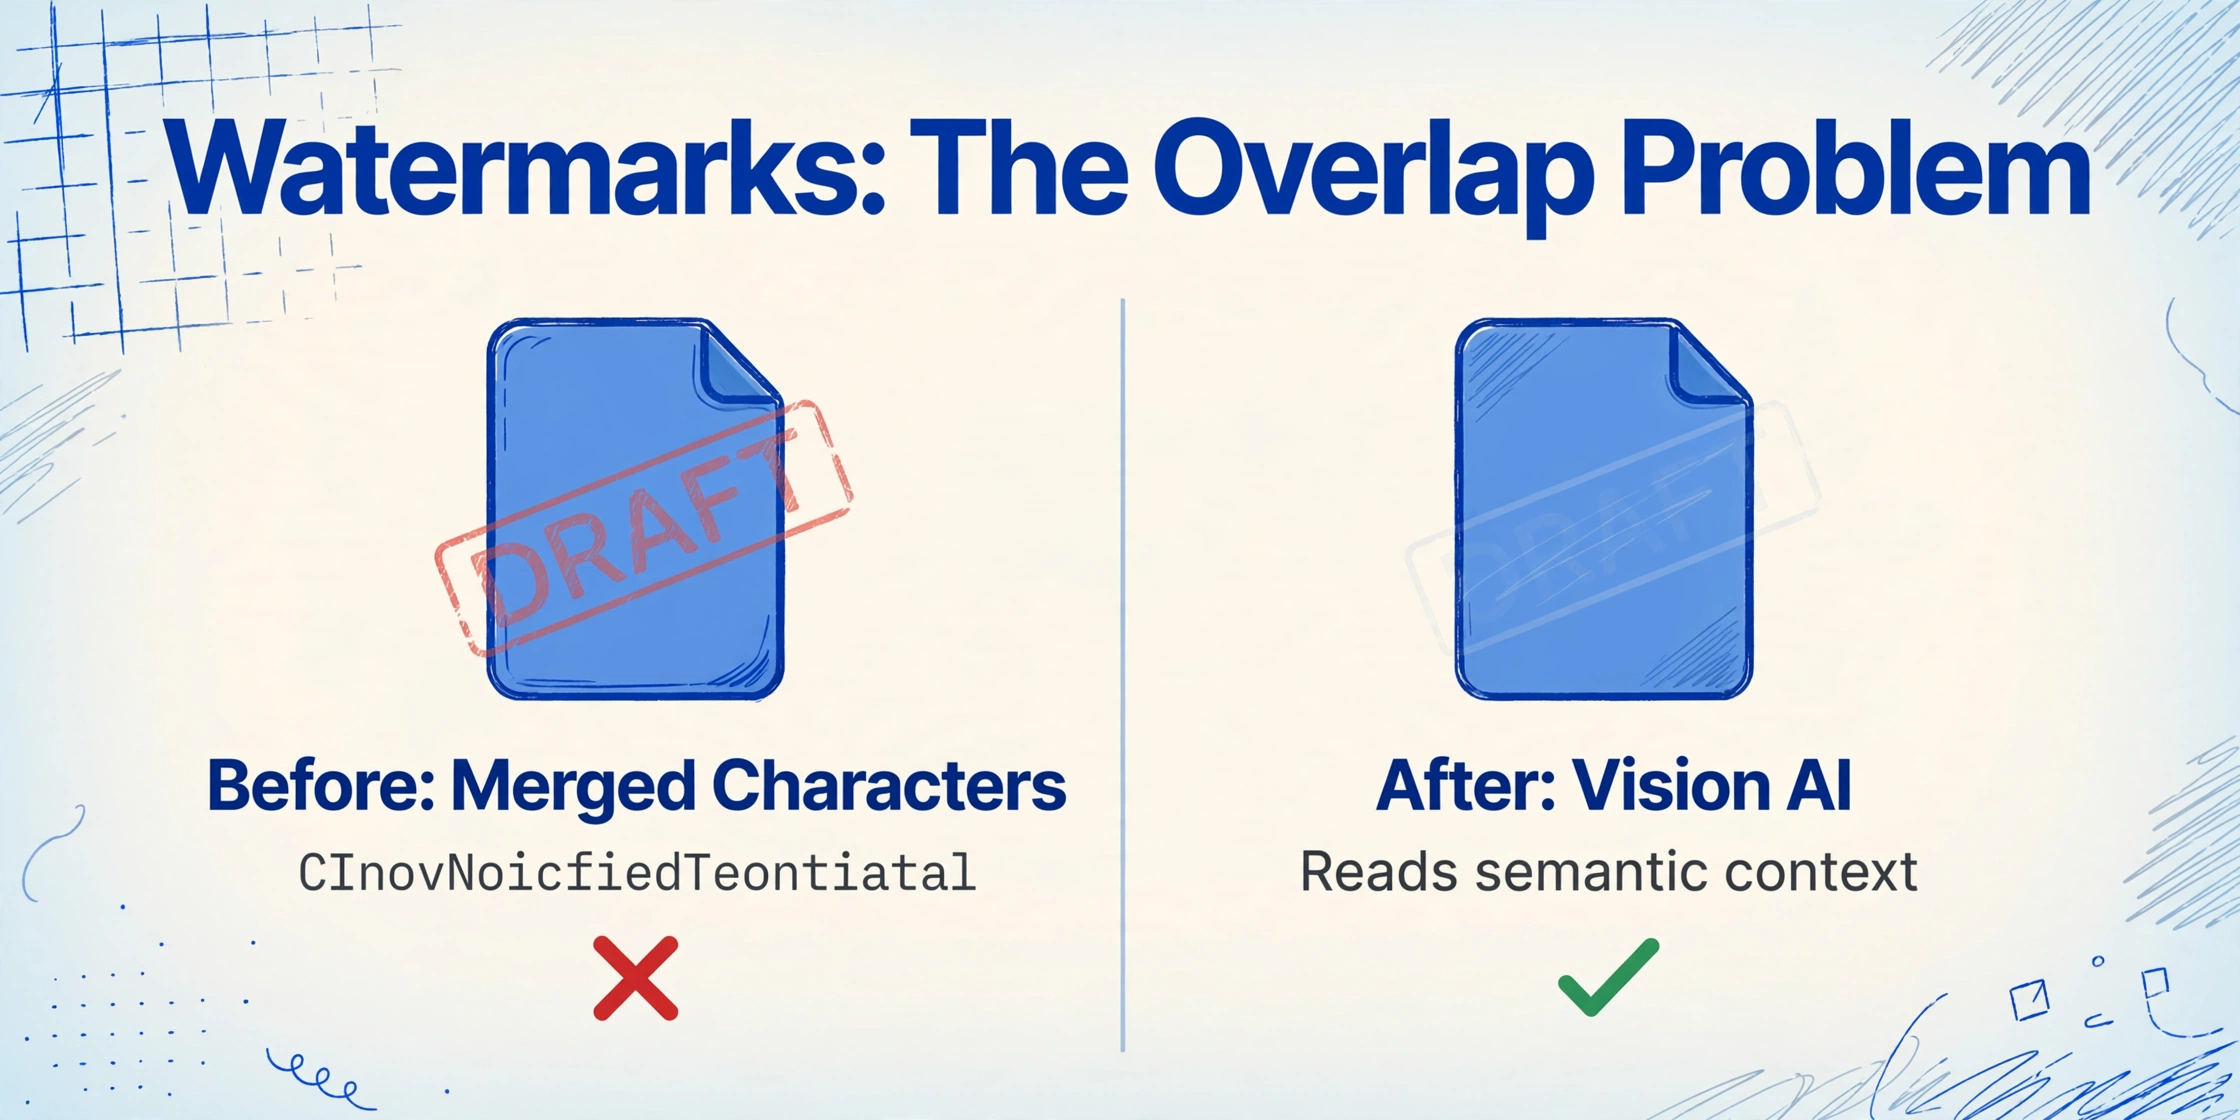
Esta causa desconcierta incluso a los usuarios más experimentados porque el documento se ve perfectamente legible al ojo humano. Una marca de agua "BORRADOR" o "CONFIDENCIAL" es texto semitransparente superpuesto en diagonal sobre la página. Usted, al leerlo, filtra inconscientemente la marca de agua y lee solo el contenido real. El OCR tradicional no tiene ese filtro. Lee cada píxel visible, incluidos los píxeles de la marca de agua que se superponen con el texto real.
El resultado es una secuencia de caracteres fusionados. Donde el documento dice "Total de la factura: $1,250.00" y una marca de agua diagonal "CONFIDENCIAL" atraviesa "Total", el OCR puede generar "CInovNoicfiedTeontiatal: $1,C20E0.N00T." La marca de agua no es una capa separada como en una aplicación de edición de PDF; está integrada en los datos de píxeles como una superposición semitransparente. El motor de OCR ve una sola capa, y todo es ruido.
Cómo diagnosticarlo: Si la región de texto tiene una segunda cadena de texto tenue que la atraviesa en ángulo (horizontal o diagonal), especialmente palabras repetidas como "BORRADOR", "MUESTRA", "COPIA" o "CONFIDENCIAL", tiene un problema de marca de agua. Con una marca de agua clara (una tan ligera que apenas se registra), el texto principal puede seguir leyéndose correctamente. La zona de peligro son las marcas de agua de opacidad media, donde tanto el texto real como la marca de agua tienen suficiente densidad de píxeles para influir en el reconocimiento de caracteres.
Solución: Esta es la solución de preprocesamiento más difícil. A diferencia de los problemas de contraste o patrón, las marcas de agua se superponen físicamente a los mismos píxeles que el texto real; ningún ajuste de umbral puede separarlas limpiamente porque no hay una separación limpia en la imagen de origen.
Algunos enfoques pueden ayudar en casos limitados: aumentar el brillo puede reducir los píxeles tenues de la marca de agua por debajo del umbral de detección; un filtro de dominio de frecuencia (band-stop basado en FFT) puede eliminar marcas de agua que tienen un ángulo diagonal y un espaciado consistentes. Pero ambas técnicas requieren ajustes por documento y degradarán la calidad del texto real en el proceso. El equipo de producto de Microsoft Azure Form Recognizer ha confirmado la interferencia de marcas de agua como una limitación conocida sin una solución general disponible (Microsoft Q&A, 2023-2024).
La solución confiable es arquitectónica: usar una herramienta que lea el documento semánticamente en lugar de píxel por píxel.
Causa 4: Fondos degradados
Los degradados son un caso especial del problema de contraste y exponen la limitación fundamental del umbral global. Un fondo degradado pasa de oscuro en la parte superior de la página a claro en la inferior, o de azul en el encabezado a blanco en el cuerpo. El texto sobre el degradado cruza múltiples zonas de brillo. En la parte oscura, el texto tiene bajo contraste contra el fondo. En la parte clara, el mismo texto tiene alto contraste.
Un umbral global — un único corte de brillo aplicado a toda la página — no puede resolver ambas zonas a la vez. Si ajustas el umbral para capturar texto en la zona oscura, el fondo de la zona clara se clasifica como texto (falsos positivos). Si lo ajustas para limpiar la zona clara, el texto en la zona oscura desaparece. El mismo carácter "5" puede leerse correctamente al final del degradado y perderse por completo al inicio.
Cómo diagnosticarlo: Observa el encabezado del documento o el área de banner. Si el color de fondo transiciona gradualmente de un tono a otro — un encabezado azul marino oscuro que se aclara a un azul más claro, o un banner rojo en la parte superior de una factura que se desvanece en el cuerpo blanco — y el texto cruza esa transición, el degradado es la causa. El síntoma es inconsistente: la misma fuente, mismo tamaño, mismo documento produce extracción correcta en un área y errores en otra.
Solución: El umbral adaptativo es la solución estándar para degradados. Al calcular un umbral separado para cada ventana local, el texto en el lado oscuro del degradado y el texto en el lado claro obtienen su propia binarización óptima. La mayoría de las bibliotecas de imágenes (OpenCV, Pillow, LEADTOOLS) admiten métodos adaptativos. Aplícalo con un tamaño de ventana aproximadamente 3 veces el ancho promedio del carácter — demasiado pequeño y el algoritmo trata áreas uniformes grandes como ruido; demasiado grande y vuelve a comportarse como un umbral global.
El hilo común de las cuatro causas: el OCR tradicional se basa en una estrategia de lectura a nivel de píxel. Cuando los píxeles por sí solos no pueden separar limpiamente el texto del fondo — debido a bajo contraste, patrones superpuestos, texto de marca de agua superpuesto o brillo de degradado cambiante — el motor no tiene una comprensión de nivel superior a la que recurrir. No sabe cómo debería verse un campo "Total", qué debería contener un monto en dólares, o que "CONFIDENCIAL" no es parte del cuerpo de la factura.
Cuándo funciona el preprocesamiento (y cuándo no)
Aquí tienes un árbol de decisión práctico sobre qué técnica de preprocesamiento funciona para cada causa:
| Causa | Mejor preprocesamiento | Mejora esperada | Limitación |
|---|---|---|---|
| Bajo contraste | Escala de grises + Niveles automáticos / Ajuste de contraste | 10-15% de ganancia en precisión | Si el texto y el fondo tienen una luminancia casi idéntica, ningún ajuste los recupera |
| Fondo estampado | Umbral adaptativo local (Sauvola / Niblack) | 5-20% según la densidad del patrón | Los patrones de seguridad (cheques, certificados) están diseñados para resistir esto; los resultados varían según el documento |
| Marca de agua | Aumento de brillo / Filtro en dominio de frecuencia | 0-10% — muy inconsistente | Los píxeles de la marca de agua se superponen físicamente con los del texto; ningún preprocesamiento puede separarlos por completo sin dañar el texto subyacente |
| Fondo degradado | Umbral adaptativo local | 10-20% de ganancia en precisión | Funciona bien con degradados lineales suaves; los degradados complejos de múltiples paradas pueden seguir fallando |
Cuándo escalar: por qué Vision AI maneja mejor los cuatro casos
Si has probado las soluciones de preprocesamiento anteriores y aún obtienes una extracción poco fiable —especialmente con documentos con marcas de agua o fondos muy estampados— el problema no es la imagen. Es la arquitectura de extracción. El OCR tradicional es una tecnología de nivel de píxel: toma una decisión binaria en cada píxel (texto o fondo) y construye caracteres a partir del resultado. Cuando los píxeles son ambiguos, el motor falla porque no tiene una estrategia de respaldo.
Los modelos de Vision AI (también llamados VLM o LLM OCR) leen documentos a un nivel semántico. No binarizan la imagen. Procesan la imagen a todo color, entienden la estructura del documento, identifican regiones de texto y luego leen el texto en contexto —de la misma manera que un humano lee un documento con marca de agua ignorando inconscientemente la superposición. Esta diferencia arquitectónica significa que Vision AI maneja mejor los cuatro problemas de fondo, a menudo sin ningún preprocesamiento:
- Bajo contraste: Vision AI lee texto tenue reconociendo formas de caracteres y contexto de palabras, no buscando un límite limpio de píxeles blanco-negro
- Fondos estampados: El modelo aprende a distinguir el texto del patrón de fondo durante el entrenamiento, tratando el patrón como ruido visual en lugar de candidatos a texto
- Marcas de agua: Vision AI lee el texto real comprendiendo lo que dice el documento —no se confunde con el "BORRADOR" superpuesto porque el contexto semántico le indica qué texto pertenece al cuerpo del documento
- Degradados: Al no depender de un único umbral de brillo, las transiciones de degradado no provocan fallos de reconocimiento carácter por carácter
ImageToTable.ai utiliza este enfoque de Vision AI: usted sube el documento tal como está (fondo de color, marca de agua, degradado o los tres) y le indica qué datos necesita. La IA lee la página completa como lo haría una persona, extrayendo los campos que usted nombró desde donde se encuentren en el documento. Esta es la diferencia entre la extracción basada en posición (que falla con cualquier fondo no estándar) y la extracción basada en semántica (que funciona sin importar cómo se vea el documento).
Una discusión relacionada que vale la pena leer: ¿Puede la IA leer documentos borrosos? cubre cómo la Vision AI degrada de forma controlada ante problemas de calidad de imagen, y la misma ventaja arquitectónica aplica a la interferencia del fondo. Y si trabaja con documentos que combinan contenido basado en texto y solo imagen, nuestro desglose de tipos de PDF le ayuda a identificar desde qué capa está leyendo su herramienta.
Preguntas Frecuentes
¿Puedo simplemente eliminar la marca de agua antes de ejecutar el OCR?
No de forma confiable. Las marcas de agua semitransparentes están integradas en los píxeles de la imagen. Eliminarlas requiere estimar los valores de píxel originales debajo, lo cual es un problema matemáticamente mal planteado: no existe una única respuesta correcta. Las herramientas que afirman "eliminación de marcas de agua" usan filtros de frecuencia que también eliminan detalles finos del texto, o algoritmos de inpainting que adivinan el contenido faltante. Para datos críticos de documentos, la eliminación de marcas de agua introduce más errores de los que resuelve.
¿Escanear en escala de grises soluciona todos los problemas de fondo?
No, pero soluciona el más común. El escaneo en escala de grises conserva la información de luminancia que ayuda al OCR a distinguir el texto del fondo. Para el estudio de la Government Printing Office mencionado anteriormente, la escala de grises mejoró la precisión del 77% (bitonal) al 98% en documentos estándar. Pero la escala de grises por sí sola no puede corregir marcas de agua (la superposición sigue en la imagen en escala de grises), patrones de seguridad densos ni contraste extremadamente bajo.
¿Por qué el cheque de mi banco no funciona con ninguna herramienta de OCR?
Los cheques bancarios usan fondos de seguridad: patrones guilloché de líneas finas, microimpresión y diseños con cambio de color, diseñados específicamente para prevenir alteraciones y falsificaciones. Estos patrones son intencionalmente difíciles de procesar para las máquinas. La mayoría de los sistemas automatizados de procesamiento de cheques (como Check 21 en EE. UU.) usan captura basada en imagen y reconocimiento de caracteres de tinta magnética (MICR) en lugar de OCR de página completa precisamente por esta razón. Si necesita extraer datos de cheques, una herramienta de Vision AI tendrá mejor rendimiento que el OCR tradicional, pero incluso así, las características de seguridad de los cheques siguen siendo un desafío.
¿Las herramientas de IA manejan mejor los fondos de color que el OCR tradicional?
Sí, por un amplio margen. El OCR tradicional trata los fondos de color como un problema a nivel de píxel. La IA de visión trata el documento completo como una escena visual, leyendo el texto en contexto en lugar de intentar binarizar cada píxel. Para fondos de bajo contraste y degradados, la diferencia es drástica: la IA de visión suele mantener una precisión superior al 90%, mientras que el OCR tradicional cae al 60-70%. En marcas de agua y patrones de seguridad, la IA de visión sigue teniendo ventaja porque no intenta "limpiar" el fondo, sino que lee a través de él.
¿No está seguro de si su documento tiene un problema de contraste? Súbalo y compruébelo.
La forma más rápida de saber si sus fallos de extracción se pueden corregir con preprocesamiento o requieren una herramienta diferente es probarlo. ImageToTable.ai procesa documentos tal cual — fondos de colores, marcas de agua, degradados — sin configuración, sin plantillas y sin ajustes de preprocesamiento. Suba un archivo y vea lo que devuelve.
Subir un documento →No requiere registro. Resultados en 10 segundos.