Por que meu OCR falha em fundos coloridos?
4 Causas e Correções Específicas
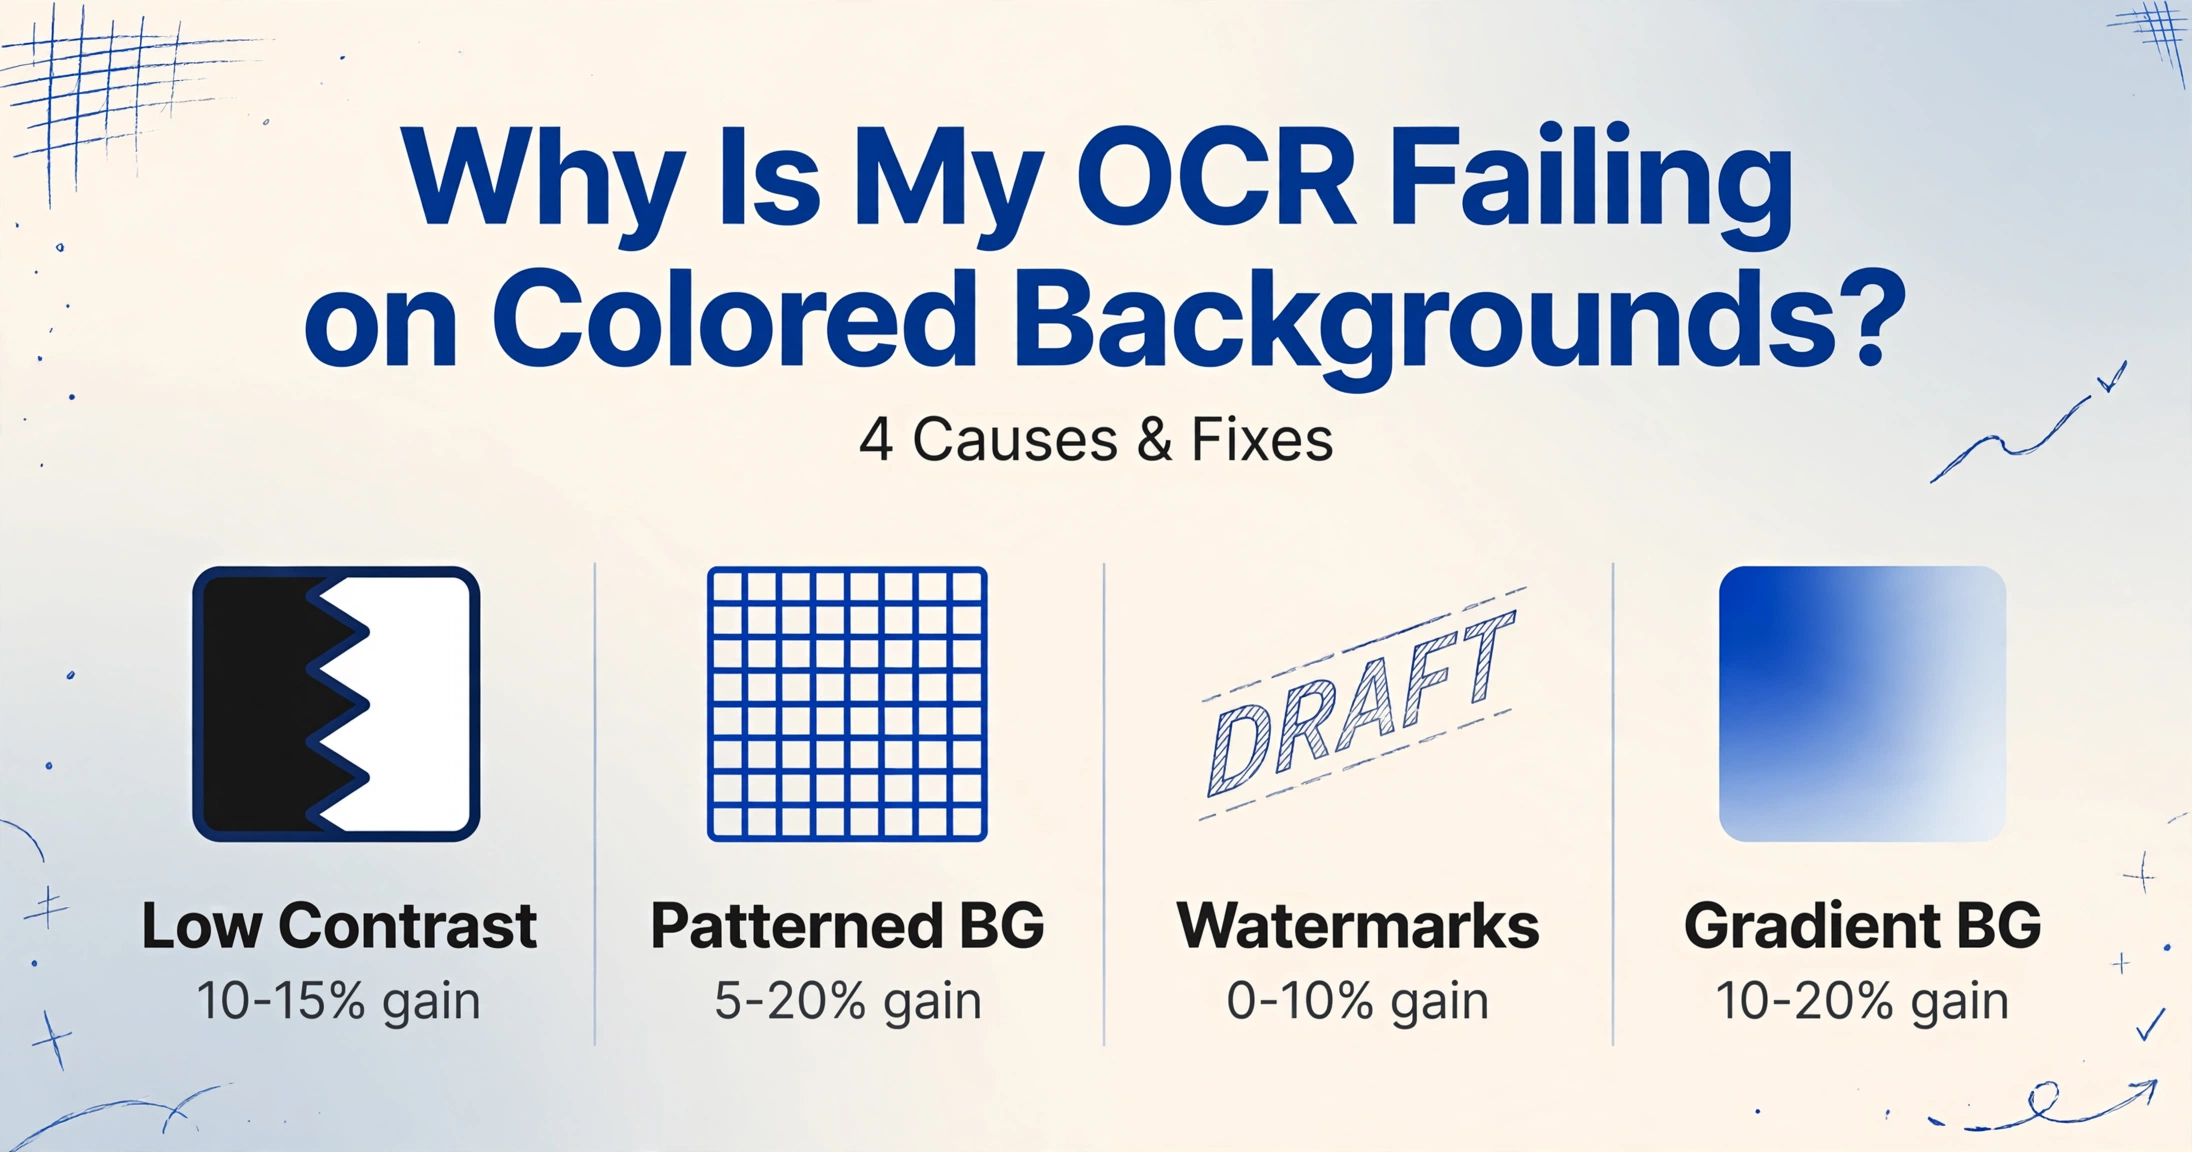
Seu OCR lê texto preto em papel branco perfeitamente. Coloque o mesmo texto em um cabeçalho de fatura azul claro, um comprovante de remessa amarelo ou atrás de uma marca d'água "RASCUNHO" — e a precisão cai 20-40%. Isso não é falha aleatória. É um problema de contraste com causas previsíveis e correções específicas.
Principais Conclusões
- Seu OCR lê a mesma fonte com 98% de precisão em papel branco — e cai para 60% no momento em que o fundo fica azul claro. Você consegue ler ambos. A máquina nunca foi projetada para isso.
- Quatro problemas não relacionados compartilham o mesmo sintoma. Baixo contraste precisa de ajuste de níveis. Padrões de segurança precisam de limiarização adaptativa local. Marcas d'água derrotam todo pré-processamento porque seus pixels se sobrepõem fisicamente ao texto. Gradientes precisam de limiares por janela. Correção errada, zero melhoria.
- O OCR tradicional falha porque precisa responder "texto ou ruído?" em cada pixel — e fundos coloridos tornam essa pergunta impossível de responder. A Vision AI ignora a pergunta completamente, lendo a página como um humano faria, entendendo o que o documento diz em vez de olhar para cada pixel um por um.
A parte frustrante é que o documento parece perfeito para você. Você consegue lê-lo. A ferramenta de OCR claramente tem a fonte certa treinada — ela processa o mesmo texto perfeitamente em uma página branca. Mas adicione um fundo de cor clara, um padrão de segurança ou um carimbo fraco de "CONFIDENCIAL", e o mesmo mecanismo que lhe dava 98% de precisão entrega uma planilha cheia de campos embaralhados.
O ponto-chave: "Problemas de fundo" não são um problema só. São quatro mecanismos de falha distintos, cada um com uma causa raiz e uma correção diferente. Aplicar a correção errada — por exemplo, adicionar mais contraste a um documento que na verdade tem um problema de marca d'água — não vai ajudar, porque você está resolvendo a camada errada. Veja como diagnosticar cada um.
Causa 1: Baixo Contraste Entre Texto e Fundo
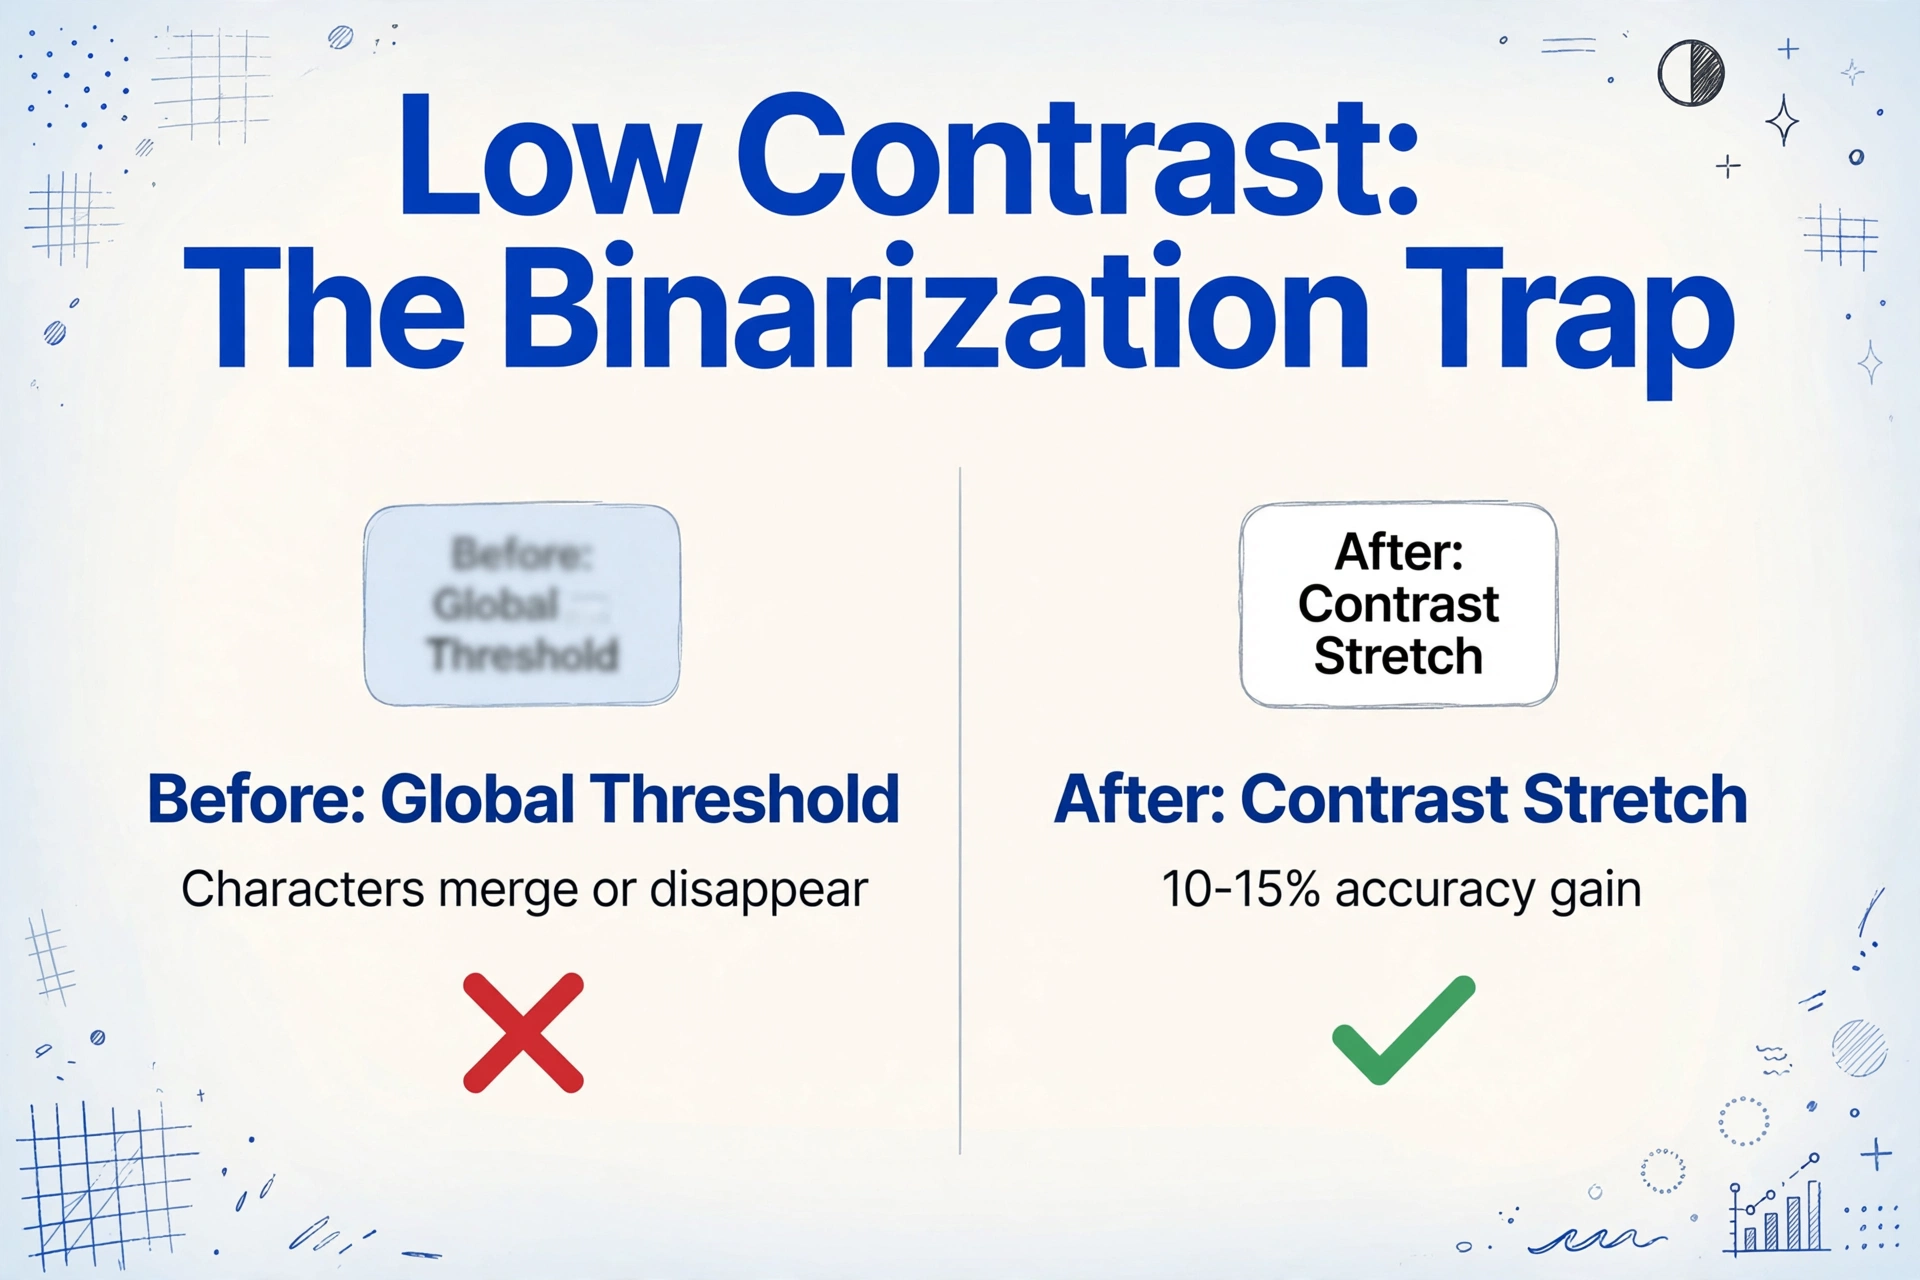
Esta é a causa mais comum e a mais fácil de corrigir. O OCR tradicional funciona binarizando uma imagem — convertendo cada pixel em preto ou branco com base em um limite de brilho. Se um pixel for mais escuro que o limite, é texto. Se for mais claro, é fundo. Isso funciona bem quando o documento é texto preto em papel branco: a diferença de brilho entre tinta e papel é grande o suficiente para que um único limite global separe os dois com clareza.
Agora coloque texto cinza sobre um fundo azul claro. Os pixels do texto são apenas ligeiramente mais escuros que os pixels do fundo. Um limite global — o tipo que mecanismos de OCR tradicionais como o Tesseract usam por padrão — não consegue separá-los com clareza. Alguns pixels de texto cruzam para o lado errado. Caracteres se fundem ou desaparecem. Um "7" é lido como "1" porque a barra horizontal se perdeu. Um "8" vira "3" porque o laço superior cruzou o limite como fundo.
Como diagnosticar: Abra a imagem escaneada em qualquer editor de fotos e converta-a para escala de cinza. Se o texto ficar difícil de ler com seus próprios olhos após a dessaturação, o contraste está baixo demais para o OCR tradicional.
Correção: Aplique um ajuste de contraste ou de níveis antes de executar o OCR. A maioria dos softwares de digitalização e editores de imagem tem um recurso de "Contraste Automático" ou "Níveis Automáticos" — isso sozinho muitas vezes recupera 10-15% da precisão perdida. Para documentos de negócios, tente também digitalizar em modo escala de cinza (não colorido, não preto e branco bitonal). Um estudo do US Government Printing Office sobre otimização de OCR descobriu que a digitalização em escala de cinza alcançou 98,26% de precisão em documentos padrão, enquanto a digitalização bitonal (preto e branco puro) caiu para 77,12% — a etapa de binarização remove exatamente a informação que o OCR precisa (GPO, Otimizando a Precisão do OCR).
Causa 2: Fundos Padronizados
Diferente do baixo contraste — que é acidental — os fundos padronizados às vezes são deliberadamente desenhados para derrotar o OCR. Padrões de segurança em cheques (fundos guilloché de linhas finas, microimpressão, bandas coloridas de arcoíris), selos anticontrafação em certificados e até papel milimetrado em planillas de engenharia criam uma capa de ruido visual que o motor de OCR não consegue filtrar.
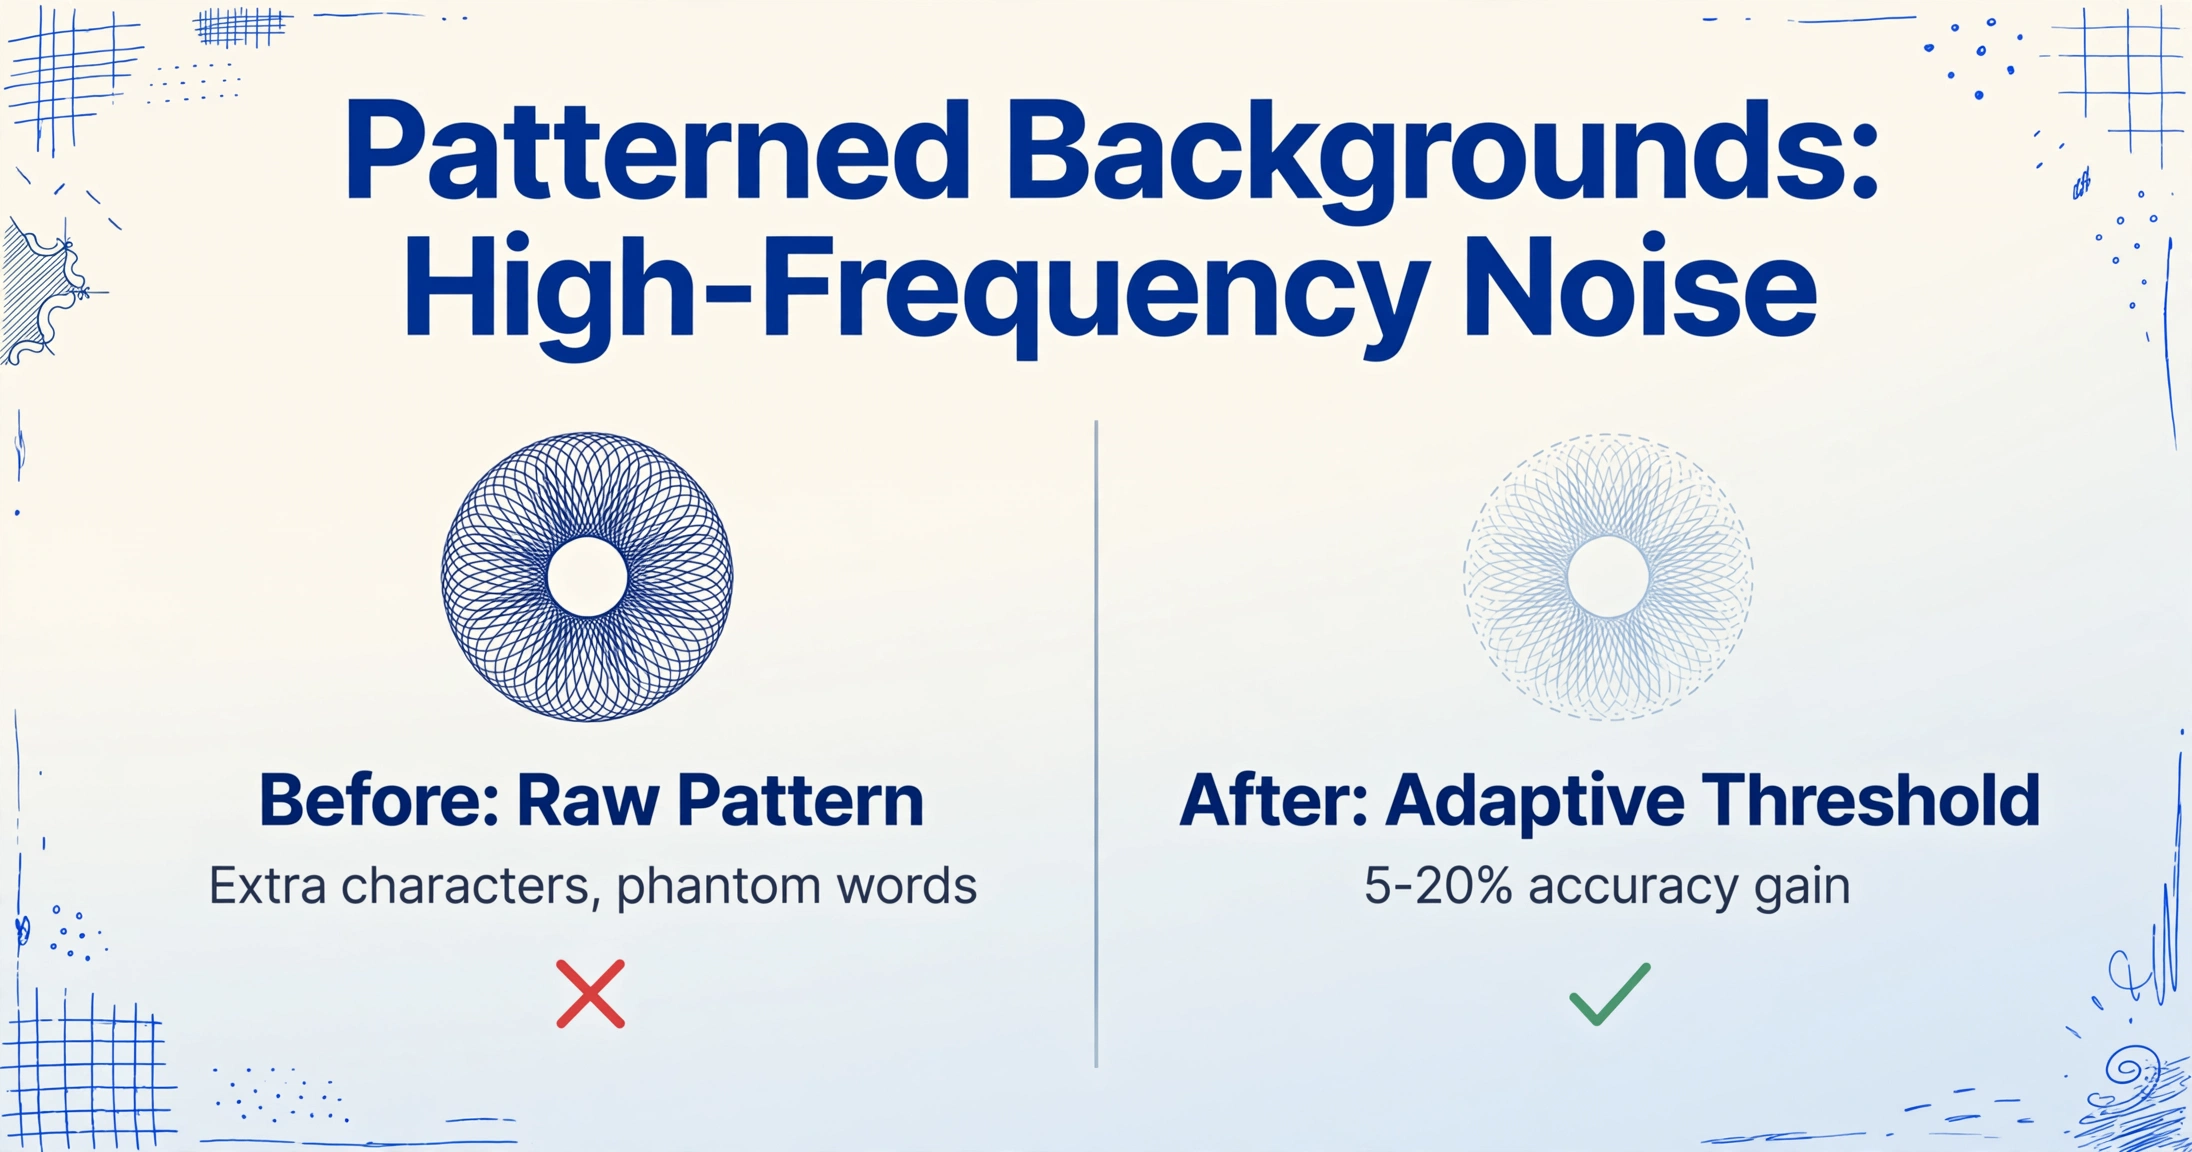
O mecanismo é diferente do baixo contraste. O fundo de segurança de um cheque não é de baixo contraste — é de detalhe de alta frequência. Durante a binarização, o motor de OCR vê milhões de pixels escuros minúsculos que pertencem ao padrão. Não consegue distinguir "pixels de padrão que devem ser ignorados" de "pixels de texto que devem ser mantidos". O resultado é uma imagem binária onde o texto fica sobre um campo salpicado de ruido. O motor tenta formar caracteres a partir de uma mistura de texto real e artefactos de fundo. Produce caracteres extras, caracteres quebrados e palavras fantasma que não existem no original.
Como diagnosticar: Aumente o zoom no documento a 200-400%. Se você vê linhas finas, pontos, padrões ondulados ou micro-texto entrelazado ao redor do texto principal, o padrão de fundo é o problema. Se a área de texto parece um fundo de cheque bancário ou uma borda de certificado, esta é a causa.
Correção: O pré-processamento sozinho raramente corrige fundos padronizados — a remoção agressiva de ruido que seja forte o suficiente para eliminar o padrão também desfocará o texto. A correção mais prática é a conversão a escala de cinza seguida de um threshold adaptativo local (método de Otsu, algoritmo de Sauvola) em vez de um threshold global. Diferente de um threshold global único que corta toda a imagem em um nível de brilho, o threshold adaptativo divide a imagem em pequenas janelas e calcula um threshold óptimo por janela. Isso preserva as bordas do texto em áreas onde o padrão é mais denso.
Uma nota honesta separada: alguns padrões de segurança não são feitos para ser lidos por máquinas. O fundo intrincado de um cheque bancário é uma característica de dissuasão de fraude. Bancos e processadores de pagamento migraron a sistemas de compensação baseados em imagem (Check 21 nos EUA) precisamente porque o OCR tradicional não consegue extraer dados de forma confiable dos fundos de segurança de cheques. Se você está processando cheques com OCR padrão e falha consistentemente no nome do beneficiário ou no montante — isso não é um bug da ferramenta. Está funcionando como foi desenhado.
Causa 3: Marcas d'água
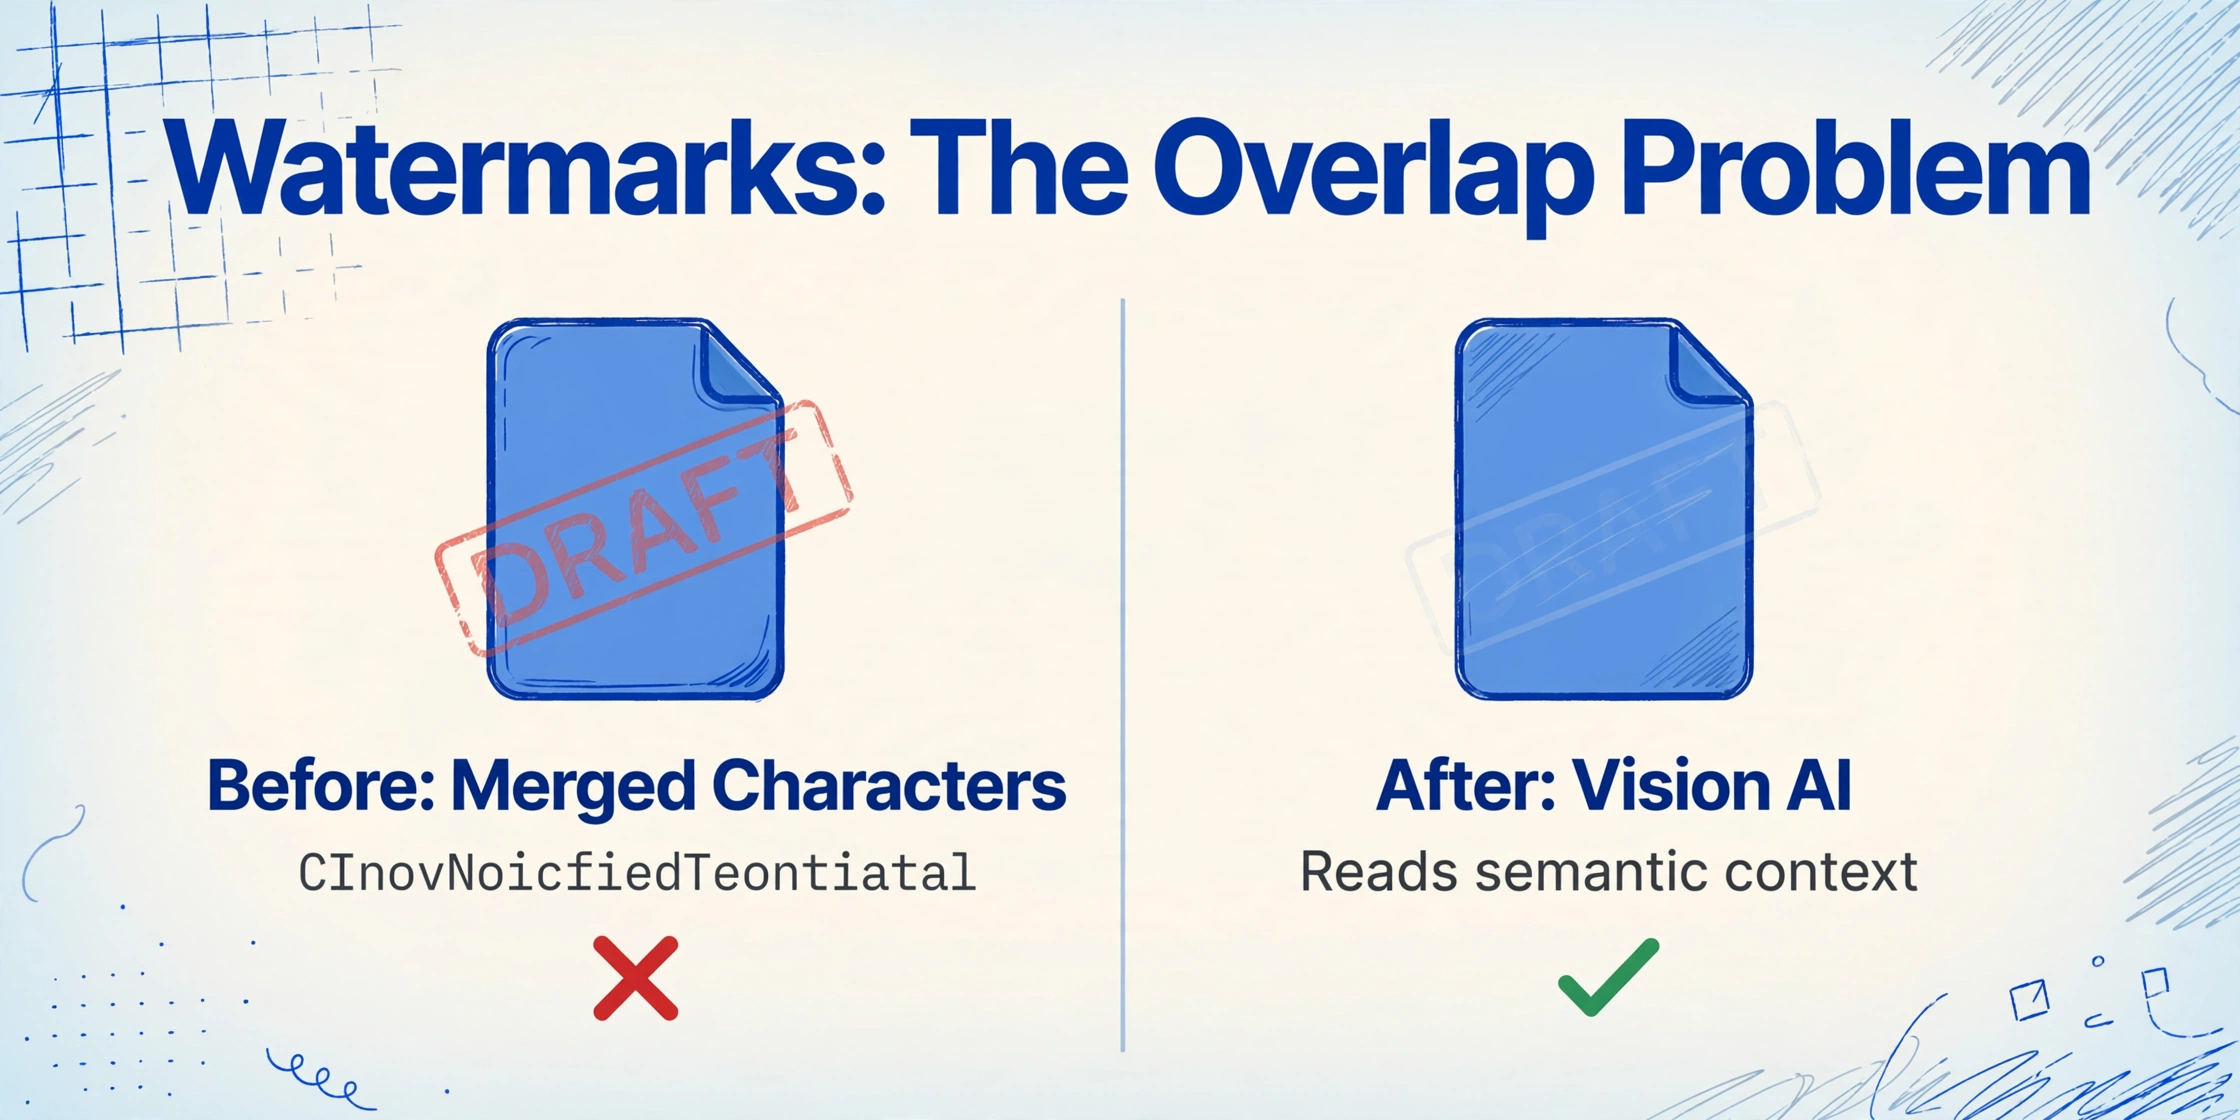
Essa causa confunde até os usuários mais experientes porque o documento parece perfeitamente legível ao olho humano. Uma marca d'água "RASCUNHO" ou "CONFIDENCIAL" é um texto semitransparente sobreposto diagonalmente na página. Você, ao ler, filtra inconscientemente a marca d'água e lê apenas o conteúdo real. O OCR tradicional não tem esse filtro. Ele lê cada pixel visível — incluindo os pixels da marca d'água que se sobrepõem ao texto real.
O resultado é um fluxo de caracteres mesclado. Onde o documento diz "Total da Fatura: $1.250,00" e uma marca d'água diagonal "CONFIDENCIAL" passa por "Total", o OCR pode gerar "CInovNoicfiedTeontiatal: $1,C20E0.N00T." A marca d'água não é uma camada separada como em um aplicativo de edição de PDF — ela está incorporada aos dados de pixel como uma sobreposição semitransparente. O mecanismo de OCR vê uma única camada, e ela é todo ruído.
Como diagnosticar: Se a região do texto tiver uma segunda sequência de texto fraca passando por ela em um ângulo (horizontal ou diagonal), especialmente palavras repetidas como "RASCUNHO", "AMOSTRA", "CÓPIA" ou "CONFIDENCIAL", você tem um problema de marca d'água. Com uma marca d'água clara — tão leve que mal é perceptível — o texto principal ainda pode ser lido corretamente. A zona de perigo são marcas d'água de opacidade média, onde tanto o texto real quanto a marca d'água têm densidade de pixels suficiente para influenciar o reconhecimento de caracteres.
Correção: Esta é a correção de pré-processamento mais difícil. Ao contrário de problemas de contraste ou padrão, as marcas d'água se sobrepõem fisicamente aos mesmos pixels do texto real — nenhum ajuste de limite pode separá-las limpidamente porque não há separação limpa na imagem de origem.
Algumas abordagens podem ajudar em casos limitados: aumentar o brilho pode reduzir pixels fracos da marca d'água abaixo do limite de detecção; um filtro de domínio de frequência (band-stop baseado em FFT) pode remover marcas d'água que têm um ângulo diagonal e espaçamento consistentes. Mas ambas as técnicas exigem ajuste por documento e degradarão a qualidade do texto real no processo. A equipe de produto do Microsoft Azure Form Recognizer confirmou a interferência de marca d'água como uma limitação conhecida, sem solução alternativa geral disponível (Microsoft Q&A, 2023-2024).
A correção confiável é arquitetural: use uma ferramenta que leia o documento semanticamente, em vez de pixel por pixel.
Causa 4: Fundos Gradientes
Gradientes são um caso especial do problema de contraste e expõem a limitação fundamental da limiarização global. Um fundo gradiente transita do escuro no topo da página para o claro na parte inferior — ou do azul no cabeçalho para o branco no corpo. O texto sobre o gradiente cruza múltiplas zonas de brilho. Na parte escura do gradiente, o texto tem baixo contraste com o fundo. Na parte clara, o mesmo texto tem alto contraste.
Um limiar global — um único corte de brilho aplicado à página inteira — não consegue resolver ambas as zonas ao mesmo tempo. Ajuste o limiar para capturar o texto na zona escura, e o fundo da zona clara será classificado como texto (falsos positivos). Ajuste-o para limpar a zona clara, e o texto na zona escura desaparece. O mesmo caractere "5" pode ser lido corretamente na parte inferior do gradiente e completamente perdido no topo.
Como diagnosticar: Observe o cabeçalho do documento ou a área do banner. Se a cor de fundo transitar gradualmente de um tom para outro — um azul marinho escuro desbotando para um azul mais claro, ou um banner vermelho no topo de uma fatura que desbota para o corpo branco — e o texto cruzar essa transição, o gradiente é a causa. O sintoma é inconsistente: a mesma fonte, mesmo tamanho, mesmo documento produz extração correta em uma área e erros em outra.
Solução: Limiarização adaptativa é a solução padrão para gradientes. Como calcula um limiar separado para cada janela local, o texto no lado escuro do gradiente e o texto no lado claro recebem cada um sua própria binarização ideal. A maioria das bibliotecas de imagem (OpenCV, Pillow, LEADTOOLS) suporta métodos adaptativos. Aplique-o com um tamanho de janela aproximadamente 3 vezes a largura média do caractere — muito pequeno e o algoritmo trata grandes áreas uniformes como ruído; muito grande e ele se comporta novamente como um limiar global.
O fio condutor entre todas as quatro causas: o OCR tradicional depende de uma estratégia de leitura em nível de pixel. Quando os pixels sozinhos não conseguem separar claramente o texto do fundo — devido a baixo contraste, padrões sobrepostos, texto de marca d'água sobreposto ou brilho gradiente variável — o mecanismo não tem um entendimento de nível superior para recorrer. Ele não sabe como um campo "Total" deve ser, o que um valor em dólar deve conter, ou que "CONFIDENCIAL" não faz parte do corpo da fatura.
Quando o Pré-Processamento Funciona (e Quando Não)
Aqui está uma árvore de decisão prática sobre qual técnica de pré-processamento funciona para cada causa:
| Causa | Melhor Pré-Processamento | Melhoria Esperada | Limitação |
|---|---|---|---|
| Baixo contraste | Escala de cinza + Níveis automáticos / Esticar contraste | Ganho de 10-15% na precisão | Se texto e fundo têm luminância quase idêntica, nenhum ajuste os recupera |
| Fundo padronizado | Limiar adaptativo local (Sauvola / Niblack) | 5-20% dependendo da densidade do padrão | Padrões de segurança (cheques, certificados) são projetados para resistir — resultados variam por documento |
| Marca d'água | Aumento de brilho / Filtro no domínio da frequência | 0-10% — altamente inconsistente | Pixels da marca d'água se sobrepõem fisicamente aos pixels do texto; nenhum pré-processamento os separa totalmente sem danificar o texto subjacente |
| Fundo gradiente | Limiar adaptativo local | Ganho de 10-20% na precisão | Funciona bem para gradientes lineares suaves; gradientes complexos com múltiplas paradas podem ainda falhar |
Quando Escalar: Por que a Visão AI Lida Melhor com Todos os Quatro
Se você tentou as correções de pré-processamento acima e ainda obtém extração não confiável — especialmente com documentos com marca d'água ou fundos densamente padronizados — o problema não é a imagem. É a arquitetura de extração. O OCR tradicional é uma tecnologia de nível de pixel: ele toma uma decisão binária em cada pixel (texto ou fundo) e constrói caracteres a partir do resultado. Quando os pixels são ambíguos, o mecanismo falha porque não tem uma estratégia de backup.
Modelos de Visão AI (também chamados de OCR baseado em VLM ou LLM) leem documentos em um nível semântico. Eles não binarizam a imagem. Processam a imagem colorida completa, entendem a estrutura do documento, identificam regiões de texto e então leem o texto em contexto — da mesma forma que um humano lê um documento com marca d'água ignorando subconscientemente a sobreposição. Essa diferença arquitetônica significa que a Visão AI lida melhor com todos os quatro problemas de fundo, muitas vezes sem nenhum pré-processamento:
- Baixo contraste: A Visão AI lê texto fraco reconhecendo formas de caracteres e contexto de palavras, não encontrando um limite nítido de pixel preto-branco
- Fundos padronizados: O modelo aprende a distinguir texto do padrão de fundo durante o treinamento, tratando o padrão como ruído visual em vez de candidatos a texto
- Marcas d'água: A Visão AI lê o texto real entendendo o que o documento diz — não se confunde com o "RASCUNHO" sobreposto porque o contexto semântico indica qual texto pertence ao corpo do documento
- Gradientes: Sem depender de um único limite de brilho, transições de gradiente não causam falhas de reconhecimento caractere por caractere
O ImageToTable.ai usa esta abordagem de IA de visão: você envia o documento como está — fundo colorido, marca d'água, gradiente, ou todos os três — e informa quais dados precisa. A IA lê a página inteira como um humano faria, extraindo os campos que você nomeou de onde quer que estejam no documento. Essa é a diferença entre extração baseada em posição (que falha em qualquer fundo não padrão) e extração baseada em semântica (que funciona independentemente da aparência do documento).
Uma discussão relacionada que vale a pena ler: IA consegue ler documentos borrados? aborda como a IA de visão degrada de forma graciosa em problemas de qualidade de imagem — e a mesma vantagem arquitetural se aplica à interferência de fundo. E se você lida com documentos que misturam conteúdo baseado em texto e apenas imagem, nossa análise dos tipos de PDF ajuda a identificar de qual camada sua ferramenta está lendo.
Perguntas Frequentes
Posso simplesmente remover a marca d'água antes de executar o OCR?
Não de forma confiável. Marcas d'água semitransparentes são mescladas aos pixels da imagem. Removê-las exige estimar os valores originais dos pixels subjacentes, o que é um problema matematicamente mal definido — não existe uma única resposta correta. Ferramentas que afirmam fazer "remoção de marca d'água" usam filtros de frequência que também removem detalhes finos do texto, ou algoritmos de inpainting que adivinham o conteúdo ausente. Para dados críticos de documentos, a remoção de marca d'água introduz mais erros do que resolve.
Digitalizar em escala de cinza resolve todos os problemas de fundo?
Não, mas resolve o mais comum. A digitalização em escala de cinza preserva informações de luminância que ajudam o OCR a distinguir texto do fundo. No estudo do Government Printing Office mencionado anteriormente, a escala de cinza melhorou a precisão de 77% (bitonal) para 98% em documentos padrão. Mas a escala de cinza sozinha não resolve marcas d'água (a sobreposição ainda está na imagem em cinza), padrões de segurança densos ou contraste extremamente baixo.
Por que o cheque do meu banco não funciona com nenhuma ferramenta de OCR?
Cheques bancários usam fundos de segurança — padrões guilloché de linhas finas, microimpressão e designs com mudança de cor — projetados especificamente para prevenir alteração e falsificação. Esses padrões são intencionalmente difíceis de processar por máquinas. A maioria dos sistemas automatizados de processamento de cheques (como o Check 21 nos EUA) usa captura baseada em imagem e reconhecimento de caracteres com tinta magnética (MICR) em vez de OCR de página inteira exatamente por esse motivo. Se você precisa extrair dados de cheques, uma ferramenta de IA de visão terá melhor desempenho que o OCR tradicional, mas mesmo assim, os recursos de segurança dos cheques continuam sendo um desafio.
Ferramentas de IA lidam melhor com fundos coloridos do que o OCR tradicional?
Sim — e com grande vantagem. Ferramentas tradicionais de OCR tratam fundos coloridos como um problema de nível de pixel. A Visão de IA trata o documento inteiro como uma cena visual, lendo o texto em contexto em vez de tentar binarizar cada pixel. Para fundos de baixo contraste e gradientes, a diferença é drástica: a Visão de IA geralmente mantém mais de 90% de precisão, enquanto o OCR tradicional cai para 60-70%. Para marcas d'água e padrões de segurança, a Visão de IA ainda leva vantagem, pois não tenta "limpar" o fundo — ela lê através dele.
Não sabe se seu documento tem problema de contraste? Envie e veja.
A forma mais rápida de saber se suas falhas de extração são corrigíveis com pré-processamento ou exigem uma ferramenta diferente é testar. O ImageToTable.ai processa documentos como estão — fundos coloridos, marcas d'água, gradientes — sem configuração, sem modelos e sem ajustes de pré-processamento. Envie um arquivo e veja o que retorna.
Enviar um Documento →Sem necessidade de cadastro. Resultados em 10 segundos.