Pourquoi mon OCR échoue-t-il sur des fonds colorés ?
4 causes et solutions spécifiques
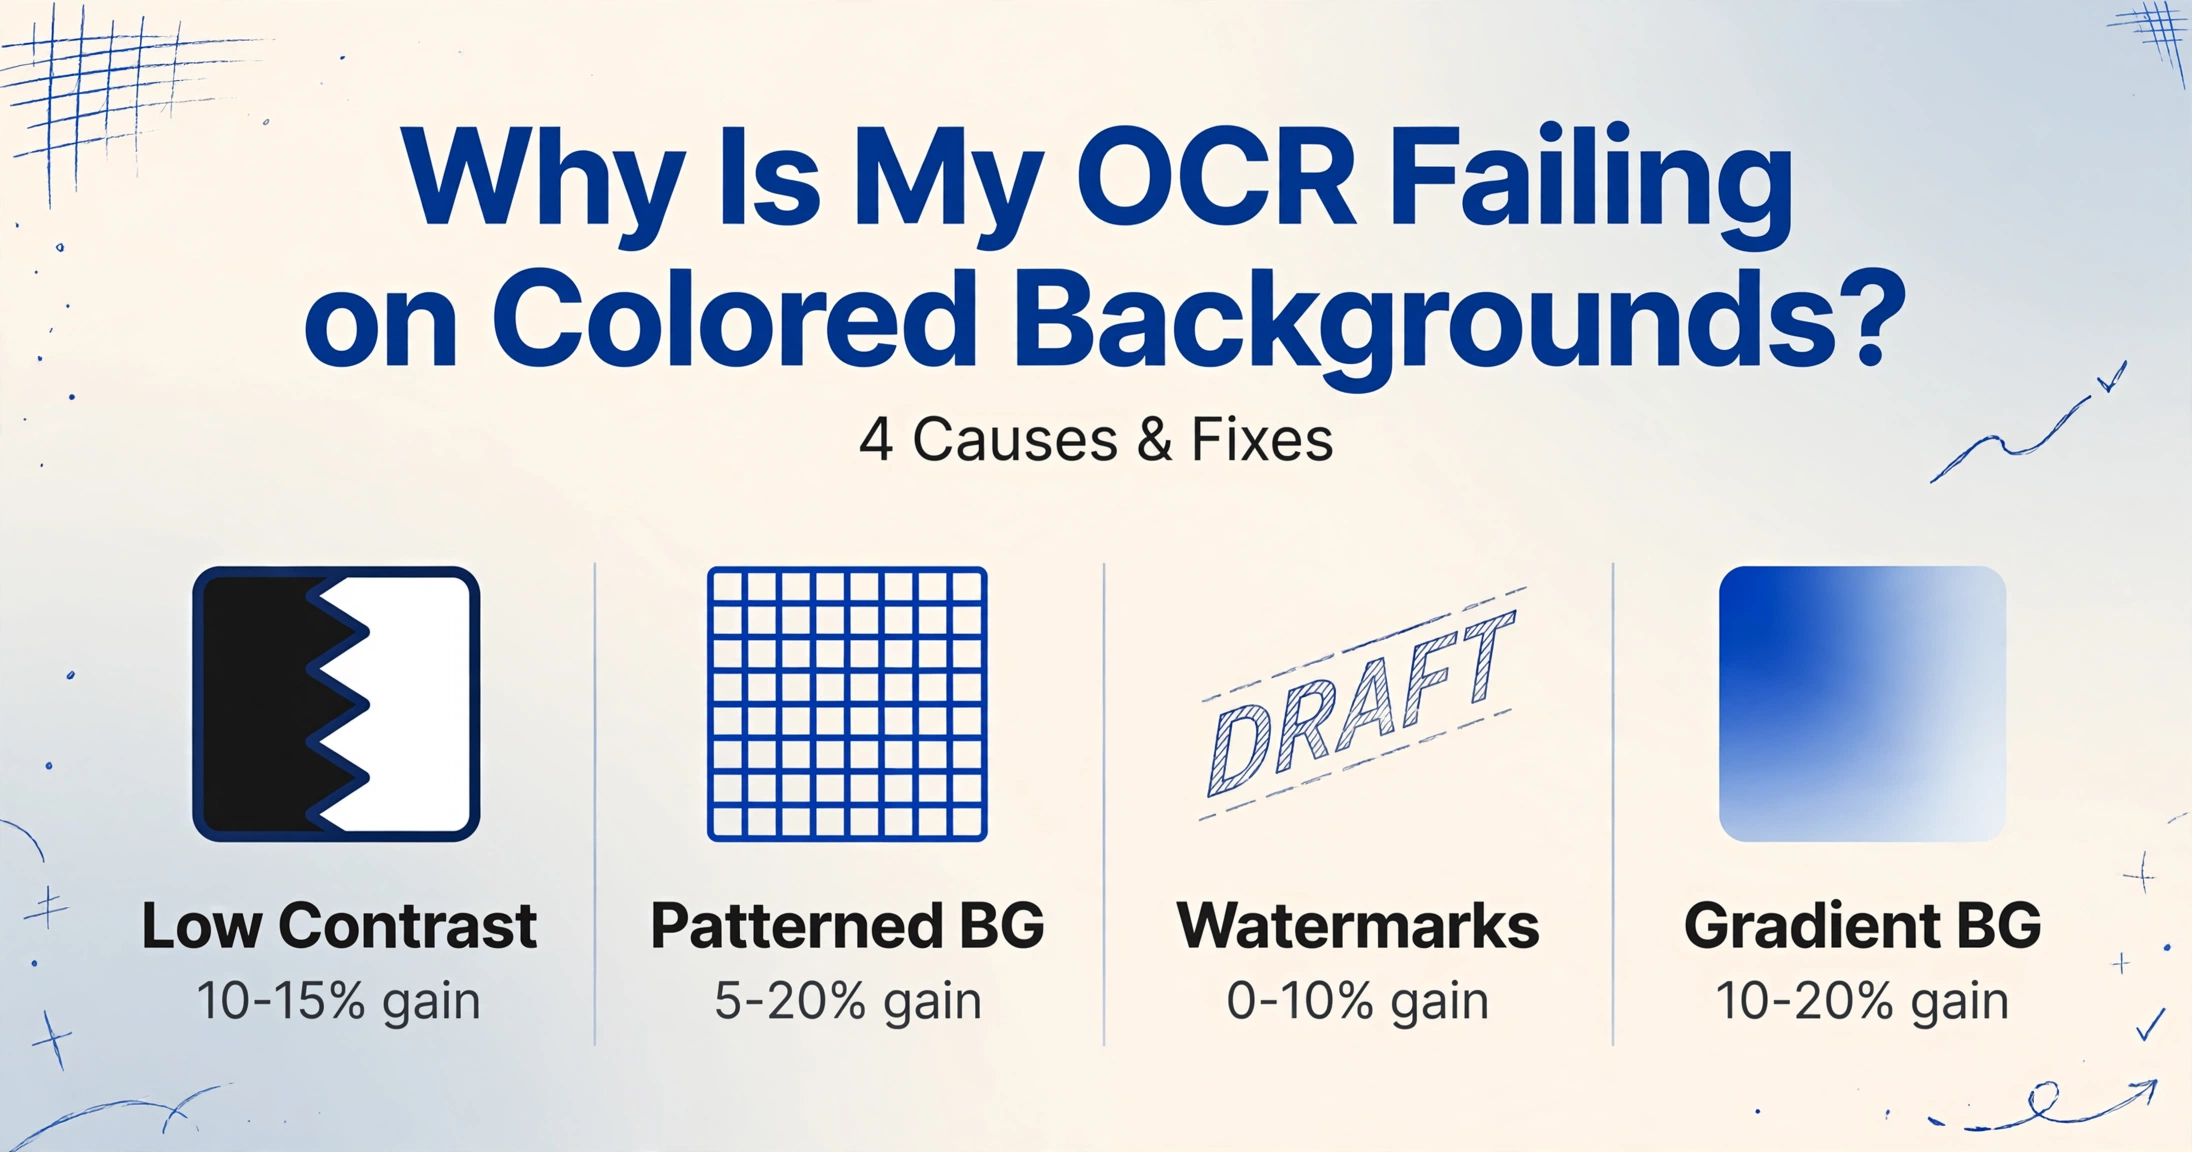
Votre OCR lit parfaitement le texte noir sur papier blanc. Placez le même texte sur un en-tête de facture bleu clair, un bordereau d'expédition jaune ou derrière un filigrane « BROUILLON » — et la précision chute de 20 à 40 %. Ce n'est pas une défaillance aléatoire. C'est un problème de contraste avec des causes prévisibles et des solutions spécifiques.
Points clés à retenir
- Votre OCR lit la même police à 98 % de précision sur papier blanc — et chute à 60 % dès que le fond devient bleu clair. Vous pouvez lire les deux. La machine n'a jamais été conçue pour cela.
- Quatre problèmes sans lien partagent le même symptôme. Un faible contraste nécessite un réglage des niveaux. Les motifs de sécurité nécessitent un seuillage adaptatif local. Les filigranes neutralisent tout prétraitement car leurs pixels chevauchent physiquement le texte. Les dégradés nécessitent des seuils par fenêtre. Mauvaise solution, zéro amélioration.
- L'OCR traditionnel échoue car il doit répondre « texte ou bruit ? » à chaque pixel — et les fonds colorés rendent cette question sans réponse. La Vision AI contourne entièrement la question, lisant la page comme le ferait un humain en comprenant ce que dit le document au lieu de fixer chaque pixel un par un.
Ce qui est frustrant, c'est que le document vous semble parfaitement lisible. Vous pouvez le lire. L'outil OCR a clairement la bonne police entraînée — il traite parfaitement le même texte sur une page blanche. Mais ajoutez un fond de couleur claire, un motif de sécurité ou un tampon discret « CONFIDENTIEL », et le même moteur qui vous donnait 98 % de précision vous livre une feuille de calcul pleine de champs illisibles.
Le point clé : Les « problèmes de fond » ne sont pas un seul problème. Ce sont quatre mécanismes de défaillance distincts, chacun avec une cause racine et une solution différentes. Appliquer la mauvaise correction — par exemple, augmenter le contraste sur un document qui a en réalité un problème de filigrane — ne servira à rien, car vous résolvez la mauvaise couche. Voici comment diagnostiquer chacun d'eux.
Cause 1 : Faible contraste entre le texte et le fond
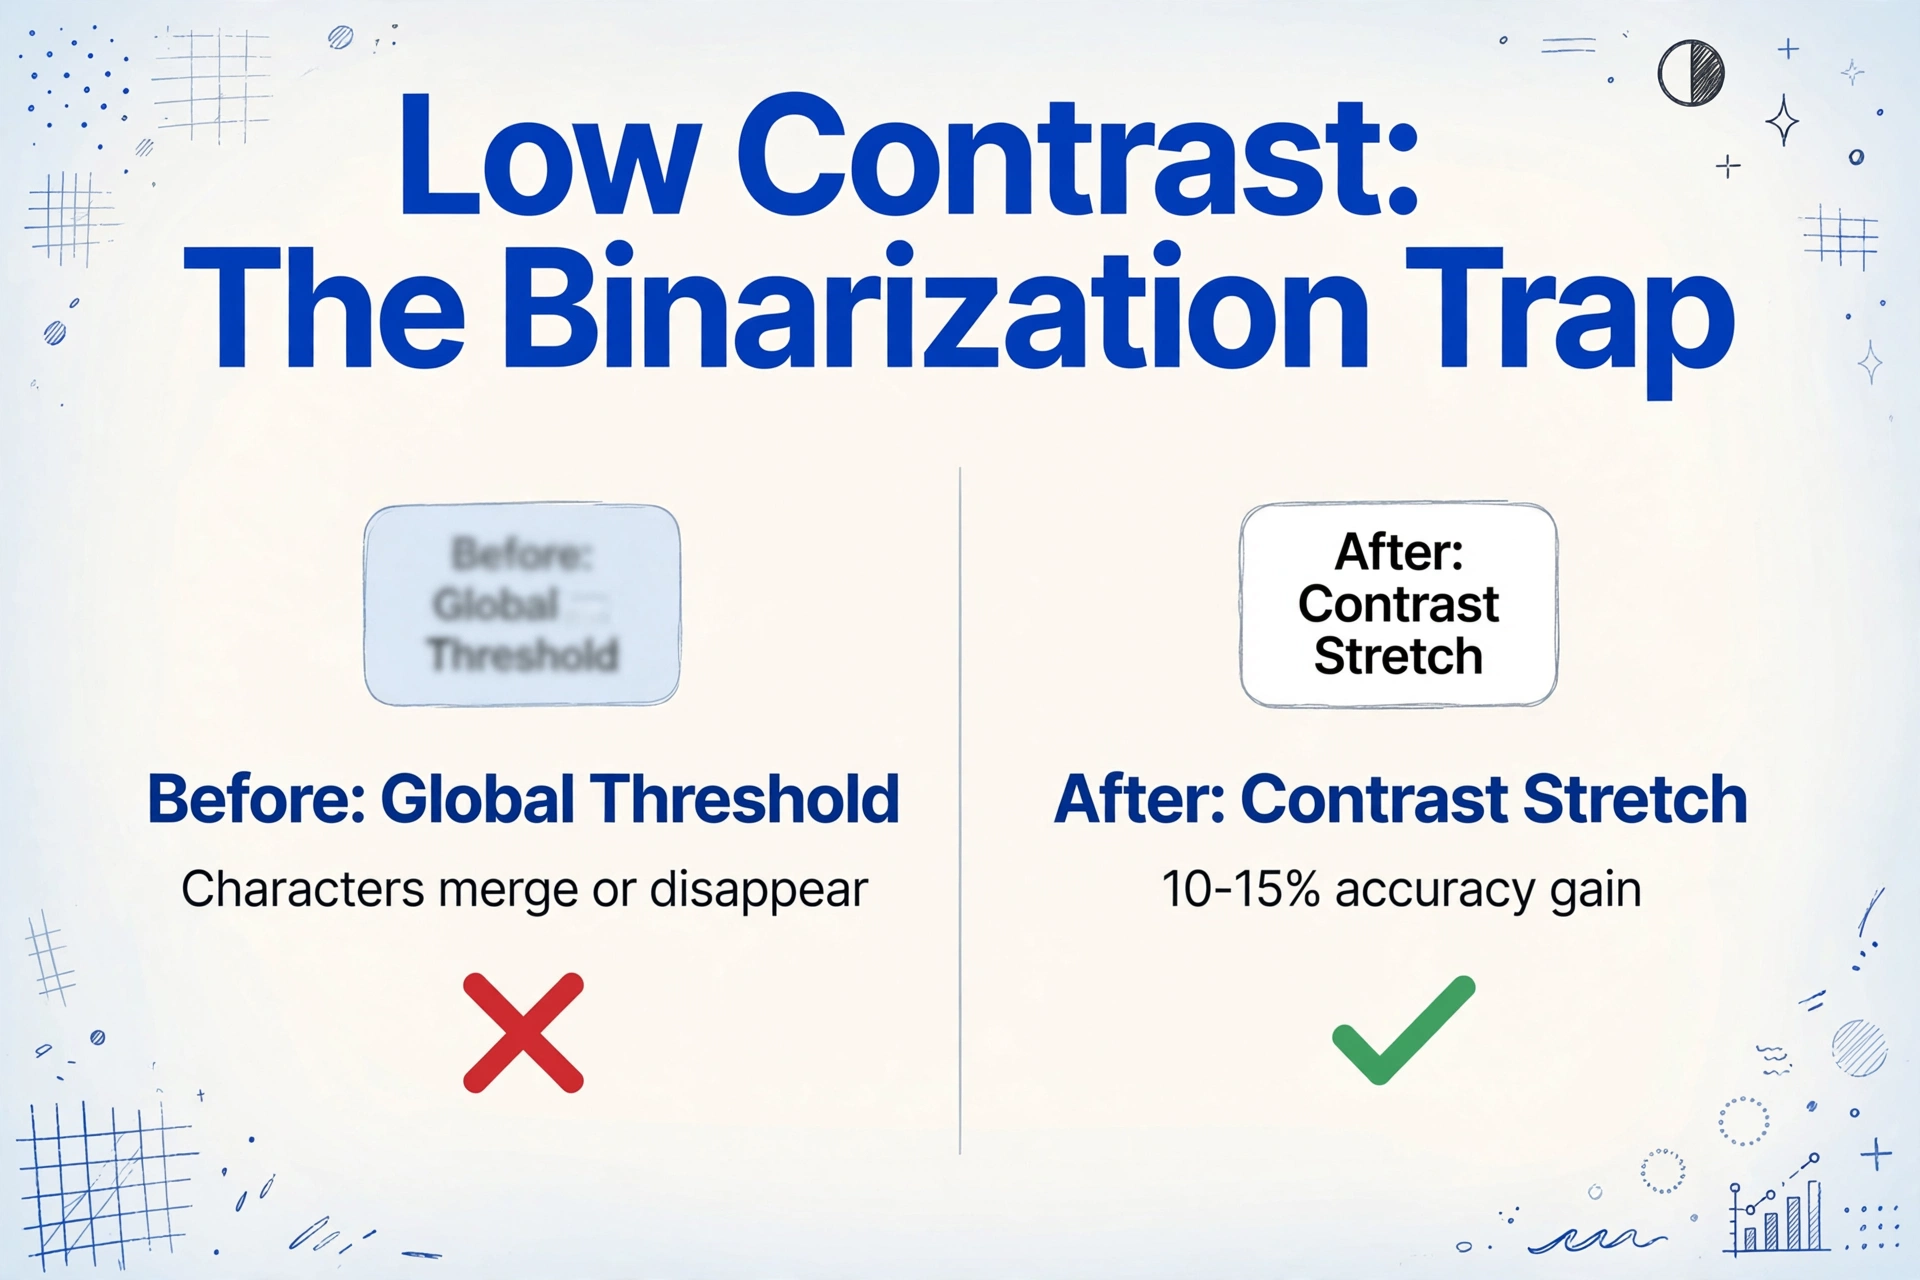
C'est la cause la plus courante et la plus facile à corriger. L'OCR traditionnel fonctionne en binarisant une image — en convertissant chaque pixel en noir ou blanc selon un seuil de luminosité. Si un pixel est plus sombre que le seuil, c'est du texte. S'il est plus clair, c'est le fond. Cela fonctionne bien lorsque le document est du texte noir sur papier blanc : l'écart de luminosité entre l'encre et le papier est suffisamment grand pour qu'un seuil global unique sépare nettement les deux.
Maintenant, placez du texte gris sur un fond bleu clair. Les pixels du texte ne sont que légèrement plus sombres que ceux du fond. Un seuil global — le type que les moteurs OCR traditionnels comme Tesseract utilisent par défaut — ne peut pas les séparer proprement. Certains pixels de texte basculent du mauvais côté. Les caractères fusionnent ou disparaissent. Un « 7 » est lu comme « 1 » parce que la barre horizontale a disparu. Un « 8 » devient « 3 » parce que la boucle supérieure a franchi le seuil comme fond.
Comment diagnostiquer : Ouvrez l'image numérisée dans n'importe quel éditeur photo et convertissez-la en niveaux de gris. Si le texte devient difficile à lire à l'œil nu après désaturation, le contraste est trop faible pour l'OCR traditionnel.
Correctif : Appliquez un étirement du contraste ou un réglage des niveaux avant d'exécuter l'OCR. La plupart des logiciels de numérisation et des éditeurs d'images disposent d'une fonction « Contraste automatique » ou « Niveaux automatiques » — cela suffit souvent à récupérer 10 à 15 % de précision perdue. Pour les documents professionnels, essayez également de numériser en mode niveaux de gris (ni couleur, ni noir et blanc bitonal). Une étude du Government Printing Office américain sur l'optimisation de l'OCR a constaté que la numérisation en niveaux de gris atteignait 98,26 % de précision sur des documents standard, tandis que la numérisation bitonale (noir et blanc pur) chutait à 77,12 % — l'étape de binarisation supprime précisément l'information dont l'OCR a besoin (GPO, Optimizing OCR Accuracy).
Cause 2 : Arrière-plans à motifs
Contrairement au faible contraste — qui est accidentel — les arrière-plans à motifs sont parfois délibérément conçus pour tromper l'OCR. Les motifs de sécurité sur les chèques (fonds guillochés à fines lignes, micro-impression, bandes arc-en-ciel), les sceaux anti-contrefaçon sur les certificats, et même le papier millimétré des feuilles de log techniques créent une couche de bruit visuel que le moteur OCR ne peut pas filtrer.
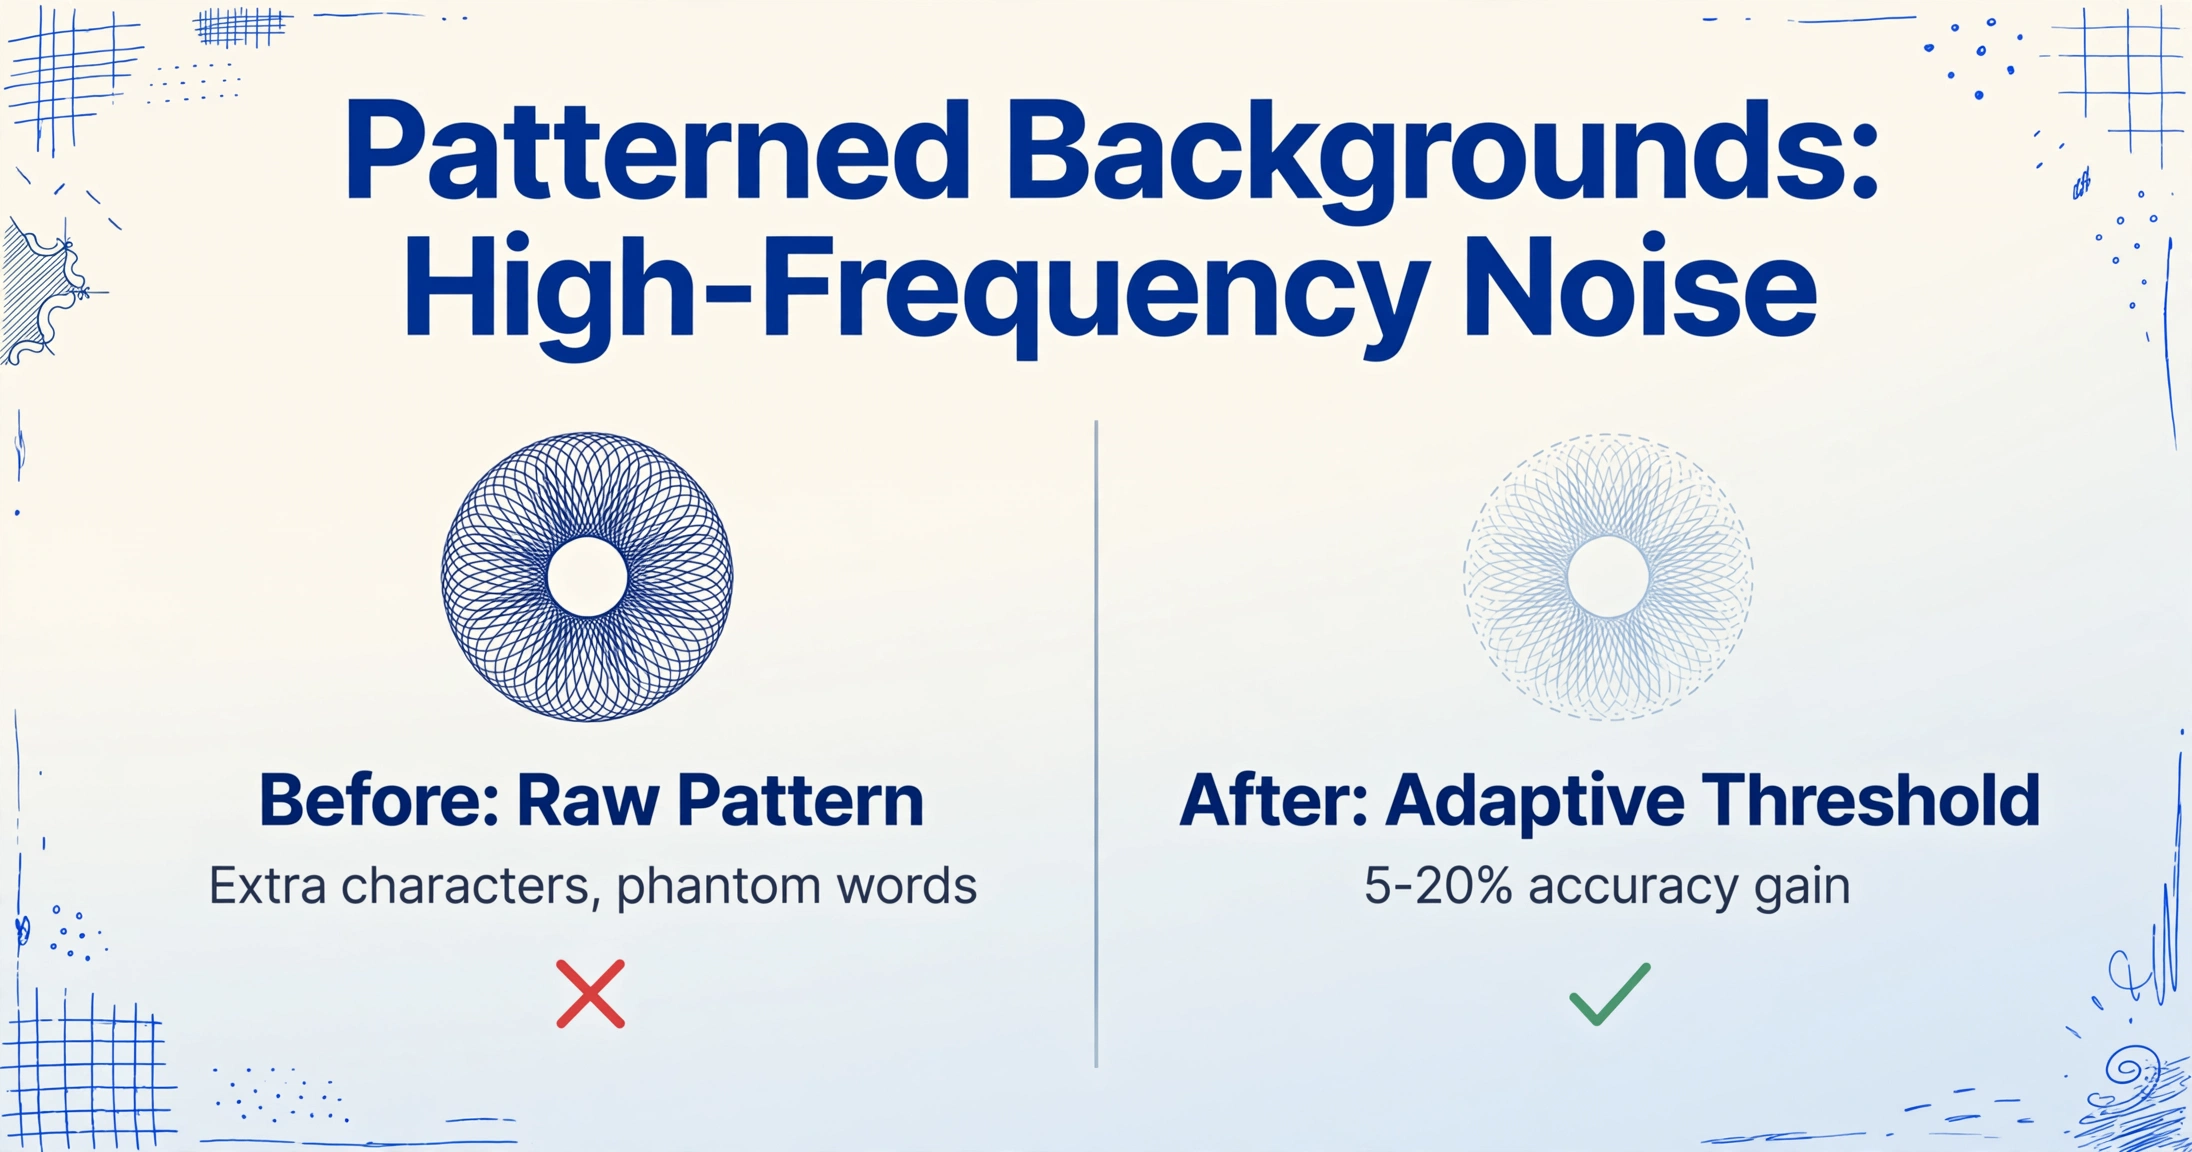
Le mécanisme est différent du faible contraste. L'arrière-plan de sécurité d'un chèque n'est pas à faible contraste — c'est un détail à haute fréquence. Le moteur OCR, lors de la binarisation, voit des millions de minuscules pixels sombres appartenant au motif. Il ne peut pas distinguer les « pixels du motif à ignorer » des « pixels de texte à conserver ». Le résultat est une image binaire où le texte repose sur un champ de bruit moucheté. Le moteur tente de former des caractères à partir d'un mélange de texte réel et d'artefacts d'arrière-plan. Il produit des caractères supplémentaires, des caractères cassés et des mots fantômes qui n'existent pas dans l'original.
Comment diagnostiquer : Zoomez sur le document à 200-400 %. Si vous voyez des lignes fines, des points, des motifs ondulés ou du micro-texte entrelacé autour du texte principal, le motif d'arrière-plan est le problème. Si la zone de texte ressemble à un fond de chèque bancaire ou à une bordure de certificat, c'est votre cause.
Correctif : Le pré-traitement seul corrige rarement les arrière-plans à motifs — une suppression agressive du bruit suffisamment forte pour effacer le motif floutera également le texte. Le correctif le plus pratique est la conversion en niveaux de gris suivie d'un seuil adaptatif local (méthode d'Otsu, algorithme de Sauvola) plutôt qu'un seuil global. Contrairement à un seuil global unique qui coupe toute l'image à un seul niveau de luminosité, le seuillage adaptatif divise l'image en petites fenêtres et calcule un seuil optimal par fenêtre. Cela préserve les bords du texte dans les zones où le motif est le plus dense.
Une note honnête distincte : certains motifs de sécurité ne sont pas destinés à être lus par des machines. L'arrière-plan complexe d'un chèque bancaire est une fonctionnalité anti-fraude. Les banques et les processeurs de paiement sont passés à des systèmes de compensation basés sur l'image (Check 21 aux États-Unis) précisément parce que l'OCR traditionnel ne peut pas extraire de manière fiable les données des arrière-plans de sécurité des chèques. Si vous traitez des chèques avec un OCR standard et qu'il échoue systématiquement sur le nom du bénéficiaire ou le montant — ce n'est pas un bug de l'outil. Cela fonctionne comme prévu.
Cause 3 : Filigranes
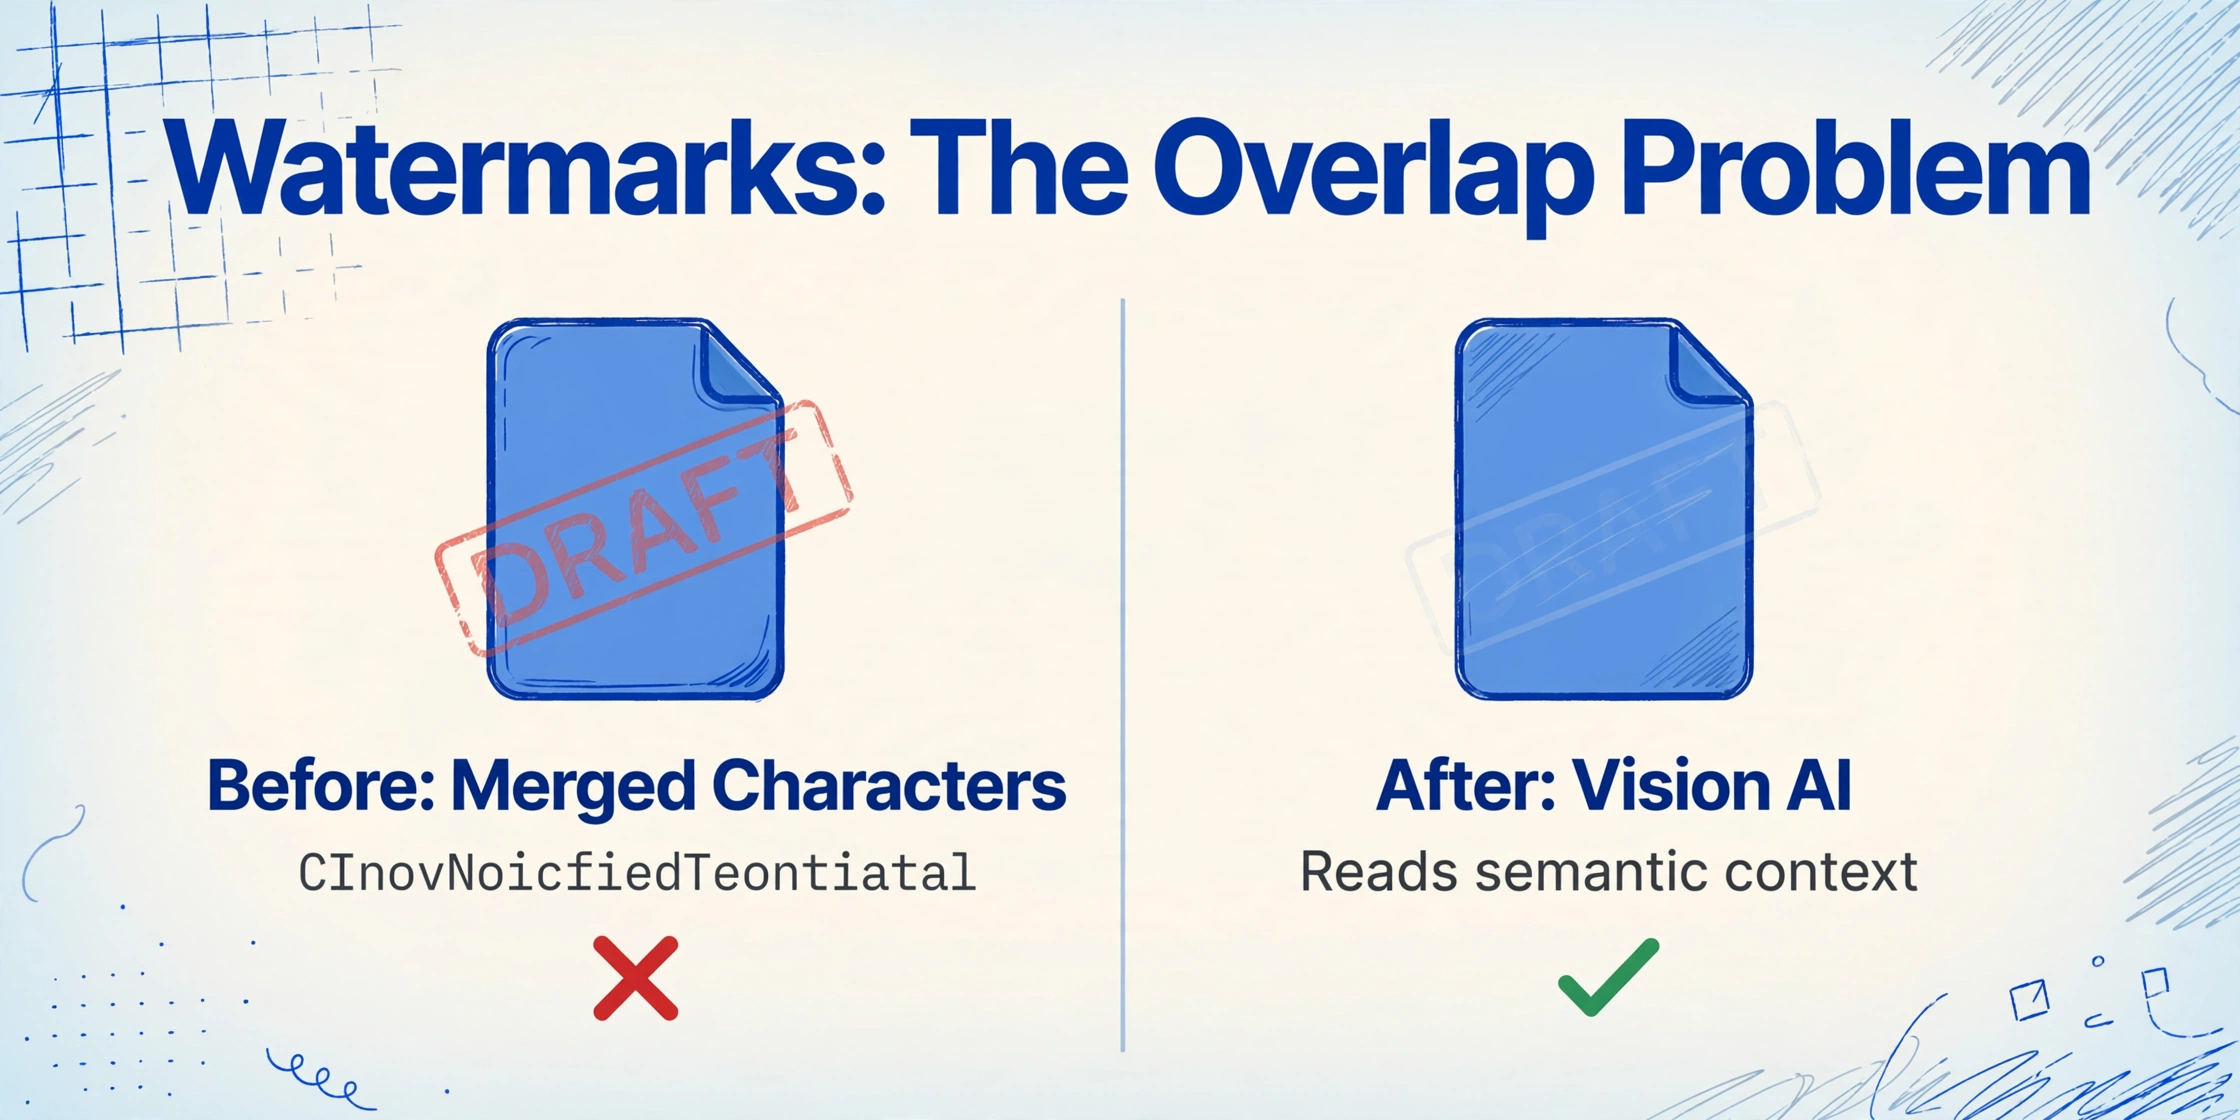
Cette cause piège les utilisateurs les plus expérimentés, car le document semble parfaitement lisible à l'œil humain. Un filigrane « DRAFT » ou « CONFIDENTIAL » est un texte semi-transparent superposé en diagonale sur la page. En le lisant, vous filtrez inconsciemment le filigrane et ne lisez que le contenu réel. L'OCR traditionnel n'a pas ce filtre. Il lit chaque pixel visible — y compris les pixels du filigrane qui chevauchent le texte réel.
Le résultat est un flux de caractères fusionné. Là où le document indique « Invoice Total: $1,250.00 » et qu'un filigrane diagonal « CONFIDENTIAL » traverse « Total », l'OCR peut produire « CInovNoicfiedTeontiatal: $1,C20E0.N00T. » Le filigrane n'est pas une couche séparée comme dans une application d'édition PDF — il est intégré aux données de pixels comme une superposition semi-transparente. Le moteur OCR ne voit qu'une seule couche, et c'est tout bruit.
Comment diagnostiquer : Si la zone de texte contient une seconde chaîne de texte faible qui la traverse en biais (horizontalement ou en diagonale), surtout des mots répétés comme « DRAFT », « SAMPLE », « COPY » ou « CONFIDENTIAL », vous avez un problème de filigrane. Avec un filigrane clair — si léger qu'il est à peine perceptible — le texte principal peut encore être lu correctement. La zone dangereuse est celle des filigranes à opacité moyenne, où le texte réel et le filigrane ont tous deux une densité de pixels suffisante pour influencer la reconnaissance des caractères.
Correctif : C'est le correctif de pré-traitement le plus difficile. Contrairement aux problèmes de contraste ou de motif, les filigranes chevauchent physiquement les mêmes pixels que le texte réel — aucun réglage de seuil ne peut les séparer proprement, car il n'y a pas de séparation nette dans l'image source.
Quelques approches peuvent aider dans des cas limités : augmenter la luminosité peut réduire les pixels de filigrane faibles sous le seuil de détection ; un filtre dans le domaine fréquentiel (coupe-bande basé sur FFT) peut supprimer les filigranes ayant un angle et un espacement diagonaux cohérents. Mais ces deux techniques nécessitent un réglage par document et dégraderont la qualité du texte réel au passage. L'équipe produit de Microsoft Azure Form Recognizer a confirmé que l'interférence des filigranes est une limitation connue sans solution générale disponible (Microsoft Q&A, 2023-2024).
Le correctif fiable est architectural : utilisez un outil qui lit le document de manière sémantique plutôt que pixel par pixel.
Cause 4 : Dégradés de fond
Les dégradés sont un cas particulier du problème de contraste, et ils révèlent la limite fondamentale du seuillage global. Un fond dégradé passe du foncé en haut de la page au clair en bas — ou du bleu dans l'en-tête au blanc dans le corps. Le texte placé sur le dégradé traverse plusieurs zones de luminosité. Dans la partie sombre du dégradé, le texte a un faible contraste avec le fond. Dans la partie claire, le même texte a un contraste élevé.
Un seuil global — une seule coupure de luminosité appliquée à toute la page — ne peut pas résoudre les deux zones à la fois. Réglez le seuil pour capturer le texte dans la zone sombre, et le fond de la zone claire sera classé comme texte (faux positifs). Réglez-le pour nettoyer la zone claire, et le texte dans la zone sombre disparaît. Le même caractère « 5 » peut être correctement lu en bas du dégradé et totalement manqué en haut.
Comment diagnostiquer : Regardez l'en-tête ou la zone de bannière du document. Si la couleur de fond passe progressivement d'une teinte à une autre — un en-tête bleu marine foncé qui s'estompe vers un bleu plus clair, ou une bannière rouge en haut d'une facture qui se fond dans le corps blanc — et que le texte traverse cette transition, le dégradé en est la cause. Le symptôme est incohérent : la même police, la même taille, le même document produisent une extraction correcte dans une zone et des erreurs dans une autre.
Correctif : Le seuillage adaptatif est la solution standard pour les dégradés. Comme il calcule un seuil séparé pour chaque fenêtre locale, le texte du côté sombre du dégradé et celui du côté clair obtiennent chacun leur propre binarisation optimale. La plupart des bibliothèques d'imagerie (OpenCV, Pillow, LEADTOOLS) prennent en charge les méthodes adaptatives. Appliquez-le avec une taille de fenêtre d'environ 3 fois la largeur moyenne d'un caractère — trop petite, l'algorithme traite les grandes zones uniformes comme du bruit ; trop grande, il se comporte à nouveau comme un seuil global.
Le fil conducteur des quatre causes : la ROC traditionnelle repose sur une stratégie de lecture au niveau du pixel. Lorsque les pixels seuls ne peuvent pas séparer proprement le texte du fond — en raison d'un faible contraste, de motifs superposés, d'un filigrane de texte superposé ou d'une luminosité de dégradé changeante — le moteur ne dispose d'aucune compréhension de plus haut niveau sur laquelle s'appuyer. Il ne sait pas à quoi un champ « Total » devrait ressembler, ce qu'un montant en dollars devrait contenir, ou que « CONFIDENTIEL » ne fait pas partie du corps de la facture.
Quand le pré-traitement fonctionne (et quand il ne fonctionne pas)
Voici un arbre de décision pratique pour savoir quelle technique de pré-traitement convient à quelle cause :
| Cause | Meilleur pré-traitement | Amélioration attendue | Limite |
|---|---|---|---|
| Faible contraste | Niveaux de gris + Niveaux automatiques / Étirement du contraste | Gain de précision de 10 à 15 % | Si le texte et l'arrière-plan ont une luminance quasi identique, aucun étirement ne peut les récupérer |
| Arrière-plan à motifs | Seuil adaptatif local (Sauvola / Niblack) | 5 à 20 % selon la densité du motif | Les motifs de sécurité (chèques, certificats) sont conçus pour y résister — les résultats varient selon le document |
| Filigrane | Augmentation de la luminosité / Filtre fréquentiel | 0 à 10 % — très inconstant | Les pixels du filigrane chevauchent physiquement ceux du texte ; aucun pré-traitement ne peut les séparer complètement sans endommager le texte sous-jacent |
| Arrière-plan dégradé | Seuil adaptatif local | Gain de précision de 10 à 20 % | Fonctionne bien pour les dégradés linéaires lisses ; les dégradés complexes à plusieurs arrêts peuvent encore échouer |
Quand passer à l'étape supérieure : pourquoi la Vision IA gère mieux les quatre cas
Si vous avez essayé les correctifs de pré-traitement ci-dessus et obtenez toujours une extraction peu fiable — en particulier avec des documents comportant des filigranes ou des arrière-plans très structurés — le problème ne vient pas de l'image. Il vient de l'architecture d'extraction. La ROC traditionnelle est une technologie au niveau du pixel : elle prend une décision binaire pour chaque pixel (texte ou arrière-plan) et construit les caractères à partir du résultat. Lorsque les pixels sont ambigus, le moteur échoue car il n'a pas de stratégie de secours.
Les modèles de Vision IA (également appelés ROC basée sur VLM ou LLM) lisent les documents à un niveau sémantique. Ils ne binarisent pas l'image. Ils traitent l'image en couleur complète, comprennent la structure du document, identifient les zones de texte, puis lisent le texte en contexte — de la même manière qu'un humain lit un document filigrané en ignorant inconsciemment la superposition. Cette différence architecturale signifie que la Vision IA gère mieux les quatre problèmes d'arrière-plan, souvent sans aucun pré-traitement :
- Faible contraste : La Vision IA lit le texte pâle en reconnaissant les formes des caractères et le contexte des mots, sans chercher une frontière nette entre pixels noirs et blancs
- Arrière-plans à motifs : Le modèle apprend à distinguer le texte du motif d'arrière-plan lors de l'entraînement, traitant le motif comme un bruit visuel plutôt que comme des candidats au texte
- Filigranes : La Vision IA lit le vrai texte en comprenant ce que dit le document — elle n'est pas perturbée par le « BROUILLON » superposé car le contexte sémantique lui indique quel texte appartient au corps du document
- Dégradés : Sans dépendre d'un seul seuil de luminosité, les transitions de dégradé ne provoquent pas d'échecs de reconnaissance caractère par caractère
ImageToTable.ai utilise cette approche de Vision AI : vous téléversez le document tel quel — fond coloré, filigrane, dégradé, ou les trois à la fois — et vous indiquez les données dont vous avez besoin. L'IA lit la page entière comme le ferait un humain, extrayant les champs que vous avez nommés, où qu'ils se trouvent sur le document. C'est la différence entre l'extraction basée sur la position (qui échoue sur tout fond non standard) et l'extraction basée sur la sémantique (qui fonctionne quel que soit l'aspect du document).
Une discussion connexe mérite d'être lue : L'IA peut-elle lire des documents flous ? explique comment la Vision AI se dégrade gracieusement face aux problèmes de qualité d'image — et le même avantage architectural s'applique aux interférences de fond. Et si vous traitez des documents qui mélangent contenu textuel et contenu uniquement image, notre analyse des types de PDF vous aide à identifier la couche à partir de laquelle votre outil lit.
Questions fréquemment posées
Puis-je simplement supprimer le filigrane avant d'exécuter l'OCR ?
Pas de manière fiable. Les filigranes semi-transparents sont fusionnés dans les pixels de l'image. Les supprimer nécessite d'estimer les valeurs de pixels d'origine en dessous, ce qui est un problème mathématiquement mal posé — il n'existe pas de réponse unique correcte. Les outils qui prétendent « supprimer les filigranes » utilisent soit des filtres de fréquence qui suppriment également les détails fins du texte, soit des algorithmes d'inpainting qui devinent le contenu manquant. Pour les données documentaires critiques, la suppression du filigrane introduit plus d'erreurs qu'elle n'en résout.
La numérisation en niveaux de gris résout-elle tous les problèmes de fond ?
Non, mais elle résout le problème le plus courant. La numérisation en niveaux de gris préserve les informations de luminance qui aident l'OCR à distinguer le texte du fond. Pour l'étude du Government Printing Office mentionnée précédemment, les niveaux de gris ont amélioré la précision de 77 % (bitonal) à 98 % sur les documents standard. Mais les niveaux de gris seuls ne peuvent pas corriger les filigranes (la superposition est toujours présente dans l'image en niveaux de gris), les motifs de sécurité denses, ou le contraste extrêmement faible.
Pourquoi le chèque de ma banque ne fonctionne-t-il avec aucun outil OCR ?
Les chèques bancaires utilisent des fonds de sécurité — motifs guillochés à lignes fines, micro-impression et designs à couleurs changeantes — spécifiquement conçus pour empêcher l'altération et la contrefaçon. Ces motifs sont intentionnellement difficiles à traiter par machine. La plupart des systèmes automatisés de traitement des chèques (comme Check 21 aux États-Unis) utilisent la capture d'image et la reconnaissance de caractères à encre magnétique (MICR) plutôt que l'OCR pleine page, précisément pour cette raison. Si vous devez extraire des données de chèques, un outil de Vision AI donnera de meilleurs résultats que l'OCR traditionnel, mais même dans ce cas, les dispositifs de sécurité des chèques restent un défi.
Les outils d'IA gèrent-ils mieux les fonds colorés que l'OCR traditionnel ?
Oui — et de loin. L'OCR traditionnel traite les fonds colorés comme un problème au niveau du pixel. L'IA visuelle considère le document entier comme une scène visuelle, lisant le texte en contexte au lieu de binariser chaque pixel. Pour les fonds à faible contraste ou dégradés, la différence est spectaculaire : l'IA visuelle maintient souvent une précision supérieure à 90 %, là où l'OCR traditionnel chute à 60-70 %. Pour les filigranes et motifs de sécurité, l'IA visuelle conserve un avantage car elle ne cherche pas à « nettoyer » le fond — elle lit à travers.
Vous n'êtes pas sûr que votre document ait un problème de contraste ? Téléversez-le et vérifiez.
Le moyen le plus rapide de savoir si vos échecs d'extraction sont corrigeables par prétraitement ou nécessitent un autre outil est d'essayer. ImageToTable.ai traite les documents tels quels — fonds colorés, filigranes, dégradés — sans configuration, sans modèle et sans réglage de prétraitement. Téléversez un fichier et voyez ce qui revient.
Téléverser un document →Aucune inscription requise. Résultats en 10 secondes.