ACORD 140 損失通知を抽出して
クレームトリアージ用にExcelへ変換する方法
ハリケーン、山火事、洪水の発生後72時間は、物的損害クレームの判断が最も重要となる時間帯です — しかし、クレーム処理は最も遅い時間帯でもあります。その理由は手続き上の問題ではなく構造上のものです。物的損害の損失通知は、代理店、ブローカー、保険契約者からPDFで届きます。それぞれを読み、スプレッドシートやクレーム管理システムに入力し、誰かが物件を調査する前に優先順位を付ける必要があります。ISO(保険サービス事務所)のProperty Claim Servicesのデータによると、業界は2025年の第3四半期までに約350万件のクレームを処理しました(Verisk、2026年)。数万件の被災物件が発生する大災害の後、データ入力待ちの損失通知の山が本当のボトルネックとなります — 調査能力や鑑定人の確保ではなく、フォームの項目を画面に入力する時間が問題なのです。
重要ポイント
- ハリケーン発生後、1週間で20万件の物的損害クレームが届きます — そして、誰かがPDFから保険契約番号、損失見積もり、原因の説明をスプレッドシートに入力するまで、1件も調査できません。
- 1件あたり15分かかる場合、5,000件の損失通知で1,250時間のデータ入力が必要になります — そして、NAIC(全米保険監督官協会)の規制時計は、データ入力の日付ではなく、損失発生日からカウントされます。
- AIセマンティック抽出は、ACORD 140のフィールドをページ上の位置ではなく意味に基づいて読み取ります — 100件の損失通知を、重大度フラグと期限アラート付きの並べ替え可能なトリアージスプレッドシートに5分以内で変換します。
ACORDフォームは北米の保険データ交換の基盤であり、170以上の標準化されたフォームがAssociation for Cooperative Operations Research and Developmentによって維持されています。商業保険の申込書から保険証明書、損失通知までを網羅しています。物的損害保険金請求において、ACORD損失通知は、保険契約者情報、損失詳細、損害原因、損害内容の説明、初期見積額を記録する文書であり、請求のトリアージと振り分けを決定するデータを提供します。商業保険では、関連するACORD 140 Property Sectionフォームが、355の入力可能なフィールドを持つ3ページにわたって詳細な建物および補償データを記載します。
この記事では、物的損害の損失通知とACORD 140データを構造化されたExcelトリアージスプレッドシートに抽出するワークフローを説明します。このワークフローは、災害後のフォームの山をデータ入力待ち行列から優先順位付けされたアクションリストに変えます。同じアプローチは他のACORDフォームタイプにも適用できます。ACORD 25 COIデータをExcelに抽出するガイドおよびACORD 27物的保険証拠の抽出ガイドでは、異なる保険文書に対して同じ列ベースの抽出ワークフローを扱っています。
手動データ入力は災害規模で機能不全に陥る — 忍耐の問題ではなく、物理的な限界の問題
保険請求チームは、手動データ入力が最大の業務負担であることを長年認識しています。しかし、あまり議論されないのは、それが最も重要となる瞬間 — 災害後 — に壊滅的に失敗する理由と、規制上の期限がフォーム読み取りに費やされる1時間ごとに何を意味するかです。
保険自動化プロバイダーのワークフロー調査によると、保険金査定人は勤務時間の35〜45%を実際の請求判断ではなくデータ処理に費やしています。標準的な案件数を担当するデスク査定人の場合、1日あたり約3〜4時間をフォームデータの読み取り、入力、検証に費やすことになります。単一の損失通知の計算: 複数ページのACORDフォームから保険証券番号、被保険者名、損失場所、損失日、原因、損失内容、見積額を特定して転記するのに12〜18分かかり、それが待機中の請求件数分だけ掛け算されます。
災害後、この計算は崩壊します。単一のハリケーン上陸で、影響を受けた州全体で20万〜40万件の物的損害請求が発生する可能性があります。地域保険会社は最初の1週間で2,000〜5,000件の損失通知を受け取るかもしれません。1フォームあたり15分として、単一の請求が査定人のデスクに実際の評価のために届く前に、純粋なデータ入力だけで500〜1,250時間かかります。保険金請求プロセスは損失通知が提出されたときに始まるのではなく、データがシステムに入力されたときに始まるのです。
規制面のプレッシャーは、多くのワークフロー議論が省略する要素です。NAIC 不公正な損害保険金請求解決慣行モデル規則(モデル902)は、保険会社が通知から15日以内に請求を受理し、合理的な期間内に責任の承認または否認を行うことを定めており、責任承認から30日以内に支払いを行う必要があります。多くの州ではさらに厳しい基準を課しています。フロリダ州法§626.9541は、争いのない第一者財産保険金請求の支払いを60日以内に要求し、同様の期限はほとんどの管轄区域に存在します。データをシステムに入力するのに費やす1日は、調査期間から差し引かれる1日です。コンプライアンスリスクは悪意から生じるのではなく、未読のフォームの山から生じます。
問題は保険金請求チームが遅いことではありません。データ入力ステップが請求量に比例して増加し、ちょうどその瞬間に請求量が基準値の10〜50倍に急増する一方で、規制上の時計はデータ入力日ではなく損失発生日から動き始めることです。
トリアージに重要なACORD 140フィールドは、引受審査に重要なフィールドとは異なります
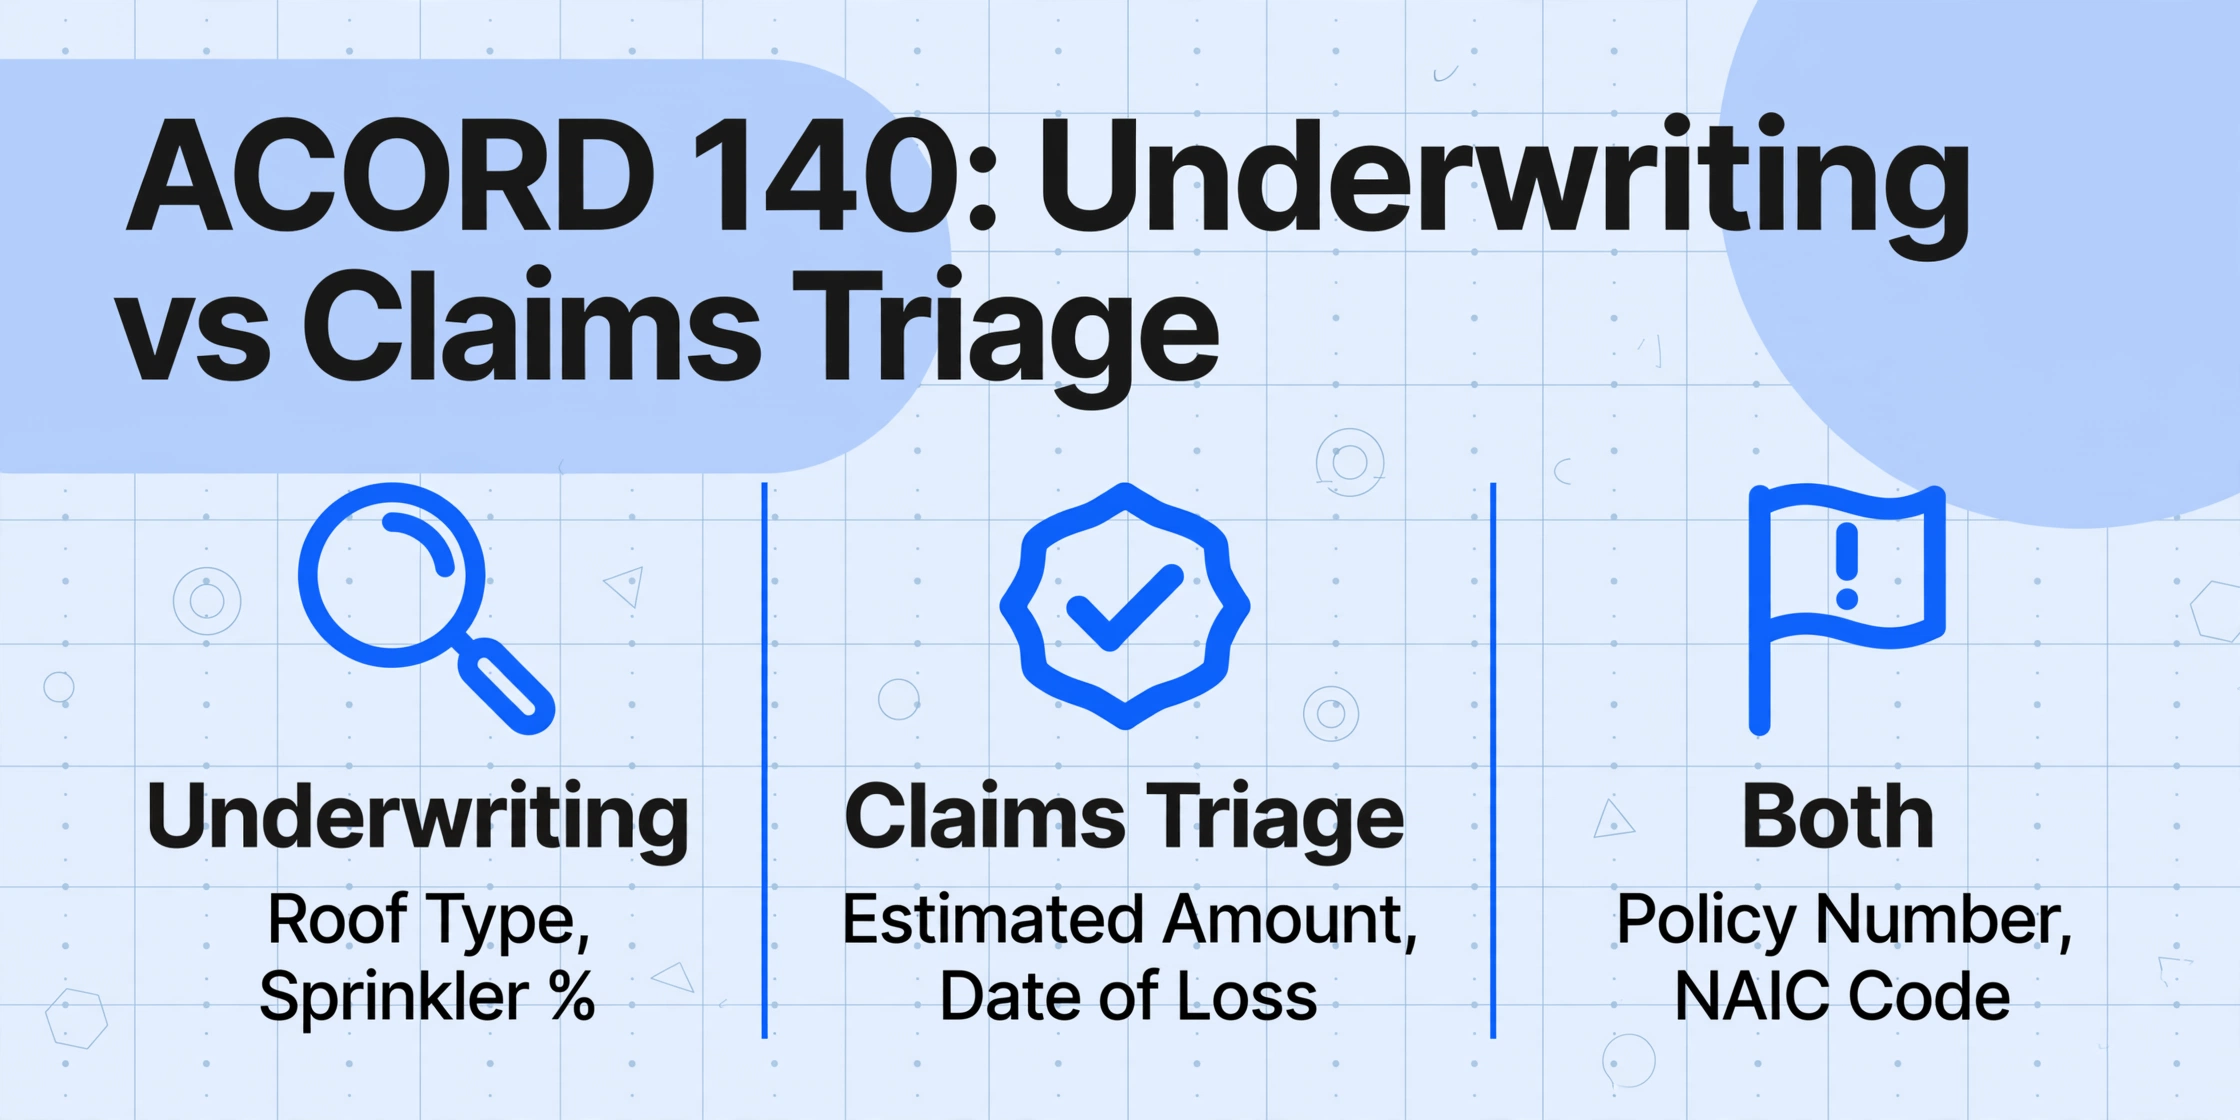
ACORD 140 財産セクションは、もともと商業保険の申込用に設計された、情報量の多い複数ページのフォームです。構造種別、用途、防火クラス、補償選択を取得します。しかし、このフォームが保険金請求の文脈で届いた場合(財産損失通知に添付された裏付け書類として)、トリアージに重要なフィールドは完全に変わります。引受審査担当者は屋根の種類とスプリンクラーの割合を知る必要があります。保険金請求査定担当者は、損失の推定コストと負傷者の有無を知る必要があります。
保険金請求のトリアージ判断を左右するフォームフィールドは、4つの層に分類されます。
| トリアージ層 | フィールド | トリアージで重要な理由 |
|---|---|---|
| 1 — 識別 | 証券番号、被保険者名、代理店名、NAICコード | これらがないと、クレームを証券に照合したり、適切なアジャスターにルーティングしたりできません。NAICコードは保険会社を一意に識別します。レイヤードプログラムに複数の保険会社が関与する場合に不可欠です。 |
| 1 — 識別 | 物件住所/損害発生場所、敷地番号、建物番号 | クレームがどのアジャスター管轄に属するか、物件が宣言された災害地域にあるかを決定します。住所が一致しないと、クレームが誤ったキューに送られます。 |
| 2 — 重大度 | 推定損害額、保険の対象、補償限度額 | 最も重要な仕分け基準です。保険会社の重大度しきい値(商業物件では通常$50,000〜$100,000)を超えるクレームは、上級アジャスターの割り当てが必要です。下回るクレームは、デスクレベルまたはストレートスルー処理の対象となる場合があります。 |
| 2 — 重大度 | 損害原因、損害発生日、損害と破損の説明 | 補償の適格性(この危険は補償対象か?)を決定し、潜在的な求償(第三者責任?)をフラグし、不正の兆候を特定します。警察報告書が添付された火災損害は、風害クレームとは異なるルーティングになります。 |
| 3 — 連絡 | 被保険者連絡先名、自宅電話、業務用電話、連絡時間 | 最初のアジャスター連絡のスケジュール設定。この段階で電話番号が誤っていると、クレームチームが電話のやり取りに追われる間、2〜3日の遅延が発生します。 |
| 4 — 参照 | 抵当権者/損害受取人の名前と住所、ローン番号 | 決済に必要です。損害受取人を確認せずに支払いを発行することはできません。受付時にこれがないと、プロセスの最後に支払い遅延が発生します。今抽出することで、その遅延を防げます。 |
重要な違い:ティア1のフィールドは、他のどのステップに進む前に100%正確でなければなりません。証券番号が間違っていると、クレーム全体が誤った保険会社に送られます。ティア2のフィールドは、ルーティングの優先順位とアジャスターの割り当てを決定します。$5,000の水害クレームが、$500,000の構造的火災クレームの前に並ぶべきではありません。ティア3と4のフィールドは後で重要になりますが、今抽出しても問題ありません。受付時に取得することで、数日後に同じフォームを再度確認する手間が省けます。
保険フォームタイプ間での抽出フィールドの違いをより広く比較するには、完全なACORD 25 COI抽出ガイドで、賠償責任証明書に対する同じティアベースのフィールド優先順位を説明しています。
トリアージ業務に合わせた抽出列を設定 — フォームのレイアウトに合わせる必要はありません
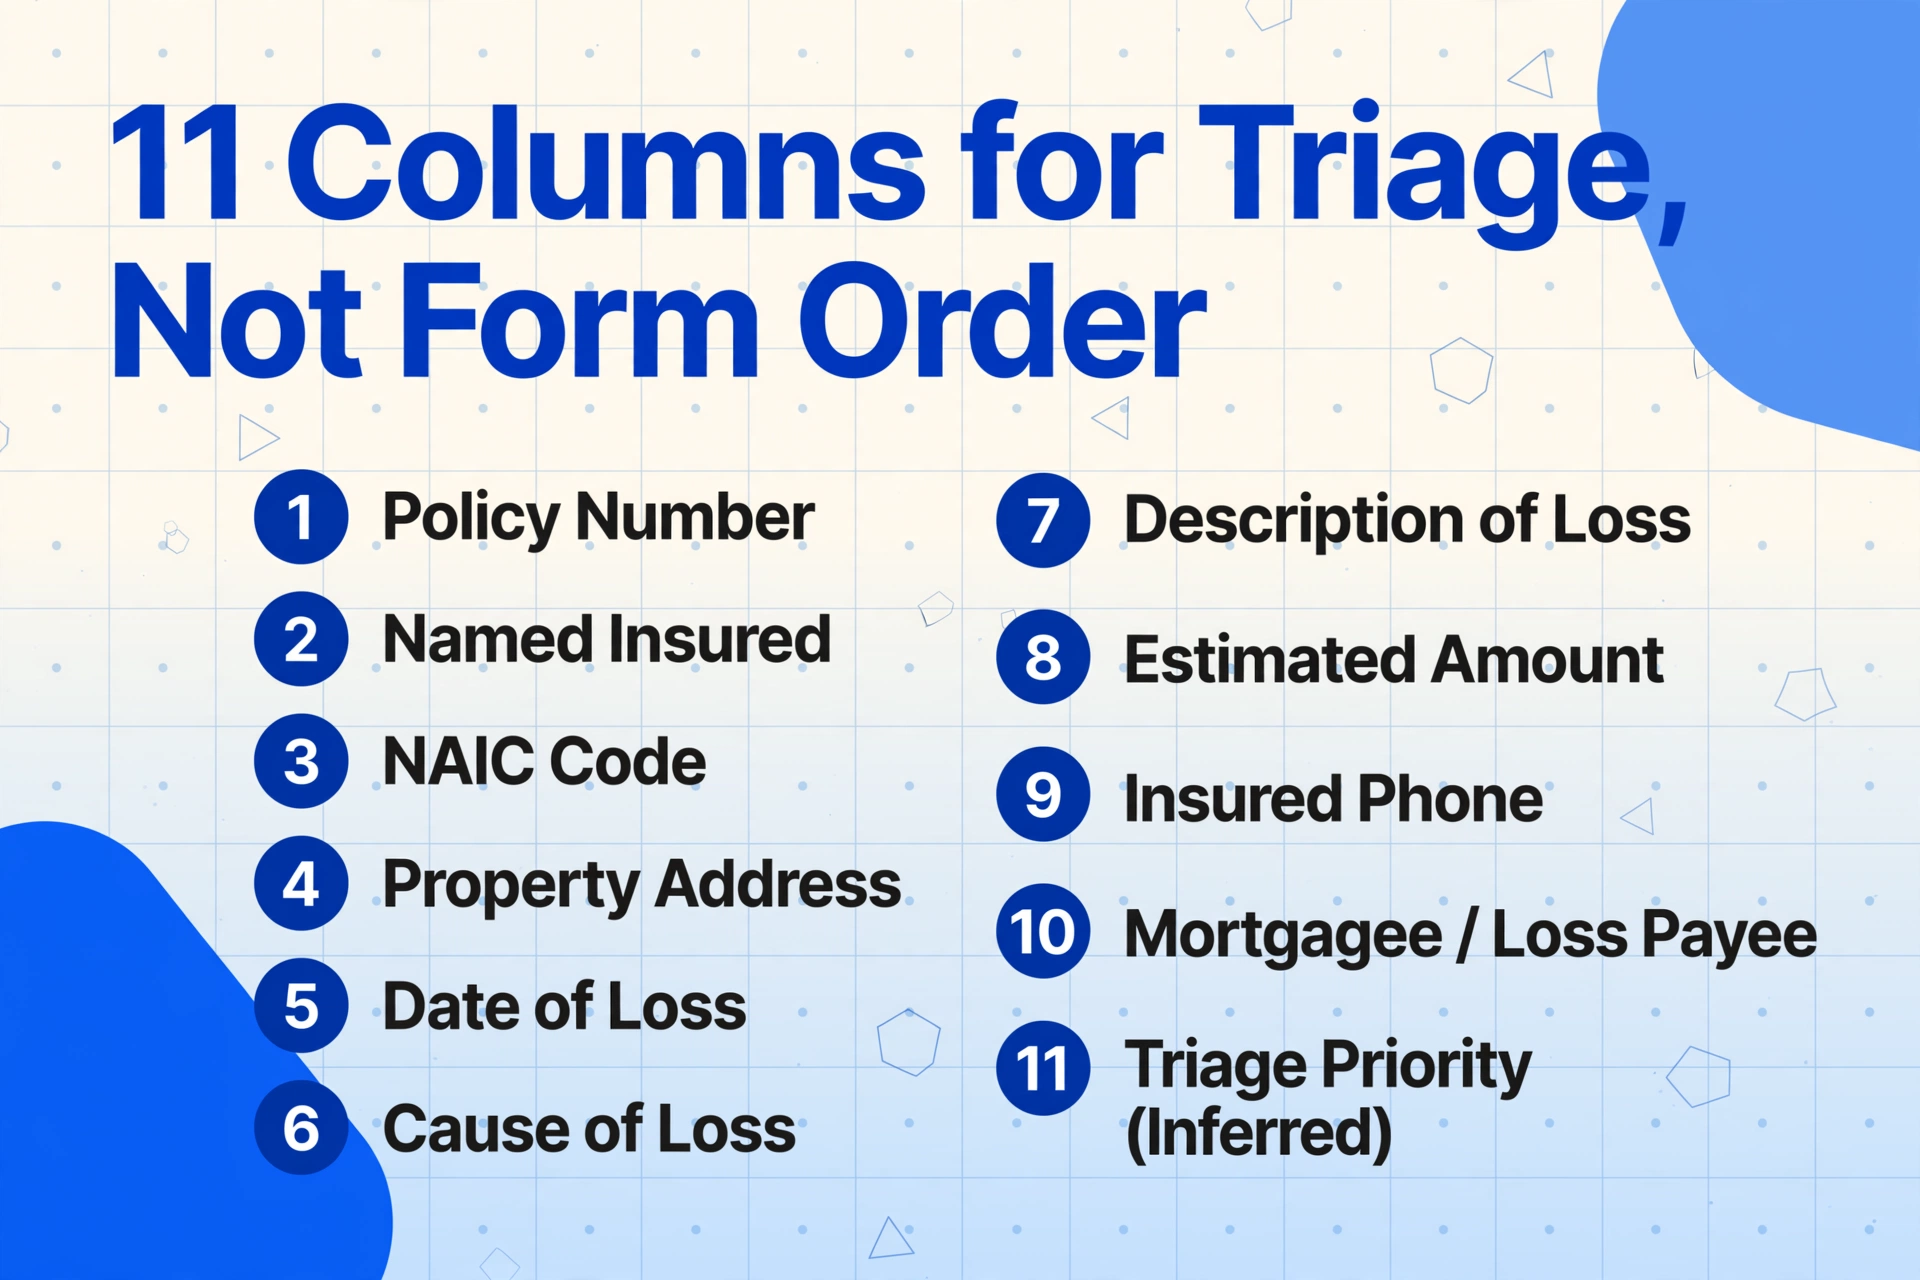
ACORDフォームから構造化データを抽出する際に最も多い間違いは、フォームのフィールド順をそのまま列ヘッダーにすることです。フォームは管理上の論理(代理店情報→建物情報→補償内容の順)でデータをグループ化しています。一方、トリアージ用スプレッドシートは意思決定の論理(識別情報→重大度→連絡先の順)でデータをグループ化する必要があります。
トリアージ最適化されたACORD 140抽出の列セットは以下のとおりです。
| 列名 | 抽出モード | トリアージ機能 |
|---|---|---|
Policy Number | 直接抽出 | 管理システムで保険契約と請求を照合 |
Named Insured | 直接抽出 | 請求者の身元確認 |
NAIC Code | 直接抽出 | 保険会社を検証し、適切な請求チームに振り分け |
Property Address | 直接抽出 | 担当アジャスターを地域別に割り当て、災害ゾーンを確認 |
Date of Loss | 直接抽出 | 損失発生からの経過日数を計算し、保険期間を確認 |
Cause of Loss | 直接抽出 | 補償範囲の確認、求償フラグ、CATコードの割り当て |
Description of Loss | 直接抽出 | 損害範囲の評価、重大度の分類、不正請求のスクリーニング |
Estimated Amount | 直接抽出 | 重大度に基づく振り分け、保険積立金の設定 |
Insured Phone | 直接抽出 | 初回連絡のスケジュール設定 |
Mortgagee / Loss Payee | 直接抽出 | 和解支払いの確認 |
Triage Priority | 推論列 | AIが推定金額と損失原因に基づいて緊急/高/標準/監視を割り当て |
この列セットは2つの抽出モードを使用します。直接抽出は、フォームに明示的に印刷されている値(保険証券番号、日付、金額)を取得します。AIは各フィールドラベルの意味を理解してこれらを特定するため、ある保険会社のフォームで「Policy #」とラベル付けされた保険証券番号も、別のフォームで「Policy Number」とラベル付けされたものも、同じ列にマッピングされます。これがセマンティック抽出と位置ベースのOCRの違いです。従来のツールは、フィールドが別のフォームバージョンで異なる位置に移動すると失敗しますが、セマンティック抽出は座標ではなく意味で読み取るため成功します。
推論列(Triage Priority)は異なる仕組みで動作します。AIが推定金額と損失原因を読み取り、ビジネスロジックを適用して優先度を割り当てます。例:$100,000を超える火災損失は緊急に振り分けられ、$10,000未満の水害請求は標準に振り分けられます。分類ルールは列定義に含まれ、AIはバッチ内のすべての行にそれらを適用します — 抽出とトリアージを1回のパスで実行します。
運用上の注意点: ACORD 140の手書きの損失説明欄は、フォームの中で最も難しい部分です。アジャスターや代理店は損害を自分の言葉で、自分の手書きで記述します — 「水が屋根から侵入し、メインオフィスエリアの天井が崩落、内容物に損害、電気系統に問題の可能性」。AIの手書き文字認識はこのばらつきに対応しますが、列名は抽出を正しい内容に導くために十分に具体的であるべきです。単に「説明」という列名では、引受目的の建物説明を含む、ページ上のあらゆる記述テキストを取得してしまう可能性があります。「損失の説明」または「損失説明」と命名することで、AIの検索対象が損失関連のテキストブロックに絞り込まれます。
バッチ処理: 100枚のPDFから1つのスプレッドシートへ、5分以内で
災害キューをトリアージ用スプレッドシートに変換する抽出ワークフローは、5つのステップで構成されています。時間のボトルネックはステップ1のアップロードです — ファイルの物理的な転送が必要なためです。それ以降はすべてAI処理時間で実行され、フォーム1枚あたり秒単位で測定され、分単位ではありません。
ファイルは安全に処理され、保存されません。
ステップ1 — すべての損失通知を一度にアップロード。 ACORDフォームのフォルダ全体 — 代理店からのPDF、現場アジャスターからのスキャン文書、手書きの損失報告書の写真 — をアップロードエリアにドラッグします。このツールはPDF、JPG、PNG、WebP形式に対応し、転送を高速化するために大きなファイルを自動的に圧縮します。バッチアップロードとは、ファイルを1つずつではなく、セット全体を一度に選択することを意味します。
ステップ2 — 列名を入力。 上記の表の列リストを列定義パネルにタイプまたは貼り付けます。各列名は出力スプレッドシートのヘッダーとなり、AIへの検索指示となります。この列セットはテンプレートとして一度保存すれば、将来のすべての災害イベントで再利用できます — 同じ11列が任意のACORD損失通知バッチで機能します。
ステップ3 — 全バッチを実行する前にプレビュー行を確認。 AIは最初に1つのフォームを処理し、抽出された値を各列にマッピングして表示します。このプレビューにより、100枚すべてのフォームを処理する前に、「保険証券番号」が正しいフィールドを取得したことを確認できます。保険証券番号が間違った列に入った場合は、列名を調整して再プレビューします — バッチはまだ開始されていません。
ステップ4 — フルバッチを実行。処理をクリックします。AIが各フォームを読み取り、セマンティック理解によって各要求フィールドを特定し、出力テーブルに入力します。100件の損失通知のバッチは、約2〜5分の処理時間で完了します — 同じタスクを手動データ入力で行う場合の25〜30時間と比較して。印刷テキストの99%精度(ツールの公開ベンチマークによる)と、筆記体や混合大文字小文字のエントリに対する強力な手書き認識により、出力テーブルは軽い検証で使用可能であり、大掛かりな修正は不要です。
ステップ5 — Excelにエクスポート。完成したテーブルをXLSXファイルとしてダウンロードします。各行が1件の損失通知、各列が1つの抽出フィールドです。エクスポートされたファイルは単一のワークブックです — 1行に1件の損失通知、1列に1フィールド、結合セルなし、ピボットテーブルなし、下流での使用を妨げる書式なし。
このワークフローが保険金請求受付のボトルネックを変革します。災害後の最初の3日間を消費していた25時間のデータ入力が、5分の処理時間と30分の検証になります — 実際の保険金調査とアジャスター派遣に24時間を解放します。これを可能にするツールについては、OCRとAI抽出の違いに関するガイドで、従来のOCRがこのワークフローを実現できない理由と、ビジョン言語モデルで何が変わったかを説明しています。
構築するトリアージスプレッドシート:意思決定スピードのための並べ替え、フィルタリング、色分け
データが入った抽出スプレッドシートはトリアージシステムではありません — それは原材料です。スプレッドシートがトリアージツールになるのは、5秒以内に1つの質問に答えるときです:次にどの保険金請求に注意が必要か?
エクスポートしたXLSXを開き、すぐに3つの変換を適用します:
推定金額の降順で並べ替え。ドル金額列が主要な重大度軸になります。保険会社の内部重大度しきい値を超える請求は上部に並びます — これらはシニアアジャスターの割り当て、潜在的な準備金の増額、そして場合によっては独立アジャスターの派遣が必要です。数千ドル未満の請求は下部に並びます — 多くの保険会社はこれらをデスクレベルまたは自動決済ワークフローにルーティングします。1回の並べ替え操作で、各フォームを開き、損失見積もりフィールドを読み、請求を互いに精神的にランク付けする手動プロセスを置き換えます。
損失原因でフィルタリング。ハリケーン後、請求はおおよそ風害、洪水害、およびその両方に分かれます。山火事後は、火災損害と煙害に分かれます — これは異なる補償トリガーと異なるアジャスタースキル要件を持つ、根本的に異なる2つの請求プロセスです。損失原因列の単一フィルターで請求を危険タイプ別にグループ化し、チームリーダーが適切なアジャスターにバッチを割り当てられるようにします。風害のみの請求は不動産チームに送られます。洪水請求 — 別のNFIPまたは民間洪水保険でカバーされている場合 — は洪水ユニットにルーティングされます。両方の危険がある請求は、ルーティング前に補償判断が必要です。
条件付き書式を適用。推定金額列を色分け:$100,000超の請求は赤、$25,000〜$100,000はオレンジ、$25,000未満は黄色。損失日付列を色分け:14日以上前に損失が発生し、処分がない請求をハイライト — これによりNAIC Model 902の受領確認期限に近づいている請求がフラグされ、チームリーダーにコンプライアンスリスクの視覚的スキャンを提供します。
結果のスプレッドシートは、抽出されたフォームデータから構築されたリアルタイムのトリアージダッシュボードです。チームリーダーは朝にそれを開き、優先度で並べ替え、上位20行を利用可能なアジャスターに割り当てます。新しい損失通知が日中に到着したら、セカンダリバッチとして抽出し、行を追加し、再並べ替えすると、優先順位が自動的に更新されます。
抽出したデータをGuidewire、Duck Creek、またはクレーム管理プラットフォームに取り込む
トリアージスプレッドシートは「次に何をすべきか」に答えます。クレーム管理システムは「このクレームで何が起きたか」に答えます。この2つを橋渡しする——抽出したフォームデータをExcelから取り出し、アジャスターが実際に作業するプラットフォームに取り込む——ことが、トリアージツールをクレームワークフローの一部に変える最終ステップです。
統合方法はクレームプラットフォームによって異なります:
Guidewire ClaimCenter — Tier-1保険会社の間で最も広く導入されているP&Cクレームプラットフォーム — は、APIレイヤーとデータ取り込みモジュールのCSVインポートツールを通じて、一括FNOL取り込みをサポートしています。抽出からエクスポートされたスプレッドシートは、ClaimCenterのクレーム取り込みフィールドに直接マッピングされます:保険証券番号 → 保険証券検索、被保険者名 → 請求者検証、事故日 → 損失イベント日、事故原因 → クレーム種別分類。クレーム運用チームはフィールドマッピングを一度設定すれば、抽出したスプレッドシートをバッチとしてインポートできます。GuidewireのFNOL自動化ルールは、インポートされた行に含まれる重大度データに基づいて、アジャスターの割り当てと積立金の推奨をトリガーします。
Duck Creek Claims — Guidewireの主要なクラウドネイティブ競合 — は、設定可能な取り込みAPIを提供し、統合レイヤーを通じてフラットファイルインポートをサポートしています。フィールドマッピングは同じロジックに従います:抽出された列はDuck Creekのクレームデータモデルにマッピングされ、Duck Creekの組み込みトリアージルールは事故原因と推定金額を使用して、クレームを適切なアジャスターキューに自動ルーティングします。
Snapsheet、BriteCore、その他のミッドマーケットプラットフォームは通常、標準的な取り込み方法としてCSVインポートをサポートしています。抽出スプレッドシートはこれらのプラットフォーム向けに直接CSVにエクスポートされます。インポート機能が限られたレガシークレームシステムを使用している保険会社にとって、抽出されたExcelファイルは依然としてワークフローを加速します——アジャスターはトリアージスプレッドシートからクレームシステムに1行ずつコピー&ペーストします。これは元のフォームを読むよりも速いです。なぜなら、すべてのフィールドが一貫した順序で1行にまとめられているからです。
主要な設計原則:抽出ステップは、宛先システムに関係なく、クリーンな列形式のデータを生成します。データがAPIを通じてGuidewireに流れる場合でも、フラットファイルインポートを通じてDuck Creekに流れる場合でも、コピー&ペーストを通じてレガシーシステムに流れる場合でも、抽出出力は同じ構造化形式です。統合方法は変わりますが、事前のデータキャプチャは変わりません。
FAQ
ACORD 140は不動産損失通知と同じものですか?
厳密には異なります。その違いは、どのフィールドを抽出するかに影響します。ACORD 140は正式名称を「Property Section」といい、ACORD 125商業保険申込書の添付書類として設計されています。建物構造タイプ、防火クラス、補償限度額、共同保険率などの引受データを取得します。全3ページ、355の入力可能フィールドで構成されています。不動産損失通知(フォームライブラリではACORD 130と番号付けされることもあります)は、保険金請求報告専用に設計された別の文書で、損失日、損失原因、損害内容、見積額などのフィールドがあります。実際には、ACORD 140フォームは補償内容と不動産データが含まれているため、請求ファイル内で損失通知に添付されることがよくあります。この記事の抽出ワークフローは両方を対象としています。トリアージ用の損失通知固有フィールド(損失日、原因、内容、見積額)と、補償確認用の140固有フィールド(保険証券番号、NAICコード、補償限度額)です。
手書きの損失内容に対するAI抽出の精度はどの程度ですか?
ACORD 140の損失内容フィールドは通常手書きです。調整担当者や代理店が損害を説明する自由形式の記述を書きます。手書きに対するAI抽出の精度は読みやすさに依存します。明確なブロック体は印刷テキストに匹敵する高い精度を達成しますが、筆記体や急いで書かれた文字、取り消し線や欄外メモがある場合は精度が低下し、人間による検証が必要になります。バッチワークフローのプレビュー手順では、バッチ全体を確定する前に手書き品質をスポットチェックできます。特定の調整担当者の手書きが一貫して誤読される場合、その担当者のフォームを手動レビュー用にフラグ付けし、残りのバッチは自動処理を続行できます。
同じ列セットを異なる災害イベントで再利用できますか?
はい。上記の11列のトリアージセット(保険証券番号からトリアージ優先度まで)は、災害の種類に関係なく、不動産損失通知とACORD 140フォームのどのバッチでも機能します。ハリケーンの損失通知には、山火事の損失通知と同じフィールドタイプ(保険証券番号、住所、日付、原因、内容、金額)が含まれています。列名は変わりません。AIが各フォームの内容に適応します。初回使用後に列セットをテンプレートとして保存し、その後のすべてのイベントで即座に読み込めます。
フォームに必須項目がない場合(見積金額や損害原因が記載されていない)はどうなりますか?
AI抽出では、フォームに要求された項目が存在しない場合、セルは空白のままになります。データを捏造することはありません。見積金額のセルが空白の場合は、その請求を直ちにフォローアップ対象としてフラグを立てる合図です。金額なしでは重大度を評価できないためです。損害原因のセルが空白の場合は、原因が判明する前にフォームが提出された可能性があります。これは、損害が発生したことを保険会社に通知することが最優先となる大災害発生後24時間以内によく見られます。空白のセルをトリアージスプレッドシートの先頭に並べ替えて、最初に注意を向けられるようにしてください。
エンタープライズ請求受付プラットフォームとの比較はどうですか?
Guidewire ClaimCenterやDuck Creek Claimsなどのエンタープライズプラットフォームは、FNOL受付、アジャスター割り当て、支払い保留額の追跡、支払い処理、レポート作成など、エンドツーエンドの請求管理を提供します。これらの受付モジュールは構造化データを受け取ることはできますが、非構造化PDFからデータを抽出することはできません。この記事で説明する抽出ステップは、請求システムの前に位置するレイヤーです。PDFを構造化された行に変換し、請求システムが取り込めるようにします。エンタープライズプラットフォームを利用している保険会社の場合、抽出はプラットフォームにデータを供給します。エンタープライズシステムを持たない中小規模の保険会社や独立系調整会社の場合、トリアージスプレッドシート自体が軽量な請求受付トラッカーとして機能します。