So extrahieren Sie ACORD-140-Schadenmeldungen
für die Schadenbearbeitung nach Excel
Die ersten 72 Stunden nach einem Hurrikan, Waldbrand oder Hochwasser sind die Zeit, in der Entscheidungen bei Sachschadenansprüchen am meisten Gewicht haben – und in der der Schadenprozess am langsamsten läuft. Der Grund ist struktureller, nicht verfahrenstechnischer Natur: Sachschadenmeldungen treffen als PDFs von Agenten, Maklern und Versicherungsnehmern ein. Jede muss gelesen, in eine Tabellenkalkulation oder ein Schadenmanagementsystem eingegeben und priorisiert werden, bevor jemand eine Immobilie besichtigen kann. Daten von Insurance Services Office (ISO) Property Claim Services zeigen, dass die Branche allein in den ersten drei Quartalen 2025 rund 3,5 Millionen Ansprüche bearbeitet hat (Verisk, 2026). Nach einer Katastrophe mit Zehntausenden betroffenen Immobilien ist der Stapel wartender Schadenmeldungen der eigentliche Engpass – nicht die Besichtigungskapazität, nicht die Verfügbarkeit von Sachverständigen, sondern die Stunden, die mit dem Abtippen von Formularfeldern in einen Bildschirm verbracht werden.
Wichtigste Erkenntnisse
- Nach einem Hurrikan treffen 200.000 Sachschadenansprüche in einer einzigen Woche ein – und keiner kann untersucht werden, bevor jemand die Policennummer, die Schadensschätzung und die Ursachenbeschreibung aus einer PDF in eine Tabellenkalkulation eintippt.
- Bei 15 Minuten pro Formular verbrauchen 5.000 Schadenmeldungen 1.250 Stunden Dateneingabe – und die regulatorische Uhr der National Association of Insurance Commissioners (NAIC), die die Compliance des Versicherers bestimmt, tickt ab dem Schadensdatum, nicht ab dem Datum der Dateneingabe.
- KI-basierte semantische Extraktion liest ACORD-140-Felder danach, was sie bedeuten, statt wo sie auf der Seite stehen – und verwandelt 100 Schadenmeldungen in unter fünf Minuten in eine sortierbare Triage-Tabelle mit Schweregrad-Kennzeichnungen und Fristwarnungen.
ACORD-Formulare sind das Rückgrat des nordamerikanischen Versicherungsdatenaustauschs – mehr als 170 standardisierte Formulare, gepflegt von der Association for Cooperative Operations Research and Development, die alles abdecken, von gewerblichen Anträgen über Versicherungszertifikate bis hin zu Schadenmeldungen. Für Sachschäden ist die ACORD-Schadenmeldung das Dokument, das Versicherungsnehmerinformationen, Schadendetails, Schadenursache, Schadenbeschreibung und erste Schätzung erfasst – die Daten, die bestimmen, wie ein Schaden priorisiert und weitergeleitet wird. In der Gewerbeversicherung enthält das zugehörige ACORD-140-Formular für Sachwerte detaillierte Gebäude- und Deckungsdaten über drei Seiten mit 355 ausfüllbaren Feldern.
Dieser Artikel beschreibt, wie Sie Daten aus Schadenmeldungen und ACORD-140-Formularen in eine strukturierte Excel-Triage-Tabelle extrahieren – ein Workflow, der den Formularstapel nach einer Katastrophe von einer Dateneingabe-Warteschlange in eine nach Prioritäten sortierte Aktionsliste verwandelt. Derselbe Ansatz gilt für andere ACORD-Formulartypen: Unsere Anleitungen zum Extrahieren von ACORD-25-COI-Daten in Excel und zum Extrahieren von ACORD-27-Sachversicherungsnachweisen decken denselben spaltenbasierten Extraktionsworkflow für verschiedene Versicherungsdokumente ab.
Manuelle Dateneingabe scheitert im Katastrophenmaßstab – nicht aus Mangel an Geduld, sondern aus physikalischen Gründen
Versicherungs-Schadenteams wissen seit Jahren, dass manuelle Dateneingabe ihre größte operative Belastung ist. Weniger diskutiert wird, warum sie genau in dem Moment katastrophal versagt, in dem es am wichtigsten ist – nach einer Katastrophe – und was die regulatorische Uhr für jede verlorene Stunde beim Formularlesen bedeutet.
Schadensachbearbeiter verbringen laut Workflow-Studien von Anbietern für Versicherungsautomatisierung 35–45 % ihres Arbeitstages mit Datenverarbeitung statt mit tatsächlichen Schadenentscheidungen. Für einen Sachbearbeiter mit einer Standardfallbelastung bedeutet das etwa 3–4 Stunden pro Tag, die mit Lesen, Tippen und Überprüfen von Formulardaten verbracht werden. Die Rechnung für eine einzelne Schadenmeldung: 12–18 Minuten, um Policennummer, Versicherungsnehmername, Schadenort, Schadendatum, Ursache, Schadenbeschreibung und geschätzten Betrag aus einem mehrseitigen ACORD-Formular zu finden und zu übertragen – multipliziert mit der Anzahl der Schäden in der Warteschlange.
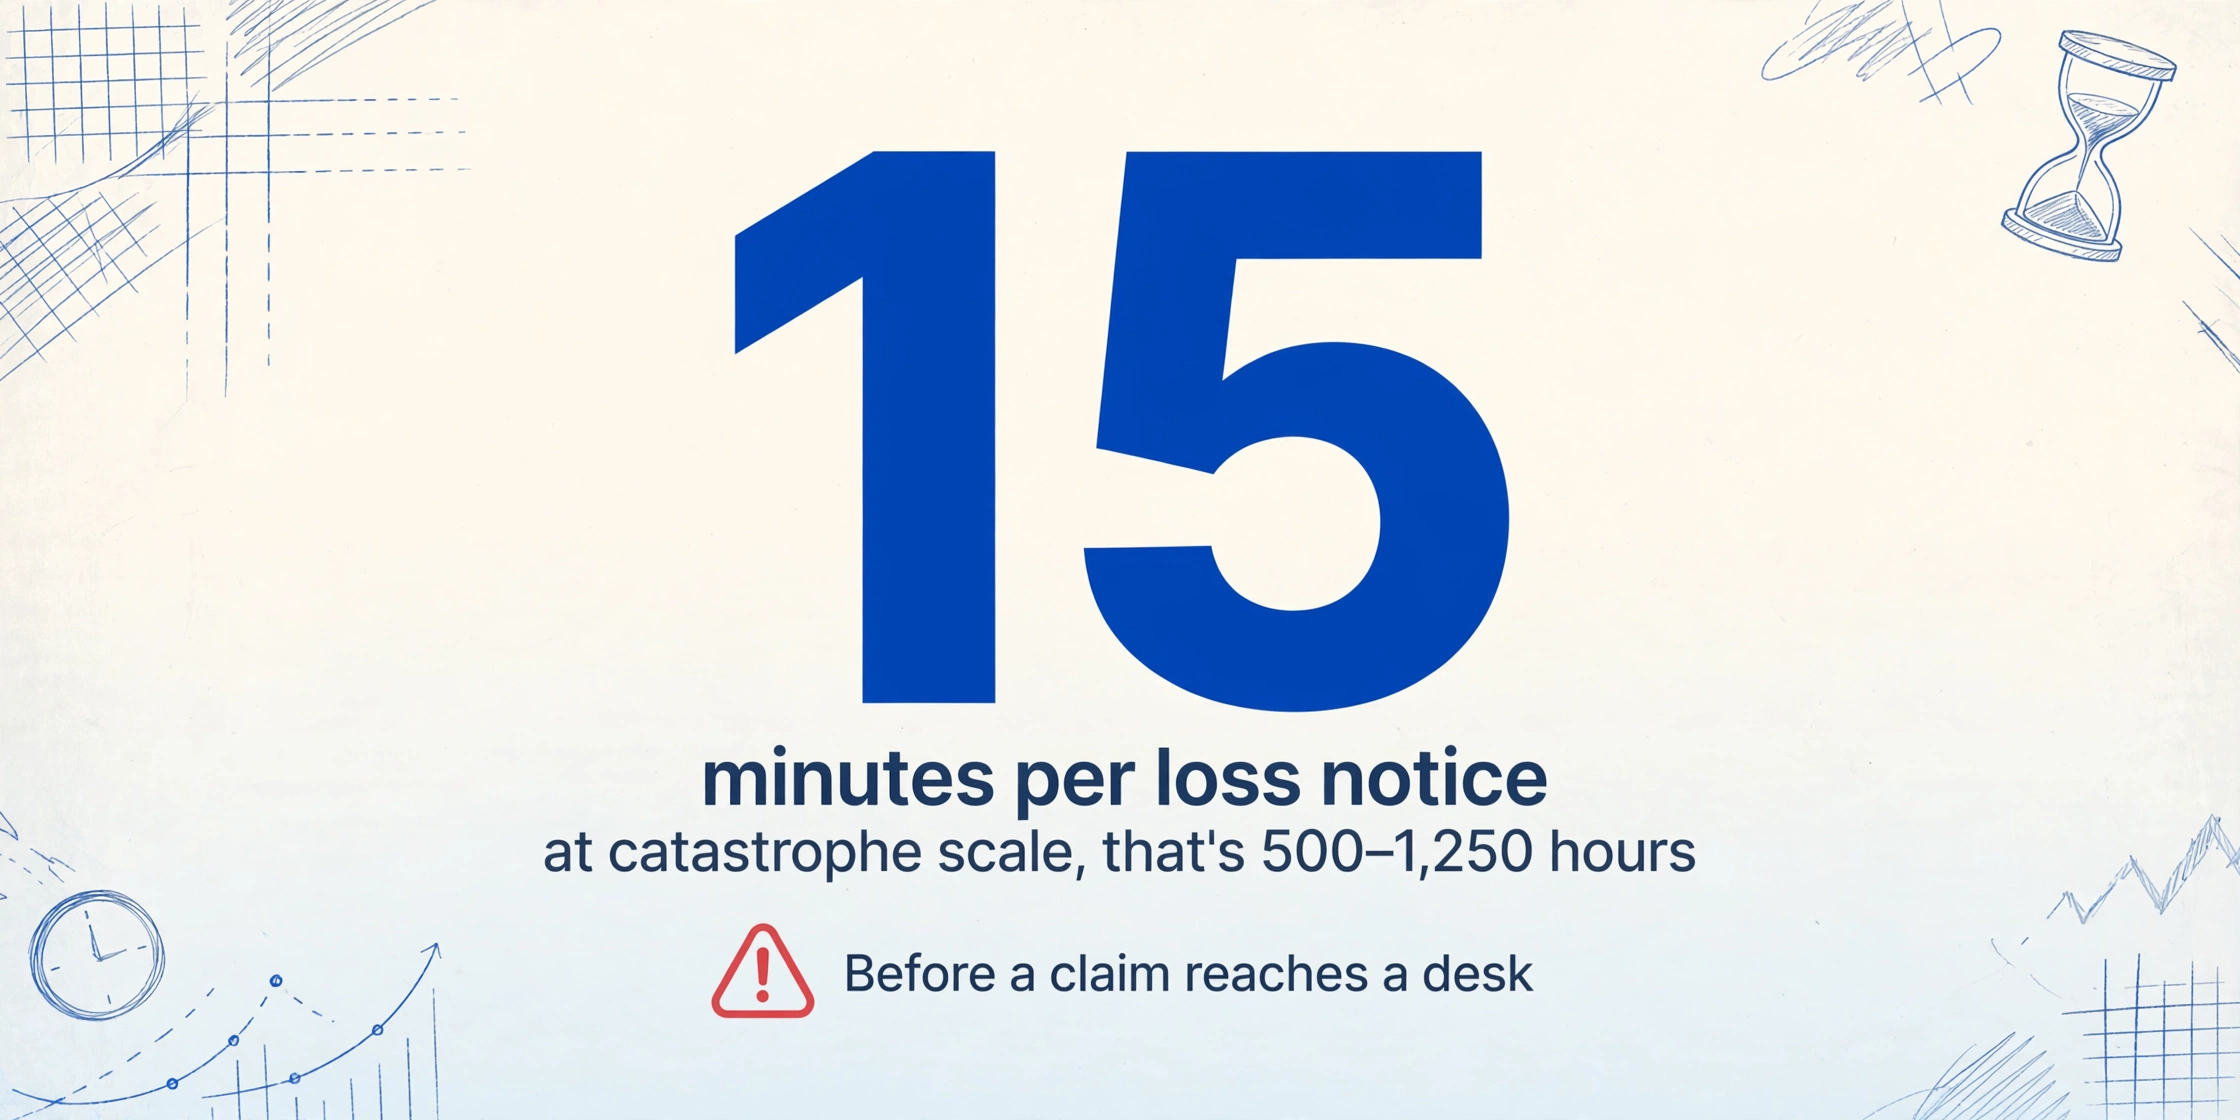
Nach einer Katastrophe bricht die Rechnung zusammen. Ein einziger Hurrikan-Landfall kann 200.000–400.000 Sachschäden in den betroffenen Bundesstaaten auslösen. Ein regionaler Versicherer könnte in der ersten Woche 2.000–5.000 Schadenmeldungen erhalten. Bei 15 Minuten pro Formular sind das 500–1.250 Stunden reine Dateneingabe, bevor ein einziger Schaden den Schreibtisch eines Sachbearbeiters zur tatsächlichen Bewertung erreicht. Der Schadenprozess beginnt nicht, wenn die Schadenmeldung eingereicht wird – er beginnt, wenn die Daten im System sind.
Die regulatorische Dimension erhöht den Druck, den die meisten Diskussionen über Arbeitsabläufe auslassen. Die NAIC Unfair Property/Casualty Claims Settlement Practices Model Regulation (Model 902) legt fest, dass Versicherer Ansprüche innerhalb von 15 Tagen nach Benachrichtigung bestätigen und die Haftung innerhalb einer angemessenen Frist anerkennen oder ablehnen müssen – mit einer Zahlungsfrist von 30 Tagen nach Anerkennung der Haftung. Viele Bundesstaaten legen strengere Standards fest: Das Florida-Statut §626.9541 verlangt die Zahlung unbestrittener Erstparteien-Sachschadenansprüche innerhalb von 60 Tagen, und ähnliche Fristen gelten in den meisten Rechtsgebieten. Jeder Tag, der mit der Eingabe von Daten in ein System verbracht wird, ist ein Tag, der vom Untersuchungszeitraum abgezogen wird. Das Compliance-Risiko entsteht nicht durch bösen Willen – es entsteht durch einen Stapel ungelesener Formulare.
Das Problem ist nicht, dass Schadensteams langsam sind. Es ist, dass der Dateneingabeschritt linear mit dem Schadensvolumen skaliert, genau in dem Moment, in dem das Volumen um das 10–50-fache über dem Ausgangswert ansteigt – und die regulatorische Uhr läuft ab dem Schadensdatum, nicht ab dem Datum der Dateneingabe.
Die ACORD-140-Felder, die für die Triage wichtig sind, sind nicht dieselben wie die Felder, die für die Underwriting-Entscheidung wichtig sind
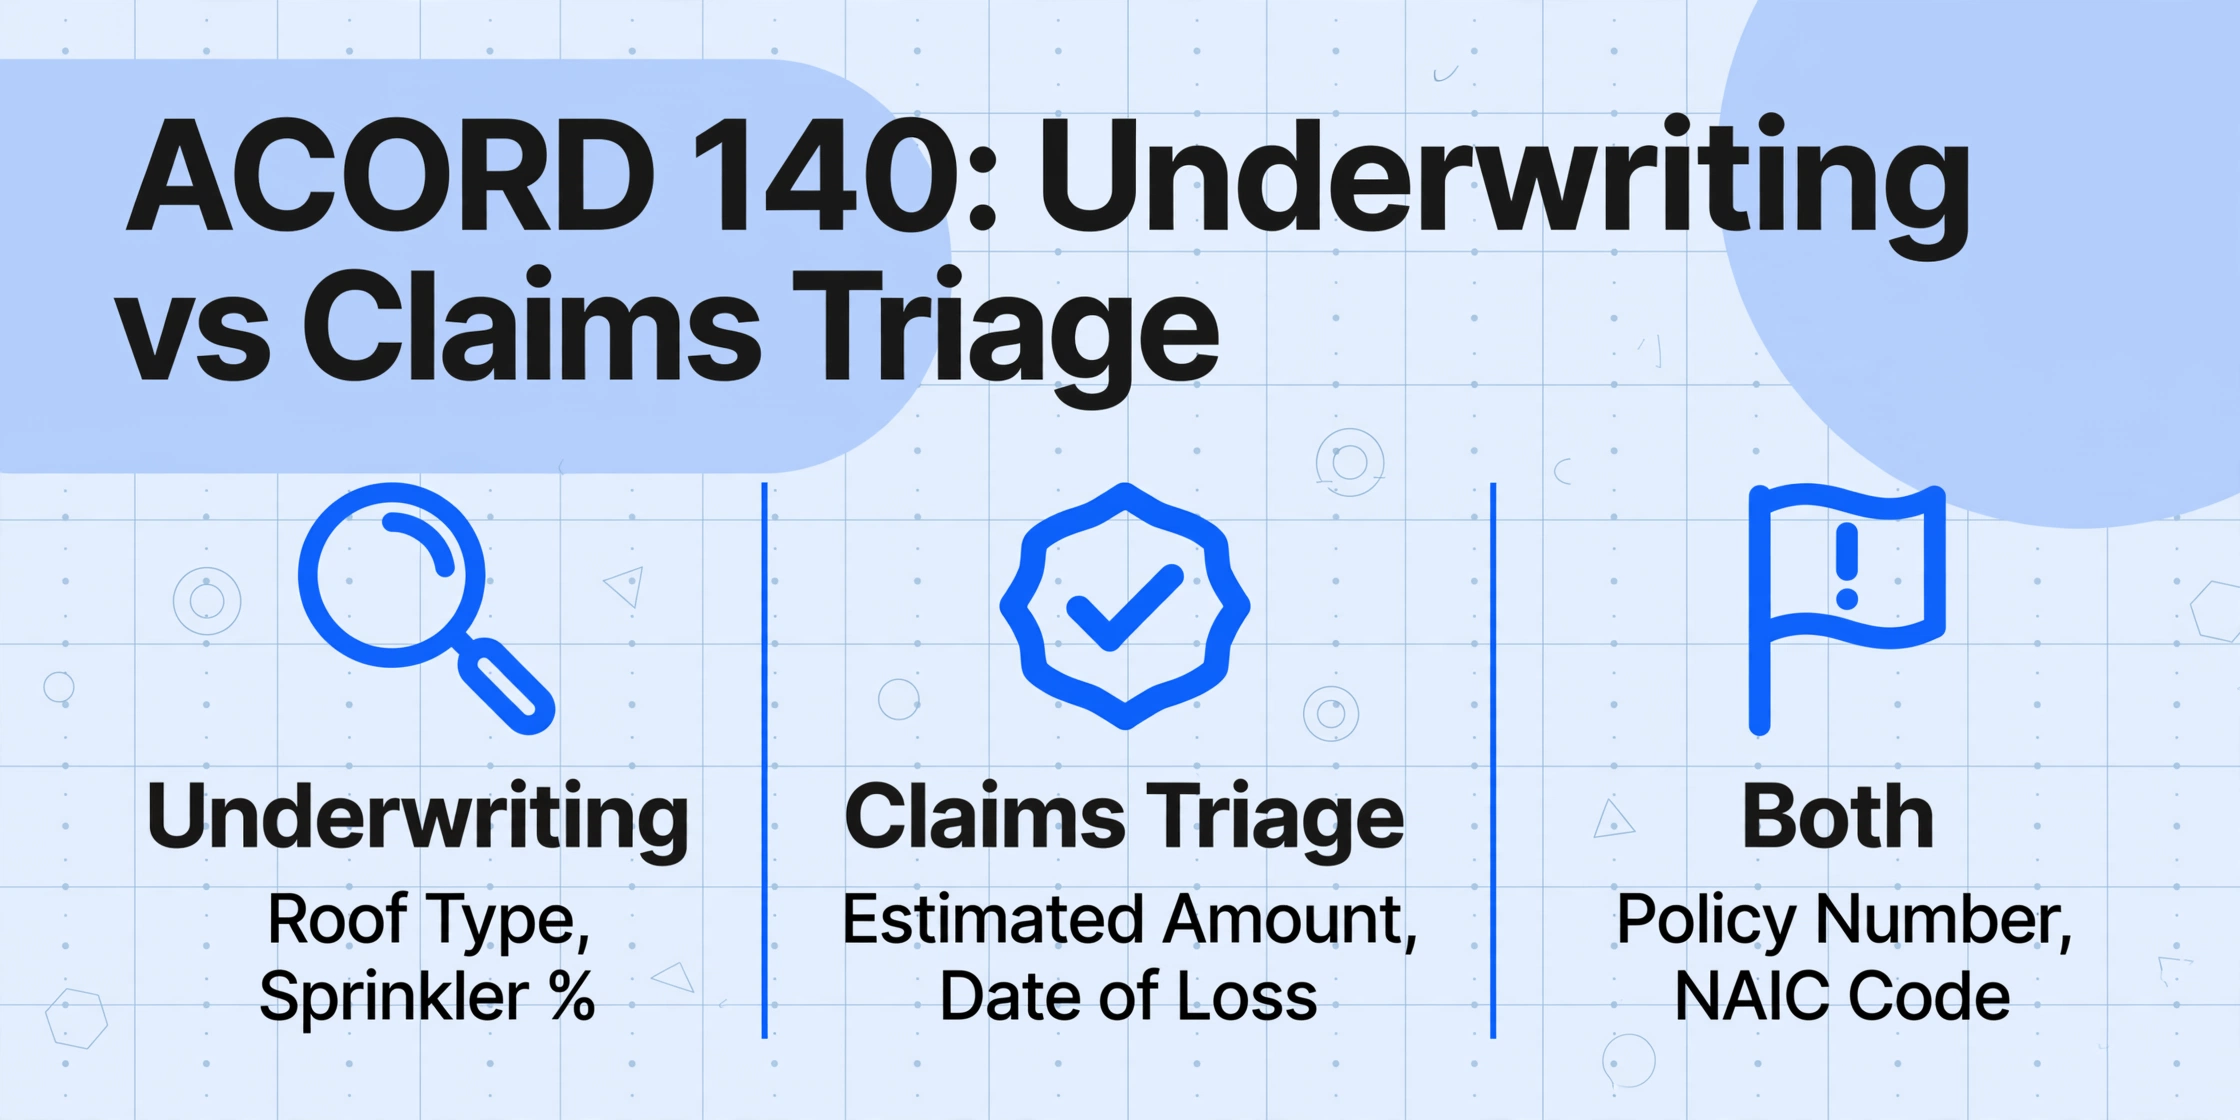
Der ACORD-140-Sachversicherungsabschnitt ist ein dichtes, mehrseitiges Formular, das ursprünglich für gewerbliche Versicherungsanträge entwickelt wurde – es erfasst Bauart, Nutzung, Feuerschutzklasse und Deckungsoptionen. Wenn dieses Formular jedoch im Schadenskontext eintrifft – als unterstützende Dokumentation zu einer Sachschadenmeldung – verschieben sich die für die Triage relevanten Felder vollständig. Ein Underwriter muss die Dachart und den Sprinkleranteil kennen. Ein Schadensregulierer muss wissen, wie hoch der geschätzte Schaden ist und ob jemand verletzt wurde.
Die Formularfelder, die Schadenstriage-Entscheidungen steuern, lassen sich in vier Ebenen unterteilen:
| Triage-Stufe | Feld | Warum es für die Triage wichtig ist |
|---|---|---|
| 1 — Identifikation | Polizennummer, versicherte Person, Agenturname, NAIC-Code | Ohne diese Angaben kann der Schaden keiner Police zugeordnet oder dem richtigen Sachbearbeiter zugewiesen werden. Der NAIC-Code identifiziert den Versicherer eindeutig — entscheidend, wenn mehrere Versicherer an einem gestuften Programm beteiligt sind. |
| 1 — Identifikation | Objektadresse / Ort des Schadens, Grundstücksnummer, Gebäudenummer | Bestimmt, zu welchem Sachbearbeitergebiet der Schaden gehört und ob sich das Objekt in einer ausgewiesenen Katastrophenzone befindet. Eine falsche Adresse leitet den Schaden in die falsche Warteschlange. |
| 2 — Schweregrad | Geschätzter Schadenbetrag, Versicherungsgegenstand, Deckungsgrenzen | Die wichtigste Sortierdimension. Schäden über der Schweregradschwelle des Versicherers (typischerweise $50.000–$100.000 für Gewerbeimmobilien) erfordern die Zuweisung eines leitenden Sachbearbeiters. Schäden darunter können für die Bearbeitung am Schreibtisch oder die direkte Durchlaufverarbeitung in Frage kommen. |
| 2 — Schweregrad | Schadenursache, Schadensdatum, Beschreibung des Schadens & der Beschädigung | Bestimmt die Deckungsberechtigung (ist diese Gefahr abgedeckt?), kennzeichnet mögliche Regressansprüche (Haftung Dritter?) und identifiziert Betrugsindikatoren. Ein Feuerschaden mit beigefügtem Polizeibericht wird anders weitergeleitet als ein Sturmschaden. |
| 3 — Kontakt | Name des Versicherten, Festnetznummer, Geschäftstelefon, Zeitpunkt der Kontaktaufnahme | Planung des ersten Sachbearbeiterkontakts. Eine falsche Telefonnummer in dieser Phase verursacht eine Verzögerung von 2–3 Tagen, während das Schadenteam Telefonstau spielt. |
| 4 — Referenz | Hypothekengläubiger / Zahlungsempfängername und -adresse, Darlehensnummer | Erforderlich für die Regulierung — eine Zahlung kann nicht ohne Bestätigung des Zahlungsempfängers ausgestellt werden. Fehlt dies bei der Erfassung, bedeutet das eine Zahlungsverzögerung am Ende des Prozesses. Die Erfassung jetzt verhindert diese Verzögerung. |
Der entscheidende Unterschied: Felder der Stufe 1 müssen zu 100 % korrekt sein, bevor jeder andere Schritt fortgesetzt werden kann. Eine falsche Polizennummer leitet den gesamten Schaden an den falschen Versicherer weiter. Felder der Stufe 2 bestimmen die Weiterleitungspriorität und die Sachbearbeiterzuweisung — ein Wasserschaden von $5.000 sollte in der Warteschlange niemals vor einem strukturellen Feuerschaden von $500.000 stehen. Felder der Stufe 3 und 4 sind später relevant, können aber jetzt problemlos extrahiert werden — ihre Erfassung bei der Aufnahme erspart Tage später einen zweiten Blick auf dasselbe Formular.
Für einen breiteren Vergleich, wie sich Extraktionsfelder zwischen Versicherungsformulartypen unterscheiden, führt unser vollständiger ACORD-25-COI-Extraktionsleitfaden durch dieselbe stufenbasierte Feldpriorisierung für Haftpflichtzertifikate.
Richten Sie Extraktionsspalten ein, die zu Ihrem Triage-Workflow passen – nicht zum Formularlayout
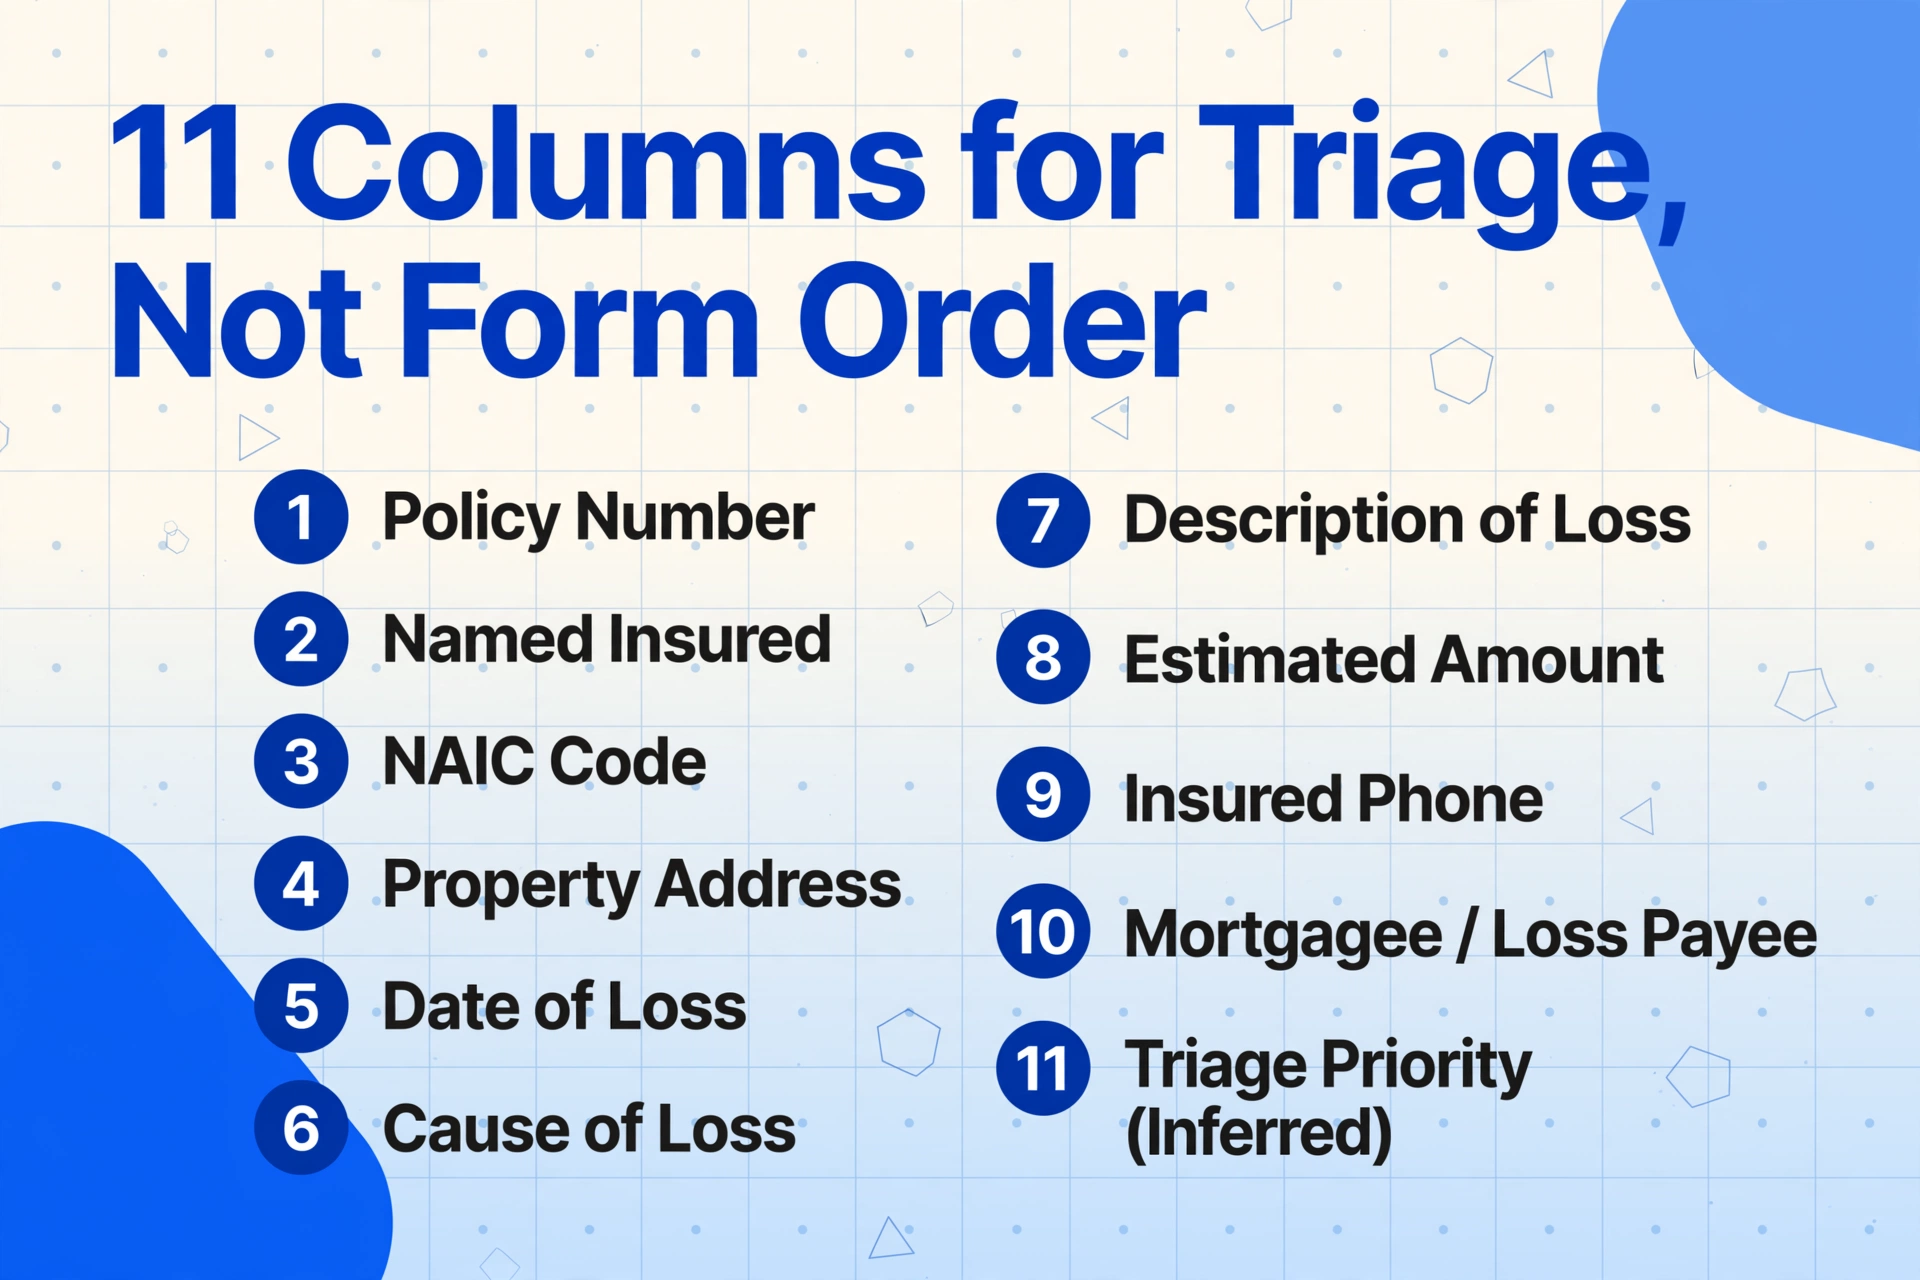
Der häufigste Fehler bei der Extraktion strukturierter Daten aus ACORD-Formularen ist die Übernahme der Feldreihenfolge des Formulars als Spaltenüberschriften. Das Formular gruppiert Daten nach administrativer Logik (zuerst Agenturinformationen, dann Räumlichkeiten, dann Deckungen). Die Triage-Tabelle muss Daten nach Entscheidungslogik gruppieren – zuerst Identifikation, dann Schweregrad, zuletzt Kontakt.
Hier ist der Spaltensatz für eine triageoptimierte ACORD-140-Extraktion:
| Spaltenname | Extraktionsmodus | Triage-Funktion |
|---|---|---|
Policy Number | Direkte Extraktion | Schaden im Verwaltungssystem der Police zuordnen |
Named Insured | Direkte Extraktion | Identität des Anspruchstellers prüfen |
NAIC Code | Direkte Extraktion | Versicherer validieren; an das richtige Schadenteam weiterleiten |
Property Address | Direkte Extraktion | Regulierer nach Gebiet zuweisen; Katastrophenzone prüfen |
Date of Loss | Direkte Extraktion | Tage seit dem Schaden berechnen; Versicherungszeitraum prüfen |
Cause of Loss | Direkte Extraktion | Deckungsprüfung; Regresskennzeichen; CAT-Code-Zuweisung |
Description of Loss | Direkte Extraktion | Umfangbewertung; Schweregradklassifizierung; Betrugsprüfung |
Estimated Amount | Direkte Extraktion | Routing nach Schweregrad; Rückstellungen bilden |
Insured Phone | Direkte Extraktion | Planung des Erstkontakts |
Mortgagee / Loss Payee | Direkte Extraktion | Prüfung der Schadenzahlung |
Triage Priority | abgeleitete Spalte | KI weist Dringend / Hoch / Standard / Überwachen basierend auf geschätztem Betrag und Schadensursache zu |
Dieser Spaltensatz verwendet zwei Extraktionsmodi. Die direkte Extraktion zieht Werte, die explizit auf dem Formular gedruckt sind – Policennummern, Daten, Geldbeträge. Die KI lokalisiert diese, indem sie versteht, was jede Feldbezeichnung bedeutet. So werden eine Policennummer, die auf einem Versichererformular als „Policy #" und auf einem anderen als „Policy Number" bezeichnet ist, derselben Spalte zugeordnet. Das unterscheidet die semantische Extraktion von positionellem OCR: Herkömmliche Tools scheitern, wenn ein Feld in einer anderen Formularversion an eine andere Position wandert; die semantische Extraktion gelingt, weil sie nach Bedeutung liest, nicht nach Koordinaten.
Die abgeleitete Spalte – Triage-Priorität – funktioniert anders. Die KI liest den geschätzten Betrag und die Schadensursache und wendet dann Geschäftslogik an, um eine Prioritätsstufe zuzuweisen. Beispiel: Ein Feuerschaden über $100.000 wird als dringend eingestuft; ein Wasserschaden unter $10.000 als Standard. Die Klassifizierungsregeln sind in der Spaltendefinition hinterlegt, und die KI wendet sie auf jede Zeile im Batch an – Extraktion und Triage in einem Durchgang.
Ein operativer Hinweis: Das handschriftliche Feld für die Schadensbeschreibung im ACORD 140 ist die Stelle, an der das Formular anspruchsvoll wird. Sachbearbeiter und Agenten beschreiben Schäden in ihren eigenen Worten, in ihrer eigenen Handschrift — „Wasser drang durch das Dach ein und verursachte den Einsturz der Decke im Hauptbürobereich, Inhalt beschädigt, Elektrik möglicherweise beeinträchtigt." Die Handschrifterkennung der KI verarbeitet diese Variabilität, aber die Spaltennamen sollten spezifisch genug sein, um die Extraktion zum richtigen Inhalt zu führen. Eine Spalte, die einfach „Beschreibung" heißt, könnte beliebigen beschreibenden Text auf der Seite erfassen — einschließlich Gebäudebeschreibungen, die für die Risikoprüfung bestimmt sind. Die Benennung als „Schadensbeschreibung" oder „Beschreibung des Schadens" grenzt die Suche der KI auf schadensbezogene Textblöcke ein.
Verarbeitung eines Batches: von 100 PDFs zu einer Tabelle in unter fünf Minuten
Der Extraktionsworkflow, der eine Katastrophen-Warteschlange in eine Triage-Tabelle verwandelt, umfasst fünf Schritte. Der zeitliche Engpass liegt bei Schritt eins — dem Hochladen —, da die Dateien physisch übertragen werden müssen. Alles danach läuft auf KI-Verarbeitungszeit, die in Sekunden pro Formular gemessen wird, nicht in Minuten.
Dateien werden sicher verarbeitet und nicht gespeichert.
Schritt 1 — Alle Schadensmeldungen auf einmal hochladen. Ziehen Sie den gesamten Ordner mit ACORD-Formularen — PDFs von Agenten, gescannte Kopien von Außensachbearbeitern, Fotos handschriftlicher Schadensberichte — in den Upload-Bereich. Das Tool akzeptiert PDF-, JPG-, PNG- und WebP-Formate und komprimiert große Dateien automatisch für eine schnellere Übertragung. Batch-Upload bedeutet, dass Sie den gesamten Satz auf einmal auswählen, nicht Datei für Datei.
Schritt 2 — Spaltennamen eingeben. Geben Sie die Spaltenliste aus der obigen Tabelle ein oder fügen Sie sie in das Spaltendefinitionsfeld ein. Jeder Spaltenname wird zu einer Kopfzeile in der Ausgabetabelle und zu einer Suchanweisung für die KI. Sie können diesen Spaltensatz einmal als Vorlage speichern und für jedes zukünftige Katastrophenereignis wiederverwenden — dieselben 11 Spalten funktionieren für jeden Batch von ACORD-Schadensmeldungen.
Schritt 3 — Eine Vorschauzeile prüfen, bevor der gesamte Batch verarbeitet wird. Die KI verarbeitet zuerst ein Formular und zeigt die extrahierten Werte, die jeder Spalte zugeordnet sind. Diese Vorschau ermöglicht es Ihnen, zu bestätigen, dass „Police-Nummer" das richtige Feld erfasst hat, bevor alle 100 Formulare verarbeitet werden. Wenn die Police-Nummer in der falschen Spalte gelandet ist, passen Sie den Spaltennamen an und prüfen Sie erneut — der Batch hat noch nicht begonnen.
Schritt 4 — Den vollständigen Batch ausführen. Klicken Sie auf „Verarbeiten“. Die KI liest jedes Formular, lokalisiert jedes angeforderte Feld durch semantisches Verständnis und füllt die Ausgabetabelle aus. Ein Batch von 100 Schadenmeldungen wird in etwa 2–5 Minuten Verarbeitungszeit abgeschlossen — im Vergleich zu den 25–30 Stunden, die dieselbe Aufgabe als manuelle Dateneingabe dauern würde. Die 99%-Genauigkeitsrate für gedruckten Text (laut den veröffentlichten Benchmarks des Tools) und die starke Handschrifterkennung für Schreibschrift und gemischte Groß-/Kleinschreibung bedeuten, dass die Ausgabetabelle mit leichter Validierung nutzbar ist, nicht mit umfangreicher Korrektur.
Schritt 5 — Nach Excel exportieren. Laden Sie die fertige Tabelle als XLSX-Datei herunter. Jede Zeile ist eine Schadenmeldung; jede Spalte ist ein extrahiertes Feld. Die exportierte Datei ist eine einzelne Arbeitsmappe — eine Schadenmeldung pro Zeile, ein Feld pro Spalte, keine verbundenen Zellen, keine Pivot-Tabellen, keine Formatierung, die die Weiterverwendung beeinträchtigt.
Dieser Workflow ist es, der den Engpass bei der Schadensaufnahme beseitigt. Die 25 Stunden Dateneingabe, die früher die ersten drei Tage nach einer Katastrophe beanspruchten, werden zu 5 Minuten Verarbeitungszeit und 30 Minuten Validierung — das schafft 24 Stunden für die eigentliche Schadensuntersuchung und die Disposition von Sachverständigen. Für die Tools, die dies ermöglichen, erklärt unser Leitfaden zu den Unterschieden zwischen OCR und KI-Extraktion, warum herkömmliche OCR diesen Workflow nicht leisten kann und was sich mit Vision-Language-Modellen geändert hat.
Die Triage-Tabelle, die Sie erstellen: Sortieren, Filtern und Farbcodierung für Entscheidungsgeschwindigkeit
Eine extrahierte Tabelle mit Daten ist kein Triage-System — sie ist Rohmaterial. Die Tabelle wird zu einem Triage-Tool, wenn sie eine Frage in unter fünf Sekunden beantwortet: Welcher Anspruch braucht als Nächstes Aufmerksamkeit?
Öffnen Sie die exportierte XLSX-Datei und wenden Sie sofort drei Transformationen an:
Nach geschätztem Betrag absteigend sortieren. Die Dollar-Betragsspalte wird zur primären Schweregradachse. Ansprüche über der internen Schweregradschwelle des Versicherers werden nach oben sortiert — diese benötigen die Zuweisung eines leitenden Sachverständigen, mögliche Reservenerhöhungen und gegebenenfalls die Beauftragung eines unabhängigen Sachverständigen. Ansprüche unter einigen tausend Dollar werden nach unten sortiert — viele Versicherer leiten diese an Desk-Level- oder automatisierte Abwicklungsworkflows weiter. Ein einziger Sortiervorgang ersetzt den manuellen Prozess des Öffnens jedes Formulars, des Lesens des Schadensschätzungsfelds und des mentalen Rankings der Ansprüche gegeneinander.
Nach Schadensursache filtern. Nach einem Hurrikan teilen sich Ansprüche grob in Windschäden, Überschwemmungsschäden und beides auf. Nach einem Waldbrand ist die Aufteilung Brandschaden versus Rauchschaden — zwei grundlegend verschiedene Schadensprozesse mit unterschiedlichen Deckungsauslösern und unterschiedlichen Anforderungen an die Sachverständigen. Ein einziger Filter auf der Spalte „Schadensursache“ gruppiert Ansprüche nach Gefahrenart, sodass der Teamleiter Batches den richtigen Sachverständigen zuweisen kann. Nur-Wind-Ansprüche gehen an das Immobilienteam. Überschwemmungsansprüche — falls durch eine separate NFIP- oder private Hochwasserpolice abgedeckt — werden an die Hochwasserabteilung geleitet. Ansprüche mit beiden Gefahren benötigen vor der Weiterleitung eine Deckungsprüfung.
Bedingte Formatierung anwenden. Färben Sie die Spalte „Geschätzter Betrag“: rot für Ansprüche über 100.000 $, orange für 25.000–100.000 $, gelb für unter 25.000 $. Färben Sie die Spalte „Schadensdatum“: Markieren Sie jeden Anspruch, bei dem der Schaden vor mehr als 14 Tagen ohne Bearbeitungsstatus eingetreten ist — dies kennzeichnet Ansprüche, die sich der NAIC-Model-902-Anerkennungsfrist nähern, und gibt dem Teamleiter eine visuelle Übersicht über Compliance-Risiken.
Die resultierende Tabelle ist ein Echtzeit-Triage-Dashboard, das aus extrahierten Formulardaten erstellt wurde. Der Teamleiter öffnet sie morgens, sortiert nach Priorität und weist die obersten 20 Zeilen den verfügbaren Sachverständigen zu. Wenn mittags neue Schadenmeldungen eintreffen, extrahieren Sie sie als sekundären Batch, fügen die Zeilen hinzu, sortieren neu, und die Prioritätsreihenfolge aktualisiert sich automatisch.
Extraktionsdaten in Guidewire, Duck Creek oder Ihre Schadenmanagement-Plattform übertragen
Die Triage-Tabelle beantwortet die Frage „Was ist als Nächstes zu tun?“. Das Schadenmanagementsystem beantwortet die Frage „Was ist bei diesem Schaden passiert?“. Die Verbindung der beiden — das Übertragen der extrahierten Formulardaten aus Excel in die Plattform, auf der die Sachbearbeiter tatsächlich arbeiten — ist der letzte Schritt, der aus einem Triage-Tool einen Teil des Schadenbearbeitungs-Workflows macht.
Der Integrationsweg hängt von Ihrer Schadenplattform ab:
Guidewire ClaimCenter — die am weitesten verbreitete P&C-Schadenplattform unter Tier-1-Versicherern — unterstützt die Massenerfassung von FNOL über seine API-Schnittstelle sowie über CSV-Importtools in seinem Datenerfassungsmodul. Die aus der Extraktion exportierte Tabelle lässt sich direkt auf die Schadenerfassungsfelder von ClaimCenter abbilden: Policennummer → Policy-Lookup, Versichertenname → Anspruchsprüfung, Schadensdatum → Schadensereignisdatum, Schadensursache → Schadensklassifizierung. Die Schadensbearbeitungsteams können die Feldzuordnung einmal konfigurieren und dann die extrahierten Tabellen als Stapel importieren. Die FNOL-Automatisierungsregeln von Guidewire lösen die Sachbearbeiterzuweisung und Reservierungsempfehlungen basierend auf den bereits in den importierten Zeilen enthaltenen Schweregraddaten aus.
Duck Creek Claims — Guidewires wichtigster Cloud-nativer Wettbewerber — bietet konfigurierbare Aufnahme-APIs und unterstützt Flat-File-Importe über seine Integrationsschicht. Die Feldzuordnung folgt derselben Logik: Die extrahierten Spalten werden auf das Schadensdatenmodell von Duck Creek abgebildet, und die integrierten Triage-Regeln von Duck Creek nutzen Schadensursache und geschätzten Betrag, um Schäden automatisch an die entsprechende Sachbearbeiter-Warteschlange weiterzuleiten.
Snapsheet, BriteCore und andere Mid-Market-Plattformen unterstützen in der Regel CSV-Import als Standard-Erfassungsmethode. Die Extraktionstabelle wird für diese Plattformen direkt als CSV exportiert. Für Versicherer mit Altsystemen, die nur begrenzte Importmöglichkeiten bieten, beschleunigt die extrahierte Excel-Datei den Workflow dennoch — die Sachbearbeiter kopieren die Daten zeilenweise aus der Triage-Tabelle in das Schadensystem, was schneller ist als das Lesen des Originalformulars, da alle Felder in einer einzigen Zeile in konsistenter Reihenfolge vorliegen.
Das zentrale Designprinzip: Der Extraktionsschritt erzeugt unabhängig vom Zielsystem saubere, spaltenbasierte Daten. Ob die Daten über eine API in Guidewire, über einen Flat-File-Import in Duck Creek oder per Copy-and-Paste in ein Altsystem fließen — das Extraktionsergebnis ist immer dasselbe strukturierte Format. Die Integrationsmethode ändert sich; die vorgelagerte Datenerfassung nicht.
FAQ
Ist der ACORD 140 dasselbe wie eine Sachschadenmeldung?
Nicht ganz — und der Unterschied ist wichtig für die Frage, welche Felder extrahiert werden sollen. Der ACORD 140 trägt offiziell den Titel „Property Section" und ist als Anhang zum ACORD 125 Commercial Insurance Application konzipiert. Er erfasst Underwriting-Daten: Gebäudekonstruktionsart, Brandschutzklasse, Deckungsgrenzen, Prozentsatz der Mitversicherung. Er umfasst drei Seiten mit 355 ausfüllbaren Feldern. Eine Sachschadenmeldung — in der Formularbibliothek manchmal als ACORD 130 nummeriert — ist ein separates Dokument, das speziell für die Schadenmeldung entwickelt wurde, mit Feldern wie Schadensdatum, Schadensursache, Schadensbeschreibung und geschätztem Betrag. In der Praxis begleiten ACORD-140-Formulare häufig Schadenmeldungen in der Schadensakte, da sie die Deckungs- und Sachdaten enthalten, die der Sachverständige benötigt. Der Extraktionsworkflow in diesem Artikel deckt beides ab: die schadenmeldungsspezifischen Felder für die Triage (Schadensdatum, Ursache, Beschreibung, Schätzung) und die 140-spezifischen Felder für die Deckungsprüfung (Polizzennummer, NAIC-Code, Deckungsgrenzen).
Wie genau ist die KI-Extraktion bei handschriftlichen Schadensbeschreibungen?
Das Feld für die Schadensbeschreibung im ACORD 140 ist in der Regel handschriftlich ausgefüllt — Sachverständige und Agenten verfassen frei formulierte Schilderungen zur Beschreibung des Schadens. Die Genauigkeit der KI-Extraktion bei Handschrift hängt von der Lesbarkeit ab: klar gedruckte Blockschrift erreicht hohe Genauigkeitsraten, die mit gedrucktem Text vergleichbar sind; stark kursiv geschriebene oder hastige Handschrift mit Durchstreichungen und Randnotizen führt zu geringerer Genauigkeit und erfordert eine menschliche Überprüfung. Der Vorschauschritt im Batch-Workflow ermöglicht es Ihnen, die Handschriftqualität zu stichprobenartig zu prüfen, bevor Sie den gesamten Batch freigeben. Wenn die Handschrift eines bestimmten Sachverständigen wiederholt falsch gelesen wird, können die Formulare dieses Sachverständigen für die manuelle Überprüfung markiert werden, während der Rest des Batches automatisch verarbeitet wird.
Kann ich denselben Spaltensatz für verschiedene Katastrophenereignisse wiederverwenden?
Ja. Der oben beschriebene 11-Spalten-Triagesatz — von der Polizzennummer bis zur Triage-Priorität — funktioniert für jeden Batch von Sachschadenmeldungen und ACORD-140-Formularen, unabhängig von der Art der Katastrophe. Eine Hurrikan-Schadenmeldung enthält dieselben Feldtypen wie eine Waldbrand-Schadenmeldung: Polizzennummer, Adresse, Datum, Ursache, Beschreibung, Betrag. Die Spaltennamen ändern sich nicht; die KI passt sich dem Inhalt jedes Formulars an. Speichern Sie den Spaltensatz nach der ersten Verwendung als Vorlage und laden Sie ihn für jedes nachfolgende Ereignis sofort.
Was ist, wenn das Formular fehlende Felder hat – kein geschätzter Betrag oder keine Schadensursache angegeben ist?
Die KI-Extraktion lässt die Zelle leer, wenn ein angefragtes Feld nicht auf dem Formular vorhanden ist – sie erfindet keine Daten. Eine leere Zelle für den geschätzten Betrag ist ein Signal, diesen Schadenfall zur sofortigen Nachverfolgung zu markieren, da die Schwere ohne ihn nicht beurteilt werden kann. Eine leere Zelle für die Schadensursache kann bedeuten, dass das Formular eingereicht wurde, bevor die Ursache ermittelt wurde – üblich in den ersten 24 Stunden nach einer Katastrophe, wenn die Priorität lediglich darin besteht, den Versicherer zu benachrichtigen, dass ein Schaden eingetreten ist. Sortieren Sie leere Zellen in der Triage-Tabelle nach oben, damit sie zuerst Beachtung finden.
Wie schneidet dies im Vergleich zur Nutzung einer Enterprise-Schadensaufnahmeplattform ab?
Enterprise-Plattformen wie Guidewire ClaimCenter und Duck Creek Claims bieten End-to-End-Schadensmanagement – FNOL-Erfassung, Sachbearbeiterzuweisung, Reservenverfolgung, Zahlungsabwicklung und Berichterstattung. Ihre Aufnahmemodule können strukturierte Daten empfangen, aber sie können diese nicht aus einem unstrukturierten PDF extrahieren. Der in diesem Artikel beschriebene Extraktionsschritt ist die Ebene, die vor dem Schadenssystem liegt: Er verwandelt PDFs in strukturierte Zeilen, die das Schadenssystem aufnehmen kann. Für Versicherer, die Enterprise-Plattformen nutzen, speist die Extraktion die Plattform. Für kleinere Versicherer und unabhängige Schadensregulierungsfirmen ohne Enterprise-System kann die Triage-Tabelle selbst als leichtgewichtiger Schadensaufnahme-Tracker fungieren.