Comment extraire les avis de sinistre ACORD 140
vers Excel pour le tri des réclamations
Les 72 premières heures après un ouragan, un incendie de forêt ou une inondation sont celles où les décisions en matière de réclamations immobilières pèsent le plus lourd — et où le processus de réclamation avance le plus lentement. La raison est structurelle, pas procédurale : les avis de sinistre immobilier arrivent sous forme de PDF envoyés par les agents, les courtiers et les assurés. Chacun doit être lu, saisi dans une feuille de calcul ou un système de gestion des réclamations, puis priorisé avant que quiconque puisse inspecter un bien. Les données d'Insurance Services Office (ISO) Property Claim Services montrent que le secteur a traité environ 3,5 millions de réclamations au cours des trois premiers trimestres de 2025 seulement (Verisk, 2026). Après une catastrophe touchant des dizaines de milliers de biens, la pile d'avis de sinistre en attente de saisie est le véritable goulot d'étranglement — pas la capacité d'inspection, pas la disponibilité des experts, mais les heures passées à taper les champs de formulaires dans un écran.
Points clés à retenir
- Après un ouragan, 200 000 réclamations immobilières arrivent en une seule semaine — et aucune ne peut être examinée tant que quelqu'un n'a pas tapé le numéro de police, l'estimation de perte et la description de la cause depuis un PDF dans une feuille de calcul.
- À 15 minutes par formulaire, 5 000 avis de sinistre brûlent 1 250 heures de saisie — et l'horloge réglementaire de la National Association of Insurance Commissioners (NAIC) qui détermine la conformité des assureurs court à partir de la date du sinistre, pas à partir de la date de saisie.
- L'extraction sémantique par IA lit les champs ACORD 140 selon leur signification plutôt que leur position sur la page — transformant 100 avis de sinistre en feuille de calcul de tri avec indicateurs de gravité et alertes d'échéance en moins de cinq minutes.
Les formulaires ACORD sont la colonne vertébrale de l'échange de données d'assurance en Amérique du Nord — plus de 170 formulaires standardisés, maintenus par la Association for Cooperative Operations Research and Development, couvrant tout, des demandes commerciales aux certificats d'assurance en passant par les avis de sinistre. Pour les sinistres immobiliers, l'avis de sinistre ACORD est le document qui capture les informations du titulaire de police, les détails du sinistre, la cause du sinistre, la description des dommages et l'estimation initiale — les données qui déterminent comment une réclamation est triée et acheminée. En assurance commerciale, le formulaire connexe ACORD 140 Property Section contient des données détaillées sur les bâtiments et la couverture sur trois pages avec 355 champs remplissables.
Cet article explique comment extraire les données des avis de sinistre immobiliers et du formulaire ACORD 140 dans une feuille de calcul Excel de tri structurée — un flux de travail qui transforme la pile de formulaires post-catastrophe d'une file d'attente de saisie de données en une liste d'actions triée par priorité. La même approche s'applique à d'autres types de formulaires ACORD : nos guides sur l'extraction des données ACORD 25 COI vers Excel et l'extraction des preuves d'assurance immobilière ACORD 27 couvrent le même flux de travail d'extraction basé sur les colonnes pour différents documents d'assurance.
La saisie manuelle des données s'effondre à l'échelle d'une catastrophe — non pas par manque de patience, mais par la force des choses
Les équipes de sinistres en assurance savent depuis des années que la saisie manuelle des données est leur plus lourde charge opérationnelle. Ce qui est moins discuté, c'est pourquoi elle échoue de manière catastrophique au moment même où elle compte le plus — après une catastrophe — et ce que l'horloge réglementaire signifie pour chaque heure perdue à lire des formulaires.
Les experts en sinistres consacrent 35 à 45 % de leur journée de travail au traitement des données plutôt qu'aux décisions réelles sur les réclamations, selon des études sur les flux de travail menées par des fournisseurs d'automatisation d'assurance. Pour un expert de bureau gérant une charge de travail standard, cela représente environ 3 à 4 heures par jour passées à lire, saisir et vérifier les données des formulaires. Le calcul pour un seul avis de sinistre : 12 à 18 minutes pour localiser et transcrire le numéro de police, le nom de l'assuré, le lieu du sinistre, la date du sinistre, la cause, la description du sinistre et le montant estimé à partir d'un formulaire ACORD multipage — multiplié par le nombre de réclamations en attente.
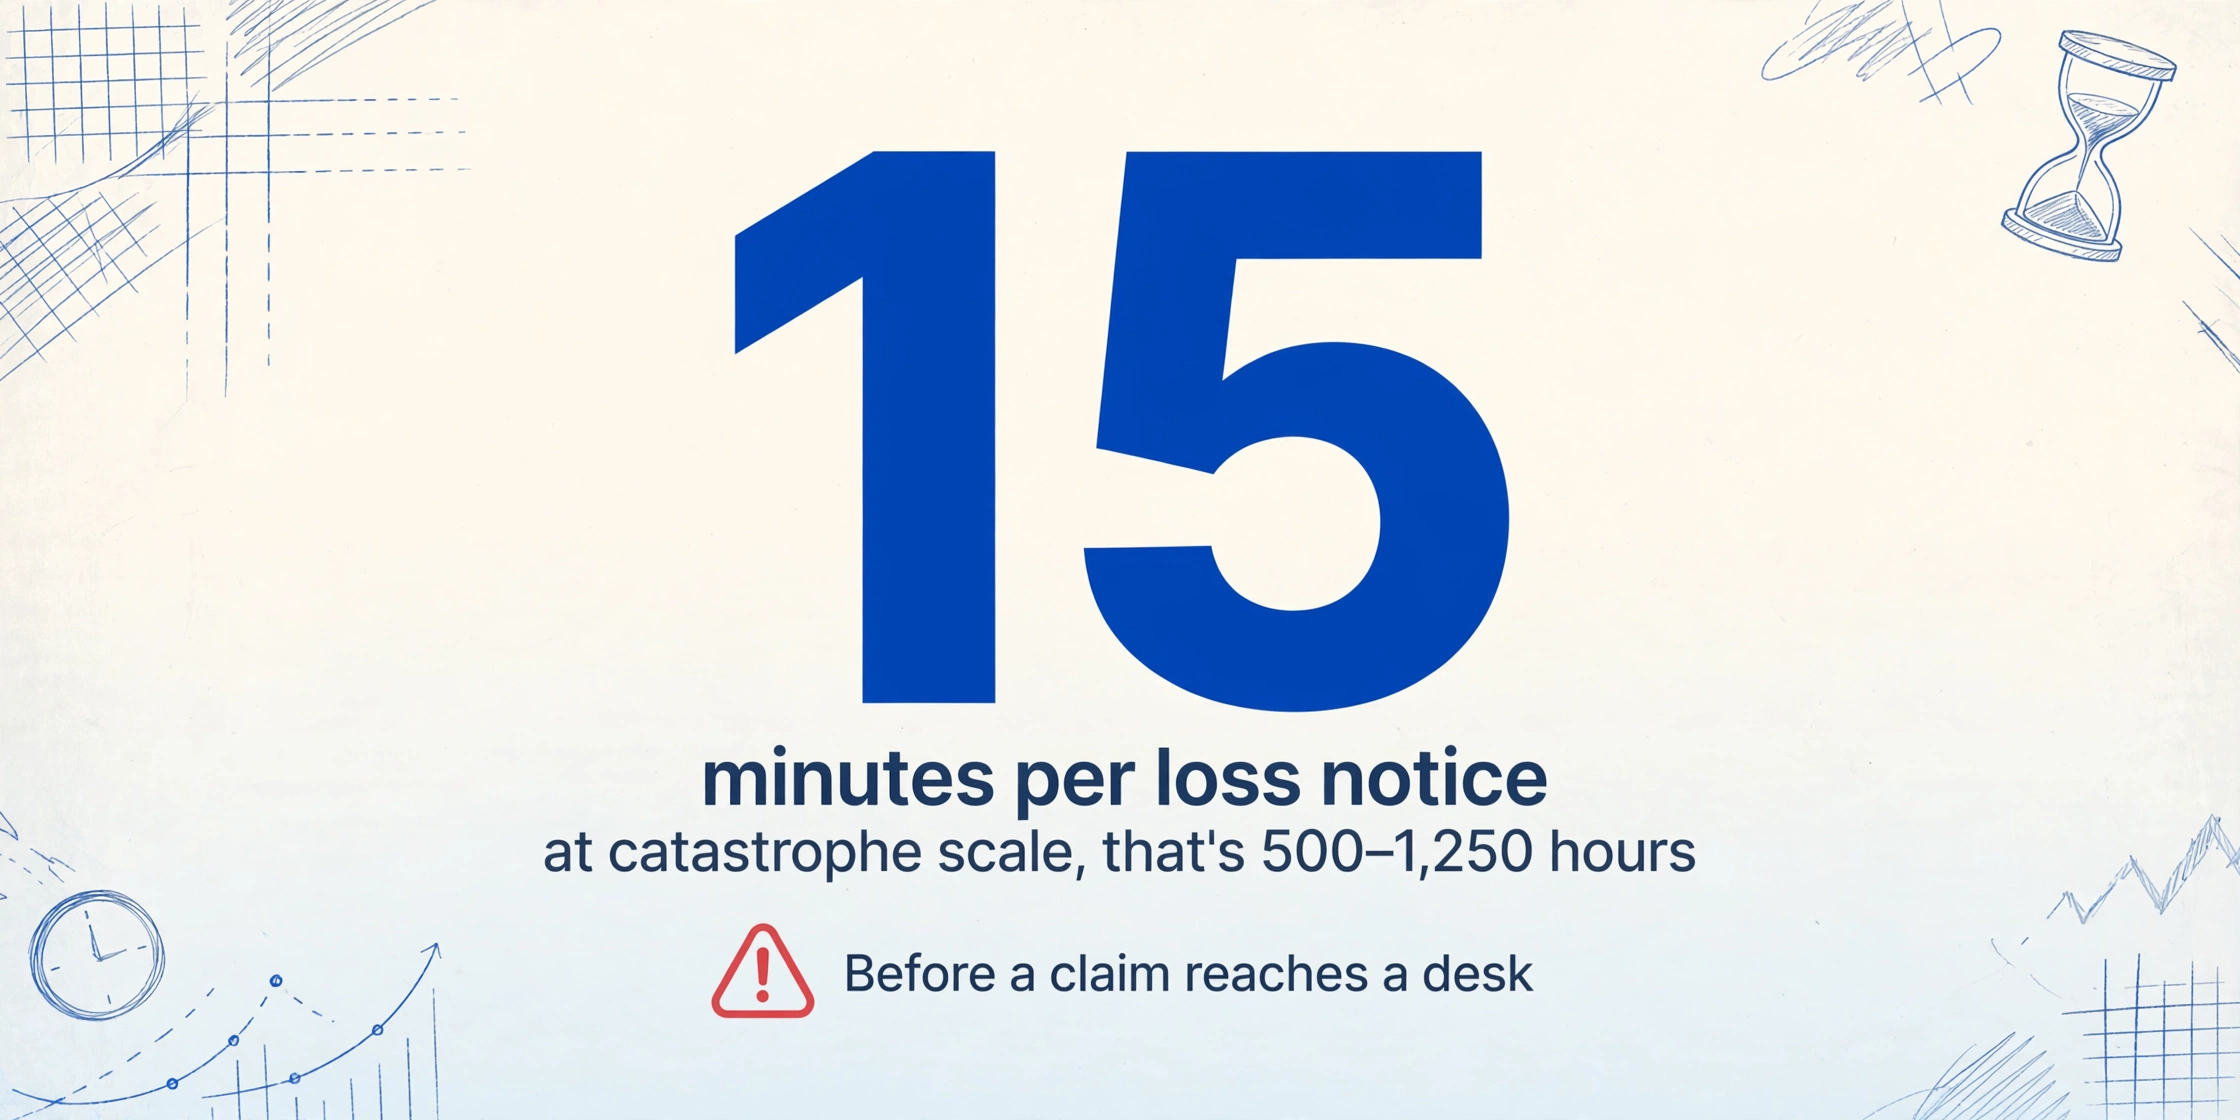
Après une catastrophe, le calcul s'effondre. Un seul atterrissage d'ouragan peut générer 200 000 à 400 000 réclamations immobilières dans les États touchés. Un assureur régional peut recevoir 2 000 à 5 000 avis de sinistre au cours de la première semaine. À 15 minutes par formulaire, cela représente 500 à 1 250 heures de pure saisie de données avant qu'une seule réclamation n'atteigne le bureau d'un expert pour une évaluation réelle. Le processus de réclamation ne commence pas lorsque l'avis de sinistre est déposé — il commence lorsque les données sont dans le système.
La dimension réglementaire ajoute une pression que la plupart des discussions sur les flux de travail ignorent. Le Règlement type NAIC sur les pratiques de règlement des sinistres en assurance de biens et de responsabilité civile (Modèle 902) établit que les assureurs doivent accuser réception des réclamations dans les 15 jours suivant la notification et confirmer ou nier la responsabilité dans un délai raisonnable — avec un paiement dû dans les 30 jours suivant la confirmation de responsabilité. De nombreux États imposent des normes plus strictes : la loi de Floride §626.9541 exige le paiement des réclamations de biens de première partie non contestées dans les 60 jours, et des délais similaires existent dans la plupart des juridictions. Chaque jour passé à saisir des données dans un système est un jour soustrait à la fenêtre d'investigation. Le risque de non-conformité ne vient pas de la mauvaise foi — il vient d'une pile de formulaires non lus.
Le problème n'est pas que les équipes de sinistres sont lentes. C'est que l'étape de saisie des données évolue linéairement avec le volume de réclamations au moment précis où le volume grimpe de 10 à 50 fois au-dessus de la ligne de base — et l'horloge réglementaire court à partir de la date du sinistre, pas de la date de saisie des données.
Les champs ACORD 140 qui comptent pour le triage ne sont pas les mêmes que ceux qui comptent pour la souscription
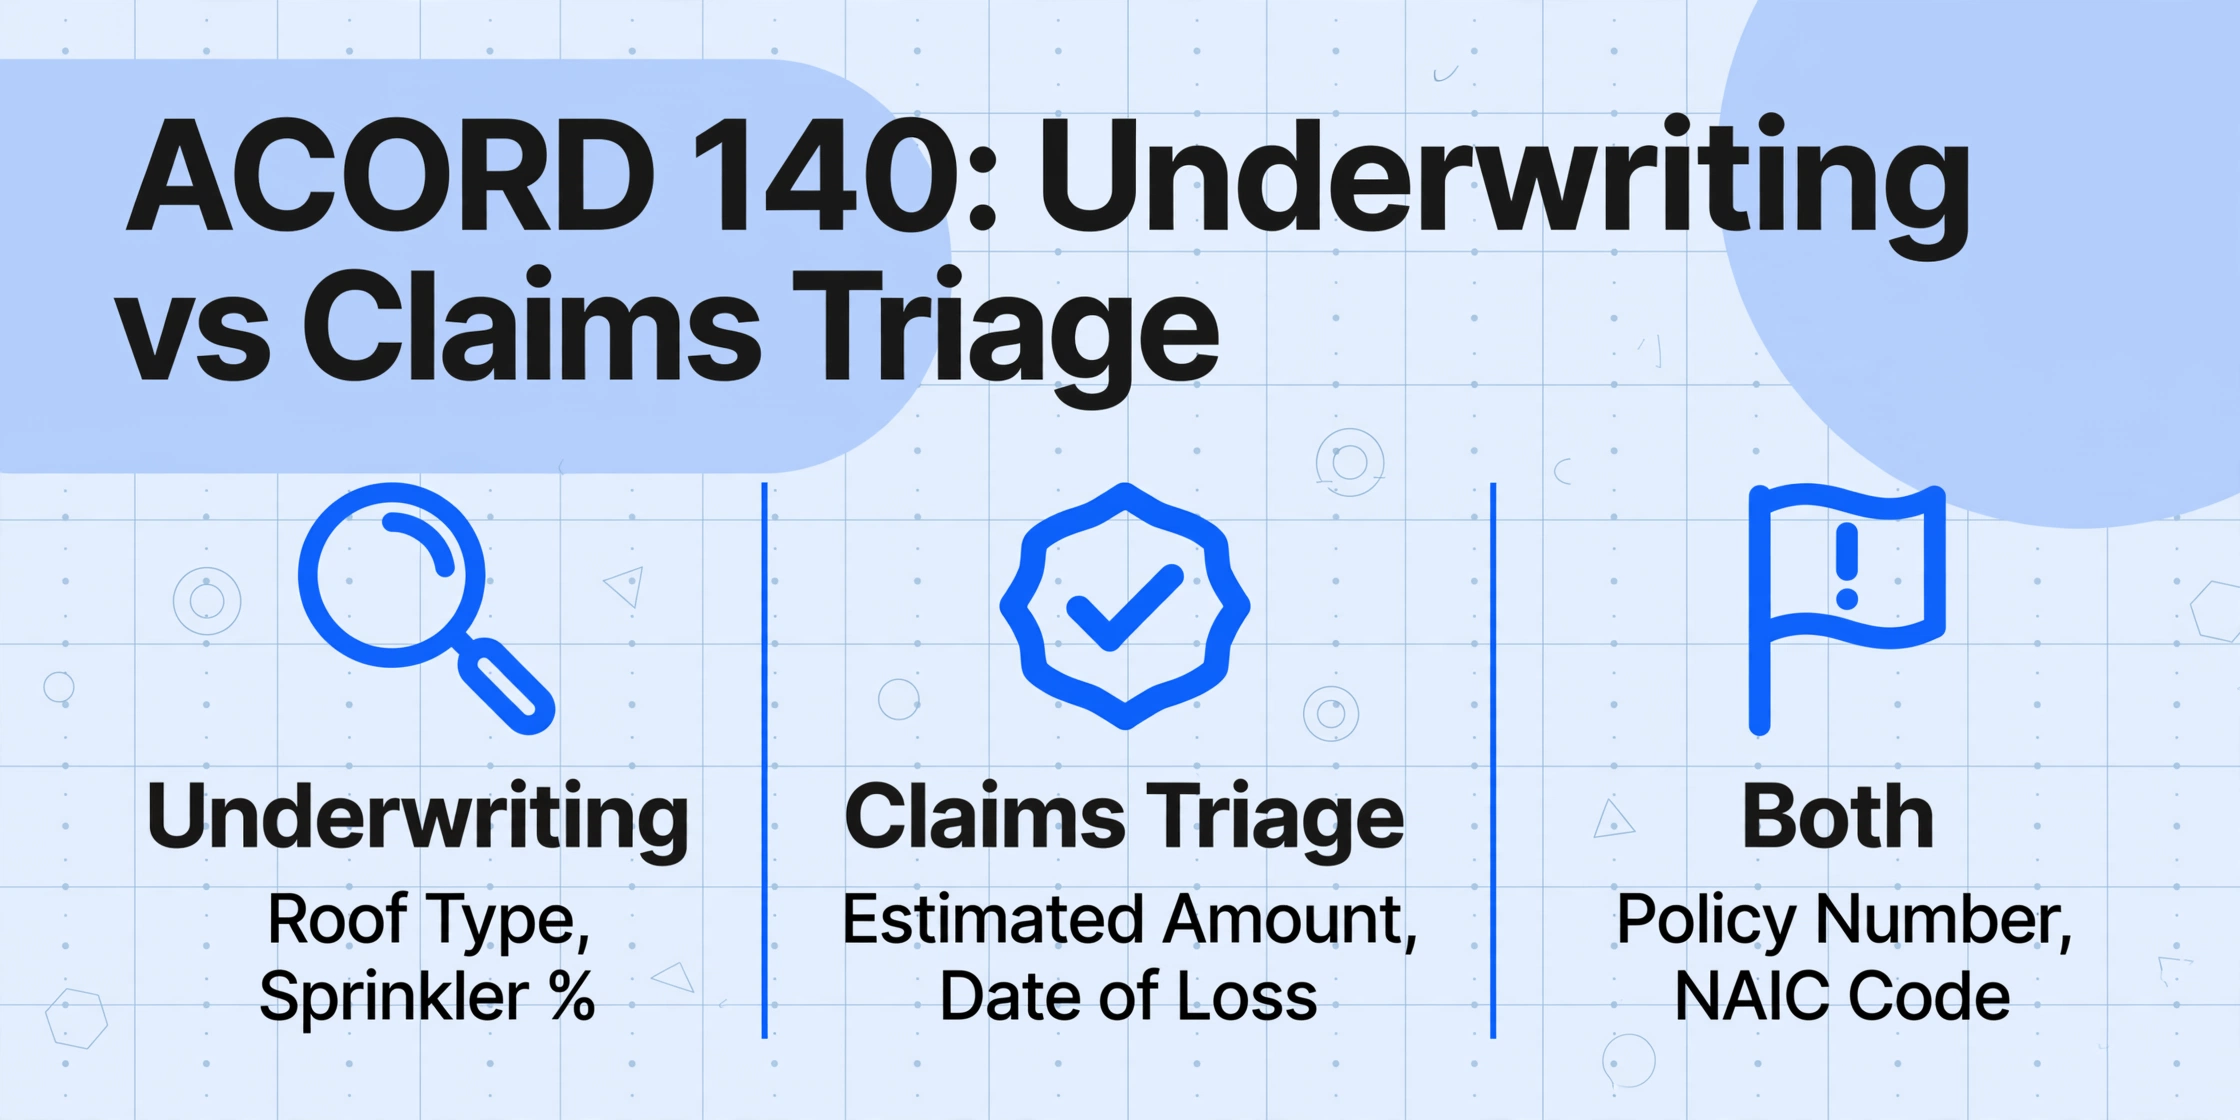
La section des biens ACORD 140 est un formulaire dense de plusieurs pages conçu à l'origine pour les demandes d'assurance commerciale — capturant le type de construction, l'occupation, la classe de protection incendie et les sélections de couverture. Mais lorsque ce formulaire arrive dans un contexte de sinistre — comme documentation justificative jointe à un avis de perte de biens — les champs qui comptent pour le triage changent complètement. Un souscripteur a besoin de connaître le type de toiture et le pourcentage de sprinklers. Un expert en sinistres a besoin de savoir combien la perte est estimée coûter et si quelqu'un est blessé.
Les champs du formulaire qui orientent les décisions de triage des sinistres se répartissent en quatre niveaux :
| Niveau de triage | Champ | Pourquoi c'est important pour le triage |
|---|---|---|
| 1 — Identification | Numéro de police, assuré désigné, nom de l'agence, code NAIC | Sans ces éléments, la réclamation ne peut pas être associée à une police ni acheminée au bon expert. Le code NAIC identifie de manière unique l'assureur — essentiel lorsque plusieurs assureurs sont impliqués dans un programme en couches. |
| 1 — Identification | Adresse du bien / lieu du sinistre, numéro de local, numéro de bâtiment | Détermine le territoire de l'expert auquel la réclamation appartient et si le bien se trouve dans une zone sinistrée déclarée. Une adresse erronée envoie la réclamation dans la mauvaise file. |
| 2 — Gravité | Montant estimé de la perte, objet de l'assurance, limites de couverture | La dimension de tri la plus importante. Les réclamations dépassant le seuil de gravité de l'assureur (généralement 50 000 $–100 000 $ pour les biens commerciaux) nécessitent l'affectation d'un expert senior. Les réclamations en dessous peuvent être éligibles au traitement au niveau du bureau ou au traitement direct. |
| 2 — Gravité | Cause de la perte, date de la perte, description de la perte et des dommages | Détermine l'éligibilité à la couverture (ce péril est-il couvert ?), signale un recours potentiel (responsabilité civile tierce ?) et identifie les indicateurs de fraude. Un sinistre incendie avec un rapport de police joint est acheminé différemment d'une réclamation pour dommages causés par le vent. |
| 3 — Contact | Nom du contact assuré, téléphone résidentiel, téléphone professionnel, quand contacter | Planification du premier contact avec l'expert. Un numéro de téléphone incorrect à ce stade génère un délai de 2 à 3 jours pendant que l'équipe des réclamations joue au téléphone. |
| 4 — Référence | Nom et adresse du créancier hypothécaire / bénéficiaire de l'indemnité, numéro de prêt | Requis pour le règlement — le paiement ne peut pas être émis sans confirmation du bénéficiaire de l'indemnité. Son absence à la réception signifie un retard de paiement à la fin du processus. L'extraire maintenant évite ce retard. |
La distinction clé : les champs du niveau 1 doivent être précis à 100 % avant que toute autre étape puisse procéder. Un mauvais numéro de police envoie toute la réclamation au mauvais assureur. Les champs du niveau 2 déterminent la priorité d'acheminement et l'affectation des experts — une réclamation pour dégâts des eaux de 5 000 $ ne devrait jamais passer devant une réclamation pour incendie structurel de 500 000 $ dans la file. Les champs des niveaux 3 et 4 comptent plus tard mais sont gratuits à extraire maintenant — les capturer lors de la réception évite un second examen du même formulaire des jours plus tard.
Pour une comparaison plus large de la façon dont les champs d'extraction diffèrent selon les types de formulaires d'assurance, notre guide complet d'extraction ACORD 25 COI présente la même priorisation des champs par niveau pour les certificats de responsabilité civile.
Configure des colonnes d'extraction adaptées à ton workflow de triage — pas à la mise en page du formulaire
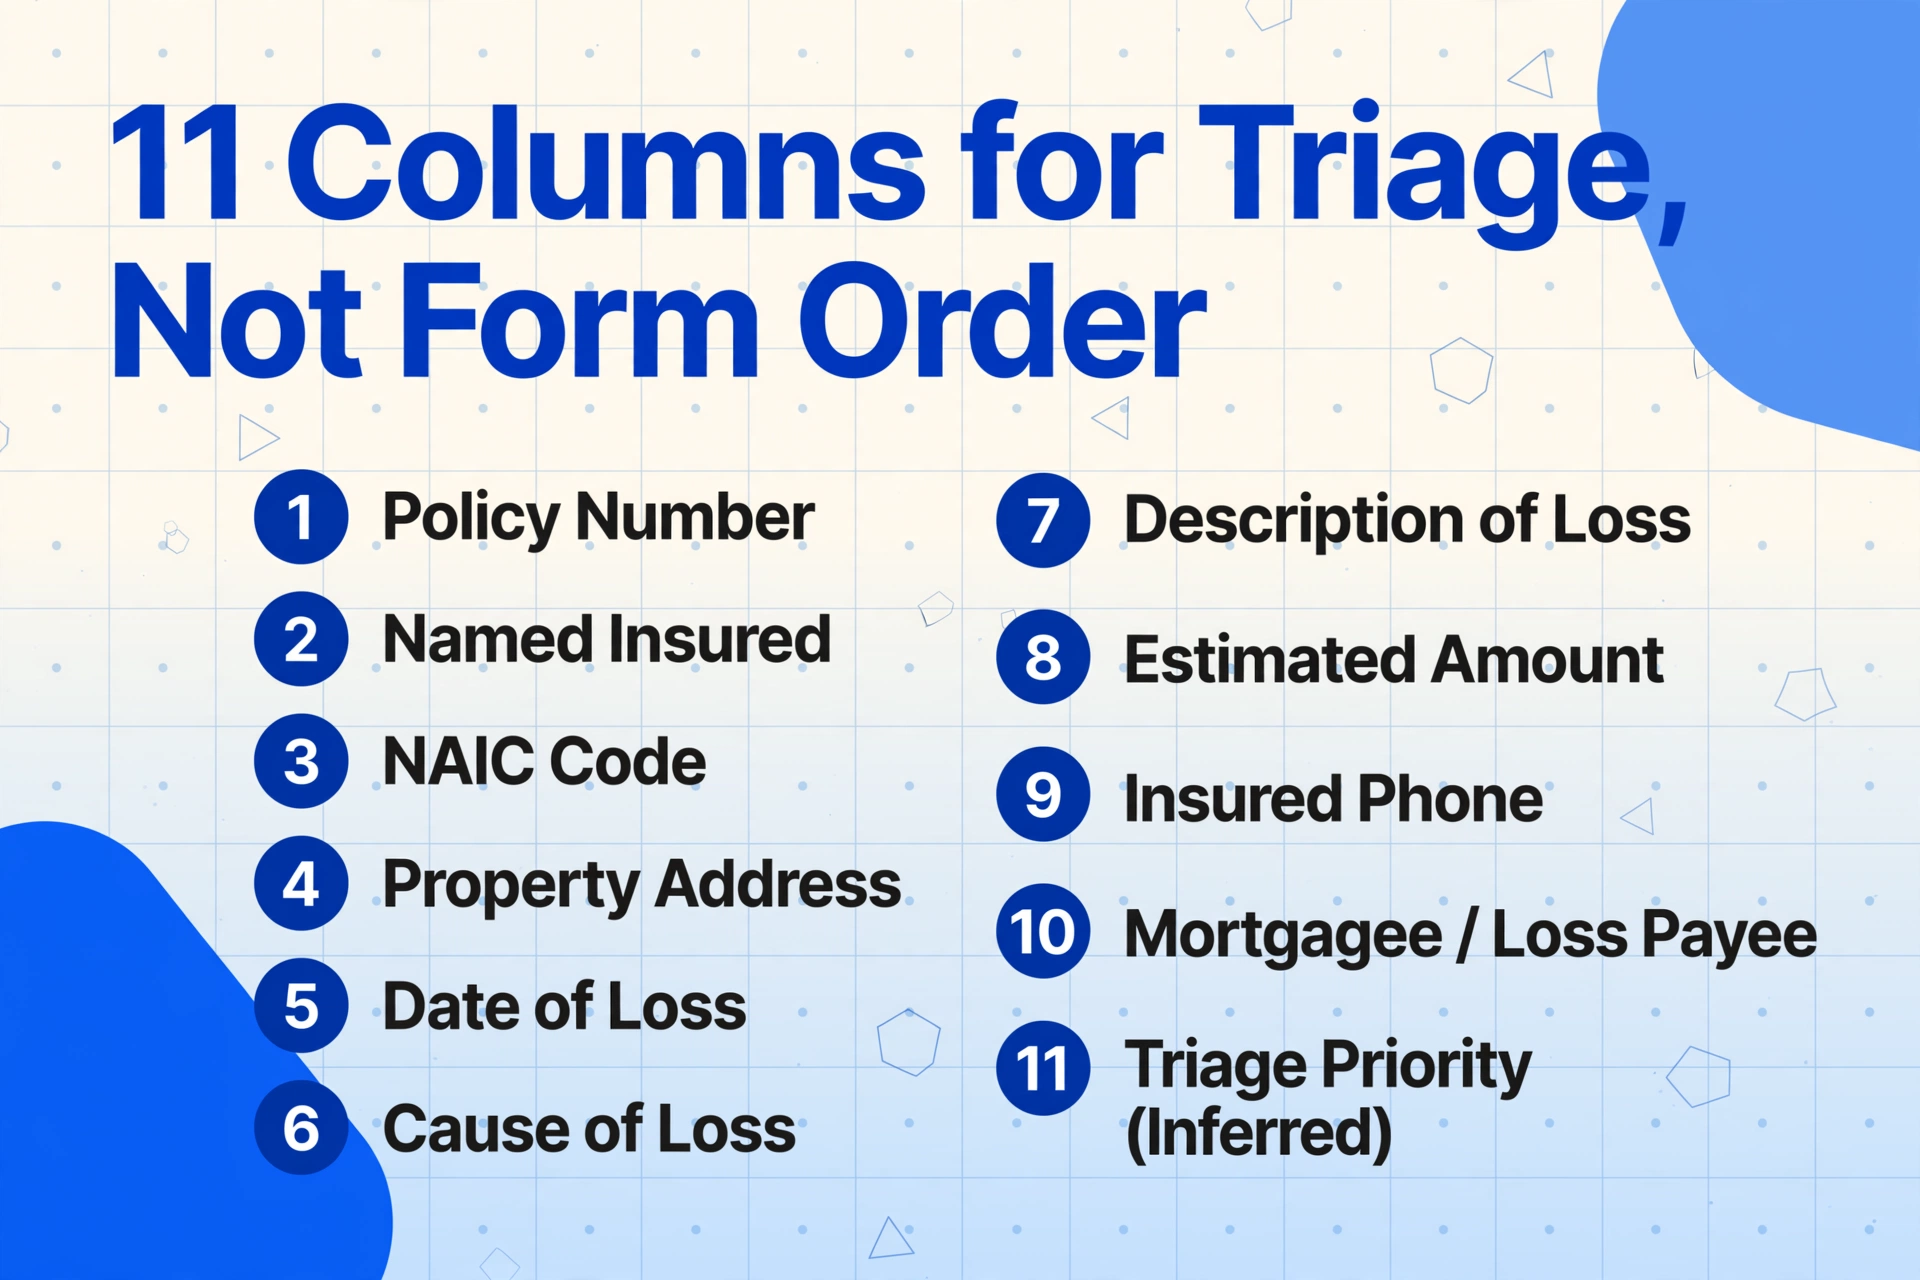
L'erreur la plus courante lors de l'extraction de données structurées à partir de formulaires ACORD est de reproduire l'ordre des champs du formulaire comme en-têtes de colonnes. Le formulaire regroupe les données par logique administrative (d'abord les informations de l'agence, puis les locaux, puis les couvertures). La feuille de calcul de triage doit regrouper les données par logique de décision — d'abord l'identification, puis la gravité, et enfin le contact.
Voici l'ensemble de colonnes pour une extraction ACORD 140 optimisée pour le triage :
| Nom de la colonne | Mode d'extraction | Fonction de triage |
|---|---|---|
Policy Number | Extraction directe | Faire correspondre la réclamation à la police dans le système d'administration |
Named Insured | Extraction directe | Vérifier l'identité du demandeur |
NAIC Code | Extraction directe | Valider le transporteur ; acheminer vers la bonne équipe de réclamations |
Property Address | Extraction directe | Assigner l'expert par territoire ; vérifier la zone de catastrophe |
Date of Loss | Extraction directe | Calculer les jours écoulés depuis la perte ; vérifier la période de police |
Cause of Loss | Extraction directe | Vérification de la couverture ; indicateur de subrogation ; attribution du code CAT |
Description of Loss | Extraction directe | Évaluation de la portée ; classification de la gravité ; filtrage de la fraude |
Estimated Amount | Extraction directe | Acheminement basé sur la gravité ; définition de la réserve |
Insured Phone | Extraction directe | Planification du premier contact |
Mortgagee / Loss Payee | Extraction directe | Vérification du paiement du règlement |
Triage Priority | colonne inférée | L'IA attribue Urgent / Élevé / Standard / Surveiller en fonction du montant estimé et de la cause de la perte |
Cet ensemble de colonnes utilise deux modes d'extraction. L'extraction directe récupère les valeurs explicitement imprimées sur le formulaire — numéros de police, dates, montants en dollars. L'IA les localise en comprenant ce que signifie chaque libellé de champ, de sorte qu'un numéro de police étiqueté « Policy # » sur le formulaire d'un transporteur et « Policy Number » sur un autre formulaire correspondent tous deux à la même colonne. C'est ce qui distingue l'extraction sémantique de l'OCR positionnel : les outils traditionnels échouent lorsqu'un champ se déplace vers une position différente sur une version différente du formulaire ; l'extraction sémantique réussit car elle lit par le sens, pas par coordonnées.
La colonne inférée — Priorité de triage — fonctionne différemment. L'IA lit le montant estimé et la cause de la perte, puis applique une logique métier pour attribuer un niveau de priorité. Par exemple : une perte par incendie de plus de 100 000 $ est acheminée comme Urgente ; une réclamation pour dégâts des eaux de moins de 10 000 $ est acheminée comme Standard. Les règles de classification vivent dans la définition de la colonne, et l'IA les applique à chaque ligne du lot — extraction et triage en une seule passe.
Une note opérationnelle : la zone de description manuscrite des pertes du formulaire ACORD 140 est l'endroit où le formulaire devient difficile. Les experts et agents décrivent les dommages avec leurs propres mots, dans leur propre écriture — « l'eau est entrée par le toit provoquant l'effondrement du plafond dans la zone du bureau principal, le contenu est endommagé, l'électricité peut être compromise ». La reconnaissance d'écriture de l'IA gère cette variabilité, mais les noms de colonnes doivent être suffisamment spécifiques pour guider l'extraction vers le bon contenu. Une colonne simplement nommée « Description » peut capturer n'importe quel texte descriptif de la page — y compris les descriptions de bâtiment destinées à la souscription. La nommer « Description des pertes » ou « Description de la perte » réduit la recherche de l'IA aux blocs de texte liés aux pertes.
Traitement d'un lot : de 100 PDF à une feuille de calcul en moins de cinq minutes
Le flux de travail d'extraction qui transforme une file de sinistres catastrophiques en feuille de calcul de tri suit cinq étapes. Le goulot d'étranglement se situe à l'étape un — le téléversement — car les fichiers doivent être transférés physiquement. Tout ce qui suit fonctionne sur le temps de traitement de l'IA, qui se mesure en secondes par formulaire, pas en minutes.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Étape 1 — Téléversez tous les avis de perte en une fois. Glissez le dossier entier de formulaires ACORD — PDF des agents, copies numérisées des experts terrain, photos des rapports de perte manuscrits — dans la zone de téléversement. L'outil accepte les formats PDF, JPG, PNG et WebP, et compresse automatiquement les fichiers volumineux pour un transfert plus rapide. Le téléversement par lot signifie que vous sélectionnez tout l'ensemble d'un coup, pas un fichier à la fois.
Étape 2 — Saisissez vos noms de colonnes. Tapez ou collez la liste de colonnes du tableau ci-dessus dans le panneau de définition des colonnes. Chaque nom de colonne devient un en-tête dans la feuille de calcul de sortie et une instruction de recherche pour l'IA. Vous pouvez enregistrer cet ensemble de colonnes comme modèle une fois et le réutiliser pour chaque futur événement catastrophique — les mêmes 11 colonnes fonctionnent pour n'importe quel lot d'avis de perte ACORD.
Étape 3 — Vérifiez une ligne d'aperçu avant de lancer le lot complet. L'IA traite d'abord un formulaire et affiche les valeurs extraites mappées à chaque colonne. Cet aperçu vous permet de confirmer que « Numéro de police » a capturé le bon champ avant de traiter les 100 formulaires. Si le numéro de police s'est retrouvé dans la mauvaise colonne, ajustez le nom de la colonne et relancez l'aperçu — le lot n'a pas encore commencé.
Étape 4 — Lancer le traitement complet. Cliquez sur Traiter. L'IA lit chaque formulaire, localise chaque champ demandé par compréhension sémantique et remplit le tableau de sortie. Un lot de 100 avis de sinistre est traité en environ 2 à 5 minutes — contre 25 à 30 heures pour la même tâche en saisie manuelle. Le taux de précision de 99 % pour le texte imprimé (selon les benchmarks publiés de l'outil) et la forte reconnaissance de l'écriture manuscrite pour les écritures cursives et les saisies en casse mixte rendent le tableau de sortie utilisable avec une validation légère, et non une correction lourde.
Étape 5 — Exporter vers Excel. Téléchargez le tableau complété en fichier XLSX. Chaque ligne correspond à un avis de sinistre ; chaque colonne à un champ extrait. Le fichier exporté est un classeur unique — un avis de sinistre par ligne, un champ par colonne, sans cellules fusionnées, sans tableaux croisés dynamiques, sans mise en forme qui interfère avec l'utilisation en aval.
Ce flux de travail transforme le goulot d'étranglement de la réception des sinistres. Les 25 heures de saisie qui occupaient les trois premiers jours après une catastrophe deviennent 5 minutes de traitement et 30 minutes de validation — libérant 24 heures pour l'investigation réelle des sinistres et l'envoi des experts. Pour les outils qui rendent cela possible, notre guide sur la différence entre OCR et extraction par IA explique pourquoi l'OCR traditionnel ne peut pas offrir ce flux de travail et ce qui a changé avec les modèles vision-langage.
La feuille de tri que vous construisez : tri, filtres et code couleur pour la rapidité de décision
Une feuille de calcul extraite avec des données n'est pas un système de tri — c'est une matière première. La feuille devient un outil de tri lorsqu'elle répond à une question en moins de cinq secondes : quel sinistre nécessite une attention immédiate ?
Ouvrez le XLSX exporté et appliquez trois transformations immédiatement :
Trier par Montant estimé décroissant. La colonne des montants en dollars devient l'axe principal de gravité. Les sinistres au-dessus du seuil interne de gravité de l'assureur se retrouvent en haut — ils nécessitent l'affectation d'un expert senior, une possible augmentation des réserves et éventuellement l'envoi d'un expert indépendant. Les sinistres sous quelques milliers de dollars se retrouvent en bas — de nombreux assureurs les orientent vers des flux de règlement automatisés ou de niveau bureau. Une seule opération de tri remplace le processus manuel d'ouverture de chaque formulaire, de lecture du champ d'estimation des pertes et de classement mental des sinistres les uns par rapport aux autres.
Filtrer par Cause du sinistre. Après un ouragan, les sinistres se répartissent approximativement entre dégâts de vent, dégâts d'inondation et les deux. Après un incendie de forêt, la répartition se fait entre dégâts de feu et dégâts de fumée — deux processus de sinistres fondamentalement différents, avec des déclencheurs de couverture et des compétences d'expert distincts. Un simple filtre sur la colonne Cause du sinistre regroupe les sinistres par type de péril afin que le chef d'équipe puisse affecter les lots aux bons experts. Les sinistres uniquement liés au vent vont à l'équipe des biens. Les sinistres d'inondation — s'ils sont couverts par une police NFIP ou une police d'inondation privée distincte — sont orientés vers l'unité inondation. Les sinistres avec les deux périls nécessitent une détermination de couverture avant l'orientation.
Appliquer une mise en forme conditionnelle. Code couleur sur la colonne Montant estimé : rouge pour les sinistres de plus de 100 000 $, orange pour 25 000 $–100 000 $, jaune pour moins de 25 000 $. Code couleur sur la colonne Date du sinistre : surlignez tout sinistre dont la perte est survenue il y a plus de 14 jours sans disposition — cela signale les sinistres approchant l'échéance d'accusé de réception du modèle NAIC 902 et donne au chef d'équipe un aperçu visuel du risque de conformité.
La feuille de calcul qui en résulte est un tableau de bord de tri en temps réel construit à partir des données de formulaires extraites. Le chef d'équipe l'ouvre le matin, trie par priorité et affecte les 20 premières lignes aux experts disponibles. Lorsque de nouveaux avis de sinistre arrivent en cours de journée, extrayez-les en lot secondaire, ajoutez les lignes, re-triez et l'ordre de priorité se met à jour automatiquement.
Récupérer les données extraites dans Guidewire, Duck Creek ou votre plateforme de gestion des sinistres
La feuille de tri répond à la question « que faire ensuite ? ». Le système de gestion des sinistres répond à la question « que s'est-il passé sur ce sinistre ? ». Faire le pont entre les deux — récupérer les données extraites des formulaires depuis Excel et les intégrer dans la plateforme où les experts travaillent réellement — est l'étape finale qui transforme un outil de tri en un élément du flux de travail des sinistres.
Le chemin d'intégration dépend de votre plateforme de sinistres :
Guidewire ClaimCenter — la plateforme de sinistres P&C la plus déployée parmi les assureurs de premier rang — prend en charge la saisie FNOL en masse via sa couche API et via des outils d'import CSV dans son module d'ingestion de données. La feuille de calcul exportée depuis l'extraction correspond directement aux champs de saisie des sinistres de ClaimCenter : Numéro de police → Recherche de police, Nom de l'assuré → Vérification du demandeur, Date du sinistre → Date de l'événement de perte, Cause du sinistre → Classification du type de sinistre. Les équipes d'exploitation des sinistres peuvent configurer le mappage des champs une fois, puis importer les feuilles de calcul extraites par lots. Les règles d'automatisation FNOL de Guidewire déclenchent l'affectation des experts et les recommandations de réserves en fonction des données de gravité déjà présentes dans les lignes importées.
Duck Creek Claims — le principal concurrent cloud-natif de Guidewire — propose des API de saisie configurables et prend en charge les imports de fichiers plats via sa couche d'intégration. Le mappage des champs suit la même logique : les colonnes extraites correspondent au modèle de données des sinistres de Duck Creek, et les règles de tri intégrées de Duck Creek utilisent la Cause du sinistre et le Montant estimé pour router automatiquement les sinistres vers la file d'attente de l'expert approprié.
Snapsheet, BriteCore et autres plateformes mid-market prennent généralement en charge l'import CSV comme méthode de saisie standard. La feuille de calcul d'extraction s'exporte directement en CSV pour ces plateformes. Pour les assureurs utilisant des systèmes de sinistres hérités avec des capacités d'import limitées, le fichier Excel extrait accélère quand même le flux de travail — les experts copient-collent depuis la feuille de tri dans le système de sinistres une ligne à la fois, ce qui est plus rapide que de lire le formulaire original car tous les champs sont sur une seule ligne dans un ordre cohérent.
Le principe de conception clé : l'étape d'extraction produit des données propres et en colonnes, quel que soit le système de destination. Que les données circulent vers Guidewire via une API, Duck Creek via un import de fichier plat, ou un système hérité via copier-coller, la sortie d'extraction est le même format structuré. La méthode d'intégration change ; la capture initiale des données, non.
FAQ
Le formulaire ACORD 140 est-il identique à un avis de perte de biens ?
Pas exactement — et cette distinction est importante pour savoir quels champs extraire. L'ACORD 140 est officiellement intitulé « Section des biens » et est conçu comme une annexe à la demande d'assurance commerciale ACORD 125. Il capture des données de souscription : type de construction du bâtiment, classe de protection incendie, limites de couverture, pourcentage de coassurance. Il s'étend sur trois pages avec 355 champs remplissables. Un avis de perte de biens — parfois numéroté ACORD 130 dans la bibliothèque de formulaires — est un document distinct conçu spécifiquement pour le signalement de sinistres, avec des champs comme Date du sinistre, Cause du sinistre, Description des dommages et Montant estimé. En pratique, les formulaires ACORD 140 accompagnent souvent les avis de perte dans le dossier de sinistre car ils contiennent les données de couverture et de biens dont l'expert a besoin. Le flux d'extraction de cet article couvre les deux : les champs spécifiques aux avis de perte pour le tri (Date du sinistre, Cause, Description, Estimation) et les champs spécifiques au 140 pour la vérification de couverture (Numéro de police, Code NAIC, Limites de couverture).
Quelle est la précision de l'extraction IA sur les descriptions de pertes manuscrites ?
Le champ de description de perte de l'ACORD 140 est généralement manuscrit — les experts et agents rédigent des récits en texte libre décrivant les dommages. La précision de l'extraction IA sur l'écriture manuscrite dépend de la lisibilité : les lettres majuscules clairement imprimées atteignent des taux de précision élevés comparables au texte imprimé ; l'écriture cursive très stylisée ou précipitée avec des ratures et des notes en marge produit une précision moindre et nécessite une vérification humaine. L'étape d'aperçu dans le flux de traitement par lots vous permet de vérifier la qualité de l'écriture avant de lancer le lot complet. Si l'écriture d'un expert particulier est systématiquement mal lue, ses formulaires peuvent être signalés pour révision manuelle pendant que le reste du lot est traité automatiquement.
Puis-je réutiliser le même ensemble de colonnes pour différents événements catastrophiques ?
Oui. L'ensemble de tri à 11 colonnes décrit ci-dessus — du Numéro de police à la Priorité de tri — fonctionne avec n'importe quel lot d'avis de perte de biens et de formulaires ACORD 140, quel que soit le type de catastrophe. Un avis de perte d'ouragan contient les mêmes types de champs qu'un avis de perte d'incendie de forêt : numéro de police, adresse, date, cause, description, montant. Les noms de colonnes ne changent pas ; l'IA s'adapte au contenu de chaque formulaire. Enregistrez l'ensemble de colonnes comme modèle après la première utilisation et chargez-le instantanément pour chaque événement ultérieur.
Et si le formulaire comporte des champs manquants — aucun montant estimé ou aucune cause de sinistre indiquée ?
L'extraction par IA laisse la cellule vide lorsqu'un champ demandé n'est pas présent sur le formulaire — elle n'invente pas de données. Une cellule Montant estimé vide est un signal pour signaler ce sinistre en vue d'un suivi immédiat, car la gravité ne peut pas être évaluée sans elle. Une cellule Cause de sinistre vide peut signifier que le formulaire a été soumis avant que la cause ne soit déterminée — courant dans les 24 premières heures après une catastrophe, lorsque la priorité est simplement d'informer l'assureur qu'un sinistre s'est produit. Triez les cellules vides en haut de la feuille de calcul de triage afin qu'elles reçoivent l'attention en premier.
Comment cela se compare-t-il à l'utilisation d'une plateforme d'intake de sinistres d'entreprise ?
Les plateformes d'entreprise comme Guidewire ClaimCenter et Duck Creek Claims offrent une gestion de sinistres de bout en bout — intake FNOL, affectation des experts, suivi des réserves, traitement des paiements et reporting. Leurs modules d'intake peuvent recevoir des données structurées, mais ils ne peuvent pas les extraire d'un PDF non structuré. L'étape d'extraction décrite dans cet article est la couche qui se situe avant le système de sinistres : elle transforme les PDF en lignes structurées que le système de sinistres peut ingérer. Pour les assureurs utilisant des plateformes d'entreprise, l'extraction alimente la plateforme. Pour les petits assureurs et les cabinets d'expertise indépendants sans système d'entreprise, la feuille de calcul de triage peut elle-même fonctionner comme un suivi d'intake de sinistres léger.