Como Extrair Avisos de Perda ACORD 140
para Excel para Triagem de Sinistros
As primeiras 72 horas após um furacão, incêndio florestal ou inundação são quando as decisões sobre sinistros de propriedade têm mais peso — e quando o processo de sinistros avança mais lentamente. O motivo é estrutural, não procedimental: avisos de perda de propriedade chegam como PDFs de agentes, corretores e segurados. Cada um precisa ser lido, digitado em uma planilha ou sistema de gestão de sinistros e priorizado antes que alguém possa inspecionar um imóvel. Dados do Insurance Services Office (ISO) Property Claim Services mostram que o setor processou cerca de 3,5 milhões de sinistros somente nos três primeiros trimestres de 2025 (Verisk, 2026). Após uma catástrofe com dezenas de milhares de imóveis afetados, a pilha de avisos de perda aguardando entrada de dados é o verdadeiro gargalo — não a capacidade de inspeção, não a disponibilidade de ajustadores, mas as horas gastas digitando campos de formulário em uma tela.
Principais Conclusões
- Após um furacão, 200.000 sinistros de propriedade chegam em uma única semana — e nenhum pode ser investigado até que alguém digite o número da apólice, a estimativa de perda e a descrição da causa de um PDF em uma planilha.
- A 15 minutos por formulário, 5.000 avisos de perda consomem 1.250 horas de entrada de dados — e o relógio regulatório da National Association of Insurance Commissioners (NAIC) que determina a conformidade da seguradora conta a partir da data da perda, não da data da entrada de dados.
- A extração semântica por IA lê os campos do ACORD 140 pelo que significam, e não por onde estão na página — transformando 100 avisos de perda em uma planilha de triagem classificável com sinalizações de gravidade e alertas de prazo em menos de cinco minutos.
Os formulários ACORD são a espinha dorsal da troca de dados de seguros na América do Norte — mais de 170 formulários padronizados, mantidos pela Association for Cooperative Operations Research and Development, cobrindo desde aplicações comerciais até certificados de seguro e avisos de sinistro. Para sinistros de propriedade, o aviso de sinistro ACORD é o documento que captura informações do segurado, detalhes do sinistro, causa do sinistro, descrição dos danos e estimativa inicial — os dados que determinam como um sinistro é triado e encaminhado. No seguro comercial, o formulário relacionado ACORD 140 Property Section carrega dados detalhados de edificação e cobertura em três páginas com 355 campos preenchíveis.
Este artigo percorre a extração de dados de aviso de sinistro de propriedade e do ACORD 140 para uma planilha de triagem estruturada no Excel — um fluxo de trabalho que transforma a pilha de formulários pós-catástrofe de uma fila de entrada de dados em uma lista de ações ordenada por prioridade. A mesma abordagem se aplica a outros tipos de formulários ACORD: nossos guias sobre extrair dados do ACORD 25 COI para o Excel e extrair evidência de seguro de propriedade do ACORD 27 cobrem o mesmo fluxo de trabalho de extração baseado em colunas para diferentes documentos de seguro.
A entrada manual de dados entra em colapso na escala de catástrofe — não por paciência, mas por física
As equipes de sinistros de seguros sabem há anos que a entrada manual de dados é seu maior imposto operacional. O que é discutido com menos frequência é por que ela falha catastroficamente no momento em que mais importa — após um desastre — e o que o relógio regulatório significa para cada hora perdida lendo formulários.
Os ajustadores de sinistros gastam 35–45% de sua jornada de trabalho em manipulação de dados em vez de decisões reais sobre sinistros, segundo estudos de fluxo de trabalho de fornecedores de automação de seguros. Para um ajustador de mesa lidando com uma carga de trabalho padrão, isso se traduz em aproximadamente 3–4 horas por dia gastas lendo, digitando e verificando dados de formulários. A matemática para um único aviso de sinistro: 12–18 minutos para localizar e transcrever número da apólice, nome do segurado, local do sinistro, data do sinistro, causa, descrição do sinistro e valor estimado de um formulário ACORD de várias páginas — multiplicado pelo número de sinistros na fila.
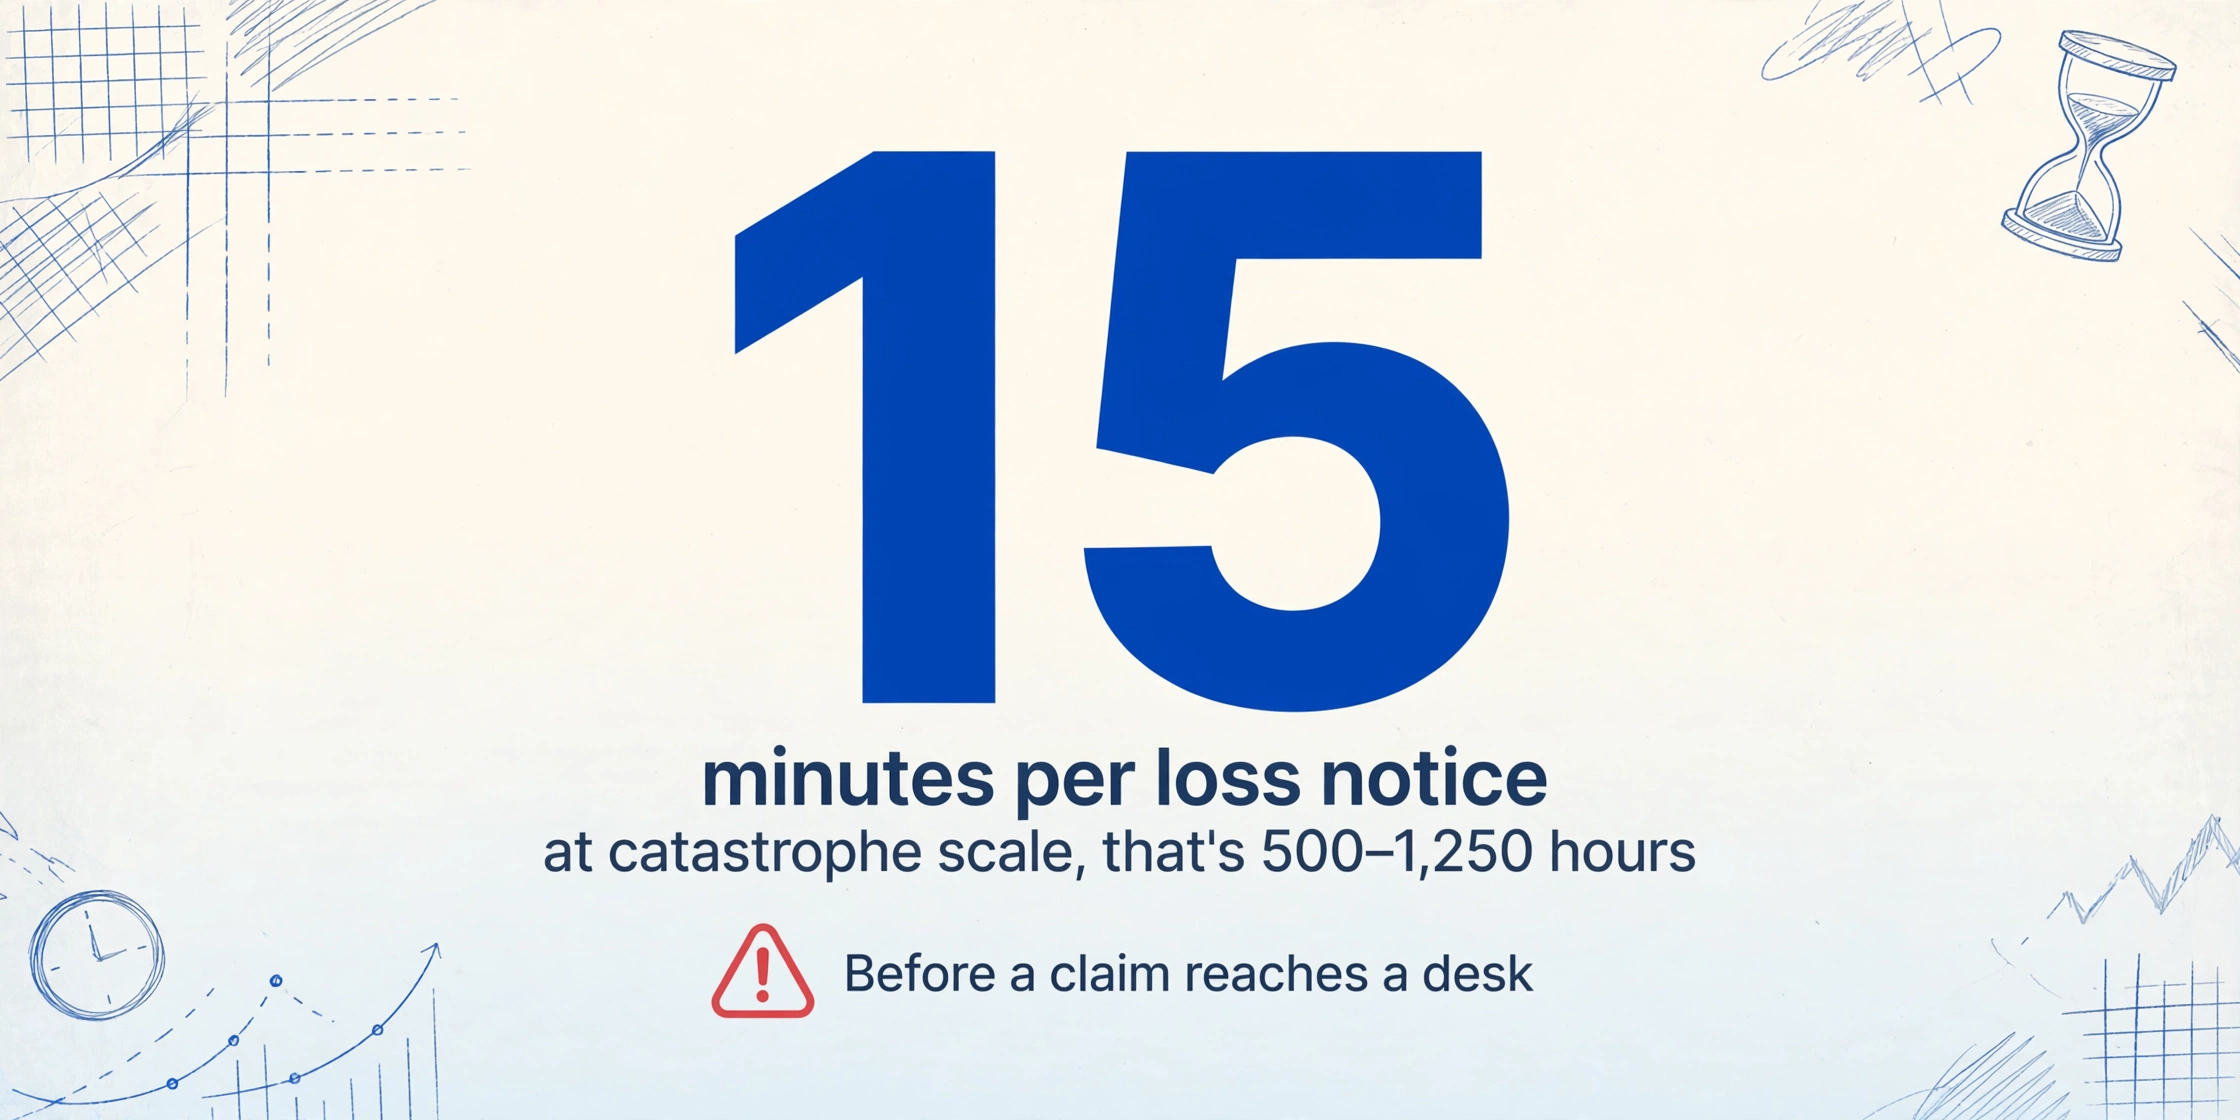
Após uma catástrofe, a matemática quebra. Um único desembarque de furacão pode gerar 200.000–400.000 sinistros de propriedade nos estados afetados. Uma seguradora regional pode receber 2.000–5.000 avisos de sinistro na primeira semana. A 15 minutos por formulário, isso representa 500–1.250 horas de pura entrada de dados antes que um único sinistro chegue à mesa de um ajustador para avaliação real. O processo de sinistro não começa quando o aviso de sinistro é registrado — começa quando os dados estão no sistema.
A dimensão regulatória adiciona uma pressão que a maioria das discussões sobre fluxos de trabalho ignora. O NAIC Unfair Property/Casualty Claims Settlement Practices Model Regulation (Model 902) estabelece que as seguradoras devem reconhecer as reclamações em até 15 dias após a notificação e confirmar ou negar a responsabilidade em um prazo razoável — com pagamento devido em até 30 dias após a confirmação da responsabilidade. Muitos estados impõem padrões mais rígidos: o estatuto da Flórida §626.9541 exige o pagamento de reclamações de propriedade de primeira parte não contestadas em até 60 dias, e prazos semelhantes existem na maioria das jurisdições. Cada dia gasto digitando dados em um sistema é um dia subtraído da janela de investigação. O risco de conformidade não vem da má-fé — vem de uma pilha de formulários não lidos.
O problema não é que as equipes de sinistros sejam lentas. É que a etapa de entrada de dados escala linearmente com o volume de sinistros exatamente no momento em que o volume dispara 10–50x acima da linha de base — e o relógio regulatório corre a partir da data da perda, não da data da entrada de dados.
Os campos do ACORD 140 que importam para a triagem não são os mesmos campos que importam para a subscrição
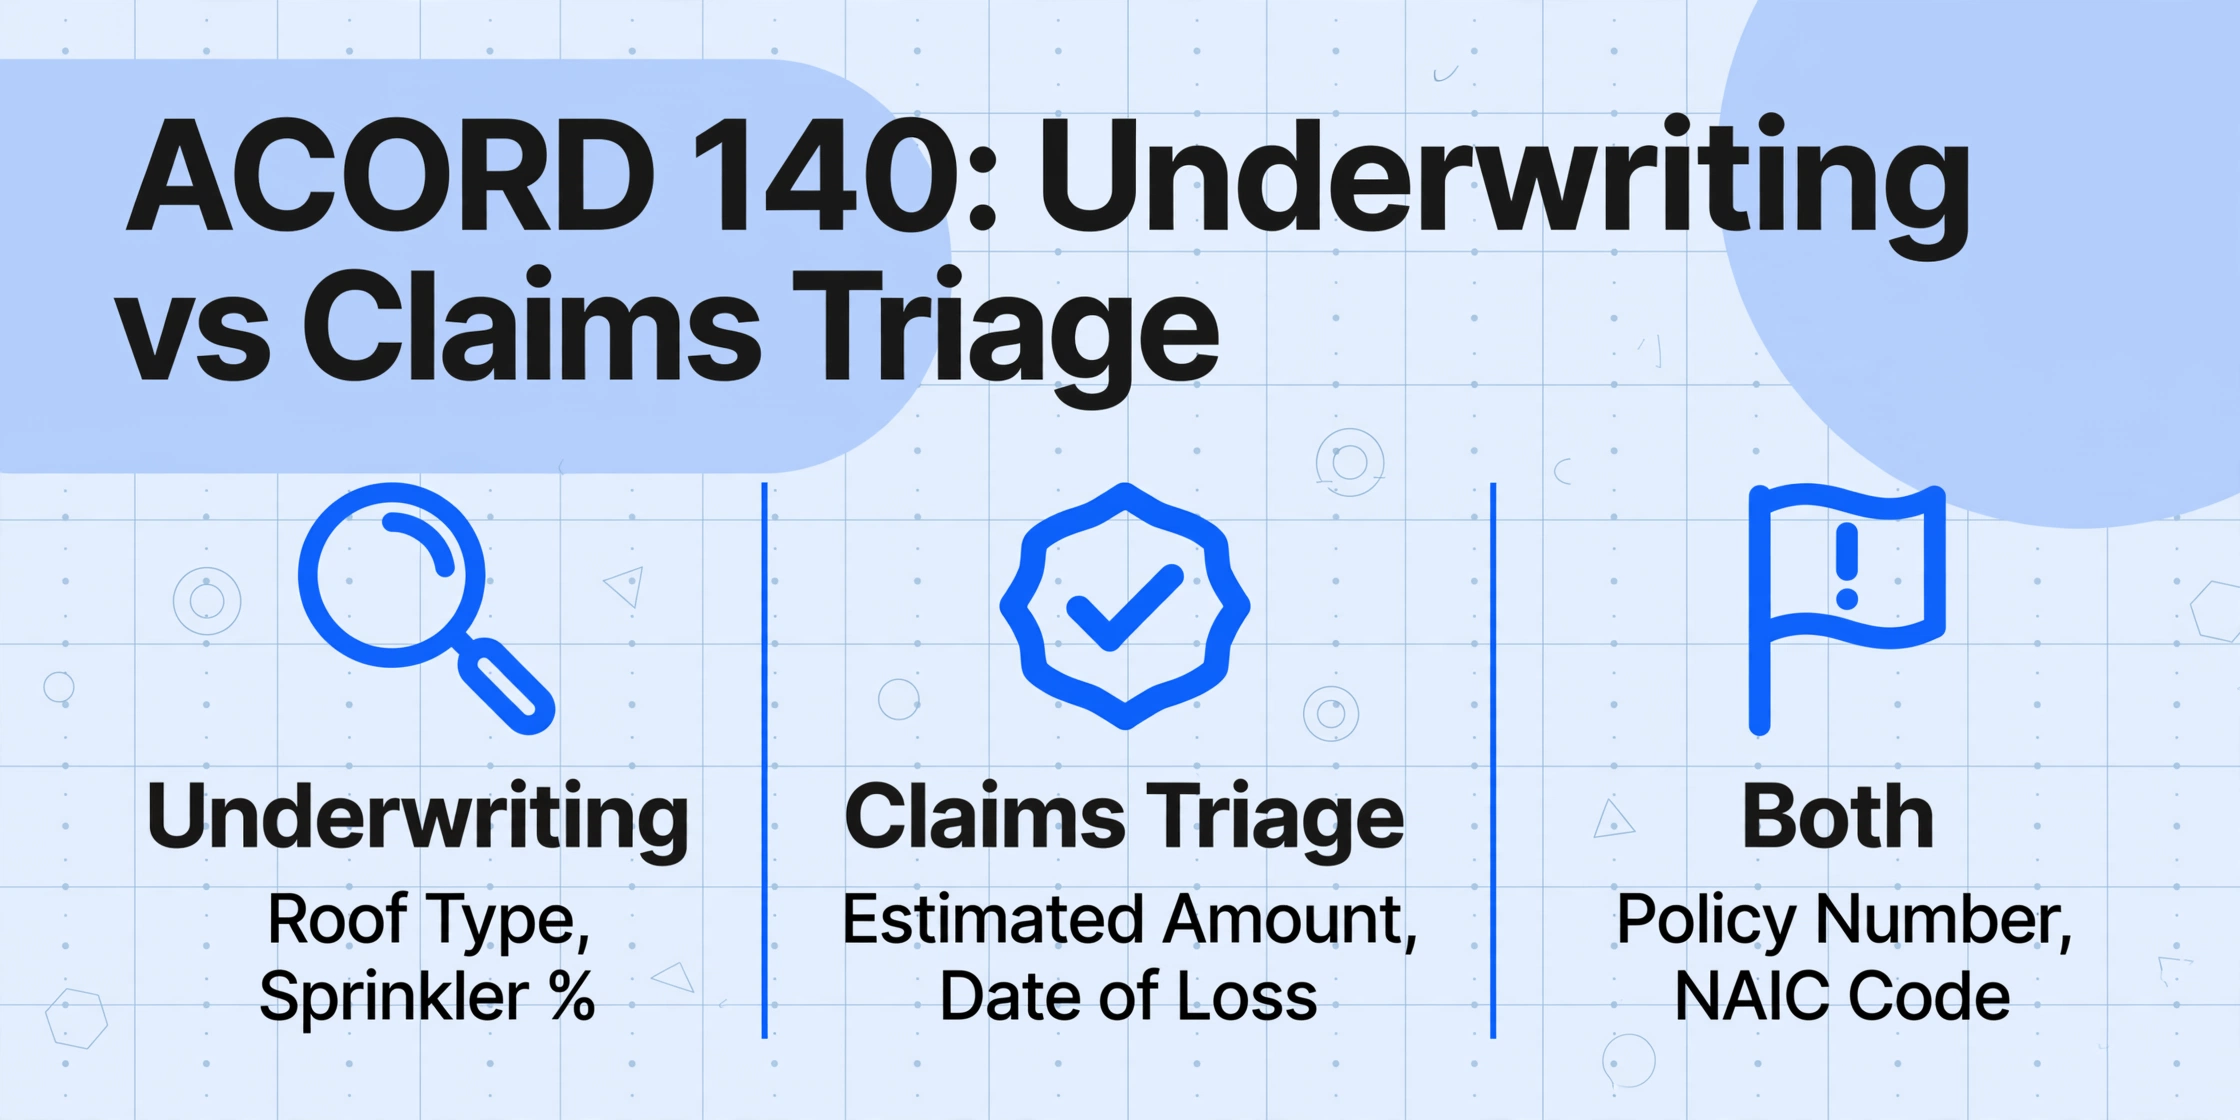
A Seção de Propriedade do ACORD 140 é um formulário denso de várias páginas, originalmente projetado para aplicações de seguro comercial — capturando tipo de construção, ocupação, classe de proteção contra incêndio e seleções de cobertura. Mas quando esse formulário chega em um contexto de sinistros — como documentação de suporte anexada a um aviso de perda de propriedade — os campos que importam para a triagem mudam completamente. Um subscritor precisa saber o tipo de telhado e a porcentagem de sprinklers. Um ajustador de sinistros precisa saber quanto se estima que a perda custará e se alguém se feriu.
Os campos do formulário que orientam as decisões de triagem de sinistros se dividem em quatro níveis:
| Nível de Triagem | Campo | Por que é importante para a triagem |
|---|---|---|
| 1 — Identificação | Número da Apólice, Segurado Nomeado, Nome da Agência, Código NAIC | Sem esses dados, o sinistro não pode ser vinculado a uma apólice nem encaminhado ao ajustador correto. O código NAIC identifica exclusivamente a seguradora — essencial quando várias seguradoras estão envolvidas em um programa em camadas. |
| 1 — Identificação | Endereço do Imóvel / Local da Perda, Número do Estabelecimento, Número do Edifício | Determina a qual território de ajuste o sinistro pertence e se o imóvel está em uma zona de catástrofe declarada. Um endereço incorreto envia o sinistro para a fila errada. |
| 2 — Gravidade | Valor Estimado da Perda, Objeto do Seguro, Limites de Cobertura | A dimensão de classificação mais importante. Sinistros acima do limite de gravidade de uma seguradora (normalmente $50,000–$100,000 para imóveis comerciais) exigem designação de ajustador sênior. Sinistros abaixo podem se qualificar para processamento de mesa ou processamento direto. |
| 2 — Gravidade | Causa da Perda, Data da Perda, Descrição da Perda e Dano | Determina a elegibilidade de cobertura (esse risco está coberto?), sinaliza possível sub-rogação (responsabilidade de terceiros?) e identifica indicadores de fraude. Um sinistro de incêndio com boletim de ocorrência anexado é encaminhado de forma diferente de um sinistro por danos de vento. |
| 3 — Contato | Nome do Contato do Segurado, Telefone Residencial, Telefone Comercial, Quando Contatar | Agendamento do primeiro contato do ajustador. Um número de telefone incorreto nessa etapa gera um atraso de 2 a 3 dias enquanto a equipe de sinistros tenta contato repetidamente. |
| 4 — Referência | Nome e Endereço do Credor Hipotecário / Beneficiário da Perda, Número do Empréstimo | Necessário para a liquidação — o pagamento não pode ser emitido sem confirmar o beneficiário da perda. A ausência disso na entrada significa atraso no pagamento ao final do processo. Extrair agora evita esse atraso. |
A distinção principal: os campos do Nível 1 devem estar 100% corretos antes que qualquer outra etapa prossiga. Um número de apólice errado envia todo o sinistro para a seguradora errada. Os campos do Nível 2 determinam a prioridade de encaminhamento e a designação do ajustador — um sinistro de danos por água de $5,000 nunca deve ficar à frente de um sinistro de incêndio estrutural de $500,000 na fila. Os campos dos Níveis 3 e 4 importam mais tarde, mas podem ser extraídos agora sem custo — capturá-los durante a entrada evita uma segunda análise do mesmo formulário dias depois.
Para uma comparação mais ampla de como os campos de extração diferem entre os tipos de formulários de seguro, nosso guia completo de extração de COI do ACORD 25 percorre a mesma priorização de campos por nível para certificados de responsabilidade.
Configure colunas de extração que correspondam ao seu fluxo de triagem — não ao layout do formulário
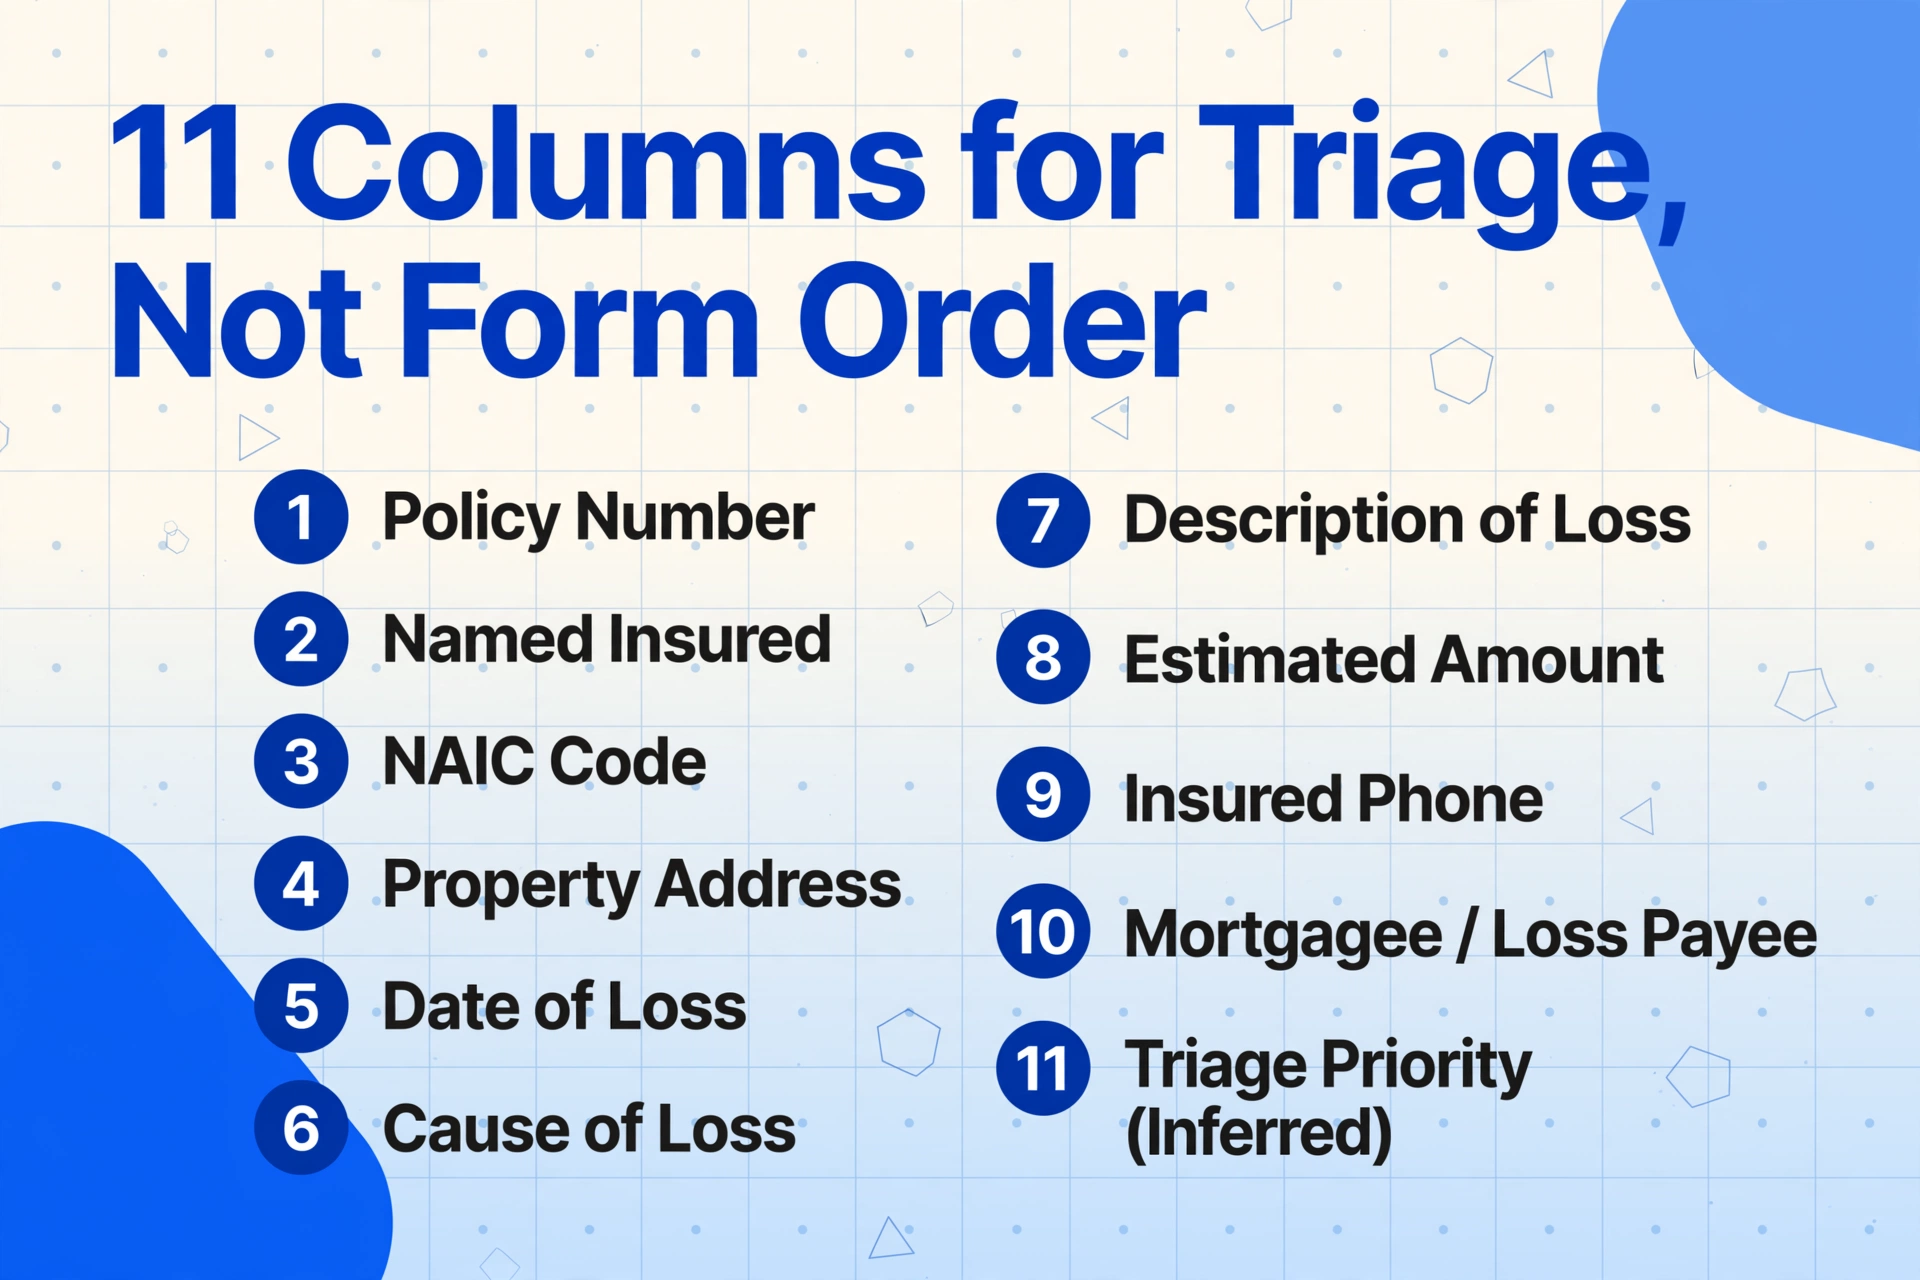
O erro mais comum ao extrair dados estruturados de formulários ACORD é replicar a ordem dos campos do formulário como cabeçalhos de coluna. O formulário agrupa os dados por lógica administrativa (informações da agência primeiro, depois imóvel, depois coberturas). A planilha de triagem precisa agrupar os dados por lógica de decisão — identificação primeiro, gravidade em seguida, contato por último.
Este é o conjunto de colunas para uma extração de ACORD 140 otimizada para triagem:
| Nome da Coluna | Modo de Extração | Função na Triagem |
|---|---|---|
Policy Number | Extração direta | Vincular sinistro à apólice no sistema de administração |
Named Insured | Extração direta | Verificar a identidade do reclamante |
NAIC Code | Extração direta | Validar a seguradora; encaminhar para a equipe de sinistros correta |
Property Address | Extração direta | Atribuir ajustador por território; verificar zona de catástrofe |
Date of Loss | Extração direta | Calcular dias decorridos desde o sinistro; verificar vigência da apólice |
Cause of Loss | Extração direta | Verificação de cobertura; sinalizar sub-rogação; atribuição de código CAT |
Description of Loss | Extração direta | Avaliação de escopo; classificação de gravidade; triagem de fraude |
Estimated Amount | Extração direta | Encaminhamento por gravidade; definição de reserva |
Insured Phone | Extração direta | Agendamento do primeiro contato |
Mortgagee / Loss Payee | Extração direta | Verificação do pagamento da indenização |
Triage Priority | coluna inferida | A IA atribui Urgent / High / Standard / Monitor com base em Estimated Amount e Cause of Loss |
Este conjunto de colunas usa dois modos de extração. A extração direta captura valores impressos explicitamente no formulário — números de apólice, datas, valores em dólar. A IA os localiza entendendo o que cada rótulo de campo significa, então um número de apólice rotulado como "Policy #" no formulário de uma seguradora e "Policy Number" no de outra mapeiam para a mesma coluna. É isso que separa a extração semântica do OCR posicional: ferramentas tradicionais falham quando um campo se move para uma posição diferente em outra versão do formulário; a extração semântica funciona porque lê por significado, não por coordenada.
A coluna inferida — Triage Priority — funciona de forma diferente. A IA lê o Estimated Amount e o Cause of Loss e então aplica lógica de negócio para atribuir um nível de prioridade. Por exemplo: um sinistro de incêndio acima de $100,000 é encaminhado como Urgent; um sinistro de danos por água abaixo de $10,000 é encaminhado como Standard. As regras de classificação ficam na definição da coluna, e a IA as aplica a cada linha do lote — extração e triagem em uma única passagem.
Uma observação operacional: a caixa de descrição de perda manuscrita do ACORD 140 é onde o formulário se torna desafiador. Ajustadores e agentes descrevem os danos com suas próprias palavras, em sua própria caligrafia — "água entrou pelo telhado causando desabamento do teto na área do escritório principal, conteúdo danificado, elétrica pode estar comprometida." O reconhecimento de caligrafia da IA lida com essa variabilidade, mas os nomes das colunas devem ser específicos o suficiente para direcionar a extração ao conteúdo certo. Uma coluna simplesmente chamada "Description" pode capturar qualquer texto descritivo na página — incluindo descrições de edificações destinadas à subscrição. Nomeá-la "Description of Loss" ou "Loss Description" restringe a busca da IA a blocos de texto relacionados a perdas.
Processando um lote: de 100 PDFs a uma planilha em menos de cinco minutos
O fluxo de extração que transforma uma fila de catástrofe em uma planilha de triagem segue cinco etapas. O gargalo de tempo está na etapa um — o upload — porque os arquivos precisam ser transferidos fisicamente. Todo o resto roda no tempo de processamento da IA, que é medido em segundos por formulário, não em minutos.
Os arquivos são processados com segurança e não são armazenados.
Etapa 1 — Envie todos os avisos de perda de uma vez. Arraste a pasta inteira de formulários ACORD — PDFs de agentes, cópias digitalizadas de ajustadores de campo, fotos de relatórios de perda manuscritos — para a área de upload. A ferramenta aceita os formatos PDF, JPG, PNG e WebP, e comprime arquivos grandes automaticamente para uma transferência mais rápida. O upload em lote significa que você seleciona todo o conjunto de uma vez, não um arquivo por vez.
Etapa 2 — Insira os nomes das colunas. Digite ou cole a lista de colunas da tabela acima no painel de definição de colunas. Cada nome de coluna se torna um cabeçalho na planilha de saída e uma instrução de busca para a IA. Você pode salvar esse conjunto de colunas como um modelo uma vez e reutilizá-lo em cada evento de catástrofe futuro — as mesmas 11 colunas funcionam para qualquer lote de avisos de perda ACORD.
Etapa 3 — Revise uma linha de pré-visualização antes de confirmar o lote completo. A IA processa um formulário primeiro e mostra os valores extraídos mapeados para cada coluna. Essa pré-visualização permite confirmar que "Policy Number" capturou o campo correto antes de processar todos os 100 formulários. Se o número da apólice acabou na coluna errada, ajuste o nome da coluna e faça uma nova pré-visualização — o lote ainda não começou.
Etapa 4 — Execute o lote completo. Clique em processar. A IA lê cada formulário, localiza cada campo solicitado por compreensão semântica e preenche a tabela de saída. Um lote de 100 avisos de sinistro é concluído em aproximadamente 2–5 minutos de processamento — em comparação com as 25–30 horas que a mesma tarefa levaria como entrada manual de dados. A taxa de precisão de 99% para texto impresso (conforme os benchmarks publicados da ferramenta) e o forte reconhecimento de escrita manual para entradas cursivas e de caixa mista significam que a tabela de saída é utilizável com validação leve, não correção pesada.
Etapa 5 — Exporte para o Excel. Baixe a tabela concluída como um arquivo XLSX. Cada linha é um aviso de sinistro; cada coluna é um campo extraído. O arquivo exportado é uma única pasta de trabalho — um aviso de sinistro por linha, um campo por coluna, sem células mescladas, sem tabelas dinâmicas, sem formatação que interfira no uso posterior.
É este fluxo de trabalho que transforma o gargalo da triagem de sinistros. As 25 horas de entrada de dados que costumavam consumir os três primeiros dias após uma catástrofe tornam-se 5 minutos de processamento e 30 minutos de validação — liberando 24 horas para a investigação real de sinistros e o envio de reguladores. Para as ferramentas que tornam isso possível, nosso guia sobre como OCR e extração por IA se diferenciam explica por que o OCR tradicional não consegue entregar este fluxo de trabalho e o que mudou com os modelos de linguagem visual.
A planilha de triagem que você constrói: classificação, filtragem e codificação por cores para velocidade de decisão
Uma planilha extraída com dados nela não é um sistema de triagem — é matéria-prima. A planilha se torna uma ferramenta de triagem quando responde a uma pergunta em menos de cinco segundos: qual sinistro precisa de atenção em seguida?
Abra o XLSX exportado e aplique três transformações imediatamente:
Classifique por Valor Estimado em ordem decrescente. A coluna de valor em dólares torna-se o eixo primário de gravidade. Sinistros acima do limite interno de gravidade da seguradora vão para o topo — estes precisam de atribuição a um regulador sênior, possíveis aumentos de reserva e, possivelmente, envio de regulador independente. Sinistros abaixo de alguns milhares de dólares vão para o final — muitas seguradoras encaminham estes para fluxos de trabalho de liquidação automatizada ou de nível administrativo. Uma única operação de classificação substitui o processo manual de abrir cada formulário, ler o campo de estimativa de perda e classificar mentalmente os sinistros uns em relação aos outros.
Filtre por Causa da Perda. Após um furacão, os sinistros se dividem aproximadamente em danos por vento, danos por inundação e ambos. Após um incêndio florestal, a divisão é danos por fogo versus danos por fumaça — dois processos de sinistro fundamentalmente diferentes, com diferentes gatilhos de cobertura e diferentes requisitos de habilidade do regulador. Um único filtro na coluna Causa da Perda agrupa os sinistros por tipo de risco, para que o líder da equipe possa atribuir lotes aos reguladores certos. Sinistros apenas de vento vão para a equipe de propriedades. Sinistros de inundação — se cobertos por uma apólice de inundação separada do NFIP ou privada — são encaminhados para a unidade de inundação. Sinistros com ambos os riscos precisam de uma determinação de cobertura antes do encaminhamento.
Aplique formatação condicional. Codifique por cores a coluna Valor Estimado: vermelho para sinistros acima de $100.000, laranja para $25.000–$100.000, amarelo para abaixo de $25.000. Codifique por cores a coluna Data da Perda: destaque qualquer sinistro em que a perda ocorreu há mais de 14 dias sem uma disposição — isso sinaliza sinistros se aproximando do prazo de reconhecimento do NAIC Model 902 e dá ao líder da equipe uma varredura visual para risco de conformidade.
A planilha resultante é um painel de triagem em tempo real construído a partir de dados de formulários extraídos. O líder da equipe a abre pela manhã, classifica por prioridade e atribui as 20 primeiras linhas aos reguladores disponíveis. Quando novos avisos de sinistro chegam no meio do dia, extraia-os como um lote secundário, anexe as linhas, classifique novamente e a ordem de prioridade é atualizada automaticamente.
Como levar os dados extraídos para o Guidewire, Duck Creek ou sua plataforma de gestão de sinistros
A planilha de triagem responde "o que fazer a seguir". O sistema de gestão de sinistros responde "o que aconteceu neste sinistro". Conectar os dois — tirar os dados extraídos do formulário do Excel e levá-los para a plataforma onde os ajustadores realmente trabalham — é o passo final que transforma uma ferramenta de triagem em parte do fluxo de trabalho de sinistros.
O caminho de integração depende da sua plataforma de sinistros:
Guidewire ClaimCenter — a plataforma de sinistros de P&C mais amplamente implantada entre as seguradoras Tier-1 — oferece suporte à entrada em massa de FNOL por meio de sua camada de API e de ferramentas de importação CSV em seu módulo de ingestão de dados. A planilha exportada da extração mapeia diretamente para os campos de entrada de sinistro do ClaimCenter: Número da Apólice → Consulta de apólice, Nome do Segurado → Verificação do reclamante, Data da Perda → Data do evento de perda, Causa da Perda → Classificação do tipo de sinistro. As equipes de operações de sinistros podem configurar o mapeamento de campos uma vez e depois importar as planilhas extraídas em lotes. As regras de automação de FNOL do Guidewire acionam a atribuição de ajustadores e recomendações de reserva com base nos dados de gravidade já presentes nas linhas importadas.
Duck Creek Claims — a principal concorrente cloud-native do Guidewire — oferece APIs de entrada configuráveis e suporta importações de arquivos flat através de sua camada de integração. O mapeamento de campos segue a mesma lógica: as colunas extraídas mapeiam para o modelo de dados de sinistro do Duck Creek, e as regras de triagem integradas do Duck Creek usam Causa da Perda e Valor Estimado para encaminhar automaticamente os sinistros à fila de ajustadores apropriada.
Snapsheet, BriteCore e outras plataformas de médio porte normalmente suportam importação CSV como método padrão de entrada. A planilha de extração é exportada diretamente para CSV para essas plataformas. Para seguradoras que usam sistemas de sinistros legados com capacidades de importação limitadas, o arquivo Excel extraído ainda acelera o fluxo de trabalho — os ajustadores copiam e colam da planilha de triagem para o sistema de sinistros linha por linha, o que é mais rápido do que ler o formulário original porque todos os campos estão em uma única linha em uma ordem consistente.
O princípio de design fundamental: a etapa de extração produz dados limpos e colunares independentemente do sistema de destino. Se os dados fluem para o Guidewire por uma API, para o Duck Creek por uma importação de arquivo flat ou para um sistema legado por copiar e colar, a saída da extração é o mesmo formato estruturado. O método de integração muda; a captura de dados inicial não.
Perguntas frequentes
O ACORD 140 é o mesmo que um aviso de sinistro de propriedade?
Não exatamente — e a distinção importa para saber quais campos extrair. O ACORD 140 tem o título formal de "Property Section" e foi projetado como anexo do ACORD 125 Commercial Insurance Application. Ele captura dados de subscrição: tipo de construção do imóvel, classe de proteção contra incêndio, limites de cobertura, percentual de cosseguro. Tem três páginas com 355 campos preenchíveis. Um aviso de sinistro de propriedade — às vezes numerado como ACORD 130 na biblioteca de formulários — é um documento separado, projetado especificamente para comunicação de sinistros, com campos como Data do Sinistro, Causa do Sinistro, Descrição dos Danos e Valor Estimado. Na prática, formulários ACORD 140 costumam acompanhar avisos de sinistro no processo de sinistros porque contêm os dados de cobertura e do imóvel de que o regulador de sinistros precisa. O fluxo de extração deste artigo cobre ambos: os campos específicos do aviso de sinistro para triagem (Data do Sinistro, Causa, Descrição, Estimativa) e os campos específicos do 140 para verificação de cobertura (Número da Apólice, Código NAIC, Limites de Cobertura).
Qual é a precisão da extração por IA em descrições de sinistro manuscritas?
O campo de descrição do sinistro do ACORD 140 normalmente é manuscrito — reguladores de sinistros e corretores escrevem narrativas livres descrevendo os danos. A precisão da extração por IA em manuscritos depende da legibilidade: letras de forma bem impressas alcançam altas taxas de precisão comparáveis a texto impresso; caligrafia muito cursiva ou apressada, com rasuras e anotações à margem, produz precisão menor e exige verificação humana. A etapa de pré-visualização no fluxo em lote permite conferir por amostragem a qualidade da caligrafia antes de processar o lote completo. Se a caligrafia de um determinado regulador de sinistros for lida incorretamente de forma consistente, os formulários desse regulador podem ser sinalizados para revisão manual enquanto o restante do lote é processado automaticamente.
Posso reutilizar o mesmo conjunto de colunas para diferentes eventos de catástrofe?
Sim. O conjunto de triagem de 11 colunas descrito acima — de Número da Apólice até Prioridade de Triagem — funciona em qualquer lote de avisos de sinistro de propriedade e formulários ACORD 140, independentemente do tipo de catástrofe. Um aviso de sinistro de furacão contém os mesmos tipos de campo que um aviso de sinistro de incêndio florestal: número da apólice, endereço, data, causa, descrição, valor. Os nomes das colunas não mudam; a IA se adapta ao conteúdo de cada formulário. Salve o conjunto de colunas como modelo após o primeiro uso e carregue-o instantaneamente para cada evento seguinte.
E se o formulário tiver campos ausentes — sem valor estimado ou sem causa da perda listada?
A extração por IA deixa a célula em branco quando um campo solicitado não está presente no formulário — ela não inventa dados. Uma célula Valor Estimado em branco é um sinal para marcar essa reclamação para acompanhamento imediato, porque a gravidade não pode ser avaliada sem ela. Uma célula Causa da Perda em branco pode significar que o formulário foi enviado antes de a causa ser determinada — comum nas primeiras 24 horas após uma catástrofe, quando a prioridade é simplesmente notificar a seguradora de que ocorreu uma perda. Classifique as células em branco no topo da planilha de triagem para que recebam atenção primeiro.
Como isso se compara ao uso de uma plataforma empresarial de recebimento de sinistros?
Plataformas empresariais como Guidewire ClaimCenter e Duck Creek Claims oferecem gestão de sinistros de ponta a ponta — recebimento de FNOL, atribuição de ajustador, acompanhamento de reservas, processamento de pagamentos e relatórios. Seus módulos de recebimento podem receber dados estruturados, mas não conseguem extraí-los de um PDF não estruturado. A etapa de extração descrita neste artigo é a camada que fica antes do sistema de sinistros: ela transforma PDFs em linhas estruturadas que o sistema de sinistros pode ingerir. Para seguradoras que usam plataformas empresariais, a extração alimenta a plataforma. Para seguradoras menores e empresas de ajuste independentes sem um sistema empresarial, a própria planilha de triagem pode funcionar como um rastreador leve de recebimento de sinistros.