Cómo extraer avisos de pérdida ACORD 140
a Excel para el triaje de reclamaciones
Las primeras 72 horas después de un huracán, incendio forestal o inundación son cuando las decisiones sobre reclamaciones de propiedad tienen más peso, y cuando el proceso de reclamaciones avanza más lento. La razón es estructural, no procesal: los avisos de pérdida de propiedad llegan como PDFs de agentes, corredores y asegurados. Cada uno debe leerse, registrarse en una hoja de cálculo o sistema de gestión de reclamaciones, y priorizarse antes de que alguien pueda inspeccionar una propiedad. Los datos de Insurance Services Office (ISO) Property Claim Services muestran que la industria procesó aproximadamente 3.5 millones de reclamaciones solo en los primeros tres trimestres de 2025 (Verisk, 2026). Tras una catástrofe con decenas de miles de propiedades afectadas, la pila de avisos de pérdida esperando entrada de datos es el verdadero cuello de botella — no la capacidad de inspección, no la disponibilidad de ajustadores, sino las horas dedicadas a teclear campos de formularios en una pantalla.
Conclusiones clave
- Después de un huracán, 200,000 reclamaciones de propiedad llegan en una sola semana — y ninguna puede investigarse hasta que alguien teclee el número de póliza, la estimación de pérdida y la descripción de la causa desde un PDF a una hoja de cálculo.
- A 15 minutos por formulario, 5,000 avisos de pérdida consumen 1,250 horas de entrada de datos — y el reloj regulatorio de la National Association of Insurance Commissioners (NAIC) que determina el cumplimiento de la aseguradora corre desde la fecha de la pérdida, no desde la fecha de entrada de datos.
- La extracción semántica con IA lee los campos ACORD 140 por lo que significan, no por dónde están en la página — convirtiendo 100 avisos de pérdida en una hoja de cálculo de triaje ordenable con indicadores de gravedad y alertas de plazos en menos de cinco minutos.
Los formularios ACORD son la columna vertebral del intercambio de datos de seguros en Norteamérica: más de 170 formularios estandarizados, mantenidos por la Association for Cooperative Operations Research and Development, que cubren desde solicitudes comerciales hasta certificados de seguro y avisos de pérdida. Para reclamos de propiedad, el aviso de pérdida ACORD es el documento que captura la información del asegurado, los detalles de la pérdida, la causa, la descripción de los daños y la estimación inicial: los datos que determinan cómo se clasifica y se enruta un reclamo. En seguros comerciales, el formulario relacionado ACORD 140 Property Section contiene datos detallados de edificios y cobertura en tres páginas con 355 campos rellenables.
Este artículo explica cómo extraer avisos de pérdida de propiedad y datos del ACORD 140 a una hoja de cálculo Excel de triaje estructurada: un flujo de trabajo que convierte la pila de formularios posterior a una catástrofe de una cola de entrada de datos en una lista de acciones ordenada por prioridad. El mismo enfoque aplica a otros tipos de formularios ACORD: nuestras guías sobre extracción de datos ACORD 25 COI a Excel y extracción de evidencia de seguro de propiedad ACORD 27 cubren el mismo flujo de extracción basado en columnas para diferentes documentos de seguros.
La entrada manual de datos falla a escala de catástrofe, no por falta de paciencia, sino por física
Los equipos de reclamos de seguros saben desde hace años que la entrada manual de datos es su mayor carga operativa. Lo que se discute menos es por qué falla catastróficamente en el momento en que más importa — después de un desastre — y qué significa el reloj regulatorio para cada hora perdida en leer formularios.
Los ajustadores de reclamos dedican el 35–45% de su jornada laboral al manejo de datos en lugar de decisiones reales de reclamos, según estudios de flujo de trabajo de proveedores de automatización de seguros. Para un ajustador de escritorio con una carga de casos estándar, eso se traduce en aproximadamente 3–4 horas al día leyendo, escribiendo y verificando datos de formularios. Las matemáticas para un solo aviso de pérdida: 12–18 minutos para localizar y transcribir número de póliza, nombre del asegurado, ubicación de la pérdida, fecha de pérdida, causa, descripción de la pérdida y monto estimado de un formulario ACORD de varias páginas — multiplicado por el número de reclamos en cola.
Después de una catástrofe, las matemáticas se rompen. Un solo huracán puede generar 200,000–400,000 reclamos de propiedad en los estados afectados. Una aseguradora regional podría recibir 2,000–5,000 avisos de pérdida en la primera semana. A 15 minutos por formulario, eso son 500–1,250 horas de entrada de datos pura antes de que un solo reclamo llegue al escritorio de un ajustador para evaluación real. El proceso de reclamos no comienza cuando se presenta el aviso de pérdida — comienza cuando los datos están en el sistema.
La dimensión regulatoria añade una presión que la mayoría de las discusiones sobre flujos de trabajo pasan por alto. La Regulación Modelo 902 de NAIC sobre Prácticas Injustas de Liquidación de Reclamaciones de Propiedad/Casualidad establece que las aseguradoras deben acusar recibo de las reclamaciones dentro de los 15 días posteriores a la notificación y afirmar o negar la responsabilidad en un plazo razonable — con el pago debido dentro de los 30 días posteriores a afirmar la responsabilidad. Muchos estados imponen estándares más estrictos: el estatuto de Florida §626.9541 exige el pago de reclamaciones de propiedad de primera parte no disputadas dentro de los 60 días, y existen plazos similares en la mayoría de las jurisdicciones. Cada día dedicado a capturar datos en un sistema es un día restado a la ventana de investigación. El riesgo de cumplimiento no proviene de la mala fe — proviene de una pila de formularios sin leer.
El problema no es que los equipos de reclamaciones sean lentos. Es que el paso de captura de datos escala linealmente con el volumen de reclamaciones precisamente en el momento en que el volumen se dispara 10–50x por encima de la línea base — y el reloj regulatorio corre desde la fecha de la pérdida, no desde la fecha de captura de datos.
Los campos de ACORD 140 que importan para el triaje no son los mismos que importan para la suscripción
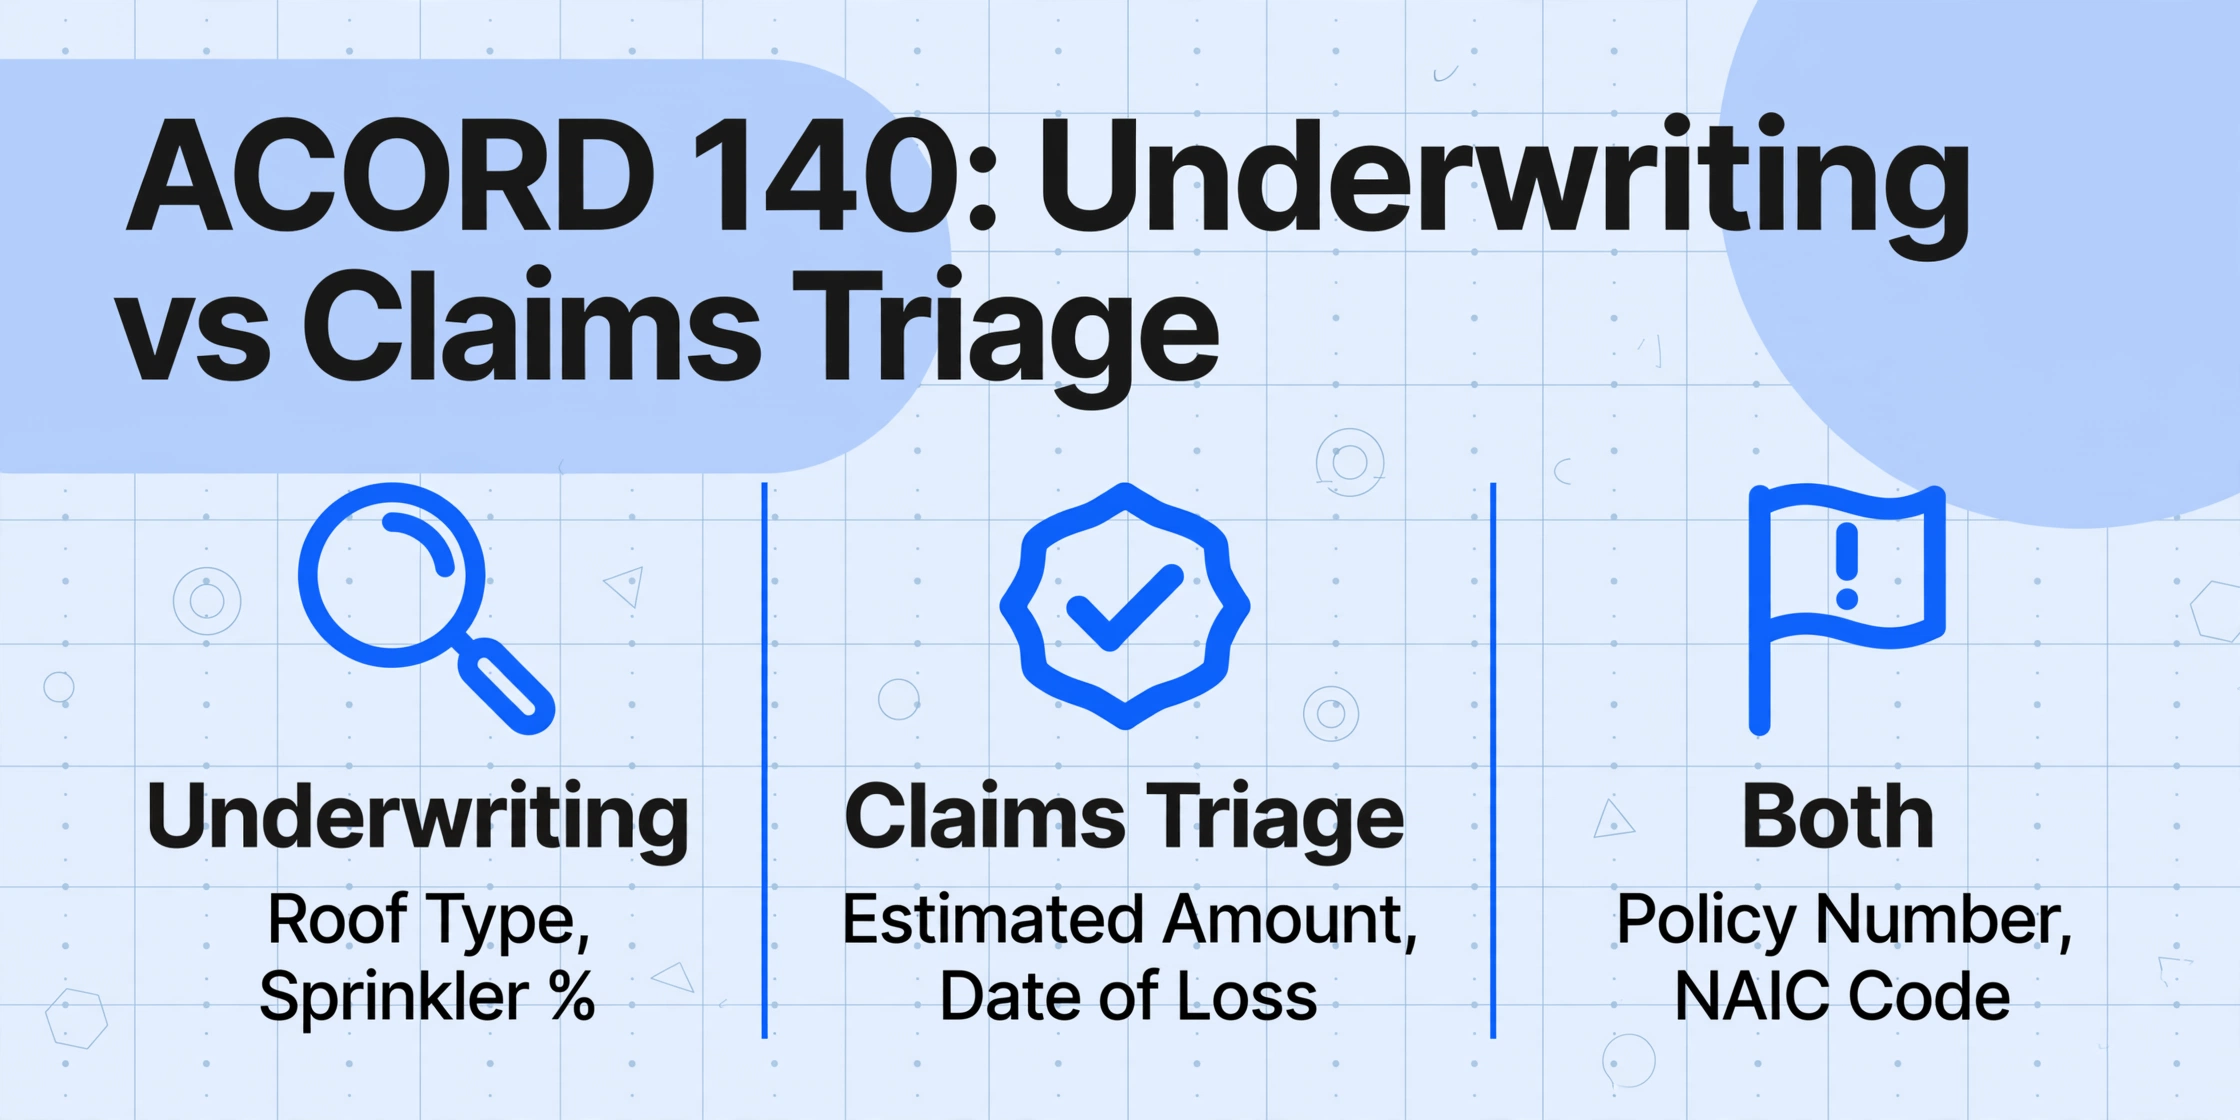
La Sección de Propiedad de ACORD 140 es un formulario denso de varias páginas diseñado originalmente para solicitudes de seguros comerciales — capturando tipo de construcción, ocupación, clase de protección contra incendios y selecciones de cobertura. Pero cuando este formulario llega en un contexto de reclamaciones — como documentación de respaldo adjunta a un aviso de pérdida de propiedad — los campos que importan para el triaje cambian por completo. Un suscriptor necesita saber el tipo de techo y el porcentaje de rociadores. Un ajustador de reclamaciones necesita saber cuánto se estima que costará la pérdida y si alguien resultó herido.
Los campos del formulario que impulsan las decisiones de triaje de reclamaciones se dividen en cuatro niveles:
| Nivel de triaje | Campo | Por qué importa para el triaje |
|---|---|---|
| 1 — Identificación | Número de póliza, Asegurado designado, Nombre de la agencia, Código NAIC | Sin estos, el reclamo no puede vincularse a una póliza ni enviarse al ajustador correcto. El código NAIC identifica de forma única a la aseguradora, algo esencial cuando hay varias aseguradoras en un programa por capas. |
| 1 — Identificación | Dirección de la propiedad / Ubicación de la pérdida, Número de local, Número de edificio | Determina a qué territorio de ajustadores pertenece el reclamo y si la propiedad está en una zona de catástrofe declarada. Una dirección incorrecta envía el reclamo a la cola equivocada. |
| 2 — Gravedad | Monto estimado de la pérdida, Objeto del seguro, Límites de cobertura | La dimensión de clasificación más importante. Los reclamos por encima del umbral de gravedad de la aseguradora (normalmente $50,000–$100,000 para propiedad comercial) requieren la asignación de un ajustador sénior. Los reclamos por debajo pueden calificar para procesamiento a nivel de escritorio o directo. |
| 2 — Gravedad | Causa de la pérdida, Fecha de la pérdida, Descripción de la pérdida y los daños | Determina la elegibilidad de cobertura (¿está cubierto este riesgo?), señala posible subrogación (¿responsabilidad de terceros?) e identifica indicadores de fraude. Una pérdida por incendio con informe policial adjunto se envía de forma distinta a un reclamo por daños de viento. |
| 3 — Contacto | Nombre de contacto del asegurado, Teléfono de residencia, Teléfono comercial, Cuándo contactar | Programar el primer contacto del ajustador. Un número de teléfono incorrecto en esta etapa genera un retraso de 2 a 3 días mientras el equipo de reclamos juega al teléfono. |
| 4 — Referencia | Nombre y dirección del acreedor hipotecario / beneficiario de la pérdida, Número de préstamo | Requerido para el pago: no se puede emitir el pago sin confirmar al beneficiario de la pérdida. Si falta esto en la recepción, habrá un retraso en el pago al final del proceso. Extraerlo ahora evita ese retraso. |
La distinción clave: los campos del Nivel 1 deben ser 100% precisos antes de que cualquier otro paso pueda continuar. Un número de póliza incorrecto envía todo el reclamo a la aseguradora equivocada. Los campos del Nivel 2 determinan la prioridad de enrutamiento y la asignación del ajustador: un reclamo de $5,000 por daños de agua nunca debería estar delante de un reclamo de $500,000 por incendio estructural en la cola. Los campos de los Niveles 3 y 4 importan más adelante, pero son gratuitos de extraer ahora: capturarlos durante la recepción evita tener que revisar el mismo formulario días después.
Para una comparación más amplia de cómo difieren los campos de extracción entre tipos de formularios de seguros, nuestra guía completa de extracción de ACORD 25 COI recorre la misma priorización de campos por niveles para certificados de responsabilidad.
Configura columnas de extracción que se ajusten a tu flujo de triaje, no al diseño del formulario
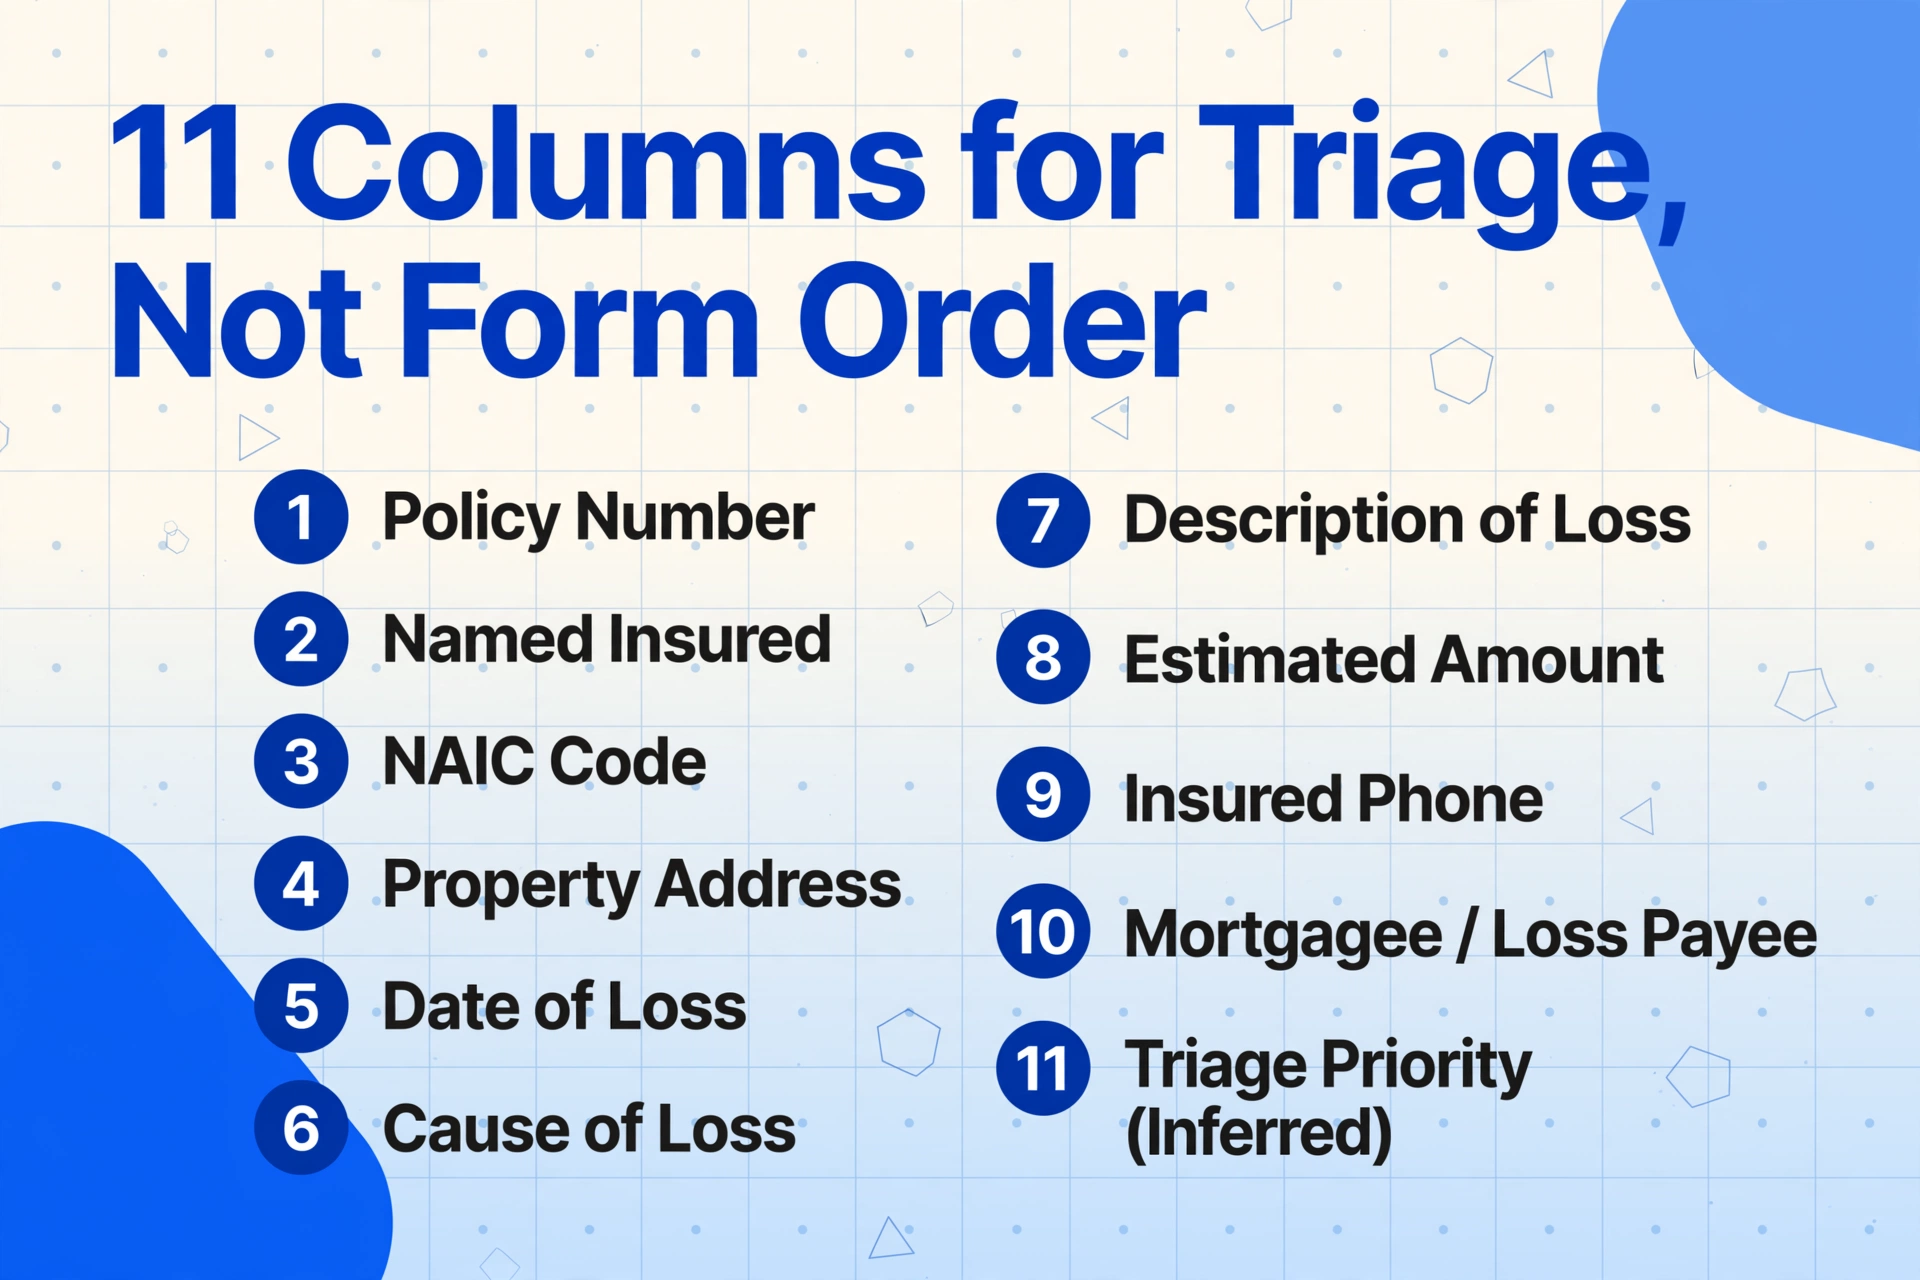
El error más común al extraer datos estructurados de formularios ACORD es replicar el orden de campos del formulario como encabezados de columna. El formulario agrupa datos por lógica administrativa (información de la agencia primero, luego premisas, luego coberturas). La hoja de cálculo de triaje necesita agrupar datos por lógica de decisión: identificación primero, severidad después, contacto al final.
Este es el conjunto de columnas para una extracción de ACORD 140 optimizada para triaje:
| Nombre de Columna | Modo de Extracción | Función de Triaje |
|---|---|---|
Policy Number | Extracción directa | Vincular reclamo a póliza en el sistema administrativo |
Named Insured | Extracción directa | Verificar identidad del reclamante |
NAIC Code | Extracción directa | Validar aseguradora; enrutar al equipo de reclamos correcto |
Property Address | Extracción directa | Asignar ajustador por territorio; verificar zona de catástrofe |
Date of Loss | Extracción directa | Calcular días transcurridos desde la pérdida; verificar período de póliza |
Cause of Loss | Extracción directa | Verificación de cobertura; indicador de subrogación; asignación de código CAT |
Description of Loss | Extracción directa | Evaluación de alcance; clasificación de severidad; detección de fraude |
Estimated Amount | Extracción directa | Enrutamiento por severidad; establecimiento de reservas |
Insured Phone | Extracción directa | Programación del primer contacto |
Mortgagee / Loss Payee | Extracción directa | Verificación de pago de liquidación |
Triage Priority | columna inferida | La IA asigna Urgente / Alta / Estándar / Monitoreo según el Monto Estimado y la Causa de Pérdida |
Este conjunto de columnas usa dos modos de extracción. La extracción directa obtiene valores impresos explícitamente en el formulario: números de póliza, fechas, montos en dólares. La IA los localiza comprendiendo qué significa cada etiqueta de campo, de modo que un número de póliza etiquetado como "Policy #" en el formulario de una aseguradora y "Policy Number" en otro se asignan a la misma columna. Esto es lo que distingue la extracción semántica del OCR posicional: las herramientas tradicionales fallan cuando un campo se mueve a una posición diferente en otra versión del formulario; la extracción semántica tiene éxito porque lee por significado, no por coordenadas.
La columna inferida — Prioridad de Triaje — funciona de manera diferente. La IA lee el Monto Estimado y la Causa de Pérdida, luego aplica lógica de negocio para asignar un nivel de prioridad. Por ejemplo: una pérdida por incendio superior a $100,000 se enruta como Urgente; un reclamo por daño de agua inferior a $10,000 se enruta como Estándar. Las reglas de clasificación viven en la definición de la columna, y la IA las aplica a cada fila del lote: extracción y triaje en una sola pasada.
Una nota operativa: el cuadro de descripción de pérdida manuscrita del ACORD 140 es donde el formulario se vuelve complicado. Los ajustadores y agentes describen los daños con sus propias palabras y su propia letra — "el agua entró por el techo causando el colapso del cielo raso en el área de la oficina principal, contenido dañado, el sistema eléctrico puede estar comprometido". El reconocimiento de escritura a mano de la IA maneja esta variabilidad, pero los nombres de las columnas deben ser lo suficientemente específicos para guiar la extracción hacia el contenido correcto. Una columna simplemente llamada "Descripción" puede capturar cualquier texto descriptivo en la página — incluyendo descripciones del edificio destinadas a la suscripción. Nombrarla "Descripción de la Pérdida" o "Descripción de Pérdida" reduce la búsqueda de la IA a bloques de texto relacionados con la pérdida.
Procesamiento de un lote: de 100 PDFs a una hoja de cálculo en menos de cinco minutos
El flujo de trabajo de extracción que convierte una cola de catástrofe en una hoja de cálculo de triaje sigue cinco pasos. El cuello de botella de tiempo está en el paso uno — la carga — porque los archivos deben transferirse físicamente. Todo lo demás se ejecuta en tiempo de procesamiento de IA, que se mide en segundos por formulario, no en minutos.
Los archivos se procesan de forma segura y no se almacenan.
Paso 1 — Carga todos los avisos de pérdida a la vez. Arrastra la carpeta completa de formularios ACORD — PDFs de agentes, copias escaneadas de ajustadores de campo, fotos de informes de pérdida manuscritos — al área de carga. La herramienta acepta formatos PDF, JPG, PNG y WebP, y comprime archivos grandes automáticamente para una transferencia más rápida. La carga por lotes significa que seleccionas todo el conjunto a la vez, no un archivo a la vez.
Paso 2 — Ingresa los nombres de tus columnas. Escribe o pega la lista de columnas de la tabla anterior en el panel de definición de columnas. Cada nombre de columna se convierte en un encabezado en la hoja de cálculo de salida y en una instrucción de búsqueda para la IA. Puedes guardar este conjunto de columnas como plantilla una vez y reutilizarlo para cada futuro evento de catástrofe — las mismas 11 columnas funcionan para cualquier lote de avisos de pérdida ACORD.
Paso 3 — Revisa una fila de vista previa antes de comprometer el lote completo. La IA procesa primero un formulario y muestra los valores extraídos asignados a cada columna. Esta vista previa te permite confirmar que "Número de Póliza" capturó el campo correcto antes de procesar los 100 formularios. Si el número de póliza terminó en la columna equivocada, ajusta el nombre de la columna y vuelve a previsualizar — el lote aún no ha comenzado.
Paso 4 — Ejecutar el lote completo. Haga clic en procesar. La IA lee cada formulario, localiza cada campo solicitado mediante comprensión semántica y completa la tabla de salida. Un lote de 100 avisos de pérdida se completa en aproximadamente 2 a 5 minutos de tiempo de procesamiento, en comparación con las 25 a 30 horas que la misma tarea tomaría como ingreso manual de datos. La cifra de precisión del 99% para texto impreso (según los puntos de referencia publicados de la herramienta) y el sólido reconocimiento de escritura a mano para entradas en cursiva y mayúsculas y minúsculas significan que la tabla de salida es utilizable con una validación ligera, no con una corrección exhaustiva.
Paso 5 — Exportar a Excel. Descargue la tabla completada como un archivo XLSX. Cada fila es un aviso de pérdida; cada columna es un campo extraído. El archivo exportado es un libro de trabajo único: un aviso de pérdida por fila, un campo por columna, sin celdas combinadas, sin tablas dinámicas, sin formato que interfiera con el uso posterior.
Este flujo de trabajo es lo que transforma el cuello de botella en la recepción de reclamaciones. Las 25 horas de ingreso de datos que solían consumir los primeros tres días después de una catástrofe se convierten en 5 minutos de tiempo de procesamiento y 30 minutos de validación, liberando 24 horas para la investigación real de reclamaciones y el envío de ajustadores. Para las herramientas que hacen posible esto, nuestra guía sobre cómo difieren el OCR y la extracción con IA explica por qué el OCR tradicional no puede ofrecer este flujo de trabajo y qué cambió con los modelos de visión y lenguaje.
La hoja de cálculo de clasificación que usted crea: ordenar, filtrar y codificar con colores para tomar decisiones rápidas
Una hoja de cálculo extraída con datos no es un sistema de clasificación: es materia prima. La hoja de cálculo se convierte en una herramienta de clasificación cuando responde una pregunta en menos de cinco segundos: ¿qué reclamación necesita atención a continuación?
Abra el XLSX exportado y aplique tres transformaciones de inmediato:
Ordene por Monto Estimado en orden descendente. La columna de cifras en dólares se convierte en el eje principal de gravedad. Las reclamaciones por encima del umbral interno de gravedad de la aseguradora se ordenan al principio; estas necesitan asignación de ajustadores senior, posibles aumentos de reservas y posiblemente el envío de ajustadores independientes. Las reclamaciones por debajo de unos pocos miles de dólares se ordenan al final; muchas aseguradoras las enrutan a flujos de trabajo de liquidación a nivel de escritorio o automatizados. Una sola operación de ordenamiento reemplaza el proceso manual de abrir cada formulario, leer el campo de estimación de pérdida y clasificar mentalmente las reclamaciones entre sí.
Filtre por Causa de Pérdida. Después de un huracán, las reclamaciones se dividen aproximadamente en daños por viento, daños por inundación y ambos. Después de un incendio forestal, la división es entre daños por fuego y daños por humo: dos procesos de reclamaciones fundamentalmente diferentes con diferentes activadores de cobertura y diferentes requisitos de habilidad del ajustador. Un solo filtro en la columna Causa de Pérdida agrupa las reclamaciones por tipo de peligro para que el líder del equipo pueda asignar lotes a los ajustadores correctos. Las reclamaciones solo por viento van al equipo de propiedad. Las reclamaciones por inundación, si están cubiertas por una póliza NFIP o de inundación privada separada, se enrutan a la unidad de inundaciones. Las reclamaciones con ambos peligros necesitan una determinación de cobertura antes de enrutarse.
Aplique formato condicional. Codifique con colores la columna Monto Estimado: rojo para reclamaciones superiores a $100,000, naranja para $25,000–$100,000, amarillo para menos de $25,000. Codifique con colores la columna Fecha de Pérdida: resalte cualquier reclamación donde la pérdida ocurrió hace más de 14 días sin una disposición; esto señala las reclamaciones que se acercan a la fecha límite de reconocimiento del Modelo 902 de la NAIC y le da al líder del equipo un escaneo visual para el riesgo de cumplimiento.
La hoja de cálculo resultante es un panel de clasificación en tiempo real construido a partir de datos de formularios extraídos. El líder del equipo la abre por la mañana, ordena por prioridad y asigna las 20 filas principales a los ajustadores disponibles. Cuando llegan nuevos avisos de pérdida a mitad del día, extráigalos como un lote secundario, agregue las filas, vuelva a ordenar y el orden de prioridad se actualiza automáticamente.
Cómo llevar los datos extraídos a Guidewire, Duck Creek o tu plataforma de gestión de siniestros
La hoja de cálculo de triaje responde "qué hacer a continuación". El sistema de gestión de siniestros responde "qué ocurrió en este siniestro". Unir ambos — sacar los datos extraídos de los formularios de Excel y llevarlos a la plataforma donde los ajustadores trabajan realmente — es el paso final que convierte una herramienta de triaje en parte del flujo de trabajo de siniestros.
La ruta de integración depende de tu plataforma de siniestros:
Guidewire ClaimCenter — la plataforma de siniestros P&C más implementada entre las aseguradoras Tier-1 — admite la captación masiva de FNOL a través de su capa de API y de las herramientas de importación CSV de su módulo de ingesta de datos. La hoja de cálculo exportada desde la extracción se asigna directamente a los campos de captación de siniestros de ClaimCenter: Número de Póliza → búsqueda de Póliza, Nombre del Asegurado → verificación del Reclamante, Fecha del Siniestro → fecha del Evento de Pérdida, Causa de la Pérdida → clasificación del Tipo de Siniestro. Los equipos de operaciones de siniestros pueden configurar la asignación de campos una vez y luego importar las hojas de cálculo extraídas como lotes. Las reglas de automatización de FNOL de Guidewire activan la asignación de ajustadores y las recomendaciones de reservas según los datos de gravedad ya presentes en las filas importadas.
Duck Creek Claims — el principal competidor cloud-native de Guidewire — ofrece APIs de captación configurables y admite importaciones de archivos planos a través de su capa de integración. La asignación de campos sigue la misma lógica: las columnas extraídas se asignan al modelo de datos de siniestros de Duck Creek, y las reglas de triaje integradas de Duck Creek usan Causa de la Pérdida y Monto Estimado para enrutar automáticamente los siniestros a la cola de ajustadores correspondiente.
Snapsheet, BriteCore y otras plataformas de mercado medio suelen admitir la importación CSV como método de captación estándar. La hoja de cálculo de extracción se exporta directamente a CSV para estas plataformas. Para aseguradoras con sistemas de siniestros heredados con capacidades de importación limitadas, el archivo Excel extraído sigue acelerando el flujo de trabajo — los ajustadores copian y pegan desde la hoja de cálculo de triaje al sistema de siniestros fila por fila, lo que es más rápido que leer el formulario original porque todos los campos están en una sola fila en un orden consistente.
El principio de diseño clave: el paso de extracción produce datos limpios y en columnas independientemente del sistema de destino. Ya sea que los datos fluyan a Guidewire a través de una API, a Duck Creek mediante una importación de archivo plano, o a un sistema heredado mediante copiar y pegar, la salida de extracción es el mismo formato estructurado. El método de integración cambia; la captura inicial de datos no.
Preguntas frecuentes
¿El ACORD 140 es lo mismo que un aviso de pérdida de propiedad?
No exactamente — y la distinción importa para saber qué campos extraer. El ACORD 140 se titula formalmente "Sección de Propiedad" y está diseñado como anexo a la Solicitud de Seguro Comercial ACORD 125. Captura datos de suscripción: tipo de construcción, clase de protección contra incendios, límites de cobertura, porcentaje de coseguro. Tiene tres páginas con 355 campos rellenables. Un aviso de pérdida de propiedad — a veces numerado ACORD 130 en la biblioteca de formularios — es un documento separado diseñado específicamente para el reporte de reclamos, con campos como Fecha de Pérdida, Causa de Pérdida, Descripción del Daño y Monto Estimado. En la práctica, los formularios ACORD 140 suelen acompañar a los avisos de pérdida en el expediente de reclamos porque contienen los datos de cobertura y propiedad que el ajustador necesita. El flujo de extracción de este artículo cubre ambos: los campos específicos del aviso de pérdida para triaje (Fecha de Pérdida, Causa, Descripción, Estimación) y los campos específicos del 140 para verificación de cobertura (Número de Póliza, Código NAIC, Límites de Cobertura).
¿Qué tan precisa es la extracción con IA en descripciones de pérdida manuscritas?
El campo de descripción de pérdida del ACORD 140 suele estar manuscrito — los ajustadores y agentes escriben narrativas libres describiendo el daño. La precisión de la extracción con IA en escritura a mano depende de la legibilidad: las letras de molde claramente impresas logran tasas de precisión altas comparables al texto impreso; la escritura muy cursiva o apresurada con tachaduras y notas al margen produce menor precisión y requiere verificación humana. El paso de vista previa en el flujo por lotes te permite revisar la calidad de la escritura antes de comprometer el lote completo. Si la escritura de un ajustador en particular se malinterpreta constantemente, los formularios de ese ajustador pueden marcarse para revisión manual mientras el resto del lote se procesa automáticamente.
¿Puedo reutilizar el mismo conjunto de columnas para diferentes eventos de catástrofe?
Sí. El conjunto de triaje de 11 columnas descrito anteriormente — Número de Póliza hasta Prioridad de Triaje — funciona con cualquier lote de avisos de pérdida de propiedad y formularios ACORD 140, independientemente del tipo de catástrofe. Un aviso de pérdida por huracán contiene los mismos tipos de campos que un aviso de pérdida por incendio forestal: número de póliza, dirección, fecha, causa, descripción, monto. Los nombres de las columnas no cambian; la IA se adapta al contenido de cada formulario. Guarda el conjunto de columnas como plantilla después del primer uso y cárgalo al instante para cada evento posterior.
¿Qué pasa si el formulario tiene campos faltantes — sin monto estimado o sin causa de pérdida indicada?
La extracción con IA deja la celda en blanco cuando un campo solicitado no está presente en el formulario — no inventa datos. Una celda de Monto Estimado en blanco es una señal para marcar ese reclamo para seguimiento inmediato, porque la severidad no puede evaluarse sin ella. Una celda de Causa de Pérdida en blanco puede significar que el formulario se envió antes de que se determinara la causa — algo común en las primeras 24 horas después de una catástrofe, cuando la prioridad es simplemente notificar a la aseguradora que ocurrió una pérdida. Ordena las celdas en blanco al inicio de la hoja de triaje para que reciban atención primero.
¿Cómo se compara esto con usar una plataforma empresarial de ingreso de reclamos?
Plataformas empresariales como Guidewire ClaimCenter y Duck Creek Claims ofrecen gestión integral de reclamos — ingreso de FNOL, asignación de ajustadores, seguimiento de reservas, procesamiento de pagos y reportes. Sus módulos de ingreso pueden recibir datos estructurados, pero no pueden extraerlos de un PDF no estructurado. El paso de extracción descrito en este artículo es la capa que se sitúa antes del sistema de reclamos: convierte PDFs en filas estructuradas que el sistema de reclamos puede ingerir. Para aseguradoras que usan plataformas empresariales, la extracción alimenta la plataforma. Para aseguradoras más pequeñas y firmas de ajuste independientes sin un sistema empresarial, la hoja de triaje puede funcionar como un rastreador ligero de ingreso de reclamos.