臨床試験文書抽出
患者1人1行を超えて
2021年、7社の製薬企業の臨床データ管理チームが、完了した20件のPhase III試験を集約し、それらに対して発生したすべてのデータクエリを数え上げました。その総数は、20,125人の参加者に対して1,939,606件に上りました。そのクエリ全体の半数以上を生み出した5つのフォームタイプは、併用薬、臨床検査、有害事象、曝露、薬剤管理でした。これら5つのフォームには共通点が1つありますが、それはレイアウトではありません。いずれも患者1人につき1レコードではないのです。この記事は、その構造的な事実と、臨床試験文書抽出を実行して、データの実際の挙動と一致しないスプレッドシートになってしまった場合に何が起こるかについてのものです。
重要ポイント
- 20,125人の参加者に対して1,939,606件のデータクエリが発生し、その半数以上が、患者1人につき1レコードではないという共通点を持つ5つのフォームタイプから生じました。
- 試験データは配列として届きます。1人の被験者に複数の有害事象があり、1つの事象に複数の関連レコードがあります。一方、スプレッドシートは1行が1つのものを前提としているため、バックログは構造的なものであり、入力速度の問題ではありません。
- まず必要な粒度を定義してください。事象ごとに1行にするか、被験者ごとに1行で来院を列にするかです。そうすれば列は自ずと決まり、残るのは人間によるレビューのみです。
臨床試験ドキュメント一式と、それぞれの内容
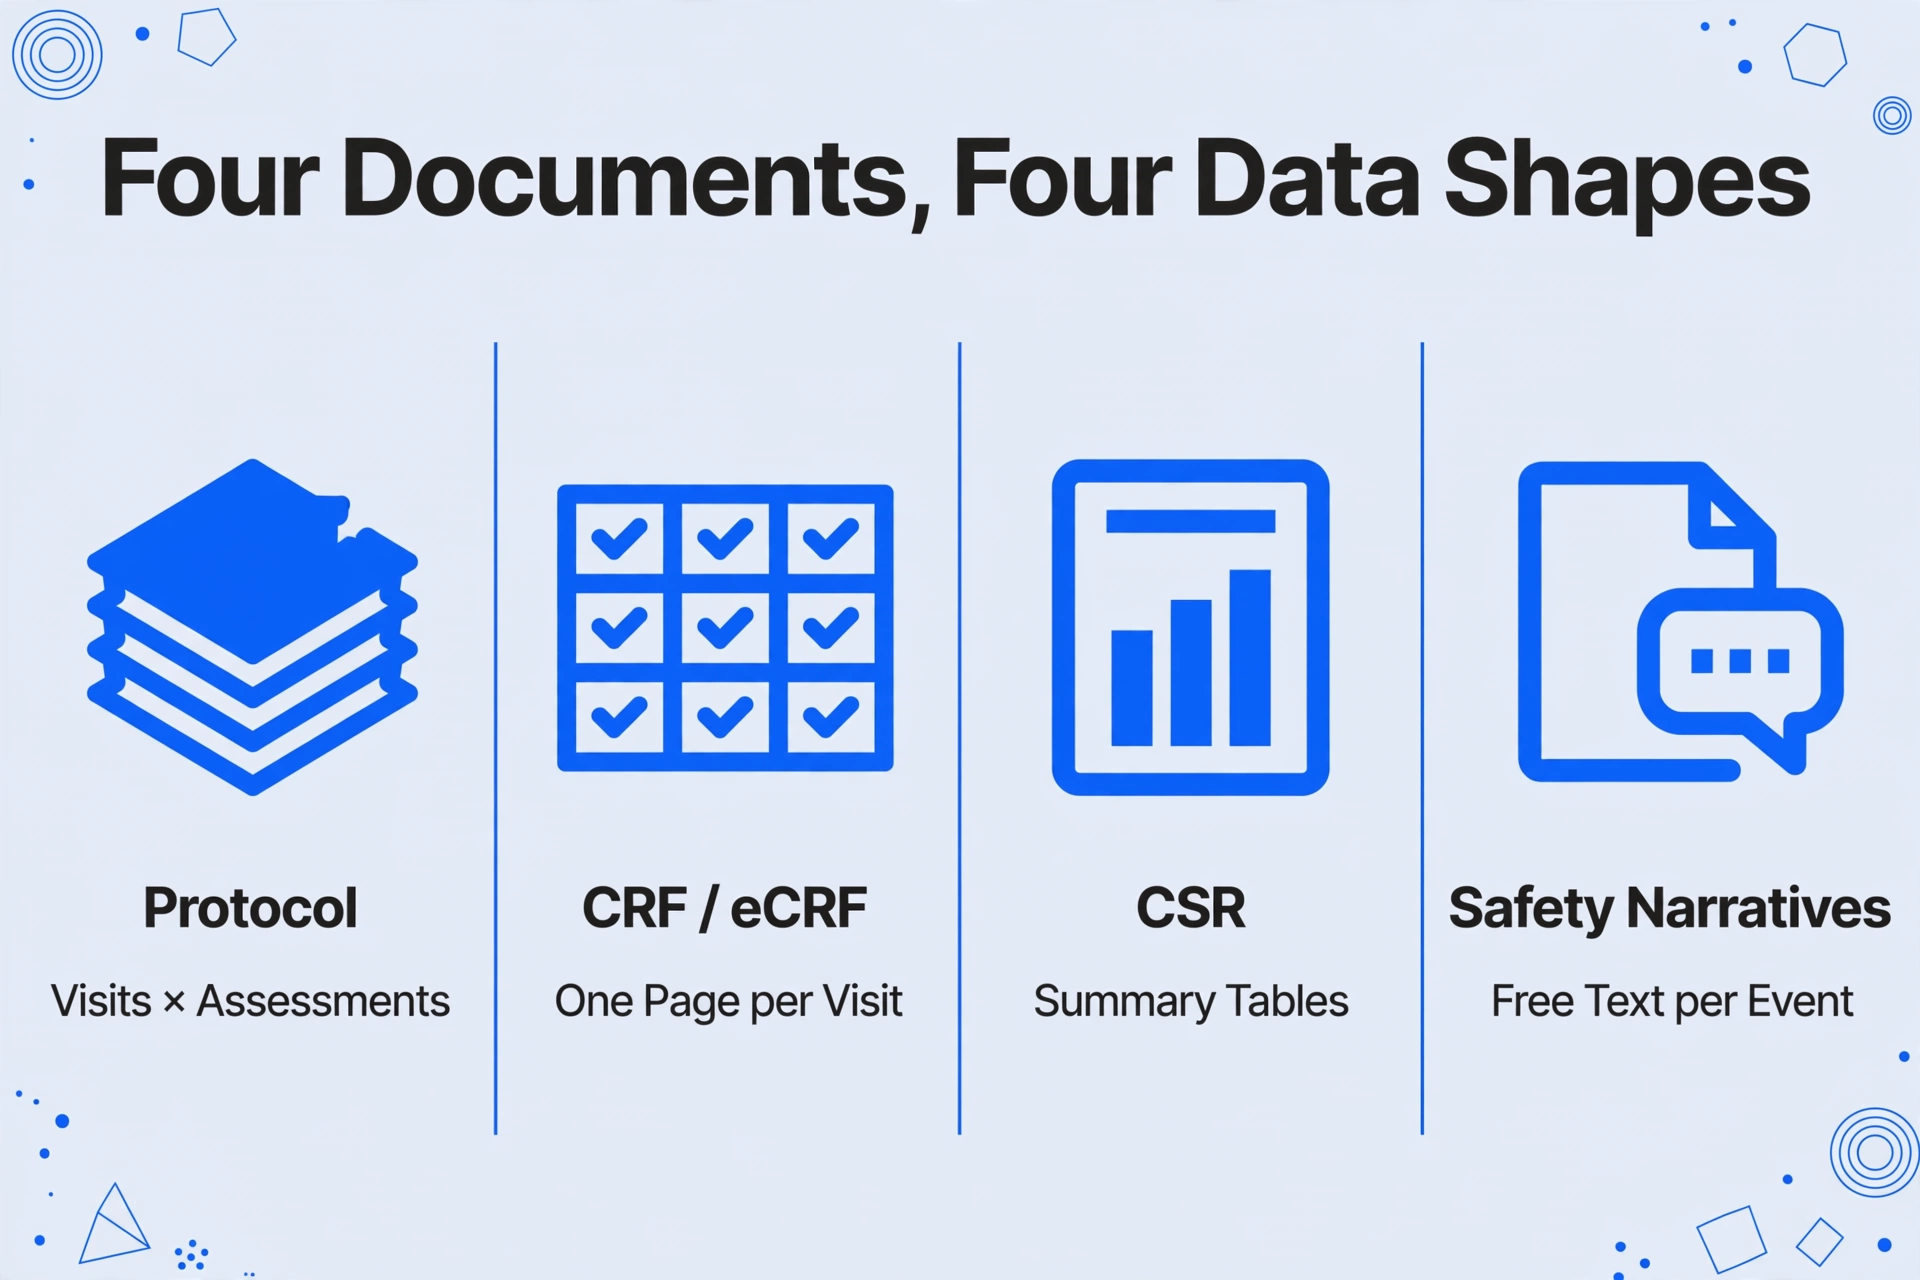
臨床試験のドキュメントは単一の文書タイプではありません。同じ試験を4つの異なる角度から記述する一連の文書群であり、各角度によって異なるデータ形状が生成されます。
| ドキュメント | 概要 | 内部のデータ形状 |
|---|---|---|
| プロトコル | 試験計画。評価スケジュールを含む:各参加者に対してどの来院時にどの手順が実施されるか | 来院 × 評価のグリッド(1行=1来院、1列=1手順) |
| CRF / eCRF | 症例報告書。各来院で発生した事象を収集するツール | 被験者ごとに来院1回につき1ページ、イベントの反復ブロック付き |
| CSR | 臨床試験報告書。試験全体の統合された規制当局向け要約 | 要約表、患者一覧表、ナラティブ。すべて同じイベントを異なる詳細レベルで記述 |
| 安全性ナラティブ | 死亡、重篤な有害事象、その他のフラグ付きイベントの散文形式の記述 | 自由テキスト。イベントごとに1つのナラティブ |
臨床試験報告書は設計上、固定された構造を持っています。臨床試験報告書の構造と内容に関する国際ガイドラインであるICH E3は、有害事象の要約をセクション12.2に、詳細な有害事象表示をセクション14.3.1に、患者別の有害事象一覧表をセクション16.2.7に配置しています。セクション12.2.2では、各有害事象、各治療群で発生した患者数、発生率を、器官別大分類でグループ化し、重症度と因果関係で分類した表を求めています。セクション16.2.7は、同じイベントが被験者ごとに1件ずつ表示される場所です。
ここが臨床試験報告書のデータ抽出が難しくなる最初のポイントです:同じ有害事象データが1つの文書内に3つの形状で存在します(集計表、被験者別一覧表、ナラティブ)。ツールに「有害事象」とだけ依頼し、どの形状を指すかを指定しない読者は、モデルが偶然最初に見つけたものを取得することになります。
レポートの下では、提出データはCDISC Study Data Tabulation Modelに準拠しています。その有害事象ドメインは被験者ごと・事象ごとに1レコードとして定義されており、これは1人の参加者が同じテーブルに複数回登場し得ることを正式に示したものです。1つの事象に付随する詳細(通過した毒性グレードの順序など)は、有害事象レコードと一対多関係で結ばれた別のドメインに格納されます。これまで1ドキュメント=1行という請求書や領収書の抽出しか扱ったことがない場合、ここが驚くポイントです。完全なモデルはCDISCに文書化されています。
フラットなテーブルが配列に出会う場所
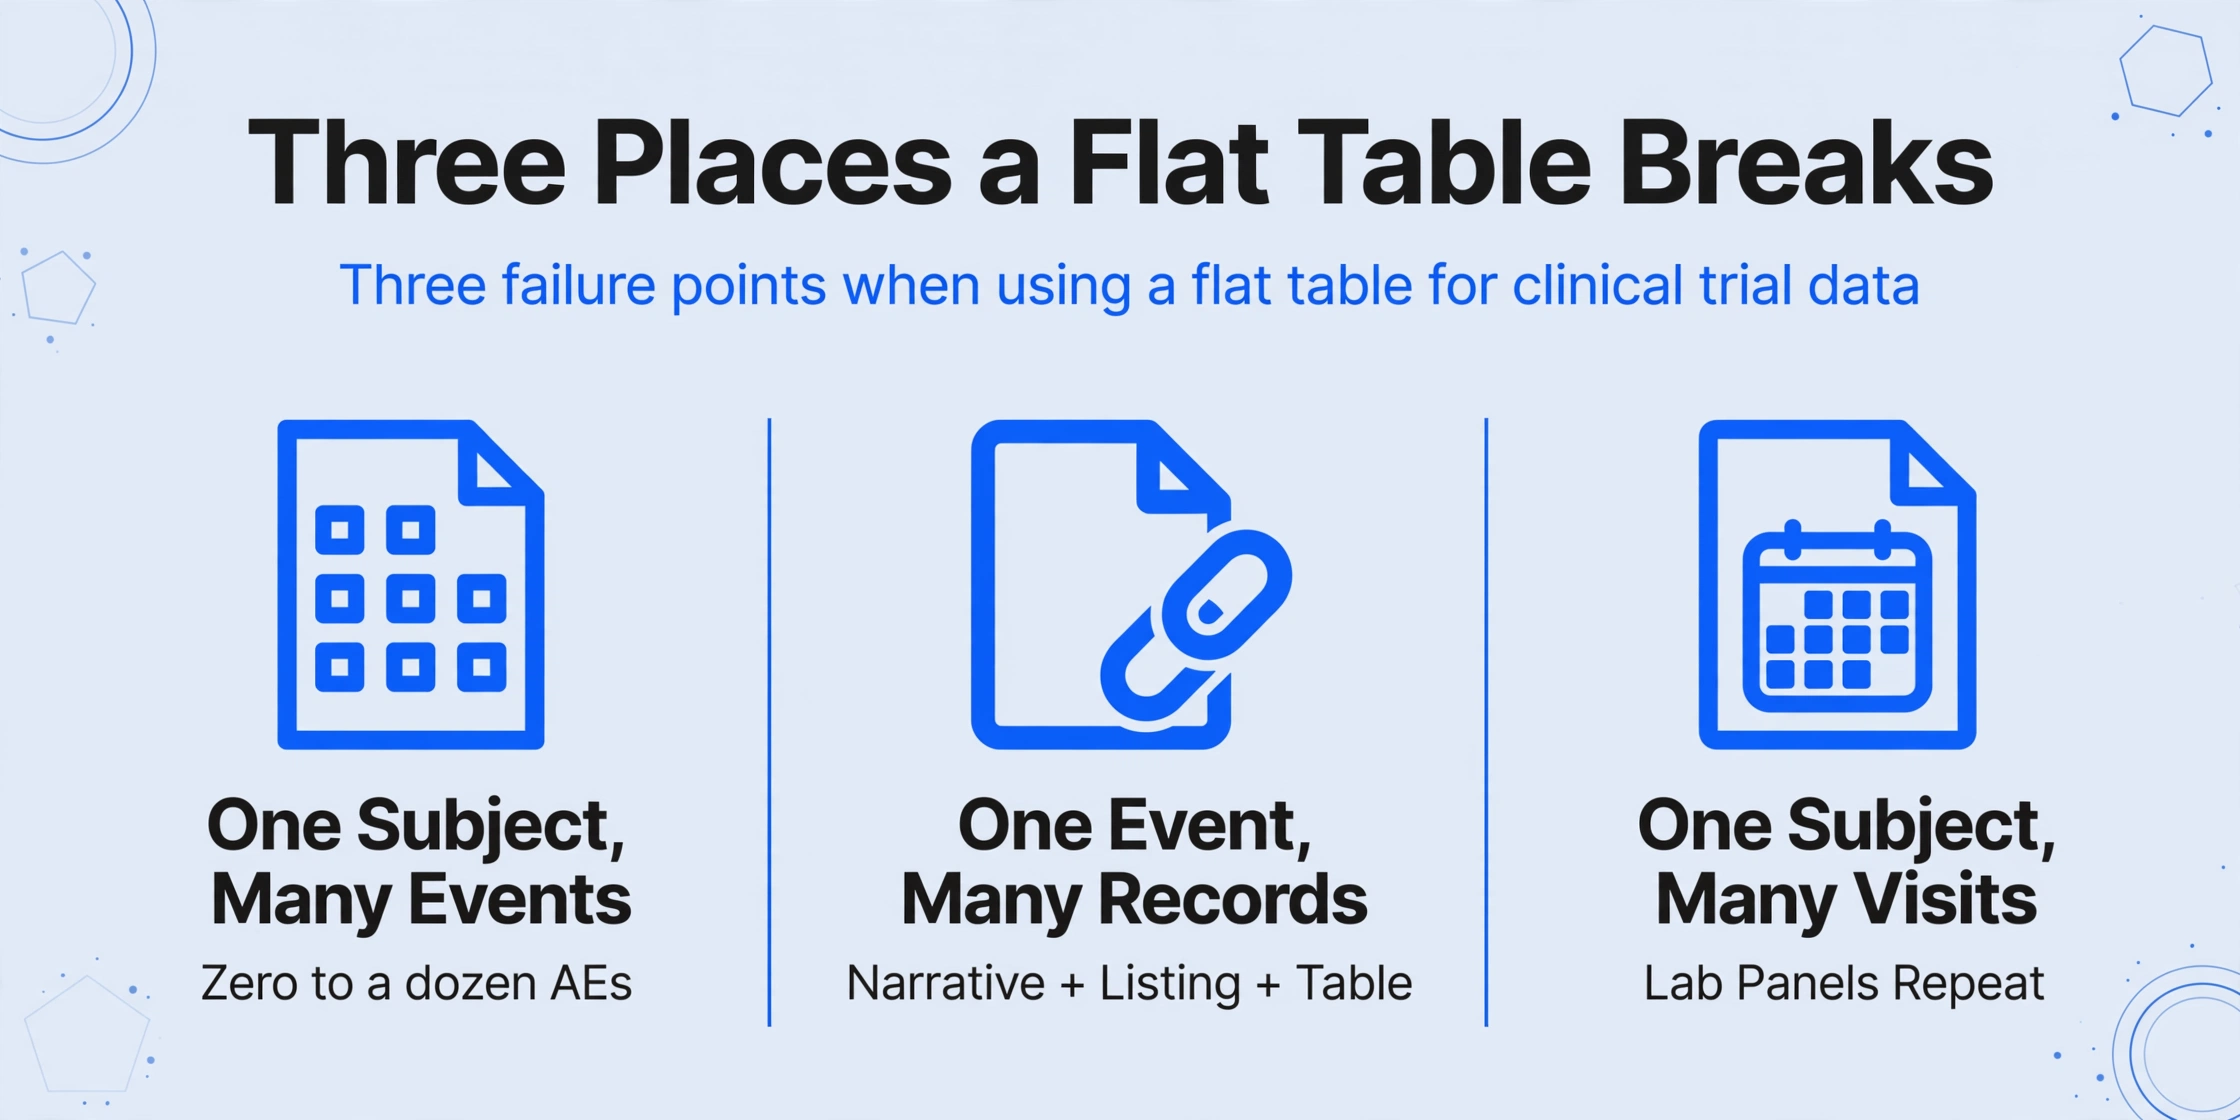
スプレッドシートは1行=1つのものという前提で成り立っています。臨床試験データはこの前提を特定の3つの場所で崩します。そのそれぞれが上記のドキュメントに現れます。
1人の被験者に複数の有害事象。単一の参加者は試験中にゼロ、1つ、あるいは十数件の有害事象を経験することがあり、それぞれに独自の用語、発症日、重症度、重篤性、因果関係、処置、転帰があります。各被験者に1行を与えるテーブルは、事象を落とすか1つのセルに詰め込むしかありません。これが冒頭の統計でクエリトラフィックを生んだ配列です。なぜなら、すべての事象がクリーンなレコードになる前にレビューと照合を必要とするからです。
1つの事象に複数の関連レコード。重篤な有害事象は単一のセルではありません。発症と転帰、因果関係の評価、そして新しい情報が届くにつれておそらく複数のフォローアップエントリがあります。データモデルではこれらはリンクされたレコードであり、印刷されたレポートではナラティブ+一覧表の1行+要約表の1行になります。
1人の被験者に複数の来院、複数の検査パネル。臨床検査値は毎回の来院で繰り返されます。スクリーニング、4週、8週、12週で採取された血液化学パネルは、同じ人に付属する同じパラメータの4セットです。プロトコルの評価スケジュール自体が2次元のグリッドであり、検査データはそこから広がっていきます。
この問題には純粋に機械的な別バージョンがあります。印刷されたテーブルは器官別大分類と基本語の階層を表現するために結合ヘッダーセルとインデントを使用することが多く、素朴な抽出器は事象の用語は正しく読むものの、それがどの器官別大分類に属していたかを失います。この故障モードの詳細は結合セルがテーブル抽出を壊す理由で扱っているので、この記事ではグリッドではなく構造に留まります。
この作業に携わる人々の不満は微妙なものではありません。r/clinicalresearchで、「I hate data entry」というスレッドに書き込んだコーディネーターは率直に述べています:"I sometimes also feel like I'm too slow and the tasks are too tedious. I've been working with a site right now that has over 200 queries."別のスレッドサイトのデータ入力バックログ解消のヒントでは、多くのチームがすでに実施しているトリアージが説明されています:最も古いクエリを最初に処理し、患者ごとに進め、毎日入力の時間を確保する。しかし、そのトリアージのいずれもバックログが存在する理由には対処していません。その理由とは、データが配列で届き、宛先が1行であることです。
臨床試験のドキュメント抽出は、ドキュメントの出力粒度とスプレッドシートの出力粒度が最初の試行で一致することはほとんどないため、時間がかかります。
出力テーブルの粒度を選ぶ
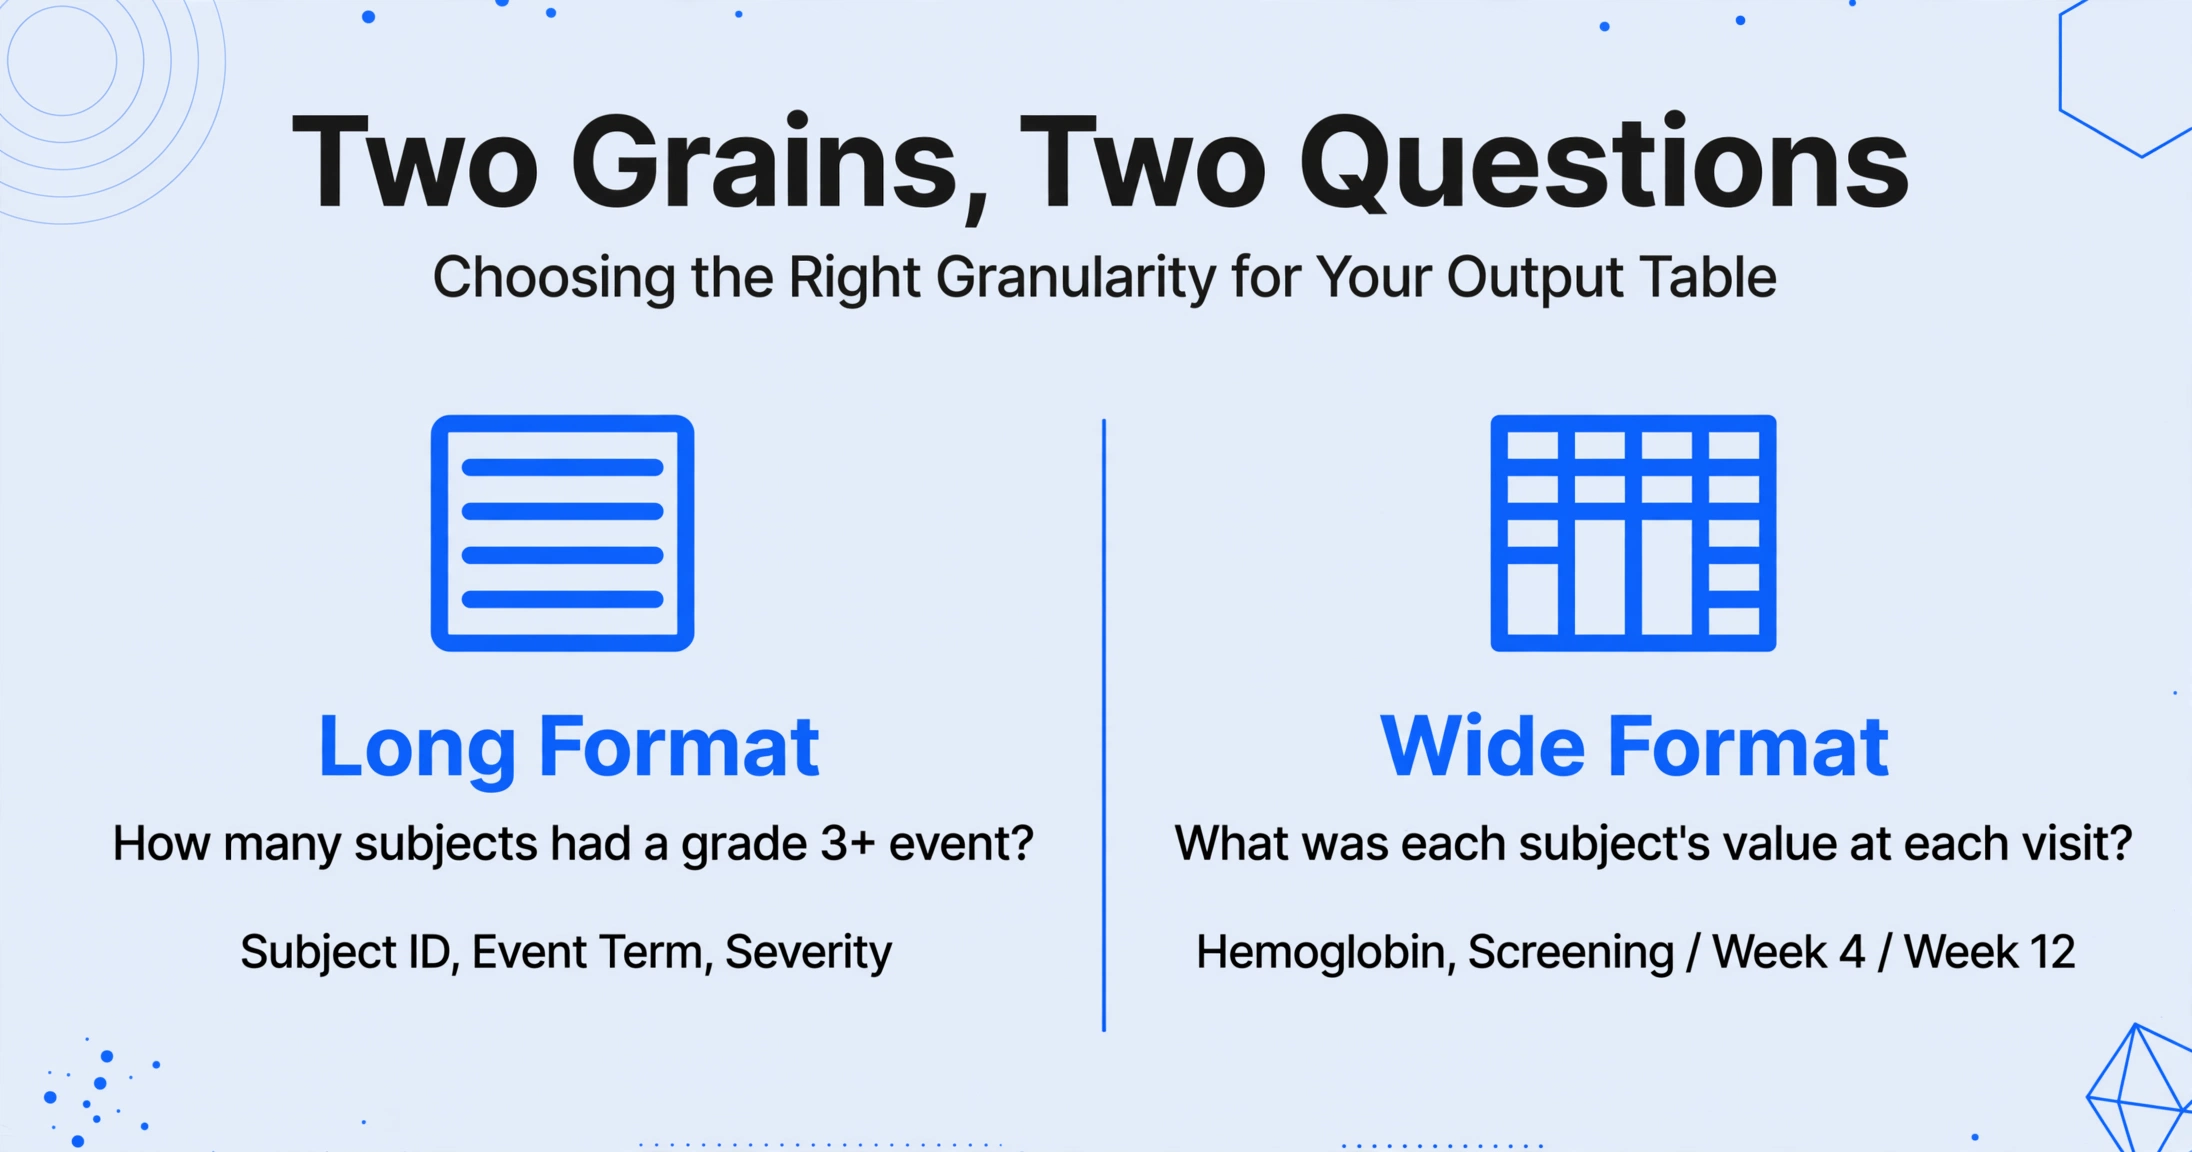
抽出を始める前に、結果の各行が何を表すかを決めてください。実用的な答えは2つあり、それぞれ異なる問いに応えます。
長形式:イベントごとに1行
各有害事象に専用の行が割り当てられ、被験者識別子はその被験者のすべてのイベントで繰り返されます。有用な列:被験者ID、イベント用語、開始日、重症度、重篤(Y/N)、因果関係、処置、転帰。これは「グレード3以上のイベントを持つ被験者が何人いるか」という問いや、統計ツールに行を渡す必要がある場合に選択します。被験者識別子が、繰り返される行を結び付ける役割を果たします。
広形式:被験者ごとに1行、来院を列として
被験者ごとに1行で、来院値は列名に組み込まれます(ヘモグロビン、スクリーニング/ヘモグロビン、4週/ヘモグロビン、12週)。「各来院時の各被験者の値は何か」という問いや、時系列で比較したい場合に有用です。トレードオフとして、時点が増えるごとにテーブルは横に広がり、長期試験では読み取りにくくなる可能性があります。
シートに問いかける質問から粒度を決め、それからソースドキュメントを確認します。ソースが被験者ごとの一覧表で、被験者ごとの比較が必要な場合、長形式から広形式への変換が必要で、その変換はどの抽出ツールも無料では行わない実際の作業です。ソースが要約表で、イベントレベルの行が必要な場合、詳細はそもそも抽出できる形で存在せず、一覧表が必要です。
列に関する注意点が1つあります。コーディング済みデータセットに含まれているからといって、有害事象テーブルに「MedDRA基本語」列を追加したくなるものです。ソースドキュメントにコーディング済み用語がすでに表示されていない限り、その列は抽出できません。基本語の割り当てはコーディングのステップであり、読み取りのステップではないからです。次のセクションでは、抽出がソースから何を取得でき、何を取得できないかについて説明します。
セマンティック抽出が反復構造をどう処理するか
テンプレートベースのツールがここで苦戦する理由は、テンプレートが位置に紐づいているからです。有害事象テーブルの抽出は、位置ベースのロジックが最初に失敗する箇所です。なぜなら、事象が1つの被験者と6つの被験者では、占める行数がまったく異なるため、同じ座標が2回一致することはないからです。意味を読み取るビジョンモデルは、そうした座標に依存しません。
カスタム列抽出がその仕組みです。ページ上に領域を描く代わりに、Subject ID、Event Term、Severity、Seriousなどの列名を入力すると、AIが列名の意味を理解して各値を特定します。入力した列名が出力テーブルのヘッダーになり、読み取りロジックは、被験者の事象行が1つでも10でも安定して機能します。一般的なアプローチについては、AI文書抽出の実際で説明しています。初めての方もご覧ください。
前のセクションで説明した配列の問題に対応する機能がいくつかあります:
- 計算列は、AIが抽出中に値をコピーするだけでなく計算できるようにします。有害事象一覧表では、被験者ごとの事象数や、小計が記載された合計と一致しない場合に行にフラグを立てるなどの条件チェックに対応します。計算は列名またはルールに記述されるため、バッチ内のすべてのドキュメントで同じように実行されます。
- 推論列は、AIがドキュメントに印刷されていない値を、印刷されている内容から割り当てられるようにします。これは、フォローアップステータスなどの区分に有用で、モデルが事象が継続中と記載されているかどうかを読み取ります。医学的判断の代わりにはならず、判定が必要な列はこの方法で構築すべきではありません。
- マルチページマージは、複数ページにまたがるドキュメントを1行にまとめます。複数の印刷ページに続く有害事象一覧表や、別々にスキャンされたシートに分散した被験者の記録は、被験者識別子などの共有値でグループ化でき、各ページにあるフィールドが埋められます。これは、一般的なマルチページPDFにも役立つ設定です。
- バッチ処理は、多数のファイルを一度に読み取り、結果を1つのテーブルに統合するため、CRFページのフォルダやCSR一覧表のセットが、1ドキュメントずつのエクスポートの山ではなく、1枚のシートになります。このパターンは、他の試験記録からのバッチ臨床データ抽出に使用されるものと同じです。
- モデルティアは、ソースが手書きの記入があるスキャン済みフォームの場合に重要です。手書きで記入された有害事象フォームは既知の困難なケースであり、上位の処理ティアでは、密集した手書き文字や複雑なレイアウトに対してより強力なモデルを使用します。
- バウンディングボックス検証付きレビューモードは、抽出された安全性テーブルを使いやすくする部分です。セルにホバーすると、その値が元のドキュメントのどこから来たかが正確にハイライトされ、領域をクリックすると対応するセルにジャンプします。重要なフィールドでは、「抽出を信頼する」から「抽出をスポットチェックする」へと、一覧表全体を読み直すのではなく数秒で切り替えられます。
ファイルは安全に処理され、保存されることはありません。
試験文書が被験者ごとに同じ構造を繰り返す場合、同じ抽出パターンが適用されます。来院別の検査パネルの表、臨床検査レポート、有害事象一覧表は、内容は異なりますが、根底にある問題は同じです。つまり、注目する単位が繰り返し出現し、ツールはそれを平坦化せずに繰り返しを保持する必要があるのです。
この種の抽出でできないこと
特に規制対象分野では、ブログ記事での主張と検証済みシステムは同じではないため、ツールを過大評価するよりも、その境界を明確にすることがより有用です。
有害事象のコーディングは行いません。報告用語を器官別大分類の下の基本語にマッピングする医学辞書であるMedDRAへの用語選択は、独自のルールに従う別のコーディング手順です。辞書とその階層は、MedDRA維持管理支援機構によって管理されています。抽出では、すでに印刷されているコーディング済みの用語を読み取ることはできますが、用語を割り当てることはできません。
安全性の判定は行いません。因果関係、重篤性、予測性の判断は、資格のある担当者に属します。推論列は、文書に記載されている内容の読み取りであり、医学的評価ではありません。
匿名化は行いません。試験文書内の被験者識別子は出力に残ります。ファイルをデータ契約のない場所に送る場合、その処理は別途、慎重に行う必要があります。
検証済みの監査認証システムではありません。規制対象の電子記録には、すべての変更に対する監査証跡や文書化されたシステムバリデーションなどの要件があり、ICH E6(R3)および21 CFR Part 11に定められています。このツールにはそのような認証がないため、記録システムの上流、つまり人間がレビューする一次パスとして位置づけられ、記録データベースとしては使用できません。大規模な検証済み試験データを保持するシステムは、Medidata Rave、Veeva Vault EDC、Oracle Clinical Oneなどの電子データ収集プラットフォームであり、CastorやREDCapのような軽量なオプションもあります。ここでの比較対象は、これらのプラットフォームではありません。一覧表を読んで再入力する人間との比較です。
残るのは、そうした限界を述べた後も作業の大半を占める部分、すなわち、繰り返し現れる値をドキュメントから取り出し、人間が確認できるテーブルにする作業です。一つひとつ手入力する代わりにです。このギャップこそが、コーディネーターがクエリのバックログに追われ、データマネージャーがすでにデジタル化されているのに手入力されている臨床データを抱える原因です。
FAQ
AIはCRFやCSRから有害事象テーブルを抽出できますか? はい、どのテーブルを指すかを定義すれば可能です。CSRには、要約表、被験者別一覧表、ナラティブと同じ事象が含まれ得るため、取得したい特定の形式の列(例:被験者ID、事象名、開始日、重症度)を指定してください。抽出は値を読み取るだけで、3つの表示のどれから取得するかを自動で判断するわけではありません。
抽出はMedDRAでの有害事象コーディングを置き換えますか? いいえ。報告用語を基本語と器官別大分類にコード化することは、独自の規則を持つ別のステップであり、人間による監視が必要です。抽出は、すでにコード化された用語が含まれるドキュメントからその用語を取り出すことはできますが、コーディング自体を行うわけではありません。
すべての有害事象を正しい被験者に紐付けるにはどうすればよいですか? 被験者識別子を独立した列として抽出し、各事象行で繰り返し表示させてください。長形式では、識別子が繰り返し行を一人の参加者に結び付けます。被験者の記録が別々にスキャンされたページに分かれている場合は、その識別子でグループ化したマルチページマージを使用して、事象が展開される前に断片を1つのレコードにまとめてください。
規制当局への提出に適していますか? 記録システムではなく、レビュー可能な一次パスとして使用してください。これはバリデーションや監査認証を受けたプラットフォームではなく、ICH-GCPや21 CFR Part 11の認証を主張するものではなく、匿名化や判定も行いません。バリデーション済みの記録データベースは、引き続き電子データ収集システムです。
ドキュメントの形状がシートの形状を決める
臨床試験ドキュメントの抽出が請求書の抽出より難しい理由は、技術的なものではなく構造的なものです。請求書は1行に1件届きます。試験ドキュメントは配列として届きます。1人の被験者が複数の来院にまたがる、1人の被験者に複数の有害事象がある、1つの事象に複数の関連レコードがある、といった具合です。実際に必要な出力の粒度を決めれば、列の定義は単純な判断になり、残る作業はレビューだけです。それはまさに、資格のある人が時間を費やすべき場所です。
1つの有害事象一覧表または1つの来院検査パネルドキュメントから始めて、必要な列を定義し、バッチ全体をコミットする前にテーブルが返ってくるのを確認しましょう。