AIは医療検査
レポートを抽出できる?
はい。最新のAIビジョンモデルは、Quest DiagnosticsやLabCorpなどの主要検査機関の標準的な印刷レポートから、95〜99%の精度でデータを抽出できます。ただし、FAXコピーでは85〜95%、手書きの医師注釈がある場合は70〜85%に精度が低下します。
重要なポイント
- 患者ポータルからダウンロードするようなクリーンなQuestまたはLabCorpのPDFでの95〜99%の精度は、将来のマイルストーンではありません。これは、現在利用可能なビジョンAIの性能です。
- FAXや注釈付きレポートでの70〜85%への低下は、モデルの欠陥ではありません。第3世代のFAXはピクセルレベルで詳細が失われ、下流のAIでは回復できません。また、欄外の急いで書かれた筆記体には、AIが文脈読解に依存するフィールド境界がありません。
- 生産的な問いは変わっています。「AIが検査レポートを抽出できるか」ではなく、「どのレポートが手入力なしで完全に処理され、どのレポートが10秒の目視確認を必要とし、どのレポートが人間のキューに回されるか」です。
これらの数値範囲はAIの限界ではなく、入力品質を反映したものです。Questの患者ポータルからのクリーンなPDFは、すべての小数点とフラグを保持します。第3世代ファックスはそうではありません。本当の問いは、「どの入力品質レベルなら、抽出結果がワークフローで信頼できるようになるか」です。
結論: AIビジョンモデルは、印刷された検査レポート(Quest、LabCorp、病院のLIS出力、参照検査室のPDF)から構造化された検査結果を確実に抽出します。ただし、エッジケース(手書き、ファックスアーティファクト、低品質スキャン)には、より優れたAIだけでなく、プロセス設計が必要です。
文書状態別の精度
LabCorpのPDFをほぼ完璧に読み取る同じビジョンモデルでも、スマートフォンでスキャンした折れ曲がったファックスの同じデータには苦労する可能性があります。入力品質に基づいて期待できる精度は以下のとおりです。
| 文書状態 | フィールド精度 | 主な制限要因 |
|---|---|---|
| 標準印刷レポート(Quest / LabCorp / 病院LIS) | 95–99% | クリーンな機械印字テキスト、一貫したカラムレイアウト |
| 患者ポータルまたはEMRエクスポートからのPDF | 95–99% | デジタル原本 — 品質劣化なし、理想的な入力 |
| クリーンなコピー / 300 DPI以上のスキャン | 90–97% | コントラスト低下とわずかな傾きが行検出に影響 |
| ファックスコピー(1回送信) | 85–95% | 約200 DPI解像度、横縞、細かい文字の欠落 |
| 多世代ファックスまたは不良コピー | 75–88% | 文字のぼやけ、小数点の融合、かすれたカラム境界 |
| 印刷物への手書き注釈 | 70–85% | 可読性はさまざま — ブロック体は認識、走り書きの筆記体は不可 |
| 照明が不安定なスマートフォン写真 | 65–85% | グレア、影、遠近歪み、モーションブラー |
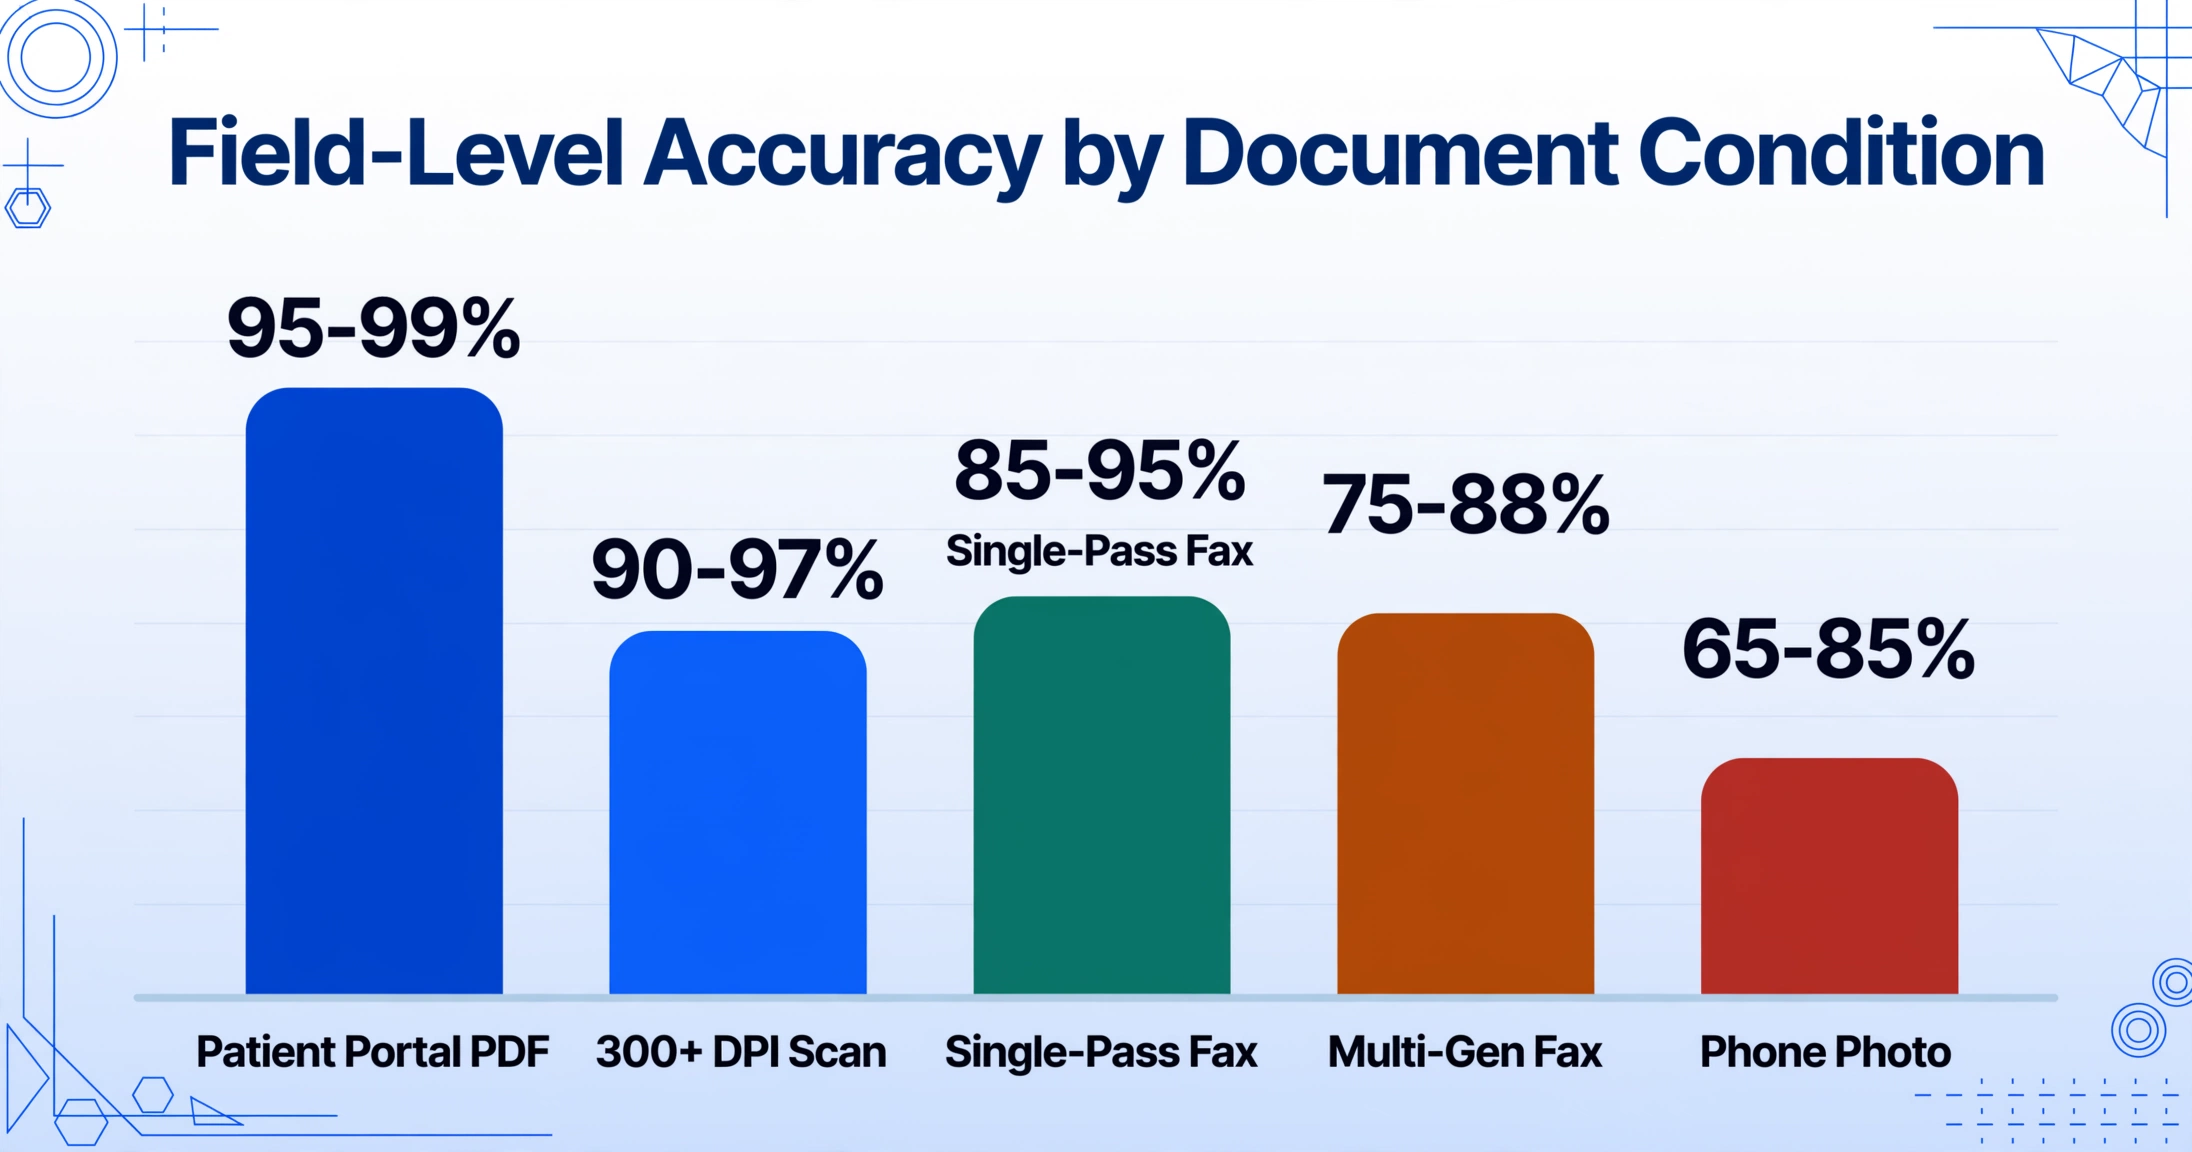
これらの数値範囲は、複数の医療機関での導入テストに基づいており、12種類の異なるLISプラットフォームからの500件以上の検査レポートに対する内部検証も含まれます。上限値は、良好な文書状態と明確に定義されたカラムを前提としています。下限値は、特殊なレイアウトや劣化したテキストなどのエッジケースを表します。
実用的なポイント: クリーンなPDFと良好なスキャンは、スポットチェックワークフロー(サンプルを検証し、残りを信頼する)に十分な精度です。ファックスや注釈付きレポートは人間によるレビューが必要です — AIモデルの変更では解決できません。
AIが得意なこと
Vision AIは、従来のOCRやテンプレートベースのツールでは実現できない、検査レポート抽出に最適な3つの機能を備えています。
意味に基づくフィールドマッピング。 従来のOCRは生のテキストボックスを出力するだけであり、どのテキストが検査名、結果、基準範囲かを別途判断する必要があります。Vision AIは文書を全体として読み取り、「グルコース」が検査名、「95」がその結果、「mg/dL」が単位、「(70–99)」が基準範囲であることを理解します。これこそがカスタム列抽出の基盤です。抽出したい列を定義すれば、AIは各フィールドの意味を理解してデータを見つけます。検査項目を縦に並べるQuestのレポートと、横の表を使う病院のレポートでも、同じ列定義で抽出できます。
フラグと基準範囲の保持。 検査結果は数値に加え、正常・異常・緊急かを示す情報が重要です。「115 mg/dL」を抽出しても「H」フラグを見逃せば、元のレポートでは異常値でも、出力は正常値のように見えます。Vision AIは結果、単位、基準範囲、フラグを一つの意味グループとして扱い、臨床的な情報を構造化データにそのまま保持します。
LISプラットフォームに依存しないフォーマット対応。 Epic BeakerのCBCは3列の表で結果を表示します。同じCBCでもSunquestは1列に基準範囲を括弧書きで表示します。Questはフラグを右端の列に、LabCorpは値の後ろに表示します。テンプレートベースのツールではそれぞれに個別の設定が必要です。Vision AIはテキスト要素間の関係性を位置に関係なく読み取ります。「結果」を定義すれば、各検査名の右、下、別のセルのいずれにあっても隣接する数値を見つけます。詳細は検査レポートデータ抽出の完全ガイドをご覧ください。
AIがまだ苦手とする領域
限界を正直に伝えることこそが、役立つ提案と営業トークを分けるポイントです。
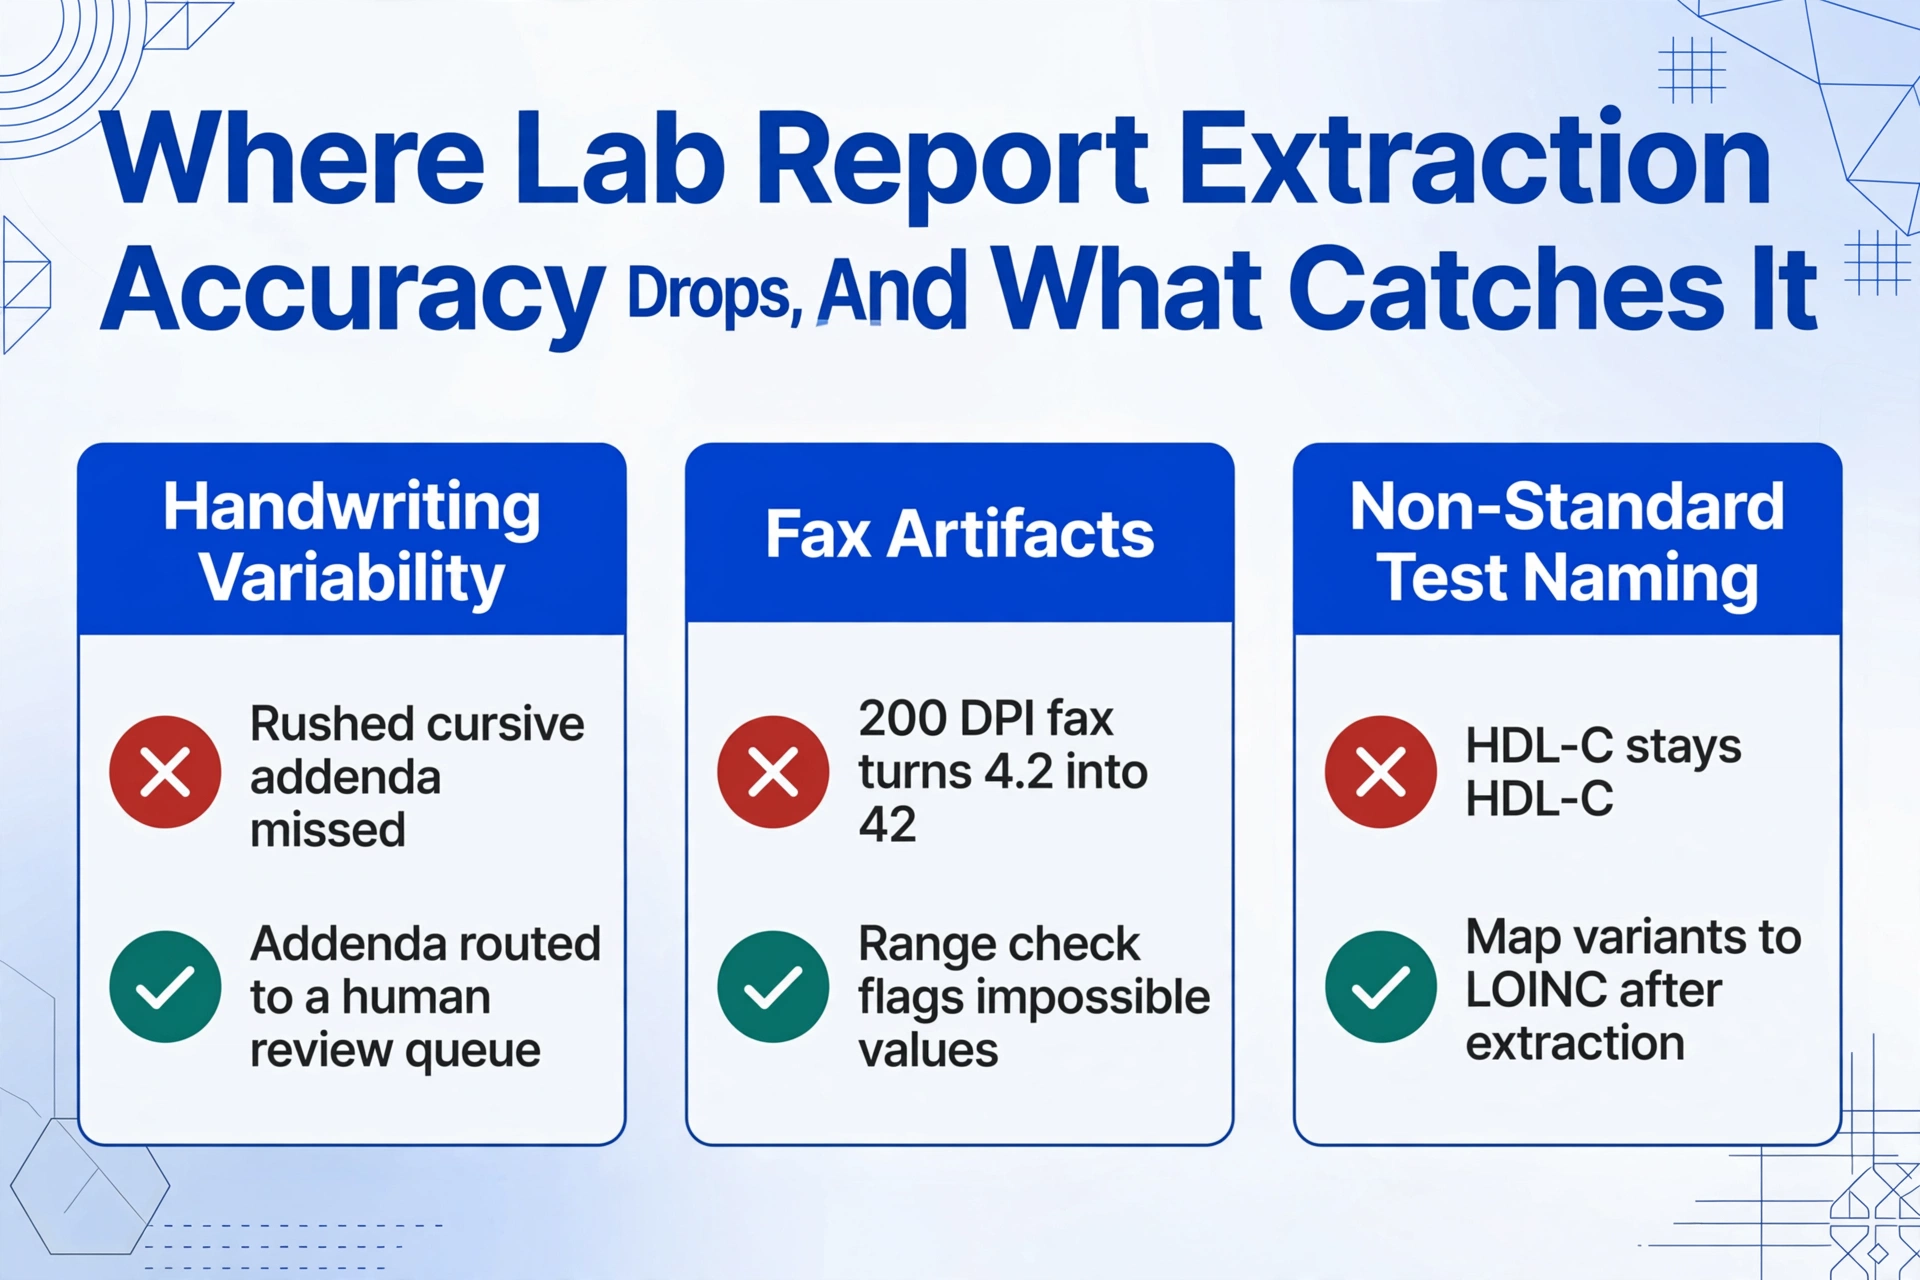
手書きのばらつき。 精度に最も大きな影響を与えるギャップです。欄外に書かれた明瞭なブロック体の注記(「TSH追加」など)は通常、抽出できます。しかし、走り書きのメモ(「6週間後に再検査 — 5.0超なら再確認」など)は抽出できません。問題は文脈の曖昧さにあります。注記が印字テキストに重なり、明確なフィールド境界がなく、医療提供者によって略語が異なるからです。 対策: まず機械印字された値を抽出します(これらが信頼できる臨床結果です)。手書きの追記は、人のレビュー待ち行列に回します。
FAXのノイズと低品質スキャン。 FAX送信は約200 DPIに圧縮されます。「4.2」の小数点はおよそ2×2ピクセルに相当します。FAXの自動閾値処理でその領域が白と判定されると、「4.2」は「42」になり、レンジチェックを行わない下流システムでは検出されない10倍の誤差になります。これはAIの問題ではなく、入力品質の問題です。 対策: 可能な場合はFAX送信をやめ、安全なPDFに切り替えます。FAXが避けられない場合は、基準値範囲と照合して結果を検証します。生物学的に妥当な範囲外の値は、手動レビュー用にフラグを立てます。
標準的でない検査名。 「HDLコレステロール」「HDL-C」「HDL」「高比重リポタンパク質」はすべて同じ分析対象を指します。AIはページ上のテキストをそのまま抽出するだけで、これらを標準用語に正規化することはありません。 対策: 抽出後の正規化を、ルックアップテーブルまたはLOINCコードマッピングで行います。抽出は印字されたテキストをそのまま提供し、正規化は別のステップであり、確立されたマッピングが利用可能です。
最良の結果を得る方法
精度は、入力品質、列設計、検証ワークフローに依存します。以下の5つの選択が、上記の範囲の高水準へと導きます。
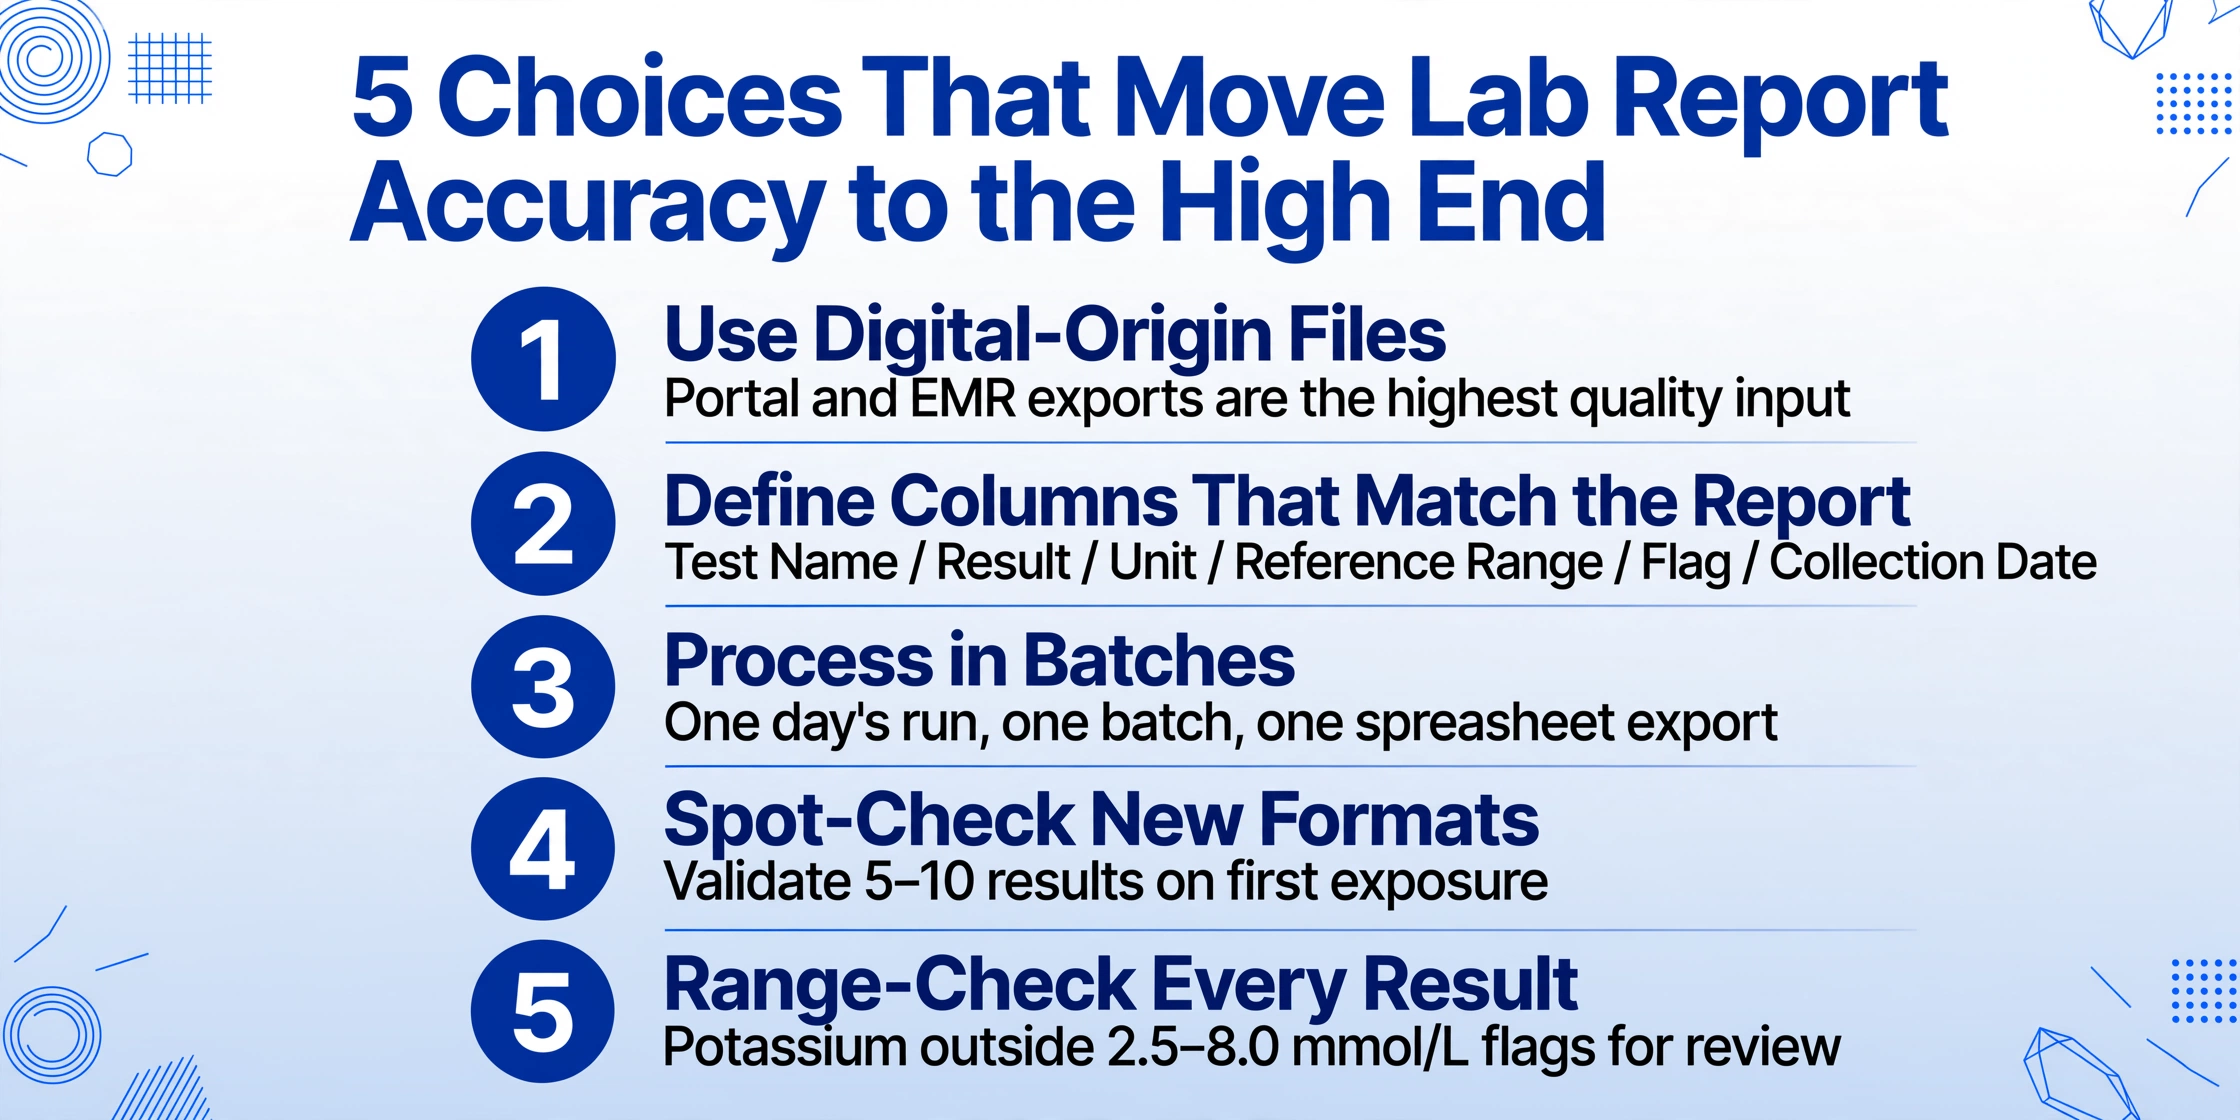
検査名 / 結果 / 単位 / 基準値 / フラグ / 採取日 の列セットで、90%以上のユースケースをカバーできます。包括的な列は避けてください。AIは各出力フィールドに明確な意味的ターゲットがある場合に最も効果的に機能します。実際の導入事例
患者検査結果の追跡管理。 ある一次診療所では、Quest、LabCorp、地元病院から3種類の形式で検査報告書を受け取っています。以前は医療アシスタントが毎日45~90分かけて、PDFからHbA1c、LDL、クレアチニン値をExcelに手入力していました。AI抽出を導入後、アシスタントは日次バッチ(15~25件の報告書)をアップロードし、4つの列を定義して、2分足らずで結果をエクスポート。毎日45分かかっていた転記作業は、10分のスポットチェック確認に短縮され、年間約140時間のスタッフ時間を削減しました。
臨床試験データの集約。 ある治験コーディネーターは、異なるLISプラットフォームを使用する8つの施設からの検査結果を管理し、患者1人あたり1回の来院につき20のパラメータを追跡しています。手動抽出では60人の患者に対して週8時間を要していました。定義済みの列セットを用いたAI抽出により、全施設の報告書を一括処理し、週の作業時間は約45分の検証作業に短縮されました。
検査業務のモニタリング。 ある病院の検査品質管理者は、緊急値報告やターンアラウンドタイムのトレンドデータを必要としていますが、アドホックなLISレポートの抽出にはIT部門の関与が必要でした。AIによる検査報告書の日次抽出(検査名、完了時間、緊急フラグを取得)を構造化スプレッドシートに行い、セルフサービスのPower BIダッシュボードに連携。以前はデータアナリストが必要だった作業が、自動化された日次バッチ処理に置き換わりました。
EOB、CMS-1500フォーム、患者受付書類など、医療分野におけるAI文書抽出の詳細については、医療文書向けOCRガイドをご覧ください。
よくある質問
AIは検査報告書を100%の精度で抽出できますか?
どの抽出システムも、永続的に100%の精度を達成することはできません。Vision AIは、鮮明な印刷報告書に対して95~99%のフィールドレベル精度を達成します。残りの1~5%には、小数点の位置が曖昧なケースや、印刷品質不良による文字の混ざりなどが含まれます。ベストプラクティスとしては、デジタル原稿のPDFでは99%以上の精度を期待し、新しい形式に初めて対応する際は検証を行い、数値結果には範囲チェックを実施してください。
AIによる検査レポート抽出はHIPAA準拠ですか?
HIPAA準拠は、ツールのデータ処理方法に依存し、抽出機能自体には依存しません。主な要件には、暗号化された送信(TLS 1.2以上)、保存時の暗号化、該当する場合のビジネスアソシエイト契約(BAA)が含まれます。各プラットフォームのセキュリティ慣行が組織の義務を満たしていることを確認してください。
同じAIがQuest Diagnostics、LabCorp、病院のレポートでも機能しますか?
はい — それが位置ベースのOCRに対するテンプレート不要のセマンティック抽出の利点です。列を一度定義すれば(検査名、結果、単位、基準範囲、フラグ)、AIは各フィールドの意味を理解することで、あらゆる検査フォーマット上の対応する値を特定します。Quest Diagnosticsの代謝パネル、LabCorpの脂質プロファイル、病院のEpic BeakerによるCBCはすべて、検査室ごとの設定なしで同じ列定義を使用します。同じ列は、健康診断レポートのスクリーンショットも読み取ります。そこでの実用的な目標は、通常、今年のパネルを去年のものと並べて比較し、どちらも再入力せずに済ませることです。
AIは検査レポートの手書き数字を抽出できますか?
明確に印刷されたブロック数字 — 技術者が空白欄に「142」と書いた場合など — は通常キャプチャされます。手書きが印刷テキストと重なったり、標準的でない数字の形を使用したりすると、精度は低下します。機械印刷の結果(検査データの大部分)では、精度は高くなります。手書きの追記については、抽出結果を人間による検証が必要なドラフトとして扱ってください。
AIは1回のバッチで何件のレポートを処理できますか?
固定の上限はありません。Vision AIプラットフォームはファイルを並行して処理します。実際には、50〜100件の検査レポート(各1〜4ページ)が数分ではなく数分以内で処理されます。出力は、一貫した列ヘッダーを持つ単一のスプレッドシートで、並べ替え、フィルタリング、ピボット分析にすぐ使用できます。
AIはH、L、Criticalなどの異常フラグをキャプチャしますか?
はい、列定義にフラグフィールドが含まれている場合、AIは各結果とともにH/L/Criticalの注記をキャプチャし、構造化出力に臨床アラートシグナルを保持します。専用のフラグ列を含め、各検査室からの最初のバッチでそれを検証してください。
「AIにできる?」から「どう設定する?」へ
実際の現場では、ほとんどのケースで答えは「はい」です。典型的な検査室の出力である印刷レポートに対して、95~99%の精度を達成できます。これは、日常的な結果の手動転記を不要にし、人間の判断が必要な業務にスタッフを振り向けるのに十分な精度です。
実用的な問いは変わりました。もはや技術が機能するかどうかではなく、クリーンなデジタルレポートを完全自動化に回し、FAXや注釈付きのものは人間の確認に回し、範囲チェックで稀ではあるが重大なエラーが患者記録に到達する前に捕捉するワークフローをどう設計するか、です。
カラムセットを定義し、バッチをアップロードし、出力をスポットチェックする。これが、未来のAIアップグレードではなく、今すぐ利用可能なビジョンモデルで実現できるワークフローです。