L'IA peut-elle extraire
les rapports de laboratoire médicaux ?
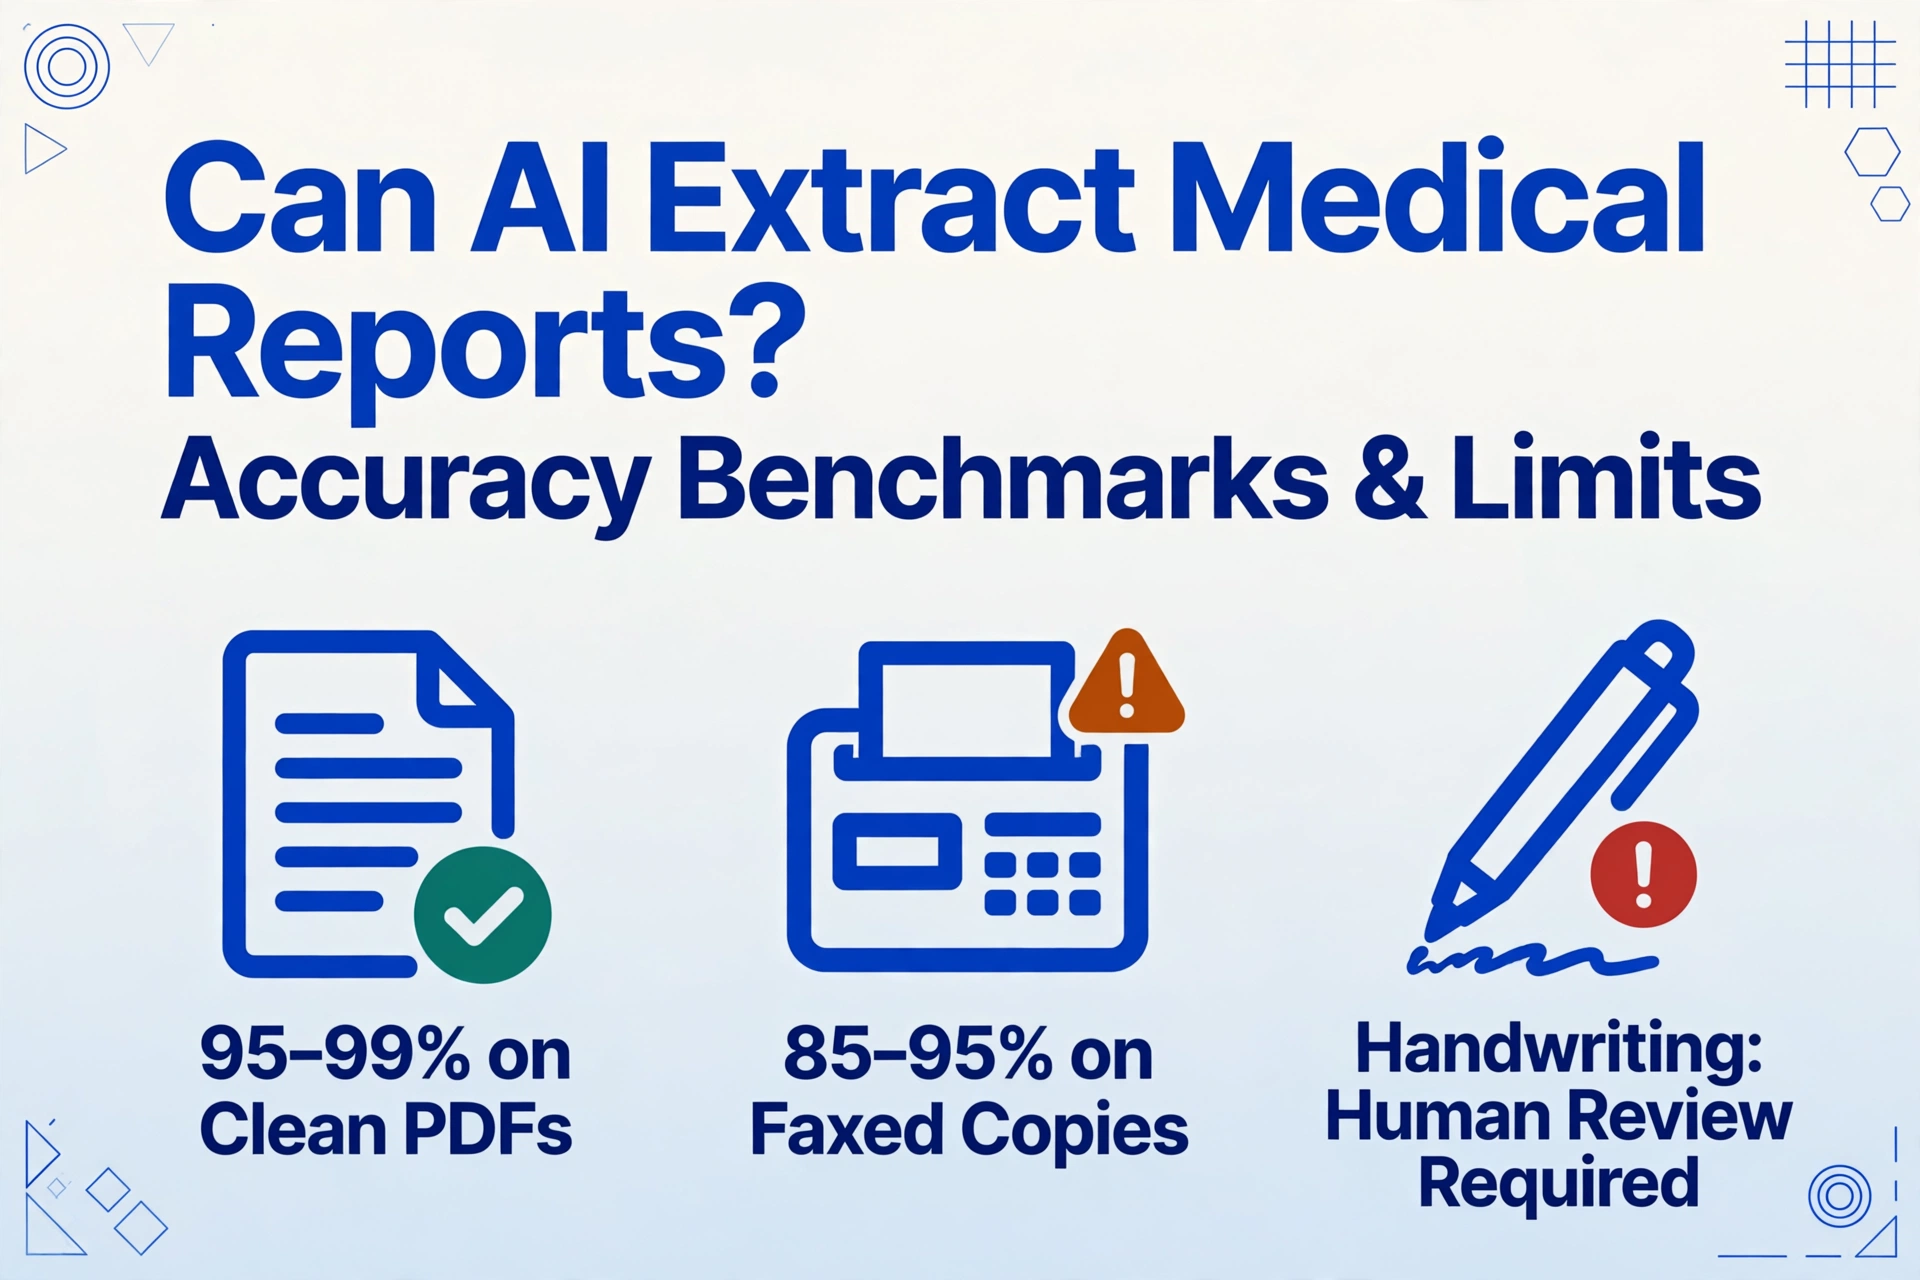
Oui. Les modèles de vision IA modernes peuvent extraire des données de rapports de laboratoire médicaux avec une précision de 95 à 99 % sur les rapports imprimés standard des grands laboratoires comme Quest Diagnostics et LabCorp, bien que la précision tombe à 85-95 % sur les copies faxées et à 70-85 % en présence d'annotations manuscrites de médecins.
Points clés à retenir
- La précision de 95 à 99 % sur un PDF propre Quest ou LabCorp — le type que l'on télécharge depuis un portail patient — n'est pas une étape future. C'est la performance de l'IA de vision disponible aujourd'hui.
- La baisse à 70-85 % sur les rapports faxés et annotés n'est pas un défaut du modèle. Un fax de troisième génération perd des détails au niveau des pixels que aucune IA en aval ne peut récupérer, et une écriture cursive précipitée dans les marges ne présente pas les limites de champ sur lesquelles l'IA s'appuie pour la lecture contextuelle.
- La question productive a changé : non plus « l'IA peut-elle extraire les rapports de laboratoire » mais « quels rapports contournent entièrement la saisie manuelle, lesquels nécessitent une vérification rapide de 10 secondes, et lesquels sont acheminés vers une file humaine ». »
Ces fourchettes ne sont pas une limite de l'IA — elles reflètent la qualité des documents sources. Un PDF propre provenant du portail patient de Quest préserve chaque décimale et chaque drapeau. Un fax de troisième génération, non. La vraie question est : à partir de quelle qualité de document l'extraction devient-elle suffisamment fiable pour votre flux de travail ?
En résumé : Les modèles de vision IA extraient de manière fiable les résultats de tests structurés à partir de rapports de laboratoire imprimés — Quest, LabCorp, impressions LIS hospitalières, PDF de laboratoires de référence. Mais les cas limites (écriture manuscrite, artefacts de fax, scans de mauvaise qualité) nécessitent une conception de processus, pas seulement une meilleure IA.
Précision selon l'état du document
Le même modèle de vision qui lit un PDF LabCorp avec une précision quasi parfaite peut avoir du mal avec les mêmes données sur un fax froissé scanné avec un smartphone. Voici ce que vous pouvez attendre selon la qualité du document.
| État du document | Précision au niveau des champs | Principal facteur limitant |
|---|---|---|
| Rapport imprimé standard (Quest / LabCorp / LIS hospitalier) | 95–99 % | Texte imprimé propre, mise en page en colonnes cohérente |
| PDF du portail patient ou export EMR | 95–99 % | Origine numérique — aucune dégradation de qualité, le document idéal |
| Photocopie / scan propre à ≥300 DPI | 90–97 % | Perte de contraste et légère inclinaison affectent la détection des lignes |
| Copie fax (simple passage) | 85–95 % | Résolution ~200 DPI, stries horizontales, caractères fins perdus |
| Fax multi-générations ou photocopie de mauvaise qualité | 75–88 % | Caractères flous, décimales fusionnées, limites de colonnes estompées |
| Annotations manuscrites sur l'impression | 70–85 % | Lisibilité variable — écriture en capitales capturée, cursive rapide manquée |
| Photo smartphone sous éclairage variable | 65–85 % | Reflets, ombres, distorsion de perspective, flou de mouvement |
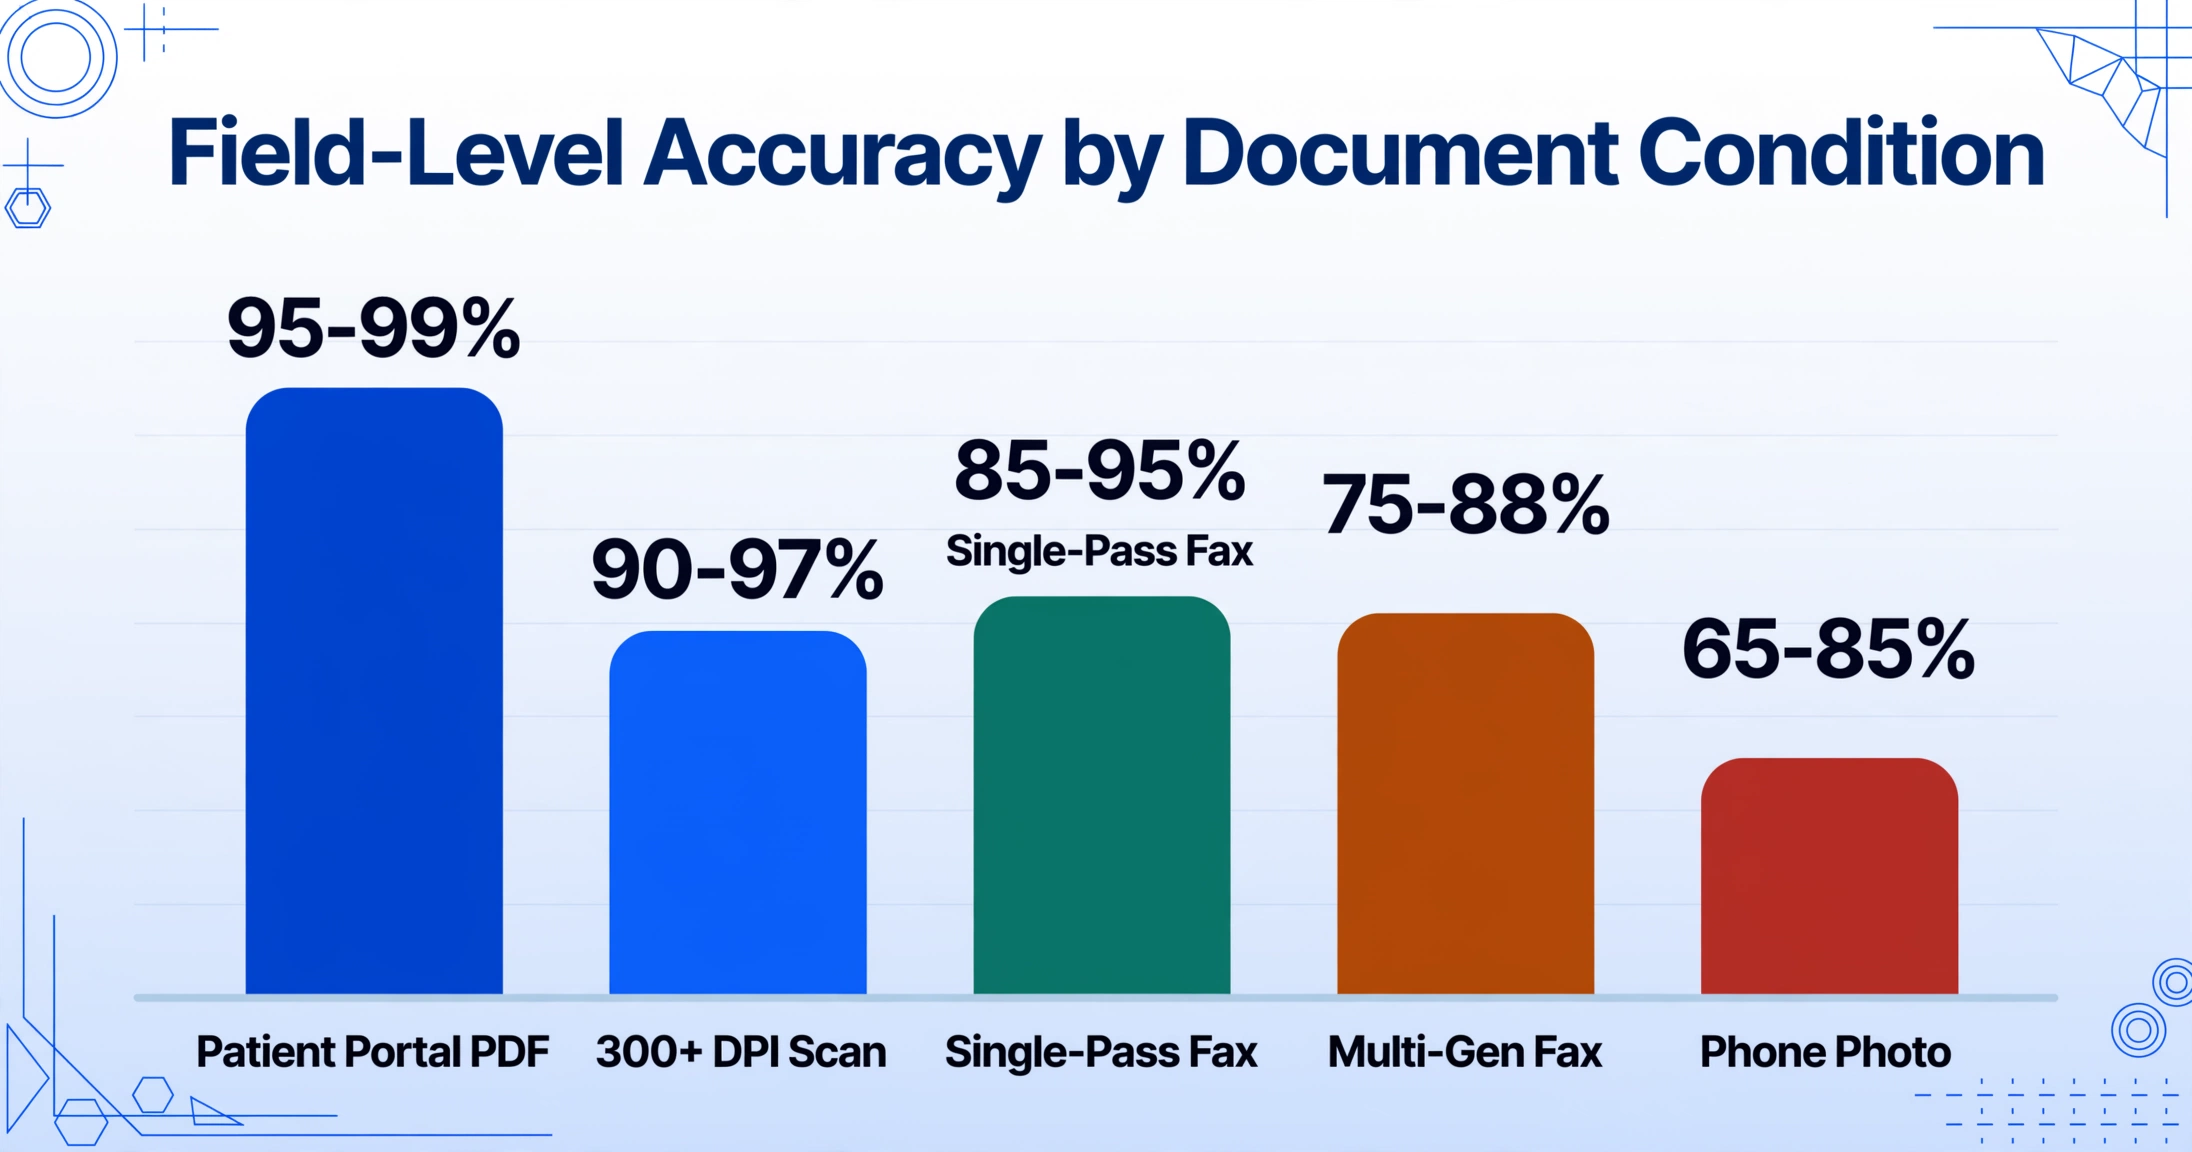
Ces fourchettes proviennent de tests menés sur plusieurs déploiements en santé, y compris une validation interne sur plus de 500 rapports de laboratoire issus de 12 plateformes LIS différentes. L'extrémité haute suppose un document en bon état et des colonnes bien définies. L'extrémité basse représente les cas limites — mises en page inhabituelles ou texte dégradé.
Conclusion pratique : les PDF propres et les bons scans sont suffisamment précis pour un flux de vérification par échantillonnage (vérifier un échantillon, faire confiance au reste). Les rapports faxés et annotés nécessitent une revue humaine — aucun changement de modèle d'IA n'y remédie.
Ce que l’IA fait bien
La Vision IA apporte trois capacités qui la rendent particulièrement adaptée à l’extraction de comptes rendus de laboratoire, qu’aucun outil OCR traditionnel ou basé sur des modèles ne fournit de manière fiable.
Mappage sémantique des champs. L’OCR traditionnel produit des blocs de texte bruts — une étape distincte doit déterminer lequel est un nom de test, lequel est un résultat et lequel est une plage de référence. La Vision IA lit le document de manière holistique, comprenant que « Glucose » est le nom du test, « 95 » son résultat, « mg/dL » l’unité et « (70–99) » la plage de référence. C’est sur cela que repose l’Extraction de colonnes personnalisées : vous définissez les colonnes souhaitées, et l’IA trouve les données en comprenant ce que chaque champ signifie plutôt que là où il se trouve. Un rapport Quest qui liste les tests verticalement et un rapport hospitalier utilisant un tableau horizontal fonctionnent avec les mêmes définitions de colonnes.
Préservation des drapeaux et plages de référence. Un résultat de laboratoire est un nombre plus le contexte qui indique au clinicien s’il est normal, anormal ou critique. Une IA qui extrait « 115 mg/dL » mais omet le drapeau « H » a fourni des données incomplètes — la sortie semble normale alors que l’original signalait une valeur élevée. La Vision IA traite le résultat, l’unité, la plage et le drapeau comme un seul groupe sémantique, préservant le signal clinique dans la sortie structurée.
Indépendance de format entre les plateformes LIS. Une NFS d’Epic Beaker liste les résultats dans un tableau à trois colonnes. La même NFS de Sunquest utilise une seule colonne avec des plages entre parenthèses. Quest place les drapeaux dans une colonne tout à droite ; LabCorp les imprime après la valeur. Un outil basé sur des modèles nécessite des configurations distinctes pour chacun. La Vision IA lit les relations entre les éléments de texte indépendamment de leur position — vous définissez « Résultat » et elle trouve la valeur numérique adjacente à chaque nom de test, qu’elle soit à droite, en dessous ou dans une cellule séparée. Pour une couverture plus approfondie, consultez notre guide complet sur l’extraction de données de comptes rendus de laboratoire.
Là où l'IA rencontre encore des difficultés
Reconnaître les limites est ce qui distingue une recommandation utile d'un argumentaire commercial.
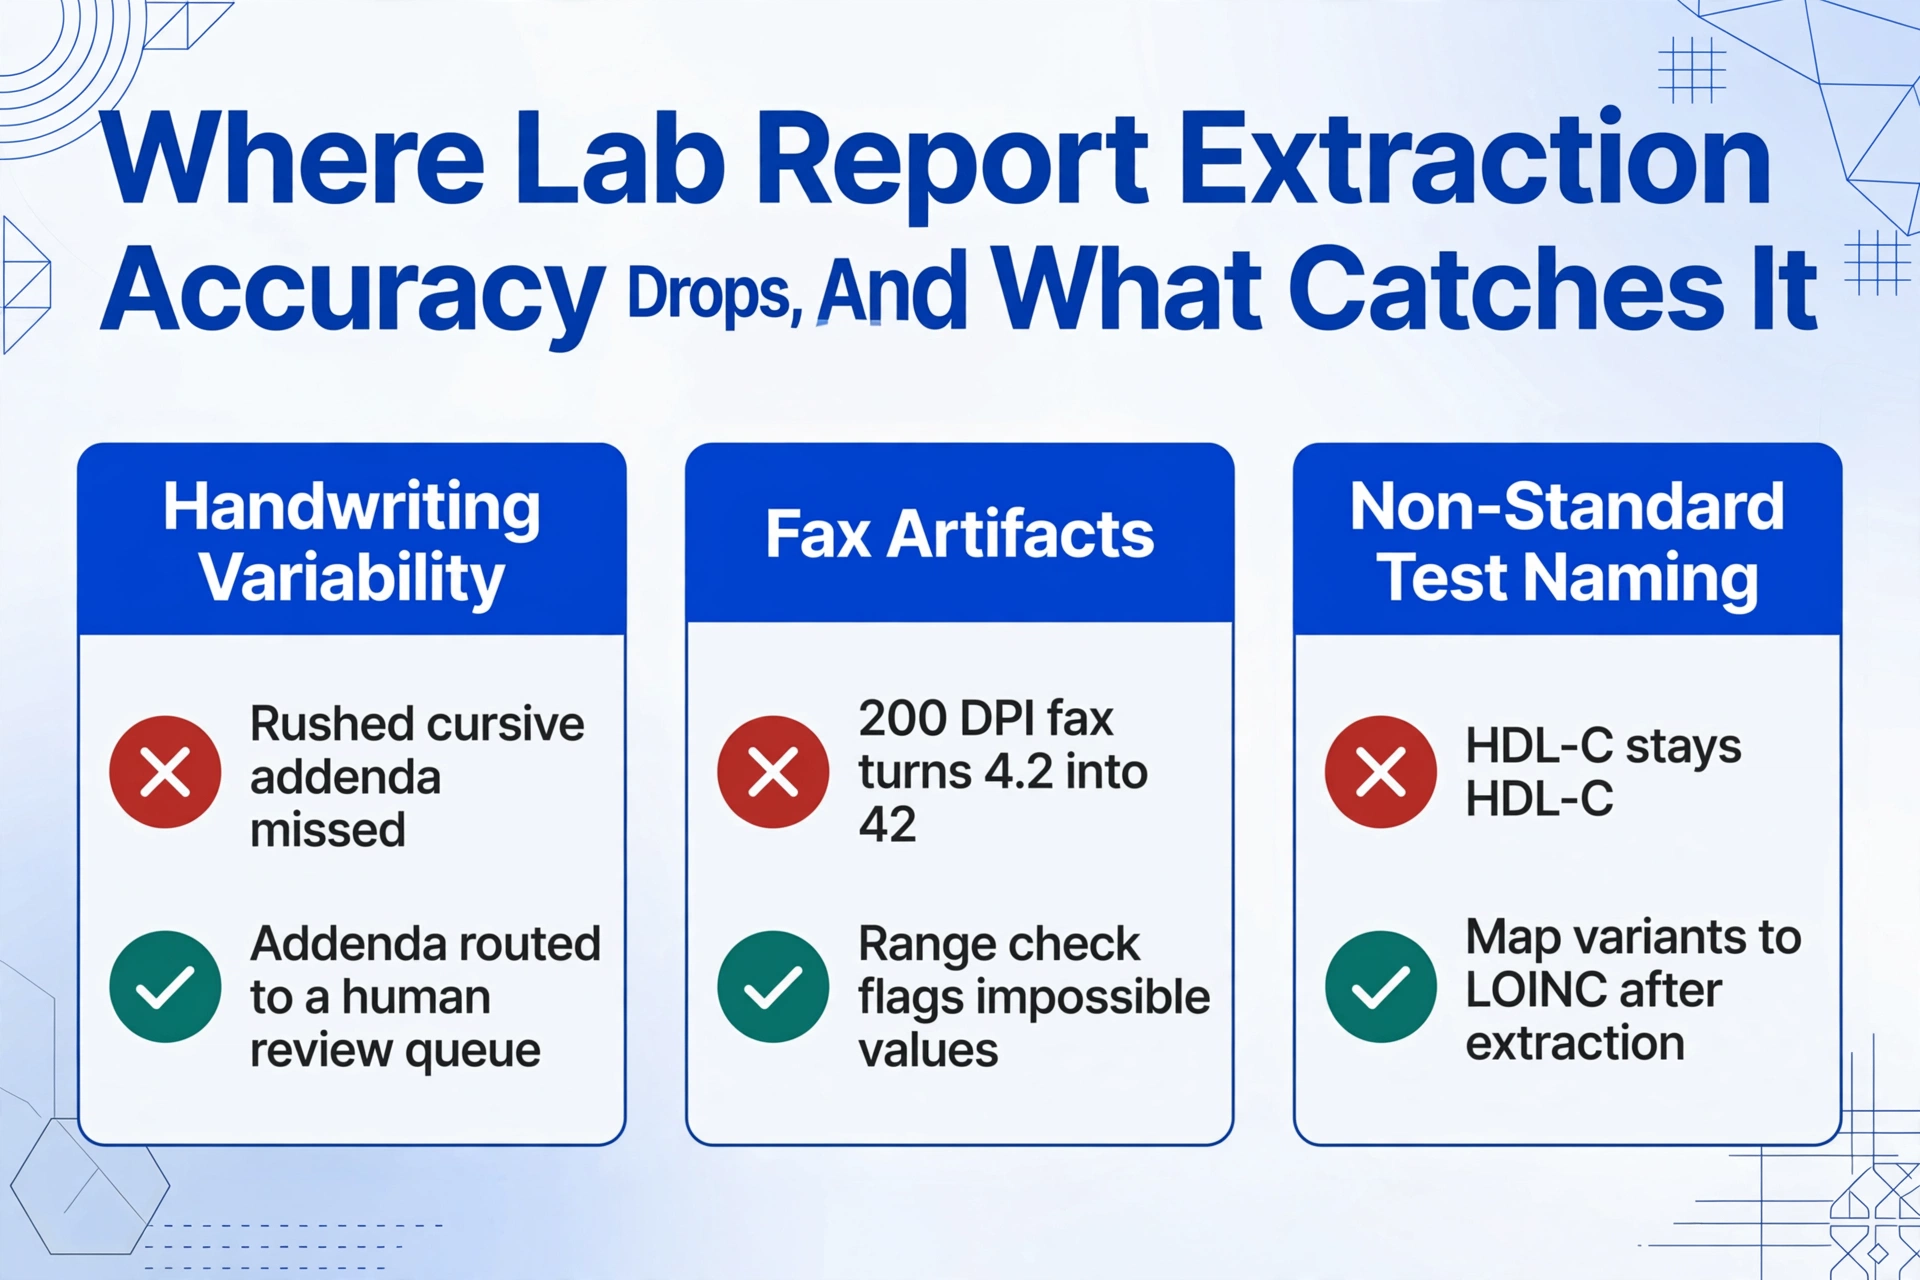
Variabilité de l'écriture manuscrite. La plus grande source d'écart de précision. Les annotations claires en lettres majuscules dans les marges (« Ajouter TSH ») sont généralement capturées. Les notes cursives rapides (« répéter dans 6 sem. — revérifier si >5,0 ») ne le sont pas — le problème réside dans l'ambiguïté contextuelle : les annotations chevauchent le texte imprimé, manquent de limites de champ claires et utilisent des abréviations qui varient selon le prestataire. Marche à suivre : Extraire d'abord les valeurs imprimées par machine (ce sont les résultats cliniques faisant autorité). Acheminer les ajouts manuscrits vers une file de révision humaine.
Artefacts de télécopie et numérisations de mauvaise qualité. La transmission par télécopie compresse à environ 200 DPI. Un point décimal dans « 4,2 » occupe environ 2×2 pixels — si la télécopie seuille automatiquement cette zone en blanc, « 4,2 » devient « 42 », une erreur décuplée qu'aucun système en aval ne détecte sans contrôle de plage. C'est un problème de qualité des données d'entrée, pas un problème d'IA. Marche à suivre : Remplacer la livraison par télécopie par un PDF sécurisé lorsque c'est possible. Lorsque la télécopie est inévitable, valider les résultats par rapport aux plages de référence : toute valeur en dehors des limites biologiquement raisonnables est signalée pour examen manuel.
Dénomination non standardisée des tests. « HDL Cholesterol », « HDL-C », « HDL » et « High-Density Lipoprotein » désignent tous le même analyte. L'IA extrait le texte tel qu'il figure sur la page — elle ne normalise pas ces termes vers une dénomination standard. Marche à suivre : Normalisation post-extraction à l'aide d'une table de correspondance ou d'un mappage de codes LOINC. L'extraction restitue le texte tel qu'imprimé ; la normalisation est une étape distincte pour laquelle des mappages bien établis existent.
Comment obtenir les meilleurs résultats
La précision dépend de la qualité des entrées, de la conception des colonnes et du processus de validation. Ces cinq choix vous placent dans la fourchette haute des plages ci-dessus.
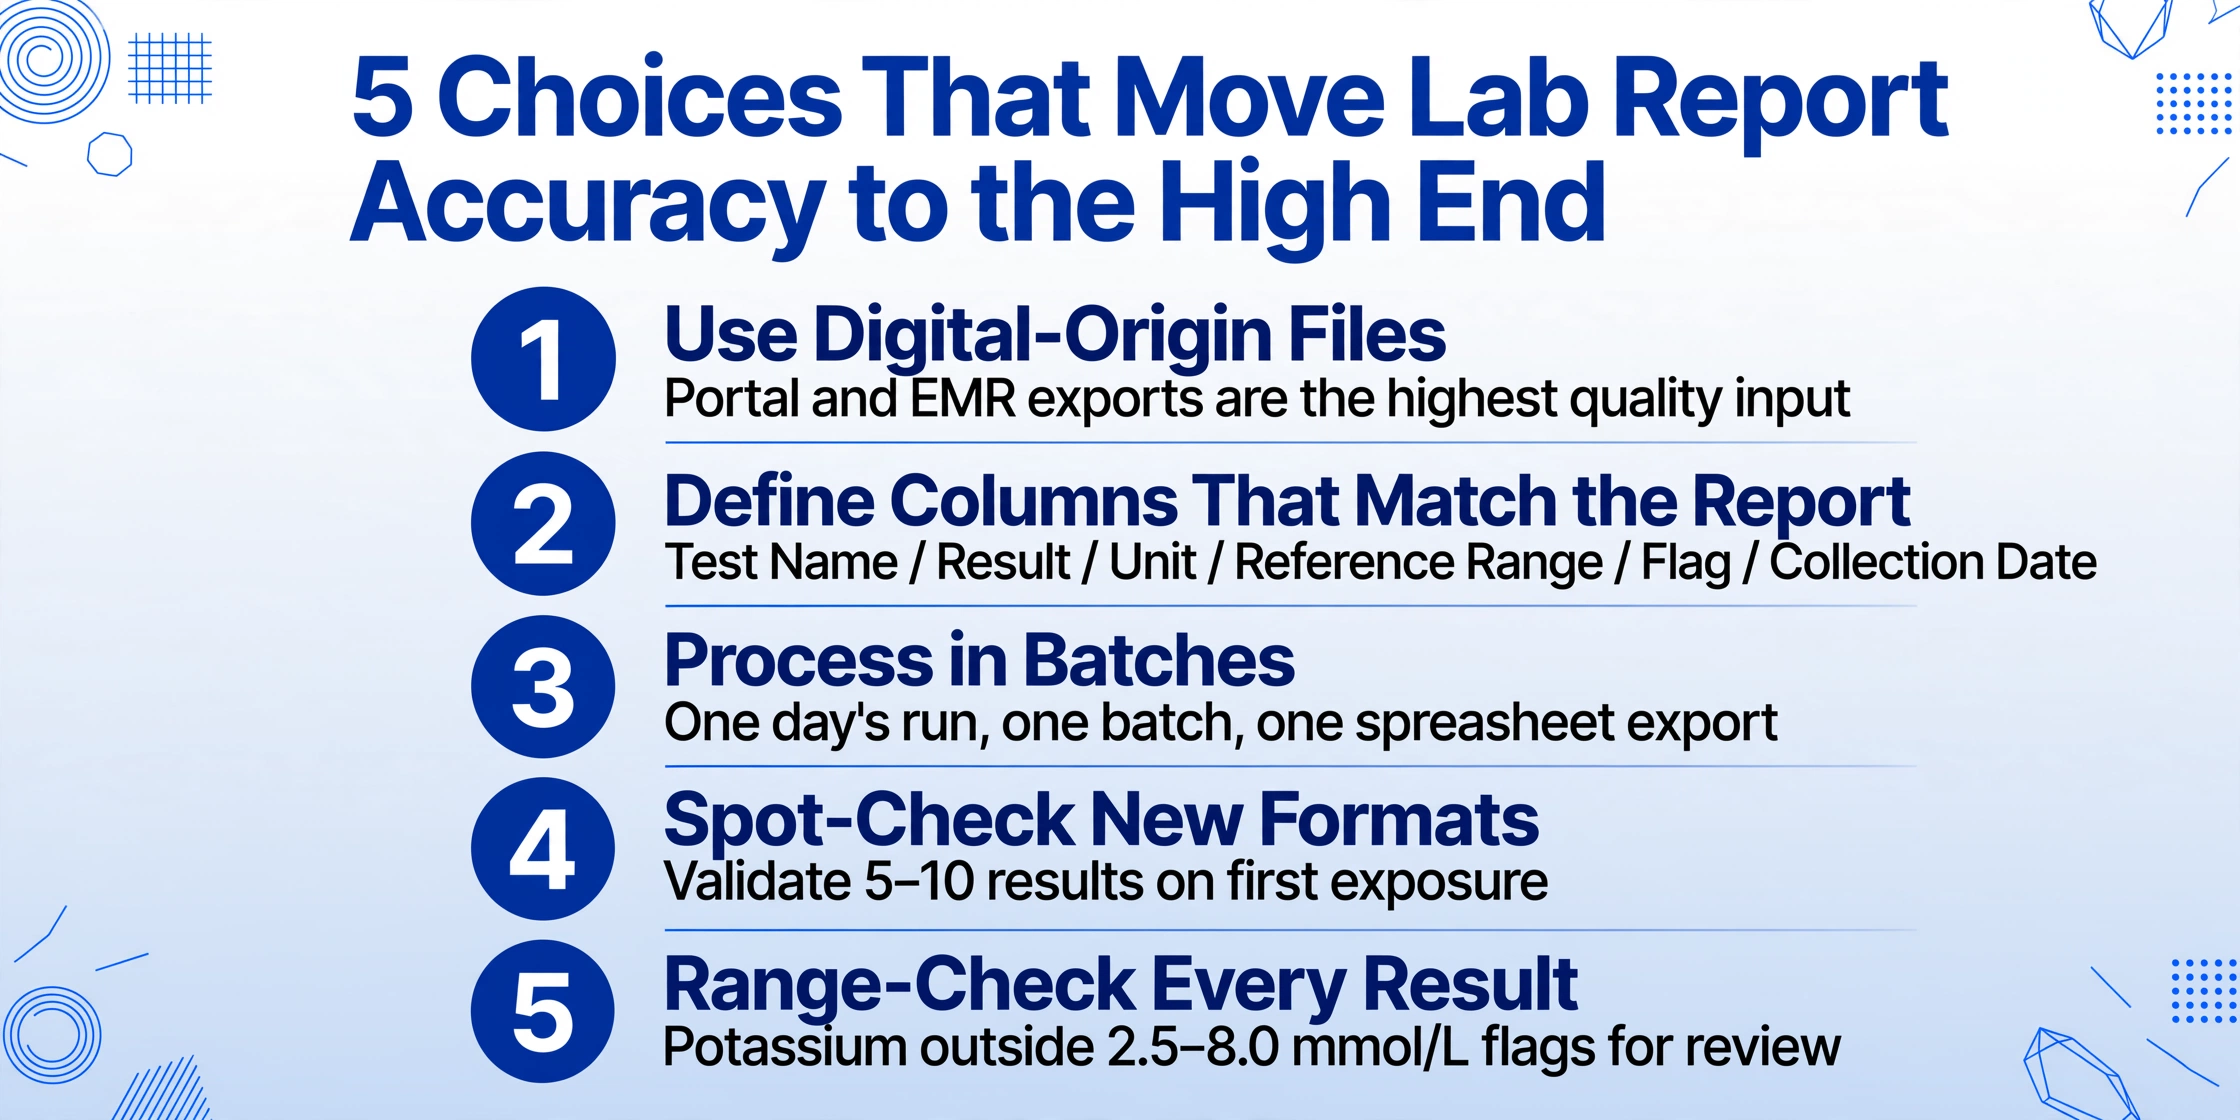
Nom du test / Résultat / Unité / Plage de référence / Indicateur / Date de collecte couvre 90 % et plus des cas d'usage. Évitez les colonnes fourre-tout — l'IA fonctionne mieux lorsque chaque champ de sortie a une cible sémantique claire.Exemples concrets
Suivi des résultats patients. Un cabinet de soins primaires reçoit des comptes rendus de laboratoire de Quest, LabCorp et d'un hôpital local dans trois formats différents. Un assistant médical passait auparavant 45 à 90 minutes par jour à saisir les valeurs d'HbA1c, LDL et créatinine depuis des PDF dans un suivi Excel. Avec l'extraction par IA, l'assistant télécharge le lot quotidien (15 à 25 comptes rendus), définit quatre colonnes et exporte les résultats en moins de deux minutes. Les 45 minutes de transcription quotidienne deviennent 10 minutes de vérification par sondage — soit environ 140 heures de temps de personnel récupérées par an.
Agrégation de données d'essais cliniques. Un coordinateur de recherche gère un essai multicentrique avec des résultats de laboratoire provenant de 8 sites utilisant différents systèmes LIS, en suivant 20 paramètres par patient et par visite. L'extraction manuelle consomme 8 heures par semaine pour 60 patients. L'extraction par IA avec un ensemble de colonnes défini traite tous les comptes rendus des sites en un seul lot, réduisant le temps hebdomadaire à environ 45 minutes de validation.
Supervision des opérations de laboratoire. Un responsable qualité de laboratoire hospitalier a besoin de données de tendance sur les délais de communication des valeurs critiques et les délais d'exécution, mais l'extraction ponctuelle de rapports LIS nécessite l'intervention du service informatique. L'extraction quotidienne par IA des comptes rendus de laboratoire dans un tableur structuré — capturant le nom du test, l'heure d'achèvement et les alertes critiques — alimente un tableau de bord Power BI en libre-service. Ce qui nécessitait auparavant un analyste de données est désormais un lot automatisé quotidien.
Pour un aperçu plus large de l'extraction de documents par IA dans le domaine de la santé — y compris les EOB, les formulaires CMS-1500 et les documents d'admission des patients — consultez notre guide sur l'OCR pour les documents de santé.
Questions fréquentes
L'IA peut-elle extraire les comptes rendus de laboratoire avec une précision de 100 % ?
Aucun système d'extraction ne fonctionne avec une précision de 100 % indéfiniment. L'IA visuelle atteint une précision de 95 à 99 % au niveau des champs sur des comptes rendus imprimés propres. Les 1 à 5 % restants incluent des cas particuliers comme un placement décimal ambigu ou du texte fusionné dû à une mauvaise qualité d'impression. Bonne pratique : attendez-vous à plus de 99 % sur les PDF d'origine numérique, validez lors de la première exposition à un nouveau format et vérifiez la plage des résultats numériques.
L'extraction de rapports de laboratoire par IA est-elle conforme à la HIPAA ?
La conformité à la HIPAA dépend de la gestion des données par l'outil, et non de sa capacité d'extraction. Les exigences clés incluent le chiffrement des transmissions (TLS 1.2+), le chiffrement des données au repos, et un contrat d'associé commercial (BAA) le cas échéant. Vérifiez que les pratiques de sécurité de toute plateforme répondent aux obligations de votre organisation.
La même IA fonctionne-t-elle pour les rapports Quest, LabCorp et hospitaliers ?
Oui — c'est l'avantage de l'extraction sémantique sans modèle par rapport à l'OCR positionnel. Vous définissez les colonnes une fois (Nom du test, Résultat, Unité, Plage de référence, Indicateur) et l'IA localise les valeurs correspondantes sur tout format de laboratoire en comprenant la signification de chaque champ. Un panel métabolique Quest, un profil lipidique LabCorp et une formule sanguine complète Epic Beaker d'un hôpital utilisent tous les mêmes définitions de colonnes, sans configuration par laboratoire. Les mêmes colonnes lisent également la capture d'écran d'un rapport de bilan de santé d'un patient, où l'objectif pratique est généralement de comparer le panel de cette année à celui de l'année dernière sans avoir à ressaisir l'un ou l'autre.
L'IA peut-elle extraire des chiffres manuscrits sur les rapports de laboratoire ?
Les chiffres en caractères d'imprimerie clairs — un technicien écrivant « 142 » dans un champ vide — sont généralement capturés. La précision diminue lorsque l'écriture manuscrite chevauche du texte imprimé ou utilise des formes de chiffres non standard. Pour les résultats imprimés par machine (la grande majorité des données de laboratoire), la précision est élevée. Pour les ajouts manuscrits, considérez l'extraction comme un brouillon nécessitant une vérification humaine.
Combien de rapports l'IA peut-elle traiter en un lot ?
Il n'y a pas de limite supérieure fixe. Les plateformes d'IA vision traitent les fichiers en parallèle. En pratique, 50 à 100 rapports de laboratoire (1 à 4 pages chacun) sont traités en quelques minutes, pas en heures. Le résultat est une feuille de calcul unique avec des en-têtes de colonnes cohérents, prête pour le tri, le filtrage et l'analyse croisée.
L'IA capture-t-elle les indicateurs anormaux comme H, L et Critique ?
Oui, lorsque la définition de colonne inclut un champ Indicateur, l'IA capture les annotations H/L/Critique avec chaque résultat — préservant le signal d'alerte clinique dans la sortie structurée. Incluez une colonne Indicateur dédiée et vérifiez-la sur le premier lot de chaque laboratoire.
De « L'IA peut-elle le faire ? » à « Comment le configurer ? »
La réponse pour la plupart des scénarios réels est oui : 95 à 99 % de précision sur les rapports imprimés qui constituent la production typique d'un laboratoire. Assez pour éliminer la saisie manuelle des résultats courants et libérer le personnel pour des tâches nécessitant un jugement humain.
La question pertinente a évolué. Il ne s'agit plus de savoir si la technologie fonctionne, mais comment concevoir un flux de travail qui achemine les rapports numériques propres vers une automatisation complète, signale les rapports faxés ou annotés pour révision humaine, et valide les résultats avec des contrôles de plage qui détectent l'erreur rare mais conséquente avant qu'elle n'atteigne un dossier patient.
Définissez votre jeu de colonnes. Importez un lot. Vérifiez la sortie. Voilà le flux de travail qui fonctionne aujourd'hui — pas dans une future mise à jour IA, mais avec les modèles de vision disponibles dès maintenant.