¿Puede la IA extraer
informes de laboratorio médicos?
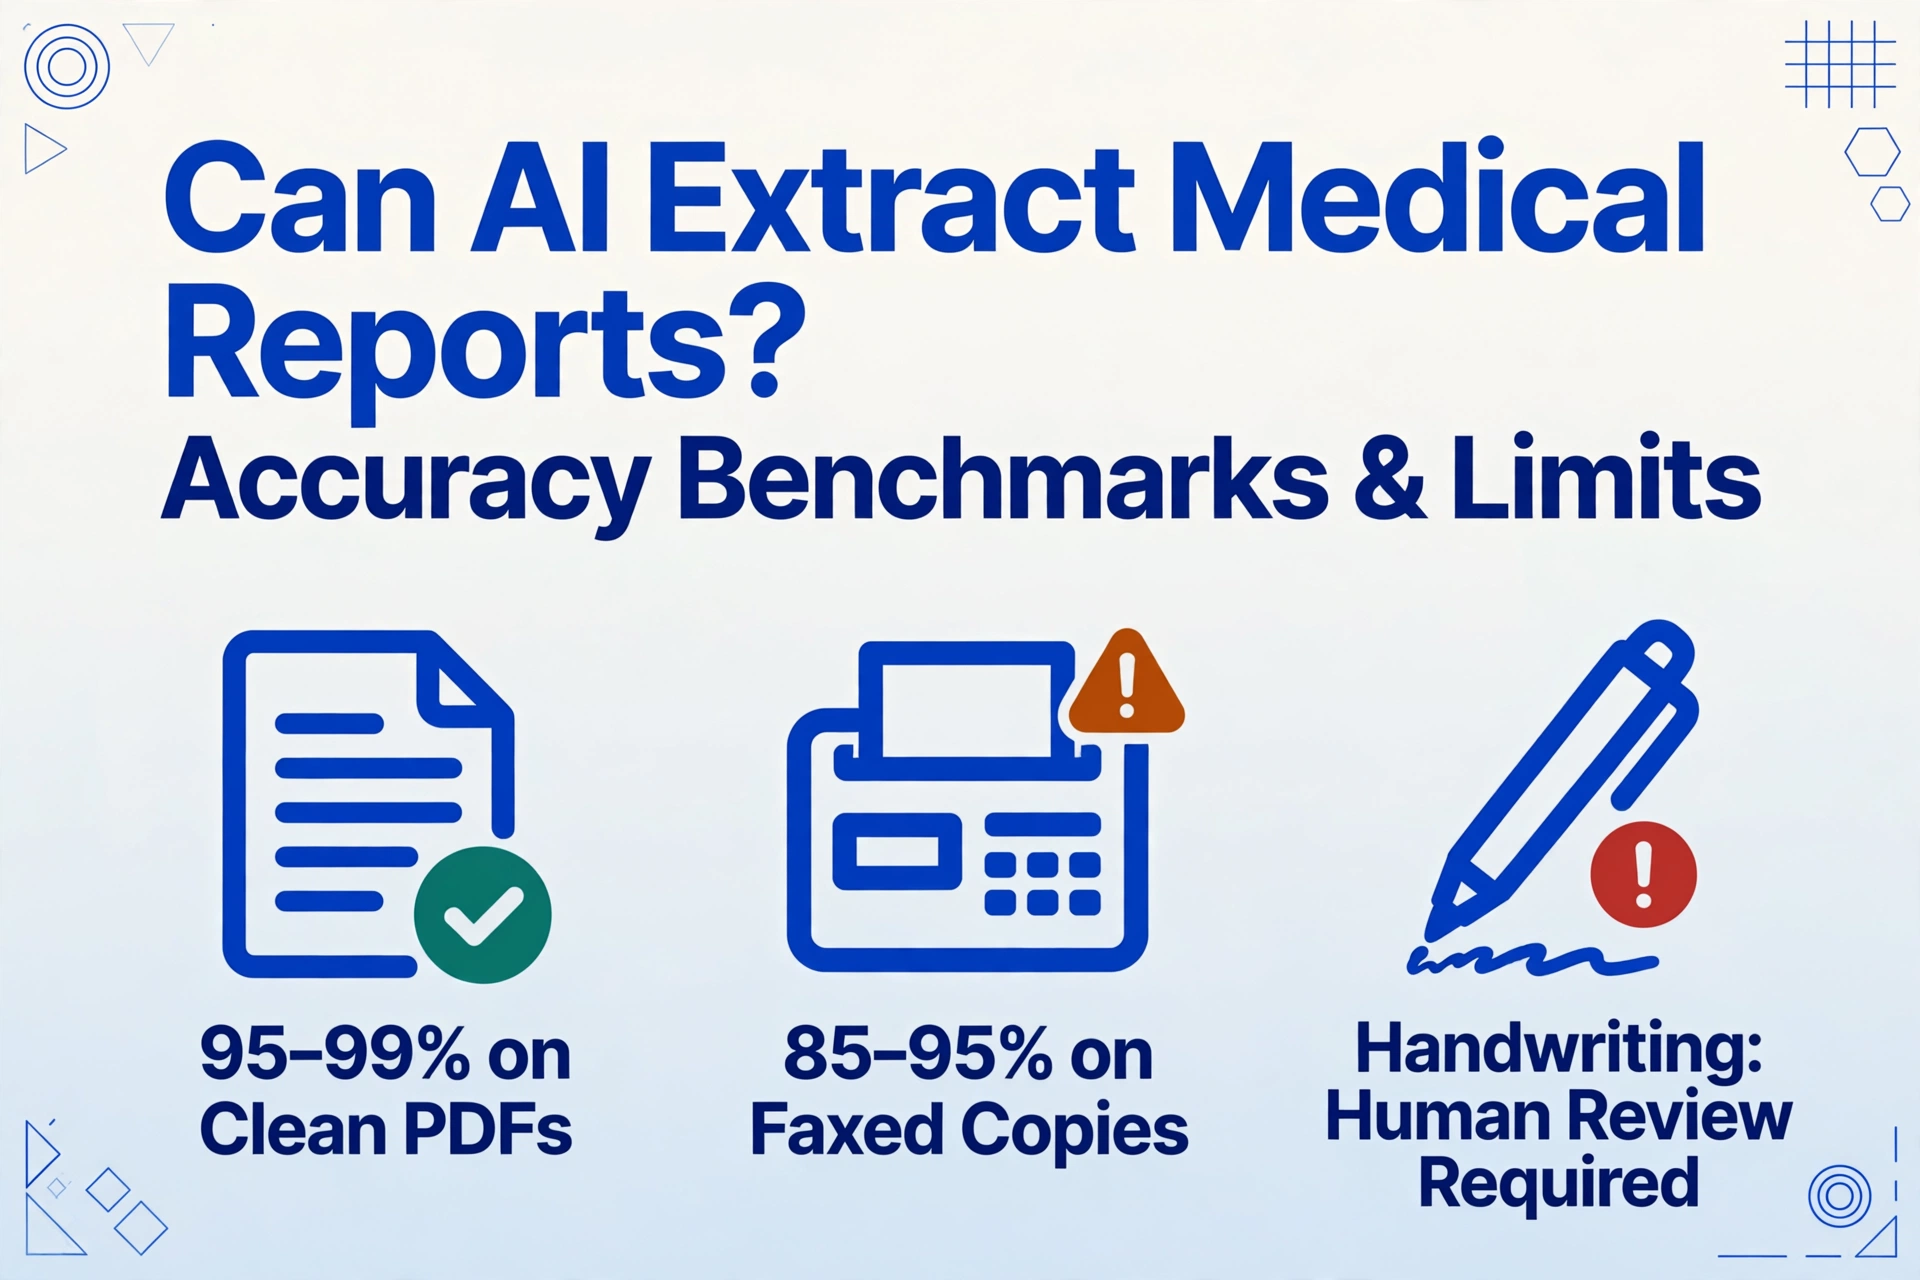
Sí. Los modelos modernos de visión por IA pueden extraer datos de informes de laboratorio médicos con una precisión del 95-99 % en informes impresos estándar de laboratorios importantes como Quest Diagnostics y LabCorp, aunque la precisión baja al 85-95 % en copias por fax y al 70-85 % cuando hay anotaciones manuscritas de médicos.
Conclusiones clave
- Una precisión del 95-99 % en un PDF limpio de Quest o LabCorp —el tipo que se descarga de un portal del paciente— no es un hito futuro. Es el rendimiento de la IA de visión disponible hoy.
- La caída al 70-85 % en copias por fax y anotadas no es una deficiencia del modelo. Un fax de tercera generación pierde detalle a nivel de píxel que ninguna IA posterior puede recuperar, y la escritura cursiva apresurada en los márgenes carece de los límites de campo en los que la IA se basa para la lectura contextual.
- La pregunta productiva ha cambiado: no «¿puede la IA extraer informes de laboratorio?», sino «qué informes omiten por completo la entrada manual, cuáles necesitan una verificación rápida de 10 segundos y cuáles se enrutan a una cola humana».
Esos rangos no son una limitación de la IA: reflejan la calidad del insumo. Un PDF limpio del portal del paciente de Quest conserva cada decimal y cada bandera. Un fax de tercera generación no lo hace. La pregunta real es: ¿con qué calidad de insumo la extracción se vuelve lo suficientemente confiable para su flujo de trabajo?
Conclusión: los modelos de visión por IA extraen de manera confiable resultados de pruebas estructurados de informes de laboratorio impresos — Quest, LabCorp, impresiones de LIS de hospitales, PDFs de laboratorios de referencia. Pero los casos límite (escritura a mano, artefactos de fax, escaneos deficientes) requieren diseño de procesos, no solo mejor IA.
Precisión según la condición del documento
El mismo modelo de visión que lee un PDF de LabCorp con precisión casi perfecta puede tener dificultades con los mismos datos en un fax arrugado escaneado con un teléfono inteligente. Esto es lo que puede esperar según la calidad del insumo.
| Condición del documento | Precisión a nivel de campo | Factor limitante clave |
|---|---|---|
| Informe impreso estándar (Quest / LabCorp / LIS de hospital) | 95–99% | Texto mecanografiado limpio, diseño de columnas consistente |
| PDF del portal del paciente o exportación de EMR | 95–99% | Origen digital: sin degradación de calidad, el insumo ideal |
| Fotocopia / escaneo limpio a ≥300 DPI | 90–97% | La pérdida de contraste y la leve inclinación afectan la detección de líneas |
| Copia por fax (una sola pasada) | 85–95% | Resolución de ~200 DPI, rayas horizontales, caracteres finos perdidos |
| Fax de múltiples generaciones o fotocopia deficiente | 75–88% | Caracteres borrosos, decimales fusionados, límites de columnas desvanecidos |
| Anotaciones manuscritas en la impresión | 70–85% | La legibilidad varía: se captura la letra de molde, se pierde la cursiva apresurada |
| Foto con teléfono inteligente en iluminación variable | 65–85% | Reflejos, sombras, distorsión de perspectiva, desenfoque de movimiento |
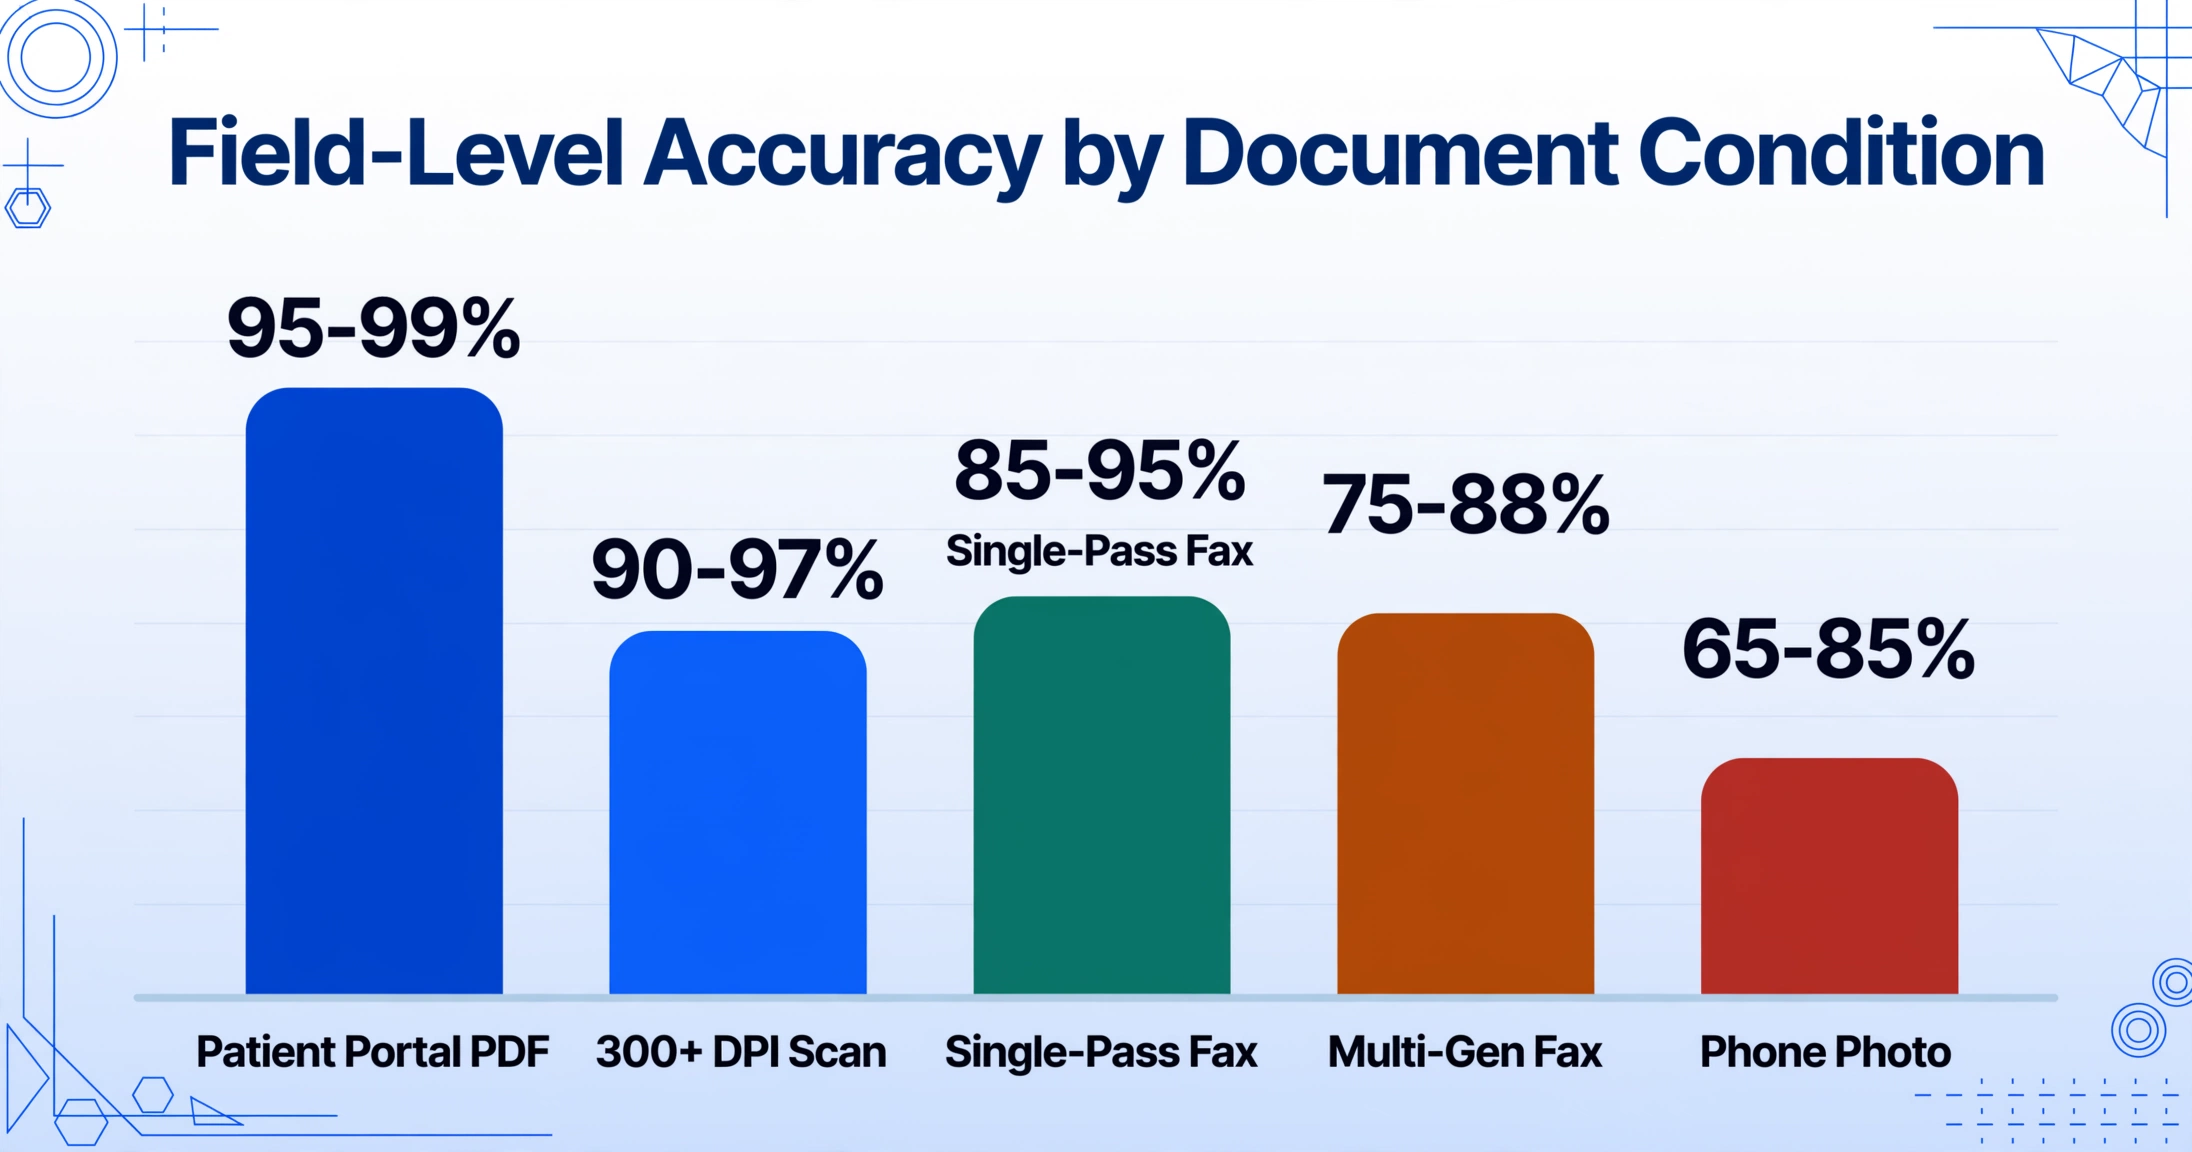
Estos rangos provienen de pruebas en múltiples implementaciones de atención médica, incluida la validación interna en más de 500 informes de laboratorio de 12 plataformas LIS diferentes. El extremo superior asume una buena condición del documento y columnas bien definidas. El extremo inferior representa casos límite: diseños inusuales o texto degradado.
Conclusión práctica: los PDFs limpios y los buenos escaneos son lo suficientemente precisos para un flujo de trabajo de verificación por muestreo (verifique una muestra, confíe en el resto). Los informes por fax y con anotaciones requieren revisión humana — ningún cambio en el modelo de IA soluciona eso.
Lo que la IA hace bien
La IA de Visión aporta tres capacidades que la hacen ideal para la extracción de informes de laboratorio, algo que el OCR tradicional o las herramientas basadas en plantillas no ofrecen de forma fiable.
Mapeo semántico de campos. El OCR tradicional genera cuadros de texto sin procesar; se necesita un paso aparte para determinar cuál es el nombre de la prueba, cuál el resultado y cuál el rango de referencia. La IA de Visión lee el documento de forma holística, entendiendo que "Glucosa" es el nombre de la prueba, "95" su resultado, "mg/dL" la unidad y "(70–99)" el rango de referencia. En esto se basa la Extracción de Columnas Personalizadas: defines las columnas que deseas y la IA encuentra los datos comprendiendo lo que cada campo significa en lugar de dónde está. Un informe de Quest que lista las pruebas verticalmente y un informe hospitalario con tabla horizontal funcionan con las mismas definiciones de columna.
Preservación de banderas y rangos de referencia. Un resultado de laboratorio es un número más el contexto que indica al clínico si es normal, anormal o crítico. Una IA que extrae "115 mg/dL" pero omite la bandera "H" ha entregado datos incompletos: la salida parece normal aunque el original lo marcó como alto. La IA de Visión trata el resultado, la unidad, el rango y la bandera como un grupo semántico único, preservando la señal clínica en la salida estructurada.
Independencia de formato entre plataformas LIS. Un hemograma de Epic Beaker muestra los resultados en una tabla de tres columnas. El mismo hemograma de Sunquest usa una sola columna con rangos entre paréntesis. Quest coloca las banderas en una columna a la derecha; LabCorp las imprime después del valor. Una herramienta basada en plantillas necesita configuraciones separadas para cada una. La IA de Visión lee las relaciones entre elementos de texto sin importar la posición: defines "Resultado" y encuentra el valor numérico adyacente a cada nombre de prueba, ya sea a la derecha, abajo o en una celda separada. Para una cobertura más profunda, consulta nuestra guía completa de extracción de datos de informes de laboratorio.
Donde la IA todavía falla
Ser honestos sobre las limitaciones es lo que separa una recomendación útil de un discurso de ventas.
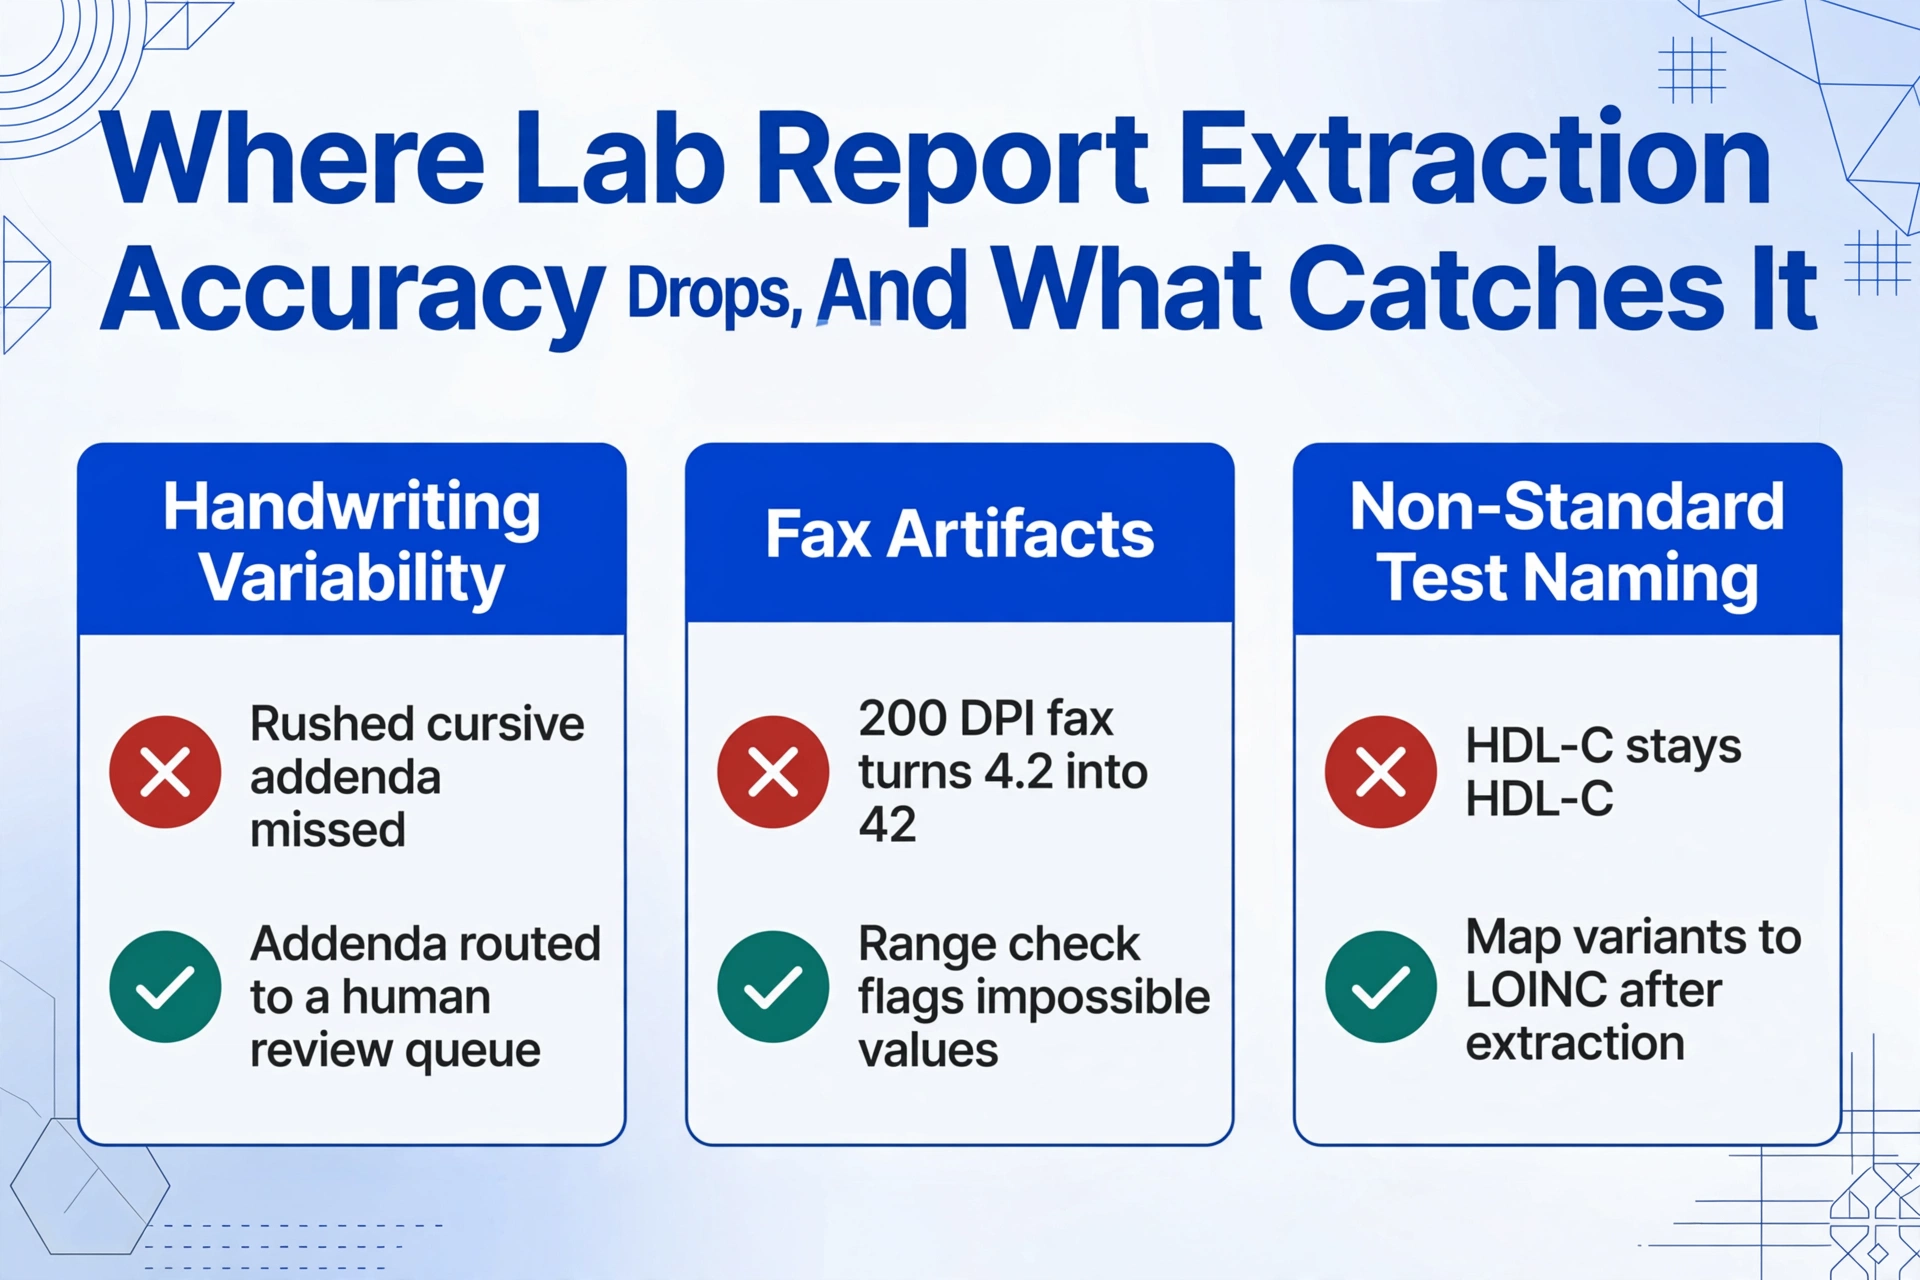
Variabilidad de la escritura a mano. La mayor brecha de precisión. Las anotaciones claras en letra de imprenta en los márgenes ("Añadir TSH") generalmente se capturan. Las notas rápidas en cursiva ("repetir en 6 sem — verificar si >5.0") no se capturan; el problema es la ambigüedad del contexto: las anotaciones se superponen con el texto impreso, carecen de límites de campo claros y usan abreviaturas que varían según el proveedor. Qué hacer: Extraiga primero los valores impresos por máquina (esos son los resultados clínicos autorizados). Envíe las adiciones manuscritas a una cola de revisión humana.
Artefactos de fax y escaneos deficientes. La transmisión por fax comprime a aproximadamente 200 DPI. Un punto decimal en "4.2" ocupa aproximadamente 2×2 píxeles; si el fax establece automáticamente ese umbral como blanco, "4.2" se convierte en "42", un error diez veces mayor que ningún sistema posterior detecta sin verificación de rangos. Esto es un problema de calidad de entrada, no un problema de IA. Qué hacer: Reemplace la entrega por fax con PDF seguro cuando sea posible. Cuando el fax sea inevitable, valide los resultados contra los rangos de referencia: cualquier valor fuera de los límites biológicamente razonables se marca para revisión manual.
Nombres de pruebas no estándar. "HDL Cholesterol," "HDL-C," "HDL" y "High-Density Lipoprotein" se refieren al mismo analito. La IA extrae el texto que aparece en la página; no lo normaliza a un término estándar. Qué hacer: Normalización posterior a la extracción con una tabla de referencia o mapeo de códigos LOINC. La extracción entrega el texto tal como está impreso; la normalización es un paso separado con mapeos bien establecidos disponibles.
Cómo Obtener los Mejores Resultados
La precisión depende de la calidad de la entrada, el diseño de las columnas y el flujo de trabajo de validación. Estas cinco decisiones lo acercan al extremo superior de los rangos mencionados anteriormente.
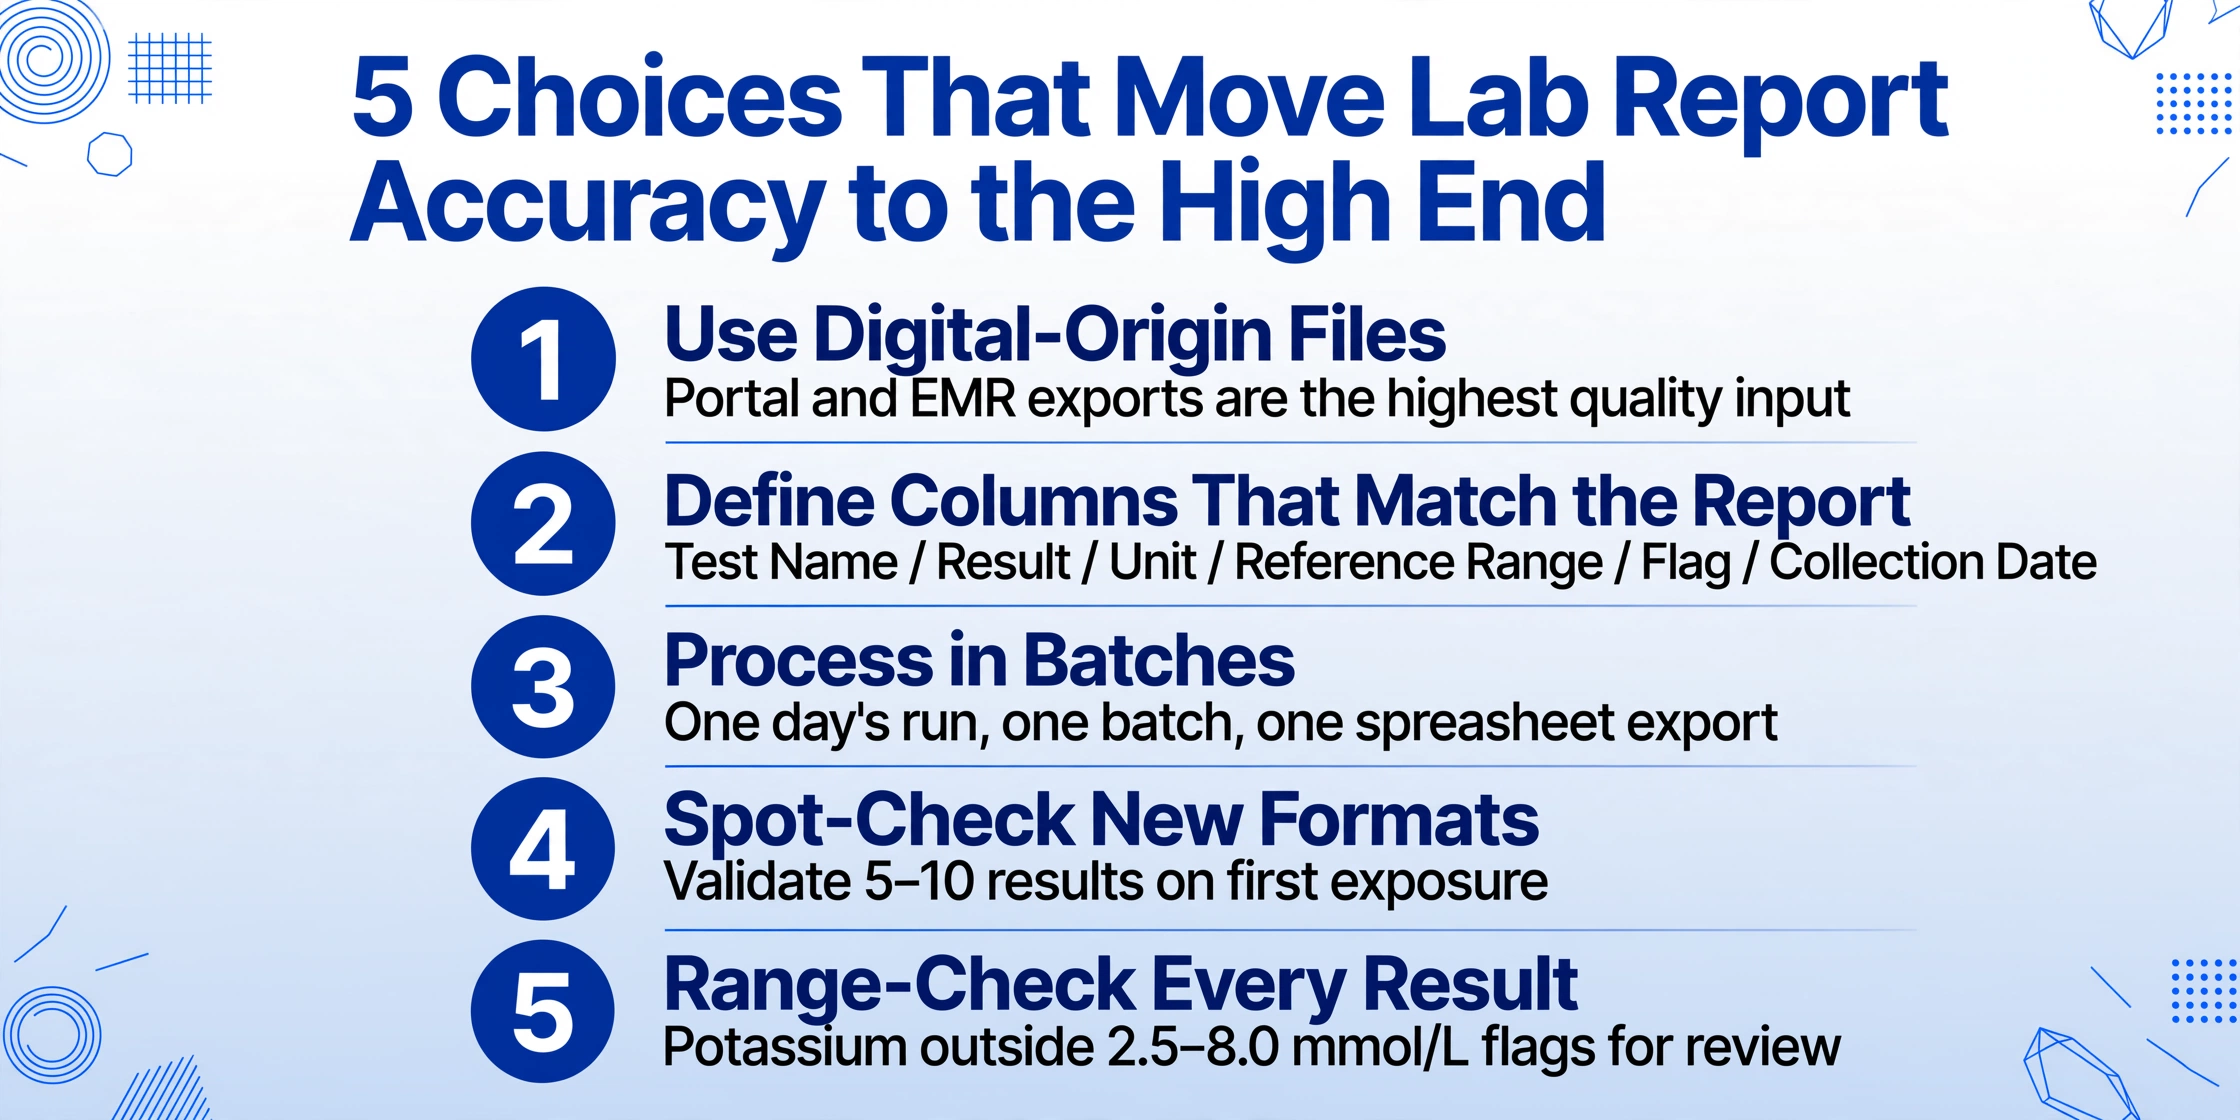
Nombre de la Prueba / Resultado / Unidad / Rango de Referencia / Indicador / Fecha de Recopilación cubre más del 90% de los casos de uso. Evite las columnas generales: la IA funciona mejor cuando cada campo de salida tiene un objetivo semántico claro.Ejemplos reales
Seguimiento de resultados de pacientes. Un consultorio de atención primaria recibe informes de laboratorio de Quest, LabCorp y un hospital local en tres formatos. Un asistente médico dedicaba antes entre 45 y 90 minutos al día a escribir valores de HbA1c, LDL y creatinina de archivos PDF en un registro de Excel. Con la extracción por IA, el asistente sube el lote diario (15 a 25 informes), define cuatro columnas y exporta los resultados en menos de dos minutos. Los 45 minutos diarios de transcripción se convierten en 10 minutos de verificación por muestreo: aproximadamente 140 horas de tiempo del personal recuperadas al año.
Agregación de datos de ensayos clínicos. Un coordinador de investigación gestiona un ensayo multicéntrico con resultados de laboratorio de 8 sitios que usan diferentes plataformas LIS, y realiza un seguimiento de 20 parámetros por paciente por visita. La extracción manual consume 8 horas a la semana para 60 pacientes. La extracción por IA con un conjunto de columnas definido procesa todos los informes de los sitios en un solo lote, reduciendo el tiempo semanal a unos 45 minutos de validación.
Monitoreo de operaciones de laboratorio. Un gerente de calidad de un laboratorio hospitalario necesita datos de tendencias sobre la notificación de valores críticos y los tiempos de respuesta, pero obtener informes LIS ad hoc requiere la intervención de TI. La extracción diaria por IA de informes de laboratorio en una hoja de cálculo estructurada —que captura el nombre de la prueba, la hora de finalización y las alertas críticas— alimenta un panel de Power BI de autoservicio. Lo que antes necesitaba un analista de datos ahora es un lote diario automatizado.
Para una visión más amplia de la extracción de documentos por IA en el sector salud —incluyendo EOB, formularios CMS-1500 y documentos de admisión de pacientes— consulte nuestra guía de OCR para documentos sanitarios.
Preguntas frecuentes
¿Puede la IA extraer informes de laboratorio con un 100% de precisión?
Ningún sistema de extracción opera con un 100% de precisión de forma indefinida. La IA de visión alcanza una precisión del 95-99% a nivel de campo en informes impresos limpios. El 1-5% restante incluye casos atípicos como colocación ambigua de decimales o texto fusionado por mala calidad de impresión. Mejor práctica: espere un 99%+ en PDF de origen digital, valide en la primera exposición a un nuevo formato y verifique el rango de los resultados numéricos.
¿La extracción de informes de laboratorio con IA cumple con HIPAA?
El cumplimiento de HIPAA depende del manejo de datos de la herramienta, no de su capacidad de extracción. Los requisitos clave incluyen transmisión cifrada (TLS 1.2+), almacenamiento cifrado en reposo y un Acuerdo de Asociado Comercial (BAA) cuando corresponda. Verifique que las prácticas de seguridad de cualquier plataforma cumplan con las obligaciones de su organización.
¿La misma IA funciona con informes de Quest, LabCorp y hospitales?
Sí — esa es la ventaja de la extracción semántica sin plantilla frente a la OCR posicional. Usted define las columnas una vez (Nombre de la Prueba, Resultado, Unidad, Rango de Referencia, Indicador) y la IA localiza los valores correspondientes en cualquier formato de laboratorio al comprender qué significa cada campo. Un panel metabólico de Quest, un perfil lipídico de LabCorp y un hemograma completo de Epic Beaker de un hospital usan las mismas definiciones de columnas sin configuración por laboratorio. Las mismas columnas también leen la captura de pantalla de un informe de chequeo de salud de un paciente, donde el objetivo práctico suele ser comparar el panel de este año con el del año pasado sin volver a escribir ninguno de los dos.
¿Puede la IA extraer números escritos a mano en informes de laboratorio?
Los números de bloque claramente impresos — un técnico que escribe "142" en un campo en blanco — generalmente se capturan. La precisión disminuye cuando la escritura a mano se superpone al texto impreso o usa formas numéricas no estándar. Para resultados impresos por máquina (la gran mayoría de los datos de laboratorio), la precisión es alta. Para anotaciones escritas a mano, trate la extracción como un borrador que requiere verificación humana.
¿Cuántos informes puede procesar la IA en un lote?
No hay un límite superior fijo. Las plataformas de IA de visión procesan archivos de forma concurrente. En la práctica, 50–100 informes de laboratorio (1–4 páginas cada uno) se procesan en minutos, no en horas. El resultado es una sola hoja de cálculo con encabezados de columna consistentes, lista para ordenar, filtrar y analizar con tablas dinámicas.
¿La IA captura indicadores anormales como H, L y Crítico?
Sí, cuando la definición de columna incluye un campo de Indicador, la IA captura las anotaciones H/L/Crítico junto con cada resultado — preservando la señal de alerta clínica en la salida estructurada. Incluya una columna de Indicador dedicada y verifíquela en el primer lote de cada laboratorio.
De "¿Puede la IA hacer esto?" a "¿Cómo lo configuro?"
La respuesta para la mayoría de los escenarios reales es sí: 95-99% de precisión en los informes impresos que constituyen la salida típica de un laboratorio. Suficiente para eliminar la transcripción manual de resultados rutinarios y liberar al personal para tareas que requieren juicio humano.
La pregunta productiva ha cambiado. Ya no es si la tecnología funciona, sino cómo diseñar un flujo de trabajo que envíe informes digitales limpios a la automatización total, marque los faxeados o anotados para revisión humana, y valide la salida con controles de rango que detecten el error raro pero grave antes de que llegue al registro del paciente.
Defina su conjunto de columnas. Cargue un lote. Verifique la salida. Ese es el flujo de trabajo que funciona hoy — no en una futura actualización de IA, sino con los modelos de visión disponibles ahora mismo.