Extraction de documents d'essais cliniques
Au-delà d'une ligne par patient
En 2021, les équipes de gestion des données cliniques de sept sociétés pharmaceutiques ont regroupé vingt études de phase III terminées et compté chaque requête de données soulevée à leur encontre. Le total s'élevait à 1 939 606 requêtes pour 20 125 participants. Les cinq types de formulaires ayant généré plus de la moitié de tout ce trafic de requêtes étaient les médicaments concomitants, le laboratoire, les événements indésirables, l'exposition et la responsabilité du médicament. Ces cinq formulaires ont un point commun, et ce n'est pas leur mise en page : aucun d'entre eux ne correspond à un enregistrement par patient. Cet article porte sur ce fait structurel et sur ce que cela signifie lorsque vous essayez d'exécuter une extraction de documents d'essais cliniques et que vous vous retrouvez avec une feuille de calcul qui ne correspond pas à la façon dont les données se comportent réellement.
Points clés à retenir
- 1 939 606 requêtes de données pour 20 125 participants, et plus de la moitié provenaient de cinq types de formulaires partageant une caractéristique commune : aucun d'entre eux ne correspond à un enregistrement par patient.
- Les données d'essai arrivent sous forme de tableaux, un sujet avec de nombreux événements indésirables et un événement avec de nombreux enregistrements associés, tandis qu'une feuille de calcul suppose qu'une ligne correspond à une chose, donc l'arriéré est structurel et ne relève pas d'une saisie plus rapide.
- Définissez d'abord la granularité dont vous avez besoin, une ligne par événement ou une ligne par sujet avec les visites en colonnes, et les colonnes se définissent d'elles-mêmes, ne laissant que la vérification humaine.
L'ensemble des documents d'essai clinique et le contenu de chacun
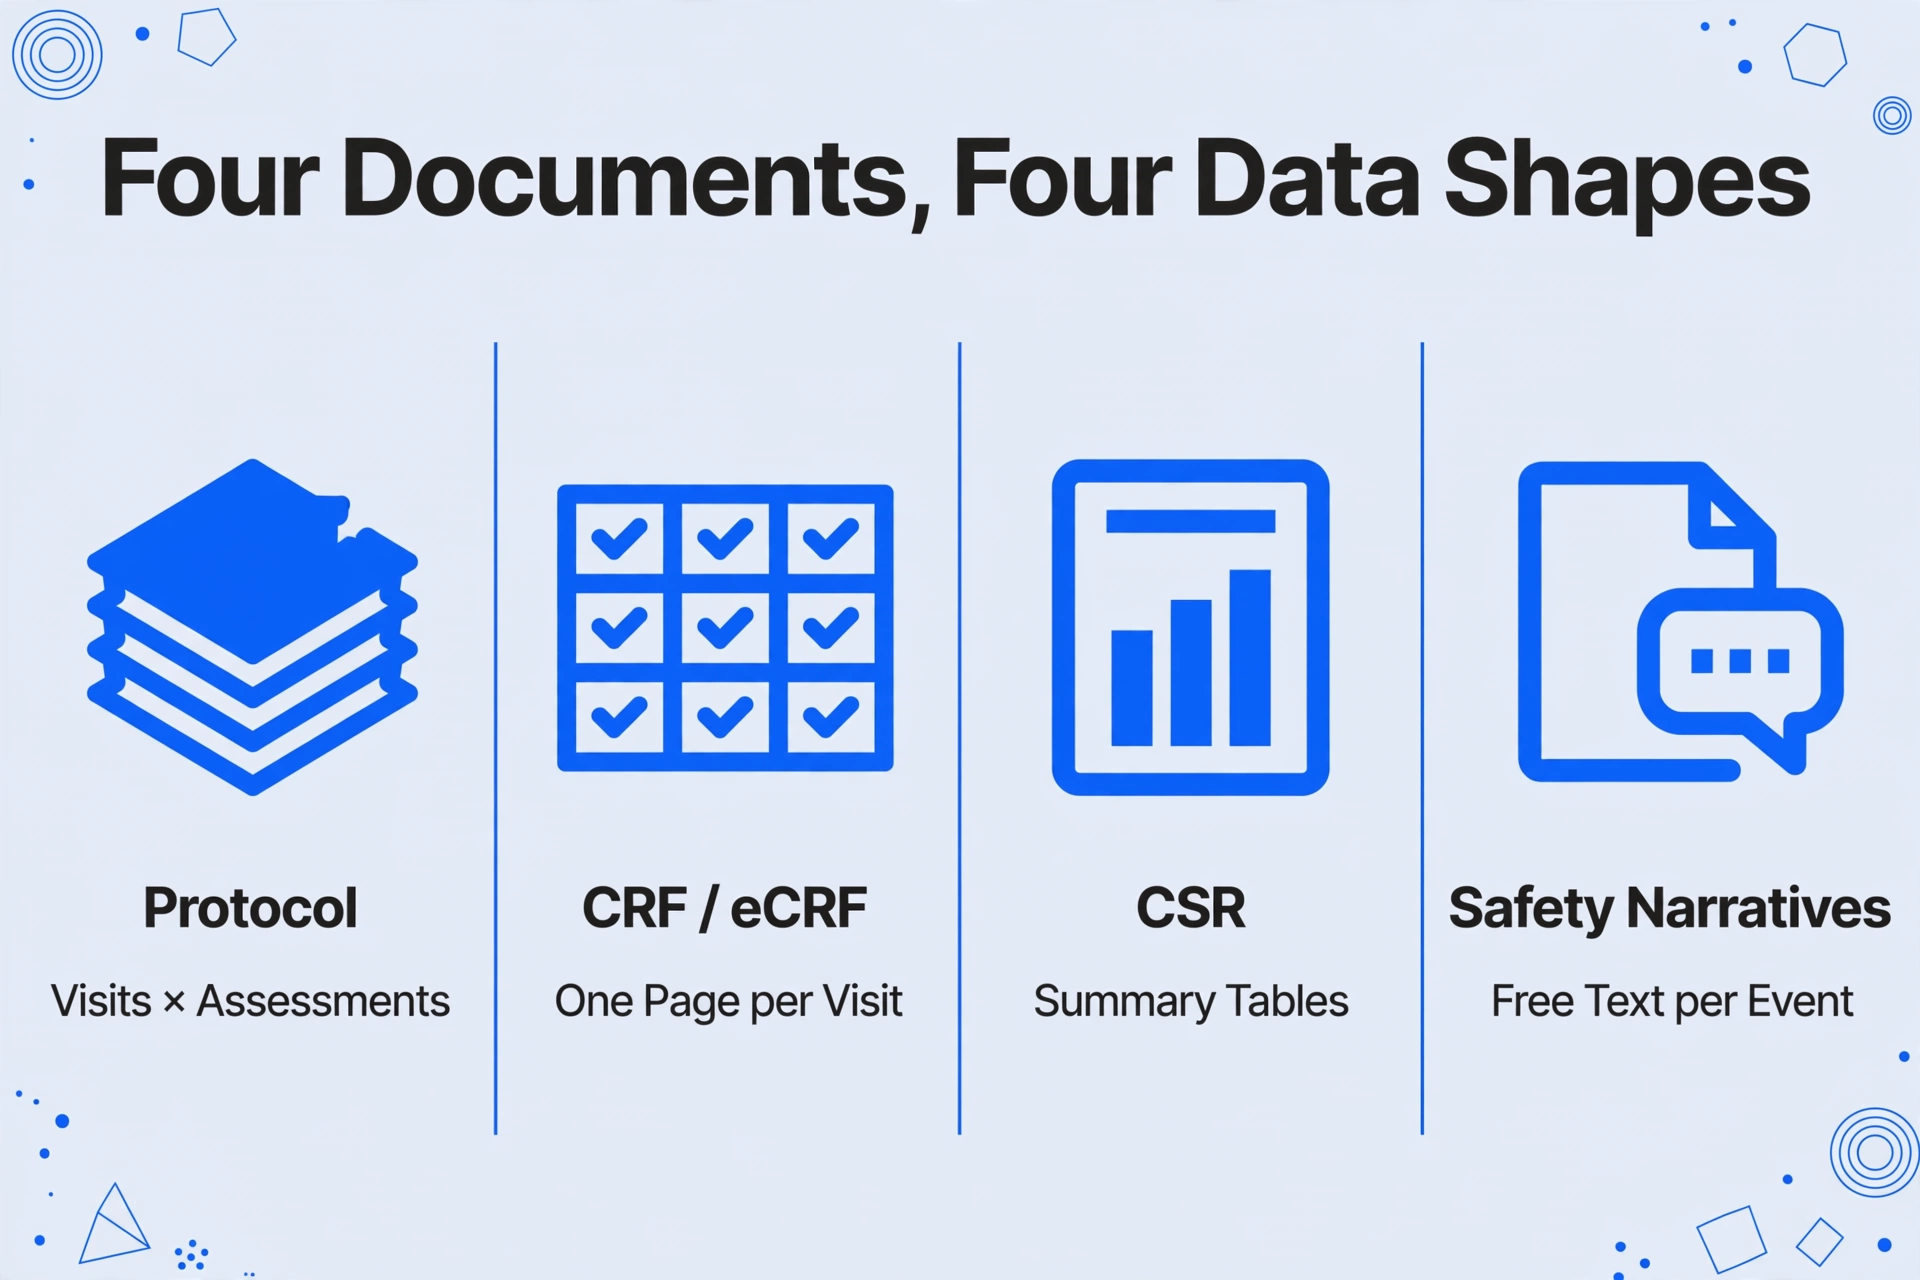
La documentation d'essai clinique ne se limite pas à un seul type de document. Il s'agit d'une petite famille de documents qui décrivent la même étude sous quatre angles différents, et chaque angle produit un format de données différent.
| Document | Ce que c'est | Format des données qu'il contient |
|---|---|---|
| Protocole | Le plan de l'étude, y compris le calendrier des évaluations : quelles procédures ont lieu à quelle visite pour chaque participant | Une grille de visites × évaluations (une ligne par visite, une colonne par procédure) |
| CRF / eCRF | Le formulaire de rapport de cas, l'instrument qui capture ce qui s'est passé à chaque visite | Une page par visite et par sujet, avec des blocs répétés pour les événements |
| CSR | Le rapport d'étude clinique, le résumé réglementaire intégré de l'ensemble de l'étude | Tableaux récapitulatifs, listes de patients et récits, décrivant tous les mêmes événements à différents niveaux de détail |
| Récits de sécurité | Comptes rendus en prose des décès, des événements indésirables graves et d'autres événements signalés | Texte libre, un récit par événement |
Le rapport d'étude clinique a une structure fixe par conception. L'ICH E3, la ligne directrice internationale pour la structure et le contenu des rapports d'étude clinique, place le résumé des événements indésirables dans la section 12.2, les tableaux détaillés des événements indésirables dans la section 14.3.1, et les listes patient par patient des événements indésirables dans la section 16.2.7. La section 12.2.2 demande des tableaux qui listent chaque événement indésirable, le nombre de patients dans chaque groupe de traitement chez qui il s'est produit, et le taux d'occurrence, groupés par système organique et répartis par gravité et causalité. La section 16.2.7 est l'endroit où les mêmes événements apparaissent un sujet à la fois.
C'est le premier endroit où l'extraction de données du rapport d'étude clinique devient difficile : les mêmes données d'événements indésirables existent sous trois formes dans un seul document (un tableau agrégé, une liste par sujet et un récit), et un lecteur qui demande à l'outil les « événements indésirables » sans préciser quelle forme il veut obtiendra celle que le modèle trouve en premier.
Sous le rapport, les données de soumission suivent le modèle CDISC Study Data Tabulation Model. Son domaine des événements indésirables est défini comme un enregistrement par événement par sujet, ce qui est une façon formelle de dire qu'un même participant peut apparaître plusieurs fois dans le même tableau. Les détails associés à un événement, comme la séquence des grades de toxicité qu'il a traversés, vivent dans un domaine séparé relié à l'enregistrement d'événement indésirable par une relation un-à-plusieurs. Si vous n'avez jamais extrait que des factures ou des reçus, où un document équivaut à une ligne, c'est la partie qui vous surprendra. Le modèle complet est documenté par CDISC.
Là où un tableau plat rencontre un tableau à plusieurs dimensions
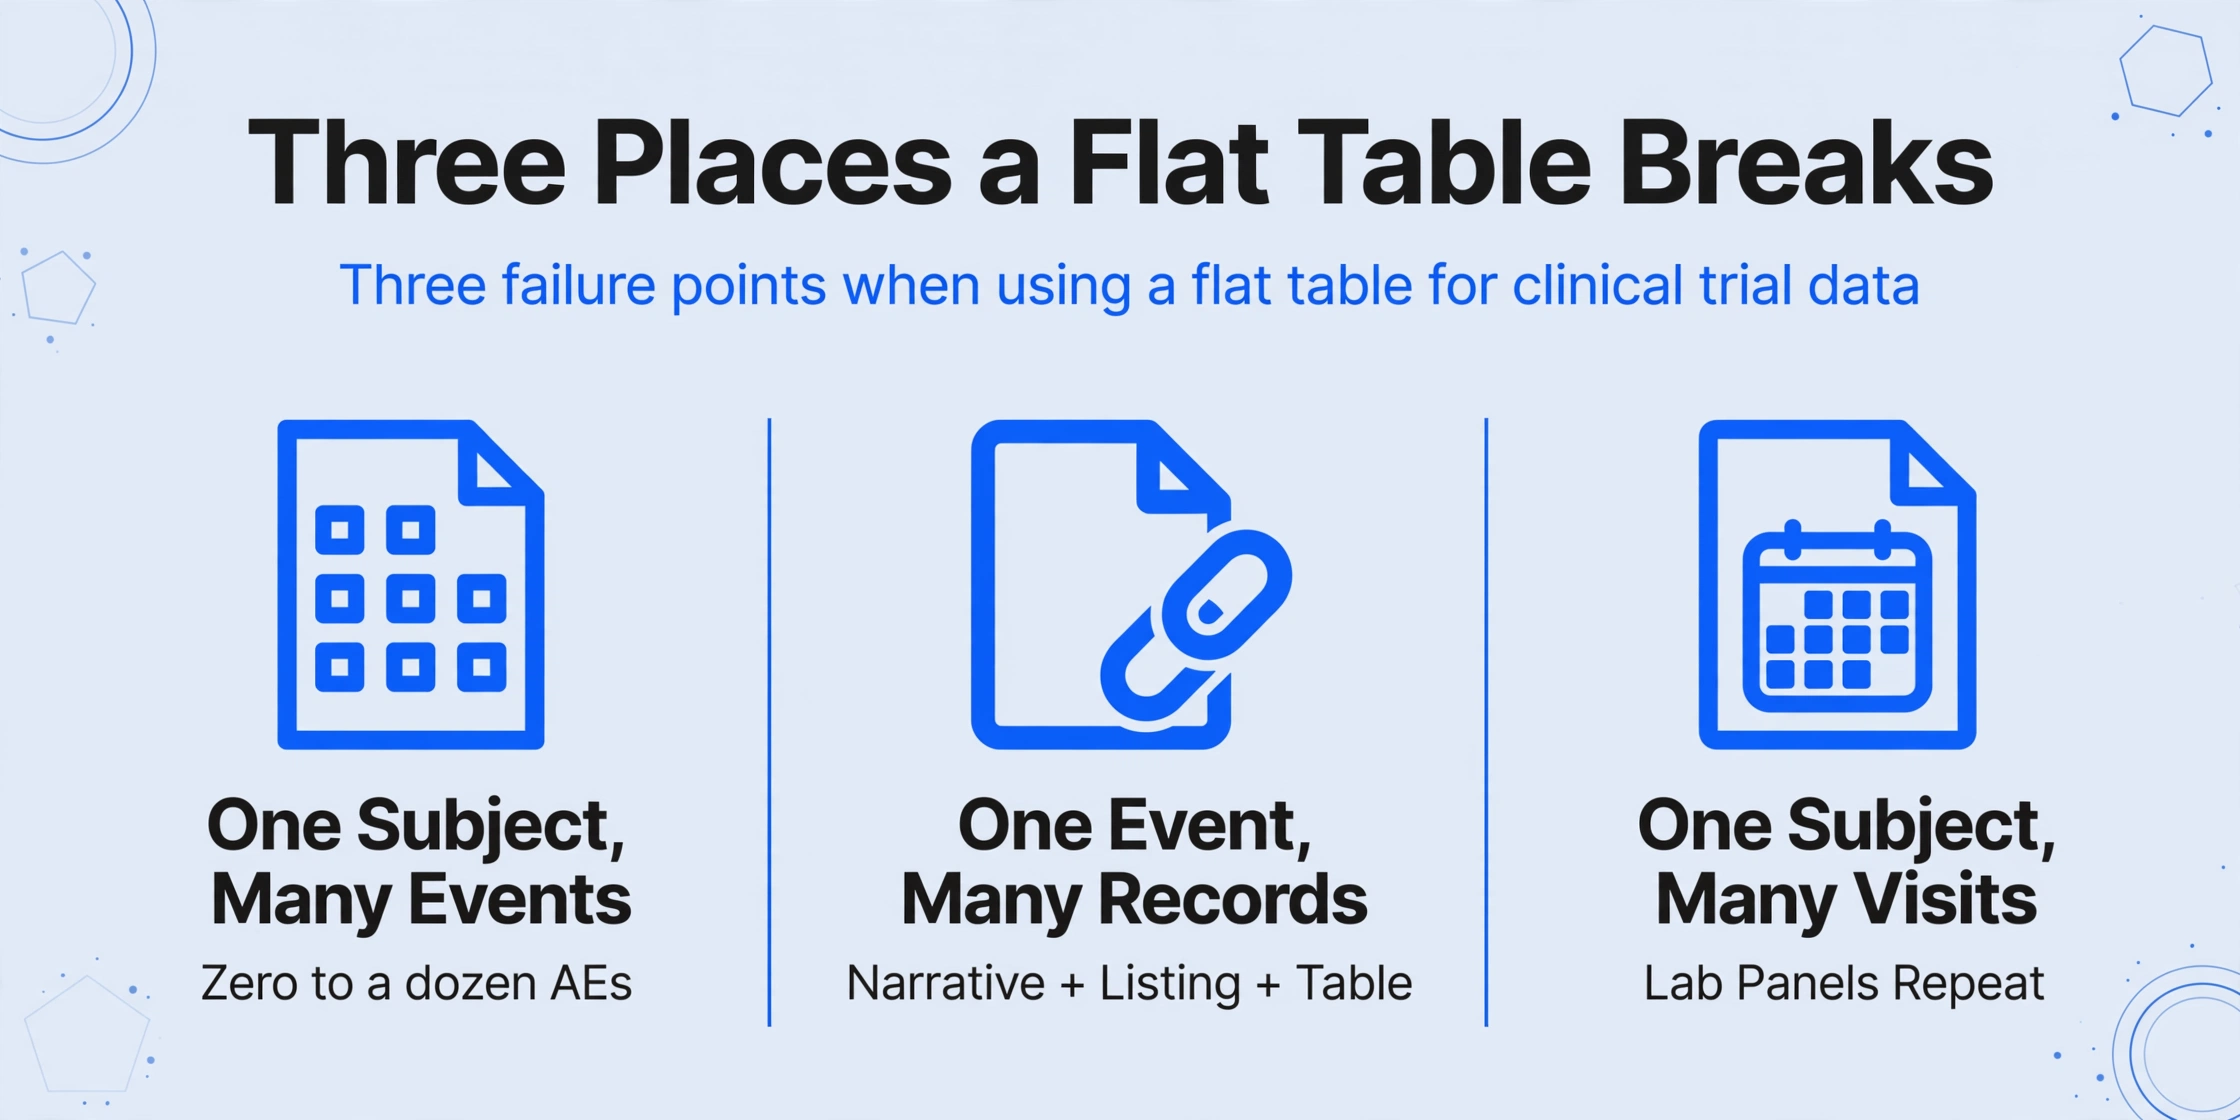
Un tableur suppose qu'une ligne correspond à une seule chose. Les données d'essais cliniques brisent cette hypothèse à trois endroits précis, et chacun apparaît dans les documents mentionnés ci-dessus.
Un sujet, plusieurs événements indésirables. Un même participant peut subir zéro, un ou une douzaine d'événements indésirables pendant un essai, chacun avec son propre terme, sa date de début, sa gravité, sa gravité (seriousness), sa causalité, sa mesure prise et son issue. Un tableau qui donne une ligne par sujet doit soit abandonner des événements, soit les entasser dans une seule cellule. C'est ce tableau à plusieurs dimensions qui a généré le trafic de requêtes dans la statistique d'ouverture, car chaque événement doit être examiné et rapproché avant de devenir un enregistrement propre.
Un événement, plusieurs enregistrements associés. Un événement indésirable grave n'est pas une simple cellule. Il a une apparition et une résolution, une évaluation de causalité, peut-être plusieurs entrées de suivi à mesure que de nouvelles informations arrivent. Dans le modèle de données, ce sont des enregistrements liés, et dans le rapport imprimé, ils deviennent un récit plus une ligne dans une liste plus une ligne dans un tableau récapitulatif.
Un sujet, plusieurs visites, plusieurs panels de laboratoire. Les valeurs de laboratoire se répètent à chaque visite. Un panel de chimie sanguine recueilli au dépistage, à la semaine 4, à la semaine 8 et à la semaine 12 représente quatre ensembles des mêmes paramètres attachés à la même personne. Un calendrier des évaluations du protocole est lui-même une grille à deux dimensions, et les données de laboratoire se déploient à partir de lui.
Il existe une version distincte, purement mécanique, de ce problème : les tableaux imprimés utilisent souvent des cellules d'en-tête fusionnées et une indentation pour exprimer la hiérarchie des systèmes organiques et des termes préférés, de sorte qu'un extracteur naïf lit correctement les termes des événements mais perd le système organique auquel ils appartenaient. Ce mode de défaillance est traité en détail dans pourquoi les cellules fusionnées cassent l'extraction de tableaux, donc cet article se concentre sur la structure plutôt que sur la grille.
La plainte des personnes qui vivent ce travail n'est pas subtile. Sur r/clinicalresearch, un coordinateur écrivant sous le fil « I hate data entry » l'a dit clairement : « Je sens parfois que je suis trop lent et que les tâches sont trop fastidieuses. Je travaille actuellement avec un site qui a plus de 200 requêtes. » Un fil séparé sur comment résorber l'arriéré de saisie de données d'un site décrit le triage que la plupart des équipes font déjà : traiter d'abord les requêtes les plus anciennes, travailler patient par patient, protéger du temps pour la saisie chaque jour. Aucun de ces triages ne s'attaque à la raison pour laquelle l'arriéré existe, à savoir que les données arrivent en tableaux à plusieurs dimensions et que la destination est une ligne.
L'extraction de documents d'essais cliniques est lente, car la granularité de sortie du document et celle du table correspondent rarement du premier coup.
Choisir la granularité de votre tableau de sortie
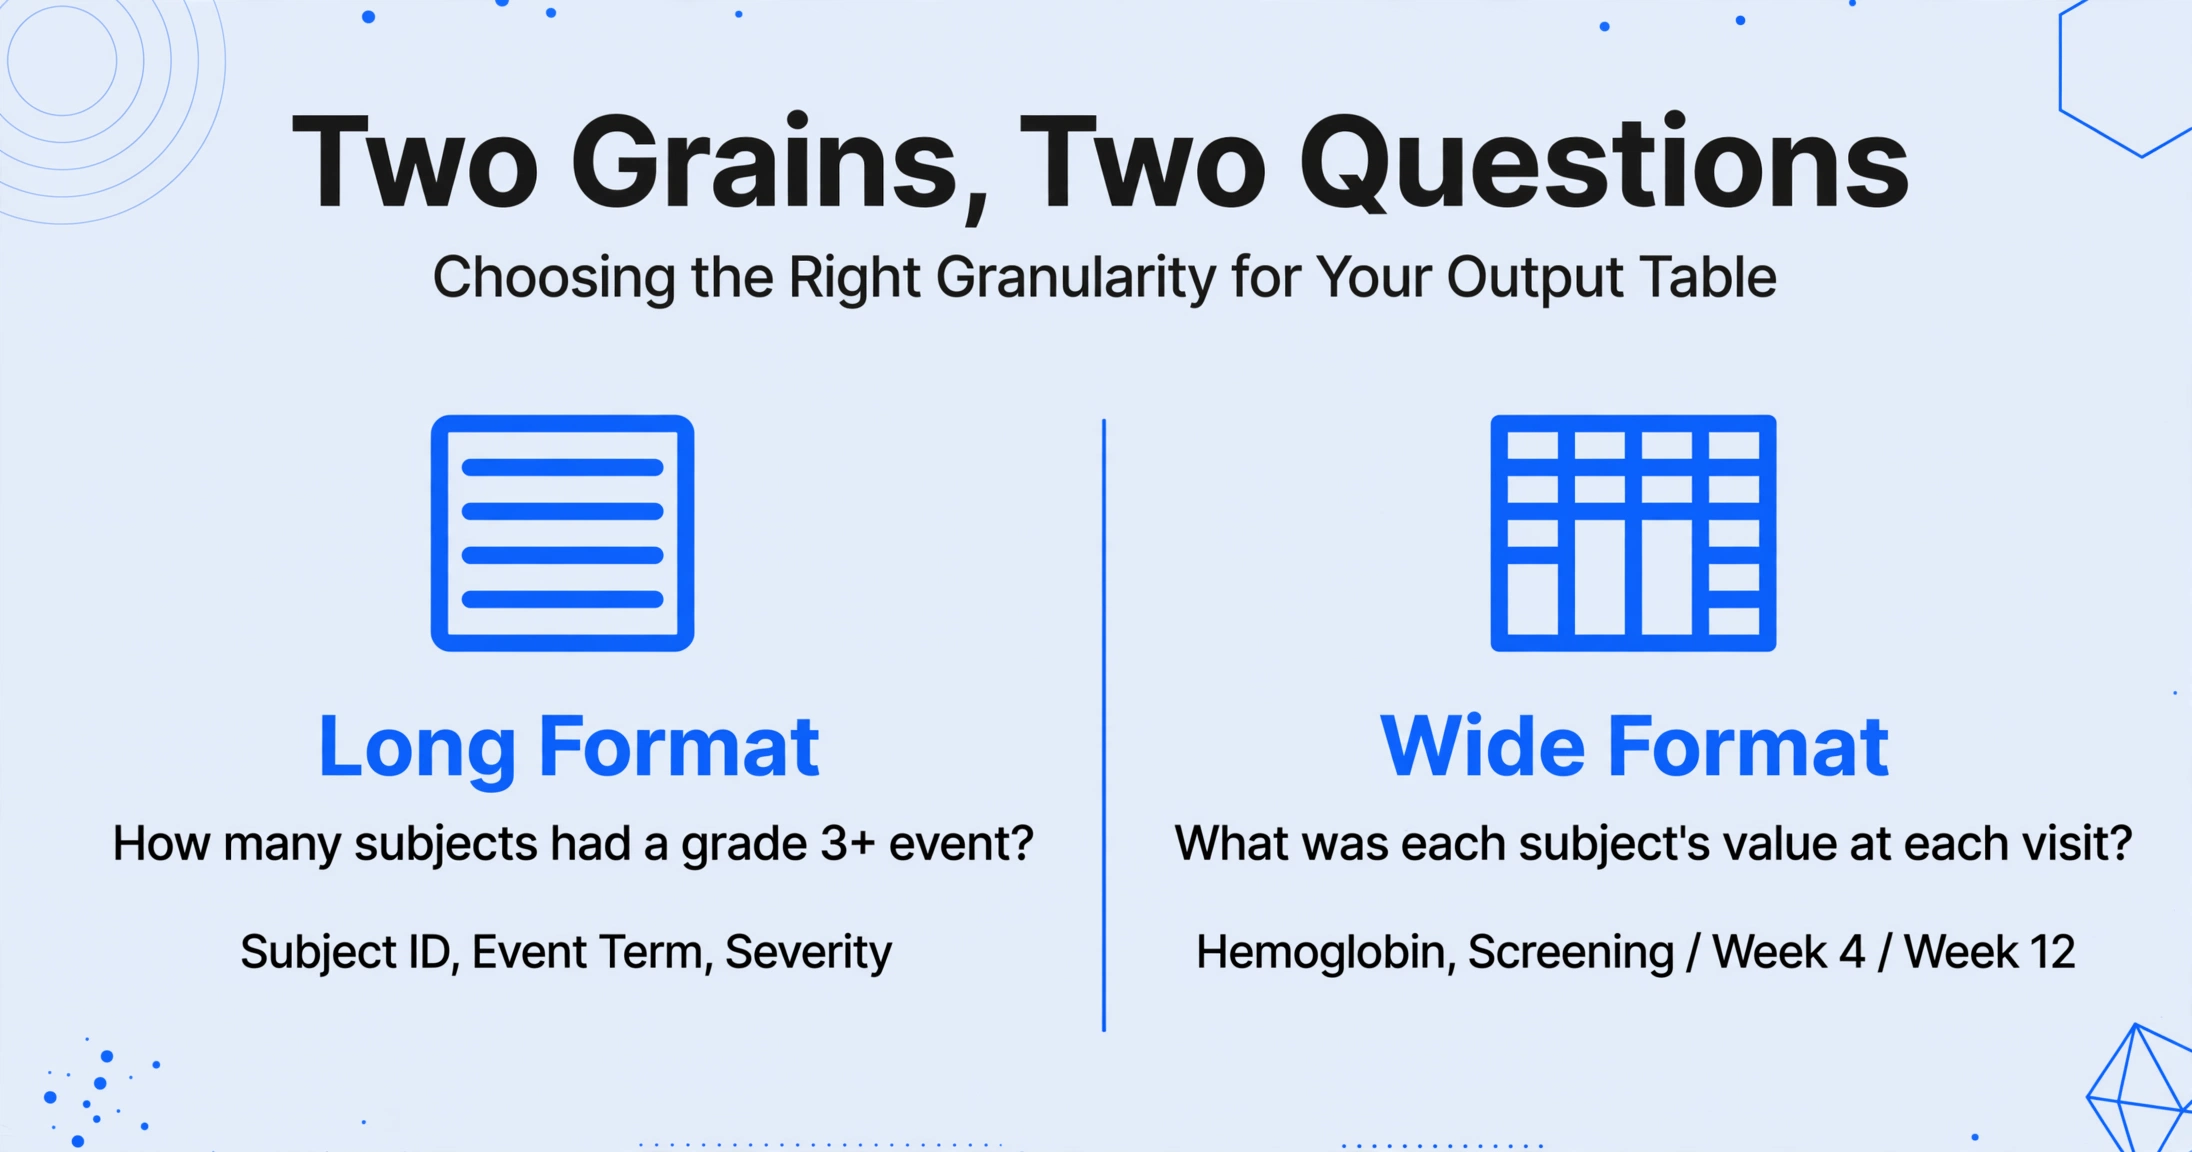
Avant d'extraire quoi que ce soit, décidez ce que chaque ligne du résultat doit représenter. Il y a deux réponses valables, et elles répondent à des questions différentes.
Format long : une ligne par événement
Chaque événement indésirable a sa propre ligne, et l'identifiant du sujet se répète sur chaque ligne des événements de ce sujet. Colonnes utiles : ID du sujet, terme de l'événement, date de début, gravité, grave (O/N), causalité, mesure prise, issue. Choisissez ce format lorsque votre question est « combien de sujets ont eu un événement de grade 3 ou plus » ou lorsque vous devez transmettre les lignes à un outil statistique. L'identifiant du sujet est ce qui relie les lignes répétées entre elles.
Format large : une ligne par sujet, les visites en colonnes
Un sujet par ligne, avec la valeur de la visite intégrée dans le nom de la colonne (Hémoglobine, Dépistage / Hémoglobine, Semaine 4 / Hémoglobine, Semaine 12). Utile lorsque votre question est « quelle était la valeur de chaque sujet à chaque visite » et que vous souhaitez comparer dans le temps. Le compromis est que le tableau s'élargit à chaque point temporel ajouté, et qu'un essai long peut le rendre difficile à lire.
Déterminez la granularité à partir de la question que vous poserez au tableau, puis examinez le document source. Si la source est une liste par sujet et que vous voulez une comparaison par sujet, vous convertissez le format long en format large, et cette conversion est un vrai travail qu'aucun outil d'extraction ne fait gratuitement. Si la source est un tableau récapitulatif et que vous voulez des lignes au niveau de l'événement, le détail n'est tout simplement pas là pour être extrait, et il vous faut la liste à la place.
Une mise en garde concernant les colonnes. Il est tentant d'ajouter une colonne « terme préféré MedDRA » à un tableau d'événements indésirables, car c'est ce que contient le jeu de données codé. À moins que le document source ne montre déjà le terme codé, cette colonne ne peut pas être extraite, car l'attribution d'un terme préféré est une étape de codage, pas une étape de lecture. La section suivante traite de ce que l'extraction peut et ne peut pas tirer de la source.
Comment l'extraction sémantique gère les structures répétées
La raison pour laquelle un outil basé sur des modèles échoue ici est qu'un modèle est lié à des positions. L'extraction de tableaux d'événements indésirables est le premier cas où la logique basée sur la position échoue, car un sujet avec un événement et un sujet avec six événements occupent des nombres de lignes complètement différents, donc les mêmes coordonnées ne correspondent jamais deux fois. Un modèle de vision qui lit pour comprendre ne dépend pas de ces coordonnées.
Extraction de colonnes personnalisées est le mécanisme. Au lieu de dessiner des zones sur une page, vous saisissez les noms de colonnes souhaités, tels que ID du sujet, terme de l'événement, gravité et gravité (seriousness), et l'IA localise chaque valeur en comprenant ce que signifie le nom de la colonne. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre tableau de sortie, et la logique de lecture reste stable qu'un sujet ait une ligne d'événement ou dix. L'approche générale est décrite dans ce qu'est réellement l'extraction de documents par IA si c'est votre première rencontre avec ce sujet.
Plusieurs fonctionnalités correspondent aux problèmes de tableaux décrits dans la section précédente :
- colonne calculée permet à l'IA de calculer une valeur pendant l'extraction plutôt que de simplement en copier une. Pour une liste d'événements indésirables, cela couvre un comptage d'événements par sujet et des vérifications conditionnelles telles que le signalement d'une ligne lorsqu'un sous-total ne correspond pas à un total déclaré. Le calcul est intégré au nom de la colonne ou à une règle, il s'exécute donc de la même manière sur chaque document du lot.
- colonne inférée permet à l'IA d'attribuer une valeur que le document n'imprime pas, déduite de ce qu'il imprime. Cela est utile pour une catégorie telle qu'un statut de suivi, où le modèle lit si un événement est décrit comme en cours. Cela ne remplace pas le jugement médical, et les colonnes nécessitant une évaluation ne doivent pas être construites de cette façon.
- fusion multipage regroupe un document qui s'étend sur plusieurs pages en une seule ligne. Une liste d'événements indésirables continuée sur plusieurs pages imprimées, ou les dossiers d'un sujet répartis sur des feuilles numérisées séparément, peuvent être regroupés par une valeur partagée telle que l'identifiant du sujet, les champs se remplissant à partir de la page qui les contient. C'est le même paramètre qui aide avec les PDF multipages en général.
- Traitement par lots lit plusieurs fichiers à la fois et fusionne les résultats en un seul tableau, de sorte qu'un dossier de pages CRF ou un ensemble de listes CSR devient une seule feuille au lieu d'une pile d'exports d'un document. Le schéma est le même que celui utilisé pour l'extraction par lots de données cliniques à partir d'autres dossiers d'essais.
- niveau de modèle est important lorsque la source est un formulaire numérisé avec des écritures manuscrites. Les formulaires d'événements indésirables remplis à la main sont un cas difficile connu, et un niveau de traitement supérieur utilise un modèle plus puissant pour l'écriture manuscrite dense et la mise en page complexe.
- Mode de révision avec vérification par boîte englobante est l'élément qui rend un tableau de sécurité extrait utilisable. Le survol d'une cellule met en évidence exactement d'où provient cette valeur sur le document original, et le clic sur une région ramène à la cellule correspondante. Pour les champs importants, cela transforme « faire confiance à l'extraction » en « contrôle ponctuel de l'extraction » en quelques secondes plutôt que de relire toute la liste.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Le même schéma d'extraction s'applique partout où un document d'essai répète une structure par sujet. Un tableau de panel de visite, un rapport de laboratoire clinique et une liste d'événements indésirables sont des contenus différents avec le même problème sous-jacent : l'unité qui vous intéresse se répète, et l'outil doit préserver cette répétition au lieu de l'aplatir.
Ce que ce type d'extraction ne peut pas faire
Être clair sur les limites est plus utile que de survendre l'outil, surtout dans un domaine réglementé où une affirmation dans un article de blog n'équivaut pas à un système validé.
Il ne code pas les événements indésirables. La sélection des termes dans MedDRA, le dictionnaire médical qui fait correspondre un terme rapporté à un terme préféré sous un système organique, est une étape de codage distincte régie par ses propres règles. Le dictionnaire et sa hiérarchie sont maintenus par l'Organisation des services de maintenance et de support MedDRA. L'extraction peut lire un terme codé déjà imprimé, mais elle n'en attribue pas.
Il ne procède pas à l'évaluation de la sécurité. Les décisions de causalité, de gravité et de caractère attendu appartiennent à une personne qualifiée. Une colonne inférée est une lecture de ce que dit le document, pas une évaluation médicale.
Il ne procède pas à l'anonymisation. Les identifiants de sujet dans un document d'essai restent dans la sortie. Si le fichier est destiné à un endroit sans accord sur les données, ce traitement est une étape distincte et délibérée.
Ce n'est pas un système validé et certifié pour l'audit. Les enregistrements électroniques réglementés comportent des exigences telles qu'une piste d'audit pour chaque modification et une validation documentée du système, définies dans l'ICH E6(R3) et la 21 CFR Part 11. Cet outil ne dispose pas d'une telle certification, il se situe donc en amont du système de référence, comme un premier passage qu'un humain vérifie, et non comme la base de données de référence. Les systèmes qui contiennent des données d'essai validées à grande échelle sont les plateformes de capture électronique des données telles que Medidata Rave, Veeva Vault EDC et Oracle Clinical One, ainsi que des options plus légères comme Castor et REDCap. La comparaison ici ne se fait pas avec ces plateformes. Elle se fait avec une personne qui lit une liste et la ressaisit.
Ce qui reste, une fois ces limites énoncées, constitue toujours l'essentiel du travail : extraire les valeurs répétées des documents et les mettre dans un tableau qu'un humain peut vérifier, au lieu de les saisir une par une. Cet écart est le même qui laisse les coordinateurs jongler avec les arriérés de requêtes et les gestionnaires de données avec des données cliniques déjà numériques et pourtant encore saisies à la main.
FAQ
L'IA peut-elle extraire les tableaux d'événements indésirables d'un CRF ou d'un CSR ? Oui, à condition de définir le tableau visé. Un CSR peut contenir les mêmes événements sous forme de tableau récapitulatif, de liste par sujet et de récit ; précisez donc les colonnes de la forme souhaitée, comme l'identifiant du sujet, le terme de l'événement, la date de début et la gravité. L'extraction lit les valeurs ; elle ne décide pas à votre place laquelle des trois présentations utiliser.
L'extraction remplace-t-elle le codage des événements indésirables dans MedDRA ? Non. Coder un terme rapporté en terme préféré et en système organique est une étape distincte, avec ses propres conventions, qui exige une supervision humaine. L'extraction peut transporter un terme codé depuis un document qui en contient déjà un, mais elle n'effectue pas le codage.
Comment garantir que chaque événement indésirable reste associé au bon sujet ? Extrayez l'identifiant du sujet comme colonne dédiée et laissez-le se répéter sur chaque ligne d'événement. En format long, l'identifiant est ce qui relie les lignes répétées à un même participant. Si les dossiers d'un sujet arrivent sur des pages scannées séparément, utilisez la fusion multipage groupée par cet identifiant afin que les éléments se regroupent en un seul enregistrement avant que les événements ne se déploient.
Est-ce adapté à une soumission réglementée ? Utilisez-le comme premier passage vérifiable, et non comme système de référence. Il ne s'agit pas d'une plateforme validée ou certifiée pour l'audit, elle ne revendique aucune certification ICH-GCP ou 21 CFR Part 11, et elle n'effectue ni anonymisation ni évaluation. La base de données de référence validée reste votre plateforme de capture électronique des données.
La forme du document doit déterminer la forme du tableau
Si l'extraction de documents d'essais cliniques est plus difficile que l'extraction de factures, c'est pour une raison structurelle, pas technique. Les factures arrivent une par ligne. Les documents d'essais arrivent sous forme de tableaux : un sujet sur plusieurs visites, un sujet avec plusieurs événements indésirables, un événement avec plusieurs enregistrements associés. Une fois que vous avez nommé la granularité de la sortie dont vous avez réellement besoin, définir les colonnes devient une décision simple, et le travail restant est la vérification, ce qui est précisément là où une personne qualifiée devrait passer son temps de toute façon.
Commencez par une liste d'événements indésirables ou un document de panel de visite, définissez les colonnes souhaitées, et voyez le tableau revenir avant de vous engager sur un lot entier.