Extraktion klinischer Studiendokumente
über eine Zeile pro Patient hinaus
Im Jahr 2021 bündelten Datenmanagement-Teams klinischer Studien von sieben Pharmaunternehmen zwanzig abgeschlossene Phase-III-Studien und zählten jede gegen sie erhobene Datenabfrage. Die Gesamtzahl belief sich auf 1.939.606 Abfragen über 20.125 Teilnehmer. Die fünf Formulartypen, die mehr als die Hälfte des gesamten Abfrageaufkommens erzeugten, waren Begleitmedikation, Labor, unerwünschte Ereignisse, Exposition und Arzneimittelabrechnung. Diese fünf Formulare haben eines gemeinsam, und das ist nicht ihr Layout: Keines davon ist ein Datensatz pro Patient. Dieser Artikel befasst sich mit dieser strukturellen Tatsache und damit, was sie bedeutet, wenn Sie versuchen, eine Extraktion klinischer Studiendokumente durchzuführen und am Ende eine Tabelle erhalten, die nicht der Art und Weise entspricht, wie sich die Daten tatsächlich verhalten.
Wichtigste Erkenntnisse
- 1.939.606 Datenabfragen über 20.125 Teilnehmer, und mehr als die Hälfte stammte aus fünf Formulartypen, die eines gemeinsam haben: Keiner davon ist ein Datensatz pro Patient.
- Studiendaten liegen in Arrays vor – ein Proband mit vielen unerwünschten Ereignissen und ein Ereignis mit vielen zugehörigen Datensätzen –, während eine Tabelle davon ausgeht, dass eine Zeile eine Sache ist. Der Rückstau ist also strukturell bedingt und keine Frage schnelleren Tippens.
- Legen Sie zuerst die Granularität fest, die Sie benötigen – eine Zeile pro Ereignis oder eine Zeile pro Proband mit Visiten als Spalten –, und die Spalten definieren sich von selbst, sodass nur noch die menschliche Überprüfung übrig bleibt.
Der klinische Studiendokumentensatz und was jedes Dokument enthält
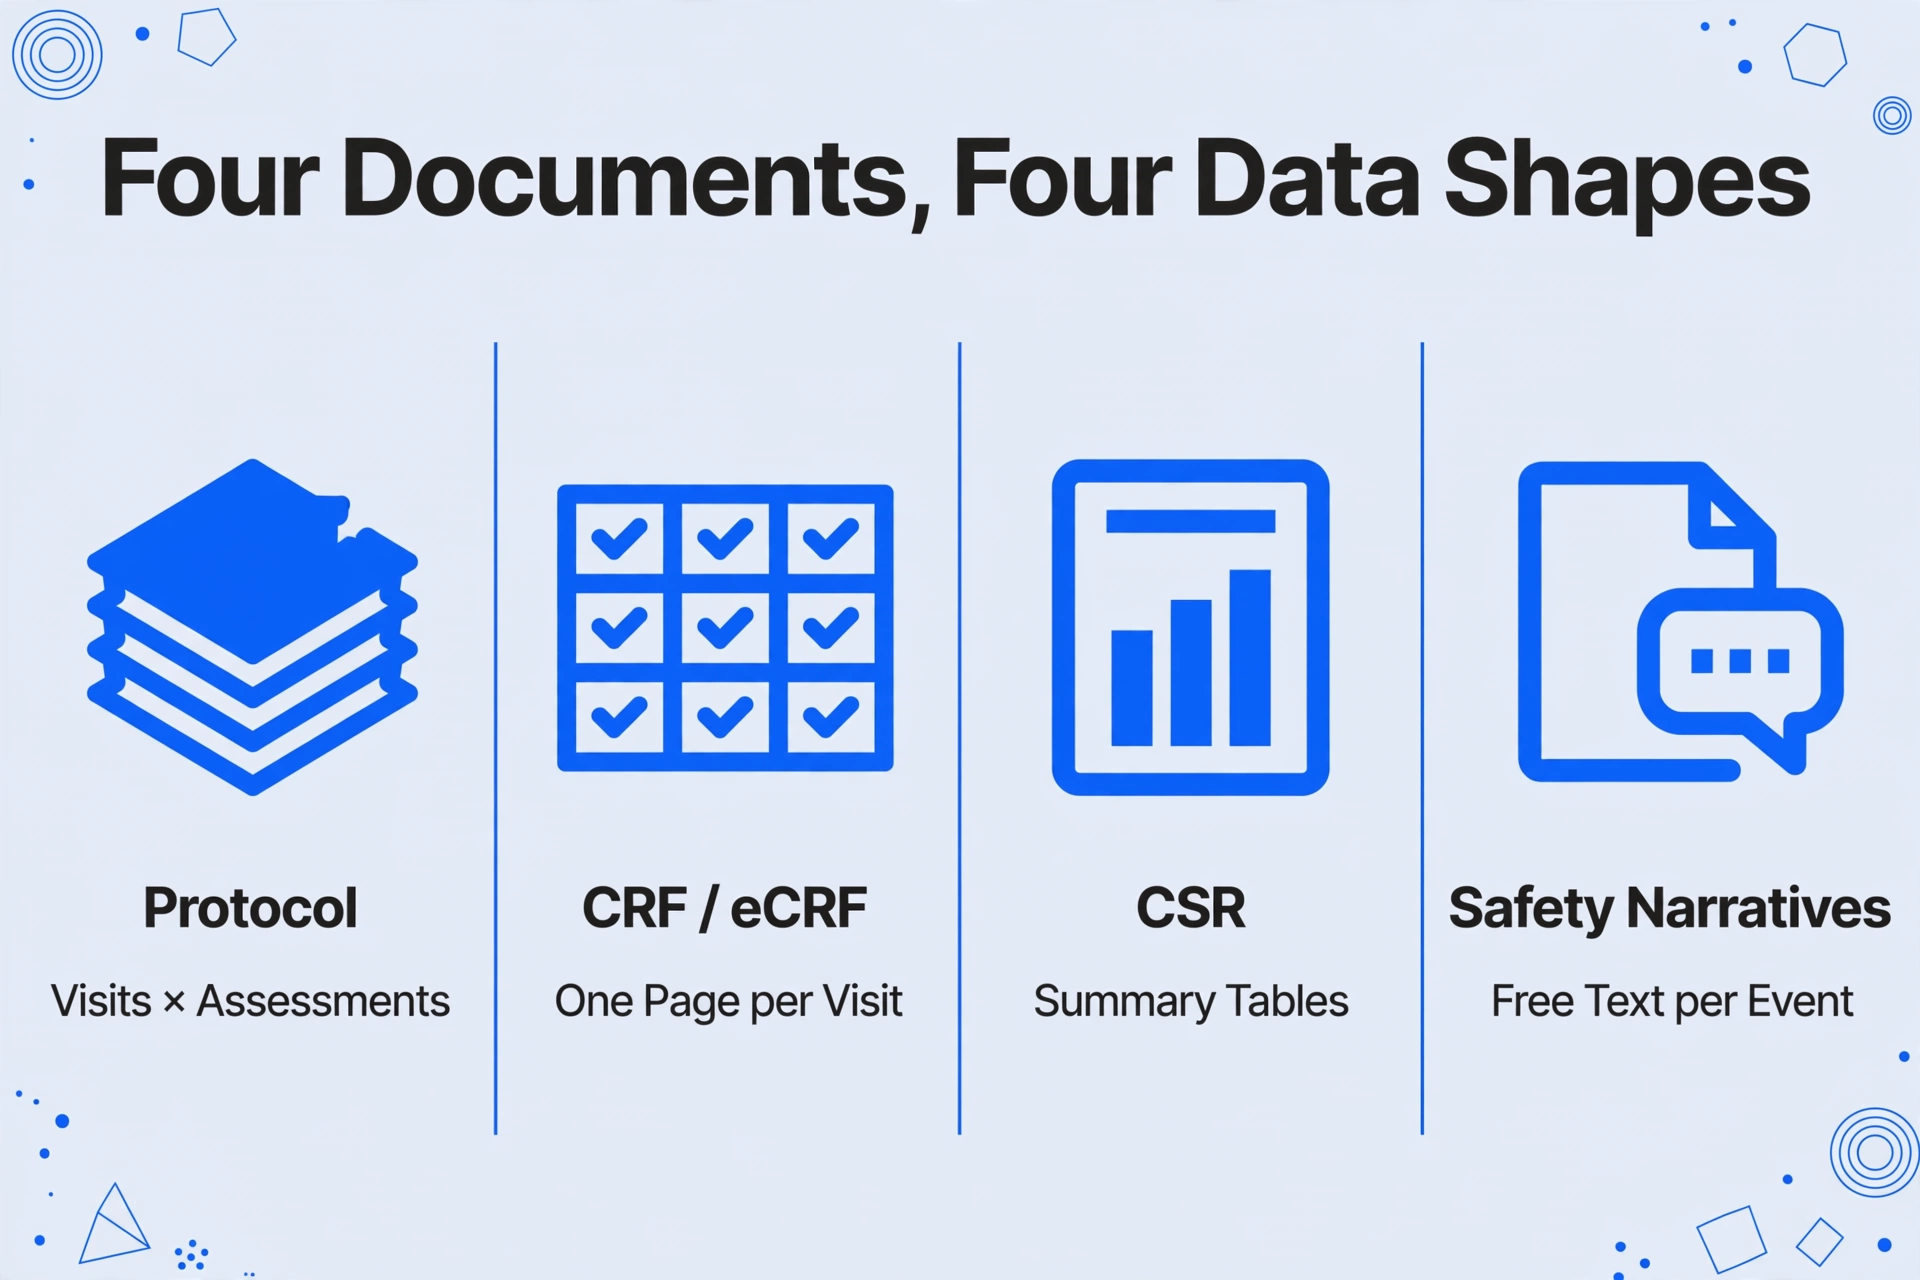
Die klinische Studiendokumentation ist nicht ein Dokumenttyp. Sie ist eine kleine Familie von Dokumenten, die dieselbe Studie aus vier verschiedenen Blickwinkeln beschreiben, und jeder Blickwinkel erzeugt eine andere Datenstruktur.
| Dokument | Was es ist | Struktur der enthaltenen Daten |
|---|---|---|
| Protokoll | Der Studienplan, einschließlich des Bewertungsplans: welche Verfahren bei welcher Visite für jeden Teilnehmer stattfinden | Ein Raster aus Visiten × Bewertungen (eine Zeile pro Visite, eine Spalte pro Verfahren) |
| CRF / eCRF | Das Fallberichtsformular, das Instrument, das erfasst, was bei jeder Visite geschehen ist | Eine Seite pro Visite und Proband, mit wiederholten Blöcken für Ereignisse |
| CSR | Der klinische Studienbericht, die integrierte regulatorische Zusammenfassung der gesamten Studie | Zusammenfassungstabellen, Patientenauflistungen und Narrative, die dieselben Ereignisse auf unterschiedlichen Detailebenen beschreiben |
| Sicherheitsnarrative | Prosa-Beschreibungen von Todesfällen, schwerwiegenden unerwünschten Ereignissen und anderen markierten Ereignissen | Freitext, ein Narrativ pro Ereignis |
Der klinische Studienbericht hat von Natur aus eine feste Struktur. ICH E3, die internationale Richtlinie für Struktur und Inhalt klinischer Studienberichte, platziert die Zusammenfassung unerwünschter Ereignisse in Abschnitt 12.2, die detaillierten Darstellungen unerwünschter Ereignisse in Abschnitt 14.3.1 und die patientenbezogenen Auflistungen unerwünschter Ereignisse in Abschnitt 16.2.7. Abschnitt 12.2.2 verlangt Tabellen, die jedes unerwünschte Ereignis, die Anzahl der Patienten in jeder Behandlungsgruppe, bei denen es auftrat, und die Häufigkeit auflisten, gruppiert nach Organsystem und aufgeschlüsselt nach Schweregrad und Kausalität. In Abschnitt 16.2.7 erscheinen dieselben Ereignisse einzeln pro Proband.
Hier wird die Extraktion von Daten aus klinischen Studienberichten zum ersten Mal schwierig: dieselben Daten zu unerwünschten Ereignissen existieren in drei Formen in einem Dokument (eine aggregierte Tabelle, eine Auflistung pro Proband und ein Narrativ), und ein Leser, der das Tool nach „unerwünschten Ereignissen" fragt, ohne anzugeben, welche Form gemeint ist, erhält diejenige, die das Modell zufällig zuerst findet.
Unterhalb des Berichts folgen die Einreichungsdaten dem CDISC Study Data Tabulation Model. Seine Domäne für unerwünschte Ereignisse ist definiert als ein Datensatz pro Ereignis pro Proband, was formal ausdrückt, dass ein einzelner Teilnehmer in derselben Tabelle mehrfach erscheinen kann. Zugehörige Details, die an ein Ereignis gekoppelt sind, wie die Abfolge der Toxizitätsgrade, die es durchlaufen hat, befinden sich in einer separaten Domäne, die über eine 1:n-Beziehung mit dem Datensatz des unerwünschten Ereignisses verbunden ist. Wenn Sie bisher nur Rechnungen oder Belege extrahiert haben, bei denen ein Dokument einer Zeile entspricht, ist dies der Teil, der Sie überraschen wird. Das vollständige Modell ist von CDISC dokumentiert.
Wo eine flache Tabelle auf ein Array trifft
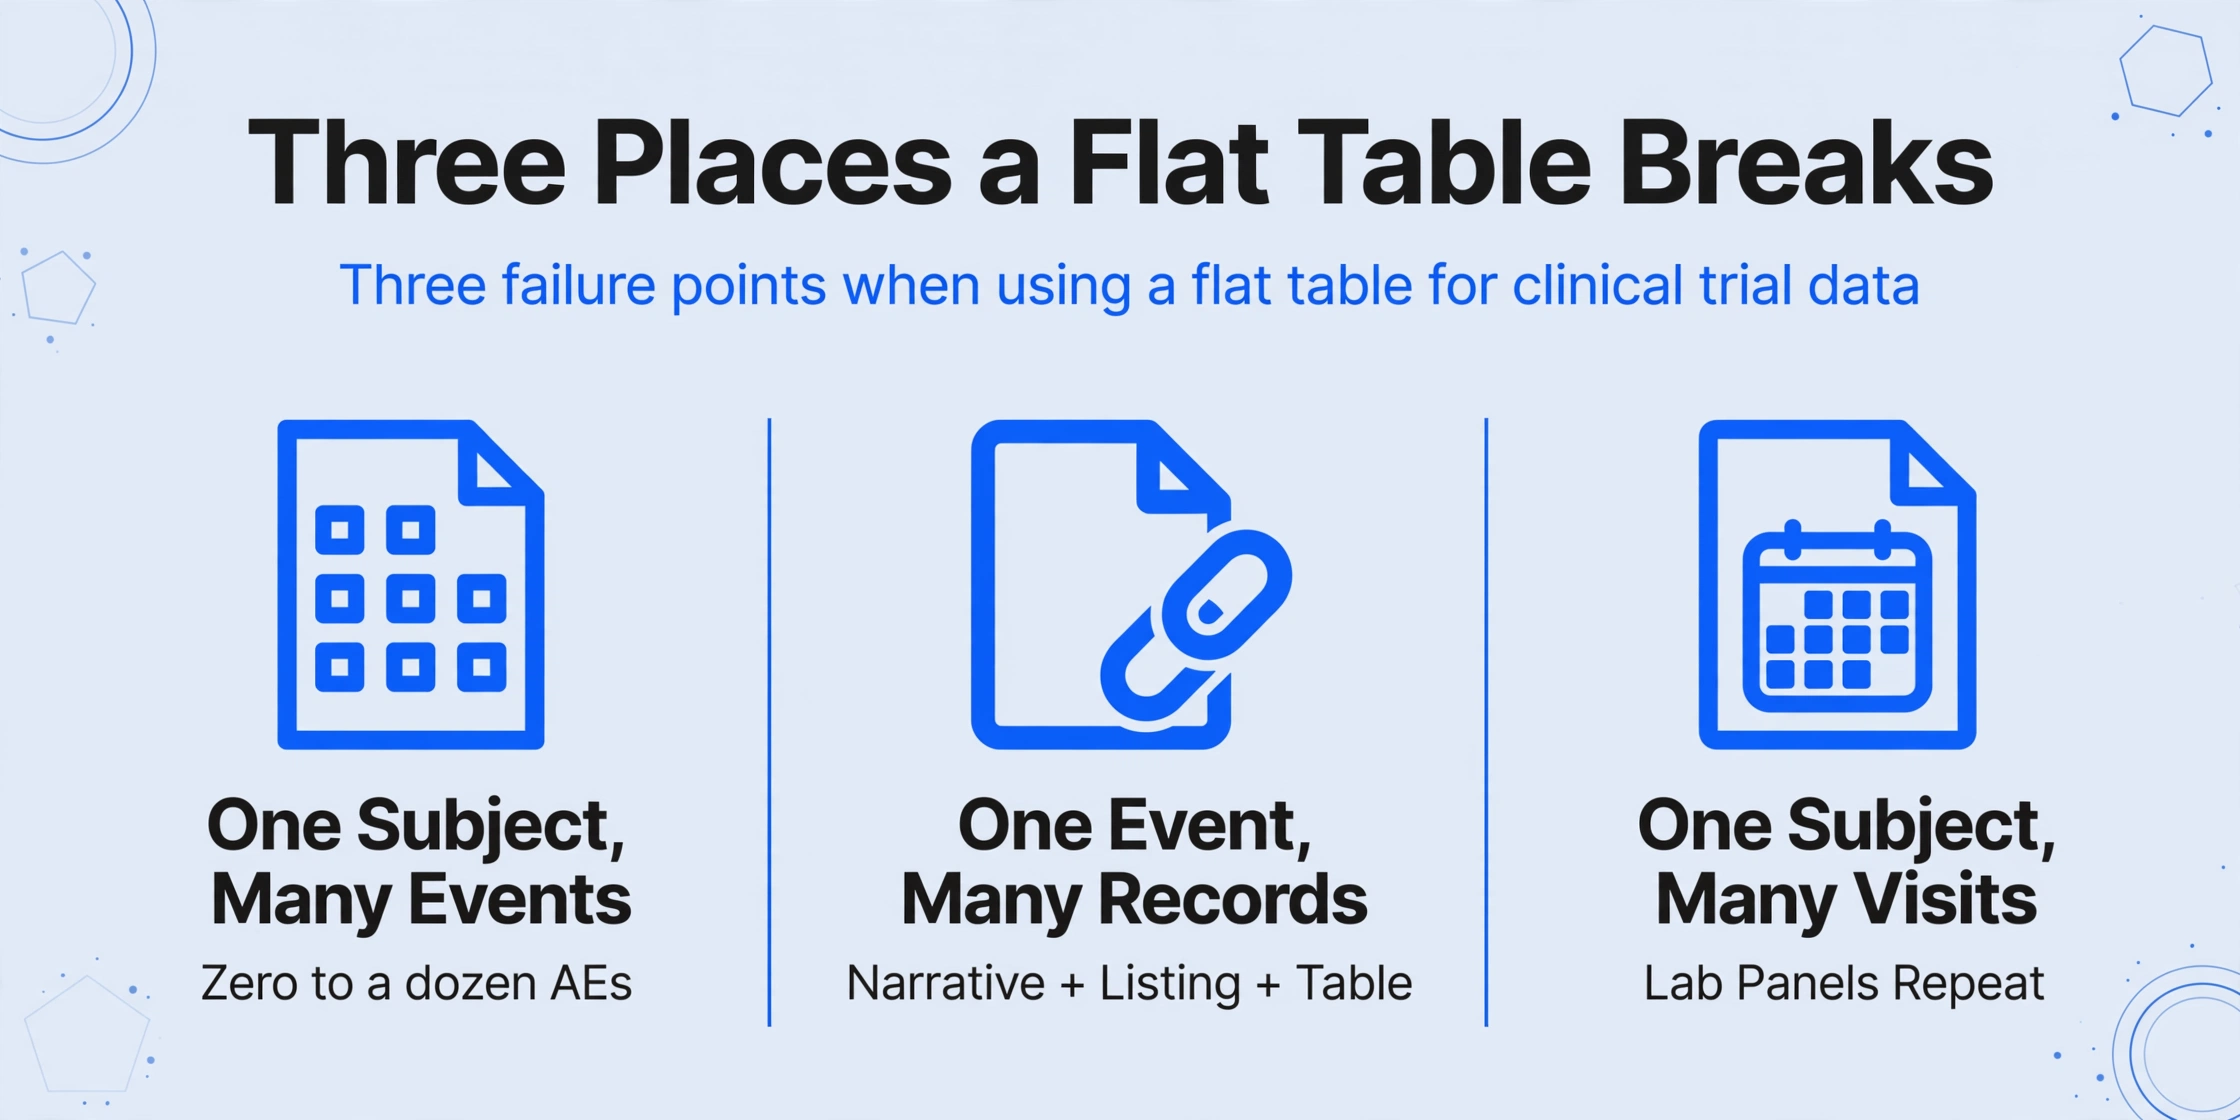
Eine Tabellenkalkulation geht davon aus, dass eine Zeile eine Sache ist. Klinische Studiendaten brechen diese Annahme an drei konkreten Stellen, und jede davon taucht in den oben genannten Dokumenten auf.
Ein Proband, viele unerwünschte Ereignisse. Ein einzelner Teilnehmer kann während einer Studie null, ein oder ein Dutzend unerwünschte Ereignisse erleben, jeweils mit eigenem Begriff, Startdatum, Schweregrad, Schweregrad (Seriousness), Kausalität, ergriffener Maßnahme und Ausgang. Eine Tabelle, die jedem Probanden eine Zeile gibt, muss Ereignisse entweder verwerfen oder in eine Zelle pressen. Dies ist das Array, das den Query-Verkehr in der Eingangsstatistik erzeugt hat, denn jedes Ereignis muss überprüft und abgeglichen werden, bevor es zu einem sauberen Datensatz wird.
Ein Ereignis, viele zugehörige Datensätze. Ein schwerwiegendes unerwünschtes Ereignis ist keine einzelne Zelle. Es hat einen Beginn und eine Auflösung, eine Kausalitätsbewertung, möglicherweise mehrere Folge-Einträge, wenn neue Informationen eintreffen. Im Datenmodell sind dies verknüpfte Datensätze, und im gedruckten Bericht werden sie zu einem Narrativ plus einer Zeile in einer Auflistung plus einer Zeile in einer Zusammenfassungstabelle.
Ein Proband, viele Visiten, viele Laborpanels. Laborwerte wiederholen sich bei jeder Visite. Ein Blutchemiepanel, das beim Screening, in Woche 4, Woche 8 und Woche 12 erhoben wird, sind vier Sätze derselben Parameter, die derselben Person zugeordnet sind. Ein Protokoll-Bewertungsplan ist selbst ein zweidimensionales Raster, und die Labordaten fächern sich daraus auf.
Es gibt eine separate, rein mechanische Version dieses Problems: Die gedruckten Tabellen verwenden oft zusammengeführte Kopfzellen und Einrückung, um die Hierarchie von Organsystem und bevorzugtem Begriff auszudrücken, sodass ein naiver Extraktor die Ereignisbegriffe korrekt liest, aber verliert, unter welchem Organsystem sie standen. Diese Fehlerart wird ausführlich in warum zusammengeführte Zellen die Tabellenextraktion brechen behandelt, daher konzentriert sich dieser Artikel auf die Struktur statt auf das Raster.
Die Beschwerde der Menschen, die in dieser Arbeit leben, ist nicht subtil. Auf r/clinicalresearch brachte es ein Koordinator, der unter dem Thread „I hate data entry" schrieb, deutlich auf den Punkt: „Manchmal habe ich auch das Gefühl, ich bin zu langsam und die Aufgaben sind zu mühsam. Ich arbeite gerade mit einer Prüfstelle zusammen, die über 200 Queries hat." Ein separater Thread über den Abbau des Dateneingabe-Rückstaus einer Prüfstelle beschreibt die Triage, die die meisten Teams bereits durchführen: zuerst die ältesten Queries bearbeiten, patientenweise arbeiten, täglich Zeit für die Eingabe einplanen. Keine dieser Triage-Maßnahmen behebt den Grund für den Rückstau, nämlich dass die Daten in Arrays ankommen und das Ziel eine Zeile ist.
Die Extraktion von Dokumenten aus klinischen Studien ist langsam, weil die Ausgabegranularität des Dokuments und die Ausgabegranularität der Tabelle beim ersten Versuch selten übereinstimmen.
Granularität Ihrer Ausgabetabelle wählen
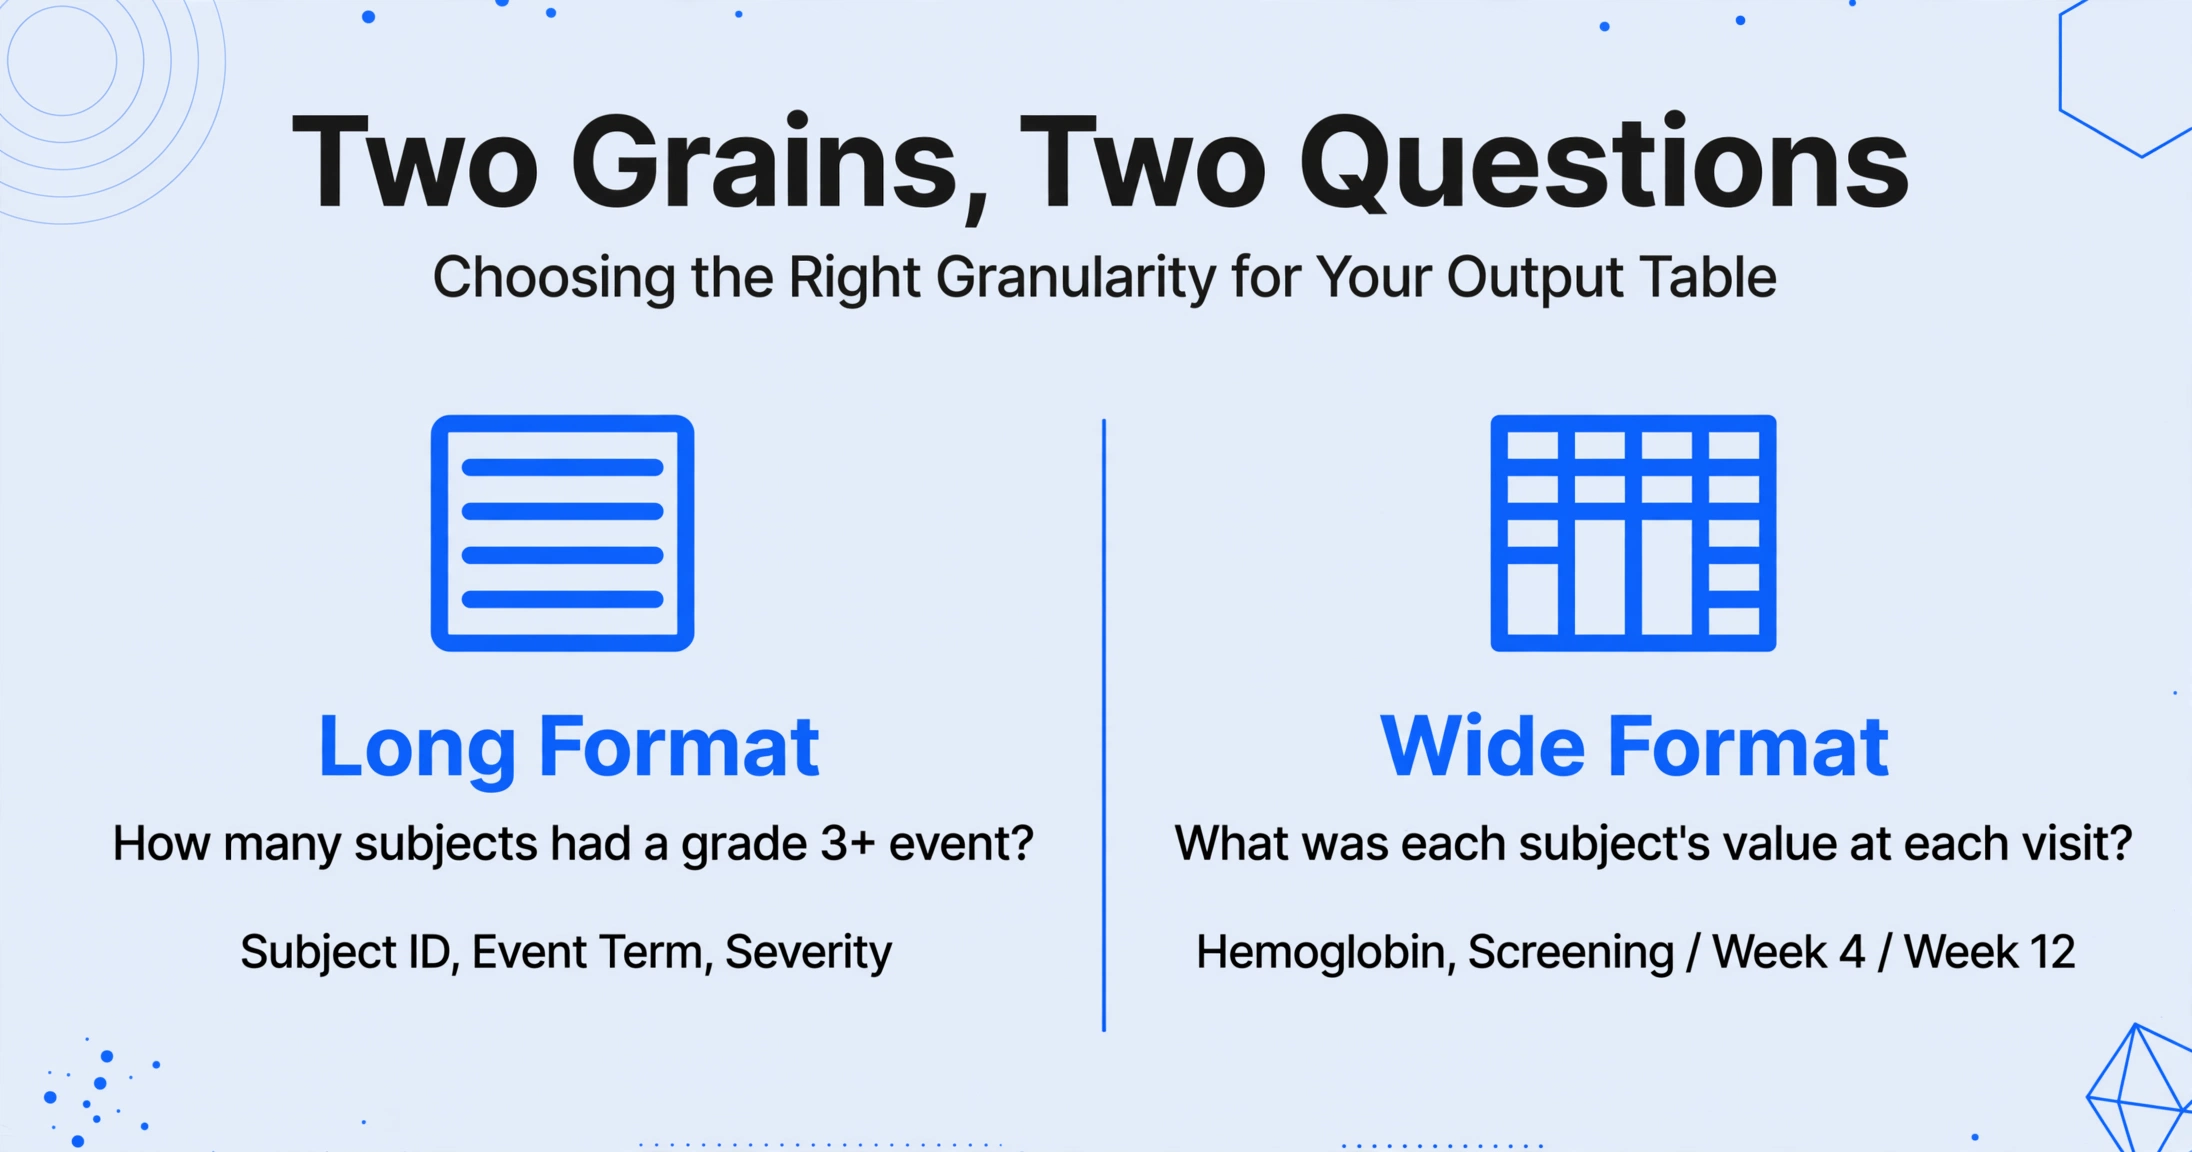
Legen Sie vor der Extraktion fest, was jede Zeile des Ergebnisses darstellen soll. Es gibt zwei praktikable Antworten, die unterschiedliche Fragen beantworten.
Langformat: eine Zeile pro Ereignis
Jedes unerwünschte Ereignis erhält eine eigene Zeile, und die Probanden-ID wird bei jedem Ereignis dieses Probanden wiederholt. Nützliche Spalten: Probanden-ID, Ereignisbegriff, Startdatum, Schweregrad, Schwerwiegend (J/N), Kausalität, ergriffene Maßnahme, Ausgang. Wählen Sie dies, wenn Ihre Frage lautet „Wie viele Probanden hatten ein Ereignis mit Grad 3 oder höher" oder wenn Sie die Zeilen an ein Statistiktool übergeben müssen. Die Probanden-ID verbindet die wiederholten Zeilen miteinander.
Breitformat: eine Zeile pro Proband, Visiten als Spalten
Ein Proband pro Zeile, wobei der Visitenwert in den Spaltennamen einfließt (Hämoglobin, Screening / Hämoglobin, Woche 4 / Hämoglobin, Woche 12). Nützlich, wenn Ihre Frage lautet „Welchen Wert hatte jeder Proband bei jeder Visite" und Sie über die Zeit vergleichen möchten. Der Nachteil: Die Tabelle wird mit jedem zusätzlichen Zeitpunkt breiter, und eine lange Studie kann sie über das angenehm Lesbare hinaus ausdehnen.
Bestimmen Sie die Granularität anhand der Frage, die Sie an die Tabelle stellen möchten, und sehen Sie sich dann das Quelldokument an. Wenn die Quelle eine Auflistung pro Proband ist und Sie einen Vergleich pro Proband wünschen, konvertieren Sie von Langformat in Breitformat – und diese Konvertierung ist echte Arbeit, die kein Extraktionstool kostenlos erledigt. Wenn die Quelle eine Zusammenfassungstabelle ist und Sie ereignisbezogene Zeilen möchten, sind die Details schlicht nicht vorhanden, um sie zu extrahieren; Sie benötigen stattdessen die Auflistung.
Ein Hinweis zu Spalten. Es ist verlockend, eine Spalte „MedDRA bevorzugter Begriff" zu einer Tabelle mit unerwünschten Ereignissen hinzuzufügen, weil das der kodierte Datensatz enthält. Sofern das Quelldokument den kodierten Begriff nicht bereits zeigt, kann diese Spalte nicht extrahiert werden, denn die Zuordnung eines bevorzugten Begriffs ist ein Kodierungsschritt, kein Leseschritt. Der nächste Abschnitt behandelt, was Extraktion aus der Quelle herausholen kann und was nicht.
Wie semantische Extraktion mit wiederkehrenden Strukturen umgeht
Der Grund, warum ein vorlagenbasiertes Tool hier scheitert, ist, dass eine Vorlage an Positionen gebunden ist. Die Extraktion von Tabellen mit unerwünschten Ereignissen ist der Punkt, an dem positionsbasierte Logik zuerst versagt, weil ein Proband mit einem Ereignis und ein Proband mit sechs Ereignissen eine völlig unterschiedliche Anzahl von Zeilen belegen – dieselben Koordinaten stimmen also nie zweimal überein. Ein Vision-Modell, das auf Bedeutung hin liest, ist nicht von diesen Koordinaten abhängig.
Benutzerdefinierte Spaltenextraktion ist der Mechanismus. Statt Zonen auf einer Seite zu zeichnen, geben Sie die gewünschten Spaltennamen ein, z. B. Probanden-ID, Ereignisbegriff, Schweregrad und Schwerwiegend, und die KI lokalisiert jeden Wert, indem sie versteht, was der Spaltenname bedeutet. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen Ihrer Ausgabetabelle, und die Leselogik bleibt stabil, ob ein Proband nun eine oder zehn Ereigniszeilen hat. Der allgemeine Ansatz wird in was KI-Dokumentextraktion tatsächlich ist beschrieben, falls Sie zum ersten Mal damit in Kontakt kommen.
Mehrere Funktionen greifen die Array-Probleme auf, die im letzten Abschnitt beschrieben wurden:
- Berechnete Spalten ermöglichen es der KI, während der Extraktion einen Wert zu berechnen, statt nur einen zu kopieren. Für eine Auflistung unerwünschter Ereignisse deckt das eine Anzahl von Ereignissen pro Proband ab sowie Bedingungsprüfungen wie das Markieren einer Zeile, wenn eine Zwischensumme nicht mit einer angegebenen Summe übereinstimmt. Die Berechnung wird in den Spaltennamen oder eine Regel geschrieben und läuft so auf jedem Dokument im Batch auf dieselbe Weise.
- Abgeleitete Spalten ermöglichen es der KI, einen Wert zuzuweisen, den das Dokument nicht druckt, abgeleitet aus dem, was es druckt. Das ist nützlich für eine Kategorie wie einen Nachverfolgungsstatus, bei dem das Modell liest, ob ein Ereignis als laufend beschrieben wird. Es ersetzt keine medizinische Beurteilung, und Spalten, die eine Beurteilung erfordern, sollten nicht auf diese Weise erstellt werden.
- Mehrseiten-Zusammenführung faltet ein Dokument, das sich über Seiten erstreckt, wieder zu einer Zeile zusammen. Eine Auflistung unerwünschter Ereignisse, die über mehrere gedruckte Seiten fortgesetzt wird, oder die Aufzeichnungen eines Probanden, die über separat gescannte Blätter verteilt sind, können über einen gemeinsamen Wert wie die Probanden-ID gruppiert werden, wobei Felder von der jeweiligen Seite ausgefüllt werden, die sie trägt. Das ist dieselbe Einstellung, die generell bei mehrseitigen PDFs hilft.
- Batch-Verarbeitung liest viele Dateien gleichzeitig und führt die Ergebnisse zu einer Tabelle zusammen, sodass ein Ordner mit CRF-Seiten oder eine Reihe von CSR-Auflistungen ein einzelnes Blatt ergibt statt eines Stapels von Ein-Dokument-Exporten. Das Muster ist dasselbe wie bei der Batch-Extraktion klinischer Daten aus anderen Studienunterlagen.
- Modellstufe ist wichtig, wenn die Quelle ein gescanntes Formular mit handschriftlichen Einträgen ist. Von Hand ausgefüllte Formulare für unerwünschte Ereignisse sind ein bekanntermaßen schwieriger Fall, und eine höhere Verarbeitungsstufe verwendet ein stärkeres Modell für dichte Handschrift und komplexes Layout.
- Überprüfungsmodus mit Bounding-Box-Verifikation ist der Teil, der eine extrahierte Sicherheitstabelle nutzbar macht. Wenn Sie mit der Maus über eine Zelle fahren, wird genau hervorgehoben, woher dieser Wert im Originaldokument stammt, und ein Klick auf eine Region springt zur passenden Zelle zurück. Bei wichtigen Feldern wird so aus „der Extraktion vertrauen“ in Sekunden ein „die Extraktion stichprobenartig prüfen“, statt die gesamte Auflistung erneut zu lesen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Dasselbe Extraktionsmuster gilt überall dort, wo ein Studiendokument eine Struktur pro Proband wiederholt. Eine Visitenpanel-Tabelle, ein klinischer Laborbericht und eine Auflistung unerwünschter Ereignisse sind unterschiedliche Inhalte mit demselben zugrunde liegenden Problem: Die Einheit, die Sie betrachten, wiederholt sich, und das Tool muss die Wiederholung erhalten, statt sie zu vereinfachen.
Was diese Art der Extraktion nicht kann
Die Grenzen klar zu benennen ist nützlicher, als das Tool zu überverkaufen – besonders in einem regulierten Bereich, in dem eine Behauptung in einem Blogbeitrag nicht dasselbe ist wie ein validiertes System.
Es kodiert keine unerwünschten Ereignisse. Die Auswahl von Begriffen in MedDRA, das medizinische Wörterbuch, das einen gemeldeten Begriff einem bevorzugten Begriff unter einem Organsystem zuordnet, ist ein separater Kodierungsschritt mit eigenen Regeln. Das Wörterbuch und seine Hierarchie werden von der MedDRA Maintenance and Support Services Organization gepflegt. Die Extraktion kann einen bereits gedruckten kodierten Begriff lesen, aber sie weist keinen zu.
Es beurteilt keine Sicherheit. Entscheidungen zu Kausalität, Schweregrad (Seriousness) und Erwartbarkeit gehören in die Hände einer qualifizierten Person. Eine abgeleitete Spalte ist eine Interpretation dessen, was das Dokument sagt, keine medizinische Bewertung.
Es anonymisiert nicht. Probandenidentifikatoren in einem Studiendokument bleiben in der Ausgabe. Wenn die Datei an einen Ort geht, an dem keine Datenvereinbarung besteht, ist das ein separater, bewusster Schritt.
Es ist kein validiertes, audit-zertifiziertes System. Regulierte elektronische Aufzeichnungen unterliegen Anforderungen wie einem Audit-Trail für jede Änderung und einer dokumentierten Systemvalidierung, festgelegt in ICH E6(R3) und 21 CFR Part 11. Dieses Tool besitzt keine solche Zertifizierung, daher gehört es vorgelagert zum System of Record, als erster Durchlauf, den ein Mensch überprüft, nicht als Datenbank of Record. Die Systeme, die validierte Studiendaten in großem Umfang halten, sind die Plattformen für elektronische Datenerfassung wie Medidata Rave, Veeva Vault EDC und Oracle Clinical One, daneben leichtere Optionen wie Castor und REDCap. Der Vergleich hier ist nicht gegen diese Plattformen. Er ist gegen eine Person, die eine Auflistung liest und sie abtippt.
Was bleibt, sobald diese Grenzen benannt sind, ist immer noch der Großteil der Arbeit: die wiederholten Werte aus den Dokumenten in eine Tabelle zu überführen, die ein Mensch prüfen kann, statt sie einzeln einzutippen. Diese Lücke ist dieselbe, die Koordinatoren mit Query-Rückstau zurücklässt und Datenmanager mit klinischen Daten, die bereits digital sind und dennoch von Hand eingegeben werden.
FAQ
Kann KI Tabellen mit unerwünschten Ereignissen aus einem CRF oder CSR extrahieren? Ja, sofern Sie festlegen, welche Tabelle Sie meinen. Ein CSR kann dieselben Ereignisse als Zusammenfassungstabelle, als Auflistung pro Proband und als Narrativ enthalten. Benennen Sie daher die Spalten der gewünschten spezifischen Form, z. B. Probanden-ID, Ereignisbegriff, Startdatum und Schweregrad. Die Extraktion liest die Werte; sie entscheidet nicht für Sie, aus welcher der drei Darstellungen gezogen wird.
Ersetzt die Extraktion die Kodierung unerwünschter Ereignisse in MedDRA? Nein. Die Kodierung eines gemeldeten Begriffs in einen bevorzugten Begriff und eine Organsystemklasse ist ein separater Schritt mit eigenen Konventionen und erfordert menschliche Aufsicht. Die Extraktion kann einen kodierten Begriff aus einem Dokument übernehmen, das bereits einen enthält, aber sie führt die Kodierung nicht durch.
Wie stelle ich sicher, dass jedes unerwünschte Ereignis dem richtigen Probanden zugeordnet bleibt? Extrahieren Sie die Probanden-ID als eigene Spalte und lassen Sie sie sich in jeder Ereigniszeile wiederholen. Im Langformat ist die ID das Element, das die wiederholten Zeilen mit einem Teilnehmer verbindet. Wenn die Aufzeichnungen eines Probanden über separat gescannte Seiten verteilt sind, verwenden Sie die Mehrseiten-Zusammenführung, gruppiert nach dieser ID, damit die Teile zu einem Datensatz zusammengeführt werden, bevor die Ereignisse aufgefächert werden.
Ist dies für eine regulierte Einreichung geeignet? Verwenden Sie es als überprüfbaren ersten Durchlauf, nicht als System of Record. Es ist keine validierte oder audit-zertifizierte Plattform, erhebt keinen Anspruch auf ICH-GCP- oder 21-CFR-Part-11-Zertifizierung und führt keine Anonymisierung oder Beurteilung durch. Die validierte Datenbank of Record bleibt Ihr System für elektronische Datenerfassung.
Die Form des Dokuments sollte die Form der Tabelle bestimmen
Der Grund, warum die Extraktion aus klinischen Studiendokumenten schwieriger ist als die aus Rechnungen, ist struktureller, nicht technischer Natur. Rechnungen kommen einzeln pro Zeile an. Studiendokumente kommen als Arrays: ein Proband über viele Visiten, ein Proband mit vielen unerwünschten Ereignissen, ein Ereignis mit vielen zugehörigen Datensätzen. Sobald Sie die Granularität der Ausgabe benennen, die Sie tatsächlich benötigen, wird die Definition der Spalten zu einer einfachen Entscheidung, und die verbleibende Arbeit ist die Überprüfung – genau das, womit eine qualifizierte Person ohnehin ihre Zeit verbringen sollte.
Beginnen Sie mit einer Auflistung unerwünschter Ereignisse oder einem Visiten-Panel-Dokument, definieren Sie die gewünschten Spalten, und sehen Sie die Tabelle zurückkommen, bevor Sie einen ganzen Batch festlegen.