Extração de Documentos de Ensaios Clínicos
Além de Uma Linha por Paciente
Em 2021, equipes de gerenciamento de dados clínicos de sete empresas farmacêuticas reuniram vinte estudos de Fase III concluídos e contaram todas as consultas de dados levantadas contra eles. O total chegou a 1.939.606 consultas em 20.125 participantes. Os cinco tipos de formulário que geraram mais da metade de todo esse tráfego de consultas foram medicação concomitante, laboratório, eventos adversos, exposição e responsabilidade do medicamento. Esses cinco formulários têm uma coisa em comum, e não é o layout: nenhum deles é um registro por paciente. Este artigo trata desse fato estrutural e do que ele significa quando você tenta executar a extração de documentos de ensaios clínicos e acaba com uma planilha que não corresponde à forma como os dados realmente se comportam.
Principais Conclusões
- 1.939.606 consultas de dados em 20.125 participantes, e mais da metade veio de cinco tipos de formulário que compartilham uma característica: nenhum deles é um registro por paciente.
- Os dados do ensaio chegam em matrizes, um sujeito com muitos eventos adversos e um evento com muitos registros relacionados, enquanto uma planilha assume que uma linha é uma coisa, então o acúmulo é estrutural e não uma questão de digitar mais rápido.
- Defina primeiro a granularidade que você precisa, uma linha por evento ou uma linha por sujeito com visitas como colunas, e as colunas se definem sozinhas, restando apenas a revisão humana.
O Conjunto de Documentos de Ensayos Clínicos e o Que Cada Um Contiene
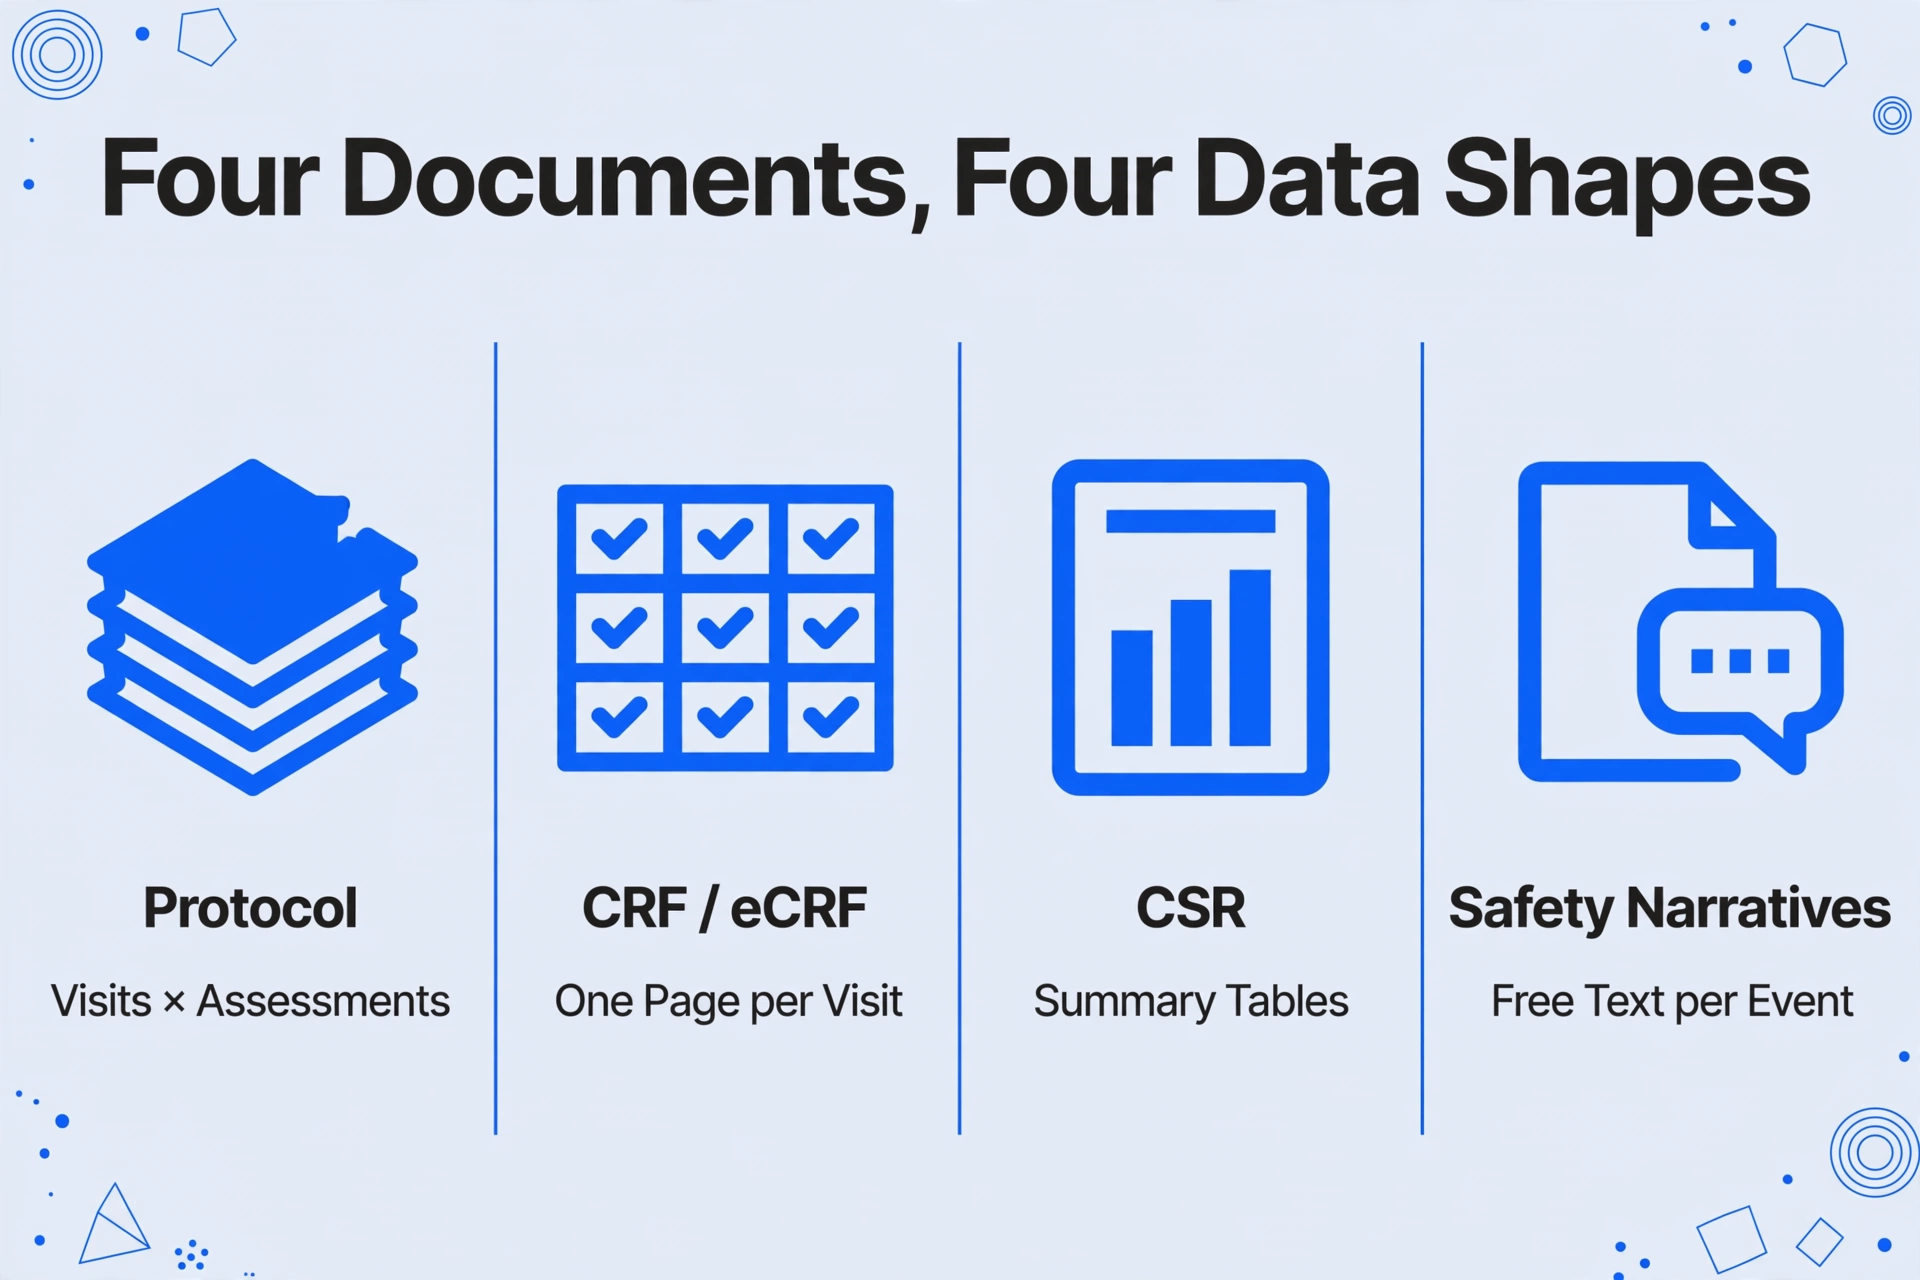
La documentación de ensayos clínicos no es un solo tipo de documento. Es una pequeña familia de documentos que describen el mismo estudio desde cuatro ángulos diferentes, y cada ángulo produce una forma de datos diferente.
| Documento | Qué es | Forma de los datos internos |
|---|---|---|
| Protocolo | El plan del estudio, incluido el cronograma de evaluaciones: qué procedimientos ocurren en cada visita para cada participante | Una cuadrícula de visitas × evaluaciones (una fila por visita, una columna por procedimiento) |
| CRF / eCRF | El formulario de relato de caso, el instrumento que captura lo que sucedió en cada visita | Una página por visita por sujeto, con bloques repetidos para eventos |
| CSR | El relatório de estudio clínico, el resumen regulatorio integrado de todo el estudio | Tablas resumen, listados de pacientes y narrativas, todos describiendo los mismos eventos a diferentes niveles de detalle |
| Narrativas de seguridad | Redacción en prosa de muertes, eventos adversos graves y otros eventos marcados | Texto libre, una narrativa por evento |
El relatório de estudio clínico tiene una estructura fija por diseño. ICH E3, la guía internacional para la estructura y el contenido de los relatos de estudio clínicos, coloca el resumen de eventos adversos en la sección 12.2, las visualizaciones detalladas de eventos adversos en la sección 14.3.1 y los listados de eventos adversos paciente por paciente en la sección 16.2.7. La sección 12.2.2 solicita tablas que enumeren cada evento adverso, el número de pacientes en cada grupo de tratamiento en el que ocurrió y la tasa de ocurrencia, agrupados por sistema corporal y divididos por gravedad y causalidad. La sección 16.2.7 es donde los mismos eventos aparecen un sujeto a la vez.
Ese es el primer lugar donde la extracción de datos del relatório de estudio clínico se vuelve difícil: los mismos datos de eventos adversos existen en tres formas dentro de un solo documento (una tabla agregada, un listado por sujeto y una narrativa), y un lector que le pide a la herramienta "eventos adversos" sin especificar qué forma quiere obtendrá la que el modelo encuentre primero.
Abaixo do relatório, os dados de submissões seguem o CDISC Study Data Tabulation Model. Seu domínio de eventos adversos é definido como um registro por evento por sujeito, o que é uma forma formal de dizer que um único participante pode aparecer várias vezes na mesma tabela. Detalhes relacionados que se anexam a um evento, como a sequência de graus de toxicidade pelos quais ele passou, ficam em um domínio separado conectado ao registro de evento adverso por uma relação um-para-muitos. Se você só extraiu faturas ou recibos até agora, onde um documento equivale a uma linha, esta é a parte que vai surpreendê-lo. O modelo completo é documentado pela CDISC.
Onde uma Tabela Plana Encontra uma Matriz
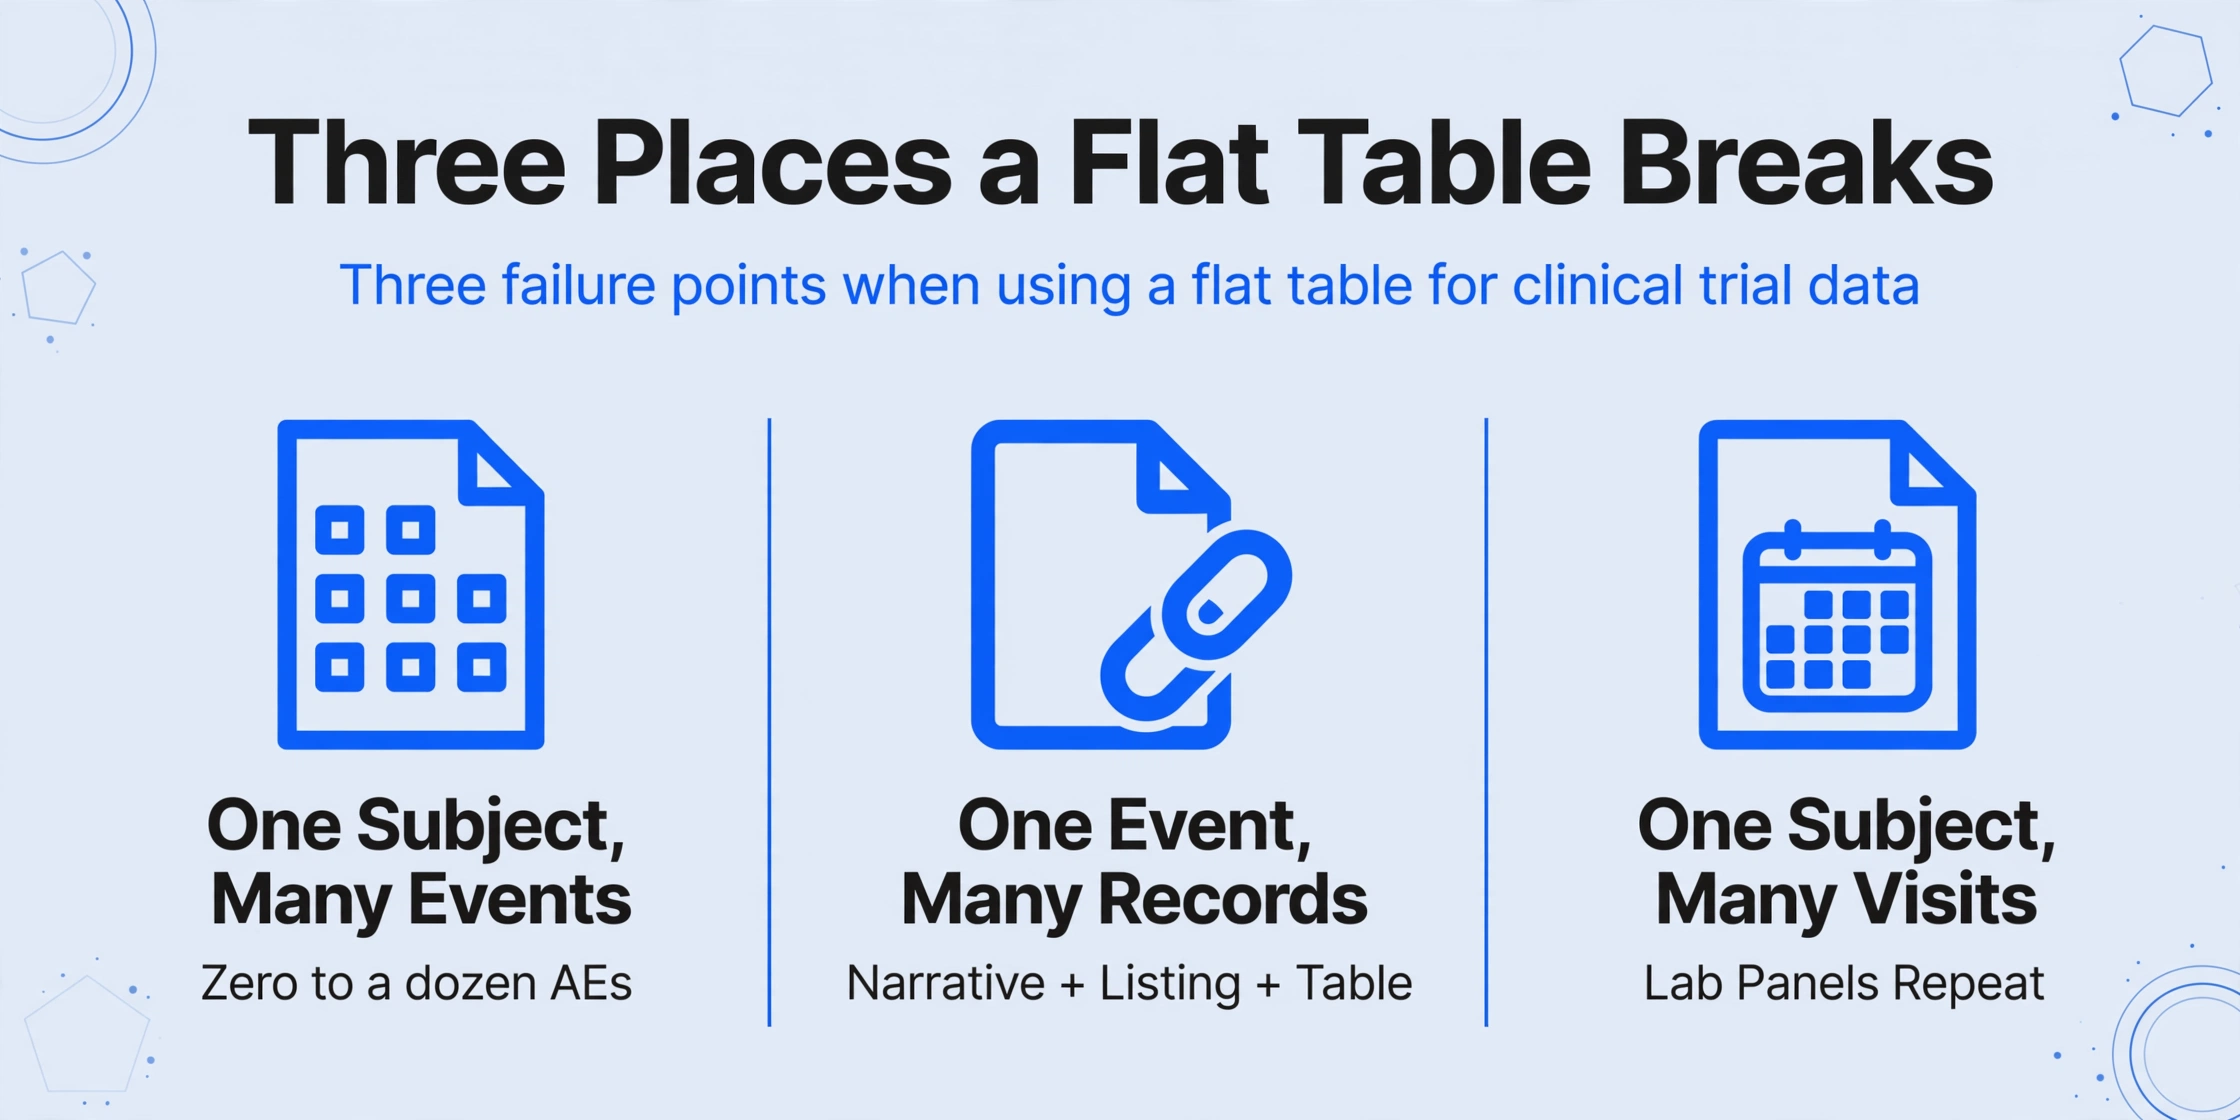
Uma planilha pressupõe que uma linha é uma coisa. Os dados de ensaios clínicos quebram essa premissa em três pontos específicos, e cada um aparece nos documentos mencionados acima.
Um sujeito, muitos eventos adversos. Um único participante pode experimentar zero, um ou uma dúzia de eventos adversos durante um ensaio, cada um com seu próprio termo, data de início, gravidade, seriedade, causalidade, ação tomada e desfecho. Uma tabela que dá a cada sujeito uma linha precisa descartar eventos ou amontoá-los em uma única célula. Esta é a matriz que gerou o tráfego de consultas na estatística de abertura, porque cada evento precisa ser revisado e reconciliado antes de se tornar um registro limpo.
Um evento, muitos registros relacionados. Um evento adverso grave não é uma única célula. Ele tem um início e uma resolução, uma avaliação de causalidade, talvez várias entradas de acompanhamento à medida que novas informações chegam. No modelo de dados, esses são registros vinculados e, no relatório impresso, tornam-se uma narrativa, além de uma linha em uma listagem e uma linha em uma tabela resumo.
Um sujeito, muitas visitas, muitos painéis de laboratório. Os valores laboratoriais se repetem a cada visita. Um painel de química do sangue coletado na triagem, na semana 4, na semana 8 e na semana 12 são quatro conjuntos dos mesmos parâmetros associados à mesma pessoa. Um cronograma de avaliações do protocolo é em si uma grade bidimensional, e os dados laboratoriais se ramificam a partir dela.
Há uma versão separada e puramente mecânica desse problema: as tabelas impressas frequentemente usam células de cabeçalho mescladas e recuo para expressar a hierarquia de sistema corporal e termo preferido, então um extrator ingênuo lê os termos dos eventos corretamente, mas perde o sistema corporal ao qual eles pertenciam. Esse modo de falha é abordado em detalhes em por que células mescladas quebram a extração de tabelas, então este artigo permanece na estrutura, em vez da grade.
A reclamação das pessoas que vivem esse trabalho não é sutil. No r/clinicalresearch, um coordenador escrevendo no tópico "I hate data entry" foi direto: "I sometimes also feel like I'm too slow and the tasks are too tedious. I've been working with a site right now that has over 200 queries." Um tópico separado sobre como limpar o acúmulo de entrada de dados de um local detalha a triagem que a maioria das equipes já realiza: resolver as consultas mais antigas primeiro, trabalhar paciente por paciente, reservar tempo para a entrada todos os dias. Nenhuma dessa triagem aborda a razão pela qual o acúmulo existe, que é o fato de os dados chegarem em matrizes e o destino ser uma linha.
A extração de documentos de ensaios clínicos é lenta porque a granularidade de saída do documento e a granularidade de saída da planilha raramente coincidem na primeira tentativa.
Escolhendo a Granularidade da Sua Tabela de Saída
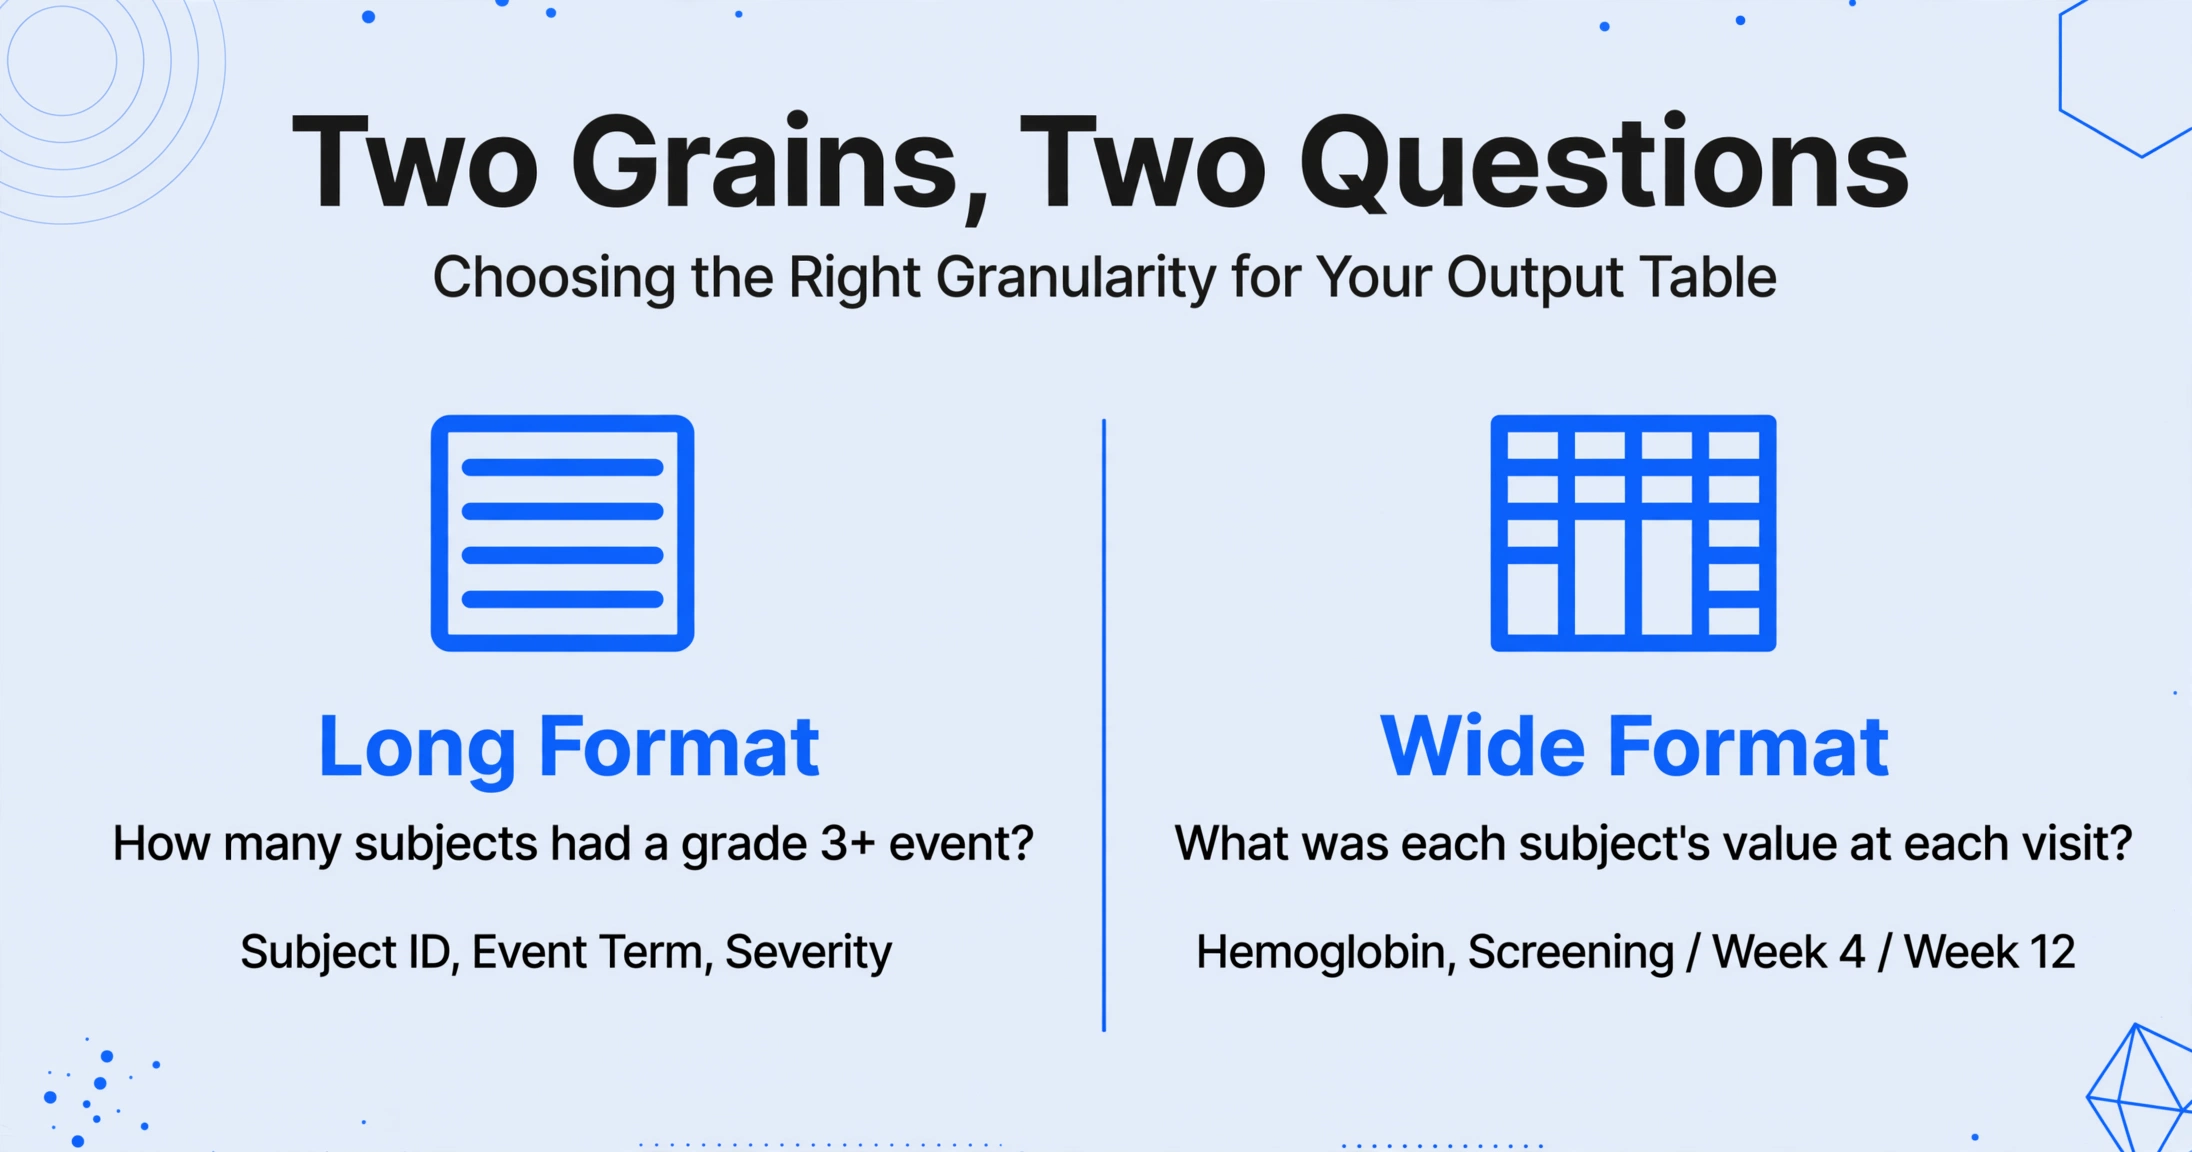
Antes de extrair qualquer coisa, decida o que cada linha do resultado deve representar. Há duas respostas viáveis, e elas atendem a perguntas diferentes.
Formato longo: uma linha por evento
Cada evento adverso recebe sua própria linha, e o identificador do sujeito se repete em cada um dos eventos daquele sujeito. Colunas úteis: ID do Sujeito, Termo do Evento, Data de Início, Gravidade, Grave (S/N), Causalidade, Ação Tomada, Desfecho. Escolha isso quando sua pergunta for "quantos sujeitos tiveram um evento de grau 3 ou superior" ou quando precisar passar as linhas para uma ferramenta estatística. O identificador do sujeito é o que conecta as linhas repetidas de volta.
Formato largo: uma linha por sujeito, visitas como colunas
Um sujeito por linha, com o valor da visita incorporado ao nome da coluna (Hemoglobina, Triagem / Hemoglobina, Semana 4 / Hemoglobina, Semana 12). Útil quando sua pergunta é "qual era o valor de cada sujeito em cada visita" e você quer comparar ao longo do tempo. A desvantagem é que a tabela fica mais larga a cada ponto de tempo adicionado, e um ensaio longo pode ultrapassar o que é confortável de ler.
Decida a granularidade a partir da pergunta que você fará à planilha e depois examine o documento de origem. Se a origem é uma listagem por sujeito e você quer uma comparação por sujeito, você está convertendo de longo para largo, e essa conversão é um trabalho real que nenhuma ferramenta de extração faz de graça. Se a origem é uma tabela resumo e você quer linhas no nível de evento, o detalhe simplesmente não está lá para ser extraído, e você precisa da listagem.
Uma ressalva sobre colunas. É tentador adicionar uma coluna "Termo Preferido MedDRA" a uma tabela de eventos adversos, porque é isso que o conjunto de dados codificado contém. A menos que o documento de origem já mostre o termo codificado, essa coluna não pode ser extraída, porque atribuir um termo preferido é uma etapa de codificação, não de leitura. A próxima seção trata do que a extração pode e não pode extrair da origem.
Como a Extração Semântica Lida com Estruturas Repetidas
A razão pela qual uma ferramenta baseada em modelos falha aqui é que um modelo está vinculado a posições. A extração de tabelas de eventos adversos é onde a lógica baseada em posição falha primeiro, porque um sujeito com um evento e um sujeito com seis ocupam números completamente diferentes de linhas, então as mesmas coordenadas nunca se alinham duas vezes. Um modelo de visão que lê por significado não depende dessas coordenadas.
Extração de Colunas Personalizadas é o mecanismo. Em vez de desenhar zonas em uma página, você digita os nomes das colunas desejadas, como ID do Sujeito, Termo do Evento, Gravidade e Sério, e a IA localiza cada valor entendendo o que o nome da coluna significa. Os nomes das colunas que você insere tornam-se os cabeçalhos da sua tabela de saída, e a lógica de leitura permanece estável, quer um sujeito tenha uma linha de evento ou dez. A abordagem geral é descrita em o que realmente é a extração de documentos por IA se esta for sua primeira vez com isso.
Várias capacidades se alinham com os problemas de matriz descritos na seção anterior:
- coluna calculada permite que a IA calcule um valor durante a extração, em vez de apenas copiar um. Para uma listagem de eventos adversos, isso cobre uma contagem de eventos por sujeito e verificações condicionais, como sinalizar uma linha quando um subtotal não reconcilia com um total declarado. O cálculo é escrito no nome da coluna ou em uma regra, então é executado em todos os documentos do lote da mesma forma.
- coluna inferida permite que a IA atribua um valor que o documento não imprime, extraído do que ele imprime. Isso é útil para um agrupamento como status de acompanhamento, onde o modelo lê se um evento é descrito como em andamento. Não substitui o julgamento médico, e colunas que exigem adjudicação não devem ser construídas dessa forma.
- mesclagem de várias páginas dobra um documento que abrange páginas de volta em uma linha. Uma listagem de eventos adversos continuada em várias páginas impressas, ou os registros de um sujeito espalhados por folhas digitalizadas separadamente, podem ser agrupados por um valor compartilhado, como o identificador do sujeito, com campos preenchidos a partir da página que os contém. Esta é a mesma configuração que ajuda com PDFs de várias páginas em geral.
- Processamento em lote lê muitos arquivos de uma vez e mescla os resultados em uma tabela, então uma pasta de páginas de CRF ou um conjunto de listagens de CSR torna-se uma única planilha em vez de uma pilha de exportações de um documento. O padrão é o mesmo usado para extração de dados clínicos em lote de outros registros de ensaios.
- nível de modelo importa quando a fonte é um formulário digitalizado com entradas manuscritas. Formulários de eventos adversos preenchidos à mão são um caso difícil conhecido, e um nível de processamento mais alto usa um modelo mais forte para caligrafia densa e layout complexo.
- Modo de Revisão com verificação de caixa delimitadora é a parte que torna uma tabela de segurança extraída utilizável. Passar o mouse sobre uma célula destaca exatamente de onde aquele valor veio no documento original, e clicar em uma região salta de volta para a célula correspondente. Para campos que importam, isso transforma "confiar na extração" em "verificação pontual da extração" em segundos, em vez de reler toda a listagem novamente.
Os arquivos são processados com segurança e não são armazenados.
O mesmo padrão de extração se aplica sempre que um documento de ensaio repete uma estrutura por sujeito. Uma tabela de painel de visitas, um relatório de laboratório clínico e uma listagem de eventos adversos são conteúdos diferentes com o mesmo problema subjacente: a unidade de interesse se repete, e a ferramenta precisa preservar a repetição em vez de achatá-la.
O que Este Tipo de Extração Não Consegue Fazer
Ser claro sobre o limite é mais útil do que superestimar a ferramenta, especialmente em uma área regulamentada onde uma afirmação em um post de blog não é o mesmo que um sistema validado.
Ela não codifica eventos adversos. A seleção de termos no MedDRA, o dicionário médico que mapeia um termo relatado para um termo preferido sob um sistema corporal, é uma etapa de codificação separada, regida por seu próprio conjunto de regras. O dicionário e sua hierarquia são mantidos pela MedDRA Maintenance and Support Services Organization. A extração pode ler um termo codificado que já está impresso, mas não atribui um.
Ela não adjudica a segurança. Decisões de causalidade, seriedade e expectabilidade pertencem a uma pessoa qualificada. Uma coluna inferida é uma leitura do que o documento diz, não uma avaliação médica.
Ela não realiza anonimização. Os identificadores de sujeito em um documento de ensaio permanecem na saída. Se o arquivo for para algum lugar sem acordo de dados, lidar com isso é uma etapa separada e deliberada.
Não é um sistema validado e certificado por auditoria. Registros eletrônicos regulamentados trazem requisitos como trilha de auditoria para cada alteração e validação documentada do sistema, definidos no ICH E6(R3) e 21 CFR Part 11. Esta ferramenta não possui essa certificação, portanto, ela pertence a montante do sistema de registro, como uma primeira passagem que um humano revisa, e não como o banco de dados de registro. Os sistemas que mantêm dados de ensaios validados em escala são as plataformas de captura eletrônica de dados, como Medidata Rave, Veeva Vault EDC e Oracle Clinical One, além de opções mais leves como Castor e REDCap. A comparação aqui não é contra essas plataformas. É contra uma pessoa lendo uma listagem e redigitando-a.
O que resta, uma vez que esses limites são declarados, ainda é a maior parte do trabalho: extrair os valores repetidos dos documentos e colocá-los em uma tabela que um humano possa verificar, em vez de digitá-los um a um. Essa lacuna é a mesma que faz os coordenadores lidarem com acúmulos de consultas e deixa os gerentes de dados com dados clínicos que já são digitais e ainda são inseridos manualmente.
FAQ
A IA consegue extrair tabelas de eventos adversos de um CRF ou CSR? Sim, desde que você defina qual tabela você quer. Um CSR pode conter os mesmos eventos em uma tabela resumo, uma listagem por sujeito e uma narrativa, então nomeie as colunas do formato específico que você deseja, como ID do Sujeito, Termo do Evento, Data de Início e Gravidade. A extração lê os valores; ela não decide por você de qual dos três formatos extrair.
A extração substitui a codificação de eventos adversos em MedDRA? Não. Codificar um termo relatado para um termo preferido e classe de sistema corporal é uma etapa separada com suas próprias convenções e exige supervisão humana. A extração pode carregar um termo codificado de um documento que já contenha um, mas ela não realiza a codificação.
Como mantenho cada evento adverso vinculado ao sujeito certo? Extraia o identificador do sujeito como uma coluna própria e deixe-o repetir em cada linha de evento. No formato longo, o identificador é o que liga as linhas repetidas de volta a um participante. Se os registros de um sujeito chegarem em páginas escaneadas separadamente, use a mesclagem de várias páginas agrupada por esse identificador para que as partes se juntem em um único registro antes de os eventos se espalharem.
Isso é adequado para uma submissão regulamentada? Use como uma primeira passagem revisável, não como o sistema de registro. Não é uma plataforma validada ou certificada para auditoria e não faz nenhuma declaração de certificação ICH-GCP ou 21 CFR Part 11, e não realiza anonimização nem adjudicação. O banco de dados de registro validado continua sendo o seu sistema de captura eletrônica de dados.
A Forma do Documento Deve Determinar a Forma da Planilha
O motivo pelo qual a extração de documentos de ensaios clínicos é mais difícil do que a extração de faturas é estrutural, não técnico. Faturas chegam uma por linha. Documentos de ensaios chegam como matrizes: um sujeito em várias visitas, um sujeito com vários eventos adversos, um evento com vários registros relacionados. Depois de definir a granularidade da saída que você realmente precisa, definir as colunas se torna uma decisão simples, e o trabalho que resta é a revisão, que é exatamente onde uma pessoa qualificada deveria gastar tempo de qualquer forma.
Comece com uma listagem de eventos adversos ou um documento de painel de visitas, defina as colunas desejadas e veja a tabela retornar antes de comprometer um lote inteiro.