Extracción de documentos de ensayos clínicos
más allá de una fila por paciente
En 2021, los equipos de gestión de datos clínicos de siete empresas farmacéuticas reunieron veinte estudios de Fase III completados y contaron todas las consultas de datos planteadas contra ellos. El total ascendió a 1.939.606 consultas entre 20.125 participantes. Los cinco tipos de formularios que generaron más de la mitad de todo ese tráfico de consultas fueron medicación concomitante, laboratorio, eventos adversos, exposición y responsabilidad del fármaco. Esos cinco formularios tienen algo en común, y no es su diseño: ninguno es un registro por paciente. Este artículo trata sobre ese hecho estructural y sobre lo que significa cuando intenta ejecutar la extracción de documentos de ensayos clínicos y termina con una hoja de cálculo que no coincide con la forma en que los datos se comportan realmente.
Conclusiones clave
- 1.939.606 consultas de datos entre 20.125 participantes, y más de la mitad provinieron de cinco tipos de formularios que comparten una característica: ninguno es un registro por paciente.
- Los datos de los ensayos llegan en arrays: un sujeto con muchos eventos adversos y un evento con muchos registros relacionados, mientras que una hoja de cálculo asume que una fila es una cosa, por lo que la acumulación es estructural y no una cuestión de escribir más rápido.
- Defina primero la granularidad que necesita —una fila por evento o una fila por sujeto con las visitas como columnas— y las columnas se definen solas, quedando solo la revisión humana.
El conjunto de documentos de ensayos clínicos y qué contiene cada uno
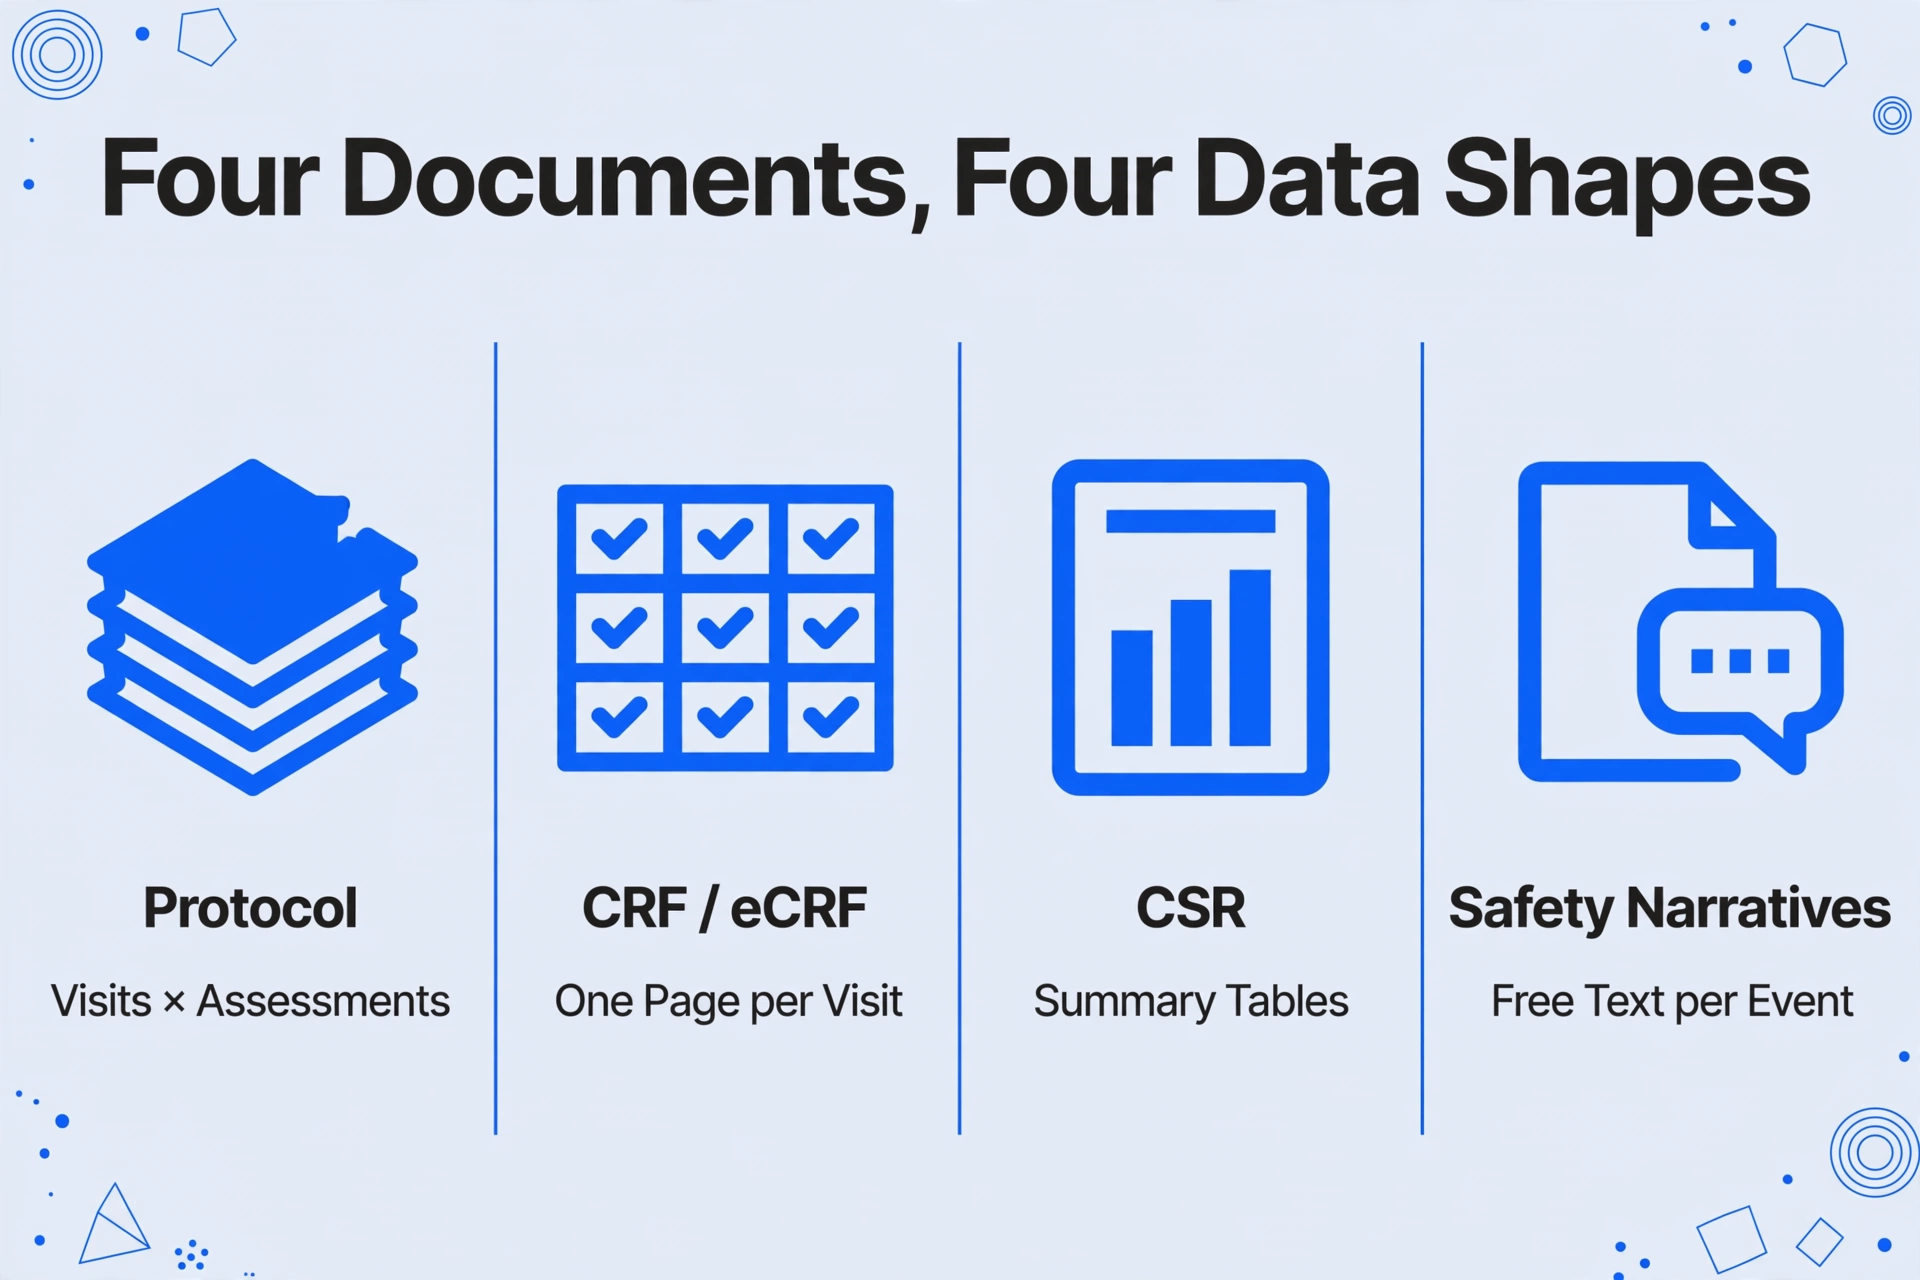
La documentación de ensayos clínicos no es un solo tipo de documento. Es una pequeña familia de documentos que describen el mismo estudio desde cuatro ángulos diferentes, y cada ángulo produce una forma de datos distinta.
| Documento | Qué es | Forma de los datos que contiene |
|---|---|---|
| Protocolo | El plan del estudio, incluido el calendario de evaluaciones: qué procedimientos se realizan en cada visita para cada participante | Una cuadrícula de visitas × evaluaciones (una fila por visita, una columna por procedimiento) |
| CRF / eCRF | El formulario de informe de caso, el instrumento que captura lo que ocurrió en cada visita | Una página por visita y por sujeto, con bloques repetidos para los eventos |
| CSR | El informe de estudio clínico, el resumen regulador integrado de todo el estudio | Tablas resumen, listados de pacientes y narrativas, todos describiendo los mismos eventos con diferentes niveles de detalle |
| Narrativas de seguridad | Redacciones en prosa de muertes, eventos adversos graves y otros eventos marcados | Texto libre, una narrativa por evento |
El informe de estudio clínico tiene una estructura fija por diseño. ICH E3, la guía internacional para la estructura y el contenido de los informes de estudio clínicos, sitúa el resumen de eventos adversos en la sección 12.2, las presentaciones detalladas de eventos adversos en la sección 14.3.1 y los listados de eventos adversos paciente por paciente en la sección 16.2.7. La sección 12.2.2 solicita tablas que enumeren cada evento adverso, el número de pacientes de cada grupo de tratamiento en los que ocurrió y la tasa de ocurrencia, agrupados por sistema corporal y divididos por gravedad y causalidad. La sección 16.2.7 es donde los mismos eventos aparecen un sujeto a la vez.
Ese es el primer lugar donde la extracción de datos del informe de estudio clínico se vuelve difícil: los mismos datos de eventos adversos existen en tres formas dentro de un solo documento (una tabla agregada, un listado por sujeto y una narrativa), y un lector que pide a la herramienta "eventos adversos" sin especificar qué forma quiere obtendrá la que el modelo encuentre primero.
Debajo del informe, los datos de las presentaciones siguen el Modelo de Datos de Tabulación de Estudios CDISC. Su dominio de eventos adversos se define como un registro por evento por sujeto, que es una forma formal de decir que un solo participante puede aparecer muchas veces en la misma tabla. Los detalles relacionados que se adjuntan a un evento, como la secuencia de grados de toxicidad por los que pasó, viven en un dominio separado conectado al registro de eventos adversos por una relación uno a muchos. Si solo ha extraído facturas o recibos, donde un documento equivale a una fila, esta es la parte que le sorprenderá. El modelo completo está documentado por CDISC.
Donde una Tabla Plana se Encuentra con una Matriz
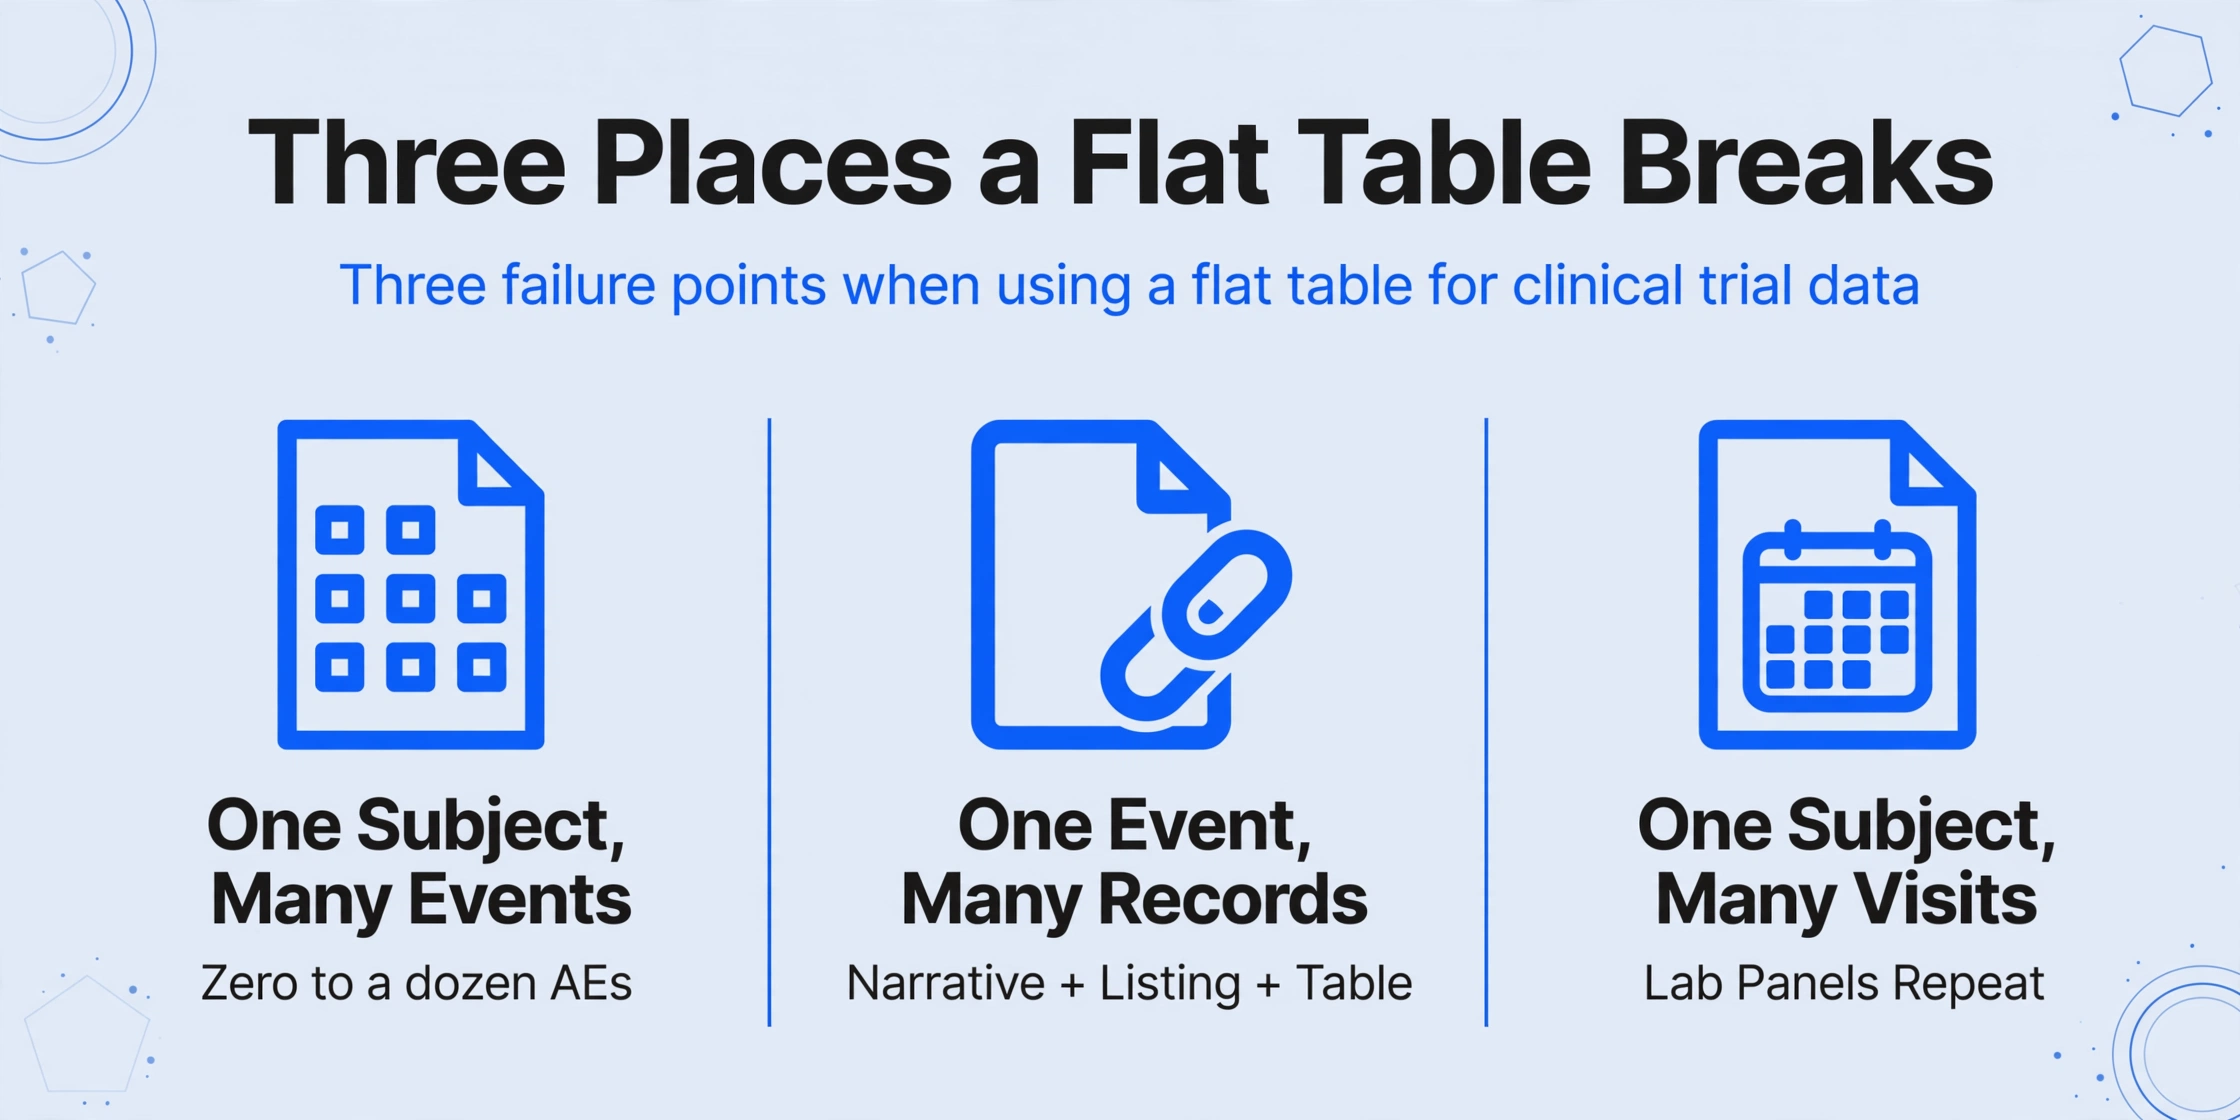
Una hoja de cálculo asume que una fila es una cosa. Los datos de ensayos clínicos rompen esa suposición en tres lugares específicos, y cada uno aparece en los documentos mencionados anteriormente.
Un sujeto, muchos eventos adversos. Un solo participante puede experimentar cero, uno o una docena de eventos adversos durante un ensayo, cada uno con su propio término, fecha de inicio, gravedad, seriedad, causalidad, acción tomada y resultado. Una tabla que le da a cada sujeto una fila tiene que eliminar eventos o meterlos en una celda. Esta es la matriz que generó el tráfico de consultas en la estadística inicial, porque cada evento debe ser revisado y conciliado antes de convertirse en un registro limpio.
Un evento, muchos registros relacionados. Un evento adverso grave no es una sola celda. Tiene un inicio y una resolución, una evaluación de causalidad, quizás varias entradas de seguimiento a medida que llega nueva información. En el modelo de datos son registros vinculados, y en el informe impreso se convierten en una narrativa más una línea en un listado más una línea en una tabla resumen.
Un sujeto, muchas visitas, muchos paneles de laboratorio. Los valores de laboratorio se repiten en cada visita. Un panel de química sanguínea recopilado en el cribado, la semana 4, la semana 8 y la semana 12 son cuatro conjuntos de los mismos parámetros adjuntos a la misma persona. Un calendario de evaluaciones del protocolo es en sí mismo una cuadrícula bidimensional, y los datos de laboratorio se expanden a partir de ella.
Hay una versión separada, puramente mecánica, de este problema: las tablas impresas a menudo usan celdas de encabezado combinadas y sangría para expresar la jerarquía de sistema corporal y término preferido, por lo que un extractor ingenuo lee los términos de los eventos correctamente pero pierde bajo qué sistema corporal estaban. Ese modo de fallo se cubre en detalle en por qué las celdas de encabezado combinadas rompen la extracción de tablas, así que este artículo se centra en la estructura en lugar de la cuadrícula.
La queja de las personas que viven en este trabajo no es sutil. En r/clinicalresearch, un coordinador que escribió en el hilo "Odio la entrada de datos" lo expresó claramente: "A veces también siento que soy demasiado lento y las tareas son demasiado tediosas. He estado trabajando con un sitio que tiene más de 200 consultas." Un hilo separado sobre cómo limpiar la acumulación de entrada de datos de un sitio recorre el triaje que la mayoría de los equipos ya realizan: abordar las consultas más antiguas primero, trabajar paciente por paciente, reservar tiempo para la entrada todos los días. Ninguno de ese triaje aborda la razón por la que existe la acumulación, que es que los datos llegan en matrices y el destino es una fila.
La extracción de documentos de ensayos clínicos es lenta porque la granularidad de salida del documento y la de la hoja de cálculo rara vez coinciden al primer intento.
Cómo elegir la granularidad de tu tabla de salida
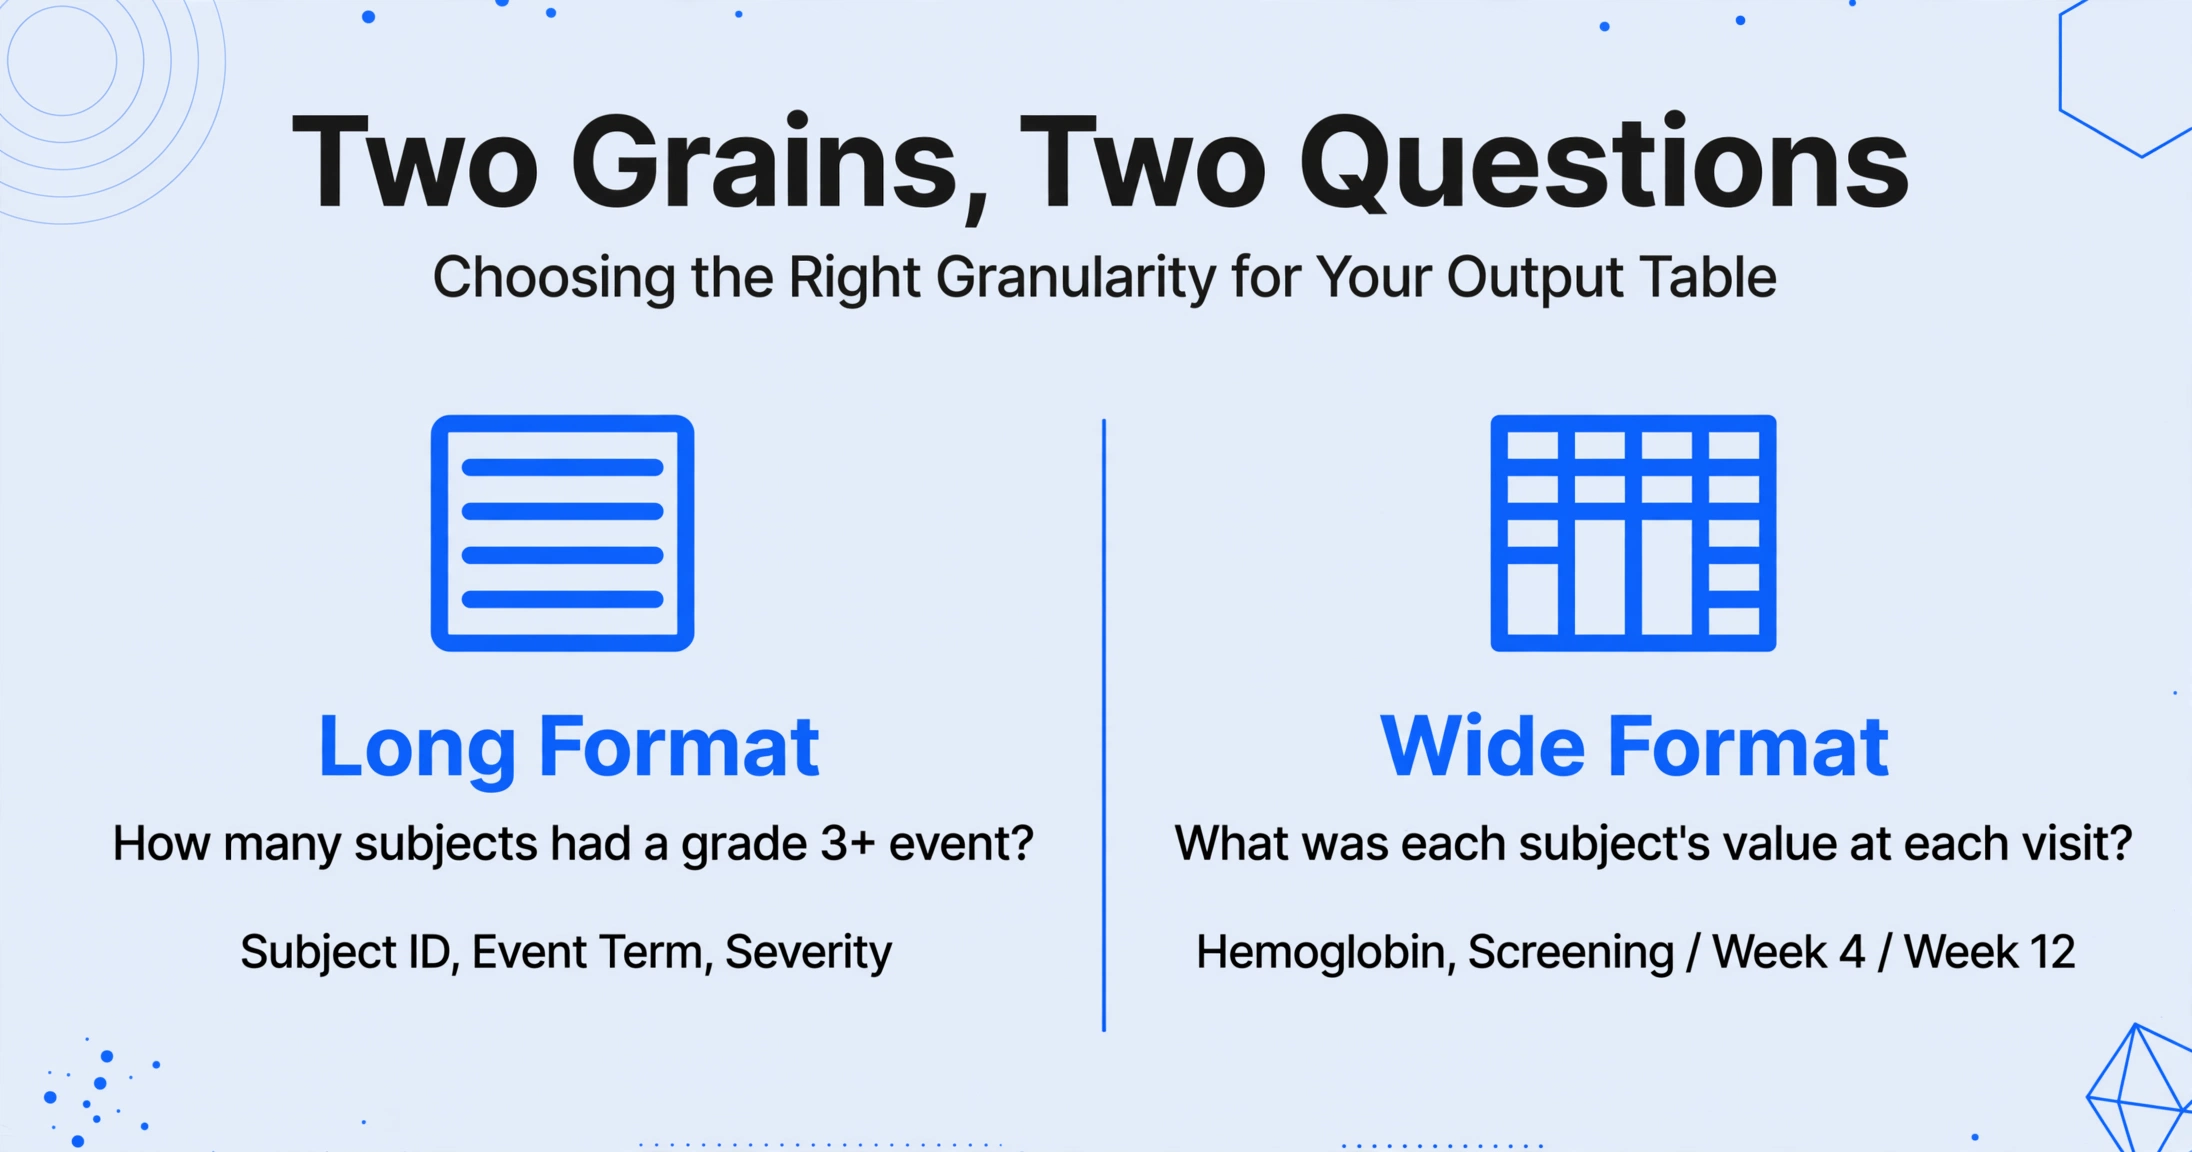
Antes de extraer nada, decide qué debe representar cada fila del resultado. Hay dos respuestas viables, y responden a preguntas distintas.
Formato largo: una fila por evento
Cada evento adverso tiene su propia fila, y el identificador del sujeto se repite en cada uno de los eventos de ese sujeto. Columnas útiles: ID del sujeto, término del evento, fecha de inicio, gravedad, seriedad (S/N), causalidad, acción tomada, resultado. Elige esto cuando tu pregunta sea "cuántos sujetos tuvieron un evento de grado 3 o superior" o cuando necesites pasar las filas a una herramienta estadística. El identificador del sujeto es lo que vuelve a unir las filas repetidas.
Formato ancho: una fila por sujeto, visitas como columnas
Un sujeto por fila, con el valor de la visita integrado en el nombre de la columna (Hemoglobina, cribado / Hemoglobina, semana 4 / Hemoglobina, semana 12). Es útil cuando tu pregunta es "cuál era el valor de cada sujeto en cada visita" y quieres comparar a lo largo del tiempo. La desventaja es que la tabla se ensancha con cada punto temporal añadido, y un ensayo largo puede llevarla más allá de lo que resulta cómodo de leer.
Decide la granularidad a partir de la pregunta que harás a la hoja y luego mira el documento fuente. Si la fuente es un listado por sujeto y quieres una comparación por sujeto, estás convirtiendo de formato largo a ancho, y esa conversión es trabajo real que ninguna herramienta de extracción hace gratis. Si la fuente es una tabla resumen y quieres filas a nivel de evento, el detalle simplemente no está ahí para extraerlo, y necesitas el listado.
Una advertencia sobre las columnas. Es tentador añadir una columna de "término preferido de MedDRA" a una tabla de eventos adversos, porque eso es lo que contiene el conjunto de datos codificado. A menos que el documento fuente ya muestre el término codificado, esa columna no se puede extraer, porque asignar un término preferido es un paso de codificación, no de lectura. La siguiente sección trata de lo que la extracción puede y no puede sacar de la fuente.
Cómo la Extracción Semántica Maneja Estructuras Repetidas
La razón por la que una herramienta basada en plantillas falla aquí es que una plantilla está ligada a posiciones. La extracción de tablas de eventos adversos es donde la lógica basada en posición falla primero, porque un sujeto con un evento y un sujeto con seis ocupan números de líneas completamente diferentes, por lo que las mismas coordenadas nunca coinciden dos veces. Un modelo de visión que lee para comprender el significado no depende de esas coordenadas.
Extracción de Columnas Personalizadas es el mecanismo. En lugar de dibujar zonas en una página, escribes los nombres de las columnas que deseas, como ID del Sujeto, Término del Evento, Gravedad y Seriedad, y la IA localiza cada valor al comprender lo que significa el nombre de la columna. Los nombres de las columnas que ingresas se convierten en los encabezados de tu tabla de salida, y la lógica de lectura se mantiene estable ya sea que un sujeto tenga una fila de evento o diez. El enfoque general se describe en qué es realmente la extracción de documentos con IA si esta es tu primera vez con este tema.
Varias capacidades se alinean con los problemas de matrices que describió la última sección:
- columna calculada permite que la IA calcule un valor durante la extracción en lugar de solo copiar uno. Para un listado de eventos adversos, esto cubre un recuento de eventos por sujeto y verificaciones condicionales, como marcar una fila cuando un subtotal no coincide con un total declarado. El cálculo se escribe en el nombre de la columna o en una regla, por lo que se ejecuta en cada documento del lote de la misma manera.
- columna inferida permite que la IA asigne un valor que el documento no imprime, derivado de lo que sí imprime. Esto es útil para una categoría como el estado de seguimiento, donde el modelo lee si un evento se describe como en curso. No es un sustituto del juicio médico, y las columnas que requieren adjudicación no deben construirse de esta manera.
- fusión de varias páginas pliega un documento que abarca varias páginas de nuevo en una sola fila. Un listado de eventos adversos continuado en varias páginas impresas, o los registros de un sujeto distribuidos en hojas escaneadas por separado, pueden agruparse por un valor compartido como el identificador del sujeto, completándose los campos desde la página que los contenga. Esta es la misma configuración que ayuda con los PDF de varias páginas en general.
- Procesamiento por lotes lee muchos archivos a la vez y fusiona los resultados en una sola tabla, por lo que una carpeta de páginas de CRF o un conjunto de listados de CSR se convierte en una sola hoja en lugar de una pila de exportaciones de un solo documento. El patrón es el mismo que se usa para la extracción de datos clínicos por lotes de otros registros de ensayos.
- nivel de modelo importa cuando la fuente es un formulario escaneado con entradas manuscritas. Los formularios de eventos adversos completados a mano son un caso difícil conocido, y un nivel de procesamiento superior utiliza un modelo más fuerte para escritura densa y diseño complejo.
- Modo de revisión con verificación de cuadro delimitador es la parte que hace utilizable una tabla de seguridad extraída. Al pasar el cursor sobre una celda se resalta exactamente de dónde proviene ese valor en el documento original, y al hacer clic en una región se salta a la celda correspondiente. Para los campos que importan, esto convierte "confiar en la extracción" en "verificación puntual de la extracción" en segundos, en lugar de volver a leer todo el listado.
Los archivos se procesan de forma segura y no se almacenan.
El mismo patrón de extracción se aplica siempre que un documento de ensayo repite una estructura por sujeto. Una tabla de panel por visita, un informe de laboratorio clínico y un listado de eventos adversos son contenidos distintos con el mismo problema subyacente: la unidad que le interesa se repite, y la herramienta debe preservar esa repetición en lugar de aplanarla.
Lo que este tipo de extracción no puede hacer
Ser claro sobre el límite es más útil que vender de más la herramienta, especialmente en un campo regulado donde una afirmación en una publicación de blog no es lo mismo que un sistema validado.
No codifica eventos adversos. La selección de términos en MedDRA, el diccionario médico que asigna un término notificado a un término preferido dentro de un sistema corporal, es un paso de codificación independiente regido por su propio manual. El diccionario y su jerarquía son mantenidos por la Organización de Servicios de Soporte y Mantenimiento de MedDRA. La extracción puede leer un término codificado que ya está impreso, pero no asigna uno.
No adjudica la seguridad. Las decisiones de causalidad, seriedad y expectabilidad corresponden a una persona cualificada. Una columna inferida es una lectura de lo que dice el documento, no una evaluación médica.
No realiza anonimización. Los identificadores de sujeto en un documento de ensayo permanecen en el resultado. Si el archivo va a algún lugar sin un acuerdo de datos, gestionar eso es un paso aparte y deliberado.
No es un sistema validado ni certificado para auditoría. Los registros electrónicos regulados conllevan requisitos como una pista de auditoría para cada cambio y una validación documentada del sistema, establecidos en ICH E6(R3) y 21 CFR Part 11. Esta herramienta no tiene dicha certificación, por lo que pertenece aguas arriba del sistema de registro, como un primer paso que un humano revisa, no como la base de datos de registro. Los sistemas que albergan datos de ensayos validados a gran escala son las plataformas de captura electrónica de datos como Medidata Rave, Veeva Vault EDC y Oracle Clinical One, junto con opciones más ligeras como Castor y REDCap. La comparación aquí no es contra esas plataformas. Es contra una persona que lee un listado y lo vuelve a escribir.
Lo que queda, una vez establecidos esos límites, sigue siendo la mayor parte del trabajo: extraer los valores repetidos de los documentos y llevarlos a una tabla que una persona pueda revisar, en lugar de escribirlos uno a uno. Esa brecha es la misma que deja a los coordinadores gestionando acumulaciones de consultas y a los gestores de datos con datos clínicos que ya son digitales y aun así se ingresan manualmente.
Preguntas frecuentes
¿Puede la IA extraer tablas de eventos adversos de un CRF o CSR? Sí, siempre que definas a qué tabla te refieres. Un CSR puede contener los mismos eventos en una tabla resumen, un listado por sujeto y una narrativa, así que nombra las columnas de la forma específica que deseas, como ID del Sujeto, Término del Evento, Fecha de Inicio y Gravedad. La extracción lee los valores; no decide por ti de cuál de las tres presentaciones extraer.
¿La extracción reemplaza la codificación de eventos adversos en MedDRA? No. Codificar un término informado a un término preferido y a una clase de sistema corporal es un paso separado con sus propias convenciones y requiere supervisión humana. La extracción puede llevar un término codificado fuera de un documento que ya lo contenga, pero no realiza la codificación.
¿Cómo mantengo cada evento adverso vinculado al sujeto correcto? Extrae el identificador del sujeto como su propia columna y deja que se repita en cada fila de evento. En formato largo, el identificador es lo que une las filas repetidas con un solo participante. Si los registros de un sujeto llegan en páginas escaneadas por separado, usa la fusión de varias páginas agrupada por ese identificador para que las piezas se unan en un solo registro antes de que los eventos se desplieguen.
¿Es adecuado para una presentación regulada? Úsalo como un primer paso revisable, no como el sistema de registro. No es una plataforma validada ni certificada para auditorías y no hace ninguna afirmación de certificación ICH-GCP o 21 CFR Part 11, y no realiza anonimización ni adjudicación. La base de datos de registro validada sigue siendo tu sistema de captura electrónica de datos.
La forma del documento debe determinar la forma de la hoja
La razón por la que la extracción de documentos de ensayos clínicos es más difícil que la extracción de facturas es estructural, no técnica. Las facturas llegan una por fila. Los documentos de ensayos llegan como matrices: un sujeto en varias visitas, un sujeto con varios eventos adversos, un evento con varios registros relacionados. Una vez que se nombra la granularidad de la salida que realmente necesitas, definir las columnas se convierte en una decisión sencilla, y el trabajo que queda es la revisión, que es exactamente donde una persona cualificada debería dedicar tiempo de todos modos.
Comienza con un listado de eventos adversos o un documento de panel de visita, define las columnas que deseas y observa cómo vuelve la tabla antes de comprometer un lote completo.