30枚のタイムシートを1つの収益ビューに
月末請求の混乱を終わらせる
「時間が記録された」と「時間が請求された」の間には、経理担当者が毎月手作業でつなぎ合わせるスプレッドシートがあります。そのスプレッドシートが30枚のコンサルタントのタイムシート — PDF、スキャンした紙のフォーム、Excelファイルで、それぞれ同じクライアントを3通りの方法で記載している — を吸収しなければならない場合、つなぎ合わせる作業自体が請求業務よりも時間がかかります。Unit4とPierre Audoin Consultantsによるプロフェッショナルサービス企業500社を対象とした2026年の調査では、47%の企業が定期的にタイムシートの修正に時間を費やしていることが判明しました — 時間の記録ではなく、すでに記録されたものの修正です。この記事は、それら30のファイルと、請求業務が依存する1つのダッシュボードとの間のギャップを埋めることについてです。
重要なポイント
- 月末請求は、30枚のコンサルタントのタイムシートを手作業でつなぎ合わせたスプレッドシートに依存しており、そのつなぎ合わせ自体が請求業務よりも時間がかかります。
- 本当の損失は入力に費やす時間ではなく、30人の異なるコンサルタントからの200の明細項目にわたって、手作業によるクリーンアップでは確実に捕捉できない正規化エラーです。
- 30のファイルすべてを1つのバッチとして処理すると、出力はピボット対応のダッシュボードとして届きます — クライアント名はすでに標準化され、収益は行ごとにすでに計算されています。
「時間を記録するだけ」では解決しない問題
SPI Researchの2026年プロフェッショナルサービス成熟度ベンチマーク(509社、PS売上630億ドルを対象)によると、2025年の課金稼働率は66.4%で、調査開始19年で最低、健全基準の70%を3.6ポイント下回りました。この数字は今年発表されたほぼすべてのPS運用記事で引用されており、当然ながら業界の警告サインです。
しかし、典型的な「稼働率向上」記事の処方箋は決まって「より優れたタイムトラッキングソフト」です。リアルタイムタイマー、カレンダー連携、自動リマインダー。これらはすべて時間の記録、つまりコンサルタントが0.1時間単位をその場で入力することを確実にするものです。当社のタイムシートデータ抽出と請求照合のガイドでは、記録ギャップ、転記ギャップ、照合ギャップという漏洩パイプライン全体を解説し、AIベースの抽出が第2段階をどう解決するかを示しました。
しかし、多くのガイドが見落としている転記のさらに下の層があります。それは大量処理に直面したときだけ表面化する問題、バッチ処理の問題です。1枚のタイムシート抽出は簡単です。しかし、30人のコンサルタントから、それぞれ微妙に異なるフォーマット、異なる顧客略称、異なる料金体系で提出された30枚のタイムシートを抽出し、その結果を顧客、プロジェクト、コンサルタント別にソートされた1つの売上ダッシュボードにする——これはまったく別の作業です。
1枚のタイムシート処理と30枚の処理の違いは、単なる30倍の労力ではありません。質的な転換です。単一ファイルの抽出はデータ入力の速度の問題ですが、バッチ抽出はデータの正規化——手動でのクリーンアップ作業なしに、一貫性のない入力を統一された出力構造に調整すること——が本質です。
バッチ処理の隠れた3つのコスト:単一ファイルのガイドが決して触れない点
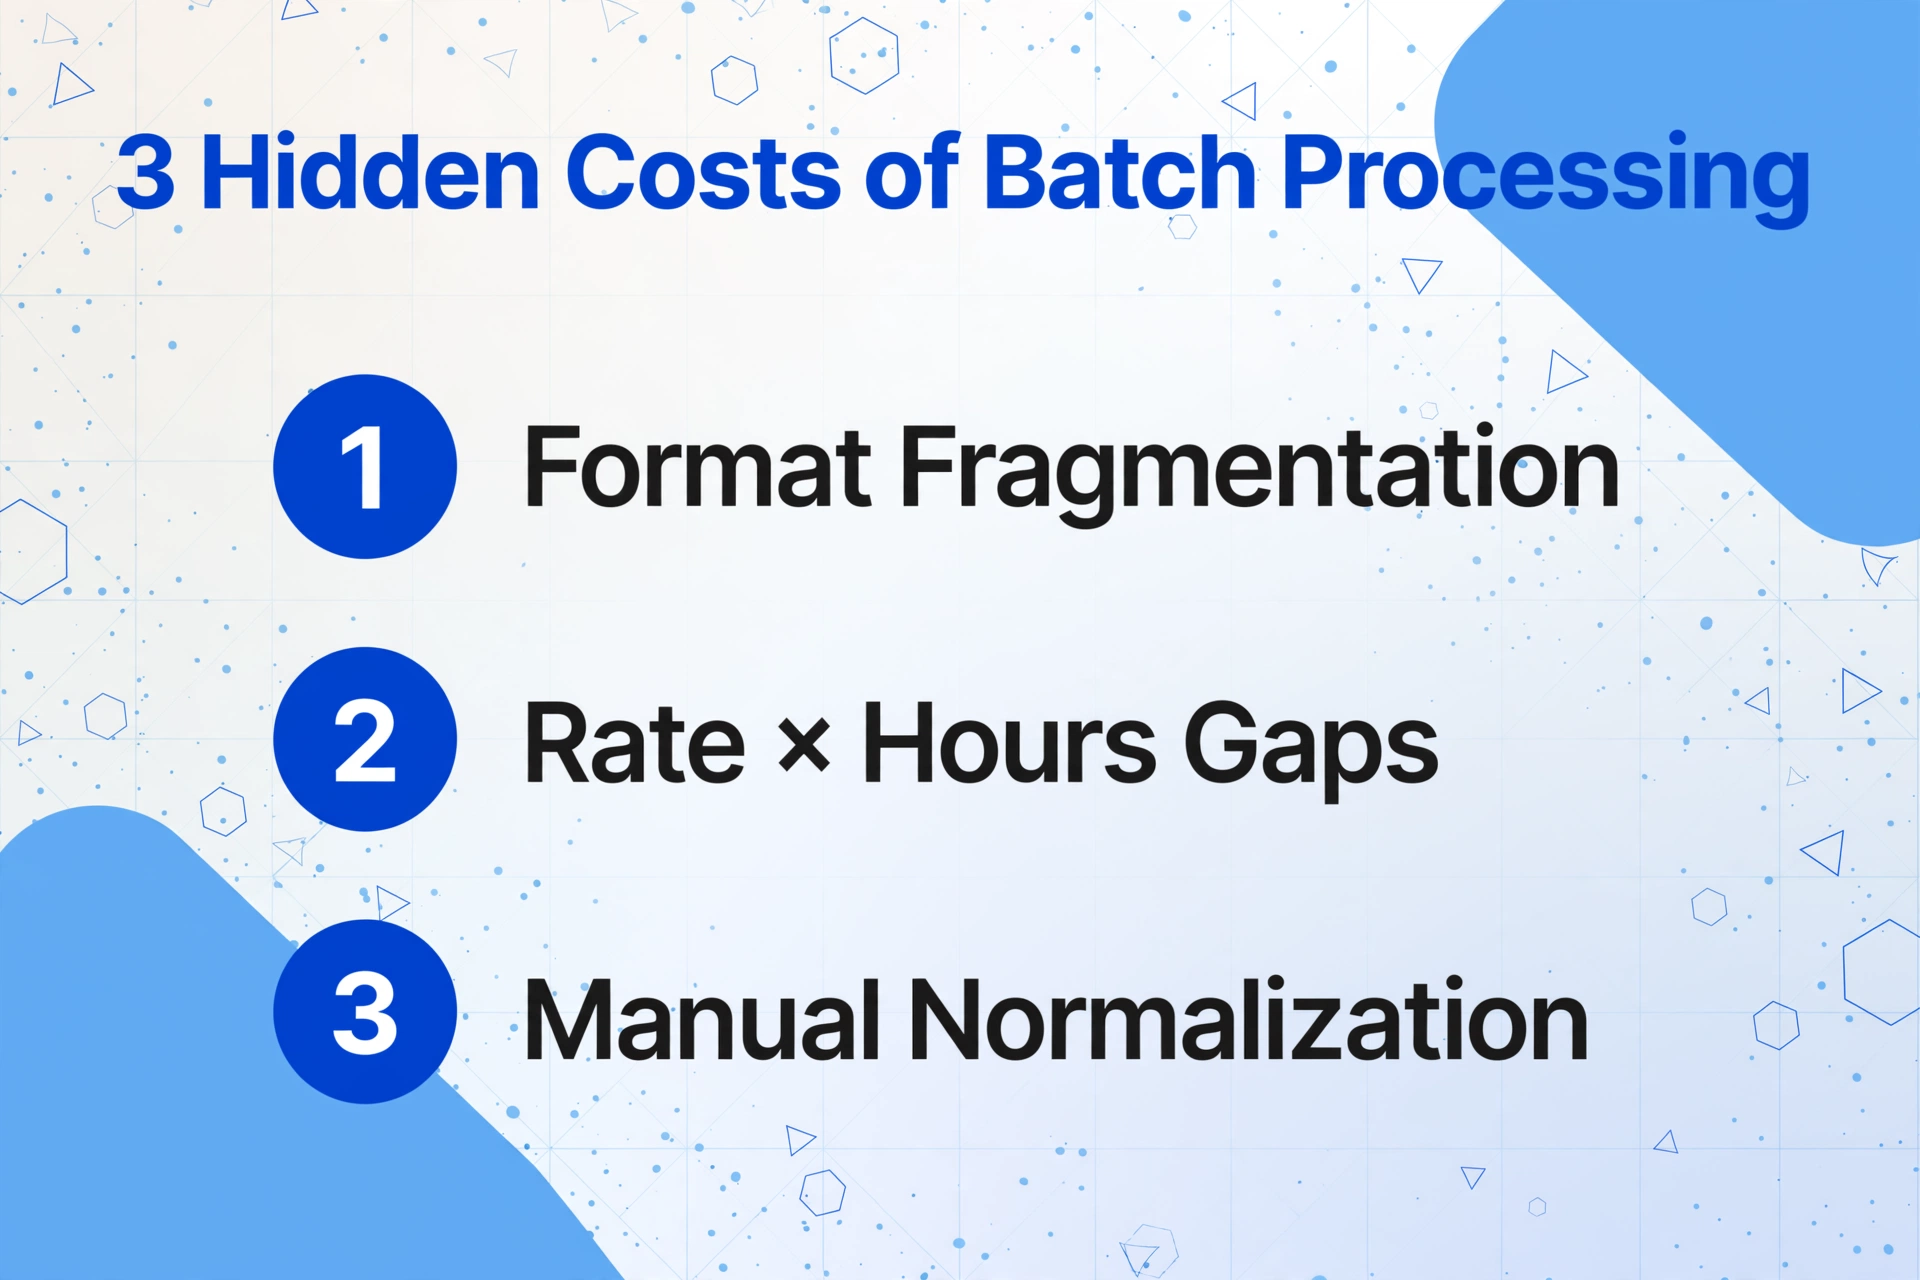
タイムシートを1件ずつ処理する場合、それは転記の問題を解決していることになります。しかし、30件をバッチ処理する場合、単一ファイルの世界には存在しない3つの問題を解決していることになるのです:
1. フォーマットの断片化と命名の不整合
コンサルタントAは会社標準のPDFタイムシートを使用します。コンサルタントBはクライアント先で手書きしたフォームの写真をメールで送ります。コンサルタントCは2022年から使い続けている個人用のExcelテンプレートを開きます。コンサルタントDはフォームを印刷し、手書きで記入し、スキャンします——しかも上下逆さまに。さらに、各コンサルタントは同じクライアントを異なる名前で呼びます:「Acme Corp - Phase 2」「AC2 - Strategy」「Acme Corp (Phase II)」のように。
これらを1件ずつ処理する場合、請求コーディネーターは入力しながら頭の中で各エントリを正規化します——「ああ、これはAcme CorpのPhase 2だ」——そして正しいコードを入力します。しかし、30件になると、頭の中での正規化は破綻します。12件目のタイムシートに達する頃には、コーディネーターは確認をやめ、文字をそのまま転記しているだけになります。その結果、同じクライアントが出力に3つの異なる名前で登場し、「Acme Corp — $47,250請求済み」と表示されるべきピボットテーブルが、同じ金額の合計を3つの別々の行として表示することになります——コーディネーターが後で気づいて手動で統合しない限りは。
これは時間追跡の問題ではありません。バッチ規模になって初めて顕在化するデータ正規化の問題です。
2. レート×時間の不一致が大量に発生するケース
レートが1つのタイムシートは検証が簡単です。7.5時間×275ドル/時間=2,062.50ドル。しかし、コンサルティング会社には通常複数のレートがあります。クライアントごとに異なるレートを交渉し、シニアコンサルタントはジュニアアソシエイトより高いレートで請求し、一部のプロジェクトはブレンドレート、他のプロジェクトは役職別請求です。30人のコンサルタントのバッチには、8種類の実効レートにわたる200以上の明細行が含まれる可能性があります。
この規模での手動検証は確率的になります。請求コーディネーターは数件をスポットチェックできますが、200行すべてをレート監査し、それぞれを契約書と照合するには数時間かかります。これらの見逃したエラーのコストは具体的です。50人の会社が200ドル/時間で請求する場合、タイムトラッキングの漏れにより年間推定78万ドルから130万ドルを失います。一部は記録ギャップ(ログされなかった時間)にあり、別の一部はここ、転記ギャップ(ログされたが誤って価格設定された時間)にあります。
3. 欠落エントリと「木曜日を忘れたのは誰?」探し
1ヶ月分の30枚のタイムシートのバッチには、必ずギャップがあります。コンサルタントが14日に病気で休み、その日を空白にした—意図的です。別のコンサルタントは19日に丸一日働いたが、行を記入し忘れた—意図的ではありません。請求コーディネーターの机から見ると、両方は同じに見えます。データの海の中の1つの欠落行です。
単一ファイル処理では、一度に一人の1ヶ月分全体を見るため、これらのギャップが見えます。バッチ処理では、30枚の結合されたタイムシートを見つめることになり、ギャップが隠れます。月全体の列の完全性をスキャンしており、コンサルタントごとのカバレッジではありません。ギャップは、クライアントが請求書に疑問を呈し、誰かが元のファイルを掘り返したときにのみ表面化します。
タイムトラッキング精度に関するWorkPulsのデータはこれを裏付けています。紙のタイムシートシステムを使用する企業の80%が、受け取ったタイムシートの80%を修正する必要があると報告しました。それらの修正を30人のコンサルタントのバッチに掛け合わせると、タイムシートを処理しているのではなく、並行した品質保証業務を実行していることになります。
タイムシートの山から収益ダッシュボードへ:バッチ処理のワークフロー
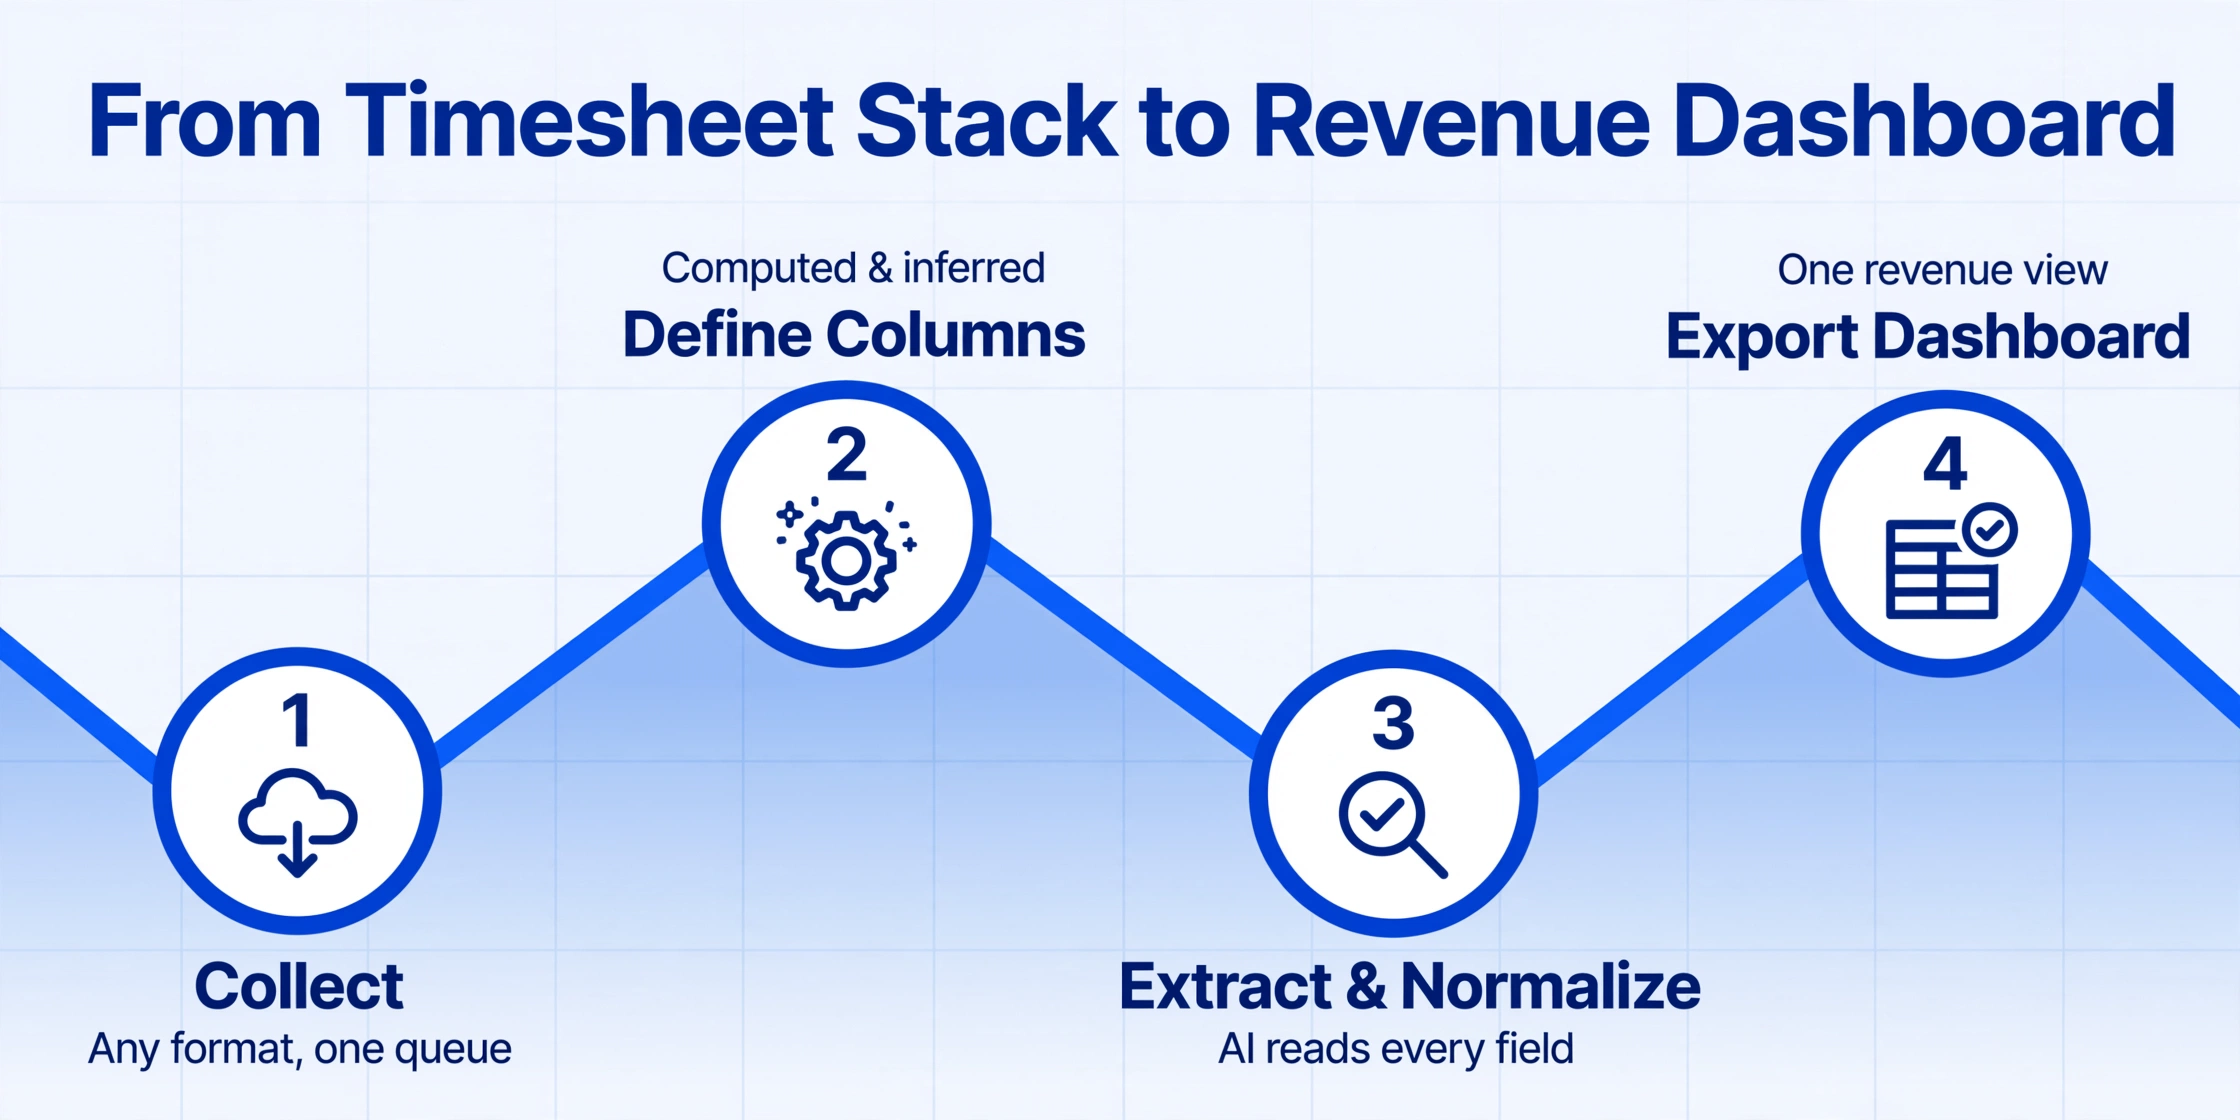
ここで抽出ツールの設計が重要になります。単一ドキュメント処理向けに作られたツールは、バッチ処理を後付けとして扱います。1つのファイルを処理し、結果をダウンロードし、次のファイルを処理するという流れです。バッチファースト処理ツール — 最初から複数ファイルを受け入れ、結果を単一の出力に統合するように設計されたツール — は、上記の3つの課題を処理ステップ自体の中で解決し、後で請求コーディネーターがExcelで解決する手間を省きます。
以下が、30枚のコンサルタントのタイムシートから1つのクライアント収益ダッシュボードを作成するワークフローです。各ステップは、3つのバッチコストのうち1つを解消するように設計されています。
タイムシートを一箇所に集約 — 形式は問いません。
すべてのコンサルタントからPDF、JPG、PNG、スキャン画像を収集します。事前に形式を統一する必要はありません。収集を自動化したい企業向けに、コレクションリンク — 各コンサルタントがタイムシートを直接処理キューにアップロードできる共有ページで、提出者のログインは不要です — により、「30人にファイルを催促する」手間が完全に不要になります。
ダッシュボードの列を定義 — 計算列も含めて。
抽出したいフィールド名を入力します: Client Name、Project Code、Consultant Name、Date、Hours、Rate。計算列を追加 — 例: Revenue (Hours × Rate) — すると、AIが抽出時に全行の請求可能金額を自動計算します。推論列を追加 — 例: Standardized Client (infer from Client Name) — すると、名前の表記ゆれを正規化できます。これらの列がダッシュボードの元データになります。
30ファイルすべてを一括アップロードして処理。
すべてのタイムシートファイルを選択し、1つのバッチとして処理します。AIはセマンティック抽出を使用して各文書を読み取ります — 「Acme Corp」という行の「Hours」の横にある「7.25」が、そのクライアントの請求可能時間7.25時間を意味すると、ページ上のフィールドの位置に関係なく理解します。30ファイルすべてが1つのExcelテーブルに統合され、計算列が行ごとの収益を計算し、推論列がクライアント名を標準化します。これが質的な転換です: 30回の個別転記作業が、約5分で1つの構造化データセットになります。
収益ダッシュボードにピボット。
統合されたExcelテーブルを使用してピボットテーブルを作成します: 行にStandardized ClientとProject Code、値にHoursの合計とRevenueの合計、フィルターにConsultant Nameを設定します。1分以内に、生のタイムシート行から以下が得られます: クライアントごとの総時間、プロジェクトごとの総収益、コンサルタントごとの稼働率(請求可能時間 ÷ 利用可能時間)、請求済み収益と予想収益の簡単な比較。手動での数式作成は不要です。ダッシュボードは抽出結果のピボットであり、ゼロから構築する別のレポートではありません。
ファイルは安全に処理され、保存されません。
手動クリーンアップなしでコンサルタントの命名規則を統一する
命名の不整合問題 —「Acme Corp - Phase 2」と「AC2 - Strategy」と「Acme Corp (Phase II)」— は、タイムシート処理における最もバッチ特有の課題です。単一ファイルの抽出では、一度に1人のコンサルタントのエントリを確認するためこの問題は発生せず、命名のばらつきが問題になるのはエントリを結合するときだけです。
この問題への従来のアプローチはすべて手動です。ルックアップテーブルを維持して全セルにVLOOKUPを適用する、半数が無視する「命名標準化ポリシー」メールを送る、または(最も一般的な方法として)ピボットに3つの別々の行を許容し、毎月のバッチ実行後に手動で統合する、という方法です。
推論列の抽出は、処理ステップ内でこれを解決します。標準化クライアント(クライアント名フィールドから推論 — オプション: Acme Corp、Beta Industries、Gamma Consulting、その他)のような列を定義します。AIは各コンサルタントの「クライアント名」エントリを読み取り、どのように書かれていても、定義した標準化名にマッピングし、正規化されたバージョンを別の列に出力します。これはルックアップテーブルとは異なります。AIが意味的類似性を理解するため、「AC2」と「Acme Corp Phase 2」が同じエンティティであると、すべてのバリエーションを定義しなくても認識されるからです。
下流の利点は即時的です。ピボットテーブルは標準化クライアント列でグループ化され、クライアントごとに1行表示されます — 必要な収益ダッシュボードが、毎回の請求実行前の45分間の手動クリーンアップなしで得られます。
ダッシュボードが生のタイムシートでは見えないことを教えてくれる理由
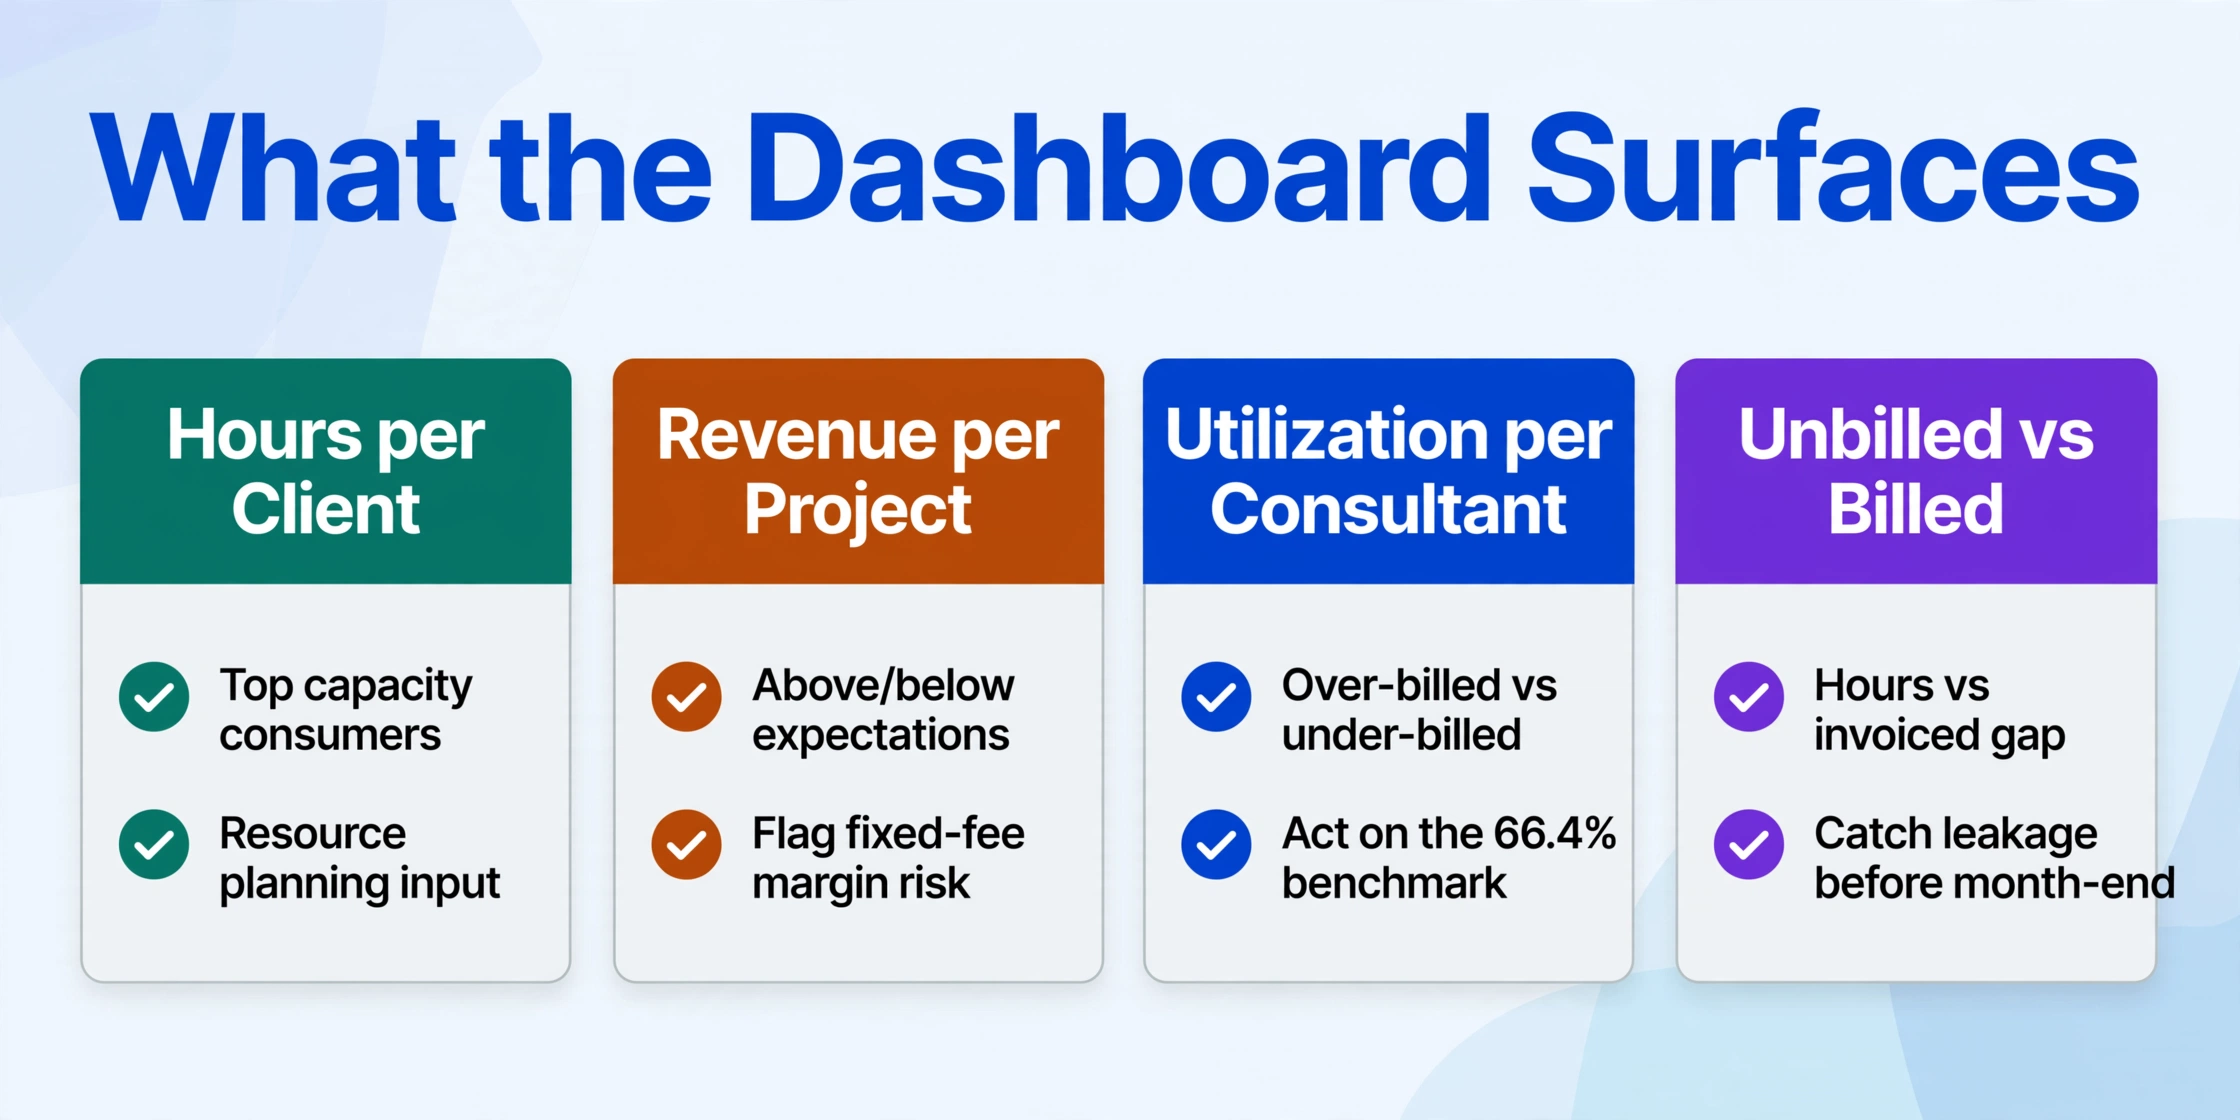
30枚のタイムシートが1つのテーブルに統合・正規化されると、ピボットテーブルは生のタイムシートでは得られない視点を提供します。データをクライアント、プロジェクト、コンサルタント別に整理すると、以下のような洞察が浮かび上がります。
| ダッシュボード表示 | ピボット設定 | 明らかになること |
|---|---|---|
| クライアント別時間 | 行: 標準化クライアント | 値: 時間の合計 | どのクライアントが最も多くの請求可能なキャパシティを消費しているか — リソース計画と更新価格設定に重要 |
| プロジェクト別収益 | 行: 標準化クライアント、プロジェクトコード | 値: 収益の合計 | どのプロジェクトが期待を上回るまたは下回る収益を生み出しているか。実際の時間が利益率を圧迫している固定費プロジェクトを特定 |
| コンサルタント別稼働率 | 行: コンサルタント名 | 値: 時間の合計 ÷ 利用可能時間 | 過剰請求(燃え尽きリスク)と過少請求(収益ギャップ)の担当者を特定。SPIの業界稼働率66.4%が、行動に移せるコンサルタント別指標になります |
| 未請求 vs 請求済みの比較 | 収益の合計 vs 予想されるクライアント請求書合計 | 作業時間と請求時間のギャップ — 15〜25%の漏れ統計の背後にある指標。クライアントが請求書に疑問を呈する前、月末前にギャップを把握しましょう |
これは毎月ゼロから構築するダッシュボードではありません。抽出出力のピボットテーブルです — 抽出されたすべての行を含む同じExcelファイルです。ピボットを一度設定すれば、毎月のバッチ処理で新しいデータが自動的に更新されます。SPIリサーチのベンチマーク目標である稼働率75%は、抽象的な業界数値ではなくなり、追跡・議論・改善できるコンサルタント別の指標になります。
稼働率は収益性の指標であるだけでなく、収益漏れの先行指標です。企業の平均稼働率が70%を下回ると、利用可能時間と請求可能時間のギャップが利益率を圧迫し始めますが、ほとんどの企業は四半期レビューまでそれに気づきません。コンサルタント別の稼働率を示す月次ダッシュボードは、四半期が終わる前にフィードバックループを閉じます。
ダッシュボードと請求サイクルの連携
抽出結果はExcelテーブルです。請求ステップとは、そのテーブルに基づいてクライアントに請求書を発行することです。ほとんどのプロフェッショナルサービス向け請求プラットフォームは、タイムエントリのCSVインポートに対応しています。つまり、「ダッシュボードに収益が表示される」から「クライアントに請求書が送信される」までのギャップは、再入力ではなくインポートステップです。
| プラットフォーム | CSVインポートパス | 標準インポート時間(200エントリ) |
|---|---|---|
| QuickBooks Online | CSVインポート:歯車→データのインポート→時間のアクティビティ | 2分未満 |
| Clio | CSVによる一括タイムエントリインポート(案件、アクティビティ、時間、レートにマッピング) | 3分未満 |
| Harvest | CSVインポート(クライアント、プロジェクト、タスク、時間、日付フィールド) | 2分未満 |
| BQE Core | CSVによるタイムエントリインポート(プロジェクト、フェーズ、従業員、時間にマッピング) | 3分未満 |
| BigTime | CSVおよびQuickBooks連携インポート(スタッフ、プロジェクト、日付、時間、レートに対応) | 2分未満 |
ワークフローは、抽出→ダッシュボードへのピボット→CSVエクスポート→請求プラットフォームへのインポートです。ダッシュボードステップは照合記録として機能します。請求書を送信する前に、請求対象と実際の作業内容が一致しているかを確認する場です。このステップを省略して直接インポートする企業は、検証なしで抽出精度に賭けていることになり、抽出ツールを導入しても15%の漏れが続く原因となります。
さらに深いニーズがある企業向けに(複数通貨請求、政府契約向けDCAA準拠、法律事務所向けLEDES形式など)、抽出から照合までの完全ガイドで詳細を解説しています。現在の市場を比較検討されている方には、2026年版タイムシート抽出ツール総まとめで、価格、精度、ワークフロー適合性を紹介しています。現場のコンサルタントから紙のタイムシートが届く場合は、紙の作業票から請求可能金額へで、紙からデジタルへの移行を具体的に解説しています。また、月末タイムシート処理と給与計算の締めでは、月次サイクルの給与計算側に同じアプローチを拡張しています。
よくある質問
1回のバッチで処理できるタイムシートの数に制限はありますか?
特に上限はありません。バッチ処理では、1回のアップロードで任意の数のファイルを受け付けます。処理時間はおおよそページ数に比例します。実用的な目安として、30枚の1ページタイムシートは、アップロードからマージされたExcel出力まで約5分で処理されます。1ページあたり5~10秒で処理され、構造化フォームの手動入力(平均3分/ページ)と比較して約18倍高速です。
コンサルタントがまったく異なるタイムシート形式を使用している場合はどうなりますか?
形式の多様性こそ、バッチ処理が解決する中心的な課題です。AI抽出は、ページ上の位置ではなく、意味的な意味に基づいてデータを識別します。「時間」の横にある「7.25」が、PDFの右上隅、Excelシートの3列目、スキャンされたフォームの走り書きの日付の横のいずれにあっても、それが請求可能時間を指すことを理解します。AIは各形式を個別に読み取り、すべての結果を同じ構造化出力に正規化します。意味的抽出がテンプレートベースのOCRとどのように異なるかについては、タイムシート抽出の完全ガイドをご覧ください。
同じコンサルタントがクライアントごとに異なる請求レートを使用する場合、AIは対応できますか?
はい、2つの方法があります。タイムシートにレート列が含まれている場合、AIは行ごとにそれを抽出するため、エントリごとに異なるレートが自動的に処理されます。タイムシート自体にレートがない場合は、計算列を使用してレートロジックを埋め込みます。固定レートのシナリオでは、標準レートとして売上を定義するか、クライアントごとに別々の列を使用します。複数レートの契約では、ルール形式(ログインユーザー向け)を使用して条件付きレートロジックを定義できます。例えば、各タイムシートから抽出されたコンサルタント名に基づいて、シニアコンサルタントには$350/時間、ジュニアアソシエイトには$200/時間を適用する、といったことが可能です。
コンサルタントが1日分の記入を忘れた場合、AIはそれを検知できますか?
AIはあくまで書類に記載された内容を抽出するもので、欠落を補完することはありません。ただし、ダッシュボード上で、個別のタイムシートレビューでは見逃しがちなギャップが浮き彫りになります。統合された出力をコンサルタント名と日付でピボットすると、月間の予定日数に満たないコンサルタントが即座に判明します。これは30件のファイルを個別に確認するだけでは気づきにくい点です。つまり、抽出工程ではなく、ダッシュボードが検知の仕組みとして機能します。
印刷されたタイムシートと手書きのタイムシートを同じアップロードで一括処理できますか?
はい。AIは同一バッチ内で印刷文字、手書き文字、およびそれらが混在した文書を読み取ります。精度は印刷文字の方が高いですが、構造化された帳票(フィールドにラベルがあり、所定の領域に記入する形式)における一般的な手書き文字は、確実に抽出できます。建設現場から提出される手書きの作業報告書など、判読性が重要なケースでは、フィールドが明確にラベル付けされた構造化テンプレートを使用することで、抽出の一貫性が向上します。
Excelではなく、請求ソフトウェアに直接エクスポートできますか?
標準出力はExcelとCSVです。QuickBooks、Clio、Harvest、BQE Core、BigTimeといった主要な請求プラットフォームはすべて、タイムエントリのCSVインポートに対応しているため、Excelを介さずにCSVとしてエクスポートし、直接インポートすることが可能です。ただし、多くの企業はExcelファイルを照合用レコードとして保持することを好みます。これは、請求に関する紛争やコンプライアンス要件をサポートする、原本のタイムシート→抽出データ→請求書という3方向の監査証跡を提供するためです。
SPI Researchによると、業界平均の請求可能利用率は66.4% — 過去最低を記録しました。転記と照合のギャップから回復した1パーセントポイントごとに、その数値は75%のしきい値に近づきます。次の月次タイムシート処理でバッチ抽出をテストして、その違いを確認してください。
タイムシートをバッチ処理