30 Stundenzettel, eine Umsatzübersicht
Beenden Sie das Abrechnungschaos am Monatsende
Zwischen „Zeit erfasst" und „Zeit abgerechnet" liegt eine Tabelle, die jemand in der Buchhaltung jeden Monat manuell zusammenfügt. Wenn diese Tabelle 30 Berater-Stundenzettel aufnehmen muss – PDFs, gescannte Papierformulare und Excel-Dateien, die denselben Kunden auf drei verschiedene Arten benennen – dauert das Zusammenfügen länger als die Abrechnung selbst. Eine Umfrage von 2026 unter 500 Professional-Services-Unternehmen von Unit4 und Pierre Audoin Consultants ergab, dass 47 % der Unternehmen regelmäßig Stunden mit der Korrektur von Stundenzetteln verbringen – nicht mit der Zeiterfassung, sondern mit der Behebung bereits erfasster Daten. Dieser Artikel zeigt, wie Sie die Lücke zwischen diesen 30 Dateien und dem einen Dashboard schließen, von dem Ihr Abrechnungslauf abhängt.
Die wichtigsten Erkenntnisse
- Die Abrechnung am Monatsende basiert auf einer manuell zusammengefügten Tabelle aus 30 Berater-Stundenzetteln – und das Zusammenfügen dauert länger als die Abrechnung selbst.
- Der eigentliche Verlust sind nicht die Stunden, die mit Abtippen verbracht werden – es sind die Normalisierungsfehler, die keine manuelle Bereinigung zuverlässig über 200 Positionen von 30 verschiedenen Beratern hinweg erfasst.
- Verarbeiten Sie alle 30 Dateien als einen Batch und das Ergebnis ist ein pivot-fähiges Dashboard – Kundennamen bereits standardisiert, Umsatz bereits pro Zeile berechnet.
Wenn „Zeit einfach tracken“ nicht das Problem ist
Die 2026 Professional Services Maturity Benchmark von SPI Research – basierend auf 509 Firmen mit 63 Milliarden US-Dollar PS-Umsatz – verzeichnete 2025 eine abrechenbare Auslastung von 66,4 %, den niedrigsten Wert in der 19-jährigen Geschichte der Studie und 3,6 Prozentpunkte unter der gesunden Mindestschwelle von 70 %. Diese Zahl taucht in fast jedem PS-Operations-Artikel dieses Jahres auf – und das zu Recht: Sie ist ein Warnsignal auf dem Armaturenbrett der Branche.
Doch wer einen typischen „So verbessern Sie die Auslastung“-Artikel aufschlägt, findet die gleiche Lösung: bessere Zeiterfassungssoftware. Echtzeit-Timer. Kalenderintegration. Automatische Erinnerungen. All das betrifft die Erfassung von Zeit – also sicherzustellen, dass Berater jede 0,1-Stunden-Einheit sofort protokollieren. In unserem Leitfaden zum Extrahieren von Stundenzetteldaten für die Abrechnungskonsolidierung haben wir die gesamte Leckage-Pipeline durchgespielt – Erfassungslücke, Transkriptionslücke, Abgleichlücke – und gezeigt, wie KI-basierte Extraktion die zweite Stufe schließt.
Doch unter der Transkription liegt eine Ebene, die die meisten Leitfäden auslassen, weil sie erst bei hohem Volumen sichtbar wird: das Batch-Processing-Problem. Einen einzelnen Stundenzettel zu extrahieren ist einfach. 30 Stundenzettel von 30 verschiedenen Beratern zu extrahieren, jeder mit einem leicht anderen Format, anderen Kundenabkürzungen und anderen Stundensätzen – und das Ergebnis als ein einziges Umsatz-Dashboard sortiert nach Kunde, Projekt und Berater zu benötigen – das ist eine völlig andere Operation.
Der Unterschied zwischen der Verarbeitung eines Stundenzettels und der Verarbeitung von dreißig ist nicht der 30-fache Aufwand. Es ist ein qualitativer Sprung: Bei der Einzeldatei-Extraktion geht es um Dateneingabegeschwindigkeit. Bei der Batch-Extraktion geht es um Datennormalisierung – das Abgleichen inkonsistenter Eingaben in eine einheitliche Ausgabestruktur ohne manuellen Bereinigungsschritt.
Die drei versteckten Kosten der Batch-Verarbeitung, die Einzeldatei-Anleitungen nie erwähnen
Wenn Sie Stundenzettel einzeln verarbeiten, lösen Sie ein Transkriptionsproblem. Wenn Sie sie in Batches von 30 verarbeiten, lösen Sie drei Probleme, die es in der Einzeldatei-Welt nicht gibt:
1. Formataufsplitterung und Namensinkonsistenz
Berater A verwendet den Standard-PDF-Stundenzettel der Firma. Berater B sendet per E-Mail ein Foto eines handschriftlichen Formulars vom Kundengelände. Berater C öffnet eine persönliche Excel-Vorlage, die er seit 2022 nutzt. Berater D hat das Formular ausgedruckt, handschriftlich ausgefüllt und eingescannt – verkehrt herum. Jeder Berater benennt denselben Kunden auch anders: „Acme Corp – Phase 2", „AC2 – Strategie", „Acme Corp (Phase II)".
Wenn Sie diese einzeln verarbeiten, normalisiert der Abrechnungskoordinator jeden Eintrag beim Tippen gedanklich – „ach, das ist Acme Corp Phase 2" – und gibt den richtigen Code ein. Aber bei 30 Dateien bricht die gedankliche Normalisierung zusammen. Beim 12. Stundenzettel prüft der Koordinator nicht mehr; er transkribiert Zeichen für Zeichen. Das Ergebnis: Derselbe Kunde erscheint unter drei verschiedenen Namen in der Ausgabe, und die Pivot-Tabelle, die „Acme Corp – 47.250 $ abgerechnet" zeigen sollte, zeigt stattdessen drei separate Zeilen mit demselben Gesamtbetrag – falls der Koordinator es bemerkt und später manuell konsolidiert.
Das ist kein Zeiterfassungsproblem. Es ist ein Datennormalisierungsproblem, das erst im Batch-Maßstab auftritt.
2. Abweichungen bei Stundensatz × Stunden in großer Stückzahl
Ein einzelner Stundenzettel mit einem Stundensatz ist leicht zu prüfen: 7,5 Stunden × 275 $/Stunde = 2.062,50 $. Aber eine Beratungsfirma hat in der Regel mehrere Stundensätze: Verschiedene Kunden handeln unterschiedliche Sätze aus, leitende Berater stellen höhere Sätze in Rechnung als Juniormitarbeiter, und einige Projekte haben Mischsätze, während andere nach Rolle abrechnen. Eine Charge mit 30 Beratern kann über 200 Zeileneinträge mit 8 verschiedenen effektiven Stundensätzen enthalten.
Manuelle Prüfung in diesem Umfang wird zur Wahrscheinlichkeitsrechnung. Ein Abrechnungskoordinator kann einige Einträge stichprobenartig prüfen, aber eine vollständige Satzprüfung über 200 Zeilen – jede gegen das Mandatsschreiben – würde Stunden dauern. Die Kosten dieser übersehenen Fehler sind konkret: Eine Firma mit 50 Mitarbeitern, die 200 $/Stunde abrechnet, verliert schätzungsweise 780.000 bis 1,3 Millionen $ pro Jahr durch Zeitverlust bei der Zeiterfassung. Ein Teil liegt in der Erfassungslücke (nie protokollierte Stunden); ein anderer Teil liegt hier, in der Übertragungslücke (protokollierte, aber falsch bepreiste Stunden).
3. Fehlende Einträge und die Jagd nach dem „Wer hat Donnerstag vergessen?“
In einer Charge von 30 Stundenzetteln für einen Monat gibt es Lücken. Ein Berater war am 14. krank und ließ diesen Tag absichtlich leer. Ein anderer Berater arbeitete am 19. einen vollen Tag, vergaß aber, die Zeile auszufüllen – unbeabsichtigt. Vom Schreibtisch des Abrechnungskoordinators aus sehen beide identisch aus: eine fehlende Zeile in einem Meer von Daten.
Die Einzeldateiverarbeitung macht diese Lücken sichtbar, weil man den gesamten Monat einer Person auf einmal betrachtet. Die Batch-Verarbeitung – bei der man 30 zusammengeführte Stundenzettel anstarrt – verbirgt sie. Man prüft auf Spaltenvollständigkeit über den gesamten Monat, nicht auf Abdeckung pro Berater. Die Lücke taucht erst auf, wenn ein Kunde seine Rechnung hinterfragt und jemand in den Originaldateien nachgräbt.
WorkPuls-Daten zur Genauigkeit der Zeiterfassung bestätigen dies: 80 % der Unternehmen mit papierbasierten Stundenzettelsystemen mussten 80 % der erhaltenen Stundenzettel korrigieren. Wenn man diese Korrekturen über eine Charge von 30 Beratern multipliziert, verarbeitet man keine Stundenzettel – man betreibt eine parallele Qualitätssicherungsoperation.
Vom Stundenzettel-Stapel zum Umsatz-Dashboard: Der Batch-Workflow
Hier kommt es auf das Design des Extraktionstools an. Tools, die für die Verarbeitung einzelner Dokumente entwickelt wurden, behandeln Batch als nachträglichen Einfall — Sie verarbeiten eine Datei, laden das Ergebnis herunter, verarbeiten die nächste. Ein Batch-First-Extraktionstool — eines, das von Anfang an dafür entwickelt wurde, mehrere Dateien aufzunehmen und Ergebnisse in einer einzigen Ausgabe zusammenzuführen — bewältigt die drei oben genannten Herausforderungen direkt im Verarbeitungsschritt, anstatt sie dem Abrechnungskoordinator zu überlassen, der sie anschließend in Excel lösen muss.
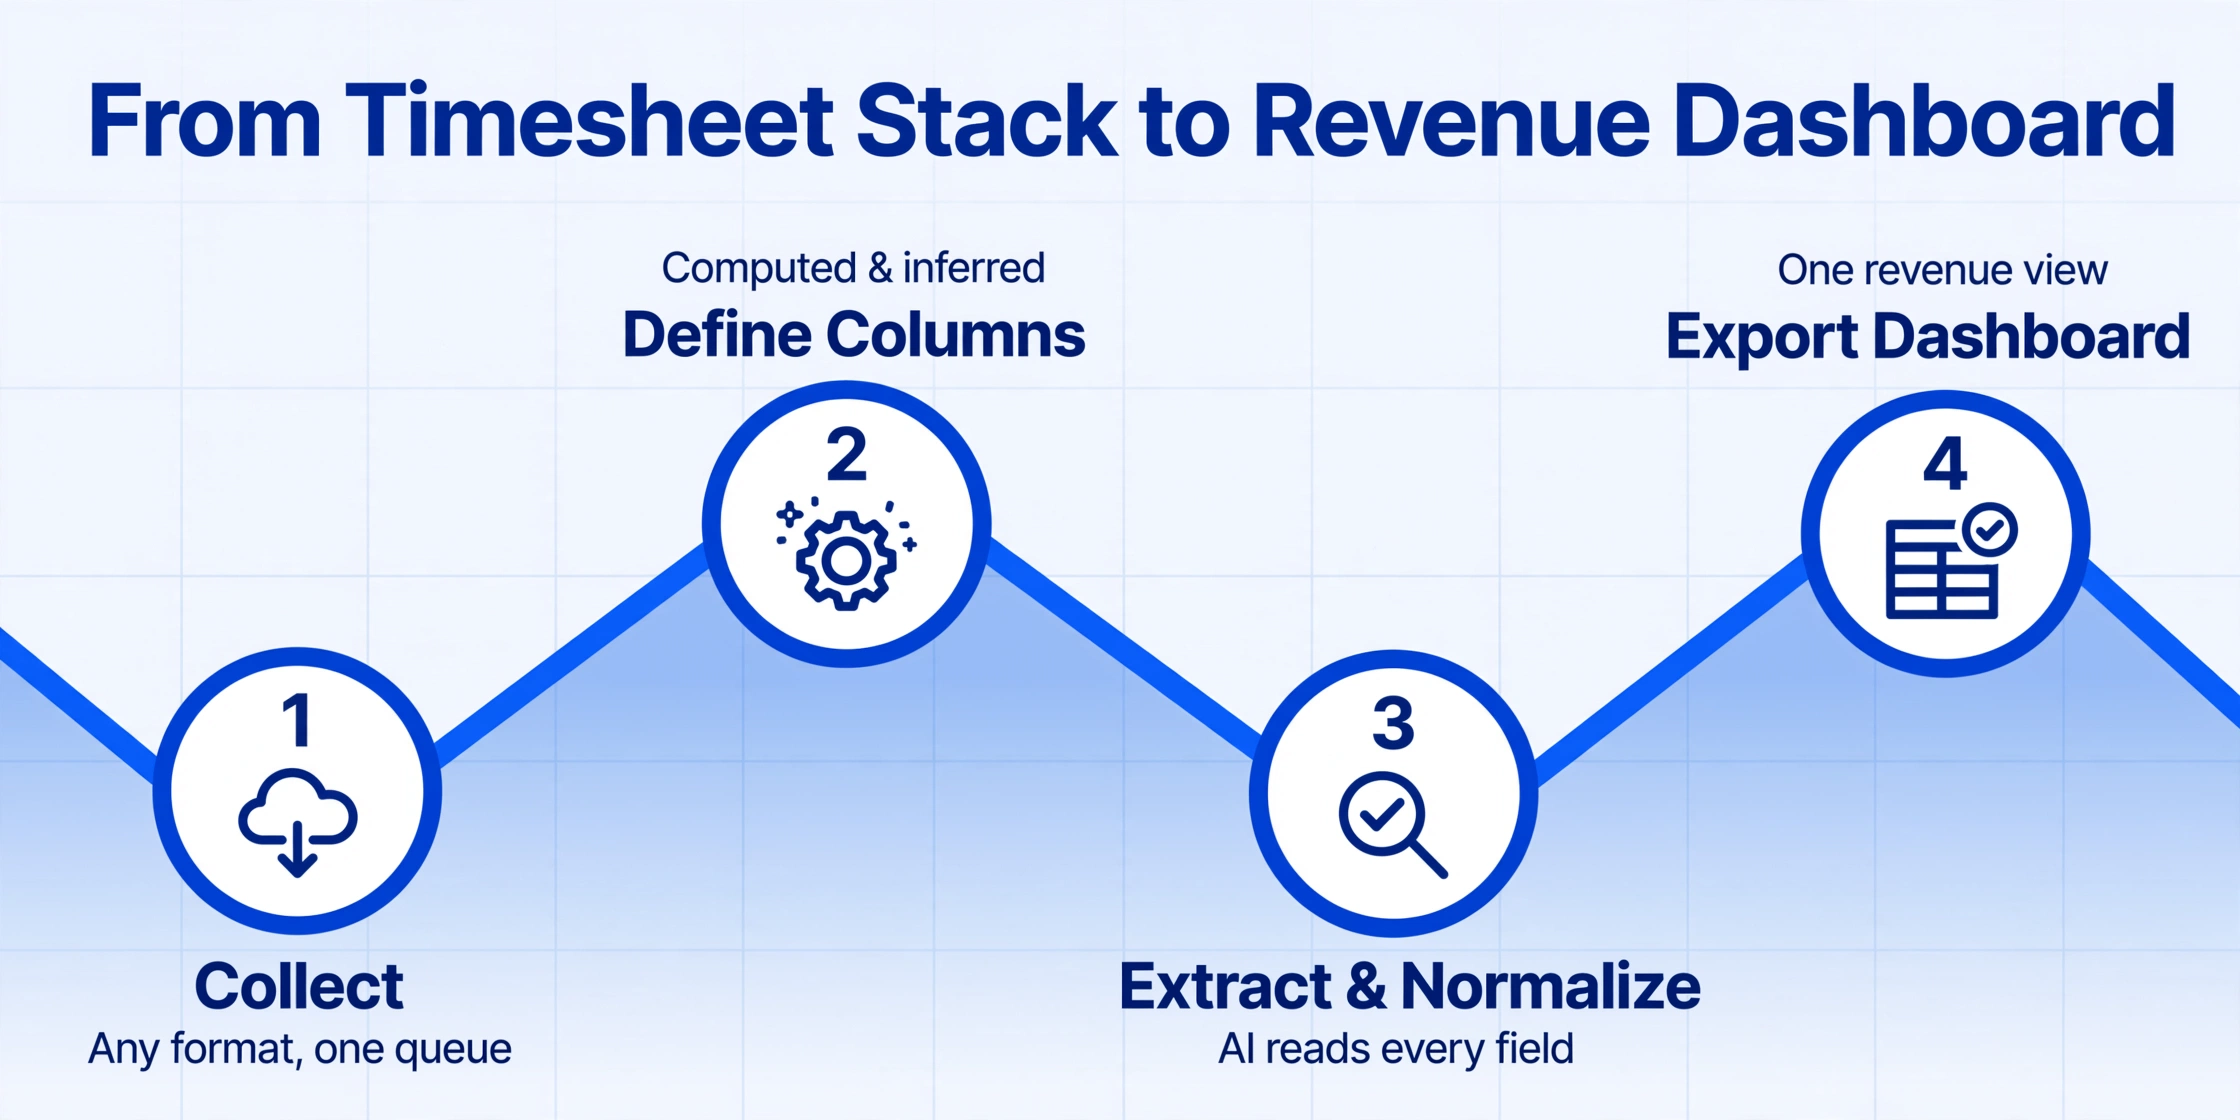
So sieht der Workflow von 30 Berater-Stundenzetteln zu einem einzigen Umsatz-Dashboard für den Kunden aus, wobei jeder Schritt darauf ausgelegt ist, eine der drei Batch-Kosten zu neutralisieren:
Stundenzettel an einem Ort sammeln – in jedem Format.
Sammeln Sie PDFs, JPGs, PNGs oder Scans von jedem Berater. Keine Notwendigkeit, Formate im Vorfeld zu standardisieren. Für Kanzleien, die die Sammlung automatisieren möchten, eliminiert ein Sammellink – eine teilbare Upload-Seite, auf der jeder Berater seinen Stundenzettel direkt in Ihre Verarbeitungswarteschlange ablegt, ohne dass sich der Absender anmelden muss – den Schritt „30 Leute nach Dateien jagen“ vollständig.
Definieren Sie Ihre Dashboard-Spalten – einschließlich Berechnungen.
Geben Sie die Feldnamen ein, die extrahiert werden sollen: Client Name, Project Code, Consultant Name, Date, Hours, Rate. Fügen Sie eine berechnete Spalte hinzu – zum Beispiel Revenue (Hours × Rate) – und die KI berechnet den abrechenbaren Betrag für jede Zeile während der Extraktion. Fügen Sie eine abgeleitete Spalte wie Standardized Client (infer from Client Name) hinzu, um Namensvariationen zu normalisieren. Diese Spalten werden zum Rohmaterial für Ihr Dashboard.
Alle 30 Dateien gleichzeitig hochladen und verarbeiten.
Wählen Sie alle Stundenzettel-Dateien aus und verarbeiten Sie sie als einen Batch. Die KI liest jedes Dokument mithilfe semantischer Extraktion – sie versteht, dass „7.25“ neben „Hours“ unter einer Zeile mit „Acme Corp“ 7,25 abrechenbare Stunden für diesen Kunden bedeutet, unabhängig davon, wo diese Felder auf der Seite stehen. Alle 30 Dateien werden zu einer einzigen Excel-Tabelle zusammengeführt, wobei die berechnete Spalte den Umsatz pro Zeile berechnet und die abgeleitete Spalte Kundennamen standardisiert. Das ist der qualitative Wandel: Aus 30 separaten Transkriptionssitzungen wird ein strukturierter Datensatz in etwa 5 Minuten.
In Ihr Umsatz-Dashboard pivotieren.
Erstellen Sie mit der zusammengeführten Excel-Tabelle eine Pivot-Tabelle: Zeilen nach Standardized Client und Project Code, Werte als SUMME von Hours und SUMME von Revenue, mit Consultant Name als Filter. In weniger als einer Minute gelangen Sie von rohen Stundenzettelzeilen zu: Gesamtstunden pro Kunde, Gesamtumsatz pro Projekt, Auslastung pro Berater (abrechenbare Stunden ÷ verfügbare Stunden) und einem schnellen Vergleich von abgerechnetem vs. erwartetem Umsatz. Kein manuelles Schreiben von Formeln. Das Dashboard ist eine Pivotierung des Extraktionsergebnisses, kein separater Bericht, den Sie von Grund auf erstellen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Namenskonventionen von Beratern ohne manuellen Bereinigungsschritt normalisieren
Das Problem inkonsistenter Benennungen – „Acme Corp – Phase 2" vs. „AC2 – Strategie" vs. „Acme Corp (Phase II)" – ist die größte batch-spezifische Herausforderung bei der Stundenzettel-Verarbeitung. Bei der Einzeldatei-Extraktion existiert es nicht, da Sie die Einträge eines einzelnen Beraters betrachten und die Namensvariation nur relevant wird, wenn Einträge kombiniert werden.
Traditionelle Ansätze für dieses Problem sind alle manuell: eine Nachschlagetabelle pflegen und jede Zelle per VLOOKUP prüfen, eine E-Mail mit „Namensstandardisierungsrichtlinie" senden, die die Hälfte der Berater ignoriert, oder (am häufigsten) drei separate Zeilen in der Pivot-Tabelle akzeptieren und sie nach jedem monatlichen Batch-Lauf manuell konsolidieren.
Abgeleitete Spalten-Extraktion löst dies innerhalb des Verarbeitungsschritts. Sie definieren eine Spalte wie Standardisierter Kunde (ableiten aus dem Feld Kundenname – Optionen: Acme Corp, Beta Industries, Gamma Consulting, Sonstige). Die KI liest den Eintrag jedes Beraters für „Kundenname" – egal wie er geschrieben wurde – und ordnet ihn dem von Ihnen definierten standardisierten Namen zu, wobei die normalisierte Version in einer separaten Spalte ausgegeben wird. Dies unterscheidet sich von einer Nachschlagetabelle, da die KI semantische Ähnlichkeit versteht: „AC2" und „Acme Corp Phase 2" werden als dieselbe Entität erkannt, ohne dass Sie jede mögliche Variante definieren müssen.
Der Vorteil downstream ist unmittelbar: Ihre Pivot-Tabelle gruppiert nach der Spalte „Standardisierter Kunde" und zeigt eine Zeile pro Kunde – das Umsatz-Dashboard, das Sie tatsächlich benötigen – ohne eine 45-minütige manuelle Bereinigungssitzung vor jedem Abrechnungslauf.
Was Ihnen das Dashboard tatsächlich verrät, was rohe Stundenzettel nicht können
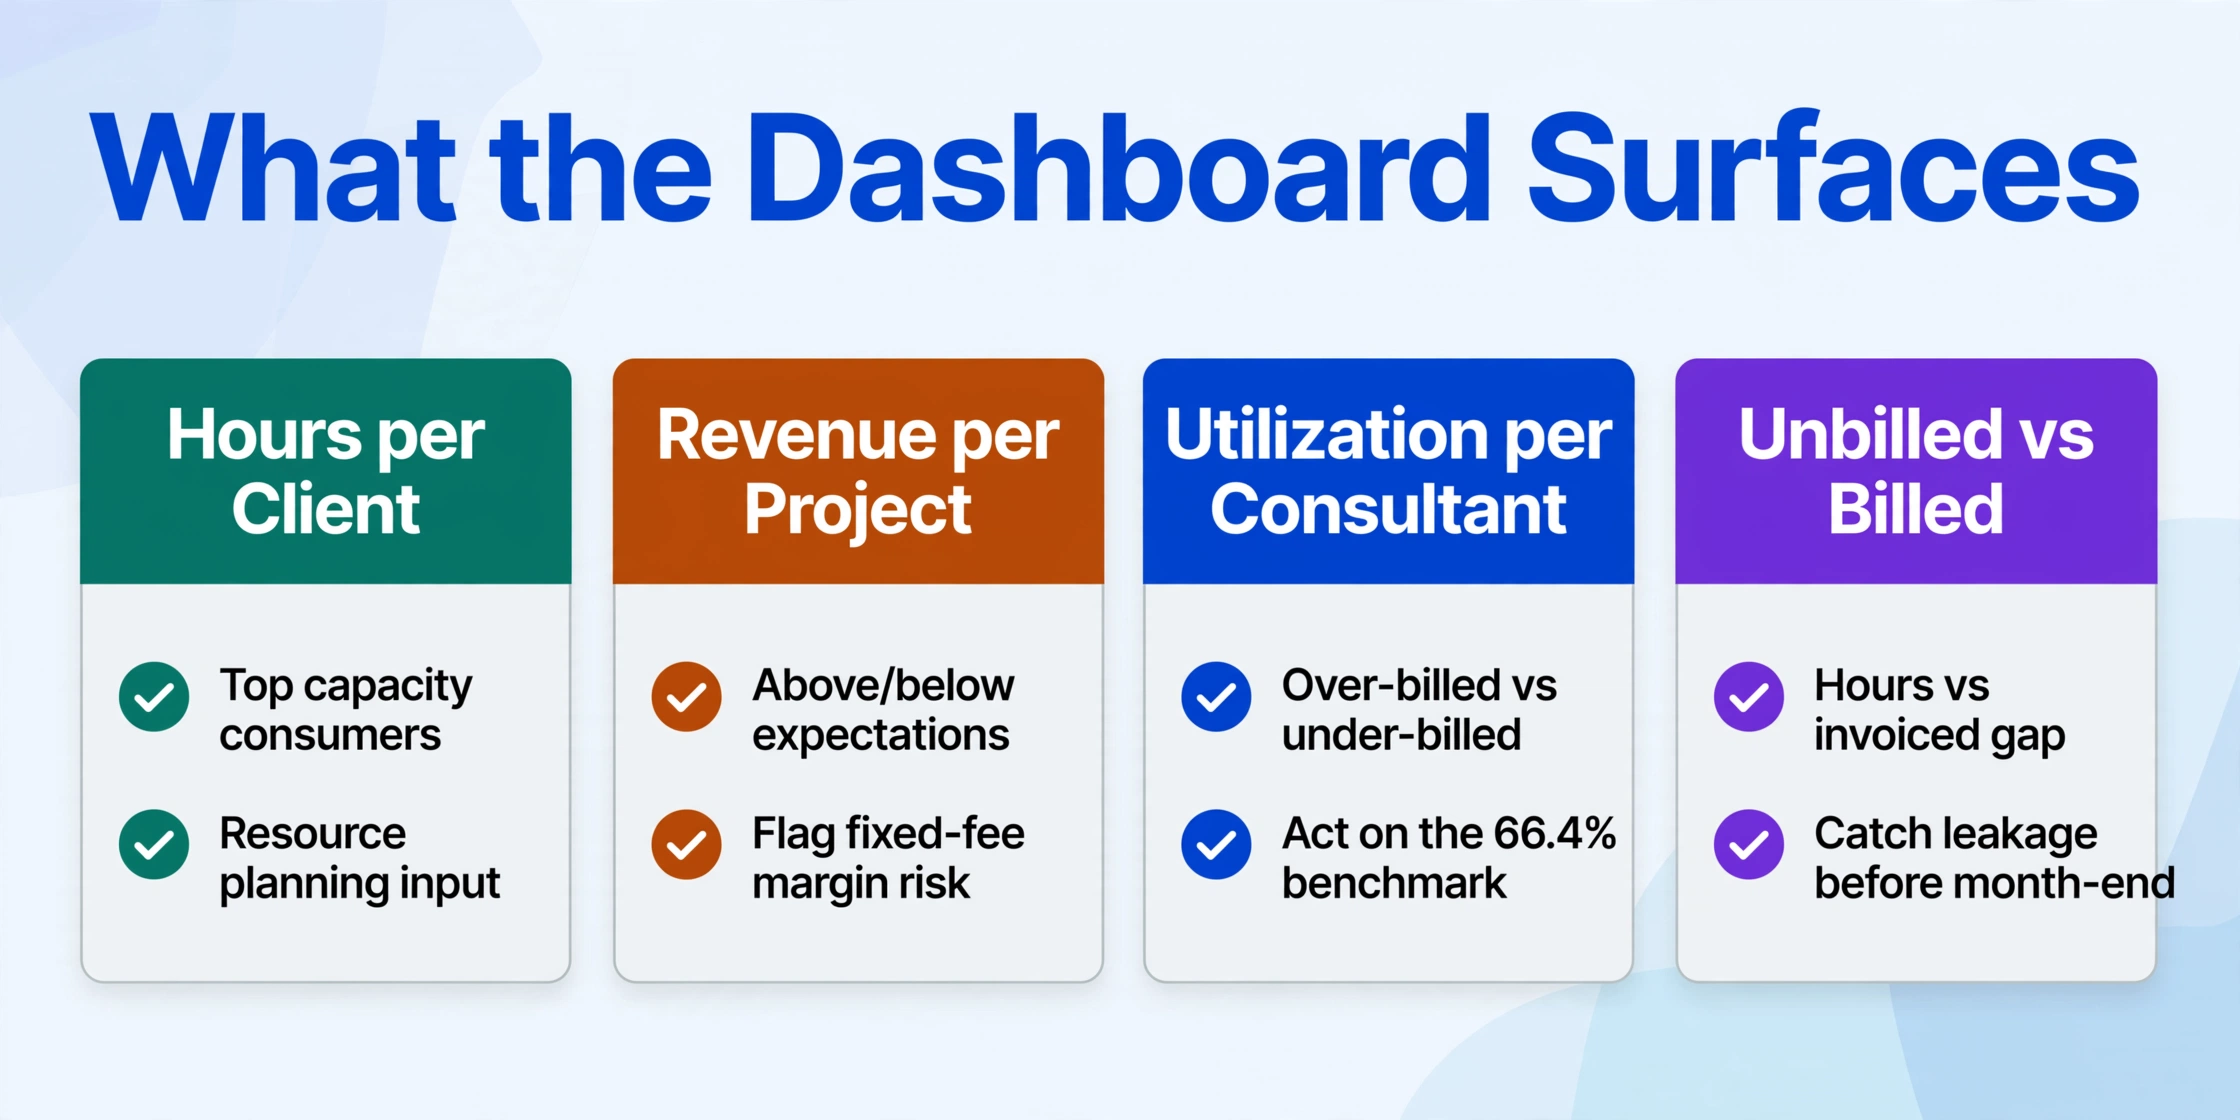
Sobald die 30 Stundenzettel zu einer Tabelle zusammengeführt und normalisiert sind, wird die Pivot-Tabelle zu einer Linse, die rohe Stundenzettel nicht bieten können. Das zeigt sich, wenn Sie die Daten nach Kunde, Projekt und Berater anordnen:
| Dashboard-Ansicht | Pivot-Konfiguration | Was sichtbar wird |
|---|---|---|
| Stunden pro Kunde | Zeilen: Standardisierter Kunde | Werte: SUMME der Stunden | Welche Kunden die meiste abrechenbare Kapazität verbrauchen – entscheidend für die Ressourcenplanung und die Preisgestaltung bei Verlängerungen |
| Umsatz pro Projekt | Zeilen: Standardisierter Kunde, Projektcode | Werte: SUMME des Umsatzes | Welche Projekte Umsatz über oder unter den Erwartungen erzielen; kennzeichnet Festpreisprojekte, bei denen die tatsächlichen Stunden die Marge schmälern |
| Auslastung pro Berater | Zeilen: Beratername | Werte: SUMME der Stunden ÷ verfügbare Stunden | Wer ist überbucht (Burnout-Risiko) und wer ist unterbucht (Umsatzlücke). Die Branchenauslastung von SPI von 66,4 % wird zu einer Kennzahl pro Berater, auf die Sie reagieren können |
| Nicht abgerechnet vs. abgerechnet | SUMME des Umsatzes vs. erwartete Rechnungssummen der Kunden | Die Lücke zwischen geleisteten und abgerechneten Stunden – die Kennzahl hinter der Statistik von 15–25 % Verlust. Schließen Sie die Lücke vor Monatsende, nicht erst, wenn der Kunde die Rechnung hinterfragt |
Das ist kein Dashboard, das Sie jeden Monat von Grund auf neu erstellen. Es ist eine Pivot-Tabelle des Extraktionsergebnisses – dieselbe Excel-Datei, die jede extrahierte Zeile enthält. Richten Sie die Pivot-Tabelle einmal ein, und jeder monatliche Batch aktualisiert sie mit neuen Daten. Das SPI-Research-Benchmark-Ziel von 75 % Auslastung ist dann keine abstrakte Branchenzahl mehr, sondern eine Kennzahl pro Berater, die Sie verfolgen, besprechen und verbessern können.
Auslastung ist nicht nur eine Rentabilitätskennzahl – sie ist ein Frühindikator für Umsatzverlust. Wenn die durchschnittliche Auslastung einer Firma unter 70 % fällt, beginnt die Lücke zwischen verfügbaren und abrechenbaren Stunden die Marge schneller aufzuzehren, als die meisten Firmen es bis zur Quartalsüberprüfung bemerken. Ein monatliches Dashboard, das die Auslastung pro Berater zeigt, schließt die Feedback-Schleife, bevor das Quartal endet.
Dashboard mit Ihrem Abrechnungszyklus verbinden
Das Extraktionsergebnis ist eine Excel-Tabelle. Der Abrechnungsschritt ist die Rechnungsstellung an Kunden auf Basis dieser Tabelle. Die meisten professionellen Abrechnungsplattformen akzeptieren CSV-Importe für Zeiteinträge – die Lücke zwischen „Dashboard zeigt Umsatz" und „Rechnung geht an Kunden" ist also ein Importschritt, kein erneutes Eintippen:
| Plattform | CSV-Importpfad | Typische Importdauer (200 Einträge) |
|---|---|---|
| QuickBooks Online | CSV-Import über Zahnrad → Daten importieren → Zeiterfassung | Unter 2 Minuten |
| Clio | Massenimport von Zeiteinträgen per CSV; Zuordnung zu Vorgang, Aktivität, Stunden, Satz | Unter 3 Minuten |
| Harvest | CSV-Import mit Feldern für Kunde, Projekt, Aufgabe, Stunden, Datum | Unter 2 Minuten |
| BQE Core | Zeiteintragsimport per CSV; Zuordnung zu Projekt, Phase, Mitarbeiter, Stunden | Unter 3 Minuten |
| BigTime | CSV- und QuickBooks-integrierter Import; unterstützt Mitarbeiter, Projekt, Datum, Stunden, Satz | Unter 2 Minuten |
Der Workflow ist: Extraktion → Pivot ins Dashboard → CSV-Export → Import in die Abrechnungsplattform. Der Dashboard-Schritt dient als Abstimmungsnachweis – hier prüfen Sie, ob das, was Sie in Rechnung stellen wollen, auch tatsächlich geleistet wurde, bevor die Rechnung rausgeht. Kanzleien, die diesen Schritt überspringen und direkt importieren, setzen auf Extraktionsgenauigkeit ohne Prüfung – so bleibt die 15%-Lücke bestehen, selbst wenn Extraktionstools im Einsatz sind.
Für Kanzleien, die tiefer einsteigen müssen – etwa bei Multiwährungsabrechnung, DCAA-Compliance für öffentliche Auftragnehmer oder LEDES-Format für Anwaltskanzleien – behandelt der vollständige Leitfaden von Extraktion bis Abstimmung diese Pfade im Detail. Für Vergleichskäufer, die die aktuelle Landschaft bewerten, führt unser Überblick über Zeiterfassungs-Extraktionstools 2026 durch Preise, Genauigkeit und Workflow-Passung im Markt. Wenn Ihre Stundenzettel von Außendienstmitarbeitern in Papierform eingehen, deckt Papier-Arbeitszettel zu abrechenbaren Beträgen speziell den Übergang von Papier zu Digital ab. Und Monatsendverarbeitung von Stundenzetteln für den Lohnabschluss überträgt denselben Ansatz auf die Lohnseite des monatlichen Zyklus.
FAQ
Wie viele Stundenzettel kann ich auf einmal verarbeiten?
Es gibt keine feste Grenze – die Stapelverarbeitung akzeptiert beliebig viele Dateien in einem Upload. Die Verarbeitungszeit skaliert etwa linear mit der Seitenzahl. Als praktischer Richtwert: 30 einseitige Stundenzettel werden in etwa 5 Minuten vom Upload bis zur zusammengeführten Excel-Ausgabe verarbeitet. Einzelne Seiten benötigen 5–10 Sekunden – etwa 18-mal schneller als manuelle Dateneingabe, die bei strukturierten Formularen durchschnittlich 3 Minuten pro Seite dauert.
Was ist, wenn Berater völlig unterschiedliche Stundenzettel-Formate verwenden?
Formatvielfalt ist das Kernproblem, das die Stapelverarbeitung löst. Die KI-Extraktion identifiziert Daten anhand der semantischen Bedeutung, nicht der Position auf der Seite – sie versteht, dass „7,25" neben „Stunden" abrechenbare Stunden bedeutet, unabhängig davon, ob dieses Feld in der oberen rechten Ecke eines PDFs, in der dritten Spalte einer Excel-Tabelle oder handschriftlich neben einem gekritzelten Datum auf einem gescannten Formular steht. Die KI liest jedes Format unabhängig und normalisiert alle Ergebnisse in dieselbe strukturierte Ausgabe. Eine ausführliche Erklärung, wie sich semantische Extraktion von template-basierter OCR unterscheidet, finden Sie im vollständigen Leitfaden zur Stundenzettel-Extraktion.
Kann die KI unterschiedliche Abrechnungssätze für denselben Berater bei verschiedenen Kunden verarbeiten?
Ja, auf zwei Arten. Enthält das Stundenzettel-Formular eine Spalte „Satz", extrahiert die KI diese pro Zeile – unterschiedliche Sätze für verschiedene Einträge werden automatisch verarbeitet. Fehlen die Sätze auf dem Stundenzettel, verwenden Sie eine Berechnete Spalte, um die Satzlogik einzubetten. Für Festpreis-Szenarien definieren Sie Umsatz (Stunden × 275) für einen Standardsatz oder verwenden Sie separate Spalten für verschiedene Kunden. Für Engagements mit mehreren Sätzen nutzen Sie das Regelformat (für eingeloggte Benutzer verfügbar), um bedingte Satzlogik zu definieren – z. B. 350 $/Stunde für Senior-Berater und 200 $/Stunde für Junior-Mitarbeiter, basierend auf dem aus jedem Stundenzettel extrahierten Beraternamen.
Was passiert, wenn ein Berater vergisst, einen Tag zu erfassen – erkennt die KI das?
Die KI extrahiert, was im Dokument steht – sie erfindet keine fehlenden Einträge. Das Dashboard deckt jedoch Lücken auf, die bei der manuellen Prüfung einzelner Stundenzettel übersehen werden könnten. Wenn Sie die zusammengeführten Daten nach Berater und Datum pivotieren, fallen Berater mit weniger Tagen als erwartet sofort auf – eine Lücke, die beim Durchblättern von 30 einzelnen Dateien kaum sichtbar wäre. Das Dashboard wird so zum Erkennungsmechanismus, nicht der Extraktionsschritt selbst.
Funktioniert die Stapelverarbeitung sowohl für gedruckte als auch handschriftliche Stundenzettel im selben Upload?
Ja. Die KI liest gedruckten Text, Handschrift und gemischte Dokumente im selben Stapel. Die Genauigkeit ist bei gedrucktem Text höher, aber gängige Handschrift auf strukturierten Formularen (mit beschrifteten Feldern und Einträgen in definierten Bereichen) wird zuverlässig extrahiert. Für Szenarien, in denen die Lesbarkeit entscheidend ist – etwa bei handschriftlichen Arbeitsberichten von Baustellen – verbessert eine strukturierte Vorlage mit klar beschrifteten Feldern die Extraktionskonsistenz.
Kann ich direkt in meine Abrechnungssoftware exportieren, statt nach Excel?
Der Standardexport erfolgt als Excel und CSV. Da alle gängigen Abrechnungsplattformen – QuickBooks, Clio, Harvest, BQE Core, BigTime – CSV-Importe für Zeiteinträge akzeptieren, können Sie als CSV exportieren und direkt importieren, ohne den Zwischenschritt über Excel. Die meisten Kanzleien behalten die Excel-Datei jedoch als Abstimmungsnachweis – sie bietet den dreistufigen Prüfpfad (Original-Stundenzettel → extrahierte Daten → Rechnung), der Abrechnungsstreitigkeiten und Compliance-Anforderungen unterstützt.
SPI Research beziffert die branchenweite durchschnittliche abrechenbare Auslastung auf 66,4 % – der niedrigste je gemessene Wert. Jeder Prozentpunkt, der aus der Transkriptions- und Abgleichlücke zurückgewonnen wird, bringt diese Zahl näher an die 75-%-Schwelle. Testen Sie die Batch-Extraktion bei Ihrem nächsten monatlichen Stundenzettellauf und sehen Sie den Unterschied.
Stundenzettel als Batch verarbeiten